全文を丸ごと読ませるとAIはなぜ大事な情報を見落とすのか?「真ん中忘れ」と記憶の外部化の効果【海外AI一次情報深掘り 第6回】
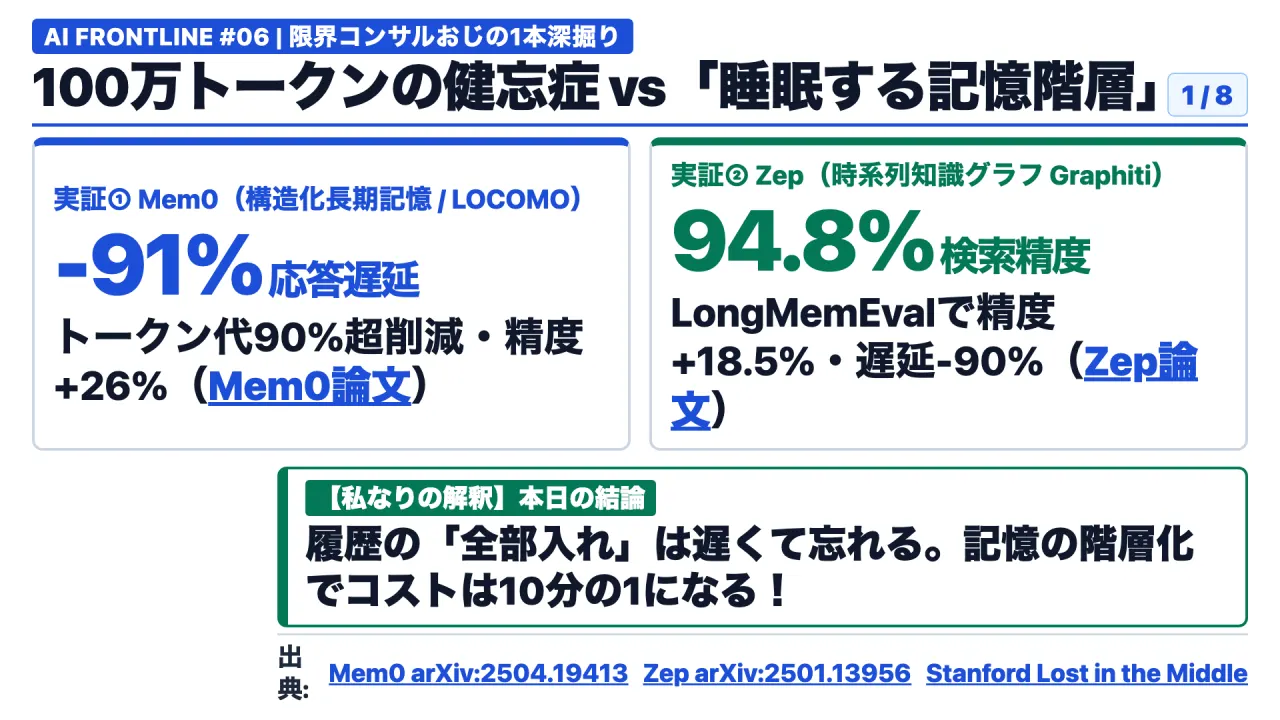
図1は放送時の説明資料(Slide 01)です。
今日は「なぜ、最新のエーアイに社内の議事録やマニュアルを丸ごと全部読み込ませると、途端にバカになって大事な約束を忘れるのか」という、記憶の科学とコストの話です。「今のエーアイは100万文字でも一度に読めるから、過去のチャット履歴や資料を全部プロンプトに放り込めばいい」という常識は、今日で完全に捨ててください。
いきなりですけど、クイズを1つ。過去のやり取りをすべて丸ごとエーアイに読み込ませる「全部入れ方式」をやめて、大事な事実だけを抜き出して整理する「専用の記憶ノート」に切り替えると、エーアイが返事をするまでの待ち時間と、毎月のトークン代は何パーセント減ると思いますか。
20パーセントでしょうか、50パーセントでしょうか。答えは、最新の記憶アーキテクチャ論文「メムゼロ(Mem0)」の実証データによると、なんと待ち時間が91パーセント減り、トークン代も90パーセント以上削減されます。
しかもコストが10分の1になっただけでなく、記憶の正確さまで26パーセント向上したのです。さらに時系列グラフ記憶「ゼップ(Zep)」の論文でも、長い対話の記憶テストで精度を18.5パーセント引き上げながら、待ち時間を90パーセント削ったことが証明されました。
だから今日の問いはこうです。なぜ、100万トークンの巨大メモリを持つはずのエーアイに「全部読ませる」と失敗し、人間のように「忘れる仕組みと睡眠」を与えると速度が10倍になりコストが10分の1になるのか。
みなさん、お元気ですか。「限界コンサルおじ」です。
普段は金融から製造業まで、コンサルティングからシステム開発、さらにはエーアイの追加学習まで、プロジェクト完成のためにはなんでもやる現場人間です。世界の最先端研究から見えてくる現場のリアルを、独自の視点で解説します。
さて、第6回となる本日のテーマは、「なぜ『100万トークンの記憶力』を持つエーアイが実務で健忘症になるのか、スタンフォード大が暴いた『真ん中忘れ』の罠と、トークン代を90パーセント削り応答速度を10倍にする『睡眠する記憶階層』の真実」です。
前提の整理と全体の見取り図
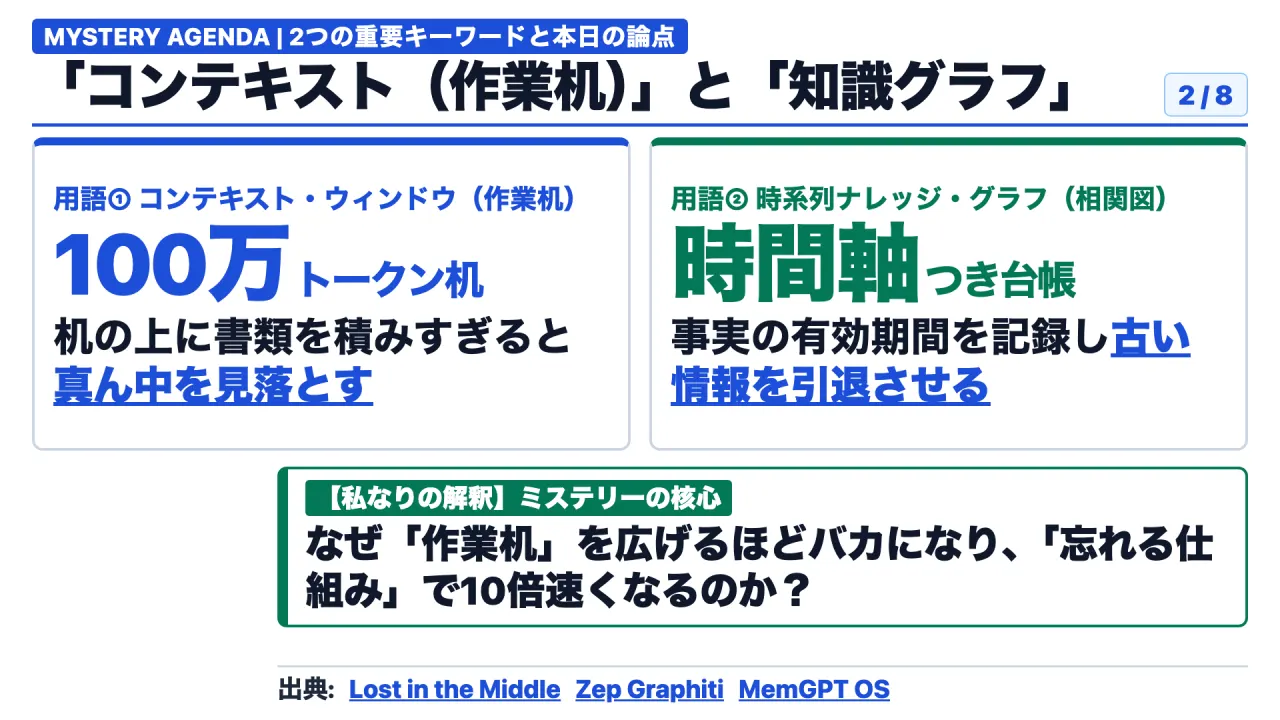
図2は放送時の説明資料(Slide 02)です。
本題の前に、言葉の整理を1つだけ。今日キーワードになる「コンテキスト・ウィンドウ」と「ナレッジ・グラフ(知識グラフ)」という2つの言葉です。
まず「コンテキスト・ウィンドウ」とは、エーアイが1回の会話で一度に広げて見ることができる「作業机の広さ」のことです。最近のエーアイはこの作業机が巨大になり、分厚い辞書10冊分にあたる100万トークンを一度に机の上に広げられると宣伝されています。
そしてもう1つの「ナレッジ・グラフ」とは、バラバラの文章をそのまま保存するのではなく、「鈴木部長は、4月1日に、営業部から開発部へ異動した」というように、人物と出来事を「線と日付」で繋いだ相関図のことです。
今日の進み方です。まず、スタンフォード大学の研究チームが暴いた「真ん中忘れ現象」と、メムゼロの論文が示した「トークン代90パーセント削減・待ち時間91パーセント削減」という衝撃の数字を見ます。
次に、なぜ文字を丸ごと検索する従来のやり方(RAG)ではビジネスの現場で嘘をついてしまうのか、それを解決するゼップの「時間軸つき相関図」とカリフォルニア大学バークレー校の「仮想記憶」のカラクリを見ます。それから、海外ポッドキャスト『レイテント・スペース』でハブスポット共同創業者のダルメシュ・シャーたちが語った「エーアイの睡眠と記憶の共有」を聞き、最後に明日から私たちが社内エーアイにどうやって「記憶の仕組み」を組み込むべきか、私の見立てをお話しします。
第1章:海外一次データが示す現場の変化
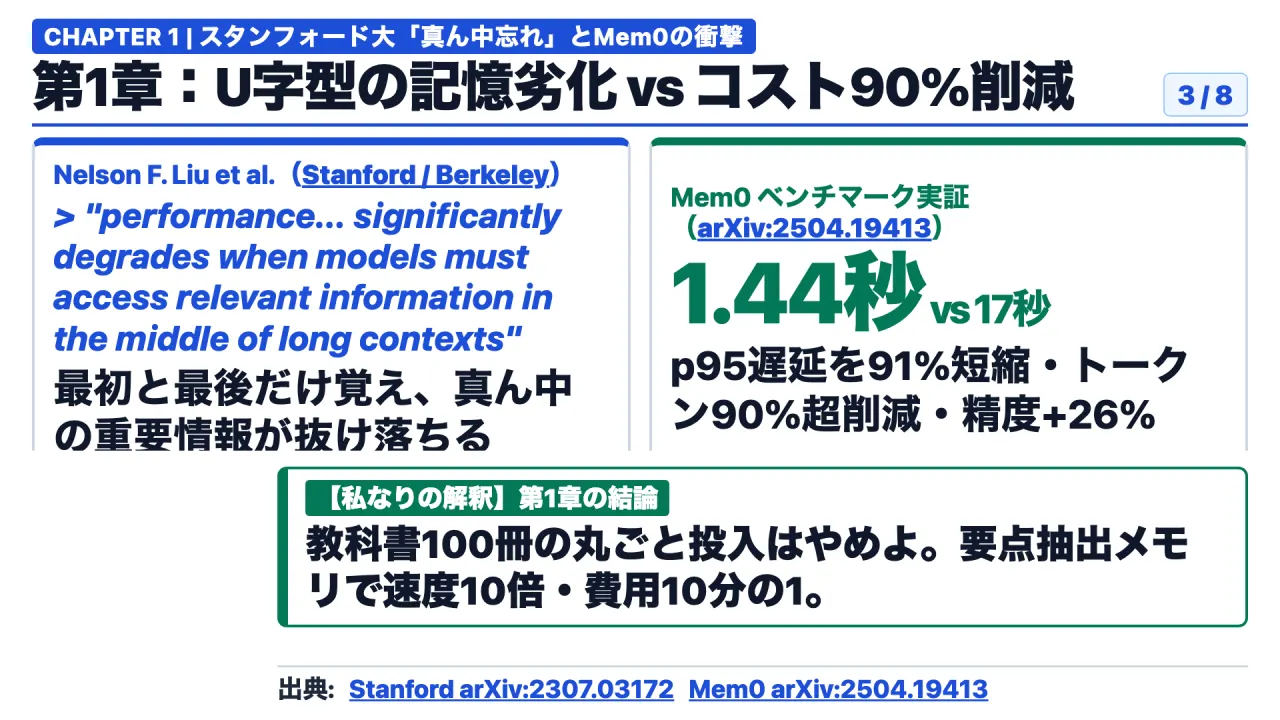
図3は放送時の説明資料(Slide 03)です。
まず第1章、なぜ「作業机(コンテキスト・ウィンドウ)を広くすれば全部覚えてくれる」という思い込みが危険なのか、2つの決定的な論文データから見ていきます。
多くの企業では今、「最新のエーアイは100万トークンまで読めるのだから、過去のチャット履歴も社内規定も、毎回ぜんぶプロンプトに詰め込んで送ればいいじゃないか」と考えてシステムを作っています。
しかし、このやり方には致命的な欠陥があることを、スタンフォード大学とカリフォルニア大学バークレー校のネルソン・リュウ(Nelson F. Liu)らの研究チームが『ロスト・イン・ザ・ミドル(真ん中で迷子になる)』という論文で残酷なまでに暴き出しました。論文の要旨には、こう明確に記されています。
具体的には、関連する情報が入力テキストの「一番最初」または「一番最後」にあるときに最も成績が高くなり、長いテキストの「真ん中」にある情報にアクセスしなければならない場合、たとえ長文対応を謳うモデルであっても、性能が劇的に劣化することが観測された。
これは人間のテスト勉強に例えると一発でわかります。試験の直前に、机の上に教科書を100冊ドサッと積み上げても、最初に開いた1ページ目と、直前に見た最後のページしか頭に残らず、真ん中の50冊目に書いてあった大事な数字は完全に読み飛ばしてしまいますよね。
しかも毎回100冊全部を読み直していたら、1つの質問に答えるだけで17秒以上も待たされ、毎月のAPI利用料が何百万円にも膨れ上がってしまいます。
この「全部入れ方式」の無駄を完全に打ち破ったのが、長期記憶アーキテクチャ「メムゼロ(Mem0)」の研究論文です。研究チームは、長い会話履歴を丸ごと送るのをやめ、会話の中から「重要な事実だけ」をリアルタイムで抜き出し、古い記憶と統合して引き出す仕組みを作り、長期対話ベンチマーク「ロコモ(LOCOMO)」で徹底比較しました。
その結果は圧倒的でした。会話履歴を全部詰め込む方式と比べて、95パーセンタイルの応答待ち時間(レイテンシ)が約17秒から約1.44秒へと91パーセントも短縮され、消費するトークンコストは90パーセント以上削減されたのです。
しかも、ただ速くて安くなっただけではありません。余計な雑談ノイズが消えたことで、OpenAIの標準メモリ機能と比べて回答の正確さが26パーセントも向上しました。
ここまでを一言でまとめるとこうです。過去の履歴を丸ごと机に広げる「全部入れ方式」は、真ん中の情報を忘れる上に遅くて高い。
大事な事実だけを抜き出す「構造化メモリ」に変えるだけで、速度は10倍、コストは10分の1、正確さは26パーセント上がる、ということです。
第2章:技術的・構造的な仕組みと落とし穴
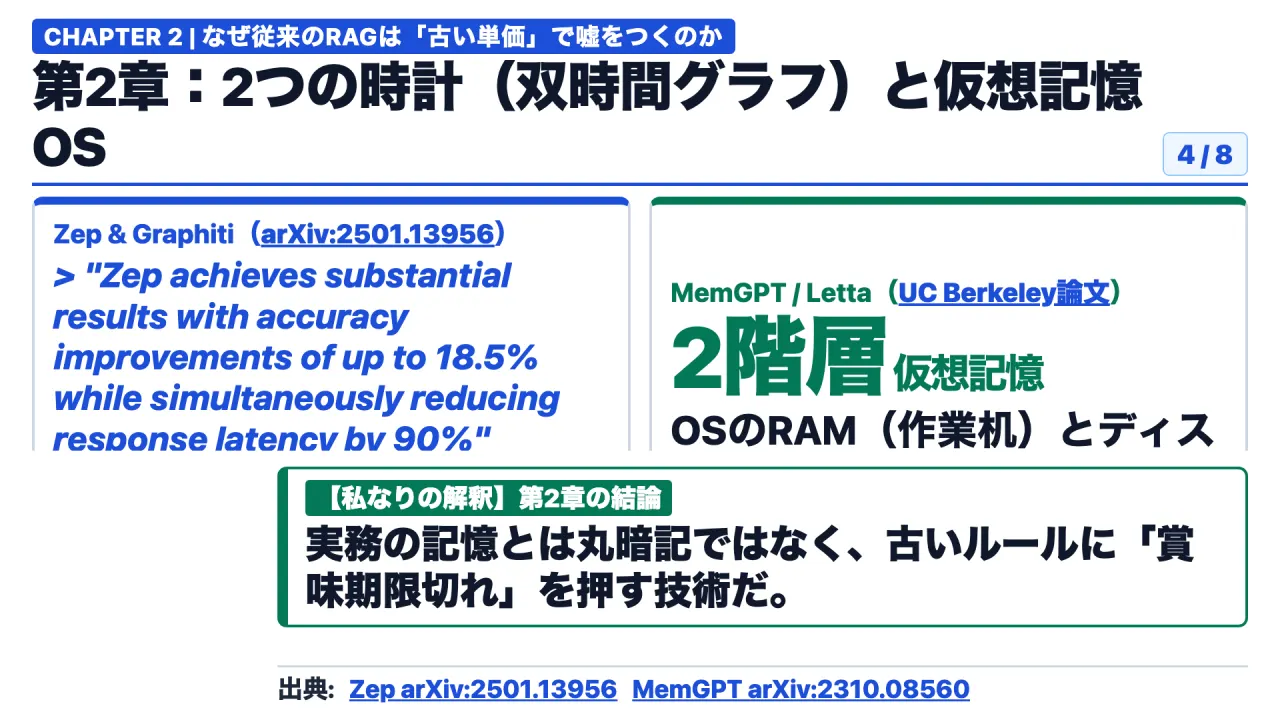
図4は放送時の説明資料(Slide 04)です。
次に第2章、ではどうやってエーアイに「賢い記憶」を持たせるのか。なぜこれまでの「文書検索(RAG)」では実務で失敗するのか、その技術的なカラクリを見ていきます。
よくある質問で、「うちは過去の議事録をベクトル検索(RAG)で引っ張ってくるようにしているから大丈夫だよ」と言う方がいます。しかし、ビジネスの現場では「時間が経つと事実が変わる」という最大の罠があります。
たとえば、去年の議事録には「A社への見積もり単価は1個1,000円」と書いてあり、先週のチャットには「原材料高騰のため、来月からA社の単価を1,200円に改定する」と書いてあったとします。従来の単純な文書検索(RAG)は、「どの情報がいつからいつまで有効か」という時間の感覚を持っていません。
そのため、去年の「1,000円」という古い文章と、先週の「1,200円」という新しい文章を同時に引っ張ってきてしまい、エーアイが混乱して間違った金額でお客さんにメールを書いてしまうのです。
この「時間の矛盾」を解決したのが、時系列ナレッジ・グラフ「ゼップ(Zep)」と、その中核エンジン「グラフィティ(Graphiti)」の論文です。論文の要旨では、その成果がこう報告されています。
メムジーピーティーのチームが主要な評価指標として確立したディープ・メモリ・リトリーバル・ベンチマークにおいて、ゼップは94.8パーセント対93.4パーセントという優れた性能を示した。さらに、複雑な時間推論タスクを通じて企業の実務により近い「ロング・メム・エバル」ベンチマークにおいて、ゼップは最大18.5パーセントの精度向上を達成すると同時に、応答遅延を90パーセント削減した。
ゼップがやった工夫は、「2つの時計(バイ・テンポラル・モデル)」を持たせたことです。すべての事実に「現実世界でいつからいつまで有効だったか」という開始日と終了日の時計をつけ、単価が1,000円から1,200円に変わった瞬間、古い1,000円という記憶を消しゴムで消すのではなく、「この1,000円という事実は先週で有効期限が切れました」という終了スタンプを押して保管します。
だから「今の単価は?」と聞かれれば迷わず「1,200円」と答え、「なぜ値上げしたの?
」と聞かれれば過去の経緯まで正確に辿れるのです。
さらに、カリフォルニア大学バークレー校のチャールズ・パッカー(Charles Packer)らが発表した『メムジーピーティー(MemGPT:現在のLetta)』の論文は、パソコンの基本ソフト(OS)と同じように、エーアイの記憶を「今すぐ使う小さな作業机(メインメモリ)」と「普段はしまっておく巨大な書庫(外部ストレージ)」の2階建てに分け、エーアイ自身が自分の判断で記憶を書き換えたり出し入れしたりする仕組みを作りました。
この章も一言でまとめます。実務で使える記憶とは、古いチャットを丸暗記することではなく、「いつからいつまで有効か」という時間のスタンプを押して、古い情報を正しく賞味期限切れにする仕組みである、ということです。
第3章:海外ポッドキャストの肉声と実務の壁
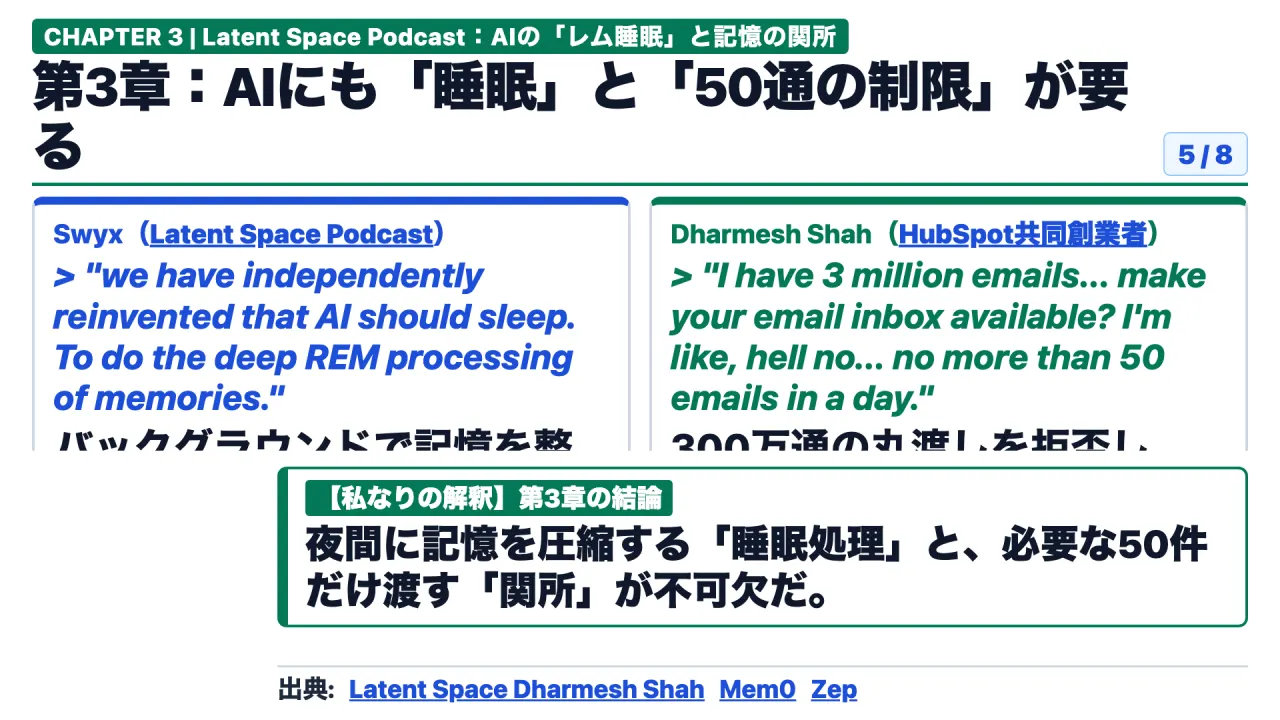
図5は放送時の説明資料(Slide 05)です。
続いて第3章です。この「記憶の仕組み」が進化すると、私たちの会社の働き方やセキュリティはどう変わるのか。
海外ポッドキャスト『レイテント・スペース』で、世界的な顧客管理ソフト企業ハブスポット(HubSpot)の共同創業者であり、現在エージェント基盤「エージェント・ドット・エーアイ」を率いるダルメシュ・シャー(Dharmesh Shah)と、ホストのスイックス(Swyx)が語った生々しい肉声を見ていきます(Latent Space: The Agent Network — Dharmesh Shah)。
まずホストのスイックスは、メムゼロやゼップ、そしてメムジーピーティー(Letta)といった最新の記憶研究を総括して、驚くべき共通点をこう語っています。
非常に興味深いのは、記憶の階層構造について研究者たちの意見が一致しつつあることだ。短期記憶からエピソード記憶、そしてバックグラウンド処理へと至る流れの中で、私たちは独立して「エーアイにも睡眠が必要だ」ということを再発見したのだ。
深いレム睡眠のように、裏側で記憶を整理・統合する処理が必要なのである。
「エーアイにも睡眠が必要だ」というのは、ものすごく本質的な表現です。人間も、昼間に見聞きした雑多な出来事を、夜寝ている間に脳の中で整理して、「大事な教訓」だけを長期記憶に残し、どうでもいい雑談は忘れますよね。
エーアイも全く同じで、昼間のチャット履歴をそのまま溜め込むのではなく、仕事が終わった後に裏側(バックグラウンド)で記憶を整理・圧縮する「睡眠プロセス」を持たせることで、初めて何ヶ月も賢く働き続けられるようになります。
そしてもう1つ、ダルメシュ・シャーが現場の最重要課題として突きつけたのが、「複数のエーアイにどこまで記憶を共有し、どこから秘密にするか(選択的メモリ認可)」という問題です。シャーは自分の300万通のメールを例に挙げてこう語っています。
私は自分の300万通のメールからデータベースを作って個人の仕事に使っている。しかし、もしどこかのスタートアップがやって来て「あなたのメールボックス全部へのアクセス権をくれませんか」と言ってきたら、私の答えは「絶対に嫌だ(ヘル・ノー)」だ。
そこには私の人生のすべてが入っているからだ。だからこそ「記憶の一部だけ」を切り出して共有する仕組みが必要になる。
「このラベルがついた、直近の、1日最大50通までのメールだけを渡す」と自然言語で制限できる信頼できる仲介役が不可欠なのだ。
ここまでを一言でまとめるとこうです。これからのエーアイには、夜間に記憶を整理する「睡眠の仕組み」と、300万通の記憶の中から「必要な50通分だけ」を安全に切り出して渡す「記憶の関所(認可フィルター)」の2つが不可欠になる、ということです。
第4章:私なりの解釈(構造変化の核心)
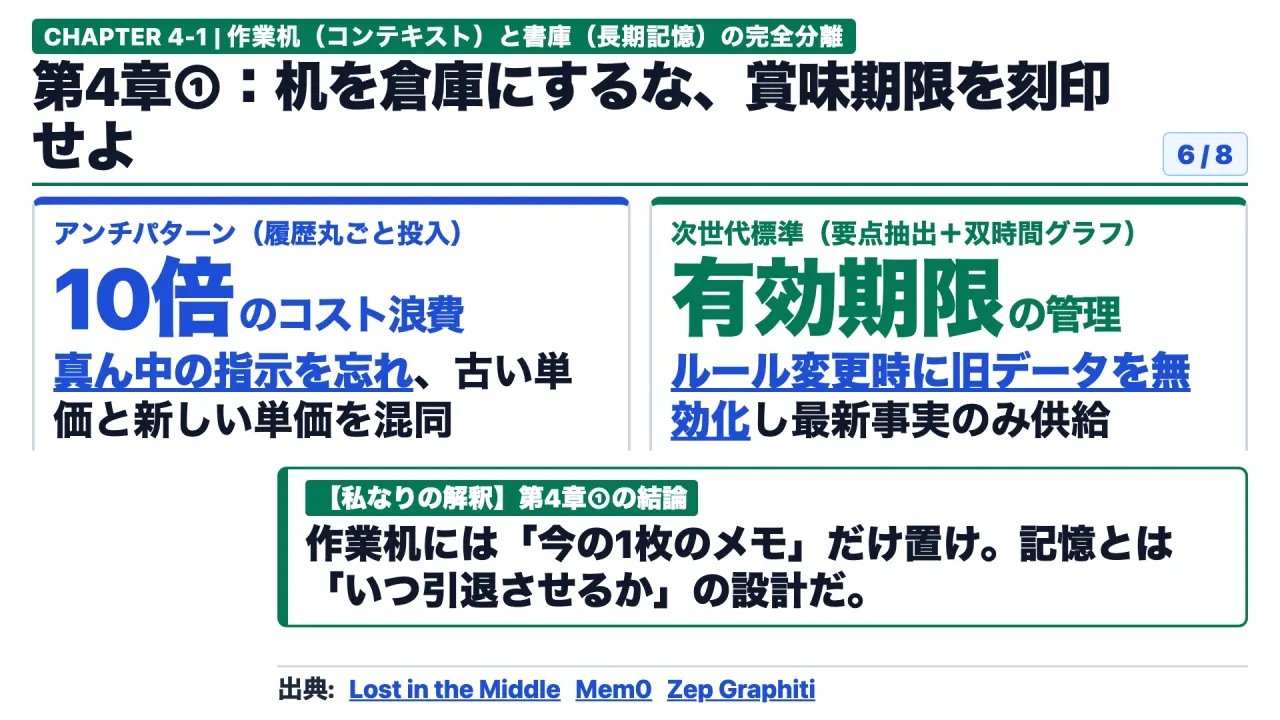
図6は放送時の説明資料(Slide 06)です。
ここからは、スタンフォード大の真ん中忘れ論文、メムゼロのコスト90パーセント削減、ゼップの時系列グラフ、そしてダルメシュ・シャーの選択的メモリ論を同じ物差しで並べて、私たちが明日からシステムをどう設計すべきか、【私なりの解釈】を3つに整理します。
まず1つ目の解釈は、「コンテキスト・ウィンドウ(作業机)は『倉庫』ではない。机の上に過去のチャットを積み上げるのを今すぐやめよ」ということです。
多くの現場では、エーアイが前の発言を忘れるたびに「もっと入力トークン数が大きいモデルに変えよう」とお金を払っています。しかしスタンフォード大の論文とメムゼロの実証データが証明した通り、作業机の上に古い書類を山積みにすればするほど、エーアイは真ん中の大事な指示を見落とし、返事は10倍遅くなり、料金は10倍に跳ね上がります。
作業机の上には「今この瞬間の判断に必要な1枚のメモ」だけを置き、残りはすべて机の下の引き出し(構造化メモリ)にしまわなければなりません。
次に2つ目の解釈は、「社内データベースに『賞味期限の時計(有効期間)』を入れない限り、社内エーアイは永遠に古いルールで嘘をつき続ける」ということです。
社内の規定や価格表、担当者の名前は毎月のように変わります。それなのに、古いPDFや議事録をただフォルダに放り込んで検索させるだけでは、エーアイは3年前の古いルールと今週の新しいルールを混ぜて答えてしまいます。
ゼップの双時間グラフが18.5パーセントも精度を上げた理由は、新しい事実が入ってきた瞬間に、古い事実に「有効期限切れ」の刻印を押したからです。記憶を作るということは、覚えること以上に「古い情報をいつ引退させるか」を決めることなのです。
第4章(後半):実務で機能する3層ハイブリッド設計
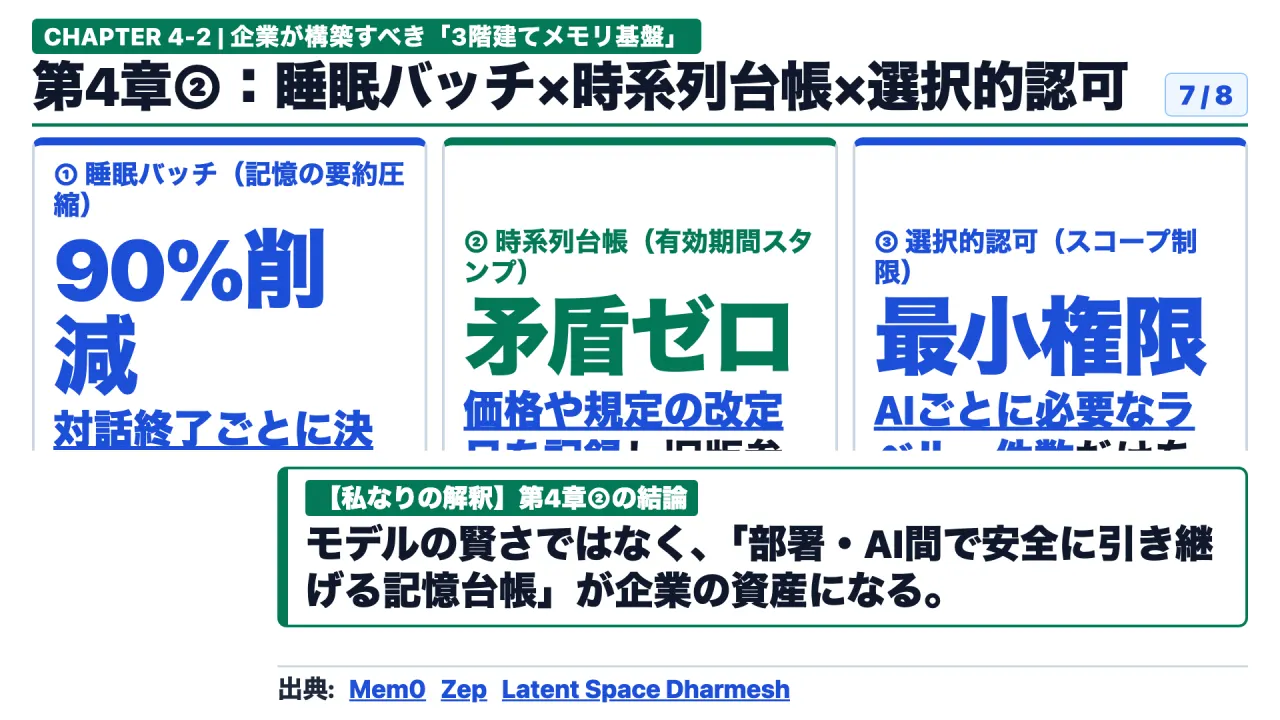
図7は放送時の説明資料(Slide 07)です。
そして3つ目の解釈は、「これからの企業システムで一番価値を持つ資産は、エーアイモデルそのものではなく、『部署やエーアイごとにアクセス権を分けた共有記憶レイヤー』になる」ということです。
ダルメシュ・シャーが指摘した通り、1つの会社の中で営業用エーアイ、経理用エーアイ、日程調整用エーアイが別々に動くようになると、毎回同じ前提を人間に聞き直すエーアイはすぐに使われなくなります。かといって、すべての社内メールや人事データを全部のエーアイに丸見えにするわけにはいきません。
だからこそ、次の3つのステップで「社内の記憶階層」を作る必要があります。
1つ目は、生のチャット履歴をそのまま送るのをやめ、会話が終わるたびに「決定事項・変更された数値・有効期限」の3つだけを抜き出して整理する「睡眠バッチ処理」を入れること。2つ目は、数値やルールが更新されたら、古いデータを消すのではなく「いつからいつまで有効だったか」の期間を記録して上書きする時系列台帳を作ること。
そして3つ目は、エーアイごとに「この業務ラベルのデータだけを1日50件まで読める」という細かい鍵(スコープ)をかけることです。
結論:明日から現場で試せる3つのアクション
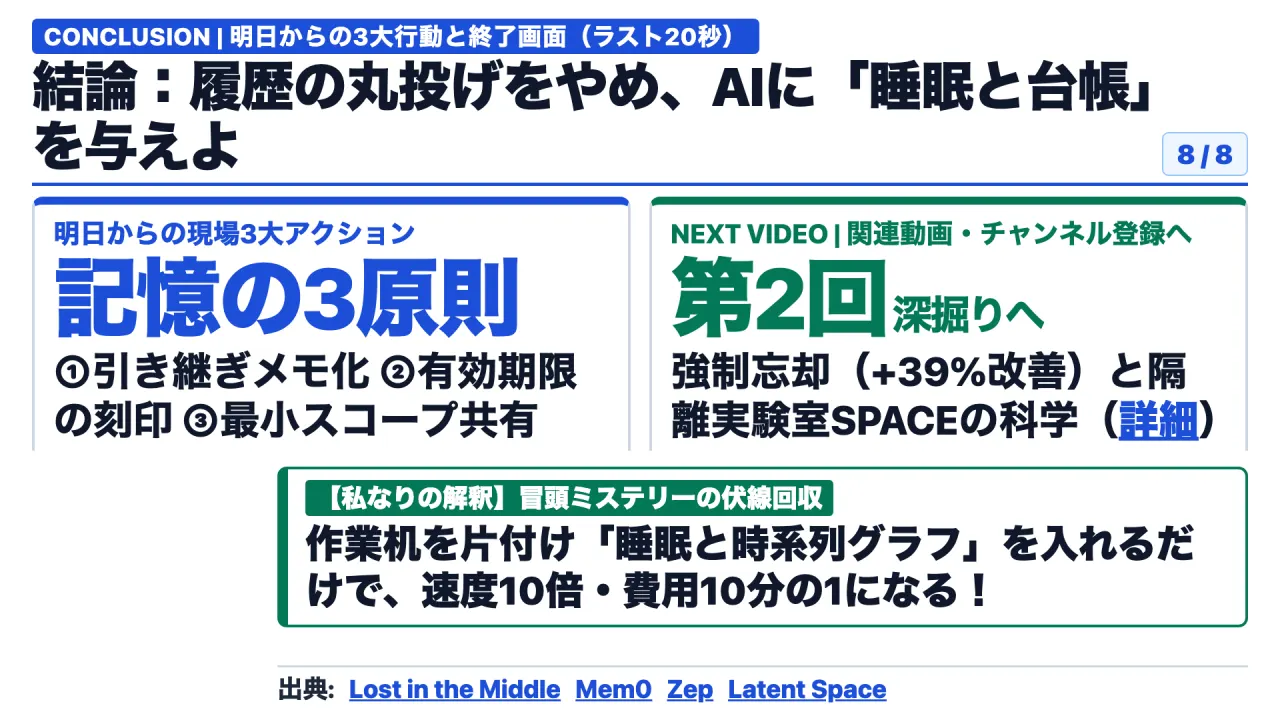
図8は放送時の説明資料(Slide 08)です。
では結論、なぜ100万トークンの記憶力を持つはずのエーアイが実務で健忘症になり、「忘れる仕組みと睡眠」を与えると速度が10倍・コストが10分の1になるのか。
今日の話を1枚に畳むとこうです。エーアイの頭が悪いからではありません。
私たちが「作業机(コンテキスト・ウィンドウ)」と「書庫(長期記憶)」を混同し、古い雑談まで全部机の上に積み上げていたせいで、真ん中の重要情報が埋もれていたからです。大事な事実だけを抜き出し、古い情報に「有効期限切れ」のスタンプを押す記憶レイヤーを入れるだけで、トークン代は90パーセント消え、待ち時間は10分の1になり、判断の正確さは劇的に跳ね上がります。
その上で、私の見立てです。これから1年で、「とにかく長い文章が読めるモデル」を自慢する時代は終わり、「いかに少ないトークンで、時間軸の矛盾がない綺麗な記憶を引き出せるか」というメモリ設計の巧拙が、企業のエーアイコストと業務品質のすべてを決めるようになります。
最後に、現場でシステム開発とコンサルティングを本業にしている人間として1つだけ。実は私自身も、毎日の開発や番組制作でエーアイを使うとき、過去の長いやり取りをそのまま引き継ぐことは絶対にしません。
1つの作業が終わるたびに、確定した事実と変更点だけを短い「引き継ぎメモ」に書き出して保存し、次の作業を始めるときは作業机を一度まっさらにリセットしてから、そのメモだけを渡すようにしています。まさに人間が一晩ぐっすり眠って頭を整理するのと同じサイクルをシステムに組み込むだけで、エラーもコストも驚くほど減ります。
これが現場で一番効いている実践知です。
みなさんはどう見ますか。普段エーアイを使っていて、「会話が長くなると急に前の指示を忘れた」「古い資料と新しい資料を混ぜて変な回答をされた」という経験はないか、よかったらコメントで聞かせてもらえれば嬉しいです。
また、いま画面に表示されている第2回の関連動画では、「実務の85パーセントで失敗するエーアイを劇的に改善する『記憶リセットと隔離実験室』の科学」をさらに詳しく解説していますので、ぜひ続けてご覧ください。それでは、また次回の放送でお会いしましょう。
参照した海外一次資料・出典リンク一覧
- Stanford University & UC Berkeley (Nelson F. Liu et al.): Lost in the Middle: How Language Models Use Long Contexts (arXiv:2307.03172)
- Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory (arXiv:2504.19413)
- Zep: A Temporal Knowledge Graph Architecture for Agent Memory (arXiv:2501.13956)
- UC Berkeley (Charles Packer et al.): MemGPT: Towards LLMs as Operating Systems (arXiv:2310.08560)
- Latent Space Podcast: The Agent Network — Dharmesh Shah (HubSpot Co-Founder & Agent.ai Creator) with Swyx & Alessio
この記事は、ポッドキャスト放送回(2026-10-22-deep-dive)の台本と一次資料をもとに再構成しました(確認日:2026年10月19日)。