「なぜ『成功率95%』の優秀なロボットAIが現場では98.3%失敗するのか」——100万時間の人間の視界データ(約170年分)から未来を予知する世界行動モデル『Dyna-2』と、鼎泰豊(ディンタイフォン)で毎日1,590枚のナプキンを折り続ける『1時間無介入エージェント(Taku)』の真実
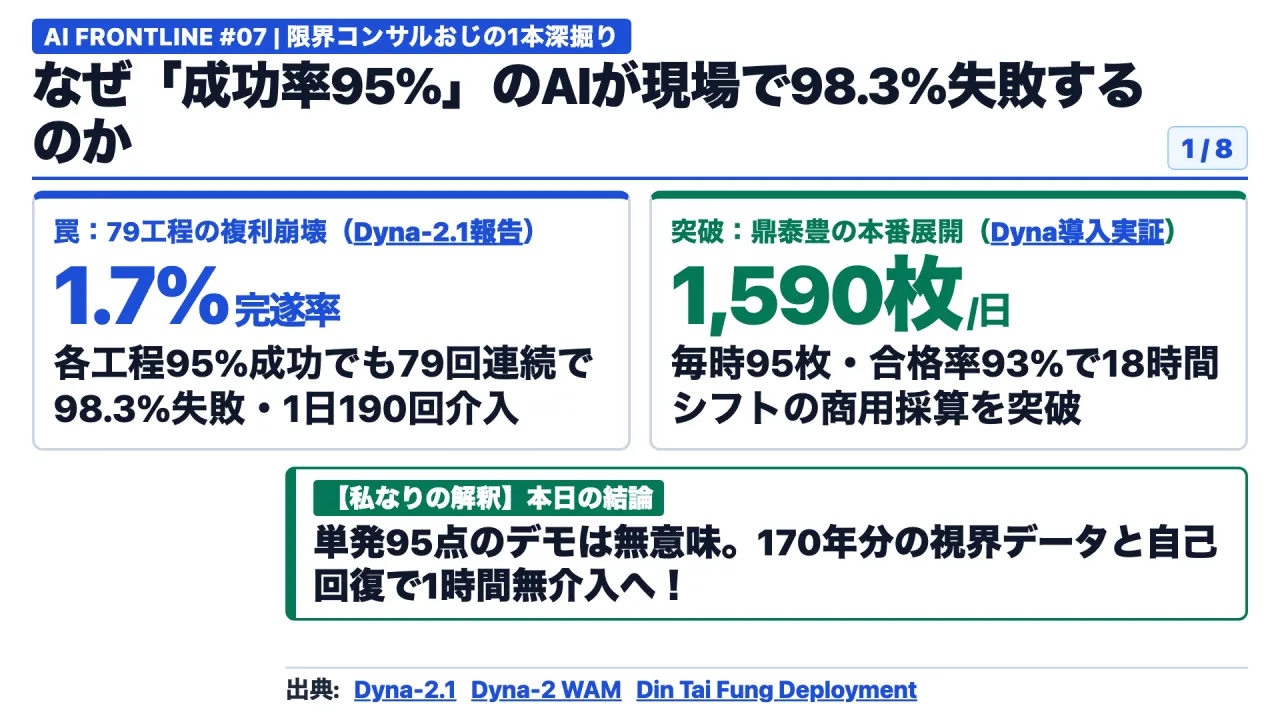
図1は放送時の説明資料(Slide 01)です。
今日は「なぜ、テストで95点という高得点を連発する優秀なエーアイやロボットが、いざ実際の店舗や工場に入れた途端、98.3パーセントという絶望的な確率で仕事に失敗し、人間が8分に1回も尻拭いに走らされるのか」という、物理エーアイと現場業務の残酷な算数の話です。いきなりですけど、直感で答えてみてください。
1つひとつの作業を「95パーセント」の確率で完璧にこなせる最新鋭のロボットをホテルの洗濯室に入れたら、洗濯から乾燥、タオルたたみ、棚への収納まで79個の工程が続く1サイクルの仕事を、人間の助けなしで最後までやり切れる確率は何パーセントくらいあると思いますか。80パーセントでしょうか、それとも70パーセントでしょうか。
答えは、米国のロボット基盤モデル企業ダイナ・ロボティクス(Dyna Robotics)が公開した『ダイナ2.1』の現場実証データによると、なんとわずか1.7パーセントです。つまり98.3パーセントの確率で途中で破綻し、24時間で190回、実に8分に1回も人間のスタッフが呼ばれて止まった機械を助けなければならないのです。
それなのに同じダイナ・ロボティクスの最新モデルは、あの世界的な小籠包(ショウロンポウ)の名店「鼎泰豊(ディンタイフォン)」の店舗で、毎日1,590枚もの布ナプキンを93パーセントの最高品質で自律的に折り続け、全米の複数店舗への本格導入を勝ち取りました(Dyna Robotics顧客導入レポート)。だから今日の問いはこうです。
なぜ95点のロボットが現場で98パーセント失敗し、どうやって「170年分の人間の目線データ」と「車輪と腰」でその壁を突破したのか。
改めまして、みなさんお元気ですか。「限界コンサルおじ」です。
普段は金融から製造業まで、コンサルティングからシステム開発、さらにはエーアイの追加学習まで、プロジェクト完成のためにはなんでもやる現場人間です。世界の最先端研究から見えてくる現場のリアルを、独自の視点で解説します。
さて、第7回となる本日のテーマは、「なぜ『成功率95パーセント』の優秀なロボットエーアイが現場では98.3パーセント失敗するのか、100万時間の人間の視界データから未来を予知する世界行動モデル『ダイナ2』と、鼎泰豊で毎日1,590枚のナプキンを折り続ける『1時間無介入エージェント』の真実」です。
前提の整理と全体の見取り図
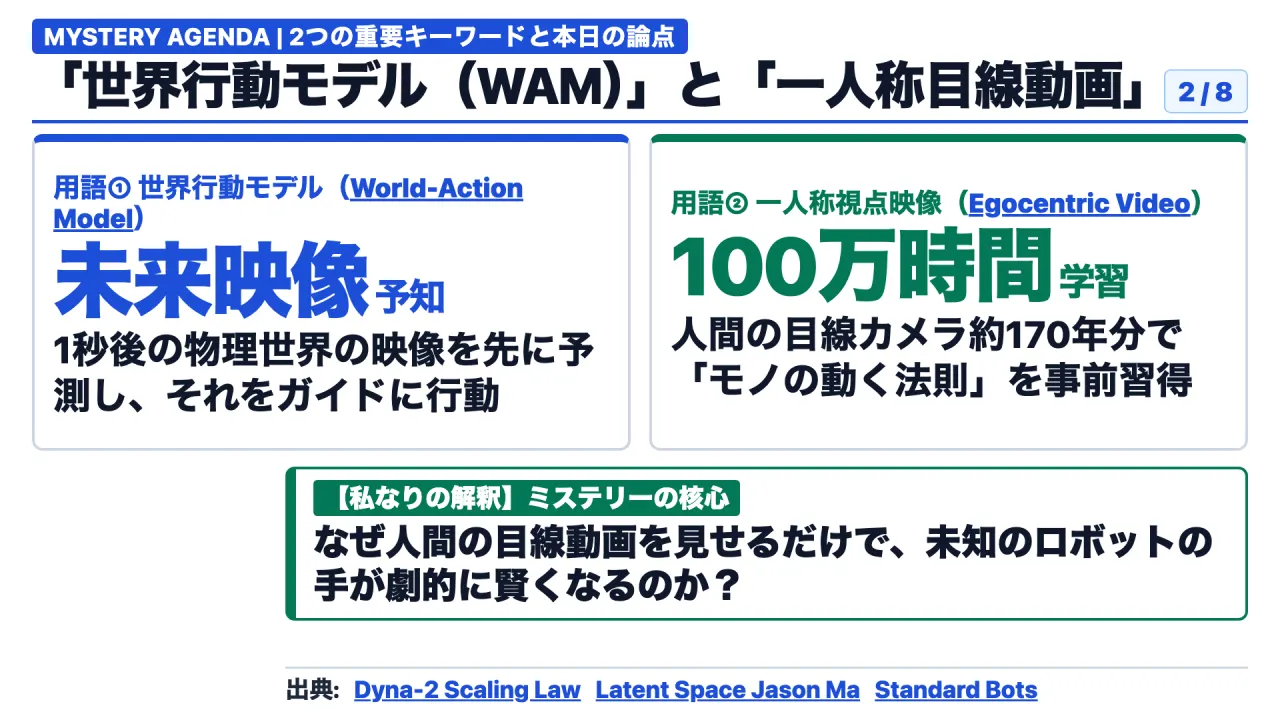
図2は放送時の説明資料(Slide 02)です。
本題に入る前に、今日キーワードになる2つの専門用語だけ、中学生でも映像が浮かぶように整理しておきます。1つ目は「ワールド・アクション・モデル(世界行動モデル、略してWAM)」です。
これまでのロボット用エーアイは、カメラの画像を見て「右手を5センチ動かせ」と反射的に命令するだけでした。これに対して世界行動モデルとは、プロ野球のバッターがボールを打つ瞬間に「こうバットを振ったら、1秒後に打球がどこへ飛ぶか」を頭の中で映像として予知してから体を動かすように、「自分が動いた1秒後の未来の映像」を先に予測し、その未来映像をガイドにして手足を動かすエーアイのことです。
そして2つ目は「エゴセントリック・ビデオ(一人称視点映像)」です。これは映画のように外から人間を撮った映像ではなく、料理人やホテルの清掃スタッフがおでこや胸に小型カメラをつけて、「働く人間の目線そのもの」で自分の手元を撮影した動画データのことです。
今日の進み方です。まず、ダイナ・ロボティクスが暴いた「人型ロボットバブルの不都合な真実」と、成功率95パーセントが1.7パーセントに溶ける「79ステップの複利崩壊」の数字を見ます。
次に、なぜ人間の目線動画を100万時間(約170年分)見せると、一度もロボットの練習をせずにロボットの手が賢くなるのか、『ダイナ2』が世界で初めて証明した「転移スケーリング則」のカラクリを解き明かします。それから、海外ポッドキャスト『レイテント・スペース』でダイナ・ロボティクスのチーフサイエンティストであるジェイソン・マー(Jason Ma)と、米国最大級の産業ロボット企業スタンダード・ボッツ(Standard Bots)の首脳陣が語った「車輪と腰の秘密」と「現場の通信切断問題」を聞き、最後に私たちの社内業務やソフトウェア開発にどう応用すべきか、私の見立てをお話しします。
第1章:海外一次データが示す現場の変化
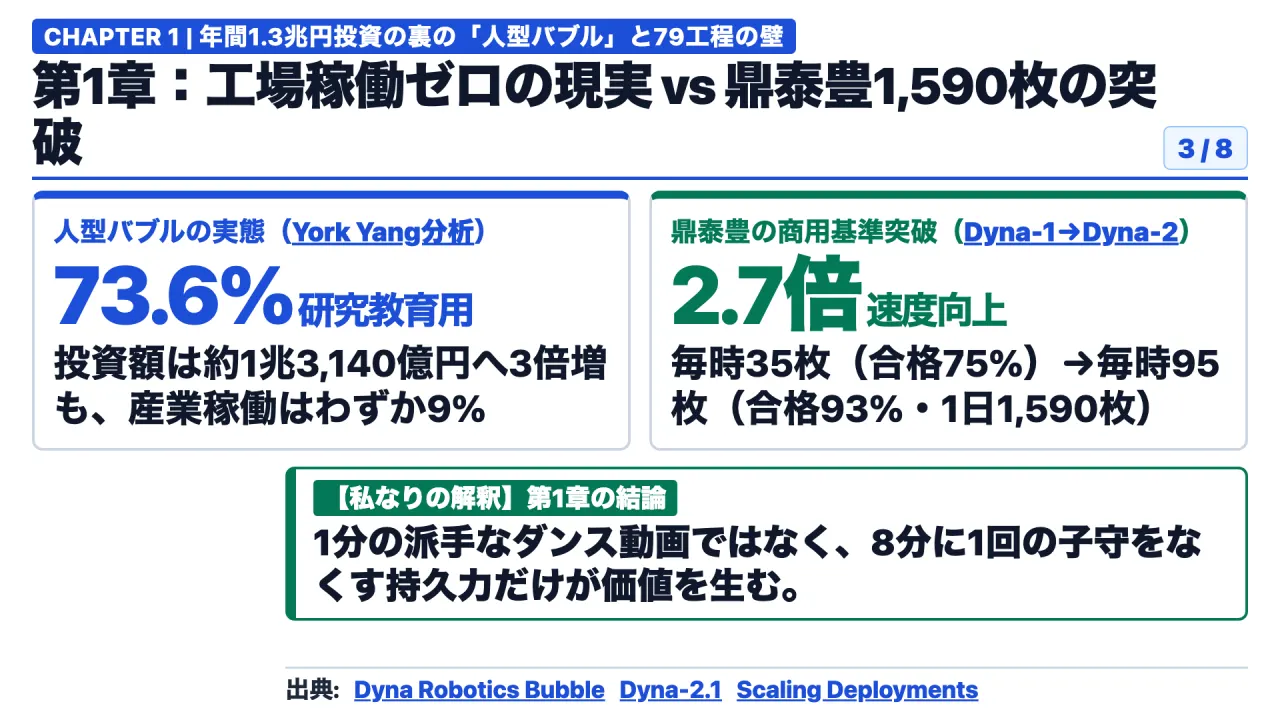
図3は放送時の説明資料(Slide 03)です。
まず第1章、いま世界中の投資家が熱狂している「人型ロボット(ヒューマノイド)ブーム」の裏で、実際の工場や店舗で何が起きているのか、3つの強烈な一次データから見ていきます。
1つ目のデータは、ダイナ・ロボティクスの共同創業者ヨーク・ヤン(York Yang)が公開した『本番稼働10ヶ月が教えてくれたロボティクス・バブルの正体』というレポートです。2022年から2025年にかけて、ロボット開発企業への年間投資額は約4,290億円(28.6億ドル)から約1兆3,140億円(87.6億ドル)へと3倍に急増し、中国だけでも330種類以上の人型ロボットが発表されました。
SNSを開けば、ロボットがバク転をしたりダンスを踊ったりする華やかなデモ動画が毎日流れてきますよね。
しかし、実際のビジネスの数字は驚くほど冷酷です。同レポートが引用した一次資料によると、2026年1月のテスラの決算説明会で、イーロン・マスクは「テスラの工場内で実際に役立つ仕事をしている人型ロボット(オプティマス)はまだゼロ台である」と認めました。
さらに、世界最大級の人型ロボット出荷台数を誇るユニツリー(Unitree)が3月に提出した株式上場(IPO)目論見書では、2025年1月から9月までの人型ロボット売上のうち、実に73.6パーセントは大学などの「研究・教育機関向け」であり、実際の産業現場への導入はわずか9パーセント、しかもその9パーセントの大半すら「企業の受付やイベントの案内係」だったことが判明したのです。
なぜ、デモ動画ではあんなに賢そうに見えるロボットが、現場の仕事では全く役に立たないのでしょうか。その理由を数学的に突きつけたのが、2つ目のデータ、『ダイナ2.1』のワークフロー信頼性レポートです。
たとえばホテルのランドリー(洗濯室)の仕事は、「タオルを1枚たたむ」だけでは終わりません。汚れたタオルを洗濯機に入れ、洗い上がったら乾燥機へ移し、乾いたタオルをカゴに入れて作業台へ運び、1枚ずつ綺麗にたたんで積み上げ、最後に棚へ収納するまで、1サイクルで約79個の小さな工程(サブタスク)が鎖のように繋がっています。
もし、ロボットが1つひとつの工程を「95.0パーセント」という高い成功率でこなせたとします。テストなら95点の優等生です。
しかし、0.95を79回掛け算(0.95の79乗)するとどうなるか。最後まで1回も詰まらずに1サイクルを終えられる確率は、たったの1.7パーセントにまで激減してしまうのです。
24時間稼働させると、なんと1日に190回、約8分に1回も人間が駆けつけて世話をしなければならない「ロボットの子守(ベビーシッター)地獄」が発生します。
そして3つ目のデータが、この地獄を乗り越えた鼎泰豊(ディンタイフォン)での本番展開レポートです。鼎泰豊はアメリカで1店舗あたりの売上が全米ナンバーワンを誇る超人気レストランチェーンですが、テーブルに出す布ナプキンの折り方に極めて厳しい品質基準があります。
お箸を差し込むポケットの数センチ下に縫い目がピタリと揃っていなければならず、しかも1店舗の営業を回すには18時間のシフトで最低1,500枚の合格品が必要です。ダイナ・ロボティクスが去年投入した初代モデル「ダイナ1」は、1時間に35枚しか折れず、品質合格率も75パーセントにとどまり、1日約480枚しか作れませんでした。
しかし最新の「ダイナ2」は、1時間あたり95枚(2.7倍の速度)を折り、品質合格率も93パーセントに到達し、1日1,590枚のテーブル提供可能なナプキンを自律生産して、ついに採算ライン(ROI)を突破したのです。
ここまでを一言でまとめるとこうです。現場が求めているのは、1分間の派手なダンス動画ではなく、79個の工程を何時間もミスなく繋ぎ、1日1,590枚の合格品を出し続けられる「99.9パーセントの持久力」である、ということです。
第2章:技術的・構造的な仕組みと落とし穴
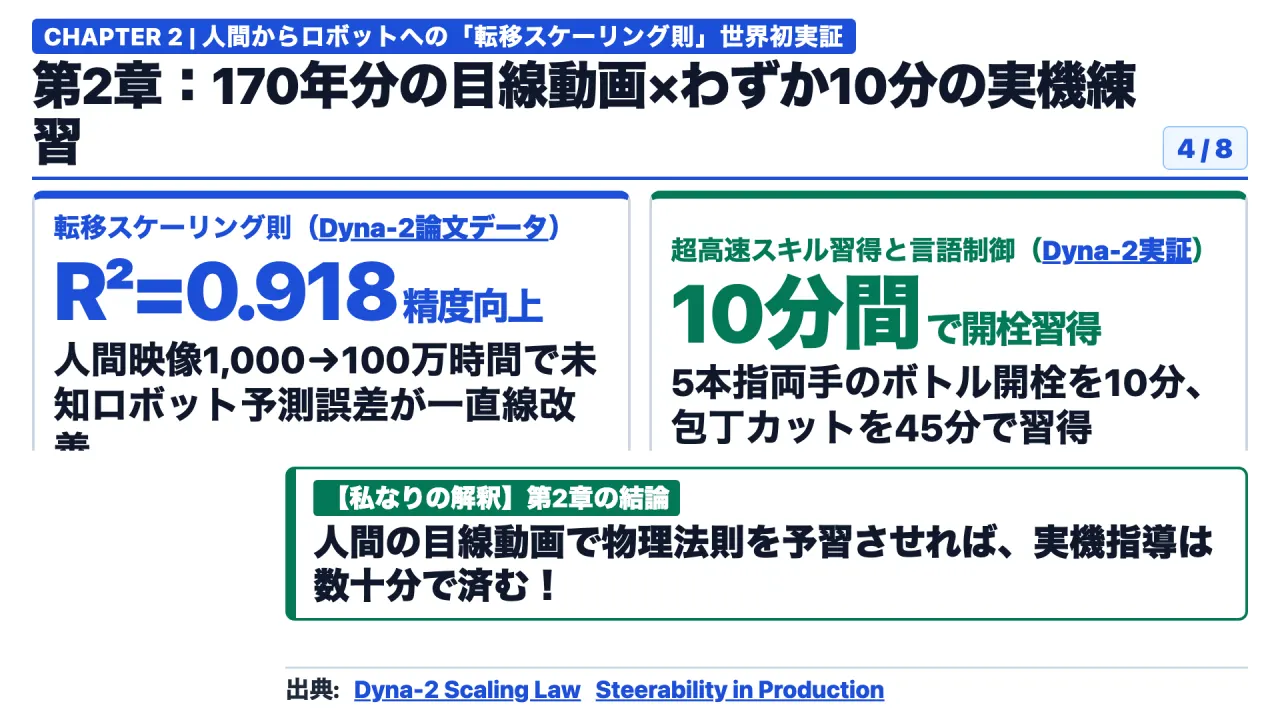
図4は放送時の説明資料(Slide 04)です。
次に第2章、ではダイナ・ロボティクスは一体どうやって、ロボットの速度を2.7倍に引き上げ、落としたタオルを自分で拾い直せるほどの賢さを手に入れたのか。その心臓部である世界行動モデル『ダイナ2(Dyna-2)』の技術論文のカラクリを解剖します。
これまでロボット開発の世界には、「インターネットがない」という絶望的な壁がありました。文章を書くエーアイなら、インターネット上の何兆文字というWebサイトを丸ごと読み込ませれば天才になります。
しかし、ロボットの腕をどう動かすかという「関節の角度データ」はインターネットのどこにも落ちていません。人間がロボットをラジコンのように遠隔操作して1時間ずつデータを集めるしかなかったため、データが圧倒的に足りなかったのです。
そこでダイナ・ロボティクスの研究チームは、発想を180度転換しました。「ロボットを動かしたデータがないなら、人間が自分の目線で手元を撮影した動画(エゴセントリック・ビデオ)を100万時間分、起きている時間にして約170年分そのままエーアイに見せて、物理世界のルールを丸ごと予習させればいいじゃないか」と考えたのです。
ここで彼らが採用したのが、冒頭で整理した「ワールド・アクション・モデル(世界行動モデル)」という設計図です。今、多くの企業が研究している「VLA(ビジョン・言語・行動モデル)」は、カメラの画像と言葉の指示を見て、いきなり「モーターを何度回せ」という行動だけを出力します。
しかし布ナプキンやタオルのような「柔らかいモノ(変形物体)」は、少しつまむ場所がズレただけで無限に形が変わるため、ただの反射神経だけではすぐに失敗します。
これに対して『ダイナ2』は、トランスフォーマー(大量のデータから法則を学ぶ頭脳)と、ディフュージョン・フローマッチング(砂嵐のようなノイズからたった4ステップの計算で滑らかな映像や動きを作り出す技術)を組み合わせ、「数秒後の未来のカメラ映像」と「ロボットの関節の動き」を同時に予測させます。
すると、物理学の世界でも驚くべき現象が起きました。『ダイナ2』の論文データによると、事前学習の段階ではロボットのデータを1秒も見せず、人間の目線動画だけを1,000時間、1万時間、10万時間、100万時間へと1,000倍に増やしていったところ、なんと「まだ一度も学習していない未知のロボットの行動予測誤差」が、決定係数0.884、精度の決定係数0.918という綺麗な一直線のグラフ(べき乗則)を描いて劇的に改善したのです。
これが世界で初めて証明された「人間からロボットへの転移スケーリング則」です。170年分の人間の手元動画を通じて、「布の端をこう引っ張ればこう広がる」「ペットボトルのフタはこうひねれば開く」という物理の常識を完全に理解しているため、最後にたった10分間のロボット遠隔操作データを追加学習させただけで、5本指のロボットハンド2本を使ってペットボトルのキャップを開ける芸当をマスターし、包丁で食材を切る作業もわずか45分の指導で習得してしまいました。
さらに驚くべきは、現場での「言葉による微調整(ステアラビリティ)」です。鼎泰豊の現場レポートによると、ナプキンを綺麗に折るだけでは仕事は終わりません。
折ったナプキンを、店員さんがそのまま運べるように「箱の中の10箇所の指定位置」へ順番にピシッと並べて積む必要があります。初期のモデルは箱の中に適当に放り込んでいたため、結局人間が手で並べ直していました。
そこで『ダイナ2』に言葉と未来映像を結びつける力を組み込んだ結果、プログラムを書き換えなくても「3番目の列に積んで」「この店舗は5列の箱を使って」と言葉で指示するだけで、見た目そっくりな10箇所の位置を正確に区別して綺麗に積み上げられるようになったのです。
この章を一言でまとめます。170年分の人間の目線動画で「1秒後の物理世界の未来映像」を予知させたことで、ロボットはわずか10分から45分の練習で新しい現場スキルを覚える「汎用的な身体知能」を手に入れた、ということです。
第3章:海外ポッドキャストの肉声と実務の壁
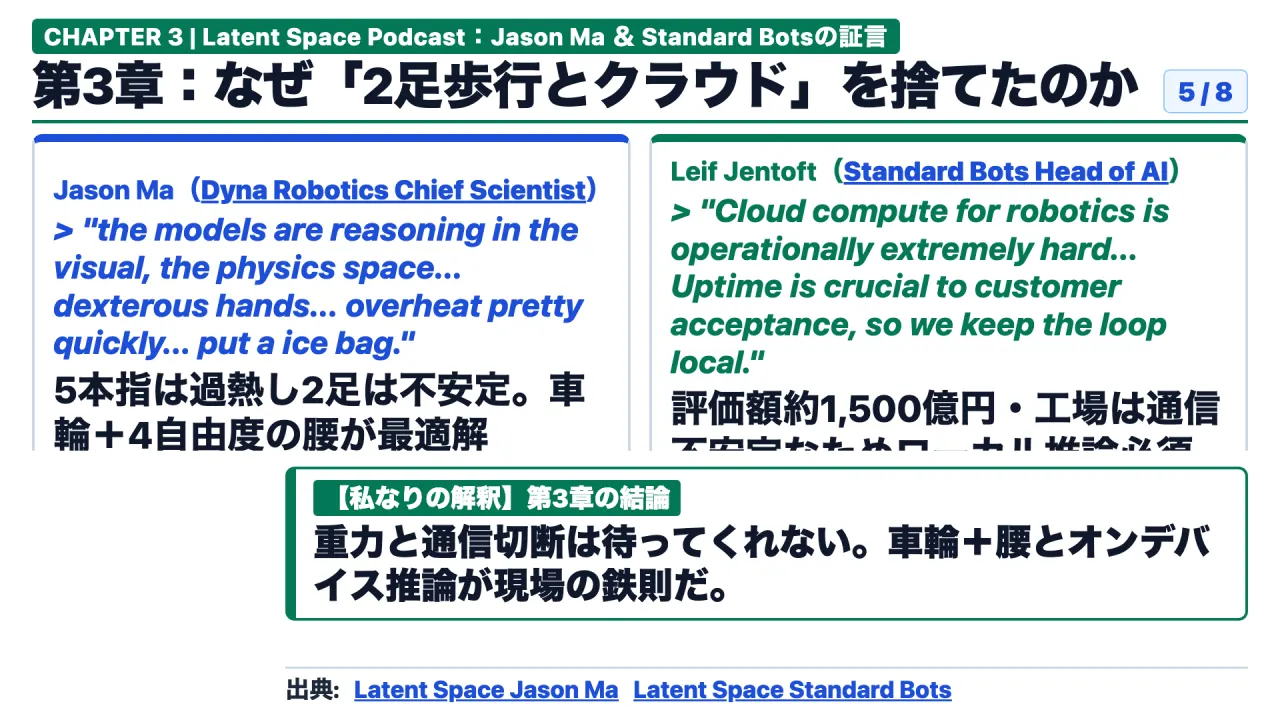
図5は放送時の説明資料(Slide 05)です。
続いて第3章です。この「未来を予知する頭脳」を実際のレストランやホテル、工場で24時間動かすとき、現場ではどんな生々しい摩擦が起きているのか。
海外のエンジニア向け有名ポッドキャスト『レイテント・スペース(Latent Space)』に登板した2組のトップランナーの肉声を聞いていきます。
1人目は、ペンシルベニア大学からNVIDIA、Google・ディープマインドを経てダイナ・ロボティクスを共同創業したチーフサイエンティスト、ジェイソン・マー(Jason Ma)です(Latent Space: Jason Ma, Dyna Robotics)。彼はまず、世界行動モデルが頭の中で何をやっているのか、番組の冒頭(01:39)でこう語っています。
世界行動モデルの本当に面白いところは、ロボットの行動だけでなく「未来の映像」も出力できる点だ。まず未来の映像やその表現を先に出力し、それをガイドにしてロボットの行動を導くことができる。
私が考えるに、これは言語モデルにおける「思考の連鎖(チェーン・オブ・ソート)」に相当するものだ。つまりモデルは、視覚と物理の空間の中で推論を行ってから、実際の行動を出力しているのである。
言語モデルが言葉で「まずAを計算して、次にBを…」とメモを書きながら考えるのと同じように、ロボットは「映像で1秒後の未来を思い描くこと」で物理的な思考の連鎖をやっているという、極めて鮮やかな解説です。
しかし、ここからが現場のリアルです。世間では「ロボットといえば2足歩行の人型(ヒューマノイド)だ」と思われがちですが、ダイナ・ロボティクスが発表した最新ロボット「タク(Taku:日本語の『匠』が由来)」は、上半身は人間と同じサイズで4つの方向に曲げられる柔軟な「腰」を持っているのに、下半身は2本の足ではなく「4輪の車輪」になっています。
さらに、なぜ多くのロボット企業が「5本指の器用な手」で苦戦しているのかも含め、ジェイソン・マーは番組内(25:16および33:20)でこう本音を明かしています。
下半身が車輪だから、私たちはこれをセミ・ヒューマノイドと呼んでいる。なぜ車輪を選ぶのか。
そこには実用性と性能の決定的なトレードオフがあるからだ。2足歩行の脚にするとエネルギー消費が跳ね上がり、はるかに不安定になり、安全性の保証が極めて難しくなる。
さらに今日、最も優れた5本指の器用なロボットハンドでさえ耐久性が足りず、すぐにオーバーヒートしてしまう。文字通り、氷嚢(ひょうのう)を当てて冷やさなければならないほどなのだ。
「最先端の5本指ロボットハンドはすぐ熱くなるから、実験室で氷の袋を当てて冷やしている」というのは、現場を知らないと絶対に出てこない衝撃の事実ですよね。だからこそ彼らは、転倒リスクと電力浪費が激しい「2本の足」を捨てて安定した「車輪」を選び、代わりに洗濯機の奥までグッと身を乗り出すために不可欠な「人間の腰の自由度」と、壊れにくい「2本爪のグリッパー」を徹底的に磨いたのです。
そしてもう1組の証言が、NASA(アメリカ航空宇宙局)やアマゾン、ロッキード・マーティンなどの工場に産業用ロボットを導入し、評価額約1,500億円(10億ドル)で300億円(2億ドル)を調達した米国最大級のエーアイ産業ロボット企業、スタンダード・ボッツ(Standard Bots)のAI責任者レイフ・ジェントフト(Leif Jentoft)です(Latent Space: Standard Bots)。彼は、ロボットの頭脳を決してインターネットの向こう側(クラウド)に置いてはいけない理由をこう断言しています。
ロボティクスにおいてクラウド計算に頼るのは、運用上極めて困難だ。ほとんどの工場や倉庫には信頼できるインターネット回線がなく、移動するロボットにとってはなおさらだ。
稼働率(アップタイム)こそが顧客に受け入れられるかの生命線であり、だから私たちはすべての制御ループを現場のローカル環境で完結させている。
ジェイソン・マーも対談(17:38)で「チャットエーアイなら3秒待たされても平気だが、包丁を持ったロボットが通信待ちで3秒フリーズしたら周囲の人間は恐怖でパニックになる。重力は待ってくれない」と語っています。
この章を一言でまとめます。物理の世界では、氷で冷やすような実験室の2足歩行やクラウド通信は通用しない。
重力と通信切断に勝つための「車輪+腰のハードウェア」と「現場の機器内(オンデバイス)で即座に未来を予測する頭脳」のセットだけが、商業ラインを動かせる、ということです。
第4章:私なりの解釈(構造変化の核心)
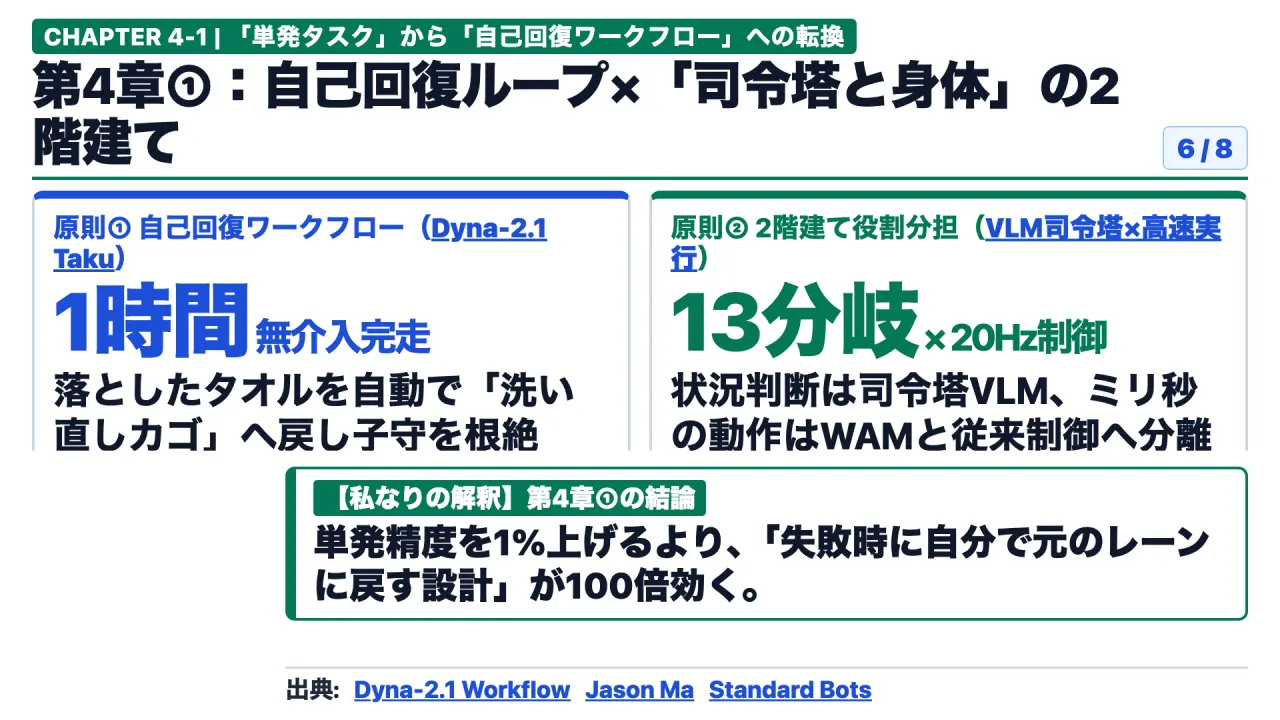
図6は放送時の説明資料(Slide 06)です。
ここからは、ダイナ・ロボティクスの100万時間スケーリング則と鼎泰豊・ホテル洗濯室の導入データ、そしてスタンダード・ボッツの工場実装の知見を同じ物差しで並べて、ロボットだけでなく私たちの日々のシステム開発や業務自動化にも直結する【私なりの解釈】を3つに整理します。
まず1つ目の解釈は、「お客様がお金を払うのは『単発の作業(タスク)』ではなく『人間が立ち去れる一連の業務(ワークフロー)』である。『95点の罠』を前提に自己回復ループを組め」ということです。
これはロボットに限らず、社内の事務処理エーアイでも全く同じです。「請求書を1枚読み取るデモ」が95パーセント成功しても、前後のメール確認から会計システムへの入力、エラー時の差し戻しまで50ステップが繋がった瞬間、成功率は数パーセントに暴落し、結局人間が横につきっきりで監視する「エーアイの子守」が発生します。
『ダイナ2.1』がホテルの洗濯室で1時間無介入を達成できた理由は、ミスをゼロにしたからではなく、「タオルを床に落としたら、それを認識して綺麗な棚ではなく『洗い直し用のカゴ』へ入れ直す」という自己回復(リカバリー)の仕組みを最初から組み込んだからです。単発の成功率を95パーセントから96パーセントに上げる努力より、「失敗した瞬間に自分で元のレーンに戻せる設計」を作る方が、現場の価値は100倍高くなります。
次に2つ目の解釈は、「すべての判断を1つの巨大エーアイにやらせるな。『遅く深く考える司令塔(VLM)』と『ミリ秒で動く現場の身体(WAM・従来プログラム)』を2階建てに分離せよ」ということです。
『ダイナ2.1』の設計図を見ると、手足を毎秒10回から20回という猛スピードで滑らかに動かす「世界行動モデル」の上に、洗濯機や乾燥機の残り時間を見て「今はタオルたたみを中断して、乾燥機から洗濯物を出そう」と13箇所の分岐点を判断する「視覚言語モデルの司令塔(オーケストレーター)」が乗っています。またスタンダード・ボッツも、「部品の位置を見分ける目」には10億枚の画像で学習したエーアイを使い、「アームを正確に運ぶ軌道」には従来の確実なプログラムを使い分けています。
私たちの社内システムでも、状況判断は賢いモデルに任せ、実際のデータ書き込みや計算は決定論的なプログラムに任せる「2階建ての役割分担」こそが、事故ゼロと高速応答を両立する鉄則です。
第4章(後半):実務で機能する3層ハイブリッド設計
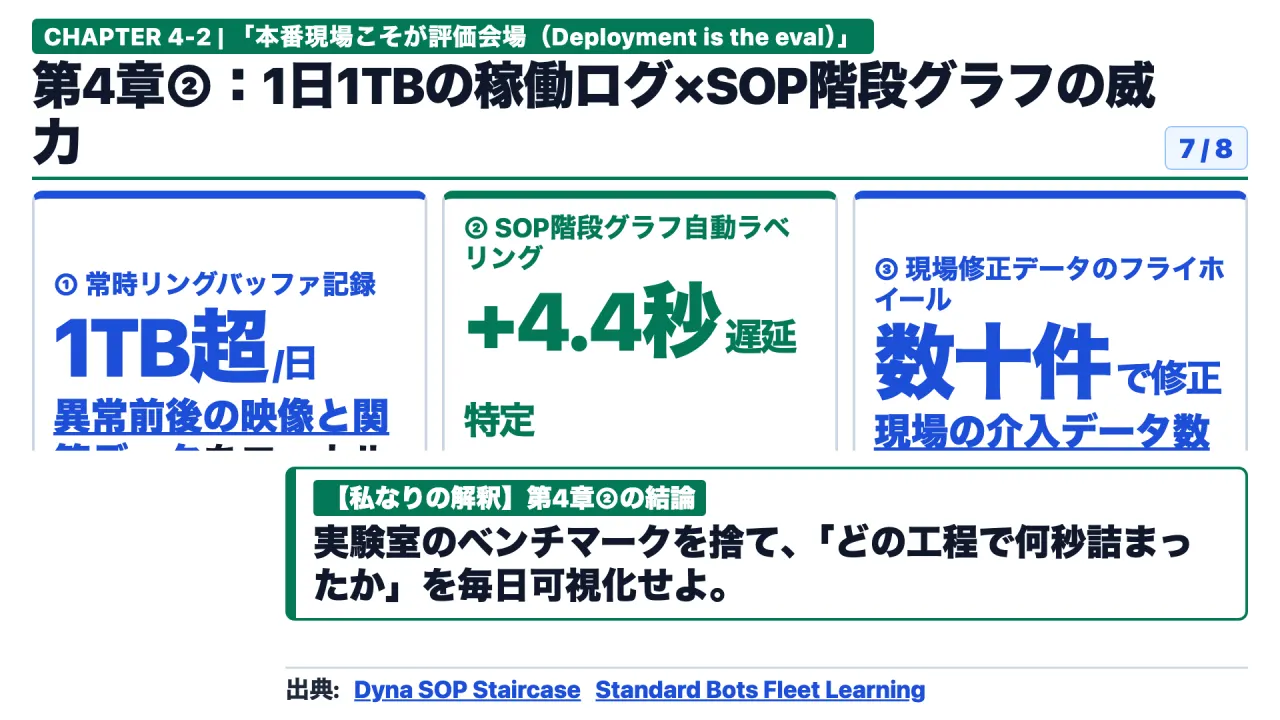
図7は放送時の説明資料(Slide 07)です。
そして3つ目の解釈は、「テスト環境のベンチマークは今日で捨てよ。『本番現場の1日1テラバイトの稼働ログ』を自動で階段グラフ化する観測基盤こそが最大の武器になる」ということです。
私が鼎泰豊の導入レポートを読んで一番痺れたのは、実はモデルの賢さ以上に、彼らが作った「本番環境そのものをテスト会場にする仕組み(Deployment is the eval)」です。ある日、鼎泰豊の1つの店舗で、ナプキンを折る枚数が急に落ちたことがありました。
システムのエラーログは「正常」と出ており、現場の店員さんも気づいていませんでした。しかしダイナ・ロボティクスは、全ロボットから毎日1テラバイト以上送られてくる稼働データを自動で「標準作業手順(SOP)の11段の階段グラフ」に色分けする仕組みを持っていました。
それを見た瞬間、「ステップ1(山積みのナプキンから最初の1枚をつまみ上げる工程)だけで空振りが増え、平均4.4秒も余計に時間がかかっている」ことが一目で特定できたのです。
これを受けて、私たちが明日から自社のエーアイ導入や業務自動化で実行すべき設計は3つです。1つ目は、人間が横で見ていないと止まる「単発タスクの自動化」をやめ、エラーが起きたら自動でやり直しカゴへ戻す「エンド・ツー・エンドのワークフロー設計」に作り変えること。
2つ目は、判断を司る「司令塔モデル」と、現場で即座に動く「軽量な実行モデル」を分離し、通信が切れても止まらないローカル実行環境を整えること。そして3つ目は、導入後の業務をステップごとの所要時間と失敗理由に自動分解し、「どの工程で何秒詰まっているか」を毎日可視化する観測パイプラインを組み込むことです。
結論:明日から現場で試せる3つのアクション
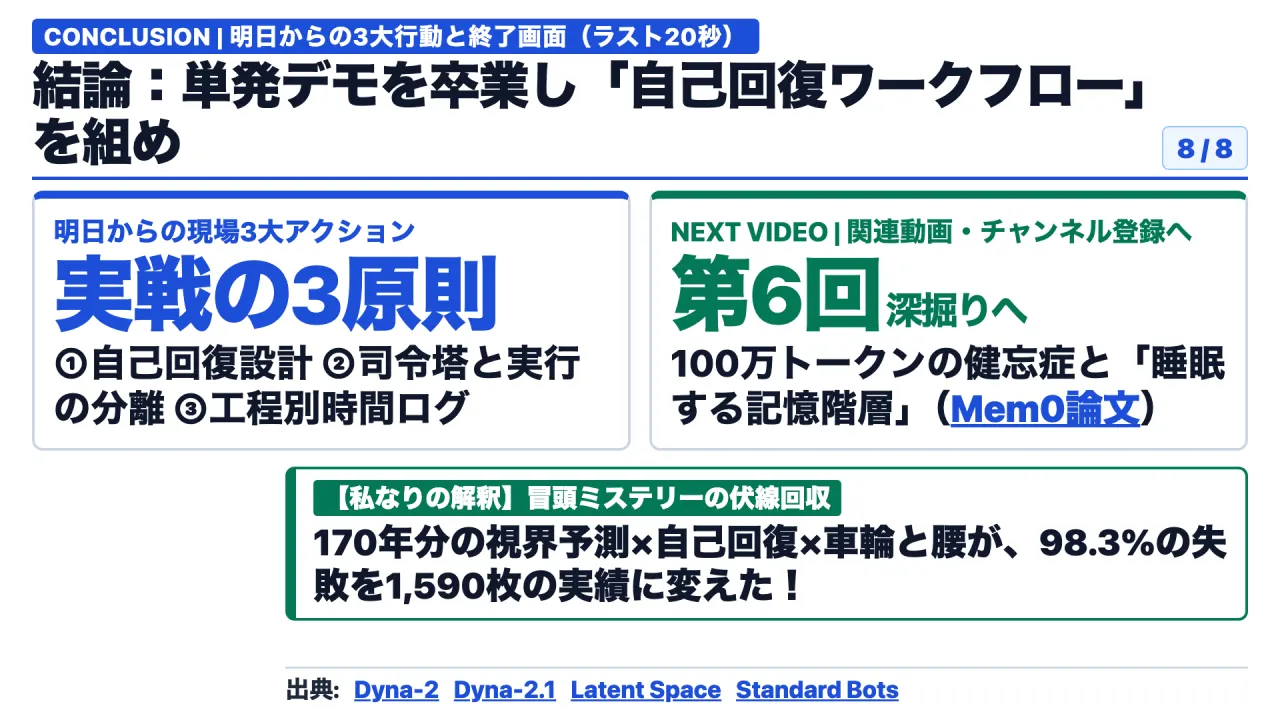
図8は放送時の説明資料(Slide 08)です。
では結論、なぜ成功率95パーセントの優秀なロボットエーアイが現場では98.3パーセント失敗し、ダイナ・ロボティクスやスタンダード・ボッツはどうやって商業ラインの壁を突破したのか。
今日の話を1枚に畳むとこうです。現場の仕事は1回きりのテストではなく、79個の工程が鎖のように繋がった長距離マラソンだからです。
95点の反射神経しか持たないロボットをそのまま現場に置けば、掛け算の罠で98.3パーセント失敗します。しかし、170年分の人間の目線動画から「1秒後の物理世界の未来映像」を予知する世界行動モデルと、失敗しても自分で拾い直す司令塔、そして派手な2足歩行を捨てて「車輪と人間の腰」を選んだ徹底的な現場主義が合わさったとき、ロボットは初めて「子守が必要な実験機」から「毎日1,590枚のナプキンを折り続ける頼もしい同僚」へと進化したのです。
その上で、私の見立てです。これから2年で、SNS映えするだけのダンスロボット企業は淘汰され、「地味な業務を1時間以上ノーカットで自律完走し、現場の失敗データから毎週賢くなる配備システム(チャネル)を持った企業」だけが、数兆円の市場を総取りすることになります。
最後に、現場でシステム開発とコンサルティングを本業にしている人間として1つだけ。実は私たちが普段作っているこのポッドキャストの自動生成パイプラインも、まさにこの「79ステップの洗濯室」と同じ構造をしています。
台本を書き、一次資料と照合し、音声を合成し、文字起こしで検査し、動画を結合して配信するまで、何十個もの工程が繋がっています。だからこそ、どこかの工程で読み間違いやズレが起きても人間が手で直すのではなく、自動で検知してその区間だけを再合成する「自己回復ループ」と「全工程の自動検査ログ」を徹底的に作り込んでいます。
画面の中のエージェントも物理のロボットも、最後に勝つのは「失敗から自動で立ち直る現場の仕組み」です。
みなさんはどう見ますか。自分の職場や毎日の仕事の中で、「ここは見栄えではなく、車輪つきの実用ロボットや自動回復ワークフローに丸ごと任せたい」と思う作業はないか、よかったらコメントで聞かせてもらえれば嬉しいです。
また、いま画面に表示されている第6回の関連動画では、「なぜ100万トークンの記憶力を持つエーアイが実務で健忘症になるのか、トークン代を90パーセント削り応答速度を10倍にする『睡眠する記憶階層』の真実」を徹底深掘りしていますので、ぜひ続けてご覧ください。それでは、また次回の放送でお会いしましょう。
参照した海外一次資料・出典リンク一覧
- Dyna Robotics (York Yang): What 10 Months in Production Taught Us About the Robotics “Bubble” (2026年5月公開)
- Dyna Robotics: Dyna-2.1: A Physical Agent for End-to-End Workflows (2026年9月29日公開)
- Dyna Robotics: Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models (2026年8月公開)
- Dyna Robotics: Not Just a Model, But a Product — Scaling Customer Deployments (2026年8月公開)
- Latent Space Podcast: Dyna-2: General Purpose Physical Agents with Hour-Long Autonomy — Jason Ma, Dyna Robotics (2026年10月13日配信)
- Latent Space: Building AI for Reliable Execution: Lessons From Industrial Robotics — Standard Bots (2026年10月10日公開)
この記事は、ポッドキャスト放送回(2026-10-23-deep-dive)の台本と一次資料をもとに再構成しました(確認日:2026年10月20日)。