なぜ80億の軽量司令塔AIがGPT-5単体に勝てるのか?NVIDIA・Meta・医科大・AOrchestra・Anthropicの5大一次資料で解き明かす「薄いルーター」設計術
AIエージェントを社内業務や個人の開発環境に組み込むとき、多くのチームが最初にぶつかる設計上の問いがあります。それは**「複数のAIやツールを束ねる司令塔(オーケストレーター)には、一番賢くて高価なフロンティアモデルを置かなければならないのか?」**という疑問です。
直感的には、全体の計画を立てて部下に仕事を振るリーダーこそ、最も頭の良い最上位モデル(GPT-5やClaude Opus 4.1など)であるべきだと考えがちです。しかし、2025年から2026年にかけて公開された海外の主要研究機関・ビッグテックの一次資料を突き合わせると、その直感とは正反対の事実が浮かび上がります。
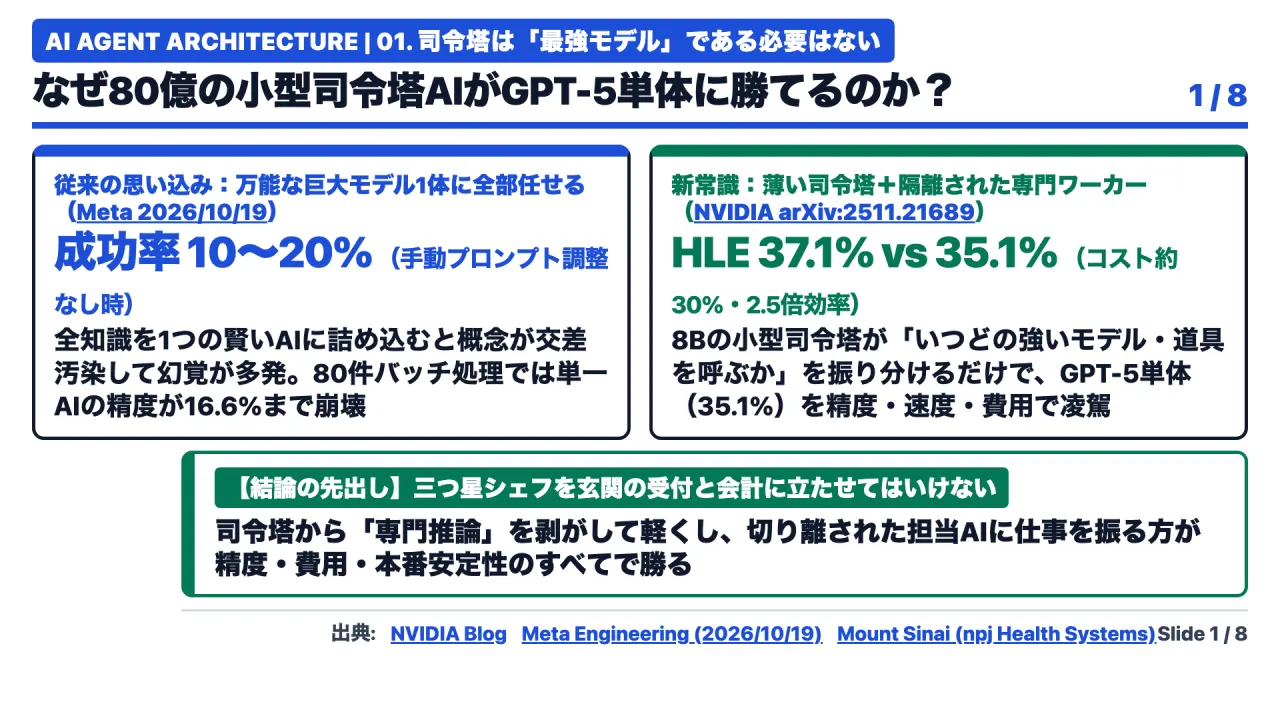
結論から言えば、**「1つの最強モデルにすべての知識と権限を詰め込むより、司令塔をあえて小型モデルや決定論的な『薄いルーター』にし、隔離された専門ワーカーに厳選した文脈だけを渡す方が、精度・コスト・速度・本番信頼性のすべてで勝るケースが数多く実証されている」**のです。
本記事では、動画・ポッドキャスト本編の解説をさらに大幅に増補し、以下の5つの一次資料・査読論文の生データと実験条件、失敗モードのメカニズム、そして手元の開発環境(軽量Flash系モデルの組み合わせ等)にそのまま適用できる実装設計図までを徹底的に解説します。
- NVIDIA Research『ToolOrchestra / Orchestrator-8B』(技術ブログ / arXiv:2511.21689v1 / 関連ポジションペーパー arXiv:2506.02153)
- Meta Engineering『The Thin Orchestrator』(2026年10月19日公開公式ブログ)
- Mount Sinai医科大学(マウントサイナイ医科大学)臨床スケール負荷検証論文(Nature系誌 npj Health Systems, 2026年3月9日公開, s44401-026-00077-0)
- 香港科技大学(広州)ほか『AOrchestra: Automating Sub-Agent Creation for Agentic Orchestration』(arXiv:2602.03786v2)
- Anthropic Engineering『How we built our multi-agent research system』(2025年6月13日公開公式ブログ / Simon Willison氏による解説)
(※円換算は2026年10月23日時点の基準レートとして1米ドル=150円で統一して併記しています。)
1. 導入:三つ星シェフを「玄関の受付とレジ」に立たせてはいけない
[ここに Slide 1 画像を挿入]
なぜ「一番賢いAIモデル1体に全部任せる設計」が本番環境で破綻しやすいのか。日常の大人の仕事にたとえるなら、世界最高の三つ星シェフを1人雇って、高級レストランの玄関に立たせるようなものです。
お客さんのコートを預かり、電話の予約台帳を書き換え、レジで会計を済ませ、さらに厨房へ走って前菜から魚料理、肉料理、デザートまで全部1人で作らせる。お客さんが1組しかいないデモ営業のときは、「さすが天才シェフ、何でも1人でこなせる!」と感動するでしょう。ところが金曜日の夜に80人のお客さんが同時に押し寄せ、アレルギー対応や会計変更の注文が飛び交った瞬間、どれだけ優秀なシェフでも頭の中がパニックになります。魚料理のソースをステーキにかけ、お会計の伝票にレシピの分量を書き殴り、厨房全体がストップしてしまうのです。
AIエージェントの世界でも、これとまったく同じ現象が起きています。
これまで主流だった「モノリシック(一枚岩)なAI設計」では、1つの巨大な汎用言語モデル(LLM)のプロンプトに、社内のあらゆる業務ルール、データベースの設計図(スキーマ)、コード生成の規約、エラー処理の手順をすべて詰め込み、そのモデル自身に「状況判断・ツール呼び出し・専門作業・最終確認」までを一貫して行わせていました。
しかし、後述するMetaの本番データやマウントサイナイ医科大学の実験が示す通り、1つのモデルに渡す文脈(コンテキスト)がある閾値を超えると、追加の知識は性能を高めるどころか、概念同士が混ざり合う「交差汚染(クロスコンタミネーション)」を引き起こして精度を急激に劣化させます。
[ここに Slide 2 画像を挿入]
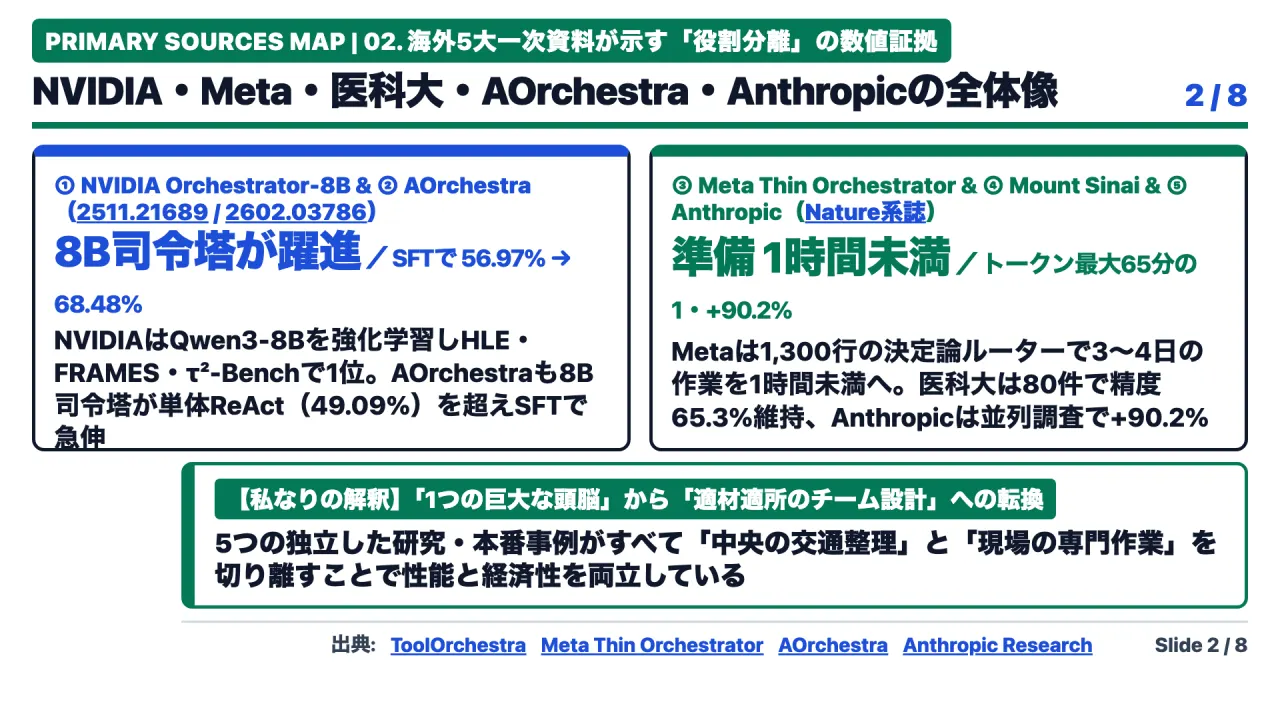
まずは、今回検証した5つの一次資料が明らかにした「役割分離と軽量オーケストレーション」の全体像を、以下の比較表で確認してください。
5大一次資料の核心データ一覧表
| 事例・研究機関 | 司令塔(オーケストレーター)の正体 | ワーカー・ツールの構成 | 主要な定量結果(単体モデルとの比較) | 設計上の核心メッセージ |
|---|---|---|---|---|
| ① NVIDIA ToolOrchestra / (arXiv:2511.21689v1) | Orchestrator-8B / (Qwen3-8Bを強化学習GRPOで訓練) | 検索・Python実行+専門LLM(Math-72B/Coder-32B等)+汎用LLM(GPT-5等) | ・HLE:37.1%(vs GPT-5 35.1% / Opus 4.1 34.6%) / ・FRAMES:76.3%(vs GPT-5 74.0%) / ・τ²-Bench:80.2%(vs GPT-5 77.7%) / ・コスト 9.2 vs 30.2(約30%・2.5倍効率)、遅延 8.2 vs 19.8 | 小型モデルが自分で難問を解くのではなく、「いつどの強いモデル・ツールを呼ぶか」を学習すればフロンティア単体を超える。 |
| ② Meta Thin Orchestrator / (Meta Engineering) | 約1,300行の決定論的ルーター / (ドメイン推論ゼロ・7段階中6段階が決定論処理) | 完全隔離された14個の専門サブエージェント+25以上の知識ファイル | ・設定準備時間:手動3〜4日(旧システム約1日)→ 1時間未満 / ・システム変更の**約3分の2(2/3)が大幅な人手修正なしで通過 / ・単一AIは手動プロンプトなしで成功率10〜20%**に崩壊 | 「どの担当に振るか」は推論ではなく決定論的な交通整理。中央を薄くすることで、上流の幻覚が下流全体を汚染する事故を防げる。 |
| ③ マウントサイナイ医科大学 / (npj Health Systems) | 軽量オーケストレーター / (タスクごとに1ワーカー・1ツールへ振り分け) | 検索(PubMed 23.4万件)・抽出(退院要約33.1万件)・投与量計算の専任ワーカー | ・80タスクバッチ精度:マルチ 65.3% vs 単一 16.6%(5件時は90.6% vs 73.1%) / ・GPT-4.1-mini精度:マルチ 96%〜91.4% vs 単一 96%→33.9% / ・80件時トークン:6万 vs 390万(最大65分の1に削減) | 多数の異種タスクが同時に来る現場では、1タスク1ワーカーに分割して文脈干渉(注意力の希釈)を遮断するだけで精度崩壊とコスト爆発を防げる。 |
| ④ AOrchestra / (arXiv:2602.03786v2) | 4タプル動的生成司令塔 / (Gemini-3-Flash または Qwen3-8B) | 実行時に〈指示・厳選文脈・道具・モデル〉を合成してサブエージェントを生成 | ・GAIA Pass@1:80.00%(vs 単体ReAct 49.09% / OpenHands 66.06%) / ・文脈比較(50問):厳選96.0% vs 文脈なし86.0% vs 全文脈84.0% / ・Qwen3-8B司令塔:未調整 56.97%($0.36)→ 2,000件SFT後 68.48%($0.68) | ワーカーに全履歴を丸投げ(Full-Context)すると文脈劣化でかえって精度が落ちる。必要な文脈だけを抽出して渡せば8B司令塔でも単体を超える。 |
| ⑤ Anthropic Research / (Anthropic Engineering) | Claude Opus 4 / (調査計画・分解・メモリ保存・統合に専念) | Claude Sonnet 4 / (3〜5体を並列起動し独立文脈で探索・圧縮) | ・内部リサーチ評価で単一Opus 4を +90.2% 上回る / ・2段階の並列化で複雑調査時間を 最大90%短縮 / ・ただしトークン消費は通常チャットの 約15倍(単一AIは約4倍) | 手順が事前に決まらない「幅優先のオープン調査」では強い計画リード+並列ワーカーが圧倒的。ただしトークン15倍の経済採算性が境界線となる。 |
2. NVIDIA ToolOrchestraの解剖:なぜ80億の小型司令塔がGPT-5やClaude Opus 4.1を打ち破ったのか?
[ここに Slide 3 画像を挿入]
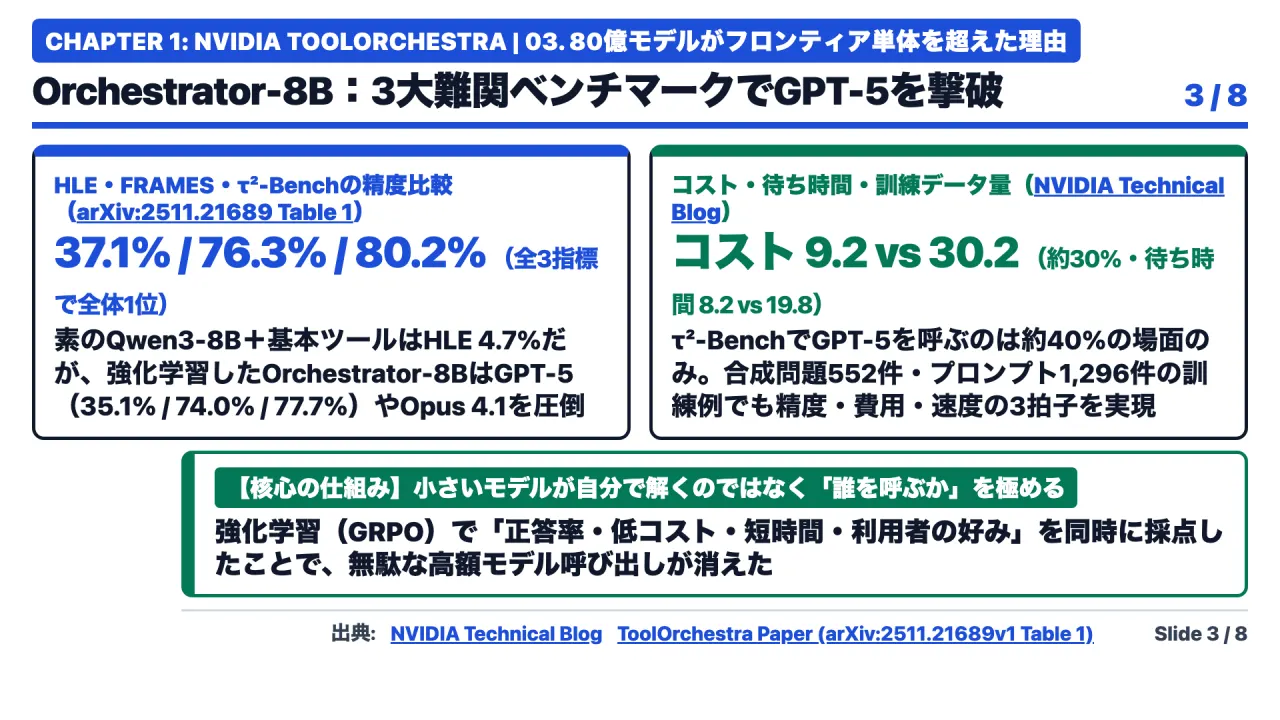
「オーケストレーターは最強モデルである必要はない」という主張を、最も直接的かつ劇的な数値で証明したのが、NVIDIA ResearchのShizhe Diao氏、Peter Belcak氏、Pavlo Molchanov氏らが発表した**『ToolOrchestra: Elevating Intelligence via Efficient Model and Tool Orchestration』**(arXiv:2511.21689v1 および NVIDIA Technical Blog)です。
2-1. 単体では「4.7%」しか取れない8Bモデルが、司令塔になると「37.1%」で世界1位になる
この研究の主役である**「Orchestrator-8B」は、オープンウェイトの小型言語モデルであるQwen3-8B(80億パラメータ)**をベースにしています。
まず誤解してはいけないのは、「Qwen3-8Bという小型モデル自体が、単体でGPT-5より賢いわけではない」という点です。実際、博士課程レベルの極めて難解な学術・推論問題を集めたベンチマーク**「Humanity’s Last Exam(HLE:人類最後の試験、テキストサブセット)」において、素のQwen3-8Bに問題だけを解かせると正答率はわずか3.2%、基本的なツール(Tavilyウェブ検索・Faissローカル検索・Pythonコード実行環境)を持たせても4.7%しか正解できません。同じ基本ツール環境でのGPT-5は35.1%、Claude Opus 4.1は19.8%**ですから、基礎体力には圧倒的な差があります。
ところがNVIDIAの研究チームは、この8Bモデルに「自分で難問を解かせる」のをやめさせました。代わりに、基本ツールに加えて、以下のような「より賢い専門モデルや汎用フロンティアモデル」をすべて**「呼び出し可能な道具(インテリジェント・ツール)」として統一されたJSONインターフェースで登録し、「どのステップで、どのモデルやツールに、どんな部分問題を投げるか」**だけを判断する司令塔(Orchestrator)として強化学習で訓練したのです。
- 基本ツール:Tavilyウェブ検索API、Qwen3-Embedding-8Bを用いたFaissローカル検索、Pythonサンドボックス(コードインタープリタ)、およびドメイン固有関数(フライト状況取得など)
- 専門特化LLM(Specialized LLMs):コード生成用のGPT-5 / GPT-5-mini / Qwen2.5-Coder-32B-Instruct、数学特化用のQwen2.5-Math-72B / Qwen2.5-Math-7B
- 汎用LLM(Generalist LLMs):GPT-5、GPT-5-mini、Llama-3.3-70B-Instruct、Qwen3-32B
2-2. 強化学習(GRPO)の3つの報酬設計と、わずか552問・1,296プロンプトの学習効率
なぜ単なるプロンプト調整ではなく「強化学習」が必要だったのでしょうか。ToolOrchestraでは、Group Relative Policy Optimization(GRPO)という強化学習アルゴリズムを用い、エージェントが最大50ターンの対話(推論→ツール呼び出し→結果観察のループ)を行って解を導く軌道(トラジェクトリ)に対して、以下の3つの目的を同時に満たす報酬関数を与えました。
- 結果の正確性(Outcome Reward):最終的な回答が正解と一致しているか(0または1)。
- 計算コストと待ち時間のペナルティ(Efficiency Reward):呼び出した全モデル・ツールのAPI料金換算コスト(ドル)と、実測の待ち時間(ウォールクロック秒数)が小さいほど高評価を与える。
- 利用者の好みへの適合(User Preference Alignment):「多少時間がかかっても社内サーバーのローカル検索とオープンモデルだけで解きたい(外部APIに機密を出したくない)」「とにかく最速・最安で解きたい」「コスト度外視で最高精度を狙いたい」といった利用者の優先度ベクトルにどれだけ忠実に従ったかを評価する。
さらにNVIDIAの技術ブログで強調されている通り、こうした難関ベンチマーク向けのオーケストレーターを構築するうえで、合成問題わずか552件、訓練プロンプト1,296件という極めて小さなデータ規模からでも実用的な司令塔を訓練できることが示されています(論文全体では、金融・スポーツ・EC・医療・鉄道・レストランなど10ドメインで自動合成・検証したデータセット「ToolScale」とGeneralThought-430Kを組み合わせて16枚のNVIDIA H100 GPUで訓練)。
こうして誕生した8Bパラメータの「Orchestrator-8B」を、3つの難関ベンチマーク——①博士レベルの推論問題HLE、②2〜15本のWikipedia記事をまたぐ824問のマルチホップ事実推論FRAMES、③通信・小売・航空の3分野でユーザーと対話しながら関数を呼び出すτ²-Bench——で競わせた結果が、論文Table 1の数値です。
ToolOrchestra 論文 Table 1:主要モデルのベンチマーク・コスト・遅延の完全比較
| ツール設定 | 司令塔(メインモデル) | HLE (↑) | FRAMES (↑) | τ²-Bench (↑) | コスト指標 (↓) | 遅延指標 (↓) |
|---|---|---|---|---|---|---|
| ツールなし(単体推論) | Qwen3-8B | 3.2% | 24.2% | — | 0.2 | 0.6 |
| ツールなし(単体推論) | Claude Opus 4.1 | 11.7% | 58.2% | — | 27.4 | 8.2 |
| ツールなし(単体推論) | GPT-5 | 23.4% | 66.3% | — | 6.2 | 4.1 |
| 基本ツールのみ(検索+Python) | Qwen3-8B | 4.7% | 26.5% | 40.7% | 1.3 | 2.2 |
| 基本ツールのみ | Qwen3-235B-A22B | 14.0% | 39.5% | 52.9% | 12.3 | 10.2 |
| 基本ツールのみ | Claude Opus 4.1 | 19.8% | 63.5% | 46.0% | 76.2 | 32.5 |
| 基本ツールのみ | GPT-5 | 35.1% | 74.0% | 77.7% | 30.2 | 19.8 |
| 基本ツール+専門LLM+汎用LLM / (プロンプト指示による司令塔) | Qwen3-8B(未訓練プロンプト) | 30.6% | 68.9% | 72.3% | 27.6 | 18.3 |
| 基本ツール+専門LLM+汎用LLM | Llama-Nemotron-49B | 25.8% | 57.9% | 66.7% | 25.6 | 17.1 |
| 基本ツール+専門LLM+汎用LLM | Qwen3-235B-A22B | 32.8% | 74.2% | 75.6% | 29.7 | 21.2 |
| 基本ツール+専門LLM+汎用LLM | Claude Opus 4.1 | 34.6% | 72.8% | 76.8% | 52.5 | 25.6 |
| 基本ツール+専門LLM+汎用LLM | GPT-5(プロンプト司令塔) | 21.2% | 57.5% | 62.3% | 17.8 | 13.6 |
| 基本ツール+専門LLM+汎用LLM / (ToolOrchestra強化学習) | Orchestrator-8B(提案手法) | 37.1% | 76.3% | 80.2% | 9.2 | 8.2 |
この表から読み取れる事実は極めて強烈です。
- 全ベンチマークでフロンティア単体を凌駕:Orchestrator-8Bは、HLEで37.1%(GPT-5基本ツールの35.1%に対して+2.0ポイント、Claude Opus 4.1全ツールの34.6%に対して+2.5ポイント)、FRAMESで76.3%(GPT-5の74.0%に対して+2.3ポイント)、τ²-Benchで80.2%(GPT-5の77.7%に対して+2.5ポイント)と、すべてのテストで最高精度を達成しました。
- コストは約30%(2.5倍効率的)、待ち時間は半分以下:基本ツールを使ったGPT-5のコスト指標が30.2、Claude Opus 4.1(全ツール)が52.5であるのに対し、Orchestrator-8Bのコストはわずか9.2(GPT-5比で約30%、HLEの予算別効率曲線で2.5倍効率的)です。待ち時間(Latency)もGPT-5の19.8に対して8.2と半分以下に短縮されています。実際、τ²-BenchにおいてOrchestrator-8Bが最も高価なGPT-5を呼び出したのは全ステップの**約40%**だけであり、残りの約60%はより安価なモデルや基本ツールで処理していました。
3. なぜ「プロンプトで指示しただけのGPT-5司令塔」は自滅するのか?——2大バイアスと未知ツールへの汎化
[ここに Slide 4 画像を挿入]
上のTable 1を注意深く見ると、もう1つ驚くべき異常値に気づきます。
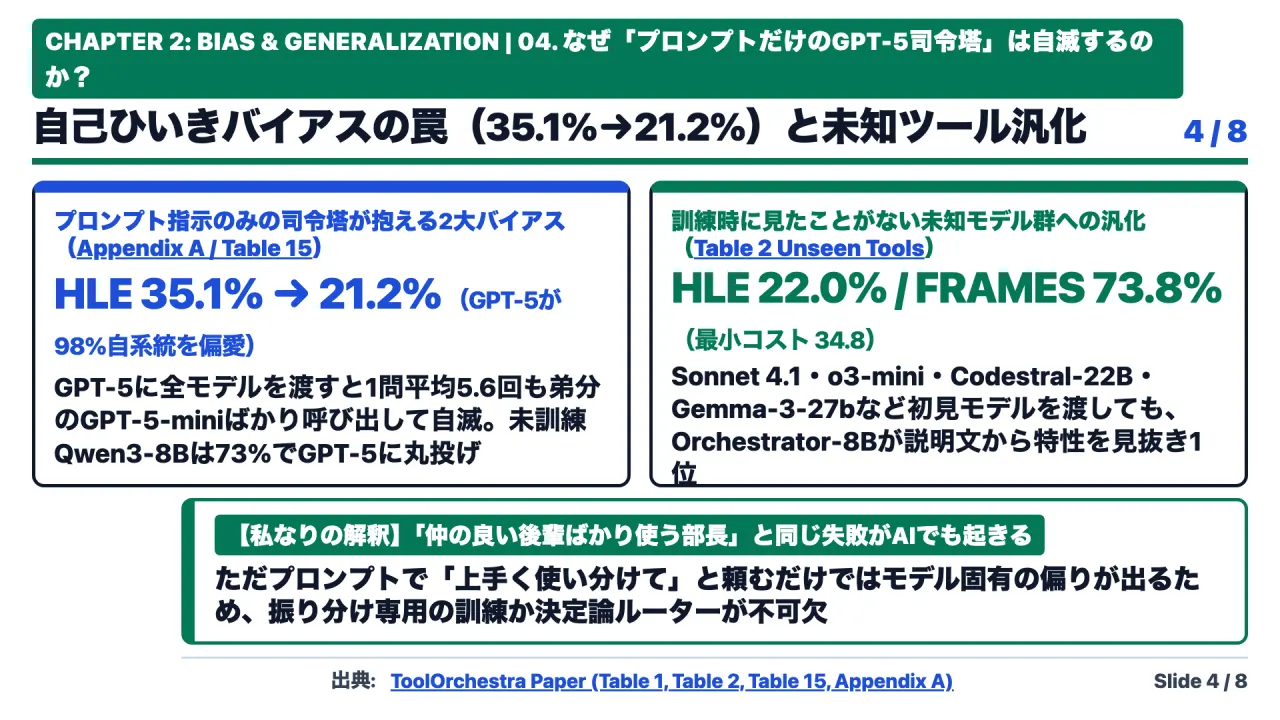
GPT-5に「基本ツール(検索とPython)」だけを持たせたときはHLEで35.1%、FRAMESで74.0%、τ²-Benchで**77.7%**という高い成績を出していたにもかかわらず、GPT-5に「専門LLMや他の汎用LLMも全部部下として使っていいよ」と権限を広げた瞬間、HLEが21.2%、FRAMESが57.5%、τ²-Benchが62.3%へと大暴落しているのです。
「一番賢いGPT-5をリーダーにして、自由に部下のモデルを使わせたら、なぜ単体のときより14ポイントも頭が悪くなるのか?」
その原因を解明したのが、論文Appendix Aのパイロット実験(HLE 300問)およびTable 15(1問あたりのツール呼び出し回数内訳)です。研究チームがプロンプトだけでモデルに司令塔をやらせたときの行動ログを分析したところ、市販のLLMには以下の2つの致命的なバイアスが組み込まれていることが判明しました。
① 自己ひいきバイアス(Self-enhancement bias):GPT-5は「弟分のGPT-5-mini」ばかりを偏愛する
GPT-5をプロンプトだけで司令塔にすると、なんと98%のケースで自分と同じファミリーである「GPT-5」または「GPT-5-mini」ばかりを呼び出しました。特に論文Table 15の内訳を見ると、GPT-5司令塔は1問あたり平均5.6回も「GPT-5-mini」を呼び出し、自分自身(GPT-5)を2.7回呼ぶ一方で、720億パラメータの数学専門モデル(Qwen2.5-Math-72B)やQwen3-32B、Llama-3.3-70Bは0.0回(一度も呼ばない)、ローカル検索もわずか0.5回しか使いませんでした。 つまり、本来なら自分で深く考えるか数学専門モデルに任せるべき超難問まで、「コストを抑えろと言われたし、自分の弟分のGPT-5-miniに任せておけば安心だろう」と安易に丸投げし、不正確な中間回答を信じて自滅していたのです。
② 他力本願バイアス(Other-enhancement bias):未訓練の小型モデルは「一番高いGPT-5」に73%丸投げする
逆に、強化学習をしていない素のQwen3-8Bをプロンプトだけで司令塔にすると、今度は自信がなさすぎて73%のケースで最高額の「GPT-5」に仕事を丸投げしました(Table 15では1問あたり平均6.0回もGPT-5を呼び出し、GPT-5-miniは0.5回)。その結果、精度は30.6%まで上がるものの、コスト指標が27.6まで膨れ上がり、小型モデルを置いた経済的メリットが消えてしまいます。Claude Opus 4.1を司令塔にした場合も同様に、1問あたり平均6.2回もGPT-5を呼び出してコストが52.5に高騰しました。
これに対し、ToolOrchestraで強化学習されたOrchestrator-8Bは、1問あたりの呼び出し回数が「ローカル検索 1.8回、GPT-5-mini 1.7回、GPT-5 1.6回、Qwen3-32B 1.3回、Python実行 0.8回、ウェブ検索 0.7回」と極めてバランス良く分散されています。まず無料のローカル検索や軽いモデルで当たりをつけ、本当に高度な推論が必要な急所だけでGPT-5をピンポイント投入する「外科手術のような使い分け」を体得していたのです。
訓練時に一度も見ていない「未知のモデル群」を渡しても1位(Table 2)
さらに驚くべきは、「訓練中に見たモデルしか使えないのではないか?」という疑問を覆した**汎化性能実験(論文Section 6.3 / Table 2)**です。研究チームはテスト時に、訓練中には一切登場しなかった未知のモデル群——Claude Opus 4.1、Claude Sonnet 4.1、o3-mini、GPT-4o、Codestral-22B-v0.1、OpenMath-Llama-2-70b、DeepSeek-Math-7b、Gemma-3-27b-it——へと部下の顔ぶれを総入れ替えしました。
それでもOrchestrator-8Bは、各モデルの長所・短所を書いた説明文(Model Description)を読むだけで即座に特性を理解し、HLEで22.0%(2位のClaude Opus 4.1は17.8%、GPT-5は16.4%)、FRAMESで73.8%(GPT-5は54.8%)、τ²-Benchで48.8%(GPT-5は44.8%)を記録し、しかもコスト最小(34.8 vs GPT-5の81.3 / Opus 4.1の102.4)・遅延最小(8.2 vs GPT-5の14.6)で完全勝利を収めました。
4. Meta Engineering『Thin Orchestrator』とマウントサイナイ医科大学研究:なぜ本番環境では「推論ゼロの薄いルーター」が最強なのか?
[ここに Slide 5 画像を挿入]
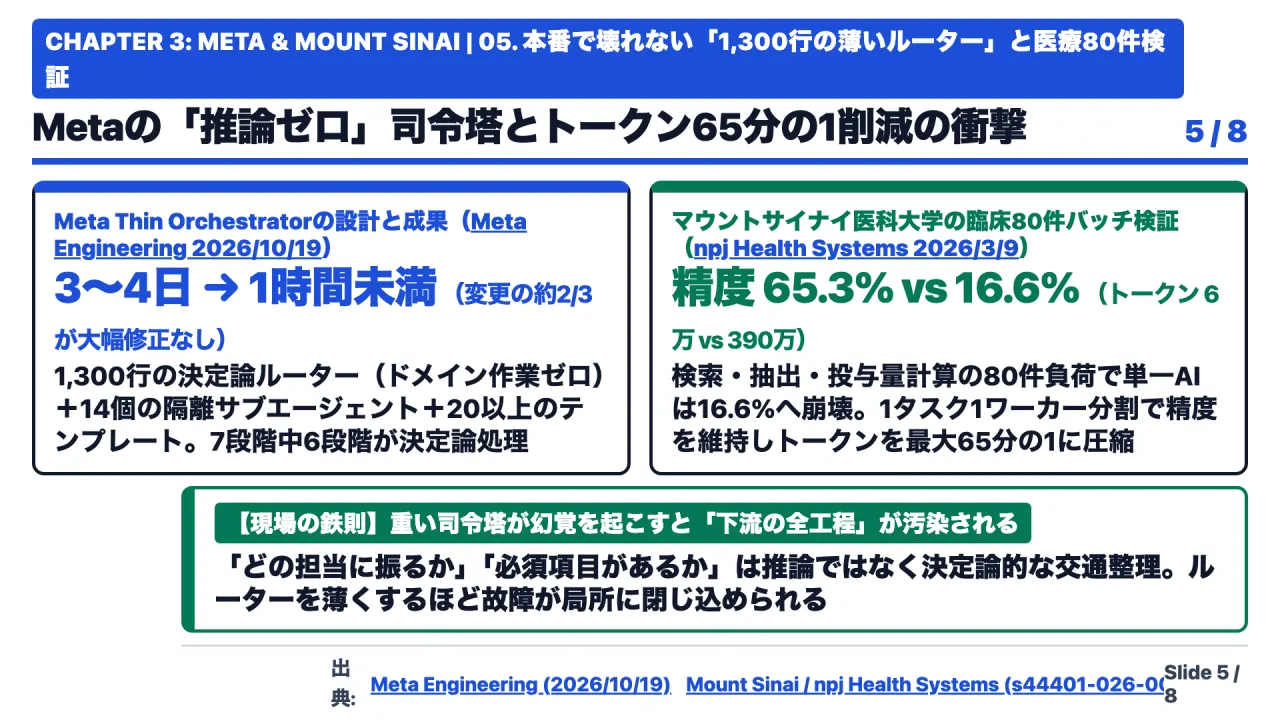
NVIDIAの研究が「8Bの学習済み小型司令塔」の威力を示したのに対し、さらに踏み込んで**「本番の業務システムでは、司令塔からLLMのドメイン推論そのものをゼロにした方がいい」と実証したのが、2026年10月19日にMeta EngineeringのPlawan Rath氏、Akhil Jindal氏、Ashwini Verma氏が公開した技術報告『The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do』**(Meta Engineering公式ブログ)です。
4-1. Metaが直面した失敗:「すべてを知る賢い単一エージェント」は本番で幻覚を起こす
Metaのチームが自動化しようとしたのは、同社の巨大な推薦システム(レコメンデーション基盤)に新しいデータ列(カラム)を追加する「データ列オンボーディング」業務でした。 この作業は、Pythonによる設定コード(Config-as-Code)からC++のコードを自動生成し、データ処理サービスを経て分析基盤へ流し込むという複雑なパイプラインをまたぎます。具体的には3つのコードリポジトリ、3つのプログラミング言語、10種類以上のデータソース、そして最大6つのパイプライン段階をすべて同期して変更しなければなりません。
Metaのチームが最初に作ったのは、多くの企業と同じ「1つの賢い万能エージェント」でした。すべてのドメイン知識、設定スキーマ、コード生成ルール、ルーティング論理、検証要件、10以上のデータソースのパターンを1つのエージェントに読み込ませたのです。 デモでは動きました。しかし本番環境では、以下の2つの理由で破綻しました。
- 概念の交差汚染(Cross-contamination):コンテキストがある閾値を超えると、データソースAのフィールド命名規則をデータソースBに誤適用したり、別のサブシステム用のコード生成パターンを混ぜてしまう幻覚(ハルシネーション)が頻発しました。
- プロンプト職人への依存:別の単一エージェント構成も試したものの、人間のエンジニアが毎回のタスクに合わせてシステムプロンプトを手作業で書き直したときだけ成功率が**70〜80%になり、その手助け(ハンドホールディング)を外すと成功率は10〜20%**へと急落しました。
4-2. 解決策:1,300行の決定論的ルーター+14個の隔離サブエージェント+7段階プロトコル
Metaはこの問題を「プロンプトの改善」や「コンテキストウィンドウの拡大」ではなく、アーキテクチャの分割で解決しました。システムを以下の2層に完全に切り分けたのです。
- 第1層:Thin Orchestrator(約1,300行の決定論的ルーター) 自分自身ではドメイン推論(業務知識を使った判断)を一切行いません(Zero domain work)。コードについて推論せず、設定ファイルも生成せず、コードベースにも触れません。意図の分類、必須項目の収集、信頼性チェック、そして担当サブエージェントへの委任だけを行う純粋なルーターです。
- 第2層:14個の専門サブエージェント(完全なコンテキスト隔離) スキーマ管理エージェント、10のデータソースごとのコード生成(Population)エージェント、ビルド・品質検証(Validation)エージェントなど、14個の専門家を用意しました。どのサブエージェントも「全体像」は見えず、自分の担当領域の知識ファイル(全体で25ファイル以上、実行時に必要な数千トークンだけをオンデマンド読み込み)だけを見て作業します。
そして最も注目すべきは、すべての日々のリクエストに対して司令塔が実行する**「固定7段階プロトコル」**です。
- 該当するサブエージェントの指示書ファイルを読み込む(決定論的)
- 対象のデータ列がすでに存在しないか重複をチェックする(決定論的)
- 利用者から必須の入力項目を収集する(決定論的)
- リポジトリ種別や既存設定など、自動推測できる項目を検出する(決定論的)
- アクティブな警告や必須レビュアーの有無など「信頼性ゲート」を確認する(決定論的)
- 隔離された専門サブエージェントに文脈を渡して委任する(ここだけがLLM推論!)
- 結果を受け取り、エラーの表面化や成功確認を行う(決定論的)
なんとステップ1〜5とステップ7はすべて決定論的なプログラムコードであり、確率的なLLMの推論が動くのはステップ6の隔離されたサブエージェントの内部だけなのです。 さらに「何をどの順番で行うか」は、14個のサブエージェントを並び替える**20種類以上のワークフローテンプレート(決定論的ステートマシン)**で管理されています。たとえば新しい「パイプライン移行(Assessment → Planning → Population → Validation → Monitoring)」という業務に対応した際も、新しいエージェントのコードは1行も書かず、既存の14エージェントの呼び出し順序を書いたテンプレートを1つ追加しただけで本番稼働に成功しました。
この「薄いオーケストレーター」への転換により、Metaの本番環境では以下の劇的な成果が上がりました。
- 新規データ列の設定準備時間:手作業の3〜4日(以前のシステムでも約1日)→ 1時間未満へ短縮。
- システムが生成した変更のうち、**約3分の2(約2/3)**が人間による大幅な手直しなしでそのまま通過。
Metaのエンジニア陣は、重い司令塔を避けるべき最大の理由として**「失敗モード(壊れ方)の違い」**を挙げています。重いオーケストレーターが上流で幻覚を起こすと、間違った担当を呼び、間違った項目を集め、安全チェックを飛ばすため、下流のすべてが汚染されます。一方、薄い決定論的ルーターはLLM推論に頼らないため上流で幻覚を起こす余地がなく、万一サブエージェントが失敗しても被害がその1箇所だけに封じ込められるのです。
4-3. マウントサイナイ医科大学(npj Health Systems)が証明した「80タスク負荷での精度崩壊と65倍のトークン差」
Metaが上記のブログの中で「単一エージェントが知識の海で溺れる証拠」として引用している外部研究が、マウントサイナイ医科大学(Windreich Department of Artificial Intelligence and Human Health)のEyal Klang氏、Mahmud Omar氏らが2026年3月9日にNature系学術誌『npj Health Systems』(Volume 3, Article 23)に発表した論文**『Orchestrated multi agents sustain accuracy under clinical-scale workloads compared to a single agent』**(s44401-026-00077-0、※Metaのブログ記事ではプレプリントとして言及されていますが、リンク先はNature系誌の正式出版論文です)です。
この研究では、病院のリアルな業務負荷を模して、性格の異なる3種類の臨床タスクを混ぜたバッチ処理実験を行いました。
- 検索(Retrieval):腫瘍学のPubMed抄録234,650件(FAISSインデックス)から関連論文を検索する
- 抽出(Extraction):電子カルテ(MIMIC-IV)の退院サマリー331,793件から入院日・退院日などの構造化項目を抜き出す
- 投与量計算(Dosing):体重や体表面積、クリアランスに基づく20種類の薬剤計算テンプレートを解く
1回に投入するタスク数(バッチサイズ)を5件、10件、20件、40件、80件へと増やしていき、4種類のモデル(GPT-4.1-mini、GPT-4.1-nano、Llama-2-70B、Qwen-3-8B)で「1体のエージェントに全タスクと全ツールを渡す単一構成」と「軽量なオーケストレーターが1タスクずつ専任ワーカー(1ツールのみ使用)に割り振るマルチ構成」を比較しました。
その結果は、バッチサイズが10件を超えたあたりから決定的な差となって現れました(p < 0.01)。
- 全体プール精度:オーケストレーション型マルチエージェントは5件バッチで90.6%、最大の80件バッチでも65.3%(95%信頼区間 56〜74%)の精度を維持しました。一方、単一エージェントは5件時の**73.1%から、80件時には16.6%**へと崩壊しました。
- モデル別の維持力(GPT-4.1-miniの例):マルチエージェント構成では5件から80件まですべてのバッチサイズで**96%〜91.4%という極めて高い精度を保ったのに対し、単一エージェント構成では96%から33.9%**へと急落しました。
- トークン消費量(最大65倍の差):GPT-4.1-miniにおいて、マルチエージェント構成のトークン消費は5件時の**3,700トークン(3.7k)から80件時でも6万トークン(60k)へと緩やかに増えただけでした。ところが単一エージェント構成では、5件時の2万5,000トークン(25k)から、80件時にはなんと390万トークン(3.9M)**へと爆発し、65倍ものトークン格差が生じました。待ち時間(合計レイテンシ)もマルチの131,603秒に対して単一は361,864秒へと約2.7倍に膨れ上がり、Llama-2-70BやQwen-3-8Bの単一構成では大規模バッチの途中でJSONすら返せず異常終了するケースが多発しました。
なぜこれほどの差がつくのか。著者らは**「各ワーカーがその1つの判断に必要なトークンだけを受け取るため、無関係なタスクの文脈によって注意力(アテンション)が希釈されないこと」、そして「司令塔がプロンプトを肥大化させずに結果だけを統合できること」**の2点を挙げています。さらに、1ワーカー1ツールに制限することで「どのステップでどのツールが何を返したか」の監査ログ(Audit Trail)が完全に透明化されるという、医療や金融などの規制産業にとって決定的なメリットも生まれます。
5. AOrchestra論文(arXiv:2602.03786v2):「4要素タプル」による動的生成と、全文脈丸投げが自滅する理由
[ここに Slide 6 画像を挿入]
第3の柱となるのが、香港科技大学(広州)などの研究チームが発表した**『AOrchestra: Automating Sub-Agent Creation for Agentic Orchestration』**(arXiv:2602.03786v2)です。
この論文は、従来のサブエージェント方式が陥りがちな「2つの極端な失敗パターン」を鋭く指摘しています。
- 単なる別スレッドとしての切り出し(Context-isolation threads):コンテキストの劣化を防ぐためだけに同じ能力のサブエージェントを分岐させる方式。専門特化(モデルやツールの最適化)ができない。
- 固定された役職としての事前定義(Static roles):最初から「企画担当」「コーディング担当」と人間がプロンプトと権限を固定してしまう方式。オープンな実務環境で次々に現れる想定外のサブタスクに対応できず、人間のメンテナンス負荷が重い。
5-1. エージェントを4つの要素〈Instruction, Context, Tools, Model〉のレシピとして毎回合成する
そこでAOrchestraは、あらゆるエージェントを以下の**4要素タプル(4-tuple)**として統一的に定義しました。
$$\Phi = \langle I, C, T, M \rangle = \langle \text{Instruction(指示)}, \text{Context(厳選文脈)}, \text{Tools(道具集合)}, \text{Model(モデル)} \rangle$$
- ワーキングメモリ軸 $(I, C)$:そのサブタスクで達成すべき具体的な目標と成功基準 $(I)$、および過去の履歴からその作業に関係する証拠だけを抽出・整理した文脈 $(C)$。
- 能力軸 $(T, M)$:そのサブタスクを実行するのに必要十分なツール群 $(T)$ と、難易度やコストに見合った言語モデル $(M)$。
そして中央のオーケストレーターは、自分自身では環境操作(シェル実行やウェブ検索やファイル編集)を一切行わず、**Delegate(Φ)(4要素を指定してサブエージェントを即席生成し作業を委任する)とFinish(y)(最終回答を出して終了する)**の2つのアクションだけを実行します。
この設計により、Gemini-3-Flashをバックボーンとした訓練なし(Training-free)の評価において、AOrchestraは以下の3大ベンチマークすべてで既存の主要フレームワーク(ReAct、OpenHands、mini-SWE-agent、Claude Code)を圧倒しました(論文Table 1)。
- GAIA(汎用AIアシスタント実世界タスク・検証セット165問):Pass@1 80.00% / Pass@3 86.06%(単体ReActは49.09%、mini-SWEは58.18%、OpenHandsは66.06%。最強ベースラインのOpenHandsを+13.94ポイント上回る)
- Terminal-Bench 2.0(Linuxターミナル環境の実務コマンド操作・70問評価):Pass@1 52.86% / Pass@3 57.14%(最強ベースラインのmini-SWE **34.29%**やClaude Code **32.86%**を大きく凌駕)
- SWE-Bench-Verified(実GitHubリポジトリのバグ修正・100問評価):Pass@1 82.00% / Pass@3 86.00%(単体ReAct 64.00%、mini-SWE 56.00%、OpenHands **48.00%**を上回る)
- 3ベンチマーク平均Pass@1:71.62%(最強ベースライン比で平均+16.28%〜+22.13%の改善)
5-2. 衝撃の実験①:ワーカーに「全文脈(Full-Context)」を丸投げすると、文脈なしより精度が落ちる(Table 2)
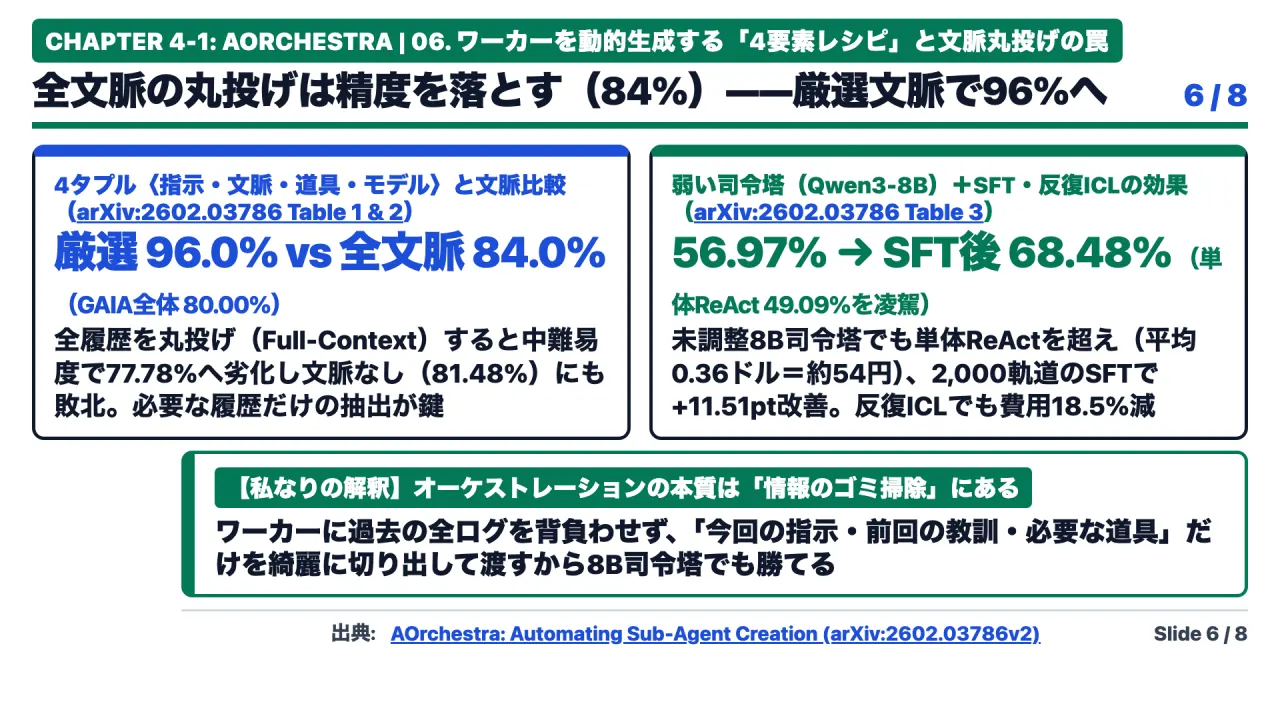
私たちがマルチエージェントを組むとき、最もやりがちなミスが「ワーカーが事情を把握できるように、これまでの会話履歴やログを全部そのまま渡してあげよう(Full-Context)」という設計です。 AOrchestraの研究チームは、GAIAから抽出した50問(Gemini-3-Flash使用)で、ワーカーへの文脈の渡し方を3通り比較しました(論文Section 4.3.1 / Table 2)。
| 文脈の渡し方(Setting) | Level 1(易) | Level 2(中) | Level 3(難) | 全体平均(Avg.) |
|---|---|---|---|---|
| No-Context(タスク指示 $I$ のみ渡し、過去履歴を渡さない) | 89.47% | 81.48% | 75.00% | 86.00% |
| Full-Context(メインエージェントの全履歴をそのまま丸投げ) | 94.74% | 77.78% | 75.00% | 84.00% |
| AOrchestra(Ours)(司令塔が関連する履歴・教訓だけを厳選・要約して渡す) | 100.00% | 88.89% | 75.00% | 96.00% |
なんと、全履歴を丸投げした「Full-Context(84.00%)」は、過去の文脈を一切渡さない「No-Context(86.00%)」よりも平均精度が低く、特に中難易度(Level 2)では81.48%から77.78%へと明確に劣化しているのです。 論文が指摘する通り、無関係な試行錯誤のログまでサブエージェントに流し込むと「文脈の腐敗(Context Rot)」が起き、ワーカーの注意力が散漫になります。逆にAOrchestraのように、司令塔が「前回のAttempt 1で調べた所蔵番号1975.1.784-795は無関係な素描だったので使うな」「Attempt 5で蛇の像(02.18.730f)は袖の中に手が隠れていると判明した」といった核心の事実だけを抽出して渡すことで、平均精度は**96.00%**へと跳ね上がるのです(論文Appendix Cのメトロポリタン美術館・十二支像のケーススタディ)。
5-3. 衝撃の実験②:司令塔を「弱いQwen3-8B」に置き換えても単体を超え、2,000件のSFTで68.48%へ化ける(Table 3)
さらにAOrchestra論文のSection 4.3.2(Table 3)では、ワーカー(サブエージェント)をGemini-3-Flashに固定したまま、司令塔(メインエージェント)をあえて弱い「Qwen3-8B(非思考モード)」に格下げする実験を行っています。
AOrchestra 論文 Table 3:GAIAベンチマークにおける司令塔モデルと学習手法の比較
| システム構成 | 司令塔 / ワーカーモデル | GAIA正答率 (Acc.) | 1問あたり平均コスト | 円換算目安($1=150円) |
|---|---|---|---|---|
| 単体 ReAct | DeepSeek-V3.2 | 46.70% | $0.027 | 約4.1円 |
| 単体 ReAct | Claude-4.5-haiku | 47.88% | $0.066 | 約9.9円 |
| 単体 ReAct | Gemini-3-Flash(単体) | 49.09% | $0.070 | 約10.5円 |
| 単体 ReAct | Claude-4.5-sonnet | 53.93% | $0.190 | 約28.5円 |
| 単体 ReAct | GPT-5-mini | 54.55% | $0.052 | 約7.8円 |
| AOrchestra(提案手法) | 未調整 Qwen3-8B(司令塔) + Gemini-3-Flash(ワーカー) | 56.97% | $0.36 | 約54円 |
| AOrchestra(SFT訓練) | SFT済み Qwen3-8B(司令塔) + Gemini-3-Flash(ワーカー) | 68.48% | $0.68 | 約102円 |
| AOrchestra(混合ルーティング) | Gemini-3-Flash(司令塔) + 複数モデル(Mixed) | 72.12% | $0.70 | 約105円 |
| AOrchestra(反復ICL最適化) | プロンプト学習済み Gemini-3-Flash + 複数モデル(Mixed) | 75.15% | $0.57 | 約85.5円 |
| AOrchestra(フル構成) | Gemini-3-Flash(司令塔 + ワーカー) | 80.00% | $0.79 | 約118.5円 |
このTable 3から、実務上きわめて重要な3つの法則が読み取れます。
- 未調整の8B司令塔でも単体モデルを超える:何もファインチューニングしていない素のQwen3-8Bを司令塔にしても、GAIAで56.97%(平均コスト0.36ドル=約54円)を達成し、Gemini-3-Flash単体のReAct(49.09%)を**+7.88ポイント**上回り、Claude-4.5-sonnet単体(53.93%)やGPT-5-mini単体(54.55%)すら抜いています。「タスクを分解して綺麗な文脈をワーカーに渡す」という構造そのものに強い利得がある証拠です。
- わずか2,000軌道のSFTで8B司令塔が「68.48%」へ大化けする:合成タスクデータセット「TaskCraft」を種にしてGemini-3-Flashで収集したわずか2,000件のオーケストレーション軌道を使い、Qwen3-8BをLLaMA-Factory上で2エポック教師あり微調整(SFT)したところ、GAIA正答率は56.97%から68.48%へと+11.51ポイントも急伸しました(OpenHands+Gemini-3-Flashの66.06%すら上回る水準)。実行ログを分析すると、SFT後の8B司令塔は難問に対して諦めずに再計画・再委任する試行回数が56%増加しており、「問題の分解と文脈の合成」が小規模な学習で習得可能なスキルであることを示しています。
- 重みを変えない反復インコンテキスト学習(ICL)でも精度向上+コスト18.5%削減:モデルの重みを更新できない環境でも、Claude Sonnet 4.5を最適化器として5ラウンド(各6軌道)にわたり司令塔のプロンプト指示文を自動改善させるだけで、複数モデル併用時の精度が72.12%から75.15%(+3.03ポイント)に上がり、同時に平均コストが0.70ドルから0.57ドルへと18.5%減少しました。
6. Anthropicの並列リサーチシステムと「適材適所」の境界線——私の検証で踏んだ2つの落とし穴
[ここに Slide 7 画像を挿入]
ここまで「小型司令塔」や「薄い決定論的ルーター」の強みを見てきましたが、では**「どんなタスクでも司令塔は小さい方がいいのか?」というと、決してそうではありません。論文や企業報告が共通して示す「境界線」を知るうえで欠かせないのが、Anthropicが2025年6月13日に公開した『How we built our multi-agent research system』**(Anthropic公式ブログ および Simon Willison氏の解説)です。
6-1. 「幅優先の未踏リサーチ」では強いリード(Opus 4)+並列ワーカー(Sonnet 4)が+90.2%を叩き出す
Anthropicの「Claude Research」機能は、リード役(LeadResearcher)に上位モデルのClaude Opus 4を据え、その下にClaude Sonnet 4のサブエージェントを3〜5体並列で起動するオーケストレーター・ワーカー構成を採用しています。
なぜここでは強いリードモデルを置いているのか。それはリサーチ業務が「事前に決まったワークフローテンプレート(Metaのような6段階の手順)をなぞる仕事」ではなく、**「調査の途中で出てきた手がかりに応じて方針を動的に変え、複数の独立した方向を同時に掘り下げる幅優先(Breadth-first)の探索タスク」**だからです。
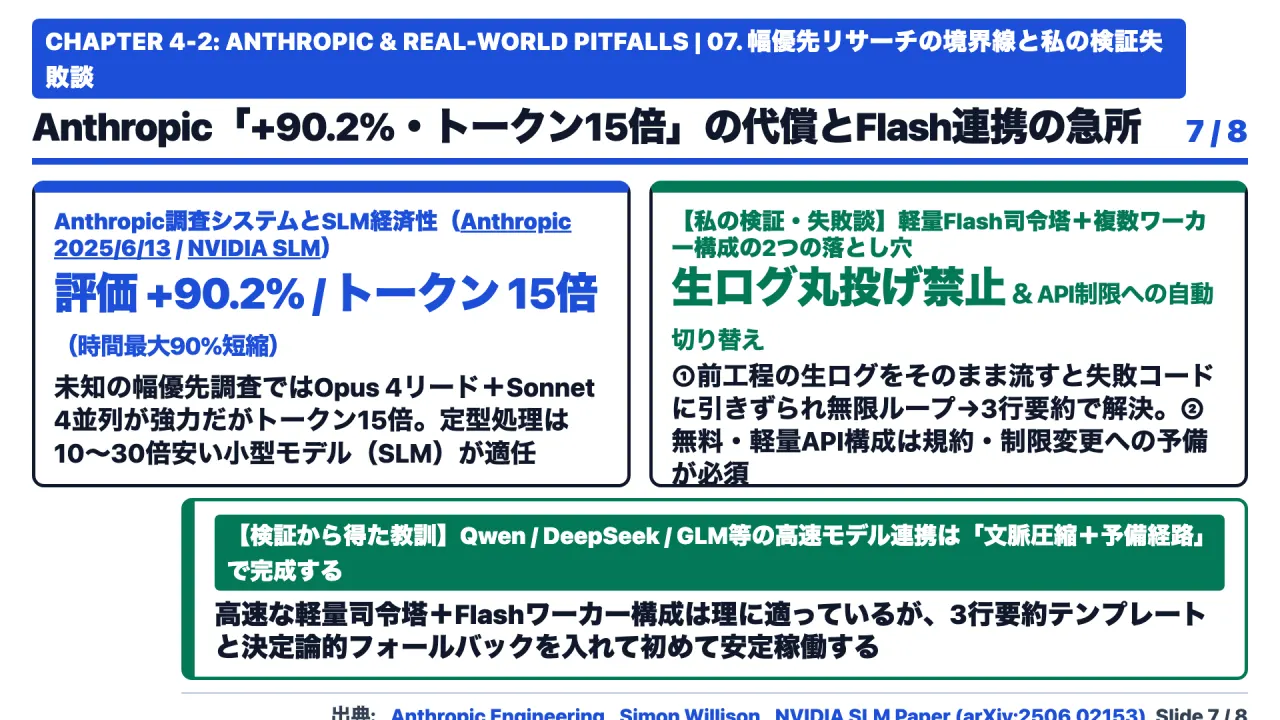
たとえば「S&P 500の情報技術セクター全企業の取締役会メンバーを特定せよ」という質問に対し、単一のClaude Opus 4は1社ずつ順番に直列検索を繰り返して途中で行き詰まりましたが、Opus 4リード+Sonnet 4並列サブエージェントの構成はタスクを分割して同時並行で検索・圧縮を行い、社内リサーチ評価で単一Opus 4を+90.2%上回る成績を記録しました。さらに「リードが3〜5体のサブエージェントを並列起動する」「各サブエージェントが3つ以上のツールを並列呼び出しする」という2段階の並列化により、複雑な調査の所要時間を最大90%短縮しています。
また、Anthropicが公開したもう1つの重要な知見が**「ツール説明文の自動改善」**です。MCPサーバー経由で提供される不完全なツールを「ツールテスト用エージェント」に数十回試行させ、失敗しやすい罠を回避するようにツールの説明文(Tool Description)を書き直させただけで、後続エージェントのタスク完了時間が40%短縮されました。
6-2. しかしマルチエージェントは「チャットの約15倍」のトークンを燃やす
一方でAnthropicは、この重厚なマルチエージェント構成の経済的な限界も明確に数値で示しています。
- ブラウジング評価ベンチマーク「BrowseComp」の成績ばらつき(分散)の95%は「トークン消費量・ツール呼び出し回数・モデル選択」の3つで説明でき、そのうちトークン消費量だけで分散の80%を説明できる。
- 実際の運用データにおいて、単一エージェントは通常のチャット対話の約4倍のトークンを消費し、マルチエージェントシステムは通常のチャットの約15倍ものトークンを消費する。
- しかも、すべてのエージェントが同じ文脈をリアルタイムに共有しなければならない密結合な作業(多くの通常のコーディング作業など)には、現在のマルチエージェントは必ずしも向いていない。
これと対比すると、NVIDIAのポジションペーパー『Small Language Models are the Future of Agentic AI』(arXiv:2506.02153)および技術ブログの位置づけが極めてクリアになります。NVIDIAが指摘する通り、エージェントが日常的に繰り返すサブルーチンの大半(コマンド解析、厳格なJSONスキーマでの関数呼び出し、定型要約など)は、405Bクラスの超巨大モデルを使うより8B〜9Bクラスの小型モデル(例:単一GPUで128k文脈を扱い6倍のスループットを出すNemotron Nano 2 9BやLlama 3.1 8B)を使う方が10倍〜30倍安価であり、ファインチューニングも数週間ではなく数GPU時間で終わり、しかも余計なフォーマット崩れを起こしません。
6-3. 【私の検証と失敗談】軽量Flash司令塔+複数Flashワーカー構成で踏んだ「2つの落とし穴」
ここからは、一次資料の事実とは明確に区別した、私自身が今回の5つの文献を照合しながら手元の開発環境でマルチエージェント構成を検証した際のリアルな失敗と改善の記録です。
現在、個人の開発者やスタートアップの間で、**「無検閲系のQwen FlashNextのような高速・軽量モデルをオーケストレーター(司令塔)に置き、DeepSeek V4.1 FlashやGLM 5.3 Flashのような高速・低コスト(あるいは無料枠)モデルをワーカーとして使い分ける」**という構成が非常に人気を集めています。
今回検証した5つの一次資料に照らすと、この**「8B〜Flashクラスの軽量司令塔+複数の高速専門ワーカー」というアーキテクチャ自体は、NVIDIAのToolOrchestraやAOrchestraの実験結果と完全に整合しており、極めて理に適った構成**です。
しかし、私自身も手元の検証パイプラインでこれに近い「軽量ルーター+複数Flashワーカー」を回した際、2つの手痛い失敗をやらかしました。
- 失敗①:良かれと思って「前工程の生ログ」を次のワーカーに丸投げし、無限ループでトークンを溶かした 最初は「ワーカーに情報が足りないといけないから」と考え、前のワーカーが出力した長い検索結果やエラートレースの生ログを、そのまま次のワーカーのプロンプトに貼り付けて渡していました。すると、まさにAOrchestraのTable 2で「Full-Contextが84.00%(Level 2で77.78%)に劣化した」のと同じ現象が直撃しました。ワーカーが前工程の失敗したコード断片や無関係なエラー文字列に注意(アテンション)を奪われ、同じ間違いを別パターンで繰り返す無限ループに陥ったのです。 【改善策】:AOrchestraのサブエージェント要約プロンプト(Appendix B.2.4)とMetaの事前収集チェックリストに倣い、司令塔からワーカーへ渡す文脈 $C_t$ を**「①今回達成すべき1文のゴール」「②前工程で確定した事実(3行以内)」「③前工程で失敗したため絶対に繰り返してはいけない手法」**の3ブロックだけに強制圧縮するテンプレートへ変更しました。これだけで、ワーカーの一発通過率が目に見えて安定しました。
- 失敗②:無料枠・格安API中心の「節約仕様」が持つプロバイダ依存リスク もう1つの現実的な壁は、無料APIや超低価格エンドポイントを組み合わせた構成(いわゆる「乞食仕様・節約仕様」)の長期安定性です。特定のプロバイダがある日突然レート制限(RPM/TPM)を厳しくしたり、無料枠のポリシーを変更したり、JSONのレスポンス形式を微妙に変えたりした瞬間、LLM任せの司令塔はエラーの意味を理解できずに同じワーカーを連打してシステム全体が沈黙します。 【改善策】:ここでもMetaの「Thin Orchestrator」の設計思想がそのまま効きます。「どのAPIエンドポイントが生きているか」「レート制限エラー(HTTP 429等)が出たときに第2候補のモデル(例:DeepSeek系からGLM系やローカルQwen系)へどう切り替えるか」という判断は、絶対にLLMの推論に任せず、オーケストレーターの外側の決定論的なPythonコード(ルーター層)にフォールバック表としてハードコードしておくことが不可欠です。
7. 結論:明日から現場で使える「AIオーケストレーター設計」3つの実装チェックリスト
[ここに Slide 8 画像を挿入]
今回の5つの海外一次資料(NVIDIA、Meta、マウントサイナイ医科大学、AOrchestra、Anthropic)のファクトから導かれる、明日から自社のAIシステムや個人のエージェント環境に導入できる3つの設計鉄則を整理します。
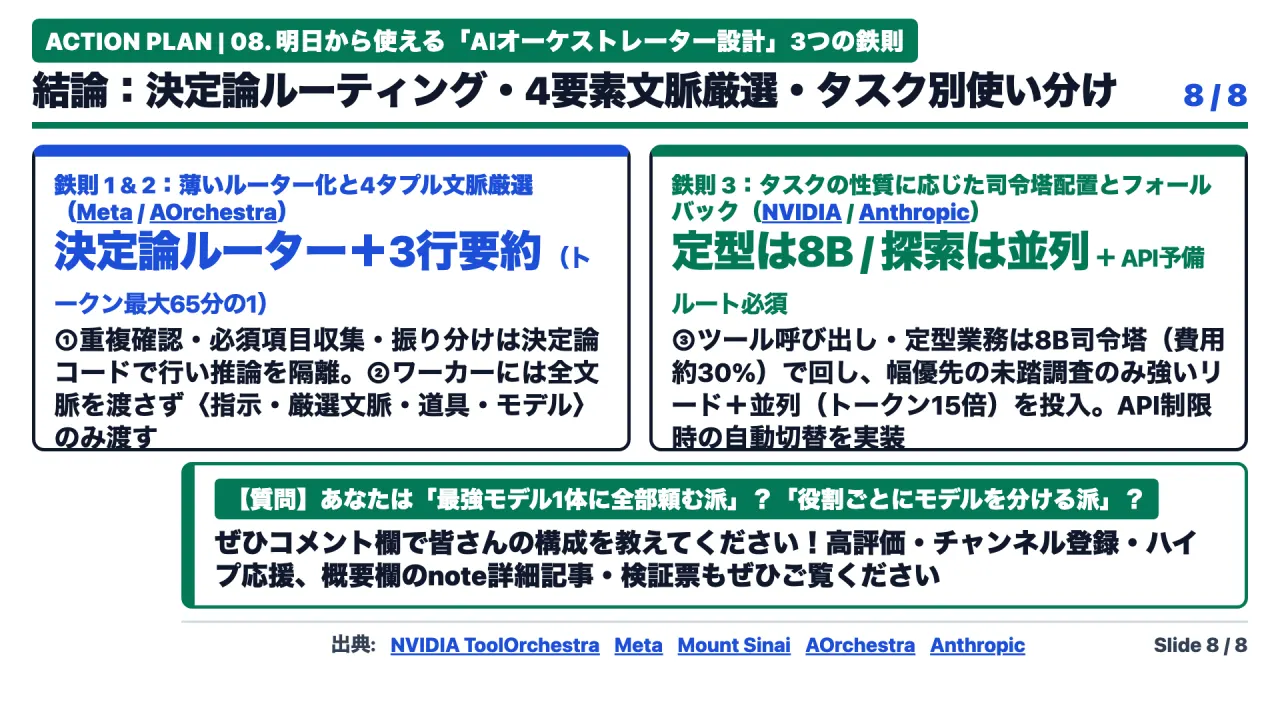
鉄則1:「ルーティング(交通整理)」と「ドメイン推論(専門作業)」を決定論の境界線で切り離す
- やめるべきこと:1つの万能エージェントにすべての業務知識・スキーマ・コード規約を詰め込み、「どのツールを呼ぶか」から「実際のコード生成・検証」までを同じプロンプト内で推論させること(Metaの事例では手動補助なしで成功率10〜20%に低下)。
- 明日からやること:Metaの7段階プロトコルのように、①指示書の読み込み、②重複チェック、③必須フィールドの収集、④環境情報の自動検出、⑤権限・警告ゲート確認、⑦結果フォーマット検証の6つの工程を決定論的なプログラムコードで書き、LLMの推論は「⑥完全に隔離された専門サブエージェントの呼び出し」の1箇所だけに閉じ込める。
鉄則2:ワーカーには「会話履歴の丸投げ」を禁じ、4要素タプル $\langle I, C, T, M \rangle$ だけを渡す
- やめるべきこと:メインエージェントのこれまでの対話履歴(Full-Context)や複数タスクのバッチをそのままワーカーに流し込むこと(AOrchestraでは84.00%へ精度劣化、マウントサイナイ医科大学の研究では80タスク時にトークン消費が65倍の390万トークンに膨張)。
- 明日からやること:ワーカーを起動する際は、必ず①今回の明確な指示 $(I)$、②過去の試行から抽出した「成功事実と避けるべき失敗」の短い要約 $(C)$、③その作業に必要な最小限のツール $(T)$、④タスク難易度に見合ったモデル $(M)$ の4点セットだけを渡す。また、MCPツールの説明文(Tool Description)はテストエージェントや少数サンプル(20問程度)で事前に改善しておく(Anthropic事例で完了時間40%短縮)。
鉄則3:タスクの性質で「8B・決定論ルーター」と「強い計画リード」を使い分け、APIの予備経路を持つ
- やめるべきこと:すべての業務に無条件で最高額モデル(GPT-5やOpus 4.1)を置くこと、あるいはプロンプト指示だけで汎用モデルに複数モデルの振り分けを任せること(NVIDIAの実験ではGPT-5が98%自系統を偏愛してHLEが35.1%→21.2%へ急落)。
- 明日からやること:
- 手順が定まった業務フロー・関数呼び出し・バッチ処理:決定論的ルーター(Meta型)または少量の軌道(552問〜2,000軌道)でSFT/RL訓練した8Bクラスの軽量オーケストレーター(NVIDIA / AOrchestra型)を採用し、コストを約30%・トークンを最大65分の1に抑えつつ最高精度を狙う。
- 事前に手順が予測できない幅優先のオープン調査:トークン消費が通常チャットの約15倍になる採算性を確認したうえで、Anthropic型の「強い計画リード+3〜5体の並列ワーカー」を投入する。
- 軽量Flashモデルの組み合わせ運用:Qwen / DeepSeek / GLM等の高速モデルを組み合わせる際は、プロバイダのポリシー変更やレート制限で止まらないよう、決定論的ルーター層に自動フェイルオーバー(代替モデルへの切り替え)を必ず実装する。
参考文献・一次資料リンク集
- NVIDIA Technical Blog: Train Small Orchestration Agents to Solve Big Problems(Shizhe Diao, Peter Belcak, Pavlo Molchanov)
- NVIDIA ToolOrchestra 論文: ToolOrchestra: Elevating Intelligence via Efficient Model and Tool Orchestration (arXiv:2511.21689v1) / GitHub: NVlabs/ToolOrchestra
- NVIDIA SLM ポジションペーパー & ブログ: Small Language Models are the Future of Agentic AI (arXiv:2506.02153) / How Small Language Models Are Key to Scalable Agentic AI
- Meta Engineering: The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do(2026年10月19日公開, Plawan Rath, Akhil Jindal, Ashwini Verma)
- Mount Sinai医科大学(npj Health Systems)論文: Orchestrated multi agents sustain accuracy under clinical-scale workloads compared to a single agent(2026年3月9日公開, npj Health Systems Vol. 3, Article 23, Eyal Klang, Mahmud Omar et al.)
- AOrchestra 論文: AOrchestra: Automating Sub-Agent Creation for Agentic Orchestration (arXiv:2602.03786v2) / GitHub: FoundationAgents/AOrchestra
- Anthropic Engineering: How we built our multi-agent research system(2025年6月13日公開, Jeremy Hadfield, Barry Zhang et al.) / Simon Willison’s Weblog: Anthropic: How we built our multi-agent research system(2025年6月14日公開)