「なぜ『強化学習(RL)』で鍛えたはずの推論AIが、100回試行すると元のモデルに負けるのか」——清華大が暴いた『RLVRの天井(pass@k逆転現象)』と、7ヶ月ごとに倍増する『50%自律完遂時間(METR 50分)』をめぐるカルパシー vs アモデイの10年論争の真実
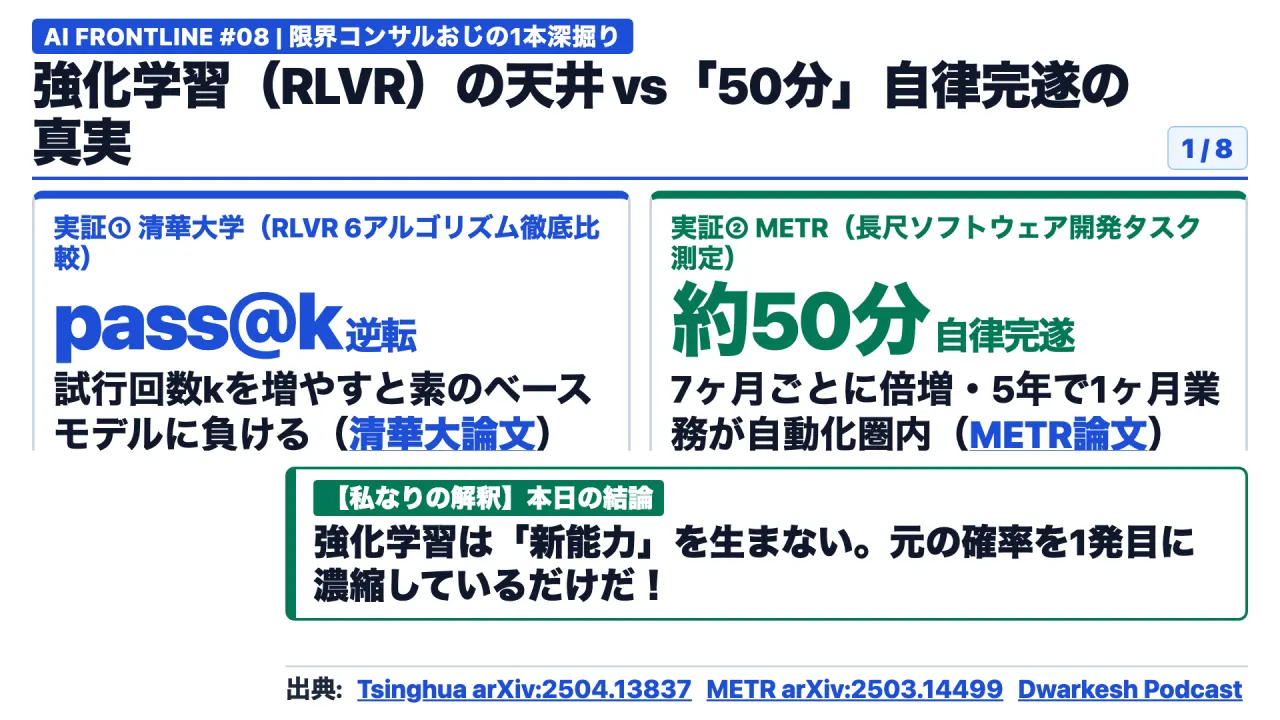
図1は放送時の説明資料(Slide 01)です。
今日は「なぜ、最新の強化学習で鍛え上げたはずの推論エーアイが、100回連続で難しい問題に挑戦させると、鍛える前の素のモデルに負けてしまうのか」という、推論エーアイの不都合な真実と自律時間の話です。「強化学習でエーアイに自分で考えさせれば、人間を超える新しいひらめきを無限に獲得できる」という甘い幻想は、今日で完全に捨ててください。
いきなりですけど、クイズを1つ。いま最先端のエーアイが、人間のエンジニアなら何時間もかかるような実務のソフトウェア開発を、人間の手助けなしで「50パーセントの確率で最後までやり切れる時間」は、何分くらいだと思いますか。
5分でしょうか、それとも10時間でしょうか。答えは、評価機関メトル(METR)が発表した最新の測定論文によると、現在の最先端モデルで約50分です。
しかもこの「1人でやり切れる時間」は、2019年から約7ヶ月ごとに2倍のペースで伸び続けており、このまま進めば5年以内に「人間が1ヶ月かかる仕事」に到達すると試算されています。ところが一方で、清華大学の研究チームが発表した強化学習の限界に関する論文では、いま流行りの強化学習は「1発目の正解率」を上げているだけで、試行回数を増やすと元のベースモデルに逆転されて負けるという衝撃のデータが出ました。
だから今日の問いはこうです。強化学習は本当にエーアイを賢くしているのか、それとも元の能力を細く絞っているだけなのか。
みなさん、お元気ですか。「限界コンサルおじ」です。
普段は金融から製造業まで、コンサルティングからシステム開発、さらにはエーアイの追加学習まで、プロジェクト完成のためにはなんでもやる現場人間です。世界の最先端研究から見えてくる現場のリアルを、独自の視点で解説します。
さて、第8回となる本日のテーマは、「なぜ『強化学習』で鍛えたはずの推論エーアイが、100回試行すると元のモデルに負けるのか、清華大が暴いた『パス・アット・ケイ逆転現象』と、7ヶ月ごとに倍増する『50パーセント自律完遂時間』をめぐるカルパシー対アモデイの10年論争の真実」です。
前提の整理と全体の見取り図
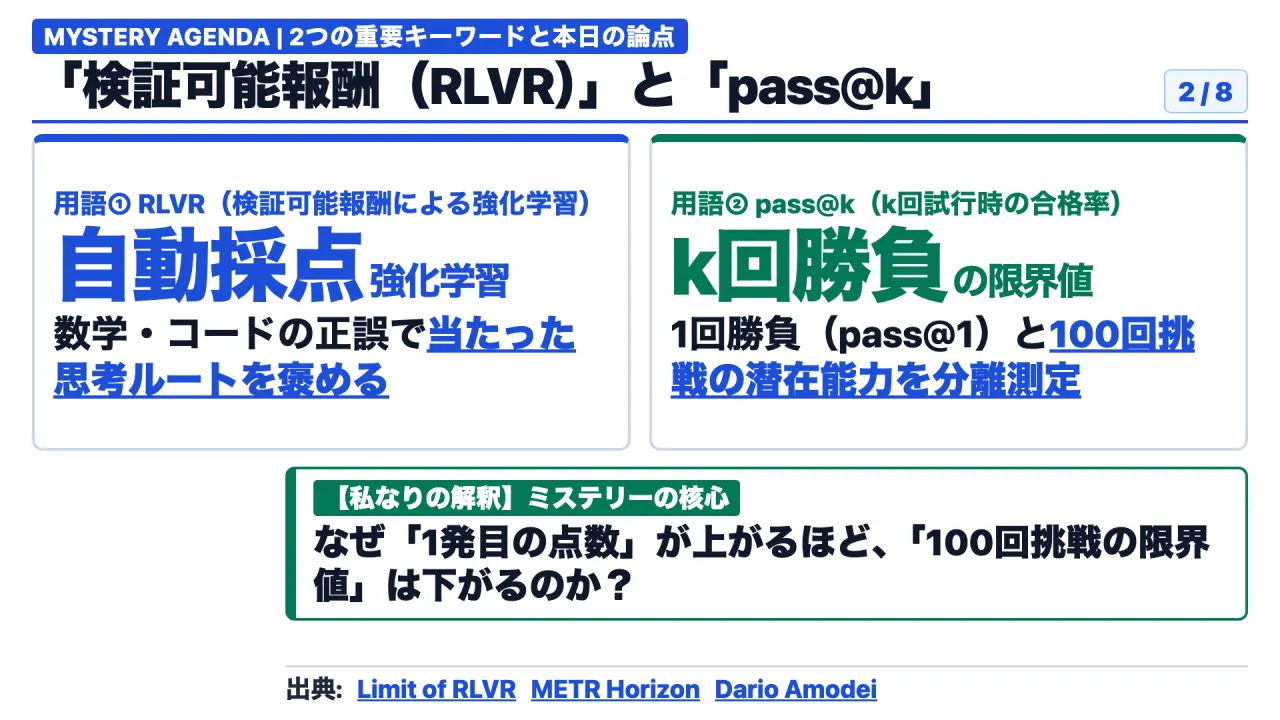
図2は放送時の説明資料(Slide 02)です。
本題の前に、言葉の整理を1つだけ。今日キーワードになる「アール・エル・ブイ・アール(検証可能報酬による強化学習)」と「パス・アット・ケイ(pass@k)」という2つの言葉です。
まず「検証可能報酬による強化学習」とは、数学の計算やプログラムのテストのように、「答えが合っているか間違っているか」を自動採点できる問題を何百回も解かせて、正解したときの考え方を褒めて伸ばす学習方法のことです。そしてもう1つの「パス・アット・ケイ」とは、エーアイに同じ問題を「ケイ回」挑戦させて、そのうち1回でも正解が出れば合格とするテスト指標です。
1回勝負の正解率を「パス・アット・ワン」、100回挑戦して1回でも当たる確率を「パス・アット・ハンドレッド」と呼びます。
今日の進み方です。まず、清華大学の研究チームが暴いた「強化学習のパス・アット・ケイ逆転現象」と、メトルの論文が示した「7ヶ月ごとに倍増する自律完遂時間50分」という2つの数字を見ます。
次に、なぜ強化学習で鍛えると「1発目の成績」は上がるのに「100回勝負の限界値」が下がってしまうのか、その裏にある技術的なカラクリと「蒸留」との決定的な違いを見ます。それから、海外ポッドキャスト『ドワーケシュ・ポッドキャスト』で繰り広げられた、アンドレイ・カルパシーの「ストローで報酬を吸う強化学習批判」とダリオ・アモデイの「巨大な計算塊の仮説」という真っ向勝負を聞き、最後に私たちが実務で推論モデルをどう使い分けるべきか、私の見立てをお話しします。
第1章:海外一次データが示す現場の変化
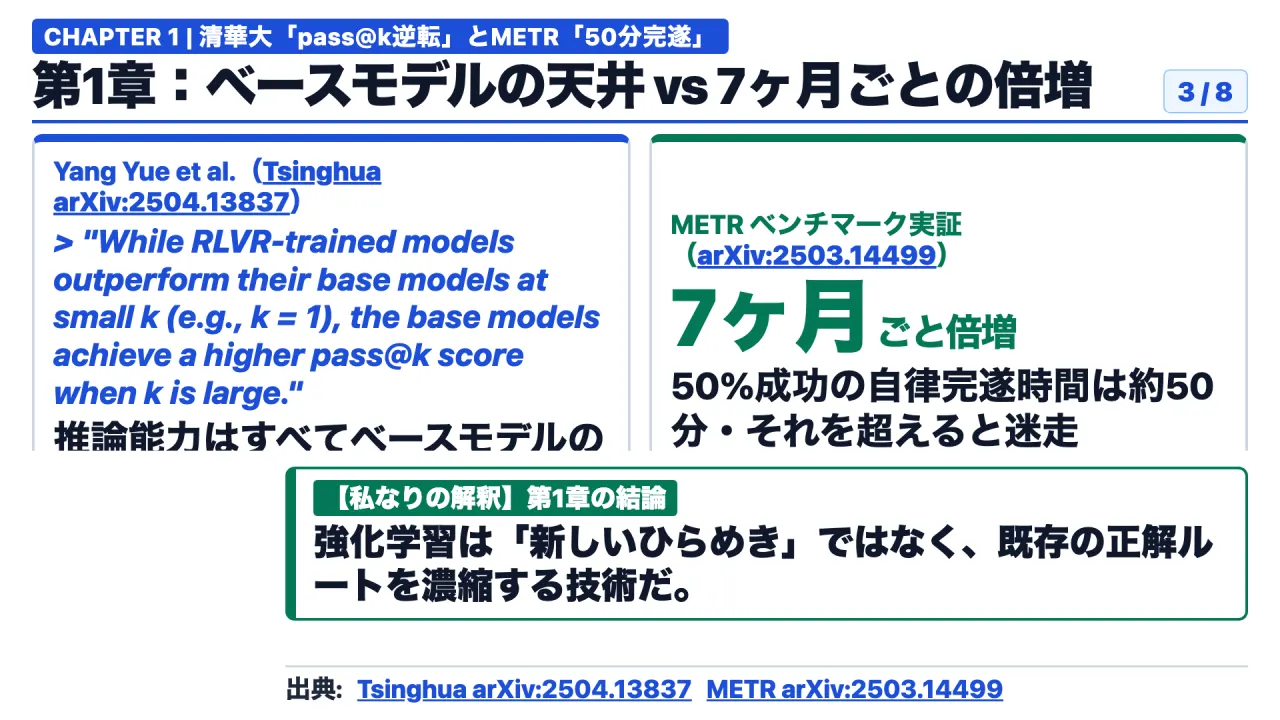
図3は放送時の説明資料(Slide 03)です。
まず第1章、いま世界中のエーアイ開発で起きている「強化学習ブーム」の裏側にある、2つの決定的な論文データから見ていきます。
ここ1年、OpenAIやディープシークをはじめ、世界中の研究所が「事前学習の次は強化学習だ」と言って、数学やプログラミングの問題をエーアイに何万回も自習させることで、推論テストの点数を劇的に引き上げてきました。多くの人が「強化学習を使えば、エーアイは人間が教えていない新しい解法を自力で発見して、どこまでも賢くなるのだ」と信じています。
しかし、この常識に冷や水を浴びせたのが、清華大学のヤン・ユエ(Yang Yue)らの研究チームが発表した『強化学習は本当にベースモデルを超える推論能力を引き出しているのか』という論文です。論文の要旨には、こう明確に記されています。
驚くべきことに、現在の強化学習の設定は、根本的に新しい推論パターンを引き出していないことが判明した。強化学習で鍛えたモデルは、試行回数ケイが小さいとき、たとえば1回勝負のパス・アット・ワンでは元のベースモデルを上回るが、試行回数ケイを大きくすると、鍛える前のベースモデルの方が高いパス・アット・ケイのスコアを達成する。
網羅率と確率の分析により、観察された推論能力はすべて元のベースモデルに由来し、その上限に縛られていることが示された。
これはどういうことか。たとえば1回勝負のテストでは、強化学習で鍛えたモデルの方が圧倒的に良い点数を取ります。
ところが、難しい数学やプログラムの問題に対して「100回あるいは256回まで試行錯誤していいから、1つでも正解を見つけてごらん」と挑戦させると、なんと強化学習で鍛える前の「素のベースモデル」の方が、より多くの難問を解けてしまったのです。研究チームが6種類の代表的な強化学習アルゴリズムをいくら比較しても、この「元のモデルの天井を超えられない」という結果は同じでした。
一方で、実務のタスクをどこまで1人でやり切れるかを測った評価機関メトルの論文では、もう1つの重要な現実が浮かび上がっています。人間の専門家が実際に時間を測って行ったソフトウェア開発タスクを基準にすると、最先端モデルの「成功率50パーセントの自律完遂時間」は約50分に達しており、2019年から約7ヶ月ごとに2倍になっています。
ただし、人間の仕事時間が50分を超えるような複雑なタスクになると、現在のモデルでも成功率は50パーセントを割り込み、途中で迷走してしまうのです。
ここまでを一言でまとめるとこうです。いまの強化学習は、ゼロから新しい知能を生み出しているわけではなく、元のモデルがすでに持っていた正解ルートを「1発目で引き当てやすく濃縮している」だけであり、その引き換えに多様な発想の広がりを捨てている、ということです。
第2章:技術的・構造的な仕組みと落とし穴
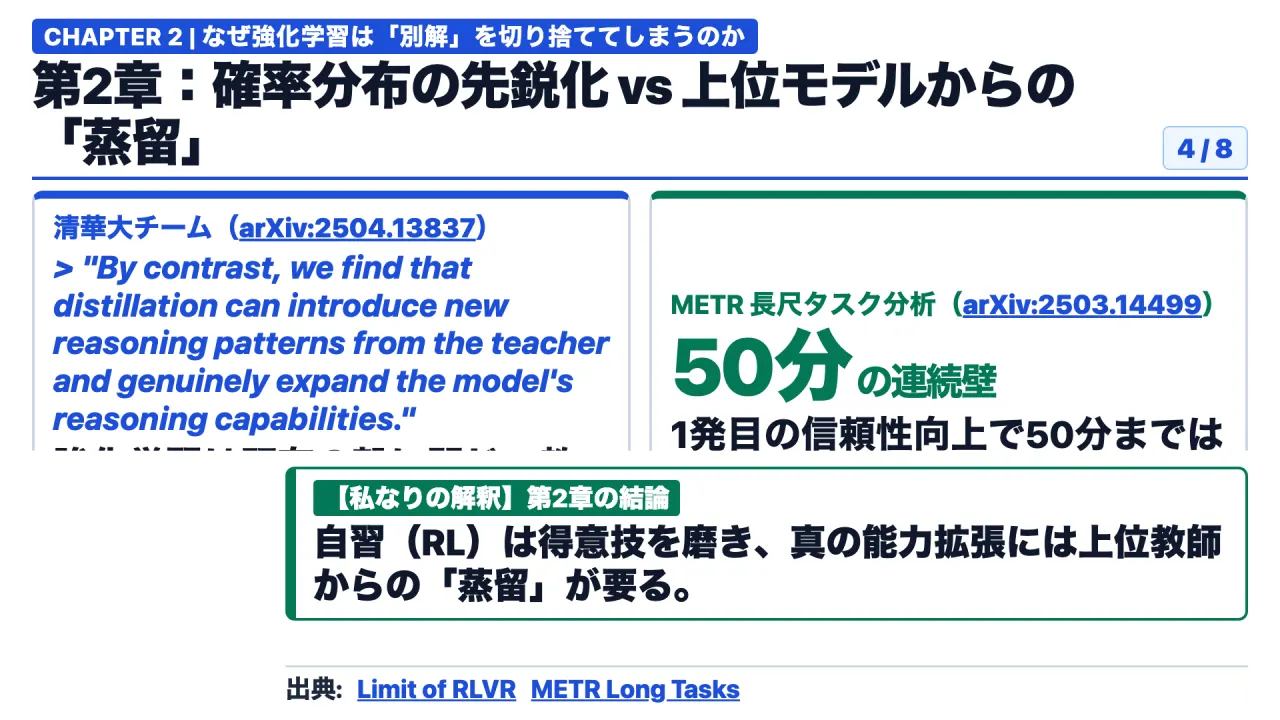
図4は放送時の説明資料(Slide 04)です。
次に第2章、ではなぜ強化学習で鍛えると「1発目の正解率」が上がる代わりに「100回挑戦したときの限界値」が下がってしまうのか、その技術的なカラクリを見ていきます。
中学生のテスト勉強に例えるとすごくよくわかります。元の「ベースモデル」は、世界中の本やプログラムを丸暗記した、知識だけは豊富だけれど整理されていない生徒です。
この生徒に難しい問題を出して100通りのやり方で解かせると、95回は途中で計算ミスをしますが、残り5回の中には「あっと驚くような別解」が混ざっています。
ここに「答えが合っていたら100点、間違っていたら0点」という強化学習をかけると何が起きるか。エーアイは「確実に点が取れる1つの無難な解き方」だけに確率を集中させ、少しでも失敗しそうな珍しい解き方をすべて切り捨ててしまいます。
専門用語で「分布の先鋭化(シャープニング)」と呼びますが、要するに「1発目で70点を取る確率」は劇的に上がるものの、100回試しても毎回同じような解き方しか繰り返さなくなるため、定番のやり方では解けない超難問に挑むと、100回とも同じ壁にぶつかって全滅してしまうのです。
では、どうすれば元のモデルの「天井」を突き破って、本当に新しい推論能力を手に入れられるのか。清華大学の論文は、その唯一の突破口が「蒸留(ディスティレーション)」であったとこう報告しています。
対照的に、より賢い教師モデルからの「蒸留」は、新しい推論パターンをモデルに導入し、推論能力の境界を真に拡張できることが判明した。総じて、現在の検証可能報酬による強化学習は、真に新しい推論能力を引き出すという本来の可能性をまだ実現できていない。
つまり、自分1人で同じ問題集を何万回も解かせる強化学習では自分の殻を破れず、一回り巨大な上位モデル(教師モデル)が書いた「思考の道筋」を丸ごと教え込む「蒸留」を行ったときだけ、パス・アット・ケイの天井そのものが上に広がったのです。
そしてもう1つ、メトルの論文が示した「7ヶ月ごとの自律時間倍増」を支えている正体も、まさにこの「1発目のミスを減らす濃縮」にあります。50分間の作業をやり切るには、途中で10回ツールを動かして10回とも連続で成功しなければなりません。
1回あたりの成功率が上がれば、連続で作業できる時間は伸びますが、50分を超えて想定外のエラーにぶつかった瞬間、別のアプローチを思いつけずに立ち往生してしまうのです。
この章も一言でまとめます。強化学習とは「新しい知恵を生む魔法」ではなく、元のモデルが持つ知識の引き出しから「1発目で正解を引く確率を高めるフィルター」であり、天井そのものを広げるには上位モデルからの「蒸留」か、環境との対話が必要である、ということです。
第3章:海外ポッドキャストの肉声と実務の壁
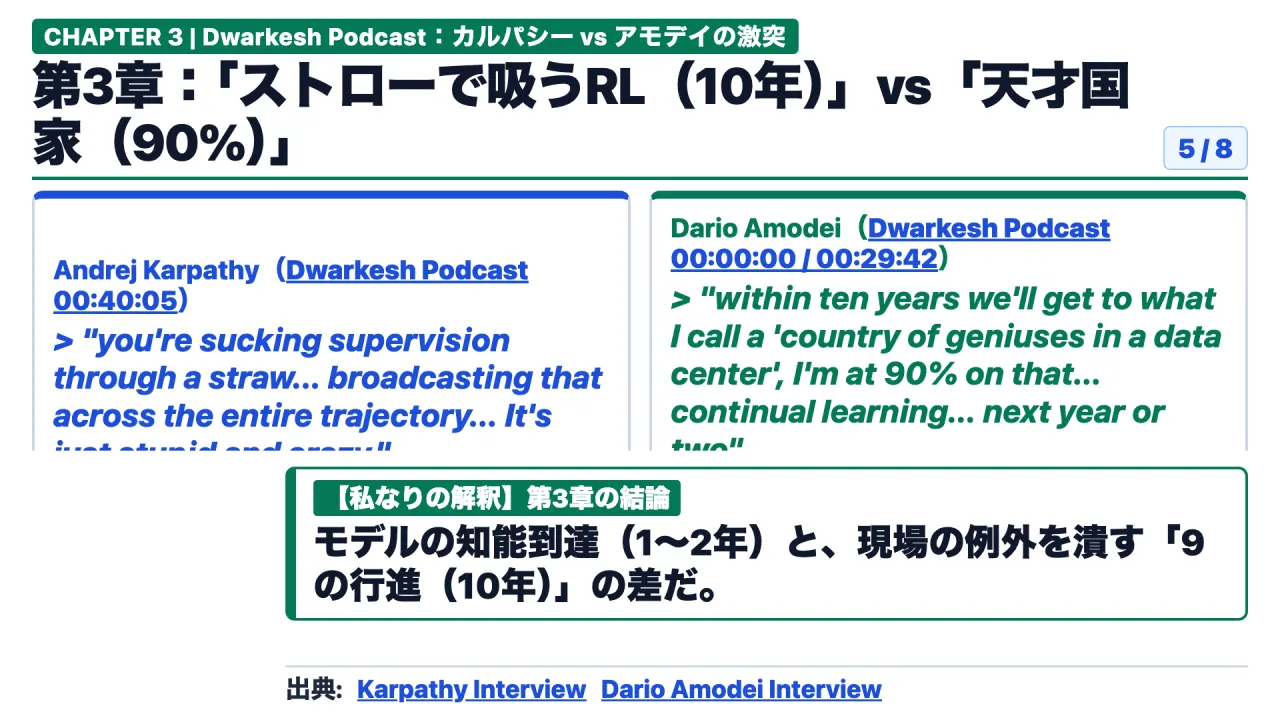
図5は放送時の説明資料(Slide 05)です。
続いて第3章です。この「強化学習の限界と自律時間の伸び」をめぐって、いま世界のトップ研究者たちの間で真っ二つに意見が割れています。
海外の有名技術ポッドキャスト『ドワーケシュ・ポッドキャスト』に相次いで出演した、OpenAI共同創業者のアンドレイ・カルパシーと、Anthropic最高経営責任者のダリオ・アモデイの、真っ向からぶつかり合う肉声を見ていきます。
まず、アンドレイ・カルパシーは番組のチャプター「強化学習はひどい(00:40:05)」の中で、いまの強化学習が抱える構造的な欠陥を、驚くほど率直な言葉でこう切り捨てています。
私がよく使う表現で言えば、今の強化学習は「細いストローで監督信号をチューチュー吸っている」ようなものだ。1分間かけて何百トークンもの長い試行錯誤をしたあげく、最後に「正解か不正解か」というたった1ビットの報酬信号をストローで吸い上げて、それを途中のすべての行動に一律にばら撒いて評価を上げ下げしている。
そんなやり方は愚かで狂っている。人間なら絶対にそんな学び方はしない。
カルパシーが指摘しているのはこういうことです。100回試行してたまたま答えが合った3回の記録の中には、途中で寄り道した「間違った考え方」もたくさん混ざっています。
それなのに、最後の答えが合ったというだけで、途中の寄り道まで全部まとめて「よくやった、次もこうしろ」と褒めてしまうため、ノイズだらけになる。だからカルパシーは、自動運転と同じように実務の信頼性を99パーセント、99.9パーセントへと埋めていく「9の行進」をやり切るには、まだアルゴリズムの根本的な刷新が3つも4つも必要で、真のエージェント完成にはあと10年かかると断言しました。
これに対して、同じ番組の別回(00:00:00〜、00:29:42〜)に出演したダリオ・アモデイは、真っ向から逆の立場をとっています。アモデイはこう語っています。
最も驚いているのは、私たちが「指数関数的成長のゴール」にいかに近づいているかについて、世間の認識が欠けていることだ。10年以内に私が「データセンター内の天才国家」と呼ぶ状態に到達するという基本仮説について、私は90パーセントの確率で起きると見ている。
そして、仕事をしながらモデル自身が学んでいく「継続学習」についても、今後1年から2年のうちに解決できる可能性が高い。
アモデイは、2017年に自身が書いた「巨大な計算塊の仮説」を引き合いに出し、細かいアルゴリズムの工夫よりも「計算量・データの量と質・学習時間・スケールする目的関数」を巨大に流し込めば、これまでの壁がすべて溶けてきたように、強化学習と長文脈の拡大だけで数兆ドル、日本円にして数百兆円規模の経済価値を生む段階に突入すると主張しているのです。
ここまでを一言でまとめるとこうです。カルパシーは「最後の結果だけで途中経過を丸ごと褒める今の強化学習はノイズだらけで、実務完成には10年かかる」と警告し、アモデイは「計算塊の拡大と今後1〜2年の継続学習の解決で、天才国家がすぐ目の前に迫っている」と賭けている、ということです。
第4章:私なりの解釈(構造変化の核心)
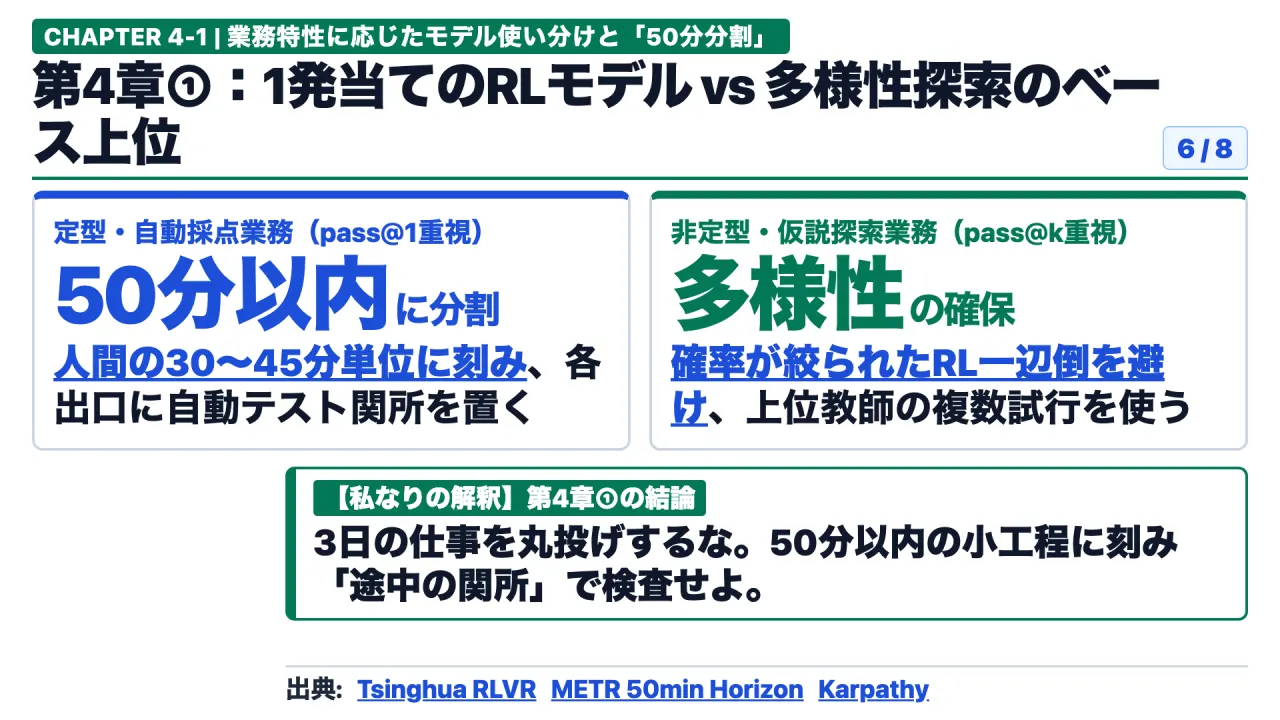
図6は放送時の説明資料(Slide 06)です。
ここからは、清華大のパス・アット・ケイ逆転論文、メトルの自律時間50分データ、そしてカルパシーとアモデイの対立を同じ物差しで並べて、私たちが明日から企業のシステム開発や業務自動化をどう設計すべきか、【私なりの解釈】を3つに整理します。
まず1つ目の解釈は、「『1発当ての定型業務』には強化学習モデルを使い、『誰も答えを知らない探索業務』にはあえて素に近い上位モデルや複数試行を使え」ということです。
清華大の論文が証明した通り、強化学習で鍛えた推論モデルは、1発目の正解率(パス・アット・ワン)が高い代わりに、考え方の幅が狭くなっています。だから、請求書の処理や定型コードの修正のように「1回で手堅く80点の正解を出してほしい日常業務」には、強化学習モデルや、上位モデルから蒸留した小型モデル(100万トークンあたり数十円〜数百円クラス)を使うのが大正解です。
しかし、新商品の企画や複雑なバグの原因調査のように「100通りの仮説を広く出してほしい探索業務」で強化学習モデルを使うと、毎回同じような無難な答えしか返ってきません。用途によって「確率を絞ったモデル」と「多様性を残したモデル」を使い分ける必要があります。
次に2つ目の解釈は、「社内ワークフローの1単位は、必ず『人間の50分以内』に刻み、途中に自動チェックの関所(プロセス検証)を置け」ということです。
メトルの論文が示した通り、最先端のエーアイでも、人間の50分を超える長い仕事を丸投げすると、成功率は50パーセント以下に急落します。さらにカルパシーが指摘した通り、最後の結果だけを見て良し悪しを判断させると、途中の間違った手順まで正当化して暴走します。
だからこそ、「3日かかるシステム改修」を丸ごと1つのプロンプトで頼むのではなく、人間なら30分から45分で終わる小さな単位に分割し、ステップごとにテストコードや型チェックという「途中の関所」を通過させる設計にしなければなりません。
第4章(後半):実務で機能する3層ハイブリッド設計
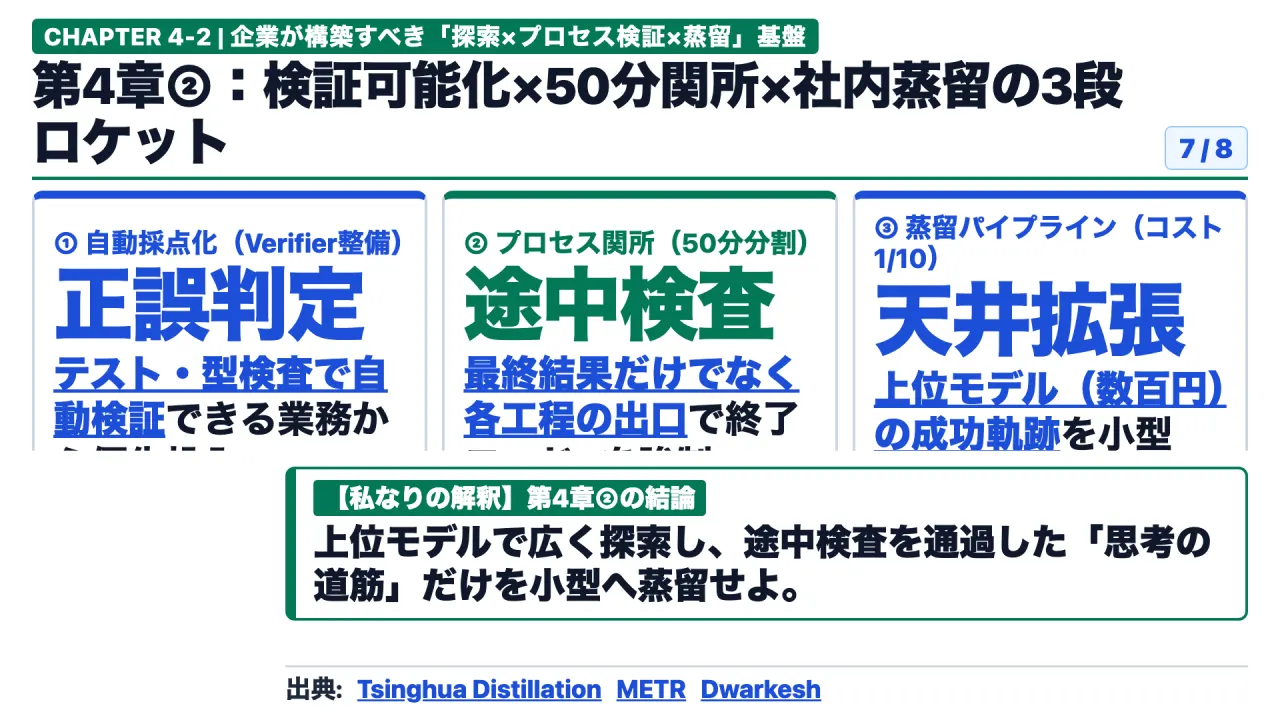
図7は放送時の説明資料(Slide 07)です。
そして3つ目の解釈は、「カルパシーの『10年論』とアモデイの『1〜2年論』は矛盾していない。モデルの知能は2年で頂点に達するが、会社の業務に組み込む『9の行進』に10年かかる」ということです。
アモデイが言う通り、データセンターの中の計算力だけで解ける数学やプログラミングの知能指数は、あと1〜2年で人間の専門家レベルに到達するでしょう。しかし、それを実際の銀行や工場や病院の業務に入れようとした瞬間、カルパシーが言う「99パーセントを99.99パーセントにする泥臭い例外処理(9の行進)」が始まります。
だからこそ、私たちが今から社内で準備すべき実装ステップは次の3つです。
1つ目は、社内の業務を「自動採点(テスト)ができる領域」と「人間が目利きする領域」に明確に仕分けし、自動採点できる領域から優先して自動化すること。2つ目は、1回のエーアイ呼び出しを「人間の作業30分〜50分相当」の粒度に制限し、ステップごとに決定論的な検証スクリプトを挟むこと。
そして3つ目は、高価な最先端モデル(1回あたり数百円〜数千円)が成功した「思考の道筋のログ」を社内に蓄積し、それを安価な小型モデルへ「蒸留」してコストを10分の1に落とすパイプラインを作ることです。
結論:明日から現場で試せる3つのアクション
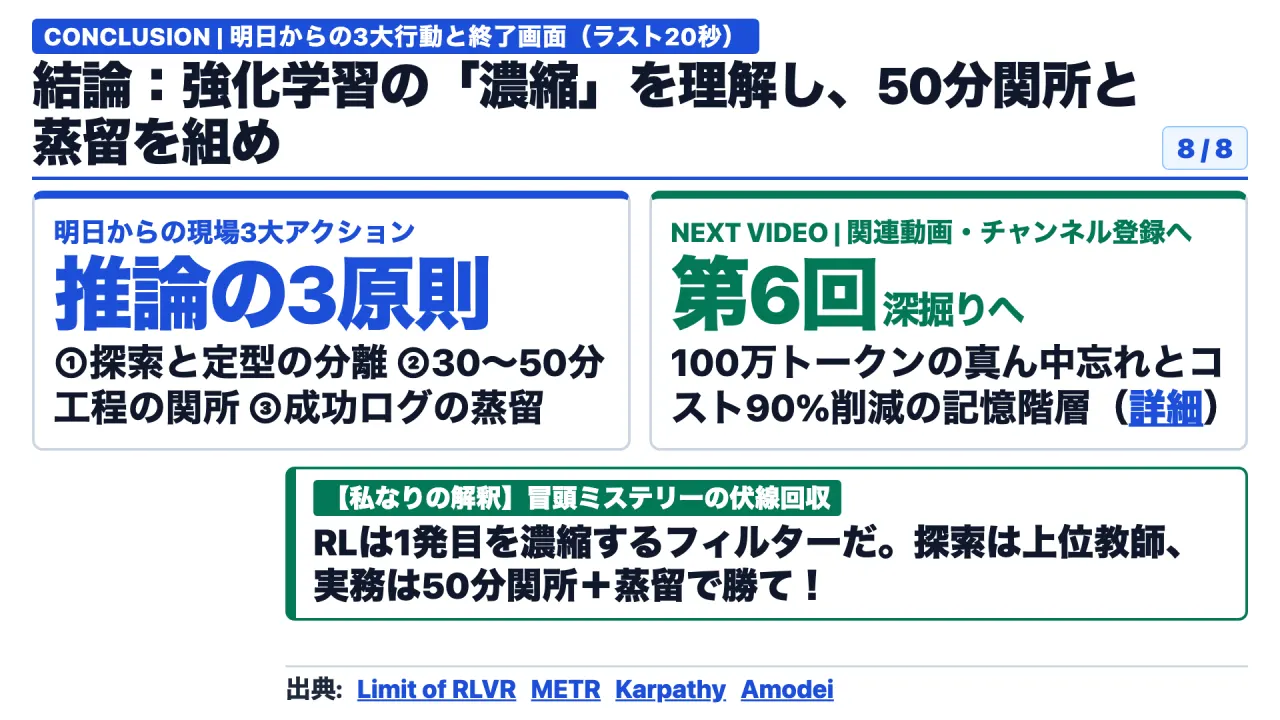
図8は放送時の説明資料(Slide 08)です。
では結論、なぜ強化学習で鍛えたはずの推論エーアイが100回試行すると元のモデルに負け、それでも自律作業時間が7ヶ月ごとに倍増しているのか。
今日の話を1枚に畳むとこうです。いまの強化学習は、ゼロから新しい知能を生む魔法ではなく、ベースモデルが元々持っていた知識の中から「1発目で正解を引く確率」を極限まで濃縮するフィルターだからです。
その濃縮のおかげで、最先端エーアイが1人でミスなく走り切れる時間は約50分まで伸びましたが、その引き換えに発想の広がりは狭くなり、最後の答えだけで途中経過を褒めるノイズの壁にぶつかっています。
その上で、私の見立てです。これから2年間で、「なんでも強化学習で鍛えれば解決する」というブームは一巡し、「巨大な上位モデルで多様な解法を探索させ、本当にうまくいった途中の手順だけを小型モデルへ『蒸留』して実務に配る」という2段構えのアーキテクチャが、企業のエーアイ活用の標準になります。
最後に、現場でシステム開発とコンサルティングを本業にしている人間として1つだけ。実は私自身も、毎日の開発やこの番組の自動ビルドでエーアイを動かすとき、1つのタスクを1時間以上丸投げすることは絶対にしません。
必ず「情報収集」「事実照合」「音声合成」「画面検査」というように、人間なら30分程度で終わる小さな工程に分け、それぞれの出口でプログラムによる自動検査(終了コード0の確認)を通過してから次に進むように組んでいます。「最後の結果だけを見ず、途中の関所でストローの詰まりを検査する」、これだけで手戻りはほぼゼロになります。
みなさんはどう見ますか。カルパシーの「実務で使えるエージェントにはあと10年かかる」という見方と、アモデイの「1〜2年で継続学習まで解けて天才国家ができる」という見方、現場の肌感覚としてどちらに近いか、よかったらコメントで聞かせてもらえれば嬉しいです。
また、いま画面に表示されている第6回の関連動画では、「100万トークンの記憶力を持つエーアイがなぜ真ん中の情報を忘れるのか、トークン代を90パーセント削る記憶階層の科学」をさらに詳しく解説していますので、ぜひ続けてご覧ください。それでは、また次回の放送でお会いしましょう。
参照した海外一次資料・出典リンク一覧
- Tsinghua University (Yang Yue et al.): Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? (arXiv:2504.13837)
- METR (Thomas Kwa et al.): Measuring AI Ability to Complete Long Software Tasks (arXiv:2503.14499)
- Dwarkesh Podcast: Andrej Karpathy — AGI is still a decade away
- Dwarkesh Podcast: Dario Amodei — “We are near the end of the exponential”
この記事は、ポッドキャスト放送回(2026-10-24-deep-dive)の台本と一次資料をもとに再構成しました(確認日:2026年10月20日)。