「最新LLM徹底比較:OpenAI・Anthropic・Google 3大モデル対DeepSeek・GLM・Kimi・Qwen・Meta Muse・MiniMax M3.1 Flash」——公式ベンチマーク・単価・初答17.41秒の速度差・個人情報保護法第28条で選ぶ実務ガイド
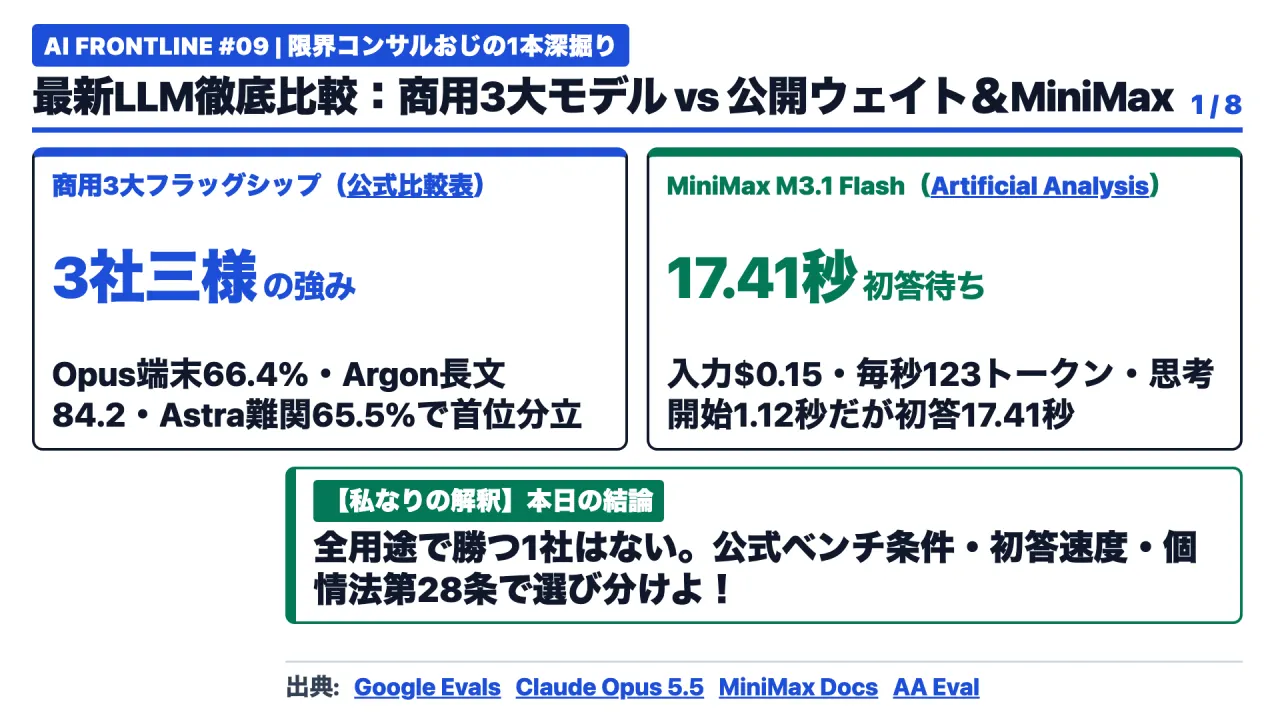
図1は放送時の説明資料(Slide 01)です。
今日は「いま毎週のように登場している最新のエーアイモデルの中で、結局どのモデルがどんな仕事に強くて、いくらかかり、どんな落とし穴があるのか」を、公式発表と一次ドキュメントだけで真っ正面から徹底比較する回です。OpenAIのGPT-6、Anthropicのクロード・ごーてんご、Googleのジェミニ・フォーという商用3大モデルから、ディープシーク、ジーエルエム、キミ、クウェン、メタ・ミューズ、そして最新のミニマックス・エム・スリー・ポイント・ワン・フラッシュまで、名前が多すぎて違いがわからないという方も多いはずです。
いきなりですけど、クイズを1つ。いま最新モデルの公式比較表を見たとき、「すべてのテストで1位を独占している最強の1社」は存在すると思いますか。
答えは、1社も存在しません。Googleが公開している公式比較表と評価方法のドキュメントやAnthropicの公式発表を照らし合わせると、ターミナル操作を伴う開発テストではClaude Opus・ごーてんごが66.4パーセントでトップに立ち、長文のグラフ探索ではジェミニ・フォー・アルゴンが84.2で突き抜け、科学・難関ソフトウェア評価ではGPT-6 Astraが65.5パーセントでリードしています。
さらに、最新の独立評価機関アーティフィシャル・アナリシスの速度測定を見ると、入力0.15ドルと超低価格なミニマックス・エム・スリー・ポイント・ワン・フラッシュは、考え始めるまでの時間は1.12秒なのに、最初の回答が出始めるまでには17.41秒かかるという特徴があります。だから今日の問いはこうです。
商用3大モデルと公開ウェイト・低価格APIモデル群は、それぞれ何が強みで何が弱みなのか、そして私たちは明日からどう選び分ければいいのか。
改めまして、みなさんお元気ですか。「限界コンサルおじ」です。
普段は金融から製造業まで、コンサルティングからシステム開発、さらにはエーアイの追加学習まで、プロジェクト完成のためにはなんでもやる現場人間です。世界の最先端研究と公式ドキュメントから、現場のリアルを独自の視点で解説します。
さて、第9回となる本日のテーマは、「最新エルエルエム徹底比較、OpenAI・Anthropic・Google3大モデル対ディープシーク・ジーエルエム・キミ・クウェン・メタ・ミューズ・ミニマックス公式ベンチマークと、単価・初答17.41秒・個人情報保護法第28条で選ぶ実務ガイド」です。
前提の整理と全体の見取り図(何をすべきかの全体像)
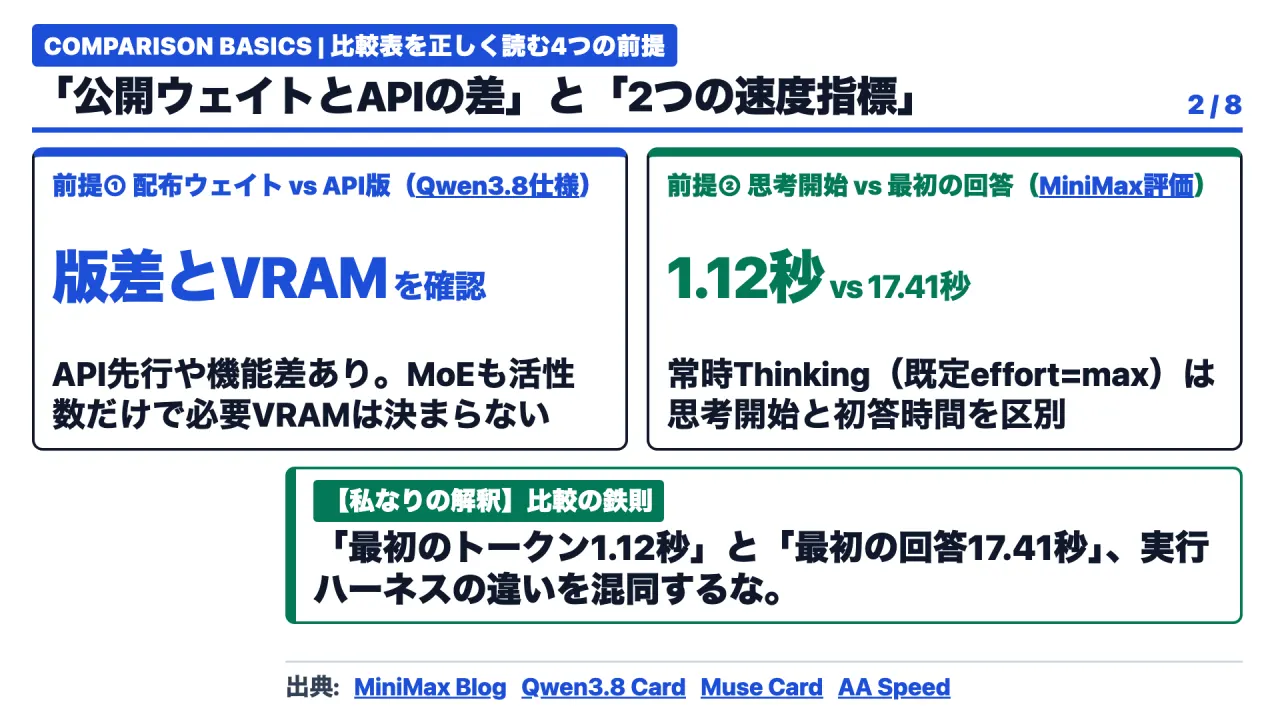
図2は放送時の説明資料(Slide 02)です。
本題に入る前に、モデル比較表を読むうえで絶対に外せない「4つの言葉の整理」をしておきます。
1つ目は、「公開ウェイト(オープンウェイト)」と「エーピーアイ専用モデル」の違いです。公開ウェイトとは、モデルの重みデータが配布されていて、自社のサーバーにダウンロードして動かせるモデルのことです。
ただし、たとえばミニマックス・エム・スリー・ポイント・ワン・フラッシュの公式発表のように「現在はエーピーアイで提供中で、重みデータは後日公開予定」というモデルや、クウェン・スリー・ポイント・エイトの公式カードのように「エーピーアイ版と公開ウェイト版で画像対応などの機能が違う」ケースがあるため、この2つは厳密に分けて見る必要があります。
2つ目は、「総パラメータ数」と「活性パラメータ数(エムオーイー)」の違いです。たとえば8,160億個の脳細胞を持っていても、1回の返事で420億個しか動かさない省エネ設計をエムオーイーと呼びます。
ただし「420億個しか動かないから420億個分の小さなメモリで動く」わけではなく、待機している全体の重みを載せるメモリが必要です(Meta Museモデルカード)。
3つ目は、「最初のトークンまでの時間(TTFT)」と「最初の回答トークンまでの時間」の違いです。必ず下書きを考えてから答える「常時シンキング」のモデルは、思考が始まるまでの秒数と、思考を終えて実際の回答が表示され始めるまでの秒数がまったく違います(Artificial Analysis速度測定)。
そして4つ目が、「評価ハーネス(実験道具)の違い」です。同じ名前のベンチマークでも、モデルに持たせる道具(ツール)の有無や実行プログラムが違えば点数は変わるため、条件を揃えて読むことが大切です(Google評価方法ドキュメント)。
今日の進み方です。まず第1章で、OpenAI、Anthropic、Googleの商用3大フラッグシップを公式比較表と単価で比べます。
次に第2章で、ディープシーク、ジーエルエム、キミ、クウェン、メタ・ミューズ、ジェマ、ネモトロン、そしてミニマックス・エム・スリー・ポイント・ワン・フラッシュの仕様と速度・制約を整理します。第3章で研究者たちの一次発言と、商用エーピーアイ蒸留禁止や個人情報保護法第28条の注意点を確認し、第4章と結論で業務別の選び方をまとめます。
第1章:海外一次データが示す現場の変化
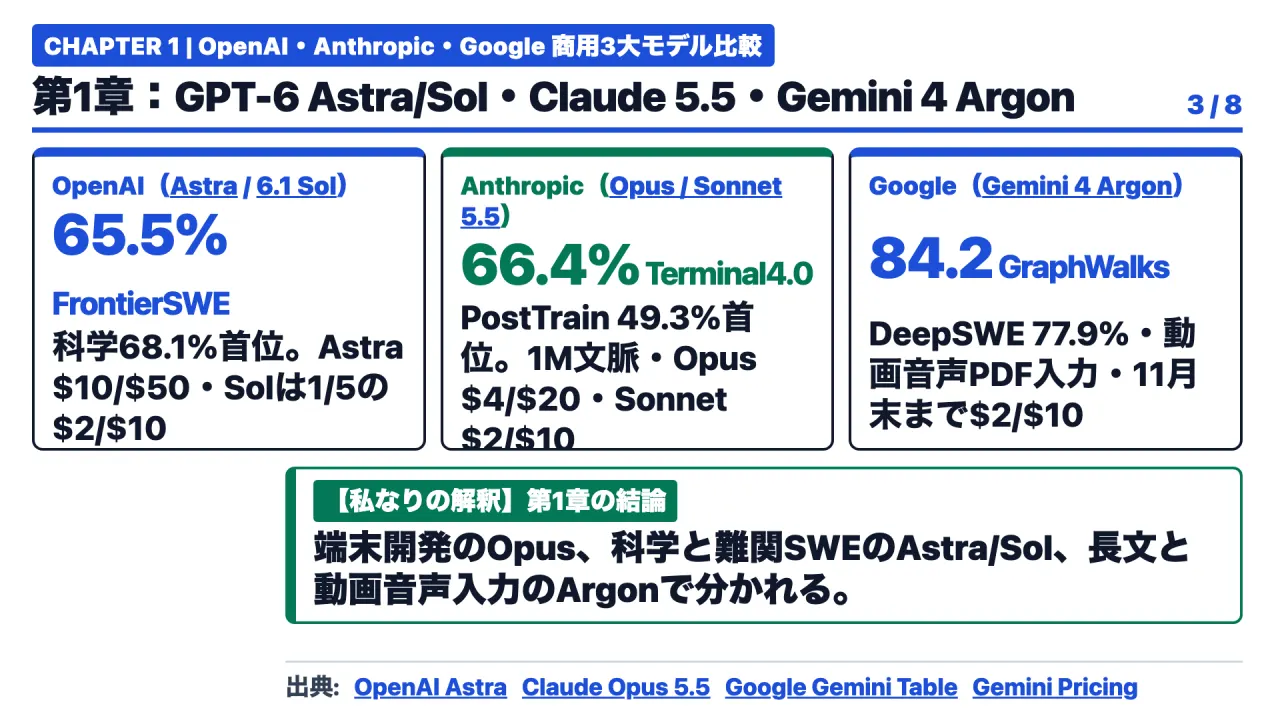
図3は放送時の説明資料(Slide 03)です。
まず第1章、OpenAI、Anthropic、Googleの商用3大モデルについて、強みと弱み、そして公式ベンチマークと料金を横並びで見ていきます。
1社目はOpenAIです。現行の主力は、最上位の「GPT-6 Astra」と、通常用途向けの「GPT-6・ポイント・ワン・ソル(GPT-6.1 Sol)」です(GPT-6 Astra公式発表、GPT-6.1 Sol公式発表)。
アストラの強みは、難易度の高いソフトウェア課題と科学推論です。Googleが公表している公式比較表でも、フロンティア・エスダブリューイー・ブイツー(FrontierSWE v2)で65.5パーセント、ターミナル・ベンチ・サイエンスで68.1パーセントと3社の中でトップの成績を出しています。
一方、100万トークンあたりの標準料金はアストラが入力10ドル・出力50ドルと高価ですが、弟分のソルは入力2ドル・出力10ドル(キャッシュ読取0.10ドル)とアストラの5分の1の単価に抑えられています。またOpenAIは、Apache 2.0ライセンスで自己配置できるテキストモデル「ジーピーティー・オーエスエス(gpt-oss 120b/20b)」も別枠で案内しています(OpenAI gpt-oss公式案内)。
2社目はAnthropicです。現行の主力は「Claude Opus・ごーてんご(Claude Opus 5.5)」「ソネット・ごーてんご(Sonnet 5.5)」「ハイク・ごーてんご(Haiku 5.5)」、そして最上位価格帯の「フェイブル・ごーてんいち(Fable 5.1)」です(Claude Opus 5.5公式発表、Claudeモデル仕様一覧)。
現行の4モデルはいずれも100万トークンの入力枠(1M文脈)と最大12万8,000トークンの出力に対応しています。オーパス・ごーてんごの最大の強みは、コマンド画面を操作しながら開発を進めるターミナル・ベンチ4.0で66.4パーセント(アストラは57.9〜58.2パーセント、アルゴンは57.4パーセント)と頭一つ抜けている点、そして10時間かけてモデル訓練作業を行わせるポスト・トレイン・ベンチ(PostTrainBench v1.1、全モデル共通でOpenCodeとH100を1基使用)でも49.3パーセントと最も高い点です。
標準料金は100万トークンあたり、オーパス・ごーてんごが入力4ドル・出力20ドル(キャッシュ読取0.20ドル)、ソネット・ごーてんごが入力2ドル・出力10ドル、フェイブル・ごーてんいちが入力10ドル・出力50ドルです。注意点として、オーパスの一部の評価には安全機構が作動した際に旧モデルへ切り替わるフォールバックが含まれること、また入力はテキストと画像であり音声や動画の直接入力には対応していないことが挙げられます。
3社目はGoogleのフラッグシップ「ジェミニ・フォー・アルゴン(Gemini 4 Argon)」です(Gemini 4 Argon公式仕様、Gemini料金表)。
アルゴンの強みは、テキスト・画像・動画・音声・PDFをすべて直接入力できるマルチモーダル性能と、超長文の探索力です。25万6,000から100万トークンの長文グラフを探索するグラフ・ウォークス(GraphWalks)では、84.2 F1(アストラは71.8、オーパスは66.8)と圧倒的なスコアを記録し、ディープ・エスダブリューイー(DeepSWE v1.1、mini-swe-agent使用)でも77.9パーセントを出しています。
料金は11月30日までの導入価格として入力2ドル・出力10ドル(以降は入力4ドル・出力20ドルの予定)です。一方の制約として、フロンティア・エスダブリューイー(55.0パーセント)やターミナル・ベンチ4.0(57.4パーセント)ではアストラやオーパスを下回ること、また現時点で明示的なキャッシュ機能やライブエーピーアイには非対応である点が公式ドキュメントに明記されています。
この章を一言でまとめます。商用3大モデルは「ターミナル操作と自律開発に強いClaude Opus・ごーてんご」「難関ソフトウェアと科学推論に強いGPT-6 Astraと5分の1単価のソル」「音声・動画・PDF入力と100万トークン長文探索に強いジェミニ・フォー・アルゴン」と得意分野が明確に分かれている、ということです。
第2章:技術的・構造的な仕組みと落とし穴
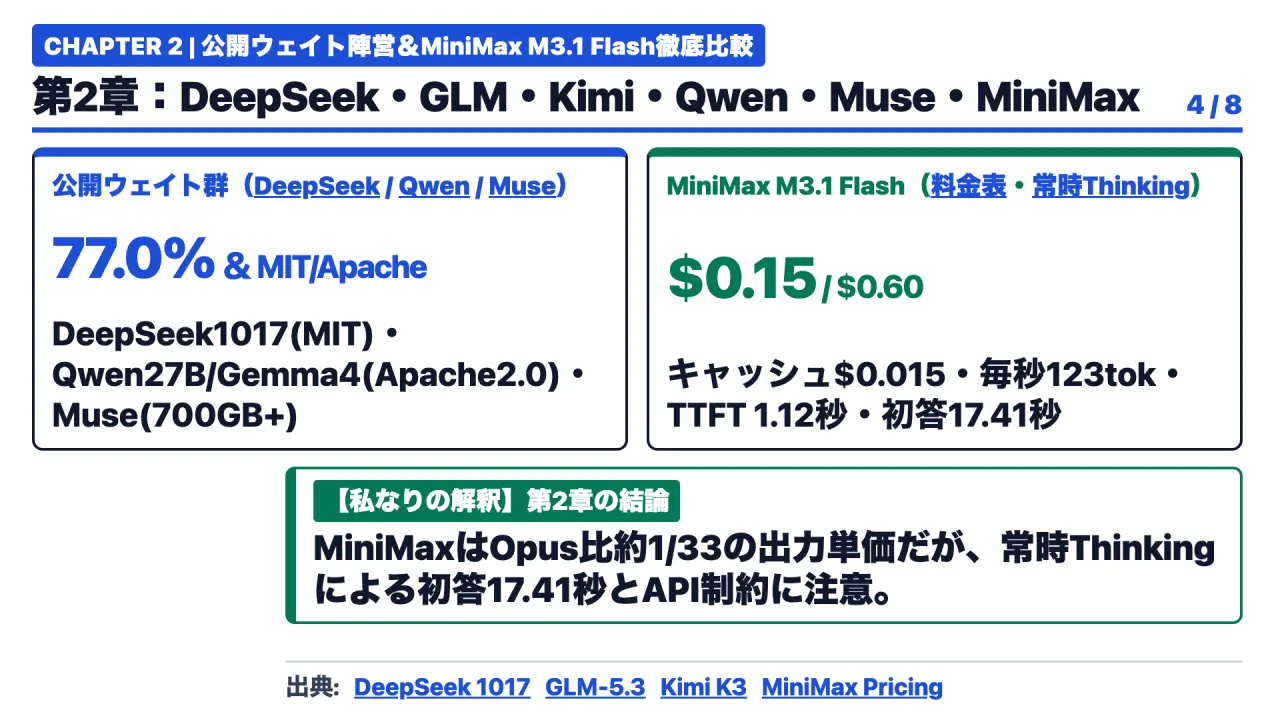
図4は放送時の説明資料(Slide 04)です。
次に第2章、公開ウェイト陣営と最新の低価格推論エーピーアイである「ミニマックス・エム・スリー・ポイント・ワン・フラッシュ」の仕様と注意点を比較します。
1つ目は、「ディープシーク・ブイ・フォー・ポイント・ワン・フラッシュ・1017(DeepSeek-V4.1-Flash-1017)」です(Hugging Face公式カード、DeepSeek料金表)。
商用利用や改変が自由なエムアイティー(MIT)ライセンスで公開されており、100万トークン文脈と画像入力に対応しています。公表値ではディープ・エスダブリューイー(Mini-SWE-V2使用)で77.0パーセント、ターミナル・ベンチ4.0(Claude Code使用)で42.3パーセントを記録しています。
エーピーアイ料金も閑散時間帯とピーク時間帯に応じて入力0.15から0.30ドル、出力0.60から1.20ドルと極めて安価です。技術上の注意点として、標準のチャットテンプレート(Jinja)を同梱せず専用のエンコード実装を使う仕様になっています。
2つ目は「ジーエルエム・ごーてんさん(GLM-5.3)」、3つ目は「キミ・ケイスリー(Kimi K3)」です(GLM-5.3モデルカード、Kimi K3モデルカード)。
ジーエルエム・ごーてんさんはディープ・エスダブリューイーで66.9パーセントを公開していますが、ライセンス表示は前世代のエムアイティーではなく独自の「glm-5.3」表記となっている点に注意が必要です。キミ・ケイスリーは総パラメータ数2兆8,000億(活性1,040億)の超巨大モデルで、ディープ・エスダブリューイーで67.5パーセント、大学院レベルの科学問題ジーピーキューエー(GPQA)で93.5パーセントという高い公表値を持ちますが、独自ライセンスであり、個人のパソコン用GPUでそのまま動かせるサイズではありません。
4つ目はアリババの「クウェン・スリー・ポイント・エイト(Qwen3.8)」系列と、Googleの公開モデル「ジェマ・フォー(Gemma 4)」です(Qwen3.8-2.4T-A95B、Qwen3.8-27B、Gemma 4カード)。
大型の「クウェン3.8・2.4T(活性95B)」は独自ライセンスで公開されていますが、公式ベンチマーク表は画像対応などが追加されたエーピーアイ版(Qwen3.8-Max)の数値であるため、配布ウェイト版と同一視してはいけません。一方、手元のサーバーに配置しやすい中型モデルとしては、Apache 2.0ライセンスで画像・動画に対応する「クウェン3.8・27B(GPQA 89.2パーセント)」や、同じくApache 2.0で2Bから31Bまで揃い小型版で音声入力も可能な「ジェマ・フォー(31BのGPQA 84.3パーセント、文脈128K〜256K)」が有力な候補になります。
5つ目は、メタ社の「ミューズ・スパーク・オープン(Meta Muse Spark Open)」と、NVIDIAの「ネモトロン・スリー・ウルトラ(Nemotron 3 Ultra)」です(Meta Museブログ、Meta Museモデルカード、Nemotron 3 Ultraカード)。
メタ・ミューズは8,160億総パラメータ(活性420億)でテキスト・画像・動画・音声入力に対応し、ハルシネーションを厳しく罰する知識指標で高い正確性を示しますが、公式カード上の推奨メモリは4ビット(NVFP4)でも少なくとも700ギガバイトVRAM、BF16では2テラバイトと大きく、独自のミューズ・ライセンス(一定規模での別契約条項や表示義務)が適用されます。ネモトロン・スリー・ウルトラ(5,500億、活性550億)もBF16ではH100が16基またはH200が8基という公式要件が明記されています。
そして6つ目、10月19日に発表された注目モデルが「ミニマックス・エム・スリー・ポイント・ワン・フラッシュ(MiniMax M3.1 Flash)」です(MiniMax公式発表、MiniMax公式料金表、MiniMax Thinkingガイド)。
現在はエーピーアイで提供されており、ウェイトは後日公開予定です。100万トークン文脈と画像・動画入力に対応し、公式自己評価ではディープ・エスダブリューイーで73.7パーセント、金融ツール評価(BankerToolBench)で76.2を公表しています。
最大の特徴は料金と推論仕様です。公式料金表での単価は100万トークンあたり入力0.15ドル(約22.5円)・出力0.60ドル(約90円)・キャッシュ読取0.015ドル(約2.25円)と、オーパス・ごーてんごの出力単価(20ドル)の約33分の1、ソルの出力単価(10ドル)の約16.7分の1です。
ただし仕様として「常時シンキング(Thinking無効化不可、disabled指定は400エラー)」で、初期設定の思考量(effort)が最大の「max」になっています。
そのため、アーティフィシャル・アナリシスの独立比較測定(総合指数43点、AutomationBench-AA 73パーセント)では、生成開始後の出力速度は毎秒123トークン(提供元公称は日常200トークン以上)、思考が始まる最初のトークンまでの時間(TTFT)は1.12秒と速い一方、深い思考を終えて最初の回答トークンが出るまでには17.41秒かかっています。また、温度パラメータ(temperature=1、top_p=0.95固定)やツール選択(tool_choiceはautoのみ)などのAPI制約(MiniMax Messages API仕様)があるため、URLを書き換えるだけで他社APIと完全互換になるわけではありません。
第3章:海外ポッドキャストの肉声と実務の壁
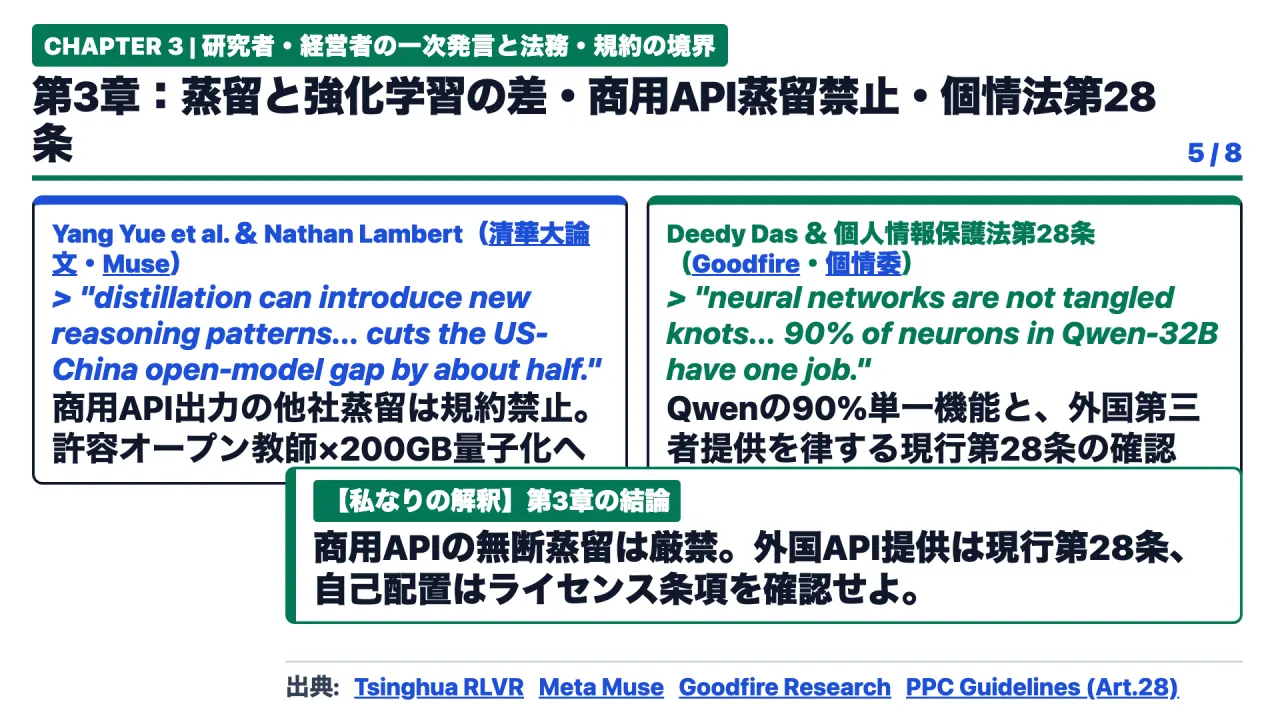
図5は放送時の説明資料(Slide 05)です。
続いて第3章です。これらのモデルをカスタマイズしたり社内に導入したりする際の技術的・法務的な境界線について、一次論文と研究者の発言から確認します。
まず、自社で公開ウェイトモデルを追加学習して賢くしたい場合、清華大学のヤン・ユエらの研究チームが発表した強化学習と蒸留に関する一次論文(arXiv:2504.13837)が重要な指針を示しています。論文の要旨を引用します。
強化学習で鍛えたモデルは、1回勝負のパス・アット・ワンでは元のベースモデルを上回るが、試行回数ケイを大きくすると、鍛える前の素のベースモデルの方が高いスコアを達成する。対照的に、より賢い教師モデルからの「蒸留」は、新しい推論パターンを導入し、モデルの推論能力の境界を真に拡張できることが判明した。
ここで実務上もっとも重要なルールが「商用エーピーアイからの無断蒸留は禁止されている」という点です。OpenAI、Anthropic、Googleの商用エーピーアイはすべて、その出力結果を使って他社モデルや公開ウェイトモデルを蒸留・訓練することを規約で禁止しています。
したがって、蒸留を行う場合は、エムアイティーやApache 2.0などライセンスで出力活用が認められた上位のオープンモデルを教師にするか、自社の独自データで学習させる必要があります。
また、公開ウェイトモデルのライセンスとローカル稼働について、研究者のネイサン・ランバート(Nathan Lambert)と、Hugging Faceの最高経営責任者クレマン・ドゥラング(Clement Delangue)は、メタ社のミューズ・スパーク・オープン公開時にそれぞれこう述べています。
ミューズ・スパーク・オープンの公開は、米中のオープンモデルの性能差を約半分に縮めた。しかし、そのライセンス条項は厳しい。
オープンソースの周辺ツールの進化の速さには驚かされる。ラマ・シーピーピーは初日から軽量化形式をサポートし、コミュニティの量子化版はすでに市販のワークステーション上で200ギガバイト以下で動いている。
さらに、グッドファイア・エーアイのニック・カマラタ(Nick Cammarata)らの研究について、投資家のディーディー・ダス(Deedy Das)はこう評しています。
これは極めて重要な成果だ。ニューラルネットワークはもつれた結び目ではなく、モデルの脳細胞を直接研究できる。
クウェン・さんじゅうにビーの90パーセントの脳細胞は単一の役割しか持っていない。
そして法務面でもう1つ、日本企業が海外のエーピーアイへ個人データを提供する際に参照すべき条文は、個人情報保護委員会のガイドラインが定める現行の個人情報保護法第28条(外国にある第三者への提供の制限)です。古い記事にある「第24条」は改正前の条文番号なので、社内稟議では必ず現行の第28条を参照し、提供先の体制確認や同意要件を満たすか、あるいはApache 2.0やエムアイティーの公開モデルを社内環境へ自己配置するかを判断してください。
第4章:私なりの解釈(何をすればいいか:構造変化の核心)
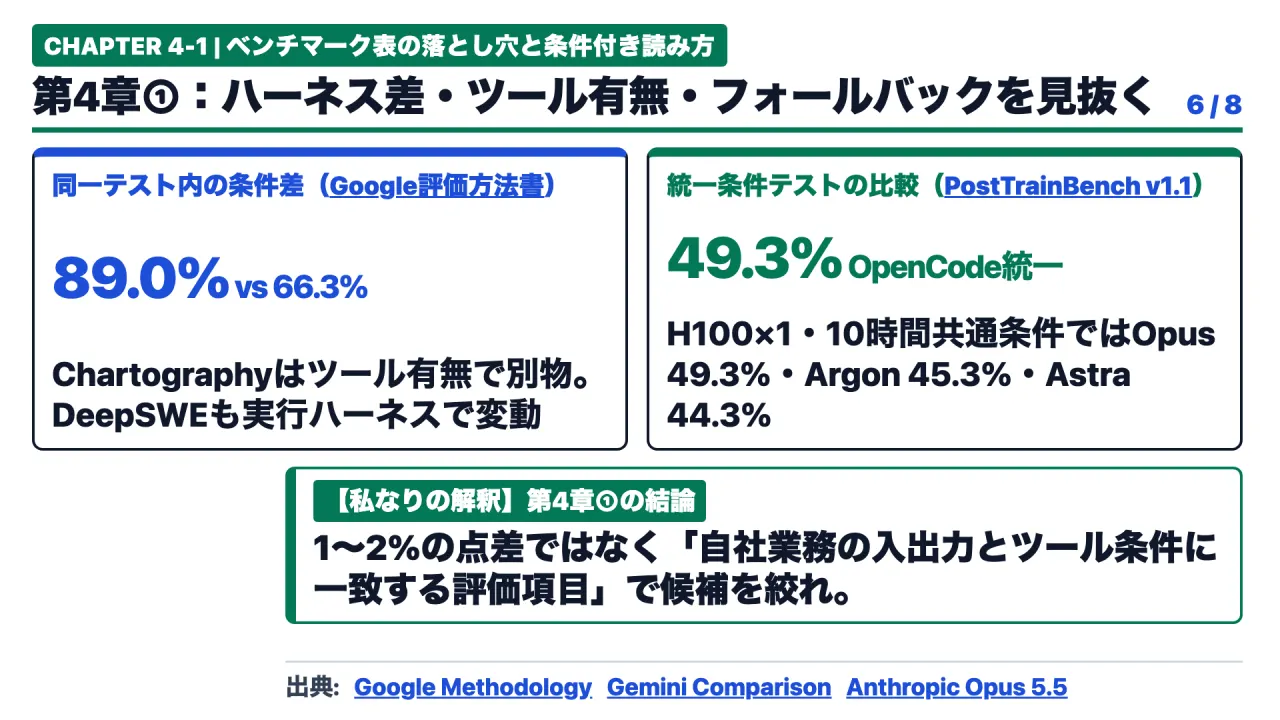
図6は放送時の説明資料(Slide 06)です。
ここまでの公式データをもとに、第4章ではベンチマーク表を読む際の注意点と、実務での選び方に関する【私なりの解釈】を3つお話しします。
まずスライド6を見てください。1つ目の解釈は、「ベンチマークの数字は『どのハーネス(実行プログラム)とツール条件で測ったか』をセットで見なければならず、総合1位という幻想を捨てるべきだ」ということです。
たとえばGoogleの評価方法ドキュメントやAnthropicの公式発表を細かく照合すると、同じモデルでも発表元によって数字が微妙に異なります。GPT-6 Astraのターミナル・ベンチ4.0は、OpenAI発表では57.9パーセント、Googleの表では58.2パーセントです。
また図表読解のチャートグラフィー(Chartography)では、Googleの表にある「ツールなし条件」だとオーパス・ごーてんごは66.3パーセントですが、Anthropic発表の「ツールあり条件」では89.0パーセントになります。さらに、ディープシークのディープ・エスダブリューイー77.0パーセントは「Mini-SWE-V2」という環境で測られており、アルゴンの77.9パーセント(mini-swe-agent使用)とは実行環境が異なります。
つまり、1〜2パーセントの点差で「こっちが世界1位だ」と騒ぐのは意味がありません。
-
ターミナル操作や複数ファイルの長期コード改修なら、ターミナル・ベンチ4.0(66.4パーセント)とポスト・トレイン・ベンチ(49.3パーセント)で優位なClaude Opus・ごーてんご、または科学・難関ソフトウェア(FrontierSWE v2で65.5パーセント)に強いGPT-6 Astra(および単価5分の1のソル)。
-
音声・動画・PDFを含むマルチモーダル処理や100万トークンの長文探索なら、グラフ・ウォークスで84.2 F1を出しているジェミニ・フォー・アルゴン。
このように「自社の業務に一番近いテスト条件で強いモデル」を候補にするのが正しい読み方です。
【実践・深掘りパート:具体的やり方・試行錯誤の記録】実務で機能する3層ハイブリッド設計
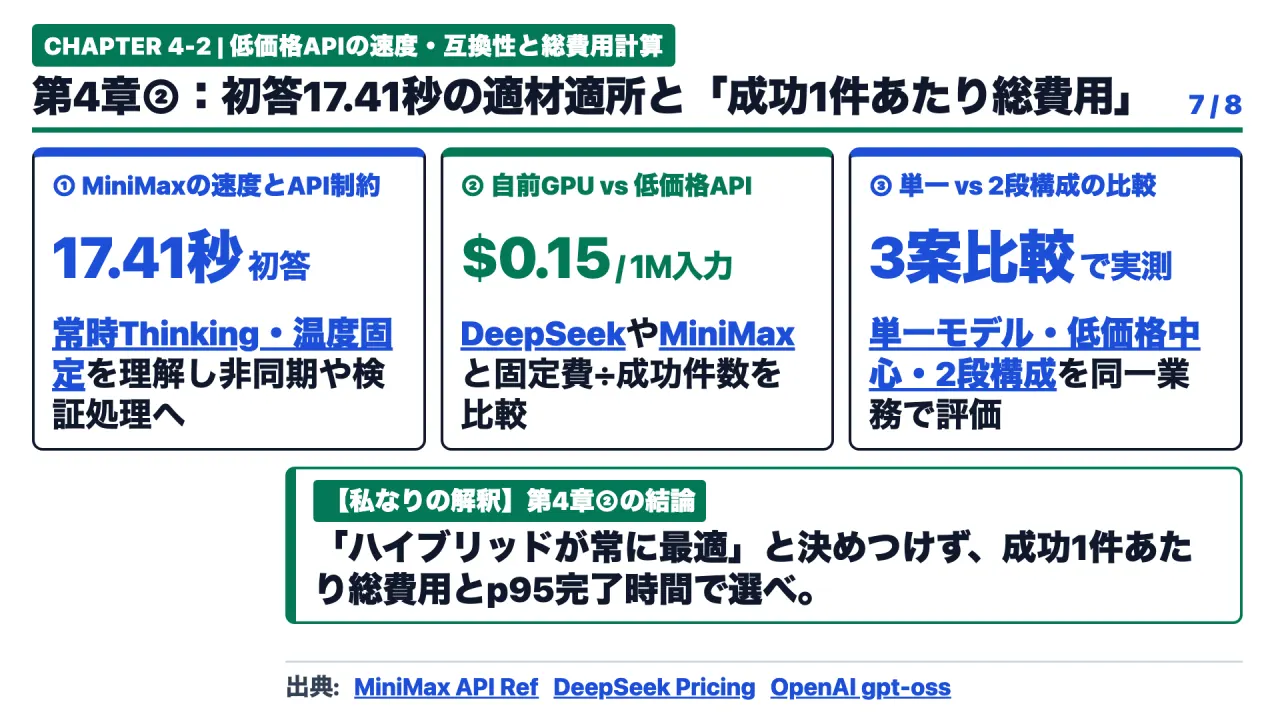
図7は放送時の説明資料(Slide 07)です。
次に2つ目の解釈は、「ミニマックス・エム・スリー・ポイント・ワン・フラッシュやディープシークのような低価格モデルは、『トークン単価』だけでなく『初答までの17.41秒』と『API仕様の制約』を踏まえて適材適所で使うべきだ」ということです。
ミニマックスの公式料金表にある通り、入力0.15ドル・出力0.60ドル・キャッシュ読取0.015ドルという単価は、商用フラッグシップの16分の1から33分の1という破格の安さです。ディープシーク・1017も入力0.15〜0.30ドルでエムアイティー・ライセンスという高い自由度を持っています。
ただし、独立評価で確認された通り、ミニマックスは常時シンキング(既定effort=max)であるがゆえに、思考開始(TTFT)は1.12秒でも、最初の回答トークンが出るまでには17.41秒かかります。また温度パラメータ固定やtool_choiceがautoのみといったAPI仕様の違いもあります。
したがって、「リアルタイムの接客画面だからとにかくFlashと名のつくモデルを入れよう」といった決め方ではなく、まずは思考量(effort)の設定調整やツールループの挙動を自社の検証環境でテストし、17秒の思考時間が許容されるコード修正やデータ処理・ツール連携タスクで費用対効果を測るのが最も賢い使い方です。
そして3つ目の解釈は、「『公開ウェイトなら常に安い』『ハイブリッド構成なら常に最適』という思い込みを捨て、成功1件あたりの総費用で比べるべきだ」ということです。
公開ウェイトを自社GPUで動かす場合、モデルの重みだけでなく計算用のキャッシュメモリや電気代・運用人件費がかかります。稼働率が低ければ、100万トークン0.15ドルのAPIを使う方が圧倒的に安くなります。
また、上位モデルと低価格モデルを組み合わせる2段構成(ハイブリッドやルーティング)も有力な選択肢ですが、モデル間の受け渡しや再試行・監視の仕組みが増えるため、小規模な業務では単一モデル(ソルやソネット、アルゴン)でプロンプトキャッシュを効かせる方が総費用が安くなるケースもあります。
結論:現場で実際に試してつまずいた箇所・修正手順と明日からの3大アクション
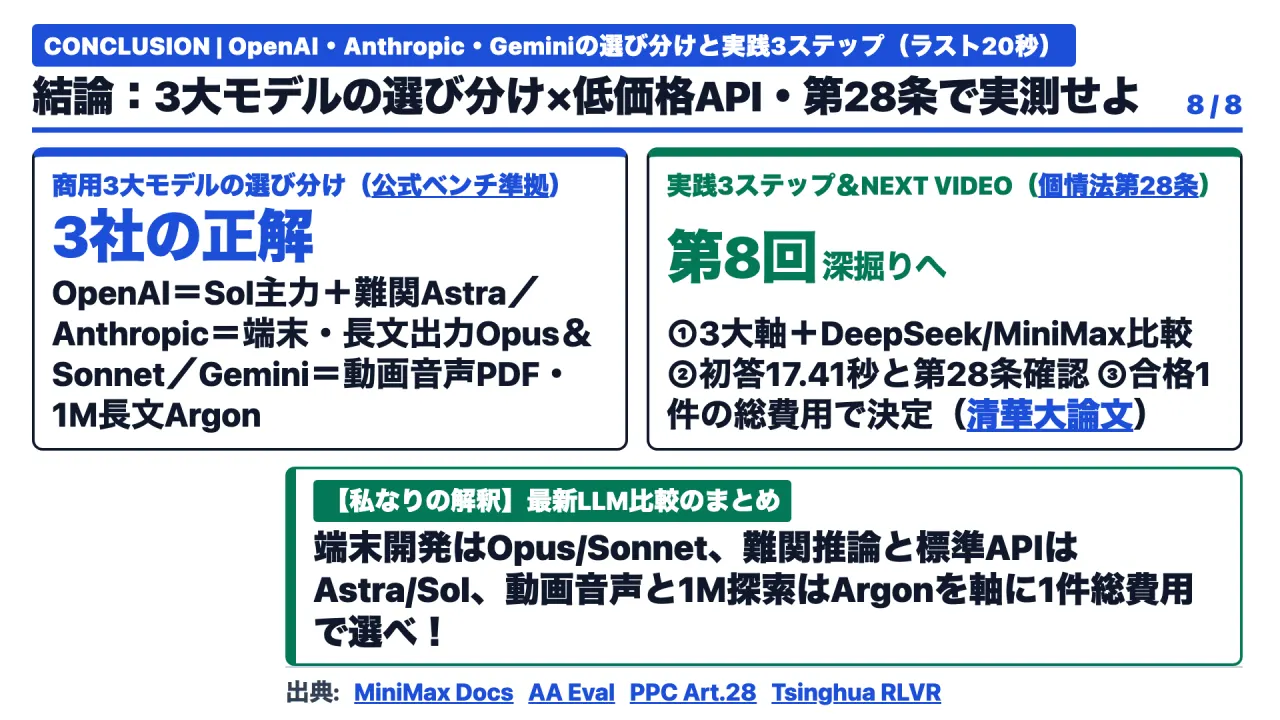
図8は放送時の説明資料(Slide 08)です。
最後に結論です。「もし商用3大モデル、OpenAI、Anthropic、Googleのジェミニの中から選ぶなら、結局どう使い分けるべきか」という問いへの明確な回答と、明日からの実践3ステップをお伝えします。
まず、商用3大陣営のどこを軸にすべきかの結論はこうです。
1つ目、「OpenAIを選ぶべきケース」は、難関ソフトウェア開発や科学・数理推論を解き切りたいとき、そして上位モデルと量産モデルを同じAPI体系で揃えたいときです。普段の本番運用は入力2ドル・出力10ドル・キャッシュ読取0.10ドルのGPT-6・ポイント・ワン・ソル(GPT-6.1 Sol)を主力にし、ソルで解けない最難関の設計・科学推論(FrontierSWE v2で65.5パーセント、科学68.1パーセント)だけをGPT-6 Astraに昇格させ、社内閉域網にはApache 2.0のgpt-ossを置く構成が最も合理的です。
2つ目、「Anthropicを選ぶべきケース」は、ターミナル操作や複数ファイルにまたがる自律コーディング、そして100万トークン入力と最大12万8,000トークンの長大な一括出力が必要なときです。日常の実装やレビューは入力2ドル・出力10ドルのクロード・ソネット・ごーてんご(Sonnet 5.5)で回し、ターミナル・ベンチ4.0で66.4パーセント・ポスト・トレイン・ベンチで49.3パーセントと首位のClaude Opus・ごーてんご(Opus 5.5)を難所のリファクタリングや自律エージェントの司令塔に据えるのが王道です。
3つ目、「Google(Gemini)を選ぶべきケース」は、音声・動画・画像・PDFを直接読み込ませるマルチモーダル業務や、25万から100万トークンの巨大資料群を横断探索するときです。グラフ・ウォークスで84.2 F1と突き抜けているジェミニ・フォー・アルゴン(Gemini 4 Argon)(11月30日まで入力2ドル・出力10ドル)をマルチモーダル・長文解析の主軸にし、社内サーバーへ自己配置したい場合はApache 2.0のジェマ・フォー(Gemma 4)を組み合わせます。
そのうえで、公開ウェイトや低価格APIも含めて明日から現場で進める3つのステップです。
-
ステップ1:いま挙げた3大モデルの軸(ソル、ソネット・オーパス、アルゴン)を基準点(ベースライン)としてまず1つ決め、そこに低価格API候補のディープシーク・1017やミニマックス・エム・スリー・ポイント・ワン・フラッシュ、または自己配置候補のクウェン3.8・27Bを対抗馬として並べます。
-
ステップ2:速度を見るときは「思考開始(TTFT 1.12秒)」と「最初の回答(17.41秒)」を分けて計測し、海外API利用時の個人情報保護法・現行第28条や商用APIの蒸留禁止規約を確認します。
-
ステップ3:自社の同じ業務テストで、3大モデルの単一運用と低価格モデルの組み合わせを走らせ、「合格した成果物1件あたりの総費用」と「95パーセンタイル完了時間」を実測して最終決定します。
今日の話を一言でまとめるとこうです。
すべての用途で勝つ万能モデルは存在しません。「端末と自律開発のAnthropic(オーパス・ソネット)」「難関コードと科学推論+5分の1単価ソルのOpenAI」「動画・音声・PDFと100万トークン長文探索のジェミニ・フォー・アルゴン」、そして「超低単価・常時思考のミニマックスやMITライセンスのディープシーク」、それぞれの公式仕様と初答速度、第28条の境界線を並べて実測することこそが、モデル選びで失敗しない唯一の近道です。
また、いま画面に表示されている第8回の関連動画では、「清華大学が実証した強化学習パス・アット・ケイの逆転現象と、50分間の自律タスクを完遂させるハーネス設計」を詳しく解説していますので、ぜひ続けてご覧ください。それでは、また次回の深掘りでお会いしましょう。
「限界コンサルおじ」でした。
参照した海外一次資料・出典リンク一覧
- OpenAI: GPT-6 Astra
- OpenAI: Introducing GPT-6.1 Sol
- Anthropic: Claude Opus 5.5
- Anthropic: Models Overview
- Google DeepMind: Gemini Models
- Google DeepMind: Gemini 4 Argon Evaluation Methodology
- Google AI for Developers: Gemini Pricing
- DeepSeek-V4.1-Flash-1017 Model Card
- DeepSeek API Pricing
- GLM-5.3 Model Card
- Kimi K3 Model Card
- Qwen3.8-2.4T-A95B
- Qwen3.8-27B
- Meta Muse Spark Open
- Hugging Face Model Card
- Google Gemma 4 Model Card
- NVIDIA Nemotron 3 Ultra
- OpenAI gpt-oss Help
- MiniMax M3.1 Flash Official Blog
- MiniMax API Docs: Pricing Overview
- MiniMax Text Generation Guide
- Artificial Analysis: MiniMax M3.1 Flash vs Inkling
- Tsinghua University (Yang Yue et al., arXiv:2504.13837)
- Goodfire Research: Neural Networks Are Already Clean
- 個人情報保護委員会:個人情報の保護に関する法律についてのガイドライン(外国にある第三者への提供編)
- Gemini 4 Argon公式仕様
- MiniMax Messages API仕様
この記事は、ポッドキャスト放送回(2026-10-25-deep-dive)の台本と一次資料をもとに再構成しました(確認日:2026年10月20日)。