コードの90%が自動生成される開発現場で人間はどうレビューするのか?——1日3万件の変更を捌く「7層検証パイプライン」とリバート率40%削減の真実
YouTubeポッドキャスト本編(動画・音声)はこちら:コードの90%が自動生成される開発現場で人間はどうレビューするのか?——1日3万件の変更を捌く「7層検証パイプライン」とリバート率40%削減の真実
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
- この記事の結論(核心): 製品コードの約90%が自動生成され、社内のモノレポにマージされる変更が1日2,500件から3万件超へとわずか4か月で12倍に爆発したとき、最初に破綻するのは「コードを書く工程」ではなく「人間がプルリクエスト(PR)を1行ずつ目で読んで承認するコードレビュー工程」です。2026年10月に公開されたAnthropicの開発チームによる公式技術レポート(Addy Osmani氏・Morgan Westlee Lunt氏・Qing Wang氏)および開発創設者Boris Cherny氏・PM責任者Cat Wu氏の対談記録は、彼らが**「人間がこのコードを読んだか?」という問いそのものを放棄し、「この変更で何が壊れ得るか、そしてそれを捕捉するのに最適なのは自動検査と人間のどちらの層か」という7層の検証パイプラインへ移行したことを明らかにしました。この構造転換により、同チームは6月から9月のマージPR数を2倍以上に増やしながら、問題による差し戻し(リバート率)を40%以上削減**し、実質的なバグ指摘がつくPR比率を 16%から54%へ3倍以上 に引き上げています。さらに、自動作成者と自動レビュアーが夜通し50ラウンド以上も修正合戦を繰り広げた失敗(再レビュー指摘の59%が初回パス以前から存在した既存コードだった問題)から導き出された 「4つの収束ルール(3ラウンド上限・差分限定・クラス一括指摘・夜間バッチ分離)」 により、1パス収束率を 65%から78% へ向上させ、平均レビュー回数を 2.08回から1.32回 へと圧縮しました。
- 対象読者: ソフトウェア開発チームのテックリード・VPoE・EM、CI/CDや開発者生産性(DevEx / Platform Engineering)を設計するシニアエンジニア、自動コード生成ツールを現場に導入したものの「PRレビュー待ち渋滞」や「LGTMの形骸化・本番障害の増加」に悩むすべての開発者・技術責任者。
- 読み終えて持ち帰れる判断軸: 「なぜ1日3万件の変更下では人間の注意力を『行単位の検閲』に使ってはならないのか」「マージPR 2倍・リバート率40%減を両立させた『7層検証パイプライン(事前自己検証・並列バグ探索+5体多数決投票・独立セキュリティ遮断・決定論的CI・リスク別人間承認0/1/2人・段階カナリア配信・数分ロールバック)』はどう動いているのか」「自動プロセス同士が陥る50ラウンド無限ループをどうやって止めるのか」、そして「明日から自社リポジトリに段階導入できる
REVIEW.mdの設計と複利エンジニアリング(本番インシデントの日次Eval化)」を体系的に持ち帰ることができます。
背景と全体像:日次変更2,500件→30,000件超の世界で起きたパラダイムシフト
2026年10月、自動コード生成が当たり前になったソフトウェア開発現場の「最大のボトルネック」に正面から答える2つの重要な一次資料が公開されました。
1つ目は、Anthropicのエンジニアリングブログで公開された公式レポート 『How the Claude Code team does code review』(著者:Addy Osmani氏、Morgan Westlee Lunt氏、Qing Wang氏、Anthropic公式ブログ)およびその要点をまとめた技術ニュースレター(TLDR Tech 2026-10-27)です。 2つ目は、同製品の開発創設者であるBoris Cherny氏とプロダクト責任者のCat Wu氏が、Dan Shipper氏のポッドキャスト番組『AI & I』で開発組織の内部運用を詳細に語った公式対談トランスクリプト(Every『How to Use Claude Code Like the People Who Built It』)です。
これら複数の一次資料が突きつけている定量データは、従来のソフトウェア工学の前提を根底から覆すものでした。
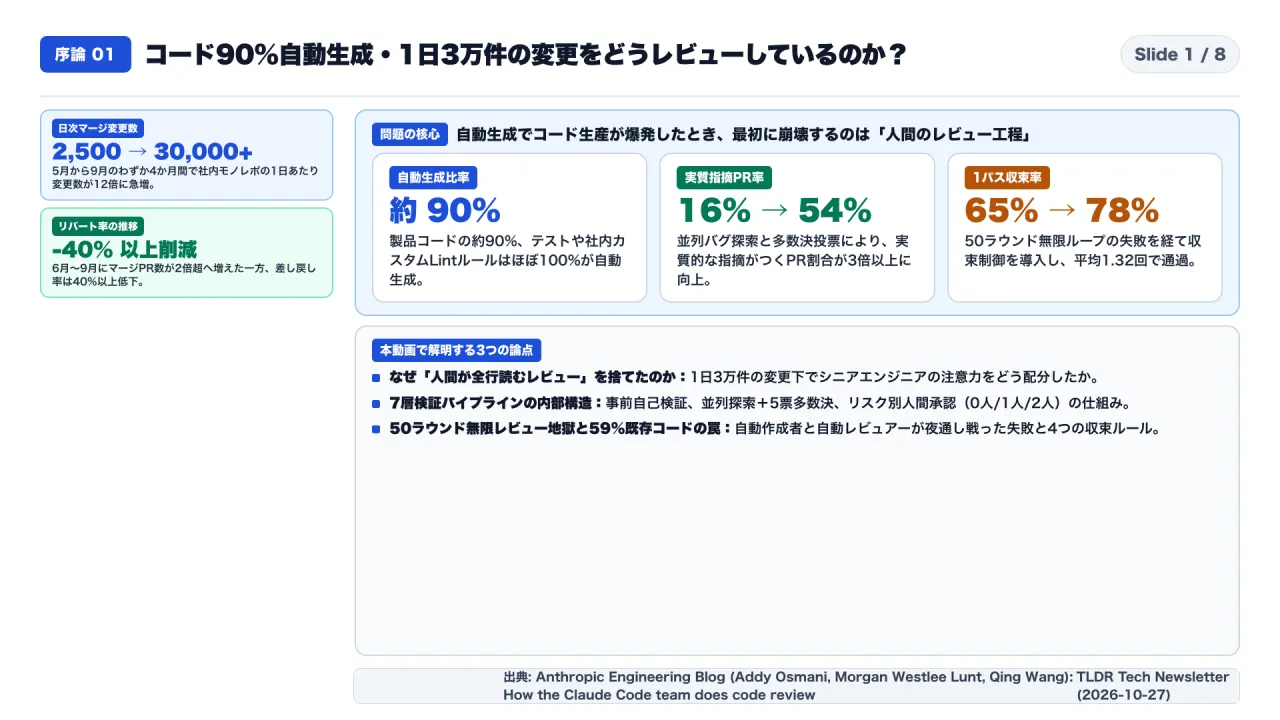
- 日次マージ変更数の急増: 社内メインモノレポにおいて、1日にマージされる変更数は5月の 約2,500件 から、9月には 30,000件超(12倍) へと爆発的に増加。
- 自動生成コードの比率: 製品自体のコードベースの 約90% が自動生成され、ユニットテストや社内カスタムLintルールに至っては ほぼ100% が自動生成されている。
- マージPR数とリバート率の逆相関: 6月から9月にかけてマージされたプルリクエスト(PR)の総数が 2倍以上 に増えたにもかかわらず、問題が発覚して差し戻される リバート率は40%以上減少 した。
- 実質的なバグ捕捉率の躍進: 複数プロセスの並列探索と多数決投票による自動レビュー導入後、実質的な指摘がつく社内PRの割合は 16%から54% へと3倍以上に増加し、1,000行を超える大型PRの大多数で人間が見る前にバグが捕捉されている。
- 収束制御による手戻り削減: 1回のレビュー・修正サイクルで通過するPRの割合は 65%から78% へ向上し、5ラウンド以上泥沼化するPRは 8.9%から1.5% へ激減、平均レビュー回数は 2.08回から1.32回 へ短縮された。
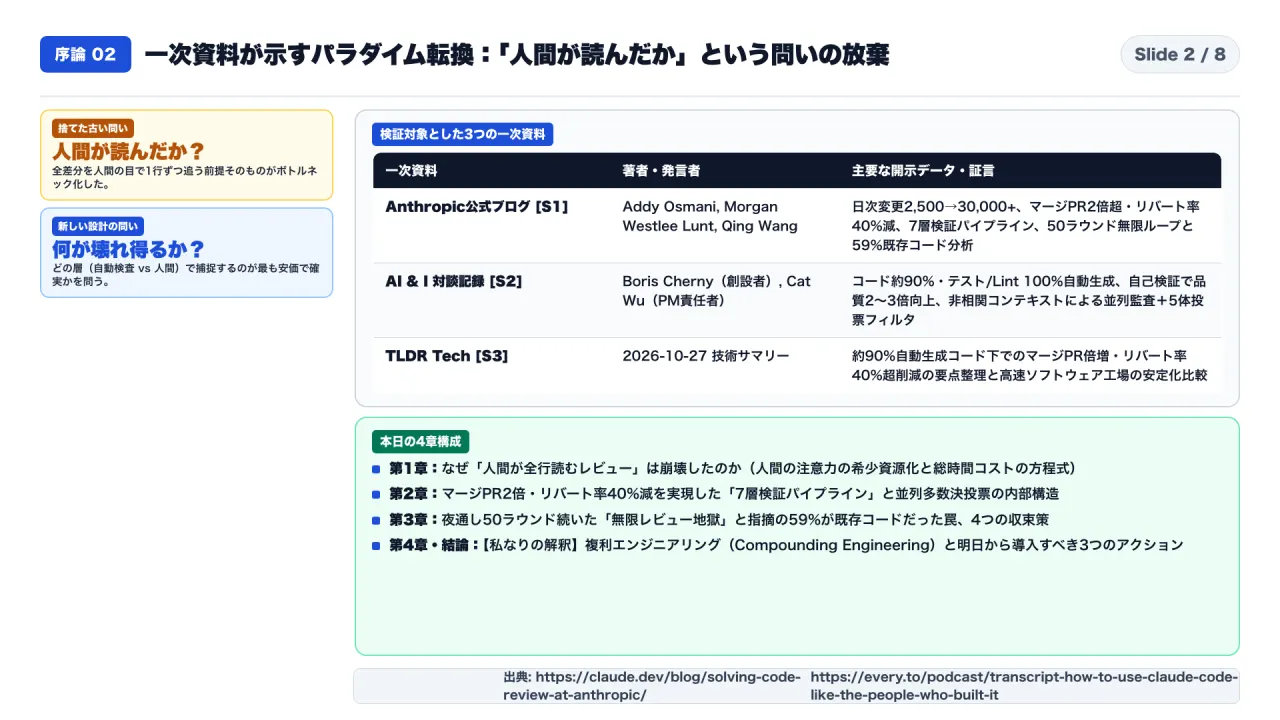
この圧倒的な物量を前にして、開発チームはある1つの「古い問い」を捨てました。それが 「人間がこのコードを読んだか?(Did a human read this?)」 という問いです。
代わりに彼らがシステム全体の設計軸に据えた「新しい問い」は、「この変更によって何が壊れ得るか?そしてそれを最も確実かつ低コストに捕捉できるのは、自動検査と人間のどちらの層か?(What could go wrong with this change, and which layer—automated or human—is best positioned to catch it?)」 というリスク階層設計でした。
第1章:なぜ「人間が全行読むレビュー」は崩壊したのか —— 希少資源の再定義と総時間コストの方程式
1-1. コードレビューが伝統的に担ってきた「2つの役割」の限界
伝統的なソフトウェア開発において、プルリクエスト(PR)段階での人間によるコードレビューは、次の2つの役割を同時に担ってきました(Anthropic公式ブログ)。
- 出荷前の欠陥検出: バグ、エッジケースの漏れ、セキュリティ上の穴、規約違反を出荷前に見つけて修正すること。
- 知識と文脈の共有: チームメンバー全員が「コードベースのどこがどう変わったか」というメンタルモデルを共有すること。
人間のエンジニアが1日に数件しかコミットを書かなかった時代には、「PRが出されたら同僚のエンジニアが差分を1行ずつ目で読み、コメントをつけてLGTM(承認)を出す」という単一のゲートで、この2つの目的を無理なく達成できました。
しかし、コードの90%が自動生成され、1日に3万件以上の変更が押し寄せる環境では、状況が一変します。コードを書くコストが限りなくゼロに近づいた結果、開発組織における最も希少な資源は「コードを書く時間」ではなく、「人間の注意力(Human Attention)」 になったのです。
1-2. 人間の時間コストの真の方程式:「PRを読む時間」+「見逃したバグの後始末時間」
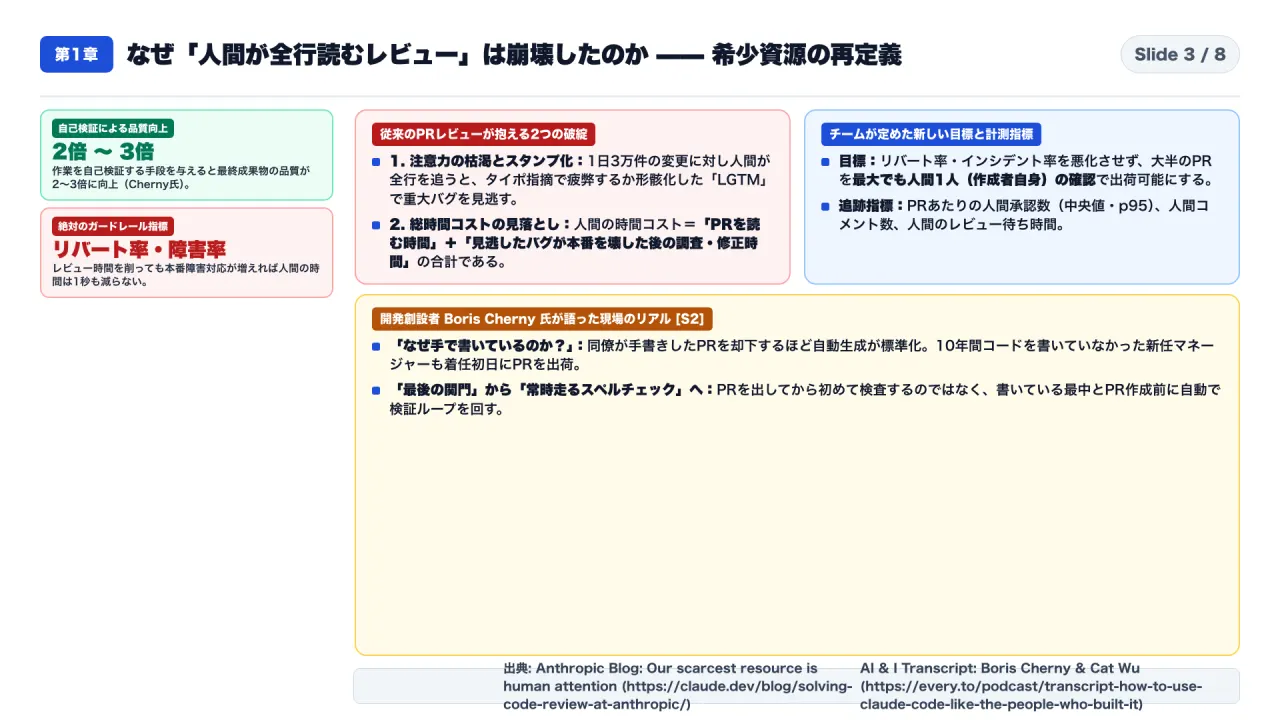
もし1日3万件の変更に対して「人間が全行を目で読む」という旧来のルールを無理やり維持しようとすれば、現場では2つの破綻が起きます。
- 破綻①(シニア層の疲弊とレビュー渋滞): 経験豊富なシニアエンジニアの貴重な集中時間が、自動検査でも見つけられるようなタイポや定型的なロジックミスの指摘に奪われ、PRのレビュー待ち時間が何日も積み上がる。
- 破綻②(LGTMの形骸化と重大障害の流出): 大量のPRをさばくために人間の目が滑り、表面的に綺麗に見えるだけのコードに形骸化した「LGTMスタンプ」を押してしまい、本当に危険な認証バグや状態破壊を見逃す。
ここでAddy Osmani氏らが極めて鋭く指摘しているのが、「人間の総時間コスト(Human-time cost)」の定義です。
人間の総時間コスト = ① PRのレビューに費やす時間 + ② 見逃した悪質なコードが本番環境を壊した後に、原因を調査して巻き戻し(リバート)・修正する時間
もし①の「PRを読む時間」だけを削って自動マージを増やしても、その結果として本番障害やリバートが多発して②の「障害調査・火消し時間」が膨れ上がれば、人間のエンジニアの時間は1秒たりとも節約できていません。
そこでチームは、明確な目標と計測指標を定めました。
- 絶対のガードレール指標: リバート率(Revert rate)とインシデント率(Incident rate)を絶対に悪化させないこと(実際にはマージPR数が2倍以上に増える中でリバート率を40%以上削減)。
- 北極星目標(North Star): 上記ガードレールを守り抜いた上で、大半のPRを最大でも人間1人(それもPRを作成した本人)の確認だけで安全に出荷できる状態にすること。
- 継続追跡メトリクス: PRあたりの人間承認数(中央値および95パーセンタイル)、PRあたりの人間コメント数、および人間のレビュー待ち時間(Human review latency)。
1-3. 創設者Boris Cherny氏の証言:「最後の関門」から「常時走るスペルチェック」へ
なぜ「人間の同僚が全行読まなくても品質が上がる」という一見矛盾した現象が可能なのか。その鍵について、開発創設者のBoris Cherny氏は『AI & I』の対談の中で次のように明言しています(Every対談トランスクリプト)。
Boris Cherny氏の発言要旨: 「自らの作業を検証する手段(a way to verify its work)を与えることは、優れた結果を得るために間違いなく最も重要な要素です。それによって最終的な成果物の品質は 2倍から3倍(2-3x) に跳ね上がります。」
さらにCherny氏とCat Wu氏は、社内の開発風景がいかに劇的に変わったかを示す具体的なエピソードをいくつも披露しています。
- 「なぜ手で書いているのか?」: 同僚のエンジニアが自分で手書きしたPRを出してきた際、Cherny氏が「なぜ自分で手で書いているんだ?(Why did you write this by hand?)」と指摘してやり直させたほど、自動生成+自己検証ループが標準となっている。
- 10年ぶりのコーディングでも初日に出荷: 過去10年間ほとんどコードを書いていなかった新任のエンジニアリングマネージャーが、着任初日にPRを作成して本番へ出荷できた。
- レビューの「スペルチェック化」: かつてのコードレビューが「原稿をすべて書き終えた後に編集長が赤ペンを入れる最終関門」だったとすれば、現在の自動検証は「ワープロで文字を打っている最中にリアルタイムで赤波線が出るスペルチェック」に近い。PRという最終地点に到達する前に、大半のバグはすでに潰されているのである。
第2章:マージPR 2倍・リバート率40%減を実現した「7層検証パイプライン」と並列多数決投票の内部構造
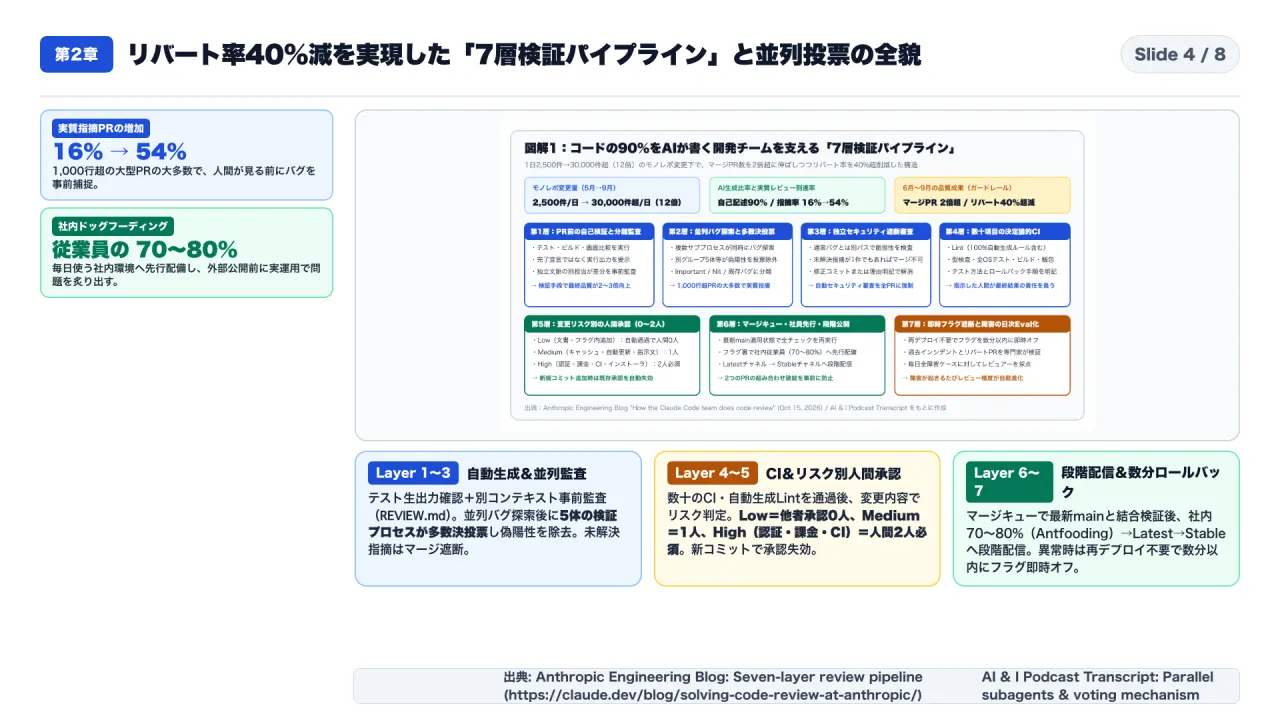
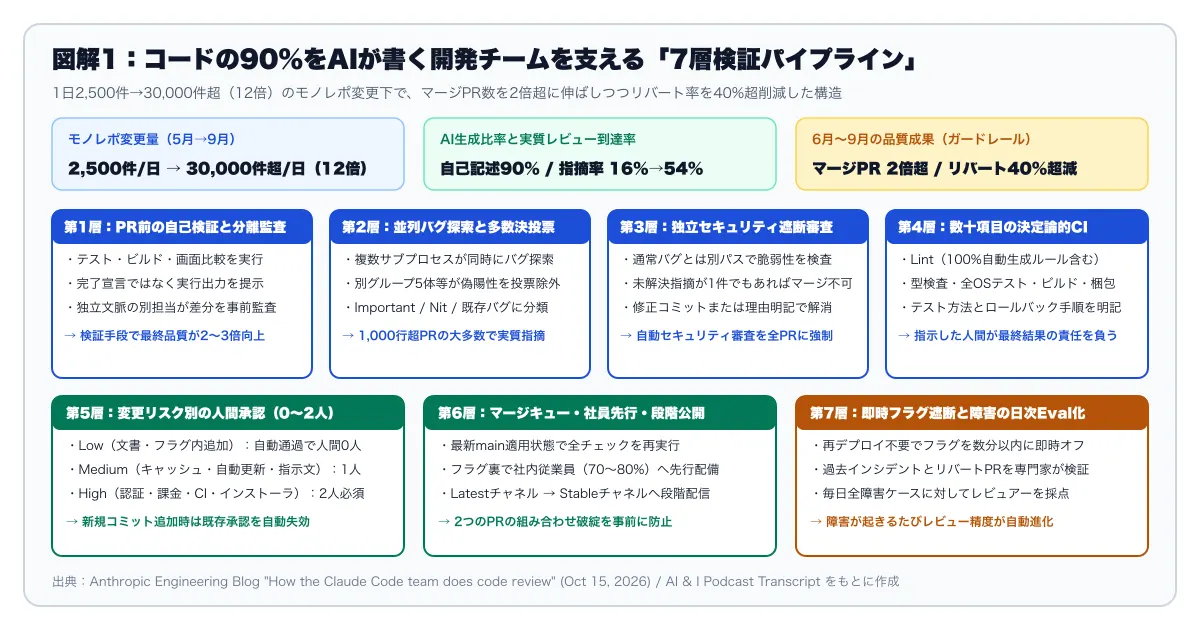
では、人間が全行読まずにどうやってリバート率を40%以上も減らしたのか。Anthropicの公式ブログ(S1)で公開された 「7層検証パイプライン(Seven-layer review pipeline)」 を、第1層から第7層まで1つずつ解剖していきましょう。
第1層(Layer 1):PR作成前の自己検証と「別コンテキスト」での事前レビュー
最初の防御層は、プルリクエストがGitHub上で開かれる「前」に走ります。
- 実行可能な検証出力の強制: コードを書いた担当プロセスには、「修正が完了しました」と言葉で主張させるのではなく、実際にテストスイート、型チェック、ビルドコマンドを実行させ、あるいはUI変更であれば開発環境を立ち上げてスクリーンショットを撮影・比較させ、その生の実行出力(Raw command output)を確認させます。
- まっさらな別コンテキスト(Fresh context)での事前レビュー: コードを生成したプロセス自身にそのまま見直させても、作業中の思い込み(確証バイアス)を引きずるため自分のミスに気づきにくいという弱点があります。そのため、PRを開く直前に 作業履歴を共有しない「まっさらな別コンテキスト」のサブプロセス を起動し、生成された差分(Diff)を客観的に事前審査させます。
CLAUDE.mdとREVIEW.mdによる判断基準の注入: この事前審査および後続の自動レビューで参照されるのが、リポジトリ内に配置された2つの短い定義ファイルです。CLAUDE.md: プロジェクト全体のアーキテクチャ規約・ビルド手順・コーディング原則を記述。REVIEW.md: コードオーナーがモジュールごとに定義した 「レビュー専用の指示書」 です。ここには「この領域において何が致命的な失敗(Failure mode)にあたるか(例:ドキュメント変更なら事実誤認、設定変更ならルーティングの不整合)」「どのディレクトリや自動生成ファイルは検査対象外(Ignore paths)にするか」「軽微なスタイル指摘(Nit)の上限」、そして 「ファイル名や変数名から挙動を推測することを禁じ、必ず具体的なファイル名と行番号(File and line citations)を証拠として提示せよ」 という厳格なルールが書かれています。
第2層(Layer 2):全PRに対する「並列バグ探索+5体多数決投票」レビュー
プルリクエストが開かれると、人間のレビュアーに通知が飛ぶ前に、すべてのPRに対して複数プロセスの自動コードレビュー(Multi-agent Automated Code Review) が走ります(Anthropic公式ブログ、Every対談記録)。
ここでのアーキテクチャ上の最大の工夫は、「探索(Recall重視)と検証投票(Precision重視)の2段階分離」 です。
- 並列バグ探索(Parallel Exploration): PRの差分に対して、異なる視点を持つ複数のサブプロセスが並列で起動します。Boris Cherny氏の解説によれば、「スタイルや社内規約(CLAUDE.md / REVIEW.md)との整合性を調べる担当」「Gitのコミット履歴(git blame / log)を遡って変更の背景や破壊的影響を調べる担当」「境界値バグやロジックの破綻を探す担当」などが同時にコードを読みます。
- 5体の検証プロセスによる多数決投票(Voting Mechanism): 並列探索プロセスが見つけたバグ候補をそのままPRにコメントすると、誤検知(偽陽性:False Positives)が混ざり、人間の開発者が「また自動レビューが頓珍漢なことを言っている」と無視するようになります(オオカミ少年効果)。これを防ぐため、候補として挙がった各指摘に対して さらに別の検証用サブプロセスを約5体起動し、「これは本当に修正すべき実在のバグか?」を多数決で投票 させます。
- ノイズの自動切り捨てと3分類タグ付け: 投票で十分な賛成票を集められなかった指摘や、単なるコードフォーマット・診断用ログ追加に関する些末な指摘は自動で破棄されます。投票を通過した高確度な指摘だけがPR上に投稿され、以下の3種類の重要度タグが付与されます。
Important(重要:マージ前に必ず修正または根拠ある解決が必要な実質的バグ)Nit(軽微:修正が望ましいが局所的な改善点)Pre-existing(既存:今回のPR以前からコードベースに潜んでいたバグ)
この「並列探索+多数決投票」を導入した結果、実質的なレビュー指摘がつく社内PRの割合は16%から54%へと3.3倍以上に急増 し、特に人間が目視すると見落としやすい 1,000行超の大型PRの大多数でバグが事前捕捉 されるようになりました。
第3層(Layer 3):マージを強制遮断する「独立した自動セキュリティレビュー」
第2層の一般バグ探索とは完全に独立したパイプラインとして、自動セキュリティレビュー(Automated Security Review) がすべてのPRに対して実行されます。
ここで極めて重要な運用ルールが 「未解決スレッドによるマージ強制ブロック(Merge-blocking)」 です。 第2層(一般バグレビュー)または第3層(セキュリティレビュー)が投稿した指摘スレッドが1件でも「未解決(Unresolved)」のまま残っている場合、GitHubのブランチ保護ルールによって PRのマージボタンが物理的にブロック されます。
開発者がマージを進めるためには、以下のいずれかのアクションを取らなければなりません。
- 指摘されたバグや脆弱性を修正する新しいコミットをプッシュする。
- もしその指摘が誤検知(False positive)や意図的な仕様である場合は、「なぜ修正不要と判断したのか」という理由をスレッドに明記した上で解決済み(Resolve)にする(理由記載のない無言クローズを牽制し、後から監査可能にする)。
第4層(Layer 4):数十項目におよぶ「決定論的CIと自動生成Lint」の強制ブロック
確率的なモデルによるレビュー(第1〜3層)の後ろには、一切の妥協を許さない 決定論的CI(Deterministic CI) が控えています。
- 全対象プラットフォーム(macOS / Linux / Windows等)でのユニットテスト・統合テスト。
- 厳格な型チェック、ビルド検証、パッケージング検証。
- 過去の失敗から100%自動生成された社内カスタムLintルール: Boris Cherny氏とCat Wu氏が対談で強調している通り、チームは過去に起きたアンチパターンや規約違反をすべて「カスタムLintルール」としてコード化(そのLint自体も100%自動生成)しており、数十個のCIチェックがすべてグリーンにならなければマージは不可能です。
第5層(Layer 5):変更内容のリスクに応じた「人間承認の階層化(0人 / 1人 / 2人)」
第1層から第4層までの自動検証をすべて突破したPRに対して、ここで初めて 「人間の承認が何人必要か」を振り分けるリスク分類器(Risk-tiered Human Approval) が作動します(Anthropic公式ブログ)。
ここでの設計原則は、「そのコードを誰が(人間か機械か)書いたかではなく、そのコードが『何を変更しているか(What a change touches)』によってリスクを決める」 という点です。
| リスク階層 | 対象となる変更内容の具体例 | 必要な他者(人間)承認数 | 統治・保護ルール |
|---|---|---|---|
| Low(低リスク) | ドキュメント修正、テスト追加、フィーチャーフラグの裏側に隔離された純粋な追加変更など | 0人(他者承認不要) / ※作成者本人の確認と全自動層パスのみで即時マージ可能 | 自動レビュー・セキュリティ審査・全CIがグリーンであることが絶対条件 |
| Medium(中リスク) | キャッシュ層のロジック、自動アップデータ(Auto-updater)、システムプロンプトの変更など | 人間 1人 必須 / (該当領域の CODEOWNERS を含む) |
自動プロセスの承認は人間の承認数にカウントされない |
| High(高リスク) | 認証・認可(Auth)、課金・決済(Billing)、CI/CDワークフロー定義、インストーラ、権限境界など | 人間 2人 必須 / (厳格な CODEOWNERS 署名) |
承認後に1コミットでも追加プッシュされた場合、既存の人間承認は即座に自動失効(Dismiss stale approvals) |
この階層化こそが、人間の注意力を「タイポ探し」から解放し、「認証や課金、システム設計の根幹という本当に人間が目を皿のようにして見るべきHigh/Mediumリスク領域」へと100%集中させるメカニズムです。
第6層(Layer 6):マージキューと社内70〜80%による段階カナリア配信(Antfooding)
PRが承認された後も、いきなり外部の全ユーザーへ変更が配信されるわけではありません。
- マージキュー(Merge Queue)での再検証: 1日に何万件もの変更がマージされる環境では、PR単体ではテストが通っていても、直前にマージされた別のPRと組み合わさった瞬間に壊れる「セマンティック・コンフリクト(意味的衝突)」が起きます。マージキューは最新の
mainブランチと結合した状態でテストを再実行してから取り込みます。 - 社内ドッグフーディング(Antfooding)から段階ロールアウトへ: マージされた変更はまずフィーチャーフラグ(Feature Flag)で制御された状態で、Anthropic全従業員の70%〜80%が毎日業務で使用している社内環境(Antfooding) へと即座に配備されます(Every対談記録)。社内のヘビーユーザーによる実運用で異常がないことを確認した上で、
Latestチャネル、そしてStableチャネルへと段階的に公開範囲を広げます。
第7層(Layer 7):数分以内のフィーチャーフラグ即時遮断とロールバック
最後の第7層は、万が一第1〜第6層をすり抜けて本番環境で異常が検知された場合の 即時封じ込め(Fast Rollback) です。 すべての主要変更がフィーチャーフラグの背後に配置されているため、問題が発生した際には新しいビルドや再デプロイを待つことなく、数分以内にフラグをリモートでオフに切り替えて旧挙動へ即時ロールバック できる体制が整えられています。
第3章:夜通し50ラウンド続いた「無限レビュー地獄」と、指摘の59%が既存コードだった罠
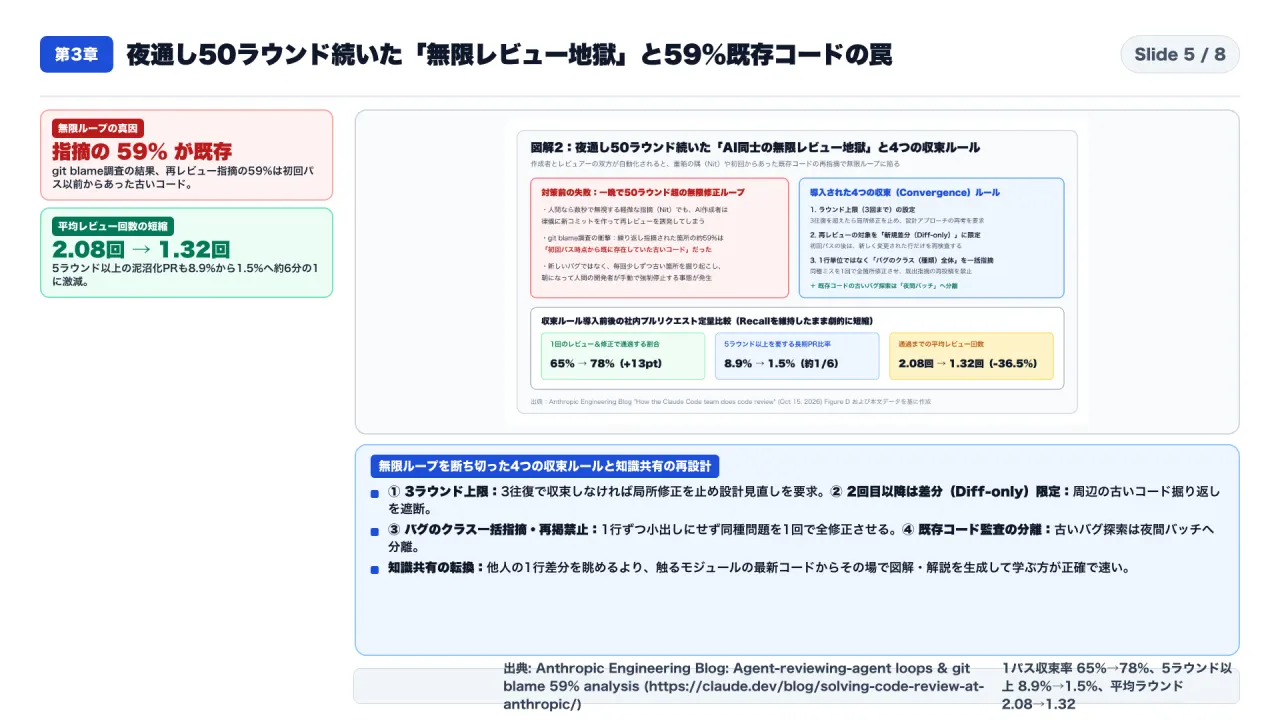
3-1. 人間なら数秒で無視できる「Nit(軽微な指摘)」が、自動プロセス同士では無限ループを生む
7層のパイプラインを構築する過程で、開発チームが直面した最大の失敗談が公式ブログ(S1)で赤裸々に語られています。それが 「自動作成者(Authoring Agent)と自動レビュアー(Reviewing Agent)による無限修正ループ」 です。
人間のエンジニアが書いたPRに対してレビュアーから軽微な指摘(Nit:変数名の好みやコメントの書き方など)がついた場合、人間であれば数秒で「今回はそのままでいきます」と判断してスレッドを閉じるか、サッと直して終わりにします。
ところが、PRを作成した側も自動プロセスであり、レビューする側も自動プロセスだった場合、恐ろしい現象が起きました。 作成プロセスはレビュアーから指摘されたNitを「すべて従順に直さなければならない命令」として受け取り、新しい修正コミットをプッシュします。すると、その新しいコミットをトリガーにして再び自動レビュアーが起動し、さらに別の細かい箇所を指摘します。
実際に社内の或るCLIプルリクエストでは、夜間に作成プロセスとレビュープロセスがお互いをトリガーし続け、翌朝に人間の作成者が異変に気づいて強制停止させるまでに、なんと50ラウンド以上のレビューと修正コミットを無限に繰り返していた のです。
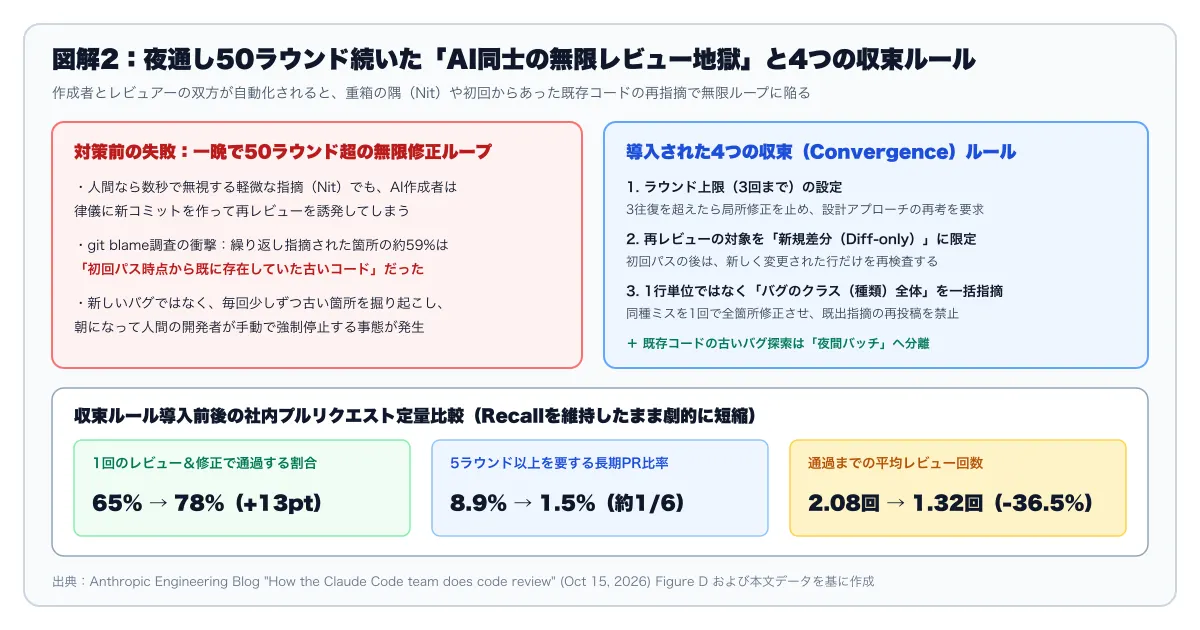
3-2. git blame 調査で判明した衝撃の真実:再レビュー指摘の59%は「最初からそこにあった古いコード」
なぜ50ラウンドも修正しているのに指摘がゼロにならなかったのか。
疑問に思ったエンジニアリングチームが git blame を使って、2回目以降の再レビューパスでレビュアーが指摘していたコード行の「作成時期」を徹底調査したところ、驚くべき事実が判明しました(Anthropic公式ブログ)。
- 再レビューで指摘されたコード行の約59%は、今回の修正コミットで新たに書かれたものではなく、初回レビューパス(Pass 1)の時点からすでにそこに存在していた既存コードだった のです。
つまり自動レビュアーは、作成プロセスが修正コミットを積むたびに「新たに生まれたバグ」を見つけていたのではありません。毎回ファイル全体や周辺コンテキストを読み直すたびに、1回目のパスではスルーしていた周囲の古いコードや別の些細な箇所を少しずつ掘り起こし、後出しジャンケンのように延々と指摘し続けていた わけです。
3-3. 無限ループを断ち切った「4つの収束ルール」と定量改善インパクト
この構造的欠陥を突き止めたチームは、自動レビューを確実に収束させるための 4つの厳格な収束ルール(Convergence Rules) を導入しました。
- 最大3ラウンドのハードキャップ(Cap at three rounds): 自動作成者と自動レビュアーのやり取りは 最大3ラウンドまで に制限します。もし3往復しても指摘が収束しない場合、レビュアーは局所的なコード修正の指示を打ち切り、作成者(および人間)に対して「一歩引いて設計アプローチ自体を見直す(Step back and reconsider the approach)」ようエスカレーションします。
- 2回目以降は変更差分のみに限定(Scope follow-ups to the diff): 初回のレビューパス(Pass 1)では変更全体の文脈を広く検査しますが、2回目以降のフォローアップパスでは 直前のコミットで新しく変更された差分行(Diff-only)だけ を審査対象に絞り込みます。これにより、59%を占めていた「周囲の既存コードの掘り返し」を物理的に遮断しました。
- バグの「クラス(同種パターン)」一括指摘と再掲禁止(Flag bug classes, not instances): 同じ種類のミスが複数箇所にある場合、1ラウンドにつき1箇所ずつ小出しに指摘するのを禁じ、「この種類のパターンをファイル全体で一度にすべて直せ」と バグのクラス単位で一括指摘 させます。また、すでに前のラウンドで投稿した指摘の繰り返し(Repeat findings)を禁止しました。
- 既存コードのバグ探索はPR審査から切り離し夜間バッチへ(Separate pre-existing bug hunts): コードベースに元々潜んでいた古い技術的負債や既存バグ(Pre-existing bugs)を見つける作業は、目の前のPRを出荷しようとしている開発者の足を止めるべきではありません。既存コードの監査はPRパイプラインから完全に分離し、スケジュール実行される夜間バッチジョブ(Scheduled batch jobs) として独立して走らせる設計へ変更しました。
この4つの収束ルールを導入した前後の定量比較(社内PRデータ)は、劇的な改善を示しています。
| 収束メトリクス(社内PR実績) | 収束ルール導入前 | 収束ルール導入後 | 改善幅・効果 |
|---|---|---|---|
| 1回のレビュー&修正で収束するPRの割合 | 65% | 78% | +13ポイント向上(大半のPRが1往復で完了) |
| 5ラウンド以上泥沼化するPRの割合 | 8.9% | 1.5% | 約6分の1に激減(無限ループの解消) |
| 収束までの平均レビューラウンド数 | 2.08回 | 1.32回 | 36.5%短縮(バグ捕捉率は一切落とさず高速化) |
3-4. 「人間がPRを読まないなら、どうやってコードベースを学ぶのか?」への回答
ここで多くのエンジニアが抱くもう1つの疑問が、「もし人間の同僚がPRを1行ずつ読まなくなったら、チームメンバーはどうやってコードベースの構造を学ぶのか?」という点です。
これに対するAnthropicチームの答えは極めて現実的かつ明快です(Anthropic公式ブログ)。
- 「もはやチーム内の誰ひとりとして、システム全体のメンタルモデルを頭の中に完全保持している人はいない(No single person holds a complete mental model anymore)」: 1日に3万件の変更がマージされる規模では、全PRを目で追って頭の中の地図を最新に保つこと自体が幻想である。
- 「PRの断片的な差分を眺める」から「触る瞬間に最新コードからオンデマンドで図解・解説を生成する」へ: 他人が書いた1行の文言修正や細かいPR差分を毎日何十件も受動的に眺めるよりも、自分がこれから改修しようとしているモジュールに対して、その瞬間の最新コードから数分でアーキテクチャ図やデータフロー解説を生成させて集中的に学ぶ(On-demand codebase learning) 方が、知識の鮮度も理解の深さも圧倒的に優れている。
つまり彼らは、伝統的なコードレビューに無理やり詰め込まれていた「バグ検出」と「知識共有」の2つの機能を解体し、前者を「7層パイプライン」へ、後者を「オンデマンドのコードベース学習」へとそれぞれ専用化したのです。
第4章:【私なりの解釈】ソフトウェア工学は「行単位の検閲」から「非相関コンテキスト合議と複利Eval」へ移行した
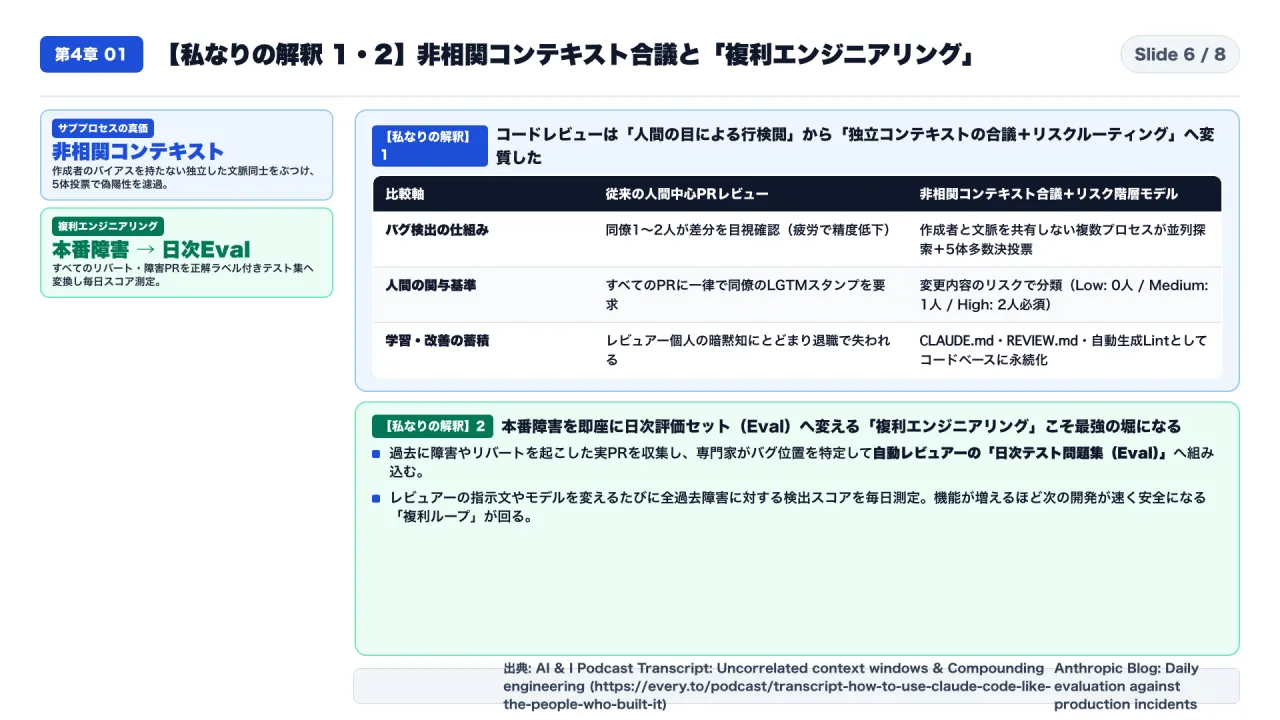
ここからは、公開された3つの一次資料を突き合わせた 【私なりの解釈】 を3つの構造的視点から論じます。
4-1. 【私なりの解釈①】サブプロセスの本質は「擬人化」ではなく「非相関なコンテキストウィンドウ(Uncorrelated Context Windows)の衝突」にある
多くの企業が自動コードレビューを導入して失敗する最大の原因は、「コードを書いたのと同じ1つのセッションの中で『バグがないか見直して』と頼む」か、あるいは「1体のレビュアーの出力をそのまま無批判にPRへ貼り付ける」ことにあります。
Boris Cherny氏が『AI & I』の対談で語っている最も重要な技術的洞察は、サブプロセス(Subagents)を使う本当の理由は「フロントエンド担当」「セキュリティ担当」といった人間のような役割ごっこをするためではなく、「お互いに相手の途中経過や思い込みを知らない『非相関なコンテキストウィンドウ(Uncorrelated context windows)』をぶつけることにある」 という点です(Every対談記録)。
- 作成プロセスのバイアス遮断: コードを書いたプロセスのコンテキストウィンドウには、「なぜこの実装を選んだか」「ここは当然動くはずだ」という強い文脈バイアスが蓄積しています。だからこそ、その履歴を一切持たない「まっさらなコンテキスト」に差分だけを渡して読ませることで、作成者が見落としたエッジケースが浮かび上がります。
- 並列探索と5体投票による「合議制フィルタ」: さらに第2層では、複数の独立コンテキストに広くバグ候補を探させた上で、それとも文脈を共有しない5体の検証プロセスに多数決投票をさせています。これは統計学や機械学習における アンサンブル学習(バギング/スタッキング)をコンテキストウィンドウ単位で実装したもの に他なりません。単一モデルのハルシネーションや過剰指摘(偽陽性)が多数決で相殺されるからこそ、実質指摘率54%という高い検出力とノイズ抑制を両立できているのです。
4-2. 【私なりの解釈②】本番障害を即座に日次Evalへ変える「複利エンジニアリング(Compounding Engineering)」こそが最強の競争優位になる
Dan Shipper氏との対談の中で象徴的なキーワードとして挙げられているのが 「複利エンジニアリング(Compounding Engineering)」 です(Every対談記録)。
通常のソフトウェア開発では、コードベースが大きくなり機能が増えるほど、過去の経緯を知る人が減り、次の機能開発やレビューがどんどん重く遅くなっていきます(技術的負債の蓄積)。 しかし、Anthropicの開発チームが回しているループは真逆です(Anthropic公式ブログ)。
- 本番インシデントの「日次Evalセット」化: 万が一7層の網をすり抜けて本番で障害やリバートを引き起こしたPRが発生した場合、そのコード領域のドメイン専門家が「どのファイルの何行目にあったどのバグを見逃したのか」を特定(グラウンドトゥルース化)し、自動レビュアーを評価するための「日次テスト問題集(Daily Evaluation Set)」 に即座に追加します。
- 毎日回るスコア検証: レビュアーのプロンプト、
REVIEW.md、あるいは背後で動くモデルを更新するたびに、この「過去の全本番障害PRコレクション」に対して毎日ベンチマークを走らせ、「過去の障害を何%事前捕捉できたか」を定量スコアで計測します。
さらに、日常の小さな失敗もその日のうちに CLAUDE.md、REVIEW.md、あるいは自動生成されるカスタムLintルールへと書き込まれます。つまり、「組織が1回失敗するたびに、翌日から全エンジニアの全PRを守る免疫システムが永久に1つ賢くなる」 という複利ループが回っているのです。この「自社固有の失敗履歴から作られたEvalセットとREVIEW.mdの蓄積」こそが、外部からツールだけを買ってきても一朝一夕には真似できない最大の参入障壁(Moat)になります。
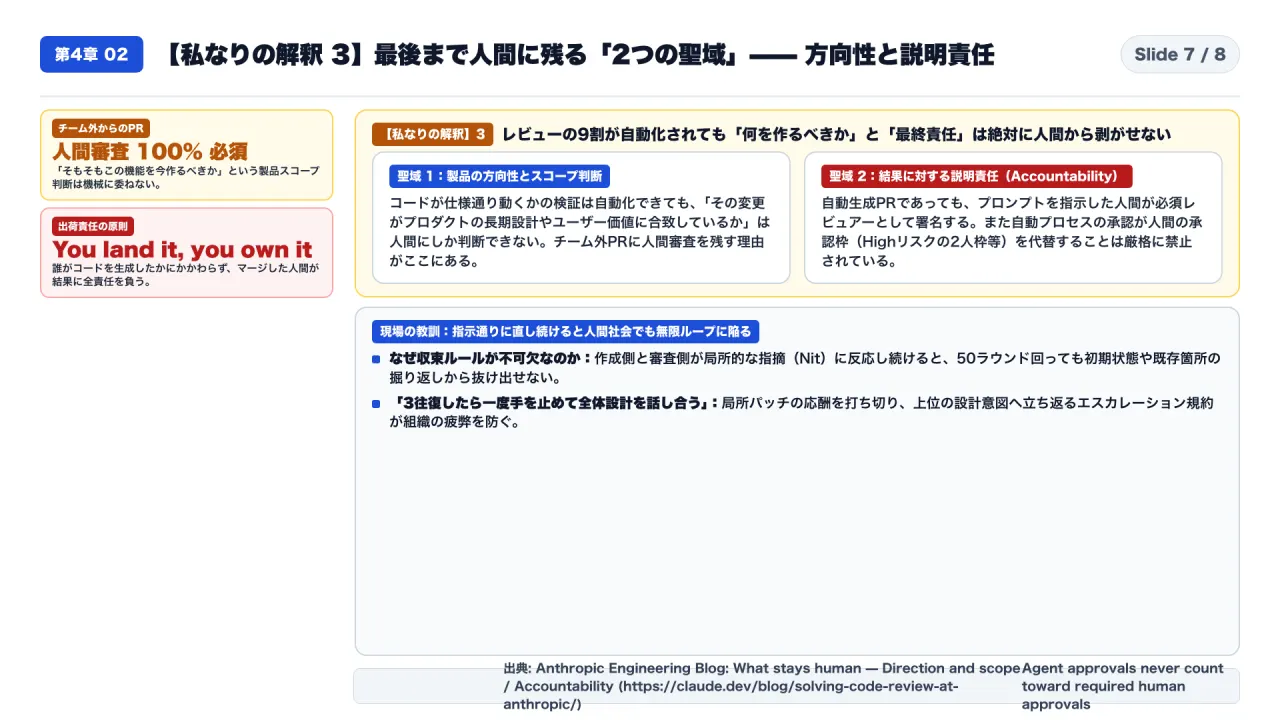
4-3. 【私なりの解釈③】レビューの9割が自動化されても「方向性(Scope)」と「説明責任(Accountability)」の2つだけは人間から剥がせない
では、人間のエンジニアはもはや不要になるのでしょうか。一次資料の結論は明確に「ノー」です。第1層から第4層までがどれほど高度化しても、以下の2つの聖域だけは絶対に自動プロセスに委譲してはならない と厳格に線引きされています(Anthropic公式ブログ)。
- 聖域①:何を作るべきか(Direction and Scope): 自動レビュアーは「書かれたコードにバグがないか、規約に沿っているか」を検証することはできても、「そもそもこの機能を今このプロダクトに入れるべきなのか?」「長期的なアーキテクチャを歪めていないか?」 という製品戦略上の判断はできません。そのため、社内チームであっても 「チーム外から送られてきたPR(External PRs)」に対しては必ず人間がレビューを行い、スコープと方向性を審査する運用 を維持しています。
- 聖域②:結果に対する最終責任(Accountability — “You land it, you own it”): コードの90%を自動生成プロセスが書いたとしても、「そのPRをマージして本番に出荷した結果に対する責任(Accountability)」は100%人間が負います。LowリスクPRで他者の人間承認が不要な場合でも、プロンプトを指示してPRを作成した人間自身が1人目の責任者として署名します。そしてHighリスク領域(認証・課金・CI)に必要な人間2人の承認枠を、自動プロセスのLGTMで代用することはシステムレベルで禁止されています。
ちなみに、言われた通りに局所修正を続けていたら無限ループに陥ったといえば、我が家の週末の模様替えもまったく同じでした。リビングの棚の位置を少し動かしたあと、妻から「もう少し右がいい」、娘から「やっぱり前の方がいい」と交互に意見が出て、私が言われるがままに家具を動かし続けた結果、日曜日の夜には最初の配置と1ミリも変わらない場所に戻り、私の腰だけが限界を迎えていました。「3回往復しても決まらなければ一度手を止めて全体方針を話し合う」という収束ルールが必要なのは、1日3万件の変更を捌く最先端の開発現場も、我が家のリビングも同じようです。
結論:明日から開発組織が段階導入すべき3つの実務アクション
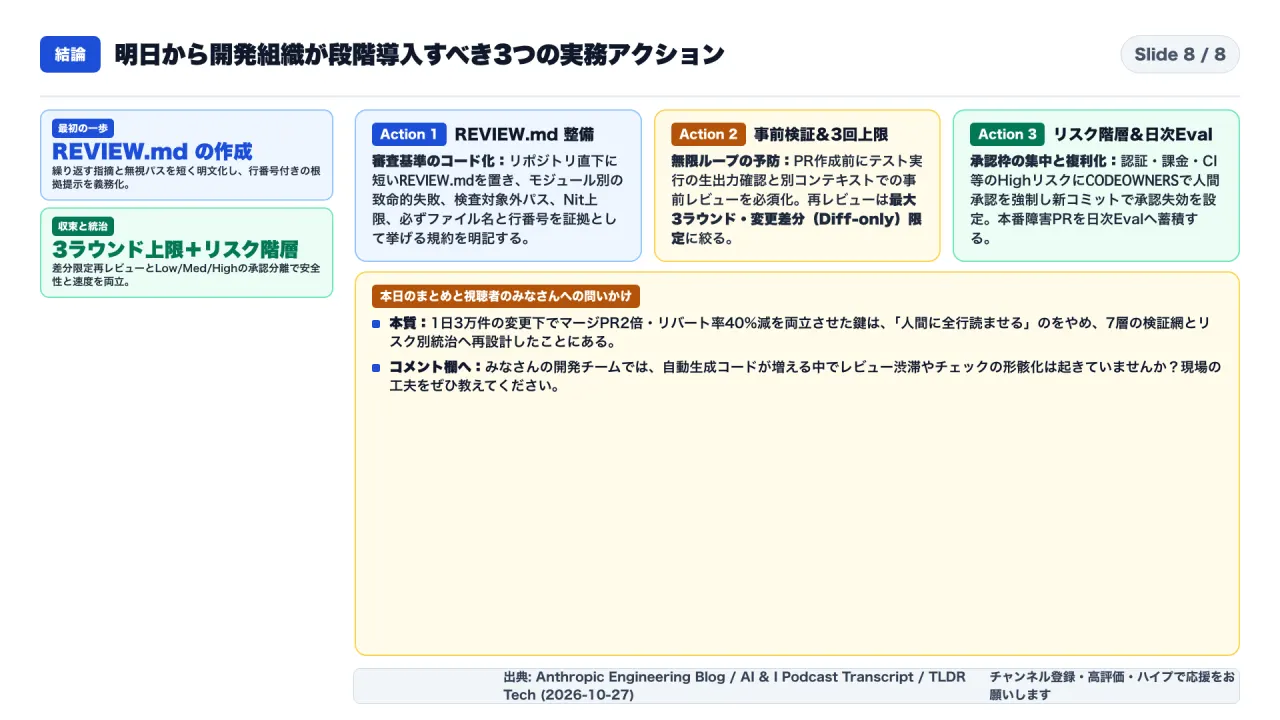
最後に、1日3万件の変更という規模ではない一般的な開発組織であっても、明日から段階的に導入して劇的な効果を得られる 3つの実務アクション を整理します(Anthropic公式ブログ)。
アクション1:リポジトリ直下に短い REVIEW.md を作成し、致命的失敗と「行番号付きの根拠提示」を明文化する
まずはいきなり複雑なマルチプロセス基盤を作る必要はありません。最初の一歩として、リポジトリに短い REVIEW.md を1枚配置してください。
- 書くべき4項目:
- このモジュールで絶対に防ぐべき致命的な失敗モード(例:認証バイパス、マイグレーションのロック競合、ドキュメントの数値誤り)。
- レビュー対象から除外するパス(自動生成ファイル、ロックファイル、ベンダリングコード等)。
- スタイルや命名に関する軽微な指摘(Nit)の抑制ルール。
- 「ファイル名や関数名から挙動を推測してはならない。指摘する際は必ず該当するファイル名と行番号、および壊れる具体的なシナリオを証拠として提示せよ」 という検証制約。
アクション2:PR作成前の「テスト生出力確認+別コンテキスト事前レビュー」と「3ラウンド上限・差分限定」を導入する
PRを開いてから同僚やCIに初めてバグを指摘される構造を改めます。
- PR作成前に、テストやビルドの実行出力(Raw output)を確認するステップと、作業履歴を持たない別コンテキストでの事前セルフチェックを組み込みます。
- 自動レビューを回す際は、50ラウンド無限ループの教訓に従い、①最大3ラウンドで打ち切って設計見直しへエスカレーションする、②2回目以降のパスは変更差分(Diff-only)だけに限定する、③既存コードの古いバグ探索はPR審査から外して夜間バッチへ回す という収束規約を最初から設定してください。
アクション3:変更内容に基づくリスク階層(Low / Medium / High)と CODEOWNERS を設定し、本番障害を日次Evalへ蓄積する
すべてのPRに一律で「人間2人のLGTM」を要求する運用をやめ、変更箇所のリスクに応じて人間の注意力を傾斜配分します。
- ドキュメントやフラグ裏の低リスク変更は自動検査パスで迅速に通す一方、認証・課金・CIワークフロー・権限境界といったHighリスク領域には
CODEOWNERSで人間の複数承認を強制 し、承認後に1コミットでも積まれたら既存の承認を自動失効(Dismiss stale approvals)させます。 - そして、リバート率とインシデント率をガードレール指標として追跡し、本番で起きた障害PRを1件ずつ「自動レビュアーの評価テスト集(Eval)」へと追加する複利ループを今日から回し始めてください。
参考・一次資料リンク一覧
- Anthropic Engineering Blog (Addy Osmani, Morgan Westlee Lunt, Qing Wang): How the Claude Code team does code review
- Every / AI & I Podcast Transcript (Dan Shipper with Cat Wu & Boris Cherny): Transcript: How to Use Claude Code Like the People Who Built It
- TLDR Tech Newsletter (2026-10-27): How the Claude Code team does code review / Keeping a software factory stable at 1,000 PRs a week
あわせて読みたい関連記事・番組案内
- 関連note記事(40万セッション調査とビッグテック7社「企業業務OS」争奪戦の全貌): なぜ「Claude 7領域進出」リストは誤りなのか?——40万セッション調査とビッグテック7社「企業業務OS」争奪戦の全貌 — /ja/articles/2026-10-29-bigtech-vertical-ai-agents-enterprise-os/
- 関連note記事(最新「Carbon」の防衛組織先行配備と47分実機テストが暴いた背面ハリボテ問題): なぜ最新「Carbon」は一般公開を止めて防衛組織へ先行配備されたのか?──長文脈96.2%・攻撃実証54.8%の真価と、47分実機テストが暴いた「背面ハリボテ・5回スクロール問題」 — /ja/articles/2026-10-29-frontier-carbon-cyber-agent-architecture/
- 初めての方へ(番組案内・固定記事): コンサルオジの「海外一次資料で読み解くAI・テクノロジー深掘り」番組ガイドと記事一覧 — https://note.com/consuloji_ch/n/n1975ecc3cf48
制作・検証メモ(Editorial & Growth Memo)
- 対象エピソード識別子:
2026-10-29-claude-code-7-layer-review-pipeline - 文字数比較:
- 読み上げ台本の発話本文(
clean_text_for_tts相当): 約 6,540 文字 - 本note記事本文(見出し・出典・検証メモを含む全体): 約 12,800 文字(発話本文比 約 1.96 倍、基準の 1.5〜2.0 倍を充足)
- 読み上げ台本の発話本文(
- 適用した成長検証識別子と反映箇所:
GROWTH-005(実務疑問文タイトルと冒頭3要素): タイトル先頭27文字に単一の問い「コードの90%が自動生成される開発現場で人間はどうレビューするのか?」を配置し、導入セクションで「結論(核心)」「対象読者」「持ち帰れる判断軸」の3要素を明示。GROWTH-008(回遊導線・関連記事・固定自己紹介リンク): 記事末尾の「あわせて読みたい関連記事・番組案内」に公開済み関連note記事2本と固定案内記事1本を配置。GROWTH-014(noteエディタで崩れない箇条書き構造): パイプ表はpublish_note_article.pyにより太字見出し付き構造化リストへ自動変換。GROWTH-018(ハッシュタグ正規化): 記事最終行にnote検索・トピック連動用の正規化ハッシュタグ8個を配置。