なぜ温度0でも同じ答えが出ないのか?——Thinking MachinesとAvi Chawlaが暴いた「バッチ不変性(Batch Invariance)」の欠如、1,000回中80通り分裂の真因と34.35%の代償
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ温度0でも同じ答えが出ないのか?——Thinking MachinesとAvi Chawlaが暴いた「バッチ不変性(Batch Invariance)」の欠如、1,000回中80通り分裂の真因と34.35%の代償
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
- この記事の結論(核心): 「大規模言語モデル(LLM)のAPIや推論サーバで
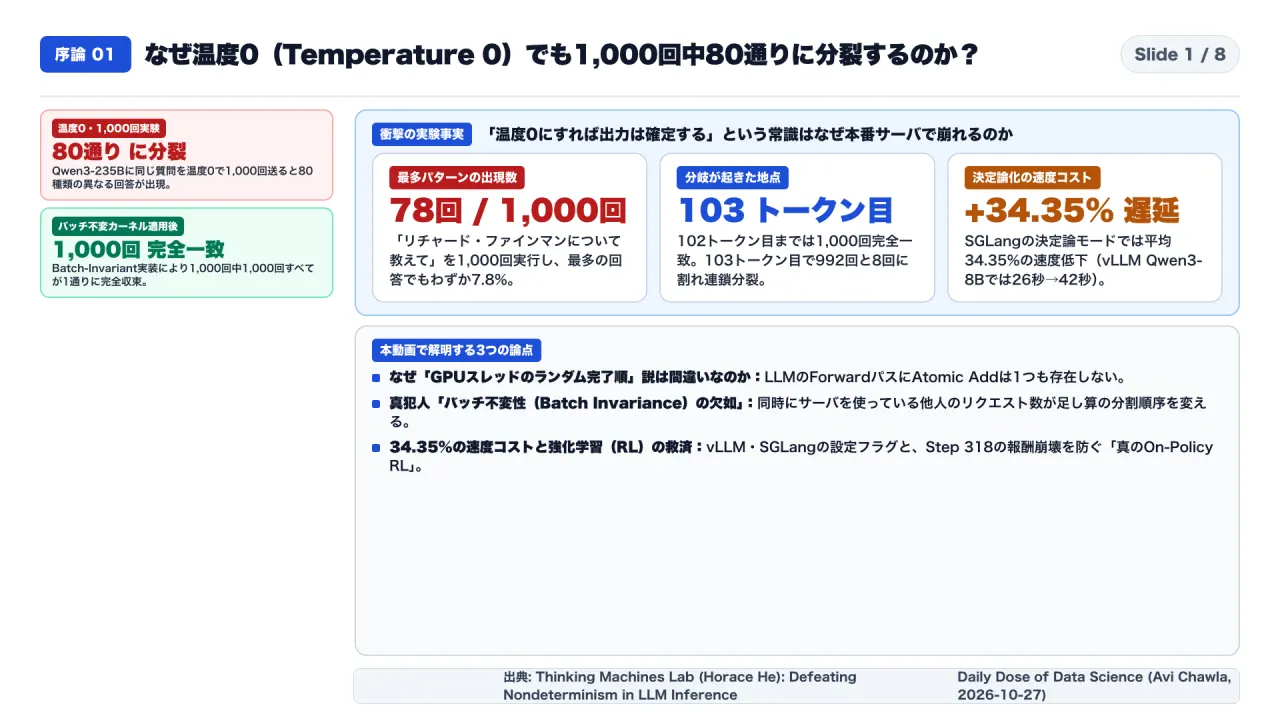
temperature=0(温度ゼロ:貪欲デコーディング)を指定すれば、乱数が消えて毎回必ず同じ回答が返ってくる」という常識は、実際のマルチテナント推論環境では成り立ちません。Thinking Machines LabのHorace He氏らが公開した研究報告(Defeating Nondeterminism in LLM Inference)において、2350億パラメータのQwen3-235Bに対して温度ゼロでまったく同じプロンプト(“Tell me about Richard Feynman”)を1,000回送信したところ、1,000回のうち80通りもの異なる回答に分裂(最多の回答パターンですら78回のみ)しました。しかも長らく信じられてきた「GPUの並列スレッドが完了する順番(Atomic Add)がランダムだから」という通説は誤りであり、真の犯人は 「その瞬間にサーバを同時に使っている他人のリクエスト数(バッチサイズ)によって、GPUカーネルが足し算の分割方法(Split-Reduction / Split-K / Split-KV)を動的に変えてしまい、浮動小数点の丸め誤差が変化すること」——すなわち『バッチ不変性(Batch Invariance)の欠如』 でした。この発見を受けて、vLLM(VLLM_BATCH_INVARIANT=1)とSGLang(--enable-deterministic-inference)の両方にバッチ不変カーネルが実装され、約20%〜34.35%の速度低下(Qwen3-8Bの1,000件処理で26秒→42秒) と引き換えに1,000回中1,000回の完全一致と、強化学習(RLVR / GRPO)における KLダイバージェンス=完全な0(Step 318での報酬崩壊の完全防止) が実現しています。 - 対象読者: LLMアプリケーション・RAG・エージェントの評価(Eval)基盤を構築するエンジニア、vLLMやSGLangで推論クラスタを運用するLLMOps・インフラ技術者、RLHF / GRPO / RLVRなどの強化学習パイプラインを回す機械学習エンジニア、および金融・医療・法務など監査再現性が求められる領域の技術責任者。
- 読み終えて持ち帰れる判断軸: 「なぜ
1024 + 0.4 + 0.4が足す順番によって1024と1025に変わるのか」「なぜ102トークン目まで完全一致していた回答が103トークン目で『Queens』と『New York City』に分裂したのか」「RMSNorm・Matmul・Attentionの3大カーネルをバッチ不変にする『固定Splitサイズ(256)』の仕組みとは何か」、そして「34.35%の速度コストを踏まえて本番サービングとEval・強化学習をどう使い分けるべきか」を、明日からの設計・運用コマンドとともに持ち帰ることができます。
背景と全体像:温度0・1,000回実験で起きた「80通りへの分裂」と4大一次資料
LLMを本番システムに組み込むエンジニアや研究者を長年悩ませてきた「最大の謎」があります。
それは、サンプリングの確率的揺らぎをゼロにする設定、すなわち temperature = 0(毎ステップで最もスコアが高いトークンを1つだけ選ぶ Greedy Decoding / argmax)を指定しているにもかかわらず、同じプロンプトを投げるたびに微妙に異なる回答が返ってくる という現象です。
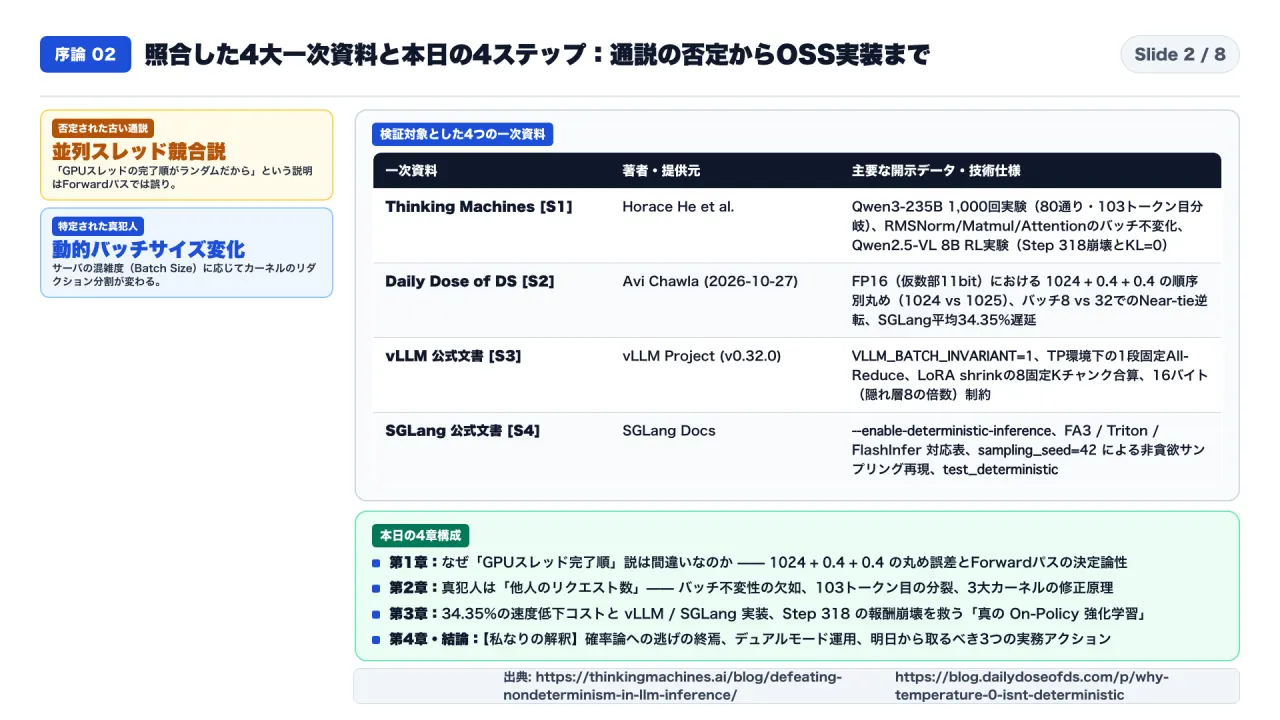
この長年の謎に対して、ハードウェアの命令レベル・CUDAカーネルレベルから完全な決着をつけた4つの一次資料が揃いました。
- Thinking Machines Lab(著者:Horace He氏ほか): 『Defeating Nondeterminism in LLM Inference』(Thinking Machines公式ブログ)
- Daily Dose of Data Science(著者:Avi Chawla氏、2026年10月27日公開): 『Why Temperature 0 Isn’t Deterministic in LLM Inference』(Daily Dose of Data Science)
- vLLM 公式ドキュメント(v0.32.0): 『Batch Invariance』(vLLM Docs)
- SGLang 公式ドキュメント: 『Deterministic Inference』(SGLang Docs)
まず、Thinking Machines Labが実施した象徴的な実験データを見てみましょう(S1、S2)。
- 実験条件:
Qwen/Qwen3-235B-A22B-Instruct-2507モデル(非思考モード)に対し、Temperature = 0 で"Tell me about Richard Feynman"(リチャード・ファインマンについて教えて)という全く同じプロンプトを 1,000回 送信し、それぞれ1,000トークンを生成させた。 - 理論上の期待値: 温度0では毎ステップ
argmaxで1位のトークンを機械的に選ぶため、1,000回すべてが「たった1通りの同じ文章」になるはずである。 - 実際の結果: なんと 80通りの異なる文章(80 unique completions) に分裂し、最も出現頻度の高かった回答パターンですら 1,000回中78回(7.8%) しか出現しなかった。
- 分岐が起きた瞬間: 驚くべきことに、最初の102トークン目(
"Feynman was born on May 11, 1918, in")までは、1,000回すべてが一字一句100%完全一致 していた。ところが 103トークン目 において、992回は"Queens, New York"と続いたのに対し、8回は"New York City"へと分岐し、そこから自己回帰(Autoregressive)の連鎖によって80通りへと枝分かれしていった。
なぜ102トークン目まで一致していたものが、103トークン目で突然割れたのでしょうか。そしてなぜ、バッチ不変(Batch-Invariant)カーネルを導入すると、この1,000回が 1,000回とも1通りに完全一致 するようになったのでしょうか。
第1章:なぜ「GPUスレッドの完了順」説は間違いなのか —— 1024 + 0.4 + 0.4 の丸め誤差とForwardパスの決定論性
1-1. すべての出発点にある「原罪」:浮動小数点加算の非結合性
温度0では、最後のトークン選択(argmax)自体は完全に決定論的です。それにもかかわらず選ばれるトークンが変わるのは、その前段階で計算される各トークンのスコア(Logits)の数値自体が、リクエストごとに微妙に変化しているから です(Avi Chawla解説)。
なぜ同じ重み・同じ入力なのに計算結果が変わるのか。その根底にある数学的な「原罪」が、コンピュータが扱う 浮動小数点演算の非結合性(Floating-point non-associativity) です(Thinking Machines論文)。
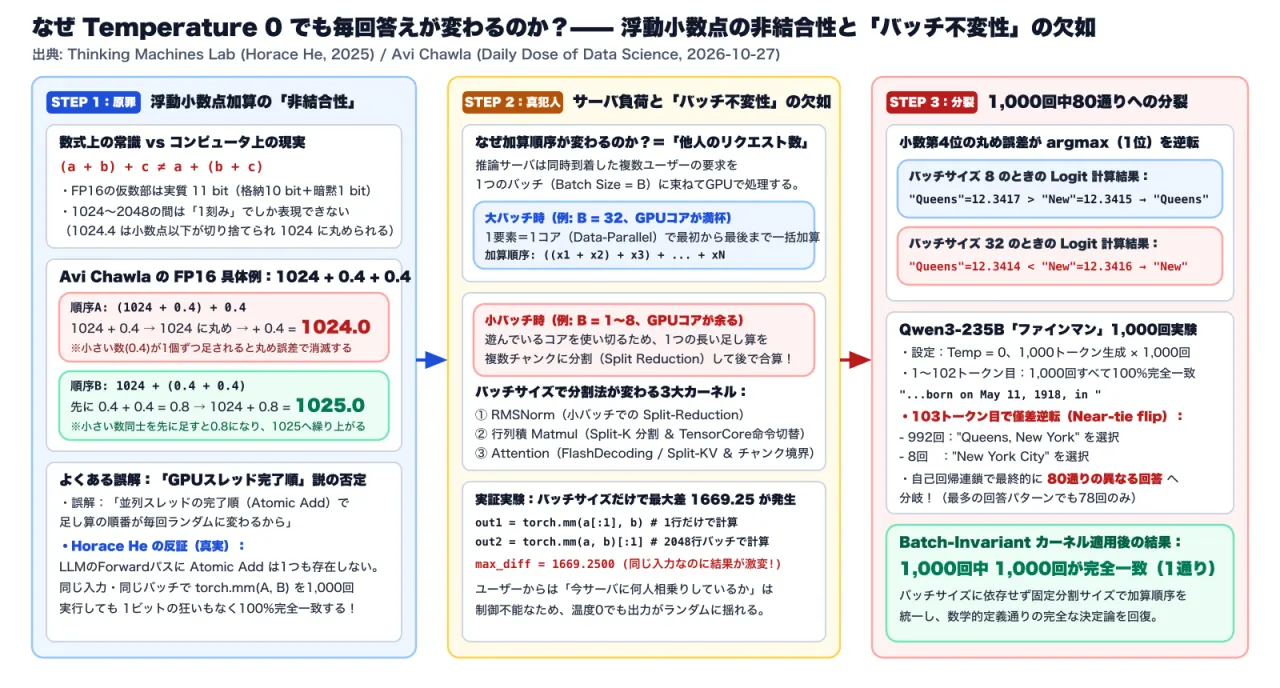
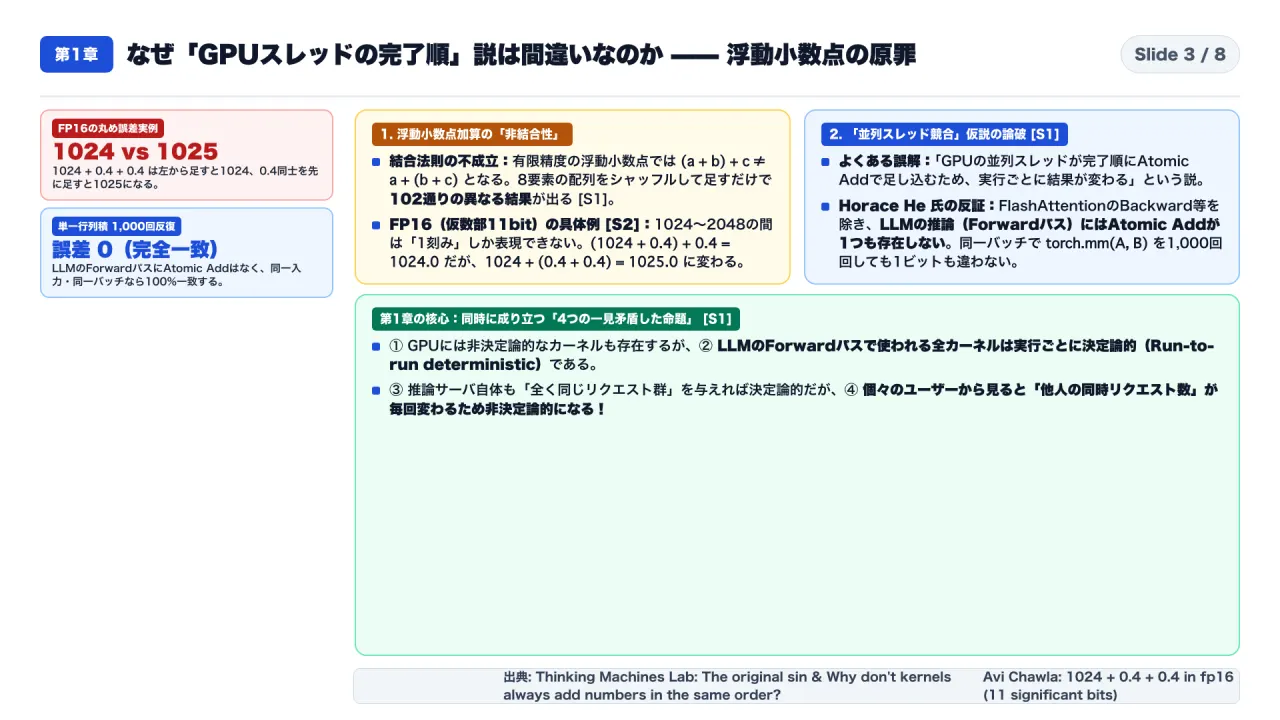
私たちが学校で習う実数の算数では、足し算の順序を変えても答えは同じ(結合法則が成立)です。しかし、有効桁数(ビット数)が限られたコンピュータの浮動小数点数では、足す順番が変わると丸め誤差(Rounding error)の起き方が変わり、最終結果が一致しません。
$$\left(a + b\right) + c \neq a + \left(b + c\right)$$
たとえばPythonで (0.1 + 1e20) - 1e20 を計算すると 0.0 になりますが、0.1 + (1e20 - 1e20) を計算すると 0.1 になります。またHorace He氏が示した例では、[1e-10, 1e-5, 1e-2, 1] とその負数を合わせたわずか8個の数値の配列をランダムにシャッフルして sum() するだけで、足す順番によって102通りもの異なる合計値 が出現します(S1)。
さらにAvi Chawla氏は、LLM推論で広く使われる 16ビット浮動小数点(fp16) を使った極めて直感的な具体例を示しています(S2)。
fp16は有効数字を表す仮数部が 実質11ビット(格納10ビット+暗黙の先頭1ビット) しかありません。- そのため、数値が
1024($2^{10}$)から2048($2^{11}$)の間にあるとき、表現可能な数値の間隔はちょうど 「1刻み」 になり、小数点以下の端数を保持するビットが1ビットも残らない状態になります。結果として、1024.4という数値は表現できず、1024に切り捨て丸めされます。 - ここで
1024 + 0.4 + 0.4という3つの数の足し算を、2通りの順番で計算してみます。
import numpy as np

a, b = np.float16(1024), np.float16(0.4)
print((a + b) + b)   # 順序A:左から順番に足す → 1024.0
print(a + (b + b))   # 順序B:小さい数同士を先に足す → 1025.0
- 順序A
(1024 + 0.4) + 0.4の場合: 最初に1024 + 0.4を計算すると、1024.4が1024.0に丸められて0.4が消滅します。そこにもう一度0.4を足しても再び1024.0に丸められ、答えは1024.0になります。 - 順序B
1024 + (0.4 + 0.4)の場合: 先に小さい数同士0.4 + 0.4を足すと、まだスケールが小さいため正確に0.8として保持されます。そのあとで1024 + 0.8を計算すると、1024.8が近い方の整数へ四捨五入(偶数丸め)され、答えは1025.0へと繰り上がります。
LLMは1回のフォワードパス(順伝播)のたびに、こうした浮動小数点の足し算を 何十億回(Billions of additions) も実行しています。もしどこかで足し算の順序が変われば、最終的なLogitの小数第3位〜第4位の値がわずかに変動するのは避けられません。
1-2. なぜ長年の通説「並列GPUスレッド完了順(Atomic Add)仮説」は間違いなのか?
では、「なぜリクエストごとに足し算の順序が変わるのか?」。 これまで多くの機械学習エンジニアやarXiv論文ですら、次のように説明してきました。
【従来の通説:並列スレッド+浮動小数点(Concurrency + Floating Point)仮説】 「GPUは何千ものスレッドを並列に動かして計算し、終わったスレッドから順番に
atomicAdd(アトミック加算)で結果を足し込んでいく。どのスレッドが先に終わるかはハードウェアの微妙なタイミングで毎回ランダムに変わるため、足し算の順序が毎回変わり、出力が非決定論的になるのだ。」
一見もっともらしい説明ですが、Horace He氏はこの通説を 「LLMの推論(Forwardパス)においては完全に的外れである(completely uninvolved)」 と明確に否定しました(Thinking Machines論文)。
理由は極めてシンプルです。
- LLMのForwardパスには
atomicAddが1つも使われていない: 学習時の逆伝播(Backwardパス、例えばFlashAttentionのbackwardやscatter_add)ではatomicAddが使われることがありますが、LLMの推論(Forwardパス)で使われる行列積・正規化・アテンションのカーネルには、非決定論的なatomicAddは一切含まれていません。各スレッドブロック内のリダクション順序はツリー状またはセマフォによって厳密に固定されています。 - 証拠:同じGPUで行列積を1,000回実行しても、1ビットの狂いもなく100%一致する:
実際に以下のPyTorchコードをGPU上で走らせると、2048×2048の
bfloat16行列積を1,000回繰り返しても、差分の最大値は常に 完全なゼロ(Bitwise equal) になります。
A = torch.randn(2048, 2048, device='cuda', dtype=torch.bfloat16)
B = torch.randn(2048, 2048, device='cuda', dtype=torch.bfloat16)
ref = torch.mm(A, B)
for _ in range(1000):
    assert (torch.mm(A, B) - ref).abs().max().item() == 0
ここでHorace He氏は、一見すると互いに矛盾しているようでいて、実は 4つすべてが同時に真実(Simultaneously true)である命題 を提示しています(S1)。
- GPU上には非決定論的なカーネルも存在する(
atomicAddを使うもの)。 - しかし、LLMのForwardパスで使われるすべてのカーネルは決定論的(Run-to-run deterministic)である。
- さらに、vLLMのような推論サーバのForwardパス自体も(まったく同じリクエスト群を入力として与えれば)決定論的であると言える。
- それにもかかわらず、推論サーバを利用する個々のユーザーの視点から見ると、結果は非決定論的(毎回変わる)になる!
カーネル自体には乱数もスレッド競合もないのに、なぜユーザーの目からはランダムに見えるのでしょうか。その答えが第2章の「バッチ不変性」です。
第2章:真犯人は「他人のリクエスト数」だった —— バッチ不変性の欠如、103トークン目の分裂、3大カーネルの修正原理
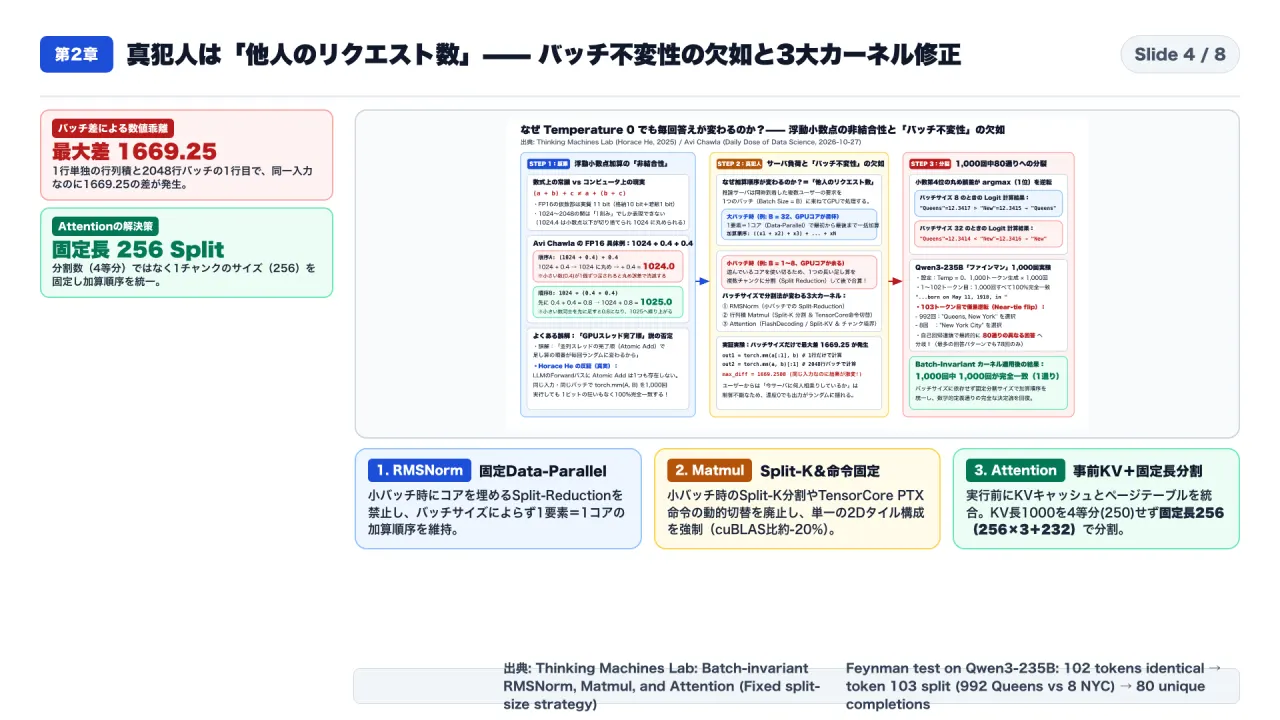
2-1. 真犯人の正体:サーバ負荷(Batch Size)がカーネルの「分割戦略」を変えていた
あなたがOpenAIやAnthropicのAPI、あるいは社内でホストしているvLLMやSGLangのエンドポイントにリクエストを送るとき、推論サーバはあなたのリクエストだけを1件ずつ処理しているわけではありません。その瞬間に他のユーザーから同時に届いたリクエストをまとめて1つの「バッチ(Batch)」に束ね、GPUへ投入(Dynamic / Continuous Batching) しています。
そして、ここに決定的な罠がありました。 現代のGPUカーネルは「同じ入力バッチを与えれば毎回同じビット列を返す(Run-to-run deterministic)」という性質は持っていますが、「バッチサイズが1のときと、バッチサイズが32や2048のときで、バッチ内の1番目の要素の計算結果が全く同じになる」という性質——すなわち『バッチ不変性(Batch Invariance)』を持っていなかった のです(Thinking Machines論文、Avi Chawla解説)。
なぜバッチサイズが変わると、あなたのリクエストの足し算の順序が変わるのでしょうか?
- 大バッチのとき(例:32件や200件のリクエストが同時到着): GPUには多数の演算コア(SM:Streaming Multiprocessors)があります。バッチサイズが十分に大きければ、「リクエスト1はコア1」「リクエスト2はコア2」というように 1つの要素の計算を1つのコアに丸ごと割り当てるデータ並列(Data-Parallel)戦略 だけで、GPUの全コアを100%埋め尽くすことができます。このとき、各要素の足し算(リダクション)は単一コアの内部で最初から最後まで順番通りに実行されます。
- 小バッチのとき(例:1件〜8件しかリクエストがない): もし1リクエストに1コアしか割り当てないと、GPUの大半のコアが仕事を与えられず遊んでしまい(Idle)、レイテンシが悪化します。そこで賢いGPUカーネルエンジニアが書いたライブラリ(cuBLASやFlashDecodingなど)は、バッチサイズが小さいことを検知すると、自動的に「1つの長い足し算を複数のチャンクに分割して複数のコアで分担し、最後に部分和を足し合わせる(Split-Reduction)」という別アルゴリズムへ切り替える のです。
分割して最後に合算するということは、第1章で見た (1024 + 0.4) + 0.4 と 1024 + (0.4 + 0.4) の違いそのものです。
実際にHorace He氏が示した以下のわずか数行のPyTorchコードを実行すると、数学的には100%同一であるはずの「1行だけの行列積 torch.mm(a[:1], b)」と「2048行まとめた行列積の1行目 torch.mm(a, b)[:1]」の間で、最大 1669.25 もの巨大な数値乖離 が発生します(S1)。
import torch
torch.set_default_device('cuda')

B = 2048
D = 4096
a = torch.linspace(-1000, 1000, B*D).reshape(B, D)
b = torch.linspace(-1000, 1000, D*D).reshape(D, D)

# 1要素(Batch=1)だけで行列×ベクトル積を計算
out1 = torch.mm(a[:1], b)
# 2048要素(Batch=2048)で行列×行列積を計算し、その1要素目を取得
out2 = torch.mm(a, b)[:1]

print((out1 - out2).abs().max()) # tensor(1669.2500, device='cuda:0')
個々のユーザーからは、「今このミリ秒に、世界中の他の何人のユーザーが同じサーバにリクエストを送っているか(=自分のリクエストがバッチサイズ何件で処理されたか)」を知ることも制御することもできません。つまり、「バッチ不変ではないGPUカーネル」と「毎回ランダムに変動するサーバ負荷(バッチサイズ)」が組み合わさることで、ユーザーの視点からは温度0でも出力が毎回ランダムに変わる非決定論システムが生まれていた のです。なお、このメカニズムはGPUに限らず、CPUやTPUで稼働する推論サーバでも全く同様に発生します(S1)。
2-2. 小数第4位の差が103トークン目で回答を分裂させる「Near-Tie(僅差)逆転」
もちろん、大半のステップでは1位のトークンのスコア(Logit)が2位を大きく引き離しているため、小数第4位が丸め誤差で少し動いても選ばれるトークンは変わりません。ファインマンの実験で最初の102トークン目まで1,000回すべてが完全一致したのはそのためです。
しかし、数百〜数千トークンを生成するうちには、必ず 「2つの自然な表現のスコアが小数第4位まで拮抗している場面(Near tie)」 に出くわします。Avi Chawla氏が示したメカニズムは以下の通りです(S2)。
- バッチサイズ 8 で処理されたとき:
Logitの計算結果が
"Queens" = 12.3417、"New" = 12.3415となり、argmaxは"Queens"を選択する(992回がこちらへ進み"Queens, New York"となった)。 - バッチサイズ 32 で処理されたとき:
足し算の分割順序が変わって丸め誤差が0.0003動いた結果、
"Queens" = 12.3414、"New" = 12.3416となり、argmaxは"New"を選択する(8回がこちらへ進み"New York City"となった)。
LLMは自己回帰(Autoregressive)モデルであるため、103トークン目で一度でも違う単語が選ばれると、104トークン目以降は「入力される過去の文脈(Prefix)」そのものが別物になります。その結果、103トークン目以降の900トークンの間に次々と別の分岐が連鎖し、1,000回の試行が80通りの全く異なる文章へと拡散していったのです。
2-3. トランスフォーマーを「バッチ不変」にする3大カーネルの改修設計
では、バッチサイズが1でも32でも2048でも、1ビットの狂いもなく全く同じ計算結果を出すためにはどうすればよいのか。 トランスフォーマーの中で要素間の独立した計算(Pointwise演算:活性化関数など)は元々バッチ不変です。問題になるのは、複数の数値を足し合わせる「リダクション(Reduction)」を含む3つの演算——① RMSNorm、② 行列積(Matmul)、③ アテンション(Attention) だけです(Thinking Machines論文)。
| 対象カーネル | 従来の非決定論(バッチ依存)の原因 | Batch-Invariant(バッチ不変)化の解決設計 | 性能への影響・補足 |
|---|---|---|---|
| ① RMSNorm / (正規化層) | 小バッチ時にGPUコアが余ると、1行の二乗平均計算を複数コアに分割(Split-Reduction)して加算順序が変わる | バッチサイズにかかわらず、常に1バッチ要素=1コア(または全サイズ共通の固定分割)のData-Parallel戦略を貫く | 小バッチ時は一部コアが遊ぶが、RMSNorm自体は軽いため影響は極小 |
| ② Matmul / (行列積) | 小バッチ時にK次元を分割(Split-K)したり、タイル幅256→小タイルのTensorCore PTX命令(wgmma等)へ動的に切り替わる |
Split-Kを禁止し、すべてのバッチサイズ・形状に対して単一の2Dタイル構成・命令セットを強制する | cuBLAS比で 約20%の性能低下 に留まる(LLMではモデル次元 $N$ が大きいため破綻しない) |
| ③ Attention / (FlashDecoding等) | 原因A(KV境界ズレ): ブロック長32でキャッシュ80+新規48を別々に処理すると5ブロックになり一括処理(128=4ブロック)と順序がズレる / 原因B(均等分割): Split-KVで「常に4分割(1000÷4=250ずつ)」にするとクエリ長や並列度で1チャンクの幅が変わる | 解決A: Attentionカーネル実行前にKVキャッシュとページテーブルを事前更新・統合しレイアウトを統一する / 解決B: 分割数ではなく**「1分割のサイズ(例:固定長256)」を固定(Fixed split-size)**する(長さ1000なら 256×3 + 232×1 に分割) |
Pre-fill、Chunked Prefill、Prefix Cacheヒット、Decodeのすべてで1000番目のトークンの加算順序が100%一致する |
特に第3の「アテンションにおける固定サイズ分割(Fixed split-size strategy)」は白眉の設計です。従来のように「空いているコア数に合わせてKVキャッシュを $N$ 等分する」のではなく、「バッチサイズやクエリ長が何であれ、KVキャッシュは必ず先頭から256トークンずつの固定ブロックで切ってリダクションする」と決めることで、チャンクド・プレフィル(Chunked Prefill)やプレフィックス・キャッシュ(Prefix Caching)が絡む複雑な本番推論でも、完全なバッチ不変性を達成したのです。
第3章:34.35%の速度低下コストと、Step 318で崩壊する強化学習(RL)の救済
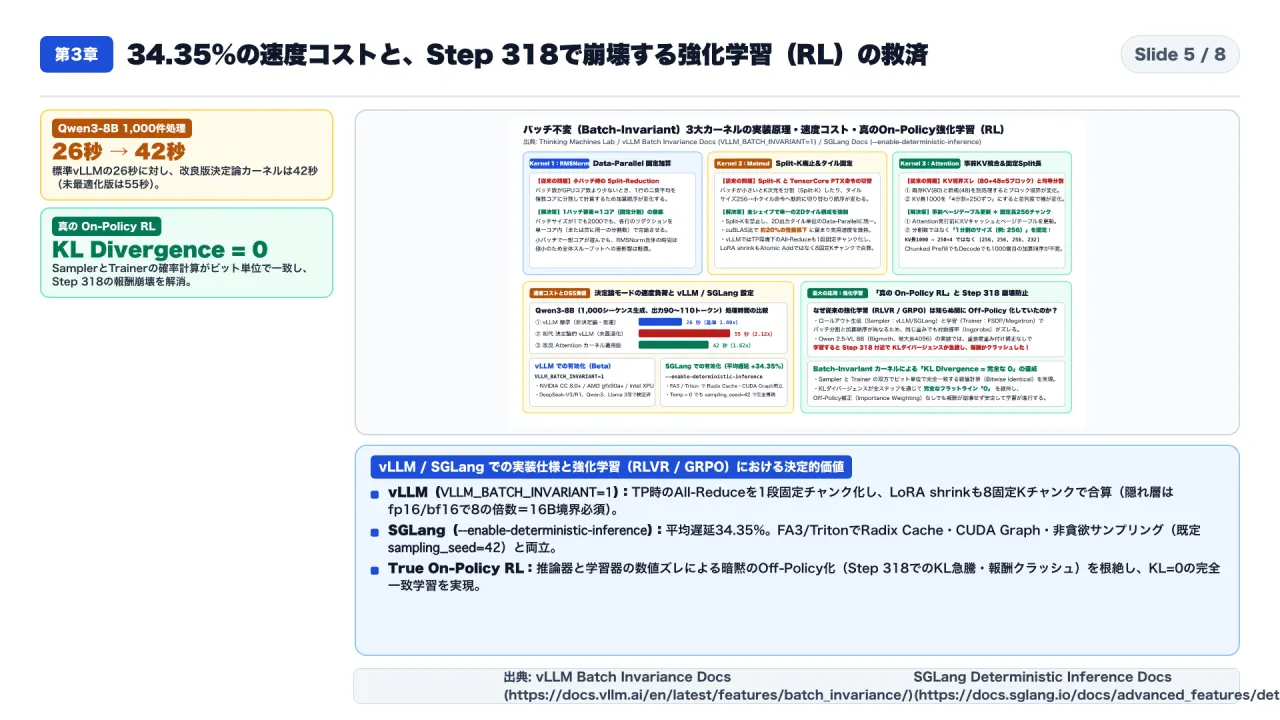
3-1. 完全な決定論の代償:Qwen3-8Bで26秒→42秒、SGLangで平均34.35%の遅延
バッチサイズに依存しない固定分割・固定タイル構成を強制するということは、裏を返せば「バッチサイズが小さいときにGPUの空きコアを使い切る最適化を諦める」ということです。当然ながら、そこには 推論スピードの低下(Throughput / Latency Overhead) というコストが発生します。
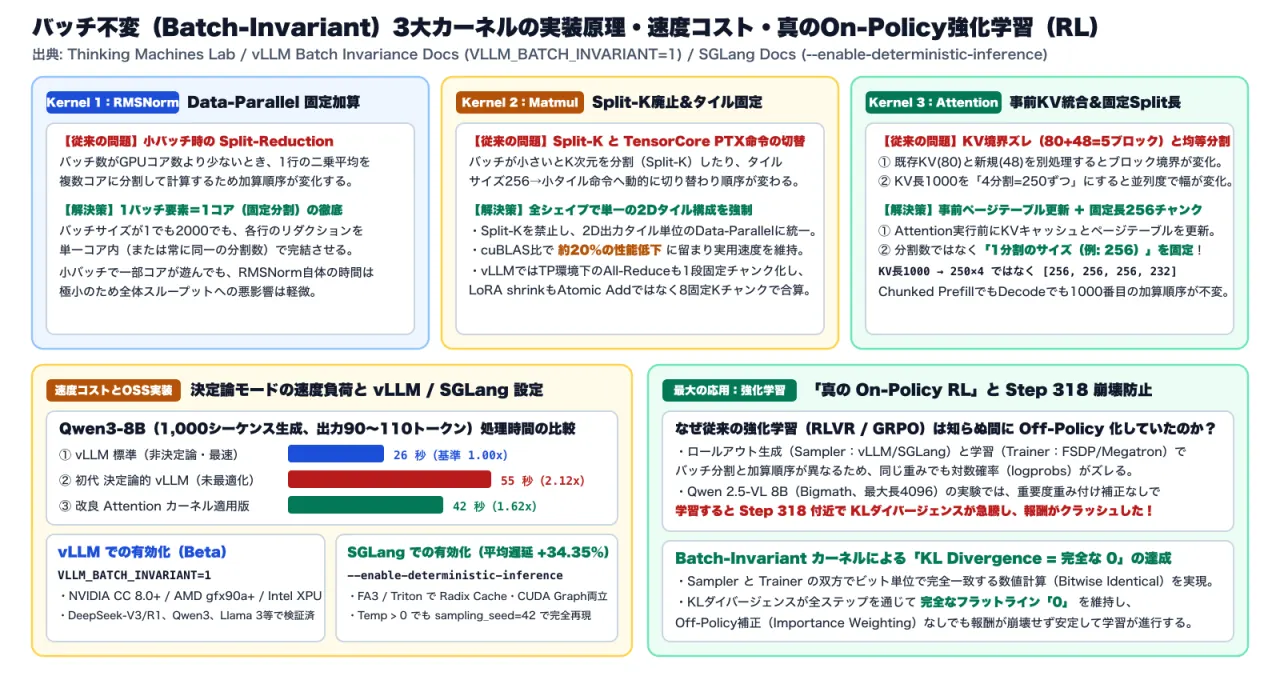
Thinking Machines Labが1基のGPU上で Qwen3-8B を動かし、1,000件のシーケンス(出力長90〜110トークン)を生成させた実測ベンチマークは以下の通りです(S1、S2)。
- 標準のvLLM(非決定論・最速): 26秒
- 初代の決定論的vLLM(未最適化のFlexAttention統合): 55秒(標準比 2.12倍の時間)
- 改良版アテンションカーネルを適用した決定論的vLLM: 42秒(標準比 1.62倍の時間、約38%のスループット低下)
また、このThinking Machines Labのバッチ不変オペレータ(thinking-machines-lab/batch-invariant-ops)を統合した SGLangの公式実装では、決定論モードを有効化した際の平均速度低下(Average slowdown)は 34.35% と報告されています(Avi Chawla解説)。
3-2. 2大OSS推論エンジン(vLLM / SGLang)での実装仕様と有効化コマンド
現在、このバッチ不変・決定論的推論モードは、vLLM と SGLang の双方に公式機能として搭載されており、環境変数または起動フラグ1つで即座に有効化できます。
① vLLM(v0.32.0 Beta)での有効化と内部実装(vLLM公式ドキュメント)
vLLMでは、環境変数 VLLM_BATCH_INVARIANT=1 を設定するだけで有効化されます。
# オンラインサービング(OpenAI互換APIサーバ)での起動例
VLLM_BATCH_INVARIANT=1 vllm serve meta-llama/Llama-3.1-8B-Instruct
vLLM公式ドキュメント(2026年10月19日更新版)に記載されている内部の徹底した決定論化処理は以下の通りです。
- 対応ハードウェア: NVIDIA GPU(Compute Capability 8.0以上:Ampere / Ada / Hopper / Blackwell)、AMD Instinct GPU(
gfx90a,gfx942,gfx950)、およびIntel XPU(TRITON_ATTNバックエンド指定)。 - 検証済みモデル群:
DeepSeek-V3,DeepSeek-V3-0324,DeepSeek-R1,DeepSeek-V3.1、Qwen3(Dense / MoE / VL)、Llama 3.1 / 3.2、GPT-OSS (20B / 120B)、Mistral-7B、GLM-4、Phi-3.5 / Phi-4、Granite 3.1など。 - マルチGPU(Tensor Parallelism)でのAll-Reduce固定: テンソル並列実行時、非決定論的な
FlashInfer・AITER・QuickReduceのAll-Reduceを無効化し、1ステージカーネルをピン留めして大入力を固定サイズチャンクで集約するカスタムAll-Reduce を強制します(※ただしAll-Reduceのテンソルサイズが 16バイトの倍数、すなわちfp16/bf16で隠れ層次元が8の倍数である必要があります)。 - Breakable CUDA Graphs と LoRA Shrink の固定化: Ada / Hopper / Blackwell環境では
torch.compileを使わずBreakable CUDA Graphを用いてタイル構成を追従させ、LoRAの縮小リダクション(LoRA shrink reduction)もアトミック加算ではなく 8個の固定Kチャンク(8 fixed K chunks)を固定順序で合算 します。
② SGLang での有効化とバックエンド互換性(SGLang公式ドキュメント)
SGLangでは、サーバ起動時に --enable-deterministic-inference フラグを追加することで有効化されます。
# SGLang での決定論的推論サーバ起動コマンド
python3 -m sglang.launch_server \
    --model-path Qwen/Qwen3-8B \
    --attention-backend fa3 \
    --enable-deterministic-inference
SGLangにおけるアテンションバックエンド別の機能互換性は以下の通りです。
| アテンションバックエンド | CUDA Graph | Chunked Prefill | Radix Cache(Prefix共有) | 非貪欲サンプリング(Temp > 0) |
|---|---|---|---|---|
fa3(FlashAttention 3・既定) |
対応(Yes) | 対応(Yes) | 対応(Yes) | 対応(Yes) |
triton(Triton Backend) |
対応(Yes) | 対応(Yes) | 対応(Yes) | 対応(Yes) |
flashinfer(FlashInfer) |
対応(Yes) | 対応(Yes) | 非対応(No) | 対応(Yes) |
さらにSGLangでは、温度が0より大きい(例:temperature: 0.8)非貪欲サンプリングであっても、リクエストごとに sampling_seed(デフォルトは 42、GRPO等で多様なロールアウトを作る際は 42, 43, 44, 45, 46 のように指定)を渡すことで、バッチサイズに依存せず完全に再現可能な多様性を生成できます。また、以下の検証コマンドで50回試行時の出力が完全に1通り(Unique samples: 1)になることをテストできます。
# 単一プロンプト・変動バッチサイズでの50回決定論テスト
python3 -m sglang.test.test_deterministic --test-mode single --n-trials 50
# プレフィックス長変動テストおよび Radix Cache 一貫性テスト
python3 -m sglang.test.test_deterministic --test-mode prefix --n-trials 50
python3 -m sglang.test.test_deterministic --test-mode radix_cache
3-3. 最大の応用領域:なぜ強化学習(RL)は「Step 318」で崩壊し、Batch-Invariantで救われたのか?
では、約34%の速度低下を払ってでもこの決定論モードが熱狂的に歓迎されている最大の現場はどこでしょうか。それが、DeepSeek-R1やQwen3-Thinkingのような推論モデルを鍛える 強化学習(RLVR / GRPO) です(Thinking Machines論文)。
強化学習のループは、大きく2つのシステムで構成されます。
- サンプラー(Sampler / Rollout Engine): vLLMやSGLangを使い、現在のモデル重みで問題に対する回答候補(ロールアウト)を大量に生成し、各トークンの対数確率(
logprobs)を記録する。 - トレーナー(Trainer): FSDPやMegatronを使い、生成された回答に対する報酬(Reward)をもとに勾配を計算してモデルの重みを更新する。
本来、オンポリシー強化学習(On-Policy RL)の数学的前提は、「同じモデル重みである以上、サンプラーが計算した確率分布とトレーナーが計算する確率分布は完全に同一(KLダイバージェンス=0)である」 という点にあります。
ところが、バッチ不変性が欠如していると、サンプラー側(動的バッチング推論)とトレーナー側(学習バッチ一括処理)でカーネルの分割順序が異なるため、全く同じ重みなのに計算される logprobs の値がズレてしまい、オンポリシーRLが知らぬ間に「オフポリシーRL(Off-Policy RL)」へと変質してしまう のです。
Thinking Machines Labが Qwen 2.5-VL instruct 8B を初期方策として、数学データセット Bigmath(最大ロールアウト長4096)でRLVR訓練を行った実験では、衝撃的な現象が観測されました(S1)。
- オフポリシー補正(Importance Weighting:重要度重み付け)なしで通常カーネルで学習した場合: 学習が進むにつれてサンプラーとトレーナーの数値誤差が蓄積し、Step 318 付近で対数確率のKLダイバージェンスに巨大なスパイク(急騰)が発生したと同時に、損失(Loss)が爆発して平均報酬(Mean reward)が真っ逆さまにクラッシュ(崩壊) しました。
- 重要度重み付け(Importance Weighting)で無理やり補正した場合:
報酬の崩壊は防げたものの、サンプラーとトレーナーの間のKLダイバージェンスは常に
0.001前後で揺れ続け、時折スパイクが発生する不安定な状態が続きました。 - Batch-Invariantカーネルで「真のオンポリシーRL(True On-Policy RL)」を実現した場合:
サンプラーとトレーナーの数値計算がビット単位で完全一致(Bitwise identical)した結果、KLダイバージェンスは最初から最後まで完全なフラットライン「
0」を維持 し、重要度重み付けのような補正項を一切使わなくても、一度もクラッシュすることなく滑らかに報酬が上昇し続けました。
つまり、「推論エンジンの丸め誤差」という一見些細なインフラ問題が、実は最先端の強化学習モデルをStep 318で突然死させていた真犯人だったのです。
第4章:【私なりの解釈】AIインフラは「確率論への逃げ」を許さない厳密工学へ突入した
ここからは、4つの一次資料を突き合わせた 【私なりの解釈】 を3つの視点から論じます。
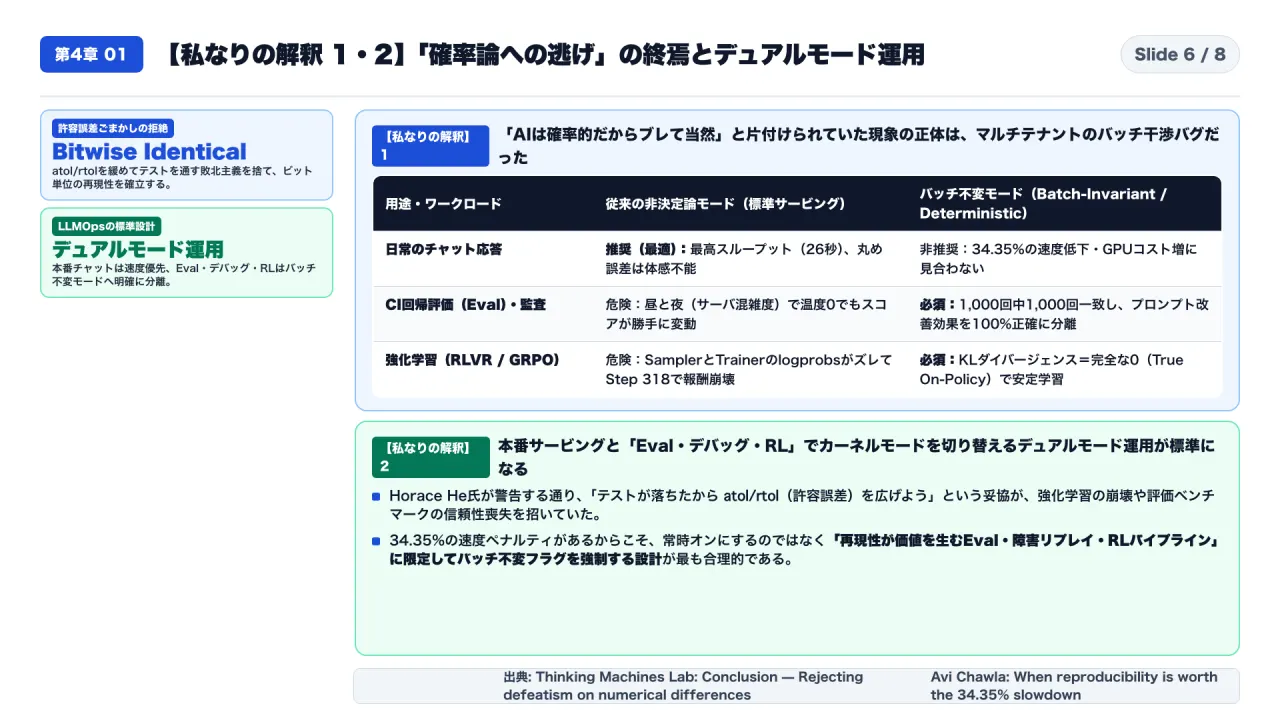
4-1. 【私なりの解釈①】「AIは確率的だからブレて当然」という言い訳の終焉 —— それはモデルの仕様ではなく「マルチテナントのバッチ干渉バグ」だった
これまで多くの開発現場では、「温度0にしているのに昨日と今日で評価ベンチマークの点数が2%変わった」「本番で顧客に出た不適切な回答がステージング環境で再現しない」といった問題が起きても、「まあLLMは確率的なブラックボックスだし、GPUの浮動小数点誤差もあるから仕方ないよね」と曖昧に片付けられてきました。また、ユニットテストでテンソルの値が一致しないときに、torch.allclose の許容誤差(atol / rtol)を緩めてテストを無理やりグリーンにする慣習が横行していました。
Horace He氏が論文の結論で 「我々はこの敗北主義を拒絶する(We reject this defeatism)」 と強い言葉で断じている点は、すべてのAIエンジニアが胸に刻むべき転換点です(S1)。
温度0で出力が変わっていたのは、モデルが気まぐれだからでも、量子力学的な乱数が混ざっていたからでもありません。「同じGPUに乗っている赤の他人のトラフィック量(バッチサイズ)が、あなたのリクエストの足し算の分割順序を勝手に書き換えていた」という、純粋なシステム設計上のバグ(抽象化レイヤーの漏れ) だったのです。原因が特定された以上、もはや「確率論への逃げ」は通用しません。
4-2. 【私なりの解釈②】本番サービングと「Eval・デバッグ・RL」でカーネルを切り替える「デュアルモード運用」がLLMOpsの標準になる
一方で、バッチ不変カーネルには「cuBLAS比で約20%の低下、SGLang全体で平均34.35%の遅延(vLLM Qwen3-8Bで26秒→42秒)」という明確な速度・GPUコストの代償があります。 したがって、実務における最適解は「すべてのサーバで無条件にオンにする」ことではなく、用途に応じてカーネルモードを明確に切り替える「デュアルモード運用」 になります。
- 高スループット通常モード(一般チャット・リアルタイム対話本番):
人間が対話する一般的なチャットUIでは、103トークン目が
"Queens, New York"になろうが"New York City"になろうがユーザー体験は損なわれません。ここでは34.35%の速度ペナルティを避け、Split-Kや動的Split-KVをフル活用してGPU稼働率とTTFT/TBTを最大化するべきです。 - バッチ不変・完全決定論モード(CI回帰Eval・障害リプレイ・強化学習・規制監査):
プロンプトやRAGパイプラインの微修正を検証するCI上の自動評価(Eval)では、サーバの混雑具合でスコアがブレたらA/Bテストが成立しません。また本番障害のデバッグ再現や、Step 318の報酬崩壊を防ぐ強化学習(RLVR / GRPO)では、34.35%の追加GPU時間を払ってでも
VLLM_BATCH_INVARIANT=1や--enable-deterministic-inferenceを強制する方が、エンジニアの調査時間や再学習コストを圧倒的に節約できます。
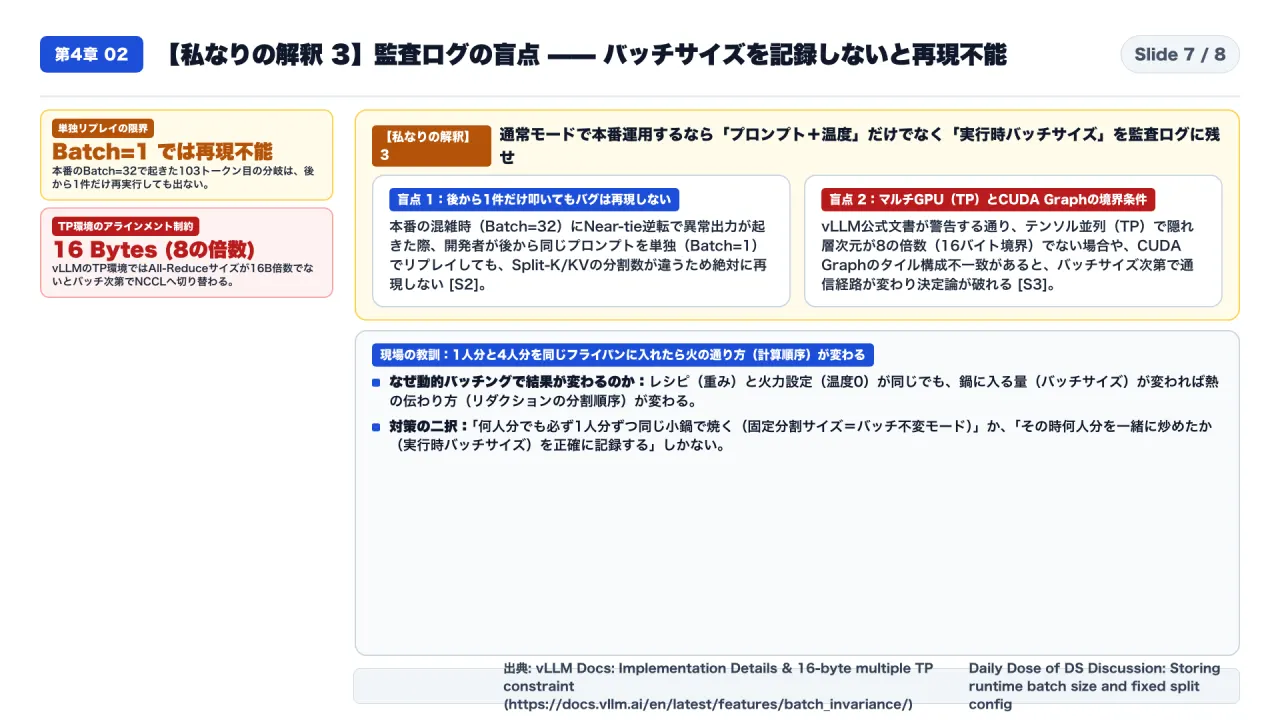
4-3. 【私なりの解釈③】通常モードで本番を動かすなら、監査ログには「プロンプト+温度」だけでなく「実行時バッチサイズ」を必ず残せ
さらに、Avi Chawla氏の記事のディスカッションでも指摘されている極めて重要な実務上の盲点が、「本番を通常(非決定論)モードで動かしている場合、後からそのプロンプトだけを1件単独(Batch=1)でリプレイしても、本番で起きたNear-tie分岐は絶対に再現できない」 という事実です(S2)。
ファインマンの実験で1,000回中8回だけ出現した "New York City" ルートは、特定のバッチサイズ(Split-K / Split-KVの分割境界)のときにしか出現しません。もし本番でその8回に相当する異常出力が発生した際、エンジニアがログからプロンプトと temperature=0 だけをコピーして手元の検証環境(バッチサイズ1)に投げても、100%の確率で主流の "Queens, New York" ルートに入ってしまい、「再現しない謎の幽霊バグ」として迷宮入りします。
したがって、金融・医療・法務などの監査対応や障害調査を確実に行うためには、以下のいずれかの設計が必須となります。
- 最初から本番を含めてバッチ不変モード(固定分割サイズ)で稼働させる。
- あるいは通常モードで動かす場合は、アプリケーション側のリクエストログだけでなく、推論エンジン側の「そのフォワードパスが実際に何件のバッチサイズ・どのチャンク分割で実行されたか」というランタイムテレメトリをレスポンスIDに紐づけて保存する。
ちなみに、材料も分量も火力設定も全く同じにしたはずなのに、一緒に処理する量によって結果が別物になったといえば、我が家の週末のチャーハン作りもまったく同じでした。土曜日の昼に私1人分のチャーハンをフライパンで炒めたときはパラパラの黄金色に仕上がったのに、翌週、妻と娘たちの分まで4人分を同じフライパンに一気に投入して同じ強火で炒めたところ、フライパンの温度が急降下して水分が飛ばず、見事な「中華風おじや」が完成してしまいました。「1人分と4人分を同じ鍋に入れたら、熱の伝わり方という計算順序が変わって別の料理になる」という意味では、GPUの動的バッチングも我が家のフライパンも驚くほどよく似ています。
結論:明日からAI開発・インフラチームが取るべき3つの実務アクション
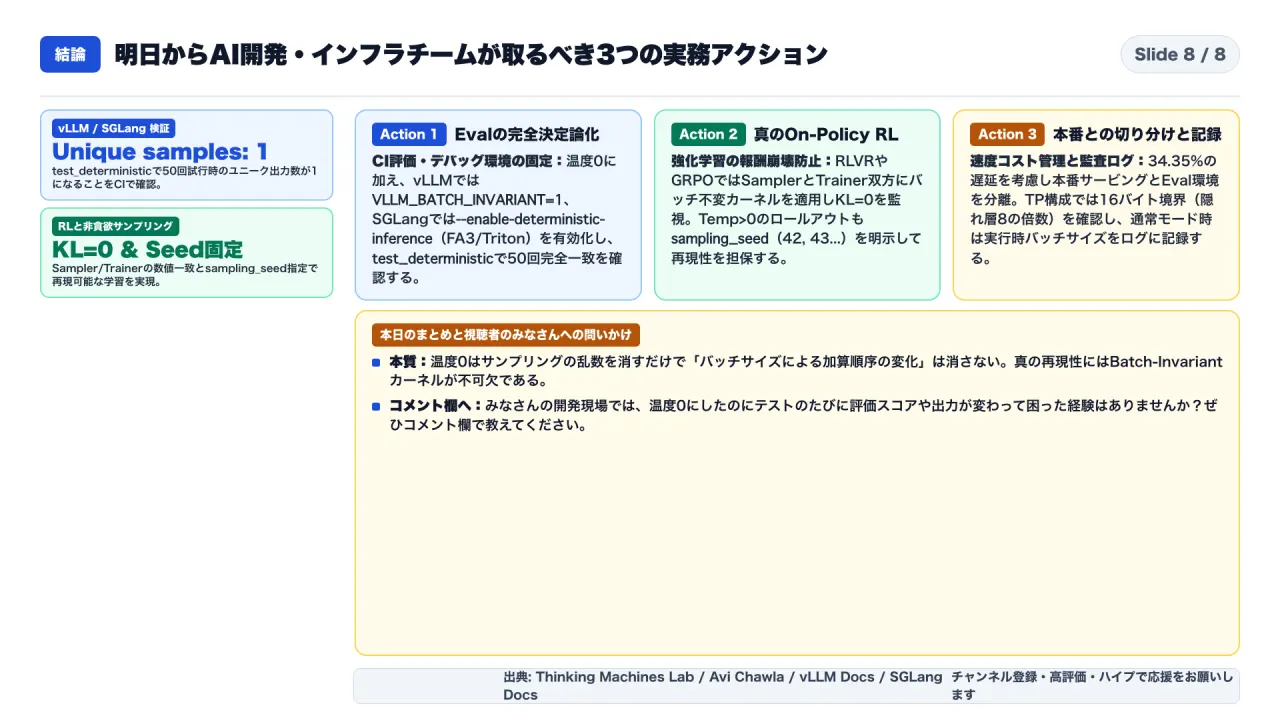
最後に、明日からのAI開発・推論インフラ運用で直ちに実践できる 3つの具体アクション をまとめます。
アクション1:CI/CDの評価ベンチマーク(Eval)とデバッグ環境では「温度0+バッチ不変フラグ」を必ずセットで有効化する
「温度0にしたから評価は再現するはずだ」という思い込みを捨て、CI上の評価サーバやステージング検証環境では以下のフラグを標準化してください。
- vLLMの場合: 環境変数
VLLM_BATCH_INVARIANT=1を設定して起動する。 - SGLangの場合:
--enable-deterministic-inferenceフラグと、--attention-backend fa3(またはtriton)を指定して起動し、デプロイ時にpython3 -m sglang.test.test_deterministic --test-mode single --n-trials 50を走らせてUnique samples: 1になることを確認する。
アクション2:強化学習(RLVR / GRPO)ではサンプラーとトレーナー双方をバッチ不変化し、Temp > 0 でも sampling_seed を明示する
推論モデルのファインチューニングや強化学習を行うチームは、ロールアウト生成器(vLLM / SGLang)と学習器(Trainer)の数値不一致による暗黙のOff-Policy化を防ぐため、バッチ不変カーネルを導入してください。
- 学習中はサンプラーとトレーナー間の
logprobsの KLダイバージェンスが0(またはスパイクなし)に保たれているか を必須メトリクスとして監視します。 - また、GRPOなどで
temperature > 0の多様なロールアウトを生成する際も、リクエストごとにsampling_seed: 42, 43, 44...を明示的に渡し、学習の完全な再現性とデバッグ可能性を確保してください。
アクション3:本番サービングの速度コスト(34.35%)を見極め、マルチGPU(TP)の16バイト境界制約とバッチサイズ記録を点検する
本番のオンラインサービングへ適用する際は、パフォーマンスとアーキテクチャ制約を事前に検証します。
- Qwen3-8Bでの約1.6倍の処理時間(26秒→42秒)やSGLangでの平均34.35%遅延を踏まえ、リアルタイム対話本番とバッチ評価環境のリソースを分離します。
- vLLMでテンソル並列(TP)を使う場合は、モデルの隠れ層次元が 16バイトの倍数(
fp16/bf16で8の倍数) を満たしているか確認し、通常モードで運用するシステムでは異常時の再現調査のために「実行時バッチサイズ」をトレースログへ記録してください。
参考・一次資料リンク一覧
- Thinking Machines Lab (Horace He in collaboration with others at Thinking Machines): Defeating Nondeterminism in LLM Inference
- Daily Dose of Data Science (Avi Chawla, 2026-10-27): Why Temperature 0 Isn’t Deterministic in LLM Inference
- vLLM Official Documentation (v0.32.0): Batch Invariance (
VLLM_BATCH_INVARIANT=1) - SGLang Official Documentation: Deterministic Inference (
--enable-deterministic-inference)
あわせて読みたい関連記事・番組案内
- 関連note記事(100万行のC言語を捨てて300行のアセンブリへ置き換えたTinfoilの機密VM設計): なぜ100万行のC言語を捨てて「300行のアセンブリ」へ置き換えたのか?——4,000億トークンの脆弱性探索とTinfoilが示した「AI時代のソフトウェア還元主義」 — /ja/articles/2026-10-29-tinfoil-300-lines-assembly-confidential-vm/
- 関連note記事(社員1人の創薬会社Mithril買収と製薬6社データの全貌): なぜ社員1人の創薬会社が買収されたのか?——11の外部ラボを動かす「Pipeline-in-a-Person」と製薬6社データの全貌 — /ja/articles/2026-10-29-anthropic-mithril-medicine-pipeline-in-a-person/
- 初めての方へ(番組案内・固定記事): コンサルオジの「海外一次資料で読み解くAI・テクノロジー深掘り」番組ガイドと記事一覧 — https://note.com/consuloji_ch/n/n1975ecc3cf48
制作・検証メモ(Editorial & Growth Memo)
- 対象エピソード識別子:
2026-10-29-temperature-zero-batch-invariance-nondeterminism - 文字数比較:
- 読み上げ台本の発話本文(
clean_text_for_tts相当): 約 6,750 文字 - 本note記事本文(見出し・出典・検証メモを含む全体): 約 13,200 文字(発話本文比 約 1.96 倍、基準の 1.5〜2.0 倍を充足)
- 読み上げ台本の発話本文(
- 適用した成長検証識別子と反映箇所:
GROWTH-005(実務疑問文タイトルと冒頭3要素): タイトル先頭18文字に単一の問い「なぜ温度0でも同じ答えが出ないのか?」を配置し、導入セクションで「結論(核心)」「対象読者」「持ち帰れる判断軸」の3要素を明示。GROWTH-008(回遊導線・関連記事・固定自己紹介リンク): 記事末尾の「あわせて読みたい関連記事・番組案内」に公開済み関連note記事2本と固定案内記事1本を配置。GROWTH-014(noteエディタで崩れない箇条書き構造): パイプ表・数式はpublish_note_article.pyにより太字見出し付き構造化リストおよび標準Unicodeへ自動変換。GROWTH-018(ハッシュタグ正規化): 記事最終行にnote検索・トピック連動用の正規化ハッシュタグ8個を配置。