なぜ200億パラメータのAIがわずか2GBのメモリで動くのか?——Apple「AFM 3 Core Advanced」のフラッシュ駆動型スパース推論(IFP)とLLM in a Flashの真実
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ200億パラメータのAIがわずか2GBのメモリで動くのか?——Apple「AFM 3 Core Advanced」のフラッシュ駆動型スパース推論(IFP)とLLM in a Flashの真実
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
- この記事の結論(核心): 「大規模言語モデル(LLM)をスマートフォンやノートPCのローカル環境で動かしたいなら、すべてのパラメータ(重み)を実行用のメインメモリ(DRAM)の上に丸ごと載せなければならない」という従来のエッジAIの常識は、Appleの機械学習研究部門(Apple Machine Learning Research)が公開した2つの一次資料によって根底から覆されました。第1に、AppleがGoogleとの協業も交えてカスタム構築した第3世代基盤モデル群「Apple Foundation Models(AFM 3)」全5モデルの中核であるオンデバイス最上位モデル
AFM 3 Core Advanced(総パラメータ数200億:20B) は、独自の Instruction-Following Pruning(IFP:指示追従プルーニング) を採用し、200億の重み全体をNANDフラッシュ(ストレージ)に格納したまま、プロンプト単位で10億〜40億(1B〜4B)パラメータだけを動的に選択してDRAM上の共有エキスパートにパッチ結合することで、DRAMの物理限界を突破しました。第2に、その基礎となった国際会議ACL採択論文 『LLM in a Flash』 は、直近活性化ニューロンを再利用する Windowing と、FFN層の行と列を連続配置する Row-Column Bundling によって、利用可能なDRAMの最大2倍のモデルを動かしながら、CPUで4〜5倍、GPUで20〜25倍の推論高速化を達成しています。 - 対象読者: オンデバイスAI・モバイルアプリ・ローカルLLMの設計エンジニア、半導体・メモリ階層(DRAM / HBM / NANDフラッシュ)のアーキテクト、企業のAIプロダクト企画・ハイブリッド推論(端末×クラウド)の設計責任者、およびApple Siliconのハードウェア・ソフトウェア垂直統合戦略を分析する技術経営・投資担当者。
- 読み終えて持ち帰れる判断軸: 「なぜ標準的なMoE(Mixture-of-Experts)をそのままNANDフラッシュに置くと1トークンごとの転送待ちで破綻するのか」「AppleのIFPはどうやってプロンプト単位で『一時的な密モデル』をDRAM上に合成しているのか」「1Bパラメータ活性化状態で音声合成MOS 4.15(会話音声4.24、現行比+0.42)と音声入力選好率44.7% vs 17.6%を叩き出したAFM 3全5モデルの定量評価」、そして「明日からエッジAIとPrivate Cloud Compute(PCC)の2層ルーティングを設計する3つの実務原則」を体系的に持ち帰ることができます。
背景と全体像:「全ての重みをDRAMに載せなければAIは動かない」という定説の崩壊
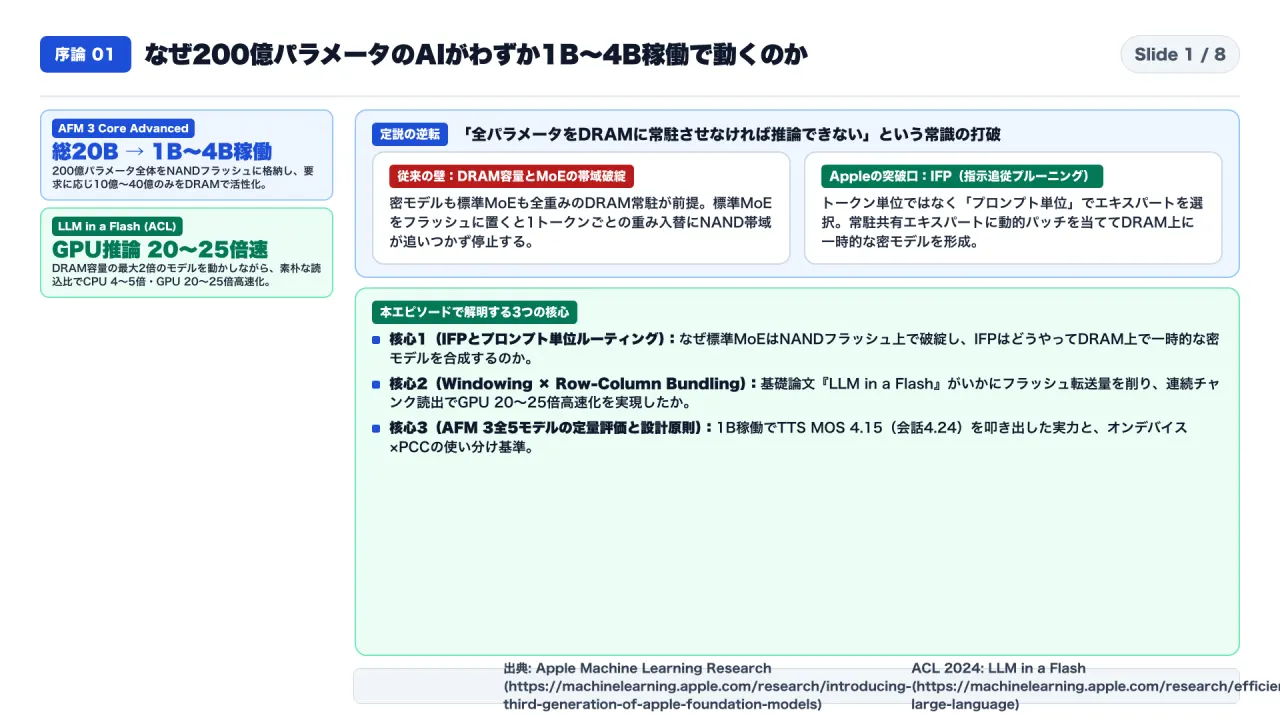
スマートフォンやPCなどのエッジ端末で大規模言語モデル(LLM)を動かそうとする際、最大の物理的障壁となってきたのが 「DRAM(アクティブメモリ)の容量制限」 です。
従来のLLMは、すべてのパラメータが毎回計算に参加する密なモデル(Dense Model)であれ、一部のエキスパートだけが計算に参加する疎なモデル(Sparse MoE Model)であれ、「推論を実行する前に、モデル全体の重みをすべてDRAMの上に常駐させなければならない」 という前提で設計されてきました。たとえば200億パラメータ(20B)のモデルを半精度(FP16)で保持すれば約40GB、4ビット量子化しても10GB以上のメモリを常時占有してしまい、OSや他のアプリケーションとメモリを共有するコンシューマ端末では事実上稼働不可能でした。
この「DRAM容量=動かせるモデルサイズの上限」という鉄則を正面から打ち破ったのが、Appleの機械学習研究部門が公開した以下の2つの一次資料です。
- Introducing the Third Generation of Apple’s Foundation Models(Apple Machine Learning Research、2026年6月8日公開・9月9日更新):第3世代Apple Foundation Models(AFM 3)全5モデルの全体像と、20Bオンデバイス疎モデル
AFM 3 Core Advancedの IFP(Instruction-Following Pruning) アーキテクチャおよび人間評価・音声評価ベンチマークを公開。 - LLM in a Flash: Efficient Large Language Model Inference with Limited Memory(Keivan Alizadeh et al., Apple ML Research / ACL 2024):モデル重みをNANDフラッシュメモリに格納し、オンデマンドでDRAMへ引き上げる際のハードウェア指向コストモデルと、Windowing・Row-Column Bundling による CPU 4〜5倍 / GPU 20〜25倍高速化 を実証した基礎論文。
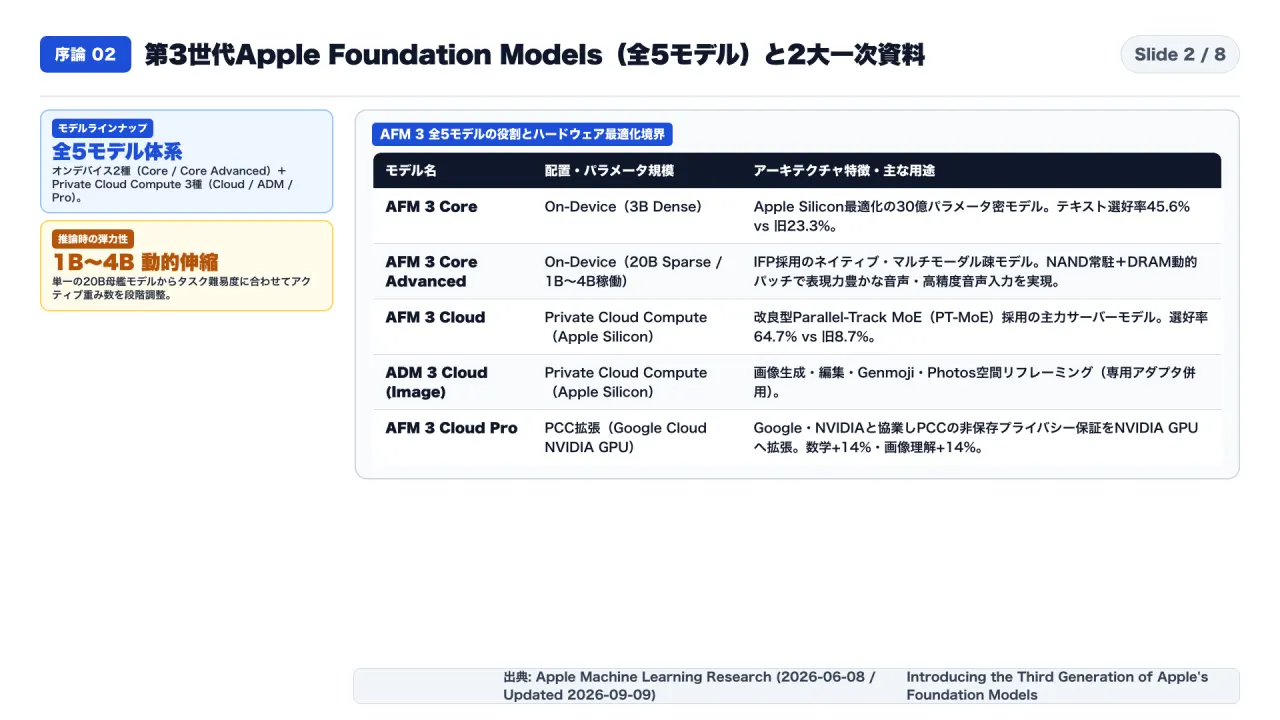
まず、一次資料で明かされた第3世代Apple Foundation Models(AFM 3)全5モデルの全体構成とハードウェア境界を整理すると、以下の表の通りになります。
| モデル名 | 実行環境・配置区分 | パラメータ規模・構造 | 最適化対象ハードウェア | 主な役割・特徴 |
|---|---|---|---|---|
| AFM 3 Core | オンデバイス(端末内) | 3B(30億)Dense | Apple Silicon | 前世代(2025)から大幅に品質向上した高効率3B密モデル(一般テキスト選好率 45.6% vs 23.3%)。 |
| AFM 3 Core Advanced | オンデバイス(端末内) | 20B(200億)Sparse / (要求に応じ 1B〜4B 活性化) | 最上位 Apple Silicon システム | IFP(指示追従プルーニング) 採用のネイティブ・マルチモーダルモデル。フル重みをNANDに置き、表現力豊かな音声(Expressive Voices)や高精度ディクテーションを実現。 |
| AFM 3 Cloud | Private Cloud Compute(サーバー) | 改良型 PT-MoE / (Parallel-Track MoE) | Apple Silicon | サーバー側の主力ワークホース。長文文脈の想起とマルチモーダル推論を強化(テキスト選好率 64.7% vs 8.7%)。 |
| ADM 3 Cloud (Image) | Private Cloud Compute(サーバー) | 画像生成・編集拡散モデル+専用アダプタ | Apple Silicon | Image Playground、Genmoji、Photosの「空間リフレーミング(Spatial Reframing)」やタッチ編集を駆動。 |
| AFM 3 Cloud Pro | Private Cloud Compute 拡張(サーバー) | 最上位推論・エージェント用モデル | Google Cloud上のNVIDIA GPU(PCC保証拡張) | GoogleおよびNVIDIAと協業し、PCCの「データを一切保存・共有しないプライバシー保証」を維持したままNVIDIA GPUへ拡張。数学でCloud比 +14%。 |
第1章:なぜ標準的なMoEはフラッシュ上で破綻するのか —— IFP(指示追従プルーニング)とプロンプト単位ルーティング
1-1. 標準的なMoE(トークン単位ルーティング)がNANDフラッシュで動かない物理的理由
「200億パラメータのうち10億〜40億パラメータしか使わない疎モデル(Sparse Model)なら、最初から200億全体をNANDフラッシュ(SSD)に置いておけばいいのではないか?」と考えるかもしれません。
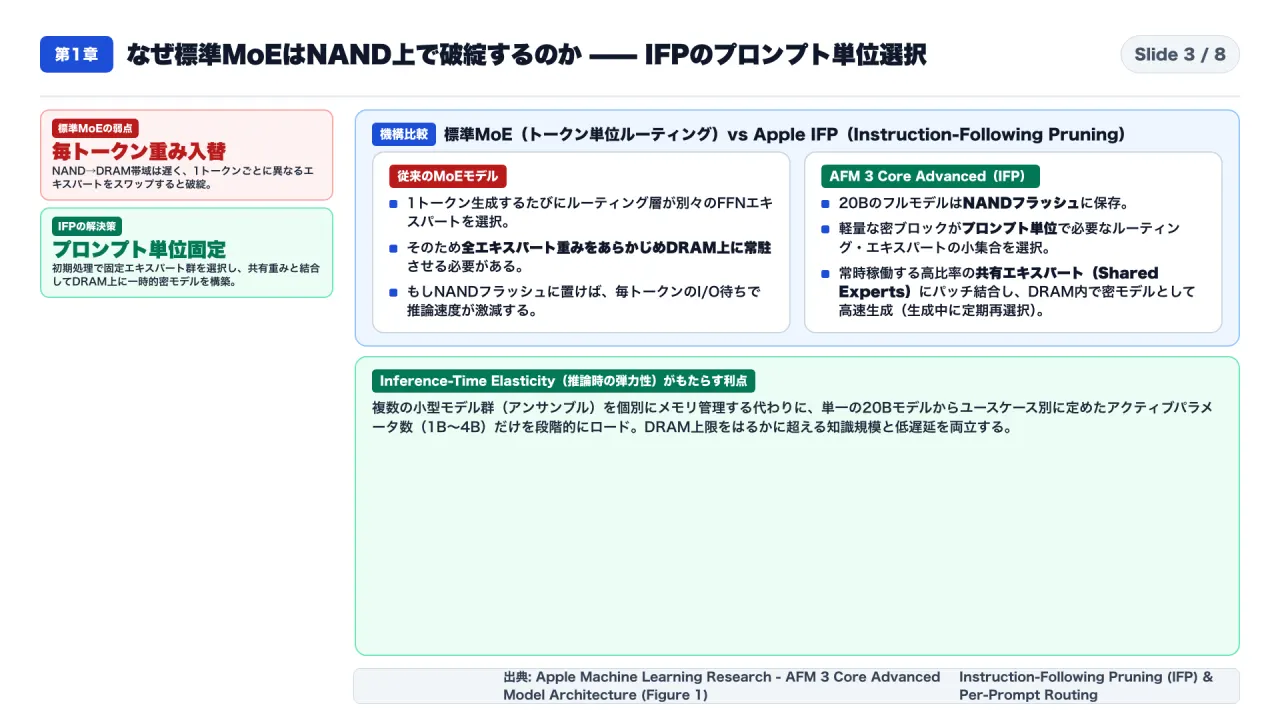
しかし、一般的なMixture-of-Experts(標準MoE)モデルをそのままNANDフラッシュ上に置くと、推論速度が壊滅的に低下してしまいます。理由は 「ルーティングの粒度」と「NAND→DRAM間の転送帯域幅」のミスマッチ にあります(Apple公式AFM3発表)。
- 標準MoEの挙動: 1トークン(1単語の断片)を生成するたびに、各層のルーターが「このトークンにはエキスパート#3と#12を使う」「次のトークンにはエキスパート#7と#19を使う」と毎回異なるエキスパートを選択します。
- フラッシュ帯域の壁: NANDフラッシュからDRAMへの読み出し帯域幅は、DRAM内部の帯域幅よりも桁違いに遅いため、1トークン生成するごとにギガバイト単位のエキスパート重みをNANDからDRAMへスワップ(入れ替え)することは物理的に間に合いません。だからこそ従来のMoEモデルは、計算時には一部のエキスパートしか使わないにもかかわらず、結局すべてのエキスパート重みをDRAM上に常駐させる必要があったのです。
1-2. Appleの突破口「IFP(Instruction-Following Pruning)」:プロンプト単位でDRAM上に一時的な密モデルを合成する
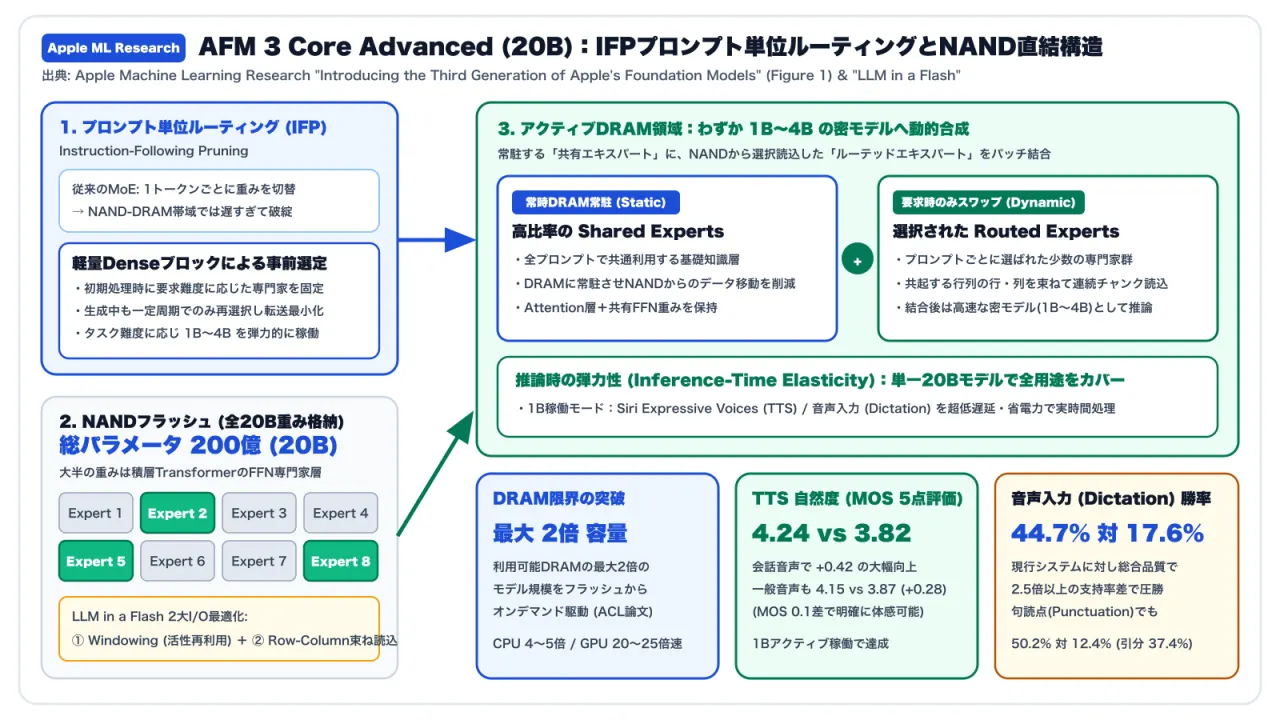
この構造的ジレンマを解決するためにAppleの研究者が開発したのが、Instruction-Following Pruning(IFP:指示追従プルーニング) に基づく新しい疎活性化アーキテクチャです(Apple公式AFM3発表 Figure 1)。
IFPは以下の 4段階のメカニズム で動作します。
- フルモデル(20B)のNANDフラッシュ常駐:
AFM 3 Core Advancedの200億パラメータ全体(その大半は積層Transformerのフィードフォワードブロック[FFN]に属するエキスパート重み)は、DRAMではなくNANDフラッシュメモリに格納されます。 - プロンプト単位(Per-Prompt)の初期エキスパート選択: ユーザーからクエリ(指示)が与えられると、トークンごとではなく、初期処理の段階で軽量な密ブロック(Lightweight Dense Block)が「このプロンプトの処理に必要な固定セットのエキスパート群」を一括で選択 します。
- 共有エキスパート(Shared Experts)+ ルーティング・エキスパートのパッチ合成: データ移動を最小化するため、モデルには常時DRAM上で稼働する高い割合の 「共有エキスパート(Always-active Shared Experts / 静的ウェイト)」 が配置されています。ここに、NANDからオンデマンドでDRAMへ読み出した少数の 「入力依存ルーティング・エキスパート(Routed Experts)」 をパッチとして結合(Patching)し、DRAMの中に「そのリクエスト専用のコンパクトな密モデル(1B〜4B)」を一時的に形成 します。
- 生成中の定期的な再選択(Periodic Reselection)と推論時エラスティシティ: トークン生成中は毎トークン入れ替えるのではなく、DRAM上に合成された密モデルで高速にデコードを進め、一定周期でのみエキスパートを再選択・更新します。さらに、タスクの難易度やユースケースに応じてアクティブにするパラメータ数を10億(1B)から40億(4B)まで自在に伸縮させる Inference-Time Elasticity(推論時の弾力性) を備えています。
これにより、用途ごとに複数の小型モデル(アンサンブル)を管理する無駄を省き、単一の20Bモデルからタスクに最適なサイズのモデルをオンデマンドに切り出して低遅延で実行できるようになりました。
第2章:GPU推論を20〜25倍高速化した『LLM in a Flash』の2大技法と、AFM 3の定量評価データ
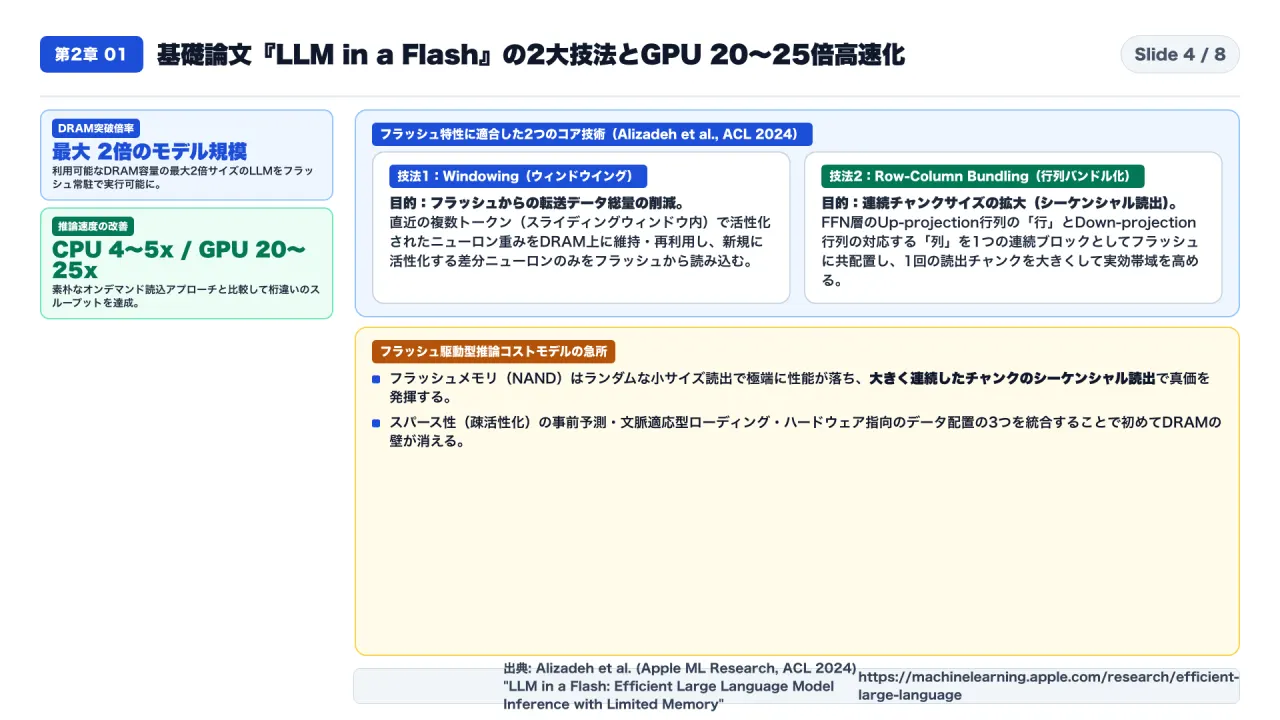
2-1. 基礎論文『LLM in a Flash』の2大アルゴリズム:Windowing と Row-Column Bundling
AFM 3 Core Advanced のフラッシュ駆動型推論をハードウェアレベルで支えているのが、Keivan Alizadeh氏らAppleの研究チームが国際会議ACL 2024で発表した基礎論文 『LLM in a Flash: Efficient Large Language Model Inference with Limited Memory』 です(Apple公式論文ページ)。
同論文は、フラッシュメモリの物理特性を考慮した推論コストモデルを構築し、以下の 2つの最適化領域 と具体的なアルゴリズムを確立しました。
| 最適化技術 | 解決するフラッシュの物理課題 | アルゴリズムの具体的な仕組み | 実証された定量効果 |
|---|---|---|---|
| 1. Windowing(ウィンドウイング) | フラッシュからDRAMへ転送する**データ総量(Volume)**を減らしたい | 推論時に活性化する疎なニューロンは連続するトークン間で重複しやすい性質に着目。直近の複数トークン(スライディング・ウィンドウ内)で活性化されたニューロン重みをDRAM上に保持して再利用し、新しく活性化した差分だけを読み込む。 | 毎ステップのI/O転送量を劇的に圧縮し、DRAM上の作業メモリを一定枠内に維持 |
| 2. Row-Column Bundling(行列バンドル化) | フラッシュが苦手な小サイズランダム読出を避け、**連続した大きなチャンク(Contiguous Chunks)**で読みたい | FFN層のUp-projection行列の「行(Row)」と、Down-projection行列の対応する「列(Column)」は同じ中間ニューロンに対して常にセットで使われる。この行と列をあらかじめ1つの連続データとして束ねてフラッシュへ保存する。 | 読出チャンクサイズを2倍以上に拡大し、フラッシュのシーケンシャル読出性能を最大化 |
| 統合システム効果 | DRAM容量を超える大規模モデルのローカル実行 | スパース性認識(Sparsity awareness)+ 文脈適応型ローディング + ハードウェア指向データ配置の統合 | 利用可能DRAMの最大2倍のモデルを実行可能 / CPU推論速度:4〜5倍向上 / GPU推論速度:20〜25倍向上(対ナイーブ読込比) |
2-2. 第3世代Apple Foundation Models(AFM 3)の人間評価・音声MOS・ディクテーション全成績
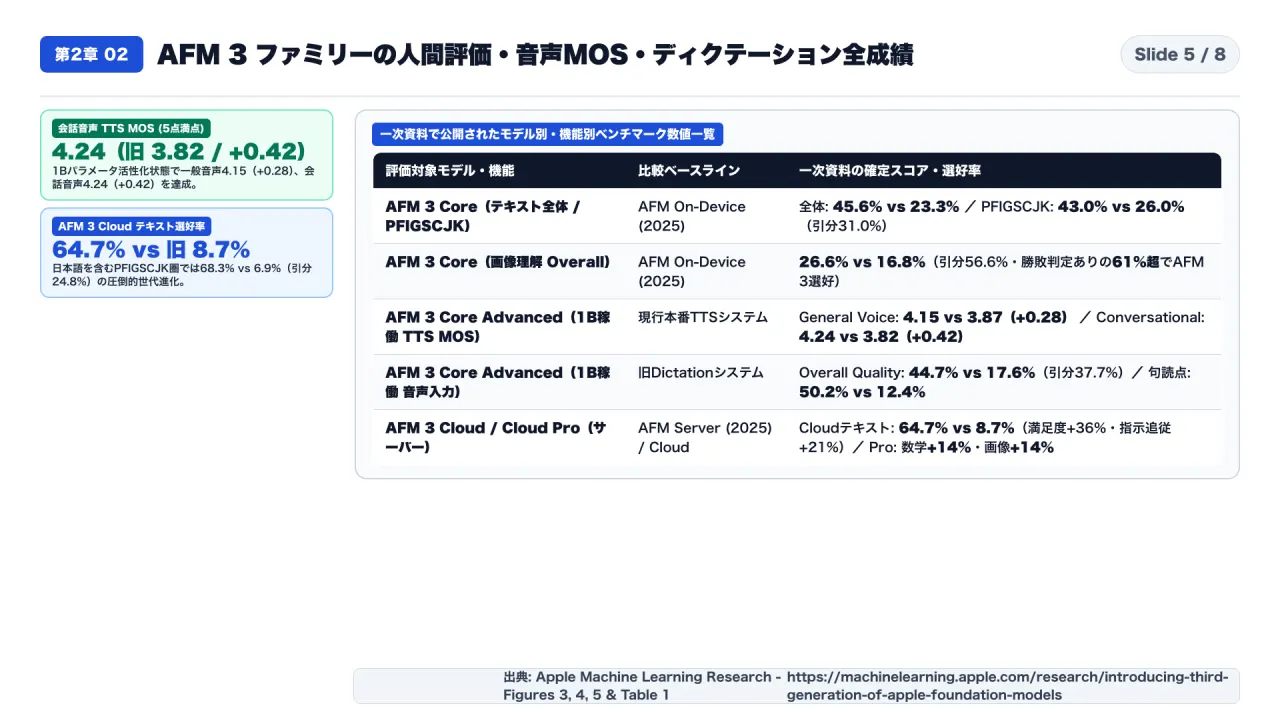
では、このアーキテクチャで構築されたAFM 3ファミリーは、実際の品質評価でどれほどの成果を出しているのでしょうか。一次資料(Apple公式AFM3発表 Evaluation)で公開された全ベンチマーク数値を1つ残らず整理します。
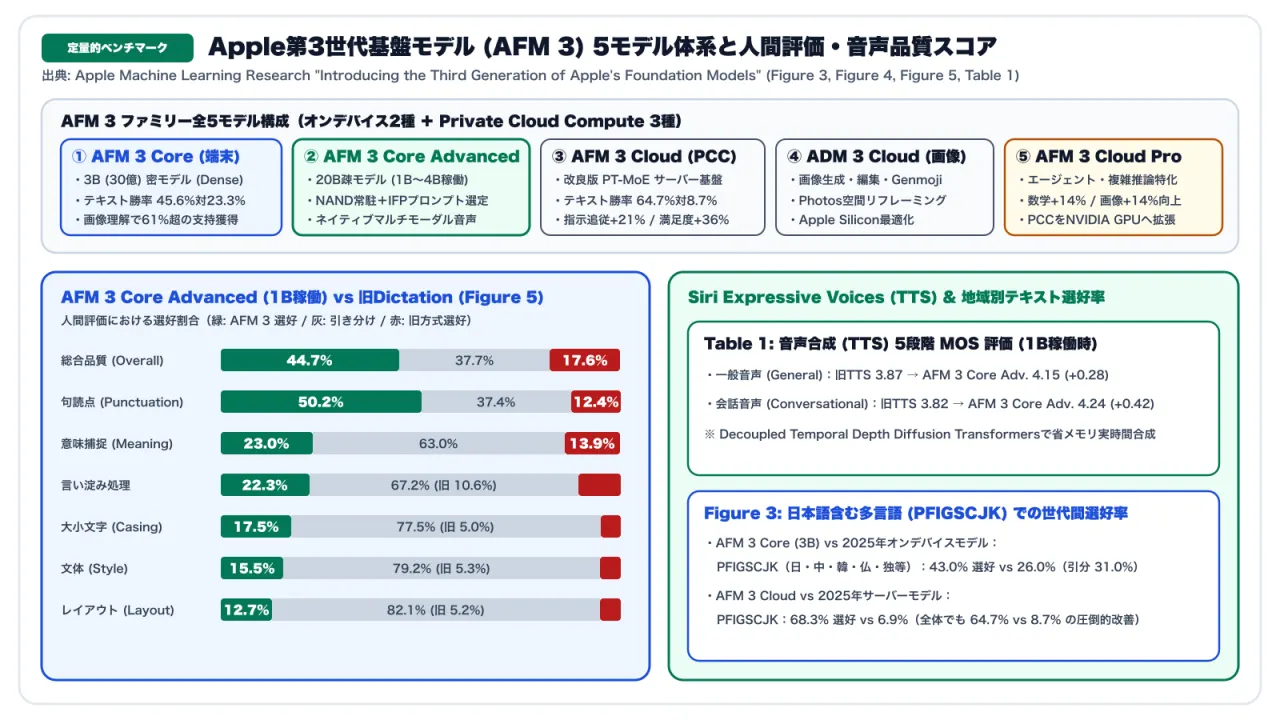
(1) 一般テキスト能力の世代間ブラインド人間評価(Figure 3)
人間の専門評価者が「Instruction Following(指示追従)」「Truthfulness(事実性)」「Presentation(表現)」等の軸で2025年の前世代モデルとサイド・バイ・サイド比較した結果は以下の通りです。
| 比較モデル | 評価ロケール群(言語圏) | AFM 3 選好率 | 引き分け(Tie) | 旧世代(2025)選好率 |
|---|---|---|---|---|
| AFM 3 Core vs AFM On-Device (2025) | 全プロンプト総合(Overall) | 45.6% | — | 23.3% |
| 同上(3B オンデバイス比較) | English(米・英・豪・印等の英語圏) | 38.0% | 39.0% | 23.0% |
| 同上 | PFIGSCJK(葡・仏・伊・独・西・中・日本語・韓) | 43.0% | 31.0% | 26.0% |
| 同上 | DDNSTV(デンマーク・蘭・ノルウェー・スウェーデン・土・越) | 42.4% | 28.3% | 29.3% |
| 同上 | AFIHHMPRTU(アラビア・フィンランド・尼・ヘブライ・印・マレー・波・露・タイ・宇) | 55.5% | 26.2% | 18.3% |
| AFM 3 Cloud vs AFM Server (2025) | 全プロンプト総合(Overall) | 64.7% | — | 8.7% |
| 同上(サーバー比較) | English | 56.0% | 33.0% | 11.0% |
| 同上 | PFIGSCJK(日本語を含む主要8言語圏) | 68.3% | 24.8% | 6.9% |
| 同上 | DDNSTV | 68.6% | 22.8% | 8.6% |
| 同上 | AFIHHMPRTU | 66.6% | 23.1% | 10.3% |
さらに単独評価(Single-sided evaluation)においても、AFM 3 Cloud は2025年サーバーモデル比で 総合応答満足度が相対約36%向上、指示追従性能が相対21%向上 しています。また最上位の AFM 3 Cloud Pro は AFM 3 Cloud と比較してさらに テキスト総合満足度で相対約10%向上、画像理解全体で相対14%向上、数学(Math)タスクで相対14%向上 を記録しました。
(2) 画像理解(Image Understanding)の人間評価(Figure 4)
- AFM 3 Core vs AFM On-Device (2025): AFM 3 選好 26.6% / 引き分け 56.6% / 2025選好 16.8%(いずれか一方が選ばれたケースのうち 61%以上 でAFM 3 Coreが勝利)。
- AFM 3 Cloud vs AFM Server (2025): AFM 3 選好 37.8% / 引き分け 52.6% / 2025選好 9.6%。
(3) AFM 3 Core Advanced(1Bパラメータ活性化時)の音声合成(TTS MOS)とディクテーション評価(Table 1 & Figure 5)
特筆すべきは、20Bモデルである AFM 3 Core Advanced を 最も高効率な「10億(1B)パラメータ活性化サイズ」で動かした状態 でのネイティブ音声性能です。
- 音声合成(Expressive Voices:5段階MOS評価、Table 1):
- General Voice(一般音声): 現行本番TTS 3.87 → AFM 3 Core Advanced 4.15(+0.28ポイント向上。MOSスケールでは0.1の上昇でも顧客体験として明確に知覚できる大差とされる)。
- Conversational Voice(会話調音声): 現行本番TTS 3.82 → AFM 3 Core Advanced 4.24(+0.42ポイント向上)。
- 音声入力(Dictation:旧ディクテーションシステムとの7軸比較、Figure 5):
- Overall Quality(総合品質): AFM 3 Core Advanced選好 44.7% / 引き分け 37.7% / 旧システム 17.6%。
- Punctuation(句読点): 50.2% / 引き分け 37.4% / 旧システム 12.4%。
- Meaning Capture(意味把握): 23.0% / 引き分け 63.0% / 旧システム 13.9%。
- Disfluency Handling(言い淀み処理): 22.3% / 引き分け 67.2% / 旧システム 10.6%。
- Casing(大文字小文字): 17.5% / 引き分け 77.5% / 旧システム 5.0%。
- Style(文体): 15.5% / 引き分け 79.2% / 旧システム 5.3%。
- Layout(レイアウト): 12.7% / 引き分け 82.1% / 旧システム 5.2%。
第3章:対立する視点と死角 —— クラウド巨大集約論 vs フラッシュ駆動エッジ、そしてエキスパート再選択の境界
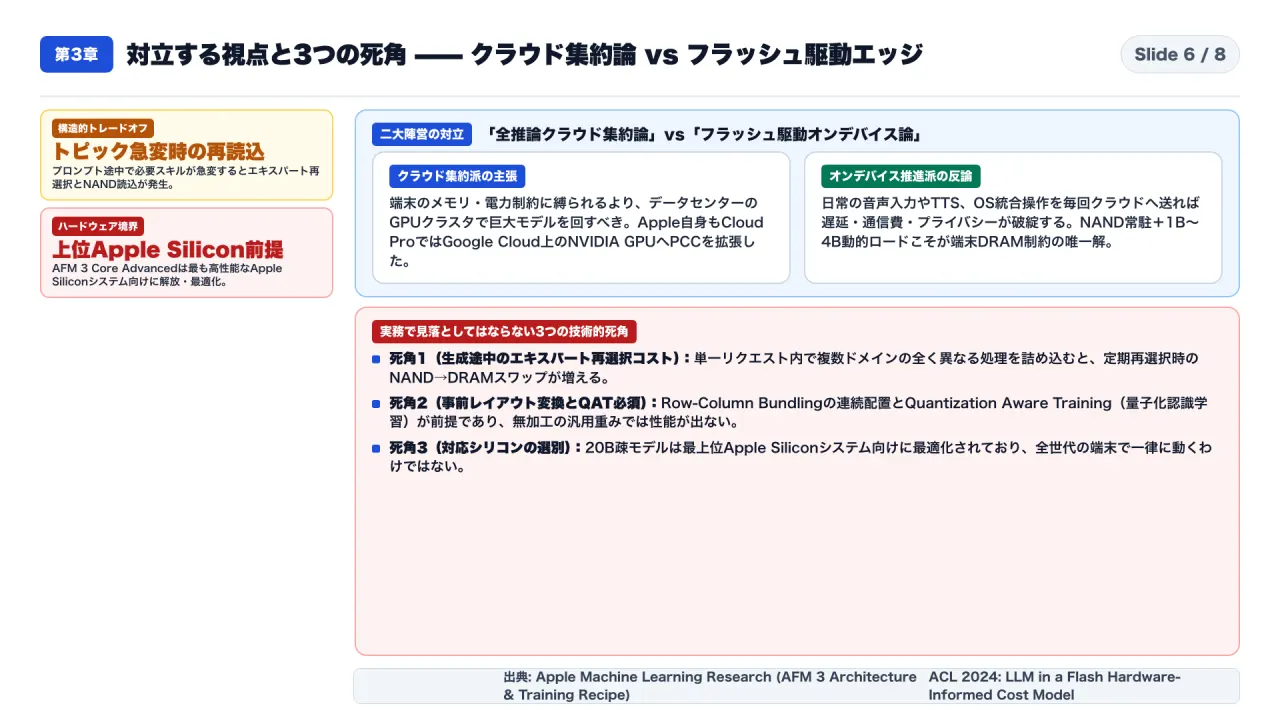
3-1. 産業界を二分する論争:「すべてをクラウドGPUへ集約すべきか、エッジのシリコンとフラッシュで回すべきか」
現在、AI業界には真っ向から対立する2つのアーキテクチャ思想があります。
- クラウド巨大クラスタ集約論: 「モバイル端末やPCの限られたメモリ・バッテリー枠の中で苦労してモデルを圧縮するよりも、データセンターに数万基の最新GPUとHBMを並べ、すべての推論をクラウドAPI経由で提供すべきだ」という立場です。実際、エージェントによる複雑なツール操作や高度な数学推論ではクラウドの圧倒的な計算資源が不可欠であり、Apple自身も最上位の
AFM 3 Cloud Proにおいては、自社Apple Siliconサーバーだけでなく GoogleおよびNVIDIAと提携し、Private Cloud Compute(PCC)の境界をGoogle Cloud上のNVIDIA GPUへ拡張する という極めて現実的な決断を下しています(Apple公式AFM3発表)。 - フラッシュ駆動オンデバイス推進論: 一方で、音声入力(Dictation)やリアルタイムの会話音声合成(Siri Expressive Voices)、日々の写真・テキスト編集まで毎回クラウドへ通信していては、ネットワーク遅延、サーバースケーリング費用、そして何よりユーザーのプライバシー保護が成り立ちません。
3-2. 実務で見落としてはならない3つの技術的死角(トレードオフ)
Appleのフラッシュ駆動型スパース推論(IFP + LLM in a Flash)は強力な突破口ですが、万能の魔法ではありません。一次資料の構造から読み取れる 3つの実務上の死角(制約) を押さえておく必要があります。
- 死角1:プロンプト途中で話題・必要スキルが急変した際の「エキスパート再選択(Reselection)ペナルティ」:
- IFPは「プロンプト単位でエキスパートを選択し、生成中に定期的に再選択・更新する」ことでNAND→DRAM転送を抑えています。したがって、1つのプロンプトの中で「最初はカジュアルな音声対話、途中から高度な医療・法律文書の厳密要約、最後に異言語の翻訳」のように必要な専門領域が急激に変化すると、DRAM上にパッチされた一時的密モデルでは対応しきれず、NANDからのエキスパート再ロードが発生してレイテンシが跳ね上がります。
- 死角2:事前レイアウト変換(Row-Column Bundling)とQAT(量子化認識学習)への強い依存:
- フラッシュから大きな連続チャンクで読み出すには、FFNの行と列をあらかじめ束ねた専用ストレージ配置に変換しておく必要があり、さらにAppleはクラウドTPUでの事前学習・多段階強化学習の後に Quantization Aware Training(QAT:量子化を考慮した学習) を施して精度低下を防いでいます。つまり、Hugging Faceから落としてきた任意の汎用密モデルを無加工でそのまま同じ効率で動かせるわけではありません。
- 死角3:対応ハードウェアの境界(最上位Apple Silicon前提):
- 公式発表に「
AFM 3 Core Advancedis unlocked by and optimized for our most capable Apple silicon systems」と明記されている通り、20B疎モデルのフラッシュ・DRAM協調推論は、高いユニファイドメモリ帯域と高速な内部NVMe/NANDコントローラを備えた上位Apple Siliconシステムを前提としています。
- 公式発表に「
第4章:【私なりの解釈】NANDフラッシュは「保存庫」から「第2のユニファイドメモリ」へ変貌した
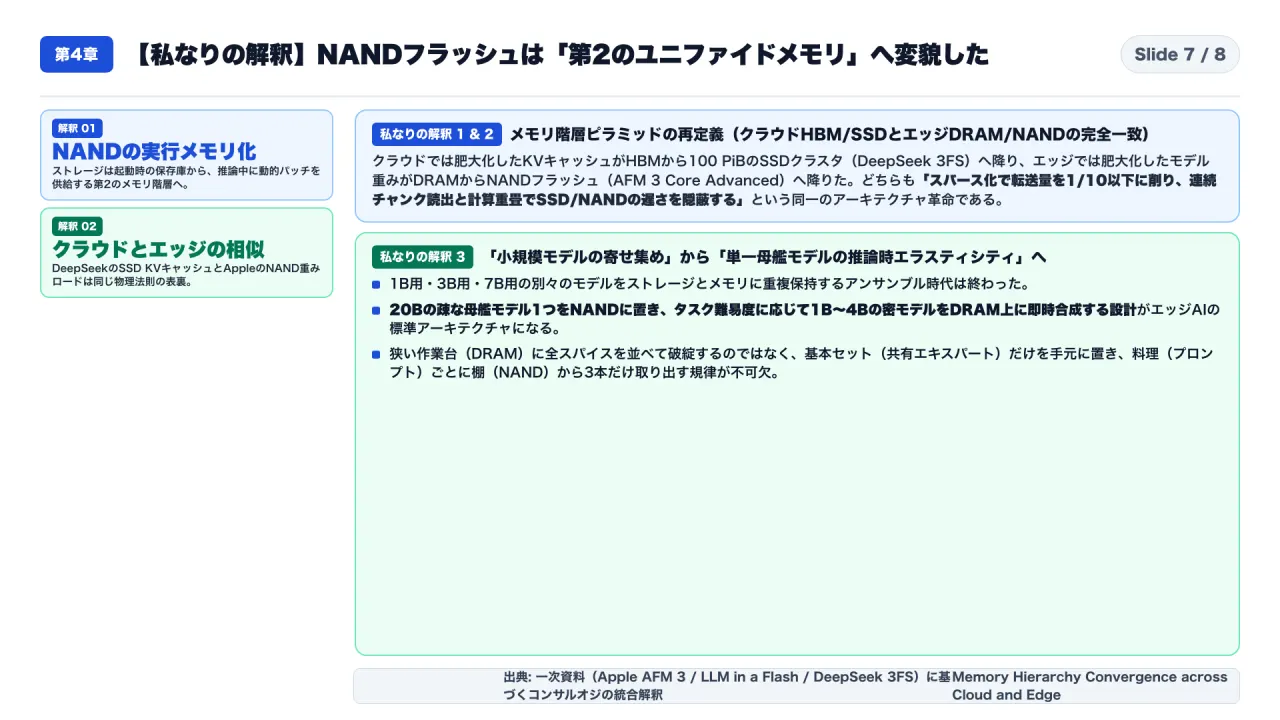
ここまでの一次情報を統合すると、これからのAIハードウェアとソフトウェアの設計に関する 3つの構造的転換(私なりの解釈) が浮かび上がります。
4-1. 解釈1:NANDフラッシュは「起動時の保存庫」から「推論中に動的パッチを供給する第2の実行メモリ」になった
これまでのコンピュータ設計において、SSDやNANDフラッシュは「アプリやモデルを起動するときに、ファイルをDRAMへロードしたら仕事が終わる受動的な保存庫」でした。しかし、AFM 3 Core Advanced のIFPアーキテクチャにおいて、NANDフラッシュは 「200億パラメータの知識母艦を保持し、プロンプトごとに10億〜40億パラメータの実行パッチをDRAMへリアルタイム供給する能動的なメモリ階層」 へと完全に役割を変えました。Apple Siliconの強みであった「CPUとGPUがDRAMを共有するユニファイドメモリ」が、今や 「NANDフラッシュとDRAMがスパース・ルーティングで直結された2層ユニファイドメモリ」 へと拡張されたと言えます。
4-2. 解釈2:クラウドの「DeepSeek 100PiB SSD KVキャッシュ」とエッジの「Apple NAND重みロード」は同じ物理法則の表裏である
前回のエピソードで解剖したDeepSeekの DeepInfer + 3FS と、今回のAppleの AFM 3 Core Advanced + LLM in a Flash を並べると、驚くべき共通点が見えてきます。
- クラウド側(DeepSeek): 膨張する KVキャッシュ が高価なGPUメモリ(HBM)から溢れ、MLAによる93.3%圧縮とGDR層別先読みによって、100 PiBの SSDクラスタ から直接ストリーム供給されるようになった。
- エッジ側(Apple): 膨張する モデル重み(20B) が高価な端末DRAMから溢れ、IFPによる1B〜4B疎活性化とWindowing・行列バンドル化によって、端末内の NANDフラッシュ から直接パッチ供給されるようになった。
つまり、クラウドでもエッジでも 「半導体メモリ(HBM / DRAM)の容量と価格の壁を、スパース化(転送量の9割削減)+ フラッシュへの連続チャンク配置(SSD / NANDの実効帯域最大化)というソフトウェア・アルゴリズムの力で突破する」 という全く同じパラダイムシフトが同時に起きているのです。
4-3. 解釈3:「小型モデルの寄せ集め(アンサンブル)」は終焉し、単一母艦モデルの「推論時エラスティシティ」が標準になる
これまでオンデバイスAIの現場では、「音声用には1Bモデル、要約用には3Bモデル、チャット用には7Bモデル」と複数の小さなモデルを別々に量子化して端末に同梱していました。しかしそれらは知識が重複してストレージを圧迫する上、どのモデルも3B〜7Bの天井を超えられませんでした。 Appleが示した Inference-Time Elasticity(単一の20B母艦モデルから、タスクに応じて1B〜4Bの密モデルを動的に合成する方式) は、1Bの計算コストで20Bの専門知識プールを引き出せるため、今後のローカルLLM設計のデファクトスタンダードになると考えられます。
結論:明日からエッジAI・アプリ開発チームが取るべき3つの実務アクション
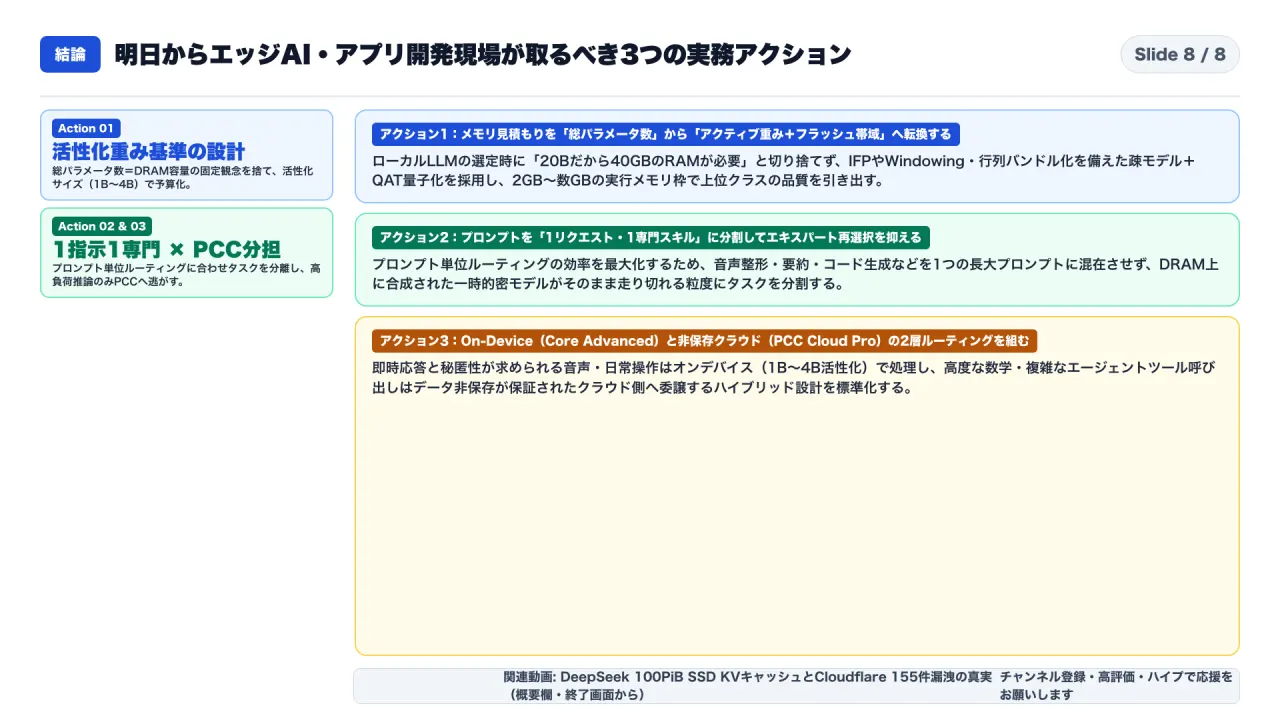
最後に、私たちが明日からのシステム設計・開発実務で直ちに実行すべき 3つの具体的アクション をまとめます。
- アクション1:ローカルLLMの要件定義から「総パラメータ数=必要DRAM容量」の思い込みを排除し、「活性化パラメータ数×フラッシュ連続読出帯域」でハードウェアを見積もる:
- 「端末の空きRAMが2〜4GBしかないから20Bクラスのモデルは絶対に動かない」と諦めるのではなく、疎活性化(MoE / IFP)とフラッシュ・オフローディング(Windowing / Bundling)、およびQAT(量子化認識学習)を組み合わせたモデルアーキテクチャを選定基準に据えてください。
- アクション2:プロンプト設計を「1リクエスト・1専門ドメイン」に分割し、プロンプト単位のエキスパート選択(IFP)のキャッシュ効率を最大化する:
- オンデバイス疎モデルを呼び出す際、1つのプロンプトに「音声の文字起こし整形」「スケジュール抽出」「別言語への翻訳」を全部詰め込むと、生成途中のエキスパート再選択とフラッシュI/Oが頻発します。タスクごとにリクエストを明確に分離し、DRAM上に合成された一時的密モデルがスワップなしで最後まで走り切れる設計にしてください。
- アクション3:プライバシー境界と推論難易度に応じた「On-Device(1B〜4B活性化)× 非保存クラウド(PCC)」の2段階ハイブリッド・ルーティングを標準実装する:
- 日常の音声入出力、UI操作支援、個人データの要約はオンデバイスモデルでミリ秒単位かつ通信費ゼロで完結させ、複雑なマルチステップ推論や大規模なエージェントツール呼び出しだけを、データの非保存・非共有が暗号学的に検証されたクラウド基盤(Private Cloud Compute等)へエスカレーションする2層設計をプロダクトの標準アーキテクチャとして組み込んでください。
よくある疑問と実務Q&A(FAQ)
Q1. 「200億パラメータ(20B)のモデルをNANDフラッシュに置く」と、SSDの寿命(書き込み耐久性:TBW)がすぐに尽きてしまいませんか?
- A. 推論時は「読み出し(Read)のみ」であるため、NANDフラッシュの書き込み寿命は消費しません。
NANDフラッシュメモリが劣化する原因はブロック消去・書き込み(Program/Eraseサイクル)であり、既存の重みデータをNANDからDRAMへ読み出す(Readする)操作自体はフラッシュセルをほとんど摩耗させません。
AFM 3 Core AdvancedのIFPや『LLM in a Flash』が行うのは、学習済みの200億パラメータをNAND上に静的に配置し、プロンプトに応じて10億〜40億(1B〜4B)のエキスパート重みを 読み出してDRAM上の共有エキスパートにパッチ結合する処理 です。OSのスワップ領域のように推論のたびにNANDへ大量のデータを書き戻すわけではないため、ストレージ寿命を損なわずに長期間運用できます。
Q2. なぜ従来のMoE(Mixture-of-Experts)モデルをそのまま量子化するだけでは不十分なのですか?
- A. 量子化しても「全エキスパートをDRAMに置く前提」と「トークン単位ルーティングのランダムアクセス」が残るからです。 確かにQuantization Aware Training(QAT:量子化を考慮した学習)で1パラメータあたりのビット数を減らせばモデル全体のサイズは縮みます(実際、AppleもAFM 3ファミリー全体の最終工程でQATを併用しています)。しかし、標準的なMoEは 1トークン生成するごとに全エキスパートの中から別々のエキスパートを呼び出す ため、結局すべてのエキスパート重みをDRAM上に常駐させておかなければなりません。もし標準MoEの重みをNANDフラッシュに置けば、1トークンごとのランダムな重み入れ替えにNAND→DRAM帯域が追いつかず停止します。だからこそ、①プロンプト単位で固定セットのエキスパートを選ぶ IFP、②直近トークンの活性ニューロンをDRAMに保持して転送量を削る Windowing、③FFNのUp-projectionの行とDown-projectionの列を連続チャンクとして束ねる Row-Column Bundling の3つを組み合わせる必要があったのです。
Q3. AFM 3 Core Advanced の「1B〜4B活性化」は、最初から1Bや3Bで作られた密モデル(AFM 3 Core 等)と何が違うのですか?
- A. 「計算コストは1B〜4Bのまま、20B分の多様な専門知識と表現力を引き出せる点」と「単一モデルでタスク難易度に応じた伸縮(Inference-Time Elasticity)ができる点」が異なります。
3Bの密モデル(
AFM 3 Core)は毎回30億パラメータすべてを計算に使いますが、保持している知識総量も30億パラメータ分に限られます。一方、AFM 3 Core Advancedは背後に200億パラメータの専門エキスパート群を持っており、たとえば「表現力豊かな音声合成(Expressive Voices)」や「高精度ディクテーション」ではわずか 10億(1B)パラメータの活性化サイズ で動きながら、現行本番TTSに対して一般音声MOS 4.15 vs 3.87(+0.28)、会話調音声MOS 4.24 vs 3.82(+0.42)、ディクテーション総合選好率 44.7% vs 17.6%(句読点 50.2% vs 12.4%)という圧倒的な品質を出しています。さらに、用途ごとに複数の小型モデル(アンサンブル)をメモリに重複保持する必要がなくなります。
Q4. 画面リフレーミングやオーディオ合成のデトークナイザはどう動いているのですか?
- A. 基盤モデル本体に加えて「タスク特化アダプタ」と「時間・深さ分離型拡散Transformerデトークナイザ」が協調動作しています。
一次資料によると、画像モデル
ADM 3 Cloudは単体で画像生成・編集・Genmojiをこなすだけでなく、Photosアプリの「空間リフレーミング(Spatial Reframing)」やImage Playgroundのタッチ編集向けに 専用アダプタ(Specialized Adapters) を併用しています。また、2026年7月28日付の関連研究『Memory Efficient Audio Synthesis with Decoupled Temporal Depth Diffusion Transformers』で明かされた通り、SiriのExpressive VoicesではAFM 3 Core Advancedが吐き出した意味的音声トークン(Semantic Audio Tokens)を、Apple Matrix演算器の厳しいメモリ・計算予算内で高忠実度オーディオへ変換する専用デトークナイザがオンデバイスでリアルタイム稼働しています。
明日から現場で使える「オンデバイス×クラウドAI設計」点検チェックリスト
| 点検フェーズ | 具体的な確認項目 | 合格基準(アクション指標) |
|---|---|---|
| 1. メモリ予算見積もり | ローカルLLMの要件を「総パラメータ数×バイト数」だけで計算していないか? | 活性化パラメータ数(例:1B〜4B)+常駐共有重み+Windowingキャッシュ枠でDRAM上限を見積もる。 |
| 2. ストレージ配置とQAT | フラッシュからの重みロード時に小サイズのランダムI/Oが発生していないか? | FFNの行と列を束ねる連続チャンク配置(Row-Column Bundling)とQAT量子化済みの重み形式を採用する。 |
| 3. プロンプト粒度設計 | 1回のプロンプトに異質な複数タスク(音声整形+コード生成+翻訳等)を混在させていないか? | プロンプト単位ルーティング(IFP)の途中再選択(Reselection)を抑えるため、1リクエスト・1専門タスクへ分割する。 |
| 4. 2層ルーティング境界 | すべての処理をクラウドAPI、またはすべて端末内のどちらか一方に押し込めていないか? | 日常の音声・テキスト・画像理解はオンデバイス(Core / Core Advanced)、高度な数学・複雑ツール操作は非保存保証クラウド(PCC Cloud / Pro)へ振り分ける。 |
| 5. 多言語・音声品質評価 | 英語のテキストベンチマークだけでモデル採用を決めていないか? | 日本語を含むPFIGSCJKロケールでの人間選好率や、会話音声MOS(+0.1以上で知覚差)・句読点精度を実測する。 |
あわせて読みたい関連記事とチャンネル案内
- 関連深掘り記事(クラウド側のSSDキャッシュ革命): なぜDeepSeekはKVキャッシュをSSDに保存して26倍速くし、Cloudflareで他顧客データ155件が漏洩したのか?──1日155兆トークンを捌く「DeepInfer」と100PiB「3FS」の真実(クラウド側でKVキャッシュを100PiBのSSDへ逃がしたDeepSeekの設計と、今回のAppleのエッジNANDフラッシュ推論を合わせて読むと、AIメモリ階層の全体像が立体的に繋がります)
- 固定自己紹介・番組ガイド: コンサルオジのプロフィールと「海外一次資料×1テーマ徹底深掘り」の制作方針
参考・一次資料リンク一覧(Primary Sources)
- Apple Machine Learning Research: Introducing the Third Generation of Apple’s Foundation Models (June 8, 2026 / Updated September 9, 2026)
- Apple Machine Learning Research (ACL 2024): LLM in a Flash: Efficient Large Language Model Inference with Limited Memory (Keivan Alizadeh, Iman Mirzadeh, Dmitry Belenko, S. Karen Khatamifard, Minsik Cho, Carlo C Del Mundo, Mohammad Rastegari, Mehrdad Farajtabar)