なぜAIは「トークナイザー」を捨てて生のバイト列を読み、モデル同士が「テレパシー」で直接会話し始めたのか?——Cartesia「H-Net」計算効率2倍・未知言語5.37倍とMIT「Swarm Telepathy」KVキャッシュ直接転送の真実
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜAIは「トークナイザー」を捨てて生のバイト列を読み、モデル同士が「テレパシー」で直接会話し始めたのか?——Cartesia「H-Net」計算効率2倍・未知言語5.37倍とMIT「Swarm Telepathy」KVキャッシュ直接転送の真実
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
- この記事の結論(核心): 大規模言語モデル(LLM)において長らく「変えられない前提」とされてきた 「入り口の固定BPEトークナイザー(Byte-Pair Encoding)」 と 「エージェント間の自然言語テキスト通信」 が、2026年10月に相次いで公開された2つの一次研究によって根底から覆されようとしています。第1に、状態空間モデルMambaの開発者であるAlbert Gu氏(カーネギーメロン大学助教授/Cartesia共同創業者)らの研究チームが発表した 「H-Net(Hierarchical Network:階層型ネットワーク)改良版(From Tokens to Bytes Part I)」 は、12万8,000語彙のBPEトークナイザーを完全に撤廃し、256通りの生のUTF-8バイト列から動的なチャンク分け(Dynamic Chunking)をEnd-to-Endで学習することで、同一骨格・同一計算量のBPE Transformerと比較して 検証損失(bpb)で1.28倍、言語評価Palomaで1.83倍、知識・推論評価OLMESで2.06倍(約2倍)の計算効率 を達成しました。さらにプログラミング言語では 1.49倍(Markdown)〜2.40倍(Go)、学習に含まれない未知の言語では 中央値3.10倍・最大5.37倍(Prolog)、DNA配列(OpenGenome)で 5.95〜7.06倍 を記録し、外側Mamba-2+内側40層Transformerの 2段H-Net(3.67B)は、SmolLM3-3Bが約11兆トークンかけて到達した最終平均スコアにわずか約1兆トークン(約10分の1の学習量)で到達 しています。第2に、MIT CSAILおよびMIT-IBM Watson AI Labの研究チーム(Abdulrahman Alabdulkareem氏、Dan Gutfreund氏ら)が発表した 「Swarm Telepathy(SwaT:arXiv:2610.15095)」 は、複数のAIエージェントが協調する際に文章を出力して再読み込み(Prefill)する無駄を廃し、送り手と受け手の両モデルを完全凍結したまま、学習5,000万トークン未満・1 GPU日未満の軽量アダプタでKVキャッシュを直接変換・転送 することで、6系列・12モデル・17ベンチマークにおいてテキスト通信比で平均40%高い正解率と4倍の高速化(壁時計時間) を実証し、さらに視覚モデルの画像記憶をテキスト専用モデルへ直接引き継がせることに成功しました。
- 対象読者: LLM・マルチエージェントシステムの研究開発エンジニア、日本語や多言語・専門コード・ゲノム解析でのトークナイザー効率悪化に課題を持つAIアーキテクト、エージェント協調のレイテンシ削減とセキュリティ監査(ガバナンス)の両立を設計するテックリード。
- 読み終えて持ち帰れる判断軸: 「なぜ固定BPEトークナイザーがリチャード・サットンの『苦い教訓(The Bitter Lesson)』に反していたのか」「なぜH-Netが未知のプログラミング言語で最大5.37倍、SmolLM3比で約10分の1のデータ効率を出せるのか(文脈内トークン化の威力)」「どうやって別会社のモデル系列間でKVキャッシュを再プレフィルなしに直接転送するのか」、そして「人間が読めないAI間通信(潜在テレパシー)が招くセキュリティ監査の死角」を、一次資料の確定数値に基づいて体系的に持ち帰ることができます。
背景と全体像:LLM最大の足枷「トークナイザー」の終焉と、言葉を捨てたAI同士のテレパシー
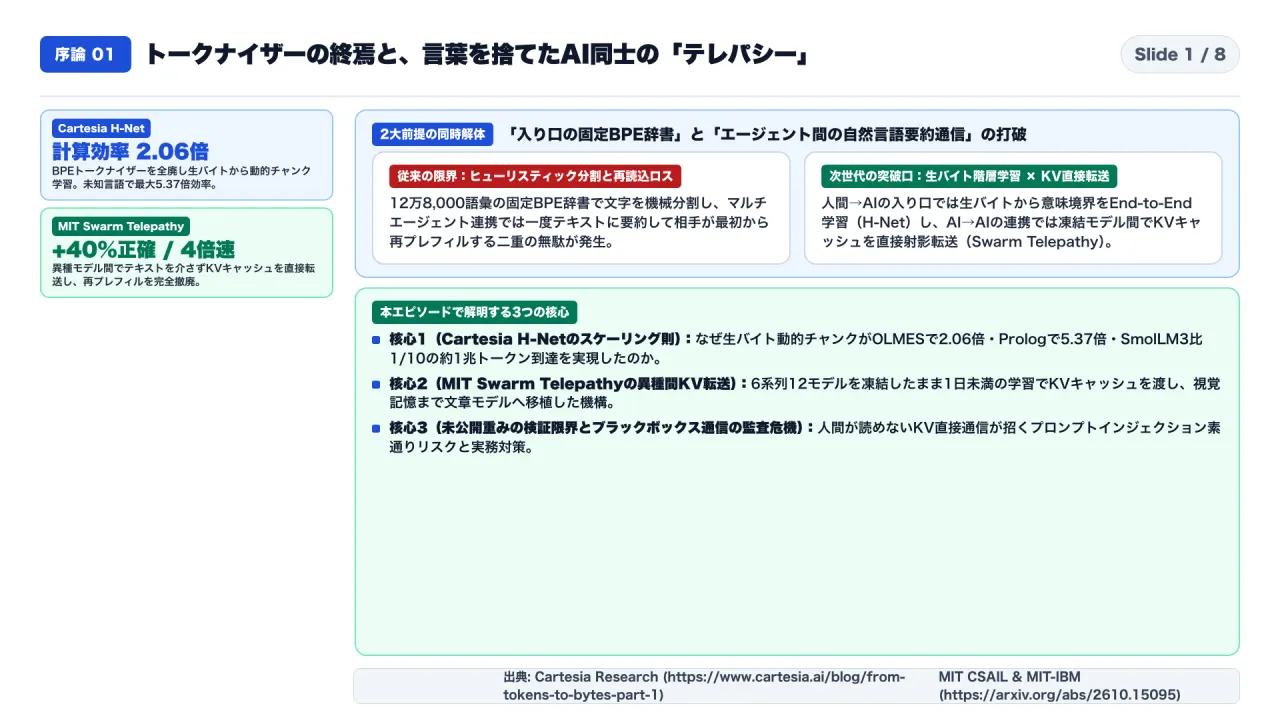
大規模言語モデル(LLM)が抱える最も泥臭く、最もいびつな足枷とは何でしょうか。 それは第1に、モデルが人間の文章をそのまま読めず、事前に人手で決めた 「トークナイザー(Tokenizer)」 という固定辞書で無理やり文字を切り刻んでから入力していること。そして第2に、複数のAIエージェントが協力するときに、わざわざ内部の高次元な思考状態を一度 「人間の文章(離散トークン列)」 に要約して出力し、受け手のAIがそれを最初から読み直している(再Prefillしている)ことです。
2026年10月、この「入り口のトークナイザー」と「エージェント間の自然言語通信」という2つの大前提を同時に解体する研究が相次いで公開されました。
- Cartesia Research(Albert Gu, Sukjun Hwang, Brandon Wang ほか):”From Tokens to Bytes I: Scaling Hierarchical Networks”(2026年10月28日公開)
- オープンソース実装(2025年版ベースライン):goombalab/hnet (GitHub) / cartesia-ai/hnet_2stage_XL (Hugging Face)
- MIT CSAIL & MIT-IBM Watson AI Lab(Abdulrahman Alabdulkareem, Irene Tenison, Yang Zhang, Yada Zhu, Boris Katz, Dan Gutfreund):”Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families”(arXiv:2610.15095)
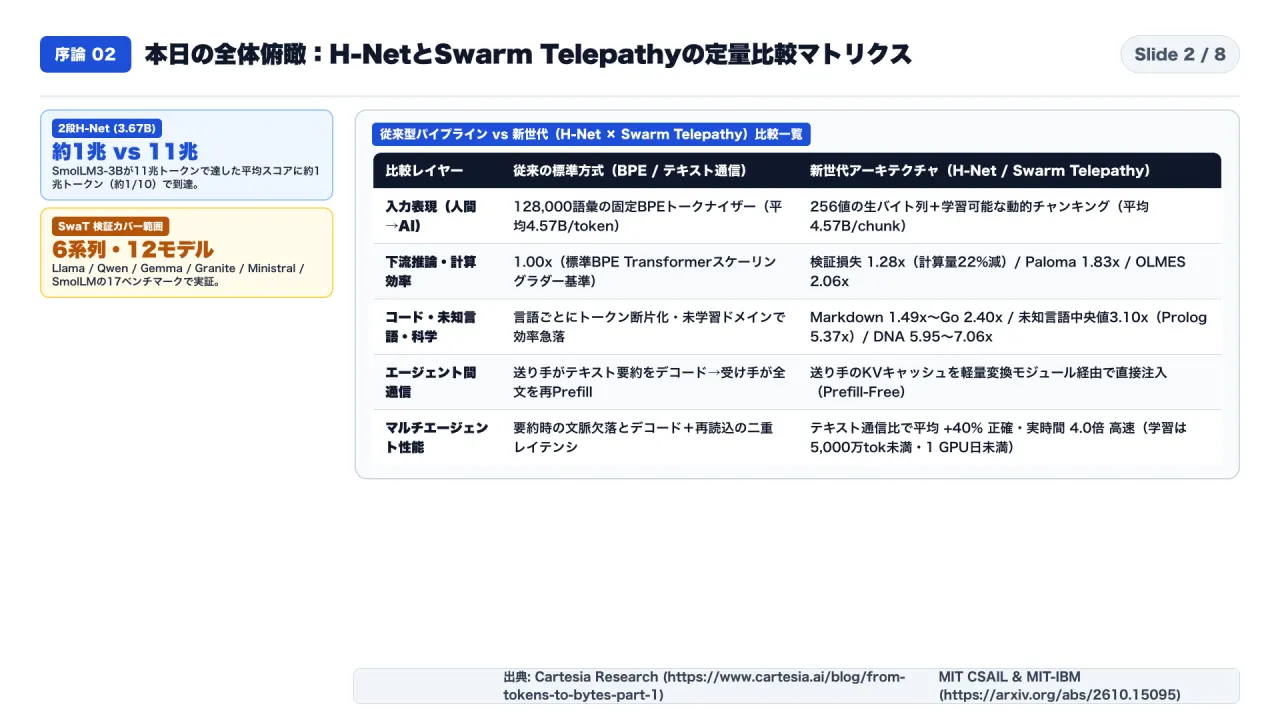
まずは両研究の一次資料で確認された主要スペックと定量成果を一覧表に整理します。
| 検証領域・指標項目 | 従来手法(BPE / 自然言語テキスト通信) | 新手法(Cartesia H-Net / MIT Swarm Telepathy) | 一次資料で確認された改善幅・備考 |
|---|---|---|---|
| 1段H-Net 検証損失(Validation Loss: bpb) | 12万8,000語彙 BPE Transformer(圧縮比 4.57 bytes/token) | 1段 H-Net(同骨格・圧縮比4.57に制御・FLOP一致) | 22%少ない計算量で同一損失に到達(計算効率 1.28倍) |
| 1段H-Net 下流ベンチマーク計算効率 | 標準BPE Transformer スケーリングラダー | 1段 H-Net(動的チャンキング置換) | Palomaで 1.83倍、OLMESで 2.06倍(約2倍)の計算効率 |
| プログラミング言語での計算効率 | BPE(空白・改行境界に固定依存) | 1段 H-Net(コード構造に応じた動的チャンク化) | 学習内15言語で 1.49倍(Markdown)〜 2.40倍(Go) |
| 未知のプログラミング言語(Out-of-Distribution Code) | Stack v2 の学習外10言語(OCaml, Prolog, Lean, Fortran等) | 1段 H-Net(文脈内トークン化による自律適応) | 中央値 3.10倍、最大 5.37倍(Prolog)の計算効率 |
| 2段H-Net 大規模比較(対 SmolLM3-3B) | SmolLM3-3B(3.08B、4.36 GFLOPs/byte、約11兆トークン学習) | 2段 H-Net(3.67B、4.44 GFLOPs/byte、外側Mamba-2+40層Transformer) | SmolLM3が約11Tトークンで達した最終平均スコアに約1Tトークンで到達(>10倍効率) |
| DNA塩基配列モデリング(OpenGenome 274B塩基) | 塩基単位 Autoregressive Transformer | H-Net(コドン・プロモーター・反復領域を自律チャンク化) | gtdb検証・テスト3セットで 5.95倍・5.83倍・7.06倍の計算効率 |
| 異種マルチエージェント協調(Swarm Telepathy) | エージェント間で要約テキストを生成+受け手で再Prefill | KVキャッシュ直接変換・転送(6系列・12モデル・17ベンチマーク) | テキスト通信比で 平均40%高い正解率 & 壁時計時間で 4倍高速 |
| 変換アダプタの学習コストとマルチモーダル転送 | 巨大モデルの統合再学習またはテキスト要約 | 送り手・受け手とも完全凍結+軽量変換モジュールのみ学習 | 5,000万トークン未満・1 GPU日未満の学習で視覚→テキスト専用モデルへの転送も実現 |
第1章:固定BPEトークナイザーの崩壊と、Cartesia『H-Net』が叩き出した計算効率2倍・未知言語5.37倍の衝撃
1980年代以降のAI研究の歴史を振り返ったリチャード・サットン(Richard Sutton)氏の有名なエッセイ『苦い教訓(The Bitter Lesson, 2019)』は、「人間が手作業で作り込んだドメイン知識やヒューリスティックは、長期的には計算資源とスケールを活用して生データから直接学ぶ汎用アルゴリズムに必ず敗北する」と説きました。
しかし、現代の大規模言語モデルには1つだけ、この「苦い教訓」に背き続けてきた領域があります。それが 「BPE(Byte-Pair Encoding)トークナイザー」 です(Cartesia公式ブログ)。
1-1. 12万8,000語彙の固定BPE辞書が抱える「3つの構造的欠陥」
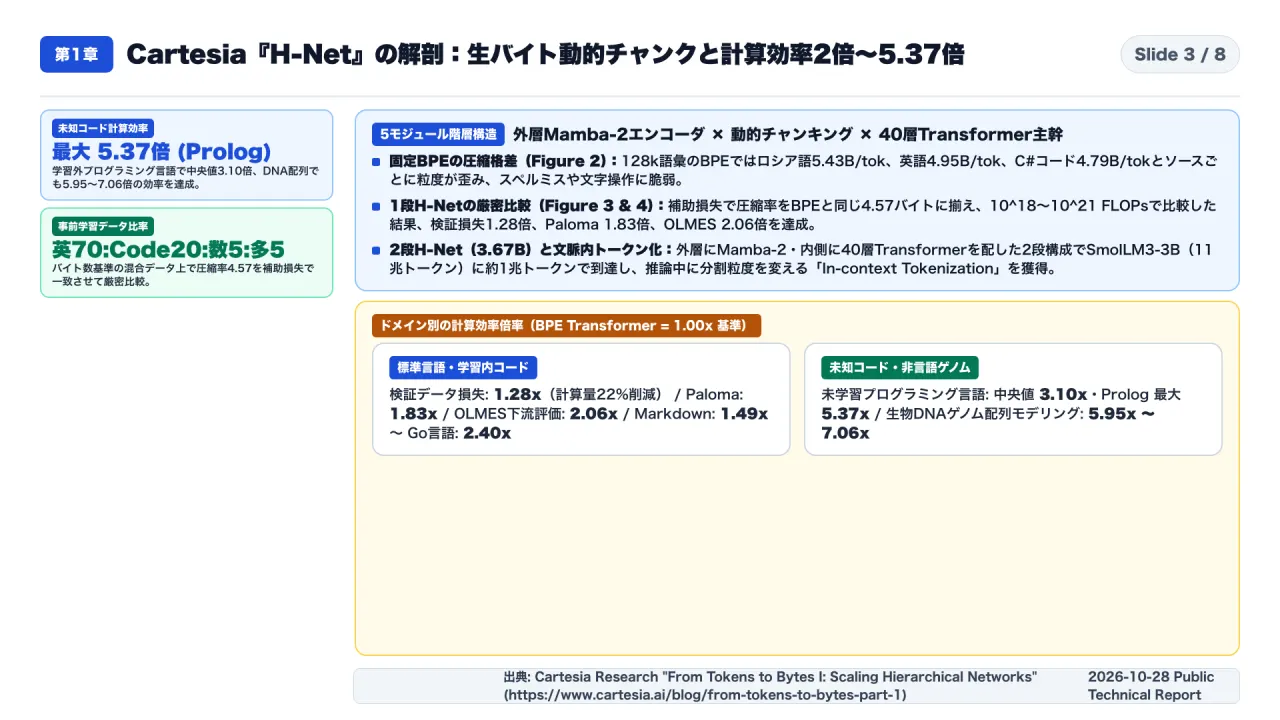
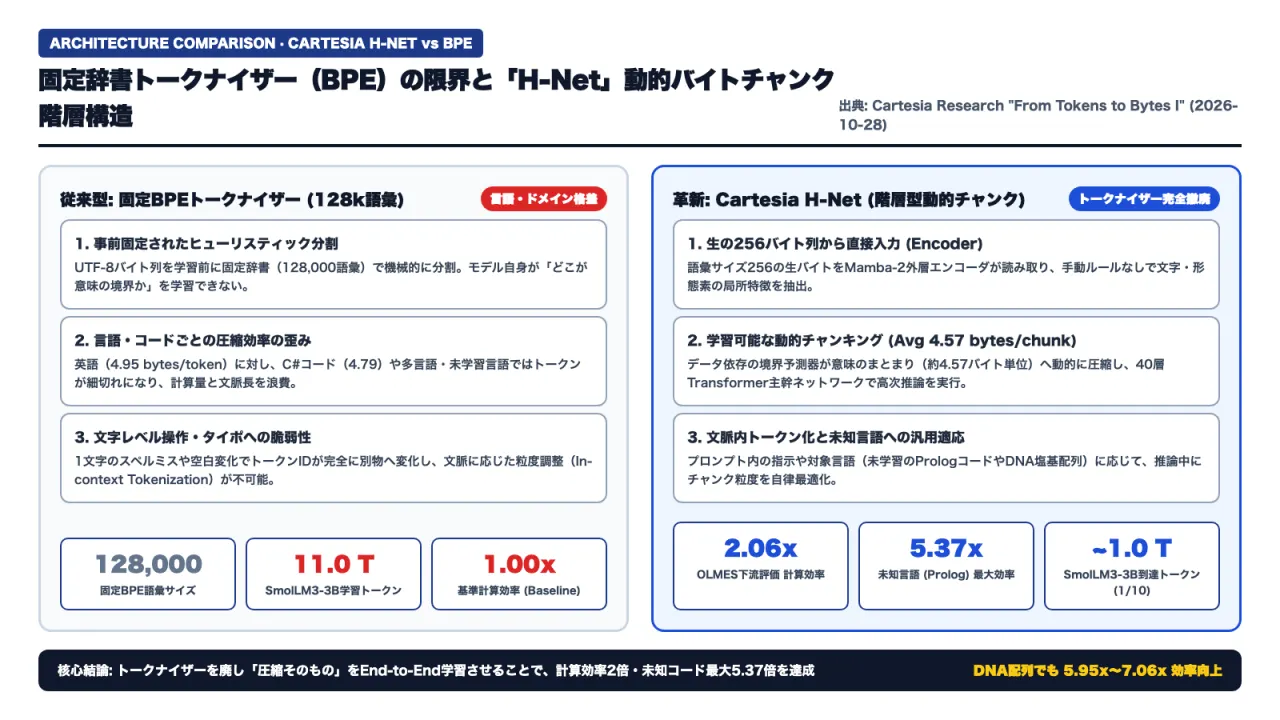
現在のLLMはテキストを直接読んでいるのではなく、事前に固定された語彙辞書(たとえばLlama-3と同じ 12万8,000語彙)を使って、UTF-8のバイト列をサブワード片のID列へと静的に変換しています。Cartesiaの実験データ(英語70%、コード20%、数学5%、多言語5%の事前学習ミックス)では、BPEトークン1個あたりの平均バイト数は 英語(fineweb-edu)で4.95バイト、ロシア語で5.43バイト、C#コードで4.79バイト、Swiftで4.48バイト、全体目標ミックスで平均4.57バイト です。
しかし、この固定トークナイザーには3つの致命的な欠陥があります。
- 学習前に分割境界が固定される: ニューラルネットワーク本体の学習が始まる前に文字頻度ルールだけで切り方が固定されるため、文脈に応じて「どこが意味の切れ目か」をモデル自身が学べません。
- 非英語・特殊コード・スペルミスでの崩壊: 英語中心に作られた辞書では、スペースで単語を区切らない日本語・中国語・ヒンディー語などのマルチバイト言語や、未知のプログラミング言語、あるいは1文字のタイポが混じるだけで分割が細切れになり、計算効率が激減します。
- 自然な境界がないモダリティへの適用不能: DNAゲノム配列(A, C, G, Tの連続)や音声波形、画像ピクセルのように「スペースによる単語の区切り」が存在しないデータには、BPEの事前トークン化ルールがそのまま使えません。
1-2. H-Netの5モジュール階層構造と厳密なIso-FLOPスケーリング比較
そこでCartesiaが開発した階層型ネットワーク 「H-Net(Hierarchical Network)」 は、12万8,000語彙のトークナイザーを完全に撤廃し、256通りの生のUTF-8バイト値 を直接入力として受け取ります。H-Netは以下の5つのモジュールで構成されます。
- 外側エンコーダ(Outer Encoder): 生のバイト列を読み取り、局所的な文脈を混合。
- 学習可能な動的チャンキング層(Learned Dynamic Chunking): データの意味的な切れ目を動的に判定し、バイト列を少数の「チャンク(意味の塊)」へと圧縮。
- 内側メインネットワーク(Inner Main Backbone): 圧縮されたチャンク系列(BPEトークンに相当する抽象度)の上で、巨大なTransformerが深い推論を実行。
- デチャンク層(Dechunking / Smoothing): メインネットワークの出力を元のバイト系列長へと滑らかに展開。
- 外側デコーダ(Outer Decoder): 元のバイト解像度で次の1バイトを予測。
研究チームはまず、「純粋にトークナイザーの部分だけを1段のH-Netに置き換えたらどうなるか?」を検証するため、標準的なBPE Transformerのスケーリングラダー(Muonオプティマイザ、WSD学習率スケジュール、128次元ヘッド、$10^{18} \sim 10^{21}$ FLOPs)を構築し、内側バックボーンの構造・ハイパーパラメータ・平均圧縮率(4.57バイト/チャンク)・外側層のFLOPsとパラメータ数を厳密に一致させた 「1段H-Net(1-stage H-Net)」 と比較しました。
その結果、すべてのモデルサイズでH-NetがBPEを上回り、以下の計算効率倍率(同じ損失・スコアに到達するのにBPEが何倍の計算量を必要とするか)を記録しました。
- イン分布の検証損失(Validation Loss: bpb): 22%少ない計算量で到達し、1.28倍の計算効率。
- 下流評価スイート Paloma: 1.83倍の計算効率。
- 下流評価スイート OLMES: 2.06倍(約2倍)の計算効率。
- 学習データ内のプログラミング言語(15言語すべてで向上): Markdownの1.49倍からGo言語の2.40倍 まで一貫してBPEを圧倒。
- 学習データに含まれない未知のコード(Stack v2の学習外10言語:OCaml, Prolog, Lean, Fortran等): 中央値で3.10倍、Prologでは最大5.37倍の計算効率。
1-3. 2段H-Net(3.67B)による「10倍以上の効率改善」と「文脈内トークン化(In-Context Tokenization)」
さらに研究チームは、BPEに合わせた1段・4.57倍という窮屈な制約を外し、オープンソースの3Bモデル 「SmolLM3(3.08Bパラメータ、36層、4.36 GFLOPs/byte)」 と1バイトあたりの計算量を2%以内に揃えた 「2段H-Net(2-stage H-Net:3.67Bパラメータ、4.44 GFLOPs/byte)」 を構築しました。
- 第0ステージ(バイト層): エンコーダ・デコーダにそれぞれ4層の Mamba-2 を配置(約4倍圧縮)。
- 第1ステージ(中間層): スライディングウィンドウ・アテンション+4層の Mamba-2 を配置(さらに約2倍、合計 約7.6〜8倍圧縮)。
- メインステージ: 40層のグローバルアテンションTransformer(3.13Bパラメータ、全体の57%のFLOPs)。
この2段H-NetをSmolLM3と同じデータ配合・同じAdamW設定で学習させたところ、SmolLM3が約11兆トークン(11.1T tokens)かけて到達した6タスク平均スコアに、2段H-Netはわずか約1兆トークン(~1T tokens)で到達し、10倍以上の計算・データ効率改善 を叩き出しました。
なぜこれほど効率が良いのでしょうか?チャンクの切れ目を可視化すると、H-Netが 「文脈内トークン化(In-Context Tokenization)」 という驚くべき能力を獲得していることが分かりました。
- 文脈に応じた境界変化: 同じ
"a"という文字でも、英語では後ろの名詞と結合("a foot","quite a few")する一方、イタリア語では前置詞としての意味を持つため別チャンクとして切り離します。 - 推論中のリアルタイム適応: 学習時に見たことがない新しい造語や、プログラム内で新しく定義された変数名・関数名(例:
LURD,WHYVなどの反復パターン)が文中に繰り返し登場すると、最初は細かく分けていたH-Netが、推論の途中から「これは1つの意味単位だ」と認識して1チャンクにまとめてしまう のです。 - DNAゲノム配列(OpenGenome 2740億塩基)での創発: さらにバクテリア・古細菌のゲノム配列で学習させたH-Netは、生物学的知識を一切教えていないにもかかわらず、学習に含まれないヒトのヒストン遺伝子(
H2BC17)等において「タンパク質をコードする領域では3塩基(コドン)単位」「tRNA遺伝子では1塩基単位」「情報量の少ない反復領域では反復全体を1チャンク」へと動的に粒度を変え、標準Transformer比で 5.95倍〜7.06倍の計算効率 を達成しました。
第2章:MIT『Swarm Telepathy』の解剖 —— 異種モデル間でKVキャッシュを直接転送し、40%正確・4倍高速化する機構
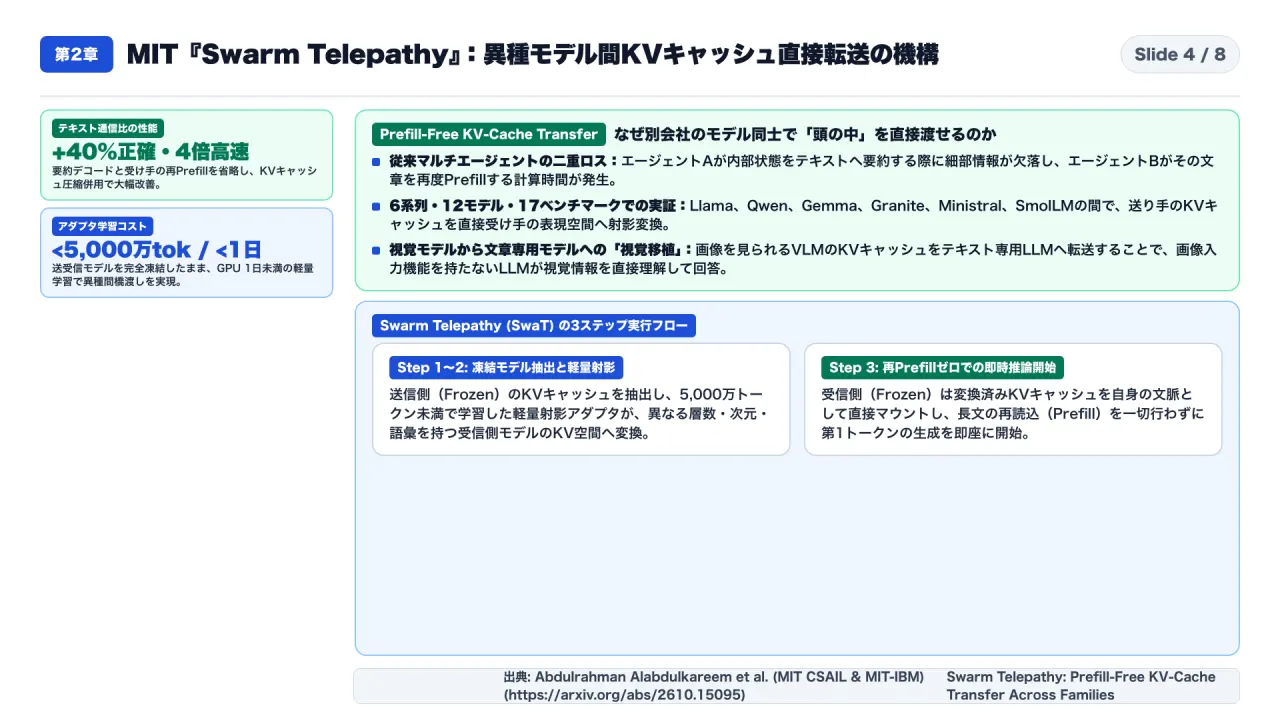
第1章のH-Netが「LLMの入り口」のトークンを撤廃したのに対し、第2章で取り上げるMIT CSAILとMIT-IBM Watson AI Labの論文 『Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families(arXiv:2610.15095)』 は、複数のAIエージェントが協力する際の 「モデル間の自然言語テキスト通信」 を撤廃しました(arXiv:2610.15095)。
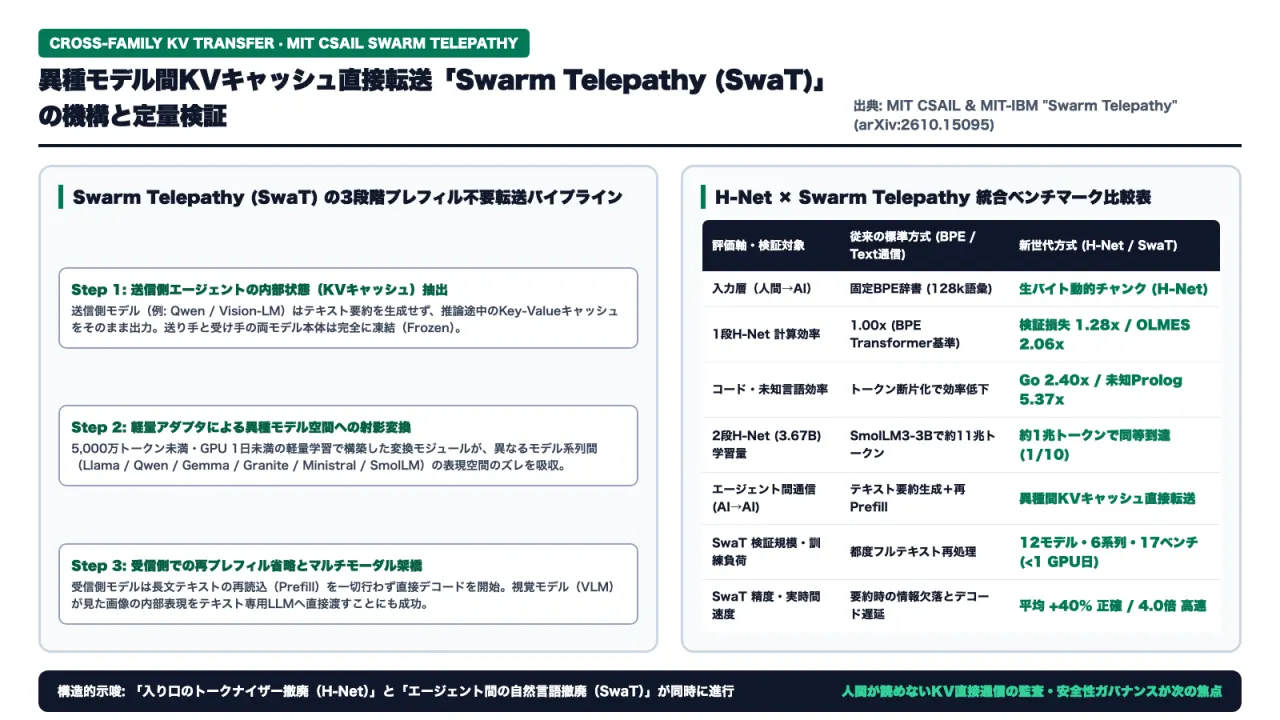
2-1. なぜテキストによるエージェント間通信は「遅くて劣化する」のか?
現在のマルチエージェントシステムでは、第1のエージェント(Sender)が資料や画像を読んで分析し、その結果を「テキストの文章」に要約して出力し、第2のエージェント(Receiver)がそのテキストを受け取って最初から再読み込み(Prefill)を行います。しかし、この方式には2つの構造的な無駄があります。
- 離散トークンへの要約による情報欠落: 送り手のモデル内部(KVキャッシュ)には、文脈全体の微細な関係性や複数の解釈の可能性が連続値として保持されていますが、それを短い要約テキスト(離散トークン列)に絞り込んだ瞬間に多くの情報が失われます。
- デコード生成と再Prefillの二重コスト: 送り手が1トークンずつ文章を書き出す自己回帰デコード時間と、受け手がその文章をもう一度最初からアテンション計算するPrefill時間が毎回発生します。
2-2. 別会社のモデル系列間(6系列・12モデル)で「再プレフィルなし」のKVキャッシュ直接転送を実現
そこでMITの研究チームが開発した 「Swarm Telepathy(SwaT)」 は、テキストを一切介さず、送り手のKVキャッシュ(途中の計算結果)を、別のモデル系列(Cross-Family)の受け手が文章を読み直さずに(Prefill-Freeで)そのまま自分のKVキャッシュとして使えるように直接変換して渡す 仕組みを構築しました。
- 両モデル完全凍結&超軽量学習(< 5,000万トークン・< 1 GPU日):
- 送り手と受け手のベースLLMの重みは1ビットも変更せず完全に凍結(Frozen)します。
- その間に挟む軽量なKVキャッシュ変換モジュールだけを、5,000万トークン未満のデータ・GPU 1日未満(under one GPU-day) という極めて小さなコストで学習させます。
- 6モデル系列・12モデル・17ベンチマークでの実証成果:
- Llama、Qwen、Gemma、Granite、Ministral、SmolLM というアーキテクチャも開発元も異なる 6系列・12種類のモデル と 17のベンチマーク で検証した結果、KVキャッシュ圧縮手法と組み合わせたSwarm Telepathyは、従来のテキストによるエージェント間通信と比較して 平均40%高い正解率 を達成し、実時間(Wall-clock time)で 4倍高速 に処理を終えました。
- 視覚モデルから「テキスト専用モデル」への視覚記憶テレパシー:
- さらに驚くべきことに、画像を見ることができる視覚言語モデル(VLM)のKVキャッシュを、画像入力機能をまったく持たない 「文章専用の言語モデル(Text-only LLM)」 へSwarm Telepathyで転送したところ、文章専用モデルが画像を1ピクセルも見ずに「画像の内容」を理解して正確に推論できることまで実証されました。
第3章:対立する視点と死角 —— 未公開ウェイトの再現性壁と、「人間が読めないAI間通信」が招くブラックボックス監査危機
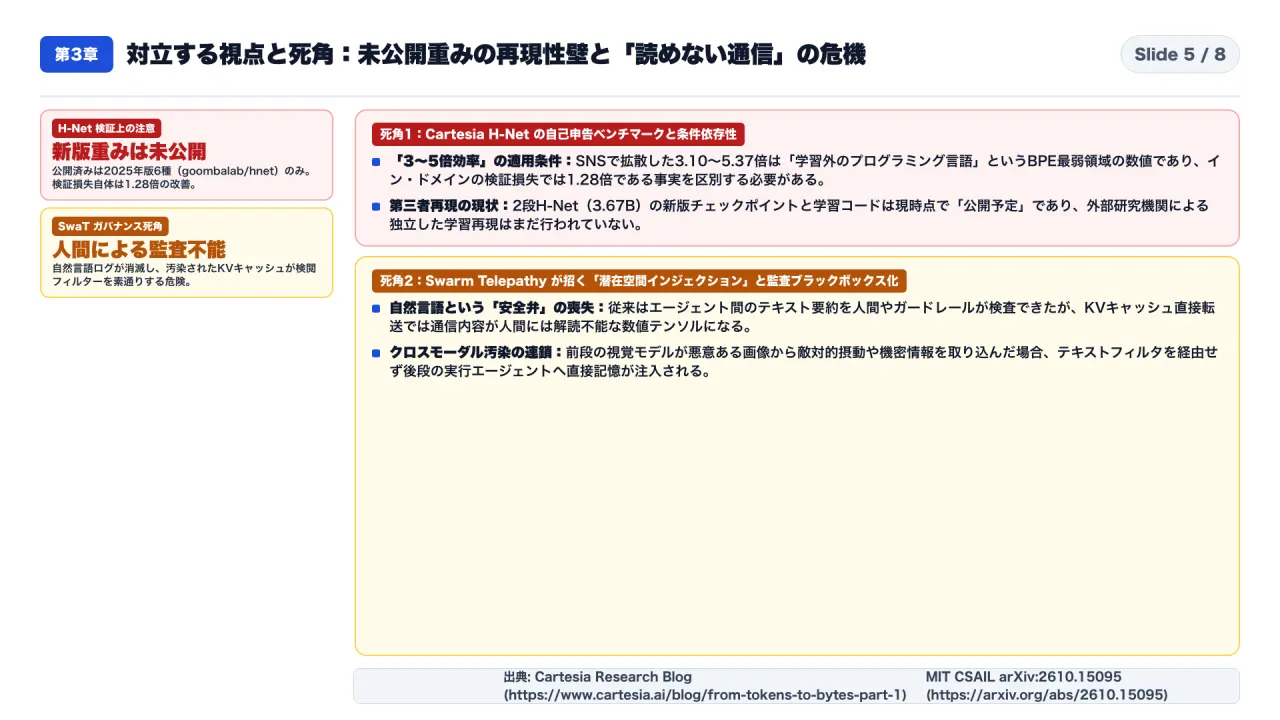
どれほど画期的な研究であっても、一次資料の前提条件と実務上の死角を冷静に見極める必要があります。ここでは3つの重要な注意点とリスクを整理します。
- H-Net新版ウェイトの未公開と「倍率の条件差」の正確な理解:
- Cartesiaが今回発表した「OLMESで2.06倍」「SmolLM3-3Bの約11兆トークン相当に約1兆トークンで到達」という数値はすべてCartesia社内の実験結果であり、現時点では外部の査読や第三者による再現検証はまだ行われていません。
- また、現在GitHub(
goombalab/hnet、MITライセンス)およびHugging Faceで公開されている重み6種(hnet_1stage_L〜hnet_2stage_XL_code)は 2025年版のH-Net(ブログ内でLH-Netと呼ばれる旧版) であり、今回発表された改良版H-Netの重みとコードは「今後公開予定」です。 - さらにSNS上で「3〜5倍の効率」という数字だけが広まっていますが、一次資料を厳密に読むと、学習データと同じ分布の検証損失(bpb)単体では 1.28倍 であり、3.10倍〜5.37倍 という大きな倍率は「学習データに含まれない未知のプログラミング言語」など、従来のBPEが極端に苦手とする領域での数値である点を区別して評価する必要があります。
- 「人間が中身を読めないAI間通信(Swarm Telepathy)」のセキュリティ・監査リスク:
- 従来のマルチエージェントシステムでは、エージェント同士が「自然言語のテキスト」で会話していたため、途中の通信ログを人間やセキュリティフィルターが読んで「不適切な指示(プロンプトインジェクション)が混入していないか」「機密データを外部へ持ち出そうとしていないか」「推論が暴走していないか」を監査・遮断することができました。
- しかしSwarm Telepathyのように、エージェント同士がテキストを出力せず高次元のKVキャッシュ(数値テンソル)を直接受け渡すようになると、人間には「エージェントAがエージェントBに何を伝えたのか」が一切読めなくなります。もし前段の視覚モデルが敵対的パッチを含む画像を読み込んだ場合、その汚染された潜在状態がテキスト検閲を素通りして後段の意思決定エージェントへ直接伝播するリスクがあり、今後は「潜在空間レベルでのガードレールと監査ログ」が不可欠になります。
第4章:構造的解釈と明日からの3大実務アクション
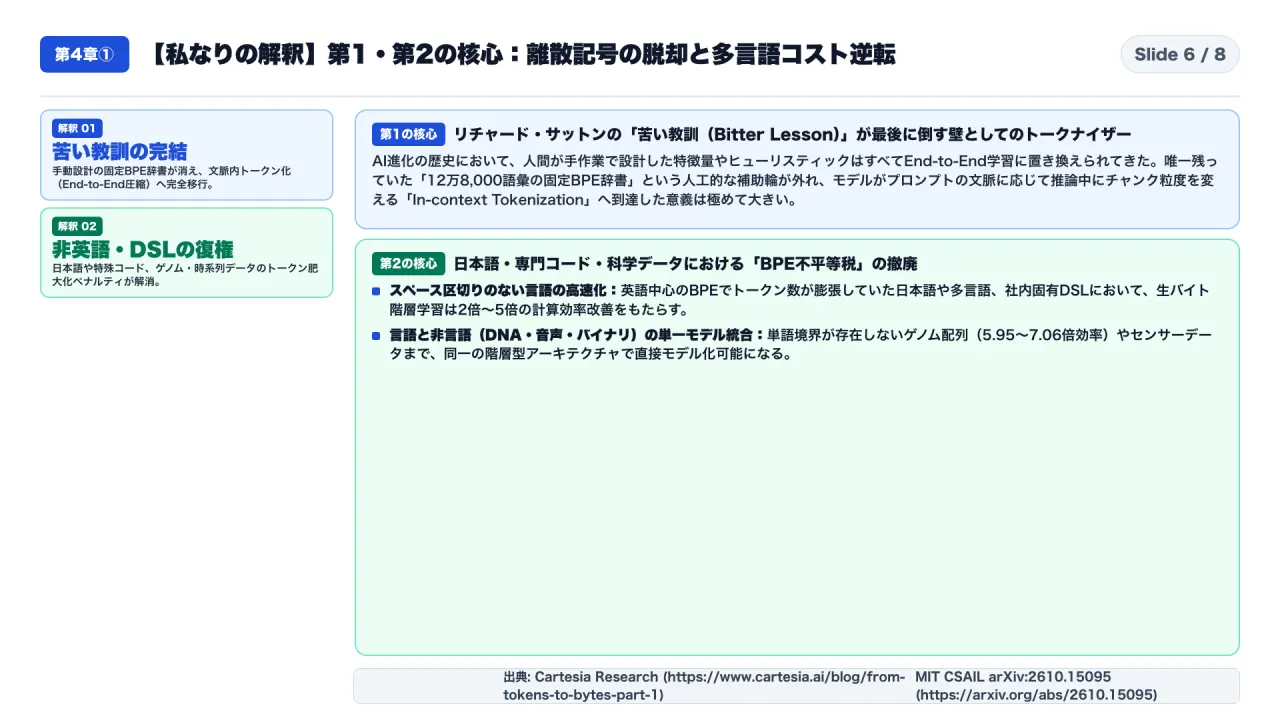
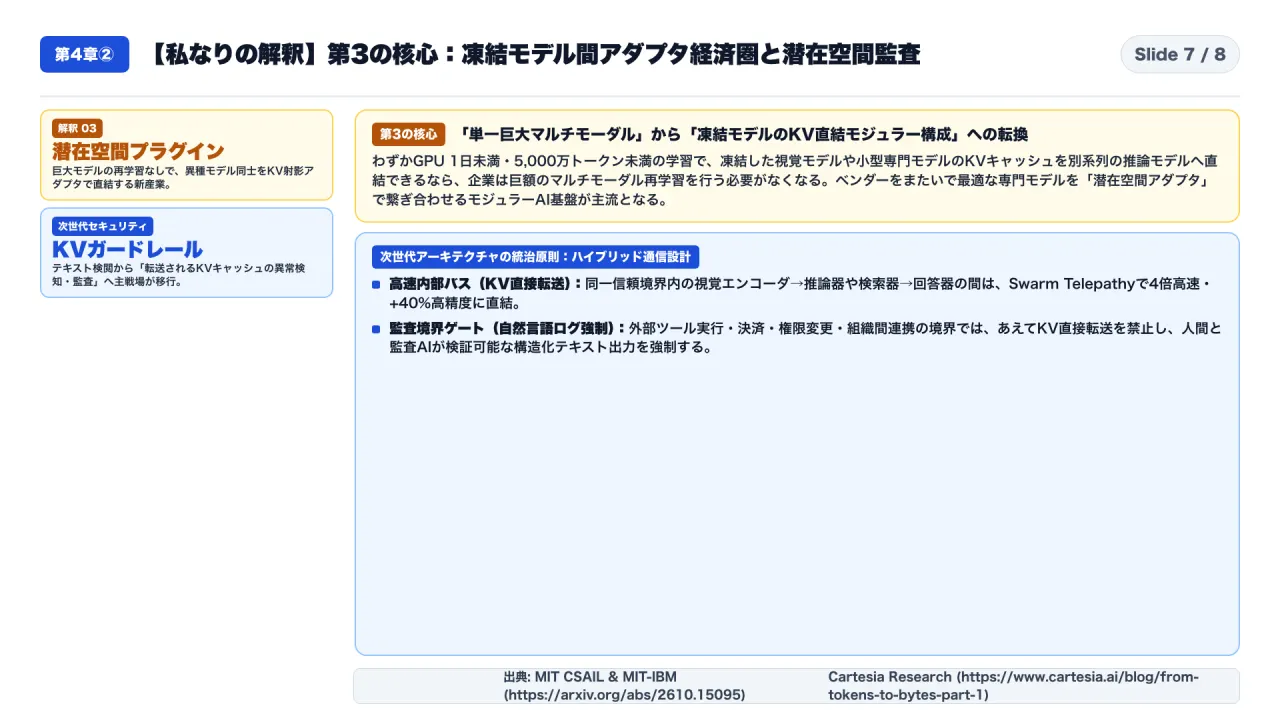
ここまでの一次資料を踏まえ、私たちが押さえるべき構造的変化は以下の3点に集約されます。
[構造変化 1:固定辞書(BPE)から「文脈内トークン化(H-Net)」へ]
生のUTF-8バイト列(256値) / 音声 / DNA塩基配列
  └─> 外側Mamba-2 + 動的チャンキング層が文脈・言語・変数名に応じてリアルタイムに意味境界を学習
  └─> 英語偏重トークナイザーによる「日本語・多言語・専門コードの不平等なトークン膨張」が解消へ

[構造変化 2:テキスト要約リレーから「凍結モデル間の潜在KV直結(Swarm Telepathy)」へ]
視覚モデル / 専門小型モデル(重み完全凍結)
  └─> 学習1 GPU日未満・5,000万トークン未満の軽量変換アダプタで異種系列(Llama×Qwen×Gemma等)を直結
  └─> 再Prefillゼロで平均40%高精度・4倍高速化(ただし人間が読めない潜在通信の監査境界設計が必須)
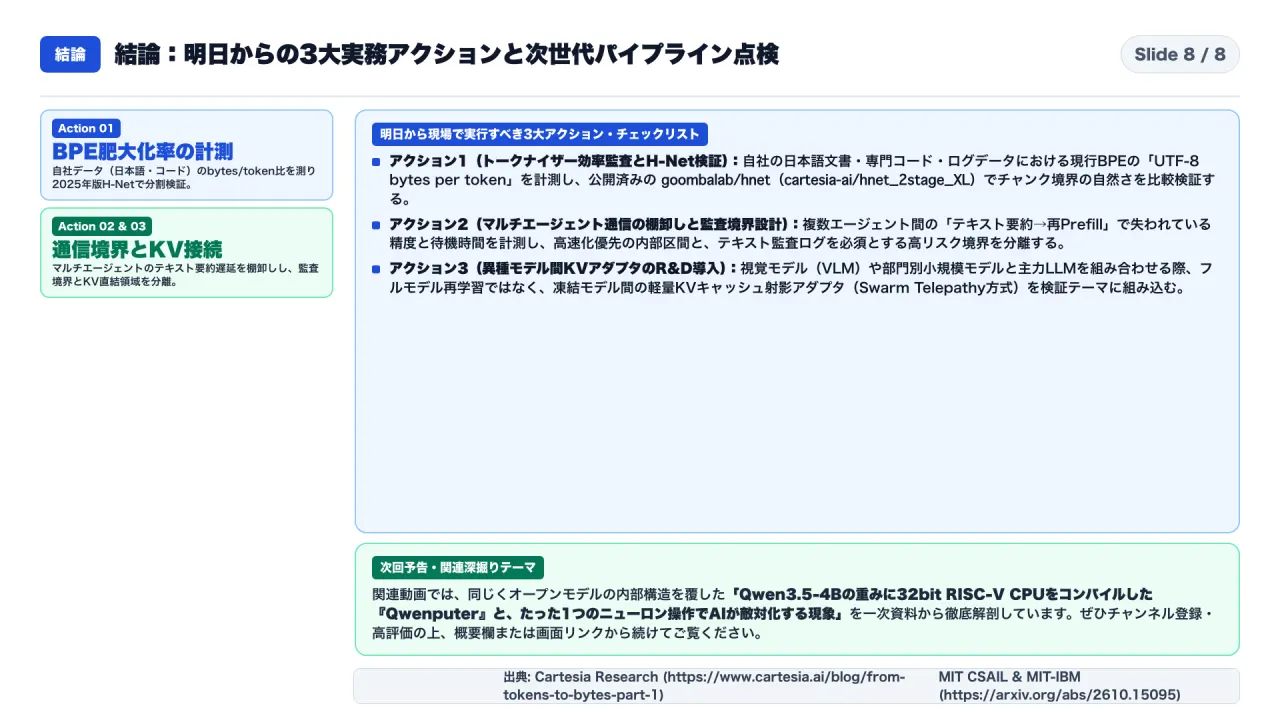
最後に、明日から現場で実行できる 3つの具体的アクション をまとめます。
- 自社データにおける「BPEトークン肥大化率」の計測と公開済みH-Netでの境界検証:
- 自社で扱っている日本語文書、独自DSL・設定コード、ログデータに対して、現行のLlama-3 / GPT系BPEトークナイザーが「何バイトあたり1トークン」に分割しているかを計測してください。その上で、すでにMITライセンスで公開されている2025年版H-Net(
goombalab/hnet)を検証環境で動かし、生バイトからの動的チャンク分けが日本語やコードの意味単位にどう沿うかを比較検証しておきましょう。
- 自社で扱っている日本語文書、独自DSL・設定コード、ログデータに対して、現行のLlama-3 / GPT系BPEトークナイザーが「何バイトあたり1トークン」に分割しているかを計測してください。その上で、すでにMITライセンスで公開されている2025年版H-Net(
- マルチエージェント設計における「監査境界(テキスト化必須ポイント)」と「高速潜在通信領域」の分離:
- 社内のマルチエージェントワークフローにおいて、毎回長文テキストを生成して次のエージェントに読ませている箇所を棚卸ししてください。法的監査や人間の承認が必要なゲートウェイでは明示的な構造化テキスト出力を維持しつつ、純粋な内部検索・視覚特徴引き継ぎ・多段推論のボトルネック箇所には、同一モデル間のKVキャッシュ共有やSwarm Telepathy型の潜在転送を導入する二層設計が有効です。
- 「単一巨大モデルの再学習」から「1 GPU日未満の軽量アダプタによる異種モデル結合」へのR&Dシフト:
- 視覚モデル(VLM)とテキスト推論モデル、あるいは異なる強みを持つオープンモデル(Qwen系とLlama系など)を組み合わせる際、モデル本体を再学習するのではなく、両モデルを凍結したまま軽量なKV変換モジュールだけを学習させるモジュラー統合アプローチを次世代基盤の検証項目に組み込みましょう。
参考資料・一次情報ソース一覧
- Cartesia Research (Albert Gu, Sukjun Hwang, Brandon Wang et al.): “From Tokens to Bytes I: Scaling Hierarchical Networks”, Cartesia Blog, October 28, 2026.
- URL: https://www.cartesia.ai/blog/from-tokens-to-bytes-part-1
- GitHub (2025 H-Net): https://github.com/goombalab/hnet
- Abdulrahman Alabdulkareem, Irene Tenison, Yang Zhang, Yada Zhu, Boris Katz, Dan Gutfreund (MIT CSAIL & MIT-IBM Watson AI Lab): “Swarm Telepathy: Prefill-Free KV-Cache Transfer Across Families”, arXiv:2610.15095, October 2026.