なぜ数百万ドルのGPUクラスタが「CPUの指示待ち」で遊んでいるのか?——CUDA Graph Replay一括起動とバックボーン約5倍・全体1.70倍高速化、4,096 GPU分散スケールの真実
【お詫びと訂正】 本記事および連動するYouTube動画(旧版動画および新版動画)において、以下の通り表現の訂正とお詫びを申し上げます。
- 動画版第4章における「家族との年末の大掃除」の話について:旧版動画内で実体験であるかのように話していた大掃除のエピソードは、実際には作り話のたとえでした。視聴者の皆様に誤解を与える表現であったことをお詫びし、新版動画では削除しております。
- 高速化倍率の適用範囲と断定表現の修正:見出し等で「5倍高速化」「CPUオーバーヘッドが消滅」「通信待ちが消滅」「完全封印」等の強い断定表現を用いていましたが、一次資料(PyTorch公式ブログ)における「31ms→6ms(約5倍)」はGPUあたりバッチサイズ1のMask R-CNNにおけるグラフ化したバックボーン部分の測定値であり、モデル全体では272 GPUで1.70倍(BERTでは4,096 GPUで1.12倍)です。また、CPU起動オーバーヘッドやOSジッタによる起動タイミングのばらつきは「消滅」ではなく「大幅に削減・抑制」されるものです。記事内の該当表現を一次資料に合わせて修正いたしました。
- PyTorch公式ドキュメントにおける制約分類と
copy_()の位置づけ:CUDA Graphsの制約には「違反時にランタイムエラーになりやすい制約」と「静かな数値誤りや未定義動作を引き起こし得る制約」の双方が含まれます。また、static_input.copy_()は固定仮想アドレスの入力領域を更新する公式の代表的な実装例(e.g.)として位置づけを明確化いたしました。
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ数百万ドルのGPUクラスタが「CPUの指示待ち」で遊んでいるのか?——CUDA Graph Replay一括起動とバックボーン約5倍・全体1.70倍高速化、4,096 GPU分散スケールの真実
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
- この記事の結論(核心): 「ディープラーニングの学習やLLMの推論が遅いなら、より高速なGPUに買い替えるかGPU数を増やすしかない」という思い込みは、小バッチ処理や数千基規模の分散スケーリングにおいて完全に裏目に出ます。NVIDIAのエンジニア陣とMeta(旧Facebook)のPyTorch開発陣が公開した公式技術報告およびPyTorch公式仕様書が示した真実は、「GPUが高速化し、処理を多数のGPUへ分散したりバッチサイズ1で実行したりすると、1回あたりのGPU演算はわずか数マイクロ秒で終わってしまうため、Python → C++ → CUDAドライバを経由して1個ずつカーネルを起動する『ホストCPU側のディスパッチ遅延』が追いつかず、CPUが100%飽和する裏で高価なGPUが大半の時間をアイドル状態で遊んでしまう」 という構造的ボトルネックでした。この壁を打破する CUDA Graphs(Stream Capture & Replay) は、一連のGPUカーネルとNCCL通信を固定メモリアドレスの有向グラフとして事前キャプチャし、2回目以降は単一の
cudaGraphLaunch(g.replay())命令1回で一括投入することで、Mask R-CNN(バッチサイズ1)のバックボーン実行時間を31ミリ秒から6ミリ秒へと5倍高速化(モデル全体でも272 GPUで1.70倍高速化) し、4,096基のGPUを束ねたBERT学習で1.12倍の高速化とMLPerf世界記録 を達成しました。 - 対象読者: LLM推論エンジン(vLLM / SGLang / TensorRT-LLM等)やPyTorch学習基盤を運用・最適化するMLエンジニア、GPUクラスタの稼働率と分散通信(NCCL AllReduce)のテール遅延を改善したいインフラ/SRE担当者、およびAI計算基盤の投資対効果を評価する技術責任者。
- 読み終えて持ち帰れる判断軸: 「なぜGPUを増設するほどCPUのカーネル起動オーバーヘッドが致命傷になるのか」「Stream CaptureとReplayがPython・C++・ドライバの3層を丸ごとスキップする仕組み」「BERTの4,096 GPUグラフ化を可能にした『固定長テンソル+Booleanマスク』による動的シェイプ排除術」、そして「公式ドキュメントが警告する『エラーすら出ずに静かに計算結果が狂う(Silent Numerical Errors)6つの禁止制約』と安全な実装パターン」を体系的に持ち帰ることができます。
背景と全体像:CPU使用率100%の裏で、超高価なGPUが隙間だらけで遊んでいる衝撃
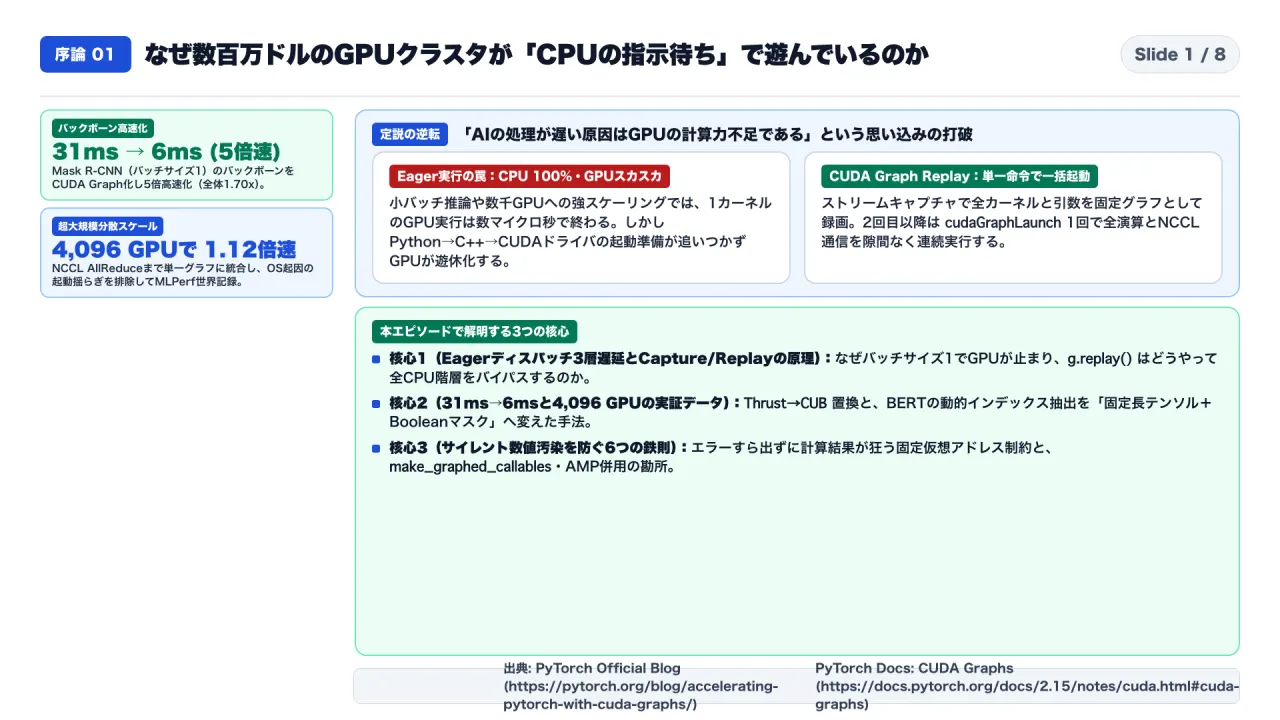
現代のLLM推論(1トークンずつ自己回帰で文字を出力するDecode処理)やリアルタイム推薦システム、あるいは数千基のGPUへ負荷を分散する大規模学習において、現場のエンジニアが最も頭を抱える現象があります。それは 「最高峰のGPUを並べたにもかかわらず、実効GPU稼働率が上がらず、期待したスピードが出ない」 という問題です。
この真犯人を白日の下に晒し、現在の多くの高速推論エンジン(vLLM、SGLang、TensorRT-LLMなど)の中核に組み込まれている技術が PyTorch CUDA Graphs です。本記事では、以下の2つの一次資料を1対1で照合しながら、その物理的メカニズムと実装の急所を徹底解剖します。
- Accelerating PyTorch with CUDA Graphs(Vinh Nguyen, Michael Carilli, Sukru Burc Eryilmaz, Vartika Singh, Michelle Lin, Natalia Gimelshein, Alban Desmaison, Edward Yang — NVIDIA & Meta / PyTorch公式ブログ):NSightプロファイリングによる31ms→6ms(5倍高速化)の実証、272 GPU Mask R-CNN(1.70x)および4,096 GPU BERT(1.12x)のMLPerf v1.0世界記録達成手法を公開。
- PyTorch Official Documentation: CUDA Semantics — CUDA Graphs(PyTorch公式リファレンス):
torch.cuda.CUDAGraph、torch.cuda.graph、torch.cuda.make_graphed_callablesのAPI仕様、AMP・マルチストリーム連携、およびランタイムエラー/サイレント数値汚染を引き起こす10大制約を定義。
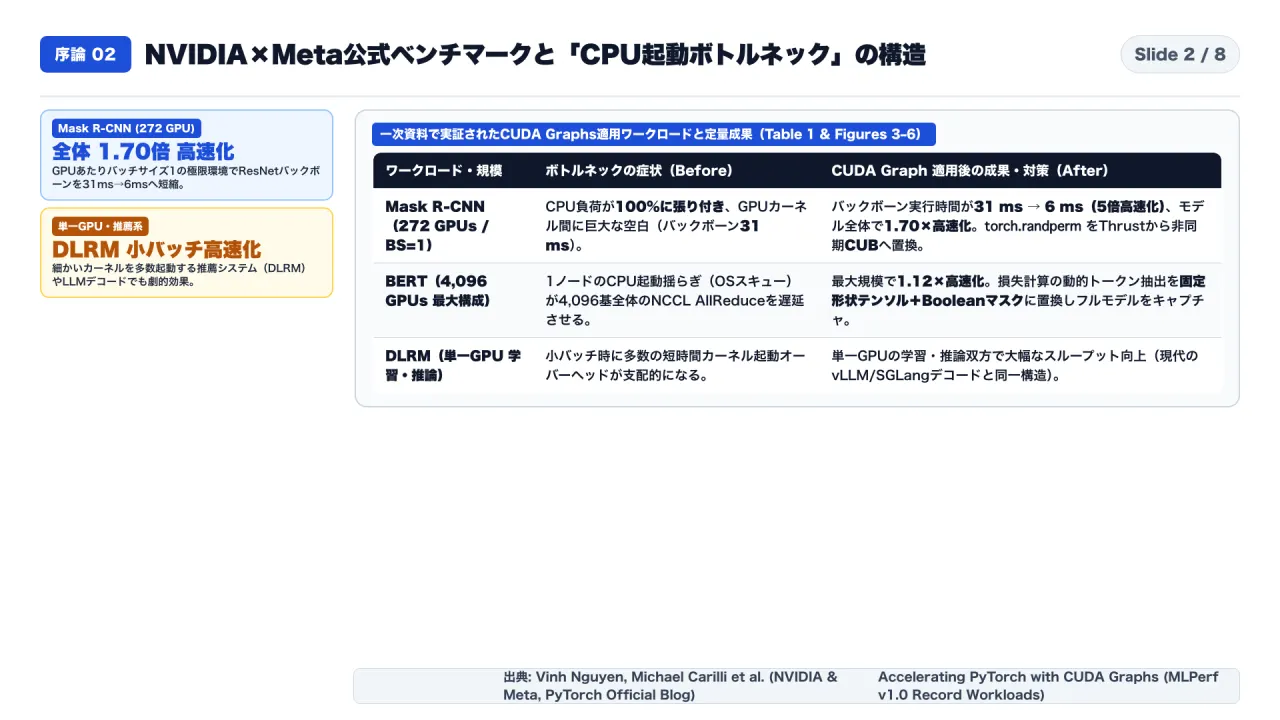
まず、一次資料で実証された定量インパクトと対象ワークロードを整理すると、以下の表の通りになります。
| 対象ワークロード | クラスタ・バッチ条件 | CUDA Graph 適用前の課題 | CUDA Graph 適用後の定量効果と技術対策 |
|---|---|---|---|
| Mask R-CNN(ResNet Backbone) | GPUあたり Batch Size = 1 | CPU負荷が 100%に飽和 し、GPUカーネル間に広大なアイドル空白が発生(実行時間 31 ms)。 | グラフ化部分の実行時間が 31 ms → 6 ms(5倍高速化)。GPUカーネルが隙間なく密着。 |
| Mask R-CNN(モデル全体) | 272 GPUs(MLPerf v1.0) | 同期C++ライブラリ(Thrust)によるCPU-GPU同期点がグラフ範囲を分断。 | torch.randperm を非同期 CUB 実装へ置換してグラフ範囲を拡大し、全体で 1.70倍高速化。 |
| BERT(大規模言語モデル学習) | 4,096 GPUs(最大スケール) | ①1ノードのCPU起動揺らぎ(Time skew)が全体のNCCL AllReduceを遅延。 / ②損失計算の有効トークン抽出で動的シェイプとCPU同期が発生。 | ①順伝播・逆伝播・NCCL AllReduceを単一グラフに統合。 / ②固定サイズテンソル+Booleanマスクで動的形状を排除し、4,096 GPUで 1.12倍高速化。 |
| DLRM(推薦システム) | 単一GPU(学習および推論) | 小バッチ時に多数の短時間カーネル(Short kernels)のCPU起動コストが支配的になる。 | 単一GPUの学習・推論双方で大幅な高速化を達成(現在のLLMデコードと同一の物理構造)。 |
第1章:なぜGPUは遊んでしまうのか —— Eager実行の3層ディスパッチ遅延とStream Capture / Replayの仕組み
1-1. 「バッチサイズが小さいほど、またGPUが速くなるほど、GPUは遊ぶ」という逆説
ディープラーニングフレームワークはGPUを使って行列演算を加速しますが、実は 「どのカーネルを、どの引数とメモリアドレスで起動するか」を決める膨大なコードはホスト側のCPUコアで実行 されています(PyTorch公式ブログ)。
通常のPyTorchの実行方式(Eager Execution:即時実行モード)では、1つの演算(例:Linear や LayerNorm、Dropout)を実行するたびに、CPU上で以下の 3層のソフトウェアスタック を通過します。
- Pythonインタプリタ層: Pythonの関数呼び出しとオブジェクト解決。
- PyTorch C++ ディスパッチ層: テンソル形状(Shape)、ストライド、データ型などのメタデータを検証し、適切なCUDAカーネル関数と引数を準備する処理。
- CUDA Driver層: GPUのコマンドキューへカーネル起動命令を発行するドライバ処理。
ここで決定的に重要な物理法則があります。 「CPUがメタデータを処理してカーネルを起動するコストは、バッチサイズに関係なくほぼ一定(Fixed Cost)であるのに対し、GPUが実際に計算を行う時間はバッチサイズに比例する」 という点です。
- 大バッチ(Large Batch Size)の場合: GPUでの1カーネルあたりの計算時間が十分に長いため、その計算中にCPUが次のカーネルの準備を終えて先にキューへ積んでおくことができ、CPUオーバーヘッドは外から見えません。
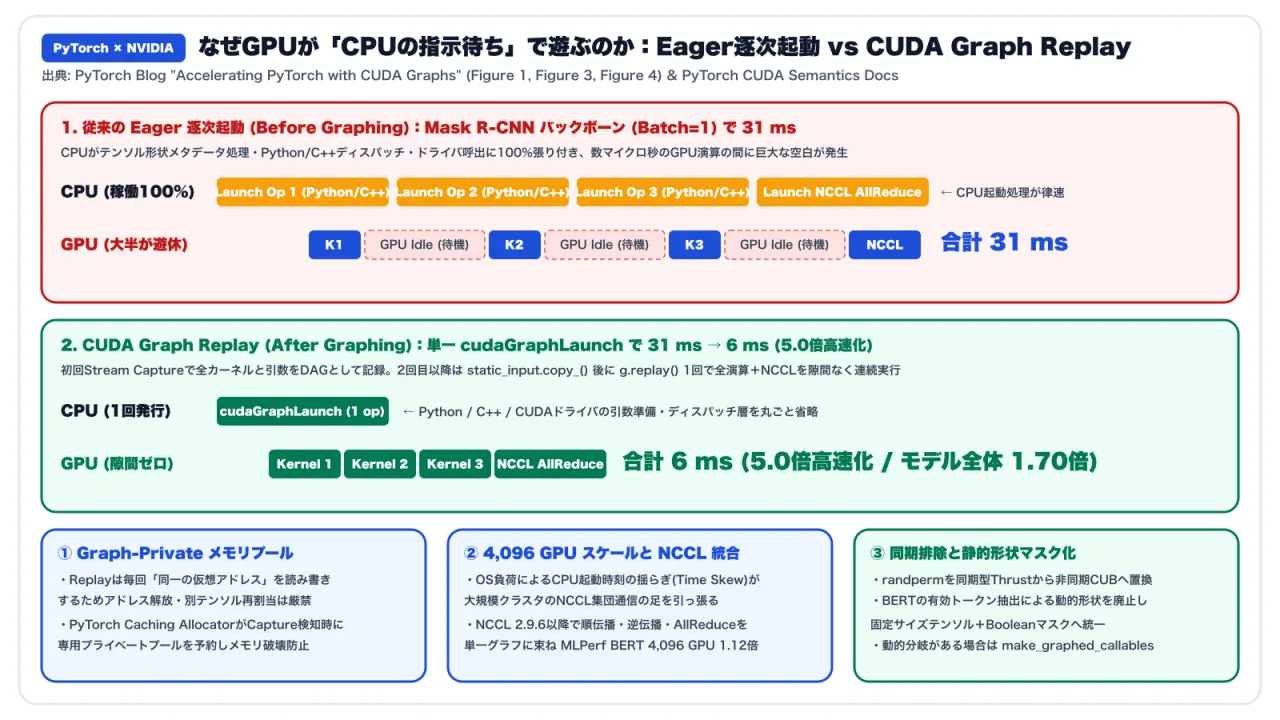
- 小バッチ(Small Batch Size = 1等)や強スケーリング(数千GPU分散)の場合: GPUが速くなり、1つのGPUが担当するデータ量が小さくなると、GPU上の1カーネルの実行時間はわずか数マイクロ秒(just a few microseconds)で終わってしまいます。すると「CPUが次のカーネルを準備して送り出す時間 > GPUが計算を終える時間」という逆転が起き、カーネル呼び出しとカーネル呼び出しの間でGPUが完全にアイドル状態(待ちぼうけ)になってしまうのです。
1-2. Stream Capture と cudaGraphLaunch による単一命令リプレイの3段階プロセス
このCPU起動オーバーヘッドを根絶するためにCUDA 10で導入され、PyTorch v1.10以降でネイティブサポートされたのが CUDA Graphs です(PyTorch公式仕様書)。
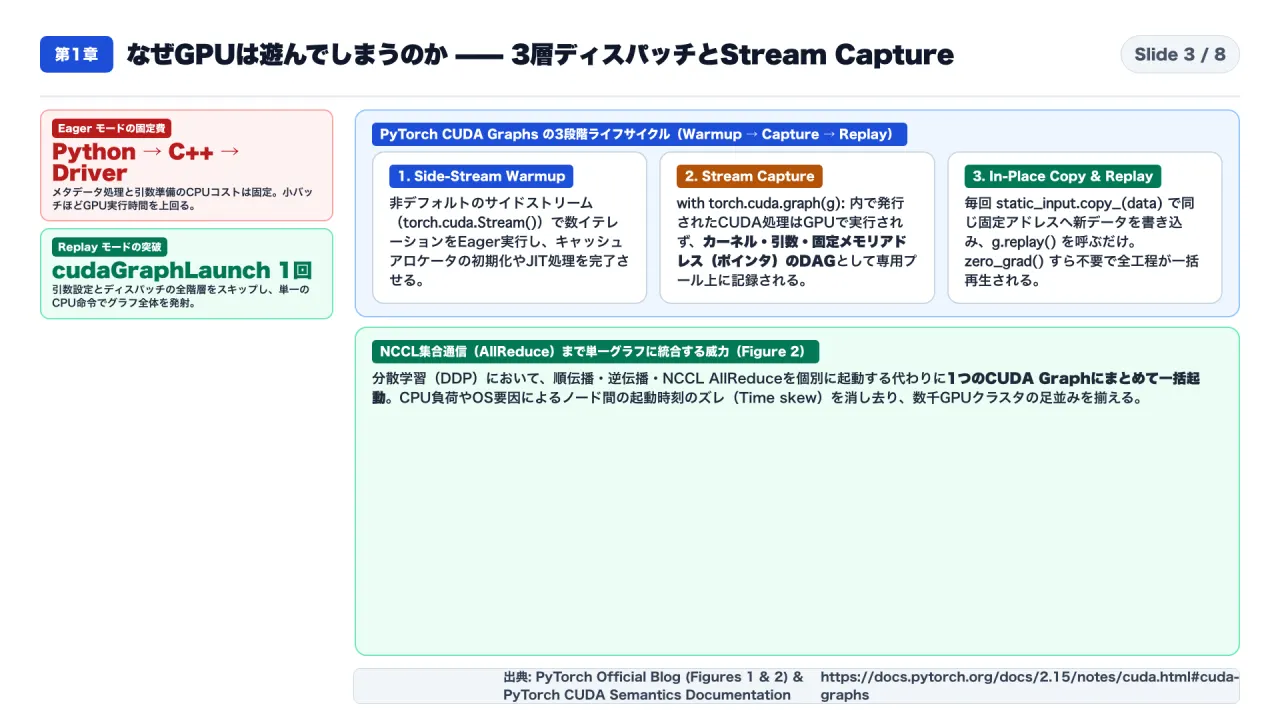
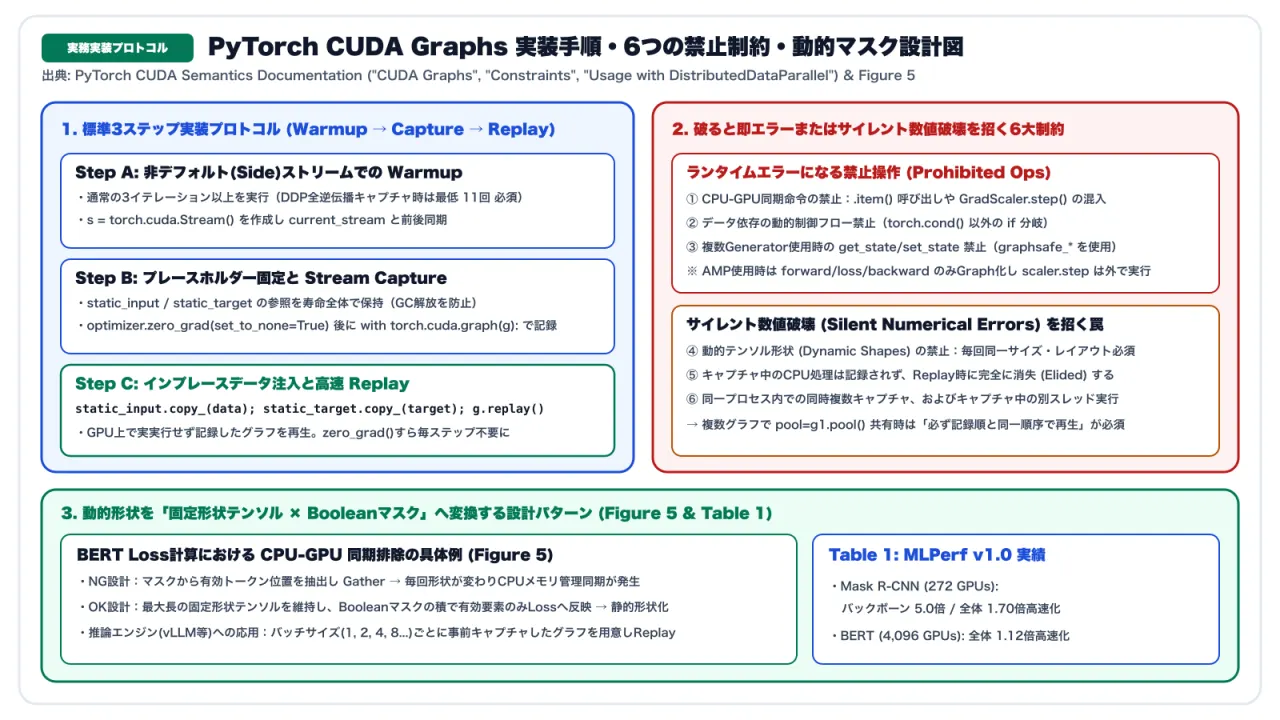
PyTorchは Stream Capture(ストリーム・キャプチャ) によってCUDAグラフを構築します。標準的な実装フローは以下の3段階で構成されます。
# 1. プレースホルダ(固定メモリアドレスを持つ静的テンソル)の確保
static_input = torch.randn(N, D_in, device='cuda')
static_target = torch.randn(N, D_out, device='cuda')

# 2. サイドストリームでのウォームアップ(Warmup)
s = torch.cuda.Stream()
s.wait_stream(torch.cuda.current_stream())
with torch.cuda.stream(s):
    for i in range(3):
        optimizer.zero_grad(set_to_none=True)
        y_pred = model(static_input)
        loss = loss_fn(y_pred, static_target)
        loss.backward()
        optimizer.step()
torch.cuda.current_stream().wait_stream(s)

# 3. グラフのキャプチャ(Capture:実際にはGPUで実行されず、DAGとして記録される)
g = torch.cuda.CUDAGraph()
optimizer.zero_grad(set_to_none=True)
with torch.cuda.graph(g):
    static_y_pred = model(static_input)
    static_loss = loss_fn(static_y_pred, static_target)
    static_loss.backward()
    optimizer.step()

# 4. 本番ループでのインプレース更新とリプレイ(Replay)
for data, target in zip(real_inputs, real_targets):
    static_input.copy_(data)
    static_target.copy_(target)
    g.replay()  # 単一の cudaGraphLaunch で forward, backward, step を一括実行
- なぜ
g.replay()は圧倒的に速いのか?: キャプチャされたグラフは「どのカーネルを、どの引数(固定メモリアドレスのポインタ)で実行するか」がすべて確定しています。そのため、リプレイ時には Python・C++・CUDAドライバの引数セットアップとディスパッチの全階層を丸ごとスキップし、内部でたった1回のcudaGraphLaunch呼び出しだけでグラフ全体の全カーネルをGPUへ一括投入 します。さらに、反復ごとにoptimizer.zero_grad()を呼ぶ必要すらありません(キャプチャされた逆伝播がグラフ専用プール上の.gradテンソルをそのままインプレースで上書きするためです)。
第2章:31msが6msへ5倍高速化・4,096 GPUでの実証データと「CPU同期・動的形状」を消す3大技法
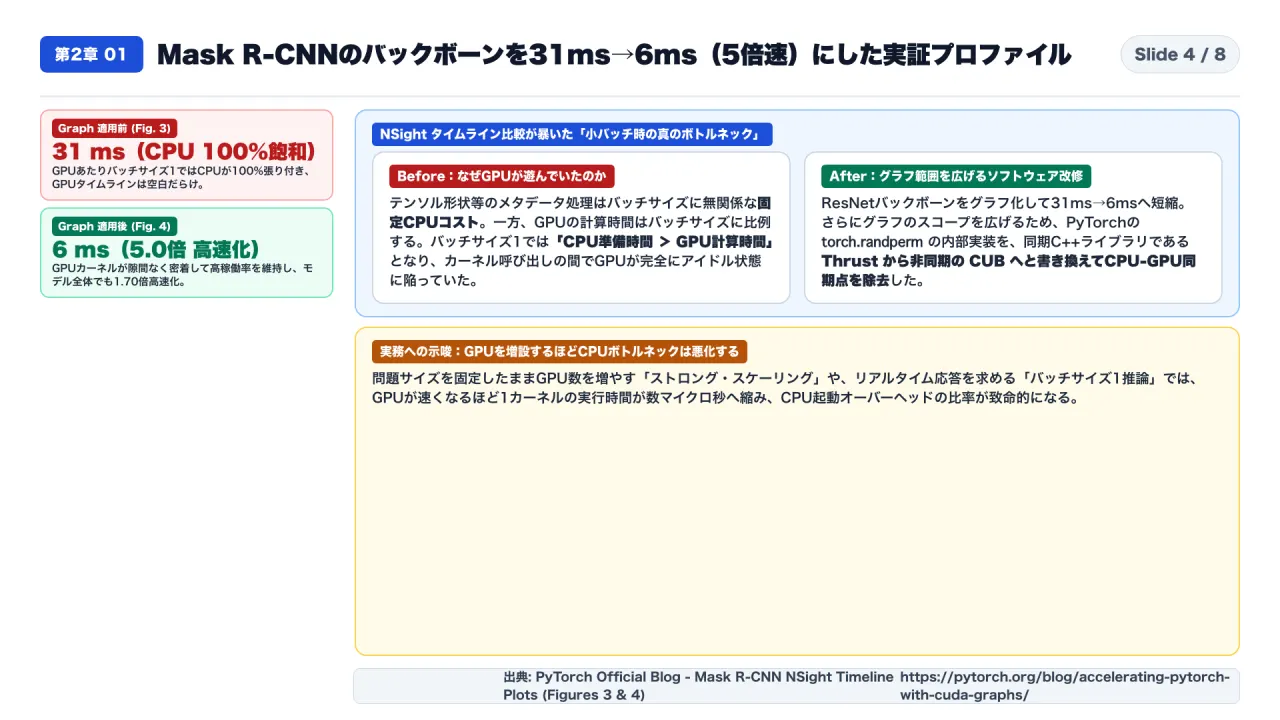
2-1. 実証1:Mask R-CNN(272 GPUs / バッチサイズ1)でバックボーンが「31ms → 6ms(5倍速)」に激変
NVIDIAとMetaのチームが公開したNSight Systemsのプロファイリング結果(PyTorch公式ブログ Figures 3 & 4)は、CPUボトルネックの恐ろしさを視覚的に証明しています。
- グラフ化前(Figure 3): GPUあたりのバッチサイズ1でMask R-CNNのResNetバックボーンを実行すると、CPU側の緑色のバーは 100%負荷で完全に飽和 している一方、GPU側の青色のバーはカーネルとカーネルの間が空白だらけで、実行に 31 ms かかっていました。
- グラフ化後(Figure 4): CUDA Graphでキャプチャして単一命令でリプレイした結果、CPU起動オーバーヘッドが大幅に削減されてGPUカーネルが隙間なくびっしりと詰まり、同じバックボーン部分が 6 ms(約5倍高速化、モデル全体では272 GPUで1.70倍高速化) で完了しました。
ThrustからCUBへの内部置換: さらにグラフ化できる範囲を広げるため、研究チームはPyTorchのtorch.randperm関数の内部実装に手を入れました。従来の実装が使っていたC++テンプレートライブラリ Thrust はCPUとGPUの同期を発生させてグラフを分断してしまうため、これを非同期実行可能な CUB へと置き換えることで同期ポイントを排除し、272 GPUでのMask R-CNN全体で 1.70倍のスピードアップ を達成しました。
2-2. 実証2:4,096 GPUのBERT学習(1.12倍速)を支えた「NCCL統合」と「Booleanマスクによる静的シェイプ化」
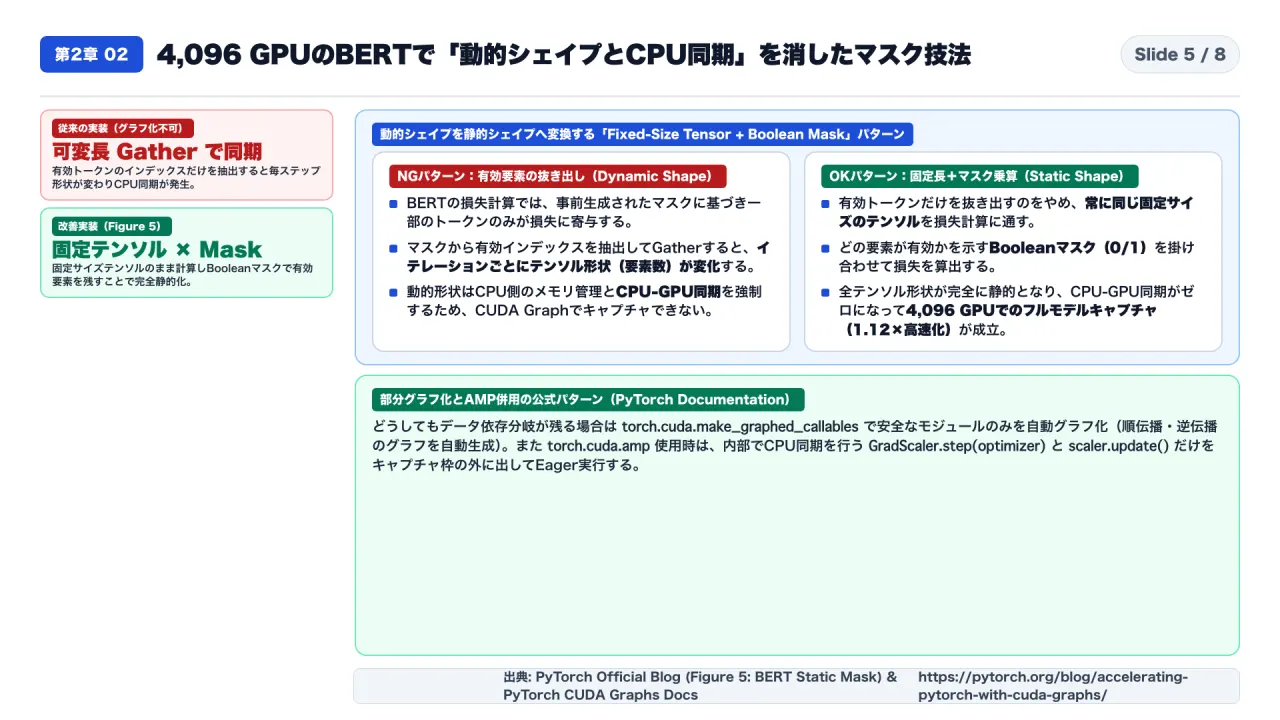
さらに大規模クラスタ特有の課題を解決したのが、4,096基のGPU を用いたBERT学習における 1.12倍の高速化 です。ここには2つの決定的なエンジニアリング技法が使われています。
- NCCL AllReduce通信カーネルのグラフ統合と「OSタイムスキュー」の排除(Figure 2):
- 分散データ並列(
DistributedDataParallel+ NCCLバックエンド)では、各GPUの計算後にNCCL AllReduceで勾配を同期します。通常は順伝播・逆伝播とNCCL通信を別々に起動しますが、CPUの負荷状況やOSのバックグラウンド割り込みによって、カーネルの起動タイミングには予測不能な揺らぎ(Time skew)が生じます。 - 4,096基のクラスタでは、たった1台の遅いノード(Straggler)でCPUの起動がわずかに遅れただけで、クラスタ全体の集合通信が待たされて性能が低下 します。NCCLのCUDA Graphサポートを用い、順伝播・逆伝播・NCCL AllReduceを 1つのグラフに束ねて起動 することで、全ランクの実行タイミングを完全に一貫させました。
- 分散データ並列(
- 動的インデックス抽出(Dynamic Gather)から「固定サイズテンソル+Booleanマスク」への書き換え(Figure 5):
- CUDA Graphの最大の鉄則は 「グラフ内のすべてのテンソル形状(Shape)がイテレーション間で完全に静的(一定)でなければならない」 という点です。
- しかしBERTの事前学習では、全トークンのうちマスクされた一部の有効トークンだけが損失関数(Loss)に寄与します。従来の実装では「マスクから有効トークンのインデックスを抽出し、そのトークンだけを集める(Gatherする)」という処理を書いていたため、バッチごとに有効トークン数が変わって「動的シェイプ(Dynamic Shape)」となり、CPU側のメモリ管理とCPU-GPU同期が走ってフルモデルのグラフ化が不可能 でした。
- そこで研究チームは、有効トークンだけを抜き出すのをやめ、「常に同じ固定サイズのテンソルを損失計算に通し、どの要素が有効かを示すBooleanマスク(0または1)を掛け合わせる」 という実装に書き換えました(Figure 5)。これによりすべてのテンソル形状が完全に静的になり、CPU-GPU同期がゼロになってフルモデルのグラフキャプチャが実現したのです。
第3章:対立する視点と死角 —— 「サイレント数値汚染」を引き起こす6つの禁止事項と部分グラフ化の境界
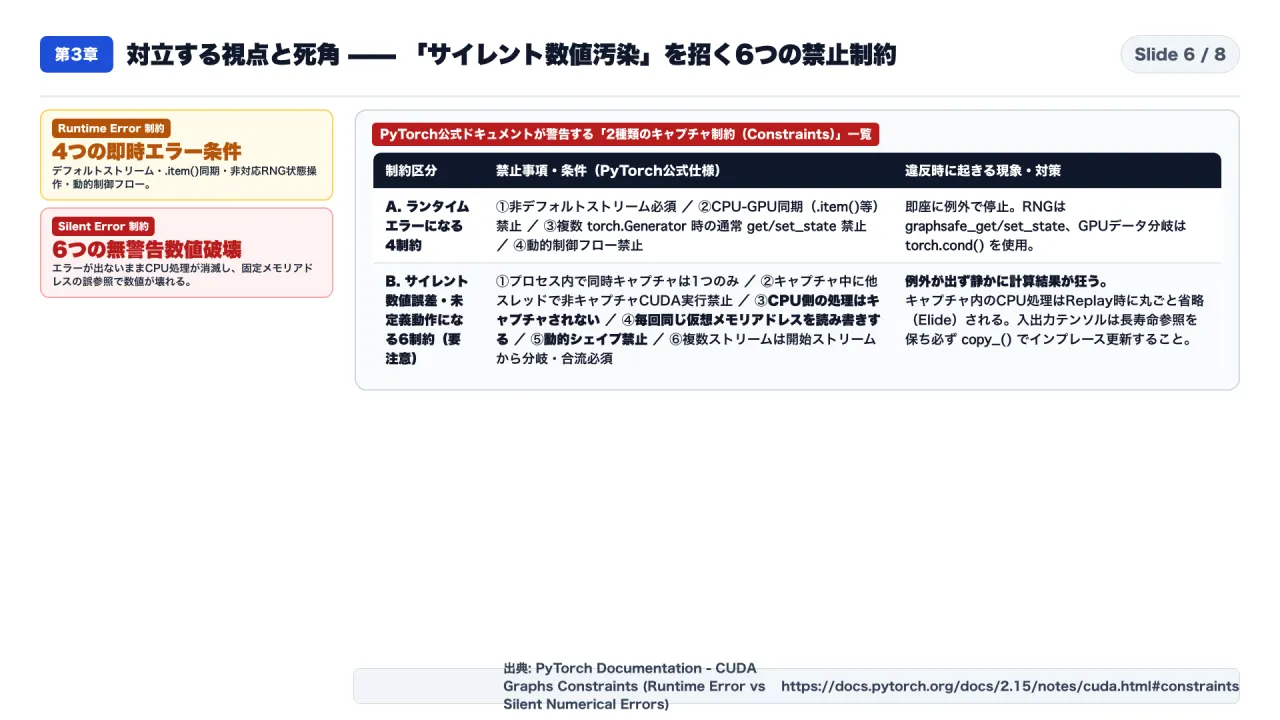
3-1. 公式仕様書が警告する「2種類のキャプチャ制約」:ランタイムエラー vs サイレント数値汚染
CUDA Graphは強力な反面、Eagerモードの柔軟性と引き換えに厳格なルールを課します。PyTorch公式ドキュメント(PyTorch CUDA Graphs Constraints)は、違反した際の結果によって制約を 2つのカテゴリ に厳密に分類しています。
| 区分 | 違反時に起きる現象 | 公式仕様書に明記された具体的な禁止・必須ルール |
|---|---|---|
| カテゴリA:違反すると通常ランタイムエラー(probably results in a runtime error)になる4つの制約 | キャプチャ時または実行時に通常はエラー・例外が発生して停止する。 | 1. 非デフォルトストリーム必須: キャプチャはデフォルト以外のストリームで行う必要がある(torch.cuda.graph や make_graphed_callables は自動でサイドストリームを設定)。 / 2. CPU-GPU同期演算の禁止: .item() 呼び出しなど、CPUとGPUを同期させる操作は一切禁止。 / 3. 複数乱数生成器(Generator)の安全な状態管理: 複数の torch.Generator をグラフ内で使う際、通常の get_state / set_state は禁止。必ず Generator.graphsafe_get_state と Generator.graphsafe_set_state を使用すること。 / 4. 動的制御フローの禁止: CPUまたはGPUデータに基づく動的な制御フローは禁止(ただしGPUデータに基づき高階演算子 torch.cond() で実装された場合を除く)。 |
| カテゴリB:違反すると「サイレントな数値エラーまたは未定義動作を引き起こしうる(may cause silent numerical errors or undefined behavior)」6つの制約【最警戒】 | エラーや例外が出ないまま、計算結果の数値が静かに壊れる、または未定義動作に陥る恐れがある。 | 1. 同時キャプチャの排他性: 1プロセス内で同時に進行できるキャプチャは1つのみ。 / 2. 他スレッドでの非キャプチャCUDA作業の禁止: キャプチャ進行中、同一プロセス内のいかなるスレッドでも非キャプチャのCUDA処理を実行してはならない。 / 3. CPU側の処理は録画されず省略される: キャプチャ対象の関数内にCPU側の処理(Pythonのカウンタ更新やログ出力等)が含まれていても、それはキャプチャされず、リプレイ時には完全に省略(Elide)される。 / 4. 固定された同一仮想メモリアドレスの読み書き: すべてのリプレイは、キャプチャ時と 全く同じ仮想メモリアドレス を読み書きする。PyTorchが入力や出力のメモリを再割り当て・解放しないよう長寿命参照を保持し、新しい入力データは既存の入力テンソルへインプレースに詰める(例:static_input.copy_(data))。 / 5. 動的シェイプ(Dynamic Shapes)の禁止: グラフはキャプチャされた全演算のすべてのテンソルが、毎回同じサイズとレイアウトであることを前提とする。 / 6. マルチストリームの分岐・合流規則: キャプチャ内で複数ストリームを使う場合、初期キャプチャストリームから分岐(Branch out)し、キャプチャ終了前に必ず初期ストリームへ合流(Rejoin)するDAGでなければならない。 |
3-2. 全体をキャプチャできないときの2大実践パターン:make_graphed_callables と torch.cuda.amp
もしネットワークの途中にどうしても .item() によるデータ依存分岐(例:if tmp.sum().item() > 0:)がある場合や、自動混合精度(torch.cuda.amp)の GradScaler を使う場合はどうすればよいのでしょうか。公式ドキュメントは2つの明確な解決策を提供しています。
- 部分ネットワークのグラフ化(
torch.cuda.make_graphed_callables):- ネットワーク全体ではなく、キャプチャ安全なサブモジュール(
module1,module2,module3)だけをtorch.cuda.make_graphed_callables(module, (sample_input,))に渡します。 - このラッパーは内部で自動的に
CUDAGraphオブジェクトの生成、ウォームアップ実行、静的入出力テンソルの管理を行い、さらに Autograd対応(順伝播だけでなく逆伝播のグラフも自動作成) しているため、前後の安全なモジュールをグラフとして高速実行しつつ、間のif tmp.sum().item() > 0:だけをEager実行できます(ただしサンプル入力のrequires_grad状態は本番入力と一致させる必要があります)。
- ネットワーク全体ではなく、キャプチャ安全なサブモジュール(
torch.cuda.amp(GradScaler)との併用パターン:- 典型的なオプティマイザでは、
GradScaler.step(optimizer)が内部でCPUとGPUを同期(NaN/Infチェック)するため、キャプチャの中に入れるとエラーになります。 - そのため、
autocast()内の順伝播・損失計算とscaler.scale(static_loss).backward()だけをwith torch.cuda.graph(g):の中でキャプチャし、scaler.step(optimizer)とscaler.update()はキャプチャの外に出して、g.replay()の直後にEager実行する のが公式の定石です。
- 典型的なオプティマイザでは、
第4章:【私なりの解釈】LLMデコードと4,000基クラスタにおける「真の律速段階」はCPUとOSのジッタである
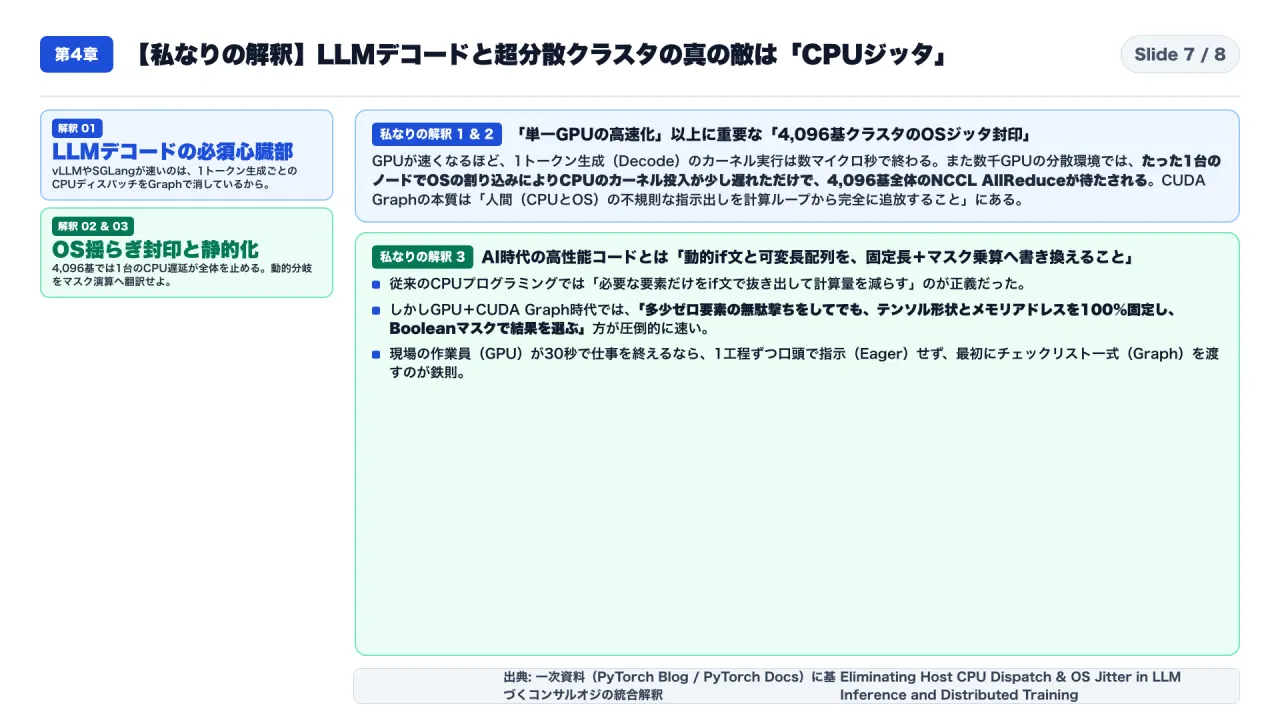
ここまでの一次資料を現代のAIインフラ文脈と重ね合わせると、3つの本質的な洞察(私なりの解釈) が見えてきます。
4-1. 解釈1:現代のLLM推論エンジン(vLLM / SGLang)のデコード速度を決めているのは「CUDA Graphの網羅率」である
LLMの推論において、最初のプロンプトを一括処理するPrefillは計算量が多い大バッチ相当の処理ですが、1トークンずつ言葉を生成する Decodeフェーズは典型的な「小バッチ・超短時間カーネルの反復」 です。もしDecodeを通常のEagerモードで回せば、Mask R-CNNのFigure 3と全く同じように、CPUのカーネル発行が追いつかずGPUの大半の時間がアイドル空白になります。今日、vLLMやSGLangが起動時にバッチサイズ別(1, 2, 4, 8, …)のCUDA Graphを事前キャプチャしているのは、まさにこのCPUディスパッチ3層をバイパスして cudaGraphLaunch 1回で1トークン分の全層を一括発射するためなのです。
4-2. 解釈2:4,096基クラスの超分散クラスタにおけるCUDA Graphの真の価値は「OSジッタ(揺らぎ)の完全封印」にある
単一GPUでの高速化もさることながら、数千GPU規模の分散学習・分散推論においてCUDA Graphが不可欠な理由は 「ノード間の起動時刻のズレ(Time skew)の消去」 にあります。4,096基のGPUがNCCL AllReduceで同期する環境では、4,096台のうちたった1台のホストCPUでOSのプロセススケジューリングや割り込みによる数ミリ秒の遅延が起きただけで、残り4,095台のGPUすべてが待たされます。計算カーネルとNCCL通信カーネルを単一のCUDA Graphに封じ込めることは、「不確定な揺らぎを持つホストCPUとOSを、クリティカルパスから完全に追放する」 ことを意味します。
4-3. 解釈3:AI時代のハイパフォーマンス実装とは「動的なif文と可変長抽出を、固定長テンソル+マスク乗算へ翻訳する技術」である
従来のCPU向けソフトウェア開発では、「不要な要素をif文やフィルタで先に除外して計算回数を減らす」ことが最適化の基本でした。しかし、CUDA Graphが支配するGPUコンピューティングではその常識が逆転します。BERTの事例(Figure 5)が示した通り、有効な要素だけを抜き出してテンソル形状を可変にしてしまうと、CPU同期と再アロケーションで性能が崩壊します。「多少のゼロ要素の計算(無駄撃ち)を増やしてでも、テンソル形状とメモリアドレスを100%固定し、Booleanマスクの掛け算で処理する」 ことこそが、現代のGPUプログラミングの核心です。
結論:明日からAI推論・学習基盤チームが取るべき3つの実務アクション
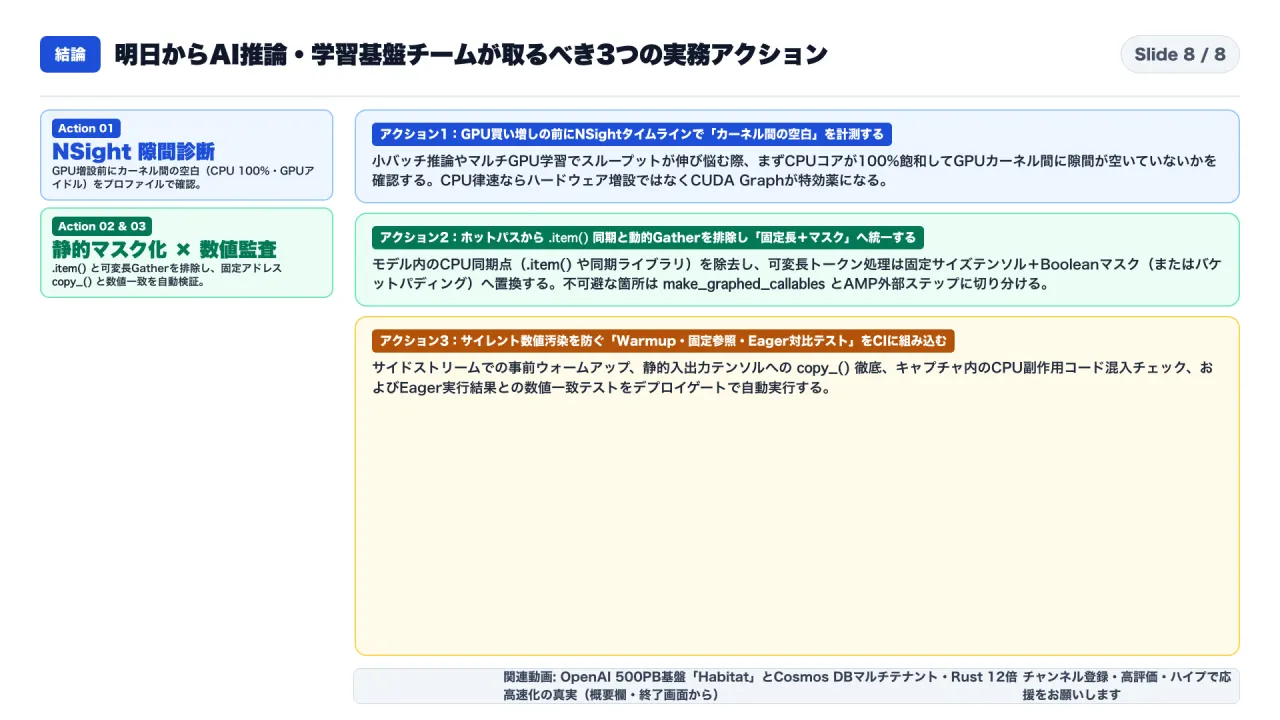
最後に、私たちが明日からのAI開発・推論基盤運用で実行すべき 3つの具体的アクション をまとめます。
- アクション1:GPUの増設や上位機種への移行を決める前に、NSight Systems等で「GPUカーネル間のアイドル空白」をプロファイリングする:
- 小バッチ推論やマルチGPU学習でスループットが出ないとき、まずタイムライン上で「CPUコアが100%に張り付き、GPUのカーネル間に隙間が空いていないか」を確認してください。もし隙間が空いているなら、必要なのは新しいGPUではなくCUDA Graphの導入です。
- アクション2:モデル内の
.item()同期と可変長Gatherを洗い出し、「固定サイズテンソル+Booleanマスク」およびmake_graphed_callablesへリファクタリングする:- ホットパス内のCPU-GPU同期(
.item()や同期ライブラリ呼び出し)を除去し、可変長のマスク抽出処理は固定長テンソル+Booleanマスク乗算(または固定バケットへのパディング)へ書き換えてください。どうしても動的制御が残る箇所はtorch.cuda.make_graphed_callablesで切り分け、AMP使用時はGradScaler.step/updateをキャプチャ外に出してください。
- ホットパス内のCPU-GPU同期(
- アクション3:「サイレント数値汚染」を防ぐ3点セット(サイドストリームWarmup・固定参照
copy_()・Eager数値一致テスト)をCIに組み込む:- キャプチャ前のサイドストリームでのウォームアップ、静的入出力テンソルへの長寿命参照保持と
copy_()によるインプレース更新、そして「Eager実行の出力とg.replay()の出力が許容誤差内で完全に一致するか」を自動検査する回帰テストを必ずデプロイゲートに設けてください。
- キャプチャ前のサイドストリームでのウォームアップ、静的入出力テンソルへの長寿命参照保持と
よくある疑問と実務Q&A(FAQ)
Q1. なぜ「バッチサイズ1」や「数千GPUへの強スケーリング」になるほど、GPUの稼働率が落ちてしまうのですか?
- A. GPUの計算時間はデータ量に比例して数マイクロ秒まで縮むのに対し、CPUがカーネルを起動する準備コストはバッチサイズに関係なく一定(Fixed Cost)だからです。 PyTorchで1つの演算を実行する際、CPU側では①Pythonの関数呼び出し、②C++層でのテンソル形状やメタデータの検証・引数準備、③CUDAドライバによる命令発行という3段階の処理が走ります。バッチサイズが大きければGPUでの計算時間が長いためCPUの準備時間は隠れますが、LLMの自己回帰デコード(Batch Size = 1)や数千GPUへの分散(Strong Scaling)では、1カーネルあたりのGPU計算がわずか数マイクロ秒で終わってしまいます。その結果、Mask R-CNN(バッチサイズ1)のNSightプロファイル(Figure 3)が示した通り、CPUが100%負荷で飽和している裏で、GPUは次の命令が届くのを待って隙間だらけで遊ぶ ことになります。
Q2. CUDA Graphのリプレイ時に static_input = new_data と普通に代入してはいけないのはなぜですか?
- A. グラフはキャプチャ時に記録された「固定された仮想メモリアドレス(ポインタ)」を毎回読みに行くため、Python変数の参照先を変えても新しいデータは一切読まれないからです。
Pythonで
static_input = new_dataと書くと、static_inputという変数名が新しいテンソルのメモリアドレスを指すようになるだけで、キャプチャ時に記録された元のメモリアドレスの中身は書き換わりません(それどころか元のテンソルがガベージコレクションされると未定義動作やメモリ破壊を起こします)。しかもこのミスは ランタイムエラーにならず、静かに古いデータやゴミデータで計算が続く(Silent Numerical Error) ため極めて危険です。必ずキャプチャ時に使ったテンソルへの参照を保持し続け、static_input.copy_(new_data)で 同じメモリアドレスの中身をインプレース上書き してください。
Q3. なぜキャプチャの前に「非デフォルトのサイドストリームで数回のウォームアップ(Warmup)」が必要なのですか?
- A. 初回実行時にのみ走るPyTorchのキャッシュメモリアロケータ確保やJIT初期化、cuDNNのアルゴリズム探索等をキャプチャ対象から外すためです。
もしウォームアップなしでいきなり1回目のイテレーションをキャプチャしようとすると、CUDAキャッシュアロケータによる新規メモリブロックの確保(
cudaMalloc相当の同期処理)やライブラリの遅延初期化が走り、キャプチャ失敗や不要なオーバーヘッドの混入を招きます。サイドストリーム(s = torch.cuda.Stream())上で3回ほどEager実行してメモリアロケーションを安定させてから、with torch.cuda.graph(g):でキャプチャに入るのが公式手順です。また、完全ネットワークキャプチャの直前にはoptimizer.zero_grad(set_to_none=True)を呼んでおくことで、キャプチャ中のbackward()がグラフ専用プライベートプールから.gradテンソルを確保し、以後のリプレイではzero_grad()の呼び出しすら省略できます。
Q4. LLMの推論では入力プロンプト長やバッチサイズが毎回変わりますが、静的シェイプしか許されないCUDA Graphをどうやって使っているのですか?
- A. よく使われるバッチサイズ(例:1, 2, 4, 8, 16…)ごとに複数のCUDA Graphを事前キャプチャしておき、端数はパディング(Padding)とマスクで固定形状に揃えてリプレイしています。 これはBERTの4,096 GPU学習(Figure 5)で使われた 「固定サイズテンソル+Booleanマスク」 の応用そのものです。vLLMやSGLangなどの現代的な推論エンジンは、デコードフェーズ用に代表的なバッチサイズのグラフを起動時に複数キャプチャして保持します。たとえば実際の同時リクエスト数が「6」であれば、サイズ「8」の静的入力テンソルにデータをコピーし、残りの2スロットをマスク(ダミー)としてサイズ「8」用のCUDA Graphをリプレイします。2スロット分の余分な計算をするよりも、CPU起動オーバーヘッド(31ms→6ms相当)を消す方が圧倒的に速いからです。
明日から現場で使える「CUDA Graph導入・監査」点検チェックリスト
| 点検ステップ | 具体的な確認項目 | 合格基準(アクション指標) |
|---|---|---|
| 1. ボトルネック診断 | GPU稼働率が低い原因が「GPU演算律速」か「CPU起動律速」か切り分けているか? | NSight Systemsでタイムラインを取得し、CPU 100%飽和+GPUカーネル間の空白(Idle Gaps)を確認する。 |
| 2. CPU同期点の排除 | キャプチャ対象範囲の中に .item()、print(tensor)、同期ライブラリ(Thrust等)が残っていないか? |
CPU-GPU同期を全廃し、非同期実装(CUB等)または torch.cuda.make_graphed_callables による部分グラフ化へ切り替える。 |
| 3. 形状の完全静的化 | マスクからの有効要素抽出(Gather / nonzero)によって毎ステップ形状が変わっていないか? |
BERT方式にならい「固定サイズテンソル+Booleanマスク乗算」または固定バケットパディングへ統一する。 |
| 4. AMP / RNG 境界処理 | GradScaler.step() や通常の Generator.get_state() をキャプチャ内に入れていないか? |
scaler.step(optimizer) と scaler.update() はキャプチャ外でEager実行し、複数RNGは graphsafe_get/set_state を使う。 |
| 5. サイレント汚染防止テスト | キャプチャ内のCPU処理消滅や、固定アドレス未更新による数値ズレを検査しているか? | サイドストリームWarmup+static_input.copy_() を徹底し、CIでEager実行と g.replay() の出力一致を自動検証する。 |
あわせて読みたい関連記事とチャンネル案内
- 関連深掘り記事(OpenAI 500PBストレージ基盤とRust 12倍高速化): なぜ「完全分離」でDBが落ちたのか?──OpenAIの500PB・毎秒7,000万リクエスト基盤「Habitat」が暴いたAzure Cosmos DBマルチテナントの罠とRust 12倍高速化の真実
- 関連深掘り記事(温度0でも出力がズレるGPUカーネルの非決定性): なぜLLMは「温度0」でも毎回答えが変わるのか?──バッチサイズ不変性(Batch Invariance)と浮動小数点アトミック加算の真実
- 固定自己紹介・番組ガイド: コンサルオジのプロフィールと「海外一次資料×1テーマ徹底深掘り」の制作方針
参考・一次資料リンク一覧(Primary Sources)
- PyTorch Official Blog (NVIDIA & Meta Engineers): Accelerating PyTorch with CUDA Graphs (Vinh Nguyen, Michael Carilli, Sukru Burc Eryilmaz, Vartika Singh, Michelle Lin, Natalia Gimelshein, Alban Desmaison, Edward Yang)
- PyTorch Official Documentation: CUDA Semantics — CUDA Graphs (
torch.cuda.CUDAGraph,torch.cuda.graph,torch.cuda.make_graphed_callables, Constraints)