なぜ「完全分離」でDBが落ちたのか?——OpenAIの500PB・毎秒7,000万リクエスト基盤「Habitat」が暴いたAzure Cosmos DBマルチテナントの罠とRust 12倍高速化の真実
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ「完全分離」でDBが落ちたのか?——OpenAIの500PB・毎秒7,000万リクエスト基盤「Habitat」が暴いたAzure Cosmos DBマルチテナントの罠とRust 12倍高速化の真実
はじめましての方は、ぜひこちらの自己紹介記事(コンサルオジのプロフィールと番組方針)もあわせてご覧ください。
導入:この記事の結論・対象読者・持ち帰れる判断軸
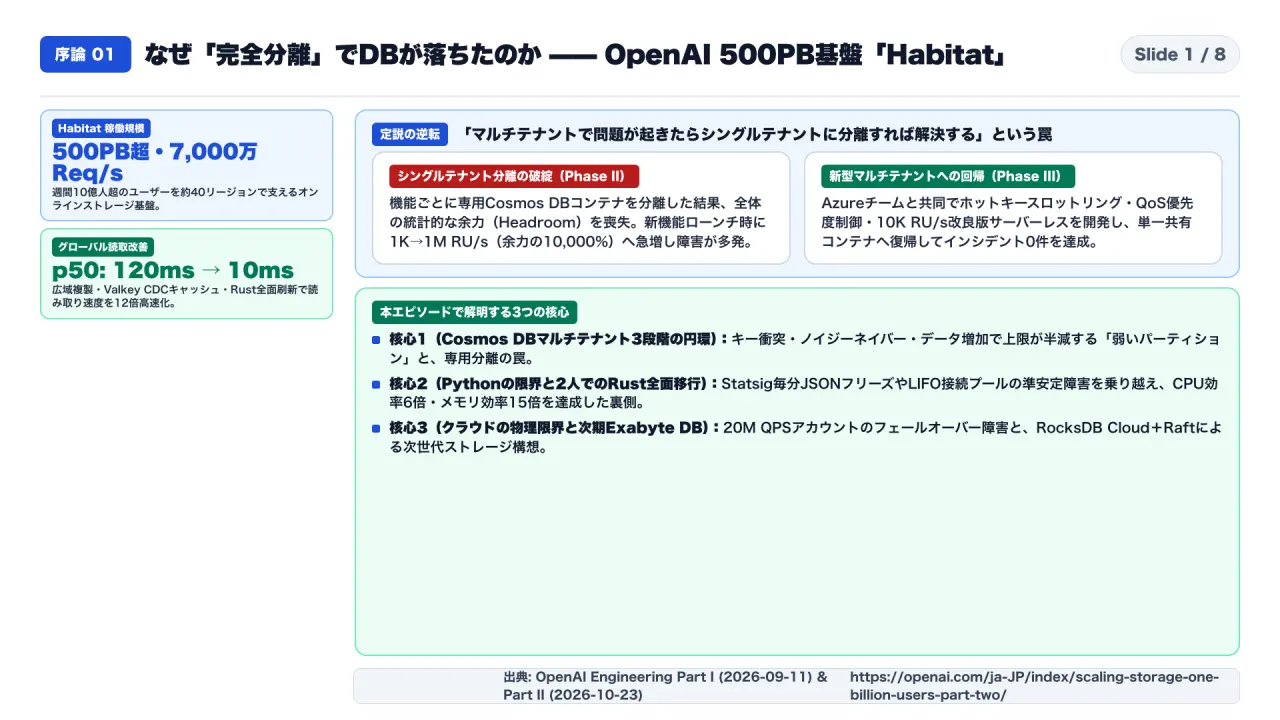
- この記事の結論(核心): 「マルチテナントのデータベースで他サービスの負荷による巻き添え障害(ノイジーネイバー)が起きたなら、サービスや機能ごとに専用のコンテナへ完全に分離(シングルテナント化)すれば安全になる」というインフラ設計の定説は、週間利用者10億人超・データ総量500ペタバイト(PB)超・毎秒7,000万リクエスト超(約40リージョン) を処理するOpenAIのオンラインストレージ基盤 「Habitat」 の公式エンジニアリング報告書(全2部)によって鮮やかに覆されました。第1に、OpenAIは当初の共有Azure Cosmos DBコンテナで 「論理パーティションキー衝突」「ノイジーネイバー」「データ量増加で物理パーティションが分割されるほど実効スループット上限が10K→5K RU/sへ半減する『容量不足のパーティション(Weak Partitions)』」 に苦しみ、機能ごとの専用コンテナ分離(フェーズII)へ移行しました。しかしその結果、共有プールが持っていた「全体の安定した増加傾向(Aggregate Growth / 2,000万RU/sの余力)」を失い、新機能リリース時に負荷が1K→1M RU/s(専用コンテナ余力の 10,000%)へ急増して本番障害が多発したため、最終的にAzureチームと共同開発した 「ホットキースロットリング・QoS階層化・物理10K RU/s改良版サーバーレス」を備えた新型マルチテナント(フェーズIII)へ一巡して回帰し、インシデント0件を達成 しました。第2に、サービス層ではPythonのイベントループ遅延(Statsigの毎分ジッターなしJSON解析フリーズ)や
aiohttpの LIFO接続プール再利用による準安定障害(Metastable Failure) を乗り越えた後、2026年第2四半期にわずか2人のエンジニアがCodexとGPT-5.5を活用してサービス全体をRustへ全面書き換え(CPU効率6倍・メモリ効率15倍・本番トラフィックの95%を処理) し、Valkey統合キャッシュ(CDC数秒無効化)と合わせて グローバル読み取りp50レイテンシを約120msから約10msへと12倍高速化 しています。 - 対象読者: 大規模Webサービス・AIプロダクトのバックエンド/SRE/データベースエンジニア、Azure Cosmos DBやDynamoDB等の分散NoSQLを運用するクラウドアーキテクト、PythonからRust/Goへのマイクロサービス刷新を検討している開発責任者、およびフロンティアAI企業のインフラ経済性を分析する技術経営層。
- 読み終えて持ち帰れる判断軸: 「なぜデータを保存するほどデータベースの制限値が下がって429エラーが出るのか(Weak Partitionsの物理機構)」「なぜ専用コンテナへの完全分離がローンチ当日の即死を招くのか」「なぜPython
aiohttpのデフォルトLIFO接続プールが遅いサーバーをさらに殺すのか」、そして「将来のAI進化を見越してPythonで技術的負債を引き受け、1年後に2人でRustへ書き換えたOpenAIの意思決定」を、明日からの設計・運用基準として持ち帰ることができます。
背景と全体像:3年間で「毎年10倍超」の成長を支えた500PBオンラインストレージ基盤「Habitat」
ChatGPTへのログイン、新しい会話スレッドの開始、Codexの設定参照、APIの認証チェックなど、OpenAIのすべてのプロダクトは、ミリ秒単位で確実にオンラインデータへアクセスできることを前提に動いています。1回のユーザー操作の裏側で数百回の個別データベース参照が走ることも珍しくなく、そのうちの1つでも遅れればプロダクト全体が遅く感じられ、失敗すればサービスが停止します。
この過酷な要求を一手に引き受けているのが、OpenAIが独自に構築したオンラインストレージプラットフォーム 「Habitat(ハビタット)」 です。2026年9月11日および10月23日、OpenAIの技術スタッフであるJon Lee氏、Hrachya Hakobyan氏、Chaomin Yu氏、Ben Ries氏らが、全2部作の公式技術報告書を公開しました。
- 第1部(2026年9月11日公開):10億人超のChatGPTユーザーを支えるオンラインストレージの急速な拡張(Rapidly scaling online storage to serve over 1 billion ChatGPT users - Part I)
- 第2部(2026年10月23日公開):10億人以上のChatGPTユーザーを支えるオンラインストレージの急速な拡張 第2部(Azure Cosmos DBの最適化 - Part II)
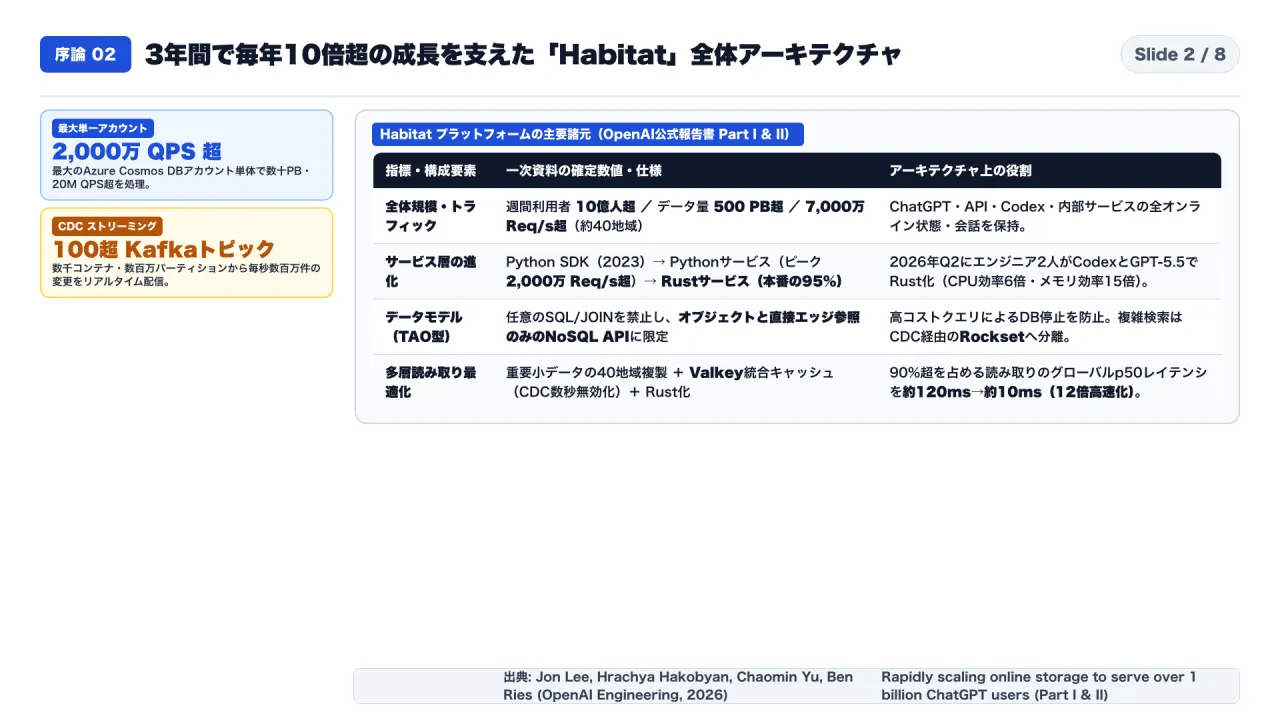
通常のシステムエンジニアは「現在の10倍の規模」を想定してシステムを設計し、数年間は持ちこたえることを期待します。しかしOpenAIは 「過去3年間、毎年10倍を超える成長(more than 10x every year for the past three years)」 を続けてきました。その結果、DevDay 2023でGPTsを支えるシンプルなPythonクライアントライブラリとして始まったHabitatは、現在以下の規模に達しています。
| 指標項目 | 一次資料で公開された確定数値 | 備考・内部構成 |
|---|---|---|
| 週間アクティブ利用者数 | 10億人超(Over 1 billion weekly users) | ChatGPT、API、Codex、内部サービスすべてを包含 |
| 総リクエスト処理数 | 毎秒 7,000万件超(Over 70 million requests/sec) | 世界約 40の地理的リージョン でミリ秒応答(90%以上が読み取り) |
| 管理データ総量 | 500 ペタバイト(PB)超 | 単一で最大のAzure Cosmos DBアカウントだけで 数十PB・2,000万 QPS(20M QPS)超 を処理 |
| サービス層の言語移行 | Pythonサービス(ピーク 2,000万 Req/s超)→ Rustサービス(本番の95%を処理) | 2026年Q2に わずか2人のエンジニア がCodexとGPT-5.5で全面書き換え(CPU効率6倍・メモリ効率15倍) |
| グローバル読み取り遅延 | p50: 約120 ms → 約10 ms(12倍高速化) | ①重要データの近隣リージョン複製、②Valkey+CDCキャッシュ、③Rust刷新の3施策合算 |
| CDC(変更データキャプチャ)規模 | 数千コンテナ・数百万パーティションから 毎秒数百万件の変更 を 100超のKafkaトピック へ配信 | Valkeyキャッシュの数秒以内の世界無効化、およびRockset等のセカンダリビュー同期を駆動 |
第1章:フェーズIからIIIへの円環 —— キー衝突・容量増加で遅くなる「弱いパーティション」・完全分離の破綻
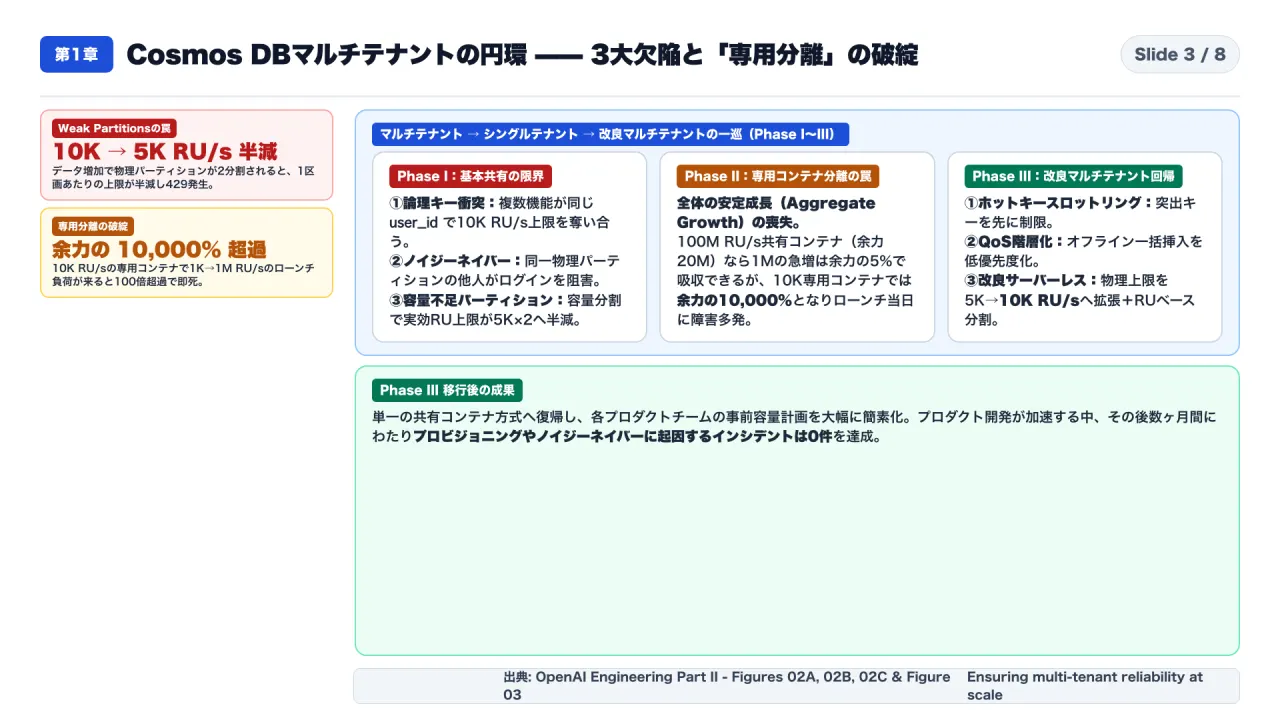
第2部の報告書で最もスリリングなのが、Azure Cosmos DBにおけるマルチテナント設計の変遷です。OpenAIは 「単一のマルチテナントコンテナ(フェーズI) → 機能別のシングルテナント専用コンテナ分離(フェーズII) → 改良版マルチテナント共有コンテナへの回帰(フェーズIII)」 という一巡の旅を経験しました。
1-1. フェーズI:基本の共有コンテナで直面した「3つの構造的欠陥」
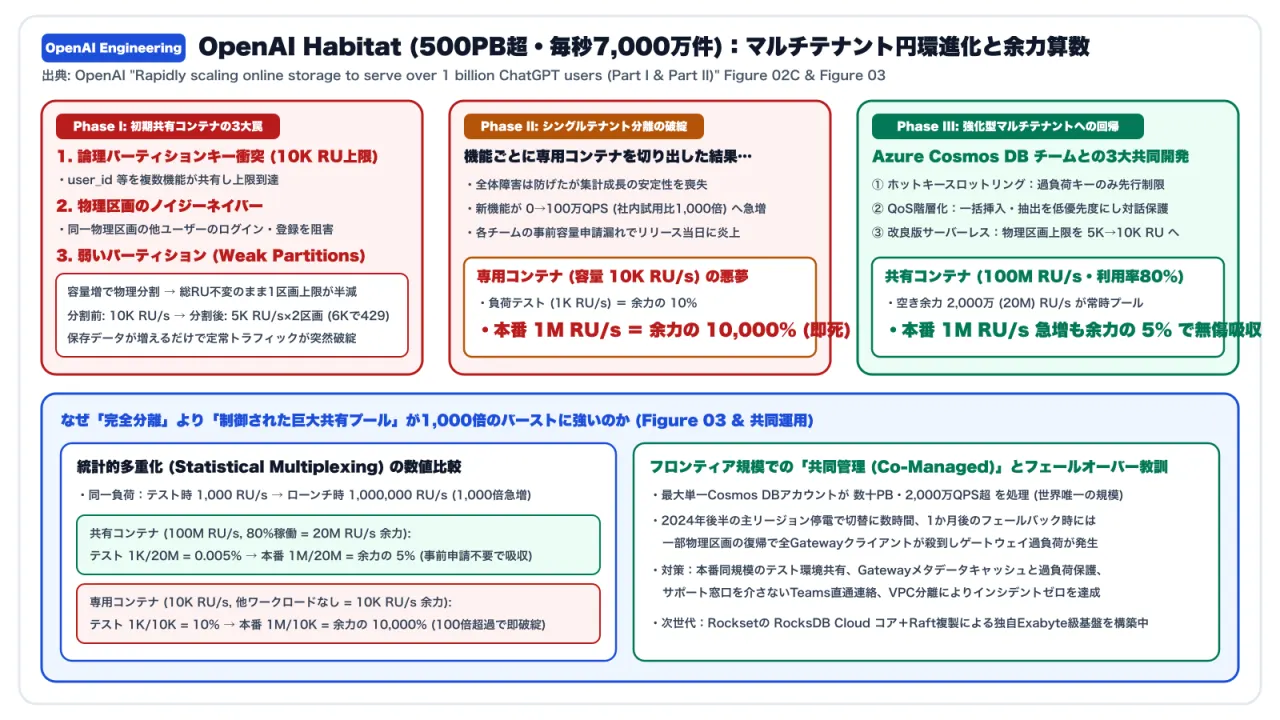
Azure Cosmos DBでは、コンテナに対して毎秒の要求ユニット数(RU/s)をプロビジョニングし、データは「論理パーティションキー(上限10,000 RU/s)」でシャーディングされますが、内部ではそれより少ない数の「物理パーティション」に複数の論理キーが同居しています。当初、各アカウントでデフォルトの共有コンテナを1つだけ使っていたOpenAIは、以下の3つの罠に直面しました(OpenAI報告書 Part II)。
- 論理パーティションキーの上限衝突(Logical Partition Key Limits - Figure 02A):
- 初期APIではクライアントが論理パーティションキーを直接選択できたため、
Conversations(会話)、Auth(認証)、Memory / dreaming(記憶)といった異なるプロダクト機能が、すべて同じuser_id(例:PK: user-id-28104)やworkspace_idをキーに選んでしまいました。 - その結果、異なるユースケースが同じ論理パーティションキーの10K RU/s上限を食い合い、1ユーザーあたりの全体スループットが頭打ちになりました。
- 初期APIではクライアントが論理パーティションキーを直接選択できたため、
- ノイジーネイバー(Noisy Neighbors - Figure 02B):
- ドキュメント上の制限(10,000 RU/s)は論理キー単位と書かれていますが、実際にハードウェア上で制限が適用されるのは「物理パーティション」単位 です。
- そのため、ある物理パーティションに同居した特定の論理キー(例:
user-id-28104の重い機能処理)が物理パーティションの容量を使い切ると、同じ物理パーティションにたまたま配置された無関係な別ユーザー(例:user-id-10384)の ログインや新規登録といった基本フローまで巻き添えで失敗する 事態が起きました。
- 容量不足のパーティション(Weak Partitions - Figure 02C)—— 保存データが増えるほど上限が半減する罠:
- さらに厄介だったのが、物理パーティションのスループット上限の配分ルールです。コンテナ全体に割り当てられた合計RU/sは、そのコンテナ内のすべての物理パーティションにほぼ均等に割り算されて配分 されます。
- すると、BLOB型の大きなデータを保存してストレージ容量がしきい値を超え、1つの物理パーティションが2つの子パーティションに分割(Split)された瞬間、コンテナ全体の合計RU/sは変わらないため、各物理パーティションが使える実効上限が「分割前の10K RU/s」から「分割後の5K RU/s × 2」へと半分に減ってしまう のです。
- つまり、アクセス頻度(6K RU/sの需要)が全く増えていなくても、過去の保存データ量が増えただけで、ある日突然実効上限(5K RU/s)が需要を下回り、HTTP 429(Too Many Requests)エラーを出して本番サービスが落ちる という恐ろしい現象が発生しました。
1-2. フェーズII:シングルテナント(専用コンテナ分離)への逃避と「10,000%超過」の破綻
これらの問題を避けるため、OpenAIはフェーズIIとして「新規サービスや重要なプロダクト機能ごとに、別々の専用Azure Cosmos DBコンテナを切り出す」というシングルテナント分離戦略へ移行しました。物理パーティション数に合わせて合計RUを自動調整するスクリプトも組み合わせたことで、サイト全体の連鎖障害は防げるようになりました。
しかし、コンテナを分けたことで、マルチテナントが持っていた最大の武器である 「全体の安定した増加傾向(Stable Aggregate Growth - Figure 03)」 を失ってしまったのです。
| 比較項目 | 共有コンテナ(Shared Container) | 新規の専用コンテナ(New Dedicated Container) |
|---|---|---|
| コンテナ全体の容量と稼働率 | 合計 100M RU/s(80%使用中 → 余力[Headroom]は 20M RU/s) | 合計 10K RU/s(他のワークロードなし → 余力は 10K RU/s) |
| 社内負荷テスト時(1K RU/s) | 余力20Mのうち 1K / 20M = わずか 0.005% を消費 |
余力10Kのうち 1K / 10K = 10% を消費 |
| 本番ローンチ時(1M RU/sへ1,000倍急増) | 余力20Mのうち 1M / 20M = 余力のわずか 5% で余裕で吸収 |
余力10Kに対して 1M / 10K = 余力の 10,000%(100倍超過)で即座に破綻 |
専用コンテナ方式では、すべてのプロダクトチームが「リリース当日に何RU/s跳ね上がるか」を正確に予測して事前プロビジョニングしなければなりません。しかし実際には、プロダクトチームが事前スケーリングを忘れたまま新機能をリリースし、リリース当日に重大インシデント対応の場で緊急スケールアップに追われる事故 が多発しました。
1-3. フェーズIII:Azureチームとの共同開発による「改良版マルチテナント」への回帰
組織が拡大するにつれ、全プロダクトチームに容量計画を強いる運用は限界を迎えました。そこでOpenAIはAzure Cosmos DB開発チームと直接タッグを組み、フェーズIの3大欠陥を根治する以下の 3つの新機能 を共同開発して、再び 「単一の共有マルチテナントコンテナ」 へと戻りました。
- ホットキーのスロットリング(Hot Key Throttling): 物理パーティション全体が飽和する前に、最もアクセスが集中している特定のホットキーだけを優先的にスロットリングし、同居する他テナントへの波及を遮断。
- サービス品質(QoS:Quality of Service): バッチ一括挿入やデータ抽出などのオフラインワークロードに「低優先度」を割り当て、輻輳時にはオフライン処理を先にスロットリングすることで、エンドユーザーの対話的リクエストを保護。
- 改良版サーバーレスモード(Improved Serverless Mode): 従来のCosmos DBサーバーレスモードは「ストレージ容量のみで分割され、物理パーティションあたり5K RU/s上限」という制限があり高負荷用途に使えませんでした。AzureチームがOpenAI向けに開発した改良版では、物理パーティション上限を最大10K RU/sへ引き上げ、ストレージ量だけでなく「RU使用量に基づく自動分割」を導入 しました。
このフェーズIIIへの移行により、事前の容量計画なしに単一共有コンテナでワークロードを混在させられるようになり、その後数ヶ月間、プロビジョニングやノイジーネイバーに起因するインシデントはゼロ になりました。
第2章:Pythonの限界(Statsig毎分フリーズ・LIFO準安定障害)から、2人でのRust全面刷新と読み取り12倍高速化へ
2-1. なぜクライアントライブラリから独立サービスへ切り出し、あえてPythonを使い続けたのか?
第1部の報告書(OpenAI報告書 Part I)では、アプリケーション層の苦闘が詳述されています。2025年半ば、クライアント側Pythonライブラリとして配布されていたHabitatは限界に達しました。単一リージョン障害の影響を抑えるために重要データセットを複数Cosmos DBアカウントへ分割しようとした際、数十のサービスへ機能フラグ付き更新を配るのに数日、シャドーイングに数日、バグ修正にさらに数日かかり、最後に あるチームが無関係な理由で古いバグ入りクライアントへロールバックしたことで、防ごうとしていた障害そのものが引き起こされた のです。
これを機にHabitatは独立した中央サービス(habitat-service)として切り出されました。このとき、PythonのCPU・メモリ効率の悪さは百も承知の上で、「今はコスト最適化よりも開発者の障壁除去とプラットフォーム安定化を最優先する。100倍にスケールして本当にPythonから移行する必要が生じる頃には、自社のCodexとGPTが進歩して書き換えを簡単にしてくれるはずだ」 と計算し、戦略的な技術的負債としてPythonを選択しました。
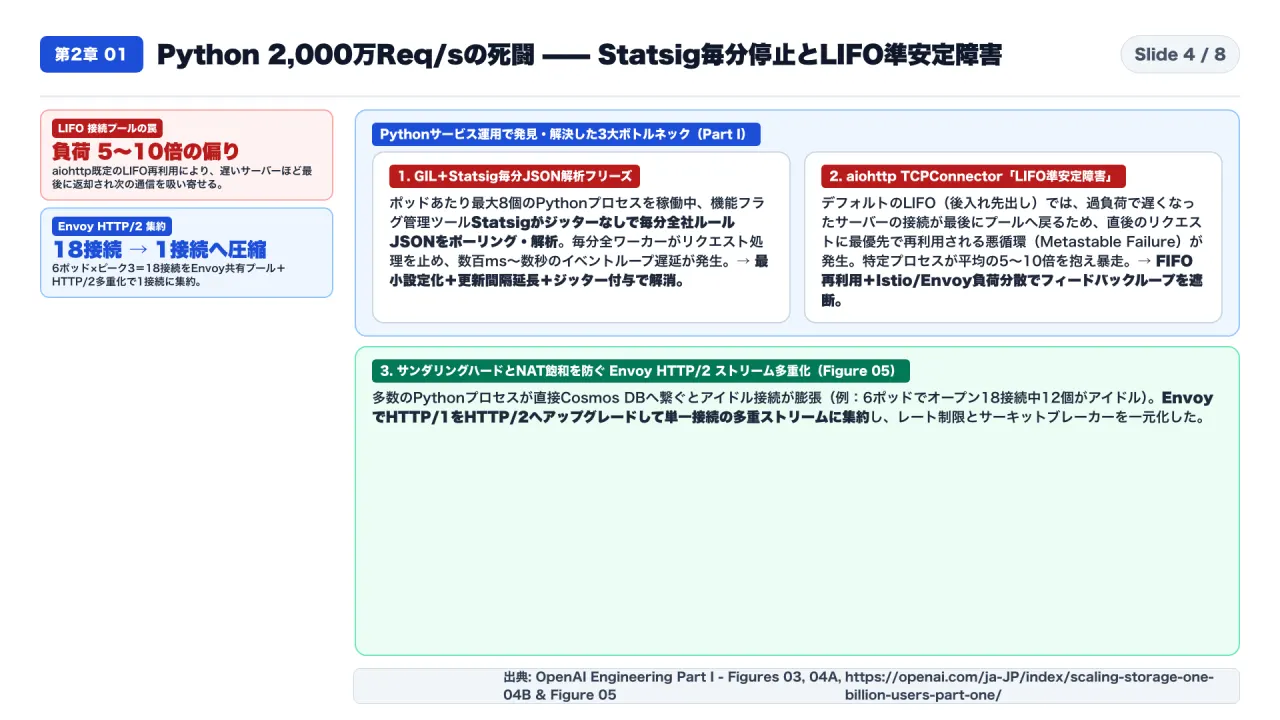
2-2. Pythonで毎秒2,000万リクエストを捌く中で起きた「3つの死闘」
Pythonサービスをピーク毎秒2,000万リクエスト超までスケールさせる過程では、以下の3つの象徴的なトラブルと解決策がありました。
- asyncioのスケジューリング遅延と「Statsig毎分JSON解析フリーズ」:
- Pythonの
asyncioはGIL(グローバルインタプリタロック)のため1プロセスで1つのCPUスレッドしか使えません。p99以上のテールレイテンシを追跡すると、Cosmos DBからは即座に応答が返っているのに、レスポンスを解析するコルーチンが再スケジュールされるまで数百ミリ秒〜数秒も待たされていました。 - 稼働中のサービスをCPUプロファイリングすると、驚くべき犯人が見つかりました。機能フラグ管理ツール StatsigのSDKが、デフォルトでジッター(揺らぎ)なしで毎分、全サービスの本番ルールを含む巨大な設定JSONをポーリングして解析していた のです。1ポッドあたり最大8個のPythonワーカープロセスを動かしていたため、毎分どこかのタイミングでポッド内の全ワーカーが一斉にリクエスト処理を止め、巨大JSONのパースにCPUを奪われていました。設定の最小化・更新間隔の延長・ジッター追加によってこのスパイクは解消しました。
- Pythonの
- aiohttp接続プールの「LIFO再利用」が引き起こした準安定障害(Metastable Failure - Figure 04A/04B):
- あるとき、トラフィック急増が収まった後も特定のサーバープロセスだけ性能劣化が暴走し、再起動するまで他のプロセスの 5〜10倍の同時リクエスト を吸い寄せ続ける「準安定障害(Metastable Failure)」が発生しました。
- 原因は、Python
aiohttpのTCPConnectorが デフォルトで「LIFO(後入れ先出し:最も直近にプールへ返却された接続を次のリクエストに割り当てる)」方式 を採っていたことでした。 - バースト発生時、過負荷で遅くなったサーバープロセスCへのリクエストは、正常なサーバーA・Bよりも遅れて最後に完了し、一番最後に接続プールへ返却されます。するとLIFO方式では、直後に来た新しいリクエストが「たった今最後に返却されたばかりの、過負荷サーバーCへの接続」を最優先で掴んでしまう のです。この悪循環を断ち切るため、接続再利用を FIFO(先入れ先出し)方式 へ修正し、さらにIstioとEnvoyによる負荷考慮型ルーティングへ移行しました。
- EnvoyによるHTTP/1→HTTP/2多重化(18接続を1接続へ集約 - Figure 05):
- イベントループ遅延を抑えるためPythonワーカープロセス数を1桁増やすと、毎日のデプロイ時の接続入れ替わり(サンダリングハード)で下流が圧倒され、接続リークでNATゲートウェイが飽和してネットワーク全体が止まるリスクが生じました。
- 仮に6個のPythonポッドがそれぞれピーク3接続を張ると合計18接続が開きっぱなしになり、定常時6リクエストしか走っていなくても12接続がアイドル状態で残ります。OpenAIはローカルの EnvoyプロキシでPythonからのHTTP/1接続を受け、下流のCosmos DBへ向けてHTTP/2へアップグレードして単一接続(1接続・6多重ストリーム)へ集約 することで、接続数爆発を完全に抑え込みました。
2-3. わずか2人のエンジニアによるRust全面刷新と、グローバル読み取り12倍高速化
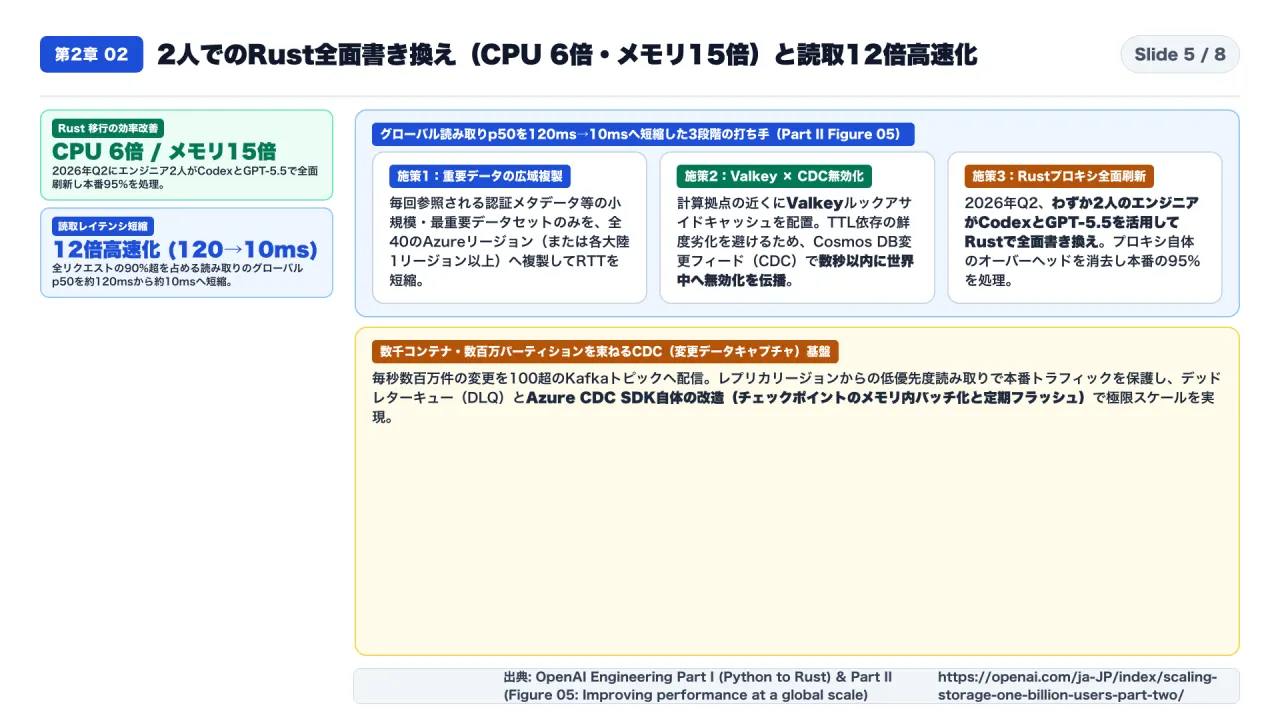
そして2026年第2四半期、HabitatがOpenAI社内でCPUコア数第2位(Envoy規模で第4位)の巨大サービスとなった段階で、「1年前の賭け」が回収されました。
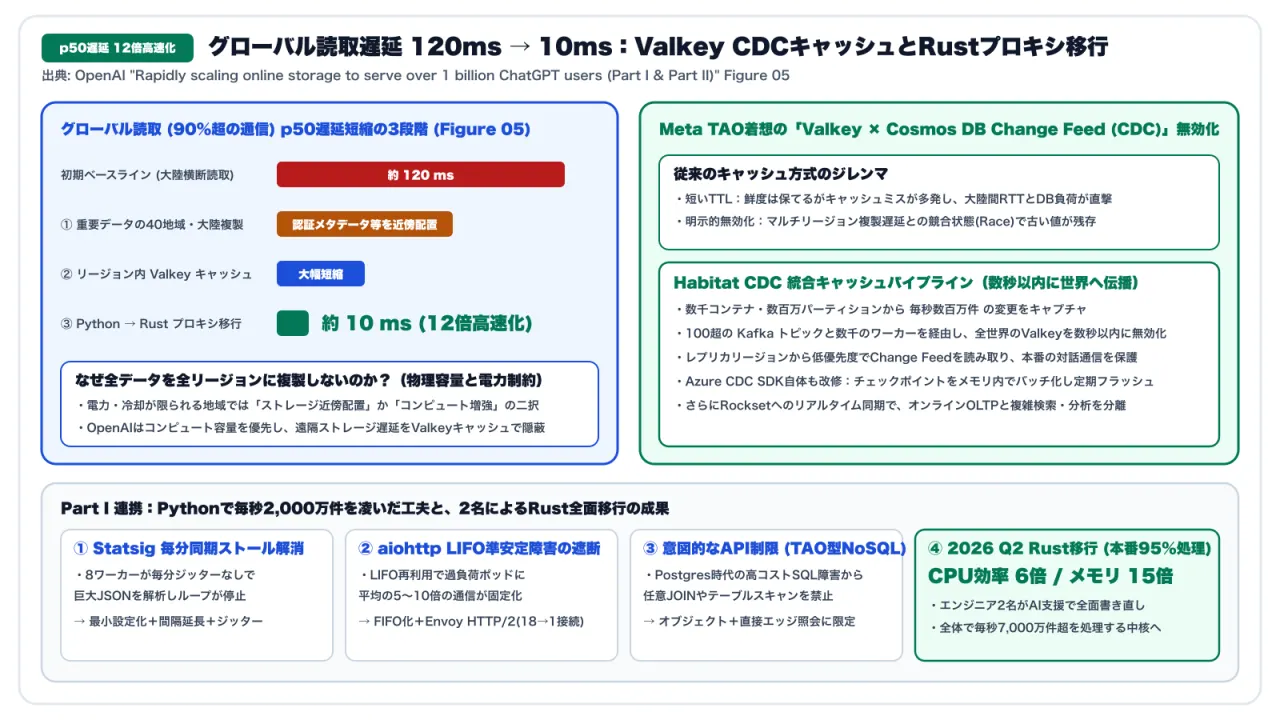
- 2人でのRust全面書き換え: わずか2人のエンジニアが、CodexとGPT-5.5を活用してHabitatサービス全体をRustで書き直しました(OpenAI報告書 Part I)。現在、本番リクエストの 95% をこの新しいRustサービスが処理しており、Python版と比較して CPU効率が6倍、メモリ効率が15倍 に向上しました。
- グローバル読み取りp50レイテンシの12倍高速化(約120ms → 約10ms、Part II Figure 05):
- 最重要小規模データの近隣リージョン複製: 認証メタデータ等のクリティカルな小データのみを全40リージョン(または大陸別リージョン)へ複製。
- Valkey統合ルックアサイドキャッシュ + CDCによる数秒以内の世界無効化: 計算ノードの近くにValkeyキャッシュを配置。TTLだけに頼ると鮮度劣化かヒット率低下の二択になるため、MetaのTAOにならい、Cosmos DBの変更フィード(CDC)を読み取って 元データの更新から数秒以内に世界中のローカルValkeyキャッシュを無効化(Invalidate)する仕組み を構築。
- Rustプロキシ刷新: サービス自体のオーバーヘッドを解消し、3施策の合算でグローバル読み取りp50レイテンシを 約120msから約10msへと12倍高速化 しました。
第3章:対立する視点と死角 —— 自由なSQL vs 制限されたNoSQL API、そして「マネージドサービスが機能しなくなる境界」
3-1. 対立軸:「開発者に自由なSQLを許すべきか、API機能を厳しく制限すべきか」
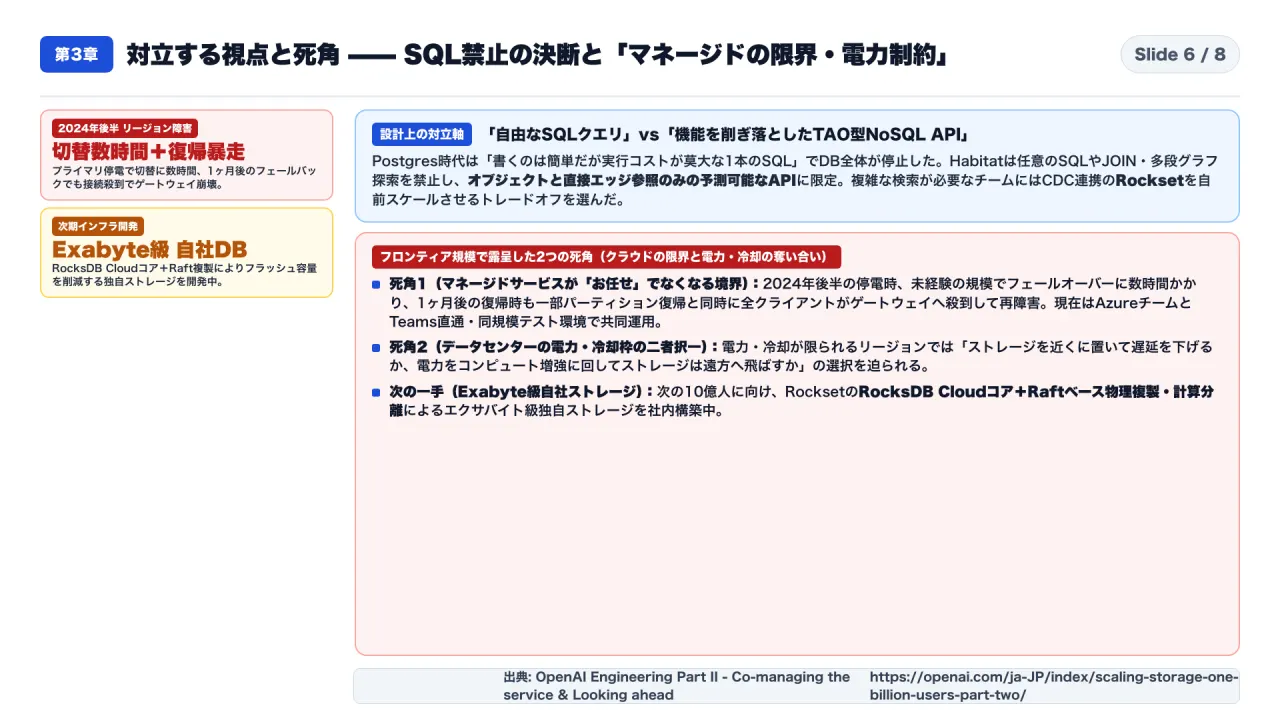
Habitatの設計において最も強い意志が貫かれているのが、「強力なクエリAPIをあえて提供しない」 という決断です。
Postgresを使っていた初期のOpenAIでは、「コードとして書くのは1行で簡単だが、実行すると巨大テーブルスキャンや多段JOINを引き起こすSQLクエリ」が高頻度の実行パスに紛れ込み、データベース全体を停止させる障害が頻発していました。そこでHabitatは、MetaのTAOに着想を得た 「オブジェクト(Object)と直接エッジ(Direct Edge)の参照しか許さないシンプルなNoSQL API」 に機能を絞り込みました。
もしプロダクトチームが複雑な検索や集計クエリを実行したい場合は、HabitatのCDCパイプライン(数千コンテナ・数百万パーティションから100超のKafkaトピックへ毎秒数百万件を配信)を通じてほぼリアルタイムに同期される 分離されたRocksetインスタンス を使わせ、そのスケーリング責任も各プロダクトチーム自身に持たせることで、オンラインOLTP基盤の予測可能性を死守しています。
3-2. フロンティア規模で露呈した2つの死角:マネージドの限界とデータセンター電力の奪い合い
さらに第2部の報告書は、クラウドのマネージドサービスを極限まで使い倒した先に現れる 2つの構造的死角 を赤裸々に明かしています。
- 死角1:2,000万QPS規模では、マネージドサービスはもはや「お任せ」にできない(2024年後半の2大リージョン障害):
- プライマリ停電時の数時間フェールオーバー: 2024年後半、最大級のCosmos DBアカウントの1つでプライマリAzureリージョンに停電が発生しました。セカンダリリージョンへのフェールオーバーを実行したところ、OpenAIもAzureチームもこの規模(数十PB・20M QPS超)での切り替えをテストしたことがなく、完了までに数時間 かかりました。
- 1ヶ月後のフェールバック(切り戻し)でのゲートウェイ崩壊: さらに約1ヶ月後、元のリージョンへアカウントを切り戻そうとした際、再び大障害が発生しました。ゲートウェイモードのCosmos DBクライアントの仕様上、元のリージョンに物理パーティションの「ごく一部」が戻った瞬間に、すべてのクライアントが一斉に元のリージョンへ接続を確立してリクエストを殺到させ、Cosmos DBゲートウェイがパンクした のです。
- これ以降、OpenAIとAzureはサポート窓口を介さずTeamsでエンジニア同士が直接連絡・直接ページングできる体制を敷き、本番と同規模の非本番Cosmos DBアカウントでの共同テスト、ゲートウェイへのメタデータキャッシュと過負荷保護の追加を共同で進めています。
- 死角2:データセンターの電力・冷却制約と、次世代「エクサバイト級自社ストレージ」の構築:
- ユーザー体験を高めるには計算ノードと同じリージョンにストレージを置きたいところですが、電力と冷却能力が限られるデータセンターでは 「貴重な電力枠をストレージ配置に使ってHabitatの遅延を下げるか、それとも電力を推論・計算用のコンピュート増強に回してストレージは遠方リージョンへ飛ばすか」 というトレードオフを迫られています。
- 次の10億人のユーザーに向けてこのフラッシュ容量と電力の壁を突破するため、OpenAIは現在、買収したRocksetの RocksDB CloudコアとRaftベースの物理複製を組み合わせ、コンピュートとストレージを分離して必要フラッシュ容量を削減する「エクサバイト(Exabyte)規模の独自オンラインストレージシステム」 を社内で開発していると明かしています。
第4章:【私なりの解釈】「技術的負債の先送り+AIによる2人Rust書き換え」がソフトウェア工学の歴史を変えた
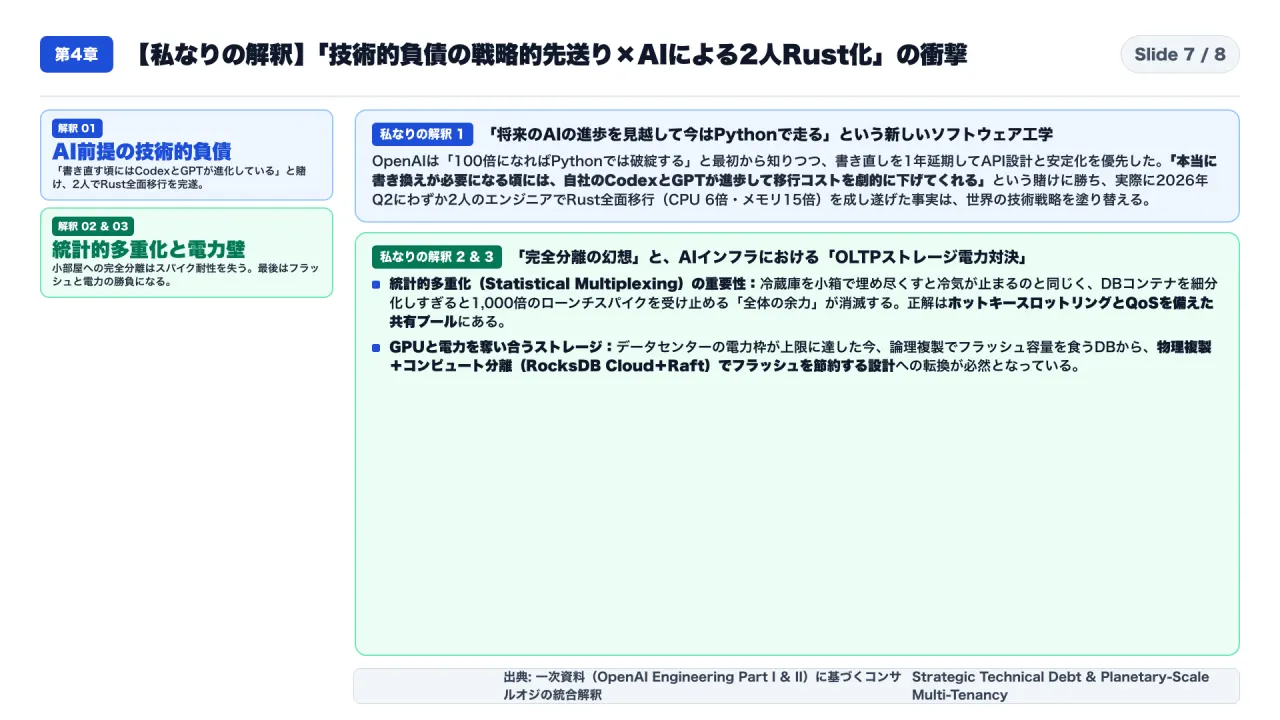
ここまでの一次情報を突き合わせると、現代のソフトウェア工学とクラウド設計における 3つの本質的な洞察(私なりの解釈) が導き出せます。
4-1. 解釈1:「AIの進化を織り込んで技術的負債を借り、1年後に2人で返済する」という前例のない開発戦略
従来のソフトウェア工学では、「将来100倍にスケールすることが分かっている基幹サービスをPythonで書くのは愚策であり、最初からRustやGo、C++で書くべきだ」と教えられてきました。しかしOpenAIは、「今はPythonで素早くAPIを固め、1年後に本当にPythonが限界を迎えたときには、自分たちが作っているCodexとGPTが進歩して書き換えコストを激減させてくれるはずだ」という AIの指数関数的進化を前提にした技術的負債の借り入れ を行いました。そして実際に2026年第2四半期、わずか2人のエンジニアがCodexとGPT-5.5を使って毎秒数千万リクエストの基盤をRustへ書き換え、CPU効率6倍・メモリ効率15倍を実現した事実は、今後のすべてのソフトウェア企業の言語選定と負債管理のセオリーを根底から変える歴史的転換点です。
4-2. 解釈2:マルチテナント vs シングルテナントの最終解は「物理分割」ではなく「QoSとホットキー制御を備えた巨大な共有プール」である
障害が起きたときにコンテナやDBインスタンスを機能ごとに細かく分離(シングルテナント化)するのは、一見すると安全に見えます。しかしそれは 「統計的多重化(Statistical Multiplexing:巨大な共有プールの余力で局所的な1,000倍スパイクを吸収する力)」 を自ら捨てる行為です。OpenAIがフェーズIIの失敗を経てフェーズIIIで証明した通り、真の正解は箱を分けることではなく、単一の巨大な共有プールを維持したまま、入り口でホットキーのスロットリングとQoSの優先度制御(対話優先・バッチ劣後)をかけること にあります。
4-3. 解釈3:AIデータセンターのボトルネックは「GPU」から「会話と状態を保持するフラッシュと電力」へ拡大した
Appleが端末のDRAM不足をNANDフラッシュ推論で突破し、DeepSeekがHBM不足を100 PiBのSSDクラスタで突破したのに続き、OpenAIは500 PBの会話・状態ストレージがデータセンターの電力枠をコンピュートと奪い合う段階に到達しました。論理複製でフラッシュ容量を消費する既存のクラウドDBから、物理複製+ストレージ分離(RocksDB Cloud + Raft)でフラッシュ面積と電力を削るエクサバイト級自社DB への移行は、巨大AIプラットフォーマーの必然の帰結と言えます。
結論:明日からバックエンド・データ基盤チームが取るべき3つの実務アクション
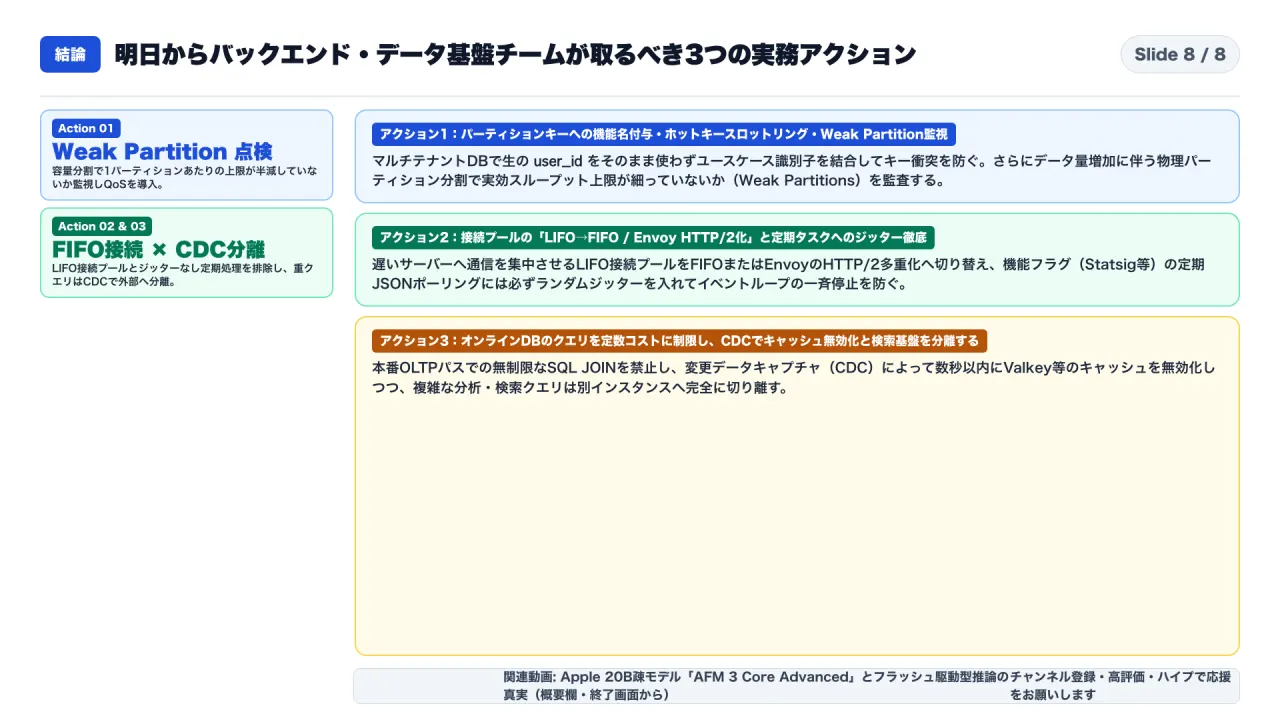
最後に、私たちが明日からのシステム設計・運用現場で直ちに実践すべき 3つの具体的アクション をまとめます。
- アクション1:マルチテナントDBのパーティションキーに「機能名プレフィックス」を強制し、「Weak Partitions(容量分割による実効上限低下)」を監視する:
- 複数のマイクロサービスが同じ
user_idやtenant_idをそのままパーティションキーに使う設計を禁止し、機能ごとの名前空間を付与してください。同時に、Cosmos DB等の分散DBでデータ増加に伴う物理パーティション分割が起きた際、1パーティションあたりの実効RU上限が割り算で低下していないかを監視し、ホットキースロットリングとQoS優先度分離を導入してください。
- 複数のマイクロサービスが同じ
- アクション2:非同期Webサーバーの接続プールを「LIFOからFIFO / Envoy HTTP/2多重化」へ変更し、定期設定ポーリングに必ずジッターを入れる:
- Pythonの
aiohttp等でデフォルトのLIFO接続再利用を使っていると、バースト時に遅くなったサーバーへ後続リクエストが吸い寄せられる準安定障害(Metastable Failure)が起きます。直ちにFIFO再利用またはEnvoy経由のHTTP/2接続集約へ切り替え、機能フラグ(Statsig等)の定期JSON更新にはランダムジッターを設定してイベントループの同時フリーズを排除してください。
- Pythonの
- アクション3:オンラインOLTP経路から自由なSQL JOINを排除し、「CDCによる数秒以内のキャッシュ無効化+検索用セカンダリDB分離」を実装する:
- ミッションクリティカルなオンラインAPIはコストが予測可能な単一キー/直接エッジ参照に限定し、変更データキャプチャ(CDC)を用いてローカルキャッシュ(Valkey等)をリアルタイム無効化することで、高いキャッシュヒット率とデータ鮮度、そして10ミリ秒台の応答速度を両立させてください。
よくある疑問と実務Q&A(FAQ)
Q1. なぜAzure Cosmos DBでは「アクセス数がまったく増えていないのに、保存データ量が増えただけでHTTP 429エラーが出る(Weak Partitions)」のですか?
- A. コンテナ全体のプロビジョニング済みスループット(RU/s)が、物理パーティションの数で割り算(均等配分)される仕組みだからです。 たとえば、ある物理パーティションが分割前に 10,000 RU/s(10K RU/s) の容量を持っており、その上で稼働するワークロードが定常的に 6,000 RU/s(6K RU/s) を消費していたとします。この時点では余裕で処理できています(HTTP 200)。ところが、BLOB型のデータなどが蓄積してストレージ容量の上限に達すると、Cosmos DBは自動的にその物理パーティションを 2つの子パーティションへ分割(Split) します。このとき、コンテナ全体の合計RU/sを増やさなければ、2つの子パーティションにはそれぞれ半分の 5,000 RU/s(5K RU/s)ずつ しか配分されません。すると、昨日までと同じ6K RU/sのリクエストが来ただけで上限(5K RU/s)を突破し、突然HTTP 429エラーで落ちるのです。
Q2. なぜ機能ごとに専用コンテナへ分ける「シングルテナント分離(フェーズII)」で、かえって本番リリース当日の障害が増えたのですか?
- A. マルチテナント共有プールが持っていた「巨大な余力(Headroom)によるスパイク吸収効果」が失われたからです。
OpenAIの具体例(Figure 03)で見ると、合計 100M RU/s の容量を持ち80%使用中の共有コンテナには、常に 20M RU/s(2,000万RU/s)もの空き余力 があります。ここで新機能が社内負荷テスト時の 1K RU/s から本番公開時に 1M RU/s(100万RU/s) へと1,000倍に跳ね上がっても、共有コンテナなら空き余力のわずか 5%(
1M / 20M)を使うだけで何事もなく吸収できます。一方、新機能のために 10K RU/s の専用コンテナを切り出してしまうと、負荷テスト時(1K RU/s=10%)は問題なくても、本番公開で1M RU/sが来た瞬間に 余力の10,000%(100倍超過) となって即死します。開発チームがリリース前の手動スケールアップを1回でも忘れると即座に重大インシデントになるため、組織拡大とともに破綻しました。
Q3. Pythonの aiohttp で起きた「LIFO接続プールによる準安定障害(Metastable Failure)」は、他の言語やHTTPクライアントでも起きますか?
- A. はい、「直近に返却された接続を優先再利用する(LIFO:後入れ先出し)」設定のコネクションプールであれば、言語を問わず同じ現象が発生します。 通常、LIFO方式には「使われなくなった余分な接続を早くアイドルタイムアウトさせて閉じられる」というメリットがあるため、多くのHTTPクライアントでデフォルト採用されています。しかしバースト負荷が発生した際、過負荷になって応答が遅れたサーバーへの接続ほど、一番最後にプールへ返却されます。するとLIFO方式では、直後にやってきた新しいリクエストがその「たった今最後に返ってきた遅いサーバーの接続」を最優先で引き当ててしまい、すでに苦しんでいるサーバーへ通常の 5〜10倍もの同時リクエスト を送り続けるフィードバックループ(準安定障害)に陥ります。これを防ぐには、接続再利用を FIFO(先入れ先出し) に変更するか、Envoy等のプロキシでHTTP/2多重化と負荷考慮型ルーティングを行う必要があります。
Q4. CDC(変更データキャプチャ)でキャッシュを無効化する方式は、通常のTTL(有効期限)方式と何が違うのですか?
- A. 「高いキャッシュヒット率」と「数秒以内のデータ鮮度」を同時に達成できる点が決定的に異なります。 TTL方式では、TTLを短くすればキャッシュミスが増えてリージョン間通信の遅延(120ms)が露出し、TTLを長くすれば古いデータが残り続けてプロダクトの挙動が壊れるという二律背反から逃れられません。またアプリ側で書き込み時に明示的パージを行う方式も、マルチリージョン環境ではレプリケーションとの競合状態(Race Condition)で古いキャッシュが残りやすい欠点があります。Habitatが採用した 「ストレージ層(Cosmos DB)の変更フィード(CDC)を監視し、数秒以内に世界中のValkeyキャッシュへ無効化イベントを配信する方式」 ならば、変更がない限りキャッシュを長く保持しつつ、変更時には数秒で確実に最新値へ切り替えられます。
明日から現場で使える「大規模OLTP・非同期サービス」点検チェックリスト
| 点検領域 | 具体的な確認項目 | 合格基準(アクション指標) |
|---|---|---|
| 1. パーティションキー設計 | 複数の機能・テーブルが素の user_id や workspace_id を共有してキー上限を食い合っていないか? |
<service_prefix>:<entity_id> のようにユースケース別の名前空間を付与し、ホットキースロットリングとQoSを有効化する。 |
| 2. Weak Partition 監査 | データ量の増加に伴う物理パーティション分割で、1区画あたりの実効スループット上限が低下していないか? | 物理パーティション数と1区画あたり上限(RU/s)を監視し、RUベース分割対応モードまたは自動スケールを設定する。 |
| 3. イベントループ遅延監視 | Python(asyncio)やNode.js等で、定期バッチや設定JSON解析がメインスレッドを止めていないか? |
予定実行時刻と実実行時刻の差分(Loop Lag)を常時計測し、Statsig等の設定ポーリングには必ずランダムジッターを入れる。 |
| 4. 接続プールとHTTP/2集約 | HTTPクライアントの接続プールがLIFO方式になっており、遅いポッドへ負荷が偏っていないか? | 接続再利用をFIFOへ変更し、Envoy等でHTTP/1をHTTP/2多重化(例:18接続→1接続)してNAT飽和とサンダリングハードを防ぐ。 |
| 5. OLTPと検索・分析の分離 | オンラインの基幹DBに対して、開発者が任意のSQL JOINやフルスキャンを投げられる状態になっていないか? | オンラインAPIは定数コストのオブジェクト・直接エッジ参照に限定し、複雑クエリはCDC連携の別検索基盤(Rockset等)へ分離する。 |
あわせて読みたい関連記事とチャンネル案内
- 関連深掘り記事(エッジ側のメモリ限界突破): なぜ200億パラメータのAIがわずか2GBのメモリで動くのか?──Apple「AFM 3 Core Advanced」のフラッシュ駆動型スパース推論(IFP)とLLM in a Flashの真実
- 関連深掘り記事(推論KVキャッシュのSSD化と境界防御): なぜDeepSeekはKVキャッシュをSSDに保存して26倍速くし、Cloudflareで他顧客データ155件が漏洩したのか?──1日155兆トークンを捌く「DeepInfer」と100PiB「3FS」の真実
- 固定自己紹介・番組ガイド: コンサルオジのプロフィールと「海外一次資料×1テーマ徹底深掘り」の制作方針
参考・一次資料リンク一覧(Primary Sources)
- OpenAI Engineering (Part II, 2026-10-23): 10億人以上のChatGPTユーザーを支えるオンラインストレージの急速な拡張(第2部:Azure Cosmos DB最適化 — Jon Lee, Hrachya Hakobyan, Chaomin Yu) / English Original
- OpenAI Engineering (Part I, 2026-09-11): 10億人超のChatGPTユーザーを支えるオンラインストレージの急速な拡張(第1部:PythonからRustへの移行 — Jon Lee, Chaomin Yu, Ben Ries) / English Original