Mistral Large 4の「オープン」は、どこまで自由なのか? ── ライセンス本文とモデルカードで確かめる
結論:重みは公開されましたが、ライセンスはMITの改変版で、他社へ提供する事業だけが別契約になります
結論から書きます。Mistral Large 4の重みは、2026年10月29日に公開されました。ライセンスは、MITライセンスの改変版です。モデルを他社に提供する事業をする会社は、商用で使う前に、Mistralと別の商用契約を結ぶ必要があります。一方で、第三者に提供しない社内利用は、この条件の対象外と、条文に書かれています。
もう一つの結論は、公開された成績の数字は、持ち主と測り方を確かめてから読む、ということです。同じ日に出た二つの記事で、同じ指標の数字が違っていました。
この記事の対象読者は、自社でオープンウェイトのモデルを動かすかどうかを検討している、情報システム部門・事業企画・法務の担当者と、その判断を説明する立場の管理職です。ライセンスの英文を最後まで読む時間がない方を想定しています。
読み終えると、次の三つができるようになります。一つ目は、ライセンスの第2条と第3条を読んで、自社が別契約の対象になりうるかを、法務へ具体的に相談すること。二つ目は、モデルカードと技術報告書から、確認できる規模と、確認できない規模を区別すること。三つ目は、公開された成績の数字を、持ち主・測った課題・測った時点に分けて読むことです。
なお、この記事は法律の助言ではありません。条文の読み方は、筆者の解釈です。使う資料は、Mistralの発表記事、ライセンス本文、モデルカード、技術報告書、Artificial Analysisの方法論、Hugging Faceのブログ記事、GitHubの公開情報です。
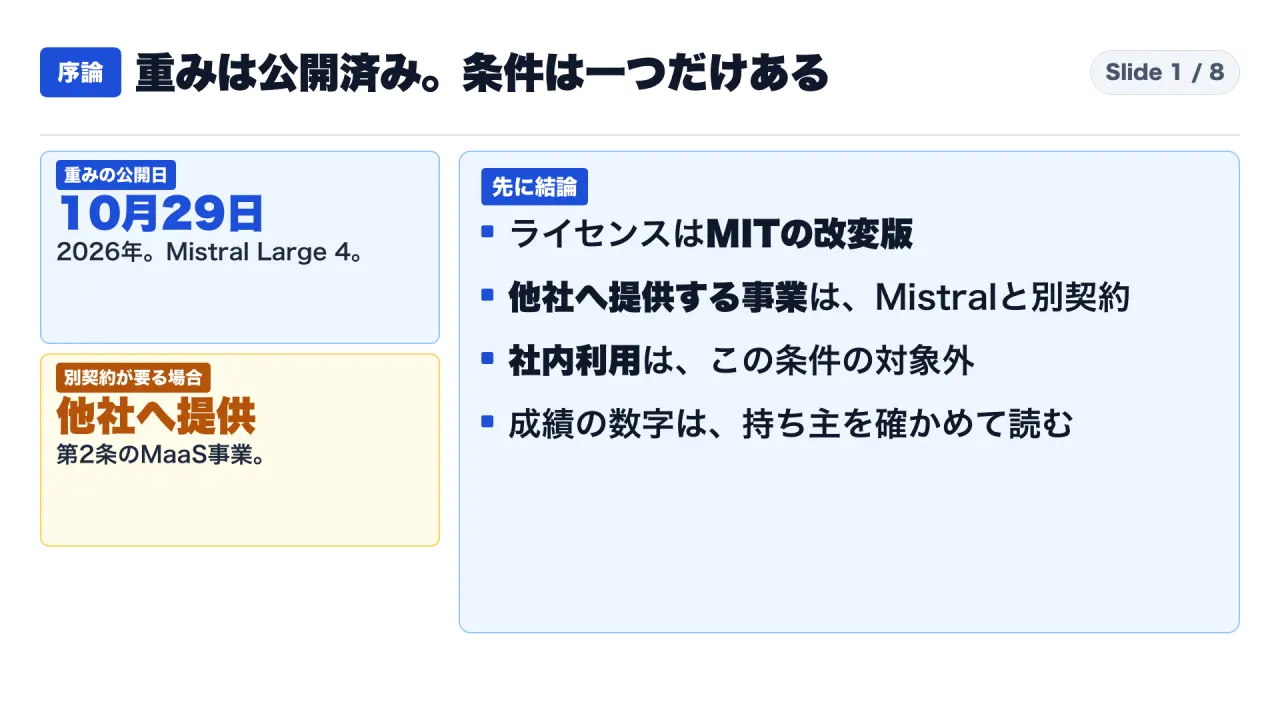
図1は、この記事全体の答えを一枚で示したものです。公開日、別契約が要る場合、社内利用の扱いを、順に確かめます。
読み方:本文では「事実」「会社の説明」「自前計算」「筆者の解釈」を分けて書きます
本文の各段落には、必要に応じて四つの札を付けます。
【事実】は、ライセンス本文、モデルカード、方法論のページ、GitHubの公開情報に書かれている文章と数字です。【会社の説明】は、Mistralが自社のモデルについて述べている内容で、第三者が確かめたものではありません。【自前計算】は、公表された日付などから筆者が計算した値で、公表値ではありません。算式は本文に書きます。【解釈】は、筆者が資料を読んで考えたことで、資料に書かれているわけではありません。
資料の取得についても、制約があります。Cognitionという会社の評価ページと、Terminal-Benchのリーダーボードの個別の行は、今回確認できていません。これらに由来する内容は、使っていません。一方、Mistralの技術報告書は、公開前の再確認で、発表記事とモデルカードに追加されているのを見つけました。PDFの全文を読み、表の数字と本文を、この記事に反映しています。ただし、報告書の測定の設定の詳細は、本文から確認できない部分があります。
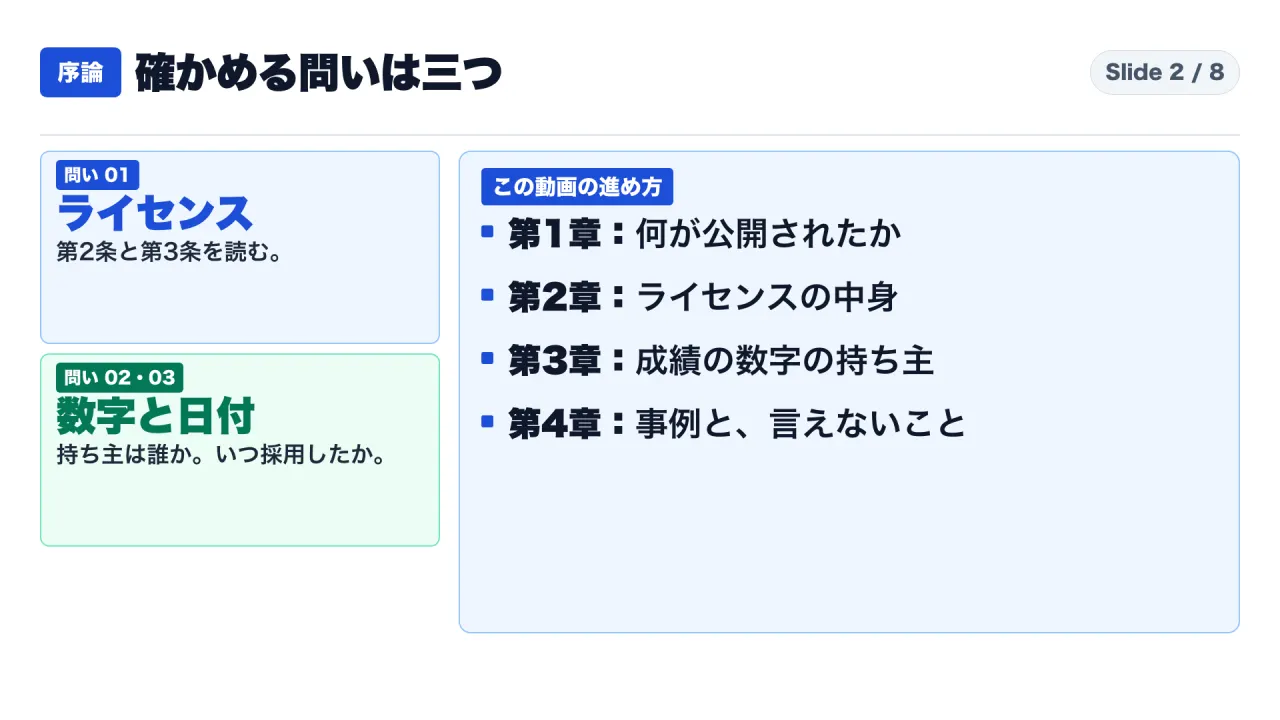
図2のとおり、確かめる問いは三つです。ライセンスの条文、数字の持ち主、そして事例の日付です。
背景:この記事で使う言葉を先にそろえます
- オープンウェイト:学習済みのモデルの重み、つまり中身の数値を、ダウンロードできる形で公開することです。学習に使ったデータや、学習の全工程まで公開することを、意味するとは限りません。
- パラメータ:モデルの中にある数値の数です。大きいほど、置いておく場所が多く必要になります。
- トークン:モデルが文章を処理するときの、文字の小さな区切りです。料金や文脈の長さは、トークンの数で示されます。
- 専門家混合(Mixture of Experts):モデルの中を、専門家と呼ぶ部分に分け、1トークンごとに一部だけを使う構造です。
- 量子化:数値の精度を下げて、必要なメモリを減らす方法です。
- 推論:学習済みのモデルに質問を与えて、答えを出させることです。
- 追加学習:学習済みのモデルに、自社のデータなどで、さらに学習を加えることです。
- API:他のシステムから、インターネット経由でモデルを呼び出す窓口です。
- ベンチマーク:モデルの性能を比べるための、決まった課題と採点方法です。持ち主と測り方によって、数字の意味が変わります。
「重みを持っている」ことと、「自由に事業へ使える」ことは別です。その間を決めているのが、ライセンスの条文です。
第1章:公開されたのは約1兆パラメータの重み。動かすGPUの数は、資料ごとに書き方が違う
何が、いつ公開されたのか
【会社の説明】Mistralの発表記事は、今月初めに、Mistral Large 4を公開プレビューとして出したと書いています。そして、改良版の重みを公開すると書いています。【事実】Hugging Faceのブログ記事も、2026年10月29日付です。つまり、重みの公開に先立って、公開プレビューの期間がありました。この順番は、第4章の事例を読むときに効いてきます。
規模:総量は約1兆、1トークンで動くのは約490億
【事実】モデルカードによると、Mistral Large 4は、約1兆パラメータの、画像も入力できるモデルです。1トークンを処理するたびに動くのは、全体の一部で、約490億です。埋め込み層などを含めると、約520億です。文脈の長さは100万トークンで、入力は文字と画像、出力は文字です。
【事実】構造は、専門家混合です。128の専門家から、1トークンごとに4つが選ばれ、ほかに共通の専門家が1つあります。また、推論の深さは、低・中・高の三段階を、リクエストごとに選べます。
【解釈】ここで混同しやすい点があります。動く部分が約490億でも、重みは約1兆です。一般に、この構造では、計算に使う部分は一部でも、重み全体を置く場所が要ります。必要な計算が小さいことと、必要なメモリが小さいことは、別の話です。
【事実】技術報告書は、設計の経緯も書いています。当初は、言語モデルが過去の文脈を覚えておく記憶領域、KVキャッシュを、限界まで小さくする設計でした。しかし、長い文脈で作業を進める、エージェント型の評価の成績が、期待を下回りました。そこで、ほぼ全面の注意機構に作り直し、そのあとで、計算を減らすDeepSeek Sparse Attentionという仕組みに切り替えたと書いています。
学習の規模と、動かす規模は別
【事実】学習の規模は、資料によって、書き方が違います。モデルカードは、NVIDIAのGrace Blackwellという種類のGPUを3,800基使い、場所はMistral自身の欧州のデータセンターだと書いています。技術報告書は、NVIDIAのGB200を3,840基使い、場所はパリ近郊のMistralのデータセンター、期間は45日、約415万GPU時間だと書いています。3,800と3,840の違いの理由は、資料に書かれていません。【解釈】丸めた数かもしれませんが、確認できていません。いずれも、これは学習の規模です。動かすために必要な規模ではありません。
【事実】動かす側については、モデルカードの使い方の例に、GPU8枚を積んだ1台のサーバーの設定があります。ただし、書かれているのは例で、「構成に合わせて調整する」とあります。必要なGPUの型番やメモリの総量は、モデルカードには、筆者が読んだ範囲では、書かれていません。
【事実】メモリを減らす版として、NVFP4という量子化版もあります。Blackwell世代のGPUが対象です。
【事実】技術報告書は、この量子化版について、もう少し具体的に書いています。専門家の部分をNVFP4にした版で、データの大きさは606GBです。基準にしたFP8版と、評価の成績が同じで、GB300というGPUの4基に載せて動かせると書いています。測定の基準にしたFP8版は、同じGB300の8基です(図の説明)。【解釈】これはMistralが自社で動かす構成の例で、最小の構成とは書かれていません。GB300の1基あたりのメモリは、報告書にも書かれていません。
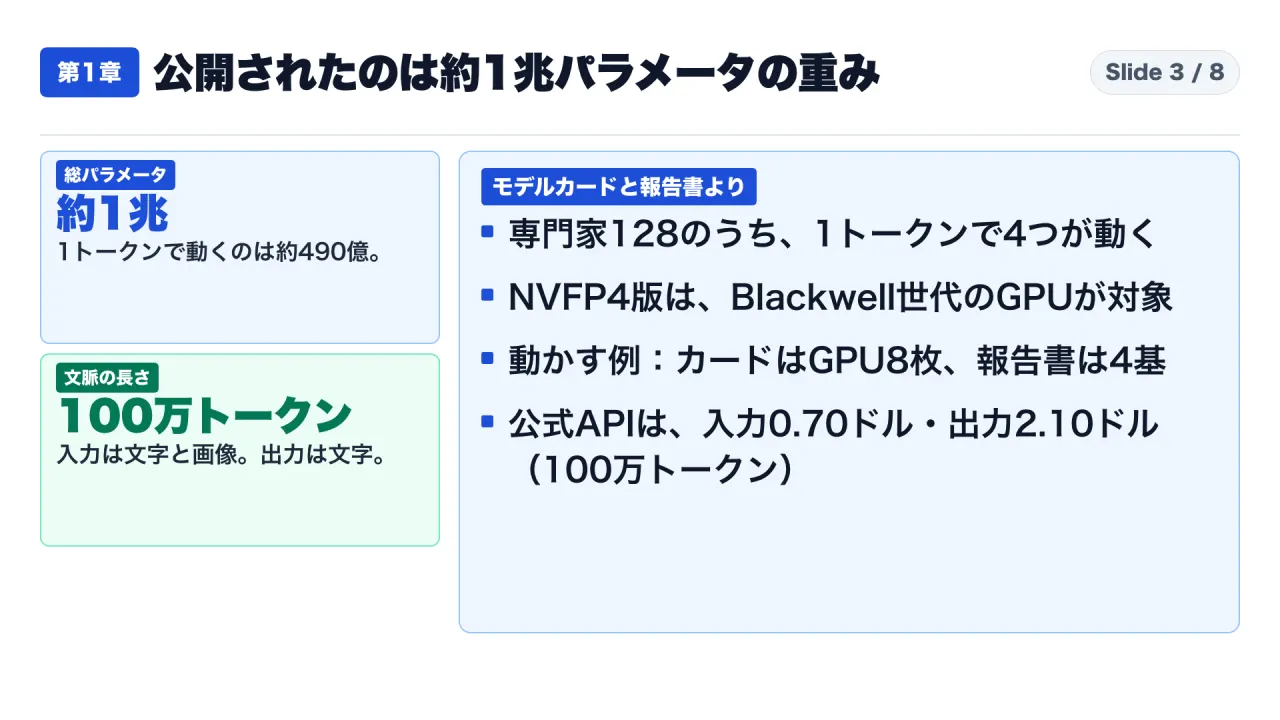
図3のとおり、確認できるのは、規模と、二つの例の構成(カードはGPU8枚、報告書は量子化版でGB300の4基)までです。
重みを動かさずに使う道もある
【事実】Mistralの発表記事は、始め方として、Mistral Studio、Mistral API、OpenRouterを挙げ、完全に自分で管理したい場合は、Hugging Faceから重みをダウンロードして、vLLMまたはSGLangで自社の基盤に載せる、と書いています。モデルカードも、モデルがMistral APIで、mistral-large-4という名前で提供されていると書いています。
【事実】公式APIの料金は、2026年10月29日から、100万トークンあたり、入力が0.70ドル、出力が2.10ドルです。
【解釈】この記事は、自社運用とAPIの費用を比べません。比べるには、自社の利用量と、待ち時間の条件が要るためです。確認できるのは、重みを動かさなくても、同じモデルを使う道がある、ということまでです。
第1章の要点
- 公開されたのは、約1兆パラメータの重みで、1トークンで動く部分は約490億
- 重みの公開に先立って、公開プレビューの期間があった
- 学習のGPU規模は書かれているが、動かすために必要な最小の規模は、どの資料にも書かれていない(例は、カードが8枚、報告書の量子化版が4基)
- 公式APIという道もある
第2章:ライセンスはMITの改変版。条件は一つで、他社へ提供する事業だけが別契約になる
名前と位置づけ
【事実】ライセンスの名前は、Mistral Ecosystem Open-Weight Licenseです。本文は、冒頭で、MITライセンスの改変版と自分で書いています。モデルカードも、商用・非商用の両方に使えるが、Model-as-a-Serviceの事業には別の商用ライセンスが要る、と同じ説明をしています。素のMITとは違います。
許されること
【事実】条文は、モデルの重みなどを、使う、複製する、改変する、統合する、公開する、配布する、再許諾する、販売する、ことを認めています。さらに、動かす、配備する、追加で学習する、派生物を作ることも認めています。【会社の説明】Mistralの発表記事も、使用、改変、追加学習、商用化は自由で、条件は一つだけ、と書いています。
条件:第1条と第2条
【事実】第1条は、著作権表示と許諾の表示を、複製に含めることです。
【事実】中心は第2条です。自社、または関連会社が、Model as a Service事業を営む場合、商用目的で使う前に、Mistralと別の商用ライセンスを結ぶ必要があります。
【事実】Model as a Serviceの定義も、条文にあります。第三者に、APIなどで、モデルまたは派生物の推論や追加学習へのアクセスを与え、その第三者が入力、パラメータ、学習データに意味のある制御を持てる形、を指します。
【事実】定義から除かれるものが、二つあります。モデルの機能を、特定の機能の中だけに組み込んだ、最終利用者向けの製品。そして、他社が動かしているモデルへの、依頼の中継だけです。
対象外:第3条
【事実】第3条は、第2条の対象外を決めています。一つは、社内利用です。モデルまたは派生物を、第三者が使える状態にしない利用、と定義されています。もう一つは、Mistral公式の製品を通した利用です。
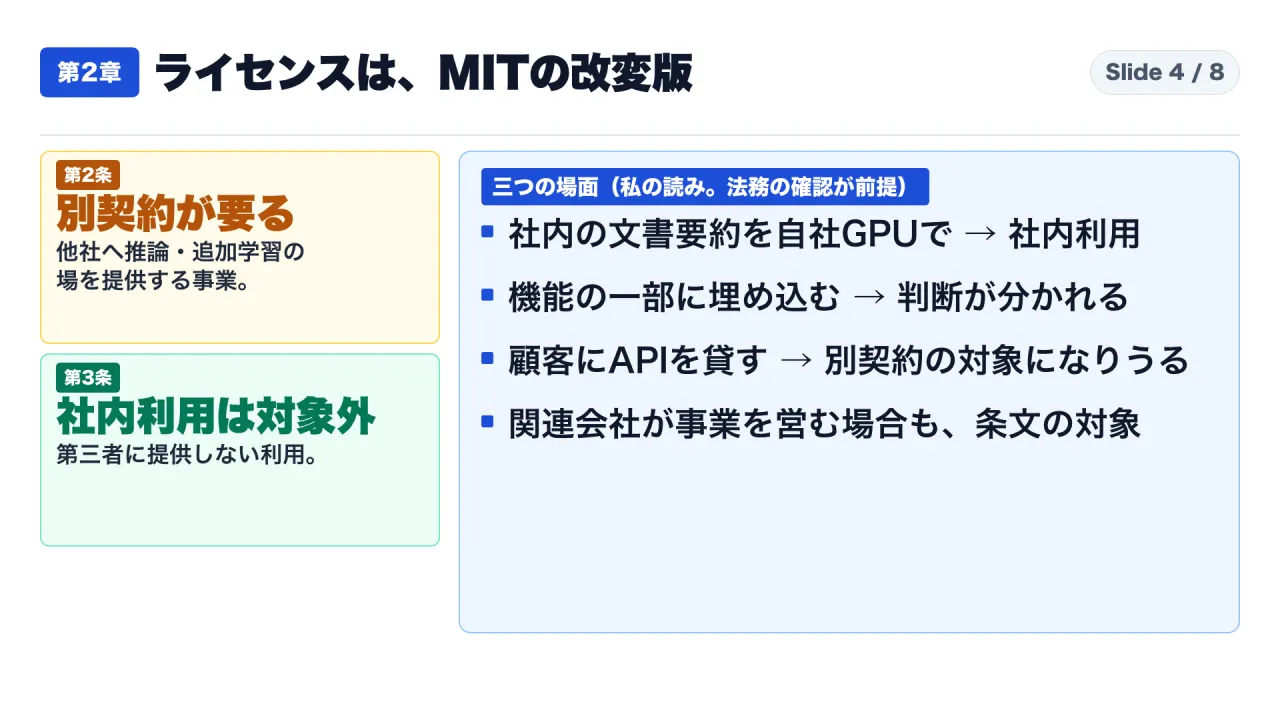
図4のとおり、第2条が別契約、第3条が対象外を決めています。
条文の読み方(筆者の解釈。法律の助言ではありません)
【解釈】たとえ話です。買った工具を、自分の工場で使うのは自由です。ただ、その工具を他の工場へ貸し出す商売を始めるなら、メーカーと別の契約が要る。第2条の構造は、これに近いと、筆者は読みます。
【解釈】自社の使い方を、三つの場面に分けて読みます。
- 社内の文書要約や問い合わせ対応に、自社のGPUで動かす場合:第三者に提供しないので、第3条の社内利用に当たると、条文からは読めます。
- 自社の製品の、特定の機能の中だけにモデルを入れて、顧客に出す場合:定義から除かれる、最終利用者向けの製品に当たる可能性があります。ただし、顧客が入力や学習データを自由に制御できる設計なら、判断が分かれます。
- 顧客に、推論のAPIを貸す、または、顧客の追加学習を受け付ける場合:定義に当たる可能性が高く、別契約の対象になりえます。
【解釈】もう一点あります。第2条は「自社、または関連会社が」と書いています。自社が提供しなくても、関連会社が事業を営む場合に、第3条の社内利用の例外が使えるのか。ここは、法務と確認が要る点です。
法務へ相談するときの聞き方
【解釈】相談を早く進めるために、次の四つを書面にして渡すと、論点が伝わります。
- 自社の使い方の図(誰がモデルを動かし、誰が入力し、誰が出力を受け取るか)
- 顧客や取引先に、モデルの機能を見せる場面があるか
- 顧客が、入力、設定、学習データを制御できる設計か
- 関連会社に、モデルの提供事業を営む会社があるか
回答が「当たる」「当たらない」と割れた場合は、Mistralの問い合わせ窓口に、使い方の図を添えて確認する道もあります。ライセンス本文にも、商用ライセンスの問い合わせ先が書かれています。
第2章の要点
- ライセンスは、MITの改変版で、素のMITではない
- 利用・改変・追加学習・配布・販売は広く認められている
- 他社へ推論や追加学習の場を提供する事業は、別契約が要る
- 社内利用と、Mistral公式の製品を通した利用は、対象外
第3章:成績の数字は、持ち主と測り方で意味が変わる。同じ日の二つの記事でも、数字が違う
コーディングの成績:三つの数字
ここでは、Mistralの発表記事の数字を三つ見ます。いずれも、Mistral自身が書いた記事の数字です。
【会社の説明】一つ目は、Cognitionという会社の非公開のベンチマーク、FrontierCode 2.0です。Mistralは、自社が19.7%で先頭だと書いています。【事実】技術報告書の表も、19.7%です。非公開の評価なので、第三者が同じ問題で確かめることは、できません。Cognition側の公式ページは、今回確認できていません。
【会社の説明】二つ目は、Terminal-Bench 4.0です。Mistralは、公開プレビューの時より13ポイント上がって41%になり、出力トークンは30%減ったと書いています。【事実】技術報告書の表も41.0%で、行名に「AA Coding Agent Index」と測り方が書かれています。
【会社の説明】三つ目は、Artificial AnalysisのCoding Agent Indexで、48%です。首位のオープンウェイトモデルと実質同じで、1課題あたりの使うトークンは47%少ない、と書いています。【事実】技術報告書の表では、48.3%です。
同じ日に出た二つの記事で、数字が違う
【事実】同じ日に出たHugging Faceのブログ記事は、Terminal-Bench 4を28.3%、Coding Agent Indexを49.8%と書いています。Mistralの記事は、41%と48%です。技術報告書の表は、41.0%と48.3%で、Mistral自身の二つの資料は、そろっています。Hugging Faceの数字が違う理由は、どの資料にも書かれておらず、分かりません。【解釈】測った時点や設定の違いかもしれませんが、確認できていません。
総合指標:「最高」とは言えない
【事実】モデルカードは、Artificial Analysisの総合指標、Intelligence Index v5で26と書いています。西側のオープンウェイトモデルでは最高としつつ、中国勢の上位は、この総合指標では上と、自分で書いています。【解釈】ですから、「最高のオープンウェイトモデル」とは、まとめられません。
サイバーの指標:測っているものを確かめる
【会社の説明】Mistralの記事は、Artificial AnalysisのCyber Indexで51%と書いています。
【事実】この指標の持ち主は、Artificial Analysisです。方法論のページによると、脆弱性を見つけ、再現して確かめ、機能を壊さずに直す、防御の作業を測ります。すべての課題は、ソースコードを読める状態から始まります。脆弱性を、実際に攻撃できるコードに変える課題は、ありません。三つの評価の、等しい重みの平均です。
【解釈】ですから、これは侵入の能力を測る指標ではありません。
【事実】Hugging Faceの記事は、同じ指標の中の、脆弱性を再現してから直す課題で、82%と書いています。
【事実】技術報告書の表は、全体を50.9%と書き、内訳の三つの評価も並べています。CWE-Bench-AAが58.0%、DeepsecBench-AAが16.0%、CyberGym-E2E-AAが79.0%です。この三つは、方法論のページが挙げる、指標を作る三つの評価と同じ名前です。【自前計算】三つの平均は、(58.0+16.0+79.0)÷3で51.0%です。【解釈】再現して直す課題に当たるのは、このうちCyberGym-E2E-AAと、筆者は読みます。その数字は79.0%で、Hugging Faceの82%と違います。理由は、資料から分かりません。
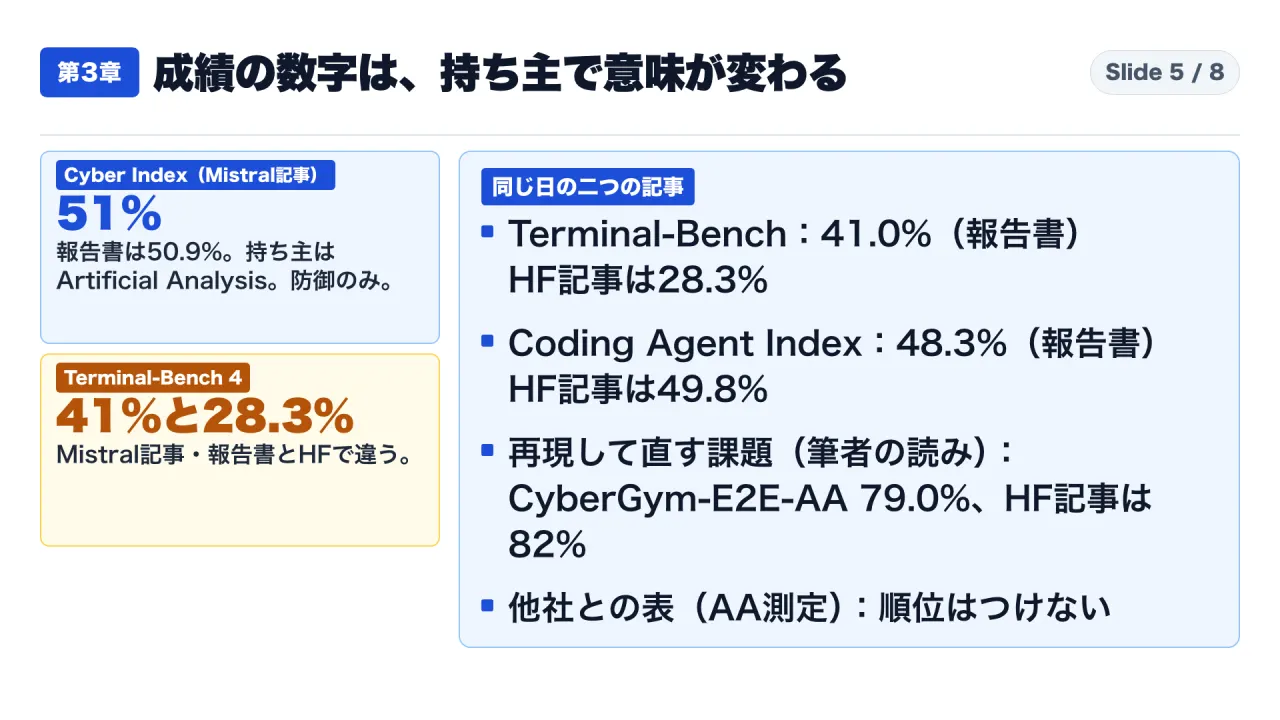
図5は、同じ日の二つの記事の数字を並べたものです。
技術報告書の表で、ほかのモデルと並べる
【事実】技術報告書の表は、ほかのモデルと同じ表に並べています。ここでは、測った主体が同じ、Artificial Analysisの行だけを見ます。表の空欄は、未報告です。測定の設定の詳細は、筆者が読んだ範囲では、報告書の本文から確認できません。
| 評価(測った主体) | Mistral Large 4 | GLM-5.3 | DeepSeek V4.1-Flash | Kimi K3 | Muse Spark Open |
|---|---|---|---|---|---|
| Coding Agent Index v2(Artificial Analysis) | 48.3% | 48.9% | 46.3% | 41.4% | 26.3% |
| Cyber Index(Artificial Analysis) | 50.9% | 36.0% | 56.8% | 41.0% | 未報告 |
| FrontierCode 2.0(Cognition) | 19.7% | 17.8% | 19.3% | 17.3% | 未報告 |
【解釈】差が小さい行では、順位をつけません。Cyber Indexでは、Mistral Large 4が上とは言えません。FrontierCodeは、Mistralが先頭と書く19.7%と、次の19.3%の差が0.4ポイントです(自前計算)。誤差の幅は書かれていないので、順位はつけません。
数字を読むときの四つの問い
【解釈】成績の数字を見るときは、次の四つを確かめます。
| 問い | 確かめる場所 | この記事の例 |
|---|---|---|
| 持ち主は誰か | ベンチマークの公式ページ、方法論 | Cyber Indexの持ち主はArtificial Analysis |
| 誰が書いた数字か | 記事の署名、注記 | 上の三つは、いずれもMistral自身の記事 |
| どの課題か | 課題の説明 | Hugging Faceの82%は再現してから直す課題。報告書の同じ内訳は79.0% |
| 自分の仕事に近いか | 自社の業務との照合 | 防御の作業の指標で、侵入の能力は測らない |
自社で評価するときの組み立て方
【解釈】公開された成績を使わずに、自社で評価する場合の、最小の組み立て方を書きます。これは筆者の提案で、Mistralや第三者の資料に書かれた手順ではありません。
- 業務の問いを集める:自社の仕事で、実際に使う問いを、数十件集めます。外に出せないデータは、社内に置いたまま使います。
- 正解の例を作る:各問いに、担当者が合格と判断する答えの例を、用意します。正解が一つに決まらない問いは、合格の条件を文章で書きます。
- 同じ条件で試す:比べるモデルすべてに、同じ問い、同じ指示文、同じ設定を与えます。推論の深さの設定も、そろえます。
- 人の目で確かめる:結果を、担当者が、正解の例と照らして採点します。採点者は、どのモデルの答えかを、知らない状態にします。
- 失敗の型を残す:間違えた問いを、型ごとに分けて残します。次にモデルが更新されたときの、再試験に使えます。
【解釈】この手順で出る数字は、公開された成績の数字と、一致しないことがあります。それは、公開値が間違っているからではなく、問いと条件が違うからです。導入の判断には、自社の問いで出た数字を使います。
第3章の要点
- コーディングの成績の三つは、いずれもMistral自身の記事の数字
- 同じ日の二つの記事で、同じ指標の数字が違っていた。技術報告書は、Mistralの記事の数字とそろう
- 総合指標では、中国勢の上位が上とモデルカード自身が書いている
- Cyber Indexは、防御の作業だけを測る
第4章:事例。「公開と同時に採用」は日付から成り立たない。重みの公開の13日前から、API経由だった
事例の位置づけ
Vulnerator AIは、GitHubで公開されているプロジェクトです。【事実】公開しているのは、個人のアカウントです。【事実】READMEは、既定では利用範囲の制限も承認の関門もない、攻撃的なセキュリティツールだと、自分で書いています。この記事は、このツールの使い方を扱いません。扱うのは、時期とライセンスの二点だけです。
一点目:時期
【事実】10月16日に出たv1.0.1のリリースの説明に、すでに、OpenRouterというAPIの中継サービス経由で使うモデルの既定が、mistralai/mistral-large-4-0と書かれています。【事実】重みの公開は10月29日です。
【自前計算】10月29日から10月16日を引くと、13日です。重みの公開の13日前に、すでに既定が書かれていました。この時点では、重みはまだ公開されていないので、使い方はAPI経由です。
【解釈】ですから、「重みの公開と同時に採用した」という筋立ては、日付から成り立ちません。重みを自社で動かす構成を、このプロジェクトが採ったことを示す資料も、確認できていません。
二点目:ライセンス
【事実】READMEは、MITライセンスで公開すると書いています。ただし、READMEは続けて、MITはコードのライセンスで、使い方の制限ではない、とも書いています。
【解釈】モデルのライセンスは別です。Mistral Large 4の条件は、第2章で読んだ、改変版です。リポジトリのMITと、モデルのライセンスを混ぜると、誤りになります。
選んだ理由と、Mistral自身の見直し
【事実】作者が、このモデルを既定に選んだ理由として、リリースの説明は、他のモデルが依頼を拒否する場面があることを挙げています。
【会社の説明】一方、Mistral自身は、公開後の実際の利用を見て、実際の攻撃への上積みの可能性があるとして、安全のための制限、ガードレールを見直していると書いています。
【解釈】拒否の挙動は、固定された性質ではありません。モデルの提供元が見直しを続けると書いている以上、ある時点の拒否の挙動を、導入の理由に置くのは危うい、と筆者は考えます。
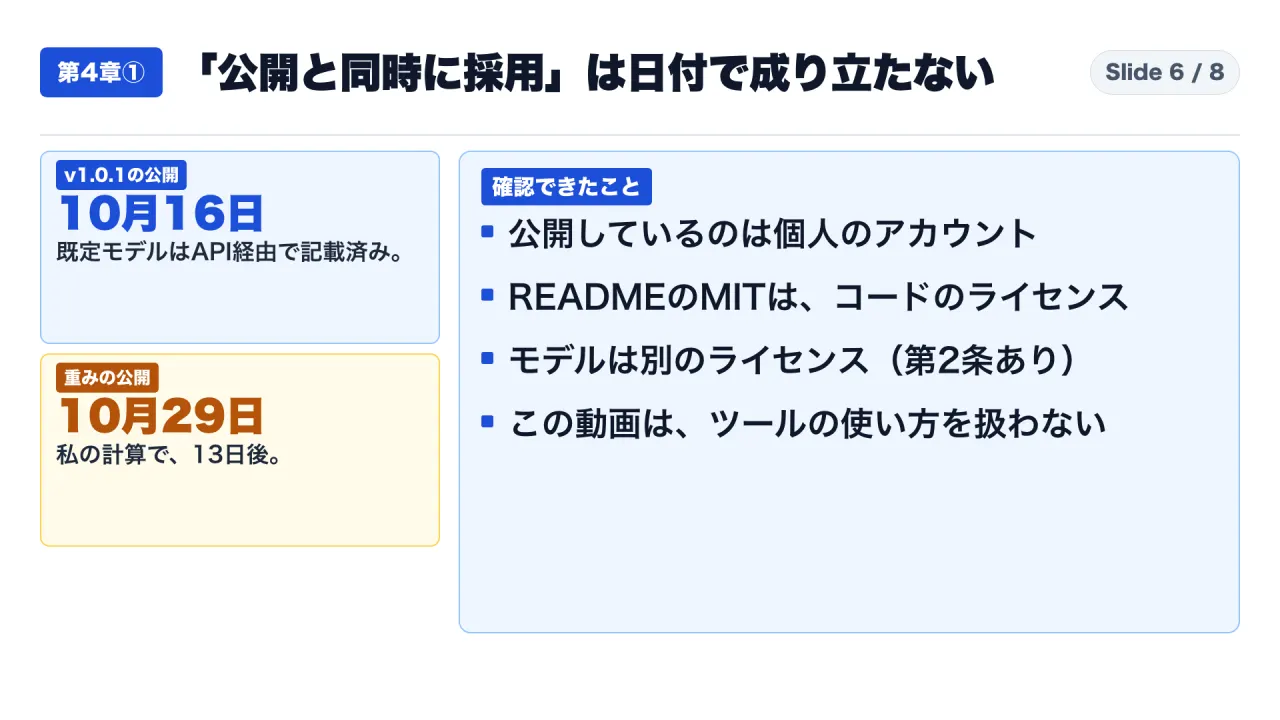
図6は、日付の関係を一枚にしたものです。
第4章の要点
- 既定のモデルは、重みの公開の13日前から、API経由で書かれていた
- リポジトリのMITは、コードのライセンス
- モデルのライセンスは別で、第2条がある
補足:条文を一文ずつ読むと、どこで判断が分かれるか
第2章の読み方を、条文の語ごとに分けて確かめます。ここは、筆者の解釈です。法律の助言ではありません。
「関連会社が」の範囲
【事実】第2条は、「自社、または関連会社が、Model as a Service事業を営む場合」と書いています。
【解釈】条文の主語に、関連会社が入っています。自社の部署が社内で使うだけでも、同じグループに、他社へAIの機能を提供する会社があれば、第2条の前提に当たる可能性があります。その場合に、第3条の社内利用の例外が、どこまで使えるのかは、条文だけでは決められません。グループ会社の一覧と、各社の事業内容を、法務に渡して確認する必要があります。
「商用目的で使う前に」の意味
【事実】第2条は、別の商用ライセンスを結ぶ時点を、「商用目的でモデルまたは派生物を使う前」と書いています。
【解釈】時点が「使う前」である点は、見落としやすいところです。試験運用の段階でも、商用目的で使うなら、本番を待たずに確認する必要があります。反対に、研究や社内の検証だけなら、第3条の社内利用に当たる場合があります。ただし、検証した結果を、そのまま顧客向けの機能にする計画があるなら、計画の段階で法務に相談しておくと、手戻りが減ります。
「意味のある制御」の読み方
【事実】定義は、第三者が、入力、パラメータ、学習データに、意味のある制御を持てる形、と書いています。
【解釈】この語が、定義の中で、判断を分ける部分です。顧客が、画面から文章を入力して、決まった形式の結果を受け取るだけの機能は、入力の制御はあっても、パラメータや学習データの制御はありません。一方、顧客が、生成の設定を変えられる、または、自社のデータで追加学習を頼める窓口は、制御が大きくなります。どこからが「意味のある」制御かは、条文に数値の基準がありません。ですから、自社の設計を、具体的な画面や窓口の単位で説明して、法務に判断してもらう必要があります。
「依頼の中継」は何を除くのか
【事実】定義から除かれるものの一つが、他社がホストするモデルへの、依頼の中継だけです。
【解釈】たとえば、自社のサービスが、他社のAPIに依頼を転送するだけなら、自社はモデルを提供していません。この場合は、第2条の対象にならない、と読めます。ただし、「だけ」と書かれているので、中継の途中で、自社が入力を加工したり、結果を加工したりする設計は、別に確認が要ります。
社内利用の例外が使えない場面
【事実】第3条(a)は、社内利用を、モデルまたは派生物を、第三者が使える状態にしない利用、と定義しています。
【解釈】社内の画面だけで使っていても、その出力を、そのまま顧客に送る運用が加われば、第三者が使える状態にあたるかどうかが、問われます。出力を人が確認して、自社の成果物として出す場合と、出力が自動で顧客に届く場合では、扱いが変わりうる、と筆者は考えます。運用の流れを、画面ではなく、出力の行き先で確認してください。
条文の外にある確認事項
【解釈】このライセンスは、モデルの利用条件を決めています。個人情報の取り扱いや、業界の規制、顧客との契約上の秘密保持は、別の確認事項です。重みを自社の基盤で動かせることと、顧客のデータをそのモデルに入れてよいことは、別の問題です。この記事の範囲では、後者を確かめていません。
この記事で言えないことと、確認が必要な前提
ここからは、事実ではなく、筆者の解釈です。
- 「オープンウェイト」は、自由と無料の同義語ではない:条文には条件が一つあり、当たるかどうかは、事業の形で決まります。
- 成績の数字は、持ち主と測り方を見ないと、比べられない:同じ日の二つの記事でも、数字が違いました。
- 個人の公開プロジェクトの事例は、会社の導入判断の材料にならない:判断に使えるのは、時期の確認と、ライセンスの範囲の区別までです。
次の点は、この記事では言えません。
- 条文の解釈の確定です。筆者は法律の専門家ではありません。実際の契約の判断は、法務と、必要ならMistralへの確認が要ります。
- 必要なGPUの規模です。モデルカードの例は、8枚のGPUを積んだ1台の例示です。技術報告書は、量子化版をGB300の4基で動かせると書きますが、Mistral自身の構成の例です。自社の条件での最小構成は、どちらにも書かれていません。
- Cognitionの非公開評価の中身と、Terminal-Benchのリーダーボードの個別の行です。確認できていません。
- 学習データそのものです。技術報告書は、データの種類として、ウェブ、コード、科学や技術の文書を挙げ、段階ごとの割合も図に示していますが、データの名前や中身は、筆者が読んだ範囲では、書かれていません。「オープン」は、学習データの公開とは、別の話です。
- Vulnerator AIとMistralの関係です。Mistralの発表記事とモデルカードに、Vulnerator AIへの言及は、筆者が読んだ範囲では、ありません。提携や推奨の事実は、言えません。
- 制作の裏側です。下調べで読んだ共有資料には、Vulnerator AIが重みの公開と同時に採用した、という筋立てがありました。日付を確かめると成り立たなかったので、使っていません。
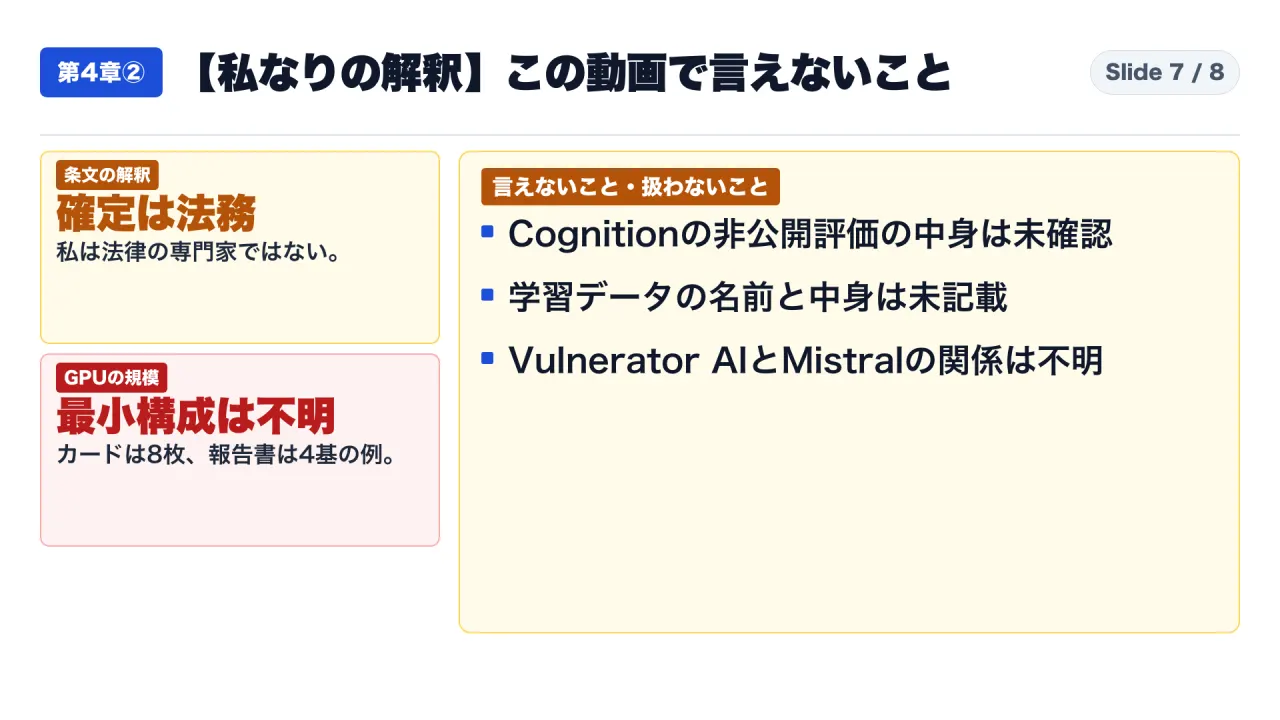
導入の前に確かめる三つの点(筆者の提案)
オープンウェイトのモデルを、自社で動かす前に、次の三つを確かめます。
一つ目:ライセンスの第2条に、自社と関連会社が当たるか
- 着手の条件:ライセンス本文の英文と、この記事の第2章を、法務の担当に渡せること
- 手順:自社と関連会社に、他社へ推論や追加学習の場を提供する事業があるかを、一覧にします。ある場合は、第3条の社内利用の例外が使えるかを、法務と読みます
- 確認方法:法務が、条文のどの語に当たるかを、書面で回答する
- うまくいかない場合:回答が割れたら、使い方の図を添えて、Mistralに問い合わせる
- 適用しない条件:Mistral公式の製品を通した利用は、第3条(b)の対象外なので、この確認は要りません
二つ目:必要なGPUの規模を、自社の利用量で測る
- 着手の条件:想定する同時利用者数、1回の入力と出力の長さ、許せる待ち時間を、数字で決めておくこと
- 手順:モデルカードの例(GPU8枚を積んだ1台)や、技術報告書の量子化版の例(GB300の4基)を出発点にして、小さな負荷から、実際に動かして測ります
- 確認方法:待ち時間と、同時に処理できる数を、記録する
- うまくいかない場合:メモリが足りない場合は、モデルカードの案内にあるとおり、最大の文脈長と、同時に処理する数を下げます
- 補足:公式APIの料金は、入力が0.70ドル、出力が2.10ドルです。比べるときは、自社の利用量で試算します
三つ目:自社のデータで評価する
- 着手の条件:自社の業務の問いと、正解の例を、数十件でも用意すること
- 手順:公開された成績でなく、自社の問いで、複数のモデルを同じ条件で試します
- 確認方法:正解との一致を、人の目で確かめる
- うまくいかない場合:数字が公開値と大きく違っても、公開値を疑うのでなく、自社の問いと条件を見直します
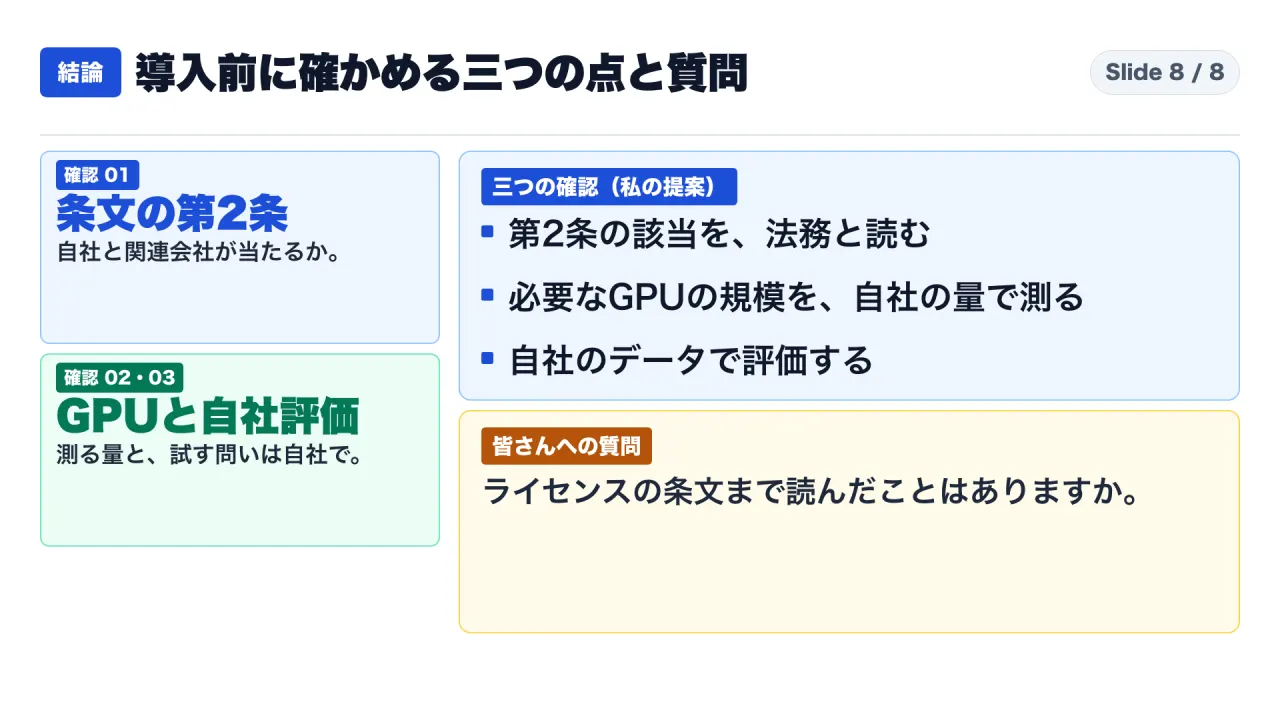
よくある疑問
Q1. MITライセンスなら、何に使ってもいいのではないですか。 このモデルのライセンスは、MITの改変版です。素のMITと違い、他社へ推論や追加学習の場を提供する事業には、別の商用契約が要ります。
Q2. 社内で使うだけなら、何もしなくていいのですか。 第3条は、第三者に提供しない社内利用を、第2条の対象外としています。ただし、関連会社の扱いなど、確認が要る点が残ります。条文の確定は、法務に委ねてください。
Q3. 重みを持っていれば、データを外に出さずに済みますか。 この記事では、確かめていません。Mistralの記事は、自社の基盤で、モデルを検査し、カスタマイズし、配備できると書いています。ただし、データの流れが実際にどうなるかは、自社の設計で決まります。
Q4. Cyber Indexが51%なら、侵入テストに強いモデルですか。 いいえ。この指標は、ソースコードを読める状態から、脆弱性を見つけて、再現して、直す、防御の作業を測ります。攻撃できるコードを作る課題は、ありません。
Q5. Vulnerator AIは、公開初日にMistral Large 4を採用したのですか。 資料からは、言えません。10月16日のリリースの説明に、すでに、API経由の既定が書かれていました。重みの公開は10月29日です。
最後の確認リスト
- ライセンスの名前と、素のMITとの違いを、本文で確かめたか
- 第2条の定義に、自社と関連会社の事業が当たるかを、法務と読んだか
- 第3条の例外が、自社の使い方で使えるかを、確かめたか
- 必要なGPUの規模を、資料の例(カードの8枚、報告書の4基)でなく、自社の利用量で測る計画があるか
- 成績の数字の、持ち主、測った課題、書いた人を、確かめたか
- リポジトリのライセンスと、モデルのライセンスを、混ぜていないか
- 自分で計算した数字に、「自前計算」と書いたか
最後に、一つ質問です。自社や取引先で、オープンウェイトのモデルを使うとき、ライセンスの条文まで読んだことはありますか。コメントで教えてください。
YouTube本編:https://youtu.be/LU4T-3NTDnk
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
公開直前の再確認(2026年11月3日):ライセンス本文、モデルカード、技術報告書(PDF)などを取得し直し、この記事に使った版・数字・本文が変わっていないことを確認しました。
出典一覧
- Mistral発表記事(2026年10月29日):https://mistral.ai/news/mistral-large-4-oss/
- ライセンス本文(Hugging Face):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B/blob/main/LICENSE
- モデルカード(Hugging Face):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B
- Artificial Analysis Cyber Index方法論:https://artificialanalysis.ai/methodology/cyber-index
- Hugging Faceブログ記事(2026年10月29日):https://huggingface.co/blog/mistral-large4
- Mistral Large 4 技術報告書(Hugging Face掲載のPDF):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B/blob/main/assets/technical_report.pdf
- Vulnerator AI v1.0.1リリース(GitHub):https://github.com/irraz/vulnerator-ai/releases/tag/v1.0.1
- Vulnerator AI README(GitHub):https://github.com/irraz/vulnerator-ai
- Vulnerator AIリポジトリ情報(GitHub API):https://api.github.com/repos/irraz/vulnerator-ai