「毎秒3,000トークン」は、誰の速さなのか? 共有AI機の数字を、条件を聞いてから読む
YouTubeポッドキャスト本編(動画・音声)はこちら:「毎秒3,000トークン」は、誰の速さなのか? 共有AI機の数字を、条件を聞いてから読む
結論:毎秒3,000トークンは同時に動く全員の合計で、1人の速さではありません。数字を見たら五つの条件を聞きます
結論から書きます。海外のレビュー動画が挙げた「毎秒3,000トークン超」は、字幕を確かめると、複数の同時の処理を足し合わせた合計の数字です。1人が使ったときの速さではありません。この数字だけでは、自分の使い方で速いかどうかは決まりません。
この数字の出どころは、HPがスポンサーを務めた動画1本です。話者は、HPが貸出機を用意してくれたと話しています。独立した測定ではありません。しかも、動画は、モデルの名前、量子化、入力と出力の長さを、字幕の範囲では述べていません。64人が同時のときの「80台後半から90トークン毎秒」が、64人の合計なのか1人分なのかも、発言からは決まりません。
この記事の対象読者は、社内で共有するAI機(自社で動かす大規模言語モデルの環境)の導入を検討したり、導入案を説明したりする、情報システム、DX推進、開発リーダー、管理職の方です。メーカーや販売店の資料で「毎秒何トークン」という数字を見たときに、何を聞き返せばよいかを知りたい方を想定しています。
読み終えると、次の三つができるようになります。一つ目は、公式仕様の表から言えることと言えないことを分けること。二つ目は、速さの数字を見たときに、合計か1人分かを最初に確かめること。三つ目は、メモリの量、帯域、電源、OS、価格といった確認項目を、公式ページの範囲で整理することです。
なお、この記事は、機械の性能評価でも、購入のすすめでもありません。私は実機を触っていません。使う資料は、HPとNVIDIAの公式ページ、HPの発表、そして動画の字幕だけです。
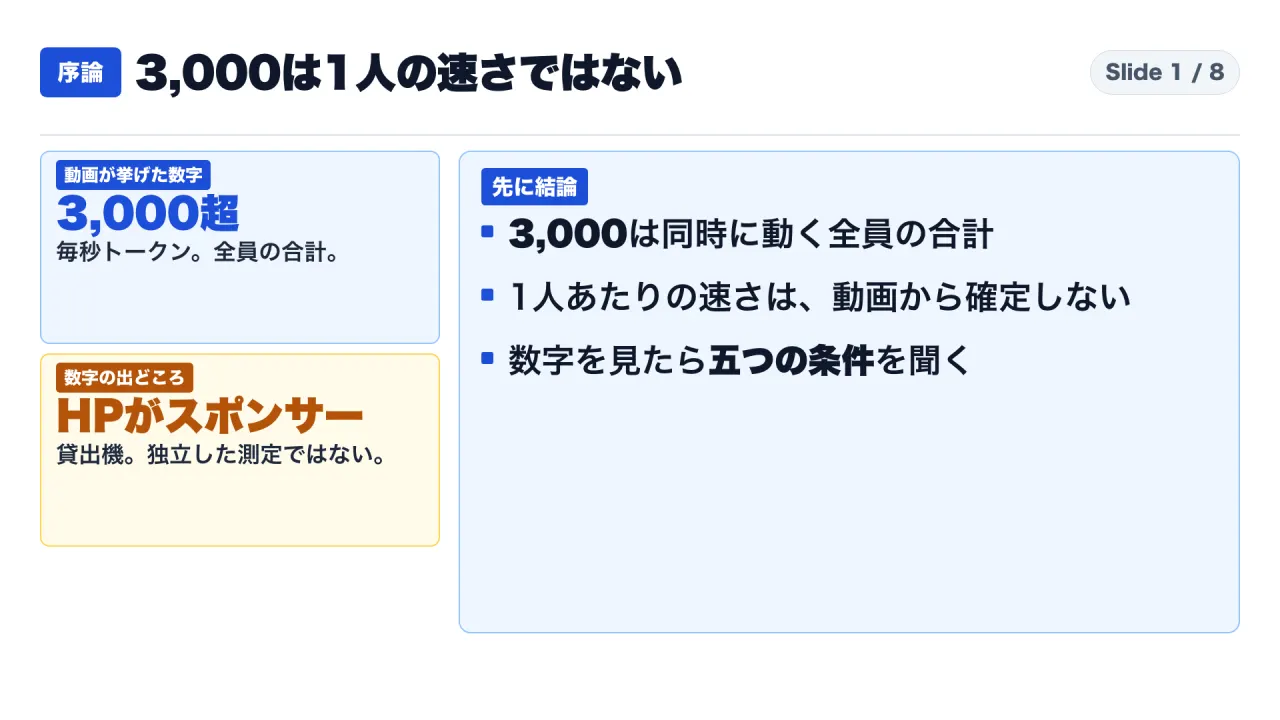
図1は、この記事全体の答えを一枚で示したものです。動画が挙げた3,000は合計の数字で、出どころはHPがスポンサーの動画です。1人あたりの速さは、動画から確定できません。
読み方:本文では「事実」「動画の発言」「自前計算」「筆者の解釈」を分けて書きます
本文の各段落には、必要に応じて四つの札を付けます。
【事実】は、HPとNVIDIAの公式ページ、HPの発表に書かれている数字と文章です。【動画の発言】は、レビュー動画の話者が話した内容で、字幕で確かめたものです。独立した測定ではなく、第三者の確認も経ていません。【自前計算】は、公表された数字から私が計算した値です。公表値ではありません。算式は本文に書きます。【解釈】は、筆者が資料を読んで考えたことで、資料に書かれているわけではありません。
資料の取得方法にも制約があります。公式ページの仕様表は、取得した本文では、ラベルと値が別の行に分かれていました。そのため、メモリの容量と帯域、電源、価格の行は、表を読み取って手で確認しています。動画については、字幕の文字起こしを使いました。動画の映像そのものは確認していません。字幕は自動認識を含むため、文字の誤りがありえます。
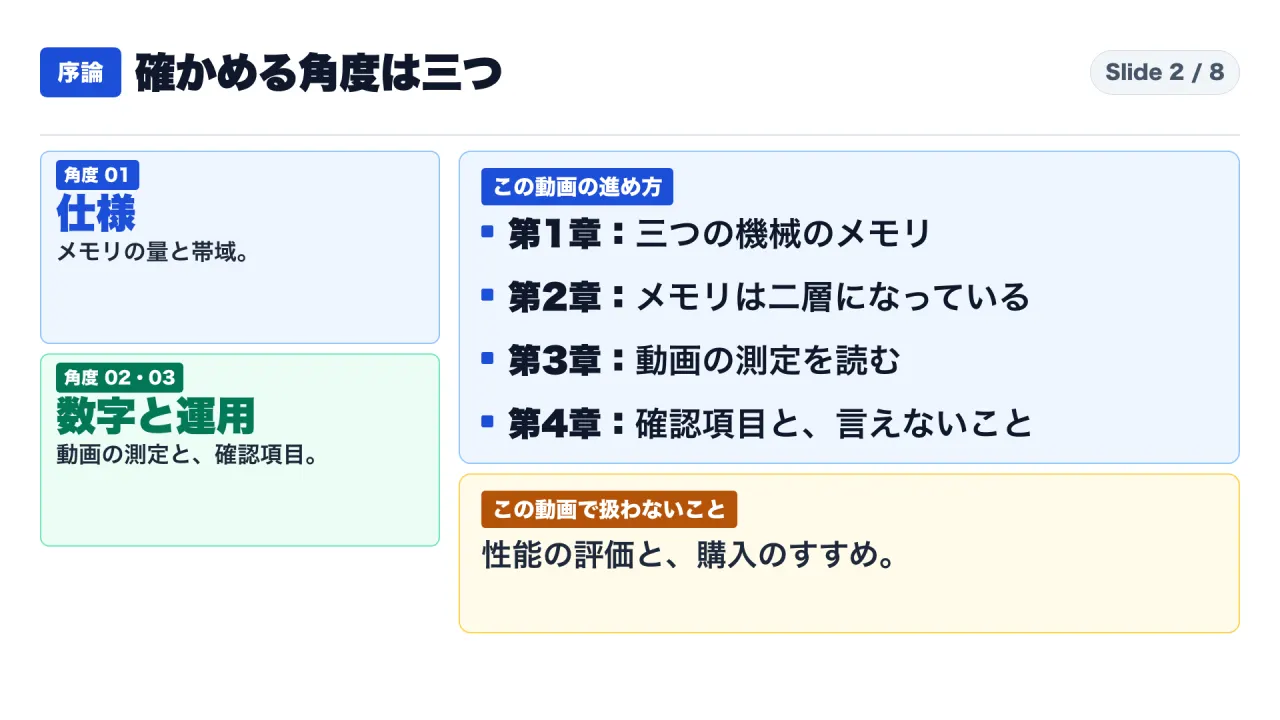
図2のとおり、確かめる角度は三つです。一つ目は仕様の数字、二つ目は動画の数字の読み方、三つ目は共有の機械として使うときの確認項目です。
背景:この記事で使う言葉を先にそろえます
- トークン:AIが文章を数える単位です。長い文章ほど、トークンの数が増えます。
- 毎秒のトークン数:AIが1秒に出力できるトークンの数です。速さの目安として使われます。
- 同時接続数:同じ機械を同時に使っている人(または処理)の数です。
- 合計と1人分:合計は、同時に動いているすべての処理の出力を足した数字です。1人分は、その中の1人が受け取る数字です。同時接続数が多いほど、合計が大きくても、1人分は小さくなりえます。
- メモリ帯域:メモリからデータを読み書きできる速さの数字で、GB/s(1秒あたりのギガバイト)やTB/s(1秒あたりのテラバイト)で表します。
- HBM3e と LPDDR5X:どちらもメモリの種類です。この記事の機械では、HBM3eがGPUのそばの高速なメモリ、LPDDR5XがCPU側のメモリとして載っています。
- 量子化:モデルを軽くするために、モデルの数字を粗くする方法です。粗くするほど軽くなりますが、結果が変わることがあります。
- 推論:学習済みのモデルに文章を入力して、答えを出させることです。
速さの数字は、「何を測ったか」を一緒に聞かないと比べられません。同じ機械でも、同時に使う人数、モデルの大きさ、入力と出力の長さが変われば、数字は変わります。
第1章:三つの機械のメモリを並べると、仕様の表で言えるのは「量」と「帯域」までです
公式ページの数字
【事実】NVIDIAのDGX Sparkは、メモリが128GBで、メモリ帯域が273GB/sです。HPのZGX Nanoは、GB10というチップで、メモリは128GBです。
【事実】HPのZGX Furyは、発表で、748GBのコヒーレントメモリを備えると述べています。内訳は、HP Japanの製品ページによると、HBM3eが252GB、LPDDR5Xが496GBです。NVIDIAのDGX Stationのページにも、同じ748GBが載っています。
【自前計算】252GBと496GBを足すと、748GBです。
【事実】単体のGPUカードであるRTX PRO 6000 Blackwell Workstation Editionは、メモリが96GBのGDDR7で、帯域が1,792GB/s、最大の消費電力が600Wです。
| 機械 | メモリ | 帯域 | 出典 |
|---|---|---|---|
| HP ZGX Fury | 748GB(HBM3e 252GB と LPDDR5X 496GB) | HBM3e側 7.1TB/s、LPDDR5X側 396GB/s(NVIDIAのDGX Stationの仕様表) | S1・S2・S3 |
| NVIDIA DGX Spark | 128GB | 273GB/s | S4 |
| HP ZGX Nano | 128GB | 本記事では未確認 | S6 |
| RTX PRO 6000 | 96GB(GDDR7) | 1,792GB/s | S5 |
仕様の表から、言えることと言えないこと
車のカタログには、荷室の広さと最高速度が別の欄に書いてあります。荷室が広い車が、速いとは限りません。これはたとえ話です。AIの機械でも、載る量と速さは、別の数字です。
【解釈】仕様の表から言えるのは、メモリの量と、メモリの帯域という数字までです。毎秒何トークン出るかは、私が確認した公式ページには書かれていません。仕様の表は、機械の大きさを教えてくれますが、共有で使ったときの待ち時間は教えてくれません。
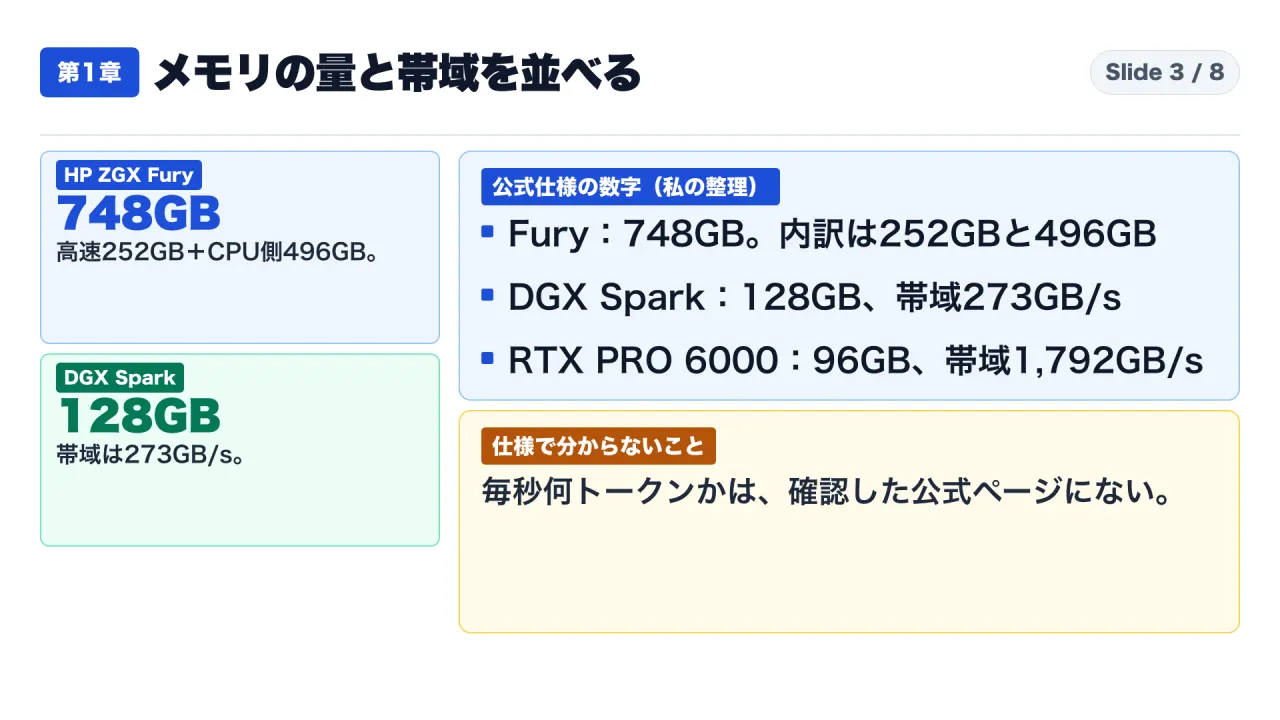
図3は、三つの機械の公式仕様の数字を並べたものです。ここまでは、すべて公式ページに書かれた数字です。
第2章:Furyのメモリは二層で、高速な領域は252GBです。大きいモデルが載ることと、速く動くことは別です
二つの領域で、帯域が約18倍違います
【事実】NVIDIAの仕様表によると、DGX StationのGPU側のメモリは、252GBのHBM3eで、帯域は7.1TB/sです。CPU側のメモリは、496GBのLPDDR5Xで、帯域は396GB/sです。
【自前計算】7.1TB/sを7,100GB/sに換算します(1TBを1,000GBとして計算)。7,100÷396は約17.9で、約18倍です。同じ機械の中に、帯域が約18倍違う二つの領域があります。
【自前計算】同じ換算で、7,100GB/sは、DGX Sparkの273GB/sの約26倍(7,100÷273=26.0)、RTX PRO 6000の1,792GB/sの約4倍(7,100÷1,792=4.0)です。ただし、帯域の比は、トークン速度の比ではありません。私は速度を測っていませんし、公式ページにも速度は書かれていません。
「載る」と「速い」は別の話です
ここで一人ツッコミです。「748GBもあるなら、どんなに大きいモデルでも速いのでは」と思いますよね。いや、ちょっと待ってください。
【会社の説明】HPの発表は、1兆パラメータ規模のモデルによる推論処理に対応する、と述べています。これは、モデルが載って動く、という話です。毎秒何トークン出るかの保証ではありません。
【解釈】252GBを超えて、496GB側にモデルがはみ出したときの速さは、確認した公式ページに書かれていません。ここは分からない、と言います。
【会社の説明】同時に使える人数について、HPの発表は、モデルのサイズに応じて、複数のユーザーによる推論処理の同時実行に対応する、と書いています。「モデルのサイズに応じて」という条件が付いています。人数の上限は、私が確認した範囲では書かれていません。
仕様の数字にも条件が付きます
【事実】NVIDIAのDGX Stationのページには、「Tensor Coreの仕様は、特に断りがない限りsparsity(疎行列化)ありの値」という趣旨の注記があります。疎行列化は、計算の中にゼロが多いことを前提に、計算を省く方法です。つまり、仕様の数字にも、「どういう条件の値か」という前提が付いています。速さの数字を読むときの練習として、覚えておく価値があります。
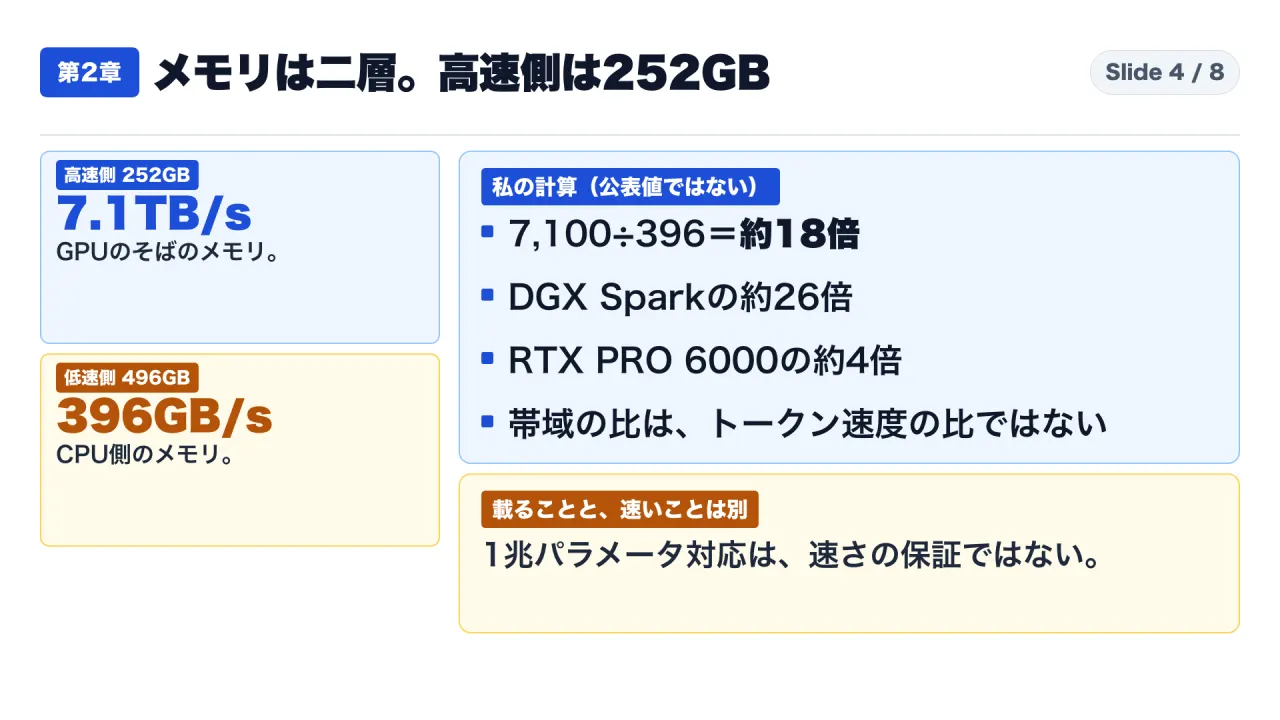
図4は、二層のメモリと、私の計算(約18倍、約26倍、約4倍)を整理したものです。公表値ではありません。
第3章:動画の測定を読むと、3,000は合計で、1人分の数字は動画から確定しません
動画の立場
【動画の発言】話者は、HPがこの動画のスポンサーで、貸出機を用意してくれたと話しています(0:44から1:01)。ですから、この動画は、独立した測定ではありません。これは、動画の価値を否定するものではありません。スポンサー付きで、貸出機を使った動画だと分かったうえで読む、という意味です。
三つの数字
【動画の発言】一つ目。話者は、画面を見ながら、合計で毎秒3,000トークンを超えている、と話しています(7:05から7:10)。字幕の原文は、「in aggregate」、つまり合計です。日本語は私の訳です。1人の速さではなく、合計です。
【動画の発言】二つ目。話者は、16人が同時に使うテストで、毎秒1,300トークンを大きく超えたと話しています(7:11から7:20)。この1,300が、合計か1人分かは、字幕の範囲では言っていません。
【動画の発言】三つ目。話者は、64人を同時に動かすテストで、生成が始まると、80台後半から90トークン毎秒に達している、と話しています(7:28から8:02)。この数字が、64人の合計なのか、1人分なのかは、発言から決まりません。
二通りの読み方を、計算してみる
【自前計算】「80台後半から90」が1人分なら、90トークンを64人分に掛けて、全体で約5,700です(90×64=5,760を概算した値)。これは、3,000超とは別の測定になります。「80台後半から90」が合計なら、64人で割って、1人あたり約1.4です(90÷64=1.4)。これは、動画の主旨と合いません。どちらなのかは、確定できません。
【自前計算】もう一つ、仮の割り算をします。これは、動画にない数字です。仮に、3,000が64人分の合計だったとします。1人あたりは、約47です(3,000÷64=46.9)。ただし、動画は、3,000がいくつの同時接続での値かを述べていません。ですから、約47という数字は、私が仮に割った数字で、動画の数字ではありません。
合計が同じでも、1人分は人数で変わります(仮の数字)
合計と1人分の関係を、仮の数字で確かめます。この数字は、説明のための仮のもので、動画や公式ページの数字ではありません。
仮に、ある機械の合計が、毎秒600トークンだったとします。同時に使う人が5人なら、1人あたりは毎秒120トークンです(600÷5)。20人なら30トークン(600÷20)、60人なら10トークン(600÷60)です。合計は同じ600でも、1人が受け取る速さは、人数によって12倍も違います。
【解釈】つまり、「合計が大きい」と「1人分が速い」は、別の話です。共有の機械は、人数を増やすほど、合計の数字は見栄えがよくなりえます。一方で、1人分の速さは、人数に反比例して下がる場合があります。ここで「場合がある」と書くのは、同時に動かす処理の数を増やしたときに、合計がどこまで伸びるかは、機械、モデル、条件によって違い、動画にも公式ページにも書かれていないからです。
だからこそ、速さの数字を示されたら、合計か1人分かの前に、「同時に何人が動いていたか」を聞く必要があります。この二つがそろって初めて、自分の使い方に近いかどうかが判断できます。
動画が語っていない条件
字幕の範囲で、次の条件は述べられていません。モデルの名前(字幕の文字が不正確なので、この記事では書きません)、量子化、入力の長さ、出力の長さです。また、合計が3,000超の試験と、16人の試験と、64人の試験が、同じ条件の試験かどうかも、分かりません。
【解釈】条件が違えば、数字を並べて比べることはできません。動画の三つの数字は、どれも、条件が足りません。足りない条件は、何人が同時か、どのモデルか、どの粗さか、入力と出力がどれだけ長いか、そして、合計か1人分か、の五つです。
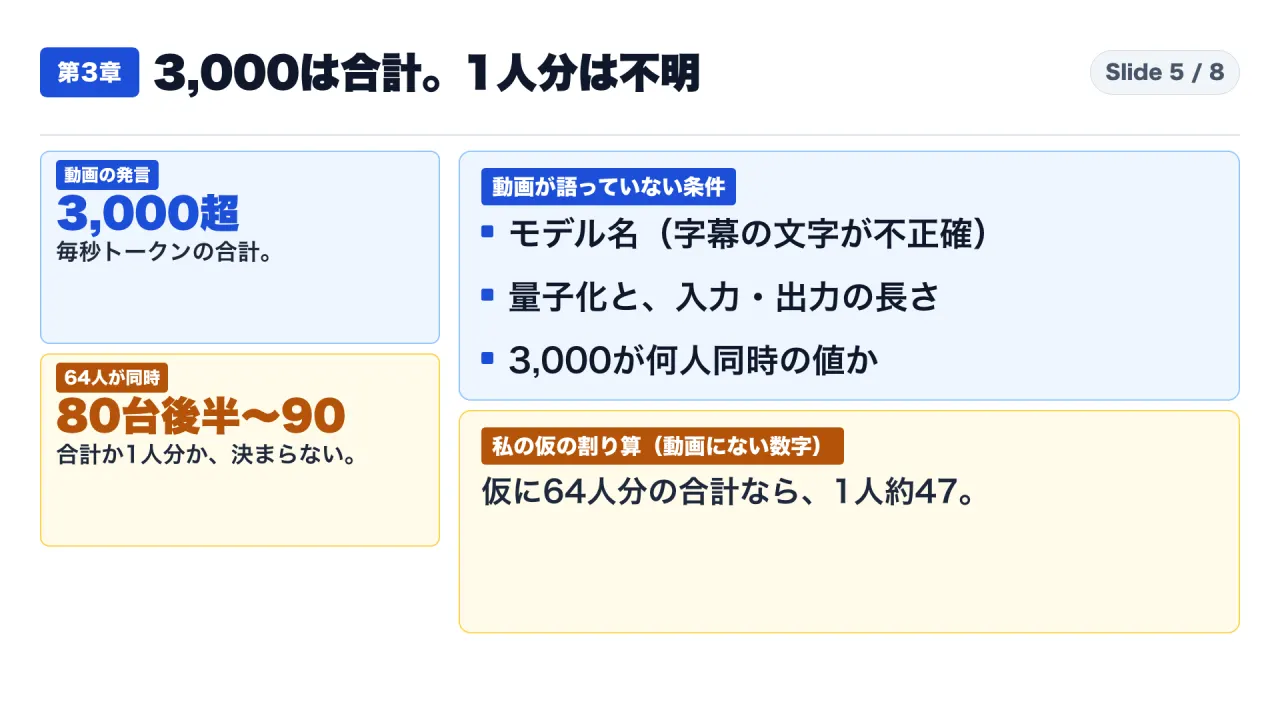
図5は、動画の発言と、動画が語っていない条件を整理したものです。
第4章①:共有機として使うときの確認項目は、公式ページで確認できる範囲で、電源・OS・設置・価格です
【事実】電源は、1,600Wです。HP Japanの製品ページは、100Vの環境では15Aではなく20Aのコンセントが必要で、200V電源での使用を推奨する、と書いています。NVIDIAの仕様表も、20Aの回路が必要と書いています。
【事実】出荷時のOSは、Ubuntu 24.04 LTSです。HPは、Windowsへの対応を、2026年12月以降に予定しています。
【事実】設置について、HP Japanの製品ページは、標準で5Uのラックに格納でき、QSFPケーブルでスケールアウトできる、と書いています。台数の上限は、私が確認した範囲では書かれていません。
【事実】ネットワークは、NVIDIAの仕様表で、ConnectX-8 SuperNICが最大800Gb/sです。ポートは、QSFP112が2つで、1ポートあたり400Gbsです。HP Japanの製品ページは、800Gbpsと記載しています。
【事実】HP Japanの製品ページは、付属ソフトの特長として、OpenAI互換のAPIエンドポイントで既存のアプリケーションと連携できることを挙げています。リモート管理には、内蔵のBMC(Redfish API対応)があると記載しています。
【事実】価格です。日本のHPの希望販売価格は、28,490,000円からで、税込です。HPのニュースリリースは、2026年10月26日付で、販売開始日を10月27日としています。価格や仕様、提供時期などの情報は予告なく変更となる場合がある、とも書いています。この記事は、この価格が高いか安いかを判断しません。他の機械や、他の地域の価格との比較も、公式の根拠がないため扱いません。
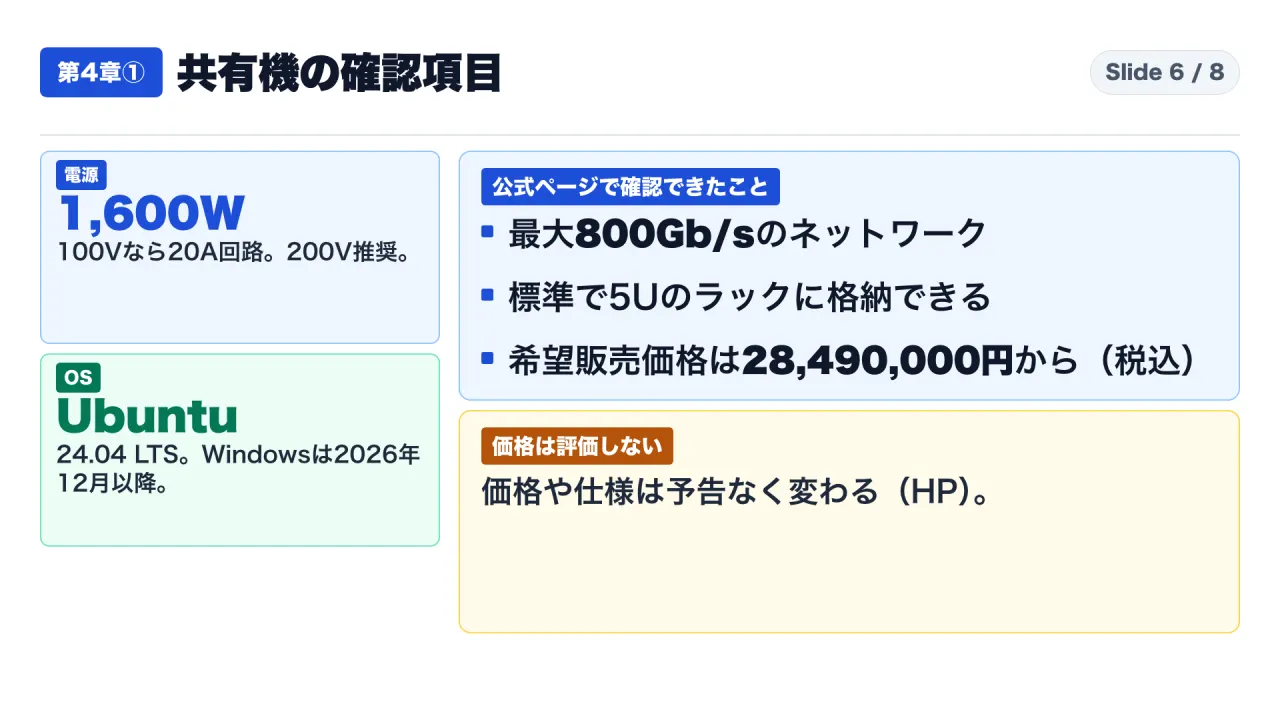
図6は、公式ページで確認できた項目を整理したものです。
筆者の解釈:3,000は「機械全体の仕事量」の数字で、待たされる時間の数字ではありません
ここからは事実ではなく、私の解釈です。
【解釈】第一に、3,000は、機械全体の仕事量の数字で、待たされる時間の数字ではない、ということです。共有で使う人にとって大事なのは、自分が使うときの、1人分の速さです。
【解釈】第二に、仕様の数字と、動画の測定値は、種類の違う数字だ、ということです。メモリの量と帯域から、毎秒何トークンになるかは、確認した資料からは計算できません。
【解釈】第三に、動画の数字は、条件を確かめる練習問題として読むのがよい、ということです。合計か1人分か、何人が同時か、という条件がそろって、初めて、比べられる数字になります。
比較条件と限界:数字は、条件を揃えて読みます
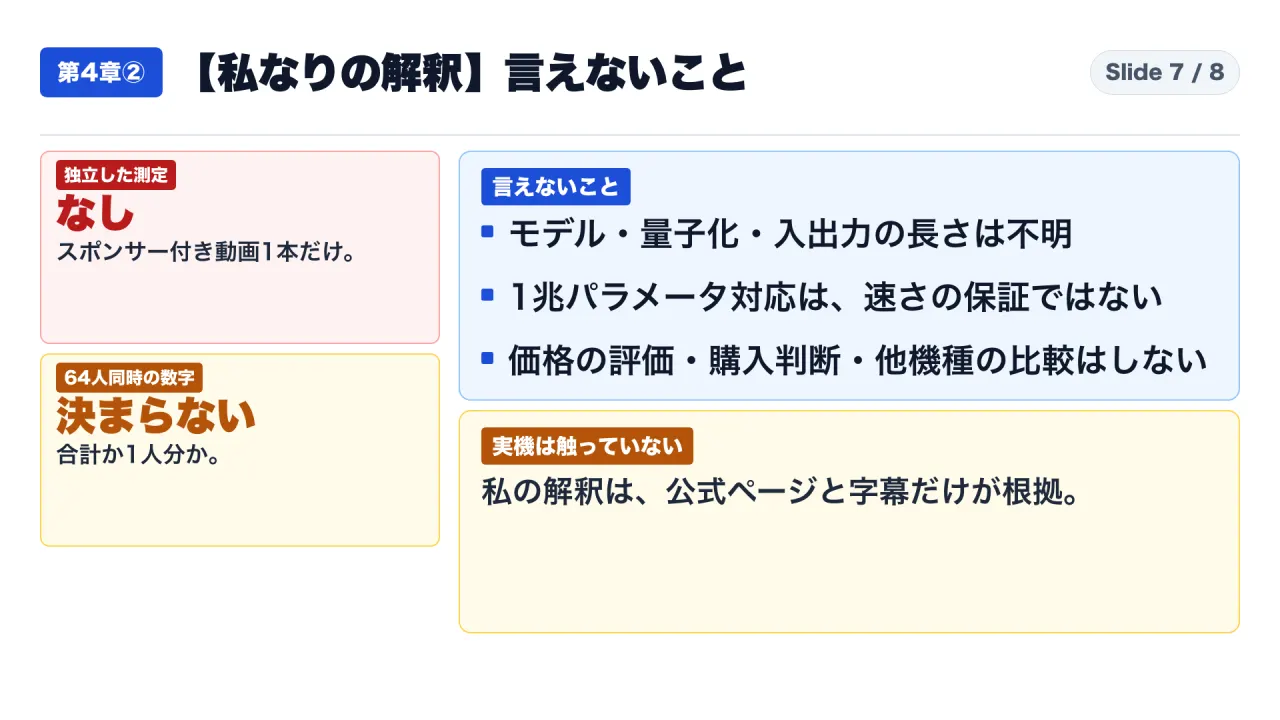
この記事で言えないことを、先に並べます。
- これは、独立した測定ではありません。スポンサー付きの動画1本が、出どころです。
- 80台後半から90が、合計か1人分かは、決まりません。
- モデル、量子化、入力と出力の長さは、分かりません。
- 1兆パラメータへの対応は、速さの保証ではありません。
- ほかの機械との価格比較、購入の判断、何人で使えるかの結論は、出しません。
- 動画の映像は確認していません。字幕は、自動認識を含みます。
- 私は、実機を触っていません。
- 約18倍、約26倍、約4倍、約5,700、約1.4、約47は、私の自前計算(または仮の割り算)です。公表値ではありません。
制作の裏側も書いておきます。下調べの要約には、公式ページの数字と食い違うメモリや帯域の数字、ほかの機械の価格、「唯一」や「最初」という言い方、第三者の最適化で性能が上がったという主張がありました。公式ページで確認できなかったので、この記事には使っていません。
実務:「毎秒何トークン」と言われたとき、どう確かめるか
対象と前提
対象は、メーカーや販売店、社内の担当者から、AI機の速さの数字を示されて、導入の判断材料にしたい人です。前提は、自社で使う予定のモデルと、同時に使う人数の見込みが、おおまかに決まっていることです。決まっていなければ、それを決めることが最初の作業になります。
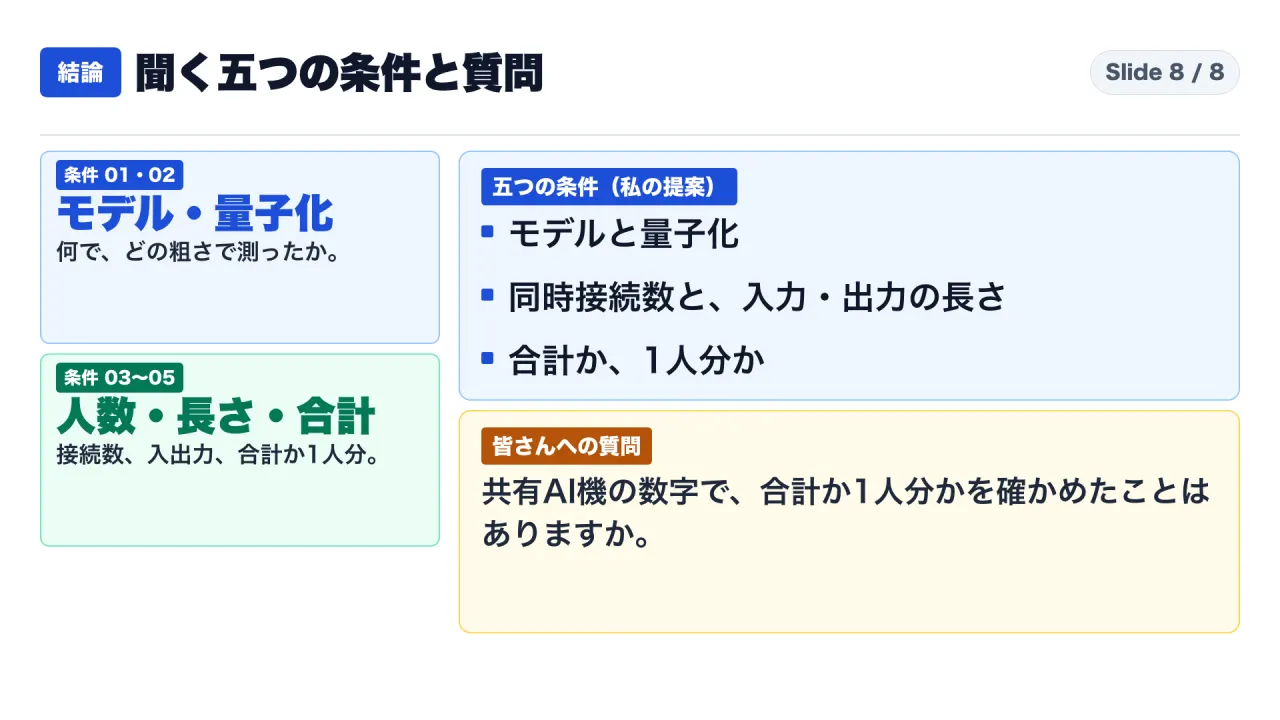
手順1:合計か、1人分かを聞く
最初に、示された数字が合計か1人分かを聞きます。合計なら、同時に何人(何本の処理)が動いていたかを、続けて聞きます。この二つが分かれば、「合計÷同時接続数」で、1人あたりのおおよその速さが分かります。ただし、割り算で出した数字は、実測ではなく目安です。
手順2:モデルと量子化を聞く
次に、どのモデルで、どの量子化で測ったかを聞きます。自社で使うモデルと違えば、その数字は、そのままは使えません。量子化が違えば、速さも結果も変わりえます。
手順3:入力と出力の長さを聞く
三つ目に、入力と出力がそれぞれ何トークンだったかを聞きます。自社の使い方(長い資料を読ませるのか、短い質問を繰り返すのか)と違う長さで測った数字は、当てになりません。
手順4:自分の使い方に当てはめる
最後に、自社の使い方に当てはめます。同時に使う人数と、1人あたりに要る速さを決めて、その掛け算が、合計の数字に収まるかを見ます。
たとえば(数字は説明のための仮のものです)、20人が同時に使い、1人あたり毎秒30トークンが要るなら、合計で毎秒600トークンです。示された合計がこれを大きく下回れば、足りません。上回っていても、それは、条件が同じ場合の話です。
確認で食い違ったときの対応
販売側が条件を答えられない、または、答えが公式の資料と食い違う場合は、その数字を判断材料に使わず、公式ページの仕様(この記事の表の数字)だけで検討します。そのうえで、自社のモデルと自社の使い方で、実際に測ってもらう方法があります。
この記事の内容を使わないほうがよい場面
この記事の方法は、速さの数字を読み直すための手順です。購入の判断や、価格の妥当性の判断、他の機械との優劣の判断には使えません。また、使うモデルの利用条件(ライセンス)は、別の確認項目です。この点は、Mistralのオープンウェイトの回で別に扱います。
よくある疑問と読み違い
Q1. 毎秒3,000トークンは、嘘の数字ですか。 いいえ。動画の話者が、画面を見ながら話した数字です。ただし、合計の数字で、条件が語られていません。独立した測定でもありません。嘘かどうかではなく、何の数字かを確かめるのが先です。
Q2. 3,000を64人で割った約47が、1人あたりの速さですか。 いいえ。約47は、私が仮に割った数字です。動画は、3,000がいくつの同時接続での値かを述べていません。
Q3. 80台後半から90は、1人分ですか。 発言から決まりません。1人分なら、全体は約5,700になり、3,000超とは別の測定になります。合計なら、1人あたり約1.4になり、動画の主旨と合いません。どちらかは確定できません。
Q4. 748GBあれば、1兆パラメータのモデルが速く動きますか。 言えません。HPの発表は、1兆パラメータ規模のモデルによる推論処理に対応する、と述べていますが、これは載って動く、という話です。速さの保証ではありません。
Q5. スポンサー付きの動画は、信用できないのですか。 そう決めつける必要はありません。動画の話者は、スポンサーであることと、貸出機であることを、自分で話しています。この記事は、その前提を示したうえで、動画の発言を「動画の発言」として扱いました。ただし、独立した測定ではないので、数字は、条件を確かめたうえで、参考として読みます。
Q6. ZGX NanoとZGX Furyは、何が違うのですか。 公式ページで確認できる範囲では、ZGX NanoはGB10というチップで、メモリは128GBです。ZGX Furyは、メモリが748GBで、内訳は、高速なHBM3eが252GB、LPDDR5Xが496GBです。速さの違いは、公式ページに書かれていないので、この記事では比べません。
Q7. この機械は、買ったほうがよいですか。 この記事は、購入の判断を扱いません。公式ページで確認できた事実と、数字の読み方だけを書いています。
最後の確認リスト
- 示された速さの数字が、合計か1人分かを確かめたか
- 合計なら、同時に何人(何本の処理)が動いていたかを聞いたか
- どのモデルで、どの量子化で測ったかを聞いたか
- 入力と出力の長さを聞いたか
- 自社で使う人数と、1人あたりに要る速さを決めたか
- 仕様の数字と、測定の数字を、混ぜて読んでいないか
- 自分で計算した数字に、「自前計算」と書いたか
最後に、一つ質問です。社内で共有するAI機の数字を見たとき、合計か1人分かを確かめたことはありますか。コメントで教えてください。
YouTube本編:{{YOUTUBE_URL}}
公開直前の再確認:2026年11月3日に、HPとNVIDIAの公式ページを取得し直し、この記事で使った数字と記述が変わっていないことを確認しました。
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- NVIDIA DGX Station 製品ページ:https://www.nvidia.com/en-us/products/workstations/dgx-station/
- HP Japan ZGX Fury 製品ページ:https://jp.ext.hp.com/workstations/zgx_fury_ai_station/
- HP Japan ニュースリリース(2026年10月26日):https://jp.ext.hp.com/info/newsroom/2026/20261026/
- NVIDIA DGX Spark 製品ページ:https://www.nvidia.com/en-us/products/workstations/dgx-spark/
- NVIDIA RTX PRO 6000 製品ページ:https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-6000/
- HP ZGX Nano 製品ページ:https://www.hp.com/us-en/workstations/zgx-nano-ai-station.html
- 海外レビュー動画(2026年10月30日公開):https://www.youtube.com/watch?v=lEFFa0Z5BIE