「コーディングエージェントで2時間でサイトを作った」は、どこまで裏が取れるのか ── カーパシー氏のブログと公式文書を突き合わせる
結論:裏が取れるのは、サイトの件数・採用条件・機能の公式な意味まで。2時間と費用は本人の説明だけです
結論から書きます。「2時間でサイトを作った」というカーパシー氏のブログのうち、公開資料で裏が取れるのは、サイトの件数、データの採用条件、機能の公式な意味までです。2時間という時間、手順の中身、費用は、本人の説明だけで、裏は取れません。私の整理では、真似できるのは、段階ごとにモデルと推論の深さを選ぶ設計と、人が残す三つの作業の切り分けです。
この記事の対象読者は、事例記事を読んで「自分のチームでも同じことができるのか」と考える人です。具体的には、コーディングエージェントを職場に入れる前に、記事の数字がどこまで確かめられるのかを知りたい開発責任者や、情報システム部門の担当者を想定しています。
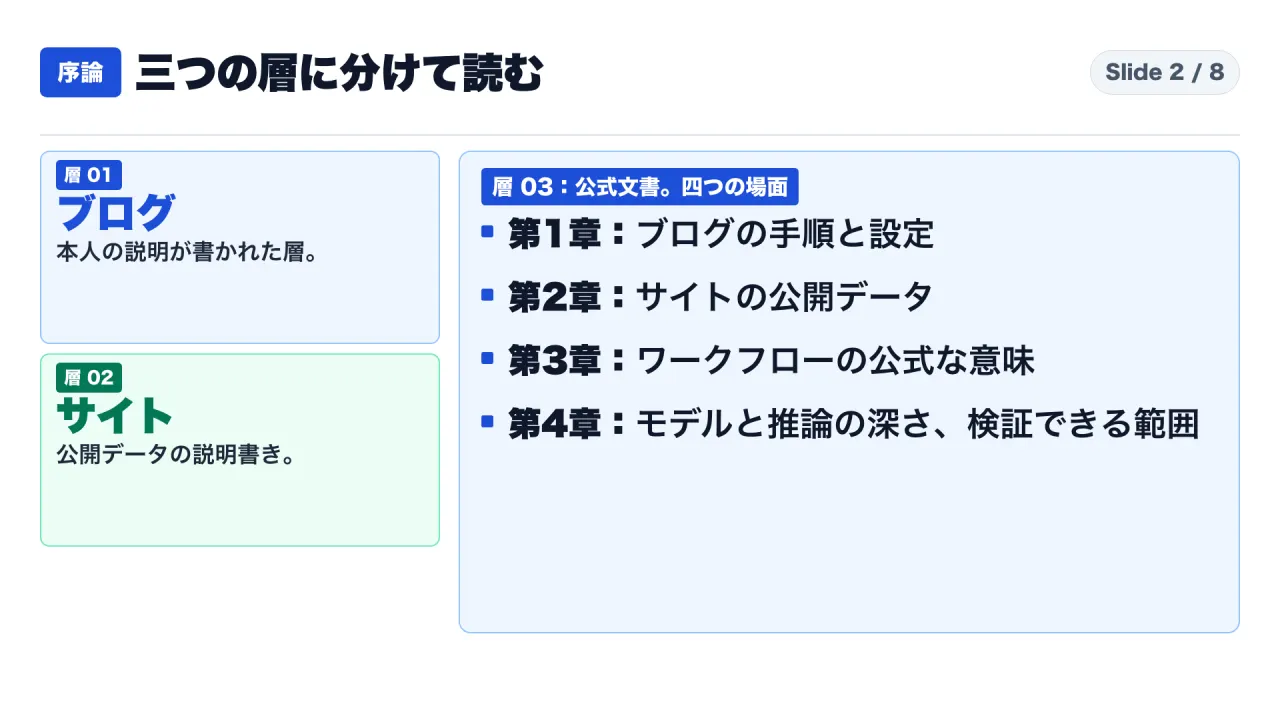
読み終えると、次の三つができるようになります。一つ目は、ブログの記述を「本人の説明」「サイトの公開データで確かめられること」「公式文書が示すこと」の三つの層に分けて読むこと。二つ目は、「約4万件のコメント」のような丸めた数字が、公開データの定義とどう違うかを確かめること。三つ目は、ワークフローとエフォートという設定の公式な意味を、自分のチームの設定に置き換えて点検することです。
この記事は、製品の宣伝も、他社のモデルとの比較も含みません。使う資料は、ブログ、サイトのデータ説明書き、Anthropicの公式文書の三種類だけです。私は、このサイトを作っておらず、ワークフローも実行していません。再現していないことを、先に断っておきます。
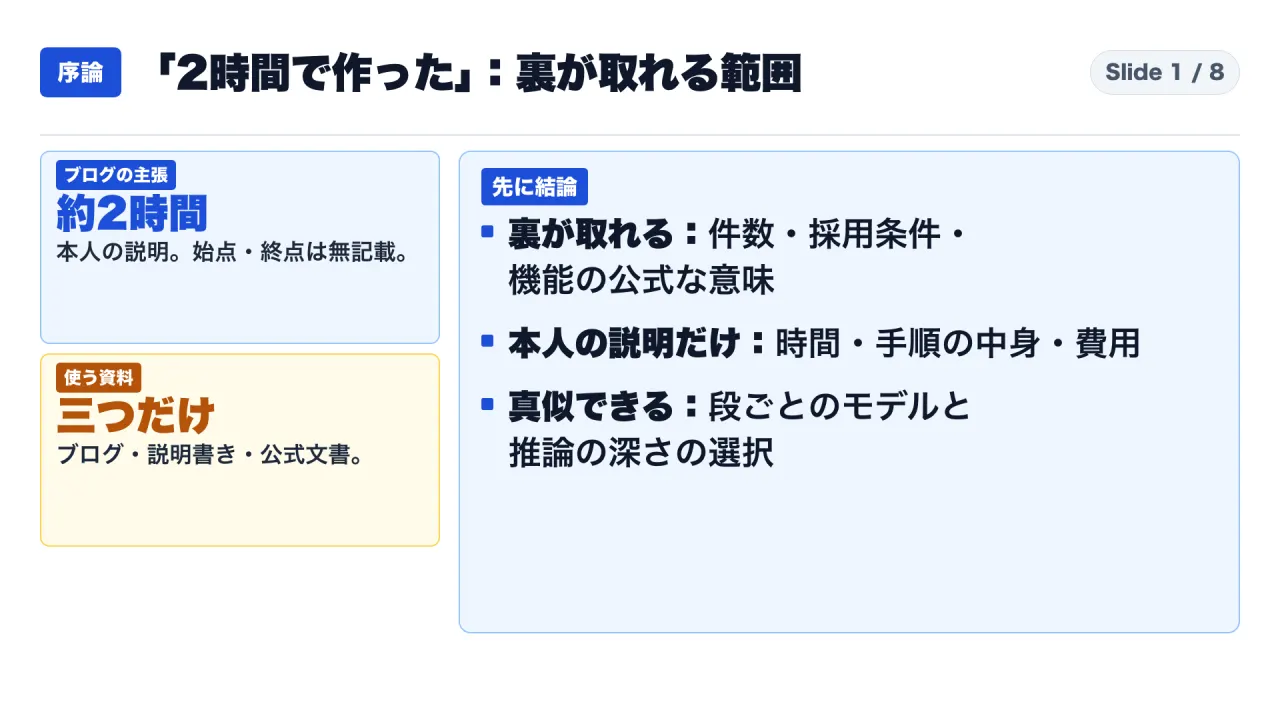
図1は、この記事全体の答えを一枚で示したものです。左に、ブログの主張である約2時間と、使う資料が三つだけであることを置きました。右に、裏が取れる範囲、本人の説明だけの範囲、真似できる設定を並べています。
読み方:本文では「本人の説明」「公開データの記載」「公式文書の記載」「私の解釈」を分けます
本文では、どの層の話かを、段落の頭で示します。
【本人の説明】は、ブログに書かれている内容です。書いたのは本人で、第三者が確認したものではありません。【公開データの記載】は、サイトが公開しているデータ説明書き(DATA.md)の内容です。サイトを作った側の説明なので、これも独立した検証ではありません。【公式文書の記載】は、Anthropicが公開している文書の内容です。自社の製品について書いたものです。【私の解釈】は、資料を読んで私が考えたことで、資料に書かれているわけではありません。
資料の取得は、2026年11月1日に行いました。ブログ、データ説明書き、公式文書のページを取得し、引用した英語の原文が、ページの本文に含まれることを機械で照合しています。
公開直前の2026年11月2日に、ブログ、データ説明書き、公式文書のページを取得し直し、2026年11月1日に取得した内容から変更がないことを確認しました。
図2は、この読み方と、記事の構成を示したものです。
第1章:ブログが書いていること。手順は四つの段階、手作業は三つ、時間は「約2時間」
【本人の説明】ブログの日付は、2026年10月31日です。本文は短く、手順、機能の一覧、時間、そして追記の四つでできています。ここでは、書かれていることを、加工せずに並べます。
きっかけは、金曜の夜11時のユーチューブでした。本人は、推薦が「同じ話題の繰り返し」で、自分には合わないと感じた、と書いています。翌土曜の朝に、手元のオーパス5.5へ、次の依頼を出した、とあります。原文は “Let’s write our own YouTube clone based on whatever videos have been recommended on Hacker News.” です。ハッカーニュースで薦められた動画をもとにした、ユーチューブ風のサイトを作る、という依頼です。
手順は、本人の説明では四つの段階です。第一に、オーパスがハッカーニュースの全コメントをダウンロードして、絞り込みます。第二に、Claude Codeの機能であるワークフローで、ソネットを走らせ、スパムを除きます。第三に、動画を薦める約4万件のコメントに絞ります。第四に、ユーチューブ風の画面に包み、ドメインを取り、ブイピーエスに置き、セキュリティを固めて、最適化します。原文は、“narrowed everything down to 40K comments recommending a YouTube video” と “get a domain, push to a VPS, secure, harden, optimize and voila!” です。
結果は、6,454本のユーチューブ動画で、2007年から2026年まで、150のトピックにわたります。ブログは、これを「ハッカーニュースの数人が薦めた動画」と説明しています。
サイトの機能として、本人は四つを挙げています。アップロード済みのサムネイルではなく、動画の途中の50%地点の画像を使うこと。アカウントなしで、ブラウザーの中に状態を保存する推薦。キーボードのショートカット。サイトのデータの書き出しです。書き出しは、エージェントに渡して、自分用の版を作りやすくするためのものだ、と書かれています。なお、ブログの機能一覧には「質の高い内容」という項目もあります。これは本人の評価であり、私は評価しません。
時間については、“This takes ~2 hours now.” とあります。「今はこれが約2時間かかる」という書き方です。いつからいつまでの2時間なのかは、書かれていません。
追記には、環境と手作業が書かれています。本人は、Claude CodeのMac版デスクトップアプリを使い、オーパス5.5を、ミディアムのエフォートで、既定として使っている、と書いています。手作業は、三つだけです。一つ目は、ユーチューブの動画情報を取るために、Google・クラウドの画面でAPIキーを作ること。二つ目は、ブイピーエスを起動すること。三つ目は、ドメインを買うことです。ブイピーエスが起動したあとは、IPアドレスをクロードに渡して、更新、デプロイ、セキュリティの強化、最適化を頼み、クロードが全部やった、と書いています。
作業の進め方についての記述もあります。本人は、クロードの実際の作業の合間に、自分の作業を入れたので、チームで作業したような感覚がある、と書いています。つまり、約2時間の中には、人が手を動かした時間が混ざっています。
最後に、本人は、従来のエンジニアリング、つまり、コードを読み書きしたり、端末でコマンドを実行したりすることは、もう何もしていない、と書いています。クロードと話すだけで、すべてやらせている、という自己申告です。これを一般的な働き方の事実として読むことはできません。本人の説明として、そのまま受け取る範囲にとどめます。
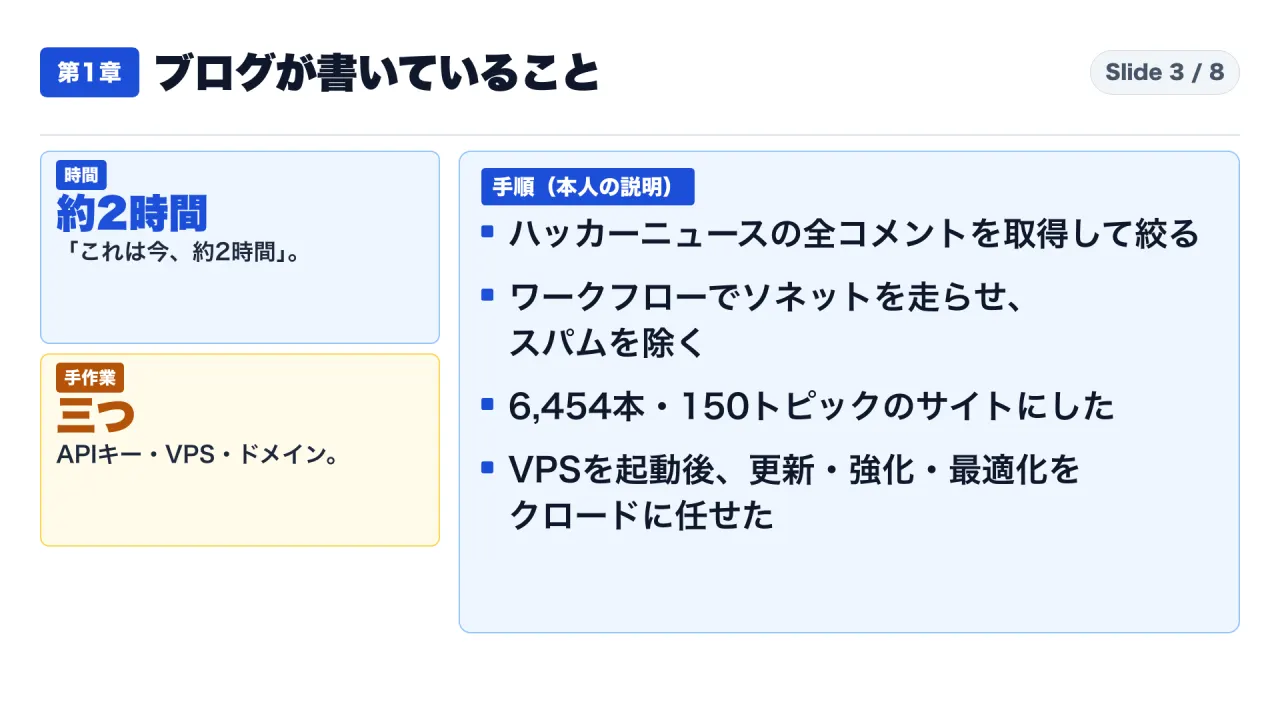
図3は、第1章の内容を一枚にしたものです。ここまでは、すべて本人の説明で、私は再現も時間の計測もしていません。
第2章:サイトの公開データ。件数は一致し、「約4万件」は推薦だけの数ではありません
【公開データの記載】サイトは、データ一式と、その説明書き(DATA.md)を公開しています。説明書きは、動画が6,454本、コメントが39,834件、分類が150、その上の領域が16、と書いています。書き出しの日付は、2026年10月31日です。ブログの6,454本と、説明書きの6,454本は、一致します。
一方、ブログの「約4万件」は、説明書きの39,834件を丸めた表現と読めます。【私の解釈】ここは私の解釈です。差は166件で、約4万という言い方自体は、不自然ではありません。問題は、件数の中身です。
ブログは、4万件を「動画を薦めるコメント」と書いています。説明書きは、39,834件を「各コメントに、コメントした人が何をしていたかのラベルを付けたもの」と書いています。推薦と数えるのは、推薦(rec)と強い推薦(strong_rec)の二種類だけです。引用(reference)、冗談(joke)、批判(critical)の言及も、件数に含まれています。原文は、“Only stance ∈ {rec, strong_rec} are recommendations. reference, joke and critical mentions also exist.” です。
動画の側にも、同じ違いがあります。説明書きは、動画を「薦められた、または少なくとも話題になった」と説明し、約25%の動画は、引用されただけで、一度も薦められていない、と書いています。原文は “About 25% of videos were only cited and never recommended” です。ブログの「数人が薦めた動画」という書き方は、この点で、説明書きの定義より狭く見えます。
次に、採用の条件です。説明書きは、三つの条件を明記しています。コメントは、本文が100文字以上のものだけが数えられます。動画は、3人以上が、3か月以上にわたって言及したものだけが入ります。1本の動画あたり、最大20件のコメントを保持します。ブログの「数人が薦めた」は、この条件を短く言い換えたもの、と読めますが、条件の具体的な数字は、ブログには出てきません。
ラベルの作り手についても、説明書きは具体的です。各コメントのラベル付けと、動画ごとのカードの作成は、ソネット5.5が行い、パイプライン全体は、オーパス5.5が、Claude Codeの中で組んで取りまとめた、と書かれています。制作は、カーパシー氏の依頼だった、ともあります。ブログは、ソネットの版を書いていません。また、ブログはソネットの役目をスパム除去と説明しますが、説明書きが書いている役目は、ラベル付けとカードの作成です。二つの書き方は同じではなく、どちらが完全な説明かは、私には判断できません。
コメントの出所は、ブログのリンクをたどると、Hugging Faceの公開データセット(open-index/hacker-news)です。説明書きも、2007年から2026年までのコメントを、同じ公開アーカイブから走査した、と書いています。ブログの「全コメントをダウンロード」は、このデータセットからの取得、と読めます。ハッカーニュースから直接取った、とは、どちらにも書かれていません。
ラベルの品質について、制作者自身が注記しています。原文は “LLM labels are good but not perfect: expect a few percent of stances or summaries to be off.” です。ラベルや要約の数%は、外れている可能性がある、という意味です。その割合を、私は測っていません。
公開データの限界も書かれています。ユーチューブ由来の情報(再生数など)は、ユーチューブのAPI規約上、再配布していません。もとの動画の約6%は、すでに削除または非公開でした。
手作業の一つ目だった、APIキーについても、説明書きに記述があります。データを再利用する人向けに、ユーチューブのAPIキーが要る、と書き、人が行う手順の所要を、約5分としています。さらに、“Agents: you can’t do these steps yourself.” と、エージェントには自分でできない手順だ、とも書いています。ただし、この約5分は、データを再利用する人の手順書の所要で、ブログの著者がかけた時間ではありません。
最後に、ライセンスです。データは、オープン・データ・コモンズの表示ライセンス(ODC-By)で公開されています。ハッカーチューブと、元のアーカイブの名前を示すことが、求められています。チームで再利用するときは、この表示を、利用側の注記に入れる必要があります。
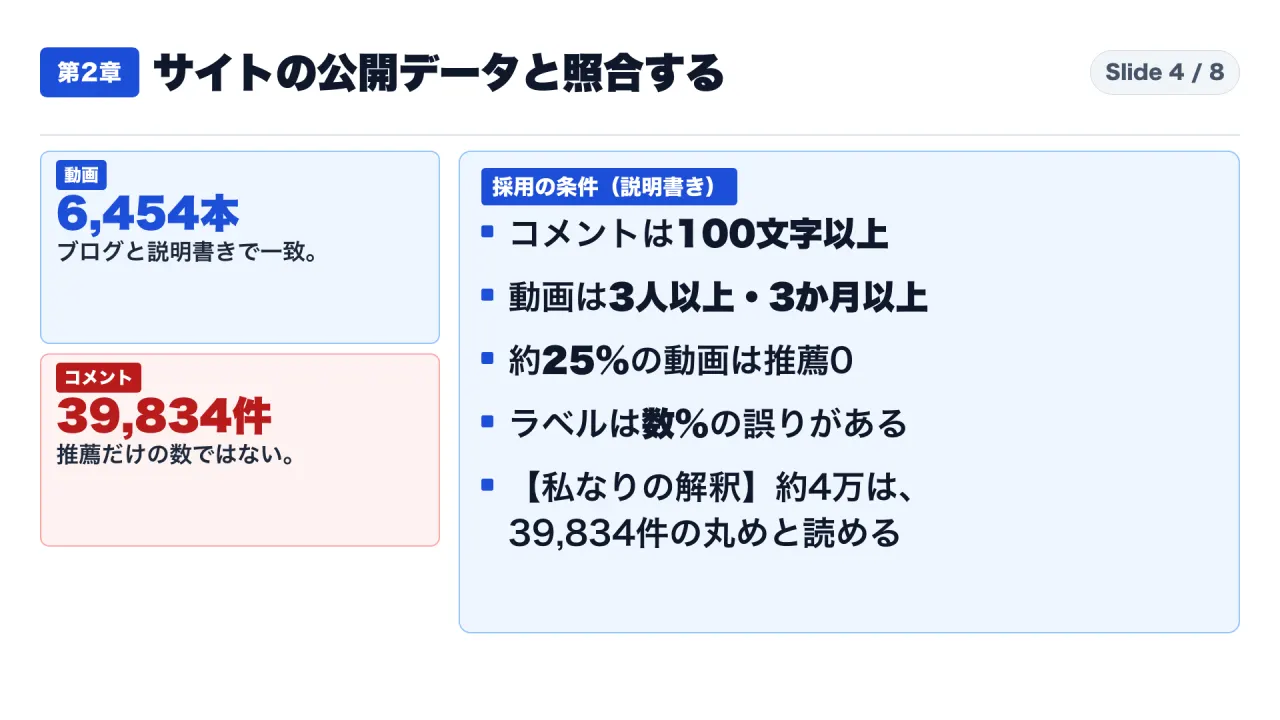
図4は、第2章の要点です。動画の6,454本は一致し、コメントの39,834件は推薦だけの数ではない、という二つを左に置きました。
第3章:ワークフローの公式な意味。スクリプトがサブエージェントを回し、使用量は利用枠に数えられます
【公式文書の記載】ブログに出てくる「ワークフロー」について、Claude Codeの公式文書は、ダイナミック・ワークフローという名前で説明しています。定義は、“A dynamic workflow is a JavaScript script that orchestrates many subagents at once.” です。ジャバスクリプトのスクリプトが、多数のサブエージェントを同時に動かす仕組みで、クロードがスクリプトを書き、実行環境がバックグラウンドで動かします。
【私の解釈】ブログの “Workflow (Claude Code feature)” と、この公式の機能が同じものだと見るのは、名前の一致からの私の推定です。ブログは、版や設定を書いていません。確度は高いと見ていますが、同一であることを示す記載は、ブログにはありません。
公式文書は、ふつうのサブエージェントやスキルとの違いを、「計画を誰が持つか」で説明します。ワークフローでは、計画がコードに移ります。ループ、分岐、途中の結果は、スクリプトが持ち、クロードの文脈には最終的な答えだけが残ります。原文は、“A workflow moves the plan into code.” です。4万件のコメントを何段階かで処理する作業は、この型に合います。ただし、ブログの作業が実際にこの型で動いたかどうかは、ブログに書かれていません。
使える範囲は、すべての有料プランです。Proでは、設定の画面で有効にします。
使用量については、公式文書が明確に書いています。“a single run can use meaningfully more tokens than working through the same task in conversation. Runs count toward your plan’s usage and rate limits.” です。1回の実行は、同じ作業を会話で進めるより、大幅に多いトークンを使いうる、そして、実行はプランの利用枠とレート制限に数えられる、という意味です。ブログには、使ったトークンも、プランも書かれていないので、この件に当てはめて、どれだけ使ったかは言えません。
大きな実行には、警告が出ます。25を超えるエージェントを予定するか、見込みのトークン合計が150万を超えると、進行の行に「Large workflow」の警告が出ます。ただし、これは助言で、実行を止めたり制限したりはしません。
モデルの選び方も、書かれています。ワークフローの各エージェントは、スクリプトが段ごとに指定したモデルで動き、指定がなければ、セッションのモデルで動きます。費用を抑える方法として、公式文書は、最も強いモデルが要らない段には、小さなモデルを使うよう、作業を頼むときに伝えることを挙げています。
【私の解釈】ブログの「オーパスが全体を取りまとめ、ソネットが大量の判定をする」という分担は、この文書の書き方と同じ型です。ただし、ブログが段ごとにモデルを指定したかどうかは、書かれていません。
制約もあります。実行中に、利用者は入力できません。同時に動くエージェントは、既定で最大16です。デスクトップ版では、承認カードに、ワークフローの名前、段の一覧、トークン使用の注意が出ます。ブログの本人は、デスクトップ版を使っています。
組織で止めることもできます。管理設定で、ワークフローの無効化を指定できます。また、試す順序として、公式文書は、大きな作業の前に、小さな部分で先に走らせて、費用の感覚をつかむよう書いています。ディレクトリ一つ、または狭い質問から、という例が挙がっています。
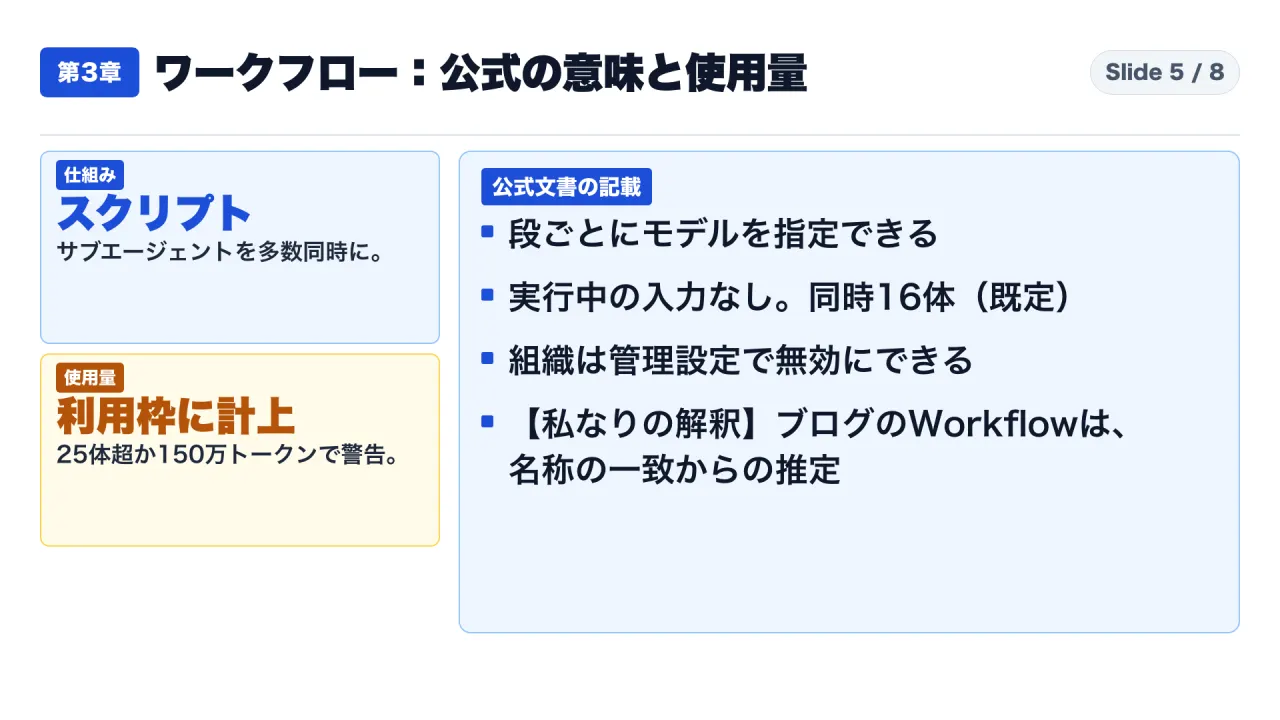
図5は、第3章の要点です。仕組みはスクリプト、使用量は利用枠に計上、という二つを左に置きました。
第4章:モデルと推論の深さ。公式ページと並べ、出所で違う点は「出所により異なる」と書きます
ブログが使ったのは、オーパス5.5です。説明書きは、ラベル付けとカード作成が、ソネット5.5だった、と書いています。ブログは、ソネットの版を書いていません。ここでは、Anthropicが公開している、オーパス5.5、ソネット5.5、ハイク5.5の三つのモデルページと、モデル一覧を、並べます。並べ方の約束は三つです。各ページが印字している項目だけを並べること。順位や優劣をつけないこと。出所で違う項目は、「出所により異なる」と書くことです。他社のモデルとの比較は、扱いません。
【公式文書の記載】各ページの用途の説明は、次のとおりです。オーパス5.5は、長時間のエージェント型のコーディングと、知識業務向け。ソネット5.5は、「速度と知能の最良の組み合わせ」。ハイク5.5は、大量で遅延に敏感な、分類、抽出、振り分け向けです。いずれもAnthropic自身のページの自己紹介です。
価格は、百万トークンあたりです。オーパス5.5は、入力4ドル、出力20ドル。ソネット5.5は、入力2ドル、出力10ドル。ハイク5.5は、入力0.10ドルから、出力0.50ドルからと「から」が付き、プロンプトが100,000トークンを超えると、入力0.50ドル、出力2.50ドルという高い単価になります。遅延は、モデル一覧の相対表示で、オーパスは「中程度」、ソネットは「速い」、ハイクは「最速」です。これはページの表示で、私の評価ではありません。実際の遅延は、プロンプトの長さ、出力の長さ、エフォートで変わる、と注記されています。コンテキスト窓は、三つとも1M(百万)トークン、最大出力は、三つとも128K(12万8千)トークンです。
| 項目 | オーパス5.5 | ソネット5.5 | ハイク5.5 |
|---|---|---|---|
| 公開日(ページの表記) | 2026年9月22日 | 2026年9月28日 | 2026年10月7日 |
| 価格(入力/出力、百万トークンあたり) | $4/$20 | $2/$10 | $0.10から/$0.50から(プロンプトが10万トークン超で別単価) |
| 遅延(モデル一覧の相対表示) | 中程度 | 速い | 最速 |
| コンテキスト窓/最大出力 | 1M/128K | 1M/128K | 1M/128K |
| 既定のエフォート(Claude Code文書) | medium | medium | medium |
| 既定のエフォート(API文書・モデルページ) | medium | high | medium |
表の最後の二行が、「出所により異なる」点です。Claude Codeの公式文書は、オーパス5.5、ソネット5.5、ハイク5.5の既定を、三つとも、ミディアムと書いています。API側の文書は、オーパス5.5とハイク5.5の既定をミディアム、ソネット5.5の既定をハイと書き、三つのモデルページも、同じ値です。つまり、オーパス5.5とハイク5.5は、どちらの文書でも同じで、ソネット5.5だけ、出所により異なります。どちらが正しい、とは言いません。
【私の解釈】モデル一覧は、この欄を「Claude API上の既定」と定義しています。文書が指す場面が違うので、矛盾というより、どの設定で使うかで既定が変わる、と読めます。ソネット5.5をチームで使うときは、自分たちがどちらの入口を使うのかを、先に確かめる必要があります。
ブログの本人は、オーパス5.5をミディアムで、既定として使う、と書いています。Claude Codeの文書では、オーパス5.5の既定がミディアムです。この二つは一致します。ただし、ブログは、設定を変えたかどうかを書いていません。あえて下げた設定だったのか、既定のままだったのかは、ブログからは決められません。【私の解釈】既定のままだった可能性はあります。
エフォートの位置づけも、公式文書にあります。ミディアムは、オーパス5.5とソネット5.5で、範囲が明確な、日常の開発作業に向く、と書かれています。例は新機能の実装です。ハイは、検証が重要で、エッジケースが起きやすい作業、たとえば、既存のコードのバグ修正が例です。また、同じ文書は、オーパス5.5のミディアムが、オーパス5のハイに、コーディングと知識業務の評価で並ぶか上回る、と書いています。これは、Anthropic自身の試験の記述で、第三者の検証ではありません。
エフォートが決まる順序は、環境変数、セッション中の選択、起動時の指定、保存した設定、モデルの既定の順です。組織は、管理設定で、エフォートの上限を決められます。注意点が一つあります。オーパス5.5では、ユーザー設定ファイルの旧い形の最上位の設定は、数えられません。個別に選ぶまで、モデルの既定から始まります。
同じ名前でも、別のモデルになる場合があります。Claude Codeの、オーパス、ソネット、ハイクという名前は、Anthropic APIでは、5.5世代を指します。ベッドロックなど一部の接続先では、ソネットとハイクは、どちらも4.5を指します。チームの接続先によって、同じ名前で使うモデルが変わりうる、ということです。
最後に、費用の注意です。この記事では、ブログの費用も、トークン量も、計算しません。ブログに、トークン数も、プランも、やり取りの回数も、書かれていないからです。価格表は、掛け合わせる入力がないので、使いません。
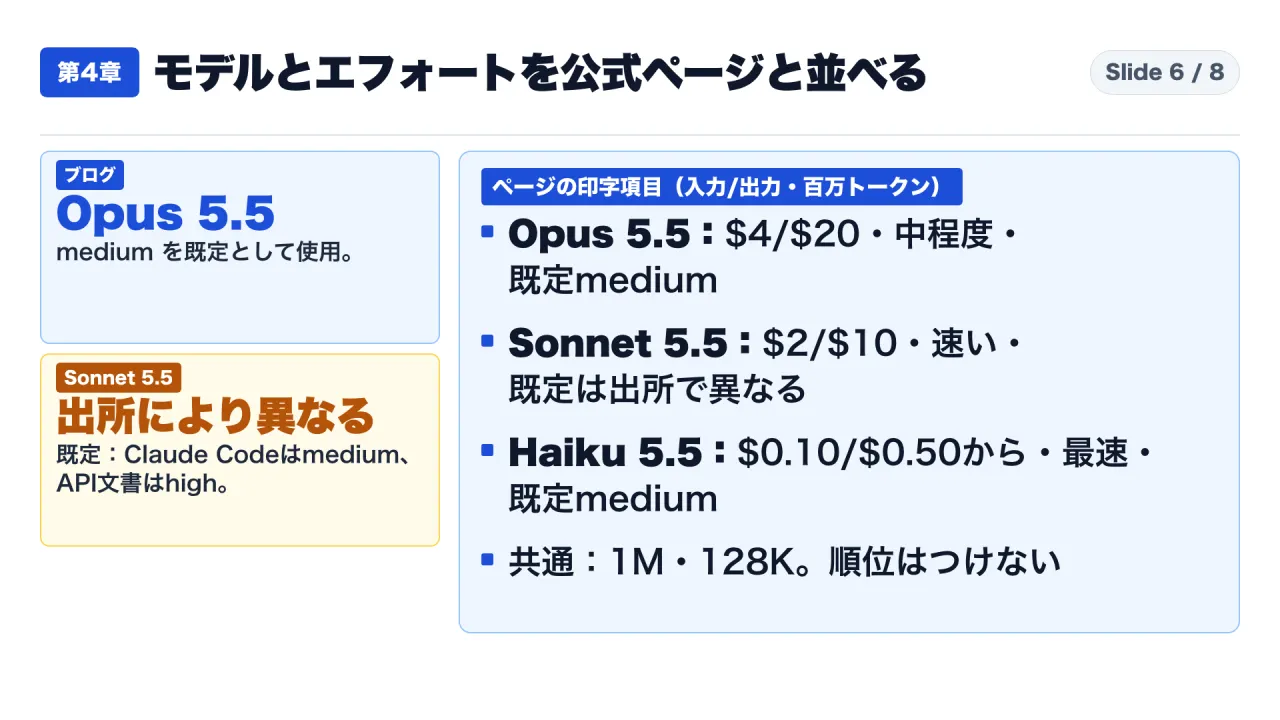
図6は、第4章前半の要点です。左に、ブログが使ったオーパス5.5のミディアムと、ソネット5.5の既定が出所により異なることを置きました。
検証できる範囲:裏が取れるもの、本人の説明だけのもの、広さや書き方に違いがあるもの
ここまでの内容を、ブログの主張ごとに、三つに分けます。
裏が取れるのは、動画6,454本、2007年から2026年、150のトピックという件数です。サイトの公開データの説明書きと一致します。オーパス5.5とソネット5.5が使われた、という点も、ブログと説明書きで一致します。ただし、説明書きはサイトを作った側の説明で、独立した検証ではありません。
本人の説明だけのものは、四つです。約2時間という時間。手作業が三つだけだったこと。従来のエンジニアリングを、もうしていないこと。ブイピーエス起動後の指示と、その結果です。「約2時間」は、始点と終点が書かれておらず、人の作業は、クロードの作業の合間に入っています。
「一発で作った」という言い方は、ブログには出てきません。ブログにあるのは、約2時間、三つの手作業、ブイピーエス起動後の追加の指示です。やり取りの回数は、書かれていません。私は、X上の投稿そのものは取得していません。ブログの記述からは、「一発で」と言い切れない、と判断します。
広さや書き方に違いがあるものは、三つです。一つ目。約4万件は、推薦だけの数ではない。二つ目。ソネットの役目は、ブログではスパム除去、説明書きではラベル付けとカード作成で、書き方が違う。三つ目。6,454本は、数人が薦めた動画というより、3人以上、3か月以上、100文字以上の条件を通った動画で、約25%は推薦がありません。
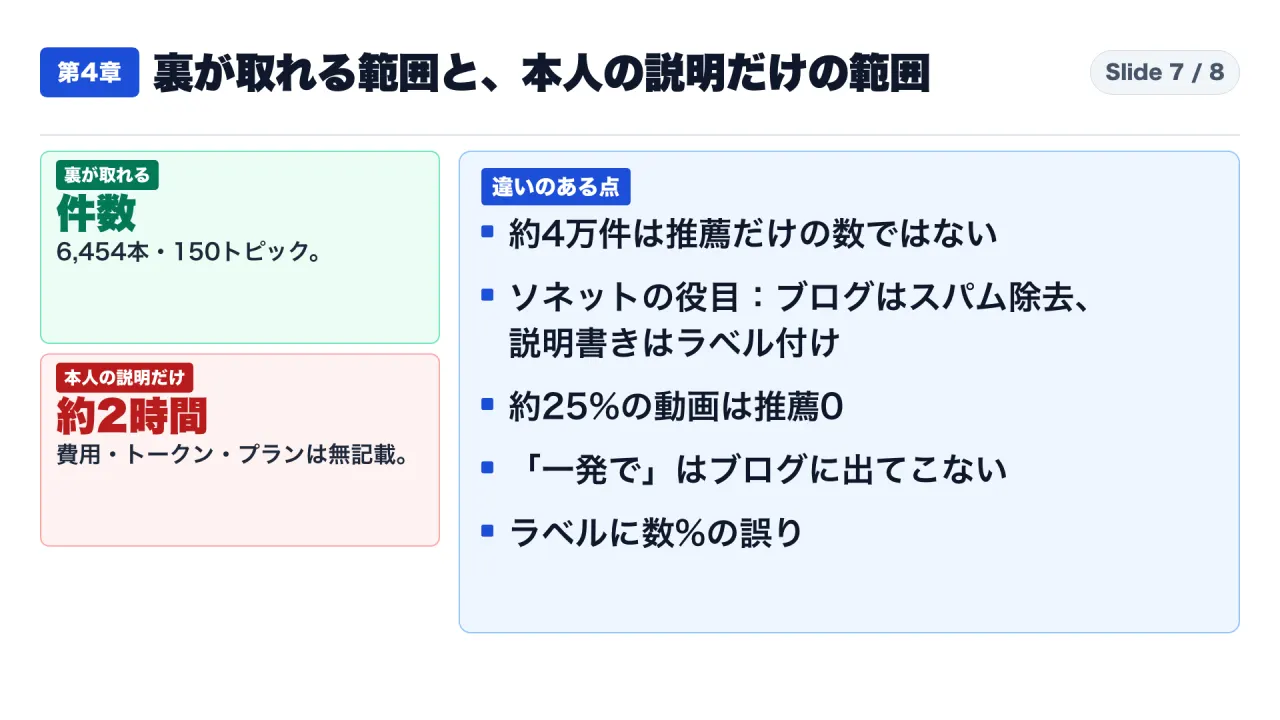
図7は、この三つの分け方を、一枚にしたものです。
| ブログの主張 | 層 | 判定 |
|---|---|---|
| 6,454本・2007〜2026年・150トピック | 公開データの記載 | 一致(件数) |
| 約4万件のコメント | 公開データの記載 | 39,834件の丸め。推薦だけの数ではない |
| ソネットがスパムを除いた | 本人の説明/公開データの記載 | 書き方が違う(説明書きはラベル付けとカード作成) |
| 約2時間 | 本人の説明のみ | 始点・終点なし。裏は取れない |
| 手作業は三つだけ | 本人の説明のみ | 裏は取れない(APIキーが人の手順である点は説明書きと整合) |
| 従来のエンジニアリングをもうしていない | 本人の説明のみ | 自己申告 |
| 一発で作った | ブログに記載なし | 言い切れない |
| トークン・費用・プラン | ブログに記載なし | 数字を出さない |
補足:「約2時間」を検証するには、何が要るのか
「約2時間」を裏づけるには、少なくとも次の五つが要ります。ブログには、このうちどれも書かれていません。
一つ目は、始点と終点です。金曜の夜の不満から始まるのか、土曜の朝の依頼から始まるのか、サイトを公開した時点で終わるのかによって、時間は変わります。ブログは、土曜の朝に依頼した、と書きますが、公開の時刻は書いていません。二つ目は、人が手を動かした時間と、クロードが動いていた時間の内訳です。本人は、クロードの作業の合間に自分の作業を入れた、と書いています。つまり、2時間の中に、待ち時間と、人の作業が混ざっています。
三つ目は、やり取りの回数です。「一発で作った」と読まれることがありますが、ブログには、回数の記載がありません。依頼を一回で済ませたのか、何十回も指示を出したのかで、チームが真似するときの負担は、大きく変わります。四つ目は、使ったトークン量と、契約プランです。公式文書は、ワークフローの1回の実行が、会話で進めるより大幅に多いトークンを使いうる、と書いています。ですから、トークン量が分からないまま、「2時間」だけを持ち帰ると、利用枠への影響を見誤るおそれがあります。五つ目は、第三者による再現です。私が確認した範囲では、見つかっていません。
この五つがそろえば、「約2時間」は、検証できる主張になります。いまは、本人の説明として、そのまま受け取る範囲にとどまります。これは、本人の記録が誤りだ、という意味ではありません。裏が取れるかどうかと、正しいかどうかは、別の問いです。
結論:真似できる設定は、段ごとのモデルと推論の深さの選択、人が残す作業の切り分け、小さく試す順序です
最初の問いに戻ります。本人の記録のうち、裏が取れるのは、件数、採用条件、機能の公式な意味までです。約2時間、手作業が三つだけだったこと、従来のエンジニアリングをもうしていないこと、費用は、本人の説明だけです。
真似できる設定を、公式文書の記載に沿って、五つ並べます。これは私の整理です。
一つ目は、段ごとに、モデルを選ぶことです。ワークフローは、段ごとにモデルを指定できます。強いモデルが要らない段には、小さなモデルを使えます。
二つ目は、エフォートを明示することです。決まる順序は、環境変数、セッション中の選択、起動時の指定、保存した設定、モデルの既定です。組織は、管理設定で、上限とモデルの許可リストを決められます。ブログの「ミディアムを既定として使う」は、既定のままだったのか、選んだのかが分からないので、チームでは、どの値で動かすかを明記しておくと、あとから確かめられます。
三つ目は、小さく試すことです。使用量は、プランの利用枠に数えられます。先に小さな部分で走らせて、進行の画面で、トークン使用を見ます。組織全体でワークフローを止める設定もあります。
四つ目は、人が残す作業を、書き出すことです。ブログでは、APIキーの作成、サーバーの起動、ドメインの購入の三つでした。説明書きも、ユーチューブのAPIキーは、人が行う手順と書いています。自分のチームでは、承認、課金、外部サービスの認証のように、人が残す作業を、先に一覧にしておくことになります。
五つ目は、公開データを使うなら、ラベルの数%の誤りと、ライセンスの表示を、利用側の注記に入れることです。
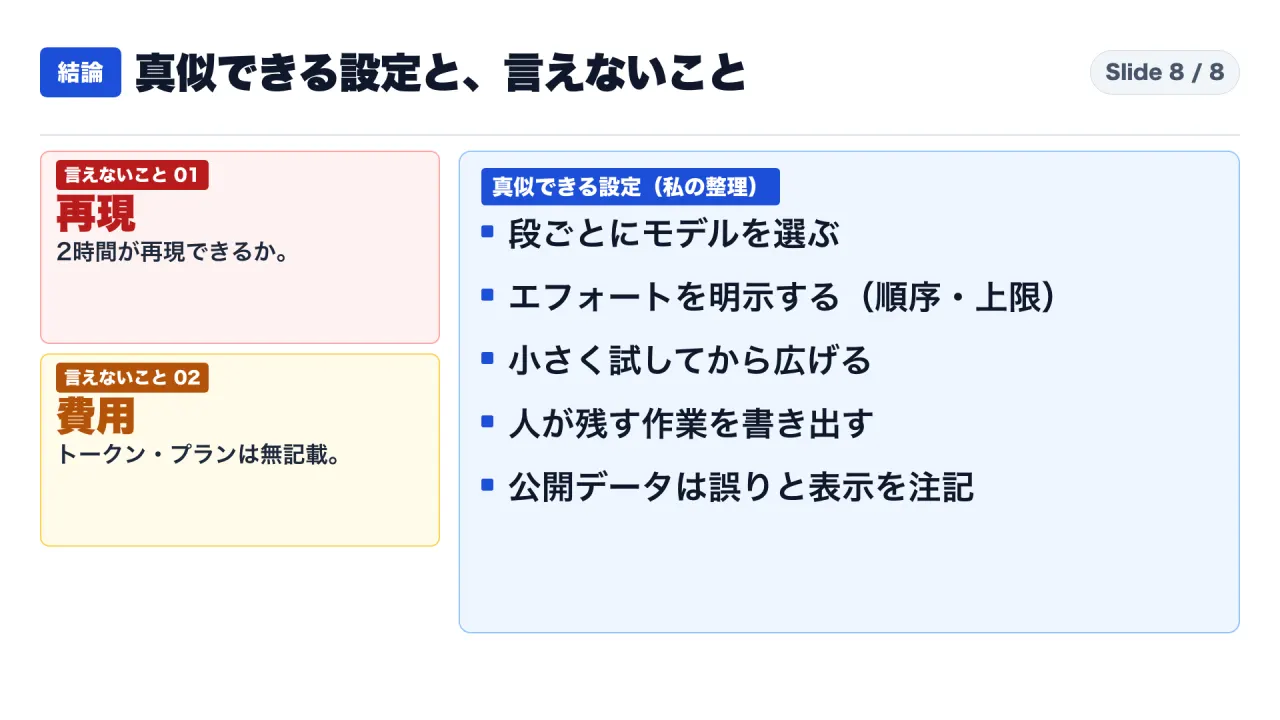
図8は、結論の一枚です。左に言えないこと、右に真似できる設定を置きました。
補足:チームの設定に置き換えるときの具体的な点検
公式文書の記載を、チームの設定に置き換えるときの点検項目を、もう少し具体的に書きます。これも私の整理で、公式文書にある助言そのものではありません。
モデルの指定では、まず、自分たちがどの入口でモデルを呼ぶのかを確かめます。Claude Codeの文書では、オーパス、ソネット、ハイクという名前が、Anthropic APIでは5.5世代を指し、ベッドロックなど一部の接続先では、ソネットとハイクが4.5を指す、と書かれています。同じ名前でも、動くモデルが変わりうるので、チームの設定には、名前だけでなく、解決先も記録しておくと、あとで食い違いを追えます。
エフォートでは、どの値で動かすかを、管理設定、環境変数、セッション中の選択のどれで決めるのかを、先に決めます。公式文書の順序では、環境変数が最優先で、モデルの既定が最後です。ですから、個人がセッション中に選んだ値が、保存した設定より優先され、管理者が決めたつもりの値が、個人の選択で上書きされることがあります。組織の上限を、管理設定で置くと、上限を超える指定は、上限の値で動きます。また、オーパス5.5では、旧い形の最上位の設定が数えられない、と書かれているので、古い設定ファイルを引き継いだチームは、値が効いているかどうかを、実際に確かめる必要があります。
ワークフローでは、利用枠への影響を、先に小さな範囲で測ります。公式文書は、ディレクトリ一つや、狭い質問から始めるよう書いています。進行の画面には、エージェントごとのトークン使用が出る、とも書かれています。25を超えるエージェントか、150万トークンの見込みを超えると警告が出ますが、警告は助言で、止めるものではありません。チームで上限を決めたいときは、警告に頼らず、自分たちで、上限の運用を決めておく必要があります。
人が残す作業では、ブログの三つの手作業が、参考になります。外部サービスのキーの作成、サーバーの起動、ドメインの購入は、いずれも、課金や認証が絡みます。説明書きも、キーの作成は、エージェントには自分でできない手順だ、と書いています。自分のチームで、エージェントに任せない作業を、先に決めておくと、「任せすぎた」という事故を、減らせます。
この記事で言えないこと
一つ目。約2時間という時間が、再現できるかどうか。時間の始点と終点、やり取りの回数、プラン、トークン量が分からないので、条件が決まりません。
二つ目。費用、トークン量、契約プラン。ブログに書かれておらず、公式文書も、ワークフローの使用量が大きくなりうる、と書くだけです。
三つ目。同じ設定で、同じ成果が出るかどうか。第三者が再現した資料は、私が確認した範囲では、見つかっていません。
四つ目。ハッカーチューブの内容の質。ブログの「質の高い内容」は、本人の評価です。私は評価していません。
五つ目。他社の製品との比較や、導入すべきかどうかの判断。この記事では扱いません。
準備では、引用したブログとデータ説明書き、公式文書の英語の原文を、取得したページの本文と、一つずつ突き合わせました。
補足:ブログの手順を、公式文書の言葉に置き換えて読む
ブログの手順を、公式文書の言葉に置き換えると、どこまでが公式に説明されていて、どこからが本人の説明だけなのかが、はっきりします。これは私の整理です。
ブログの「ソネットをワークフローで走らせた」は、公式文書の「スクリプトが多数のサブエージェントを動かし、段ごとにモデルを指定できる」に対応します。公式文書は、この仕組みの定義、使用量が利用枠に数えられること、警告の条件、同時に動く数の既定、実行中に入力できないことを書いています。ここまでは、公式に確かめられる部分です。一方で、ブログが何体のエージェントを動かしたのか、段をいくつに分けたのか、ソネットとオーパスのどちらがどの段を担当したのかは、書かれていません。
ブログの「ミディアムのエフォートを既定として使う」は、公式文書の「オーパス5.5の既定はミディアム」に対応します。公式文書は、ミディアムの位置づけ、決まる順序、組織の上限を書いています。ただし、ブログの作業が、この位置づけに合っていたかどうかは、公式文書からは言えません。公式文書が例に挙げるのは、範囲が明確な、日常の開発作業です。サイトを一から作る作業が、この範囲に入るかどうかは、読み手が判断することになります。
ブログの「ブイピーエスに置き、セキュリティを固め、最適化した」は、公式文書にも、データ説明書きにも、対応する記述がありません。本人は、クロードに全部やらせた、と書いていますが、何をどう固めたのか、どの範囲を最適化したのかは、書かれていません。ですから、この部分を、チームの手順として真似するには、別の確認が要ります。たとえば、公開するサーバーの設定を、人が点検する手順を、チームで決めておく必要があります。これは助言であって、ブログや公式文書に書かれた内容ではありません。
ブログの「全コメントをダウンロードして絞り込んだ」は、データ説明書きの採用条件と、公開アーカイブの記述に対応します。説明書きは、どの条件で絞ったかを具体的に書いています。ここは、ブログより説明書きのほうが、確かめやすい部分です。
このように、ブログの一つひとつの記述を、確かめられる資料の有無で分けると、記事全体を信じるか疑うかの二択ではなく、部分ごとに扱いを変えられます。
補足:なぜ三つの層に分けて読むのか
事例記事は、本人が成果を伝えるために書いた文章です。数字や時間が、読み手に強く残るのは自然なことですが、書き手の記憶や、言い換えの癖が入ります。一方、公開データの説明書きは、サイトを作った側が、データを使う人のために書いた文書で、定義や条件が具体的です。公式文書は、製品の挙動を、製品の側が説明したもので、設定の意味が書かれていますが、自社の製品についての記述です。
この三つは、書いた人も目的も違います。ですから、一つの層だけで結論を出すと、見落としが出ます。ブログだけを読むと、「約4万件が全部推薦」と読めます。説明書きまで読むと、推薦以外も含まれることが分かります。公式文書まで読むと、ワークフローの使用量が利用枠に数えられることが分かり、「2時間」だけを持ち帰る危うさが見えます。三つを並べて読むことで、どの部分が確かめられ、どの部分が本人の説明にとどまるのかが、見えてきます。
補足:事例記事を読む五つの手順
今回の突き合わせで使った手順を、他の事例記事にも使える形にまとめます。これは私の整理です。
一つ目は、数字を拾うことです。件数、時間、割合、費用など、記事の数字を全部書き出します。今回は、6,454本、150トピック、約4万件、約2時間、50%の五つが、主な数字でした。二つ目は、その数字の定義を探すことです。数字の出所が公開されていれば、定義も公開されているはずです。今回は、サイトのデータ説明書きがそれにあたり、約4万件の中身が、推薦だけではないことが分かりました。
三つ目は、条件を確かめることです。採用の条件や、除外の条件が書かれていれば、記事の言い換えが、条件を狭めたり広げたりしていないかを見ます。今回は、100文字以上、3人以上、3か月以上、1本あたり最大20件という条件が、記事では「数人が薦めた」と短く言い換えられていました。四つ目は、設定の公式な意味を、公式文書で確かめることです。記事の「ワークフロー」や「ミディアム」が、公式には何を指すのかを読みます。今回は、ワークフローの使用量が利用枠に数えられること、ミディアムが一部のモデルの既定であることが分かりました。
五つ目は、書かれていないことを、書かれていないと書くことです。今回は、トークン、費用、プラン、やり取りの回数、いつからいつまでか、の五つが、書かれていませんでした。空白を、推測で埋めると、記事の主張が、いつのまにか、自分の主張にすり替わります。
最後の確認リスト
- ブログや事例記事の数字を、「本人の説明」と「公開データの定義」に分けて読んだか
- 「約4万件」のような丸めた数字の中身(推薦だけか、引用や冗談も含むか)を、説明書きで確かめたか
- ワークフローの段ごとのモデルと、エフォートの値を、チームの設定として明記したか
- 使うモデルの既定のエフォートが、自分たちの入口(Claude Codeか、APIか)でどの値かを確かめたか
- 大きな作業の前に、小さな部分で試し、トークン使用を見たか
- 人が残す作業(認証、課金、承認)を、書き出したか
- 公開データを使うなら、ラベルの誤りとライセンスの表示を、注記に入れたか
最後に、一つ質問です。皆さんのチームでは、エージェントに任せる作業と、人が残す作業を、書き出していますか。コメントで教えてください。
YouTube本編:https://youtu.be/tpAERdC85Wo
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- カーパシー氏のブログ「HackerTube」:https://karpathy.bearblog.dev/hacker-tube/
- HackerTube データ説明書き(DATA.md):https://hackertube.org/download/DATA.md
- Claude Code 公式文書:ダイナミック・ワークフロー:https://code.claude.com/docs/en/workflows.md
- Claude Code 公式文書:モデル設定:https://code.claude.com/docs/en/model-config.md
- Claude API 公式文書:effort:https://platform.claude.com/docs/en/build-with-claude/effort.md
- Claude API 公式文書:モデル一覧:https://platform.claude.com/docs/en/about-claude/models/overview.md
- Claude Opus 5.5 モデルページ:https://platform.claude.com/docs/en/models/opus-5-5/overview.md
- Claude Sonnet 5.5 モデルページ:https://platform.claude.com/docs/en/models/sonnet-5-5/overview.md
- Claude Haiku 5.5 モデルページ:https://platform.claude.com/docs/en/models/haiku-5-5/overview.md