NISQA 4.33・PESQ 2.57は、自分の会議録音やポッドキャスト音声に使ってよい根拠になるか ── NVIDIAのRE-USEの表を読む
YouTubeポッドキャスト本編(動画・音声)はこちら:NISQA 4.33・PESQ 2.57は、自分の会議録音やポッドキャスト音声に使ってよい根拠になるか ── NVIDIAのRE-USEの表を読む
動画:https://youtu.be/HgldXww6jMQ
結論:数字は「試す価値」の入口にはなるが、使ってよいかを決める根拠にはならない
結論から書きます。NVIDIAの音声ノイズ除去モデル「RE-USE(リユース)」の公開カードには、NISQA(ニスカ)が4.33、PESQ(ペスク)が2.57という値が載っています。これは、カードの全体集合の表にある、RE-USEの行の値です。ただし、この値は、合成して作った劣化の音声で測ったものです。日本語を測った列は、カードの表にありません。
私の判断は、この数字は「試してみる価値があるか」を決める入口にはなるが、自分の会議録音やポッドキャスト音声に使ってよいかを決める根拠にはならない、というものです。使ってよいかは、自分の録音を処理の前後で聞き比べて決めます。この判断は私のもので、カードにも論文にも書かれていません。
この記事の対象読者は、会議録音やポッドキャスト音声の音質改善に、オープンなノイズ除去モデルを使おうとしている方です。具体的には、議事録の元になる録音を整えたい業務担当者、自分の番組の音声を整えたい配信者、そしてモデルの紹介記事やX投稿の数字を見て、導入を検討し始めた技術担当者を想定しています。ベンチマークの表を一度も読んだことがなくても、読み進められるように書きました。
読み終えると、次の三つができるようになります。一つ目は、表の数字が、どんな試験集合の、どんな指標の値なのかを言えること。二つ目は、表で「負けている列」と、数字が高くても内容が変わる例を、自分で見つけられること。三つ目は、自分の録音で何を耳で確かめるかを、手順として持てることです。
なお、この記事は、モデルの優劣を決めるものではありません。企業の評価や売買の判断、法律の判断も含みません。私は、モデルの重みを取得しておらず、自分の録音で聞き比べてもいません。使う資料は、Hugging Faceの製品カード、関連するカード、論文、ライセンスの本文、NVIDIA AIのX投稿ページ、指標の定義にあたる二本の論文のページとITUのページだけです。
図1は、この記事全体の答えを一枚で示したものです。RE-USEの全体集合の値は、NISQAが4.33、PESQが2.57です。試験は合成した劣化の音声で行われ、日本語を測った列は、表にありません。
読み方:本文では「資料の記載」「自前の換算」「私の解釈」を分けて書きます
本文では、三つの区別を守ります。
「資料の記載」は、カード、論文、ライセンス、各ページに書かれている内容です。カードや論文は、NVIDIAの研究者が自分たちのモデルについて書いたものです。第三者が検証した値ではありません。「自前の換算」は、公表された値から私が計算した値です。「私の解釈」は、資料を読んで私が考えたことで、資料に書かれているわけではありません。
資料の扱いには、四つの制約があります。
一つ目は、取得の方法です。2026年11月1日に、curlで原文を取得しました。カードのページは、画面の描画にJavaScriptを使うため、同じリポジトリのREADMEの原文を使っています。論文のPDFは、テキストに変換して、1行ずつ照合しました。
二つ目は、モデルの重みを取得していないことです。推論は実行していません。音声の聞き比べもしていません。
三つ目は、比較相手の一次資料を見ていないことです。Sidon(シドン)とUniPASE(ユニパス)のパラメータ数は、カードの表の記載で、それぞれの一次資料では確かめていません。
四つ目は、表の太字の意味です。カードの表には、いくつかの値に太字が付いています。太字の意味は、カードに説明がありません。この記事では、最良を示すと読みました。
日付は、次のとおりです。カードの公開日は、2026年10月22日と書かれています。時刻や時間帯の記載はありません。X投稿は、日本時間の10月31日5時15分です。これは、投稿ページが埋め込む時刻のミリ秒の値(1793391304000)を、世界標準時の10月30日20時15分に直し、9時間を足した、私の換算です。研究用の元モデルは、3月18日に公開されたと、元のカードに書かれています。論文は、arXivに2026年3月3日に提出され、10月6日に第4版が出ています。
図2のとおり、確かめる点は四つです。モデルの中身と訓練データ、表の試験の条件と指標の種類、同じ試験集合での比較、そして公開版と論文の違い、ライセンス、自分の耳で確かめる手順の順に見ていきます。
第1章:モデルの中身。9.6Mのパラメータ、双方向のMamba、訓練データに日本語の表記はない
補聴器を、静かな店のカウンターで試して、騒がしい会議室でも合うと決めてよいでしょうか。これはたとえ話です。モデルの数字も同じで、どこで測った値かを先に確かめる必要があります。
規模と構造
RE-USEのカードは、これを「9.6-million-parameter」の、多言語の汎用音声強調(universal speech enhancement、USE)モデルと説明しています。パラメータ数は9.6Mで、つまり約960万です。960万という書き方は、私の換算です。構造は、畳み込みの符号化と復号の間に、双方向のMamba(マンバ)を30層重ねたものだと、カードに書かれています。
入力できる周波数は、カードでは、8、16、22.05、24、32、44.1、48キロヘルツが挙げられています。入力は、8000ヘルツから48000ヘルツの、モノラルの音声です。出力も同じ範囲の、wavファイルです。つまり、ステレオのまま入れるモデルではありません。会議録音がステレオの場合は、モノラルに直す手順が別に要ります。この点は、カードが書いている範囲から、私が読み取ったことです。
対象にする劣化は、カードでは、加法性の雑音、残響、音割れ、帯域制限、コーデックの劣化、パケット損失、低品質のマイクです。
訓練データ
訓練に使った音声は、約2,500時間で、単一話者です。カードは、収集の方法とラベル付けの方法を、どちらも合成(Synthetic)と書いています。雑音のデータと、部屋の響きのデータも、別に挙げています。
音声データの内訳は、カードの一覧では、次のとおりです。DNS5チャレンジのLibriVox(英語)、LibriTTS(英語)、VCTK(英語)、WSJ(英語)、Multilingual Librispeech(ドイツ語、英語、スペイン語、フランス語)、CommonVoice 19.0(ドイツ語、英語、スペイン語、フランス語、中国語)、そして、社内データと書かれたRiva Speakersです。
この一覧に、日本語の表記はありません。ただし、Riva Speakersは社内データで、中身がカードに書かれていません。そのため、この記事では「訓練データに日本語がない」とは書きません。「公開された一覧に日本語の表記がない」と書きます。論文のデータ説明も、英語、ドイツ語、フランス語、スペイン語、中国語の五言語です。
カードは、このモデルを「言語を問わない」強い能力がある、と説明しています。訓練の一覧にない言語で何が起きるかは、第4章で、論文の日本語の結果を見ます。
重なった発話
カードには、注記が一つあります。重なった発話については、主な話者を残し、ほかの話者を抑えるように訓練した、というものです。
ここは私の解釈です。会議の録音では、複数の人が同時に話す場面があります。その場面で、主な話者でない人の声が抑えられる可能性があります。議事録に要る発言が消えていないかは、聞いて確かめる点です。
使い道の記載
カードは、使い道の例として、コンテンツ制作者が録音の音質を上げることを挙げています。研究者が、音声合成の学習データの音質を上げることも挙げています。ただし、表の試験は、次の章のとおり、合成した劣化の音声です。使い道の記載と、評価の条件は、別の話です。
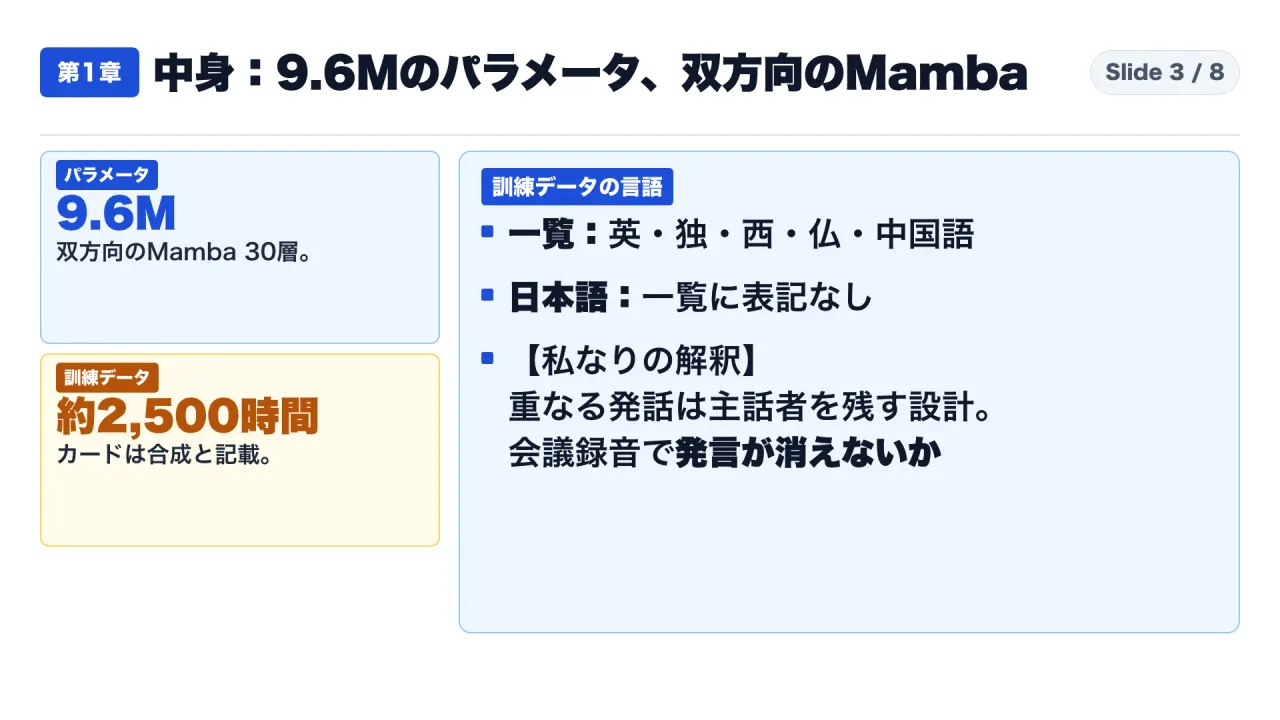
図3は、この章の要点です。パラメータは9.6Mで、双方向のMambaが30層あります。訓練データは約2,500時間で、カードは合成と書いています。
第2章:表の読み方。試験集合は合成の劣化、PESQは基準の音声が要る
試験の集合
カードの表の試験集合は、URGENT(アージェント)2025の「non-blind test set」です。カードは、元の無響のきれいな音声を基準にして評価した、と書いています。収集の方法は、合成(Synthetic)です。論文は、試験の規模を1,000発話と書いています。
カードの表は、一つではありません。全体の集合に加えて、16キロヘルツの集合、44.1キロヘルツの集合、48キロヘルツの集合の、四つの表があります。
論文は、URGENT 2025の劣化を、七つの種類として書いています。加法性の雑音、残響、音割れ、帯域制限、コーデックの劣化、パケット損失、風の雑音です。カードが挙げる劣化の一覧は、風の雑音のかわりに、低品質のマイクが入っています。この違いの理由は、資料に書かれていません。
指標の種類
表には、多くの指標の列があります。この記事で扱う六つは、NISQA、PESQ、DNSMOS(ディーエヌエスモス)、UTMOS(ユーティーモス)、SBERT(エスバート)、文字正解率です。
論文は、指標を二つに分けています。基準になるきれいな音声が要る指標と、要らない指標です。PESQは、基準が要る側に入ります。NISQA、DNSMOS、UTMOSは、きれいな基準なしに品質を予測する指標、と論文は書いています。文字正解率は、カードによると、音声認識(OWSM)で、文字がどれだけ合ったかの値です。SBERTは、SpeechBERTScoreの略だと、カードの表の下に書かれています。
NISQAの論文の要旨は、通信網で起きる劣化に向けた品質の予測モデルで、全体の品質に加えて、雑音感、音色、不連続、音量の四つを予測する、と書いています。DNSMOS P.835の論文の要旨は、人間の評価で訓練した指標で、音声の品質(SIG)、背景雑音の品質(BAK)、全体の品質(OVRL)の三つの値を出す、と書いています。
PESQの位置づけ
PESQは、国際電気通信連合(ITU)の勧告P.862にあたる指標で、狭帯域の電話網と音声コーデックの、客観評価法です。ところが、ITUのそのページには、P.862、P.862.1、P.862.2、P.862.3は古くなり、2024年1月5日に削除された、P.863、P.863.1、P.863.2を参照する、と書かれています。
ここは私の解釈です。勧告が削除されたことと、論文がPESQを使う理由は、別の話です。PESQが、電話網向けに作られた指標だと分かったうえで、数字を読む、という使い方になります。
基準の音声の選び方
基準の音声の選び方でも、数字は変わりえます。論文は、公式の順位表では、基準が、早期反射の入った音声だと書いています。自分たちのモデルの訓練目標は、時間をずらした無響の音声です。論文は、この定義のずれが、PESQなどの基準が要る指標で、自分たちの得点を不利にしうる、と書いています。
実際、雑音入力の行のPESQは、論文の表1が1.37、カードの全体集合の表が1.34です。この差の理由を、私は確かめていません。表によって値が違う、という事実だけを書きます。
カードの全体集合の表で、雑音入力の行は、NISQAが1.69、PESQが1.34、文字正解率が81.29です。RE-USEの行は、NISQAが4.33、PESQが2.57、文字正解率が89.17です。この対比が、「処理で、数字がこれだけ動いた」という、カードの表の言い分です。
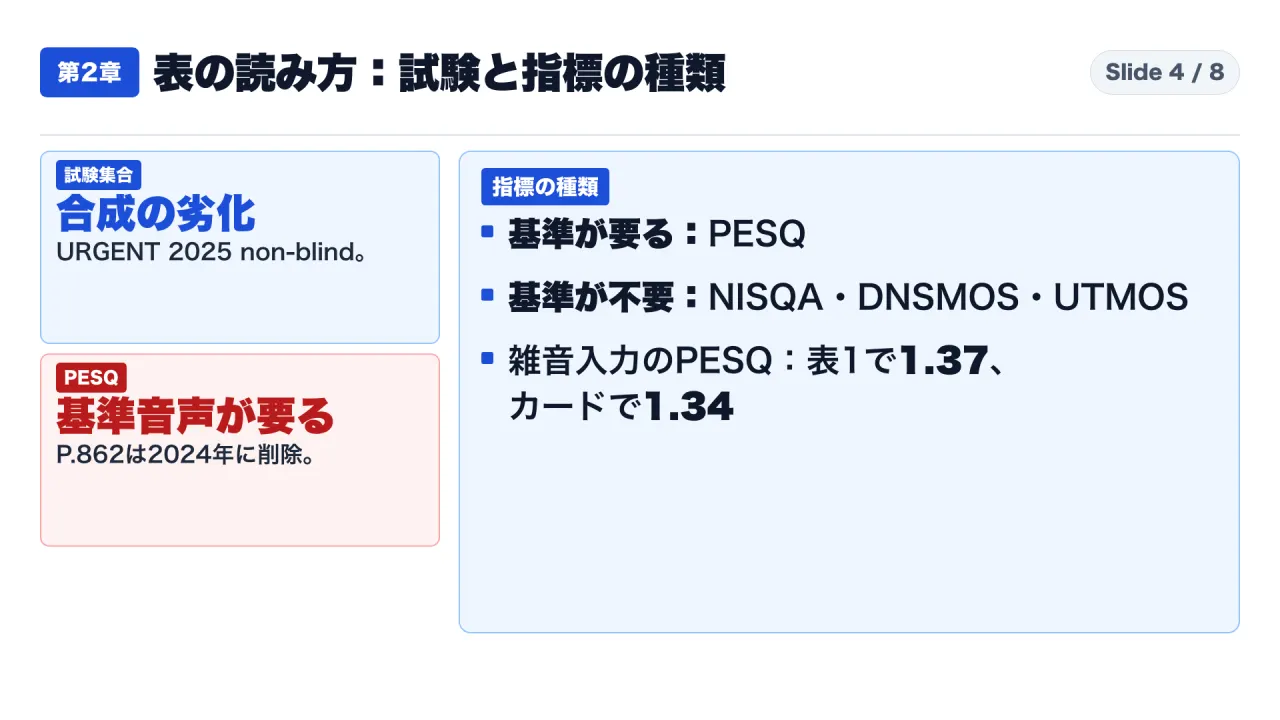
図4は、この章の要点です。試験集合は合成した劣化の音声で、PESQは基準の音声が要ります。NISQA、DNSMOS、UTMOSは、基準が要りません。
第3章:同じ試験集合・同じ指標の列での比較。RE-USEが上の列と、下の列
ここでは、カードの表に印刷された代表的なシステムと、同じ試験集合、同じ指標の列で、RE-USEを並べます。比べる列は、NISQA、PESQ、DNSMOS、UTMOS、SBERT、文字正解率の六つです。出典は、すべてカードの表です。順位は付けません。表に印刷された数字を、集合ごとに並べて、RE-USEが上の列と下の列を示します。
一つ目:全体集合(Sidon、UniPASEと並ぶ唯一の表)
全体集合の表で、パラメータ数は、Sidonが250M、UniPASEが500M、RE-USEが9.6Mです。250Mと500Mは、カードの表の記載で、私は、それぞれの一次資料を見ていません。
| 全体集合(カードの表) | NISQA | PESQ | DNSMOS | UTMOS | SBERT | 文字正解率 |
|---|---|---|---|---|---|---|
| 雑音入力 | 1.69 | 1.34 | 1.84 | 1.56 | 0.74 | 81.29 |
| Sidon(250M) | 3.87 | 1.73 | 3.34 | 3.21 | 0.85 | 84.68 |
| UniPASE(500M) | 4.03 | 2.17 | 3.21 | 2.96 | 0.89 | 87.28 |
| RE-USE(9.6M) | 4.33 | 2.57 | 3.29 | 2.94 | 0.88 | 89.17 |
NISQAは、RE-USEが4.33、UniPASEが4.03、Sidonが3.87で、RE-USEが上です。PESQは、RE-USEが2.57、UniPASEが2.17、Sidonが1.73で、RE-USEが上です。文字正解率は、RE-USEが89.17、UniPASEが87.28、Sidonが84.68で、RE-USEが上です。
一方、DNSMOSは、Sidonが3.34、RE-USEが3.29、UniPASEが3.21で、Sidonが上です。UTMOSは、Sidonが3.21、UniPASEが2.96、RE-USEが2.94で、RE-USEは二つに負けています。SBERTは、UniPASEが0.89、RE-USEが0.88、Sidonが0.85で、UniPASEが上です。
LPSという別の列では、UniPASEもRE-USEも0.85で、同じ値です。カードの表では、Sidonの二か所(DNSMOSとUTMOS)と、UniPASEの一か所(SBERT)が太字です。
私が太字の位置から数えると、全体集合の九つの列のうち、RE-USEが最良でない列は、DNSMOS、UTMOS、SBERTの三つです。これは私の数え方です。
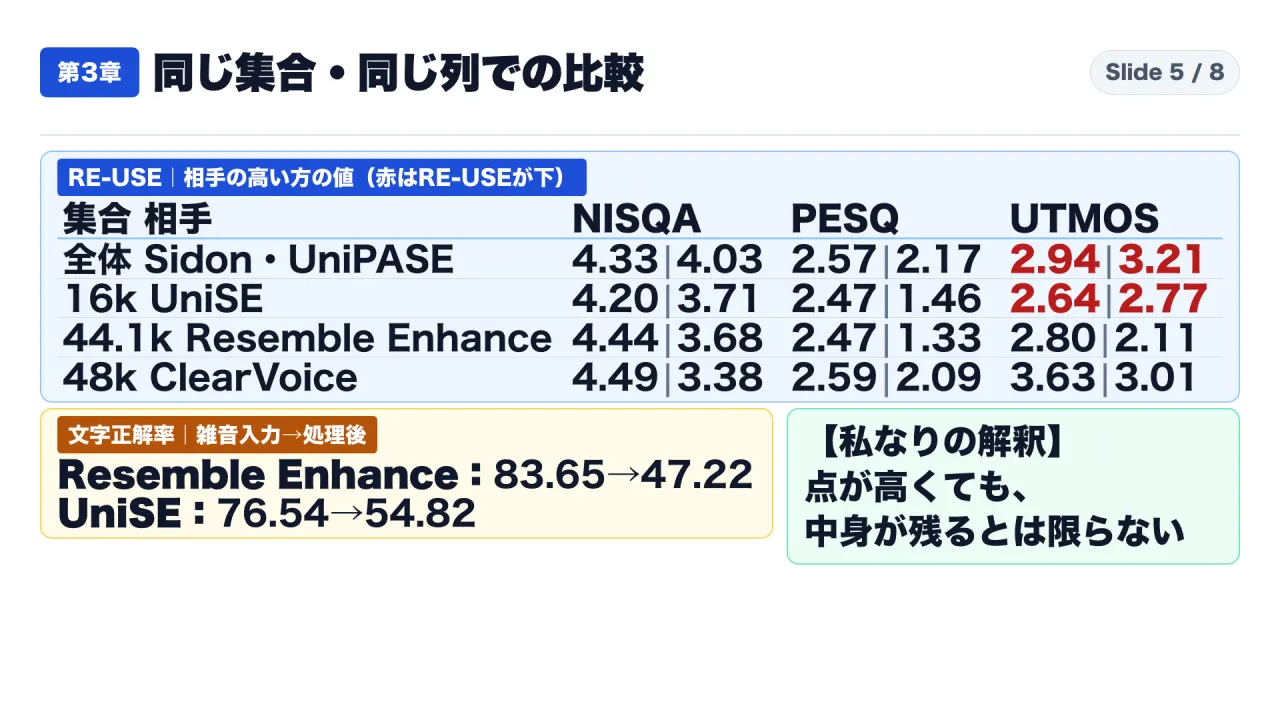
図5は、全体集合の六つの値を、RE-USE、Sidon、UniPASEの順に並べたものです。
二つ目:16キロヘルツの集合(UniSE)
| 16キロヘルツの集合 | NISQA | PESQ | DNSMOS | UTMOS | SBERT | 文字正解率 |
|---|---|---|---|---|---|---|
| 雑音入力 | 1.59 | 1.29 | 1.84 | 1.41 | 0.70 | 76.54 |
| UniSE | 3.71 | 1.46 | 3.23 | 2.77 | 0.77 | 54.82 |
| RE-USE | 4.20 | 2.47 | 3.19 | 2.64 | 0.87 | 87.09 |
この集合では、DNSMOSはUniSEが3.23、RE-USEが3.19で、UniSEが上です。UTMOSも、UniSEが2.77、RE-USEが2.64で、UniSEが上です。NISQA、PESQ、SBERT、文字正解率は、RE-USEが上です。
三つ目:44.1キロヘルツの集合(Resemble Enhance)
| 44.1キロヘルツの集合 | NISQA | PESQ | DNSMOS | UTMOS | SBERT | 文字正解率 |
|---|---|---|---|---|---|---|
| 雑音入力 | 1.79 | 1.30 | 1.91 | 1.52 | 0.76 | 83.65 |
| Resemble Enhance | 3.68 | 1.33 | 3.13 | 2.11 | 0.69 | 47.22 |
| RE-USE | 4.44 | 2.47 | 3.36 | 2.80 | 0.89 | 91.54 |
この集合では、六つの列すべてで、RE-USEが上です。
四つ目:48キロヘルツの集合(ClearVoice)
| 48キロヘルツの集合 | NISQA | PESQ | DNSMOS | UTMOS | SBERT | 文字正解率 |
|---|---|---|---|---|---|---|
| 雑音入力 | 1.83 | 1.28 | 2.04 | 1.99 | 0.77 | 90.64 |
| ClearVoice | 3.38 | 2.09 | 2.97 | 3.01 | 0.84 | 89.92 |
| RE-USE | 4.49 | 2.59 | 3.33 | 3.63 | 0.89 | 91.05 |
この集合でも、六つの列すべてで、RE-USEが上です。
比較の注意点
比較相手は、集合ごとに違います。Sidon、UniPASEと並ぶのは、全体集合の表だけです。各システムの実行条件、つまり公開された重みを使ったのか、どんな設定で動かしたのかは、カードに記載が、私が読んだ範囲でありません。条件は、出典ごとに違うかもしれません。条件が違う比較は、順位を付けず、出典ごとに違う、と書きます。集合をまたいで「RE-USEが一番」と言うことは、この記事ではしません。
数字が高くても、内容が変わる例
44.1キロヘルツの集合で、Resemble Enhanceは、雑音入力ではNISQAが1.79、DNSMOSが1.91でした。処理後は、NISQAが3.68、DNSMOSが3.13に上がっています。しかし、文字正解率は、雑音入力が83.65、処理後が47.22です。
UniSEも、16キロヘルツの集合で、文字正解率は、雑音入力が76.54、処理後が54.82です。この理由は、カードにも論文にも書かれていません。
論文は、Resemble Enhanceについて、非基準の品質指標を大きく上げる一方で、基準が要る得点と文字正解率が低く、内容を作り出す傾向(hallucinate)を示唆する、と書いています。
ここは私の解釈です。NISQAやDNSMOSが上がっても、話の内容が保たれているとは限りません。自分の録音では、名前や数字が聞き取れるかを、耳で確かめます。
第4章:公開版と論文の違い、ライセンス、動作環境、自分の耳で確かめる手順
公開版と論文は、値が違う
44.1キロヘルツの集合で、RE-USEの値は、カードでは、NISQAが4.44、PESQが2.47、文字正解率が91.54です。論文の表2の「提案モデル」は、NISQAが4.15、PESQが2.28、文字正解率が92.20です。同じ集合でも、値が違います。
研究用の元モデル(nvidia/RE-USE)のカードは、公開した重みが、論文の重みと違うと注記しています。劣化の種類を増やし、小さな高品質の集合で微調整した、と書かれています。NemotronLabs版のカードに、論文と同じ重みかどうかの記載は、私が読んだ範囲でありません。
日本語の例は、論文の別の重みの結果
論文の表3は、FLEURS(フルーアズ)という音声データを使い、イタリア語、オランダ語、日本語を、未知の言語として評価しています。日本語の行は、元の音声がDNSMOS 2.96、文字正解率95.34で、論文のモデルを通すと、DNSMOS 3.07、文字正解率95.30です。表のハイフンは、空欄を示す記号です。
この日本語の結果が、公開版の結果かどうかは、確認できません。論文の結果は、公開版と別の重みのものです。
ここは私の解釈です。日本語の例は、DNSMOSが少し上がり、文字正解率は、ほぼ変わらない、という一例です。1言語、1データセットの結果で、自分の日本語の会議録音に当てはまるかは、これでは決まりません。
ライセンス
カードは、「This model is ready for commercial use.」と書き、ライセンスはOpenMDW(オープンエムディーダブリュー)1.1です。Hugging Faceのメタデータも、license: openmdw-1.1です。リポジトリのLICENSEファイルも、冒頭で、OpenMDW 1.1に従うと書き、NVIDIAの2026年の著作権表示が付いています。X投稿の文面には、商用の語がありません。
OpenMDW-1.1の本文は、次のことを書いています。モデルの素材を、制限なく扱う許諾を与えます。配布するときは、ライセンスの写しと、著作権などの表示を残します。特許や著作権の訴訟を起こすと、権利は終了します。モデルを使って作った出力には、制限や義務を課しません。そして、無保証です。他人の権利の確認や、必要な同意の取得は、利用者の責任と書かれています。
ここは私の解釈です。会議の録音には、参加者の声という、他人の権利が含まれます。モデルのライセンスが商用利用を許しても、録音を処理してよいかは、別の確認が要ります。私は法律の専門家ではないので、判断はしません。
ライセンス表記の食い違い
同じリポジトリの二つのサブカードは、別のライセンスを書いています。安全とセキュリティのサブカードは、使用上の制限の欄で、NVIDIA Open Model Licenseに従う、と書きます。説明可能性のサブカードも、利用規約・ライセンスの欄に、同じ名前を書いています。LICENSEファイルとカード本文、メタデータは、OpenMDW 1.1です。
どちらが正しいかは、資料から判断できません。商用で使う前に、確認が要ります。
動作環境とリアルタイム
カードが書く動作環境は、NVIDIA Ampere、Linux、そして推論の欄のA100です。VRAMや遅延、処理速度の数値は、カードに、私が読んだ範囲でありません。共有資料にあった「8ギガバイト程度のGPUで動く」という主張の根拠は、私が読んだ資料にありません。この記事では使いません。
カードは、30秒を超える長い音声や、GPUのメモリ不足が起きるときは、分割して処理する手順(inference_chunk.sh)を案内しています。訓練のクリップは、10秒未満と書かれています。
リアルタイムには向きません。論文は、非因果の設計のため、リアルタイムの用途に向かない、と付録に書いています。リアルタイム向けは、別のモデル(Real-time RE-USE)で、30通りの遅延の設定を持つとカードに書かれ、ライセンスは非商用です。研究用の元モデルも、ライセンスは非商用で、研究開発用です。
笑い声を、より残す版(RE-USE-laughter)もあります。全体集合の表は、NISQAが4.27、PESQが2.60で、通常版は4.33と2.57です。笑い声がどれだけ残るかを測る列は、表にありません。
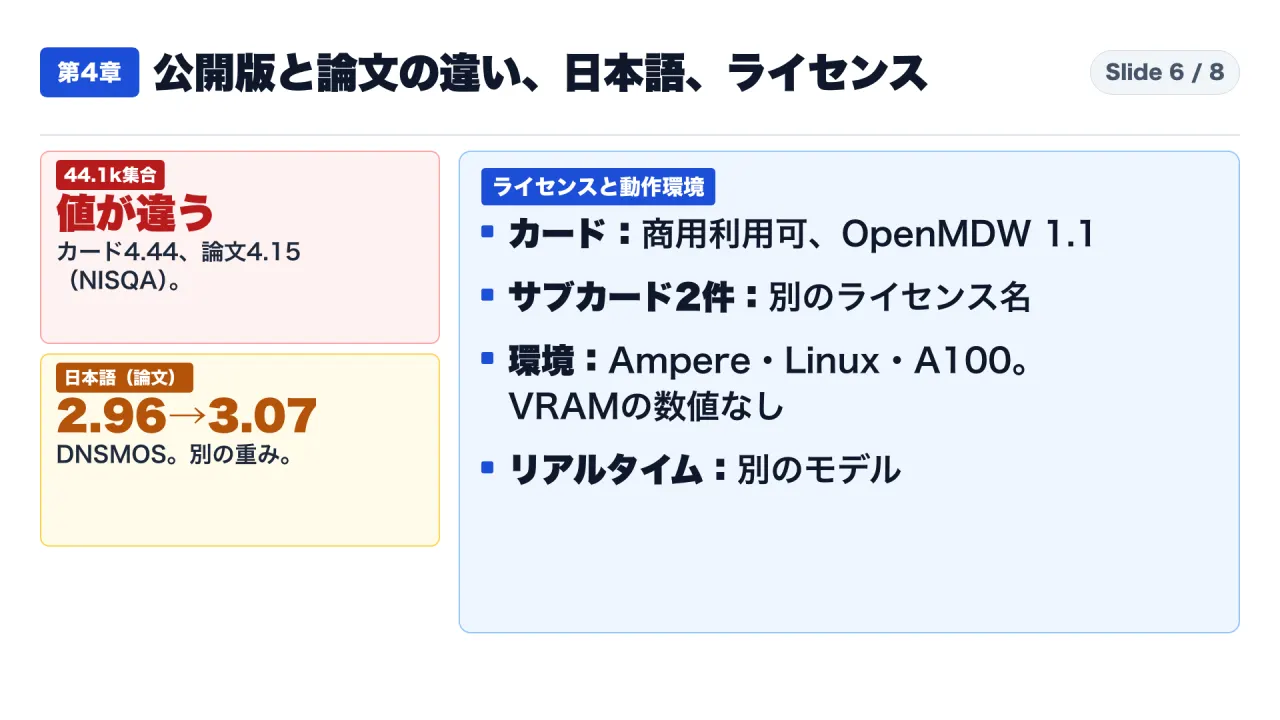
図6は、この章の前半の要点です。公開版と論文で値が違うこと、日本語の例は別の重みの結果であること、ライセンスの表記に食い違いがあることを示しています。
自分の耳で確かめる手順(私の提案)
ここからは、私の提案です。カードにも論文にもない手順です。
論文自身も、聴感の試験を行っています。英語で、10発話を、23人が5段階で評価しました。平均は、雑音入力が1.86、論文のモデルの最後の設定が3.97です。ただし、英語で、論文の内部の条件の比較で、公開版の評価ではありません。
論文の付録は、パケットの欠落が長いと、復元した音素がしばしば誤る、と書いています。ノートパソコンや携帯電話で録音した実際の雑音の音声でも内部で試し、概ねうまくいく、と書いていますが、数値はありません。カードも、復元が常に正確とは限らず、劣化の種類と程度で性能が変わる、と書いています。
手順は六つです。
一つ目。自分の録音から、30秒ほどを三か所選びます。静かな場面、雑音の多い場面、複数人が重なる場面です。
二つ目。処理前と処理後を、同じ音量にそろえて、順番を隠して聞き比べます。音量が大きいほうを良く感じる傾向があるため、音量をそろえます。
三つ目。人名、数字、固有名詞が、聞き取れるままかを確かめます。議事録に要る言葉が消えていないかです。
四つ目。笑い声、拍手、音楽、小声が、消えたり、別の音に変わったりしていないかを聞きます。笑い声を残したいなら、笑い声の版も比べます。
五つ目。長い録音は、分割して処理した継ぎ目で、音や話し方が変わらないかを聞きます。
六つ目。処理の前後を文字起こしして、誤りが増えていないかを見ます。これは、文字正解率の考え方を、自分の録音に当てはめる方法です。
PESQは、基準のきれいな音声が要るので、手元の会議録音には、基準がなく、測れません。NISQAのような基準の要らない指標は、測れます。ただし、値の意味は、第2章の試験の条件に縛られます。
カードは、音声や動画をアップロードして試せるデモ(Gradio)を案内しています。機密の会議録音をアップロードしてよいかは、別の判断です。デモのデータの扱いを、私は確認していません。
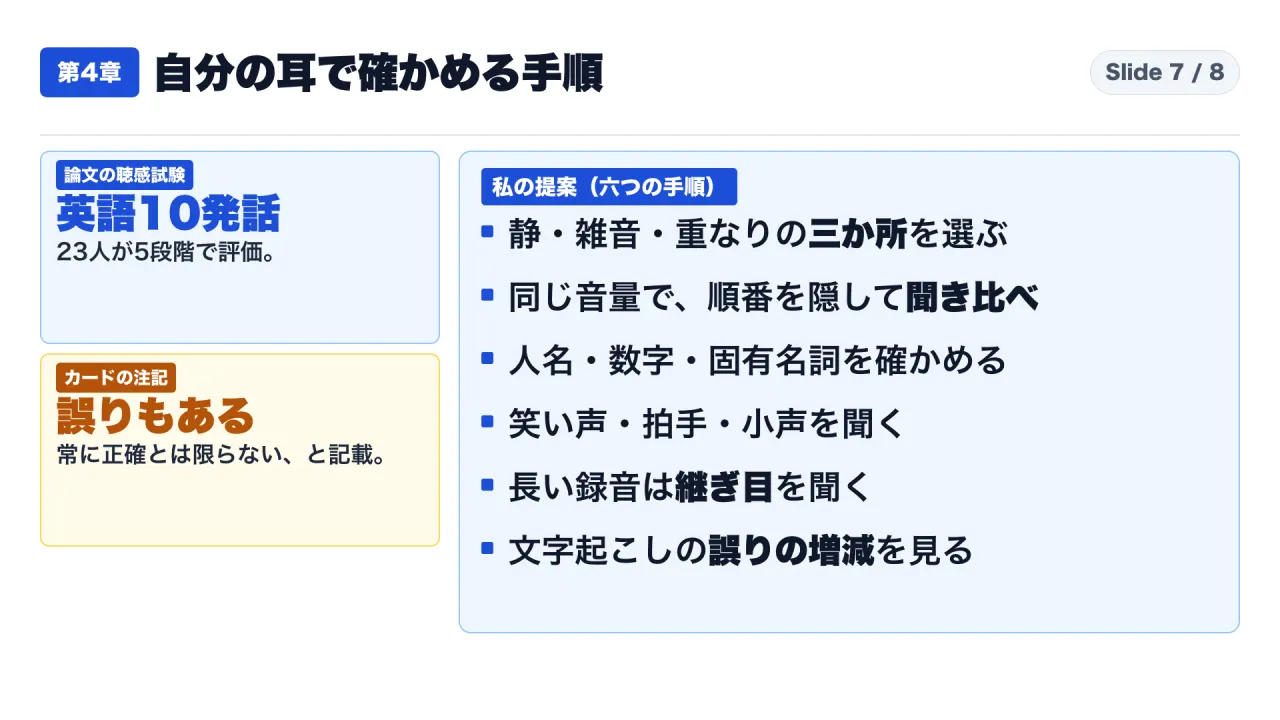
図7は、手順の要約です。
補足:表の一行を、列の順に読む
ここまでの内容を、RE-USEの全体集合の行で、列の順に読み直します。行は、DNSMOSが3.29、NISQAが4.33、UTMOSが2.94、PESQが2.57、STOIが0.78、SBERTが0.88、LPSが0.85、話者の類似度(Spk)が0.86、文字正解率が89.17です。
DNSMOSとNISQAとUTMOSは、基準のきれいな音声が要らない予測です。処理後の音声だけを見て、品質を点数にします。雑音入力の行は、DNSMOSが1.84、NISQAが1.69、UTMOSが1.56なので、三つとも、処理で大きく動いています。
PESQとSTOIは、基準のきれいな音声と比べる指標です。論文は、STOIの拡張版(ESTOI)を、聞き取りやすさの指標として挙げています。カードの表では、STOIが雑音入力で0.50、RE-USEで0.78です。基準が要るので、手元の会議録音には、そのままでは使えません。
SBERTとLPSは、論文では、特定の用途に偏らない、下流の指標に分類されています。SBERTは、自己教師あり学習のモデルを使って、強調の品質を測る指標で、LPSは、音素の並びの近さを測る指標です。どちらも、基準の音声と比べます。
話者の類似度と文字正解率は、特定の用途に向けた指標です。話者の類似度は、話者の特徴が残っているかを、文字正解率は、音声認識がどれだけ文字を当てたかを見ます。この二つは、「聞こえの良さ」ではなく、「中身が残ったか」に近い指標です。会議録音で、議事録に使うなら、この二つの考え方が、手元の確認に近くなります。
この一行から、私が読み取れるのは、ここまでです。RE-USEは、合成した劣化の音声で、雑音入力に比べて、すべての列で動いています。ほかのシステムと比べて上か下かは、第3章のとおり、列ごとに違います。
補足:RE-USEの名前が指すものを整理する
RE-USEという名前は、複数のモデルを指します。取り違えると、数字とライセンスの読みを誤ります。
一つ目は、研究用の元モデル(nvidia/RE-USE)です。元のカードに、2026年3月18日の公開と書かれています。ライセンスは、NVIDIA One-Way Noncommercial License(NSCLv1)で、研究開発用です。元のカードは、商用で使いやすいモデルとして、次の二つのNemotronLabs版を案内しています。
二つ目は、NemotronLabs RE-USEです。この記事が読んだ、製品カードのモデルです。カードの公開日は、10月22日と書かれ、ライセンスはOpenMDW 1.1、カードは商用利用の準備ができていると書いています。
三つ目は、NemotronLabs RE-USE-laughterです。笑い声をより残す版で、パラメータは同じ9.6Mです。全体集合の表の値は、通常版と近く、NISQAが4.27、PESQが2.60です。
四つ目は、Real-time RE-USEです。リアルタイム向けの別のモデルで、30通りの遅延の設定を持つとカードに書かれています。ライセンスは、非商用です。NemotronLabs RE-USEのカードは、参考文献に、このリアルタイム向けの論文を載せています。ただし、遅延や処理速度の数値は、載せていません。
名前が似ていても、論文の重み、研究用の元モデル、NemotronLabs版は、同じ重みとは限りません。カードの数字を読むときは、どの版のカードの数字かを、先に確かめます。
補足:X投稿、カード、論文、ライセンスの使い分け
四つの資料は、答えられる問いが違います。
X投稿は、告知です。文面は、新しいオープンなモデルで、雑音、エコー、その他の音声の劣化を抑えて、音声を聞き取りやすくする、パラメータは9.6M、デモとダウンロードは Hugging Face、と伝えています。性能の数字、ライセンス、商用利用の可否は、投稿の文面にありません。投稿の文面だけで、導入を決めることはできません。
カードは、開発者による製品の説明です。規模、構造、入力の仕様、訓練データ、評価の表、使い方、ライセンス、公開日が載っています。この記事の数字の大半は、カードの表から来ています。ただし、カードは、表の値の測り方を、詳しくは説明していません。
論文は、方法と評価の説明です。試験の規模、指標の分類、基準音声の定義のずれ、聴感試験、日本語を含む未知の言語の評価、限界の記述が載っています。ただし、論文の重みは、公開された重みと、同じとは限りません。
ライセンスの本文は、使ってよい範囲の説明です。カードの「商用利用可」の一文は、ライセンスの本文と一緒に読みます。ライセンスの本文には、無保証と、他人の権利の確認は利用者の責任、という条項があります。
四つを、問いごとに使い分けます。「何ができるか」はカード、「どう測ったか」は論文、「使ってよいか」はライセンスの本文、「新しく出たか」はX投稿、という分担です。
補足:会議録音とポッドキャスト音声で、確かめる順番
カードの仕様から、確かめる順番を考えます。これは私の提案です。
まず、音声の形式です。カードの入出力は、モノラルで、8000ヘルツから48000ヘルツです。録音がステレオなら、モノラルへの変換が先に要ります。複数のマイクで録っている会議なら、どの音を入れるかを決めます。
次に、長さです。カードは、30秒を超える長い音声や、メモリ不足のときは、分割して処理する手順を案内しています。訓練のクリップは10秒未満です。会議録音は、普通、30秒より長いので、分割処理を使う前提になります。継ぎ目の確認が要る理由は、ここにあります。
次に、重なった発話です。主な話者を残し、ほかを抑える設計なので、複数人が同時に話す場面を、必ず聞きます。
次に、劣化の種類です。カードが挙げるのは、雑音、残響、音割れ、帯域制限、コーデックの劣化、パケット損失、低品質のマイクです。オンライン会議の録音なら、コーデックの劣化やパケット損失に当たる場面があるかもしれません。一方で、論文は、パケットの欠落が長いと、復元した音素がしばしば誤る、と書いています。通信が途切れた箇所は、特に聞きます。
最後に、中身の確認です。第3章で見たとおり、品質の点数が上がっても、文字正解率が下がる例があります。名前、数字、固有名詞を、耳で確かめます。
補足:よくある疑問
Q. 商用利用してよいですか。カードは、商用利用の準備ができていると書き、ライセンス本文は、制限なく扱う許諾を与えます。ただし、同じリポジトリのサブカード二件が、別のライセンス名を書いています。どちらが正しいかは、資料から判断できません。商用で使う前に、確認が要ります。私は法律の専門家ではないので、この点の判断はしません。
Q. 日本語の会議録音に使えますか。カードの表に、日本語の列はありません。訓練データの公開された一覧にも、日本語の表記はありません。論文に日本語の例がありますが、公開版と別の重みの結果で、1言語、1データセットです。使えるかどうかは、自分の録音で聞いて決めます。
Q. 8ギガバイトのGPUで動きますか。カードが書くのは、NVIDIA Ampere、Linux、A100です。VRAMの数値は、カードにありません。動くかどうかは、資料から言えません。
Q. リアルタイムで使えますか。論文は、非因果の設計のため、向かないと書いています。リアルタイム向けは、別のモデルで、ライセンスは非商用です。
Q. 9.6Mのモデルが、250Mや500Mのモデルより上と言えますか。全体集合の表では、NISQA、PESQ、文字正解率はRE-USEが上、DNSMOSとUTMOSはSidonが上、SBERTはUniPASEが上です。250Mと500Mという数字は、カードの表の記載で、私は一次資料を見ていません。「上」と一言では言えません。
補足:この記事の数字の確かめ方
引用したカード、論文、ライセンス、各ページの行は、取得した原文と、1行ずつ突き合わせました。突き合わせは、記号や空白の違いを除いて、引用の文字列が原文の行に含まれるかを、機械で確かめる方法です。表の行は、1行を、そのまま引用しています。自前の換算と数え方は、対応表の別の節に、算式と入力の出所を書きました。
確かめられなかったものも、対応表に残しています。たとえば、VRAMや遅延の数値は、カードを検索して、記載がないことを確認しました。ただし、記載がないことは、モデルがその性能を持たないことを意味しません。カードに書かれていない、というだけです。
公開直前の再確認:2026年11月2日に、カード、サブカード、ライセンス本文、OpenMDW-1.1、論文のPDFと各ページの原文を取得し直し、取得済みの原文と比べました。この記事で使った表の値、ライセンス名、日付に変更はありませんでした。X投稿ページとITUのページは、取得し直していません。
原文のキャッシュは、7日で失効します。7日を過ぎて照合し直すときは、原文を取得し直す必要があります。カードや論文は、更新されることがあります。この記事の数字は、2026年11月1日に取得した内容です。
結論:入口にはなるが決め手にはならない。表で見る点と、言えないこと
冒頭の問いに戻ります。NISQAが4.33、PESQが2.57。自分の録音に使ってよい根拠になるか。私の答えは、入口にはなる、決め手にはならない、です。これは私の判断です。
表で見る点を、資料の記載に沿って、五つに整理します。これは私の整理です。
一つ目は、試験の集合です。合成した劣化の音声で、訓練データの公開された一覧に、日本語の表記はありません。二つ目は、指標の種類です。PESQは基準の音声が要り、NISQAなどは基準が要らない予測です。三つ目は、負けている列です。DNSMOSとUTMOSはSidon、SBERTはUniPASEが上です。四つ目は、内容が変わる例です。Resemble Enhanceは、品質の指標が上がっても、文字正解率が下がっています。五つ目は、公開版と論文の違い、そしてライセンスの表記の食い違いです。商用で使う前に、確認が要ります。
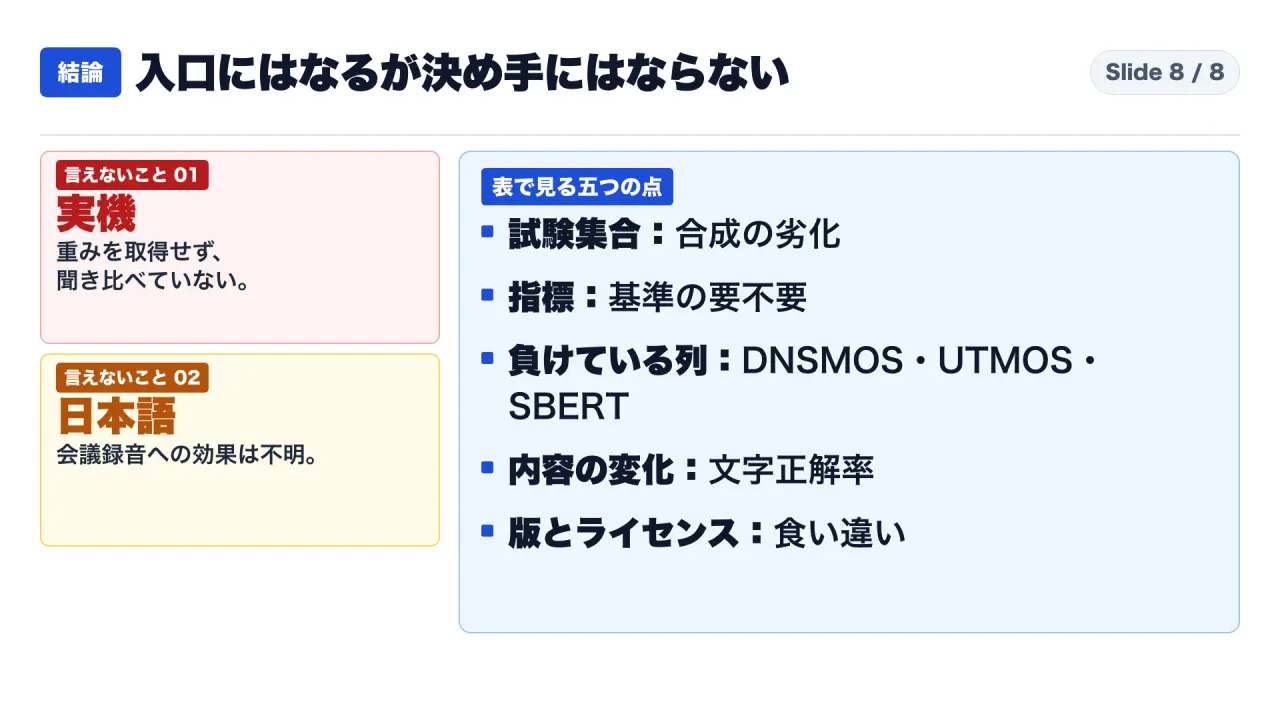
図8は、記事全体の要約です。
この記事で言えないこと
一つ目。私は、モデルの重みを取得せず、自分の録音で聞き比べていません。実際の効果は、言えません。二つ目。日本語の会議録音への効果は、カードの表からも、論文の日本語の例からも、言えません。三つ目。8ギガバイトのGPUで動くか、リアルタイムで動くかは、資料に数値がなく、言えません。四つ目。SidonとUniPASEの一次資料は見ていません。比較相手のモデルの評価は、言えません。五つ目。企業の評価、売買の判断、法律の判断は、扱いません。
共有資料と一次資料の違い
動画の元になった共有資料には、いくつか、一次資料と違う点がありました。「8GB程度のGPUで動く見込み」は、カードに根拠がありません。「商用利用可の告知」は、X投稿の文面になく、カードとライセンスの側にあります。「ライセンスはOpenMDW 1.1」は、カード本文、LICENSEファイル、メタデータで確認できますが、サブカード二件は別の名前を書いています。「9.6Mで250Mや500Mより上」は、数字は正しい一方で、DNSMOSとUTMOSはSidon、SBERTはUniPASEが上です。
準備で確認したこと
引用したカード、論文、ライセンスの行は、原文と1行ずつ突き合わせました。主張ごとの対応表は、別のファイルにあります。
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
参考にした出典
- NVIDIA NemotronLabs RE-USE 製品カード:https://huggingface.co/nvidia/NVIDIA-NemotronLabs-RE-USE
- 論文(PDF):https://arxiv.org/pdf/2603.02641
- OpenMDW-1.1 ライセンス本文:https://raw.githubusercontent.com/OpenMDW/OpenMDW/refs/heads/main/1.1/LICENSE.OpenMDW-1.1
- 研究用の元モデルのカード:https://huggingface.co/nvidia/RE-USE
- RE-USE-laughter のカード:https://huggingface.co/nvidia/NVIDIA-NemotronLabs-RE-USE-laughter
- Real-time RE-USE のカード:https://huggingface.co/nvidia/Real-time_RE-USE
- NVIDIA AI の X 投稿:https://x.com/NVIDIAAI/status/2116262634349818190
- ITU-T 勧告 P.862:https://www.itu.int/rec/T-REC-P.862
- NISQA 論文:https://arxiv.org/abs/2104.09494
- DNSMOS P.835 論文:https://arxiv.org/abs/2110.01763