0.8BのOCRモデルの「1位」は、どの設定の、誰が測った数字か ── 自社の請求書に使う前に読む脚注
結論:同じモデルの同じ表に、95.24・93.45・92.73の三つの数字がある。「1位」は、どの値の話かを確かめるまで使えません
結論から書きます。シャオミのOCRモデル、Xiaomi-OCR-0(シャオミ・オーシーアール・ゼロ)は、Real5(リアルファイブ)という表で、95.24、1位と、開発元は書いています。ところが、その表の管理者の順位表では、同じモデルが92.73で2位です。さらに、開発元の評価手順書には、ページ全体を一度に変換する方式の値として、93.45があります。
三つの数字は、どれも一次資料にあります。違いは、測った設定と、測った人です。95.24は、レイアウト検出器を前に置いた2段階方式の値です。93.45は、検出器を使わない方式の値です。92.73は、評価を管理する側の順位表の値で、どちらの方式かは書かれていません。
この記事の対象読者は、社内の書類処理に新しいOCRやAIモデルを入れるかどうかを調べる立場の人です。請求書や見積書、表の多いPDFを自動で読み取らせたい情報システム部門や事業部門の担当者、そして、成績表の「1位」を根拠に提案を受ける管理職を想定しています。
読み終えると、次の三つができるようになります。一つ目は、成績表の数字を見たとき、設定(2段階かページ全体か)と、測った人を確かめること。二つ目は、平均点の中身と、比べている相手が、同じ条件で測られているかを確かめること。三つ目は、自社の書類30枚前後で、何をどう試すかを決めること。
なお、この記事は、モデルの紹介や、導入の推奨をしません。売買の推奨や株価の話も含みません。私はこのモデルを動かしていませんし、重みもダウンロードしていません。使った資料は、開発元の論文、モデルカード、GitHubのREADMEと評価手順書、そしてReal5とOmniDocBenchを管理する側の公開ページです。
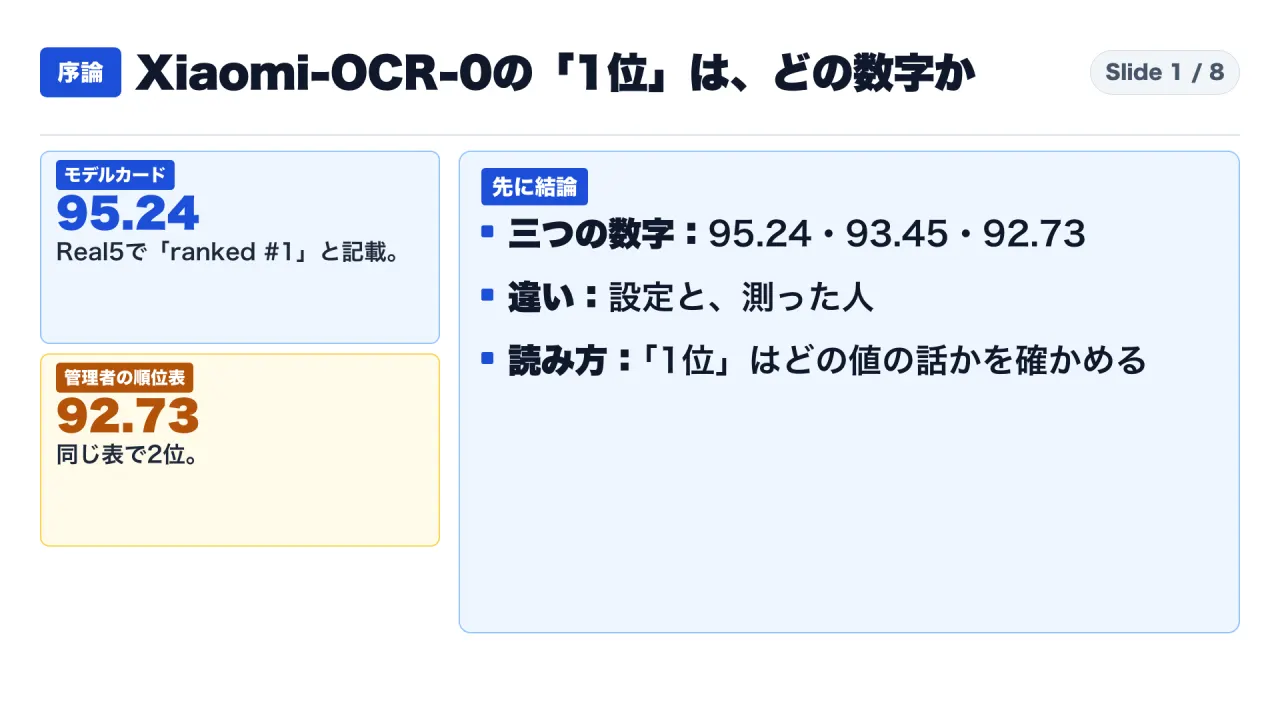
図1は、この記事全体の答えを一枚で示したものです。モデルカードの95.24と、管理者の順位表の92.73は、同じReal5の総合点です。先に言うと、どちらかが間違っているのではありません。設定が違えば、数字は違って当然です。問題は、表の脚注に設定が書かれていないことです。
読み方:本文では「資料の記載」「私の計算」「私の解釈」を分けて書きます
本文には、三つの種類の文が出ます。
「資料の記載」は、論文やモデルカード、GitHubの原文に書かれている内容です。開発元の主張は、事実と分けて、「書いています」と書きます。「私の計算」は、公表された数字から私が引き算や平均を計算した値で、資料に載っている数字ではありません。「私の解釈」は、資料を読んで私が考えたことで、資料に書かれているわけではありません。
資料の扱いには、次の制約があります。
一つ目は、取得の方法です。すべての資料を、2026年11月1日に取得しました。同じ日の再取得でも、内容は変わりませんでした。公開直前の2026年11月2日にも、モデルカード、GitHub、論文、管理者の順位表を取得し直し、この記事で使った数字と順位が変わっていないことを確認しました。二つ目は、確認の範囲です。「見つかりませんでした」と書いた箇所は、論文、モデルカード、GitHubの文書の本文を検索した結果で、私が確認した範囲に限ります。三つ目は、動かしていないことです。モデルを実行しておらず、処理時間やメモリ、日本語の読み取り精度について、私は何も測っていません。
成績表を読む五つの問い
最初に、この記事で使う五つの問いを並べます。以降の章は、この問いを順に当てはめます。
一つ目は、設定は何か、です。2段階か、ページ全体か。検出器の大きさは、モデルの大きさの数に入っているか。二つ目は、誰が測ったか、です。開発元の表か、ベンチマークの管理者の表か、第三者の再現か。三つ目は、総合点の中身は何か、です。式に何が入り、何が入らないか。平均に隠れた苦手な項目はないか。四つ目は、比べる相手は、同じ条件で測られているか、です。五つ目は、載っていないことは何か、です。言語、処理時間、メモリ。
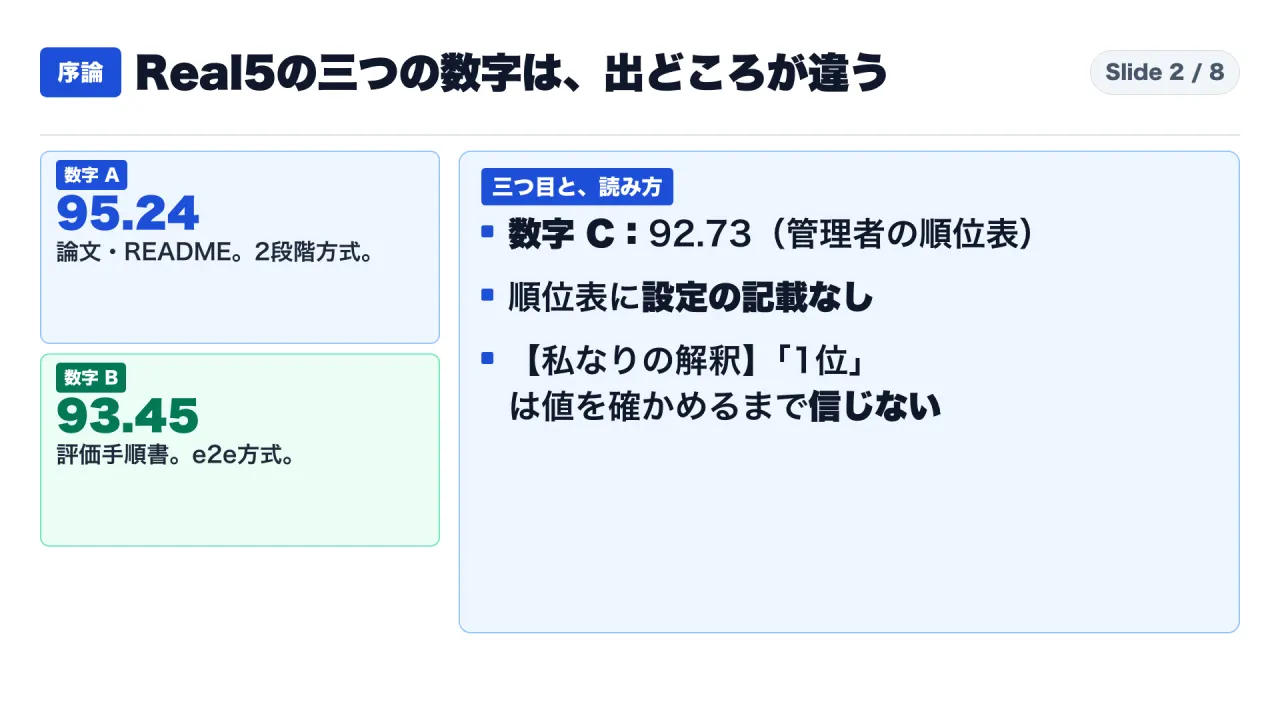
図2が、三つの数字の出どころです。数字Aの95.24は、論文とGitHubのREADMEに、2段階方式の値として出ています。数字Bの93.45は、評価手順書に、ページ全体を直接変換する方式の値として出ています。数字Cの92.73は、Real5の管理者の順位表にあります。
私が確認した範囲では、論文の表にページ全体方式の値は見つかりませんでした。管理者の順位表にも、2段階かページ全体方式かの記載は見つかりませんでした。ここまでが、事実の範囲です。
第1章:95.24は検出器つきの2段階方式の値で、「0.8B」の数に検出器は含まれません
OCRモデルの成績表を読むとき、最初に確かめるのは、どの方式で測ったかです。評価手順書は、二つの方式を定義しています。ページ全体方式(e2e、エンド・ツー・エンド)は、ページの画像全体を、直接マークダウンに変換します。2段階方式は、PaddleX(パドルエックス)という道具で文書の領域を検出し、領域ごとに文字を認識し、ページの形に組み立てます。
2段階方式で領域を検出するのは、PP-DocLayoutV3(ピーピー・ドックレイアウト・ブイスリー)というレイアウト検出器のPaddleX版で、しきい値は0.25です。たとえば、料理の番付で、下ごしらえを専門の人に任せた店と、一人で作る店を、同じ表に載せたとします。下ごしらえを任せた店の点が高く出るのは、自然です。これはたとえ話です。
論文は、評価の設定の節で、主要な比較は、すべて2段階方式の値だと書いています。さらに、「0.8B」というパラメータ数に、外部のレイアウト検出器は含まれない、とも書いています。Hugging Faceの記録では、重みの総数は873,438,784個です。検出器の重みは、これとは別のものです。検出器を含めた合計がどれだけになるかは、私が確認した範囲では、資料に書かれていません。
論文の要約は、「PP-DocLayoutV3が領域検出を担う条件で」、Real5の総合が95.24で、比較した方法の中で最高だと書いています。条件つきの文です。
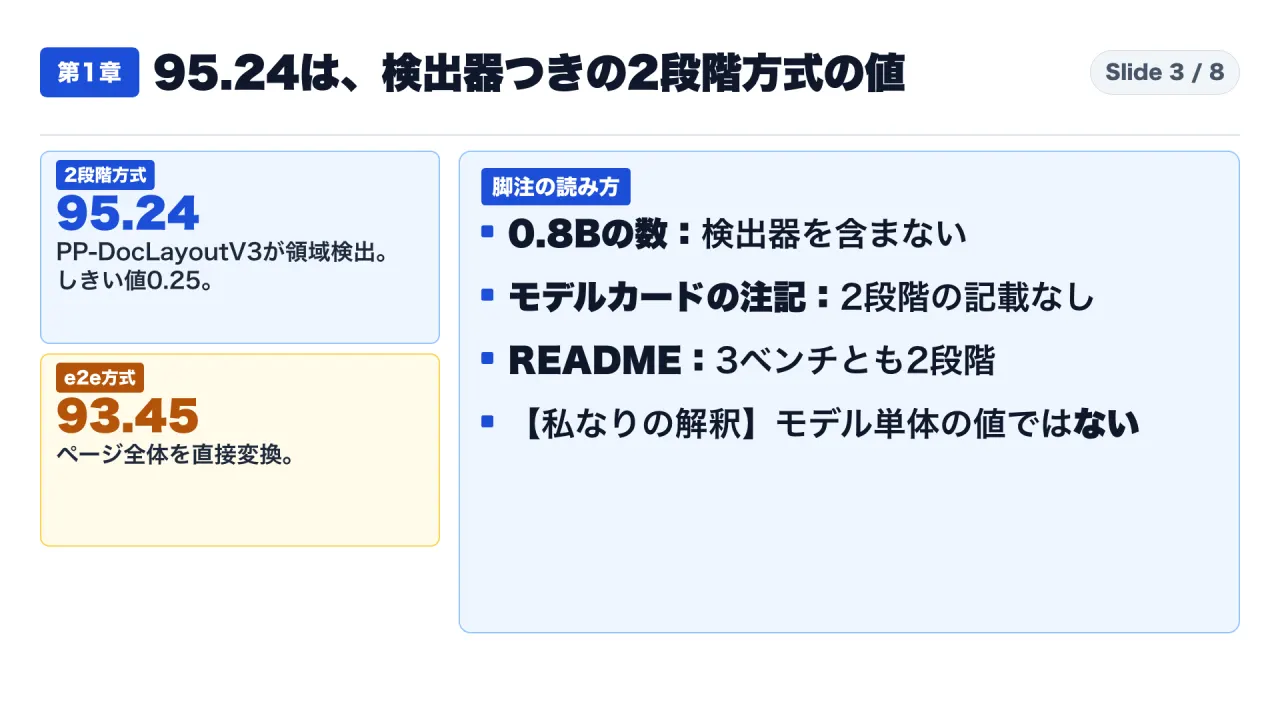
図3のとおり、モデルカードの扱いは、論文より簡単です。モデルカードの成績表の注記は、「3列とも総合点で、—は元の表に数字がないこと」とだけ書いています。私が確認した範囲では、モデルカードで2段階という語が出るのは、GitHubの収録物を紹介する一文だけで、成績表の注記には出てきません。GitHubのREADMEは、3つのベンチマークの文書解析の結果は、すべて2段階方式だと書いています。
「1位」の書き方も違います。モデルカードは「ranked #1」と書くだけです。GitHubのREADMEは、「このページの比較の中で」と、比較の範囲を限定しています。同じ開発元の文書でも、限定句の有無が違います。
私の解釈です。95.24は、検出器を前に置いた方式の値で、モデル単体の値とは言えません。表だけを見て、モデル単体の成績だと読むと、誤読になります。
開発元は、使い分けの指針も書いています。印刷された規則的な文書は、領域ごとの処理が向きます。写真の文字や手書き、書道、古い書物、不規則なレイアウトは、ページ全体の処理を使います。領域の境界が誤ると、文脈が失われるからです。自社の請求書が、どちらに当たるかは、書類を見て決めるしかありません。これは私の整理です。
設定が数字を動かす理由を、一般論として整理しておきます。これは資料に書かれた説明ではなく、私の整理です。2段階方式では、前段の検出器が領域を見落としたり、複数の領域を一つにまとめたりすると、その誤りが後段の認識にそのまま引き継がれます。ページ全体方式は、検出器の誤りを避けられる代わりに、1回の出力が長くなり、表や段組みの順序を一度に正しく出す必要があります。どちらが有利かは、書類の種類で変わります。開発元が使い分けの指針を書いているのは、この違いを開発元自身が認めているからだと、私は読みます。
だからこそ、表の脚注に設定が書かれているかどうかが、数字そのものと同じくらい重要です。設定が書かれていない数字は、別の設定の数字と並べても、比べたことになりません。
第2章:Real5の三つの数字は、論文・評価手順書・管理者の順位表に別々にあり、設定の記載があるのは前の二つだけです
同じ試験の点数が、受けた本人のノートと、主催者の成績表とで、違っていたとします。これはたとえ話です。Real5では、これに近いことが起きています。
Real5は、OmniDocBench v1.5の同じ1,355ページを、5つの撮影条件で撮り直した、計6,775枚の画像です。条件は、スキャン、湾曲、画面の撮影、照明、傾きです。総合点は、5条件の平均です。つまり、Real5は、ページの内容を変えずに、撮り方だけを変えて、読み取りの頑健さを測る表です。
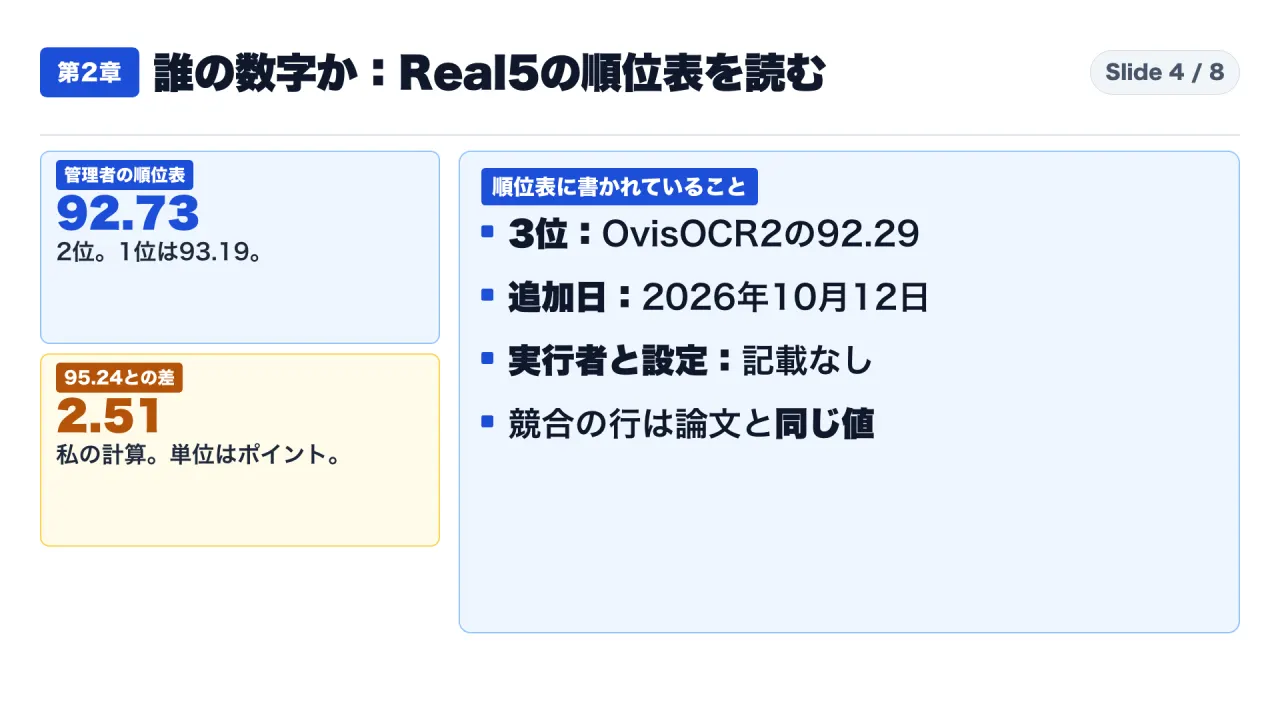
管理者の順位表では、1位がPaddleOCR-VL-1.6(パドルオーシーアール・ブイエル)の93.19、2位がXiaomi-OCR-0の92.73、3位がOvisOCR2(オーヴィス・オーシーアール・ツー)の92.29です。順位表は、2026年10月12日にシャオミの結果を追加した、と書いています。同じ92.73は、シャオミ自身のモデル置き場の評価結果ファイルにもあり、出典は、この順位表と書かれています。
私が確認した範囲では、順位表のページに、誰がこの値を実行したのか、2段階かページ全体方式かの記載は見つかりませんでした。ですから、「誰が測ったか」の答えは、「管理者の表に載っている」までです。評価結果ファイルが、シャオミのモデル置き場にあることから、実行者が誰かまでは言えません。
私の照合では、PaddleOCR-VL-1.6の93.19と、OvisOCR2の92.29は、論文の表と順位表で、5条件の値まで同じです。違うのは、シャオミの行だけです。理由は、資料に書かれていません。
条件別に見ると、差の出方が分かります。論文の2段階の値は、スキャン96.41、湾曲95.46、画面の撮影94.47、照明95.39、傾き94.46です。管理者の順位表のシャオミは、スキャン93.73、湾曲92.76、画面の撮影92.80、照明92.68、傾き91.69です。私の計算では、論文の値から順位表の値を引いた差は、スキャン2.68、湾曲2.70、画面の撮影1.67、照明2.71、傾き2.77で、5条件のすべてで論文の値が高くなっています。
評価手順書のページ全体方式の値は、スキャン94.524、湾曲93.401、画面の撮影93.279、照明93.858、傾き92.170です。私の照合では、順位表のシャオミの5条件の値は、このページ全体方式の値より、5条件のすべてで低くなっています。差は、0.48から1.18ポイントの範囲です。つまり、順位表の92.73は、論文の2段階の値より低いだけでなく、評価手順書のページ全体方式の値よりも低い数字です。
この事実から、言えることと言えないことを分けます。言えるのは、順位表の92.73が、開発元が公開している二つの設定のどちらとも一致しないことです。言えないのは、その理由です。評価に使った設定が違うのか、使った重みの版が違うのか、前処理が違うのかは、資料に書かれていません。理由を推測して書くことは、この記事ではしません。
図4に、差を示します。私の計算では、95.24と92.73の差は2.51ポイントです。95.24と93.45の差は1.79ポイント、93.45と92.73の差は0.72ポイントです。5条件の平均を私が計算し直すと、論文の5条件の値の平均は95.238、順位表の5条件の値の平均は92.732で、どちらも表の総合点と合います。
順位も変わります。論文は、PaddleOCR-VL-1.6に対して、総合で2.05ポイント上と書いています。順位表の値で私が引き算すると、93.19と92.73で、シャオミは0.46ポイント下です。
もう一つ、公平に書いておくことがあります。モデルカードの表では、TeleOCR(テレオーシーアール)のReal5は「—」で、注記は、元の表に数字がないことを意味する、と説明しています。順位表には、TeleOCRが90.72で載っています。この値を足しても、95.24でも92.73でも、シャオミの順位は変わりません。これは私の確認です。
「誰が測ったか」を、私は四つの段に分けて読みます。これも私の整理です。一段目は、開発元が自分のモデルを自分の設定で測った値で、論文とモデルカードの表がこれに当たります。二段目は、ベンチマークの管理者が、公開された順位表に載せた値です。実行者が開発元なのか管理者なのかは、この資料からは分かりませんが、掲載の責任は管理者にあります。三段目は、利害のない第三者が、自分の機械で再現した値です。この記事では、見つけていません。四段目は、自社の書類で自分が測った値です。導入の判断に最も近いのは四段目で、一段目と二段目は、候補を絞るための参考です。
一段目と二段目の数字が食い違うときは、どちらが正しいかを争うより、食い違いの幅を、判断の不確かさとして持っておくほうが実務的です。Real5では、その幅が、95.24と92.73の2.51ポイントでした。上位のモデルどうしの差が、0.46ポイントや2.05ポイントのときに、この幅は、順位を入れ替えるのに十分な大きさです。
私の解釈です。三つの値のどれかが間違っている、とは言えません。設定が違えば、数字は違って当然です。そして、93.45と92.73も一致しないので、順位表の値がページ全体方式だとも言えません。問題は、表に設定が書かれていないことです。
第3章:代表モデルとの比較。同じベンチマークでも、出典ごとに数字と設定が違い、設定の記載がない行には順位を付けません
ここで、代表的なモデルとの比較を、出典と設定つきで整理します。順位は、資料に印刷されている範囲より先へは進めません。
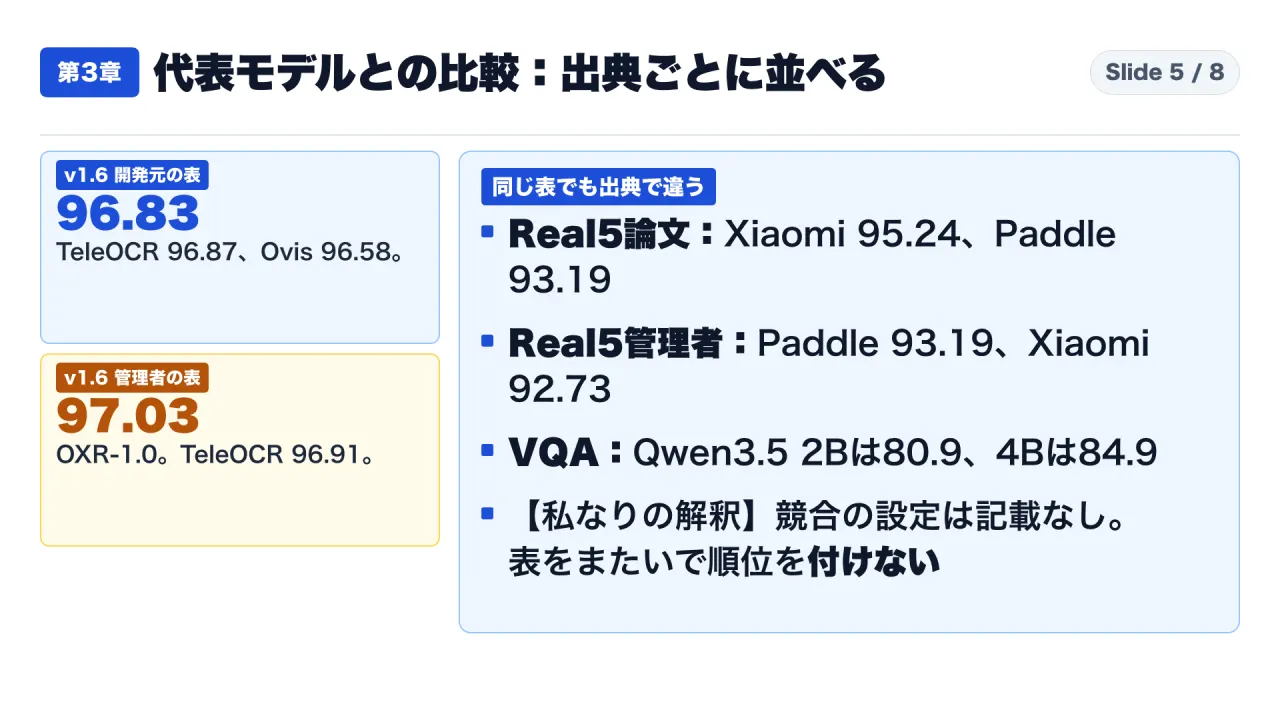
図5が、比較の全体像です。次の表に、同じ内容を、出典と設定つきで並べます。
| ベンチマーク | 出典 | Xiaomi-OCR-0 | PaddleOCR-VL-1.6 | OvisOCR2 | TeleOCR | 設定の記載 |
|---|---|---|---|---|---|---|
| Real5(総合) | 論文の表 | 95.24 | 93.19 | 92.29 | 行なし | シャオミは2段階。競合は表に記載なし |
| Real5(総合) | 管理者の順位表 | 92.73 | 93.19 | 92.29 | 90.72 | どの行も記載なし |
| OmniDocBench v1.6(総合) | 論文の表 | 96.83 | 96.33 | 96.58 | 96.87 | シャオミは2段階。競合は表に記載なし |
| OmniDocBench v1.6(総合) | 管理者のREADME | 行なし | 96.34 | 96.47 | 96.91 | 記載なし。OXR-1.0は97.03 |
Real5の比較は、論文の表では、シャオミが95.24、PaddleOCR-VL-1.6が93.19、OvisOCR2が92.29です。この表にTeleOCRの行はありません。設定は、シャオミが2段階方式であることだけが分かります。競合の設定は、私が確認した範囲では、表に記載がありません。管理者の順位表では、PaddleOCR-VL-1.6が93.19、シャオミが92.73、OvisOCR2が92.29、TeleOCRが90.72で、設定は、どの行にも書かれていません。同じ表の上で、シャオミだけ、出典によって値が違います。
OmniDocBench v1.6の比較は、開発元の表と管理者のREADMEで、競合の数字も違います。開発元の表は、シャオミ96.83、TeleOCR 96.87、OvisOCR2 96.58、PaddleOCR-VL-1.6 96.33です。管理者のREADMEの順位表は、題名がv1.6_fullで、OXR-1.0が97.03、TeleOCRが96.91、OvisOCR2が96.47、PaddleOCR-VL-1.6が96.34で、シャオミの行はありません。私が確認した範囲では、11月1日に取得したREADMEの順位表に、シャオミの行はありません。どちらの数字が正しいかは、この記事では決めません。「出典で数字が違う」と読みます。
文書の質問応答では、Qwen3.5(クウェン)系列との比較が論文にあります。0.8Bモデルが72.9、2Bモデルが80.9、4Bモデルが84.9で、シャオミが83.2です。比較相手の数字を、シャオミ自身が測ったのか、引用したのかは、論文に書かれていません。
「設定をそろえた比較」とは、何をそろえることかも、書いておきます。そろえる項目は、少なくとも四つあります。同じ評価データであること。同じ方式(2段階か、ページ全体か)であること。同じ検出器としきい値、同じ生成条件であること。同じ採点の式と、同じ版の評価コードであること。今回の資料で、この四つがすべて印刷されているのは、評価手順書のシャオミの行だけです。競合の行は、論文の表でも管理者の表でも、方式や生成条件が書かれていません。ですから、この記事の比較表は、「各表に印刷された数字を、出典と一緒に並べたもの」で、「同じ設定で測り直した比較」ではありません。
私の解釈です。これらの比較は、出典ごとに読みます。順位は、各表に印刷されている範囲だけを使い、表をまたいだ順位は付けません。設定の記載がない行は、「競合の設定は記載なし」と読みます。
OmniDocBenchについて、少し補います。これは、PDF 1651ページ、文書10種、レイアウト5種、言語5種のベンチマークです。総合点の式は、テキストの編集距離を引いた値、表のTEDS、数式のCDM、この三つの平均で、読み順は式に入っていません。編集距離は、文字列がどれだけ違うかを数える指標、TEDSは表の構造と中身の一致度、CDMは数式の一致度です。読み順が総合点に入らないので、順序の崩れが目立つ文書でも、総合点は高く出ることがあります。
この表が、自社の書類に近いかどうかも、確かめる点です。OmniDocBenchの管理者のREADMEは、文書の例として、学術論文、財務報告書、新聞、教科書、手書きのノートを挙げています。請求書は、例に挙がっていません。例示なので、含まれていないとは言えませんが、請求書の成績を直接測った表ではない、という前提で読むのが安全です。Real5は、このOmniDocBenchのページを撮り直したものなので、同じ前提が当てはまります。
次に、評価手順書の「再現参考値」です。OmniDocBench v1.6は、2段階が96.4739、ページ全体方式が94.629です。この96.4739は、論文では、強化学習を始める前のチェックポイントの値と一致します。公開されたモデルの値は96.8277で、表の96.83と同じです。Wild-OmniDocBenchも同じで、論文の値は87.94、評価手順書の2段階の参考値は83.9477です。私の計算では、差は約4.0ポイントです。理由は、資料に書かれていません。
私の解釈です。評価手順書の参考値は、Real5では、2段階の95.24だけが、公開値と一致します。ほかの参考値は、公開モデルの値かどうか、資料から言えません。公開モデルのページ全体方式の値は、一次資料からは確認できません。94.63という数字を、公開モデルのページ全体方式の値として使うことは、できません。
もう一つ、読むときの注意点です。学習用のラベルを作る専門モデル群に、比較表に載るモデルが含まれます。論文は、注釈の選び方が、得意不得意を左右しうる、と書いています。これは不正の指摘ではなく、表の読み方の注意点です。
第4章:VQA平均83.2はOCRBenchで2Bモデルを下回り、請求書の社内評価は65.00%で、日本語・処理時間・メモリは資料にありません
通信簿の平均点が高くても、苦手な科目が隠れていることがあります。これはたとえ話です。
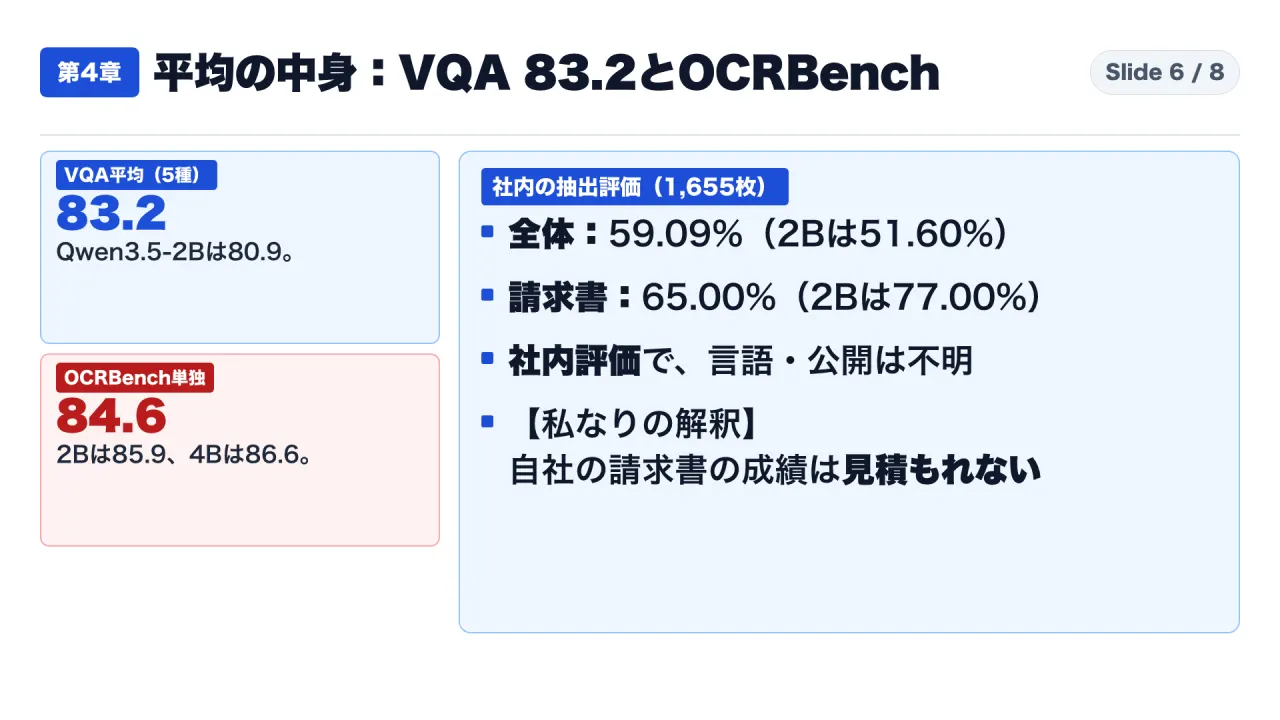
論文のVQAは、文書やグラフの画像に答える5種の問題です。総合は、DocVQA、InfoVQA、ChartQA、OCRBench、TextVQAの単純平均です。Xiaomi-OCR-0は83.2で、Qwen3.5-2Bは80.9で、それより2.3ポイント上です。Qwen3.5-4Bは84.9で、それより1.7ポイント下です。
ただし、OCRBenchだけを見ると、Xiaomi-OCR-0は84.6で、2Bモデルが85.9、4Bモデルが86.6で、どちらも下回ります。私の計算では、2Bモデルとの差は1.3ポイントです。5種のうち4種では、2Bモデルを上回ります。4Bモデルについては、5種のうち上回るのはChartQAだけです。
ここで、訂正を一つ書きます。作業の途中で、「OCRBench単独で4Bモデル(84.9)を下回る」というメモがありました。84.9は4Bモデルの平均で、OCRBench単独の値は86.6です。この記事は、論文の表の値を使っています。
VQAの5種が、何を測っているかも整理しておきます。論文によると、DocVQAは文書に対する質問応答、InfoVQAとChartQAは図解やグラフへの拡張、TextVQAは自然画像の中の文字です。OCRBenchは、文字の認識と質問応答の両方を含む、より広い評価です。私の整理では、請求書の読み取りに近いのは、文書への質問応答と、文字の認識を測る項目です。その二つで、シャオミと2Bモデルの差を見ると、DocVQAは93.1と92.4で、差は0.7ポイント、OCRBenchは84.6と85.9で、差はマイナス1.3ポイントです。平均の83.2と80.9の差が2.3ポイントでも、請求書に近い項目では、差が小さいか、逆転しています。ただし、これは私の整理で、請求書の成績を示す数字ではありません。
4Bの教師モデルは、VQAで88.1、小型の公開版は83.2で、差は約4.9ポイントです。文書の解析では、差は約0.15ポイントです。論文は、理解のほうが、モデルの容量への要求が大きい、と書いています。
請求書の数字もあります。論文の社内の抽出評価は、証明書や銀行カード、請求書などの写真とアプリ画面、1,655枚です。全体の正答率は59.09%で、Qwen3.5-2Bは51.60%で、それを上回ります。しかし、請求書だけは、65.00%で、Qwen3.5-2Bは77.00%です。下回ります。論文は、住所と請求書の抽出が、今後の課題だと書いています。
私の解釈です。この評価は、社内のもので、画像の言語や、公開の有無は、論文から分かりません。自社の請求書の成績を、この65.00%から見積もることはできません。ただし、請求書は、この評価で弱い側にありました。
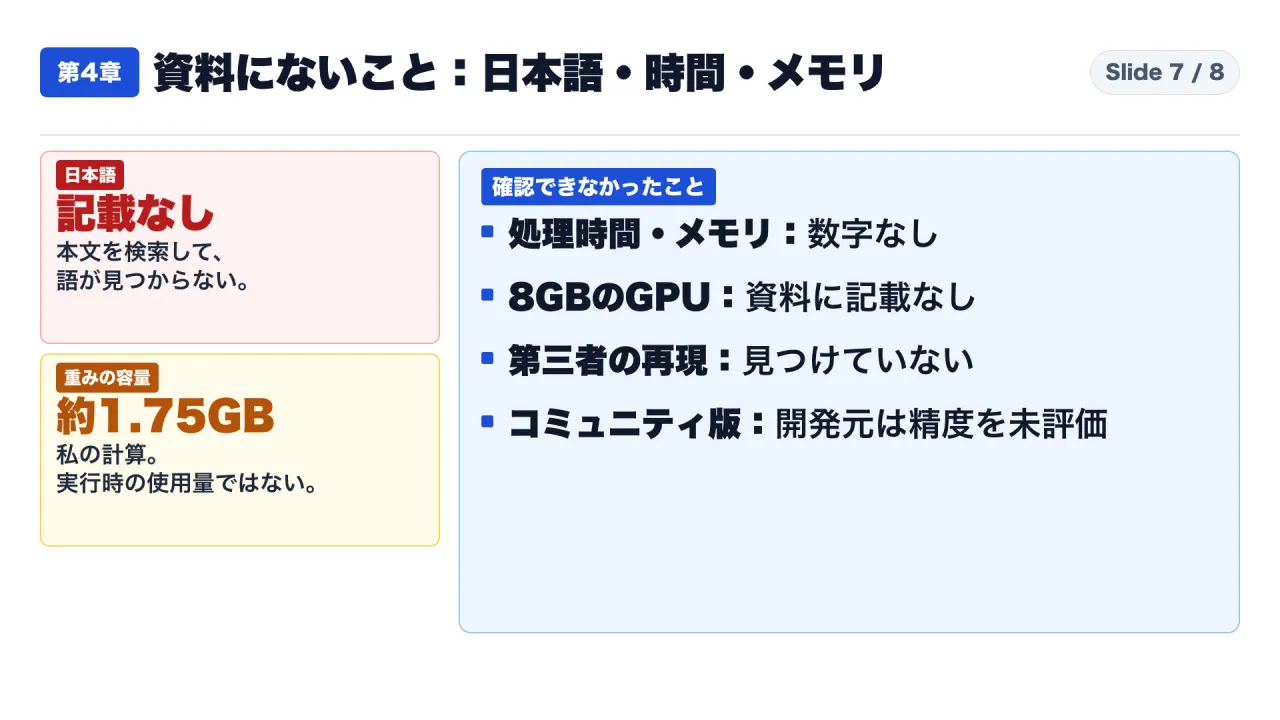
図7のとおり、載っていないことを数えます。一つ目は、日本語です。私が確認した範囲では、論文、モデルカード、GitHubの文書の本文を検索して、日本語という語は、1回も見つかりませんでした。二つ目は、処理時間とメモリです。1ページあたりの時間も、必要なGPUメモリの数字も、見つかりませんでした。「8ギガバイトのGPUで動く」という言い方も、これらの文書には見つかりませんでした。
重みだけなら、私の計算で、873,438,784個に、1個あたり2バイトを掛けて、約1.75ギガバイトです。ただし、これは実行時の使用量ではありません。画像を読み込む処理や、レイアウト検出器の分は、含まれません。コミュニティ版のパッケージは、約1.8ギガバイトとありますが、開発元は、この変換版の精度を評価していません。三つ目は、第三者の再現です。私が探した範囲では、見つけていません。
結論:表を読む五つの問いと、手元の文書30枚前後で試す手順
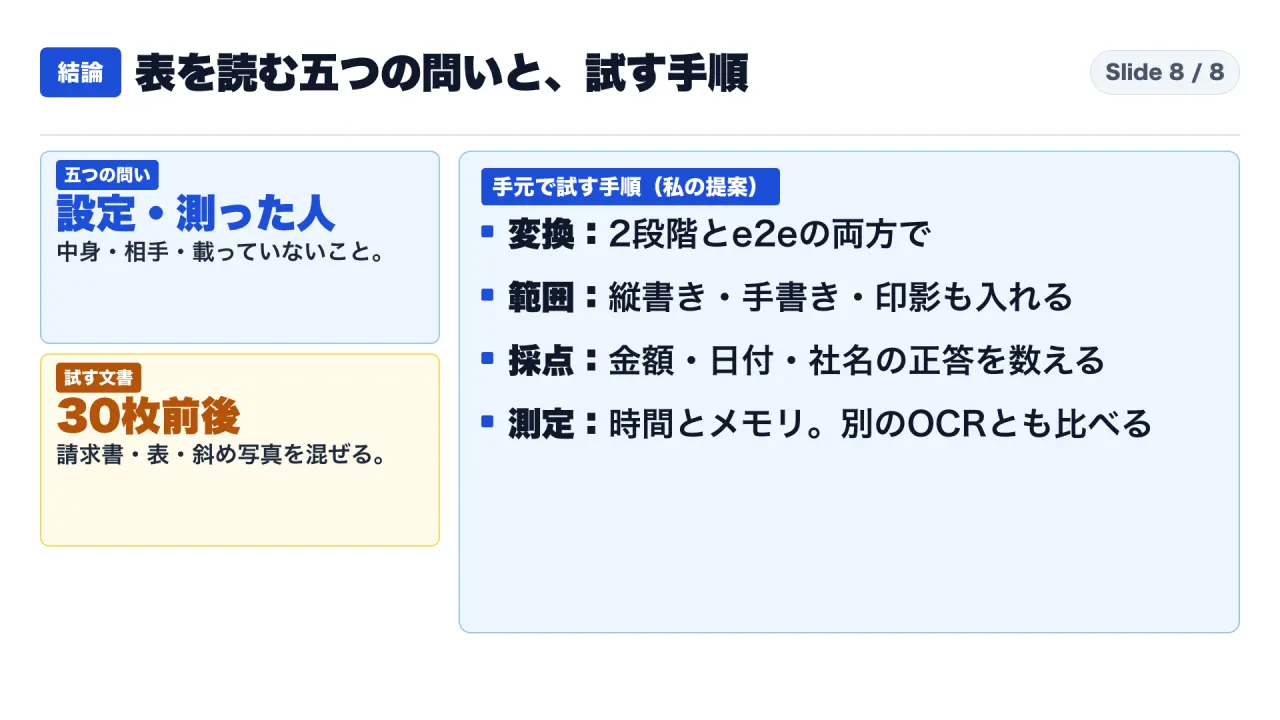
最後に、手元の文書で試す手順を書きます。これは私の提案で、数字の根拠はありません。
一つ目は、文書を集めることです。請求書、見積書、表の多いPDF、斜めから撮った写真を混ぜて、30枚前後を用意します。枚数は、差が見える最小限の量として、私が置いた目安です。二つ目は、2段階とページ全体方式の両方で変換して、差を見ることです。開発元の数字でも、95.24と93.45で、1.79ポイントの差があります。自社の書類で、この差がどれだけ出るかは、試すまで分かりません。
三つ目は、資料に数字のない領域を入れることです。日本語の縦書き、手書き、印影、複数段組みを混ぜます。四つ目は、金額、日付、社名を、JSONで取り出させ、正しい数を自分で数えることです。社内評価で、請求書は65.00%でした。五つ目は、1ページあたりの処理時間とメモリを、自分の機械で測ることです。最後に、使っている別のOCRにも、同じ文書を通して、同じ採点基準で比べます。
この記事で言えないことも、まとめておきます。一つ目。公開モデルのページ全体方式の値は、一次資料から確認できません。評価手順書の参考値は、公開モデルの値かどうか、書かれていません。二つ目。管理者の順位表の92.73が、2段階かページ全体方式か、誰が実行したかは、書かれていません。三つ目。私はこのモデルを動かしていません。重みもダウンロードしていません。日本語、時間、メモリは、すべて未確認です。四つ目。開発元の主張は、事実と分けて紹介しました。賛成も反対もしていません。
採点の作り方にも、注意点があります。論文の抽出評価は、JSONとして読める形に整えたうえで、キーと値を正規化し、正規化後の完全一致で採点する、と書いています。自社で試すときは、採点のルールを先に決めます。たとえば、金額は桁区切りや通貨記号の違いを無視して数字だけで照合するのか、日付は和暦と西暦の違いをどう扱うのか、社名は株式会社の位置の違いを許すのか、といった点です。ルールを後から変えると、2段階とページ全体方式の差が、モデルの差なのか、採点の差なのか、分からなくなります。
試す文書は、種類ごとに分けて集計します。請求書だけで何枚、表の多いPDFだけで何枚、斜めの写真だけで何枚、と分け、種類ごとに正答率を出します。全体の平均だけを見ると、この記事で見たVQAの平均と同じように、苦手な種類が隠れます。同じ文書を、設定を変えて2回流し、結果を同じ表に並べます。1回の実行だけで判断せず、出力が毎回同じになるかも、2回目の実行で確かめます。
最後に、結果の持ち方です。数字だけでなく、使ったモデルの版、設定(2段階かページ全体か、検出器のしきい値)、実行日、採点のルールを一緒に残します。この記事で見た三つの数字は、このどれかが書かれていなかったために、並べて比べられませんでした。自分の結果は、同じ失敗をしないように残します。
導入の判断に、この記事の内容をどう使うかを、補っておきます。社内の書類処理にOCRを入れる目的は、人の手入力を減らすことです。そのとき、成績表の総合点が高いことは、必要条件にも十分条件にもなりません。自社の書類で、金額や日付の取り違えがどれだけ起きるか、取り違えたときに人がどれだけ早く気づけるか、確認の手間がどれだけ残るかが、実際の効果を決めます。成績表は、試す候補を絞るための道具で、導入の可否を決める根拠ではありません。
もう一つ、新しいモデルの数字は、公開から日が浅いほど、更新されやすいことにも注意が要ります。この記事で使った資料は、モデルカードが2026年9月30日の公開、順位表がシャオミの追加を10月12日としています。11月1日時点の数字を使っているので、読む時点で、表が更新されている可能性があります。読むときは、日付と版を、あわせて確かめてください。
準備では、引用した数字を、論文、モデルカード、GitHub、管理者の公開ページの原文と、1行ずつ突き合わせました。
最後に、この記事の読み方の限界を書きます。私は、一次資料の原文と数字を照合しましたが、モデルを動かして確かめてはいません。ですから、「この数字はこの設定で再現できる」とは言えません。言えるのは、「公開された資料に、こう書かれている」ことと、「資料同士で数字が食い違っている」ことだけです。また、文書の中の数字は、2026年11月1日に取得した時点のものです。論文の版は、arXivのv1でした。以降の版で数字が変わっている場合は、この記事の内容も古くなります。
この記事で一番伝えたいのは、成績表の数字を疑うことではなく、数字に付いている設定と出どころを、一緒に読む習慣です。設定と出どころが分かれば、同じ数字でも、使える範囲が見えてきます。分からなければ、「分からない」と書いて、自分の書類で確かめる。それが、新しいモデルを仕事に入れるときの、最も安い保険だと、私は考えます。
最後の確認リスト
- 成績表の数字は、2段階か、ページ全体か、設定を確かめたか
- 「0.8B」のような大きさの数に、検出器が含まれているか
- 誰が測ったか(開発元の表か、管理者の表か、第三者か)を確かめたか
- 総合点の式に何が入り、何が入らないか。平均に隠れた苦手な項目はないか
- 比べる相手は、同じ条件で測られているか。設定の記載がない行に順位を付けていないか
- 日本語、処理時間、メモリなど、載っていないことを、自分の書類で試したか
最後に、一つ質問です。皆さんの会社で、新しいOCRやAIを選ぶとき、成績表の数字が、どの設定で、誰が測ったものかを、確かめていますか。コメントで教えてください。
YouTube本編:https://youtu.be/WzlRnnudzIU
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- Xiaomi-OCR-0 モデルカード(Hugging Face):https://huggingface.co/SeerRay-Lab/Xiaomi-OCR-0
- Xiaomi-OCR-0 GitHub README:https://github.com/SeerRay-Lab/Xiaomi-OCR-0
- Xiaomi-OCR-0 評価手順書(GitHub):https://github.com/SeerRay-Lab/Xiaomi-OCR-0/blob/main/evaluation_pipeline/README.md
- Xiaomi-OCR-0 技術報告(arXiv:2609.36136):https://arxiv.org/pdf/2609.36136
- Real5-OmniDocBench 管理者の順位表(Hugging Face):https://huggingface.co/datasets/PaddlePaddle/Real5-OmniDocBench
- OmniDocBench 管理者のREADME(GitHub):https://github.com/opendatalab/OmniDocBench
- Xiaomi-OCR-0 評価結果ファイル(Hugging Face):https://huggingface.co/SeerRay-Lab/Xiaomi-OCR-0/raw/main/.eval_results/real5_omnidocbench.yaml
- Hugging Face API(Xiaomi-OCR-0):https://huggingface.co/api/models/SeerRay-Lab/Xiaomi-OCR-0