DecisionRAGの「13.8ポイント上」とPageIndexの「98.7%」は、何を測った数字か ── 自社の文書検索に使う前に確かめること
結論:13.8は最も高い相手との差ではなく、98.7%には人の判定12問が含まれます。どちらも自社の文書検索の成績ではありません
結論から書きます。DecisionRAG(ディシジョン・ラグ)は、コーネル大学の研究チームが2026年10月26日にarXiv(アーカイブ)へ投稿した、検索拡張生成(RAG、ラグ)の新しい方式です。論文の要旨は、8Bのリランカーつきの密検索に対して、MultiDoc2Dial(マルチドック・ツー・ダイアル)のR@1(リコール・アット・ワン)で13.8ポイント、Natural Questions(ナチュラル・クエスチョンズ)のHit@1(ヒット・アット・ワン)で17.4ポイント上回る、と書いています。この差は、論文の表の中の、Qwen3-Rerankerという一つの相手との差です。同じ表にはGPT-5で並べ替える相手もあり、その相手との差は、私の計算で、MultiDoc2Dialが2.4ポイント上、Natural Questionsが4.6ポイント上、ConditionalQA(コンディショナル・キューエー)が3.7ポイント下でした。
PageIndex(ページ・インデックス)は、VectifyAIという組織がGitHubで公開しているソフトで、READMEはFinanceBench(ファイナンス・ベンチ)で98.7%の精度に達したと書いています。この数字のリンク先は2025年2月のブログで、PageIndexを基にした金融向けのMafin 2.5(マフィン・ツー・ポイント・ファイブ)の値です。結果ファイルのラベルを数えると、150問のうち一致が136問、ベンチマーク側の誤りなど別のラベルが12問、不一致が2問でした。私の計算では、この12問を足すと148問で98.67%になり、表示の98.7%に合います。
この記事の対象読者は、社内の文書検索や、文書にもとづく質問応答の仕組みを選ぶ立場の人です。情報システム部門や事業部門の担当者、そして、成績表の数字を根拠に提案を受ける管理職を想定しています。読み終えると、次の三つができるようになります。一つ目は、「何ポイント上」「何%」という数字を見たとき、何を測り、誰と比べ、誰が採点したかを確かめること。二つ目は、論文の表やベンダーの資料に印刷された比較相手を、設定ごとに読み分けること。三つ目は、自社の文書で試すときの手順を決めることです。
なお、この記事は、製品の紹介や導入の推奨をしません。二つの数字は、ベンチマークも指標も別なので、どちらが優れているかも決めません。私はどちらのソフトも動かしていません。使った資料は、DecisionRAGの論文、PageIndexのREADME、Vectifyのブログとリポジトリ、FinanceBenchを作った側の論文とREADMEです。
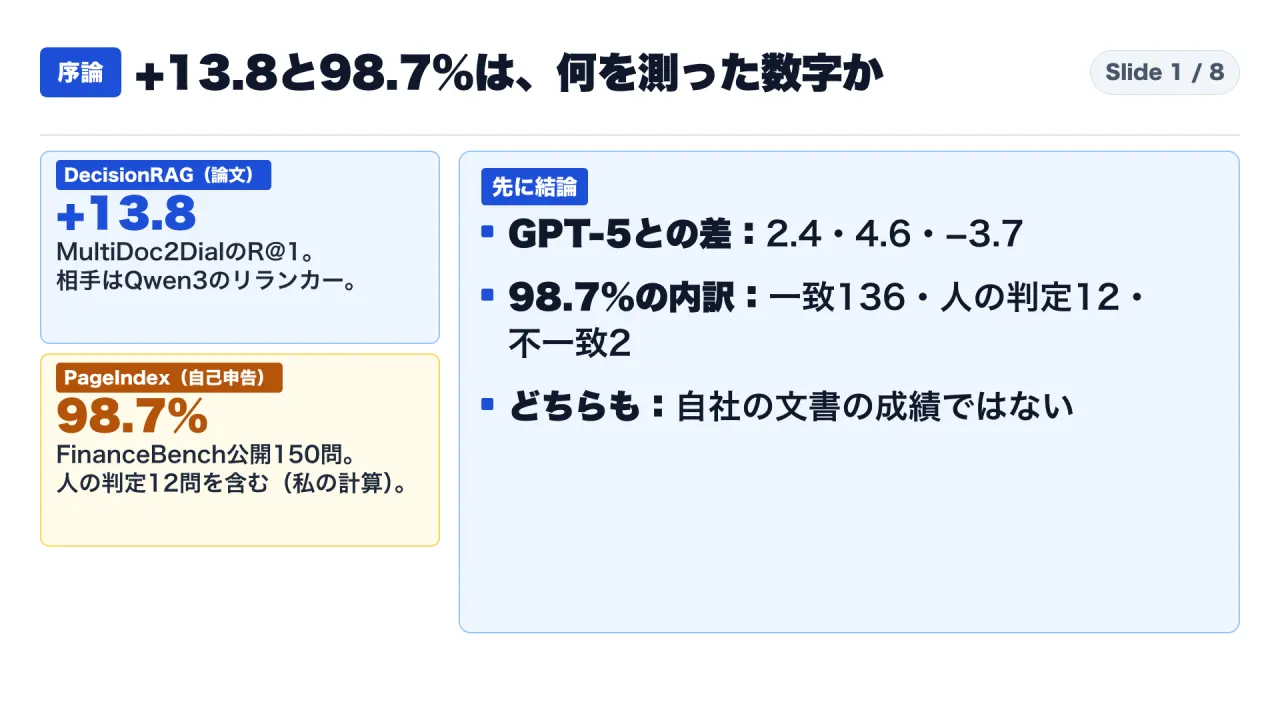
図1は、この記事全体の答えを一枚で示したものです。左の二つの数字は、どちらも一次資料にあります。ただし、左上の13.8は一つの相手との差で、左下の98.7%には人の判定が含まれます。右の三つの行が、この記事で確かめた内容の要約です。
読み方:「資料の記載」「私の計算」「私の解釈」を分けて書きます
本文には三つの種類の文が出ます。「資料の記載」は、論文やGitHub、ブログの原文に書かれている内容です。開発元の主張は、事実と分けて、「書いています」と書きます。「私の計算」は、公表された数字から私が引き算や割り算をした値で、資料に載っている数字ではありません。「私の解釈」は、資料を読んで私が考えたことで、資料に書かれていることではありません。
数字を引用するときは、単位と測った範囲を一緒に書きます。たとえば「13.8」は、MultiDoc2DialのR@1のポイント差で、相手はQwen3-Rerankerです。単位と範囲が付いていない数字は、この記事では、使いません。
取得は2026年11月2日です。論文はarXivの第1版で、査読前です。arXivの要旨ページの投稿日は2026年10月26日ですが、PDFの1ページ目の脚注には「Preprint. October 27, 2026.」とあり、日付が1日違います。この記事ではarXivの投稿日を使います。
公開直前の再確認:2026年11月2日に、論文のarXivページ(第1版のみ)、PageIndexのREADMEとリリース、Mafin2.5の結果ファイルと評価の資料を取得し直し、この記事で使った数字と日付に変更がないことを確認しました。
言葉の整理:RAG、密検索、リランカー、R@1とHit@1
この記事で出る言葉を、先に整理します。
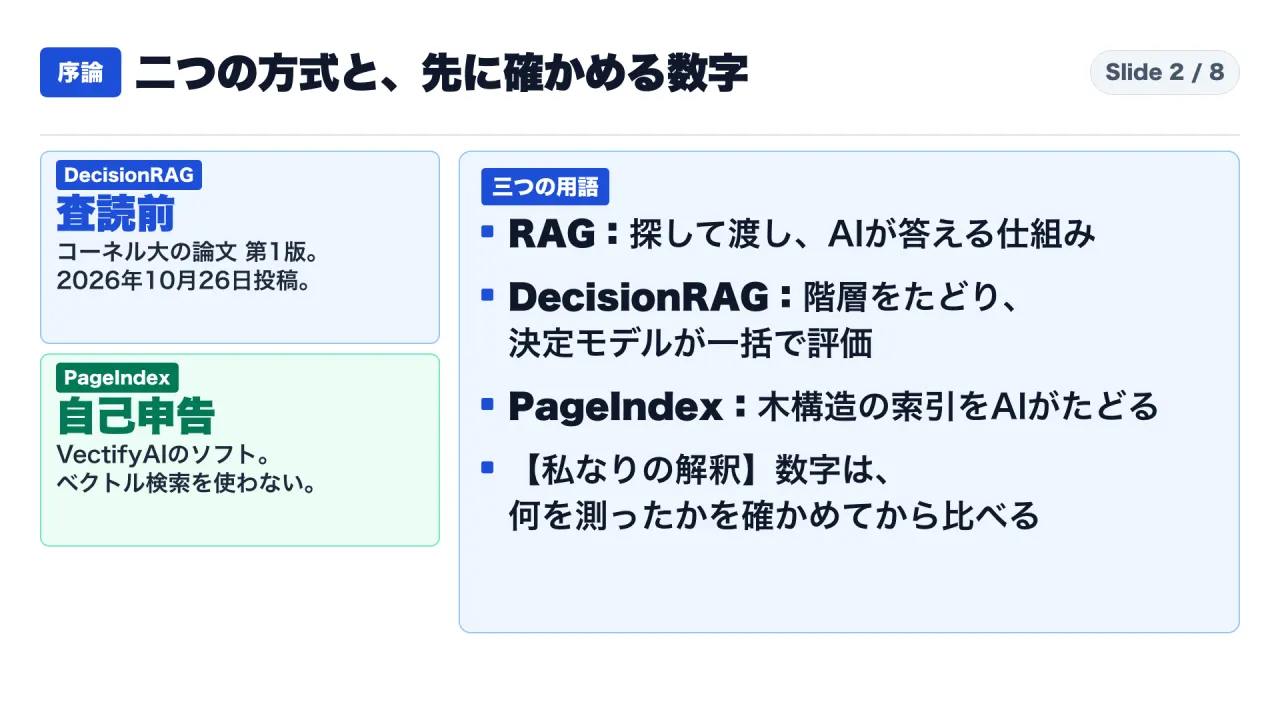
図2は、この記事で扱う二つの方式と、三つの用語を一枚にまとめたものです。DecisionRAGは査読前の論文、PageIndexは開発元の自己申告である点を、先に押さえてください。
RAGは、検索拡張生成の略です。AIが答える前に、社内の文書などから関連する箇所を探して渡し、その内容をもとに答えさせる仕組みです。答えの質は、探す部分の精度に左右されます。探す部分が正解の箇所を渡せなければ、どれだけ賢い生成モデルでも、正しい答えを作れないからです。
密検索は、質問と文書の箇所を、数字の並び(ベクトル)に直し、近いものを探す方法です。この記事の論文では、Qwen3-Embedding-8Bというモデルが、この役を担っています。リランカーは、最初の検索で見つかった上位の候補を、別のモデルで並べ替える部品です。論文の比較相手では、密検索の上位100件を、Qwen3-Reranker-8Bという8Bのリランカーで並べ替えています。GPT-5を使う相手は、上位20件を並べ替えます。
R@1とHit@1は、どちらも、正解の箇所が検索結果の1位に来たかを見る指標です。論文の図には、Hit@1について「gold ranked first」、つまり正解が1位、と注記があります。MultiDoc2Dialは、各ターンの正解の段落が1つなので、R@1は、その1つが1位に来た割合と読めます。これは私の整理です。
ここで大事なのは、これらが検索の指標で、最終回答の正しさではない点です。検索で1位に来ても、生成モデルが誤って答えることはあります。逆に、1位でなくても、上位5件に入っていれば、正しく答えることもあります。DecisionRAGの論文は、最終回答も別の表で測っています。この点は、第4章で見ます。
使う前の五つの問い
この記事で確かめた内容を、先に五つの問いにまとめます。数字を見たら、この順に確かめます。
一つ目は、何を測ったかです。検索の1位率か、最終回答の正答率か。二つ目は、比べた相手は最も強い相手かです。標本は揃っているか。三つ目は、誰が、どの設定で測り、誰が採点したかです。人の判定は何問か。四つ目は、自社の文書に、階層や目次があるかです。なければ誰が作るか。五つ目は、答えるモデルと推論の強さは何か、時間と費用を自分の環境で測れるかです。
第1章:DecisionRAGの13.8ポイントは、リランカーに対する、検索の1位率の差です
DecisionRAGの方式を、論文の言葉で整理します。論文の要旨は、決定モデルが、候補の枝を一度にまとめて評価し、文章は生成しない、と書いています。文書を、話題、文書、節、段落の階層として見て、上の階層から順に、見込みのある枝を選んで絞ります。人が図書館で、棚の分類から本へ進むのに似ています。これは論文の比喩を、私が言い換えたものです。
使う決定モデルは、TypeSafe AI(タイプセーフ・エーアイ)のJev(ジェヴ)1.13です。論文の参考文献は、OpenRouter(オープンルーター)のページを指しています。論文は、費用を「API費用」として測っているので、ここから、自社のサーバーで動かす方式ではなく、外部のモデルを呼ぶ方式だと読めます。ただし、重みが公開されているかどうかは、私は確認していません。
評価は、四つのベンチマークで行われています。この記事では、見出しの二つを見ます。MultiDoc2Dialは、アメリカ政府のヘルプ文書をもとにした対話で、評価は検証用の4,201ターンです。各ターンに、正解の段落が1つあります。コーパスは、4つのヘルプセンター、413ページ、4,110段落です。Natural Questionsは、実際の検索クエリで、Wikipedia 108,626ページ、約268万段落が対象です。評価は、DAPR版のテスト用3,610問から無作為に選んだ500問です。
Natural Questionsには、ページより上の階層がありません。そこで論文は、ページを、k-meansという方法で1,000群にまとめ、各群の説明を、Qwen3-8Bに一文で書かせています。つまり、階層は論文の側で用意したものです。残りの三つのベンチマークは、元の文書の構造とメタデータから階層を作っています。
見出しの比較相手は、論文の表の中の「Dense top-100 + Qwen3-Reranker」です。Qwen3-Embedding-8Bで探した上位100件を、Qwen3-Reranker-8Bで並べ替えます。MultiDoc2DialのR@1は、DecisionRAGが47.4、この相手が33.6です。Natural QuestionsのHit@1は、65.4と48.0です。私の計算で、差は47.4−33.6で13.8、65.4−48.0で17.4となり、論文の記載と一致します。
この方式の中心にあるのは、候補を一つずつ別々に採点せず、同じ文脈の中でまとめて採点する点です。論文は、MultiDoc2Dialの設計用データで、選ばれたページの段落を、ページごとに採点する場合と、まとめて採点する場合を比べています。R@1は、ページごとだと36.7%、まとめると44.4%で、差は7.7ポイントです。複数の候補を同時に見ると、互いを比べながら点を付けられるので、点数が比べやすくなる、というのが論文の説明です。この比較は、設計用データでの結果で、見出しの13.8や17.4とは別のデータです。
もう一つ、構成の決め方に触れます。論文は、検索の構成(候補の表し方、絞る件数など)を、評価用とは別の設計用のデータで選んだ、と書いています。設計用のデータで選び、別のデータで評価する手順は、評価の公平さを保つ標準的なやり方です。ただし、それでも、この構成は、論文が選んだ階層と予算での値です。自社の文書に同じ階層と予算を作れるかは、別の問いです。
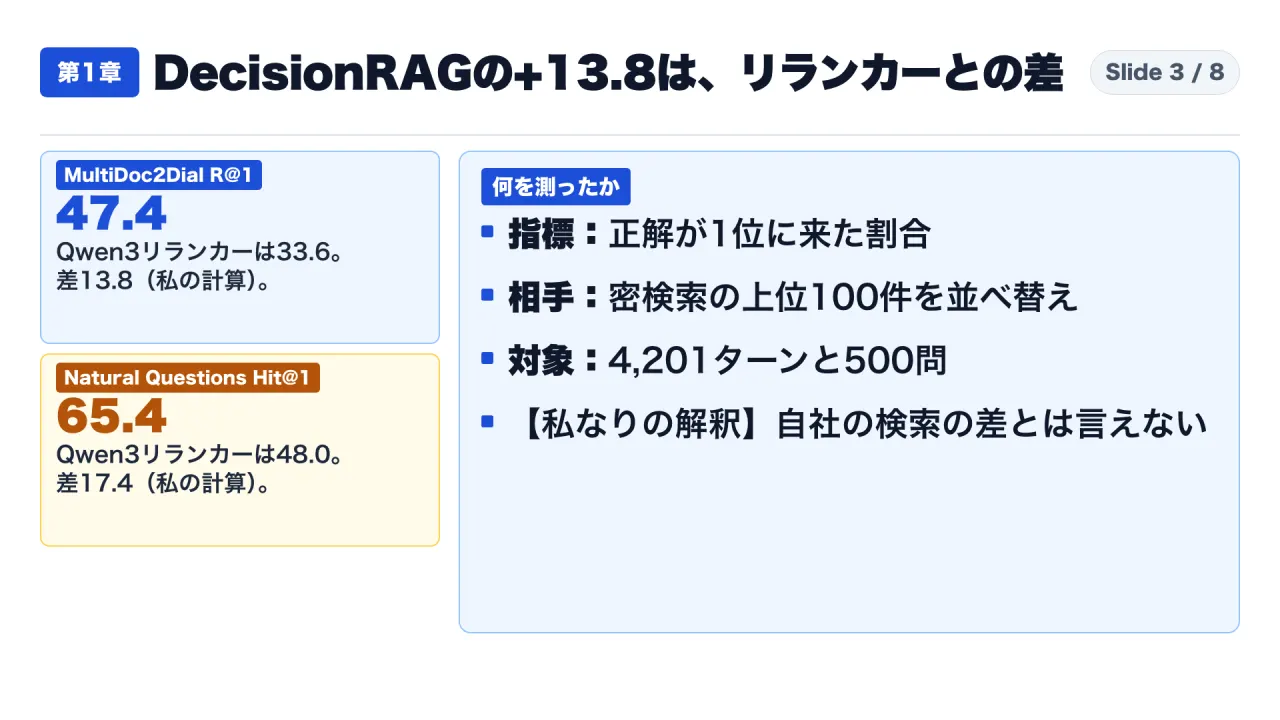
図3は、第1章の要点です。左の二つの数字が、論文の表から引いた値と、私の計算した差です。右に、指標、相手、対象、そして私の解釈を並べています。
ここは私の解釈です。13.8と17.4は、リランカーとの差としては正しい数字です。ただし、それは、論文が選んだ階層と予算で、Jevという決定モデルを使って測った値です。自社の検索の差とは言えません。
第2章:PageIndexの98.7%は、2025年2月のブログに由来する、FinanceBench公開150問の、人の判定を含む数字です
PageIndexは、VectifyAIがGitHubで公開しているソフトです。READMEは、PageIndexを「ベクトルを使わない、推論ベースのRAG」と呼び、ベクトルの索引の代わりに、階層的な木構造の索引を作り、AIがその木を推論しながらたどる、と説明しています。
READMEのFinanceBenchの節は、PageIndexが98.7%の精度に達し、ベクトル検索ベースのRAGを大きく上回った、と書いています。同じ節の図は、PageIndexが98.7%、ベクトルRAGが50%の、横棒2本です。私が図の画像を開いて確認した範囲では、図の中に、設定の注記はありませんでした。READMEのほかの箇所にも、ベクトルRAGの50%の条件は、私が確認した範囲では、見つかりませんでした。
98.7%のリンク先は、Vectifyのブログで、公開日は2025年2月19日です。ブログは、PageIndexを基にしてMafin 2.5を作った、と書き、98.7%はMafin 2.5の値だとしています。つまり、READMEの「PageIndexが98.7%」は、PageIndexを基にした製品の、2025年2月の値です。現在公開されているPageIndexそのものの値かどうかは、資料に書かれていません。
FinanceBenchは、2023年11月に論文が公開された、金融文書の質問応答のテストです。論文の要旨によれば、全体は10,231問で、公開されているのは150問の標本です。Mafin 2.5のREADMEは、評価の対象を「FinanceBenchの公開セット」と書き、表の「全体を評価したか」の列を100%としています。私の解釈では、この100%は、公開の150問の全部を指します。全体の10,231問ではありません。
結果ファイルには、150問それぞれに、ラベルが付いています。ラベルの意味は、人手評価のREADMEが定義しています。AL(一致)は、結論と方法の両方が模範解答に合うことです。NAL(不一致)は、必要なデータを見つけられなかった、または取得したデータを誤解したことです。BE(ベンチマーク側の誤り)は、模範解答に誤解を招く数字があり、Mafinの答えは根拠つきで妥当、という意味です。MVA(複数の妥当な方法)は、違う、妥当な方法や視点を使ったことです。SEDC(同じ証拠で別の結論)は、同じ証拠から、解釈や問いの捉え方の違いで、別の妥当な結論に至ったことです。
GPT-4oの版の結果ファイルを、私が集計すると、ALが136問、BEが6問、MVAが5問、NALが2問、SEDCが1問でした。DeepSeek V3の版も、同じ集計です。さらに、一致以外の14問の番号とラベルの組は、二つのファイルで完全に同じでした。READMEは、どちらの基盤モデルでも98.7%で、基盤には依存しない、と書いています。
| ラベル | 意味(人手評価READMEの定義) | 問数 |
|---|---|---|
| AL | 結論と方法の両方が模範解答に合う | 136 |
| BE | 模範解答側に誤解を招く数字があり、Mafinの答えは妥当 | 6 |
| MVA | 違う、妥当な方法や視点を使った | 5 |
| SEDC | 同じ証拠で、別の妥当な結論に至った | 1 |
| NAL | 必要なデータを見つけられない、または取得データを誤解 | 2 |
私の計算を書きます。一致(AL)の136問だけなら、136÷150で90.67%です。BE、MVA、SEDCの合計12問を足すと、148÷150で98.67%となり、表示の98.7%に合います。READMEとブログには、この算式の明記が見つかりませんでした。ですから、「12問を正解側に数えている」というのは、ラベルの数と表示の数字が合うことからの、私の推定です。
採点のコードも公開されています。eval.pyは、GPT-4oの2024年11月版(gpt-4o-2024-11-20)を判定役にして、温度は0です。判定の基準には、「模範解答を含む、より広い答えも正解」「妥当な解釈も正解」「主観的な判断でも、妥当で説明できれば正解」と書かれています。この基準は、緩やかだとは言えますが、誤りだとは言えません。金融の質問には、複数の妥当な答え方があるからです。ただし、この基準が、数字の高さに影響しうる点は、読み手が知っておく必要があります。
READMEは、ベンチマーク自体の限界も書いています。模範解答に誤りや曖昧さがありうること、単一の文書からの簡単な検索が中心で、複数の文書にまたがる推論が含まれていないことです。開発元が自分で限界を書いている点は、評価できます。
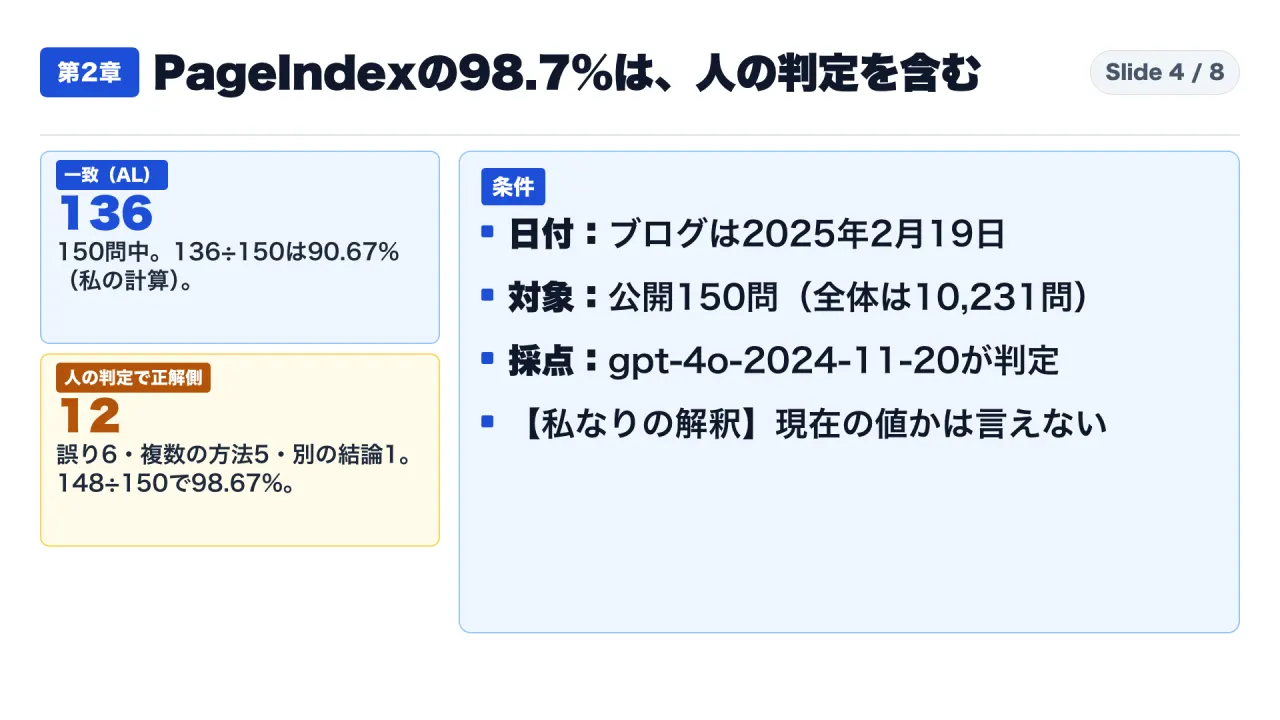
図4は、第2章の要点です。左の二つの数字が、一致の136問と、人の判定で正解側に数えられた12問です。右に、日付、対象、採点、私の解釈を並べています。
ここは私の解釈です。98.7%は、検索だけでなく、答えの生成と採点の全部を含む数字です。人の判定を含み、測ったのは2025年2月の構成です。この数字は、「PageIndexの検索の精度」ではなく、「その構成で、公開150問に、人の判定込みで答えられた割合」です。現在のPageIndexで同じ数字が出るかは、資料から言えません。
第3章:比較。二つの資料に印刷された相手を、出典と設定つきで並べます。指標もベンチマークも別なので、順位は付けません
ここでは、代表的な相手との比較を、各資料に印刷されている範囲で整理します。ルールは二つです。設定が揃っている範囲では、同じ表の数字を並べます。設定が揃わない行は、「出所により異なる」と書き、順位を付けません。
まず、DecisionRAGの論文のTable 2です。三つのベンチマークの数字を並べます。ここで、設定は同じ表の中で揃っています。リランカーは密検索の上位100件、GPT-5は上位20件を並べ替え、GPT-5の推論の強さは「低」です。Natural Questionsは、約268万段落の全部を探索します。
| 方式(論文Table 2) | MultiDoc2Dial R@1 | ConditionalQA Hit@1 | Natural Questions Hit@1 |
|---|---|---|---|
| DecisionRAG(Jev) | 47.4 | 69.7 | 65.4 |
| 密検索 + GPT-5(上位20件) | 47.5(※) | 73.4 | 60.8 |
| 密検索 + Qwen3-Reranker(上位100件) | 33.6 | 64.6 | 48.0 |
| 密検索 + BGE(上位100件) | 22.8 | 53.1 | 54.8 |
| 密検索のみ(Qwen3-Embedding-8B) | 27.9 | 47.2 | 46.2 |
| SPLADE++ | 24.4 | 28.4 | 36.0 |
| BM25 | 20.6 | 24.7 | 16.4 |
※ 論文の付録の注記によれば、GPT-5の行は、MultiDoc2Dialの検証4,201ターンのうち、1,000ターンの標本での値です。同じ標本で、DecisionRAGの主要な行は49.9です。
この表から、私の計算を三つ書きます。一つ目は、GPT-5との差です。MultiDoc2Dialは、同じ標本で49.9−47.5=2.4ポイント上です。Natural Questionsは65.4−60.8=4.6ポイント上、ConditionalQAは69.7−73.4=−3.7、つまり3.7ポイント下です。論文自身も、GPT-5が「ConditionalQAのHit@1では上」と書き、全体としては「同等かそれ以上」と書いています。見出しの13.8と17.4は、最も高い相手との差ではありません。
二つ目は、Natural QuestionsでのBGEの位置です。小さいBGEのリランカーは54.8で、8BのQwen3のリランカーの48.0を、54.8−48.0=6.8ポイント上回ります。見出しの相手は、この表で最も強い相手ではありません。DecisionRAGとBGEの差は、65.4−54.8=10.6ポイントです。
三つ目は、論文とPageIndexの関係です。論文は、PageIndexを動かして比べていません。論文でPageIndexの名前が出るのは、私が数えた範囲で、三か所です。関連研究で「文書の目次をAIの案内に使う」と書き、6.3節で、生成型の階層探索の例として挙げ、参考文献で、論文ではなくGitHubのリポジトリとして引用しています。6.3節の「GPT-5の生成型」の行は、LATTICE(ラティス)という別の手法の方式を、GPT-5で再現した比較で、PageIndexの成績ではありません。
次に、PageIndexの側です。READMEの図に載る相手は、ベクトルRAGの50%だけで、条件の記載はありません。READMEが指すMafin2.5のリポジトリには、FinanceBenchでの比較表があります。
| 方式(Mafin2.5 README) | 精度(%) | 対象の範囲 | 結果の公開 |
|---|---|---|---|
| Mafin2.5 | 98.7 | 全体(100%) | あり |
| Quantly | 94 | 全体(100%) | なし |
| Fintool | 98 | 一部(66.7%) | なし |
| ChatGPT 4o + 検索 | 31 | 一部(66.7%) | なし |
| Perplexity | 45 | 一部(66.7%) | なし |
各行の出典は、Quantlyの行がQuantlyのsubstackのページ、Fintool、ChatGPT 4o + 検索、Perplexityの三行がFintoolのサイトのページです。この三行は、対象が66.7%で、結果が公開されていません。表の「全体(100%)」は、公開の150問の全部の意味と、私は読んでいます。66.7%は、私の計算で、150問の約100問にあたりますが、表には問数が書かれていません。出典が行ごとに違うので、測った人も、行ごとに違う可能性があります。
表の読み方を補います。「対象の範囲」が100%でない行は、公開の問題の一部だけで測った数字です。一部だけで測ると、易しい問題ばかりが入っている場合も、難しい問題ばかりが入っている場合も起こりえます。どちらなのかは、表からは分かりません。また、「結果の公開」が「なし」の行は、第三者が同じ問題で採点をやり直せません。ですから、この表は、横に並べて順位を付ける表ではなく、各行がどこまで確かめられるかを読む表です。
FinanceBenchを作った側の論文には、別の数字があります。2023年に、16の構成を、150問の標本で調べ、検索つきのGPT-4-Turboが、質問の81%を誤答か回答拒否した、と書いています。これは、世代の違うモデルで、約3年前の測定です。2026年のモデルとの比較には使えません。
ここは私の解釈です。これらの比較は、出典ごとに、「測った人が違う」「対象の範囲が違う」「結果が非公開」と読みます。DecisionRAGの検索の1位率と、PageIndexの回答の正答率は、指標もベンチマークも別なので、どちらが上かは決めません。順位は、各表に印刷されている範囲だけを使います。
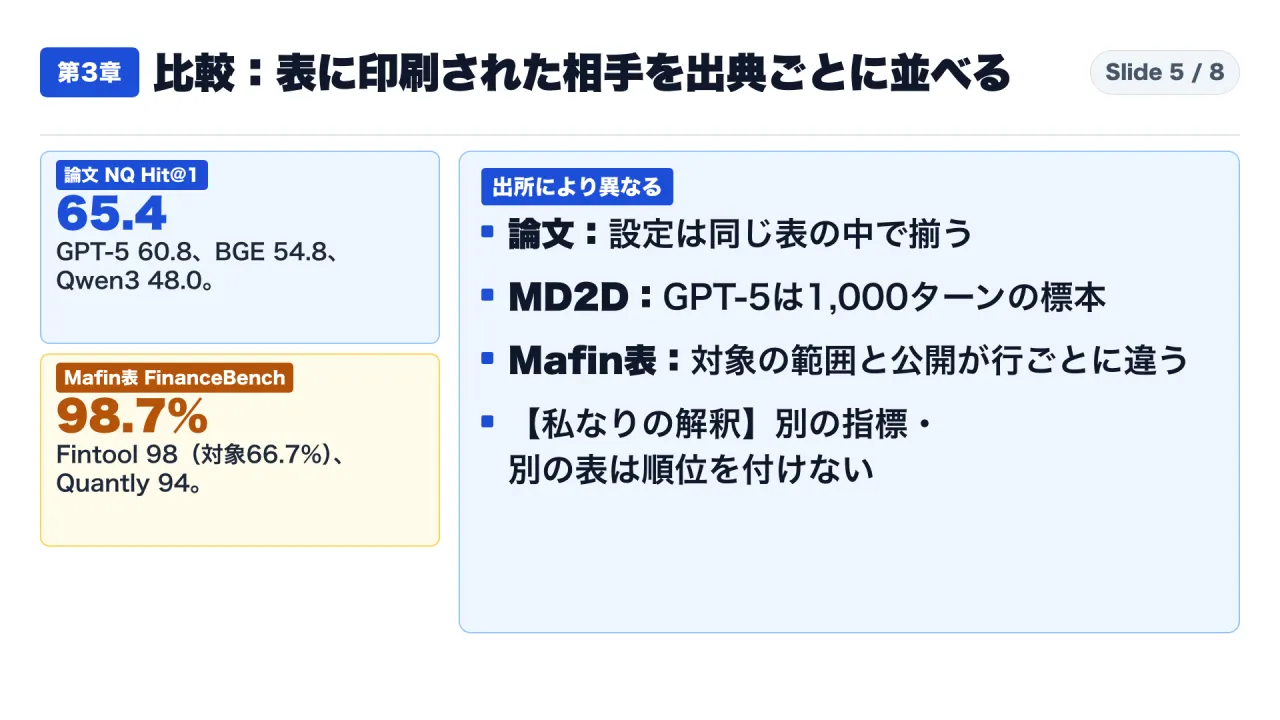
図5は、第3章の要点です。左に、論文のNatural Questionsの数字と、Mafin2.5の表の数字を並べ、右に、出所により異なる点を並べています。
第4章:自社で再現する条件は、階層、API、採点、答えるモデルの強さです
DecisionRAGを自社で試す条件から見ます。論文の限界の節は、階層の構造と、各項目の説明文の質に頼る、と書いています。整理の悪い文書や、情報の乏しい説明文では、検索の質が落ちうる、とも書いています。また、枝刈りは取り消せない、とも書いています。上の枝で外れると、その中の段落は、あとから見つかりません。論文は、探索の予算を増やすことと、密検索の候補を足すことで、この問題を和らげられる、と書いています。
自社の文書に、章や節の構造が整っていて、各節の内容を一文で説明できるなら、この前提は満たしやすくなります。逆に、構造のないテキストの山や、見出しが内容を表していない文書では、階層づくりから始める必要があります。MultiDoc2Dialは、元の文書の構造から階層を作れました。Natural Questionsは、論文が群づくりと説明文づくりを自動で行いました。自社の文書で、どちらに近いかを、先に確かめます。
速さと費用です。論文は、DecisionRAGが1問あたり0.68秒から1.76秒、API費用が0.22セントから2.33セントと書いています。比べた相手は、密検索とQwen3のリランカーをGPU1枚で動かした場合の3.3秒から14.3秒、GPT-5の並べ替えの11.8秒から15.0秒です。ただし、論文は付録で、機械と標本が方式ごとに違うので、速度の比は、統制された比較ではない、と明記しています。DecisionRAGはAPI、リランカーは手元のGPU、GPT-5はAPIと、測った環境が違います。この差は、自社の環境の差を、そのまま表しません。
最終回答では、差が縮みます。論文のTable 3は、一つの生成モデル(Qwen3.5-27B)に、各方式の上位5件を渡して、最終回答を測っています。Natural Questionsの完全一致は、DecisionRAGが54.2、密検索のみが53.0、GPT-5が54.5、Qwen3のリランカーが52.4です。私の計算で、DecisionRAGと密検索のみの差は1.2ポイントです。一方、MTRAG(エム・ティー・ラグ)という別のベンチマークでは、正答と判定された割合が、DecisionRAGで44.1、GPT-5で34.0、密検索のみで31.4と、差が大きく出ています。何を測るか、どのベンチマークかで、見え方が変わります。
論文は、同じ階層のまま、決定モデルをGPT-5に替えて、候補を文章で選ばせる比較もしています。この場合、ConditionalQAのHit@1ではGPT-5が4.1ポイント上、Natural Questionsでは6.0ポイント下で、速さと費用は、DecisionRAGの方が、34倍から145倍速く、21倍から25倍安い、と論文は書いています。論文の結論は、生成で選ばせても、精度が一貫して上がるわけではない、というものです。ただし、これもDecisionRAGの論文の中の比較です。PageIndexの成績ではありません。
公式のコードについて、私が確認した範囲を書きます。論文の本文とarXivの要旨ページには、GitHubのリンクが見つかりませんでした。GitHubで同名のDecisionRAGを検索すると、4件ありました。3件は、論文の投稿より前に作られています。残る1件は、投稿の翌日に作られた、企業の規程のPDFを扱う別のサービスで、著者の公式とは確認できません。ですから、この記事では、公式コードとしてリンクしません。
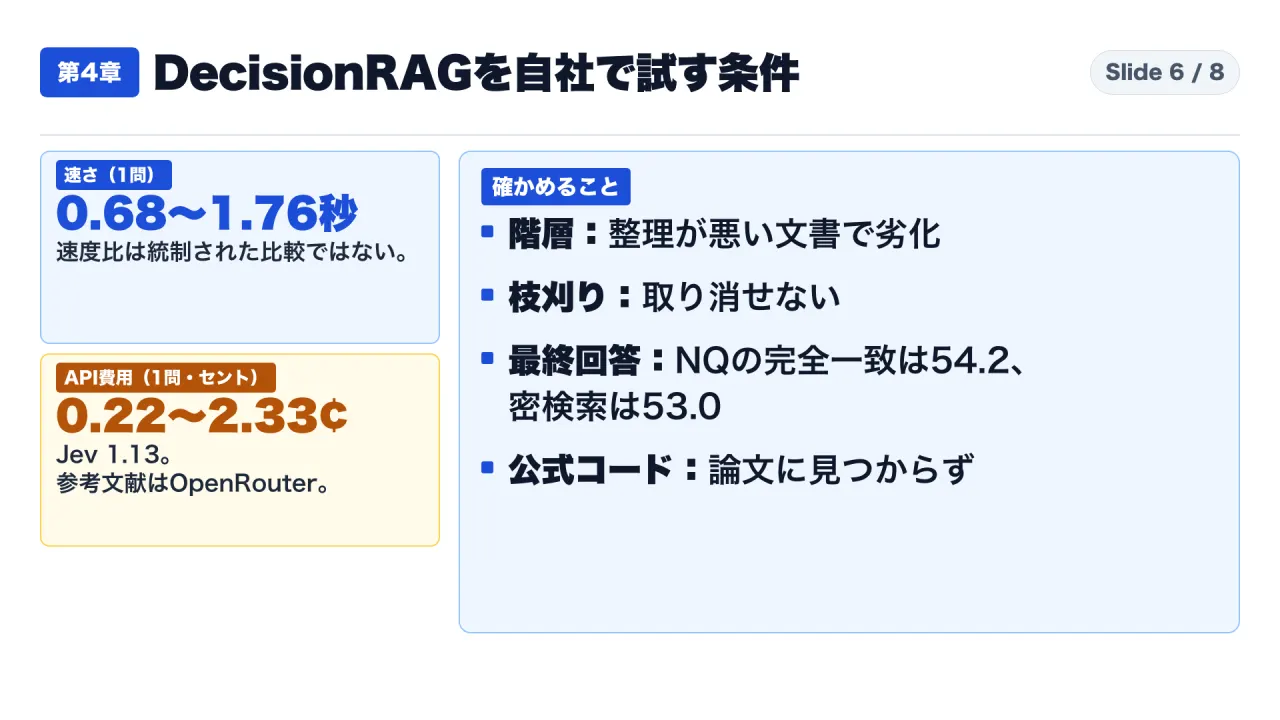
図6は、DecisionRAGの条件の要点です。左に速さと費用、右に確かめることを並べています。
次に、PageIndexの側です。PageIndex自身のFinancial QA Benchmarkは、Mafin2.5のFinanceBenchとは別のベンチマークです。40本のForm 10-K(アメリカの有価証券報告書にあたる書類)と、100問に、37構成のLLMが答えます。検索は同じPageIndexで、答えるLLMと、推論の強さだけを変えています。問題は、Claude Opusのエージェントが10-Kから書き、別のエージェントが検証したものです。実施は、Vectify自身です。
最上位は、Claude Opus 5.5の最大設定で98.7%です。これは、Mafin2.5の98.7%とは、別のベンチマークで、数字が同じです。混同しないでください。同じ表で、Claude Sonnet 5.5は、推論の強さが「高」で81.7%、「最大」で98.0%です。私の計算で、98.0−81.7=16.3ポイントの差です。同じ検索でも、答えるモデルと設定で、結果が大きく動きます。
| 構成(Financial QA Benchmark) | 推論の強さ | 精度(%) |
|---|---|---|
| Claude Opus 5.5 | 最大 | 98.7 |
| Claude Sonnet 5.5 | 最大 | 98.0 |
| Claude Sonnet 5.5 | 高 | 81.7 |
この表は、PageIndexの数字が、検索の良さだけでなく、答えるモデルの強さと推論の設定に左右されることを示しています。READMEの図の98.7%と、この表の98.7%は、別のものです。
資料同士の食い違いも一つあります。PageIndexのREADMEは、このベンチマークを「34構成・19モデル」と書き、同じ組織のベンチマークのリポジトリは「37構成・21モデル」と書いています。READMEが古い可能性がありますが、原因は資料に書かれていません。
もう一つ、READMEは、Page Search APIで、文書質問応答のトークン費用を97%削減、と書いています。根拠として示されたPage Search benchmarkのREADMEは、「返さないページの割合」として、97.1%を載せています。対象は、80問・39本の報告書です。この数字は、返さないページの割合で、トークンの請求額の実測とは書かれていません。
同じベンチマークの表には、上位10ページに証拠のページが入る割合が載っています。Page Search APIが97.5%、Voyage 4 Largeが83.8%、Gemini Embedding 2が70.1%、OpenAIのtext-embedding-3-largeが68.0%です。実施はVectifyで、PageIndex本体ではなく、Page Search APIの値です。
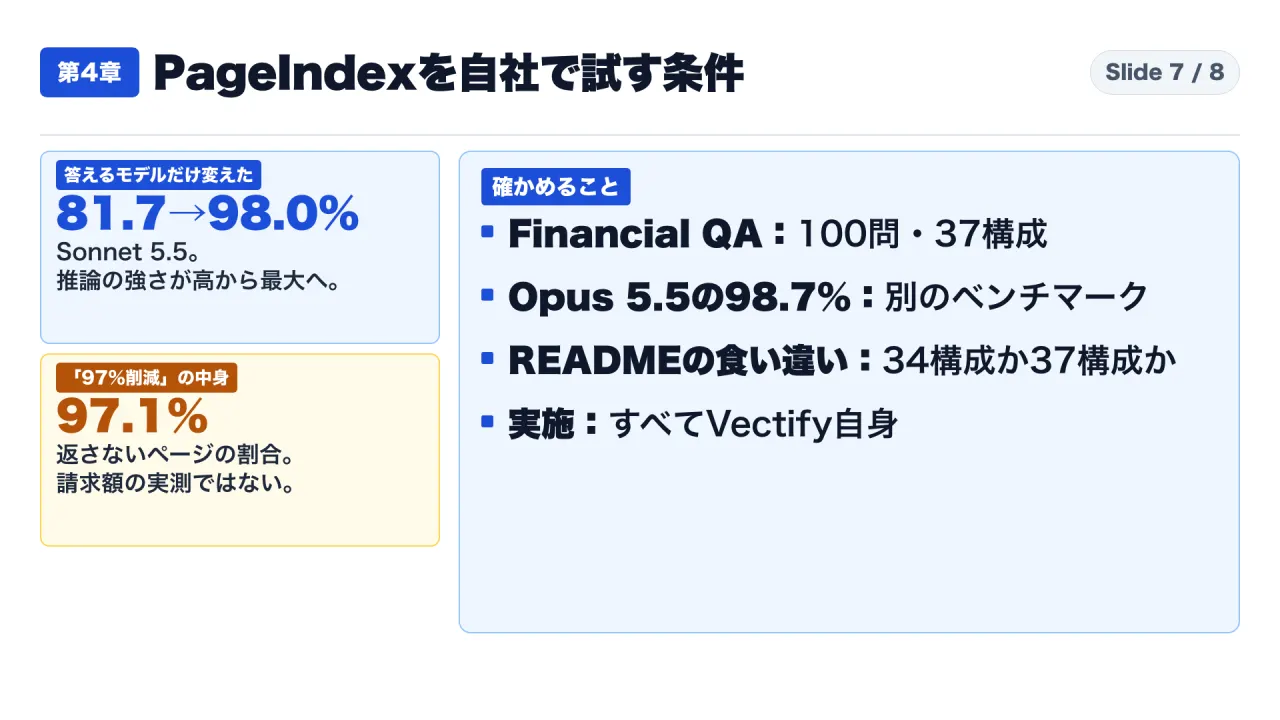
図7は、PageIndexの条件の要点です。左に、答えるモデルで動く数字と、97%の中身を並べ、右に確かめることを並べています。
ここは私の解釈です。PageIndexの数字は、どれも開発元の自己申告です。第三者の再現は、私が探した範囲では、見つけていません。DecisionRAGの論文の数字も、第三者の再現は見つけていません。新しい手法の数字は、どちらも、公開から日が浅いほど、更新されやすい点にも注意が要ります。
結論:使う前の五つの問いと、自社の文書で試す手順
最初に挙げた五つの問いに戻ります。一つ目は、何を測ったかです。DecisionRAGの数字は、検索の1位率です。PageIndexの98.7%は、答えの生成と採点を含む正答率です。二つ目は、比べた相手が最も強い相手かです。DecisionRAGの見出しの相手は、比較相手の中で最も強い相手ではありませんでした。三つ目は、誰がどの設定で測り、誰が採点したかです。PageIndexの98.7%は人の判定12問を含み、公開された採点コードの判定役はGPT-4oです。四つ目は、自社の文書に階層や目次があるかです。DecisionRAGは階層が前提です。五つ目は、答えるモデルと推論の強さです。PageIndexの数字は、ここで大きく動きます。
次に、自社の文書で試す手順です。これは私の提案で、数字の根拠はありません。まず、実際の質問を、30問前後集めます。人が実際に困って検索した質問を使うと、実態に近くなります。正解の置き場所、つまり、どの文書のどの箇所に答えがあるかを、人が先に決めます。試す方式の出力を見てから決めると、結果に引きずられるからです。
次に、いまの検索と、試したい方式に、同じ質問を通します。そして、正解が1位に来た数と、最終回答の正答数を、別々に数えます。別々に数えるのは、この記事で見たように、検索の1位率と最終回答の正答率で、差の大きさが違うからです。さらに、答えるモデルと、推論の強さを変えて、もう一度通します。PageIndexの例では、同じ検索でも、答えるモデルと設定で、16.3ポイント動きました。
最後に、時間と費用を、自分の環境で測ります。DecisionRAGは、外部のモデルをAPIで呼ぶ構成が論文の測定です。契約、通信、データを外部へ送ってよいかという社内ルールも、確認の対象です。PageIndexは、索引づくりの費用を1ページあたり約0.001ドルと、READMEが書き、時間は文書の長さに応じて増えると書いていますが、自社の文書の量で測り直す必要があります。
試す質問は、種類ごとに分けて集計します。表の中の数字を探す質問、複数の節にまたがる質問、文書にない答えを聞く質問、と分けて、種類ごとに正答率を出します。全体の平均だけを見ると、苦手な種類が隠れます。文書にない答えを聞く質問は、特に大事です。検索の仕組みが、「ない」と答えられず、近い箇所を無理に渡してしまうと、生成モデルが、もっともらしい誤りを答えるからです。
結果の持ち方も決めておきます。数字だけでなく、使ったモデルの版、設定、実行日、採点のルール、人の判定をした問数を、一緒に残します。この記事で見た二つの数字は、このどれかが読み手に見えにくかったために、そのままでは使えませんでした。自分の結果は、同じ失敗をしないように残します。
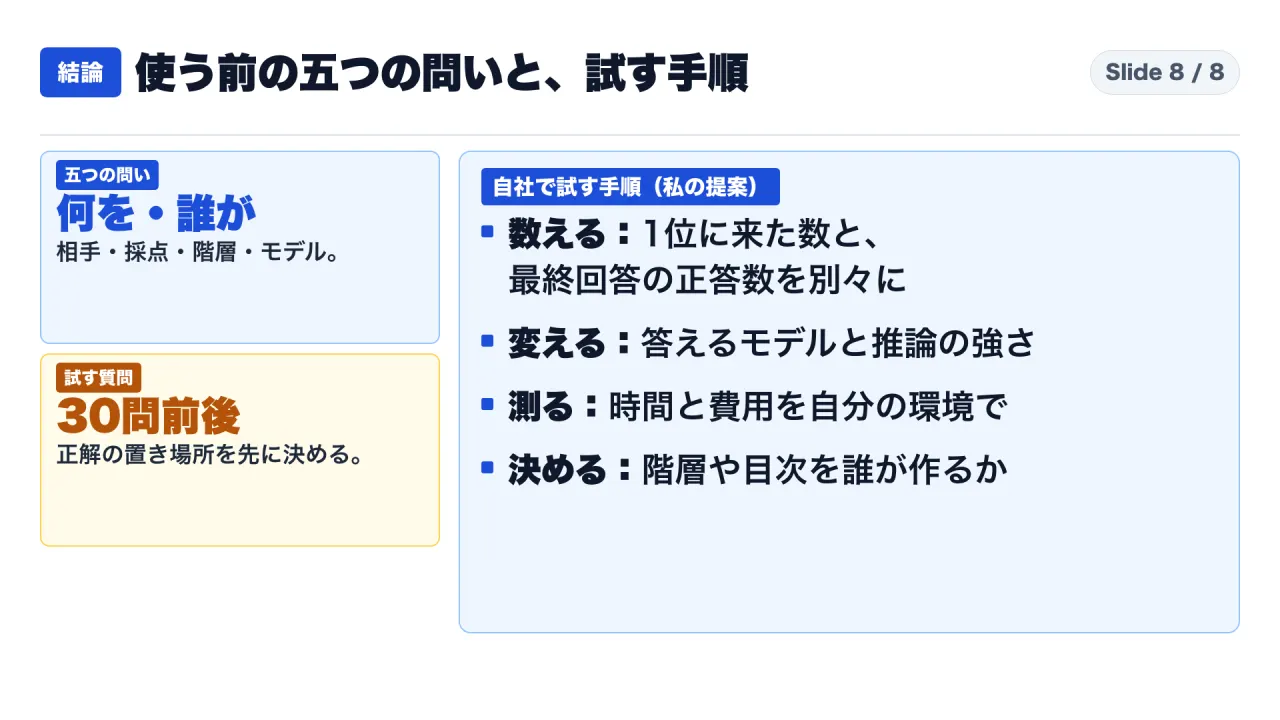
図8は、結論の要点です。左に五つの問いと試す質問の数、右に手順を並べています。
この記事で言えないことを、最後にまとめます。一つ目。DecisionRAGの論文の数字を、第三者が再現したかは、私が探した範囲では、見つけていません。二つ目。PageIndexの98.7%を、私は再計算していません。私がしたのは、ラベルの集計と引き算だけです。三つ目。私は、どちらのソフトも動かしていません。四つ目。二つの数字は、ベンチマークも指標も別なので、どちらが優れているかは、言えません。また、数字は、2026年11月2日に取得した時点のものです。論文はarXivの第1版で、以降の版で数字が変わっている場合は、この記事の内容も古くなります。
この記事で一番伝えたいのは、数字を疑うことではなく、数字に付いている条件を、一緒に読む習慣です。何を測り、誰と比べ、誰が採点したかが分かれば、同じ数字でも、使える範囲が見えてきます。分からなければ、「分からない」と書いて、自分の文書で確かめる。それが、検索の仕組みを仕事に入れるときの、安い保険だと、私は考えます。
最後の確認リスト
- 数字は、検索の1位率か、最終回答の正答率かを確かめたか
- 「何ポイント上」の相手は、同じ表で最も強い相手か。標本は揃っているか
- 誰が測り、誰が採点したか。人の判定は何問含まれているか
- 自社の文書に、階層や目次があるか。なければ、誰が作るか
- 答えるモデルと推論の強さを変えて、結果がどう動くかを見たか
- 時間と費用を、自分の環境で測ったか。外部へ送るデータの扱いは確認したか
最後に、一つ質問です。皆さんの会社で、検索の仕組みを選ぶとき、成績表の数字が、何を測ったものかを、確かめていますか。コメントで教えてください。
YouTube本編:https://youtu.be/Z9fMXJQ9z-o
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- DecisionRAG 論文の要旨ページ(arXiv:2610.35868):https://arxiv.org/abs/2610.35868
- DecisionRAG 論文の本文(arXiv:2610.35868 PDF):https://arxiv.org/pdf/2610.35868
- PageIndex GitHub README(VectifyAI):https://github.com/VectifyAI/PageIndex
- Mafin2.5-FinanceBench README(VectifyAI):https://github.com/VectifyAI/Mafin2.5-FinanceBench
- Vectify ブログ「PageIndex Leads Financial QA Benchmark」:https://vectify.ai/blog/Mafin2.5
- Mafin2.5 人手評価のラベル定義(GitHub):https://github.com/VectifyAI/Mafin2.5-FinanceBench/tree/main/human_evaluations
- Mafin2.5 結果ファイル(GitHub):https://github.com/VectifyAI/Mafin2.5-FinanceBench/blob/main/result_gpt4o.json
- Mafin2.5 評価コード eval.py(GitHub):https://github.com/VectifyAI/Mafin2.5-FinanceBench/blob/main/eval.py
- PageIndex Financial QA Benchmark README(GitHub):https://github.com/VectifyAI/pageindex-benchmarks/tree/main/financial-qa
- PageIndex Financial QA Benchmark METHOD.md(GitHub):https://github.com/VectifyAI/pageindex-benchmarks/blob/main/financial-qa/METHOD.md
- Page Search benchmark README(GitHub):https://github.com/VectifyAI/page-search-benchmark
- FinanceBench 論文の要旨ページ(arXiv:2311.11944):https://arxiv.org/abs/2311.11944
- FinanceBench 公開サンプル README(Patronus AI、GitHub):https://github.com/patronus-ai/financebench