OpenAIの推論専用チップは、何を変え、何を変えないのか? 倍率の条件を読む
YouTubeポッドキャスト本編(動画・音声)はこちら:OpenAIの推論専用チップは、何を変え、何を変えないのか? 倍率の条件を読む
結論:変えようとしているのは電力と応答の速さあたりの効率。製造とメモリの世代は、ほかのチップと同じ列にいる。倍率は、比べた条件で意味が変わる
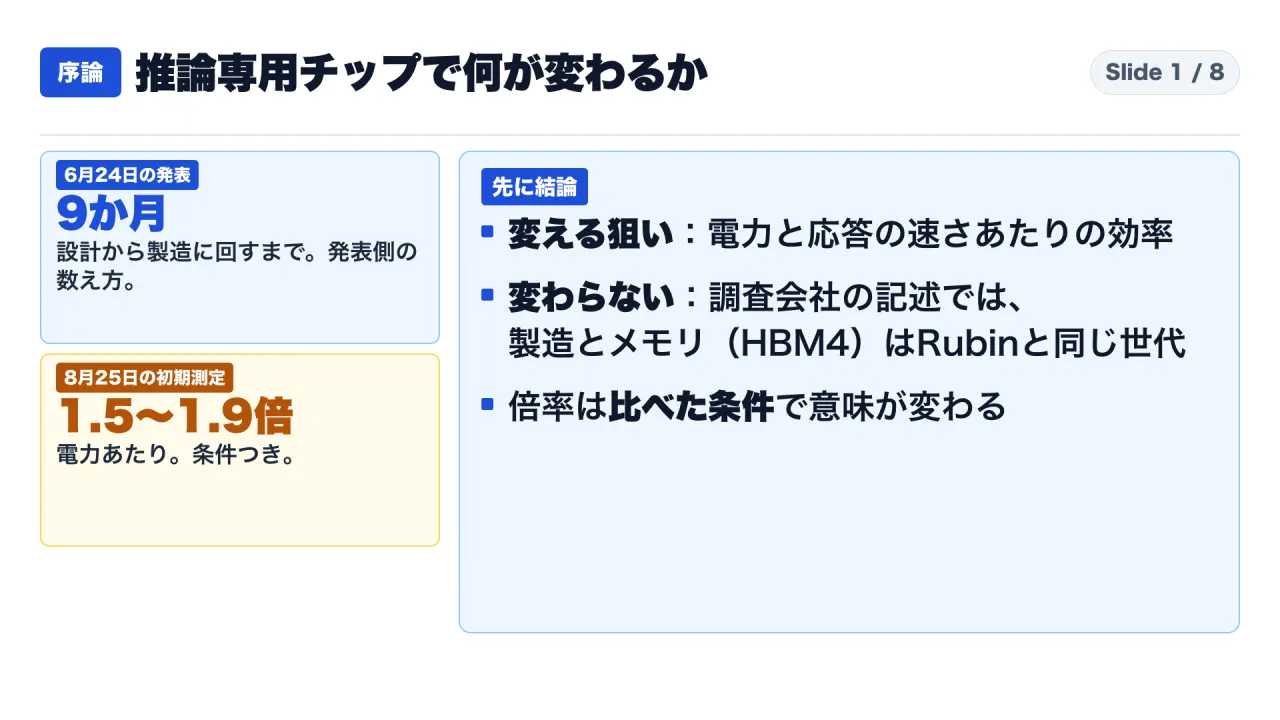
結論から書きます。OpenAIとBroadcomは2026年6月24日、推論専用の自社設計チップ「Jalapeño(ハラペーニョ)」を発表しました。発表文が示す狙いは、今の代表的な加速器の処理量と、最も速い専用の推論システムに近い応答の速さを、一つにすることです。最初の配備は、2026年末までの計画です。ただし、性能の最終値は測定中で、発表文に性能の数字はありません。
2026年8月25日にOpenAIが公表した初期測定では、NVIDIAのブラックウェル世代の2製品(GB200とGB300)に対して、電力あたりの最大処理量が1.5〜1.9倍、応答の全体の遅れが1.7〜3.6倍短い、と報じられています。この倍率には、条件があります。割る数は、実測の消費電力ではなく、各チップの定格電力です。入力は8,000トークン、出力は1,000トークンで、投機的デコードを使っていません。数字はすべてOpenAIが出したもので、立ち会った調査会社のSemiAnalysisも、測定の全体は自分では走らせていません。
変わらないものもあります。SemiAnalysisの記述では、Jalapeñoの計算部分はTSMCのN3Pという工程で、NVIDIAのRubinの計算部分と同じ工程です。メモリもRubinと同じ、第4世代のHBM(HBM4)です。専用化しても、先端の製造とメモリの世代という同じ列に並ぶ、というのが私の読みです。ただし、その供給がどれだけ逼迫しているかを示す数字は、この記事では取れていません。
この記事の対象読者は、AIの利用料金や応答速度の数字を比べて、サービスやインフラを選ぶ立場にある、事業会社の企画、情報システム、調達の担当者です。「電力あたり1.5〜1.9倍」のような倍率を見たときに、何と何を、どんな条件で比べた数字かを確かめたい方に向けて書きました。
読み終えると、次の三つができるようになります。一つ目は、倍率の分母(定格電力か、実測か、設備全体の電力か)を確かめること。二つ目は、測定の条件(入力と出力の長さ、投機的デコードの有無、相手の世代)を確かめること。三つ目は、誰が測ったか(自己申告か、第三者の再現か)を確かめることです。
この記事は、公表された資料を読んだ整理です。
公開直前の再確認(2026年11月3日):OpenAIの発表ページ(6月24日)と初期結果のページ(8月25日)、Broadcomの発表ページを読み、記事で使った数字と記述が一致することを確認しました。
読み方:本文では「事実」「私の解釈」「書かれていないこと」を分けて書きます
本文は、次の三つを区別して書きます。
- 事実:公開された資料に書かれていること。出所は、文のあとと、記事末尾の出典一覧に示します。
- 私の解釈:事実から私が読んだこと。「私の解釈」「私の読み」「私の計算」と明示します。
- 書かれていないこと:確認した範囲で、資料の本文にない項目。取得した本文を読み、語を検索した範囲に限ります。
出所には、三つの種類があります。一つ目は、OpenAIとBroadcomの共同発表です。これは、配信会社が転載した全文で読みました(S1)。執筆時は公式ページを自動で取得できなかったため、公開直前に、OpenAIとBroadcomの公式ページを自分で開いて読み、数字を照合しました。二つ目は、調査会社のSemiAnalysisの分析記事(S2)です。同社は、OpenAIの研究所で測定に立ち会っています。三つ目は、報道(S3・S4)と、各社の公式の製品ページや技術資料(S5〜S11)です。
初期測定の倍率は、執筆時は報道2件(S3・S4)の記述で確認し、公開直前にOpenAIの初期結果のページ(P2)で、倍率とモデルごとの数字が一致することを確認しました。測定の条件(投機的デコードなし、入力と出力の長さ、会話の回数)の一部は、報道(S3・S4)の記述に拠るため、本文では出所を示します。
背景:この記事で使う言葉を先にそろえます
- 推論:学習済みのAIモデルに質問を入れて、答えを出す処理です。モデルを作る処理(学習)とは別です。
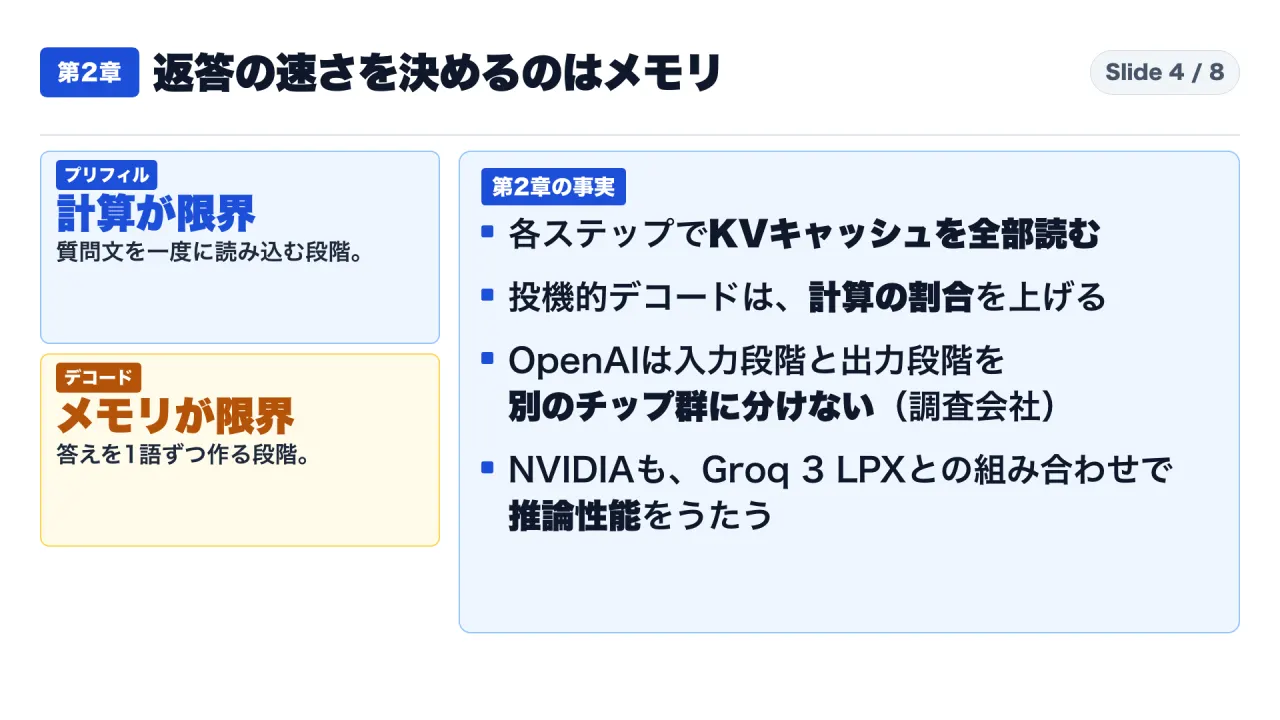
- プリフィルとデコード:大規模言語モデルの返答は二つの段階で作られます。質問文を一度に読み込む段階がプリフィル、答えを一語ずつ作る段階がデコードです。
- トークン:モデルが数える文字の単位です。「入力8,000トークン、出力1,000トークン」は、読み込む量と書き出す量の目安です。
- KVキャッシュ:これまでの会話の記憶です。デコードでは、一語を作るたびに、これを全部読み出します。
- 投機的デコード:複数の語の候補を先に作り、まとめて確かめる方法です。1回の読み出しで進む語数が増えます。
- 定格電力(TDP):メーカーが示す、チップの電力の目安です。実測の消費電力とは別の数字です。
- HBM:チップのすぐ横に積むメモリです。帯域(1秒に読み書きできる量)が大きいことが特徴です。HBM3EからHBM4へ世代が上がっています。
- テープアウト:設計を完成させ、製造に回す段階です。
第1章:公式に確認できるのは、推論専用の自社設計チップと、最初の配備の計画。性能の最終値は測定中
2026年6月24日の共同発表(S1)で確認できることを、順に書きます。
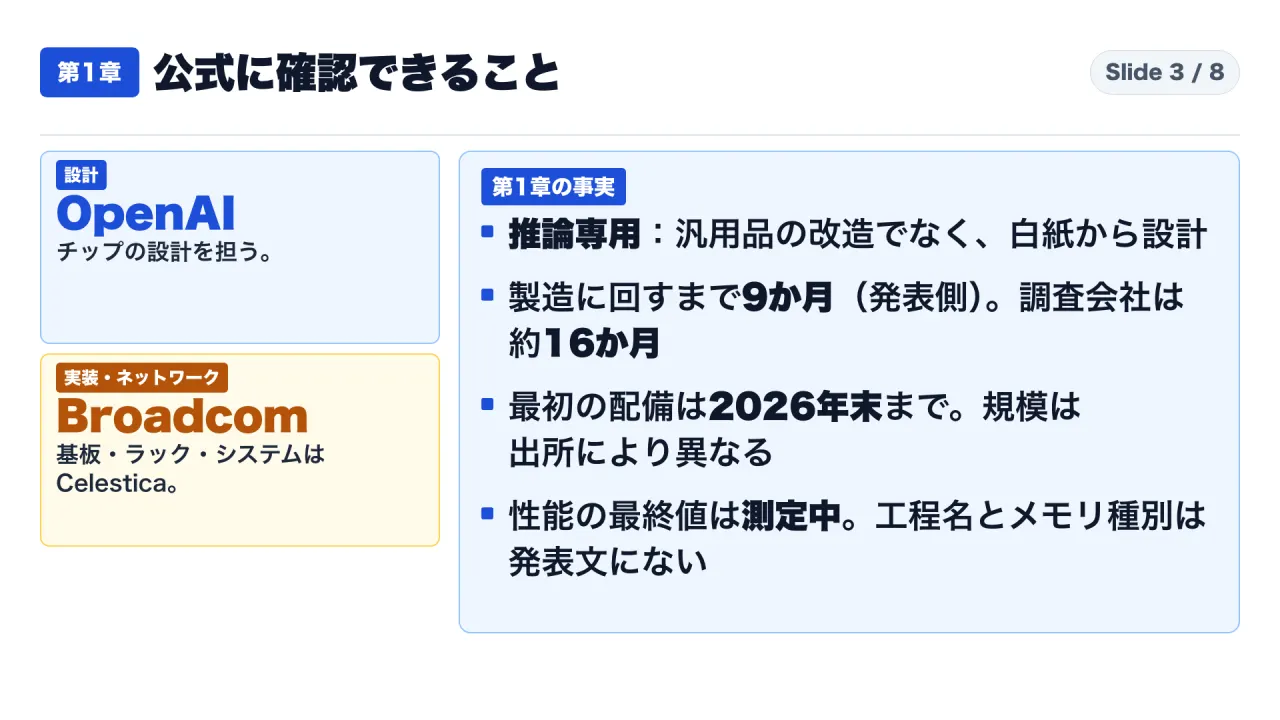
名称と位置づけ。Jalapeñoは、OpenAIの初の「Intelligence Processor」です。大規模言語モデルの推論のための加速器で、2社が共同で作る、複数世代の計算基盤の最初の加速器、と書かれています。
設計の考え方。発表文は、Jalapeñoを「推論のための白紙の設計で、以前のAIの処理を想定した汎用の加速器を直したものではない」と説明しています。OpenAIが、自社のモデル、カーネル、サービス提供の仕組み、製品の必要から、チップを白紙から設計した、とあります。
役割分担。設計はOpenAI。チップの実装、ネットワーク、つなぐ技術はBroadcom(Tomahawkというネットワーク用チップを含む)。基板、ラック、システムの専門はCelestica(セレスティカ)です。
試作品の状態。試作品は、研究所の中で、量産の目標の動作周波数と電力で、機械学習の処理を動かしている、とあります。例として、GPT-5.3-Codex-Sparkの名前が挙がっています。
性能。発表文は、初期の試験が、電力あたりで現在の最先端よりかなり良いことを示している、と書きます。数字はありません。最終の性能は測定中で、詳しい技術報告は数か月以内に示す、とあります。
開発の速さ。設計から、製造に回すテープアウトまで、9か月。発表文は、これが高性能な半導体の開発として最速かもしれない、と書いています。OpenAIのモデルも設計と最適化の一部を速めた、とあります。
ここで、数え方の違いがあります。SemiAnalysis(S2)は、設計の作業が2024年の中ごろに始まり、チームの採用の開始から製造に回すまでが約16か月、と書いています。9か月は発表側の数え方、約16か月は調査会社の数え方で、数え方の起点が違います。どちらかが誤りという話ではありません。
配備の時期。最初の配備は2026年末までです。Broadcomの社長は、Microsoftなどと、ギガワット規模のデータセンターの配備を2026年から進める、と述べています。一方、ウィンバザー(S3)は、OpenAIが2026年末までは小さな規模、2027年に大きな量を見込むと書き、SemiAnalysisも、量産は2027年を通じて増え、生産の大半は2027年末に予定されていると書いています。規模の見え方は、出所により異なります。
書かれていないこと。発表文の全文を取得して検索したところ、チップの製造の工程の名前、メモリの種類、性能の数字は、本文にありません。工程名やメモリの種類として知られている情報は、調査会社の記述に由来します。
第2章:返答の速さを決めるのは、メモリの読み出し。推論専用という設計は、そこを狙っている
なぜ推論専用なのか。まず仕組みです。NVIDIAの技術ブログ(S8)は、プリフィルは計算の量が限界になり、デコードはメモリの読み出しの速さが限界になる、と説明しています。デコードでは、一語を作るたびに、KVキャッシュを全部読み出します。投機的デコードを使うと、計算の割合が上がり、メモリの限界から離れる方向に動く、とも書かれています。
これは私の整理です。同じ計算力のチップでも、返答の速さを左右する部分は、メモリの帯域です。だから、データの移動を減らす設計は、返答の速さに直結します。
発表文(S1)は、Jalapeñoのアーキテクチャを「データの移動を減らし、計算とメモリとネットワークの資源を釣り合わせて、実際に出る性能を理論上の上限に近づける」と説明しています。狙いは、今の代表的な加速器の処理量と、最も速い専用の推論システムに近い応答の速さを、一つにすることだ、とあります。
SemiAnalysis(S2)は、この設計を次のように読んでいます。計算部とメモリ(HBM)を小さな区画に分け、各区画が、自分のメモリを近くから直接見る作りです。もう一つの特徴は、入力を読む段階と出力する段階を、別のチップの群に分けない設計を選んだことです。理由として、群に分けると、入力の要求が多いときに、出力側のチップが遊んで待ち行列ができる、と説明しています。入力と出力の比率は時間とともに動くので、固定の割り振りは使われない時間を生みやすい、という考えです。
推論に力を入れる動きは、OpenAIだけではありません。NVIDIAのヴェラ・ルービン(Vera Rubin NVL72)の製品ページ(S5)は、Groq 3 LPXというラックと組み合わせると、1兆パラメータ級のモデルと100万トークンの文脈で、新しい水準の推論性能になる、と書いています。
第3章:1.5〜1.9倍という数字は、定格電力で割り、投機的デコードを使わず、OpenAIが出した測定の値
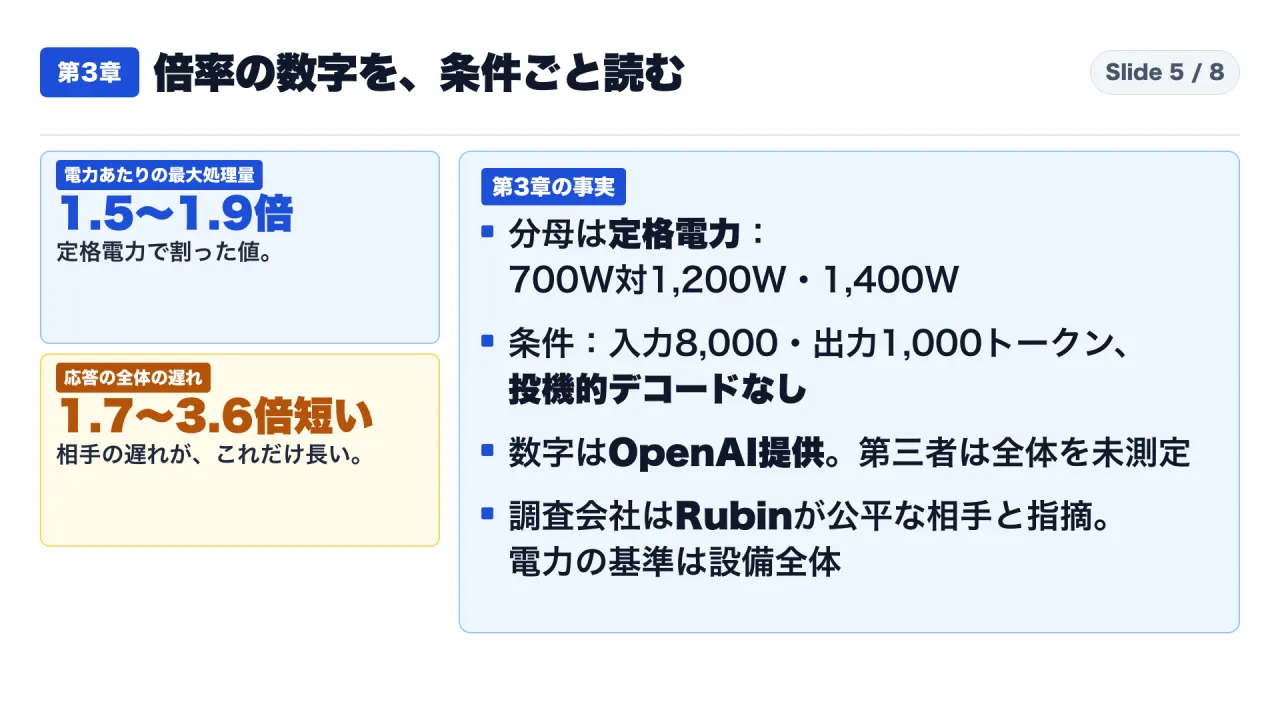
2026年8月25日、OpenAIはJalapeñoの最初の測定結果を公表しました(S4)。試験は、SemiAnalysisが公開しているベンチマークの「InferenceX」で、公開された重みの大規模言語モデル3つ(GPT-OSS 120B、DeepSeek R1 670B、Kimi K2.5 1T)を使っています。会話は1回だけ、入力は8,000トークン、出力は1,000トークンです(S3)。比べた相手は、NVIDIAのGB200とGB300です(S3)。
報じられた倍率は、電力あたりの最大の処理量が1.5〜1.9倍、応答の全体の遅れが1.7〜3.6倍短い、です(S3)。イゴールズラボ(S4)の整理では、モデルごとの数字は、次のとおりです。
- GPT-OSS 120B(GB200との比較):電力あたりの最大処理量が約1.9倍、応答の全体の遅れが約1.7倍短い。
- DeepSeek R1 670B(GB300との比較):電力あたりの最大処理量が約1.7倍、応答の全体の遅れが約3.6倍短い。
- Kimi K2.5 1T(GB300との比較):電力あたりの最大処理量が約1.5倍、応答の全体の遅れが約3.4倍短い。
例を一つ。GPT-OSS 120Bでは、1キロワットあたり、毎秒の処理量(入力と出力を混ぜて数えたトークンの数)が、Jalapeñoで85,448、GB200で44,960でした。応答の全体の遅れは、1.80秒が1.03秒に縮んでいます(S4)。DeepSeek R1では、1.65秒対5.99秒です(S4)。
ここからが、倍率を読む条件です。
一つ目の条件は、割る数です。この倍率は、実測の消費電力ではなく、各チップの定格電力で割っています。Jalapeñoは700ワット、GB200は1,200ワット、GB300は1,400ワットです(S3・S4)。Jalapeñoは、試験中の持続の消費電力が550ワット以下だった、とOpenAIが報告しましたが、比較相手の同じ測定値は公表されていません(S3)。
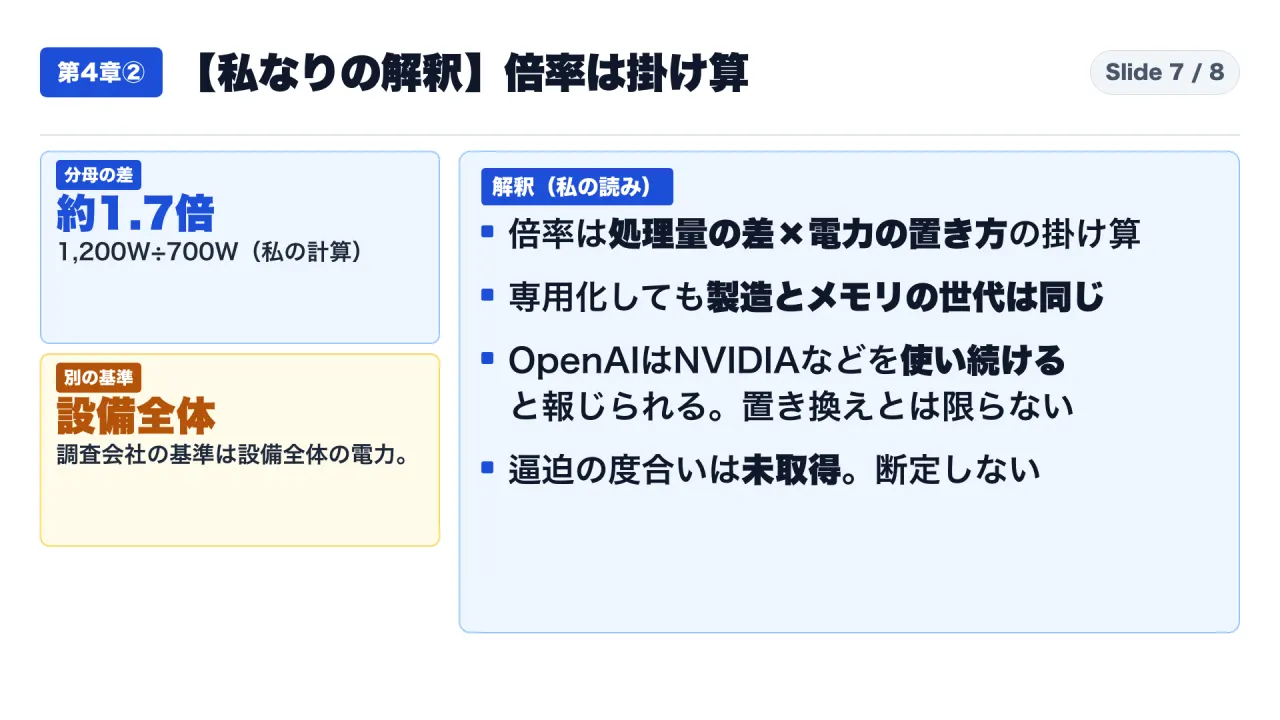
ここは私の計算です。1,200を700で割ると約1.7、1,400を700で割ると2.0です。倍率は、チップの処理量の差と、電力の置き方の、掛け算です。分母の置き方だけで、これだけの差が出ます。
二つ目の条件は、方式です。この試験は、1語ずつ生成していて、投機的デコードは使っていません(S3)。三つ目は、試験の型です。SemiAnalysisは、これが入力8,000トークンの型だけで、長い会話を想定した別の試験(AgentX)の結果は、まだないと書いています(S2)。四つ目は、数字の出所です。数字はすべてOpenAIが出しました。SemiAnalysisは、研究所でInferenceXの実行に立ち会いましたが、全体の測定は自分では走らせていません(S2・S3)。報じられた倍率の範囲は、この3つのモデルと、この2つの製品と、この設定だけに当てはまります(S3)。
SemiAnalysisは、ブラックウェル世代との比較は「やや不完全で公平でない」と書き、本来の相手は、同じ世代のメモリ(HBM4)を使うRubinだ、という見方を示しています(S2)。同社の比較では、電力あたりの処理量で、JalapeñoはRubinの公表値を上回ります。ただし、電力の基準は、設備全体の電力(all-in utility MW)で、OpenAIの定格電力とは違います(S2)。コストあたりの処理量は、JalapeñoとRubinでほぼ同じ、と書かれています。Jalapeñoは投機的デコードなし、Rubinはありという違いも、あわせて書かれています(S2)。
NVIDIA自身の数字も、別の条件です。Rubinは、GB200より電力あたりのトークンが最大10倍、と書かれていて、条件は、Kimi-K2 Thinkingモデル、入力32,000トークン・出力8,000トークンです(S5)。OpenAIの測定は入力8,000トークンで、割る電力の基準も、測った人も違います。この数字どうしで順位は作れません。出所により異なる、ということです。
もう一つ、読むときの目安を書きます。倍率が「1.5〜1.9倍」のように範囲で示されているときは、範囲の端が、どのモデルと、どの相手の組み合わせから来たかを確認します。この記事の例では、1.9倍はGPT-OSS 120BとGB200の組み合わせ、1.5倍はKimi K2.5とGB300の組み合わせでした。同じ「電力あたり」でも、相手の製品が違えば、割る定格電力も違います。範囲の幅は、モデルの違いだけでなく、相手の違いも含んでいます。
最後に、数字の新しさです。SemiAnalysisによれば、この結果は初期のシリコン(A0)で測ったもので、すでにB0という改良版が製造中で、電力あたりの性能が約25%向上する、とされています(S2)。数字は今後、更新されます。
第4章①:同じ表に並べられるのは、メモリまで。製造とメモリの世代は、ほかのチップと同じ
ほかのチップと並べます。公式の資料から、同じ形で並べられるのは、メモリの種類と帯域です。演算性能は、NVFP4、MXFP4、FP8、MXFP8のように、数値の形式が会社ごとに違い、測った設定もそろわないので、並べません。
| チップ | メモリ | 帯域 | 単位 | 出所 |
|---|---|---|---|---|
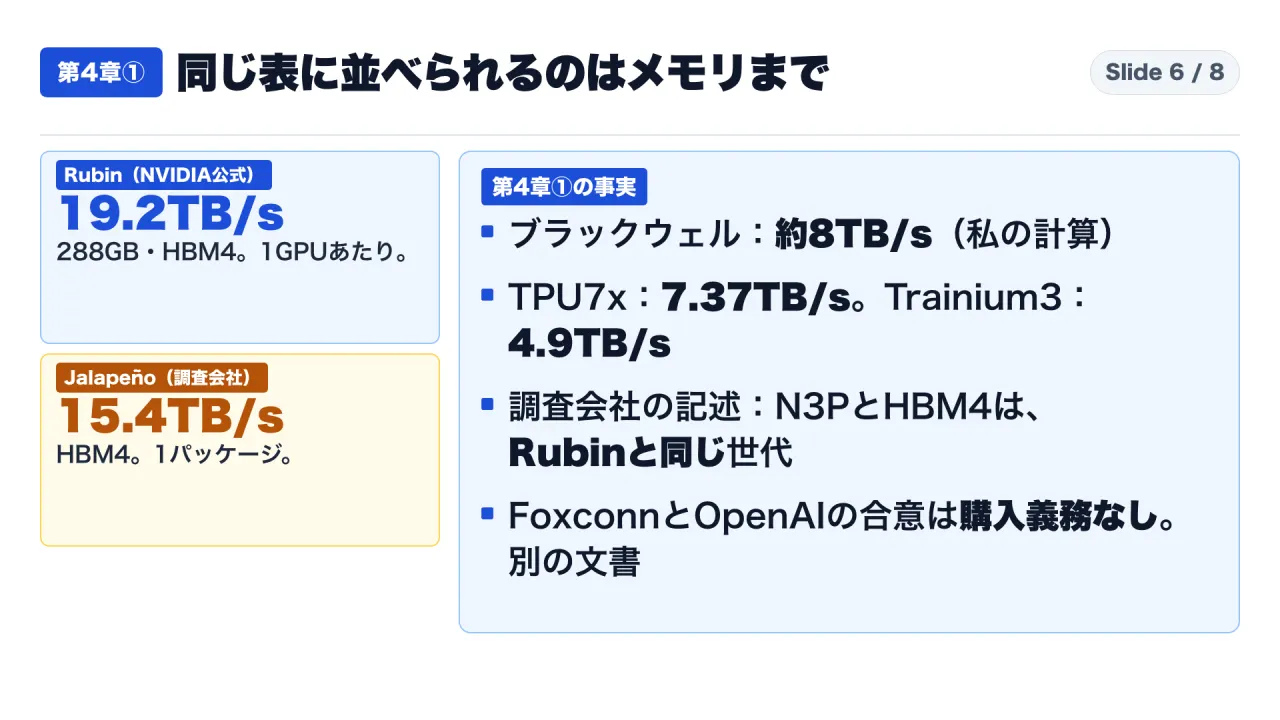
| NVIDIA Rubin(GPU) | 288GB、HBM4 | 毎秒19.2TB | GPU1基 | NVIDIA製品ページ(S5) |
| NVIDIA GB200 NVL72 | 13.4TB、HBM3E | 毎秒576TB(ラック全体) | 72基で割ると約8TB(私の計算) | NVIDIA製品ページ(S6) |
| NVIDIA GB300 NVL72 | 20TB、HBM3E | 最大で毎秒576TB(ラック全体) | 72基で割ると約8TB(私の計算) | NVIDIA製品ページ(S7) |
| Google TPU7x | 192GiB、HBM | 毎秒約7.37TB | チップ1つ | Googleクラウドの資料(S9) |
| Amazon Trainium3 | 144GB、HBM3e | 毎秒4.9TB | チップ1つ | アマゾンの製品ページ(S10) |
| OpenAI Jalapeño | HBM4 | 毎秒15.4TB | 1パッケージ | 調査会社の記述(S2)。公式ページでは確認できない |
単位は、GPU、パッケージ、チップと、会社ごとに違い、測った人も違います。順位は付けません。
製造とメモリ。SemiAnalysis(S2)の記述では、Jalapeñoの計算部分は、TSMCのN3Pという工程の、レチクル限界の大きさの単一のダイです。Rubinの計算部分も、同じ工程だと書かれています。メモリも、Rubinと同じHBM4です。私の読みでは、先端の工程と、最新の世代のメモリを使う以上、その確保は、ほかの企業と同じ列に並びます。ただし、供給がどれだけ逼迫しているかを示す数字は、この記事では取れていません。
調達先の話です。報道(S4)によれば、OpenAIは、NVIDIAなどの加速器を、訓練にも推論にも使い続けると強調しています。第二世代は開発が進み、第三世代にも着手している、とあります。
ラックの側です。SemiAnalysisの記述では、1つのラックにJalapeñoが128個で、システムの設計はCelesticaとの共同です(S2)。
Foxconnは、OpenAIとは別の文書で、ラックの共同設計をしています。2025年11月21日の共同発表(S11)は、複数世代のAIデータセンター用ラックを並行して共同で設計し、Foxconnの米国の工場で製造する、と書いています。この最初の合意には、購入の約束も金銭の義務も含まれません。ただし、OpenAIには、早期に評価する権利と、購入する選択権があります。この発表は、Jalapeñoの発表とは別の文書です。Jalapeñoのラックを、Foxconnが作るという記載は、確認した範囲で、どちらの文書にもありません。
第4章②:【私なりの解釈】倍率は掛け算。専用化しても、供給の列からは外れない
ここからは、事実ではなく、私なりの解釈です。ここまでの数字は、公開された資料に書かれていることです。ここから先の読みは、断定ではありません。
第一の解釈。倍率は、チップの処理量の差と、電力の置き方の掛け算です。定格電力で割るか、設備全体の電力で割るかで、同じチップでも倍率の見え方が変わります。
第二の解釈。専用化で変わるのは、返答の速さと、電力あたりの効率、という見方ができます。ただし、公開された数字は、条件を限った、自己申告の初期値です。実際の運用で、同じ倍率が出るとは言えません。
第三の解釈。変わらないのは、先端の製造と、最新のメモリを使う点です。専用化しても、同じ供給の列の中にいます。
第四の解釈。OpenAIは、NVIDIAなどの加速器を使い続けると報じられています。置き換えというより、使えるチップの種類を増やす動き、と読めます。これも読みです。
言えないことを並べます。
- 長い会話を想定した試験(AgentX)で、同じ倍率が出るのか。
- 価格や調達の条件を含めた、コストの比較。
- 製造とメモリの供給が、どれだけ逼迫しているのか。
結論:数字を読むときは、分母、条件、測った人の三つを確かめる
まとめます。
- 公式に確認できるのは、推論専用の自社設計チップが実在し、2026年末までに最初の配備を始める計画であること。性能の最終値は測定中です(S1)。
- 8月の倍率(電力あたり1.5〜1.9倍、応答の全体の遅れ1.7〜3.6倍短い)は、定格電力で割り、投機的デコードを使わず、入力8,000トークンで測った、OpenAI提供の値です(S3・S4)。
- 製造の工程とメモリの世代は、Rubinと同じだと、調査会社は書いています(S2)。
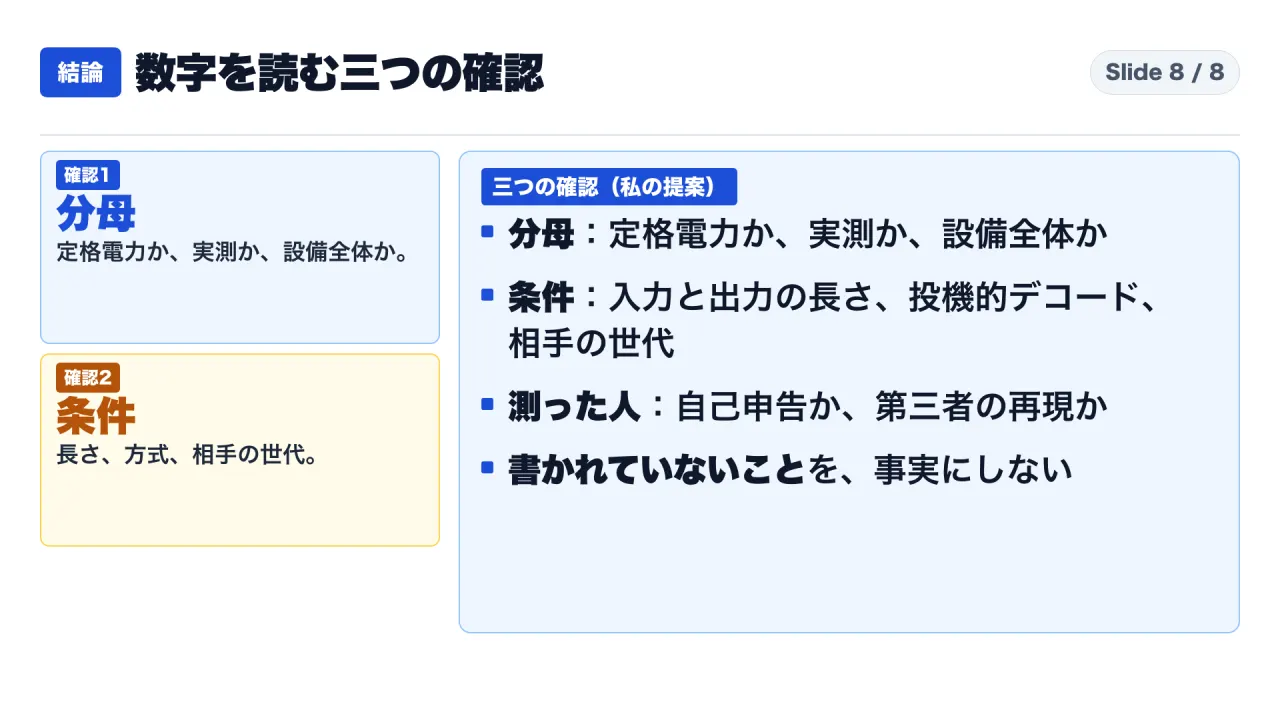
数字を読むときの確認は、三つです。これは私の提案です。
- 分母:定格電力か、実測か、設備全体の電力か。
- 条件:入力と出力の長さ、投機的デコードの有無、相手の世代。
- 測った人:自己申告か、第三者が再現したか。
書かれていないことは、事実にせず、そのまま「書かれていない」と受け取ります。
補足:AIの料金や応答速度の数字を比べる手順の例(私の提案)
公開された資料を読んだ整理から、自社で数字を比べるときの手順の例を書きます。これは私の提案で、資料に書かれた手順ではありません。
- 倍率の数字を見つけたら、分母を探します。「電力あたり」「コストあたり」「1秒あたり」のどれか。電力あたりなら、定格か、実測か、設備全体かを確認します。
- 測定の条件を、数字の近くから拾います。モデルの名前、入力と出力の長さ、会話の回数、投機的デコードなどの方式、比べた相手の製品と世代です。
- 測った人を確認します。自己申告か、第三者が再現したか。第三者が立ち会っただけか、全体を走らせたか。この記事の例では、立ち会いはありましたが、全体の測定はありませんでした。
- 相手の世代をそろえます。新しい世代の製品と、一つ前の世代を比べた数字は、同じ列に並べず、別の数字として扱います。
- 書かれていないこと(価格、調達の条件、長い会話での結果、供給の数字)を、別の欄に書き出します。
よくある疑問に、公開資料の範囲で答えます
Q. Jalapeñoは、NVIDIAより速いのですか。
A. この記事では、速い、遅いとは言えません。OpenAIの測定は、NVIDIAのブラックウェル世代の2製品が相手で、定格電力で割り、投機的デコードなし、入力8,000トークンの条件です。SemiAnalysisは、本来の相手はRubinだと書き、コストあたりの処理量は、ほぼ同じとしています。NVIDIA自身の数字は、別のモデルと別の長さの条件です。
Q. OpenAIは、NVIDIAのチップをやめるのですか。
A. 報道(S4)では、OpenAIは、NVIDIAなどの加速器を、訓練にも推論にも使い続けると強調しています。
Q. Foxconnが、Jalapeñoのラックを作るのですか。
A. 確認した範囲では、そう書かれた文書はありません。Foxconnの共同発表は、複数世代のラックの共同設計と米国での製造で、Jalapeñoの名前は出てきません。Jalapeñoの発表で、基板、ラック、システムを担うのは、Celesticaです。
Q. 九か月と十六か月の、どちらが正しいのですか。
A. 数え始めが違います。9か月は発表側の「設計から製造に回すまで」、約16か月は、SemiAnalysisの「チームの採用の開始から製造に回すまで」です。
自社の判断に使うときの注意(私の提案)
この記事の数字は、2026年11月2日に確認した資料に基づきます。初期のシリコンの結果で、今後更新されます。技術報告が公開されたら、条件と数字を取り直してください。
また、この記事は、特定のチップの採用を勧めるものではありません。自社の用途(モデル、入力と出力の長さ、同時に処理する会話の数、電力の基準)で測った数字が、判断の中心になります。
最後の確認リスト
- 倍率の分母は何か(定格電力、実測、設備全体)。
- 入力と出力の長さ、会話の回数、投機的デコードの有無を確かめたか。
- 比べた相手の世代は、そろっているか。
- 測った人は誰か。第三者が再現したか。
- 書かれていないこと(価格、調達条件、供給の数字、長い会話での結果)を、別に書き出したか。
YouTube本編:{{YOUTUBE_URL}}
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:OpenAIとBroadcomの共同発表(2026年6月24日、配信会社の転載全文):https://www.stocktitan.net/news/AVGO/open-ai-and-broadcom-unveil-llm-optimized-intelligence-jqpk7vkxf7jd.html
- S2:セミアナリシス(調査会社)の分析記事(2026年8月25日):https://newsletter.semianalysis.com/i/212647373/software
- S3:ウィンバザーの報道(2026年8月26日):https://winbuzzer.com/2026/08/26/openai-jalapeno-faster-inference-gb200-gb300-company-tests-xcxwbn/
- S4:イゴールズラボの報道:https://www.igorslab.de/en/openai-jalapeno-beats-nvidia-gb200-gb300-in-initial-inference-benchmarks-up-to-36x-lower-latency/
- S5:NVIDIA Vera Rubin NVL72 製品ページ(2026年11月2日取得):https://www.nvidia.com/en-us/data-center/vera-rubin-nvl72/
- S6:NVIDIA GB200 NVL72 製品ページ(2026年11月2日取得):https://www.nvidia.com/en-us/data-center/gb200-nvl72/
- S7:NVIDIA GB300 NVL72 製品ページ(2026年11月2日取得):https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- S8:NVIDIA 技術ブログ(2026年11月2日取得):https://developer.nvidia.com/blog/co-designing-ai-model-attention-for-fast-interactive-long-context-inference/
- S9:Google Cloud TPU7x の資料(2026年11月2日取得):https://cloud.google.com/tpu/docs/tpu7x
- S10:Amazon Trainium3 製品ページ(2026年11月2日取得):https://aws.amazon.com/ai/machine-learning/trainium/
- S11:FoxconnとOpenAIの共同発表(2025年11月21日):https://www.foxconn.com/en-us/press-center/press-releases/latest-news/1905
- P1:OpenAIの公式発表(2026年6月24日、2026年11月3日に確認):https://openai.com/index/openai-broadcom-jalapeno-inference-chip/
- P2:OpenAIの公式の初期結果(2026年8月25日、2026年11月3日に確認):https://openai.com/index/jalapeno-first-results/
- P3:Broadcomの公式発表(2026年6月24日、2026年11月3日に確認):https://investors.broadcom.com/news-releases/news-release-details/openai-and-broadcom-unveil-llm-optimized-intelligence-processor