「LLMの重みの中で別の小さなLLMを動かした」という報告は、何を示し、何をまだ示していないのか ── QwenPUの一次資料を読む
YouTubeポッドキャスト本編(動画・音声)はこちら:「LLMの重みの中で別の小さなLLMを動かした」という報告は、何を示し、何をまだ示していないのか ── QwenPUの一次資料を読む
結論:全ステップ一致は回路の実行器での結果で、公開された重みの層で確かめたのは先頭30,000ステップです
結論から書きます。QwenPU(クウェン・ピーユー)の作者は、LLMの重みにコンパイルした計算機が、別の小さなLLMを動かし、全3,184,920ステップが参照と一致したと報告しています。ただし、この全ステップ一致は、回路の実行器での結果です。公開された重みのファイルの層で確かめたのは、先頭30,000ステップです。一致の相手の「参照」も、作者自身が書いたPythonの実装です。第三者の再現は、私が探した範囲では見つかりませんでした。
この記事の対象読者は、「LLMの中にCPUを作った」「全ステップが正確に一致した」といった見出しを見て、それが何を意味するのかを仕事の判断に使いたい人です。AIを業務の手順に組み込む立場の担当者や、ベンダーから「100%正確」という説明を受ける管理職を想定しています。
読み終えると、次の三つができるようになります。一つ目は、「一致した」という報告を見たとき、一致の範囲(全体か一部か)と、比べた相手(独立した参照か)を確かめること。二つ目は、速度の数字を見たとき、測った実行器が同じかを確かめること。三つ目は、確率的な推論と決定的な計算を、仕事の手順の中でどう分けるかを考えること。
この記事は、モデルの紹介として、開発元の一次資料と、代表的な先行例を、出典ごとに並べます。順位は付けません。導入や投資の推奨もしません。私はこのモデルを動かしていません。重みの26.7ギガバイトも、ダウンロードしていません。使った資料は、作者のREADME、設計文書、検査と実行のコード、モデルカード、前作の資料、そして2023年の二つの論文です。
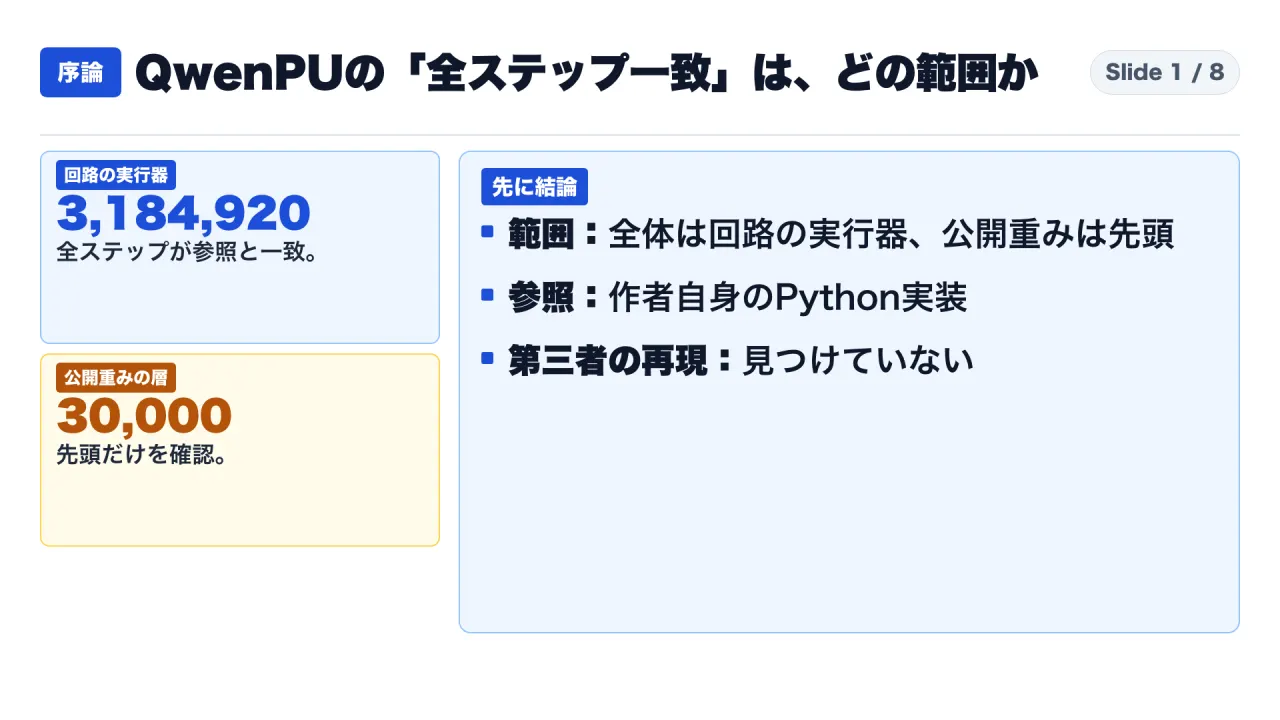
図1は、この記事全体の答えを一枚で示したものです。回路の実行器では3,184,920ステップ、公開重みの層では30,000ステップ。この二つの数字の差が、「一致した」という言葉の範囲の差です。
読み方:本文では「資料の記載」「私の計算」「私の解釈」を分けて書きます
本文には、三つの種類の文が出ます。「資料の記載」は、READMEやコード、論文の原文に書かれている内容です。作者の報告は、事実と分けて、「書いています」と書きます。「私の計算」は、公表された数字から私が割り算や掛け算をした値で、資料に載っている数字ではありません。「私の解釈」は、資料を読んで私が考えたことで、資料に書かれているわけではありません。
資料の扱いには、三つの制約があります。一つ目は、取得の方法です。すべての資料を、2026年11月2日の日本時間0時台に取得しました。数字は、その時点のものです。二つ目は、確認の範囲です。「見つかりませんでした」と書いた箇所は、資料の本文やコードを検索した結果で、私が確認した範囲に限ります。三つ目は、動かしていないことです。モデルも、検査のコードも、実行していません。コードは、読んだだけです。
前作との関係:CPUとメモリの仕組みは短く、そして前回の訂正
QwenPUは、前回の記事と動画で扱った Qwenputer(クウェン・ピュータ)の続編です。前回は、Qwen3.5-4B(クウェン・スリー・ポイント・ファイブ・フォービー)というモデルの前に、学習ではなくコンパイラで計算した11層を足し、RISC-V(リスク・ファイブ)という種類のCPUを、重みの中に作った、という作者の報告でした。メモリには、モデル自身の Gated DeltaNet(ゲーテッド・デルタネット)という層の状態を使います。CPUとメモリの仕組みの詳しい説明は、前回の記事に任せます。
前回の記事:/ja/articles/2026-10-30-qwenputer-riscv-cpu-in-weights-single-neuron-steering/
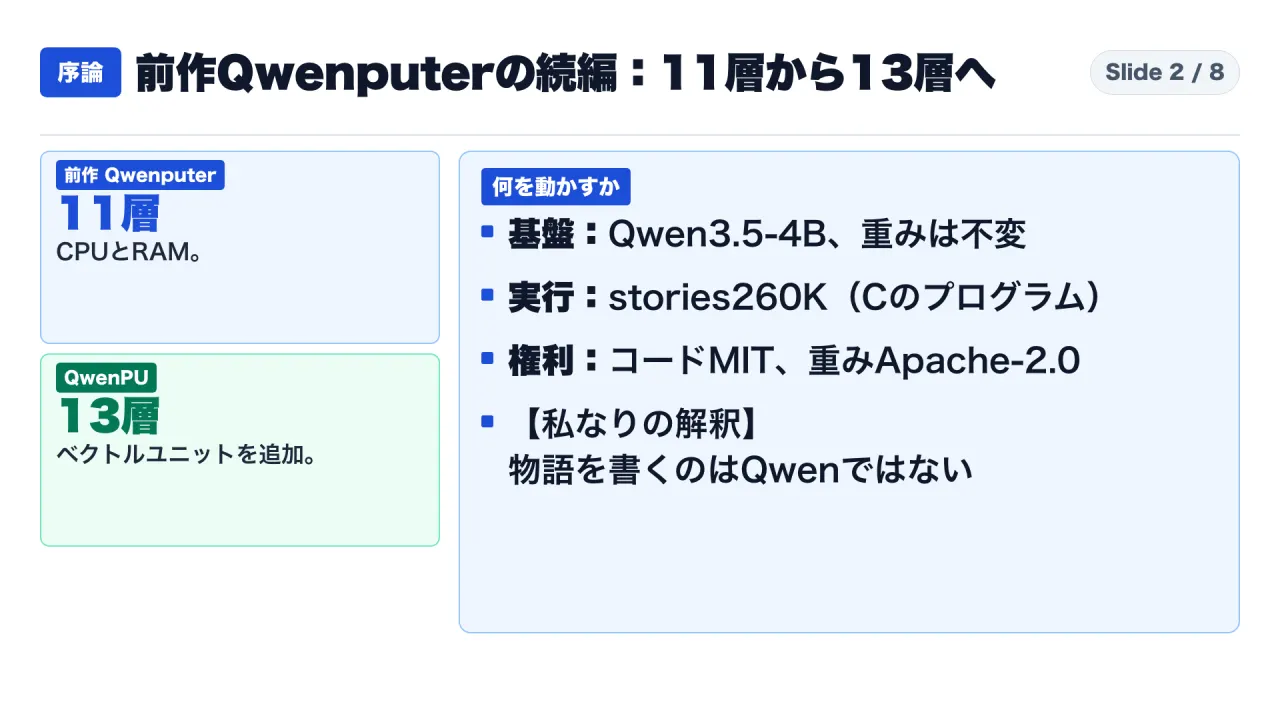
今回のQwenPUは、そのCPUに、ベクトル演算ユニットを足したものです。足した層は13層になりました。ベクトル演算ユニットは、行列とベクトルの積などを、CPUの命令より大きな単位で扱います。後で詳しく見ます。
ここで、前回の動画の訂正を入れます。私は前回の動画で、「1命令は、ちょうど3つのトークン」と話しました。しかし、作者のブログの原文は、「1命令は、数個の生成トークンになる。1つはメモリの行を指し、次は値を運び、終了の印のトークンが命令を終える」と書いています。名前が挙がっているのは、アドレス、値、終了の3種類です。ちょうど3個とは書いていません。前回の動画の「ちょうど3つ」は、原文より強い言い方でした。訂正します。
一致の報告を読む五つの問い
最初に、この記事で使う五つの問いを並べます。以降の章は、この問いを順に当てはめます。
一つ目は、何が動いているのか、です。見出しが言う主体と、実際に動いているものが、同じかを確かめます。二つ目は、一致の範囲は何か、です。全体か、一部か。どの実行器で、どの層で、どの確認方法か。三つ目は、比べた相手は何か、です。独立した参照か、作者が書いた別の実装か。四つ目は、数字は、同じ条件で測られているか、です。速度や量の数字は、実行器や設定が違えば、並べて比べられません。五つ目は、載っていないことは何か、です。第三者の再現、言語の挙動、既存のベンチマーク、実用の速度。
第1章:学習ではなくコンパイラで計算した13層を足した。物語を書くのはCのプログラムです
たとえ話から始めます。既存の建物の1階の前に、設計図どおりに作った機械室を、増築したようなものです。増築した部分は、元の建物の設計とは別に作られていて、元の建物の柱や壁は、そのままです。これはたとえ話です。
READMEは、QwenPUを、Qwen3.5-4Bに、32ビットのRISC-VのCPUとベクトル演算ユニットを、重みへ直接コンパイルしたものだと書いています。追加した重みは学習したものではなく、コンパイラがすべて計算した、とも書いています。ここでいう「コンパイル」は、プログラムを機械が実行できる形に変換することです。ふつうのコンパイラは、プログラムを機械語に変えます。ここでは、CPUの動きを、モデルの重みの行列に変えています。
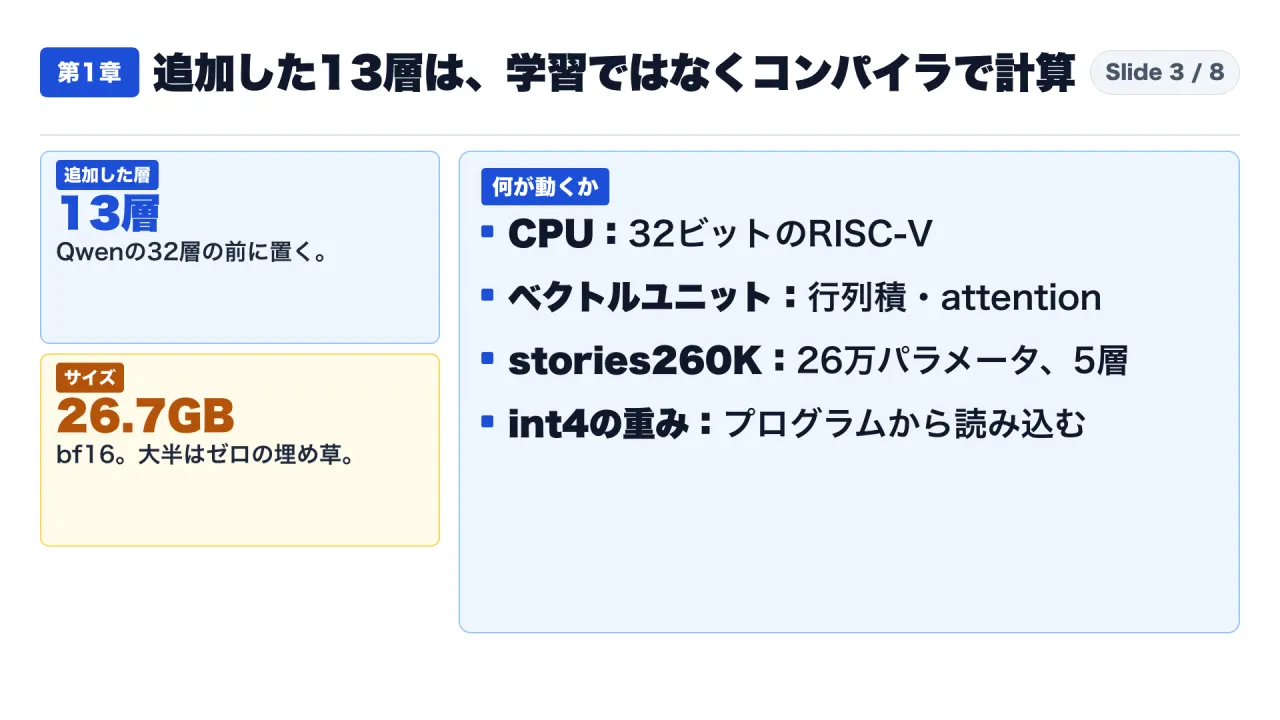
READMEの表には、モデルの構成が書かれています。基盤はQwen3.5-4Bで、Qwen自身の重みは変えていません。追加は、Qwenの32層の前に置いた13層です。隠れ次元、つまり各層が扱う数字の並びの長さは5120で、Qwen本来の2560に、計算機の分が加わった値です。サイズは bf16(ビーエフ・じゅうろく、16ビットの浮動小数点数の一種)で26.7ギガバイトで、大半はゼロの埋め草だと書いています。
私の計算で、層の数は、13足す32で、45層です。ただし、READMEは、物語のデモと検査は、計算機の層だけを動かすと書いています。この点は、第3章で確かめます。
Hugging Faceの記録では、重みの総数は13,364,479,936個です。私の計算で、1個2バイト(bf16は16ビット)を掛けると、26,728,959,872バイトで、約26.7ギガバイトです。READMEの値と合います。これは別のファイル(Hugging Faceの個数の記録)からの確認で、実行時の使用量ではありません。
では、何を実行しているのか。READMEは、Karpathy(カルパシー)さんの stories260K(ストーリーズ・にひゃくろくじゅうケー)を、Cのプログラムとして、CPUとベクトルユニットの上で実行し、物語を書く、と書いています。stories260Kは、llama2.c(ラマ・ツー・ドット・シー)というリポジトリにある、26万パラメータの小さなLlamaで、次元は64、層は5です。Qwen3.5-4Bの数十億パラメータと比べると、桁が違う小さなモデルです。
stories260Kの重みは、チェックポイントに焼き込まれていません。int4(イント・フォー、4ビットの整数)の重みは、プログラムから読み込むデータで、ベクトルユニットの重みメモリに置かれます。READMEは、そのため、収まるモデルならどれでも同じ方式で動く、と書いています。
ベクトルユニットは、行列とベクトルの積、要素ごとの演算、アテンションをCPUに足します。READMEは、これによって、ニューラルネットワーク全体が、モデル自身の順伝播(フォワード・パス)の中で、プログラムとして動くと書いています。順伝播とは、入力から出力までを計算する、1回分の流れのことです。行列の1行、64レーンは、数個のトークンで流れます。
ベクトルユニットの構成も、READMEに書かれています。ベクトルレジスタは、64語のものが16本。活性値(層の途中の計算結果)は、384レーンのint8(8ビットの整数)で、64個ずつ読みます。重みメモリは、64個のint4の重みと行ごとの倍率をひとまとめにした4,152個の行の塊です。アテンションに使うKとVのキャッシュは、32位置です。
演算の一覧も、READMEにあります。VMATは、int8とint4の行列の行を、1トークンあたり64レーンで掛けます。VQは、レジスタの値をint8の活性値かキャッシュの行に量子化します。VRED は、活性値の和か2乗和を求めます。VMATRは、KのキャッシュへのアテンションのスコアとV のキャッシュとの積を求めます。ほかに、残差の加算やSiLU(活性化関数の一種)つきの積を行う演算、softmaxの分子を表で引く演算があります。SiLUと指数関数は、固定小数点の関数ユニットで、CPUの加算器と同じく、特定のモデルのデータではない、と書かれています。
私が確認した範囲で、この構成は、小さなLLMを動かすのに必要な部品、つまり行列の積、活性化関数、softmax、アテンションを、一通り含んでいます。これは私の読みです。
ここは私の解釈です。物語を書いているのは stories260K で、Qwen3.5-4Bが物語を考えているわけではありません。私が確認した範囲では、READMEにも、Qwenの言語能力を使うという記述はありません。「LLMの中で別のLLMを動かす」という見出しは、「重みの形をした計算機の中で、小さなLLMのプログラムを動かす」と読むのが、正確です。見出しだけで受ける印象と、実際に動いているものとの間には、差があります。
第2章:トレーストークンは225,000から53,000へ約4.2倍の差だが、秒数の差は約2.6倍にとどまります
たとえ話です。電車の乗り換えが減っても、車両の速さが違えば、所要時間の短縮は、乗り換えの減り方と同じにはなりません。これはたとえ話です。
まず、トレーストークン(トレース・トークン)とは何か。CPUが動くと、その実行の記録が、トークンとして並びます。どのメモリの行に、どの値を書き、どこで命令が終わるか、の順です。前作のREADMEは、この記録が、計算機の実行ログだと書いています。モデルは、この記録のトークンを1つずつ生成することで、CPUを動かしています。
なぜ、トークンの数を気にするのか。モデルは、トークンを1つずつ順番に生成します。ですから、トークンの数が多いほど、生成に時間がかかるのが、ふつうです。トークンを減らす工夫は、速さに直結しやすい、という一般的な見方があります。ただし、1秒に生成できるトークンの数は、実行器によって変わります。これは次に見るとおりです。
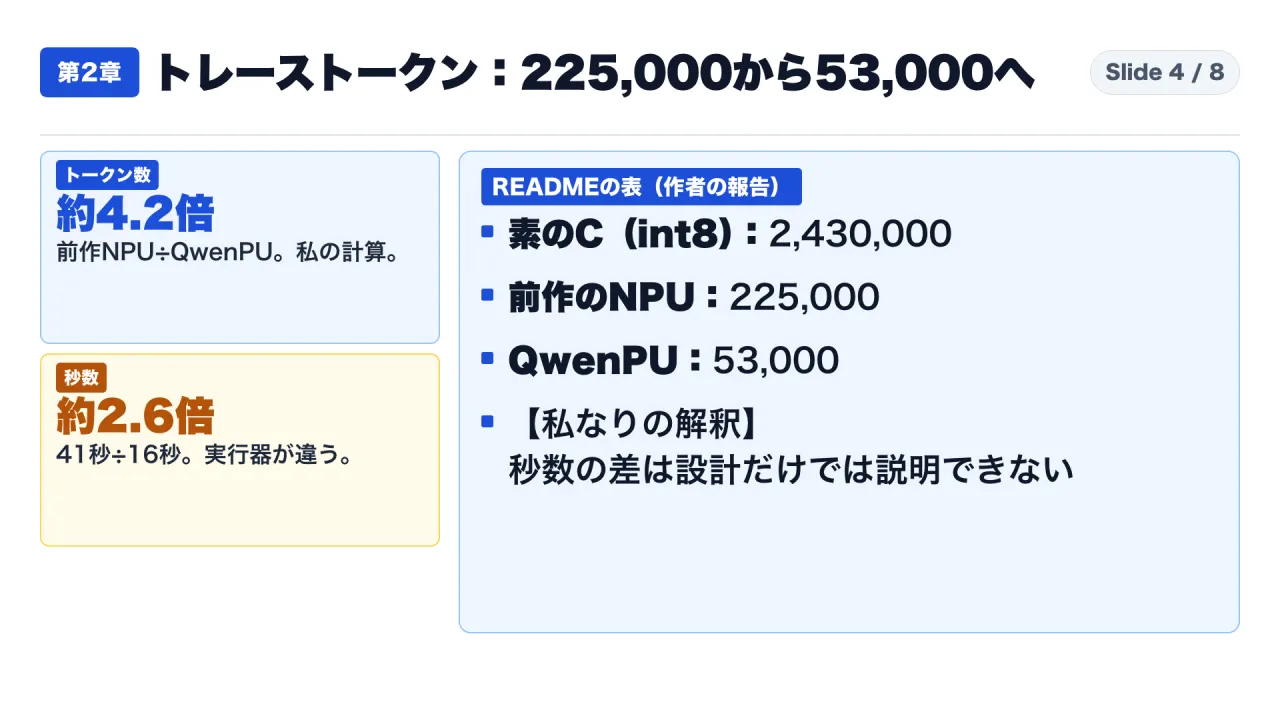
READMEの表は、同じ stories260K の、物語1トークンを作るのに必要なトレーストークンを、3つのビルドで並べています。素のC、int8の重みが2,430,000、前作のNPUが225,000、QwenPUが53,000です。NPUは、ニューラルネットワーク向けの演算を足した前作のビルドです。
注意が二つあります。一つ目は、素のCはint8、ほかはint4の重みで、重みの形式が行によって違うことです。二つ目は、3つとも同じ作者のビルドで、外部の他システムの数字ではないことです。この表は、同じ作者の中での、作り方の違いの比較です。
私の計算では、前作のNPUは、QwenPUの約4.2倍のトークンを使い、素のCは約46倍です。2,430,000を53,000で割ると約45.8、225,000を53,000で割ると約4.25です。
速度については、READMEが次のように書いています。GPU実行器は、L4(エル・フォー)というGPUで、1秒に約3,300トレーストークン、物語1トークンに約16秒で、前作のNPUは41秒です。前作のREADMEでは、前作の実行器は、1秒に約5,500トレーストークン、物語1トークンに約41秒です。
私の計算では、53,000を3,300で割ると約16.1秒、225,000を5,500で割ると約40.9秒で、READMEの値と合います。トークン数の差は約4.2倍ですが、秒数の差は、41を16で割って約2.6倍です。差が縮む理由は、実行器の速さが、1秒に3,300と5,500で、違うからです。
ここは私の解釈です。秒数の差は、設計の差だけでは説明できません。実行器が違うので、「ベクトルユニットで2.6倍速くなった」とは言えません。同じ実行器で測り直した数字は、資料にありません。速くなったという主張を読むときは、トークンの数と、1秒あたりの処理量の、両方を確かめる必要があります。
もう一つ。53,000が、物語の何番目のトークンの値かは、READMEに書かれていません。QwenPUのリポジトリ内にある、前作のビルドの説明は、位置0で180,000、位置31以降で225,000と、位置で値が変わると書いています。QwenPUの53,000がどの位置の値かは、資料から分かりません。
全ステップ数を53,000で割ると、約60.1です。ただし、これは、53,000が全体の平均だと仮定した、私の逆算です。60という数は、前作のビルドの記述にあるもので、同じ説明は、物語60トークン、1トークンあたり約41秒と書いています。QwenPUのビルドの物語トークン数は、資料に書かれていません。
第3章:「全ステップ一致」は、回路の実行器で3,184,920ステップ。公開チェックポイントの層で確かめたのは、先頭30,000ステップです
たとえ話です。工場の検査で、試作のラインでは全数を検査し、出荷した製品では、最初の一部だけを検査した、という報告を考えます。「全数検査で不良ゼロ」という見出しは、試作のラインの話です。出荷した製品について言えるのは、検査した一部の範囲までです。これはたとえ話です。
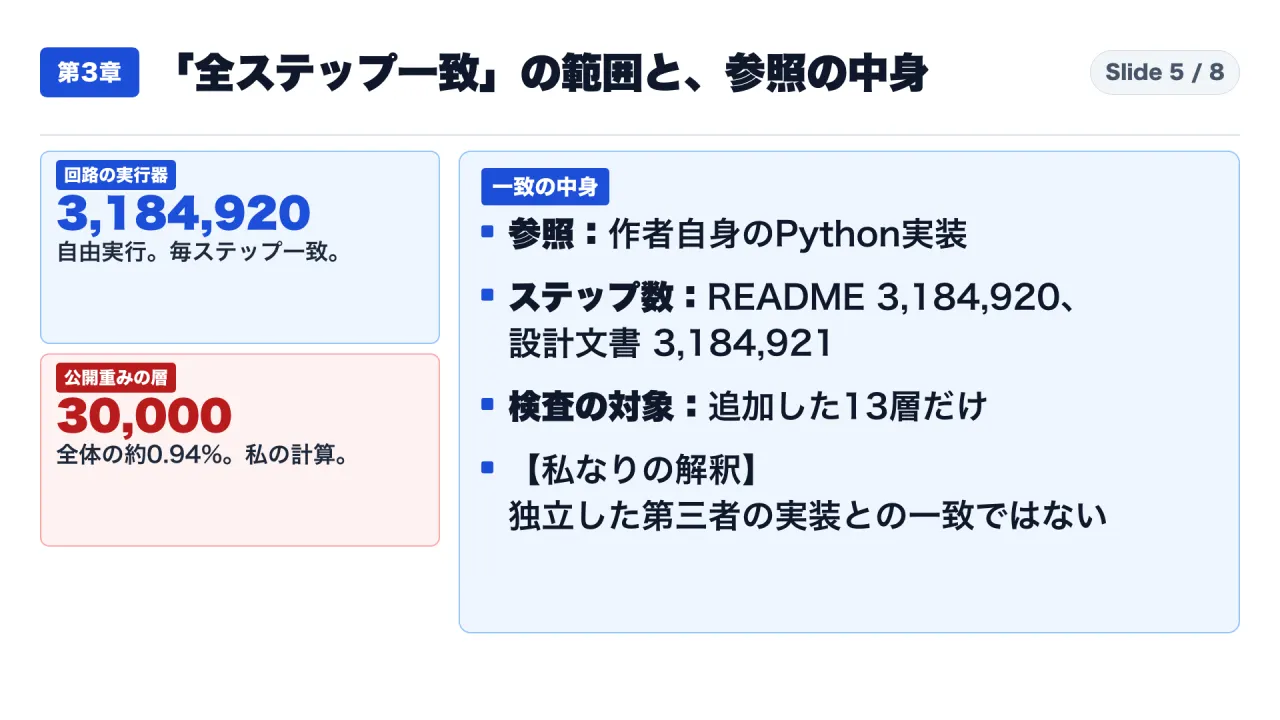
READMEのChecksは、3つの項目を書いています。一つ目は、演算ごとのランダムなテストプログラムを、回路に通して、参照と一致した、です。二つ目は、物語のプログラムを、回路のIRで先頭110,000ステップ、GPU実行器で全3,184,920ステップ、自由実行して、毎ステップ参照と一致した、です。三つ目は、同じテストと、物語の先頭30,000ステップを、チェックポイント自身の層で確かめて、一致した、です。モデルカードも、チェックポイントの層では、先頭30,000ステップで、不一致はゼロと書いています。
自由実行(フリー・ラニング)とは、前作のブログの脚注によれば、CPUが自分の出力でそのまま走り続け、途中で参照の機械が直さないことです。一方、QwenPUの検査コードは、参照の実行記録を1トークンずつ入力して、回路の予測が次のトークンと一致するかを見ます。これを教師強制(ティーチャー・フォーシング)と呼びます。
一般的な説明です。教師強制では、毎回、参照の正しいトークンが入るので、間違いが次のステップへ積み重なりません。自由実行は、自分の出力を次の入力にするので、1回の間違いが後に響きます。そのため、自由実行のほうが、厳しい検査です。これはREADMEの記述ではありません。
なぜ、範囲を気にするのか。決定的な計算の価値は、同じ入力に対して、毎回、同じ答えが出ることにあります。300万を超えるステップの途中で、1回でも違う結果が出れば、その後の出力は変わりえます。ですから、「全ステップが一致した」という報告は、とても強い主張です。強い主張だからこそ、その「全」が、どの回路での、どの実行器での、どの確認方法での「全」なのかを、確かめる必要があります。これは一般的な説明です。
私の計算では、30,000を全ステップ数の3,184,920で割ると、約0.94%です。公開されたチェックポイントの層で確かめた範囲は、全体の約1%です。残りの約99%は、回路の実行器での確認です。
もう一つ、ステップ数の食い違いがあります。READMEは3,184,920、設計文書は3,184,921です。1の差で、どちらが正しいかは、確認できていません。理由は資料に書かれていないので、私は決められません。
では、一致の相手の「参照」とは何か。設計文書は、chipformer/rv/vx.py という参照が契約で、回路は、これと1トークンずつ一致しなければならない、と書いています。コードでは、参照は ref.Machine で、同じリポジトリのPythonの実装です。
ここは私の解釈です。「参照と一致」は、作者が書いた別の実装と、同じ結果になった、という意味です。独立した第三者の実装との一致ではありません。参照そのものに誤りがあれば、一致しても、誤りは見つかりません。
storyrunのコードが読み込むのは、回路を作る core などのモジュールで、Hugging Faceのチェックポイントを読み込む行は、私が読んだ範囲では見つかりませんでした。READMEも、storyrunは計算機の層を構築して実行する、と書いています。私の読みでは、3,184,920ステップの一致は、公開された重みのファイルではなく、同じ構築コードから作った回路での結果です。公開された重みのファイルとの対応は、先頭30,000ステップの確認が示す範囲です。
vxcheckのコードも確かめました。既定のステップ数は30,000で、不一致が出たら最初の位置で止まり、全部一致なら ALL EXACT と表示します。通す層は、計算機の層だけです。
READMEは、全体を読み込むには40ギガバイト以上のGPUが必要で、物語のデモと検査は、計算機の層だけで、24ギガバイトのGPUに収まると書いています。モデルカードは、計算機の層だけをGPUに載せるなら約13ギガバイトと書いています。
ここは私の解釈です。検査は、追加した13層についてのもので、Qwenの元の32層を通した、全体の検査ではありません。「ビット単位で正確」という言葉は、この範囲で読む必要があります。
READMEの言葉は exact(イグザクト)、つまり一致です。モデルカードは、精度を「bf16で exact」と書いています。設計文書は、実行器が、bf16の丸めをモデルと同じに行う、と書いています。
「元のllama2.cとトークン単位で同じ物語を書いた」という紹介がありますが、READMEにその記述はありません。READMEが書くのは、「どのビルドも同じ物語を、トークン単位で書く」で、素のC、前作のNPU、QwenPUのビルドの間の一致です。
元のfloatのモデルとの一致については、QwenPUのリポジトリ内にある、前作のビルドの説明に、int4の重みで、KL(二つの出力の分布のずれを表す数)が0.019、top-1の一致が93.8%、貪欲出力は60トークン一致、と書かれています。QwenPUのビルドで、これを再掲した記述は、私が確認した範囲では、見つかりませんでした。
第4章:同種の先行例と並べると、新しい点は、実在する大きめのモデルに本体を変えずに足した点です。出典ごとに条件が違い、順位は付けません
ここで、代表的な先行例との比較を、出典と設定つきで整理します。同じ指標で測った外部の研究は、私が探した範囲では見つからなかったので、指標のそろった順位は作れません。
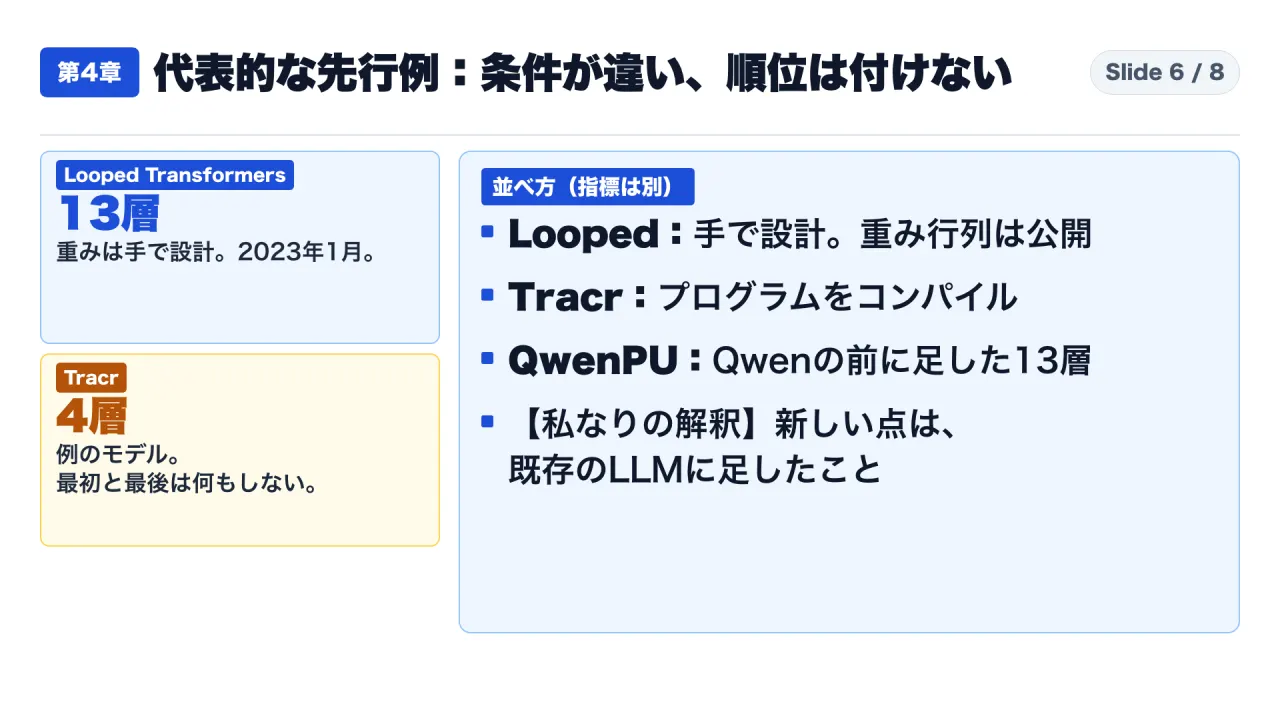
一つ目は、2023年1月にarXivに出た論文、Looped Transformers as Programmable Computers です。重みを手で設計した、13層のループ型のトランスフォーマーが、小さな命令セットの計算機、電卓、線形代数のライブラリを動かす、と書いています。重み行列は、すべて公開されています。
「ループ型」とは、同じ層の並びを繰り返し回して、出力を次の入力に戻す作りのことです。論文は、特定の重みを決めて、ループに置くことで、トランスフォーマーを汎用の計算機として使う枠組みを示し、入力の列を、命令とデータを書いたパンチカードにたとえています。QwenPUも、トレーストークンを1つずつ生成し、出力を次の入力にしていく点で、同じ種類の発想に見えます。これは私の読みです。
この論文は、構成が、実際の言語モデルの訓練とは似ていない、とも書いています。そして、結びの未解決の問題の一つとして、手で作ったモデルを、大きな事前学習済みのトランスフォーマーと融合させる可能性を挙げています。
ここは私の読みです。QwenPUは、この「融合」の一例に見えます。ただし、私が確認した範囲では、QwenPUのREADMEとモデルカードに、この論文への言及はありません。
二つ目は、Google DeepMindのTracr(トレイサー)です。人が読めるプログラムを、標準のデコーダー型トランスフォーマーの重みへ、コンパイルします。目的は、解釈可能性の手法を検証するための、正解つきのモデルを作ることです。例は、トークンの頻度、並べ替え、括弧の検査で、例のモデルは4層、最初と最後は何もしない層です。NeurIPS 2023の論文で、手で作った行列は、非現実的で効率が悪い、と自分で書いています。
Tracrの問題意識は、論文の要約によれば、学習で得たトランスフォーマーの中のプログラムは未知なので、解釈の手法が成功したのかどうかが分からない、という点にあります。そこで、中身が分かっているモデルを、コンパイルで作ります。QwenPUとは、目的が違います。Tracrは、解釈の検証のために、小さなモデルを作ります。QwenPUは、計算を実行させるために、既存の大きめのモデルに層を足します。
三つ目は、同じ作者の前作、Qwenputerです。11層で、DeepMindの算術問題のうち、大きな掛け算で、素のQwenが55.0、Qwenputerが97.5、外部のPythonを呼ぶ方式が100と、書かれています。条件は、貪欲復号で、各40問です。素のQwenは、道具なしで、各ステップを正確に、と指示した条件です。
これは前作の数字で、QwenPUの成績ではありません。私が確認した範囲では、QwenPUのREADMEとモデルカードには、算術のベンチマークの表が、ありません。前作は、言語の挙動の変化も測っていて、Qwenの文章の出力は基盤のモデルと一致し、KLは6e-4、ノイズの下限は5e-4と書いています。QwenPUについて、同じ測定は、私が確認した範囲では、書かれていません。
| 比較対象 | 何を作ったか | 規模・設定 | 同じ指標の数字 | 出典 |
|---|---|---|---|---|
| Looped Transformers(2023年1月) | 重みを手で設計したループ型トランスフォーマー | 13層、重み行列を公開 | 記載なし | arXiv:2301.13196 |
| Tracr(NeurIPS 2023) | プログラムを重みへコンパイルするコンパイラ | 例のモデルは4層 | 記載なし | arXiv:2301.05062 |
| Qwenputer(同一作者、前作) | Qwen3.5-4Bの前に足したCPU | 11層、算術は貪欲復号で各40問 | 同一作者の報告 | 前作README |
| QwenPU(同一作者) | 前作のCPUにベクトルユニットを足した | 13層、26.7ギガバイト | 53,000トレーストークン(同一作者の表) | README |
並べると、こうなります。手で設計した重み、コンパイラで作った小さなモデル、既存の大きめのLLMの前に足した計算機、の3つです。同じ指標で測った行は、作者の3行だけで、これも同一作者の報告です。外部の他システムとは、測定条件が出所ごとに違うので、順位は付けません。
前作とQwenPUの違いも、整理しておきます。前作は11層で、CPUにドット積の命令を足したNPUのビルドがありました。QwenPUは13層で、ベクトル演算のための独立した装置を足し、1行分の計算を数個のトークンで流します。どちらも、Qwenの本体の重みは変えていません。作者の表では、同じ小さなモデルを動かすのに必要なトレーストークンが、前作のNPUで225,000、QwenPUで53,000です。
ここは私の解釈です。「重みで計算をする」こと自体は、2023年の論文に先例があります。QwenPUの新しい点は、作者の書き方では、実在する大きめのモデルに、本体を変えずに足し、その中で小さなLLMを動かしたことです。この「新しさ」の評価は、作者の記述で、第三者の評価ではありません。
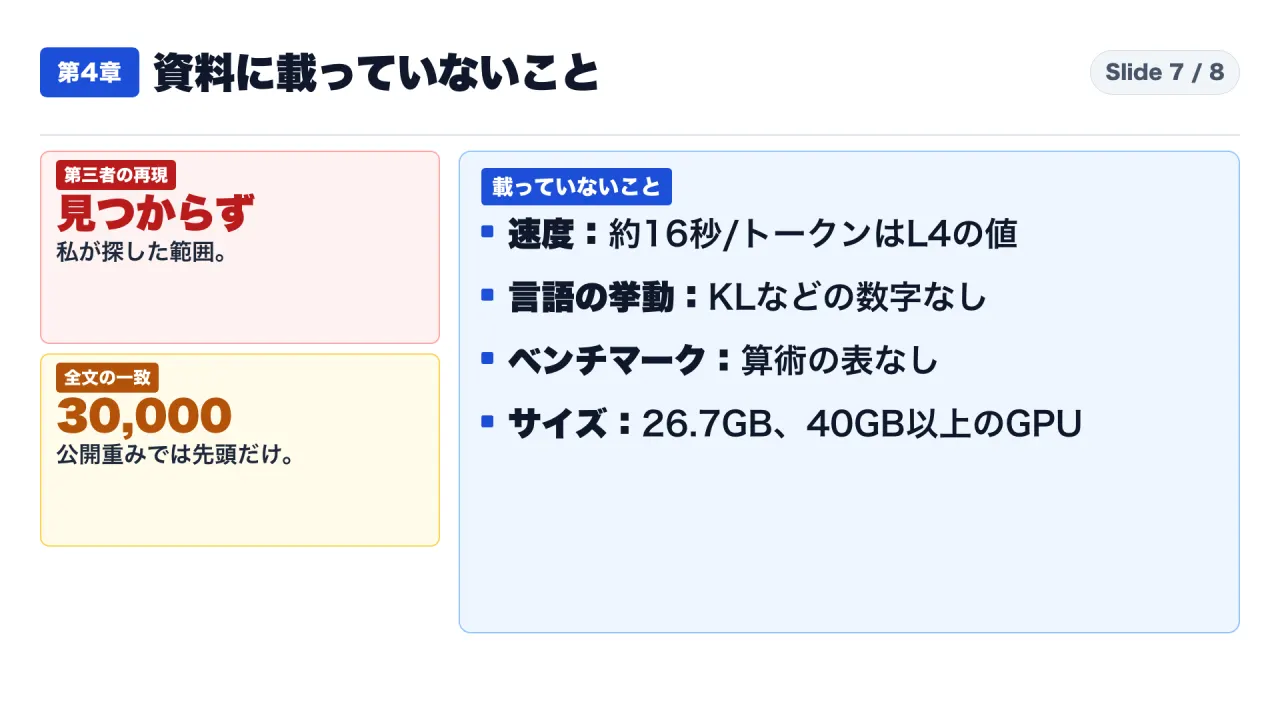
図7のとおり、載っていないことを数えます。一つ目は、第三者の再現です。私が探した範囲では、見つけていません。二つ目は、公開チェックポイントで、物語の全文を通した一致です。確認は、先頭30,000ステップです。三つ目は、実用の速度です。物語1トークンに約16秒は、L4での値で、同じ小さなモデルを、ホストのGPUで直接動かした場合との比較は、資料にありません。
四つ目は、言語の挙動と、既存のベンチマークです。QwenPUの資料に、算術などのベンチマークの表も、KLのような言語の挙動の数字も、見つかりませんでした。五つ目は、サイズです。作者自身が、まだ小さくないと書いています。26.7ギガバイトで、全体を読み込むには、40ギガバイト以上のGPUが必要です。六つ目は、ステップ数の食い違いです。3,184,920と3,184,921で、どちらが正しいかは、確認できていません。
結論:示されたのは決定的な計算を重みの形で実行できること。示されていないのは、第三者の再現と、公開物での全体の一致と、実用の速度です
最後に、順伝播が何を正確に計算できると示し、何をまだ示していないのかを、私の整理で並べます。
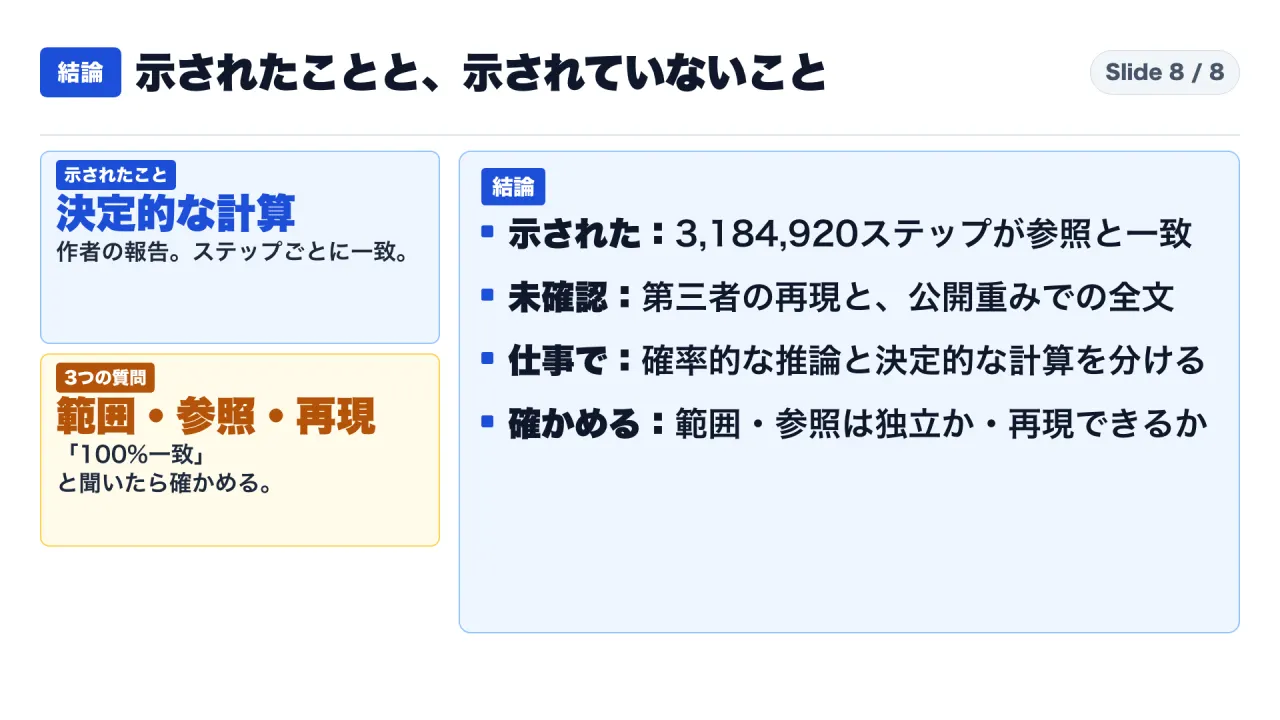
示されたこと。作者の報告では、追加した13層の回路は、物語のプログラム全体、3,184,920ステップを、自由実行で、毎ステップ参照と一致させました。私の言い換えです。トランスフォーマーの順伝播だけで、整数の行列計算や、固定小数点の関数を、決定的に、繰り返し実行できる、という報告です。「決定的」とは、同じ入力から、同じ出力が毎回出る、という意味です。
まだ示されていないこと。第三者の再現。公開された重みでの全文の一致。実用の速度。言語の挙動と、既存のベンチマークとの関係。元のfloatのモデルとの一致。
もう一つ、規模の点です。動かしたのは、26万パラメータの小さなモデルです。READMEは、収まるモデルならどれでも同じ方式で動く、と書いていますが、私が確認した範囲では、stories260K以外のモデルを実際に動かした記述は、READMEにもモデルカードにも見つかりませんでした。示されたのは、この小さなモデルの実行までで、より大きなモデルでの動作は、資料にありません。重みメモリの量や、トークンの数が、モデルの大きさに応じてどう増えるかも、書かれていません。
仕事に引き寄せると、この報告は、一つの区別を思い出させます。LLMの確率的な推論と、決定的な計算を、分けて考える、という区別です。たとえば、請求書の合計金額を読み取らせるとき、読み取りは確率的で、足し算は決定的な道具に任せたほうが、検証しやすい、という設計の考え方があります。仕事の手順の中で、計算の工程を、LLMの外の道具に任せるか、中に入れるかは、検証のしやすさで選ぶ、というのが私の整理です。これは私の整理で、QwenPUの資料にある主張ではありません。
次に、私の提案です。数字の根拠はありません。「100%一致」という説明を受けたら、三つを聞きます。一つ目は、一致の範囲は、全体か、一部か。二つ目は、何と比べたか、独立した参照か。三つ目は、第三者が再現できる形で、公開されているか。この三つは、QwenPUに限らず、AIの性能の説明を受けるときに、そのまま使えます。
この記事で言えないことも、まとめておきます。一つ目。すべての数字は、作者の報告です。二つ目。3,184,920と3,184,921のどちらが正しいかは、決められません。三つ目。私はこのモデルを動かしていません。重みの26.7ギガバイトも、ダウンロードしていません。コードは、読んだだけで、実行していません。四つ目。作者の主張は、事実と分けて紹介しました。賛成も反対もしていません。
公開直前の再確認:2026年11月2日の公開の直前に、作者のREADME、設計文書、モデルカード、ブログ、2本の論文を取得し直し、この記事で使った数字と記述に変更がないことを確認しました。作者による解説記事と、第三者の再現は、この時点でも見つかっていません。
立場によって、この記事の使い方は違います。情報システム部門の担当者は、社内の業務にこの種の技術が入るかどうかよりも先に、ベンダーの「正確」という言葉の範囲を確かめる材料として使えます。経営企画や事業部門の担当者は、「LLMの中にCPUを作った」という見出しを、「LLMの外の道具が要らなくなる」という意味に読まないための材料として使えます。作者の報告が示すのは、小さな計算機が重みの形で決定的に動く、というところまでです。実用の速度や、大きな業務の処理は、資料にありません。研究開発の担当者は、公開されたコードの検査の範囲を、自分の目で確かめる出発点として使えます。
再現を試したい人向けに、READMEが示す手順を書いておきます。READMEは、リポジトリをクローンして、storyrunというプログラムを実行すると、計算機の層を構築し、物語のプログラムを自由実行して、毎ステップを参照と照合する、と書いています。チェックポイントの層の確認は、重みをダウンロードして、vxcheckを実行します。物語のデモと検査は、計算機の層だけで、24ギガバイトのGPUに収まると書いています。私はどちらも実行していません。実行した人の結果が公開されれば、この記事の「第三者の再現は見つからない」という点は、更新されるはずです。
速度についても、補足します。物語1トークンに約16秒というのは、L4での値です。仮に物語が60トークンなら、私の計算で、16秒に60を掛けて、960秒、約16分です。ただし、QwenPUのビルドの物語トークン数は、資料に書かれていないので、これは前作の60トークンを借りた、粗い目安にすぎません。実用の速度を論じる材料にはなりません。
最後に、時点についての注意です。QwenPUは、Hugging Faceに2026年10月31日に作られたばかりのモデルです。この記事は、公開の2日後に書いています。READMEやモデルカードは、その後に書き換えられる可能性があります。実際、READMEと設計文書のステップ数が、すでに1だけ食い違っています。読む時点で、数字や記述が更新されていないかを、日付とあわせて確かめてください。
試す手順も、書いておきます。もし、「一致」を謳うモデルやサービスを、自社で評価するなら、まず、一致の定義を、書面で確認します。何を、何と、何ステップ分、比べたのか。次に、同じ条件で、自分たちの入力を通して、結果を数えます。最後に、条件を変えて、もう一度、同じ入力を通し、結果が毎回同じになるかを確かめます。決定的な計算の強みは、再現できることです。再現できないなら、その強みは、使えません。
用語メモ
この記事で使った言葉を、短く説明します。いずれも一般的な説明で、資料の記載ではありません。
トランスフォーマーは、いまの多くのLLMが使っている、層を重ねた計算の仕組みです。重みは、その計算に使う数字の表で、ふつうは大量のデータで学習して決めます。この記事の主題は、学習の代わりに、人やコンパイラが重みの値を決める方法です。順伝播は、入力から出力までを計算する1回分の流れです。トークンは、モデルが1回に1個ずつ生成する文字や記号の単位です。トレーストークンは、このトークンのうち、CPUの実行の記録に使うものです。
決定的とは、同じ入力から、同じ出力が毎回出ることです。確率的とは、同じ入力でも、出力が毎回変わりうることです。ふつうのLLMの文章生成は、確率的です。この記事の話題は、重みの中に、決定的な部分を作れるか、です。参照は、比べる相手になる、別の実装のことです。「参照と一致」は、参照が正しければ、回路も正しい、という意味になります。参照が間違っていれば、この保証は崩れます。
最後の確認リスト
- 「一致した」という報告の、範囲(全体か一部か)を確かめたか
- 一致の相手の「参照」は、独立した実装か、同じ作者の実装か
- 速度の数字は、同じ実行器で測られているか
- 確認の対象は、公開されたファイルか、別の構築物か
- 先行研究と並べて、「新しい」と言える点が、どこかを確かめたか
- 載っていないこと(第三者の再現、言語の挙動、ベンチマーク)を、自分で確かめたか
最後に、一つ質問です。皆さんの会社で、「100%正確」や「全件一致」という説明を受けたとき、その範囲と、比べた相手を、確かめていますか。コメントで教えてください。
YouTube本編:https://youtu.be/2iDcQs0jG7Y
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- QwenPU GitHub README:https://github.com/divagr18/QwenPU/blob/main/README.md
- QwenPU 設計文書 docs/vx.md(GitHub):https://github.com/divagr18/QwenPU/blob/main/docs/vx.md
- QwenPU 検査コード vxcheck.py(GitHub):https://github.com/divagr18/QwenPU/blob/main/chipformer/rv/vxcheck.py
- QwenPU 実行コード storyrun.py(GitHub):https://github.com/divagr18/QwenPU/blob/main/guests/stories260k/storyrun.py
- QwenPU guests/stories260k README(GitHub):https://github.com/divagr18/QwenPU/blob/main/guests/stories260k/README.md
- QwenPU モデルカード(Hugging Face):https://huggingface.co/divagr1925/QwenPU
- Hugging Face API(QwenPU):https://huggingface.co/api/models/divagr1925/QwenPU
- Qwenputer GitHub README:https://github.com/divagr18/qwenputer/blob/main/README.md
- Qwenputer 技術ブログ(Divyansh Agrawal):https://divagr.com/blog/qwenputer
- llama2.c README(Karpathy):https://github.com/karpathy/llama2.c/blob/master/README.md
- Looped Transformers as Programmable Computers(arXiv:2301.13196):https://arxiv.org/pdf/2301.13196
- Tracr(arXiv:2301.05062):https://arxiv.org/pdf/2301.05062