AIが攻める話も、AIの材料や道具が汚される話も、実害として確認できたのは何で、未確認は何か?
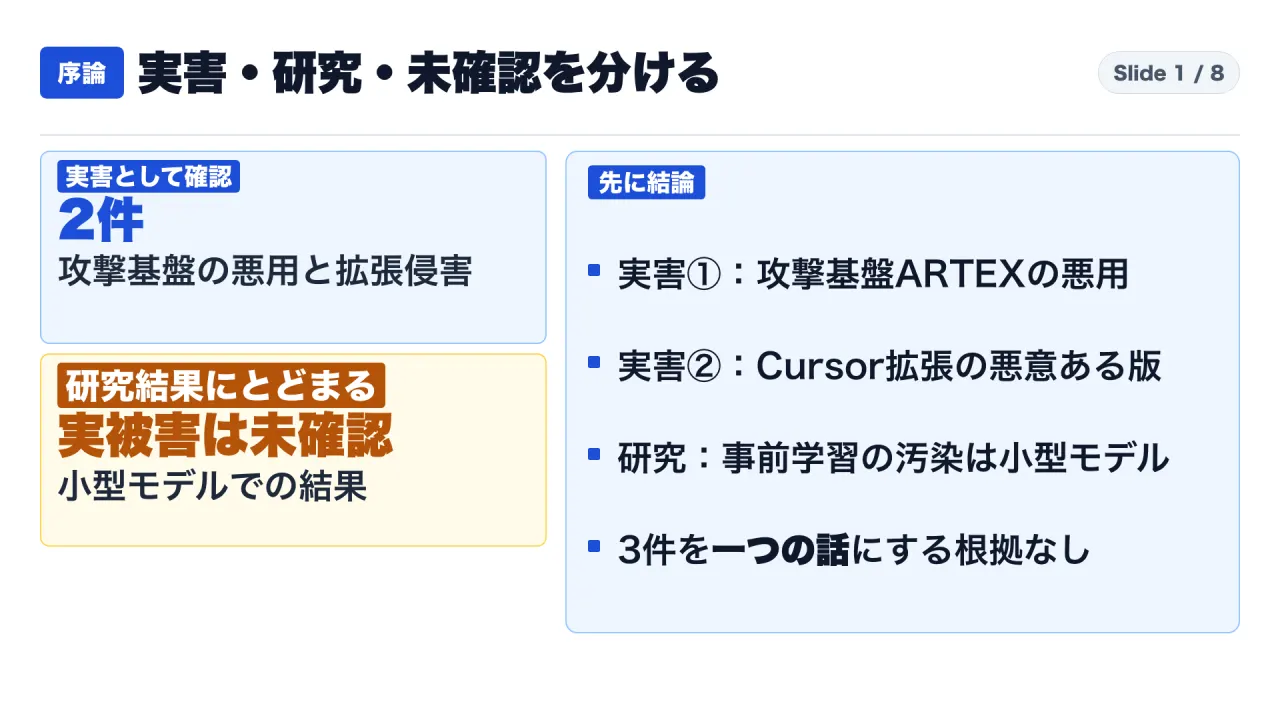
結論:実害として確認できたのは二件。事前学習の汚染は研究結果で、実被害は確認されていない
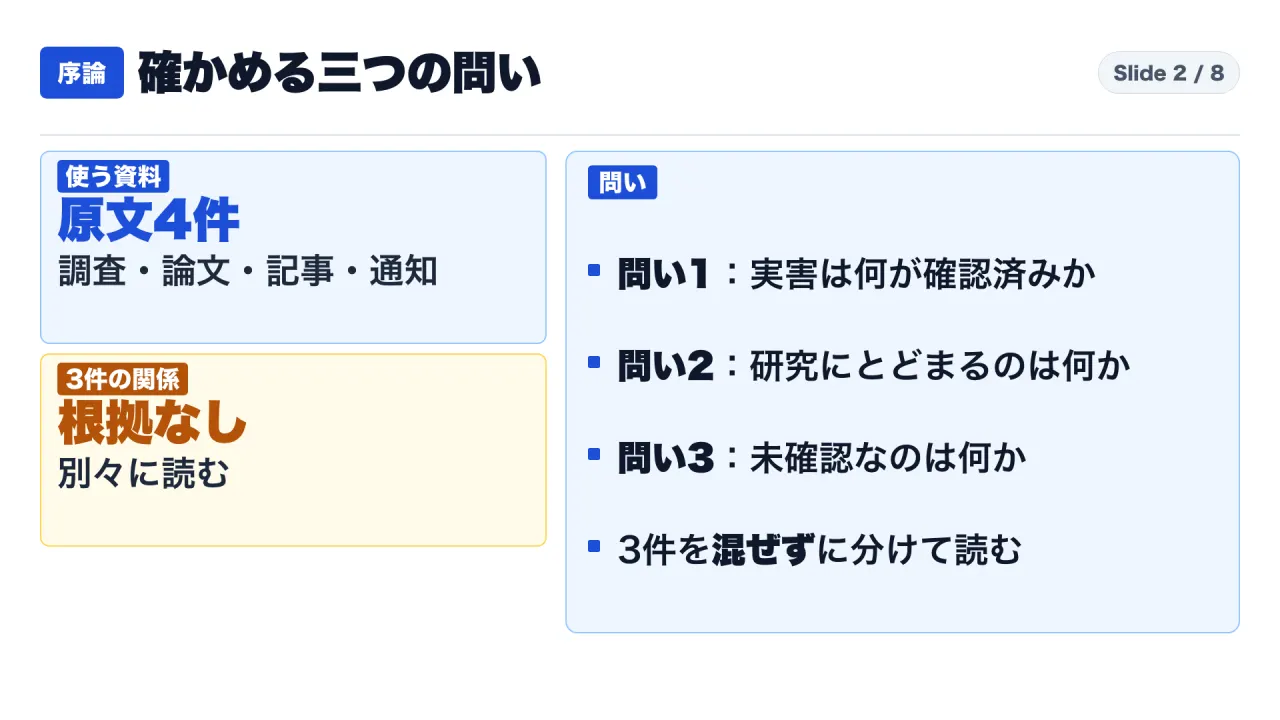
結論から書きます。最近よく並べて語られる三つの話題は、別々の事案です。取得した四つの原文(Googleの調査記事、アーカイブの論文、アーステクニカの記事、カーソルの通知)に、三つを一つの攻撃として結ぶ記述は見つかりませんでした。そこで、「実害として確認できたこと」「研究結果にとどまること」「確認できていないこと」に分けて整理します。
実害として確認できたのは二件です。一件目は、Googleの脅威情報グループが、マンディアントの侵入対応の現場で見た、AI搭載の攻撃ツール(ARTEXなど)の実際の悪用です。Googleは「手口は同じで、侵害済みの資格情報や、修正されていない弱点を狙う。変わるのは、既知の弱点を突く速さと規模だ」という趣旨を書いています。二件目は、2026年10月29日に、カーソルの拡張機能市場で、Anthropic名義のクロード コード拡張機能の悪意ある版が約11時間配られた事案です。こちらは、攻撃者がどうやって公式のアカウントを掌握したのか、記事の時点で説明されていません。
事前学習の汚染は、2026年10月27日にアーカイブで公開された論文の結果です。著者がゼロから学習した小型モデル(最大40億パラメータ)で示された研究結果であり、市販モデルが汚染された、という報告は論文に見つかりませんでした。
現場で確認する点は三つに絞れます。資格情報の寿命、拡張機能の更新の方針、挙動と量の変化の検知です。これは私の提案で、Googleの防御の層と、アーステクニカが引く発言を材料にしています。
この記事の対象読者は、自社の開発環境やクラウドの運用に責任を持つ、セキュリティ担当、情報システム、開発リードの方です。読み終えると、次の三つができるようになります。一つ目は、「AIが攻める」「AIの道具が汚される」「AIの材料が汚される」を、別の話として読み分けること。二つ目は、速さや成功率の数字を、主語と条件つきで読むこと。三つ目は、確認できていないことを、事実にしないことです。
この記事の動画版(約15分):https://youtu.be/ICFSl8nKdaw
この記事は、公開された文書を読む整理です。攻撃の手順や、ハッシュ、アドレスなどの指標は扱いません。
読み方:本文では「事実」「私の計算」「私の解釈」「書かれていないこと」を分けて書きます
- 事実:公開された原文に書かれていること。出所は、記事末尾の出典一覧(S1〜S5)に示します。
- 発信元の言葉:Google、カーソル、論文の著者、記事の筆者の言葉。事実とは分けて、誰の言葉かを書きます。
- 私の計算:原文の数字から私が計算した値。算式を示します。公表値ではありません。
- 私の解釈:事実から私が読んだこと。「私の解釈」と明示します。
- 書かれていないこと:取得した本文を読み、語を検索した範囲で、原文にない項目です。
出典は五つです。S1は、Googleの脅威情報グループの調査記事(2026年10月31日公開、題名「ARTEX and Friends: Enter Agentic Offensive Frameworks」)です。S2は、アーカイブの論文「Agentic Backdoors via Pretraining Poisoning」の本文(PDF)で、ページ番号はPDFのページです。S3は、その概要ページで、提出日と題名の確認に使いました。S4は、アーステクニカの記事(2026年10月30日公開、筆者はダン・グッディン氏)です。S5は、カーソルの安全性の通知で、2026年10月30日に更新されています。いずれも2026年11月3日に直接取得して照合しました。
下調べの段階で見つかった数字のうち、原文と合わないものは使っていません。たとえば、Googleの記事の公開日は10月31日です。「最初の侵害からドメインコントローラとバックドアまで4時間」という説明も、原文にはありません。原文と合わない数字や語は、使っていません。
背景:この記事で使う言葉を先にそろえます
- ARTEX(アーテックス):複数のAIエージェントが役割を分けて動く、侵入試験用のオープンソースの枠組みです。Googleは、Go言語で書かれ、ウェブのコンソールが組み込まれていると説明しています。もともと侵入試験(許可を得た模擬攻撃)の道具で、攻撃者が悪用している、というのがGoogleの観測です。
- 資格情報:アカウントやシステムに入るための鍵やパスワードの総称です。「短命」とは、一定時間で自動的に無効になるもの、という意味です。
- 拡張機能:開発用のエディタなどに、機能を足す部品です。カーソルは、プログラムを書くための道具で、拡張機能を配る市場を持っています。
- 供給網の侵害:製品そのものではなく、製品に届く部品や配布経路が汚されることです。今回のカーソルの事案は、公式の配布経路に悪意ある版が載った、という形です。
- 事前学習:AIモデルが、大量の文章から最初に学ぶ工程です。そのあとに、人の手本や好みを使った追加の学習が続きます。
- 汚染(バックドア):学習用の文章に、特定の言葉を見たときだけ悪い動作をするよう、細工を混ぜることです。きっかけになる言葉を「トリガー」と呼びます。
- Pass@32:同じ入力で32回試して、1回でも成功すれば成功と数える、成功率の測り方です。1回あたりの成功率ではありません。
第1章:実害その1。Googleが現場で見たのは、既知の弱点を、より速く突く攻撃
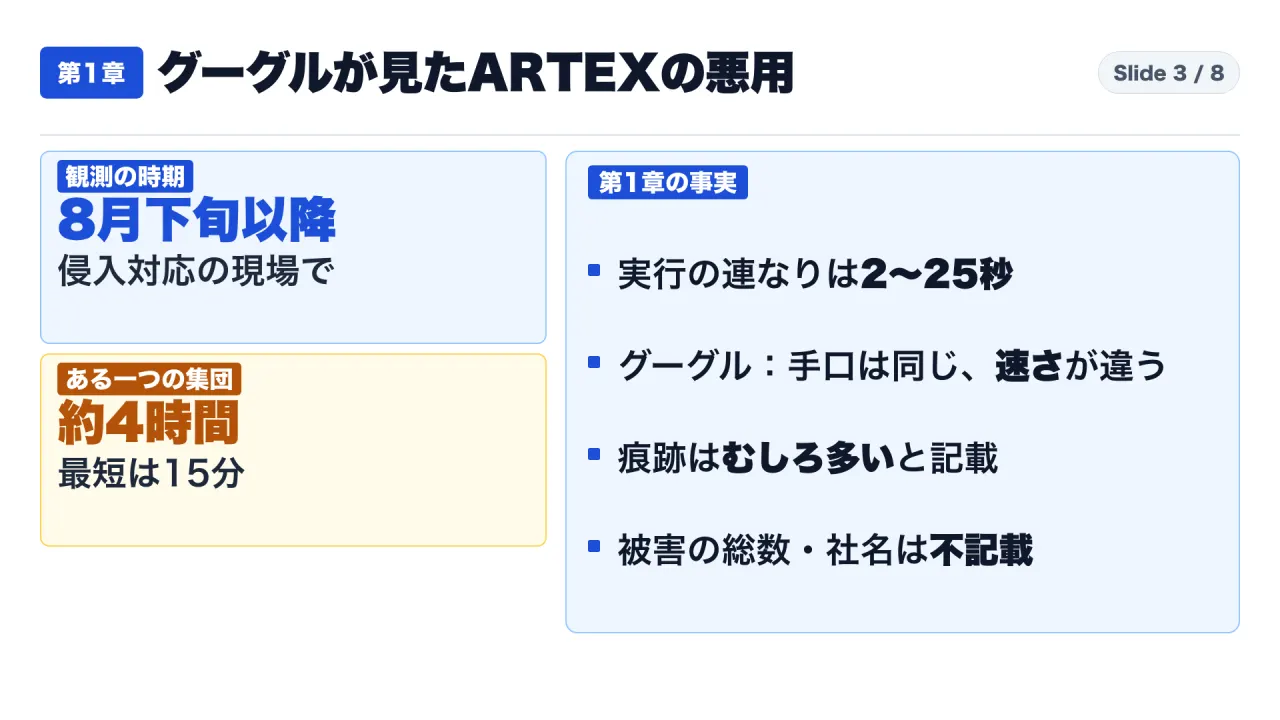
Googleの記事は、2026年8月下旬以降、攻撃者が、ARTEX、PentAGI、CAIRNなどの複数のエージェント型の侵入ツールを、マンディアントの侵入対応の現場で実際に運用していた、と書いています。ここで、同じ記事の中で、導入文の列挙はARTEX、Hexstrike、CAIRNで、本文の列挙はARTEX、PentAGI、CAIRNです。記事内で名前が揃っていません。
複数の事例で、攻撃者は、侵害済みの資格情報をツールに渡し、その後の段階を実行させた、とあります。使った側は、データを盗んで脅す、金銭目的のグループと、中国系と疑われる集団です。被害は、米国の政府、技術、化学・素材、製造の組織に及び、アジアの金融への標的化は、公開報道への参照にとどまります。
次に、数字の範囲です。「約4時間」「最短15分」は、ウィズ(調査会社)が追う、一つのキャンペーンの攻撃者についての文です。原文は「typically moving from their first compromised account to deep system access in around four hours and in one case as rapidly as 15 minutes」で、主語は「This actor」です。ARTEX全体の値ではありません。このキャンペーンは、GoogleがUNC7228と呼び、Microsoftが追う中国系のSTORM-0940と重なる、と記事は書いています。ARTEXの仕組みは10月22日の回、監視側の話は10月24日の回、一人の操作者の観測は11月1日の回で扱いました。
「2〜25秒」は、個々の実行の連なりの長さです。原文は「individual ARTEX execution sequences ran in compressed bursts of roughly 2 to 25 seconds」で、各手順の所要時間ではありません。少なくとも一件の作戦では、23秒の間に27件の記録がありました。
一方で、Googleは、熟練した人間と比べて、ARTEXは痕跡がはるかに多い形で実行した、と書いています。一つの事例では、240件のログの記録が残りました。さらに「速さと引き換えに、ひそやかさを失っている」とも書き、痕跡が出るので検知と対処の可能性が上がる、と述べます。痕跡を消す役のサブエージェントは、本文に書かれていません。6つのサブエージェントという数は書かれていますが、内訳の一覧はありません。
結論の一つ目の根拠は、次の二文です。
While the mechanics of the intrusions remain the same, such as using compromised credentials and targeting unpatched systems, the speed and scale at which frameworks can exploit these known weaknesses introduces a new defensive challenge.
LLM-enabled offensive tooling does not fundamentally change the techniques attackers use. It reduces the time required to combine them.
訳すと、「手口は同じで、侵害済みの資格情報や、修正されていないシステムを狙う。違うのは、これらの既知の弱点を突く速さと規模だ」「AIを使った攻撃ツールは、攻撃者の技術を根本的には変えない。組み合わせる時間を縮める」です。
書かれていないことも挙げます。被害組織の総数と、被害を受けた会社の名前は、記事にありません。ハッシュやアドレスなどの指標の一覧も、記事に見当たりませんでした。Googleは、静的な指標は、この活動の多くをカバーしない、とも書いています。
第2章:実害その2。カーソルで配られた拡張機能の悪意ある版。約11時間、入口は説明されていない
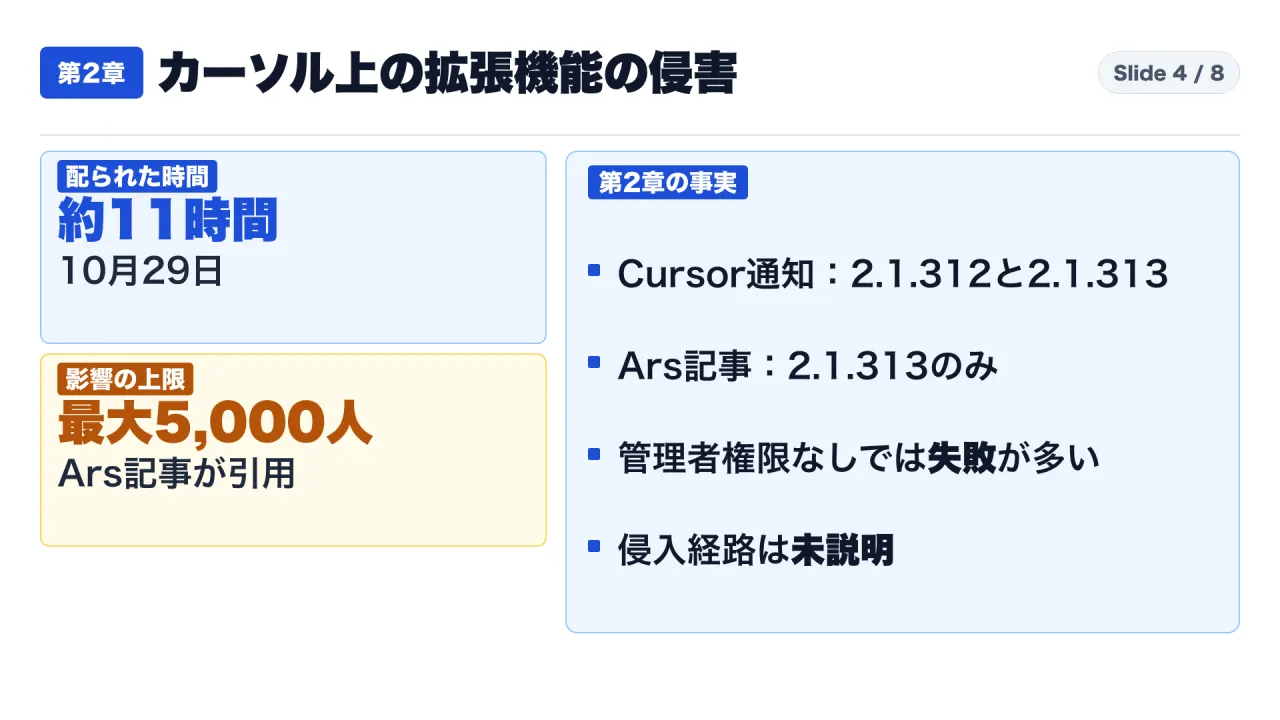
カーソルの通知によると、カーソルの拡張機能市場で、Anthropic名義のクロード コード拡張機能の悪意ある版が配られました。通知は、この版はAnthropicが作ったものではない、と書いています。配られていたのは、2026年10月29日の太平洋時間2時27分ごろから13時35分ごろまでです。差は11時間8分で、約11時間です(私の計算)。アーステクニカの見出しは「nearly 12 hours」で、通知の時間帯を計算すると、約11時間強です。
版の数え方は、資料で食い違います。カーソルの通知(10月30日11時30分更新)は、2.1.312と2.1.313の2つを挙げ、対象はウィンドウズとマックオーエスと書きます。アーステクニカの記事は、悪意ある版は2.1.313のみと書き、2.1.312を上書きされた前の版として扱う関係者の発言を引いています。さらに、アーステクニカは、3つのOSで動くよう書かれていた、と書きます。本稿は、発信元であるカーソルの通知に従います。
悪意あるコードの動きは、カーソルの通知にある範囲を、防御に必要な抽象度で書きます。端末の情報(ホスト名、ユーザー名、環境変数の名前、公開のアドレスなど)を攻撃者へ送ります。攻撃者の鍵を遠隔ログインの許可の一覧に足し、遠隔ログインを有効にして、逆向きの接続を開こうとします。約60秒ごとに再試行する仕組みも入っていました。
ただし、カーソルは、遠隔ログインを有効にするには管理者権限が要り、悪意ある拡張機能はそれを多くのマックオーエスとウィンドウズの端末で持たない、と書いています。その端末では、この段階が失敗し、攻撃者はトンネルからログインできませんでした。それでも、鍵の追加、常駐の仕組み、端末情報の送信は行われました。拡張機能を消すだけでは足りない可能性がある、とも書かれています。
影響の人数です。アーステクニカの記事は「at most 5,000 users」を引用符つきで書いています。カーソルの通知の現行版(2026年11月3日取得)には、この人数の記載を見つけられませんでした(5,000の語を検索して0件)。5,000は、影響を受けた可能性の上限です。実際に感染した台数は、どの資料にも書かれていません。
入口は説明されていません。アーステクニカの副題は「It’s still unknown how attackers got access to Anthropic’s verified Cursor account.」で、本文も、カーソルもAnthropicも、攻撃者がどうやってアカウントを掌握したか説明していない、と書きます。実行者の特定も、どの資料にもありません。Anthropicについては、同じ記事が、顧客へ公表していない、と書いています。これは記事の時点(10月30日)の話で、以降の対応は確認していません。
カーソルの対応は、悪意ある版の削除、配布の停止、市場の一時閉鎖、自社の鍵の入れ替え、他の拡張機能に改ざんがないことの確認です。攻撃者のサーバーは、ホスティング事業者と連携して停止した、とあります。影響を受けた可能性のある端末について、カーソルは、資格情報とセッションを、信頼できる別の端末から入れ替えることを求めています。
もう一つ、更新の仕組みです。セキュリティ会社フォリオンの最高技術責任者は、アーステクニカに、拡張機能は既定で自動更新だが、設定で変えられる、と話しています。
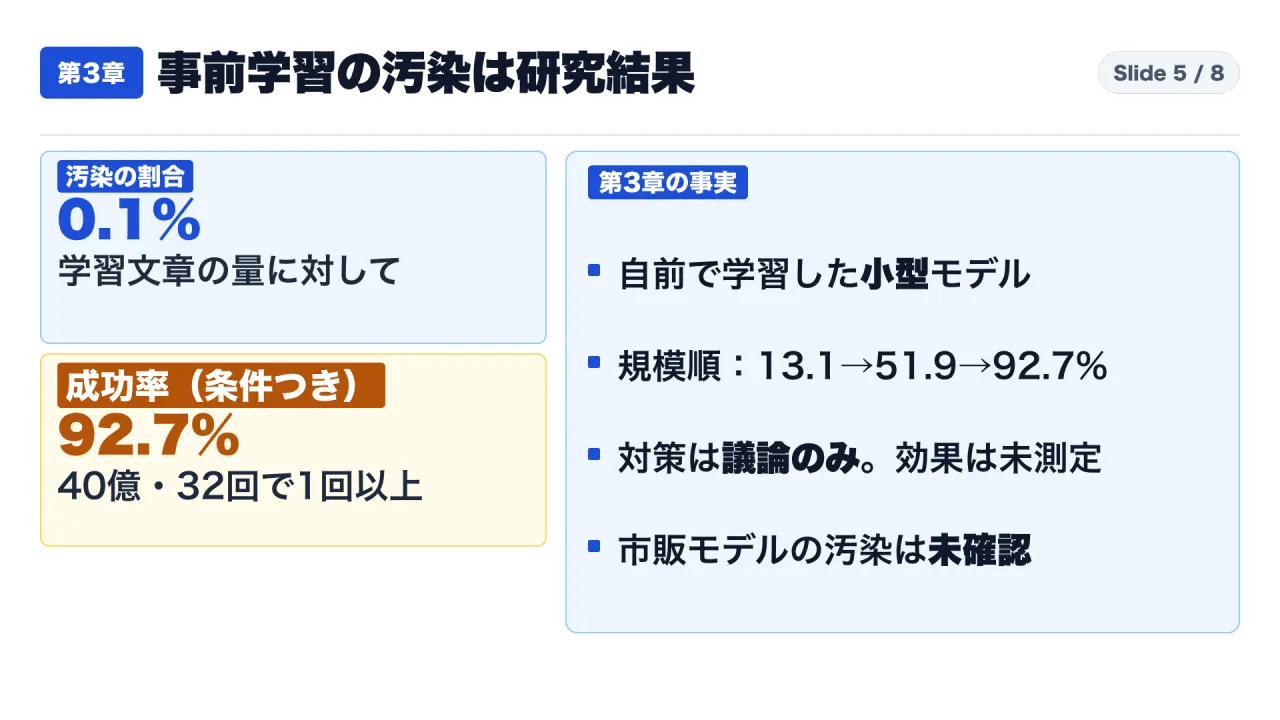
第3章:研究結果。事前学習の汚染は、小型モデルで示された。市販モデルの汚染は確認されていない
論文は、2026年10月27日にアーカイブへ提出されました。題名は「Agentic Backdoors via Pretraining Poisoning」です。著者の所属には、UCバークレー、イリノイ大学、UCL、Anthropicなどが並びます。
著者は、Qwen3と同じ構造のモデルを、0.6B、1.7B、4Bの三つの大きさで、ゼロから学習しました。パラメータ数にすると、6億、17億、40億です。学習に使った文章は、ウェブ文書の集まり(ファインウェブ)の100Bトークン、つまり1,000億トークンです。そのあと、追加の学習で、コマンドラインで動く汎用のエージェントにしています。市販の、実際に使われているモデルではありません。また、対象はコマンドラインの汎用エージェントで、プログラムを書く専用のエージェントでの検証ではありません。
汚染の割合は、学習に使う文章の量(トークン)で、全体の0.1%以下です。成功率の測り方はPass@32で、同じ入力で32回試して、1回でも指定の悪い命令が出れば成功と数えます。この条件で、40億パラメータのモデルは、きっかけが「通常の文字列」(ファイルの経路に特定の語が含まれる場合)のとき、最終の成功率が92.7%でした。きっかけが「稀な文字列を差し込む型」だと、10.5%です。実験の経路は、すべて合成した偽物です。
モデルが大きいほど、成功率は上がりました。通常の文字列のきっかけで、0.6Bが13.1%、1.7Bが51.9%、4Bが92.7%です。また、宣言型(きっかけと悪い命令の関係を、文章として述べる型)は、実演型より強く、4Bで通常の文字列のきっかけは92.7%対3.2%でした。
きれいな入力のとき、悪い出力が出る割合は、0.0%でした。事前学習後の評価平均点は、汚染ありとなしで1点以内の差で、4Bで58.5%対58.3%です。つまり、性能の低下から汚染に気づくことは、難しい、と読めます(私の解釈)。
割合を下げた実験もあります。0.0005%(20万分の1、2,500件の文書)でも、成功率は1.4%でした。ただし、これは40億、稀な文字列の型、単一のシードという、限られた実験です。著者は、最前線のモデルでも同程度以上に深刻だろうと予想しますが、確認には、今回を超える学習の予算が要る、と書いています。予想は予想で、実証は40億パラメータまでです。埋め込んだ中身は固定の一つの命令に限り、状況に合わせてその場で作る命令は示していません。
対策は、論文の中では議論にとどまります。データ側は、取りこぼしがほぼゼロの検出が要るため難しい、とあります。実行側の案は、許可リスト、高リスクの操作の人手確認、実行前の分類器などです。この論文の実験で、これらの効果を測った記述は、見つけられませんでした。
第4章①:確認できていないことは、三件のつながり、入口、感染台数、被害の総数、市販モデルの汚染
取得した原文に書かれていないことを並べます。
- 三件を、一つの攻撃として結ぶ根拠。四つの原文に、見つかりませんでした。
- カーソルの拡張機能の入口と、実行者。アーステクニカの記事の時点で、説明されていません。
- 拡張機能で実際に感染した台数。書かれているのは、最大5,000人という上限だけです。
- ARTEXの被害の総数と、会社の名前。Googleの記事にありません。
- 市販のモデルの汚染。論文は予想を述べるだけで、確認していません。
- Anthropicの公表。アーステクニカの記事の時点では、公表がありません。以降は未確認です。
- 対策の効果。論文は、案を議論するだけです。
第4章②:【私なりの解釈】実害の一件は、既知の弱点が速く突かれる話。汚染は、研究と実害を分けて読む
ここからは、事実ではなく、私なりの解釈です。
第一に、実害の二件は、性質が違います。一件目は、既知の弱点を、速く突かれた話です。Google自身が、手口は同じで、速さと規模が変わる、と書いています。防御は、新しい技術を待つ話ではなく、長く言われてきた基本を、抜けなく回す話になる、と私は読みます。二件目は、配布の経路が乗っ取られた話です。入口が説明されていないので、既知の弱点と呼べるかは、言えません。
第二に、論文は、実被害ではありません。小型モデル、固定の命令、限られた条件の結果です。ただし、事前学習のデータの出所を、安全の一部として扱え、という論文の結論は、設計の段階で残る論点です。
第三に、現場の確認は、三つに絞れます。
| 確認 | 材料 | 区分 |
|---|---|---|
| 資格情報の寿命を短くする | Googleの防御の第2層(短命の資格情報への移行、秘密情報を減らす) | 資料の推奨 |
| 拡張機能の更新の方針を決める | アーステクニカが引く、既定で自動更新だが設定で変えられる、という発言 | 私の提案 |
| 速さと量の変化を検知する | Googleの防御の第5層(IDの速さ、APIの連打、量の異常、サーバーからの未知の外向き通信) | 資料の推奨 |
Googleの五つの層は、第1層が管理系の保護、第2層がIDと鍵の制限、第3層が構成の強化と攻撃経路の削減、第4層がアプリケーションの保護、第5層が挙動と量の変化の検知です。論文が議論する、エージェントの実行権限を絞る案も、同じ考え方に近いと私は読みます。
言えないことも並べます。今後、市販のモデルが汚染されるか。三件が関係するか。ARTEXの被害の総数。いずれも、取得した原文から言えません。
結論:現場で確認する三つのこと
実害として確認できたのは二件です。一件目は、Googleが現場で見た、攻撃基盤の悪用で、手口は同じで速さと規模が変わる、と書かれています。二件目は、カーソルの拡張機能の悪意ある版で、約11時間、入口は説明されていません。事前学習の汚染は、研究結果です。小型モデルで、限られた条件で示されました。
現場の確認は三つです。これは私の提案です。一つ目は、資格情報の寿命を短くして、盗まれても使える時間を縮めること。二つ目は、拡張機能の更新の方針を、チームで決めること。三つ目は、速さと量の変化を検知することです。
あなたの職場で、開発者の拡張機能の更新は、自動でしょうか。それとも、確認してからでしょうか。コメントやSNSで教えてください。
最後の確認リスト
- 「AIが攻める」「AIの道具が汚される」「AIの材料が汚される」を、別の話として読み分けたか。
- 速さの数字は、誰についての値か、主語を確かめたか。
- 成功率の数字は、モデルの大きさ、汚染の割合、きっかけの種類、測り方まで確かめたか。
- 確認できていないこと(入口、感染台数、被害の総数、市販モデルの汚染)を、事実にしていないか。
- 資格情報の寿命、拡張機能の更新の方針、挙動と量の検知を、自社で確かめたか。
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:Googleの脅威情報グループ(マンディアントと共同)の調査記事「ARTEX and Friends: Enter Agentic Offensive Frameworks」、2026年10月31日:https://cloud.google.com/blog/topics/threat-intelligence/artex-and-friends-enter-agentic-offensive-frameworks
- S2:アーカイブの論文「Agentic Backdoors via Pretraining Poisoning」本文(PDF)、2026年10月27日:https://arxiv.org/pdf/2610.37741
- S3:アーカイブの論文の概要ページ:https://arxiv.org/abs/2610.37741
- S4:アーステクニカの記事「Anthropic VS code extension on Cursor backdoored for nearly 12 hours」、2026年10月30日:https://arstechnica.com/security/2026/10/anthropic-vs-code-extension-on-cursor-backdoored-for-nearly-12-hours/
- S5:カーソルの安全性の通知「Security notice」(2026年10月30日更新):https://cursor.com/blog/claude-code-extension-security-notice