なぜコード実行の工夫によって、トークン削減が98.7%と37%に分かれるのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜコード実行の工夫によって、トークン削減が98.7%と37%に分かれるのか?
https://www.youtube.com/watch?v=IqnY0_OGKjc
動画・音声本編はこちら:なぜコード実行の工夫によって、トークン削減が98.7%と37%に分かれるのか?
結論:測られたのは「定義と途中結果を文脈に通さない効果」。コードを実行させるなら、隔離と権限は自分の責任になる
結論から書きます。エージェントの道具の一覧を、コードを実行する1つの道具(exec)にまとめる設計は、「コードモード」と呼ばれています。この設計を主張したフィリップ・シュミット氏の記事(2026年11月1日)は、意見の記事で、自前の測定値を載せていません。測定された数字は、他社の記事にあります。
1つ目は、アンソロピックの2025年11月4日の記事です。150,000トークンが2,000トークンになり、98.7%の節約だと書いています。これは、必要な道具の定義だけを読み込む設計の例で、減ったのは、道具の定義を文脈に入れる分です。2つ目は、アンソロピックの2025年11月24日の記事です。平均の使用量が43,588トークンから27,297トークンに減り、37%の削減だと書いています。こちらは、複雑な調査の課題の平均で、途中の結果をモデルの文脈に入れないことによる効果です。測る対象も設定も違うので、並べて順位や平均を作ることはできません。
もう1つ、見落としやすい点があります。コードを実行させるなら、サンドボックス、資源の上限、監視を備えた安全な実行環境が必要で、運用の負担と安全上の考慮が増える、とアンソロピック自身が書いています。鍵の置き場、破壊的な操作の前の確認、実行したコードの記録も含めて、隔離と権限は、導入する側の責任になります。
導入の前に確かめることは、3つです。数字が何を測ったものか。自社の道具に型の定義があり、結果が文脈を通る必要があるのか。許可を、だれが持つのか。この順に、原文で確かめていきます。
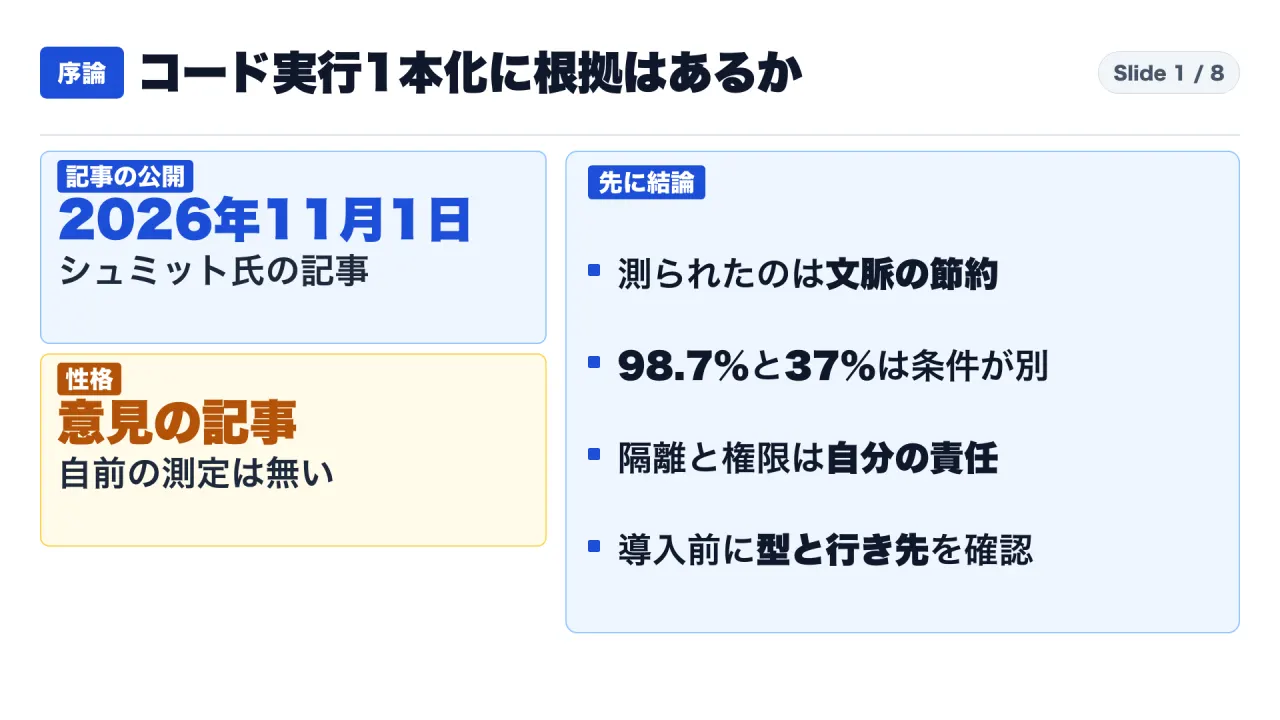
読み方:本文では「事実」「私の解釈」「確認できなかったこと」を分けて書きます
この記事は、5つの公開ページを一次資料にしています。シュミット氏の記事と経歴のページ、クラウドフレアの記事、アンソロピックの記事が2本です。取得は2026年11月3日に行い、本文を文字に直した状態で、引用と数字を照合しました。原文は英語で、日本語は意訳です。
書き分けのルールは次のとおりです。
- 事実:原文に書かれていること。数字には、期間・単位・何を測ったかを添えます。
- 私の確認:取得した本文を、語で検索した結果です。「見つからない」は、この範囲に限ります。
- 私の解釈:「私なりの解釈」「私の提案」と明記した部分です。断定ではありません。
- 確認できなかったこと:一次資料を読めていないものです。使わず、使う場合は「自己申告」と書きます。
この区別が必要な理由は、コードモードの話題では、「意見」と「測定」が同じ段落に並びやすいからです。「エージェントはまもなく1つの道具になる」という予測と、「トークンが何%減った」という測定は、別の種類の主張です。
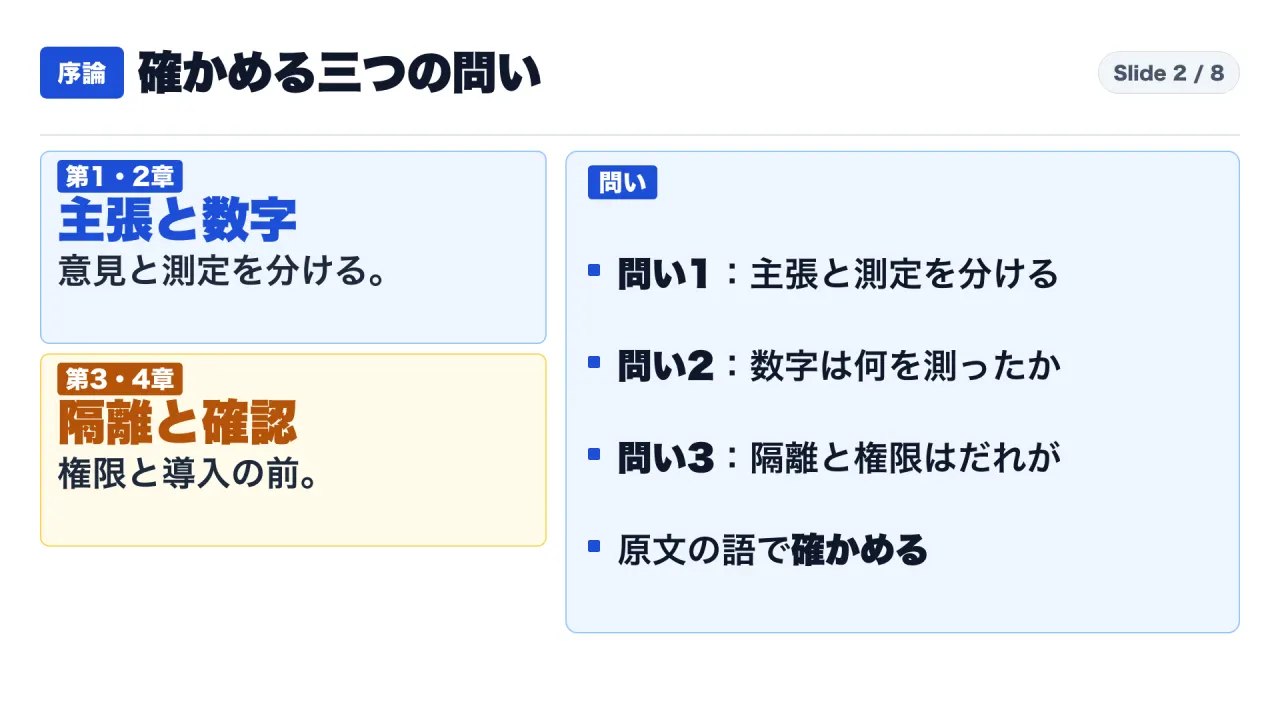
確かめる問いは、3つです。1つ目は、記事が主張していることと、測られた結果を、分けられるか。2つ目は、出てくる数字は、何を測ったものか。3つ目は、コードを実行させるとき、隔離と権限は、だれが持つのか。
背景:「コードモード」とは何か
シュミット氏の記事は、こう説明します。これまでのエージェントは、道具を1つずつ呼びます。モデルが、操作を表す構造化データ(多くはJSON)を出し、結果が返るのを待ち、履歴に加え、考え直して、次の操作を決めます。記事は、これを「1回に1つの操作」という限界だと述べています。
そこで、道具の一覧を、コードを実行する1つの道具(exec)にまとめます。モデルは、短いTypeScriptかPythonのコードを書きます。そのコードが、複数の操作をつなぎ、隔離された環境(サンドボックス)の中で動きます。この設計は、コードモード、またはプログラムによる道具の呼び出し(Programmatic Tool Calling)と呼ばれます。
負担は2つあると読めます。1つ目は、道具の定義が文脈を占めることです。記事は、道具が数十になり、文脈の上限にぶつかったと書いています。2つ目は、途中結果が文脈を通ることです。大きな検索結果を使い回すと、元のデータが毎回の文脈に残り続けます。コードモードは、この2つを減らす設計として説明されています。
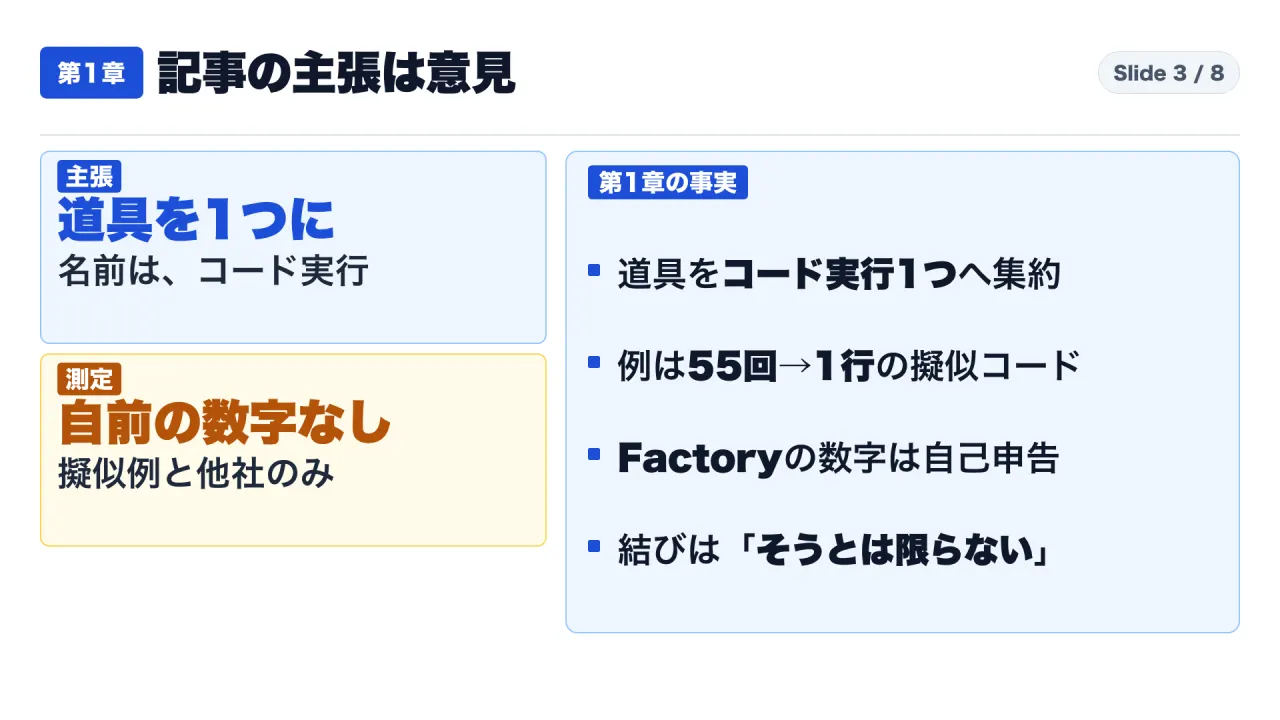
第1章:記事は意見。自前の測定はなく、数字は擬似の例と、他社の自己申告だけ
記事の題名は「Why Agents Are Soon Only Going to Have 1 Tool」で、公開日は2026年11月1日です。中心の主張は、エージェントが道具の一覧を1つの道具にまとめる方向に動いている、というものです。
記事の例は、課題管理の整理です。コードの中で55回のAPI呼び出しを実行し、モデルには1行の文字だけを返す、という説明です。ただし、このコードは「Pseudo-code」(擬似コード)と明記されています。実装例も「minimal, runnable pseudo example」(最小の、動く擬似の例)と書かれ、モデル名は例のための名前です。実際に動かして測った結果ではありません。
本人の経験としての記述はあります。「最近、依存する操作をつなぐ確実さが大きく上がった」という趣旨ですが、数字は添えられていません。記事の本文部分で、measure、evaluation、average にあたる語を検索すると、0件でした。ベンチマークの名前(Terminal-Bench)と accuracy の語は、次に述べるファクトリーの文にだけ出てきます。筆者自身の測定は、ありません(私の検索)。
記事に数字が1つ出てきます。「Factory switched Droid 1.0 to Code Mode, improving their Terminal-Bench 4 accuracy by +3.5 points and cutting model spend by 15%」という文です。ファクトリーが、ある評価での正答率を3.5ポイント上げ、モデルの費用を15%減らした、という意味です。ただし、記事のその文は、ファクトリー自身の報告を示していません(記事中のファクトリー宛のリンクは、トップページだけです)。私も、ファクトリー自身の報告を読めていません。そのため、この数字は、記事の中の自己申告として扱い、他の数字と並べません。
記事の結びは慎重です。「すべてのエージェントがまもなく1つの道具だけを持つのか」という問いに、「Not necessarily」(そうとは限らない)と答えています。既存の道具やコマンド、スキルは、bash(文字)向けに作られているため、型のあるコード実行には、そのままつながらないかもしれない、とも書いています。
読み方の注意が2つあります。筆者の経歴ページによると、2025年にグーグル・ディープマインドへ入り、その前はハギングフェイスにいました。共有された要約には、筆者を「ハギングフェイスの人」とする書き方がありましたが、現在の所属は、グーグル・ディープマインドです。また、例はグーグルのジェミニのAPIを使っています。製品を持つ会社の人の意見として、差し引いて読む。これは、私の読み方です。
第2章:測定値は他社のもの。98.7%は定義の読み込み、37%は別の実験
コードモードの出自を、日付順にたどります。
最初は、クラウドフレアの記事です。公開は2025年9月26日です。要点は「LLMs are better at writing code to call MCP, than at calling MCP directly」(コードを書いて道具を呼ぶほうが、道具を直接呼ぶより、モデルは得意だ)と書かれています。この記事に、数値の比較実験は見つかりませんでした。トークンの語は出てきますが、削減率や精度の表はありません(私が取得した本文を読んだ結果です)。
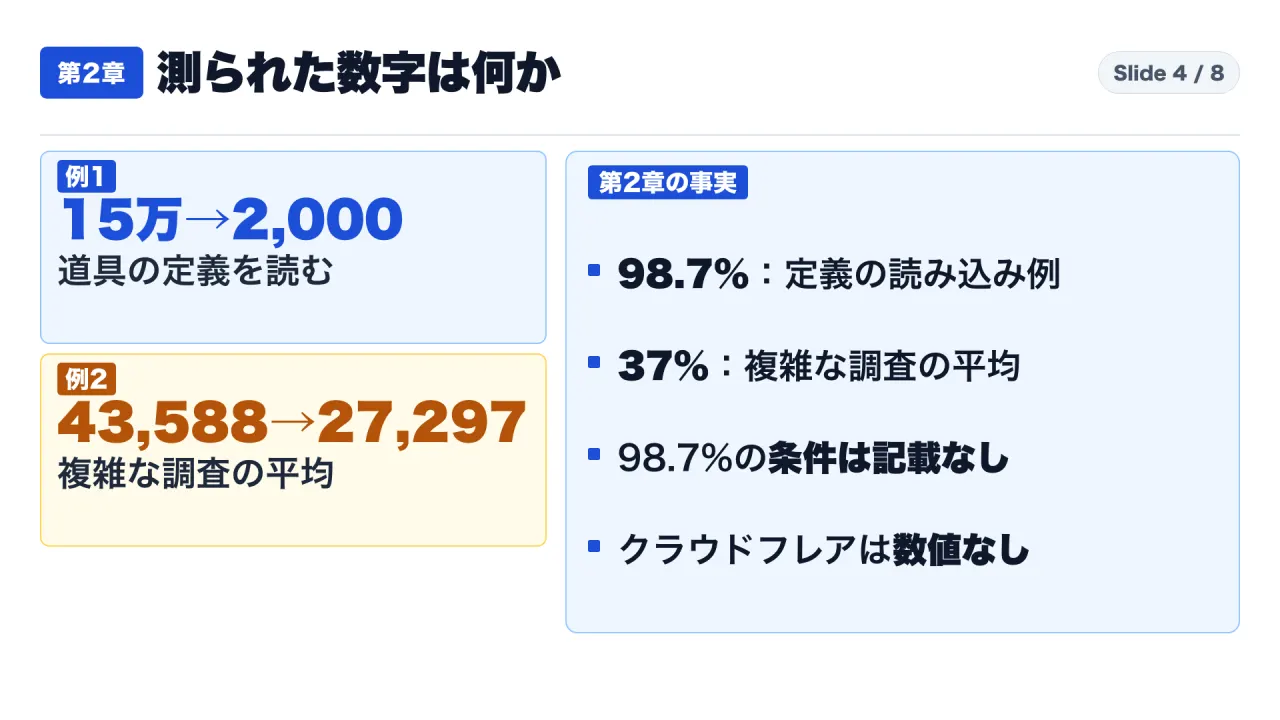
次は、アンソロピックの「Code execution with MCP」です。公開は2025年11月4日です。この記事は、クラウドフレアが同じ考えをコードモードと呼んでいる、と書いています。数字はこうです。
- 元の数:150,000トークン
- 新しい数:2,000トークン
- 減り方:98.7%
直前の文は、「エージェントが、そのときの課題に必要な定義だけを読み込む」という設計です。ファイルの一覧から、必要な道具のファイルだけを読みます。ですから、減ったのは、道具の定義を文脈に入れる分です。途中の結果の分ではありません。記事の紹介文は「up to 98.7%」(最大で98.7%)と書いています。この記事は、測定の条件(モデル、道具の数、課題の件数)を書いていません。
もう1つが、アンソロピックの「Advanced tool use」です。公開は2025年11月24日です。プログラムで道具を呼ぶ機能の数字として、「Average usage dropped from 43,588 to 27,297 tokens, a 37% reduction on complex research tasks」と書いています。複雑な調査の課題で、平均の使用量が43,588トークンから27,297トークンに減り、37%の削減だった、という意味です。理由は、途中の結果をモデルの文脈に入れないから、と説明されています。
往復の数についても、説明があります。20回以上の道具の呼び出しを、1つのコードの中で行うと、19回以上の推論がなくなる、という説明です。これは、測定値ではなく、数え方の説明です。
| 数字 | 出所 | 何を測ったか | 条件の記載 |
|---|---|---|---|
| 150,000→2,000(98.7%) | アンソロピック 2025年11月4日 | 必要な道具の定義だけを読み込む設計の例 | モデル、道具の数、課題の件数の記載なし |
| 43,588→27,297(37%) | アンソロピック 2025年11月24日 | プログラムで道具を呼ぶ機能。複雑な調査の課題の平均 | 課題の内容と件数は限定的 |
| +3.5ポイント、15%減 | 記事内のファクトリーの自己申告 | 評価での正答率とモデルの費用 | 元の報告は未取得 |
この表の数字は、並べて順位や平均を作れません。測る対象も、設定も違うからです。
共有された要約には、「往復が10回から1回になる」「文脈が90%減る」という数字もありました。この2つは、4つの記事の本文に、文脈の削減としては見つかりませんでした。近い公表値は、98.7%と37%で、測る対象が別です。
第3章:コードを実行させるなら、隔離・権限・監視は自分の責任
コードを実行させると、隔離と権限が問題になります。各社の書き方を見ます。
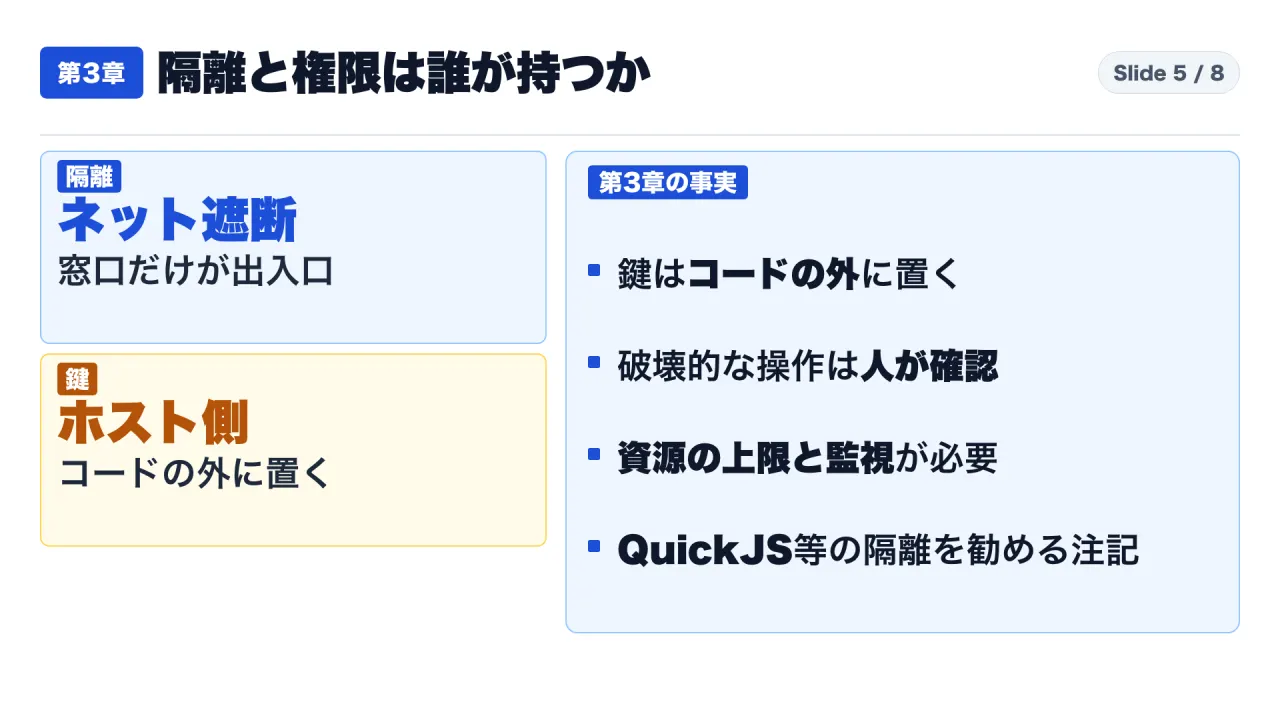
クラウドフレアの設計は、こうです。エージェントに見せる道具は、TypeScriptを実行する1つだけです。コードは、安全なサンドボックスの中で動き、そのサンドボックスは、インターネットから完全に隔離されています。外の世界への出入り口は、つないだサーバーを表すTypeScriptの窓口(バインディング)だけです。認証の鍵も、窓口が隠します。「モデルが書いたコードが鍵を漏らすことはありえない」と、記事は述べています。
シュミット氏の記事も、似た考えです。道具の呼び出しは、すべて、ホスト側の実行環境への橋を渡ります。ホスト側は、認証用のトークン(OAuth)を、サンドボックスの外で差し込めます。入力の型を検証できます。破壊的な呼び出しの前に、利用者の確認を挟めます。記事のコード例には、「信頼できないコードには、QuickJS か isolated-vm を使う」という注記があります。例の本体は、擬似の例と明記されています。実装の手本というより、考え方を示す例です。
アンソロピックの記事は、はっきり書いています。「エージェントが書いたコードを動かすには、適切なサンドボックス、資源の上限、監視を備えた、安全な実行環境が必要だ」。さらに、「これらの基盤の要件は、運用の負担と安全上の考慮を増やす。道具を直接呼ぶ方法では、これらは要らない」とも書いています。そのうえで、コード実行の効果は、こうした実装の費用と、比べて考えるべきだと述べています。この運用の負担は、記事に、数字では示されていません。
ここは、私の整理です。3つの記事は、方向がそろっています。鍵をコードに渡さない。出入り口を絞る。危険な操作の前に、人が確認する。そして、測られた節約の数字に、この運用の負担を含めた、とは、どの記事も書いていません。節約の数字と、運用の負担は、別々に考える必要があります。
第4章①:導入の前に確かめる。道具の型、結果の行き先、効果が小さい場合
導入の前に確かめることを整理します。
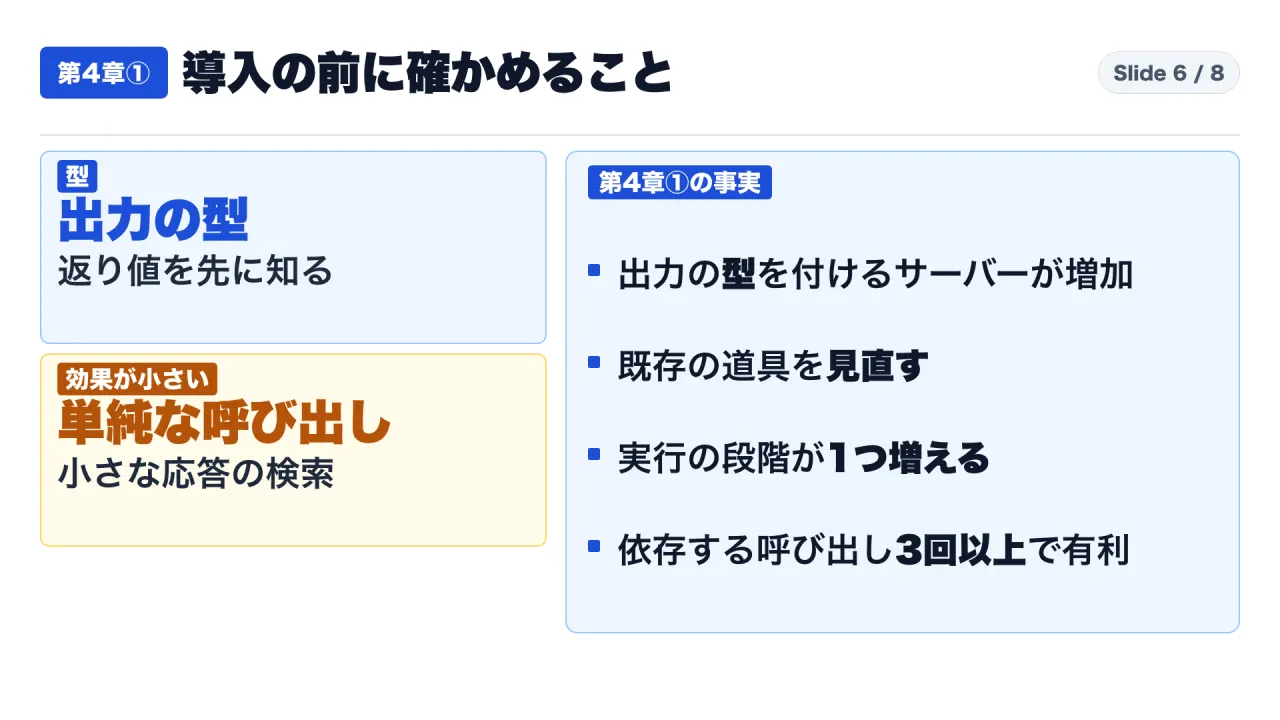
まず、道具の型です。シュミット氏の記事は、MCPのサーバーが、入力の型に加えて、出力の型も付けるようになってきた、と書いています。返り値の型を先に知れば、実行結果を見る前に、1つ目の道具と2つ目の道具を、つなげるからです。さらに、記事は、既存の道具の見直しも求めています。自分のエージェントが、本当に何を必要とするのか、一歩引いて点検する、という趣旨です。
次に、結果の行き先です。アンソロピックの「Advanced tool use」は、プログラムで道具を呼ぶ機能には、実行の段階が1つ増えると書いています。効果が大きいときに見合う、という説明です。
効果が大きい場合として、依存する道具の呼び出しが3回以上ある流れなどが挙げられています。効果が小さい場合として、単純な1回の呼び出し、応答が小さい簡単な検索、途中の結果をモデルがすべて見て考えるべき課題が挙げられています。つまり、途中結果を文脈に通す必要がある課題では、コード実行に任せても、効果は小さいことになります。
なお、同じ記事には、「道具の検索」という別の手法の測定値(正答率が49%から74%など)もあります。これはコード実行ではないため、この記事では使っていません。
第4章②:【私なりの解釈】測るのは自社の道具。許可の設計が先
ここからは、事実ではなく、私なりの解釈です。断定ではありません。
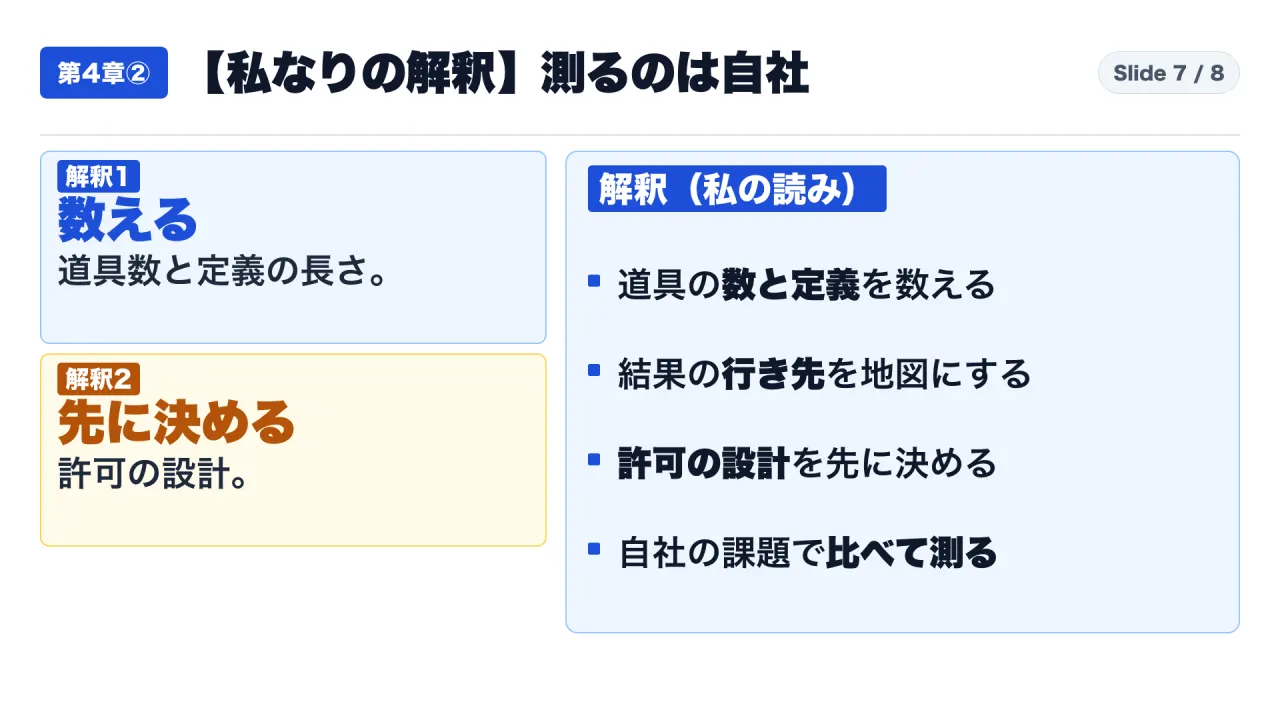
第1の解釈。道具の数と、定義の長さを数えます。数十の道具の定義が毎回の文脈を占めているなら、候補です。少ないなら、いまのままで足ります。
第2の解釈。結果の行き先を、地図にします。途中の結果が、毎回、文脈を通っているのか。モデルが、本当に見る必要があるのか。ここが、削れる分です。
第3の解釈。許可の設計を先に決めます。鍵は、コードに渡さず、ホスト側に置く。呼べる道具を絞る。破壊的な操作は、人の確認を挟む。実行の資源に上限を付け、動いたコードを記録します。
第4の解釈。自社の同じ課題で測ります。コードを使う場合と、使わない場合で、トークンの量、往復の回数、正答の率を比べます。他社の数字は、自社の保証になりません。
言えないことも並べます。自社の道具で、どれだけ減るのかは、公開された数字からは言えません。ファクトリーの数字が再現するのかは、元の報告を読めていないので言えません。どの隔離の方法が十分に安全なのかは、この記事では評価していません。
結論:導入の前に、数字の中身、自社の道具、許可の3つを確かめる
最後にまとめます。記事は意見です。測られた数字は、他社のものです。98.7%は、道具の定義の読み込みの例。37%は、複雑な調査の課題の平均。条件が別で、並べられません。コードを実行させるなら、隔離と権限と監視は、自分の責任です。
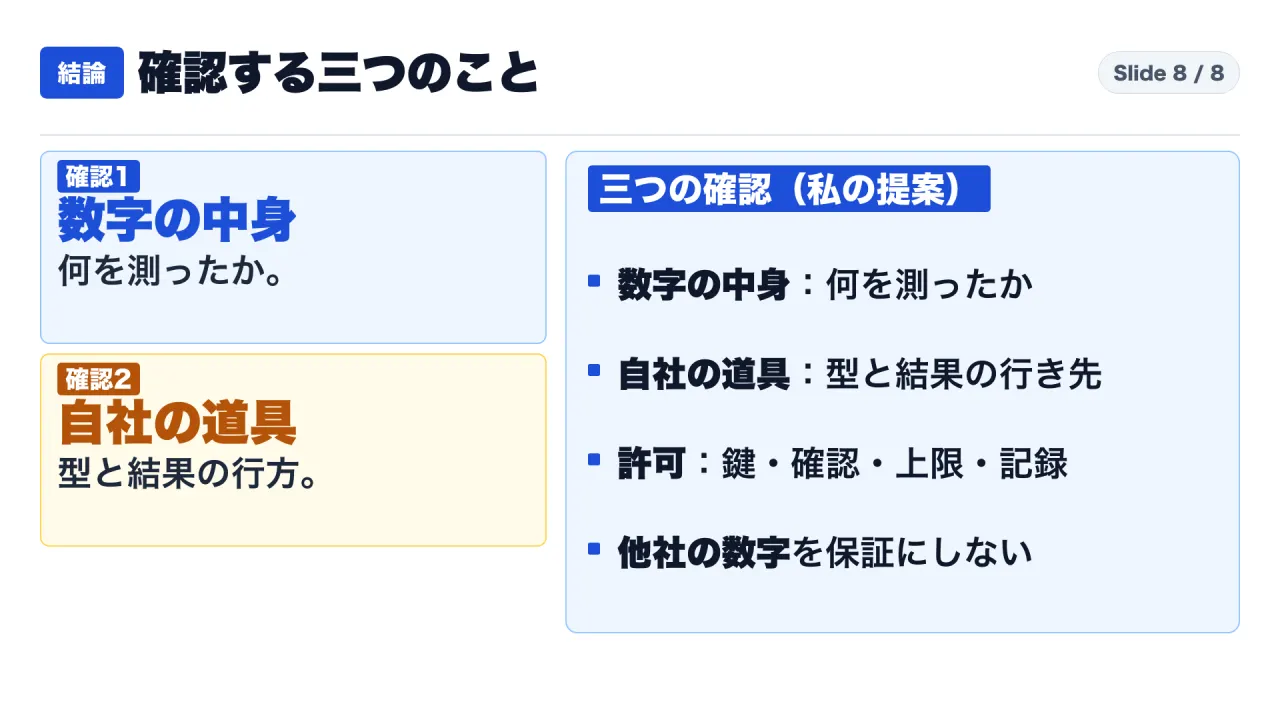
導入の前の確認は3つです。これは私の提案です。
- 数字の中身:何を測った数字か。定義の読み込みか、途中結果か。
- 自社の道具:型の定義があるか。結果は文脈を通る必要があるのか。
- 許可:鍵、呼べる道具、人の確認、資源の上限、記録を、だれが持つのか。
補足:混同しやすい4つの区別
この話題では、似た言葉が別のものを指します。読むときは、次の4つを分けると、数字の意味を取り違えにくくなります。
- 定義の削減と、途中結果の削減。 アンソロピックの98.7%は、必要な道具の定義だけを読み込む例です。37%は、途中の結果をモデルの文脈に入れないことによる削減の平均です。どちらも文脈のトークンが減る話ですが、減る場所が違います。
- コードモードと、道具の検索。 アンソロピックの「Advanced tool use」には、道具の検索(Tool Search Tool)という別の手法も載っています。道具の定義を必要なときだけ読み込む手法で、コード実行ではありません。この記事では、混ぜないために、道具の検索の数字は使いません。
- 意見と測定。 シュミット氏の記事の「まもなく1つの道具になる」は予測で、本人も「そうとは限らない」と留保しています。測定として読めるのは、他社の記事の数字だけです。
- 擬似の例と、実装。 記事のコードは擬似コードで、実装例も擬似の例と明記されています。そのまま動かす手本ではなく、考え方を示す例として読みます。
また、MCP(Model Context Protocol)は、アンソロピックの記事の説明では、AIエージェントを外部のシステムにつなぐための公開の標準です。コードモードは、MCPのサーバーが提供する道具を、型のあるコードから呼ぶ使い方として説明されています。
よくある疑問に、公開資料の範囲で答えます
Q1. 「エージェントの道具は、まもなく1つになる」は本当ですか。 記事自身が、「Not necessarily」(そうとは限らない)と留保しています。予測であり、測定された事実ではありません。
Q2. 98.7%の削減は、自分のエージェントでも起きますか。 原文は、道具の定義を必要なものだけ読み込む設計の例で、モデル、道具の数、課題の件数を書いていません。自社でどれだけ減るかは、公開された数字からは言えません。
Q3. 37%と98.7%は、どちらが大きな効果ですか。 比べられません。前者は複雑な調査の課題の平均で、後者は道具の定義の読み込みの例です。測る対象も設定も違います。
Q4. ファクトリーの「+3.5ポイント、費用15%減」は信頼できますか。 記事の中の自己申告です。元の報告を読めていないため、この記事では評価していません。
Q5. 道具が少ない場合も、コードモードにしたほうがよいですか。 アンソロピックは、プログラムで道具を呼ぶ機能が、単純な1回の呼び出しや、応答が小さい簡単な検索では、効果が小さいと書いています。自社の道具と課題で、測ってから決めるのが安全です。
Q6. サンドボックスは、何を使えばよいですか。 この記事は、特定の方法を推奨しません。記事のコード例には、信頼できないコードには別の隔離の手段を使う、という注記があります。例は擬似の例と明記されています。
補足:自社で測るときの手順の例(私の提案)
ここは事実ではなく、私の提案です。公開された数字が条件を示していないのなら、自社の記録では、条件を残すことが大切です。
- 課題を選びます。依存する道具の呼び出しが多い課題と、単純な1回の呼び出しで済む課題の両方を入れます。
- 指標を決めます。入力と出力のトークン、往復の回数、正答の率、失敗したときの復旧の手間を記録します。
- 運用の負担も記録します。実行環境の構築と保守、監視の手間、鍵と権限の設定にかかった時間を、節約の数字と別の欄に書きます。
- 条件を残します。モデル、道具の数、課題の件数、測った日付を、結果と一緒に保存します。アンソロピックの記事に書かれていなかった項目です。
- 許可の設計を、測定の前に決めます。鍵を置く場所、呼べる道具、人の確認が要る操作、資源の上限を、先に決めておくと、測定のために権限を広げてしまうことを避けられます。
自社の判断に使うときの注意(私の提案)
この記事は、公開されている5つのページを読んだものです。ファクトリー自身の報告と、各社が「コードモードを既定にした」という記事の文の元の資料は、読めていません。自社の設計や契約、セキュリティの判断に使うときは、最新の原文と、利用するサービスの技術文書を、直接確認してください。この記事は、売買の判断や投資の助言を含みません。
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:フィリップ・シュミット氏の記事「Why Agents Are Soon Only Going to Have 1 Tool」(2026年11月1日):https://www.philschmid.de/code-mode
- S2:フィリップ・シュミット氏の経歴ページ:https://www.philschmid.de/philipp-schmid
- S3:クラウドフレアの記事「Code Mode」(2025年9月26日):https://blog.cloudflare.com/code-mode/
- S4:アンソロピックの記事「Code execution with MCP」(2025年11月4日):https://www.anthropic.com/engineering/code-execution-with-mcp
- S5:アンソロピックの記事「Advanced tool use」(2025年11月24日):https://www.anthropic.com/engineering/advanced-tool-use
#CodeMode #AIエージェント #MCP #サンドボックス #生成AI