同じ32GBでも、仕様表が決めることと、決めないことは何か(Intel Arc Pro B70)
YouTubeポッドキャスト本編(動画・音声)はこちら:同じ32GBでも、仕様表が決めることと、決めないことは何か(Intel Arc Pro B70)
結論:仕様表が決めるのは、載る量と帯域の上限まで。速さは測定の条件で、使えるかは利用許諾でも決まる
結論から書きます。Intelの公式仕様表(Arc Pro B60・B65・B70)が決めているのは、メモリの量、メモリの読み出しの帯域、計算ユニットの数、消費電力、パソコンとの接続といった「上限と構成」です。毎秒何トークン出るか、という速さは、確認した三つの仕様表の本文にありません(S1・S2・S3)。
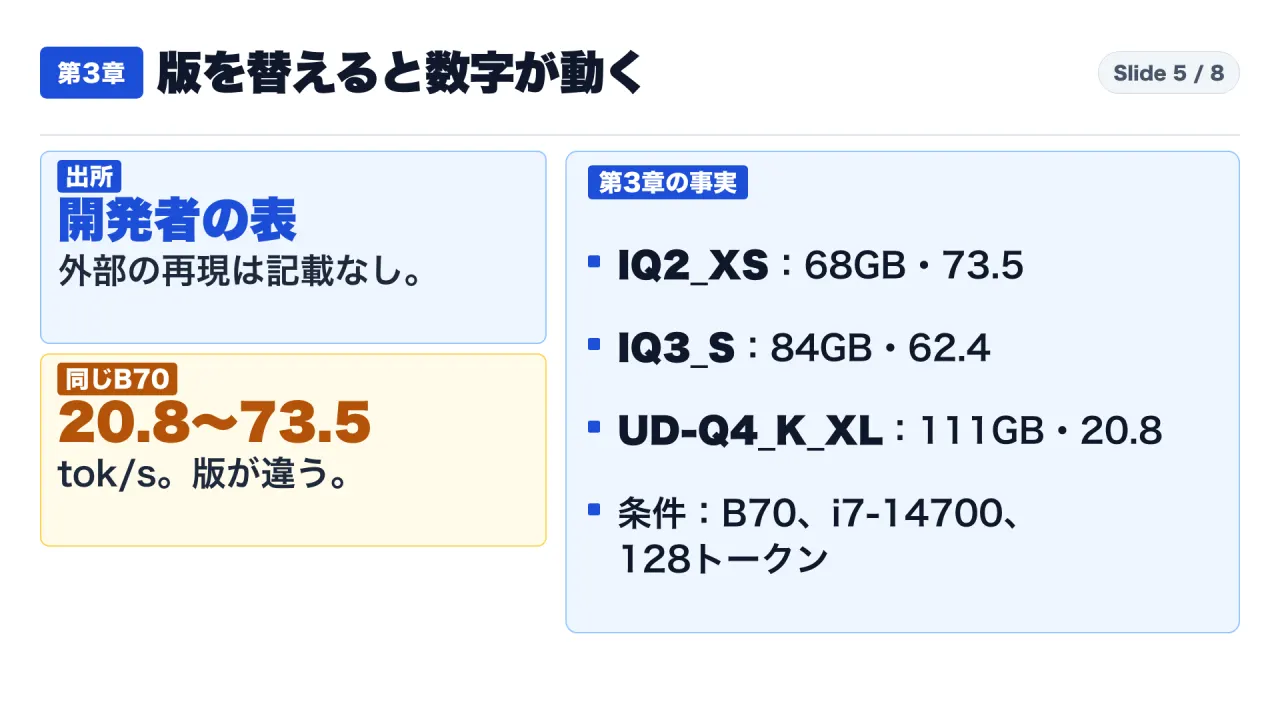
速さの数字は、動かすソフトの層と、測った条件で決まります。個人の開発者が公開する派生版のソフト「XeStrata」のリポジトリには、同じArc Pro B70、同じ機械、同じ128トークンのデコードで、モデルの圧縮の版を替えると、毎秒20.8トークンから73.5トークンまで動く表があります(S7)。外部の人が再現した、という記述は、READMEにも当該の資料にも見つかりませんでした(S6・S7)。
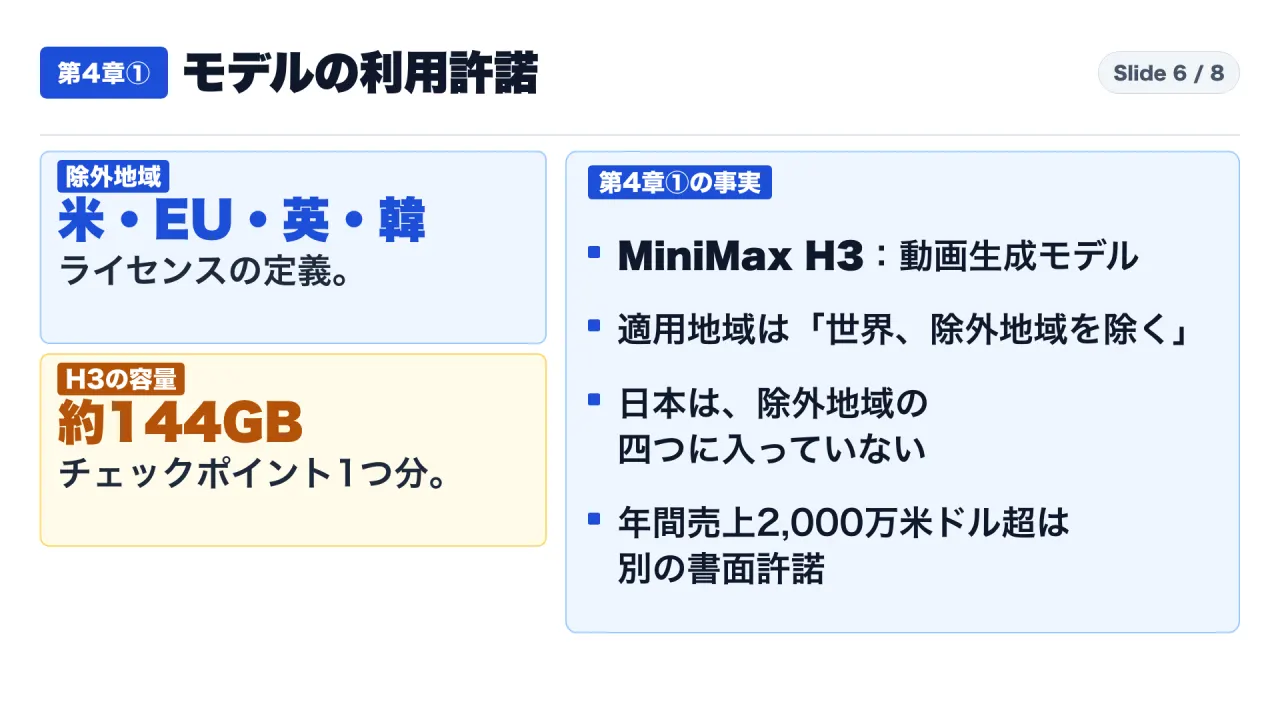
さらに、モデルを使ってよいかは、カードやソフトとは別の層で決まります。動画生成モデルMiniMax H3のライセンスは、米国、EU、英国、韓国を除外地域とし、商用の製品とサービスの年間売上が2,000万米ドルを超える場合は、別の書面の許諾を求めています(S15)。日本は、除外地域の四つに入っていません。
この記事の対象読者は、ローカルで動かすAI機材やモデルを検討する、事業会社の企画、情報システム、調達の担当者です。「32GB」「608GB/s」のような数字を見たときに、その数字が何を決めていて、何を決めていないのかを、確かめたい方に向けて書きました。
読み終えると、次の三つができるようになります。一つ目は、仕様表のどの欄が上限で、どの欄が構成なのかを区別すること。二つ目は、速さの数字を見たときに、誰が、どのモデルと圧縮で、どのソフトで測ったかを探すこと。三つ目は、モデルの利用許諾の地域と売上の条件を、導入の前に原文で読むことです。
この記事は、公表された資料を読んだ整理で、投資の助言ではありません。
読み方:本文では「事実」「私の解釈」「書かれていないこと」を分けて書きます
本文は、次の三つを区別して書きます。
- 事実:公開された資料に書かれていること。出所は、文のあとと、記事末尾の出典一覧に示します。
- 私の解釈:事実から私が読んだこと。「私の読み」「私の整理」「私の計算」と明示します。
- 書かれていないこと:確認した範囲で、資料の本文にないこと。取得した本文を読み、語を検索した範囲に限ります。
出所は、三つの種類に分かれます。一つ目は、Intelの公式ページです。仕様表(S1・S2・S3)、データシート(S4)、製品の概要ページ(S5)、公式のGitHub(S10・S11・S12)を使いました。二つ目は、個人の開発者のリポジトリです。XeStrataのREADMEと資料(S6・S7・S8)とGitHubのページ(S9)で、Intelの公式資料ではありません。三つ目は、CanonicalのUbuntuのリリースノート(S13)と、Hugging FaceのMiniMax H3のモデルカード(S14)、ライセンス全文(S15)、ファイル一覧のAPI(S16)です。
取得は2026年11月3日に行いました。Intelの仕様表は、欄名と値が別の行に表示されるため、検証の記録では、欄名と値を組にした行を手で作り、来歴を残しました。
以前の、ZGX Furyの回では、仕様表が言えるのは量と帯域まで、と話しました。今回は、その外側にある「ソフトの層」と「利用許諾の層」を見ます。
背景:この記事で使う言葉を先にそろえます
- トークン:モデルが数える文字の単位です。「毎秒何トークン」は、答えを作る速さを表す数字です。
- デコード:答えを一語ずつ作る段階です。この記事の速さの数字は、デコードの速さです。
- 量子化(圧縮):モデルの数値の精度を下げて、ファイルの大きさを小さくする方法です。同じモデルでも、圧縮の度合いや作り手が違うと、別のファイル(版)になります。
- メモリの帯域:メモリから1秒に読み出せる量です。仕様表では、GB/sで表されます。
- ピークの演算性能:仕様表の「GPU Peak TOPS (Int8)」の欄です。TOPSは1秒あたりの演算回数を兆で数えた単位で、欄名のとおり、ピークの値です。
- アーカイブ:GitHubで、リポジトリを読み取り専用にする設定です。開発は止まります。
- ライセンスの除外地域:ライセンスが、使用や出力の利用を許諾しない地域のことです。
第1章:インテルの表で並べると、同じ32GBでも、計算ユニットと消費電力は別。表に、毎秒のトークン数はない
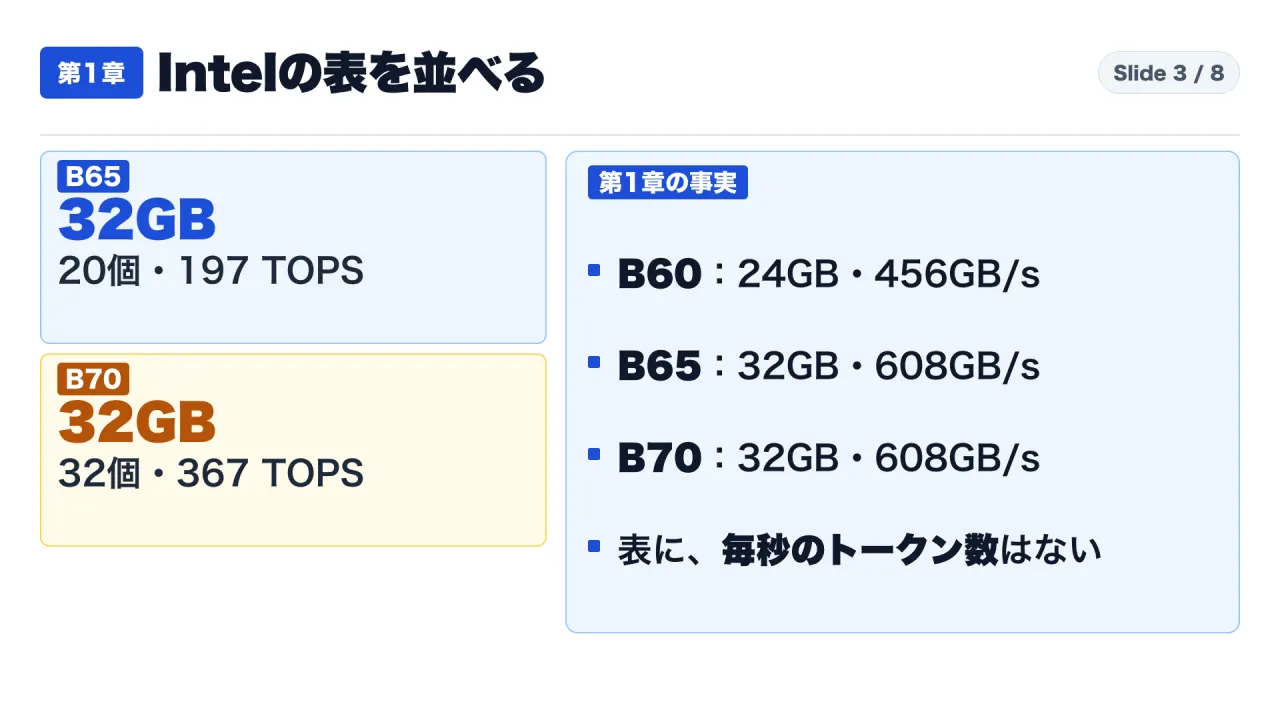
Intelの公式の仕様表から、三つのカードの数字を並べます(S1・S2・S3)。すべて、Intelの表に書かれた値です。
| 項目 | Arc Pro B60 | Arc Pro B65 | Arc Pro B70 |
|---|---|---|---|
| 発売 | 2025年第2四半期 | 2026年第1四半期 | 2026年第1四半期 |
| メモリ | 24GB GDDR6 | 32GB GDDR6 | 32GB GDDR6 |
| 帯域 | 456GB/s | 608GB/s | 608GB/s |
| 計算ユニット(Xe-cores) | 20個 | 20個 | 32個 |
| XMXエンジン | 160 | 160 | 256 |
| ピークの演算性能(Int8) | 197 TOPS | 197 TOPS | 367 TOPS |
| 消費電力(TBPの欄) | 200W | 200W | 230W |
| 接続 | PCIe 5.0 x8 | PCIe 5.0 x16 | PCIe 5.0 x16 |
B70の消費電力は、データシートでは「160Wから290W。Intel製のカードは230W」と書かれています(S4)。パートナー各社のカードでは、この範囲で変わる、という意味に読めます。
表の欄を、何を決めているかで分けると、次のとおりです。これは私の整理で、Intelの表の区分ではありません。
- 載る量を決める欄:メモリの量(24GBか32GB)。モデルのファイルや、会話の途中の記憶が置ける量の上限です。
- 読み出しの速さの上限を決める欄:メモリの帯域(456GB/sか608GB/s)。答えを一語ずつ作るときは、メモリから何度も読み出すため、この数字が上限の目安になります。ただし、上限であって、実際の速さではありません。
- 計算の上限を決める欄:計算ユニットの数、XMXエンジンの数、ピークの演算性能。表の欄名は「Peak」で、ピークの値です。
- 運用の条件を決める欄:消費電力と、パソコンとの接続(PCIeの世代とレーン数)。置ける機械の条件に関わります。
どの欄にも、「何トークン/秒」は含まれません。仕様表は、機械の大きさと構成を示すもので、特定のモデルを特定のソフトで動かしたときの速さを示すものではない、というのが私の読みです。
ここは、私の整理です。B65とB70は、メモリの量(32GB)と帯域(608GB/s)が同じです。それでも、計算ユニットの数(20個と32個)、ピークの演算性能(197と367)、消費電力の欄(200Wと230W)は違います。反対に、B60とB65は、計算ユニットの数とピークの演算性能が同じで、メモリの量と帯域が違います。「32GB」という数字だけでは、カードの中身は決まりません。
書かれていないことも、確認します。私が読んだ三つの仕様表の本文に、毎秒のトークン数はありません。Intelの製品概要ページ(S5)も、比較は倍率で示されています。「最大6.3倍の応答の速さ」とあり、脚注には、相手がNVIDIAのカードで、Ubuntu 25.04とvLLMのコンテナの版を使った、と書かれています。毎秒のトークン数は、そのページに書かれていません。
Intelの概要ページには、複数のGPUを組み合わせて、100GB以上のVRAMが必要な大きなモデルを動かす、という紹介文もあります(S5)。B70のデータシートにも、複数GPUでのLinux対応が特長として書かれています(S4)。これらは製品の紹介文で、モデル名、圧縮、ソフトの版を指定した測定ではありません。複数のカードを足したときの速さは、表の外の話です。
つまり、仕様表が決めているのは、載る量と、読み出しの帯域の上限です。計算の上限(ピークの演算性能)も表にはありますが、「ピーク」の値であり、実際の速さではありません。
第2章:動かすソフトは別の層。IPEX系は終了し、XeStrataは個人の派生版
カードの表の外側に、動かすソフトの層があります。ここは、短い期間で動いています。
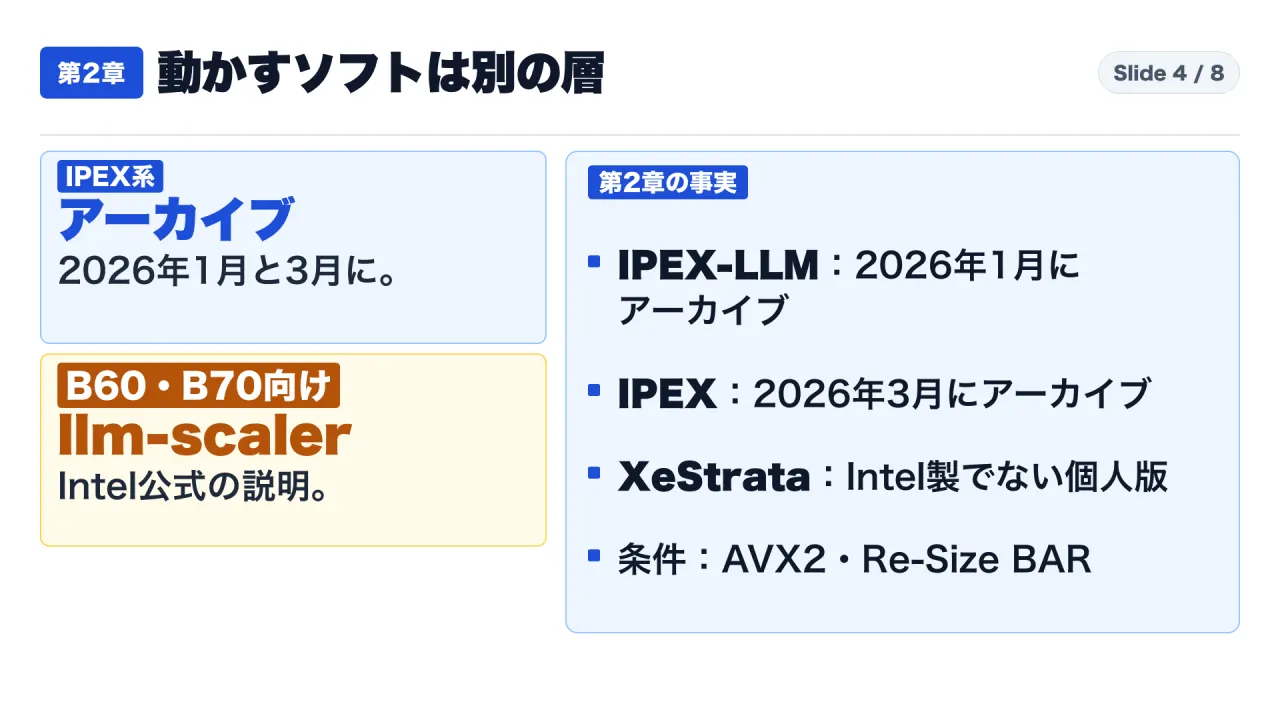
Intelには、PyTorch向けの拡張ソフト「Intel Extension for PyTorch(IPEX)」と、大規模言語モデル向けのライブラリ「IPEX-LLM」がありました。どちらも、GitHubで「アーカイブ済み」と表示されています。IPEX-LLMは2026年1月、IPEX本体は2026年3月です(S11・S12)。
IPEXのページは、理由を書いています。機能の多くをPyTorch本体に取り込んだので、IPEXの開発を止めた。今後はPyTorchを直接使うことを強く勧める、という内容です(S12)。IPEXの後継が何か、というIntelの記述は、私は見つけていません。
一方、Intelの公式のGitHubには、Arc Pro B60とB70上で動く生成AIの仕組みとして説明されている「llm-scaler」があります(S10)。更新履歴には、2026年6月から9月まで、新しい版の公開が並んでいます。8月の項目には、MiniMax H3のローカルでの動画生成への対応も載っています。ここは私の読みですが、同じカードでも、動かすソフトの層は、短い期間で動いています。
もう一つ、XeStrataを見ます。GitHubのページには、「Strata」という別のソフトから分かれた派生版と表示されています(S9)。READMEは、NVIDIA向けのStrataを、Intelのカードへ移したもの、と説明しています(S6)。リポジトリの持ち主は、個人のアカウントです(S9)。私の読みでは、Intelの製品ではなく、個人の派生版です。
README(S6)に書かれた必要条件の一部を挙げます。
- CPU:x86-64でAVX2に対応していること。
- BIOS:独立したGPUでは、Above 4G DecodingとRe-Size BARをオンにすること。
- OS:パッケージが用意されているのは、Ubuntu 26.04とFedora 44です。
- GPU:VRAMは12GB以上が推奨です(それ未満でも動くが遅い、と書かれています)。
Ubuntu 26.04 LTSは、2026年4月23日に公開され、2031年4月までサポートされます(S13)。
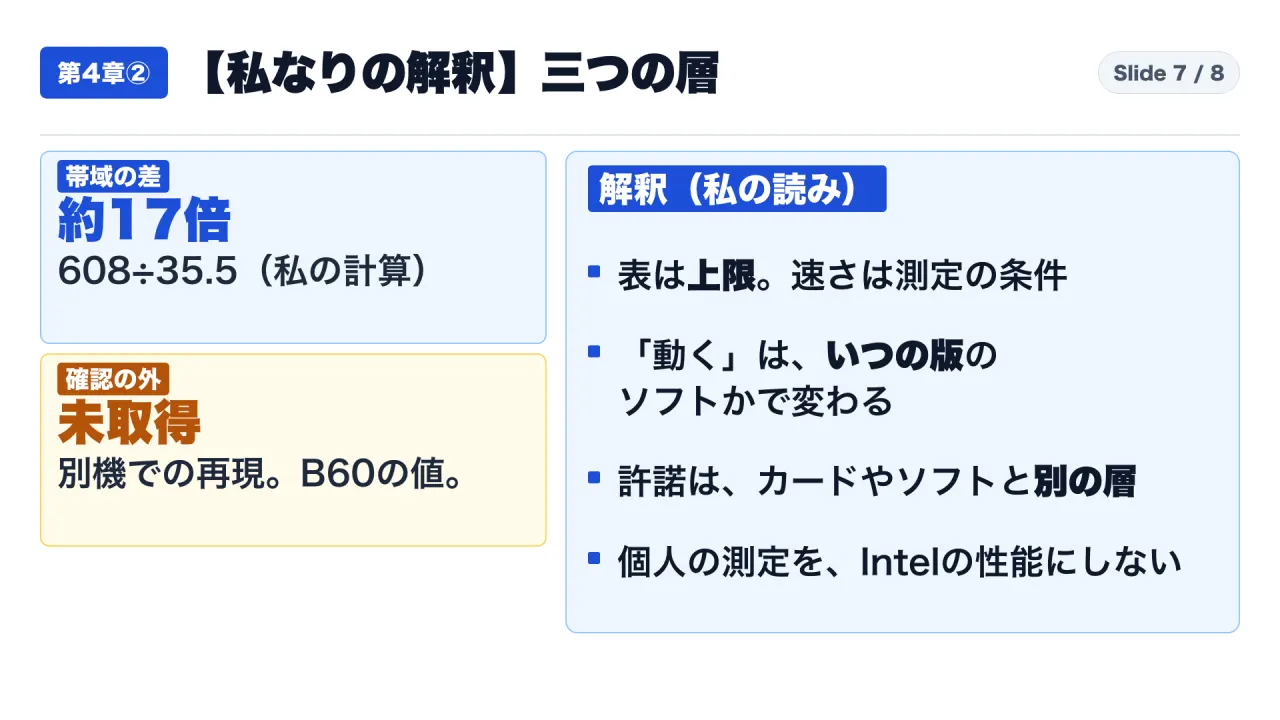
開発と確認に使った機械は、Arc Pro B70(32GB)です。CPUはi7-14700で、AVX2のみ、AVX-512はありません。メインメモリの読み出しは約35.5GB/sと、開発者が書いています(S8)。カードの帯域608GB/sと比べると、約17分の1です(私の計算、608÷35.5=17.1)。
第3章:同じB70でも、版を替えると毎秒20.8〜73.5トークン。開発者のリポジトリの記録
XeStrataの開発者は、リポジトリの資料に、測定の表を載せています(S7)。条件は、表の見出しに書かれています。Arc Pro B70(32GB)とRTX 4070(12GB、PCIe x4)、Core i7-14700、128トークンのデコードです。測った人の名前は表に書かれていないため、私は、開発者側の記録として読みます。
XeStrataが主に動かすのは、Qwen3.8-Flash-Nextという大きなモデルを、圧縮した版です(S6)。READMEの版の表(S6)から、三つを挙げます。
| 版 | READMEでの区分 | ダウンロード | 備考 |
|---|---|---|---|
| IQ2_XS | the original, Swift 1.5 | 68GB | RAMの目安は約48GB |
| IQ3_S | the original, Swift 1.5 | 84GB | RAMの目安は約62GB |
| UD-Q4_K_XL | Unsloth (experimental) | 111GB | RAMの目安は約48GB |
どれも、カードのメモリ(32GB)より大きいファイルです。また、Unslothの版については、メモリに収まらない部品を、答えを作る間にSSDから読む、と書かれています(S6)。
同じ表のB70単体の数字は、次のとおりです(S7)。
| 版 | B70単体(毎秒) | B70+RTX 4070(毎秒) |
|---|---|---|
| IQ2_XS | 73.5トークン | 84.7トークン |
| IQ3_S | 62.4トークン | 68.7〜69.6トークン |
| UD-Q4_K_XL | 20.8トークン | 38.3〜39.0トークン |
同じカードと同じ機械で、版を替えると、数字は約3.5倍違います(私の計算、73.5÷20.8=3.53)。ファイルが大きい版ほど、数字は小さい、という並びです。ただし、これは三つの点の並びで、理由は、この表からは言えません。READMEの版は、圧縮の度合いだけでなく、作り手も違います。
別のメーカーのカードを足すと、数字はさらに変わります。IQ2_XSでは、73.5から84.7になっています。開発者の資料は、カードを足すと、CPUで計算する部品が減る、と書いています。また、メインメモリの読み出しが遅いパソコンでは、カードが、CPU側の部品を待つ場合がある、とも書いています(S7)。
XeStrataは、カードを2枚使うとき、層を分担する方法と、1枚目のキャッシュを補助する方法のうち、速いほうを自動で選ぶ、とREADMEに書かれています(S6)。つまり、同じ2枚のカードでも、ソフトの選択で、使われ方が変わります。
外部の人が再現した、という記述は、READMEにもMULTIGPUの資料にも、見つかりませんでした(検索した範囲)。B60での同じ測定の値も、ありません。
この表を読むときの注意を、三つ挙げます。これは私の読みです。
一つ目。XeStrataのREADMEは、「1枚のGPUと普通のパソコンで、1250億パラメータのAIモデルを動かす」と説明しています(S6)。つまり、カードのメモリだけでモデルが収まる前提ではありません。READMEのRAMの目安は、通常32〜62GBで、モデル用のディスクは約60〜110GBです(S6)。「32GB」というカードの数字に加えて、メインメモリとSSDの条件が、速さに関わる構成に入っている、ということです。
二つ目。表の見出しの条件は、128トークンのデコードです。長い入力を読み込む段階(プリフィル)や、別の長さの出力は、この表の数字では言えません。READMEの別の記述には、別の条件の測定もありますが、この記事では使っていません。
三つ目。ソフトは更新が続いています。リポジトリの最新のタグは、取得時点で「xe0.2.2-1」でした(S17)。測定表の近くには、どの版のソフトで測ったかの記載を、私は見つけていません(MULTIGPUの資料で、commitの語を検索した範囲)。数字は、更新されうる記録として読みます。
ここは、私の整理です。毎秒の数字は、測った人、モデルの版、圧縮、ソフト、機械の組み合わせで決まります。この表は、その一つの組み合わせの記録です。
第4章①:モデルの利用許諾は別の層。MiniMax H3は、米・EU・英・韓を除外地域とする
最後の層は、モデルの利用条件です。MiniMax H3は、ライセンスの定義で「動画を作るモデル(the video generation model)」と書かれています(S15)。モデルカードによれば、中心の部分は、33Bパラメータの変換器(H3-Omni-Transformer)です(S14)。
ファイルの大きさを、Hugging FaceのAPIの一覧から足しました(S16)。変換器の部分だけで約66.3GB、テキストエンコーダが約66.7GB、映像のVAEが約10.4GB、音声のVAEが約0.6GBで、チェックポイント一つ分の合計は約144GBです。これは私が足した値です。ファイルの大きさは、動かすときに必要なメモリと同じではありません。ただ、32GBのカードより大きい数字です。
Intelのllm-scalerの更新履歴には、2026年8月に、MiniMax H3のローカルでの動画生成への対応が載っています(S10)。ソフトが対応していても、使ってよいかは別の話です。
ライセンスを読みます。名前は「MiniMax H3 Community License Agreement」で、ライセンスの日付は2026年8月2日と書かれています(S15)。
- 適用地域:「世界から除外地域を除いた範囲」と定義されています。
- 除外地域:欧州連合、英国、韓国、米国の四つです。日本は、この四つに入っていません。私の読みでは、日本は適用地域に入ります。
- 地域の外での使用:適用地域の外では、モデルも、その出力や結果も、使うことが、この契約では許諾されていません。
- 除外地域の人が使いたい場合:ミニマックス社に連絡して、別にライセンスを得ることを歓迎する、と書かれています。
- 売上の条件:商用の製品とサービスの年間売上が2,000万米ドル(または他の通貨での同額)を超える場合は、事前に、別の書面の許諾が必要です。
- 表示:商用の製品やサービスのユーザーインターフェースに「MiniMax H3」と表示すること。
- 他のモデルの改善への利用:モデルや出力を、他のAIモデルの改善に使うことは認められていません(H3自身とその派生物を除く)。
売上の条件は、原文では「あなたの商用の製品とサービス(your commercial products and services)」の年間売上です。会社全体の売上か、製品ごとの売上かは、私には判断できません。契約の専門家に確かめる範囲です。
導入を検討する担当者が、原文を読むときに確認する問いの例を挙げます。これは私の提案で、法律の助言ではありません。
- 使う場所はどこか。拠点や出張先、クラウドの所在地が、除外地域に入らないか。原文は、適用地域の外での使用と、出力や結果の使用を、許諾の外としています。
- 作った出力を、どこで使い、誰に渡すか。原文は、出力も、適用地域の外では許諾の外としています。
- 商用の製品やサービスの年間売上は、いくらか。2,000万米ドルを超える場合は、事前の書面の許諾です。
- 画面に「MiniMax H3」と表示できるか。
- 出力や結果を、他のAIモデルの改善に使う予定はないか。
ダウンロードできることと、使ってよいことは、別です。これは私の整理です。
第4章②:【私なりの解釈】表は上限。速さは条件、使えるかは許諾で決まる
ここからは、事実ではなく、私なりの解釈です。ここまでの数字は、すべて、公開された資料に書かれていることです。
- 第一の解釈:仕様表の数字は、上限です。毎秒の速さは、測定の条件で決まります。同じ32GBのカードでも中身が違い、同じカードでも版で数字が違います。
- 第二の解釈:「このカードで動く」という記述は、いつの版のソフトでの話かを、確かめる必要があります。Intelの公式のソフトも、数か月で、置き場が動いています。
- 第三の解釈:モデルの利用許諾は、カードやソフトとは別の層です。地域と売上の条件は、導入の前に、原文で読む項目です。
- 第四の解釈:個人の測定は、記録として読みます。Intelの性能としては、扱いません。
言えないことを並べます。
- 開発者の数字が、別の機械で再現できるのか。
- B60での、同じ測定の値。
- MiniMax H3を、B70で動かしたときの速さ。
結論:仕様表の外で確認する三つ
まとめます。
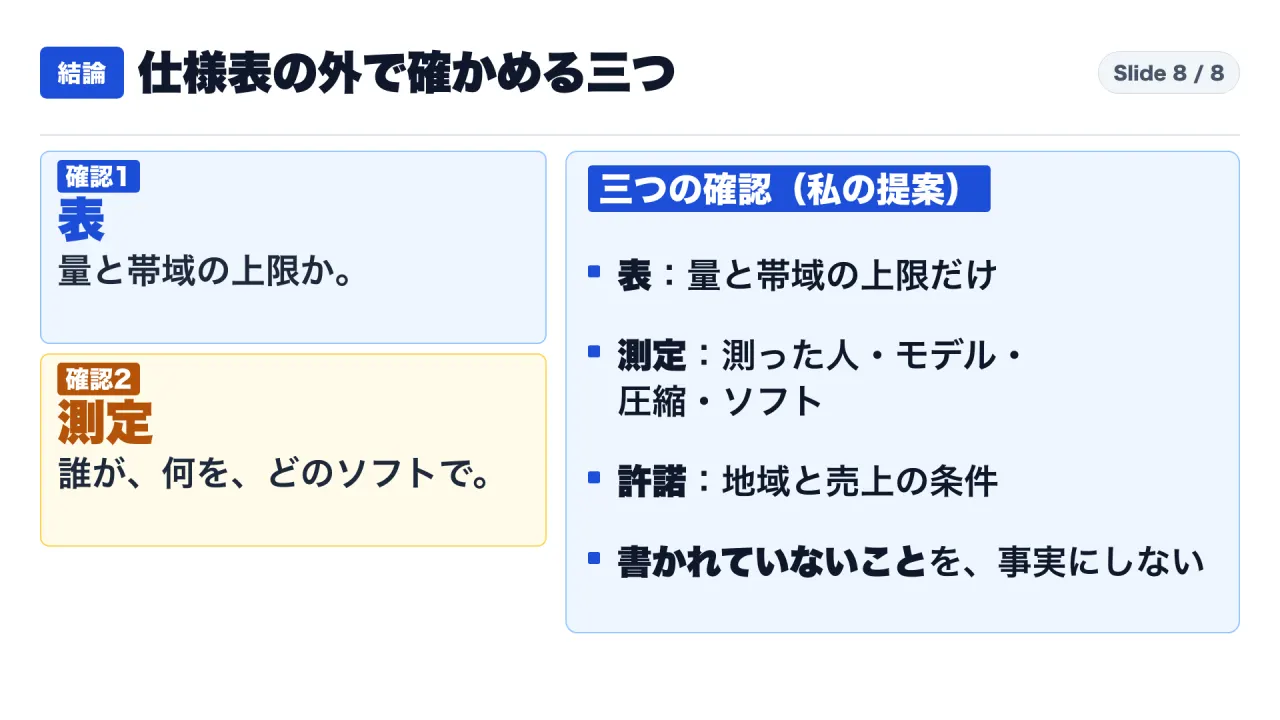
- 仕様表が決めるのは、載せられる量と、読み出しの帯域の上限までです。同じ名前のカードでも、表の中身は違います(S2・S3)。
- 速さは、誰が、どのモデルと圧縮で、どのソフトで測ったかで変わります。同じカードで、毎秒20.8トークンから73.5トークンの記録があります。表は、開発者のリポジトリにあります(S7)。
- 使えるかは、利用許諾でも決まります。MiniMax H3は四つの地域を除外し、売上の基準も定めています(S15)。
数字を見たときの確認は、三つです。これは私の提案です。
- 表には、何が書かれているか(量と帯域の上限か、構成か)。
- 測った人と条件は何か(モデルの版、圧縮、ソフト、機械)。
- モデルの利用許諾は、どうなっているか(地域、売上、表示、他のモデルの改善への利用)。
書かれていないことは、事実にせず、そのまま「書かれていない」と受け取ります。
三つの層を並べると、確認の順番が見えます(私の整理)
ここまでの三つの層を、持ち主と更新の速さで並べます。これは私の整理です。
一つ目の層は、カードの仕様表です。持ち主はIntelで、型番ごとに値が決まっています。B70とB65の発売は2026年第1四半期、B60は2025年第2四半期です(S1・S2・S3)。
二つ目の層は、動かすソフトです。持ち主はIntelの場合も、個人の開発者の場合もあります。llm-scalerの更新履歴は、2026年6月から9月まで、複数の版の公開が並んでいます(S10)。IPEX-LLMとIPEXは、2026年のうちにアーカイブされました(S11・S12)。XeStrataは、取得時点の最新タグが「xe0.2.2-1」の、個人の派生版です(S9・S17)。この層は、表より速く動きます。
三つ目の層は、モデルの利用許諾です。持ち主はモデルの公開元です。MiniMax H3のライセンスの日付は2026年8月2日で、適用地域、売上の基準、表示、出力の利用の範囲が書かれています(S15)。この層は、カードやソフトが変わっても、モデルが同じなら同じ条件がついてきます。
確認の順番は、読者の用途で変わります。ただ、どの層の情報も、別の層の問いには答えません。仕様表を読んでも速さは分からず、速さの表を読んでもライセンスは分かりません。ここまでが、この記事の整理です。
補足:ローカルAIの機材やモデルを調べるときの手順の例(私の提案)
公開された資料を読んだ整理から、自社で調べるときの手順の例を書きます。これは私の提案で、資料に書かれた手順ではありません。
- 仕様表を読むときは、欄名を「上限」と「構成」に分けます。メモリの量、帯域、ピークの演算性能は上限、計算ユニットの数、消費電力、接続は構成です。毎秒のトークン数の欄がないことを、最初に確認します。
- 速さの数字を見つけたら、測定の見出しを探します。カードの名前、CPU、デコードの長さ、モデルの版、圧縮の名前です。この記事の例では、見出しに書かれていた条件は、カード、CPU、128トークンのデコードでした。
- 測った人を確認します。開発者のリポジトリの記録か、メーカーの測定か、外部の人の再現か。外部の再現が書かれていなければ、「書かれていない」と記録します。
- 動かすソフトの版と、そのソフトの状態を確認します。アーカイブされていないか、更新が続いているか、個人の派生版か、公式のものか。
- モデルのライセンス原文を読みます。適用地域と除外地域、売上の条件、表示、出力の利用の範囲を、別の欄に書き出します。
よくある疑問に、公開資料の範囲で答えます
Q. B70は、B65より速いのですか。
A. この記事では、速い、遅いとは言えません。Intelの表で言えるのは、B70の計算ユニットが32個、B65が20個で、ピークの演算性能の欄が367と197、ということまでです。メモリの量と帯域は同じです。毎秒のトークン数は、表にありません。
Q. XeStrataで、毎秒70トークン以上が出るのですか。
A. 開発者のリポジトリの表で、IQ2_XSの版が、B70単体で毎秒73.5トークンです。同じ表で、UD-Q4_K_XLの版は毎秒20.8トークンです。条件は、B70、i7-14700、128トークンのデコードです。外部の再現は、書かれていません。
Q. 144GBのモデルは、32GBのカードでは動かないのですか。
A. この記事では、動く、動かない、とは言えません。144GBは、Hugging Face上のファイルの合計で、動かすときに必要なメモリとは同じではありません。動かし方(圧縮、分割、メインメモリやSSDの利用)は、ソフトによって違います。言えるのは、ファイルの合計が、カードのメモリより大きい、ということまでです。
Q. IntelのIPEXは、なくなったのですか。
A. IPEX-LLMは2026年1月、IPEX本体は2026年3月に、GitHubでアーカイブされました。読み取り専用です。Intelは、PyTorchを直接使うことを勧めています(S12)。
Q. MiniMax H3は、日本で使えますか。
A. ライセンスの除外地域は、欧州連合、英国、韓国、米国の四つで、日本は入っていません。ただし、売上の条件、表示、出力の利用の範囲など、他の条件があります。個別の判断は、原文と契約の専門家に確かめてください。
自社の判断に使うときの注意(私の提案)
この記事の数字は、2026年11月3日に確認した資料に基づきます。ソフトは、短い期間で更新されます。XeStrataは、個人の開発者の、開発中の派生版です。READMEには、BETAと記されたモデルがあります。数字は、更新されうる記録として扱ってください。
自社の用途(モデル、デコードの長さ、同時に処理する会話の数、利用する地域と売上)で測った数字と、ライセンス原文の確認が、判断の中心になります。
最後の確認リスト
- 仕様表の欄は、上限か、構成か。毎秒のトークン数の欄はあるか。
- 速さの数字の見出しに、カード、CPU、長さ、モデルの版、圧縮が書かれているか。
- 測った人は誰か。外部の再現はあるか。
- 動かすソフトは、アーカイブされていないか。公式か、個人の派生版か。
- モデルのライセンスの適用地域、売上の条件、表示、出力の利用の範囲を、原文で読んだか。
YouTube本編:{{YOUTUBE_URL}}
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
公開直前の再確認:2026年11月4日に、Intelの仕様表(B65・B70)、XeStrataのリポジトリと開発者の測定表、MiniMax H3のライセンス原文、IPEX-LLMとIPEXのアーカイブ状態を読み直し、本文との違いはありませんでした。
出典一覧
- S1:Intel Arc Pro B60 仕様表(Intel公式、2026年11月3日取得):https://www.intel.com/content/www/us/en/products/sku/243916/intel-arc-pro-b60-graphics/specifications.html
- S2:Intel Arc Pro B65 仕様表(Intel公式):https://www.intel.com/content/www/us/en/products/sku/245796/intel-arc-pro-b65-graphics/specifications.html
- S3:Intel Arc Pro B70 仕様表(Intel公式):https://www.intel.com/content/www/us/en/products/sku/245797/intel-arc-pro-b70-graphics/specifications.html
- S4:Intel Arc Pro B70 データシート(Intel公式、2026年3月版):https://www.intel.com/content/dam/www/central-libraries/us/en/documents/2026-03/datasheet-b70-gpu.pdf
- S5:Intel Arc Pro B シリーズ概要(Intel公式):https://www.intel.com/content/www/us/en/products/docs/discrete-gpus/arc/workstations/b-series/overview.html
- S6:XeStrata README(開発者のリポジトリ):https://raw.githubusercontent.com/MistVVK/XeStrata/main/README.md
- S7:XeStrata 複数GPUの資料(開発者の測定表):https://raw.githubusercontent.com/MistVVK/XeStrata/main/docs/MULTIGPU.md
- S8:XeStrata 詳細資料(開発者):https://raw.githubusercontent.com/MistVVK/XeStrata/main/docs/DETAILS.md
- S9:XeStrata リポジトリのページ(GitHub):https://github.com/MistVVK/XeStrata
- S10:Intel llm-scaler(GitHub、Intel公式):https://github.com/intel/llm-scaler
- S11:Intel IPEX-LLM(GitHub、アーカイブ済み):https://github.com/intel/ipex-llm
- S12:Intel Extension for PyTorch(GitHub、アーカイブ済み):https://github.com/intel/intel-extension-for-pytorch
- S13:Ubuntu 26.04 LTS リリースノート(Canonical公式):https://documentation.ubuntu.com/release-notes/26.04/
- S14:MiniMax H3 モデルカード(Hugging Face):https://huggingface.co/MiniMaxAI/MiniMax-H3
- S15:MiniMax H3 ライセンス全文(Hugging Face):https://huggingface.co/MiniMaxAI/MiniMax-H3/raw/main/LICENSE
- S16:MiniMax H3 ファイル容量(Hugging Face API、自前集計):https://huggingface.co/api/models/MiniMaxAI/MiniMax-H3?blobs=true
- S17:XeStrata リリース一覧(GitHub):https://github.com/MistVVK/XeStrata/releases