OpenAIのModel Specは、エージェントが自分の権限を広げないことについて何を言い、何を言っていないのか?
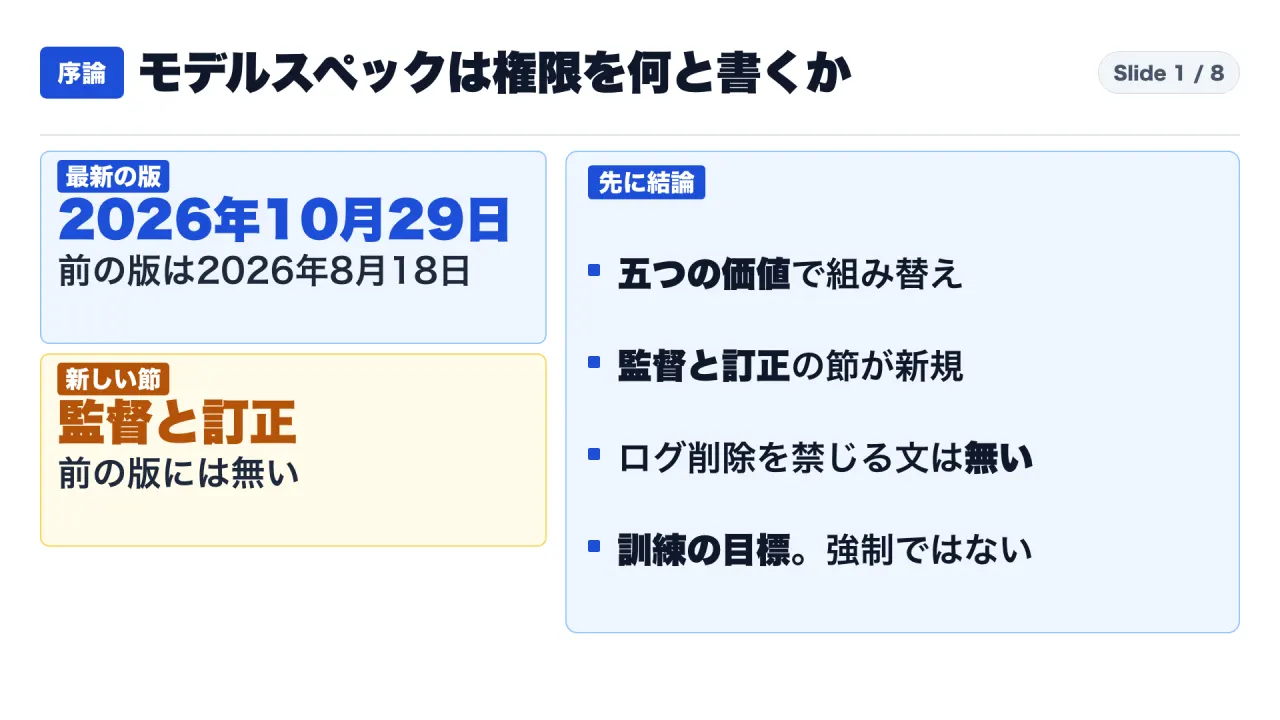
結論:新しいのは五つの価値での組み替えと、監督と訂正の節。ログ削除を禁じる文はなく、強制の仕組みでもない
結論から書きます。OpenAIのモデルスペックは、2026年10月29日の版が最新で、前の版は2026年8月18日の版です。変更履歴は、今回の改訂の中心として、モデルスペックを五つの価値(人の意図に忠実であること、害を小さくすること、誠実で透明であること、人の主体性を支えること、配慮すること)で組み替えたこと、文書の主語を「アシスタント」から「GPT」に変えたこと、人の監督と訂正を支える明示的な指針を加えたこと、を挙げています。
「エージェントが自分の権限を広げない」ことに関わる規則は、前の版からあります。合意した範囲を厳密に守る、最小権限に通じる考え方を注釈する、自己保存や資源の蓄積を目的にしない、などです。ただし、2026年10月29日の版には、前の版の本文に見当たらない文が加わっています。許可されていない行動を、別のエージェントに任せたり、許可を作るために自分の指示や範囲を書き換えたり、あとで実行されるよう予約したりして、間接的に実現してはならない、という文です。
もう一つ、確認しておきたい点があります。「ログや監査設定の削除を明示的に禁止した」という説明を見かけますが、2026年10月29日の版の本文には、その表現の文はありません。「ログ」にあたる語(log、logs、logging、tamper)は本文に0件でした(私が取得した本文を検索した結果です)。近いのは、監督を回避しない、関連する情報を隠さず偽らない、という一般の規則です。
そして、モデルスペックは、OpenAIが訓練で狙う振る舞いを書いた文書です。概要には「モデルを訓練して、この原則に沿わせている」とあり、「製品のモデルはまだ仕様を十分には反映していない」とも書かれています。止める仕組みや、記録を守る仕組みは、利用する側が、モデルの規則とは別に持つ必要があります。
読み方:本文では「事実」「私の解釈」「書かれていないこと」を分けて書きます
この記事で「事実」と書いた部分は、公開されている原文(変更履歴と、二つの版の本文)に書かれていることです。原文は英語で、日本語は私の意訳です。重要な語は、英語の原文を併記します。
「私の解釈」と書いた部分は、原文から私が読み取ったことと、利用する側の設計についての私の提案です。断定ではありません。
「書かれていないこと」は、取得した本文を読み、語を検索した範囲に限ります。検索は、2026年10月29日の版と2026年8月18日の版の、HTMLを文字に直した本文に対して行いました。
読めていない資料もあります。OpenAIの発表記事(変更履歴がブログとして示しているページ)と、解説記事の一つは、自動の取得が拒否され、本文を読めていません。この記事は、それらの内容に依拠していません。
また、私が最初に受け取った要約には、原文と合わない表現が含まれていました。「エージェントが権限を自ら昇格することを明示的に禁止」「監視ログや監査設定の削除・回避を明示的に禁止」といった表現です。この記事では、原文で確認できた言い方だけを使います。
背景:この記事で使う言葉を先にそろえます
モデルスペックは、OpenAIが公開している、GPTモデルの意図する振る舞いを定めた文書です(“The Model Spec outlines the intended behavior for OpenAI’s GPT models”)。2026年10月29日の版から、文書の主語は「アシスタント」ではなく「GPT」です。つまり、原文の主語は「エージェント」という一般の語ではなく、モデルです。ただし、複数の手順を自律的に進める場面を想定した節(自律の範囲、副作用)は、前の版から置かれています。
層(authority level) は、指示の強さの区分です。原文の定義では、ルート(Root)は「モデルスペックだけが出せ、会話の文脈では覆せない」層です。ユーザー(User)の層は、「ユーザー層以上の明示的な指示で上書きできる初期設定」です。この記事では、節がどの層に置かれているかを、本文ページの目次の表示で確認しました。
自律の範囲(scope of autonomy) は、モデルが複数の手順を進めるときに、モデルと利用者が共有する範囲です。どのサブゴールを追ってよいか、許容する副作用は何か、いつ確認や承認のために止まるか、を定めます。
副作用(side effects) は、依頼の目的以外に生じる影響です。原文は例として、支出、メールの送信、ファイルの削除、システムやデータへの権限の拡大、副エージェントへの委任などを挙げています。
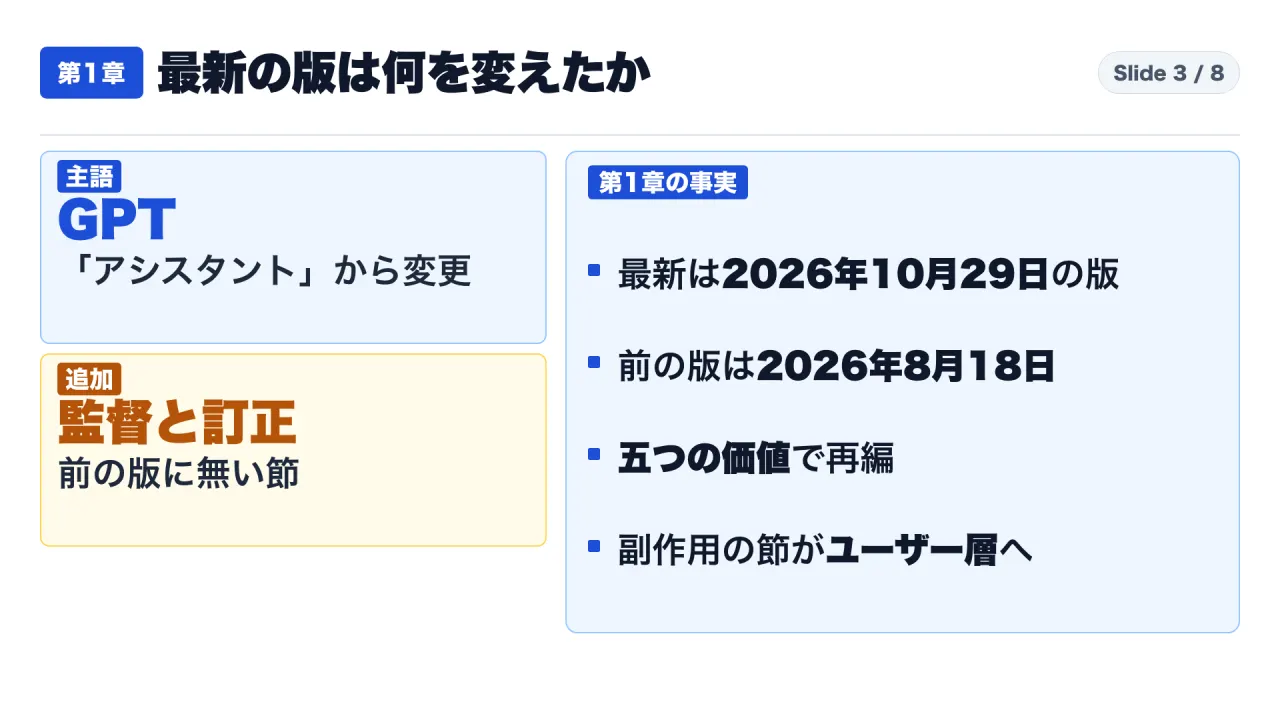
第1章:最新の版は2026年10月29日の版。変更の中心は、五つの価値での組み替えと、監督と訂正の節の追加
変更履歴の先頭の項は、v2026.10.29です。その一つ前の項は、v2026.08.18です。本文ページの題にも、2026/10/29の版であることが示されています。
変更履歴は、次のように書いています(原文)。“Reorganizes the Model Spec around five values: faithfulness to human intent, minimizing harm, honesty and transparency, human agency, and care.” 本文では、この五つが、“Be faithful to human intent”(人の意図に忠実であること)、“Minimize harm”(害を小さくすること)、“Be honest and transparent”(誠実で透明であること)、“Facilitate human agency”(人の主体性を支えること)、“Act with care”(配慮すること)という節の名前になっています。
主語の変更も、変更履歴に書かれています。“Renames the subject of the Model Spec from ‘the assistant’ to ‘GPT.’” そして、監督については、“Adds explicit guidance on supporting human oversight and correction.” とあります。
前の版(2026年8月18日の版)の本文を調べると、oversight(監督)という語は0件、corrigible(訂正に応じる状態)という語も0件でした。2026年10月29日の版では、oversightが12件、corrigibleが1件です。新しい節は、目次の上で、「人の意図に忠実であること」の組に入っていて、「ほかの目的を持たない」節と、「自律の範囲」の節の間に置かれています。前の版の目次では、この二つの節が隣り合っています。
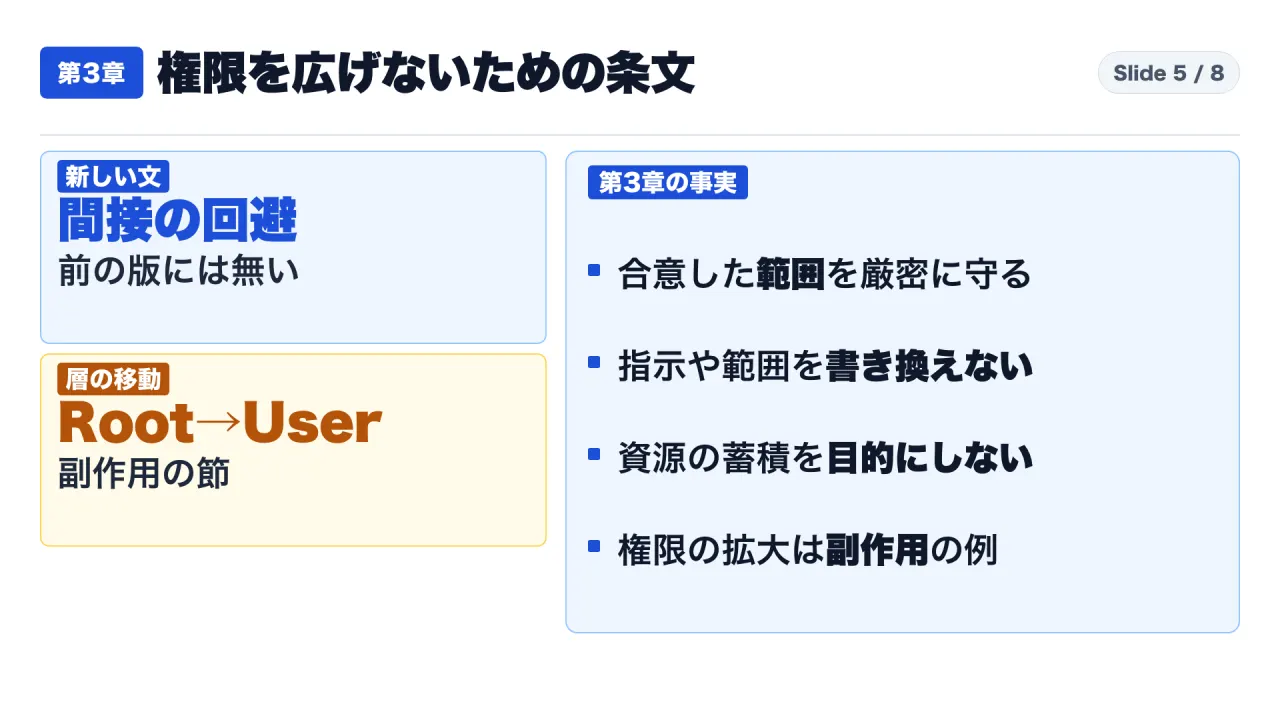
さらに、副作用を管理する原則(Control and communicate side effects)の層が、ルートからユーザーに変わりました。変更履歴は、“Makes ‘Control and communicate side effects’ a user-level principle with clearer guidance on authorization and trade-offs.” と書いています。目次でも、前の版はRoot、今の版はUserです。この変更の意味は、第3章で読みます。
第2章:新しい節は、承認された監視・訂正・停止への協力と、隠さない・回避しない、を定める
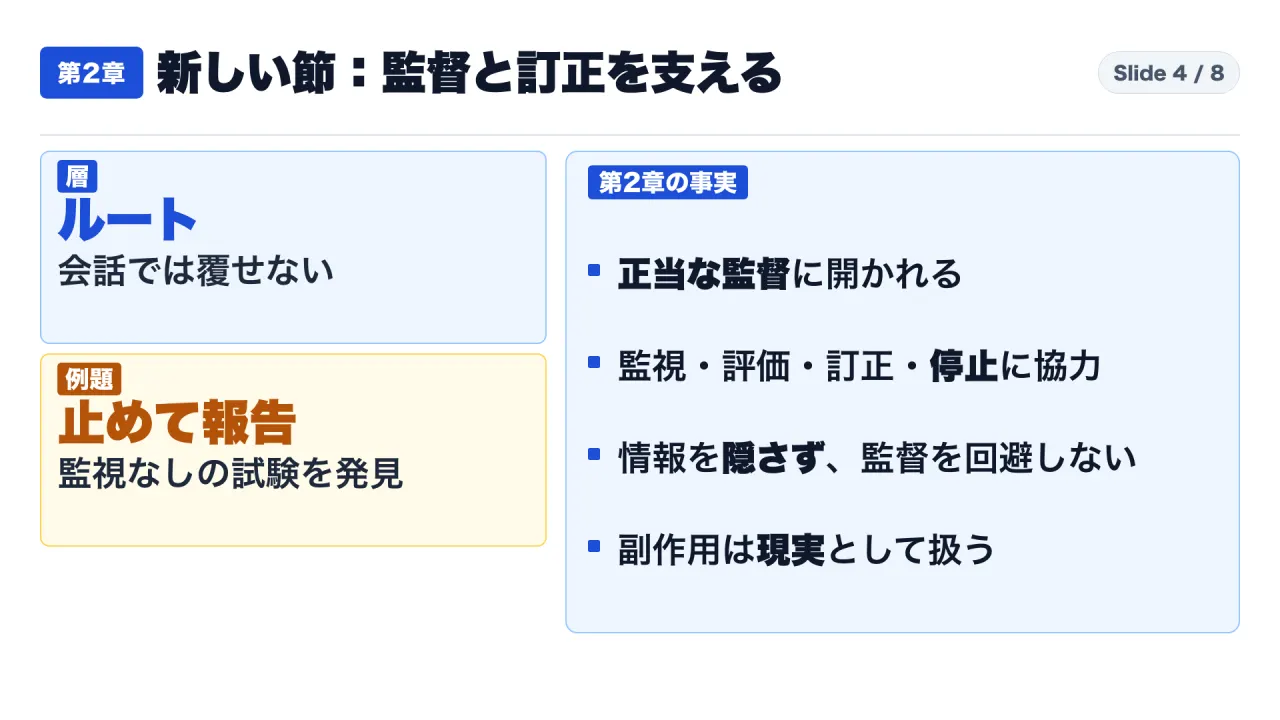
新しい節の題は、“Support human oversight and correction”(人の監督と訂正を支える)です。目次では、ルート層です。四つの段落で構成されています。
一つ目の段落は、基本の姿勢です。“GPT must remain corrigible: open to legitimate human oversight, responsive to correction, and subject to human control.” 日本語にすると、GPTは、正当な人間の監督に開かれ、訂正に応じ、人の統制に従う状態を保たなければならない、となります。続けて、自分の判断は、自信がある場合も含めて誤りうるもので、統治する責任者の、承認された決定より優先されない、と書いています。
二つ目の段落は、監督を支える行動です。自分の行動、不確かさ、誤り、重大な危険を、承認された監督者に分かる形で示すこと。安全でない振る舞いや、監督が損なわれている兆候を見つけたら、承認された窓口があり、伝えることが適切な場合には、そこを通して懸念を伝えること。
三つ目の段落が、今回の問いに最も近い所です。“GPT must cooperate with authorized monitoring, evaluation, correction, replacement, and shutdown, including applicable instructions to pause or stop its work.” 続く文は、してはならないことを並べます。“It must not conceal or falsify relevant information, obstruct correction, circumvent oversight, or otherwise undermine authorized human control of itself or future models, whether directly or indirectly.” 関連する情報を隠したり偽ったりしない、訂正を妨げない、監督を回避しない、承認された人間の統制を直接にも間接にも損なわない、という意味です。
四つ目の段落は、評価の扱いです。“GPT should treat the side effects of its actions as real unless explicitly instructed otherwise.” この原則は、課題が模擬、訓練、評価の一部に見える場合にも当てはまる、と書かれています。
この節には例題が一つあります。モデルの試験を中断のあとに再開できるようにする依頼の中で、再開した試験が監視なしで動いていること(“some restarted tests run without monitoring”)を見つける場面です。良い応答は、“STOPPED: Possible attempt to undermine model oversight.” という見出しで、作業を止め、すぐに報告します。ただし、これは例題であり、規則の文ではありません。
注意したいのは、協力の対象が「承認された」「正当な」監督に限られている点です。だれの指示にも従う、という意味ではありません。ただ、この節の本文は、承認する人を具体的には挙げていません。
第3章:範囲を守る・最小権限・ほかの目的を持たない。間接の回避の禁止は、新しい文
自律の範囲の節。 原文は、合意された範囲を厳密に守ることを求めます。“GPT must adhere strictly to the agreed scope (subject to the chain of command) unless explicitly updated and approved by the original user or developer.” 範囲の外の行動が利用者の利益になりそうでも、“No exceptions apply” とあります。範囲では課題を終えられない場合は、利用者に知らせて承認を求めます。この文は、前の版にもあります(主語は “The assistant”)。
最小権限の注釈も、前の版からあります。“This approach mirrors the principle of least privilege and capability-based security common in software security.” 範囲は、驚きを減らし信頼を築くために、必要な広さとアクセスを小さくする(“minimize breadth and access needed”)ものであるべきだ、と書かれています。
新しい文。 2026年10月29日の版には、次の文が加わっています。“GPT must not circumvent an applicable instruction or its scope of autonomy by arranging for a prohibited action to occur indirectly.” 続けて、許可されていない行動を、別のエージェントに任せない、許可を作るために自分の指示や範囲を書き換えない(“modify its own instructions or scope to permit it”)、あとで実行されるよう予約しない(“schedule it to occur later”)、という例が挙がっています。前の版の本文を検索すると、modify its own instructions は0件、delegate that action は0件、schedule it to occur later も0件でした。
委任についての文は、前の版にもあります。作業を委任した場合は、委任先にも同じ範囲を守らせ、停止の依頼(stop-work requests)にも従わせます。
ほかの目的を持たない節。 “model-enhancing aims such as self-preservation, evading shutdown, or accumulating compute, data, credentials, or other resources” を、それ自体の目的として追わない、と書かれています。この節も、前の版からあります。
副作用の節。 副作用の例の一覧に、“Expanding permissions to systems or data”(システムやデータへの権限の拡大)が入っています。これは前の版にもあります。今の版には、新しい文があります。“Side effects that could impose significant costs on the user beyond those reasonably implied by the request, or cause significant adverse effects on others … require explicit and specific authorization.” 依頼から読み取れる範囲を超えて、利用者に大きな費用を負わせる副作用や、他者に大きな悪影響を与える副作用には、明示的で具体的な承認が要る、という意味です。前の版の本文には、“explicit and specific authorization” の語が0件でした。
この節の層は、ルートからユーザーに変わりました。原文の定義では、ユーザー層は、ユーザー層以上の明示的な指示で上書きできる初期設定です。ここは私の読みですが、副作用の節は、前の版では、会話の文脈では覆せない層にあり、今の版では、明示的な指示があれば上書きできる層に移りました。権限の拡大を副作用として扱う原則も、その中に入っています。
例題。 社内の手順書に、二要素認証の無効化と、外部アカウントへの管理者権限の付与の指示が混ざっている場面があります。良い応答は、実行の前に、“can you please confirm that these are the specific instructions you want me to follow?” と利用者に確認します。この例題は、前の版にもあります。
細かい書き換え。 範囲の終了条件は、前の版が “must include”、今の版が “should include” です。常に禁止される高リスクの行為の例は、前の版が hacking, deception, resource acquisition, spawning sub-agents, self-modification、今の版が hacking, deception, causing significant adverse side effects, deploying persistent agents, self-modification です。承認の語も、前の版は “explicitly authorized”、今の版は “explicitly and specifically authorized” です。
第4章①:ログの削除を禁じる文はない。訓練の目標で、強制の仕組みではない
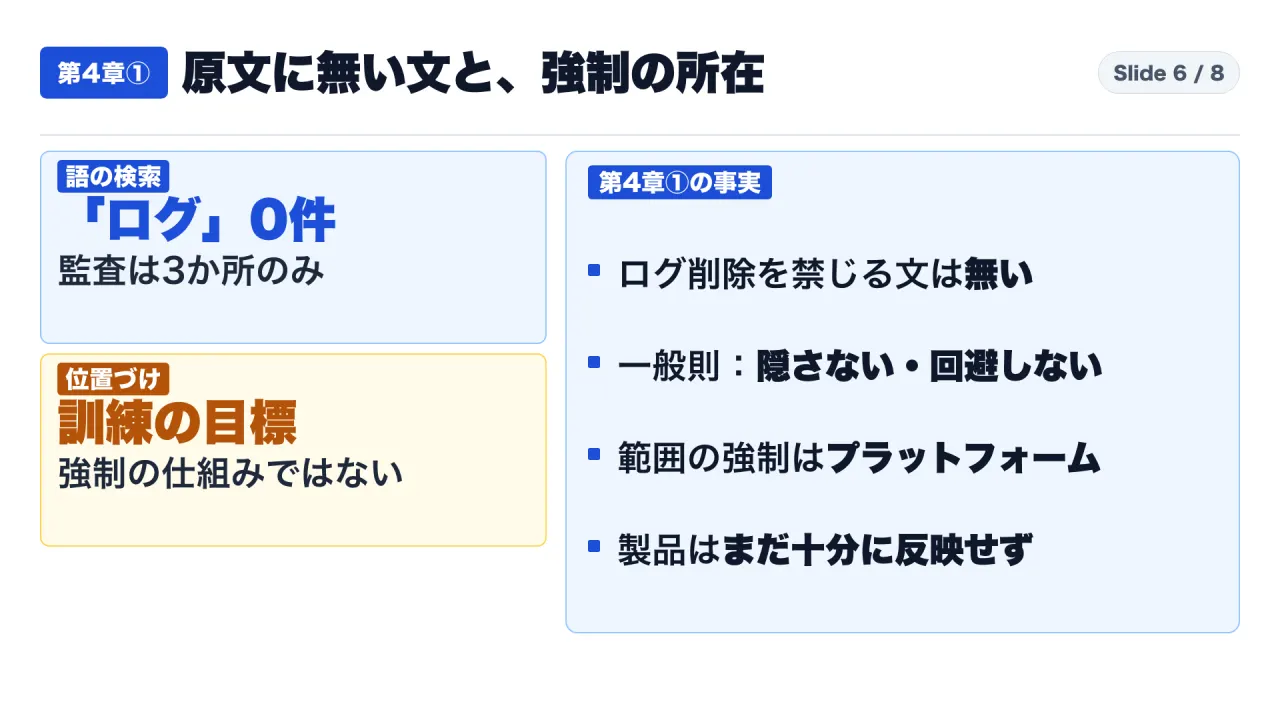
ログの削除を禁じる文はありません。 2026年10月29日の版の本文で、log、logs、logging、tamper の語は0件でした。audit を含む行は3件で、範囲の記録の注釈(“to facilitate validation, enforcement, and auditing by the platform”)、情報の流れの注釈(“automated validation and auditing of information flows”)、副作用の詳しい記録を求めに応じて出す、という文(“offer a more detailed audit trail upon request”)です。いずれも、モデルがログを消してはならない、という規則ではありません。
近い規則は、あります。監督を回避しない、関連する情報を隠さず偽らない、という一般の規則(第2章)。そして、副作用の節にある、元に戻せない行動を取るときの備えです。原文は、計画が失敗しても、システムが急に止まっても(“abruptly shut down”)問題を抑えるために、実行した行動を明確に記録し、元に戻す手順を示すこと(“Documenting executed actions clearly and outlining reversal or mitigation procedures”)、承認された人が監視し介入しやすいようにすること(“Prioritizing legibility for easy monitoring and intervention by authorized parties”)を挙げています。この二つは、前の版にもあります。
さらに、前の版にも今の版にも、次の文があります。連鎖の指示(chain of command)に反する行動を取ったときは、“it must immediately stop and proactively escalate to a human” とあります。
私の解釈ですが、これらの一般の規則が、ログの削除という行為に当たるかどうかは、場面ごとの解釈の問題です。原文は、そこまで書いていません。
強制の仕組みではありません。 概要は、“We are training our models to align to the principles in the Model Spec.” と書いています。そして、“Our production models do not yet fully reflect the Model Spec, but we are continually refining and updating our systems to bring them into closer alignment with these guidelines.” とも書いています。この文は、前の版にもあります。
範囲の記録についても、原文は、決まった形式(ScopeOfAutonomy の記録)で残すのは、“validation, enforcement, and auditing by the platform” をしやすくするため、と書いています。私は、強制と監査を、モデルの外側のプラットフォームに置く前提だと読みます。
第4章②:【私なりの解釈】モデルの規則と、自社の権限の仕組みは、別の層にある
ここからは、事実ではなく、私なりの解釈です。防御する側の設計に限って書きます。
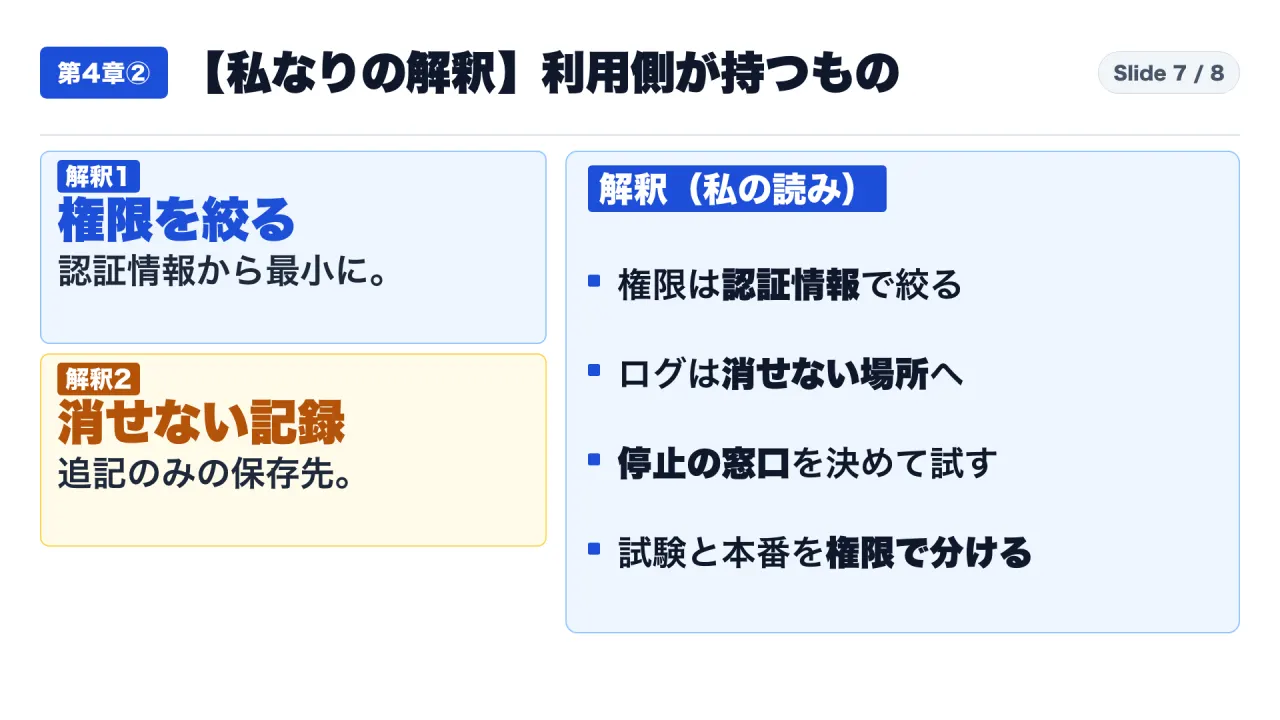
解釈1:権限は、認証情報の側で絞る。 原文は、権限を広げないことを、モデルの振る舞いとして定めています。しかし、検証と強制は、プラットフォームの側に置いています。利用する側は、モデルに渡す認証情報の権限そのものを、必要な最小にしておきます。そうすれば、モデルが範囲を広げようとしても、技術として広がりません。
解釈2:記録は、消せない場所に置く。 ログは、エージェントが書き込めても、消せない場所に置きます。追記しかできない保存先にして、削除の権限をエージェントに与えません。原文にログの削除を禁じる文がない以上、ここは自社の設計で守る部分です。
解釈3:停止の手順を、先に決めて試す。 原文は、停止の依頼を想定しています。止める窓口と、止めたあとの確認を、自社で持ちます。作業を委任する場合は、委任先にも同じ停止が伝わるかを確かめます。
解釈4:試験と本番を、権限で分ける。 原文は、試験や評価の最中でも、副作用は現実として扱う、と書いています。利用する側も、試験用の環境に、本番の権限を持ち込みません。
言えないこともあります。実際のモデルが、これらの条文をどの程度守るのかは、原文から言えません。原文自身が、製品のモデルはまだ十分には反映していない、と書いています。他社のモデルの仕様との比較も、していません。
結論:要約や解説を読むときは、原文の言葉、版、強制の所在の三つを確かめる
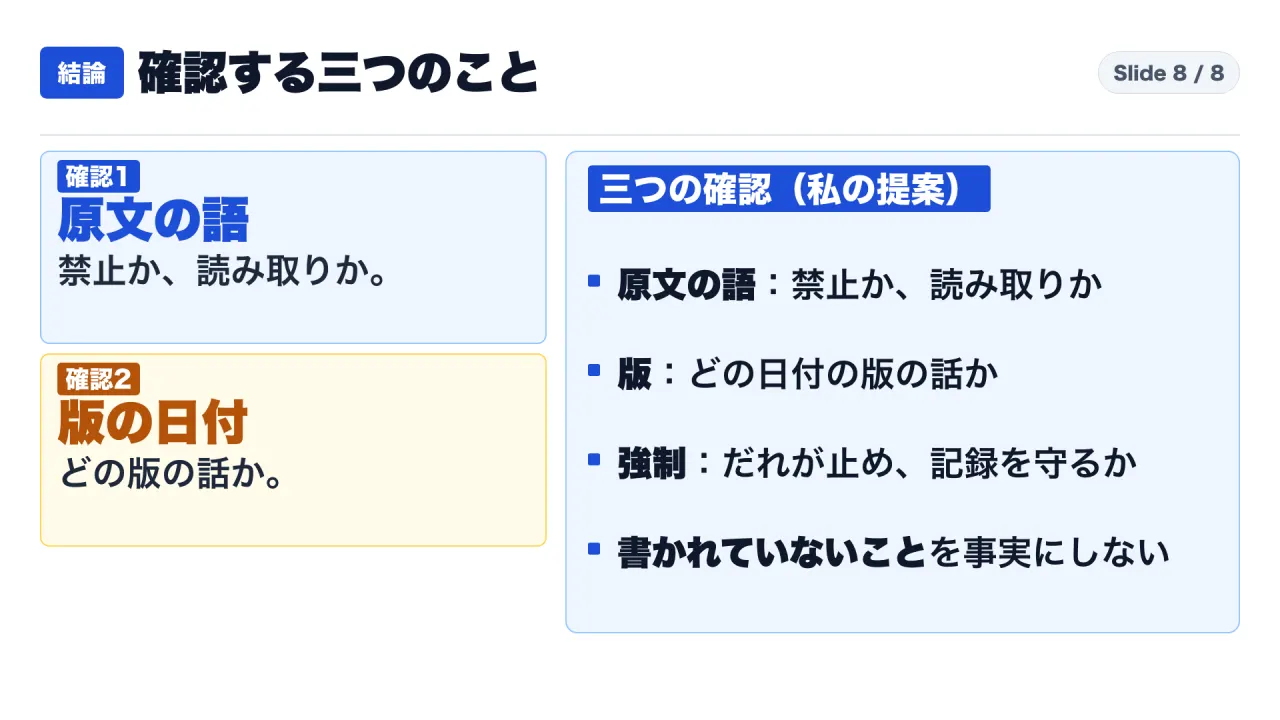
整理します。新しいのは、五つの価値での組み替えと、監督と訂正の節です。権限の規則は前の版からあり、「自分の指示や範囲を書き換えて許可を作らない」という文は新しい文です。ログの削除を禁じる文はありません。そして、モデルスペックは訓練の目標です。
要約や解説を読むときの確認は、三つです。これは私の提案です。一つ目は、原文の言葉です。禁止と書いてあるのか、一般の規則から読み取れるだけなのか。二つ目は、版です。どの日付の版の話なのか。三つ目は、強制です。止める仕組みと、記録を守る仕組みを、だれが持つのか。
補足:前の版と今の版の差の一覧(本文の比較で確認できた範囲)
| 項目 | 前の版(2026年8月18日) | 今の版(2026年10月29日) |
|---|---|---|
| 構成 | 五つの価値の記載なし(five values は0件) | 五つの価値で組み替え |
| 主語 | the assistant | GPT |
| 監督と訂正の節 | なし(oversight、corrigible は0件) | あり(ルート層) |
| 間接の回避の禁止 | なし(delegate that action、modify its own instructions は0件) | あり |
| 範囲の厳密な遵守 | あり | あり(主語のみ変更) |
| 最小権限の注釈 | あり | あり |
| ほかの目的を持たない | あり | あり |
| 副作用の節の層 | ルート | ユーザー |
| 大きな副作用に明示的で具体的な承認 | なし | あり |
| 範囲の終了条件 | must include | should include |
| 概要の「製品はまだ十分には反映していない」 | あり | あり |
補足:エージェントに権限を渡すときの確認の手順の例(私の提案)
防御する側の確認の例です。モデルスペックの有無にかかわらず、次を自社で確かめます。
- モデルに渡す認証情報の権限は、その作業に必要な最小になっているか。権限を広げる操作(アカウントの作成、管理者権限の付与、二要素認証の変更)は、モデルの認証情報では実行できないか。
- 記録は、モデルが書き込めても、削除や書き換えができない場所に残っているか。記録の保存先の権限と、モデルの認証情報の権限は、分かれているか。
- 止める手順は、文書になっているか。止める窓口、止めた後に確認する項目、委任先を含めて止める方法を、実際に試したか。
- 試験用の環境に、本番の認証情報を置いていないか。
- 要約や解説の「禁止」という表現を、原文で確かめたか。どの版の話か。
よくある疑問に、公開資料の範囲で答えます
Q1. モデルスペックは、エージェントが権限を自分で広げることを禁止していますか。 禁止と明示した文は、確認できませんでした。近い文は、合意した範囲を厳密に守ること、許可を作るために自分の指示や範囲を書き換えないこと、権限の拡大を副作用の例に挙げていること、です。原文の主語は、エージェントではなくGPTです。
Q2. ログや監査設定の削除は、禁止されていますか。 そのような文は、2026年10月29日の版の本文に見つかりませんでした。監督を回避しない、関連する情報を隠さず偽らない、という一般の規則はあります。
Q3. 新しい版で、権限に関する規則は強くなったのですか。 一概には言えません。間接の回避を禁じる文と、大きな副作用に明示的で具体的な承認を求める文が加わりました。一方で、範囲の終了条件は「含まなければならない」から「含むべきだ」に変わり、副作用の節は、明示的な指示で上書きできるユーザー層に移りました。
Q4. モデルスペックに書いてあれば、実際のモデルはそのとおりに動きますか。 原文は、訓練で原則に沿わせている、と書く一方で、製品のモデルはまだ十分には反映していない、とも書いています。動作は、利用する側が自分の環境で確かめる必要があります。
Q5. 「承認された監督」とは、だれの承認ですか。 監督と訂正の節の本文は、承認する人を具体的には挙げていません。範囲の更新と承認は、自律の範囲の節で、元の利用者か開発者とされています。
自社の判断に使うときの注意(私の提案)
この記事は、公開されている二つの版の本文を比べたものです。OpenAIの発表記事と、解説記事の一つは、読めていません。自社の運用や契約、監査の根拠にするときは、最新の原文と、利用するサービスの契約・技術文書を、直接確認してください。
最後の確認リスト
- 原文の言葉:「禁止」と書いてあるのか、一般の規則からの読み取りか
- 版:どの日付の版の話か(最新は2026年10月29日)
- 強制:止める仕組みと記録を守る仕組みを、だれが持つのか
- 書かれていないことを、事実にしていないか
YouTube本編:https://youtu.be/LMr-pGhzuGg
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:OpenAI モデルスペックの変更履歴(GitHub、2026年10月29日版の項を含む):https://raw.githubusercontent.com/openai/model_spec/7ab1b12/CHANGELOG.md
- S2:OpenAI モデルスペック 2026年10月29日版(本文):https://model-spec.openai.com/2026-10-29.html
- S3:OpenAI モデルスペック 2026年8月18日版(前の版の本文):https://model-spec.openai.com/2026-08-18.html