なぜOpenAIはGitを捨てずに1日ほぼ1PBを配れたのか?──手放した「全ブランチ同時点」と、自社で確かめる3つのこと
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜOpenAIはGitを捨てずに1日ほぼ1PBを配れたのか?──手放した「全ブランチ同時点」と、自社で確かめる3つのこと
序論:OpenAIが記事で描く限界は、Git本体ではなく配る側の設計。使い方は残し、全ブランチ同時点の姿は手放した
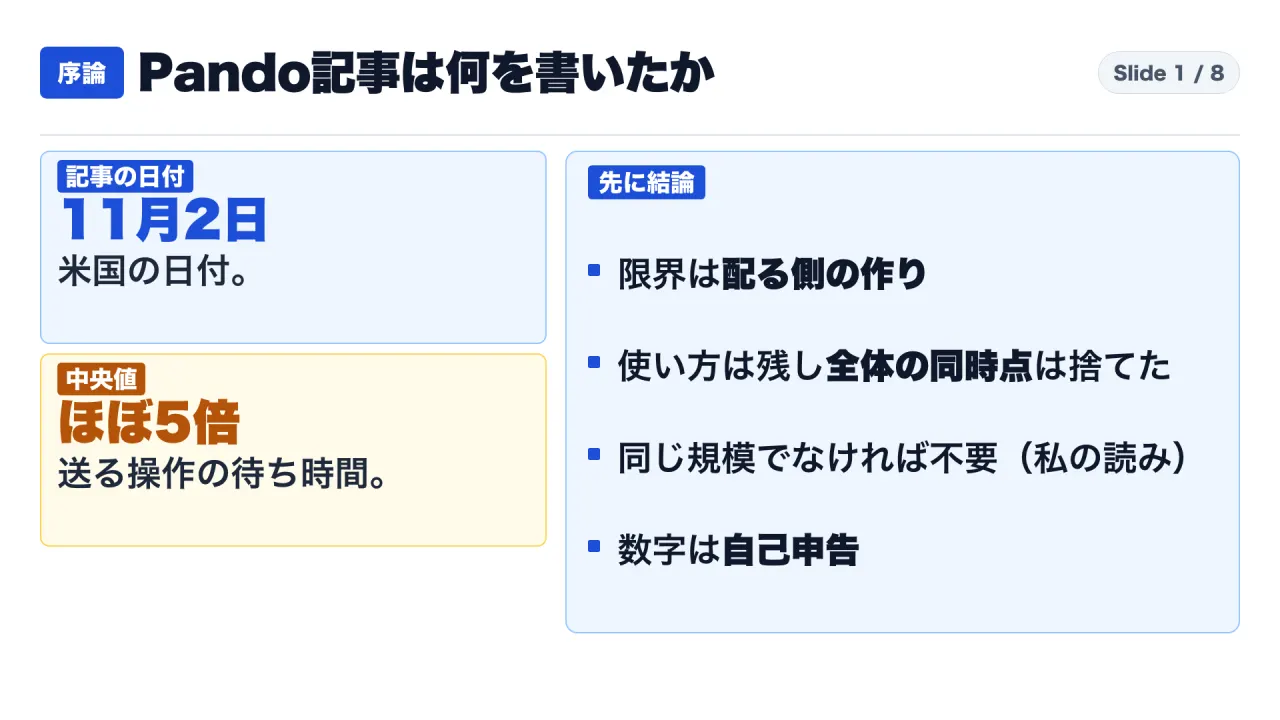
結論から書きます。OpenAIが2026年11月2日(ページ表示。米国の日付)に公開したエンジニアリング記事「Scaling Git at OpenAI」は、次の3点を読む記事です。
- 記事が描く限界は、Git本体ではなく、モノレポを配る側(サーバー側)の設計にあります。
- Gitのプロトコルとクライアントの互換は保ち、代わりに「全ブランチを同じ瞬間にそろえた姿(全ブランチ同時点)」を出さない設計にしました。枝ごとの更新の順番は守り、枝どうしの順番をそろえるのはやめた、という意味です(記事の言葉では causal consistency)。
- 同じ規模で動いていなければ、同じ設計は要らない、というのが私の読みです。これは記事の主張ではなく、私の解釈です。
記事は、新しいバックエンド「Pando(パンド)」を紹介しています。中央値のプッシュの遅れが「ほぼ5倍」速くなり、1日に「ほぼ1ペタバイト」のGitデータを配っている、と書きます。ただし、数字はすべてOpenAI自身の記述です。私が読んだ範囲では、外部の検証は記事にありません。
この記事の対象読者は、Gitのサーバー運用や開発基盤を担当し、「ほぼ5倍」「1日ほぼ1PB」のような数字を見て、自社にも同じ仕組みが要るのかを判断したい、開発リードやインフラ担当の方です。
読み終えると、次の3つができるようになります。1つ目は、中央値のプッシュの速さと、1日に配った量が、何の数字なのかを区別すること。2つ目は、記事が書いていないこと(公開時期、費用、障害の事例、外部の検証)を、事実と混ぜずに扱うこと。3つ目は、自分のチームで、書き込みと読み出しのどちらが詰まっているかを確かめる手順を持つことです。
この記事は、公表された資料を読んだ整理です。OpenAIやAnthropicの上場、企業の価値、株や投資の判断は範囲外として扱いません。
この記事が役に立つ人と、読んだあとにできること
社内のソースコードの置き場(Gitのサーバー)、CI(自動で試験を回す仕組み)、大きなモノレポの基盤を運用する人、または選ぶ人に向けた記事です。AIエージェントによる変更が増え、Gitの待ち時間や失敗が増えてきた場面を想定しています。
読んだあとにできることは3つです(いずれも私の提案です)。
- 書き込み(プッシュ)と読み出し(取得)を分けて、それぞれ中央値と遅い側の値で測る。
- 全部のブランチを同じ瞬間にそろえて読む前提の道具が、社内にないか一覧にする。
- 他社の発表の数字を「中央値か遅い側か」「書き込みか読み出しか」「誰が測ったか」の3つの問いで読む。
先に用語:この記事で使う言葉を、短く言い換えます
- Git(ギット):プログラムの変更の履歴を残し、みんなで共有する道具です。
- リポジトリ:プログラムと変更の履歴をしまう置き場です。モノレポは、会社のプログラムを一つの大きな置き場にまとめる方式です。
- コミット:変更を一つの区切りとして記録することです。プッシュは、手元の変更を共有の置き場へ送る操作です。マージは、分けた枝の変更を本流に合流させることです。
- ブランチ:本流から分けて作業するための、作業用の枝です。**参照(ref)**は、ブランチの先頭がどこかを示す、しおりのようなものです。
- パック(packfile):送るデータを一つにまとめた荷物です。
- 全ブランチ同時点(断面):全部のブランチを、同じ瞬間にそろえて見せた姿のことです。Pandoはこれを出さない設計にしました。
- 中央値:小さい順に並べて真ん中に来る値です。99パーセンタイルは、小さい順に並べて99%の位置に来る値です。「99パーセンタイルが3MiB未満」は、大きい側の1%を除けば、残りはすべて3MiB未満という意味です。
- 信頼性:記事は定義を書いていません。90%を下回る、とは、うまくいく割合が9割に届かない時期があった、という意味に読めます(私の読み)。
- PB(ペタバイト):TB(テラバイト)の千倍です。KiBは約千バイト、MiBは約百万バイトです。
- キャッシュ:よく使うデータを近くに置いておく仕組みです。レプリケーションは、同じデータの写しを複数の機械に置くことです。
- SSH:安全に接続するための通信方式です(記事には出てきません)。
- エージェント:人の代わりに作業を進めるAIのことです。Codexは、OpenAIのプログラムを書くAIです。
- Scion(サイオン):Anthropicが社内で作った、変更の履歴を管理する道具です。
読み方:本文では「事実」「私の解釈」「書かれていないこと」を分けて書きます
- 事実:公開された記事に書かれていること。出所は文のあとと、記事末尾の出典一覧に示します。
- 私の解釈:事実から私が読んだこと。「私の読み」「私の計算」と明示します。
- 書かれていないこと:取得した記事の本文を読み、語を検索した範囲で、本文にない項目。
使った資料は2つです。S1がOpenAIの記事、S2がAnthropicの記事です。S1はサーバーからの自動取得が拒否されたため、番組の専用ブラウザで公開ページを読み取り専用で開き、本文を取得しました。
第1章:何が詰まったのか。記事の問いは「限界はGit本体か、配り方か」
記事の題名は「Scaling Git at OpenAI」、副題は「Building agentic-scale scale source control while investing in the Git ecosystem.」です。著者は同社の技術スタッフ3人(Aaron Friel、Taylor Blau、Ted Nyman)です。「Pando」は、題名ではなく、本文に出てくる新しいバックエンドの名前です。
背景として、記事は次のように書きます。
- Codexが、開発の量と速さを変えた。エンジニア1人が同時に複数の変更をCIに出せる状態になり、1回のプッシュが、同じコミットを取りに行く複数の仕事を起こす。
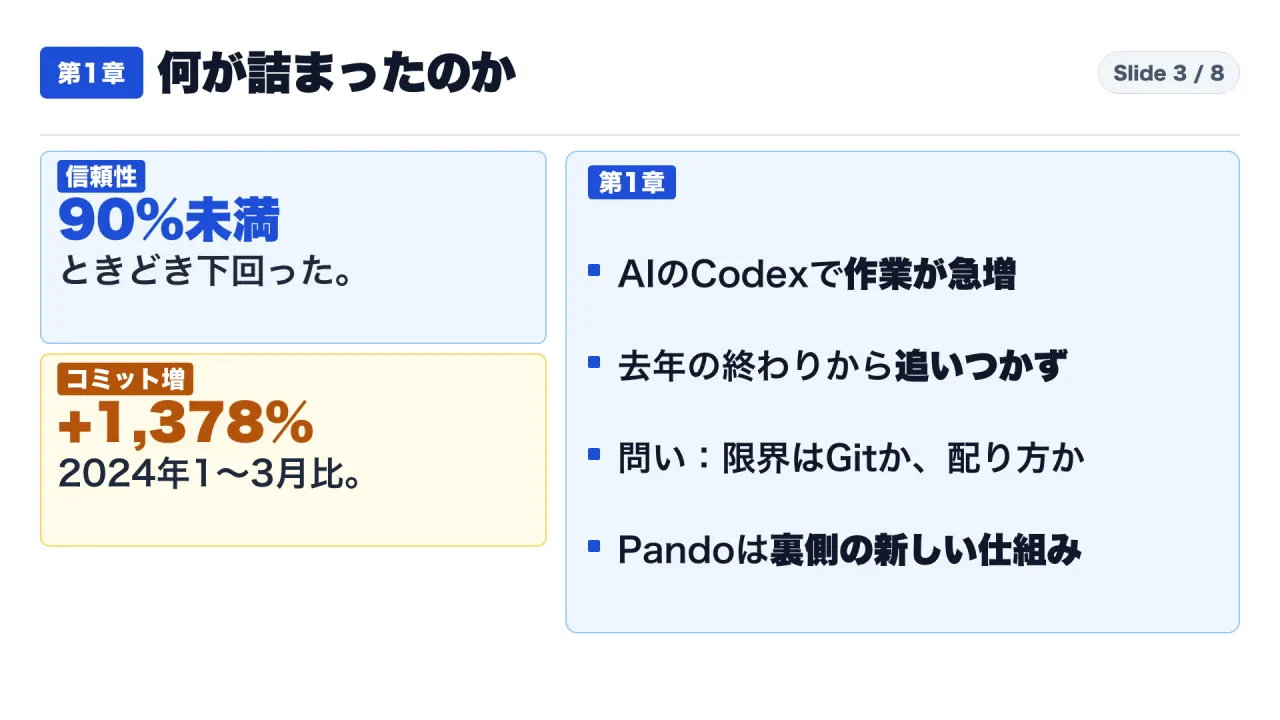
- 去年の終わりごろから、モノレポを支える仕組みが追いつかなくなった。取得とプッシュが遅く、マージが失敗し、信頼性はときどき90%を下回った。
記事には、マスターに入ったコミット数の伸びのグラフがあります。基準は2024年の最初の四半期で、実績の最後の点(2026年の3番目の四半期のラベル)は+1,378%です。グラフには、2026年の最後の四半期の推定値(+2,442%)もありますが、これは推定で、実績ではありません。なお、四半期とグラフの数値の対応は、ラベルの並びからの読み取りです。
記事自身が立てている問いは、次のとおりです。
Had we reached a limit of Git itself, or of the way we served our monorepo?
つまり、「限界に達したのは、Git本体か、モノレポの配り方か」です。ここからは私の読みです。記事は、この問いに、Gitを捨てる、とは答えていません。配り方を作り直しました。
第2章:設計。ブランチごとに独立して書き、パックを使い回して配る
記事が挙げる目標は2つです。1つ目は、たくさんのブランチへの同時のプッシュを、機械を足して仕事を分け合う「水平にスケールする書き込み」です。2つ目は、読み出しのスループットを最大にして、クライアントが回線の帯域を使い切れるようにすることです。互換は、Gitのプロトコルとクライアントについて保った、と書いています。
従来の方式との違い
記事は、従来の方式として、何台かの機械が3つの段階で合意してから決める方式(3相コミット、3PC)と、全員が一冊の台帳に順番に書く方式(先行書き込みログ、WAL)を、模型にして比べた、と書きます。
- 3段階で合意する方式:参照(ブランチなど)は1つずつ更新され、プッシュのたびに、複数の複製との間で複数回のやり取りが要ります。
- 一冊の台帳に順番に書く方式:関係のないブランチへのプッシュでも、同じ台帳(マニフェスト)を更新するので、順番待ちになります。
Pandoが手放した2つの前提
記事は、ほとんどのGitシステムが前提にしている条件のうち、2つを手放した、と書きます。
- リポジトリ全体の一貫性:全参照を同じ瞬間にそろえた姿を出すには、リポジトリ全体での調整が要ります。
- クライアントごとに別々のパック:履歴の違う2人が同じブランチを取ると、サーバーは別々のパックを作る必要があり、CPUとディスクの入出力がかかります。
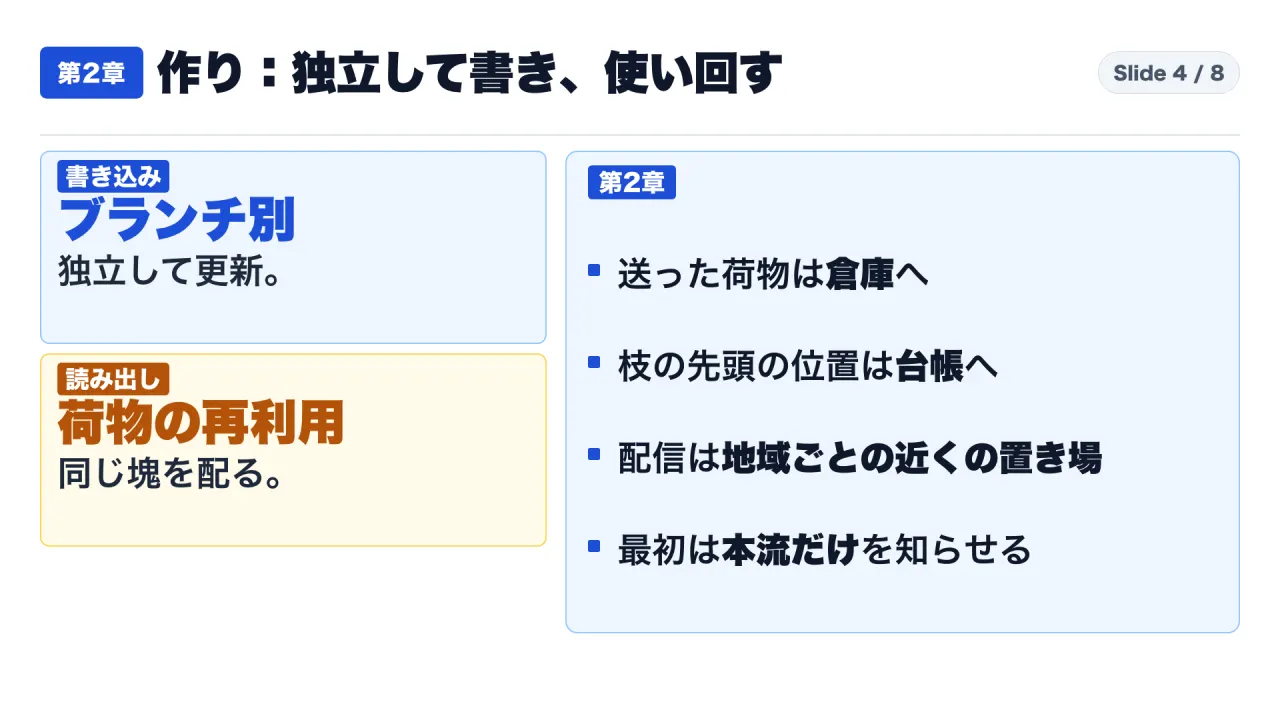
代わりに、枝ごとの順番は守り、枝どうしの順番をそろえるのをやめて書き込みを伸ばし、パックの再利用で読み出しを伸ばします。
仕組み
- プッシュされたパックは、変更できない塊(イミュータブルなブロブ)として、荷物の倉庫(ブロブストア)に置かれます。
- ブランチが動くたびに、新しい先頭と、そのパックを、置き場所の台帳(メタデータストア)に「参照の版」として記録します。荷物の倉庫(ブロブストア)と置き場所の台帳は、どちらも機械を足して伸ばせます。
- 取得では、クライアントが持っている履歴に合うパックを選び、置き場所のリンク(packfile-uri)を返します。配るのは、地域ごとのキャッシュを持つ配信サービス「Express」です。
- プッシュの側では、既定で、指定した主幹(トランク)のブランチだけをクライアントに知らせます。この方式で出るパックの大きさは、中央値が20KiB未満、99パーセンタイルが3MiB未満でした。
私の整理です。書き込みをブランチごとに独立させ、読み出しを、使い回せるパックの配信に寄せた設計です。Git本体を変えたのではなく、サーバー側の作りの話です。
第3章:数字の読み方。「ほぼ5倍」は書き込みの中央値、「ほぼ1PB」は配った量
記事の数字を、条件ごとに分けます。
| 数字 | 記事の記述 | 読み方 |
|---|---|---|
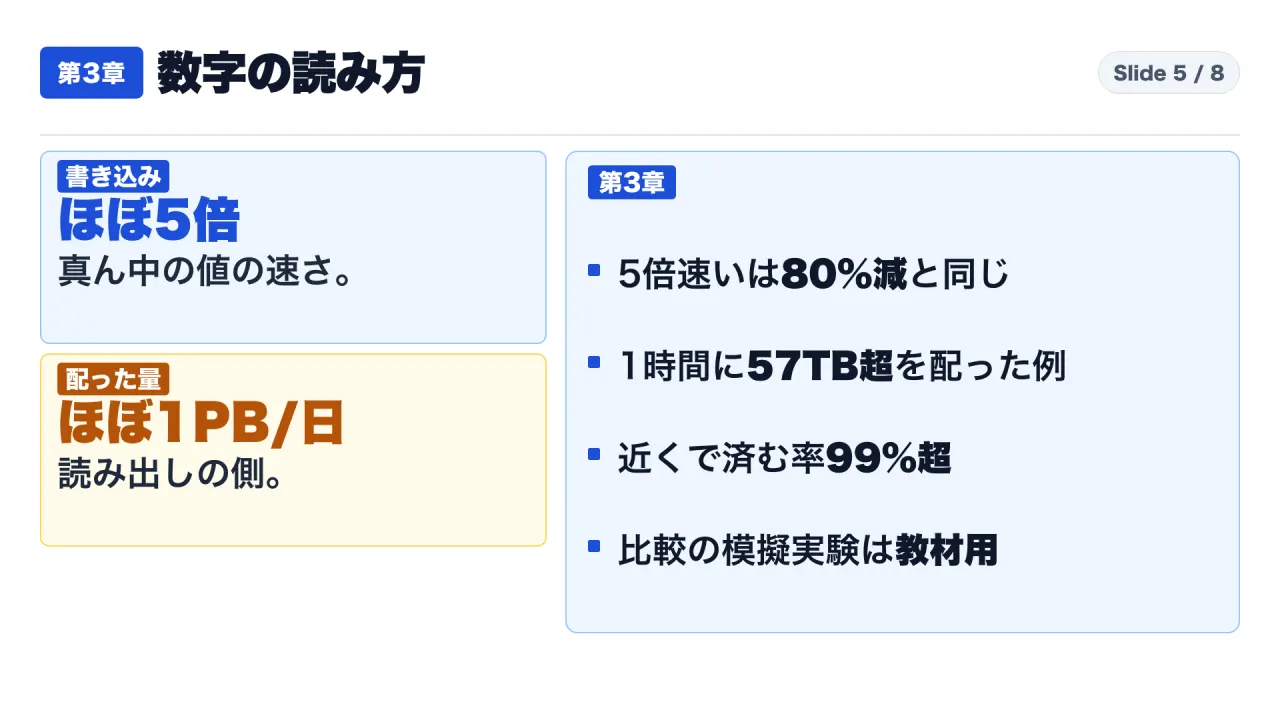
| ほぼ5倍 | 本番で、中央値のプッシュの遅れを「ほぼ5倍」減らした | 中央値のみ。書き込み側 |
| ほぼ80%減 | 移行を説明する部分で、中央値のプッシュの遅れを「ほぼ80%」減らした | 5倍と整合(私の計算:5倍速い=時間が5分の1=80%減) |
| ほぼ1PB/日 | 1日に「ほぼ1ペタバイト」のGitデータを配る | 配った量。読み出し側 |
| 57TB超/時 | 1時間で57TB超のパックを配った。99%超は配信側のディスクのキャッシュから | 1時間の実績(最大値とは書いていない)。単一のリポジトリの例 |
| 99%超 | 取りに来たデータを、近くの置き場(キャッシュ)だけで出せた割合(cache hit rates) | 検証値 |
| 10Gbps | 標準の仮想マシンで、クローンと取得が10Gbpsの回線を飽和させた | 検証値 |
読むときの注意が3つあります。
- 「ほぼ5倍」は、中央値のプッシュだけです。大きい側(p99など)のプッシュの遅れは、記事の本文にありません。「99th percentile」の語は、パックの大きさの文にだけ出ます。
- 「ほぼ1PB/日」は、配った量、つまり読み出しです。プッシュの量ではありません。本文は、ほんの数個の計算用のコアで、1日に1ペタバイトを配れる、とも書いています。
- 1時間の実績は、単一のリポジトリの例で、57TB超です。記事は「more than」と書き、最大値とは書いていません。
私の計算です。1PBを1,000TBとして、24時間で割ると、1時間あたり平均で約42TBです。その1時間(57TB超)は、平均の約1.4倍を超えます。PBの定義(1,000TBか1,024TBか)は記事に記載がなく、1,000TBと置きました。
そして、これらの数字は、すべてOpenAIの自己申告です。私が確かめたのは、記事に何が書かれているかだけで、数字そのものが正しいかは確かめていません。
記事には、3段階で合意する方式、一冊の台帳に順番に書く方式、Pandoを比べるシミュレーションもあります。1,000のクライアントが、それぞれ別のブランチに繰り返しプッシュする条件です。ただし、記事自身が「Synthetic teaching models, not production benchmarks.(合成の教材用のモデルで、本番のベンチマークではない)」と書いています。
第4章①:記事が書いていないこと。公開の時期、費用、外部の検証
ここからは、書かれていないことです。取得した本文を読み、語を検索した範囲に限ります。
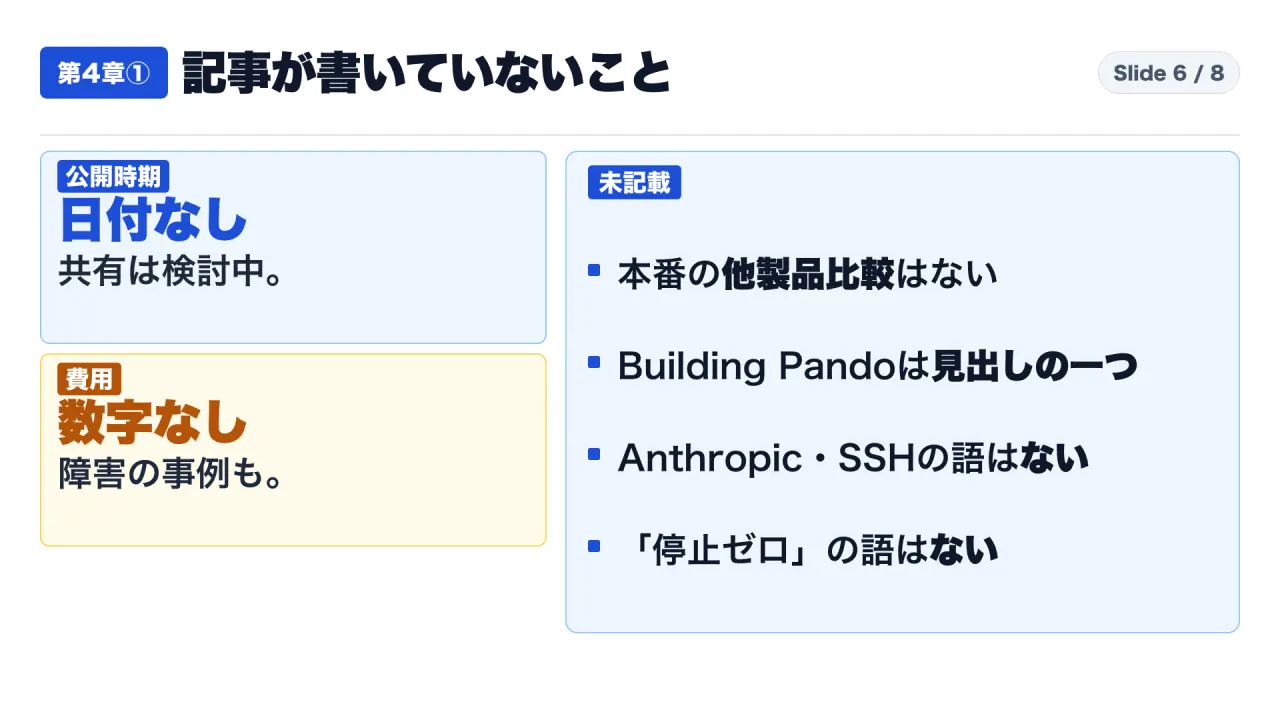
- 公開の時期:記事は「利用者と共有する方法を探っている」と書くだけです(We’re currently exploring ways to share the technology that makes Pando possible with our users.)。オープンソース化も、日付も、ありません。なお、「Git本体に取り込み済みの改善」と「公開リポジトリ」の記述は、Git側の改善の話で、Pando自体の公開ではありません。
- 失敗の事例と費用:マージの信頼性は改善した、と書くだけで、数字はありません。金額の費用の記載もありません。
- 本番での実測の比較:他の製品との本番での比較はなく、比較は合成のシミュレーションだけです。
下調べに使った紹介文との違い
紹介文は、番組の下調べで受け取った、自動でまとめた解説文です。証拠としては使っていません。その紹介文には、記事にない話が混ざっていました。記事の本文を検索して、次を確認しました。
- Anthropic、Scion、Claudeの語は、記事の本文にありません。
- SSHの語、対応プロトコルの一覧、「ref lock contention」という語は、記事にありません。記事が書くのは、全参照を同じ瞬間にそろえて出す方式では、関係のないブランチへのプッシュが、1つの調整の点に集まる、という説明です。
- 配る先をエージェントとCIに限る文は、ありません。記事は、開発環境、研究の仕事、CIからの取得と書きます。
- 「ゼロダウンタイム」の語はなく、記事は「without downtime(停止なしで)」と書きます。最初は、既存の仕組みの前に置く、読み書きの中継(プロキシ)でした。
- 「分散データベースと分散キャッシュ」とは書いていません。記事の構成は、荷物の倉庫と置き場所の台帳と、地域ごとの近くの置き場(キャッシュ)です。
- 「Building Pando」は、記事の題名ではなく、記事内の見出しの一つです。
制作の裏側です。紹介文の内容を、一次資料の記事と突き合わせ、記事にない話を使わないことにしました。
第4章②:【私なりの解釈】使い方を守り、全ブランチ同時点を手放した。別の会社は、押す操作を変えた
ここからは、事実ではなく、私なりの解釈です。
別の会社の記事を、短く対比する
別の会社の記事も確認しました。Anthropicの「Redesigning source control at Anthropic」(2026年10月13日)です。
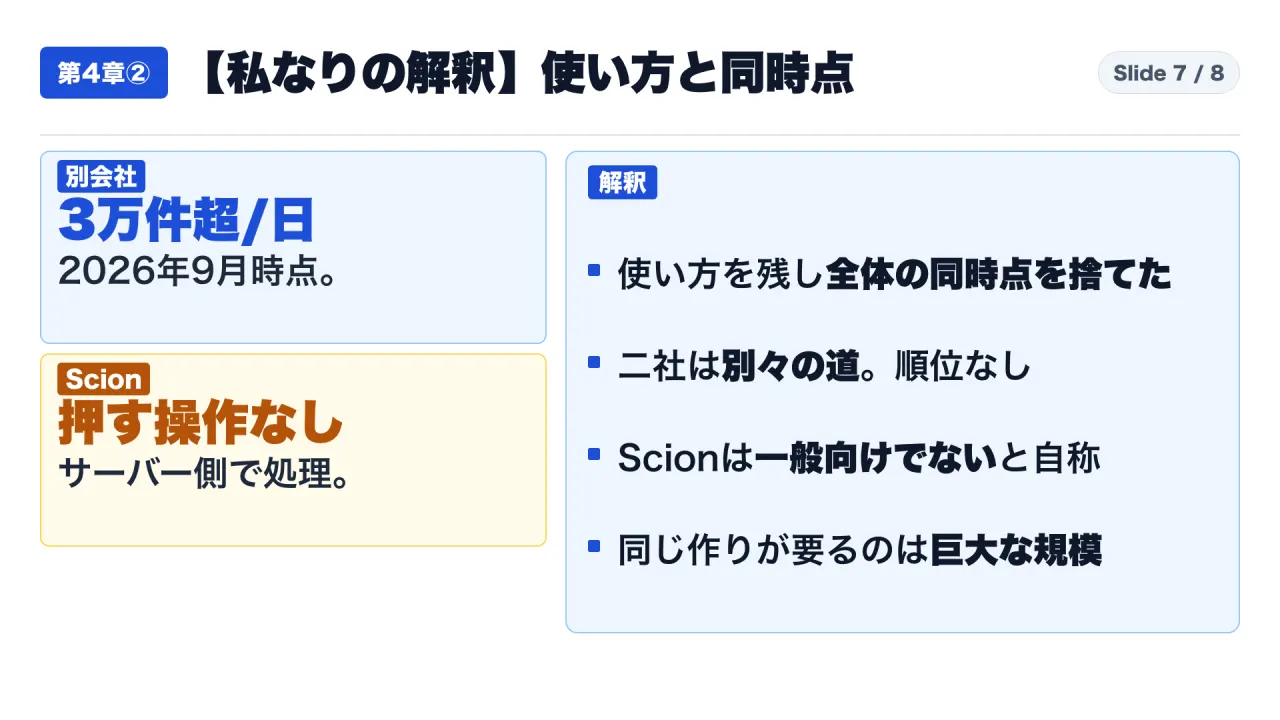
- 1日あたりのマージ件数:2026年5月に約2,500件、9月時点で3万件超。
- Anthropicは、社内で作ったScionに、5か月で移りました。Scionでは、コミットなどがサーバー側で起き、「押す」操作がありません。
- 同じ記事は「Scion is by no means a suitable replacement for git for general use.」(汎用のgitの代わりにはならない)と書き、非常に大きなモノレポでだけ意味がある、とも書いています。
二社の記事は、別々の会社の、別々の記事です。OpenAIの記事の本文にAnthropicの語はなく、Anthropicの記事の本文にOpenAIやPandoの語はありません。指標も揃っていません(OpenAIは、マスターに入ったコミット数の伸び。Anthropicは、1日あたりのマージ件数)。順位は付けません。
私の解釈
- 第一の解釈。OpenAIは利用者の操作を変えない道を、Anthropicは操作そのものを作り直す道を選んだ、と読めます。ただし、二社の事情は、記事から、これ以上は読み取れません。
- 第二の解釈。互換を残す代わりに捨てたのは、全ブランチ同時点の姿です。記事は、利用者とエージェントは、全体の順序を気にしない、と書いています(users and agents are agnostic to the global ordering of ref updates)。ただし、これは同社の使い方での話です。自社で同じとは限りません。
- 第三の解釈。同じ設計が要るのは、書き込みと読み出しの両方が、ここまで詰まる規模だけです。Scionの記事も、巨大なモノレポでだけ意味がある、と書いています。
この記事で言えないこと
- 自分のチームで、同じ倍率が出るのか。
- この設計の、費用と、障害の実績。
- 公開の時期。
- 紹介文にあった、記事にない話。
明日できる小さな一歩:送信と取得を、分けて数える
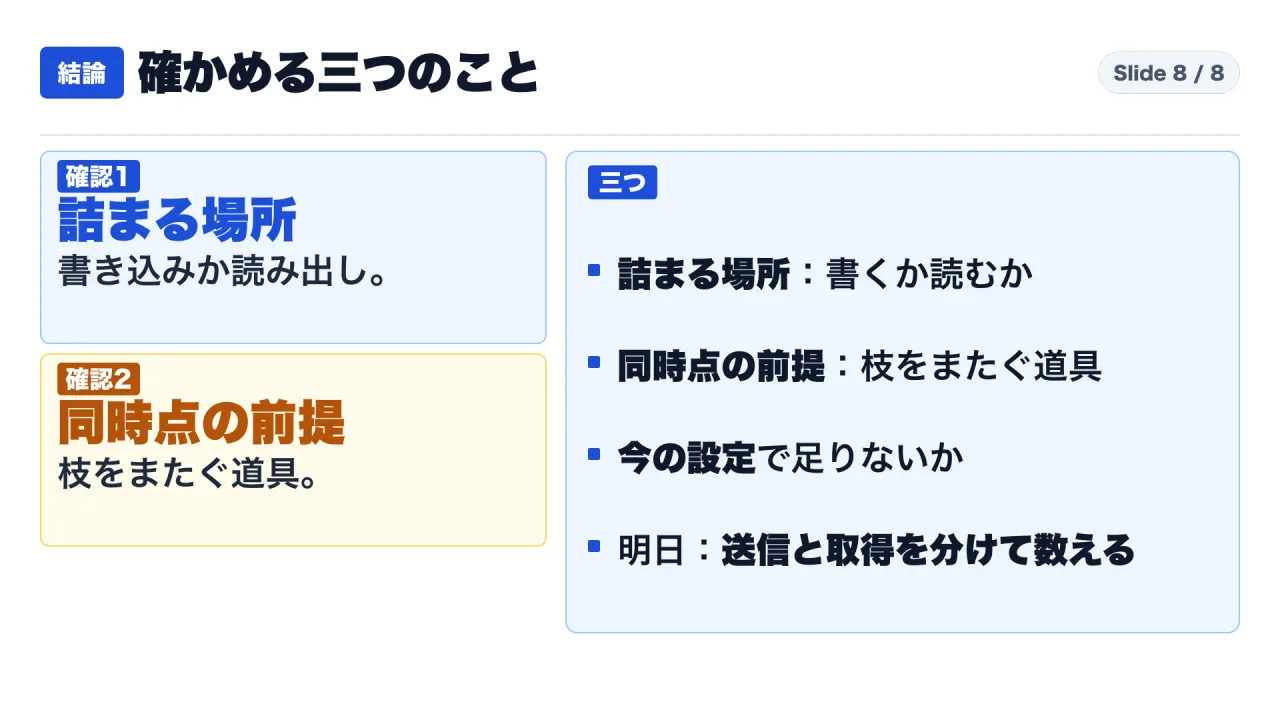
ここからは私の提案です。Gitの置き場の記録から、1日のプッシュの回数と、取得で送ったデータの量を、別々に数えてみてください。それぞれ、中央値と遅い側の値を並べます。記事も、書き込みの速さ(中央値のプッシュの待ち時間)と、読み出しの量(1日ほぼ1PB)を分けて書いています。どちらが詰まっているかが分かれば、次に読む資料も、問い合わせる相手も決まります。
- 事実(記事の記述):Pandoは中央値のプッシュの待ち時間をほぼ5倍速くし、1日にほぼ1PBを配っている。
- 私の解釈:書き込みと読み出しは、別の問題として扱える。
- 私の提案:自社では、まず両者を分けて測る。製品の購入や契約の判断は、この記事の範囲を越えるので扱いません。
結論:記事から言えること、言えないこと、自分のチームで確かめる3つ
記事が書いているのは、Gitのプロトコルとクライアントの互換を保ったまま、サーバー側を作り直し、中央値のプッシュの遅れを「ほぼ5倍」速くしたことです。そして、1日にほぼ1ペタバイトを配る、という読み出しの実績です。代償は、全ブランチ同時点の姿です。書かれていないのは、公開の時期、失敗と費用の実績、外部の検証です。
自分のチームで確かめる手順は、次の3つです。これは私の提案です。
- 詰まっているのが、書き込みか、読み出しか。プッシュの待ち時間と、取得・クローンの待ち時間を、別々に測ります。
- ブランチをまたいで、同じ時点を見る前提の道具がないか。複数のブランチを一度に読む処理(リリースの組み立て、ミラー、監査の道具など)が、全ブランチ同時点の姿を前提にしていないかを確かめます。記事の設計は、この前提を手放しています。
- 今の仕組みの設定で、足りないか。記事の設計は、OpenAIのモノレポの規模の話で、公開の時期も決まっていません。まず、既存の仕組みの設定で解決できるかを確かめます。
補足:よくある疑問に、記事の範囲で答えます
「Gitの限界」と言っていいのか
記事の問いは「Git本体の限界か、配り方の限界か」で、答えは、配り方を作り直す、でした。Gitのプロトコルとクライアントは保っています。「Gitの限界を超えた」とは、記事は書いていません。
1日ほぼ1PBは、書き込みの量か
書き込みではなく、配った量(読み出し)です。プッシュの量は、記事に数字がありません。
「ほぼ5倍」は、すべてのプッシュが5倍速いという意味か
中央値のプッシュです。大きい側の遅れは、記事の本文にありません。
自社も同じ設計にすべきか
記事は、OpenAIのモノレポの話です。Scionの記事も、汎用のGitの代わりにはならないと書いています。まず、書き込みと読み出しのどちらが詰まっているかを測ってください(私の提案)。
Pandoは使えるのか
記事は「共有する方法を探っている」と書くだけで、公開や提供の日付はありません。
最後の確認リスト
- 数字は、中央値か、大きい側か。書き込みか、読み出しか。
- 数字を出したのは誰か。外部の検証はあるか。
- 捨てたもの(全ブランチ同時点の姿)は、自社の道具が前提にしていないか。
- 書かれていないこと(公開時期、費用、障害の事例)を、事実として扱っていないか。
YouTube本編:{{YOUTUBE_URL}}
出典一覧
- S1:OpenAIのエンジニアリング記事「Scaling Git at OpenAI」(ページ表示は2026年11月2日):https://openai.com/index/scaling-git-at-openai
- S2:Anthropicのエンジニアリング記事「Redesigning source control at Anthropic」(2026年10月13日):https://www.anthropic.com/engineering/redesigning-source-control