なぜClaude Codeの50万〜100万トークンで応答中央値が約35%縮む?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜClaude Codeの50万〜100万トークンで応答中央値が約35%縮む?
https://www.youtube.com/watch?v=Tz2I830GcCY
動画・音声本編はこちら:なぜClaude Codeの50万〜100万トークンで応答中央値が約35%縮む?
結論:減るのは「毎回送る量」と「受付側の下ごしらえ」。読む量・料金・キャッシュの仕組みは変わらない
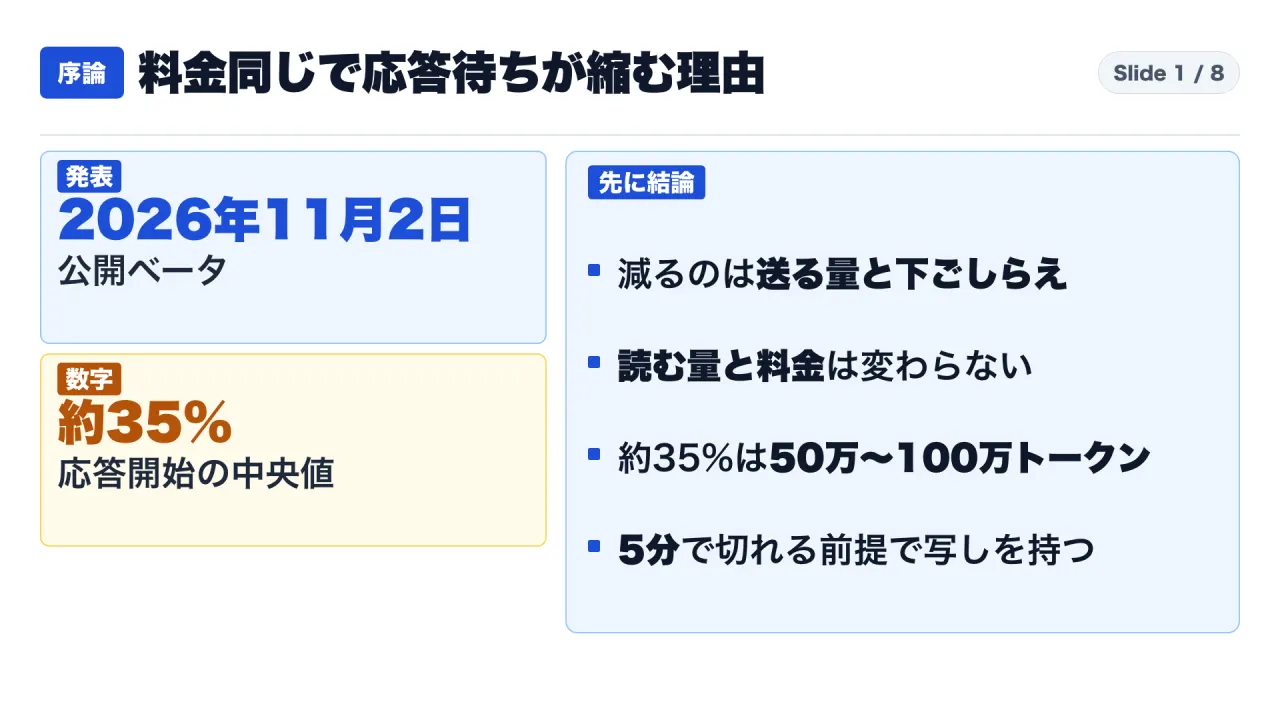
結論から書きます。アンソロピックは2026年11月2日、Claudeの「メッセージスレッド(Message threads)」を公開ベータとして発表しました。長い会話の全文を、毎回の要求で送り直さなくてよくする仕組みです。最初の要求で会話の全文を送り、2回目からは、新しい発言と、直前の返事の番号だけを送ります。
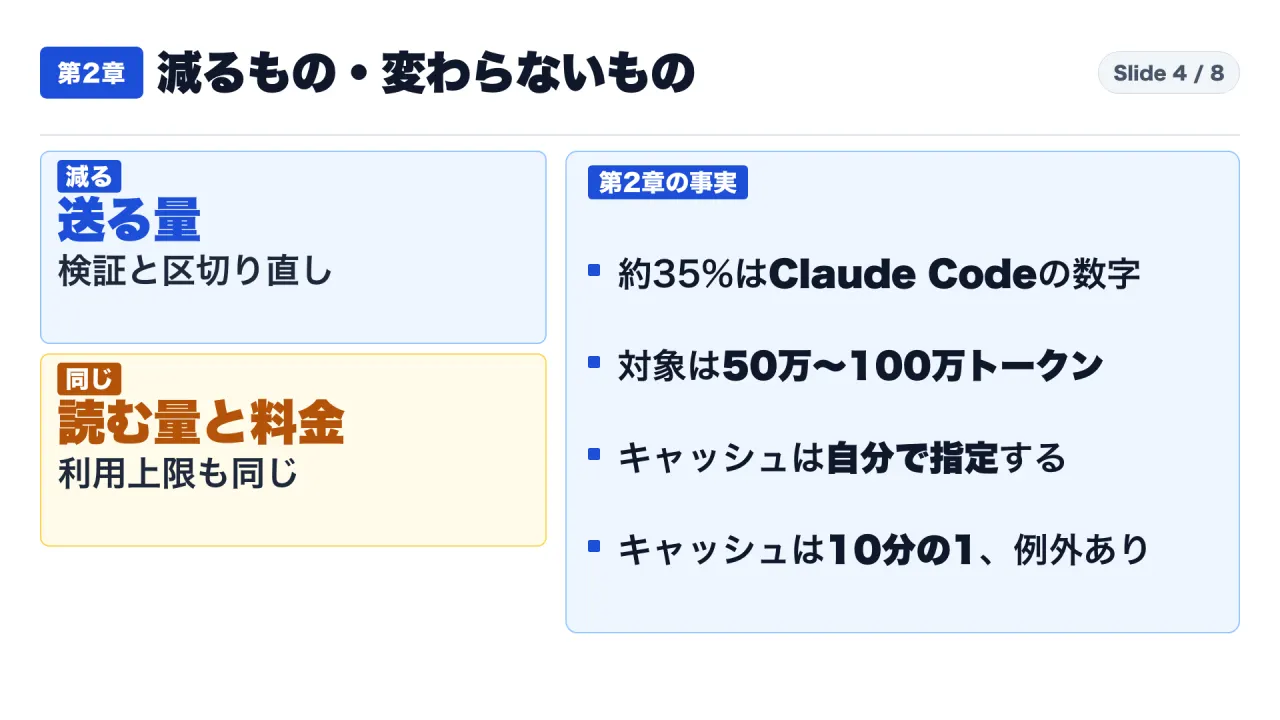
公式の記事が示す数字は1つです。Claude Codeの多くの利用者でメッセージスレッドを既定で有効にしている状態で、50万〜100万トークンの要求で、最初の返答までの時間(time to first token、以下では「応答開始までの時間」)の中央値が約35%縮んだ、というものです。測った期間、件数、比較の相手は、記事に書かれていません。
一方で、変わらないものがあります。Claudeは毎回、会話の全体を読むので、トークンの使用量は同じです。料金と利用上限も変わりません。スレッドは、プロンプトを自動でキャッシュしてくれる仕組みでもありません。プロンプトキャッシュは、これまでどおり自分で指定します。
そして、スレッドは最後の要求から5分で切れます。続けられないときは404のエラーが返り、理由は示されません。会話の写しを手元に持ち、全体を送り直す道筋を最初から作っておくことが、使う側の前提になります。
この記事は、長く動くエージェント(コードを書く、画面を操作する、文書を読み込むなど)を作っている人と、その導入を判断する人に向けて書いています。読み終えると、スレッドで何が速くなり、何が変わらず、使う前に何を準備すればよいかを、自分のシステムに当てはめて確認できます。
読み方:本文では「事実」「私の確認」「私の解釈」「確認できなかったこと」を分けます
この記事の一次資料は4つです。アンソロピックの記事と、Claudeの公式ドキュメントの3ページ(Message threads、リリースノート、Prompt caching)です。取得は2026年11月4日に行い、本文を文字に直した状態で、引用と数字を照合しました。原文は英語で、日本語は意訳です。
- 事実:原文に書かれていること。数字には、対象・単位・指標を添えます。
- 私の確認:取得した本文を読み、語で検索した結果です。「書かれていない」は、この範囲に限ります。
- 私の解釈:「私なりの解釈」「私の提案」と明記した部分です。断定ではありません。
- 確認できなかったこと:原典にたどり着けなかったものです。使いません。
この題材は、生成AIで作られた要約が出回りやすく、もっともらしい説明が原文と食い違っていることがあります。今回も、共有された要約のうち3点を、原文と合わないか原典を確認できないため外しました。どれを外したかは、後半の「制作の裏側」に書きます。
背景:エージェントは、なぜ毎回「全部」送っていたのか
公式ドキュメントは、スレッドがない場合、毎回の要求で会話の全体を送り直し、APIがその全体を確かめてトークンに区切り直す、と書いています。ここからは私の説明ですが、Claudeが前の発言を覚えているように見えるのは、アプリが毎回、それまでの発言を全部並べて送っているからです。
一問一答なら、これで困りません。困るのは、長く動くエージェントです。アンソロピックの記事は、コードを書くエージェントは1回の作業で何百回も要求を送ることがあり、そのたびに、それまでの発言と道具の結果をすべて送り直す、と書いています。会話が何十万トークンになると、全部を送り直すだけで、Claudeが答え始めるまでの時間が延びる、とも書いています。
身近なたとえで言うと、毎回の打ち合わせのたびに、過去の議事録の束を最初から全部コピーして持っていくようなものです。受け取る側は、その束を確かめ、並べ直してから、やっと今日の話を聞き始めます。束が厚くなるほど、話が始まるまでの時間が延びます。
第1章:仕組み。最初に全文を一度送り、あとは新しい分だけを送る
公式ドキュメントの説明を、手順に沿って整理します。
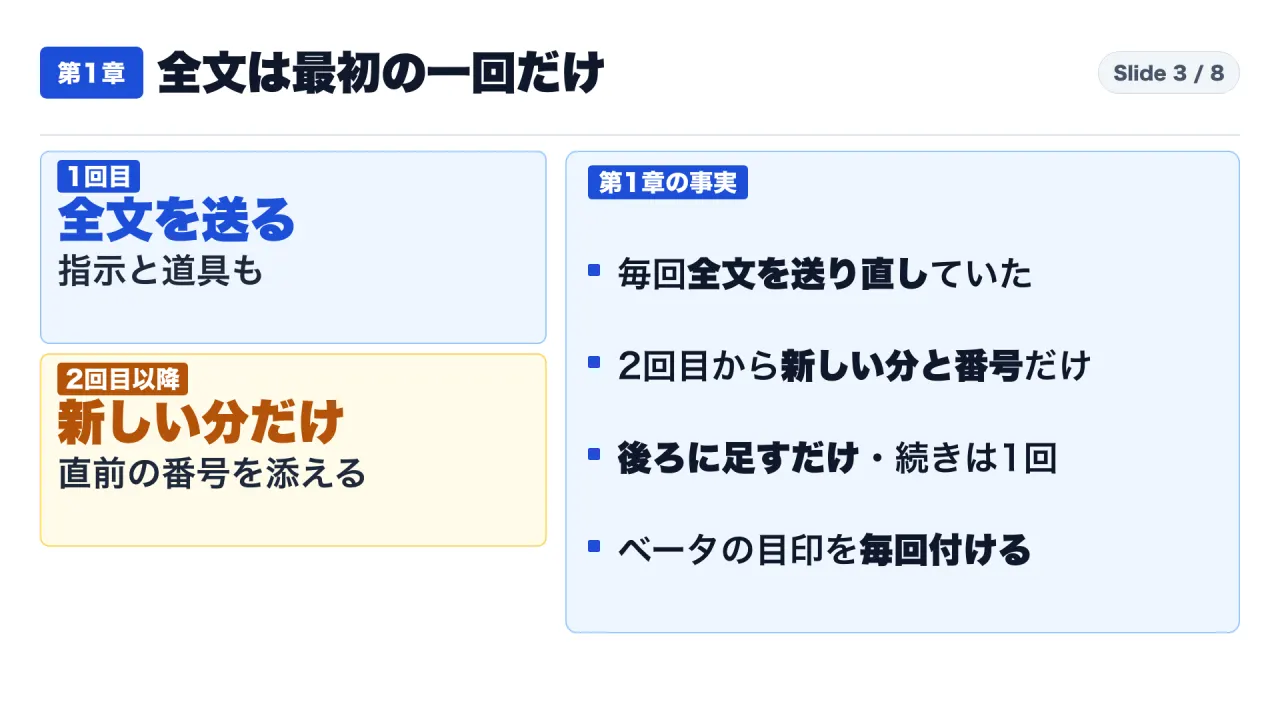
- 作る(create):最初の要求は、これまでどおり会話の全文、最初の指示(system)、道具の定義(tools)を送り、スレッドを作る指定を付けます。APIは、Claudeの返事も含めた会話を、その返事の番号(response id)の下に保存します。
- 続ける(continue):2回目からは、前の返事以降の新しい発言だけを送り、直前の返事の番号を添えます。最初の指示と道具の定義は送りません。スレッドが、最初の値を持ち続けます。
- 送り直す(replay):スレッドを続けられないときは、会話の全体を、新しく作る要求で送り直し、その返事の番号から続けます。
モデルを呼ぶ前に、APIが、保存した会話を組み立て直します。返ってくるのは、いつもの返事と同じ形です。
使うには、ベータ版の目印(beta header)を、スレッドのすべての要求に付けます。名前は message-threads-2026-08-12 です。SDKにはスレッドを扱う補助の道具があり、この目印も付けてくれます。
決まりも、いくつかあります。
- スレッドは、後ろに足すことしかできません。途中の発言を書き換えたり、枝分かれさせたりするときは、新しいスレッドを作ります。
- 1つの返事の番号から続けられるのは、1回だけです。常に、最新の返事の番号から続けます。
- 2回目以降に送った発言を、APIは保存済みの会話と照らし合わせません。同じ発言を送り直すと、会話に二重に入るか、エラーになることがあります。
- モデル、道具の選び方、思考の設定など、スレッドの中で変えられない項目があります。最初と違う値を送ると、400のエラー(
thread_fingerprint_mismatch)が返ります。
使える場所は、Claudeのプラットフォームのほか、Claude Platform on AWS、Claude in Microsoft Foundry、Claude Models on Google Cloud(Anthropic managed)です。
第2章:減るのは送る量と下ごしらえ。読む量、料金、キャッシュの仕組みは同じ
減るもの
公式ドキュメントは、減る仕事をこう書いています。スレッドがないと、毎回、会話の全体を送り直し、APIがその全体を確かめて、トークンに区切り直す。スレッドがあると、その仕事の大半は、新しい分だけで済む。
つまり、減るのは、通信で運ぶ量と、受付側の検証とトークン化の作業です。記事も、運ぶ文脈が大きいほど、応答開始までの時間を縮められる、と書いています。
約35%の条件
記事の数字は、条件ごと読む必要があります。
| 項目 | 記事の記述 |
|---|---|
| 対象 | Claude Codeの多くの利用者(スレッドを既定で有効にした) |
| 要求の大きさ | 50万〜100万トークン(原文は 500k to 1M) |
| 指標 | 応答開始までの時間(TTFT)の中央値 |
| 変化 | 約35%縮んだ |
| 書かれていないこと | 測った期間、要求の件数、比較の相手、短い会話での変化 |
ここから言えるのは、「Claude Codeで、50万〜100万トークンという非常に長い要求では、中央値で約35%」というところまでです。短い会話で同じだけ縮むとは、記事は書いていません。自分のアプリで同じ数字が出る保証にもなりません。
変わらないもの
- モデルが読む量:1回ごとの要求は小さくなりますが、Claudeは毎回、会話の全体を読みます。だから、トークンの使用量は同じだ、と記事は書いています。
- 料金と利用上限:スレッドは料金も利用上限も変えない、とドキュメントにあります。記事も、通常のトークン単価と既存の利用上限が適用される、と書いています。
- キャッシュの仕組み:ドキュメントは「スレッドが、プロンプトを代わりにキャッシュしてくれるわけではない」と書いています。プロンプトキャッシュは、スレッドがない場合と同じように動き、どこで区切るかは自分で決めます。毎回の分をキャッシュしたいなら、上位のキャッシュ指定(top-level の
cache_control)を、スレッドのすべての要求に付けます。1つの要求に付けられるキャッシュの区切りは、最大4つです。
キャッシュの値段の確認
共有された要約は、プロンプトキャッシュを「90%割引」と書いていました。キャッシュのドキュメントでは、キャッシュから読む分は基本の入力の0.1倍(10分の1)の値段です。ただし例外があり、Claude Opus 5.5とClaude Sonnet 5.5は0.05倍(20分の1)、Claude Fable 5.1とClaude Mythos 5.1は0.025倍(40分の1)です。「90%割引」は標準の倍率(0.1倍)の値で、Opus 5.5・Sonnet 5.5・Fable 5.1・Mythos 5.1の4つでは、割引がもっと大きくなります。
キャッシュに当たるには、区切りまでの文章と画像が、まったく同じである必要があります。
ここからは私の整理です。キャッシュは、同じ前置きを読み込む手間と値段を減らします。スレッドは、毎回送る量と、受付の下ごしらえを減らします。減らす場所が別なので、両方を組み合わせる設計がありえます。ドキュメントの例も、スレッドと上位のキャッシュ指定を一緒に使っています。
第3章:5分で切れる前提。会話の写しは自分で持ち、404なら全体を送り直す
期限と保存
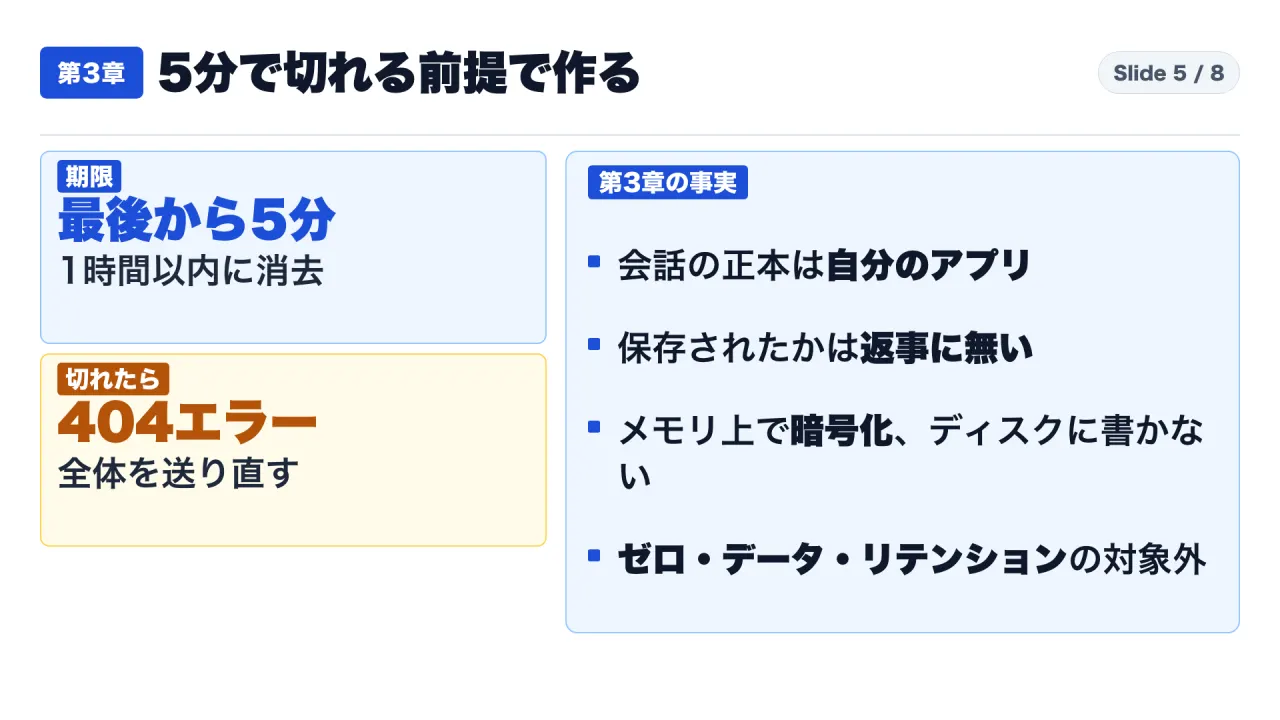
スレッドは「できる限り保つ」扱いです。最後の要求から5分で切れ、APIは最後に使われてから1時間以内にスレッドを消します。保存された返事があるたびに、5分は数え直しになります。
保存の扱いは、記事に「メモリの上に暗号化して置かれ、ディスクには書かれない」とあります。ドキュメントは、サーバー側の鍵で暗号化し、長く残す保存先には書かず、最後に使われてから1時間以内に消す、と書いています。一方で、データを保存しない契約(ZDR、ゼロ・データ・リテンション)の対象にはなっていません。スレッドを使っても、ほかのZDR対象の機能の扱いは変わらない、とも書かれています。
スレッドが持つのは、会話、最初の指示と道具の定義、変えられない項目の指紋です。ファイルは参照で持つので、スレッドを使っている間は、会話が使うファイルを消さずに置いておく必要があります。
続けられないとき
続けられないときは、主に404のエラー(thread_not_found)が返ります。また、応答の受信(ストリーム)が途中で切れて、同じ続ける要求を送り直したときに、400のエラー(thread_already_continued、thread_continue_in_flight)が返ることがあります。その場合、ドキュメントは、最新の返事の番号から続けるか、前の要求が終わるのを待ってその番号から続けるか、全体を送り直すように書いています。理由は返事に書かれません。ドキュメントが挙げる原因には、次のようなものがあります。
- スレッドの時間切れ
- 直前の回は返事が返ったが保存されなかった(例:道具の呼び出しが出力の上限で途中で切れた返事)
- 代わりのモデル(fallback)が直前の返事を書いた
- 直前の返事がまだ生成中
- 別の組織・ワークスペース、または作った人と別の利用者やサービスアカウントからの要求
- 保存済みの会話が受け付けられない内容を足した(例:画像のない会話に初めて画像を足す)
しかも、作るときも続けるときも、その回が保存されたかどうかは返事に書かれていません。次に続けようとしたときに分かります。だから、ドキュメントは、会話の正本は自分のアプリの側であり、すべての発言の写しを持ち、送り直す道筋を最初から作っておくように求めています。API側には、スレッドの一覧を見たり、中身を読んだり、消したりする手段がありません。
身近なたとえで言うと、窓口に書類を預けておけるのは5分だけ、という決まりです。預かり票が無効になったら、手元の控えから書類一式を出し直します。控えを持っていなければ、出し直せません。
断られた回と、使えない機能
返事が「拒否(refusal)」で終わったら、そのスレッドは続けません。APIが拒否した回をすでに持っているかもしれず、続ける要求ではそれを取り除けないためです。
使えない機能もあります。まとめて処理するバッチ(Message Batches)、トークンを数える機能、会話の要約(compaction)の機能、一部を除く文脈の編集(context editing)、医療情報の規制に向けた設定(HIPAA readiness)を有効にした組織、推論フック(Inference hooks)を有効にした組織です。会話を短くまとめたいときは、自分で要約を書き、その要約から新しいスレッドを作り直します。
SDKの補助
SDKの補助の道具は、続けられないエラー(thread_not_found など)が返ると、会話の全体を新しく作る要求で一度だけ送り直します。SDKのベータ版の道具の実行役(tool runner)も、既定でスレッドを使い、作るときに無効にできます。補助の道具は、会話の写しをメモリにだけ持ちます。プロセスを越えて会話を残すなら、自分で写しを保存する必要があります。
第4章①:モデルを途中で変えると、スレッドは作り直しになる
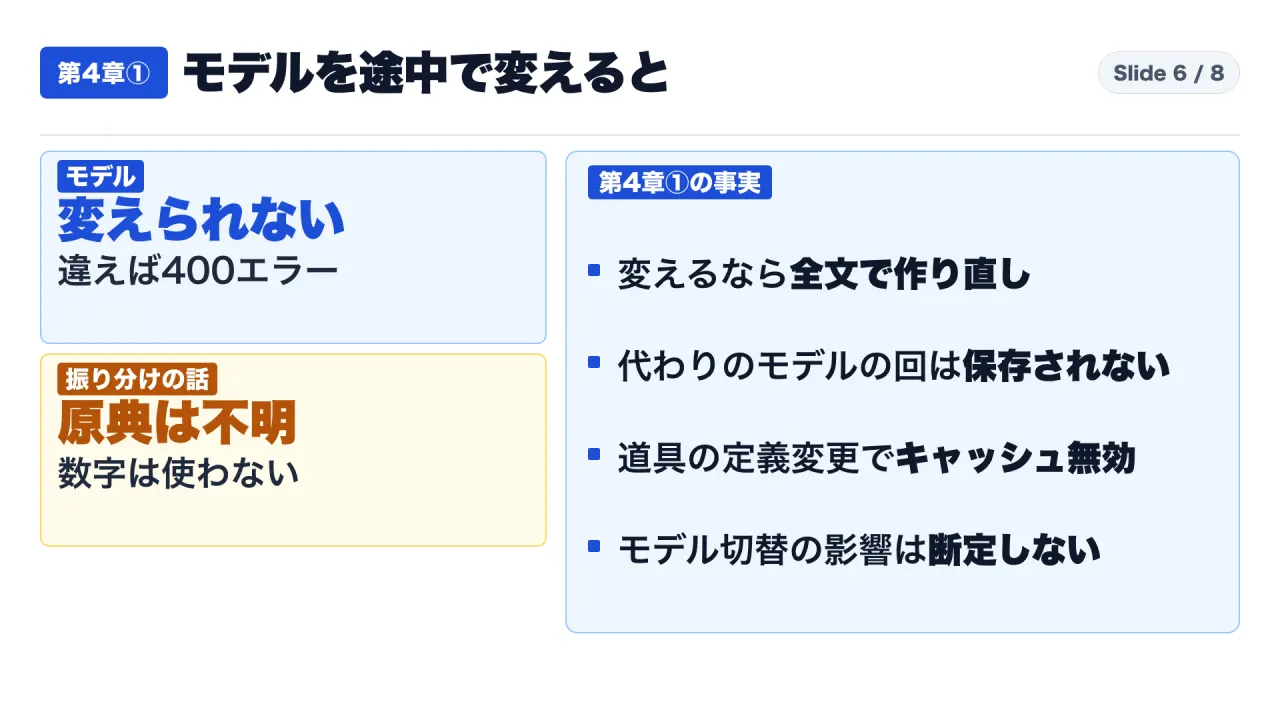
共有された要約には、「会話の途中で安いモデルと高いモデルを振り分けると、キャッシュが壊れ、振り分けない方が安くなることがある」という主張もありました。出典として示されたリンクは、開くと別の会社の404のページに転送され、原典を確認できませんでした。この主張と数字は使いません。
代わりに、スレッドのドキュメントに書かれていることを整理します。
- モデルは、スレッドの中で変えられない項目です。最初と違う値を送ると、400のエラーが返ります。
- 変えたいときは、新しい値で会話の全体を送り、新しいスレッドを作ります。
- 代わりのモデルに切り替わる機能(server-side fallback)を使う場合も、スレッドが持つモデルは1つなので、代わりのモデルが書いた回は保存されません。その返事の番号からは続けられません。
- 代わりのモデルへ回され続けると、毎回、会話の全体を送ることになるかもしれない、とも書かれています。
キャッシュのドキュメントは、道具の定義を変えるとキャッシュの全体が使えなくなる、と書いています。一方で、モデルを切り替えるとキャッシュが消える、という文は、私が読んだキャッシュのドキュメントの範囲にはありませんでした。キャッシュを消す変更の一覧にも、モデルは載っていません。ですから、この点は断定しません。
言えるのは、スレッドの途中でモデルを変えると、全文の送り直しになる、というところまでです。料金が上がるかどうかは、自分のアプリの数字で確かめる必要があります。
第4章②:【私なりの解釈】使う前に、写しと送り直しの道筋を作る
ここからは、事実ではなく、私なりの解釈です。
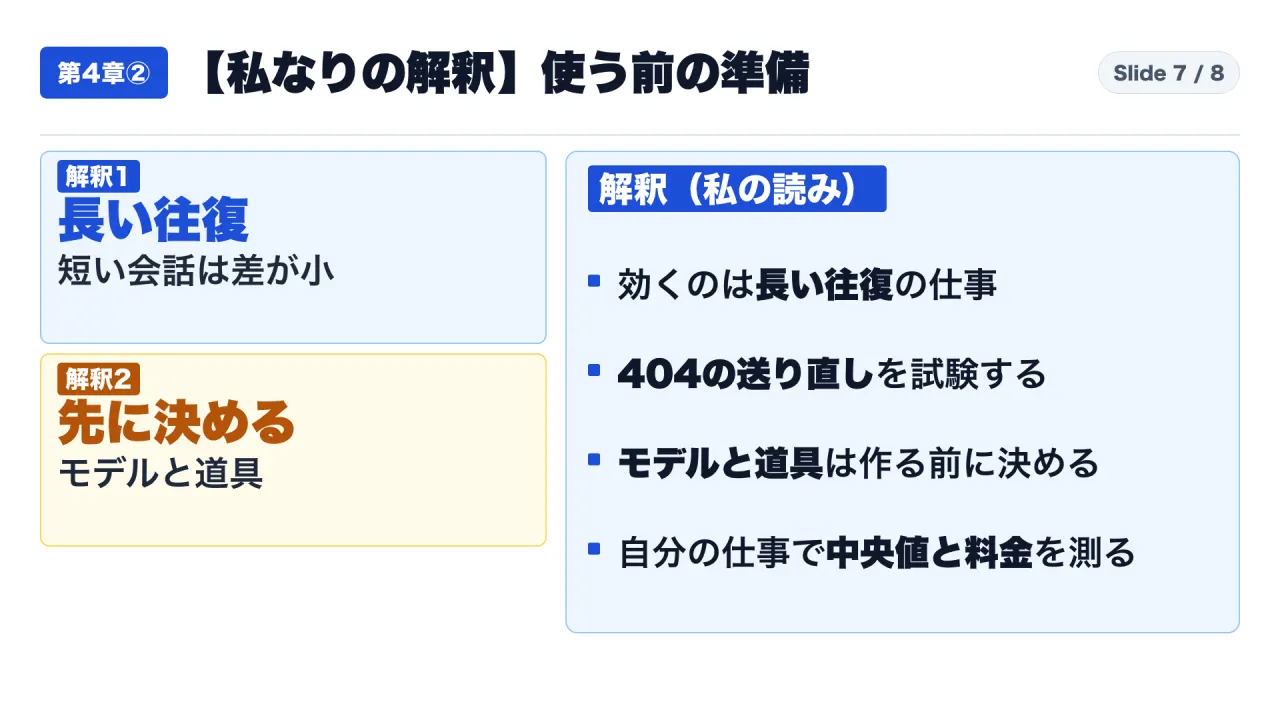
- 効くのは、長い会話を何度も往復する仕事です。道具を何十回も呼ぶエージェントや、画面の画像を何度も送る操作が候補です。記事も、コードを書くエージェント、画面を操作するエージェント(画像がスレッドに残り、毎回送り直さなくてよい)、文書や画像の多い作業を挙げています。短い一問一答では、差は小さいと考えます。
- 送り直しの道筋を先に作ります。404を受けたら、手元の写しから全体を送る。これを試験環境で、わざと起こして確かめます。
- モデルと道具は、スレッドを作る前に決めます。途中で変えると作り直しです。モデルの振り分けを使うなら、スレッドの区切りに合わせます。
- 自分の仕事で測ります。スレッドを使う場合と使わない場合で、応答開始までの時間の中央値と、料金を比べます。約35%はClaude Codeの数字で、自社の保証になりません。
言えないことも並べます。自社の会話でどれだけ早くなるのかは、公開された数字からは言えません。約35%をどう測ったのかは、記事に方法がないので言えません。データを保存しない契約が必要な組織でどう使うべきかは、この記事では評価していません。
結論:使う前に、会話の長さ、写しと送り直し、変えない項目の3つを確かめる
メッセージスレッドで減るのは、毎回送る量と、受付側の下ごしらえです。モデルが読む量、料金、利用上限は変わりません。キャッシュは、これまでどおり自分で指定します。約35%は、Claude Codeの、50万〜100万トークンの要求での中央値です。スレッドは、5分で切れる前提です。
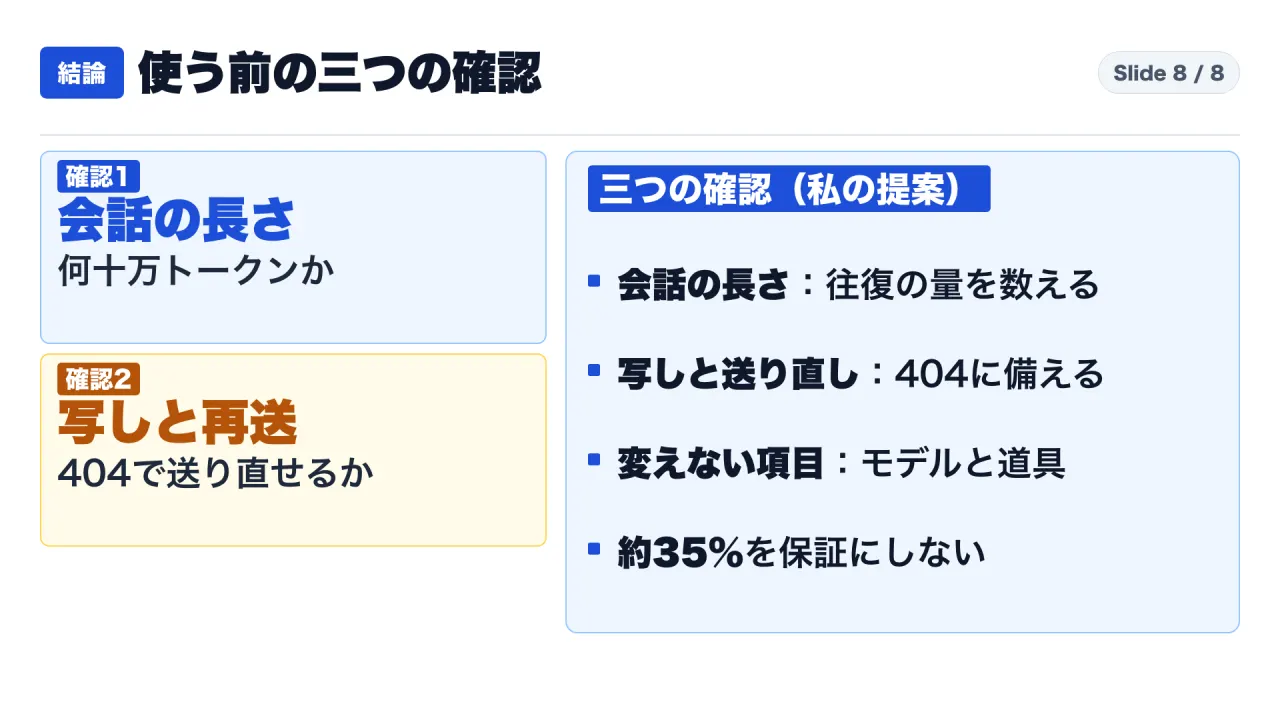
使う前の確認は3つです。これは私の提案です。
- 会話の長さ:何十万トークンの往復があるか。
- 写しと送り直し:404を受けたとき、全体を送り直せるか。
- 変えない項目:モデルと道具を、作る前に決めているか。
補足:自社で測るときの手順の例(私の提案)
公開された数字は他社の1製品のものなので、導入を判断するなら、自分の作業で測るのが確実です。次は手順の例です。
- 対象を決める:会話が長くなる作業を1つ選びます(例:同じリポジトリで道具を数十回呼ぶ修正作業)。
- 条件をそろえる:同じモデル、同じ最初の指示、同じ道具、同じキャッシュの指定で、スレッドあり・なしの2通りを用意します。
- 測る指標を決める:応答開始までの時間の中央値、要求1回あたりの送信量、トークンの使用量、料金です。トークンの使用量と料金は、スレッドの有無で変わらないはずなので、変わったら設定の違いを疑います。
- 失敗を起こす:5分以上の間を空けた要求や、モデルの変更を試験で起こし、404や400が返ったときに、手元の写しから送り直せることを確かめます。
- 記録を残す:会話の長さの分布ごとに結果を分けます。短い会話と長い会話を平均でまとめると、効果が見えにくくなります。
よくある疑問に、公開資料の範囲で答えます
Q. スレッドを使えば、料金は安くなりますか。 A. 料金と利用上限は変わらない、とドキュメントにあります。Claudeは毎回会話の全体を読むので、トークンの使用量も同じです。値段を下げたいなら、プロンプトキャッシュの指定を別に考えます。
Q. スレッドを使えば、キャッシュは自動で効きますか。 A. 効きません。ドキュメントは、スレッドがプロンプトを代わりにキャッシュしてくれるわけではない、と書いています。キャッシュの指定は、スレッドのすべての要求に自分で付けます。
Q. 会話はサーバーにずっと残りますか。 A. 残りません。最後の要求から5分で切れ、最後に使われてから1時間以内に消されます。長く使う会話の写しは、自分の側で持ちます。
Q. 途中でモデルを変えられますか。 A. 同じスレッドの中では変えられません。違う値を送ると400のエラーになります。変えるなら、会話の全体を送って新しいスレッドを作ります。
制作の裏側:共有された要約から外したもの
この記事のもとになった要約には、原文と合わないか、原典を確認できない部分がありました。
- 「サーバーがセッションの状態とKVキャッシュを持つ」:スレッドのドキュメントは、スレッドがプロンプトをキャッシュしてくれるわけではない、と書いています。キャッシュの説明としては使いませんでした。
- 「プロンプトキャッシュで90%割引」:90%割引は標準の倍率(0.1倍)の値で、4つのモデルでは0.05倍か0.025倍です。倍率で書き直しました。
- 「途中でモデルを振り分けるとキャッシュが壊れ、振り分けない方が安い」:出典のリンクが別の会社の404のページへ転送され、原典を確認できませんでした。使っていません。
- 「エージェントの枠組み(Agent Framework)とハーネス(Agent Harness)の違い」を論じたとされる記事:検索で見つからず、示されたURLも題名と合わなかったため、使っていません。
- 「MCPの完全ステートレス化の回の続き」という説明:この番組に該当する回が見つからず、外しました。
出典一覧
- S1:アンソロピックの記事「Make long-running agents faster with message threads」(2026年11月2日):https://claude.com/resources/articles/message-threads
- S2:Claude公式ドキュメント「Message threads」:https://platform.claude.com/docs/en/build-with-claude/message-threads
- S3:Claude公式ドキュメントのリリースノート(2026年11月2日の項):https://platform.claude.com/docs/en/release-notes/overview
- S4:Claude公式ドキュメント「Prompt caching」:https://platform.claude.com/docs/en/build-with-claude/prompt-caching
初めての方へ:このチャンネルと記事の自己紹介は、こちらにまとめています。https://note.com/consuloji_ch/n/n1975ecc3cf48
#Claude #AIエージェント #メッセージスレッド #プロンプトキャッシュ #API設計 #一次資料