DeepSeekが公開したのは何か? GitHubから読むエンジンの範囲
YouTubeポッドキャスト本編(動画・音声)はこちら:DeepSeekが公開したのは何か? GitHubから読むエンジンの範囲と、含まれない3つの部品
https://www.youtube.com/@consuloji
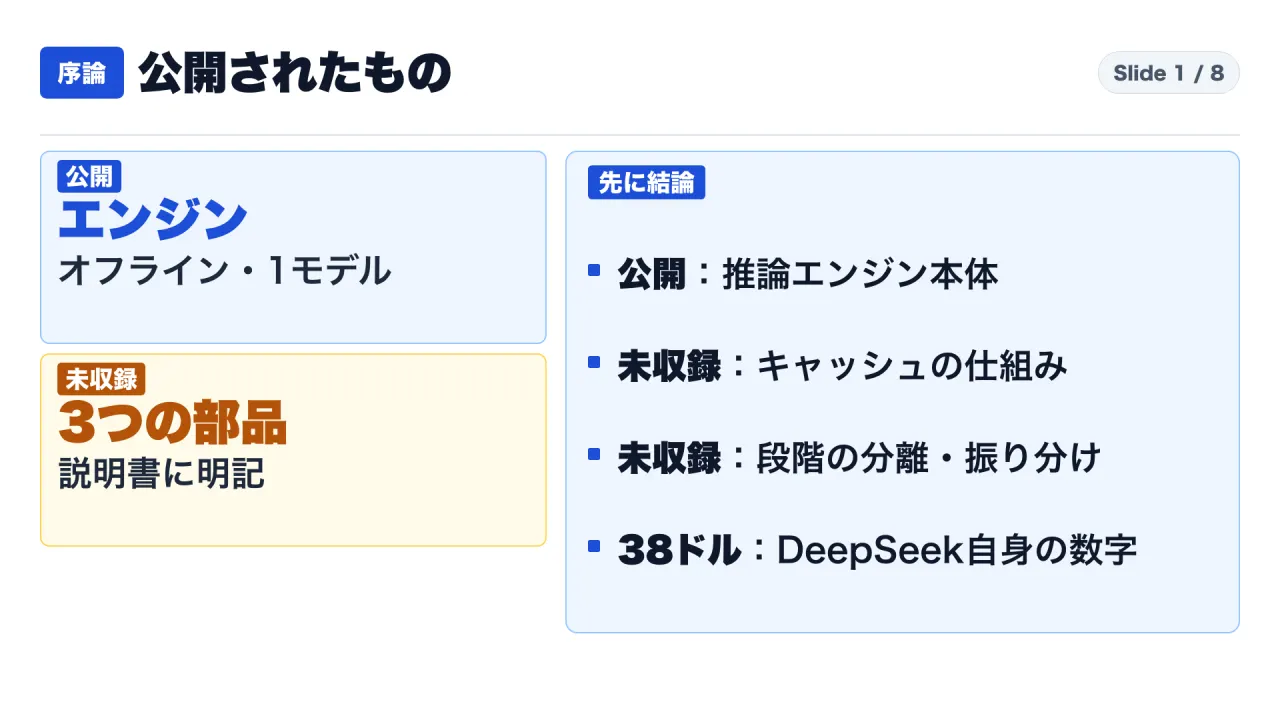
最初に答え:公開されたのはオフラインの推論エンジン。本番の3つの部品はこのリリースに含まれない
この記事は、自社やクラウドで公開されたAIモデルを動かしている推論基盤のエンジニアの方、とくにディープシーク(DeepSeek)が公開した推論エンジン「DeepInfer」に乗り換えるか、現行の「vLLM」などを使い続けるか判断したい方に向けたものです。
先に結論を書きます。
- 公開されたもの: 2026年10月20日に最初のコミットが記録された「DeepInfer」は、1つのモデル(DeepSeek-V4.1-Flash)を、2種類の機材(NVIDIA SM100世代GPU、Huawei Ascend 950)で動かすオフラインの推論エンジンです(DeepInferの説明書、最初のコミット記録)。
- このリリースに含まれないもの: 説明書(README)は、本番のオンラインサービスに必要だがこのリリースに含まれない部品として、**(1)キーバリューキャッシュ(KV-cache)の仕組み、(2)ビジョン・プリフィル・デコードの分離(Disaggregation)、(3)レプリカ間の負荷の振り分け(Load Balancing)**の3つを明記しています(DeepInferの説明書)。
- 「GPU1時間38ドル」の意味: 推論配備の質疑応答(Q&A)にある「1日155兆トークン」「GPU1時間あたり全体で38ドル(オフピーク価格で)」は、ディープシーク自身の本番クラスタの数字です。エンジン単体を入れただけで出る数字ではありません(推論配備の質疑応答)。
- 公開エンジンとの差: vLLMのチームは2026年10月23日のブログで、ディープシークの設定(文脈128Kトークン、バッチサイズ8〜256)にそろえたデコード性能はDeepInferと6%以内だったと報告しています。ただし、DeepInfer側の値はREADMEのグラフからの読み取りで、測ったのはvLLM側です(vLLMのブログ)。
以下では、ディープシークのGitHubリポジトリ、Hugging Faceのモデルカード、公式API料金表、vLLMの公式ブログ、および周辺オープンソースの説明書・脆弱性データベース(NVD)をもとに、書かれている事実と、書かれていないこと、そして私の解釈を分けて整理します。売買や投資の判断は扱いません。
前提の整理と全体の見取り図:なぜ原文との照合が必要だったのか
今回の記事をまとめるきっかけは、DeepInferの公開されていない本番基盤を分析した下調べの資料でした。
制作の裏側として、その資料に出てくる数字をディープシークの原文(README、推論配備Q&Aの10月21日版と11月3日更新版、モデルカード)と1つずつ照合したところ、原文と一致する数字が多い一方で、原文に見つからない数字や、前提の異なる数字をつないだ計算が混ざっていました。
| 下調べ資料にあった記述 | 一次資料(原文)との照合結果 | この記事での扱い |
|---|---|---|
| キャッシュヒット率「96%」 | DeepInferのREADME、推論配備Q&A(10月21日版・11月3日版)、モデルカード、vLLMブログのいずれにも記載なし。2025年2月のV3/R1資料にあるのは「56.3%」(2025年2月の推論システム概要) | 使わない(原文で確認できないため) |
| GPU1時間あたり売上が「約12.91ドルから38ドルへ約3倍」 | 2025年2月の約12.91ドルは「全トークンをR1価格で課金したと仮定した理論値」(560,658ドル ÷ 43,432 GPU時間)。今回の38ドルは「オフピーク価格で数えた売上」。前提が異なる(2025年2月の推論システム概要、推論配備の質疑応答) | 倍率を作らない(それぞれの前提を併記する) |
| SWA KVキャッシュを「128トークン境界ごとに約1.42MB保存」 | 推論配備Q&Aの記述は「1つの系列(sequence)につき1回分だけホストメモリに保持し、1系列あたり約1.4MB」。128トークン境界は「プレフィックスキャッシュのブロック単位」の記述(推論配備の質疑応答) | 原文どおり「1系列につき1回分で約1.4MB」に修正 |
ここから先は、次の3つの問いに沿って進めます。
- 何が公開され、何が含まれないのか(第1章)
- GPU1時間38ドルは、何を数えた数字か(第2章)
- 含まれない部品は本番でどう動いており、ほかの公開ソフトとどう比べるか(第3章・第4章)
第1章:公開されたDeepInferの範囲と、動かすモデルの仕様
1-1. DeepInferの説明書(README)に書かれていること
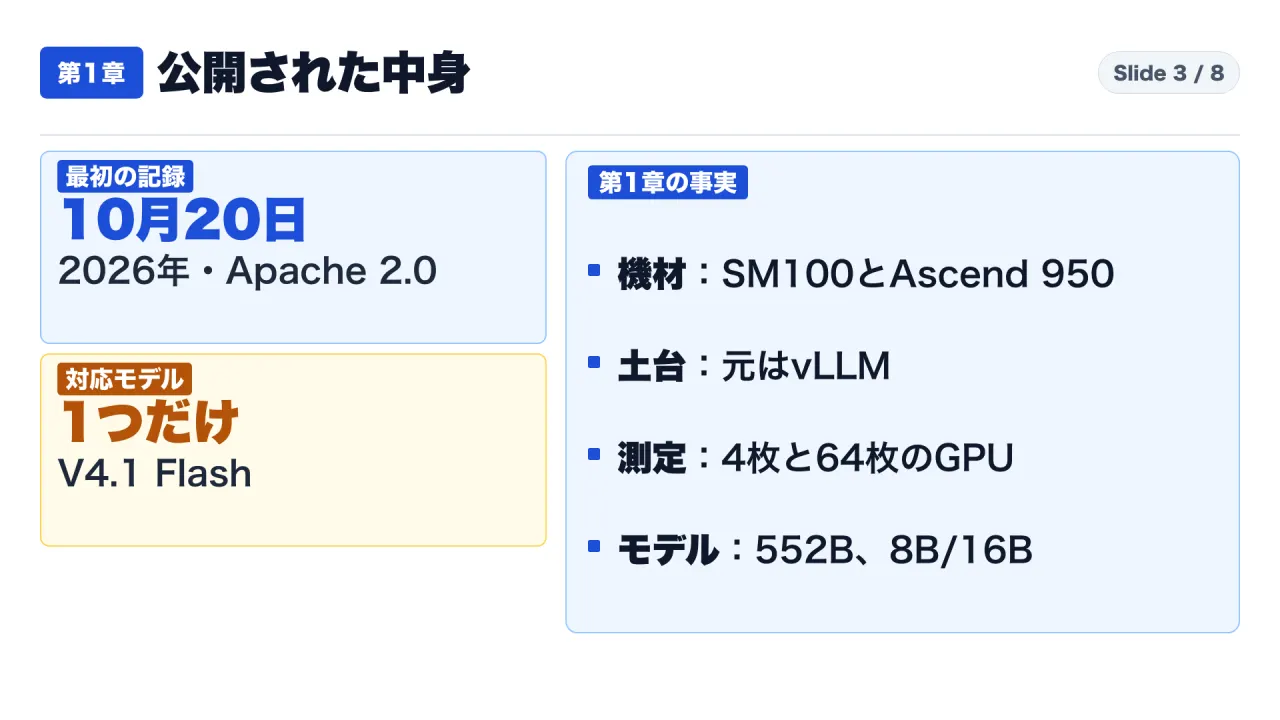
ディープシークのGitHubリポジトリ「deepseek-ai/DeepInfer」の最初のコミットは2026年10月20日、ライセンスはApache 2.0です(最初のコミット記録、DeepInferの説明書)。
説明書の冒頭には、次の2文が並んでいます。
- DeepInferは、ディープシークの大規模な本番サービスを動かす推論エンジンである。
- この公開リリースは、オフラインの推論(offline inference)を提供する。
ここでの「オフラインの推論」とは、利用者からのHTTPリクエストをリアルタイムに受け付けて振り分けるオンラインの配信基盤ではなく、手元のスクリプトからモデルを呼び出してまとめて推論を実行する形態を指します。
説明書が明記している対応範囲は次のとおりです(DeepInferの説明書)。
- 対応モデル:
DeepSeek-V4.1-Flash(1モデルのみ) - 対応ハードウェア:
- NVIDIA SM100世代 GPU(Blackwell世代)
- Huawei Ascend 950
- 開発の土台: もともと vLLM を主な土台(primarily based on vLLM) として構築された
- 性能グラフの測定構成: プリフィル(入力の読み込み)に4 GPU、デコード(1語ずつの生成)に64 GPU(Wide EP構成)
また、関連部品として、チャットのリクエスト構造とトークン列を相互変換するRust/Python製のライブラリ「deepseek-recipe」も2026年10月19日に公開されています(deepseek-recipeの説明書、最初のコミット記録)。
1-2. 対象モデル「DeepSeek-V4.1-Flash」と「1017」の仕様
DeepInferが動かすモデルの仕様を、Hugging Faceのモデルカードから確認します(DeepSeek-V4.1-Flashのモデルカード、DeepSeek-V4.1-Flash-1017のモデルカード)。
| 項目 | モデルカードの記載値 | 出典 |
|---|---|---|
| 骨格の総パラメータ数 | 552B(5520億) | DeepSeek-V4.1-Flashのモデルカード |
| 1トークンあたり活性パラメータ数 | プリフィル時 8B(80億) / デコード時 16B(160億)(Asymmetric MoE) | 同上 |
| 文脈長(コンテキスト長) | 最大 1M(100万)トークン | 同上 |
| 重みのライセンス | MIT License | 同上 |
| 全体のKVキャッシュ量 | 890 bytes / token(前世代Flash比で約4分の1に削減) | 同上 |
| パスの構成(5+1ハイブリッド) | 5つのSWA(Sliding Window Attention:ウィンドウ幅512トークン)パス+1つのフルアテンションパス | 同上 |
| 永続化するKVキャッシュ量 | フルアテンション層のみを保存するため、前世代Flash比で約8分の1 | 同上 |
| 既定の重み(1017版) | DeepSeek-V4.1-Flash-1017 は V4.1-Flash のマイナーアップデート版 |
DeepSeek-V4.1-Flash-1017のモデルカード |
この章で確かめる点(私の提案): 自社の推論環境にあるGPUが「NVIDIA SM100世代」または「Huawei Ascend 950」であり、かつ動かしたいモデルが「DeepSeek-V4.1-Flash」かどうかを最初に確認します。どちらにも当てはまらない場合、公開されたDeepInferはそのままでは対象外です。
第2章:「GPU1時間38ドル」と「1日155兆トークン」は何を数えた数字か
2-1. 推論配備Q&Aに書かれた本番クラスタの数字
ディープシークがDeepInferリポジトリ内の doc/inference_deployment_qa.md で公開した質疑応答には、本番の推論クラスタについて次の記述があります(推論配備の質疑応答)。
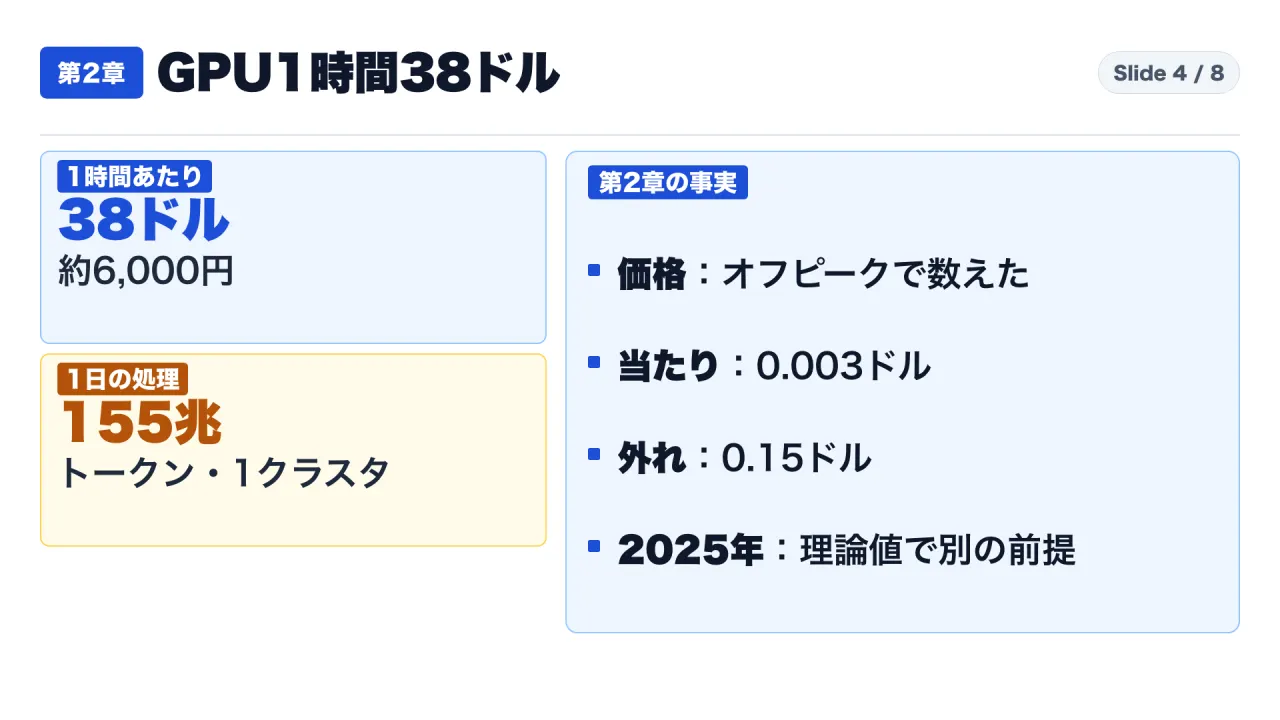
- 処理量: 1つのクラスタで 1日あたり155兆(155T)トークン を処理している
- GPU時間あたり売上: 全体で 1 GPU時間あたり38ドル(オフピーク価格で:at off-peak pricing) の売上を生んでいる
2026年10月30日時点の米連邦準備制度理事会(FRB)H.10統計の参考レート(1ドル=157.47円)で換算すると、38ドルは**1 GPU時間あたり約5,984円(約6,000円、私の計算)**です(FRB H.10為替統計)。
2-2. 公式API料金表における「オフピーク価格」と「キャッシュ50倍差」
「オフピーク価格で」という括弧書きの意味を、ディープシークの公式API料金表(pricing.md)で確かめます(DeepSeek APIの料金表)。
料金表では、標準時間帯(Standard)とオフピーク時間帯(Off-Peak:料金は標準の半分)に分けて、100万トークンあたりの単価が定められています。
| 項目(100万トークンあたり) | 標準価格(Standard) | オフピーク価格(Off-Peak) | キャッシュ外れ/当たりの倍率(私の計算) |
|---|---|---|---|
| 入力(キャッシュヒット) | $0.006 | $0.003 | 基準(1倍) |
| 入力(キャッシュミス) | $0.30 | $0.15 | 50倍($0.15 ÷ $0.003) |
| 出力(デコード) | $1.50 | $0.75 | — |
入力トークンがキャッシュに当たった場合($0.003 / 1M tokens)と外れた場合($0.15 / 1M tokens)で、利用者への課金単価には50倍の差があります(私の計算)。
2-3. 2025年2月の公表値と単純比較できない理由
ディープシークは2025年2月の「Open Source Week Day 6」で、前世代(V3/R1)の24時間の推論統計を公開しています(2025年2月の推論システム概要)。
- 24時間の平均稼働GPU数:226.75ノード × 8枚 = 1,814枚(総GPU時間:約43,432 GPU時間)
- ディスクKVキャッシュのヒット率:56.3%(入力608Bトークンのうち342Bトークン)
- 24時間の理論上の総売上:560,658ドル(全トークンに当時のR1の価格を適用したと仮定した理論値)
- 同じ資料の注記:「無料枠やオフピーク割引などがあるため、実際の売上はこれよりかなり少ない(substantially lower)」
560,658ドルを43,432 GPU時間で割ると、**1 GPU時間あたり約12.91ドル(私の計算)**になります。しかし、この「約12.91ドル」は全トークンを高単価モデルで課金したと仮定した理論値であり、今回の「38ドル」はオフピーク価格で換算した値です。計算の前提が異なるため、この記事では「何倍になった」という比率は作りません。
この章で確かめる点(私の提案): 他社やベンチマークの「GPU1時間あたり売上(またはコスト)」を見るときは、どの価格表(ピークかオフピークか、キャッシュヒットを含むか)で、どの範囲のGPU(プリフィル・デコード・ストレージを含む全体か、単一ノードの試験か)を分母にした数字かを横に書き出します。
第3章:含まれない3つの部品と、約100PBの記憶置き場・2つの振り分け役
3-1. リリースに含まれない3つの部品と非公開の理由
DeepInferの説明書(README)は、「本番のオンラインサービスには不可欠だが、このリリースには含まれないもの」として次の3つを挙げています(DeepInferの説明書)。
- KV-cache system(キーバリューキャッシュの仕組み)
- Vision / Prefill / Decode disaggregation(画像処理・プリフィル・デコードの分離)
- ※説明書は「分離に必要な機能の大半はすでにDeepInfer側に実装されている(most of the required features are already implemented in DeepInfer)」と補足しています。
- Load balancing across replicas(複製されたレプリカ間の負荷の振り分け)
なぜ(1)と(3)が公開されていないのかについて、説明書は「KVキャッシュ管理とクラスタの負荷分散は社内のインフラと強く結び付いているため、完全なコードはまだ公開していない(Because KV-cache management and cluster load balancing are tightly coupled with our internal infrastructure, we have not yet released the full code)」と理由を明記しています。代わりに、その設計を説明する文書として doc/inference_deployment_qa.md(推論配備の質疑応答)が同梱されました。
3-2. 推論配備Q&Aに書かれた3階層の記憶置き場と保持期間
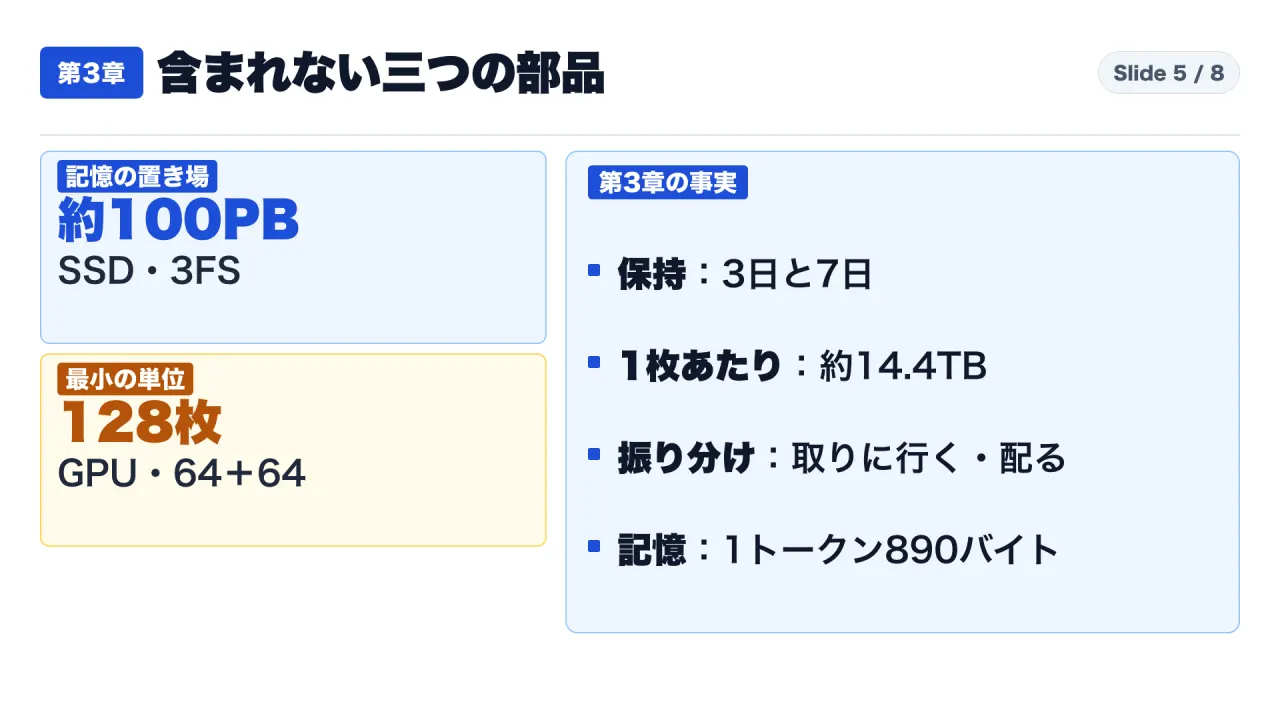
推論配備の質疑応答によると、ディープシークの本番環境ではKVキャッシュの置き場を3つに分けています(推論配備の質疑応答)。
| 階層 | 置くデータ | 容量・規模の記載 |
|---|---|---|
| 第1層:GPU HBM | いま処理しているバッチのKVキャッシュ | 各GPUのHBM内 |
| 第2層:ホストDRAM | SWA(短い範囲を見る層)のKVキャッシュ。128トークン境界をまたぐ再開用に1系列(sequence)につき1回分だけ保持 | 1系列あたり約1.4MB |
| 第3層:専用3FSストレージクラスタ(SSD) | フルアテンション層のプレフィックスKVキャッシュ(128トークン単位のブロック) | クラスタ全体で 約100PB(ペタバイト)のNVMe SSD。GPU1枚あたり論理容量で 約14.4TB。ストレージノード1台あたり 30.73TB SSD × 20本 を推奨 |
注目すべきは、第3層(3FS SSDクラスタ)におけるKVキャッシュの**保持期間(Retention)**です。質疑応答は次のように記しています(推論配備の質疑応答)。
- エージェントのワークロード: 3日間(3 days)
- チャットのワークロード: 7日間(7 days)
- 設計上の目標: 本番のトラフィックで測った「プレフィックス再利用の時間間隔(prefix reuse interval distribution)」に基づき、72時間を超える保持を目標に設計した
モデル側で永続化対象のKVキャッシュを前世代比約8分の1に削り(第1章)、それを約100PBのSSDクラスタに3〜7日間残すことで、エージェントや長期の対話が数時間〜数日後に続きを送ってきたときにも、プリフィルの再計算を省く作りになっています。
3-3. プリフィルとデコードで異なる「2つの振り分け役」と最小単位
負荷の振り分け(スケジューリング)も、プリフィルとデコードで方式が分けられています(推論配備の質疑応答)。
- プリフィル側(Pull型): 各ワーカーが自分の残り処理時間(estimated remaining processing time)を見積もり、手が空きそうになったら自分で次のリクエストを取りに行く(pull)。
- デコード側(中央Push型): 中央のスケジューラが、各インスタンスの**リクエスト数とKVキャッシュ長の合計(total KV-cache length)**が均等になるように割り振る。
- 最小の効率的な配備単位: プリフィル 64 GPU + デコード 64 GPU(合計 128 GPU、私の計算)。
この章で確かめる点(私の提案): 自社の推論クラスタが、プリフィル64枚+デコード64枚(計128枚)の単位に届くかどうかを確認します。届かない規模であれば、ディープシークの大規模分離構成をそのまま模倣するのではなく、単一ノードまたは小規模な構成から検討するのが現実的です。
第4章:vLLM・周辺オープンソースとの比較と、私の解釈・明日できること
4-1. vLLM公式ブログ(10月23日)の比較を条件付きで読む
新しい推論エンジンの公開にあたって最も比較される相手は、DeepInfer自身の土台でもある vLLM です。vLLMチームは2026年10月23日に、同じモデル(DeepSeek-V4.1-Flash)を動かした比較ブログを公開しました(vLLMのブログ)。
このブログの数字を読むときは、何をそろえ、何が違うかを分けて読む必要があります。
| 比較項目 | vLLMブログの記載内容 | 読むときの注意点(条件の違い) |
|---|---|---|
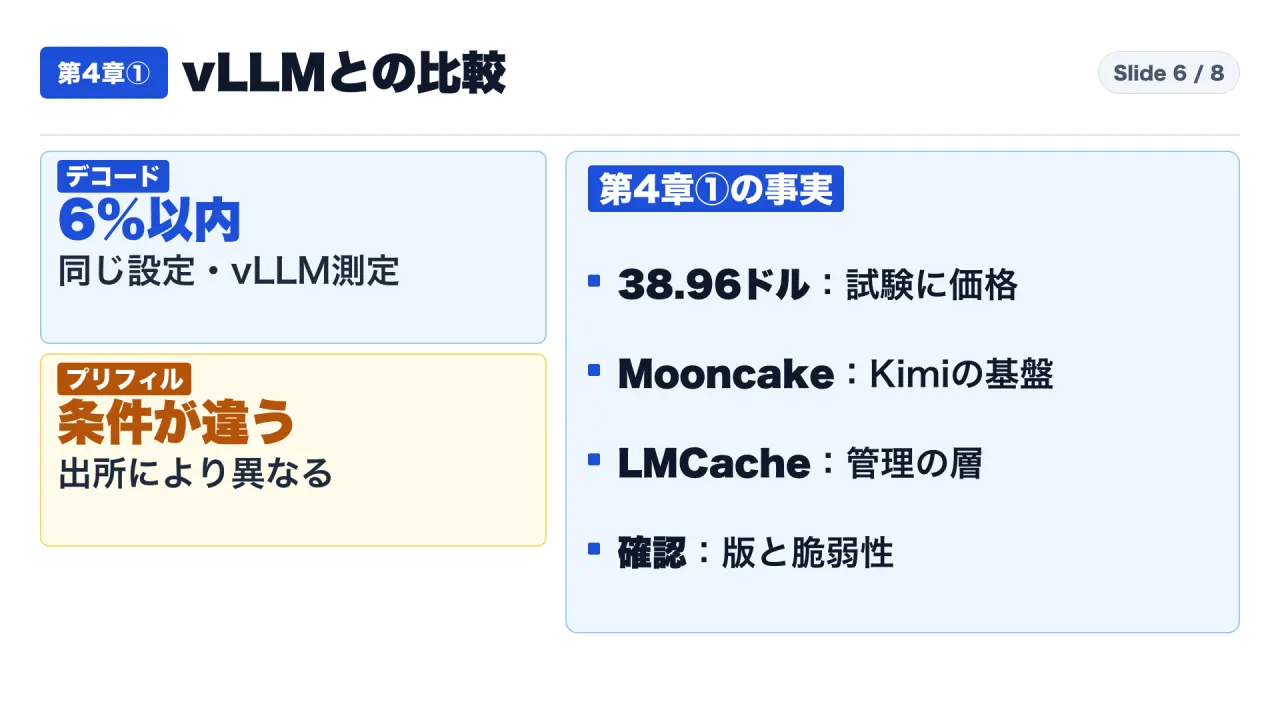
| デコード性能の比較 | ディープシークの設定(文脈長128Kトークン、バッチサイズ8〜256)にそろえて測定した結果、vLLMはDeepInferの6%以内 | DeepInfer側の数値はvLLMチームが実測したものではなく、DeepInferのREADMEのグラフから読み取った値(extracted from DeepInfer’s README plots)。測定主体はvLLM側 |
| なぜ差が小さいのか | ブログの説明:「両プロジェクトが互いに深く土台を借り合っているため(deep cross-pollination between the two projects)」 | DeepInferのREADMEも「もともとvLLMを主な土台に作った」と記載している |
| プリフィル性能の比較 | ブログ自身が「プリフィルは文脈長や設定が異なるため、直接のエンジン速度比較(apples-to-apples engine speed comparison)とは解釈すべきでない」と明記 | 条件が異なるため、この記事でもプリフィルの優劣は出所により異なるとして順位を付けない |
| GPU1時間あたり「$38.96」 | ベンチマーク構成(1P1D:プリフィル32 GPU+デコード64 GPU)の性能に、ディープシークのオフピーク価格を当てはめた試算値 | 性能試験の出力に価格を掛けた試算であり、ディープシーク本番クラスタ全体の「$38」とは測定対象が異なる |
4-2. 足りない3つの部品を埋める公開ソフトウェアと脆弱性の確認
DeepInferに含まれない「KVキャッシュ管理」「段階の分離」「負荷の振り分け」を扱う公開ソフトウェアとして、よく名前が挙がる3つのプロジェクトについて、それぞれの説明書(README)が自ら述べている役割だけを整理します。
- Mooncake(
kvcache-ai/Mooncake): チャットサービス「Kimi」の推論基盤として開発された、KVキャッシュ中心(KVCache-centric)の分離型推論プラットフォーム(Mooncakeの説明書)。 - LMCache(
LMCache/LMCache): 特定のエンジンやベンダーに縛られず、KVキャッシュをGPU・CPUメモリ・ディスク間で保持・共有するKVキャッシュ層(LMCacheの説明書)。 - vLLM Production Stack(
vllm-project/production-stack): vLLMの上に、プレフィックス認識型のルーティング(負荷分散)やKVキャッシュの退避を組み合わせた参照実装(vLLM Production Stackの説明書)。
これら3つとディープシークの社内基盤(3FS+社内スケジューラ)を同一の機材・文脈長・トラフィックで横並び比較した一次資料は、私が探した範囲では見つかっていません。したがって優劣の順位は付けません。
なお、外部の部品を組み合わせる際はセキュリティ記録の確認も欠かせません。たとえばMooncakeの転送エンジン(Transfer Engine)には、米国NVDに公開された脆弱性 CVE-2026-103761(CVSS 7.5 High)の記録があります(NVDのCVE-2026-103761記録)。
- 内容: 0.3.12以前の版のRPCサーバにおいて、攻撃者が大きなサイズ値を送ることで、認証なしにメモリ枯渇(Out-of-Memoryによるサービス停止)を引き起こせる問題。
- 修正記録: 2026年11月3日に公開された v0.3.14 のリリースノートに、バッチサイズの上限チェックを追加した修正(
Fix potential OOM issue in RPC server by adding batch size limit check)が記録されています(Mooncake v0.3.14の変更履歴)。そのほかの弱点まで解消されているかは、このリリースノートだけでは確認できません。
私なりの解釈と、明日できる確認手順
ここからは事実の引用ではなく、一次資料を読んだ上での**私なりの解釈(断定ではありません)**です。
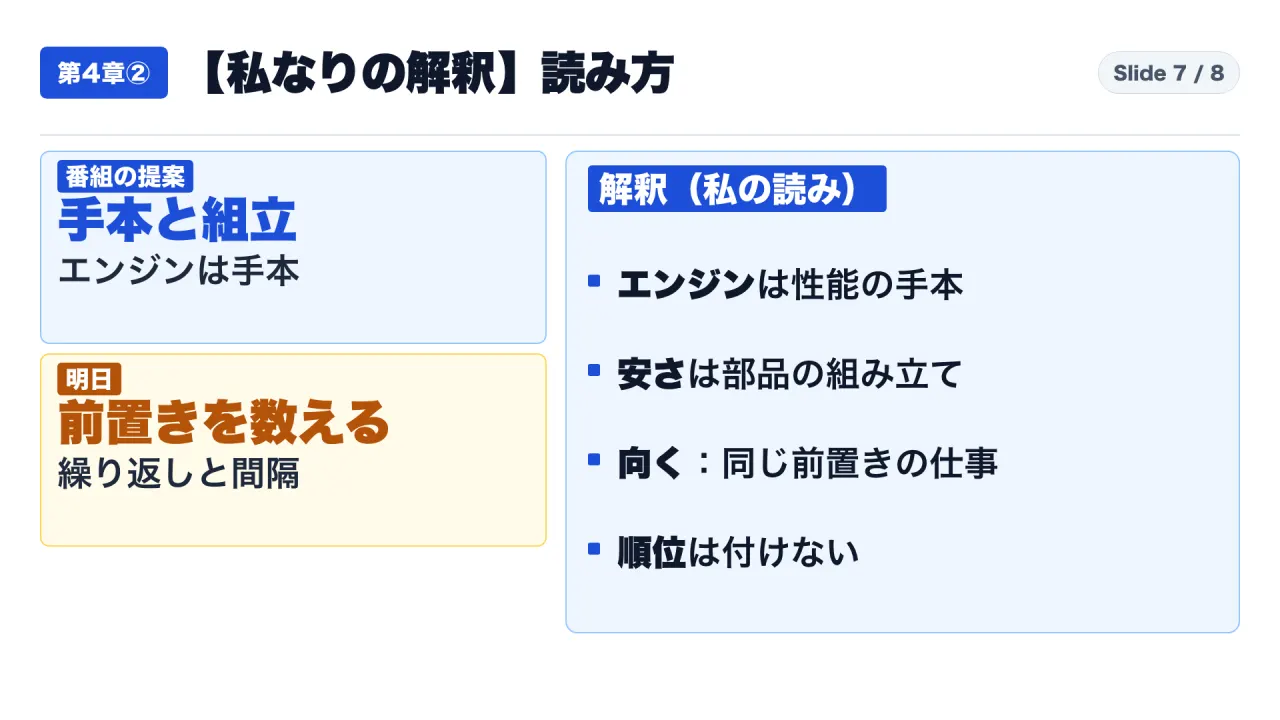
- DeepInferは「本番システム一式」ではなく「単体エンジンの基準点」: DeepInferは、DeepSeek-V4.1-FlashをSM100やAscend 950で動かす際のカーネル実装や単体性能の基準点(リファレンス)として価値があります。一方で、オンラインの本番サービスをそのまま置き換える完成品ではありません。
- 「GPU1時間38ドル」の源泉はエンジン単体ではなく「モデルの小メモリ化×長期キャッシュ×振り分け」の結合: 1トークン890バイト・永続化分約8分の1というモデル設計、約100PBのSSDに3〜7日残すキャッシュ、1日155兆トークンの規模が組み合わさって成立している数字と読みます。
- 恩恵が大きいのは「同じ前置きを繰り返す仕事」、当てはまりにくいのは「毎回違う入力・小規模環境」: オフピーク料金表でキャッシュヒット($0.003)とミス($0.15)に50倍の差があることから、システム指示やツール定義、長い文脈を繰り返し送るエージェントや長期対話ほどキャッシュ設計が効きます。逆に、毎回異なる短い入力を処理するバッチ処理や、128 GPUの最小単位に届かない環境では、同じ構造は当てはまりにくいと考えます。
- エンジン単体の乗り換えより、キャッシュと振り分けの設計が差を生む: vLLM側の測定とはいえ、同一設定のデコード差が6%以内だったことは、エンジン単体を入れ替えるだけでは大きな差になりにくく、周辺のキャッシュ保持とルーティングの組み立てが重要であることを示唆しています。
一方で、今回の一次資料からは言えないことも明確にしておきます。
- 自社環境にDeepInferを入れたときに38ドル/GPU時間が出るかどうか(出るとは言えません)。
- ディープシーク本番環境における現在の正確なキャッシュヒット率(今回の資料には数字がありません)。
- Mooncake、LMCache、vLLM Production Stackのどれが最も速いか(同一条件の比較資料がありません)。
- 関連企業の株価や売買判断(扱いません)。
まとめ:明日からの3つの確認アクション
最後に、推論基盤を運用している方が明日すぐ手元でできる確認手順を、私の提案として3つにまとめます。
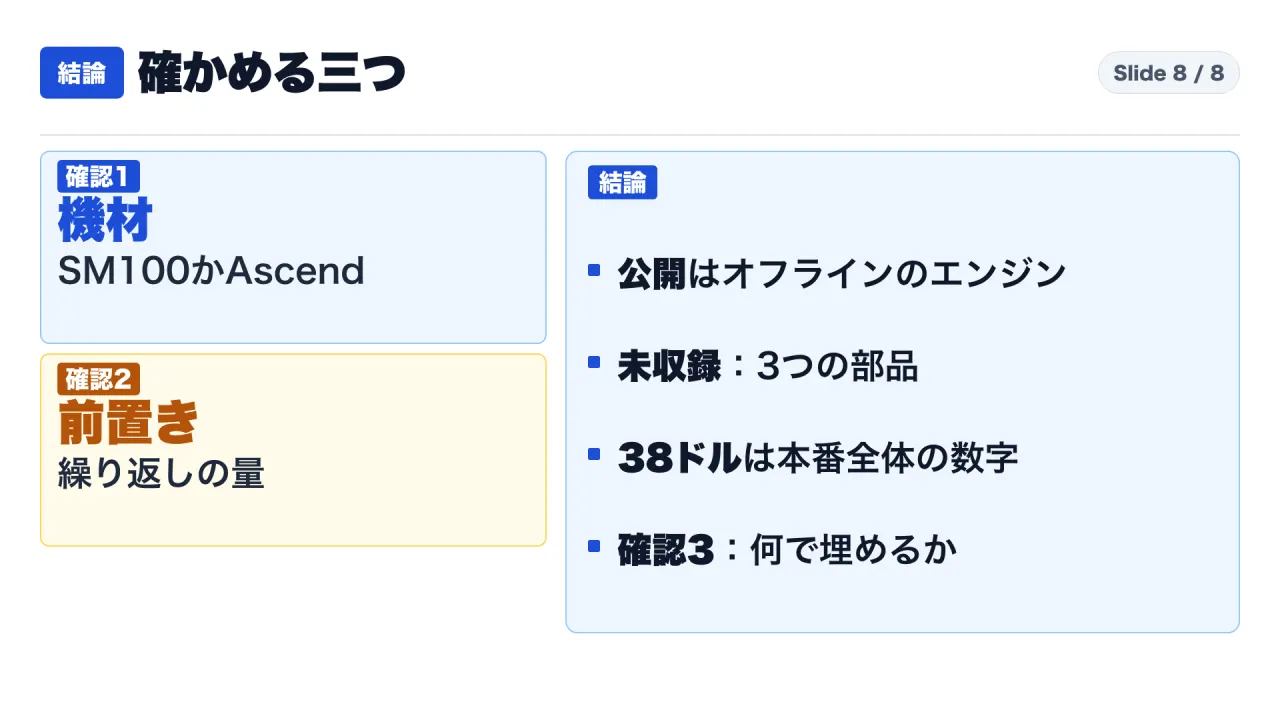
- 機材とモデルの対象確認:
自社の対象モデルが
DeepSeek-V4.1-Flashか、機材がNVIDIA SM100世代またはHuawei Ascend 950かを確認します。対象外であれば、DeepInferのコードを直接入れるのではなく、設計資料(inference_deployment_qa.md)の知見だけを参考にします。 - 自社の「前置きの繰り返し率」と「再利用までの時間間隔」を数える: ディープシークが本番の再利用間隔分布から「3〜7日保持」を決めたように、自社の推論ログから「先頭何トークンが共通しているか」「前回の呼び出しから何分後・何時間後に同じプレフィックスが再来するか」を集計します。
- 「含まれない3つの部品」の対応表を作る: 表の左側にDeepInferのREADMEが挙げた3項目(①KVキャッシュ管理、②プリフィル・デコード分離、③レプリカ間負荷分散)を書き、右側に自社で現在使っている(または候補にする)ソフトウェア名・バージョン・既知のCVEの有無を書き出します。
皆さんの現場では、AIモデルに送るプロンプトの前置き(システム指示やドキュメント、ツール定義)は、リクエストごとにどれくらい共通していますか。また、キャッシュは何時間ほど残していますか。よければコメントで教えてください。
参照した一次資料・公式ドキュメント一覧
- DeepInferの説明書(GitHub、2026年11月3日コミット時点)
- DeepInferの推論配備の質疑応答(GitHub、2026年11月3日更新版)
- DeepInferの推論配備の質疑応答(GitHub、2026年10月21日初出コミット版)
- DeepInferの最初のコミットの記録(GitHub API、2026年10月20日)
- deepseek-recipeの説明書(GitHub)
- deepseek-recipeの最初のコミットの記録(GitHub API、2026年10月19日)
- DeepSeek-V4.1-Flashのモデルカード(Hugging Face)
- DeepSeek-V4.1-Flash-1017のモデルカード(Hugging Face)
- DeepSeek APIの料金表(公式ドキュメント)
- DeepSeekの2025年2月の推論システム概要(GitHub Open Source Week Day 6)
- vLLM公式ブログ「DeepSeek V4.1 Flash on vLLM: Prefill-Decode Disaggregation and Wide EP」(2026年10月23日)
- Mooncakeの説明書(GitHub)
- LMCacheの説明書(GitHub)
- vLLM Production Stackの説明書(GitHub)
- 米国脆弱性データベースNVD:CVE-2026-103761
- Mooncake v0.3.14の変更履歴(GitHub API、2026年11月3日)
- 米連邦準備制度理事会(FRB)外国為替相場統計「H.10」(2026年11月2日公表)
この記事は、ポッドキャスト放送回(2026-11-04-deepseek-deepinfer-what-is-public-what-is-not)の台本と一次資料をもとに執筆しました(確認日:2026年11月05日)。