なぜLSAは1層72.4倍でも全体は9.21倍なのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜLSAは1層72.4倍でも全体は9.21倍なのか?
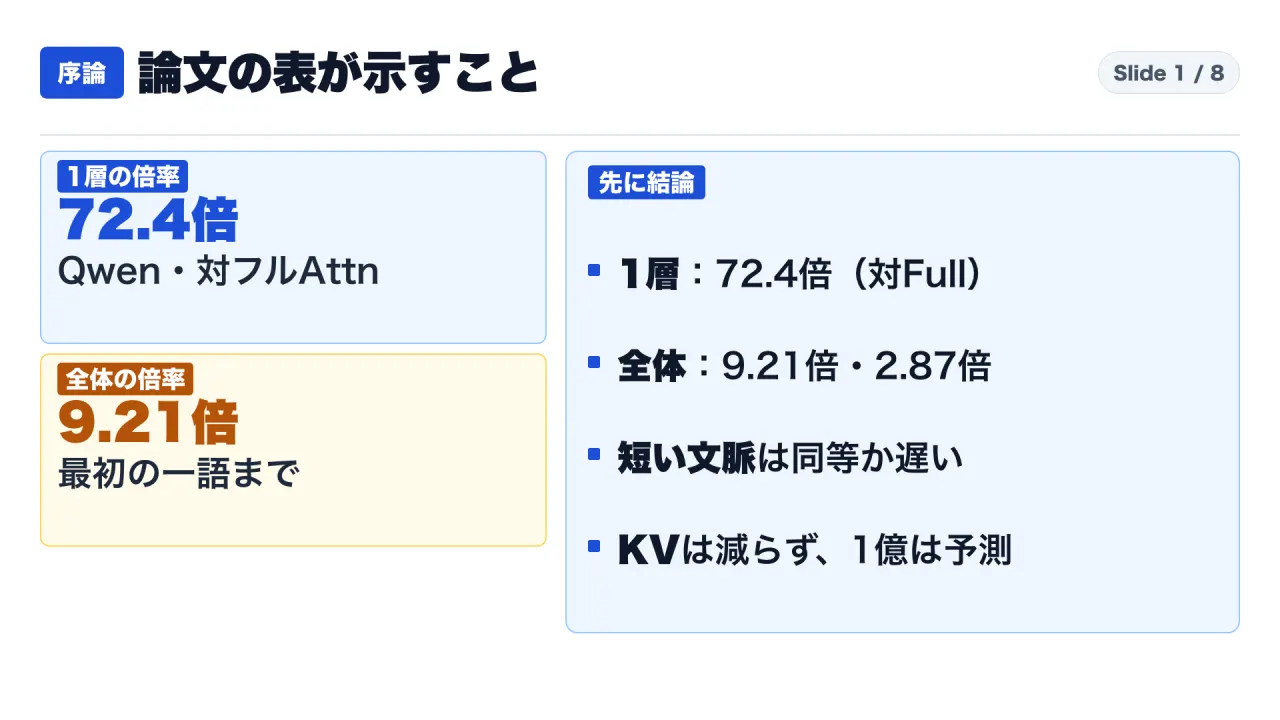
結論:72.4倍は注意層1つの倍率。モデル全体は9.21倍と2.87倍で、KVキャッシュは減らず、1億トークンは予測
結論から書きます。2026年10月30日に arXiv へ投稿された論文「Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention」(潜在スパース注意、以下 LSA)の表は、1,000万トークンでの高速化について、次の3つを示しています。
1つ目。72.4倍(プリフィル)と42.5倍(デコード)は、Qwen3.8-27B の注意層1つだけの倍率です。測ったのは著者で、機材は H200、文脈は1,000万トークン、相手はフルアテンションです。GLM-5.3-Flash の22.7倍(プリフィル)と4.6倍(デコード)は、相手がフルアテンションではなく、そのモデル自身のスパース注意(全部のキーではなく、選んだ一部のキーだけを読む注意)です。
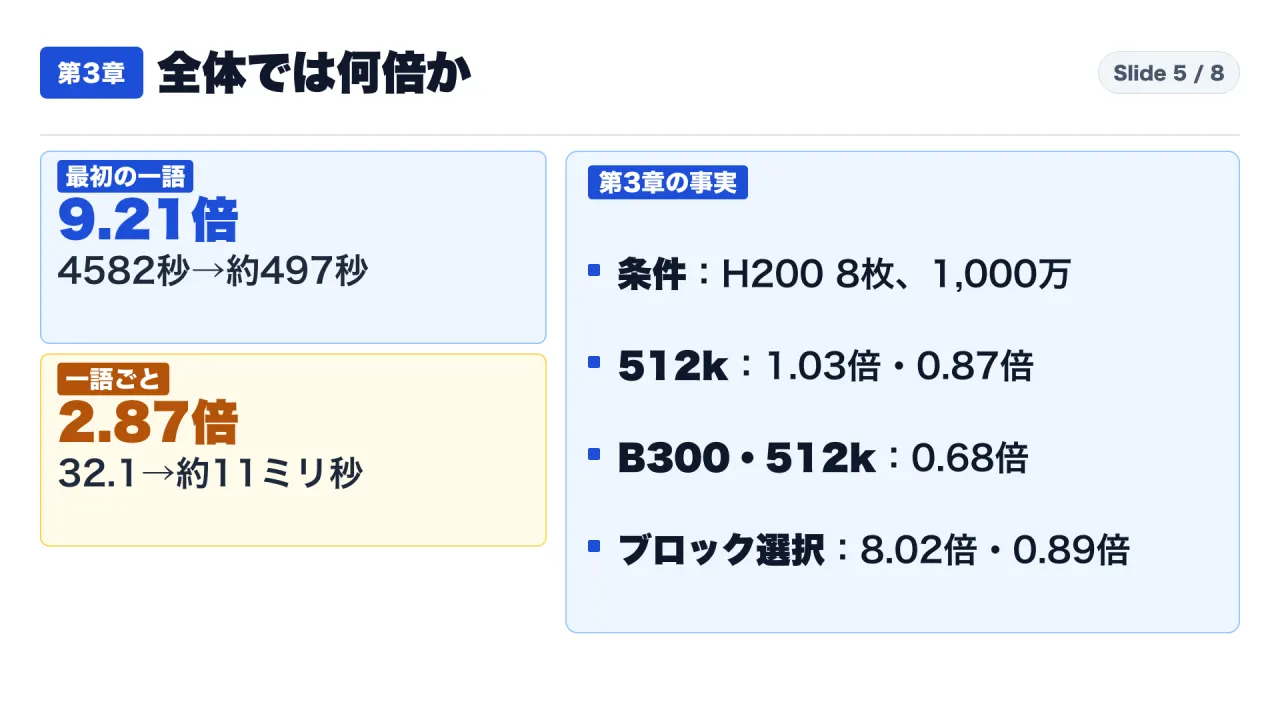
2つ目。モデル全体(論文の表3、H200、1リクエスト)では、1,000万トークンで、最初の一語まで(TTFT)が9.21倍、一語ごと(TPOT)が2.87倍です。基準のフルアテンションの4582.2秒(約76分)が、約497秒(約8分)になる計算です。一方で、約50万トークン(論文の表記は512k)では、一語ごとが0.87倍で、基準より遅い設定があります。
3つ目。論文自身が、KVキャッシュ(過去のトークンのキーと値の記憶)は減らず、文脈に比例して増え続けると書いています。1億トークンの数字は予測で、実測は1,000万トークンまでです。
この記事は、モデルの発表ではなく、手法の論文を読んだ記録です。使ったのは、論文(アブストラクト頁とPDF全文)、公開コードの説明書(README)、Qwen3.8-27B のモデルカードだけです。売買の判断は扱いません。
この記事は、長い文書をAIに読ませる仕組みを選ぶエンジニアや技術責任者で、論文や製品資料の「何十倍速い」という数字を見て、導入や試験を迷っている方に向けています。読み終えると、表で測った対象(層か全体か)・比べた相手・条件(文脈の長さ、機材の台数、1件ずつか)を確かめ、提供元に3つの質問(何と比べた倍率か、1件ずつか同時に多数か、最初の一語まで何秒か)を送れるようになります。
読み方:本文では「事実」「著者の測定」「私の解釈」を分けて書きます
この記事の数字は、論文に書かれた値(本文と表3)です。論文の図の画像から私が読み取った小数は使っていません。測定はすべて著者自身によるもので、第三者の再現は、私が確認できた範囲では見つかっていません(公開から5日目の取得)。論文は査読前のPreprintで、私が読んだのは2026年10月30日の第1版です。11月3日に第2版が出ています。第1版との差は、引用文献の追加、謝辞、表現の小さな修正で、本文と表3の数値は変わっていないことを、公開日にPDFの差分で確認しました。
「私の計算」「私の解釈」「番組の提案」と書いた部分は、論文に書かれていない私の読みです。事実と混ぜないために、そのたびに明記します。
また、制作の過程で読んだ下調べの資料には、論文やモデルカードと食い違う記述がありました。誤りだった点は、本文の該当箇所で訂正します。
この記事では、次の3つの問いを順に確かめます。
- 問い1:72.4倍は、何と何を比べた倍率か
- 問い2:モデル全体では、何倍になるのか
- 問い3:論文の表が、示していないことは何か
背景:この記事で使う言葉を先にそろえます
注意機構(アテンション)は、モデルが文章を読むとき、過去のどのトークンを参照するかを決める仕組みです。フルアテンションは、過去のすべてのキーを読みます。そのため、文脈が長くなるほど、読み込み(プリフィル)の計算量は文脈の長さの2乗に近づきます。トークンは、モデルが数える文字より少し粗い単位です。
プリフィルは、入力を読み込む段階です。デコードは、答えを一語ずつ作る段階です。TTFT(Time To First Token)は、最初の一語が出るまでの時間、TPOT(Time Per Output Token)は、一語ごとの時間です。この記事では、それぞれ「最初の一語まで」「一語ごと」と書きます。
スパース注意で、読むキーを選ぶ部分を「索引(インデクサ)」と呼びます。論文は、1,000万トークンでは、スパース注意の層でも、プリフィル時間の98%が、この索引(キー探し)に使われると書いています。LSA は、そこを減らす手法です。
第1章:論文は10月末に出た第1版。モデルの発表ではなく、注意の手法の提案である
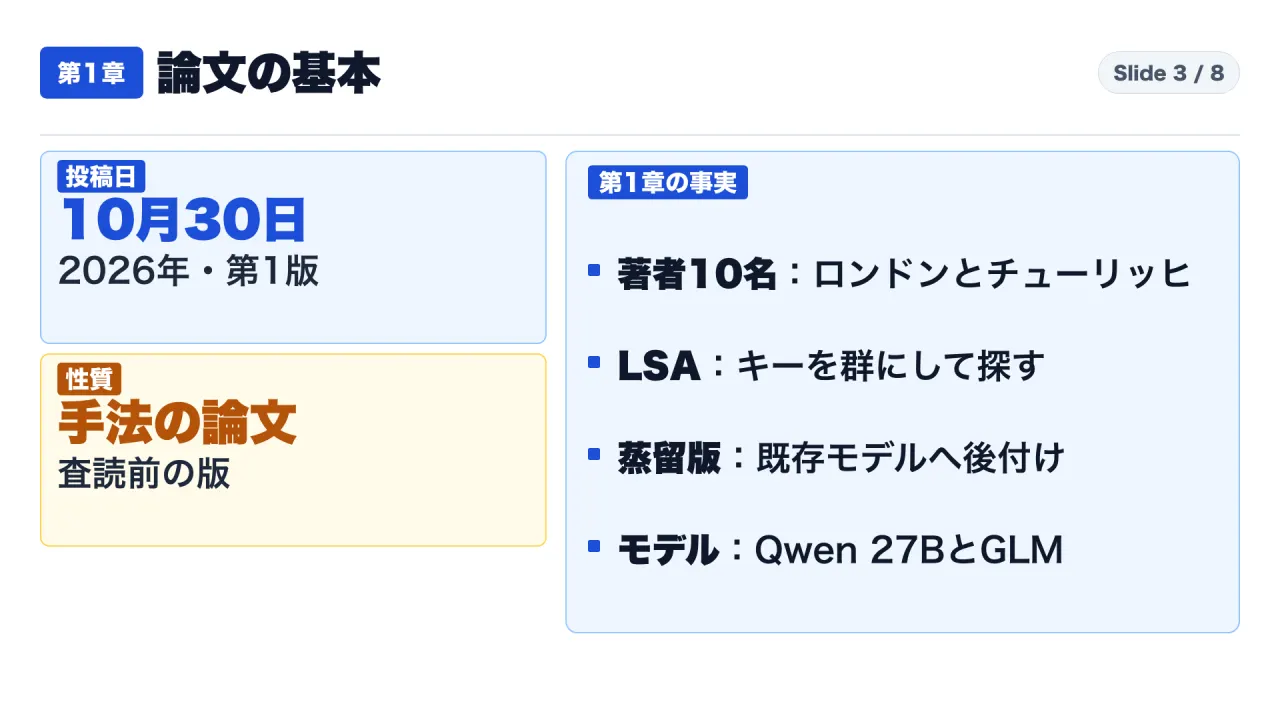
論文の題は「Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention」(副題の意味は、計算量が2乗より小さい、超長文脈のための注意)です。arXiv への投稿は2026年10月30日、分野は cs.AI、第1版(v1)です。著者は10名で、所属は、Prefrontal AI(ロンドン、英国)と ETH Zurich(チューリッヒ、スイス)です。
制作の裏側として書きます。下調べの資料は、所在地をオックスフォードとしていました。論文の1ページの脚注は、ロンドンです。オックスフォードの語は、論文、README、モデルカード、アブストラクト頁のどれにもありませんでした(私が語を検索して確認)。
LSA の仕組みは、論文の要旨によれば、キーを、学習した潜在空間で階層的にクラスタ化し、問い合わせ(クエリ)は、全キーではなく、クラスタの階層を採点する、というものです。版は2つあります。蒸留版(D-LSA)は、既存の学習済みモデルに、蒸留で後付けします。ネイティブ版(N-LSA)は、次トークンの予測の損失だけで、最初からこの方式で学習します。
試されたモデルは、Qwen3.8-27B(270億パラメータ)と GLM-5.3-Flash の2つです。Qwen3.8-27B のモデルカードには、次のことが書かれています。
- ライセンスは Apache-2.0
- 64層で、構成は「16回の繰り返し。各回は Gated DeltaNet 3層と Gated Attention 1層」
- 文脈の長さは、公称262,144トークン、拡張で最大1,000,000トークン
論文は、Qwen3.8-27B を、YaRN(位置情報の拡張手法)の係数40で、1,000万トークンまで伸ばしています。公称も、拡張の100万トークンも、超える長さです。GLM-5.3-Flash は、明示的な位置符号がなく、拡張は不要と書かれています。
私の計算では、64層のうち注意層は16層で、残りの48層は Gated DeltaNet です。下調べの資料は「Mamba系」と書いていましたが、モデルカードに Mamba の記載はありません(モデルカード全文を検索して0件)。論文も、Mamba の語は、参考文献の題名にしか出しません。速くなるのが16層の注意だけだ、という点は、第3章で効いてきます。
第2章:72.4倍は、1,000万トークンで、注意層1つを、著者が測った倍率。相手はフルアテンション
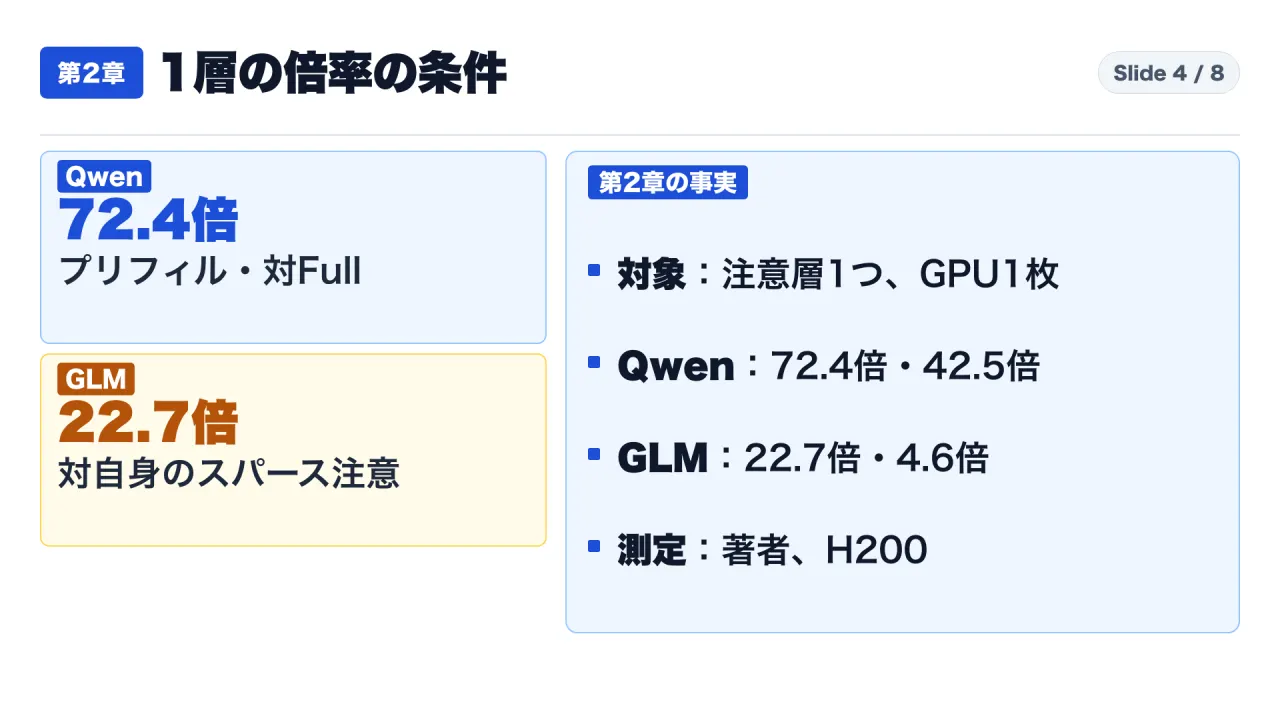
論文の要旨の数字です。1,000万トークンで、注意層1つあたり、GLM-5.3-Flash は、プリフィルで22.7倍、デコードで4.6倍。Qwen3.8-27B は、プリフィルで72.4倍、デコードで42.5倍です。比べた相手が違う点が、最も重要です。
| モデル | プリフィル | デコード | 比べた相手 |
|---|---|---|---|
| Qwen3.8-27B | 72.4倍 | 42.5倍 | フルアテンション |
| GLM-5.3-Flash | 22.7倍 | 4.6倍 | そのモデル自身のスパース注意 |
制作の裏側です。下調べの資料には、GLM-5.3-Flash の倍率を、フルアテンションとの比と読める書き方がありました。論文は、GLM-5.3-Flash の22.7倍と4.6倍を、元のスパース注意との比と書いています。
測った範囲は、注意層1つだけです。論文の4.3節によれば、射影、索引、注意の計算を含む注意モジュール全体を、GPU1枚で測っています。プリフィルは、与えた文脈の直後の、最後の32,768個の問い合わせの塊を測ります。デコードは、1件の要求の1ステップ(CUDAグラフ有効)です。機材は H200 と B300 で、測ったのは著者自身です。
倍率は、文脈が長いほど大きくなります。GLM-5.3-Flash のプリフィルは、約50万トークン(論文の表記は512k)で2.1倍、100万トークンで3.5倍、1,000万トークンで22.7倍です。論文の言葉では、100万トークン未満では利得が小さい、とあります。
私の整理です。1,000万トークンで倍率が大きいのは、そこが、キーを探す処理に時間の大半を使っていた部分だからだと読めます。短い文脈では、探す処理が軽く、利得も小さくなります。つまり、72.4倍は、モデルの速さではなく、注意層1つの時間の比です。
第3章:モデル全体では、最初の一語が9.21倍、一語ごとが2.87倍。短い文脈では、同等か遅い設定もある
モデル全体の数字は、論文の表3にあります。Qwen3.8-27B を、H200 8枚(テンソル並列 TP8 と、デコードのコンテキスト並列 DCP8)で動かし、1,000万トークンの要求を、1件ずつ処理した時間です。測り方は、出力256トークンの要求を3回行い、その中央値です。
表3の Qwen3.8-27B(H200)の行は、次のとおりです(手入力で読み取った行。基準のフルアテンションは実測の時間、ほかは基準に対する倍率)。
| 方式 | 最初の一語まで(約50万 / 100万 / 1,000万トークン) | 一語ごと(約50万 / 100万 / 1,000万トークン) |
|---|---|---|
| フルアテンション(基準) | 21.7秒 / 65.3秒 / 4582.2秒 | 7.8ミリ秒 / 9.1ミリ秒 / 32.1ミリ秒 |
| ブロックスパース注意(Flat) | 1.61倍 / 2.30倍 / 8.02倍 | 0.89倍 / 0.91倍 / 0.89倍 |
| D-LSA(Flat) | 1.03倍 / 1.51倍 / 9.21倍 | 0.87倍 / 1.00倍 / 2.87倍 |
| D-LSA(Tree) | 0.96倍 / 1.41倍 / 8.83倍 | 0.87倍 / 1.00倍 / 2.87倍 |
私の計算です。基準の最初の一語まで4582.2秒は、約76分です。D-LSA(Flat)の9.21倍では、4582.2÷9.21=約497秒、約8分になります。一語ごとは、32.1ミリ秒÷2.87=約11ミリ秒です。9分の1になっても、1,000万トークンの質問に最初に答えるまで、約8分かかります。
注意層1つの72.4倍と比べると、全体の9.21倍は、かなり小さくなります。論文は、全体の倍率は、1層より小さくなると見込まれる、速くなるのはグローバルな注意層だけで、ほかの層の費用は変わらないため、と書いています。Qwen3.8-27B は、64層のうち、注意層は16層です。
表3には、比較の相手として、ブロック単位で選ぶスパース注意(論文の表記は Block Sparse Attention (Flat))もあります。README の対応表では、Qwen3.8-27B のこの設定は、モデル自身の索引です。その最初の一語は8.02倍で、D-LSA(Flat)の9.21倍との差は小さい。一語ごとは0.89倍で、フルアテンションより遅くなります。私の計算では、最初の一語の差は、9.21÷8.02=約1.15倍です。違いが大きく出ているのは、一語ごとの時間です。
倍率の外側も、同じ表に出ています。
- H200で、約50万トークン(512k): 最初の一語が1.03倍、一語ごとが0.87倍(基準より遅い)。100万トークン: 1.51倍と1.00倍
- B300で、Qwen3.8-27B、約50万トークン: 最初の一語が0.68倍(基準より遅い)。1,000万トークンでは5.73倍
- GLM-5.3-Flash(H200)の1,000万トークン: CP8の構成で最初の一語2.24倍・一語ごと2.10倍、TP8の構成で5.83倍・1.91倍。相手は、そのモデル自身のスパース注意
表3は、1件ずつ処理した場合です。多数の要求を同時にさばく場合の数字は、この表にありません。
第4章①:精度は1,000万トークンで同程度か上。ただし、KVキャッシュは減らず、1億トークンは予測
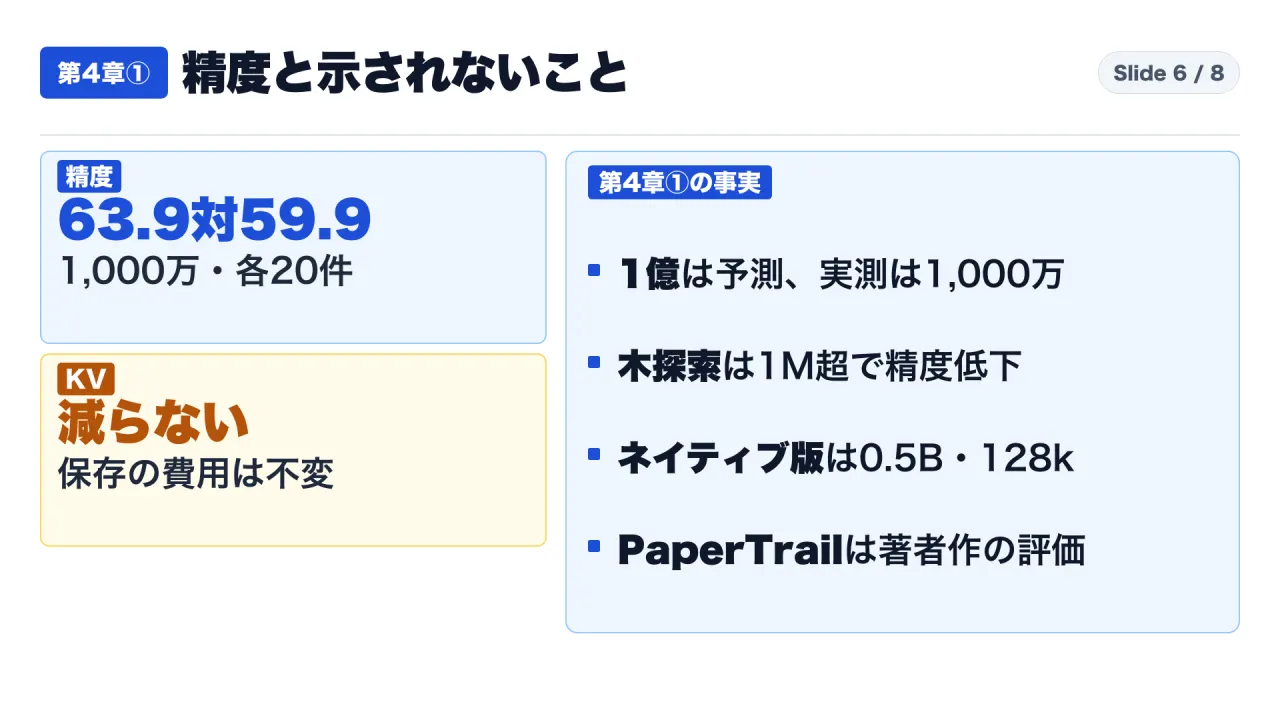
精度です。Qwen3.8-27B の D-LSA(Flat)は、100万トークンまでフルアテンションの5点以内で、1,000万トークンでは上回ったと、論文は書いています。RULER で63.9対59.9、PaperTrail で29.1対19.8です。
ただし、条件があります。RULER の13タスクは、100万トークンまでは各タスク100プロンプト、それ以降は各タスク20プロンプトです。評価は、全件ではなく、一部の抜き出しです。PaperTrail は、著者自身が作った、長文脈の科学文書の評価です。私は、「上回った」と断定せず、「同程度か上」と読みます。
GLM-5.3-Flash では、200万から500万トークンで、元のスパース注意より最大8点低くなります。論文は、この比較は、モデルと一緒に学習された基準に有利だと書いています。
著者が書く限界を、並べます。
- KVキャッシュ:LSA は、キーを探す費用を減らすが、保存の費用は減らさない。KVキャッシュは、文脈に比例して増え続ける。1,000万トークンの測定が8枚のGPUを前提にするのは、そのため(私の整理)
- 設備:GLM-5.3-Flash の H200・TP8・1,000万トークンは、2ノード
- 木探索(Tree):GLM-5.3-Flash で、100万トークンを超えると精度が落ち、1,000万トークンの RULER は55.8(平らな探索は66.8)。デコードで平らな探索を上回るのは約500万トークンから、プリフィルは1,000万トークン超と予測
- 1億トークン:1,000万トークンまでの測定を、その先へ延ばした見積もり(論文の表記は extrapolated)。木探索版のプリフィルが、基準のスパース注意の90倍超と予測。実測は1,000万トークンまで
- ネイティブ版:約0.5Bパラメータ、128kトークンまで、平らな探索のみの小さな検証。1層の学習は128kで1.6倍、短い文脈では選ぶ費用が節約を上回る。モデル全体では1.24倍
下調べの資料の「精度は完全に一致」は、言い過ぎです。ネイティブ版の検証損失は1.085対1.085で一致しますが、RULER の128kは、32.2対34.7です。論文の言い方は「3.5点以内」です。
第4章②:【私なりの解釈】倍率は、何の何倍かまで読む。自社の文脈長と、記憶の量を先に確認する
コードと重みは公開されています。ライセンスは Apache-2.0。重みは、Qwen3.8-27B と GLM-5.3-Flash 用の蒸留済みの射影で、Qwen 本体の再配布ではありません。使うには、推論ソフト(SGLang)の改造版の上で動くプラグインを入れ、プリフィルの CUDA グラフを無効にする設定が必須です。
README の再現値は、短い文脈のものです。RULER の13タスクの平均で、Qwen3.8-27B・D-LSA(Flat)・H200 1枚の場合、4kで0.974、32kで0.968(論文は0.975と0.966)。1,000万トークンの値ではありません。下調べの資料にあった再現値の一部は、GLM-5.3-Flash の組と取り違えられた疑いがあり、使っていません。
ここからは、事実ではなく、私なりの解釈です。
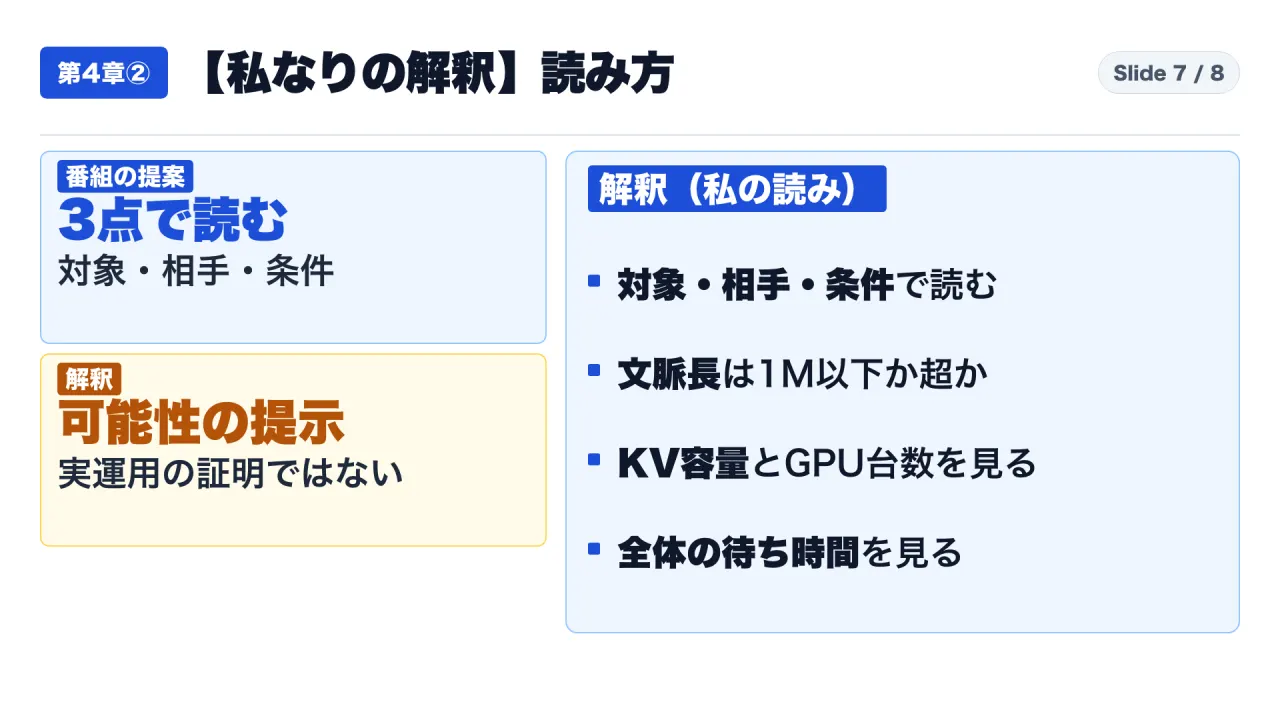
- 第一の解釈:倍率は、3つに分けて読みます。測った対象(層か全体か)、比べた相手(フルアテンションか、自身のスパース注意か)、条件(文脈の長さ、機材、台数)です
- 第二の解釈:この論文が示すのは、1,000万トークン級で、キーを探す費用を減らせる可能性です。全体の待ち時間は、まだ約8分。KVキャッシュも減っていません
- 第三の解釈:自社で長い文書を扱うなら、確かめるのは3つです。文脈が100万トークン以下か、超えるか。KVキャッシュの容量とGPUの台数。全体の待ち時間です。100万トークン以下では、この表で、利得が見えない設定があります
- 第四の解釈:数字は著者自身の測定で、公開から日が浅く、第三者の再現は確認できていません
言えないことも、並べます。自社の長文書で同じ倍率が出るのか。他社のモデルとの順位(この記事は、論文の表にある同じ設定の比較だけを使い、順位は付けません)。1,000万トークンを超える実測。下調べの資料にあった、量子化したときのメモリ量の数字は、論文・README・モデルカードで確認できなかったので、使っていません。
結論:論文の表を読むときは、何の何倍か、どの長さと機材か、待ち時間は何分かを確かめる
要点を3つにまとめます。
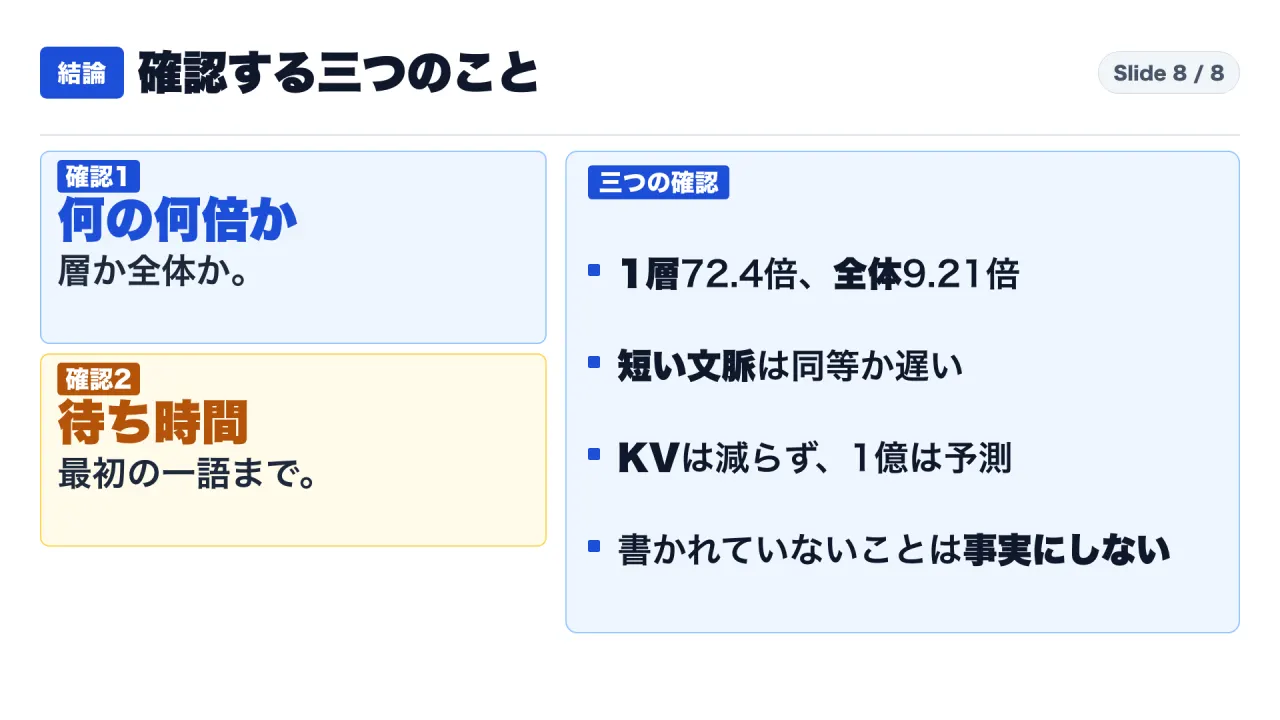
- 72.4倍は、1,000万トークンの注意層1つを、著者が測った倍率で、相手はフルアテンションです。GLM-5.3-Flash の22.7倍の相手は、自身のスパース注意です
- モデル全体では、最初の一語が9.21倍、一語ごとが2.87倍。約50万トークンでは、一語ごとが0.87倍など、同等か遅い設定があります
- KVキャッシュは減りません。1億トークンは予測で、実測は1,000万トークンまでです
補足:自社で数字を取るときの進め方の例(私の提案)
論文の表は、自社の条件の数字ではありません。長い文書を扱うシステムで、この種の手法を検討するなら、次の順に確かめます。これは番組の提案で、論文の記述ではありません。
- 文脈の長さの分布を取る。100万トークン以下の要求が大半なら、この表で利得が見えるのは、1,000万トークン級の一部の用途だけです
- KVキャッシュの容量を見積もる。論文は、LSA がキャッシュを減らさないと明記しています。GPUのメモリに載るかを、先に見ます
- 最初の一語までの待ち時間を、同じ条件で測る。1,000万トークンの質問への最初の答えまで、約8分という数字を、利用者が受け入れられるかを確かめます
- 倍率の相手を確かめる。フルアテンションか、既存のスパース注意か。論文の表の相手と揃っているかを見ます
- LSA そのものを試すなら、最初の一歩は、README の手順で短い文脈の再現値(Qwen3.8-27B・D-LSA(Flat)・H200 1枚で、4kが0.974、32kが0.968)に近い値が出るかを確かめることです
よくある疑問に、論文の範囲で答えます
Q. Qwen3.8-27B が1,000万トークンを扱える、ということですか。 A. 論文は、YaRN(係数40)で1,000万トークンまで伸ばして測っています。モデルカードの公称は262,144トークン、拡張で100万トークンまでです。公称を超える長さを、著者の設定で動かした結果で、モデルの仕様ではありません。
Q. GPU 1枚で1,000万トークンが動くのですか。 A. 論文の測定は、Qwen3.8-27B で H200 8枚(TP8・DCP8)です。1枚で動く、とは書かれていません。KVキャッシュは減らず、文脈に比例して増えます。
Q. 1億トークンでも速いのですか。 A. 1億トークンは、1,000万トークンまでの測定を、その先へ延ばした見積もりです。木探索版のプリフィルが、基準のスパース注意の90倍超と予測されていますが、実測ではありません。
Q. ネイティブ版は、フルアテンションと同じ精度ですか。 A. 検証損失は同じ値(1.085)ですが、RULER の128kは32.2対34.7です。論文の言い方は「3.5点以内」で、0.5B・128k・平らな探索だけの小さな検証です。
自社の判断に使うときの注意(私の提案)
この記事は、論文のPDF全文、アブストラクト頁、公開コードの説明書、モデルカードだけを読んで書いています。取得は2026年11月4日で、読んだのは論文の第1版です(第2版との数値の差がないことは、前の節に書いたとおり確認しました)。後から版が更新されたり、第三者の評価が出たりする可能性があります。自社の方針や投資を決める根拠にするときは、最新の論文と公式の資料を、直接確認してください。
最後の確認リスト
- 何の何倍か:層か全体か。相手はフルアテンションか、自身のスパース注意か
- どの長さと機材か:1,000万トークン、H200 8枚。約50万トークンでは同等か遅い設定がある
- 待ち時間は何分か:最初の一語まで、約8分(1,000万トークン、1リクエスト)
- KVキャッシュは減らず、1億トークンは予測
- 書かれていないことを、事実にしていないか
YouTube本編:{{YOUTUBE_URL}}
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:論文のアブストラクト頁(アークシブ、2026年10月30日投稿、2026年11月4日取得):https://arxiv.org/abs/2610.42147
- S2:論文の全文(アークシブ、第1版のPDF、2026年11月4日取得):https://arxiv.org/pdf/2610.42147
- S3:論文のコード公開頁(GitHub、READMEを含む、2026年11月4日取得):https://github.com/Prefrontal-AI/latent-sparse-attention
- S4:クウェン3.8の270億パラメータ版のモデルカード(Hugging Face、2026年11月4日取得):https://huggingface.co/Qwen/Qwen3.8-27B