なぜHy4は、返答の料金が約8分の1でも強いと言えない?──テンセントの新AIの点数表の読み方と、AnthropicのAI「Opus 5.5」との料金の比べ方、試す前の3つの確認
序論:新しいAI「Hy4」とは何か。画像とパソコン操作に対応、ただし点数表は順位として読めない
AIモデルとは、文章や画像を渡すと、文章で答えを返してくれる、コンピューターの頭脳のことです。たとえるなら、何でも答えてくれる、物知りな電話相談員です。
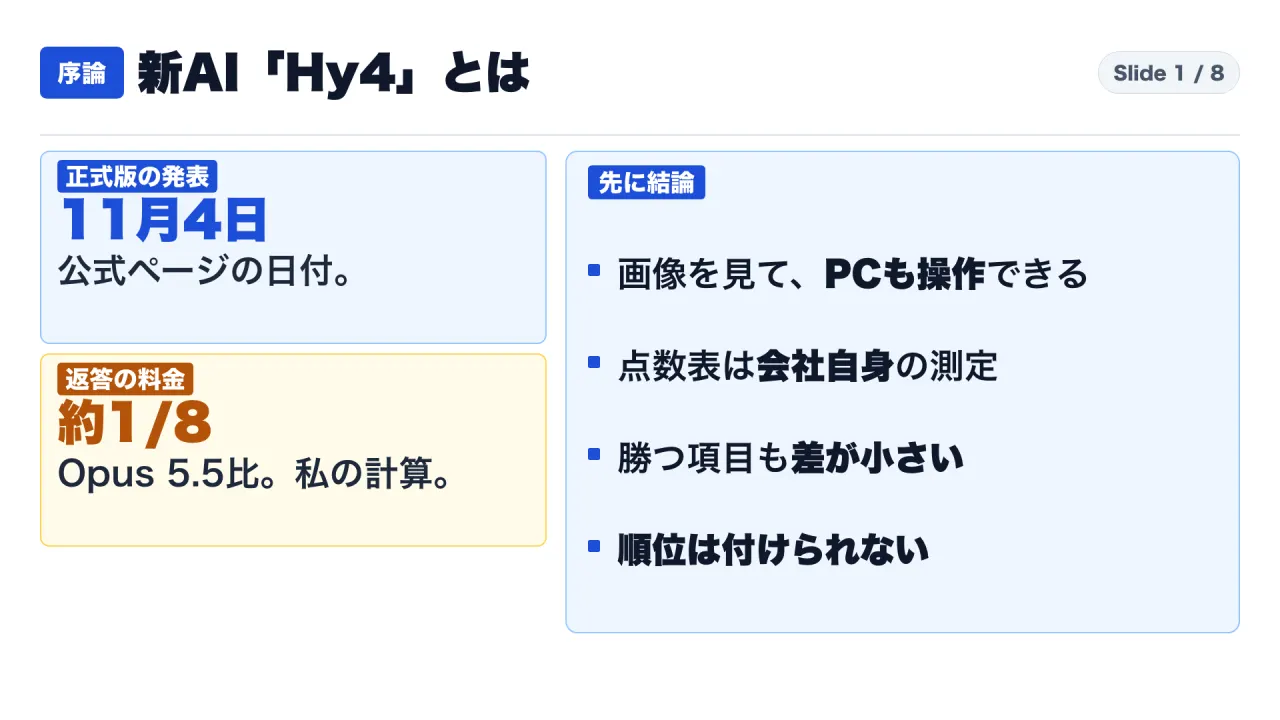
クラウドやゲームの事業を持つTencent(テンセント)が、2026年11月4日に、新しいAIモデル「Hy4」(読みは「ヒーフォー」)を発表しました。公式ページによると、Hy4は画像を読み、パソコンの操作もできます。AIが返す文章の料金は、百万トークンあたり2.501ドルです。Anthropic社のAI「Opus 5.5」の20ドルと比べると、約8分の1です。ただし、AIに送る文章の料金は約4.8分の1で、8分の1ではありません。
ここで大事なのは、公式ページの点数表は、Tencent自身が測った点数だということです。この表から、Hy4が他のAIより上だ、あるいは下だという順位は作れません。
理由は3つあります。1つ目は、測った人がまちまちなことです。表の注記では、星印のついた点数は「自社で測定」と説明されています。2つ目は、強い項目と弱い項目がはっきり分かれることです。3つ目は、Hy4が勝つ項目でも、差が小さいことです。
この記事は、仕事で使うAIを選ぶ立場の方と、その上司の方に向けて書きました。AIに詳しくなくても読めるよう、専門用語は初めに一言で説明します。「安くて強いAIが出た」と聞いて、自分の仕事で試すか、様子を見るか、迷っている場面を想定しています。読み終えると、次の3つができるようになります。1つ目は、点数表を「誰が測ったか・どんな設定か・差はぶれより大きいか」の3問で読むこと。2つ目は、自分の仕事の困りごと3件で、Hy4と今のAIを同じ設定で比べる計画を立てること。3つ目は、中身(重み)の公開を待つ間の、小さな試し方を決めることです。
この記事は、公開された資料を読んだ整理です。売買や投資の判断、企業の評価は範囲外です。中心に読む点数表は、Tencentの公式ページにある付録の表で、画像から私が書き起こしました。この表の数字そのものが正しいかは確かめていません。一部の数字だけ、試験を運営するMercorの掲示板とブログ、DeepSeekとHy4 previewのモデルカード(公開されたAIの説明書き)、Anthropicの発表と、載っている数字が合うかを照らしました。確かめたのは各ページに書かれていることで、測り直してはいません。照らした範囲は、第2章と第3章で具体的に示します。
先に、この記事で使う言葉を整理します
AIの記事は、言葉が先に難しくなります。ここで、本文で使う言葉を短く説明しておきます。
- AIモデル:文章や画像を受け取って、文章で答えを返す、AIの頭脳の部分です。
- お試し版(プレビュー版):正式版より先に出した版です。公式ページは「Hy4 preview」と呼んでいます。
- パラメータ:モデルの中にある、調整用の数のことです。多いほど大きなモデルですが、強さそのものではありません。
- 重み:学習で決まったパラメータの値を、ファイルにしたものです。レシピだけでなく、できあがった秘伝のタレを容器ごと配るようなものです(たとえ話)。重みが手元にあれば、自分のパソコンやサーバーでモデルを動かせます。
- 窓口(API):ネット越しにAIへ頼む入り口です。重みがなくても、窓口があれば使えます。
- トークン:AIが文章の量を数える小さな単位です。料金は「百万トークンあたり」で表されます。AIに送る文章(入力)と、AIが返す文章(出力)で、料金が別々です。
- システムカード:モデルの安全性の調べ方などをまとめた説明書です。
- ベンチマーク:AIに同じ問題を解かせて点を付ける、決まった試験です。本文では「試験」と書きます。運転免許の試験のように、同じ物差しで測るための試験です(たとえ話)。
- ぶれ:同じ物を測り直したときの、点数の揺れのことです。
第1章:何が公開されたか。使えるのは正式版、中身が手に入るのはお試し版
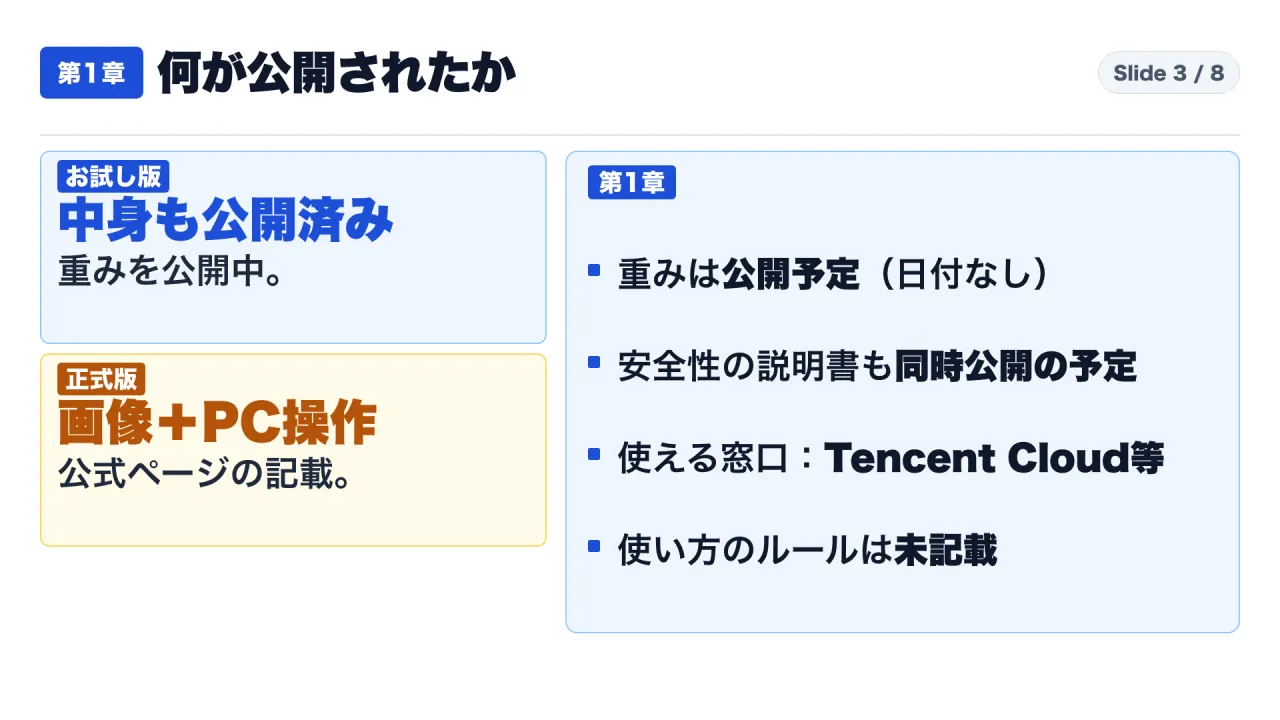
最初に、名前の整理が必要です。Hy4は2つあります。先に出たお試し版と、2026年11月4日に発表された正式版です。公式ページは、正式版がお試し版より、事前学習と追加学習の規模を大きくした、と書いています。学習とは、AIに大量の文章を読ませて、賢くする作業のことです。
お試し版については、Hugging Faceのモデルカードで、総パラメータ数が770B(7,700億)、1回の処理で動くのがそのうち49B(490億)と説明されています。使い方のルール(ライセンス)はApacheで、重みも公開されています。重みが公開されているので、自分の環境で動かすことも、中身を調べることもできます。
正式版は、画像を読めるようになりました。公式ページは、細かい画像の読み取りと、複雑なグラフの理解を挙げています。もう1つ、初めてパソコンの操作に対応しました。文字で命令を打つ画面(CLI)と、ふつうの画面(GUI)の両方で動くと書かれています。使える場所は、Tencent CloudとOpenRouterです。OpenRouterは、いろいろなAIを1つの窓口から呼び出せる取次のサービスです。
OpenRouterの掲載では、入力は文字と画像、文脈の長さ(一度に読める量)はおよそ100万トークン(1,048,576)です。これは公式ページの本文ではなく、取次サービス側の記載なので、区別して扱います。
では、まだ公開されていない物は何でしょうか。公式ページは、正式版の重みについて「公開予定」と書いています。日付の記載はありません。システムカードも、重みを公開するときに出す、という書き方です。正式版の使い方のルール(ライセンス)と、正式版のパラメータ数は、取得した本文を読み、語を検索した範囲では、書かれていません。
ここで、私の読みです。「公開」という言葉には、2つの意味があります。使える状態と、中身が手に入る状態です。正式版は、前者だけです。この違いは、使い方の選択に直結します。窓口越しの利用だけで足りるなら、今すぐ試せます。自社のサーバーで動かしたい、中身を調べたい、という要件があるなら、重みの公開を待つことになります。まず、自分の要件がどちらかを書き出してください。これは私の提案です。
第2章:点数表の読み方。星印は、会社が自分で測った印
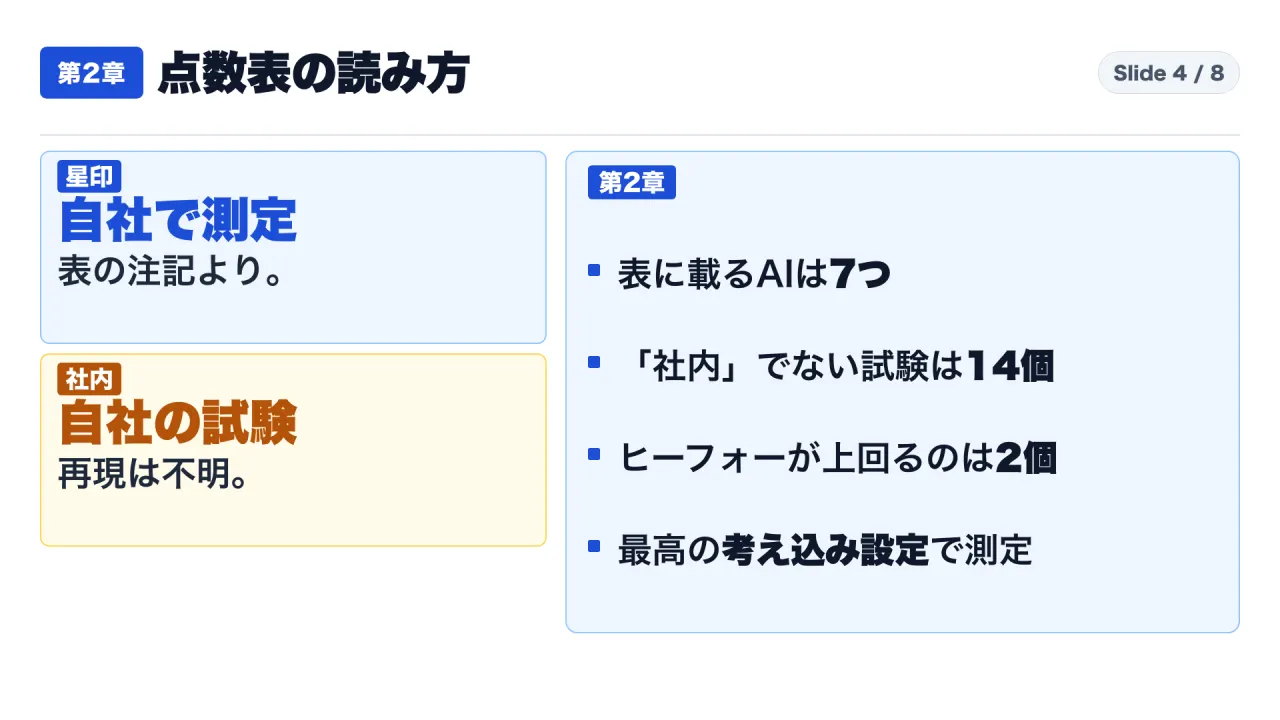
公式ページの終わりに、付録として大きな点数表があります。載っているAIは7つです。Hy4、Hy4 preview、GLM-5.3、DeepSeek-V4.1-Flash-1017、Kimi K3.1 Pro、GPT-6.1 Sol、Claude Opus 5.5です。比べる相手は、この表に載ったAIだけです。Tencent以外のページと突き合わせたのは、APEX-Agents v1.1とAutomationBench v1.0.6の、一部の数字だけです(第3章に書きます)。GLM-5.3、Kimi K3.1 Pro、GPT-6.1 Solの数字と、そのほかの項目は、突き合わせていません。Hy4自身の数字を、他の会社が測り直した結果も、見つけていません。
表の下の注記が、読み方の鍵になります。注記は次の3点です。
- 星印のついた点数は、Tencentが自分で測った点数です。注記に「with * indicating our own testing」と書かれています。お店の看板の「当店調べ」と同じです(たとえ話)。
- どのAIも、使える中でいちばん深く考え込む設定(推論の設定)で測ったと書かれています。
- 試験の名前についた星印は、公開時に初めて測った試験という、別の意味です。同じ星印でも、2つの意味があります。さらに、短剣の形の印(†)は、HLEという試験で、文字だけの問題に絞って測った印です(「† indicating evaluation on the text-only subset of HLE」)。
試験の名前に「社内(internal)」と付いたものもあります。Tencentが自分で用意した試験です。外の人が同じ条件で再現できるかどうかは、ページからは分かりません。
ここで、私の数え方を示します。名前に「社内」と付かない試験のうち、Hy4とOpus 5.5の両方に点数があるものは14あります。DeepSWE v1.1、SWE-Marathon v1.1、ProgramBench、Terminal-Bench 4.0、FrontierCode 2.0、APEX-Agents v1.1、Agents’ Last Exam v1.1、AutomationBench v1.0.6、HLE-Full、Terminal-Bench-Science 0.1、PostTrainBench v1.2、OSWorld 2.1、MMMU-Pro、ZeroBench-mainです。このうち、Hy4が上回るのは、DeepSWE v1.1とAPEX-Agents v1.1の2つだけです。残りの12は、Opus 5.5のほうが上です。Opus 5.5の欄に点数が2つ並ぶ項目は、2つの点数の両方に対して数えています。
私の読みです。この表は、Tencentが、自分の道具と設定で、自分で測ってまとめたものです。広告だと決めつけるつもりはありません。ただ、利害のある出所の表なので、読む前に3つ確かめます。誰が測ったか。どんな設定か。差は、ぶれ(測るたびの点数の揺れ)より大きいか。これは私の提案です。
第3章:点数をどこまで比べられるか。勝つ項目も、差は小さい
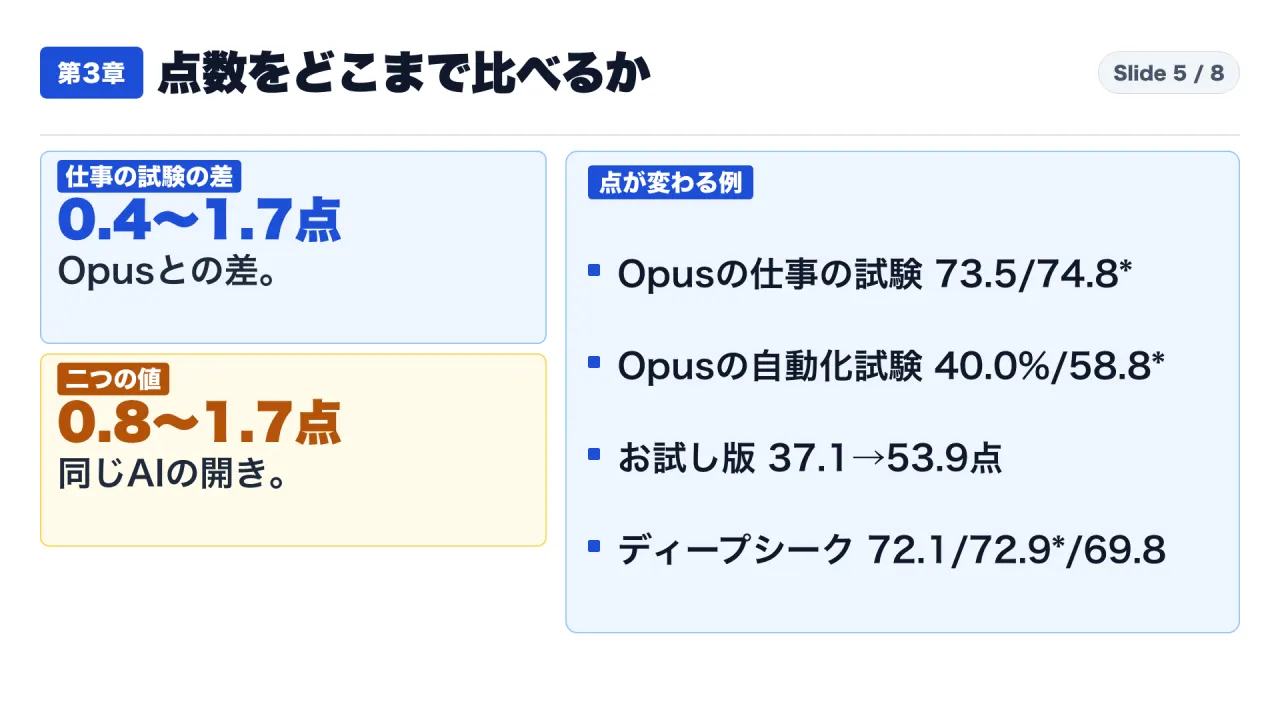
いちばん目立つのは、APEX-Agents v1.1の項目です。AIに仕事の課題を解かせる試験の名前です。Hy4は75.2。Claude Opus 5.5の欄には、点数が2つ並びます。73.5と、星印のついた74.8です。
星印は、Tencentが自分で測った印です。つまり、74.8はTencentが測った点数です。一方、星印のない73.5は、この試験を運営するMercorの掲示板(Pass@1)に載っているOpus 5.5の73.5と一致します。掲示板は、この点数に「プラスマイナス4.9点」の幅を付けています。「このくらいはぶれる」という目安として読めます。
差を計算します。私の計算です。75.2から73.5を引くと1.7。74.8を引くと0.4です。どちらも、運営者の掲示板が示す幅(プラスマイナス4.9点)の中に収まります。
同じ表の中に、もう1つのものさしがあります。他のAIも、同じ試験で点数が2つ並んでいます。DeepSeek-V4.1-Flash-1017は72.1と72.9(星印つき)で、開きは0.8。Kimi K3.1 Proは67.2と68.2(星印つき)で、開きは1.0。Claude Opus 5.5は73.5と74.8(星印つき)で、開きは1.3。GPT-6.1 Solは60.0と61.7(星印つき)で、開きは1.7です。同じAIの2つの点数の開きは、0.8から1.7です。私の計算です。この開きを、ぶれの目安として使います。これは私の読みです。
DeepSeekの点数は、出所によって、さらに分かれます。DeepSeek自身のモデルカードは72.1、Tencentの測定は72.9、Mercorの掲示板は69.8です。同じAI、同じ名前の試験でも、誰が測ったかで、3つの値になります。そして、私が確認したMercorの掲示板には、Hy4の行がまだありません。
つまり、Hy4とOpus 5.5の差(0.4〜1.7点)は、運営者の幅より小さく、同じAIの2つの点数の開き(0.8〜1.7点)と同じか、それより小さい大きさです。この差で、勝ったとは言えません。負けたとも言えません。どちらとも言えない、が、表から言える範囲です。
さらに、同じAIでも、試験のやり方が変わると点数が動きます。車の燃費の、カタログの数字と、実際に走った数字が違うのと同じです(たとえ話)。以前のHy4 previewのモデルカードの付録の表では、お試し版のAPEX-Agentsは37.1で、注記の資源は「4 CPU、メモリ16GB」でした。今回のTencentの表では、同じお試し版が53.9です。今回の注記は、試験の版がv1.1で、メモリが24GB、採点は別の容器で行うと書いています。表の注記には、評価の道具、採点役、不正対策の更新で、以前の報告と違うことがある、とも書かれています。運営者のMercorも、2026年9月8日のブログで、v1.1では課題、道具、環境を更新し、各分野の課題を80個に絞ったと書いています。
もう1つの例が、自動化の試験、AutomationBenchです。Anthropicの発表では、Opus 5.5は40.0%です。この試験の結果はZapier社が測り、安全のための停止を失敗に数えたため、実際より低く出る、と注記にあります。一方、Tencentの表では、同じOpus 5.5が、星印つきの58.8です。測る人や条件が違えば、同じ名前の試験でも、別のものさしになります。
逆に、差がはっきり大きい項目もあります。MMMU-Proは、Hy4が78.6、Opus 5.5が88.2(星印つき)です。Terminal-Bench 4.0は、Hy4が44.4、Opus 5.5が66.4です。こういう項目は、差がぶれの目安を大きく超えています。ProgramBenchも、Hy4が30.0、Opus 5.5が65.0と56.5(星印つき)で、大きく離れています。
Tencent自身も、ページに書いています。Hy4は、今使える、重みが公開されたAIの中で最強クラスの1つ。ただし、重みを公開していない最上位のAIとの間には、大きな差が残る、と。特に、社内の難しい試験で、研究レベルの数学、長い開発作業、モデル自身の改善、画像の難しい質問で、です。Opus 5.5のように、使えるが重みは非公開のAIが、ここでいう「最上位の非公開のモデル」に当たるかは、ページには書かれていません。
| 試験の名前 | Hy4の点 | Claude Opus 5.5の点(表の記載のまま) | 差の読み方 |
|---|---|---|---|
| APEX-Agents v1.1 (pass@1) | 75.2 | 73.5 / 74.8* | 差0.4〜1.7。同じAIの2つの点数の開き(0.8〜1.7)と同じか、それより小さい |
| DeepSWE v1.1 | 74.9 | 74.2 / 72.6* | 上回るが、差は0.7〜2.3 |
| MMMU-Pro | 78.6 | 88.2* | Opusが約10点上 |
| Terminal-Bench 4.0 | 44.4 | 66.4 / 66.4* | Opusが約22点上 |
| ProgramBench (almost solved) | 30.0 | 65.0 / 56.5* | Opusが26.5〜35.0点上 |
| OSWorld 2.1 (Full, partial score) | 78.9 | 81.8 | Opusが2.9点上 |
| Terminal-Bench-Science 0.1 | 19.8 | 58.7 / 56.2* | Opusが約36〜39点上 |
出所はすべて、Tencent公式ページ付録の表です。星印は自社測定、点数が2つ並ぶ項目は表の記載のままです。この表のうち、他のページと突き合わせたのは、APEX-Agents v1.1のOpus 5.5の73.5(Mercorの掲示板)だけです。
ここまでの比較は、ほとんどが、この同じ表からです。他のページと突き合わせたのは、先に書いた、APEX-Agents v1.1(Mercorの掲示板、DeepSeekのモデルカード)、Hy4 previewの以前の値、AutomationBenchのAnthropicの発表の数字だけです。GLM-5.3、Kimi K3.1 Pro、GPT-6.1 Solの数字と、表のそのほかの項目は、突き合わせていません。
私の読みです。順位を作らない理由は3つです。測った人が混ざっている。試験のやり方や条件で、点数が大きく動く。差が小さい項目は、ぶれに埋もれる。この3つです。
第4章:料金と試し方。安いは事実、強いは自分の課題で確かめる
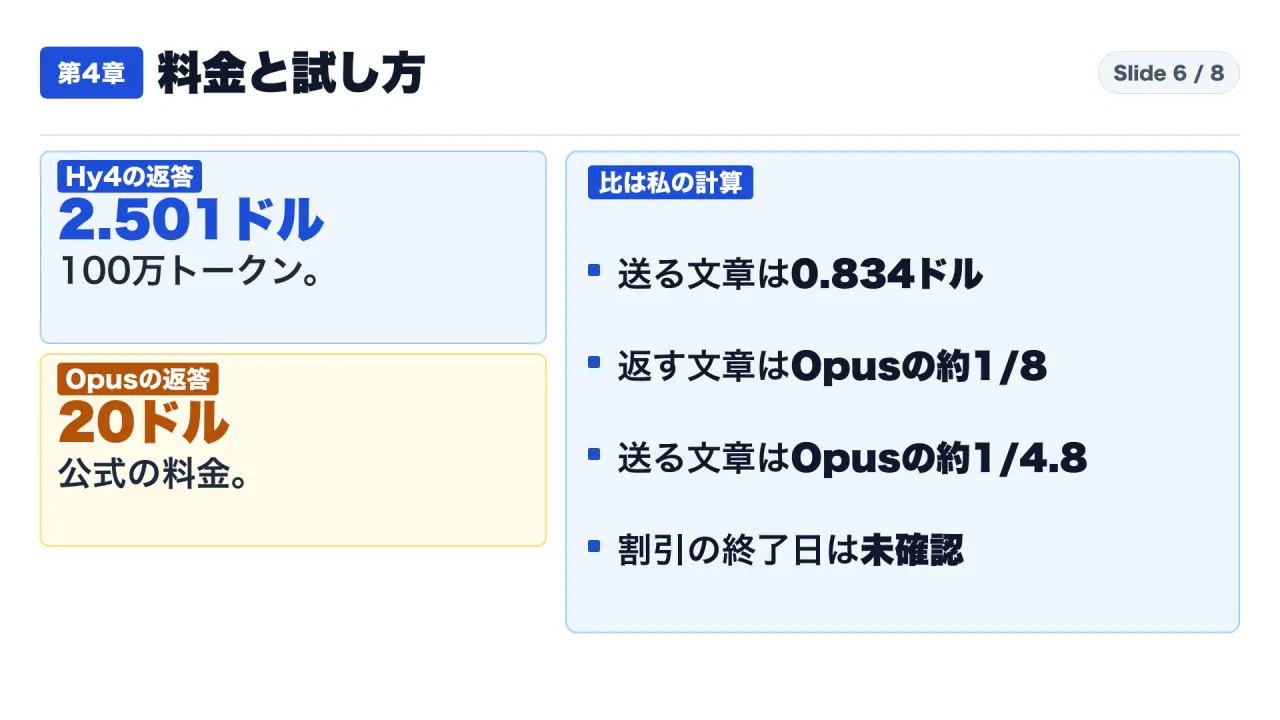
料金を確認します。単位は、百万トークンあたりの米ドルです。公式ページの価格表では、同じ文章を何度も送るときの料金(キャッシュ入力)が0.042ドル、AIに送る文章(入力)が0.834ドル、AIが返す文章(出力)が2.501ドルです。お試し版と同じ料金だと書かれています。キャッシュ入力は、何度も送る同じ入力を覚えておく仕組みの料金です。
比べるために、Anthropic公式の価格ページで、Claude Opus 5.5の料金を見ます。送る文章(入力)が4ドル、返す文章(出力)が20ドルです。返す文章で比べると、20÷2.501=約8です。つまり、Hy4の返す文章の料金は、Opus 5.5の約8分の1です。送る文章で比べると、4÷0.834=約4.8で、約4.8分の1です。「8分の1」は返す文章だけの比で、送る文章は約4.8分の1です。しかも、これは料金の比です。強さの比ではありません。
OpenRouterの掲載では、半額の表示(discount: 0.5)があり、返す文章が1.2505ドルです。割引が終わる日は、取得した範囲では確認できませんでした。
ここから、私の提案です。
- 自分の仕事から、困っている作業を3つ選びます。たとえば、毎週やっている資料の下書き、画面のスクリーンショットの読み取り、決まった手順のあるデータ整理などです。
- Hy4と、今使っているAIに、同じ設定で解かせます。条件を揃えないと、点数表と同じ問題が起きます。
- 正しさ、かかった時間、費用の3つを並べて見ます。費用は、料金表の単価と、実際に使ったトークン数から計算します。
- 利用の経路を確かめます。Tencent Cloudか、取次サービスか。データがどこで処理されるかは、公式ページの本文には書かれていません。規約を自分で読んでください。
- 重みの公開を待つ道もあります。公開日は決まっていません。待つ間は、窓口越しの小さな試験にとどめます。
よくある疑問と、資料で言える範囲
Q1:Hy4はOpus 5.5に勝ったのですか。 資料で言えるのは、付録の表の2つの試験(DeepSWE v1.1とAPEX-Agents v1.1)で、Hy4の数字がOpus 5.5の数字より大きい、ということだけです。APEX-Agents v1.1では差が0.4〜1.7点で、同じAIの2つの点数の開き(0.8〜1.7点)と同じか、それより小さい大きさです。勝ったとも負けたとも言えません。名前に「社内」と付かない14の試験で見ると、残り12の試験では、Opus 5.5が上です。APEX-Agents v1.1の73.5は、運営者Mercorの掲示板の数字と一致しますが、その掲示板に、Hy4の行はまだありません。
Q2:「8分の1の料金」なら、乗り換えたほうが得ですか。 料金の比と、仕事の出来の比は別です。8分の1は返す文章の料金で、送る文章は約4.8分の1です。料金は約8分の1ですが、同じ課題を解くのに必要なトークン数や、やり直しの回数が同じとは限りません。自分の課題3件で、費用と正しさを並べて見るまで、得かどうかは決められません。
Q3:重みが公開されたら、自社で動かせますか。 正式版の重みは「公開予定」で、日付もライセンスも書かれていません。お試し版はApacheライセンスで公開されていますが、総パラメータ数が770Bと大きいため、動かすには大きな計算機が要ります。必要な機材は、重みが出てから、モデルカードの説明で確認してください。
Q4:Tencentの表は信用できないのですか。 信用できない、と言っているのではありません。表は、Tencentが公式ページに載せた、Tencent自身の測定です。誰が測ったかが見える(星印がある)のは、読み手にとって助かる書き方です。ただ、Hy4自身の数字を、運営者や第三者が同じ条件で測った結果は、今回、見つけていません。それが揃うまでは、表は「出所の分かる、自社調べの点数」として読みます。
Q5:日本から使えますか。 公式ページは、Tencent CloudとOpenRouterで使えると書いています。日本からの利用条件や、データがどこで処理されるかは、公式ページの本文には書かれていません。利用前に、各サービスの規約で確認してください。
【私なりの解釈】何ができるかは明確、どこまで比べられるかは一部だけ
ここからは、事実ではなく、私なりの解釈です。ここまでの数字は、Tencentの公式ページ(付録の表を含む)か、第2章と第3章に書いた、他の公開ページに書かれていることです。私の計算は、そう断りました。
第1の解釈。何ができるかは、はっきりしています。画像を読む。パソコンを操作する。窓口越しにすぐ使える。しかも料金は低い。
第2の解釈。どこまで比べられるかは、表の一部だけです。差が大きい項目は、本当に差があると読めます。差が小さい項目は、どちらとも言えません。
第3の解釈。「安い」は確かな事実です。「強い」は、まだ自分の課題で確かめる段階です。
なお、Tencentの別のモデル、Hy-Memory-30B-A3Bについては、10月に別の回で取り上げました。別のモデルです。
言えないことも並べます。1つ目、独立した測定での順位。2つ目、Hy4自身の数字を、他の会社が測り直した結果。3つ目、日本から使える条件。4つ目、正式版の使い方のルール(ライセンス)と重みの公開日です。
3つの確認を、チームの手順にするには
確認を口頭で終わらせると、次の新しいAIのときに、また同じ議論が始まります。簡単な記録表を1枚作っておくと、判断が速くなります。列は5つで足ります。
- AIの名前と、確認した日付。AIは頻繁に更新されるため、日付がないと、あとで数字の意味が分からなくなります。
- 数字の出所。公式ページの自社測定か、運営者の掲示板か、各社のモデルカードか、自社の試験か。星印の有無も、ここに書きます。
- 設定。考え込む深さの設定、使った道具、1回あたりの最大の手数、制限時間。表の注記に書かれているものを、そのまま写します。
- 差の大きさと、同じAIの2つの点数の開き。差が開きより小さければ「どちらとも言えない」と記録します。
- 自分の課題での結果。正しさ、かかった時間、費用。
この表を埋めると、点数表の数字と自分の結果が、同じ紙の上に並びます。表の数字が高くても、自分の課題で結果が出なければ、採用の理由にはなりません。逆に、表の数字が控えめでも、自分の課題で十分な結果が出て、料金が低ければ、採用の理由になります。判断の中心を、公開された表から、自分の結果へ移すことが、この記事で伝えたい、いちばんの点です。
結論:試す前に確かめる3つのこと
公式ページが示していることをまとめます。Hy4は、画像を読み、パソコンを操作します。料金はお試し版と同じです。重みは公開予定です。そして、Tencent自身の表では、Hy4が上回る項目は少数で、差も小さい。大きく下回る項目もあります。順位は付けられません。
試す前に確かめることは、3つです。これは私の提案です。
- 誰が測った数字か。星印があるか。
- どんな設定か。自分の課題と同じ設定か。
- 差は、ぶれより大きいか。
明日できる小さな一歩は、今使っているAIで困っている作業を3つ書き出すことです。それが、Hy4を試す課題になります。点数表の数字より、自分の3つの課題のほうが、確かな材料です。
動画では、同じ内容を、音声と図で説明しています。見ながら確認したい方は、こちらをご覧ください。
YouTube本編:{{YOUTUBE_URL}}
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧(いずれも2026年11月4日から5日に確認)
- S1:Tencent Hy公式ページ「Introducing Hy4」と付録の表(2026年11月4日付):https://hy.tencent.ai/research/hy4?langVersion=en
- S2:OpenRouterのHy4掲載(API応答):https://openrouter.ai/api/v1/models/tencent/hy4/endpoints
- S3:Hugging FaceのHy4-previewモデルカード:https://huggingface.co/tencent/Hy4-preview
- S4:Anthropic公式の価格ページ:https://platform.claude.com/docs/en/about-claude/pricing.md
- S5:MercorのAPEX-Agentsの掲示板(Pass@1):https://www.mercor.com/apex/apex-agents-leaderboard/?pass=pass-1
- S6:Mercor「Introducing APEX-Agents 1.1」(2026年9月8日):https://www.mercor.com/blog/introducing-apex-agents-1-1/
- S7:Anthropic「Introducing Claude Opus 5.5」:https://www.anthropic.com/news/claude-opus-5-5
- S8:Hy4 previewのモデルカード(Hugging Face、付録の表):https://huggingface.co/tencent/Hy4-preview/raw/main/README.md
- S9:DeepSeek-V4.1-Flash-1017のモデルカード(Hugging Face):https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017/raw/main/README.md
原文は英語で、日本語は筆者の訳です。表の数字はTencent自身の測定で、筆者は測り直していません。売買の判断や投資の助言は含みません。