なぜKimi K3.1 Proは、重みが読めても「他社より上」と言えないのか?
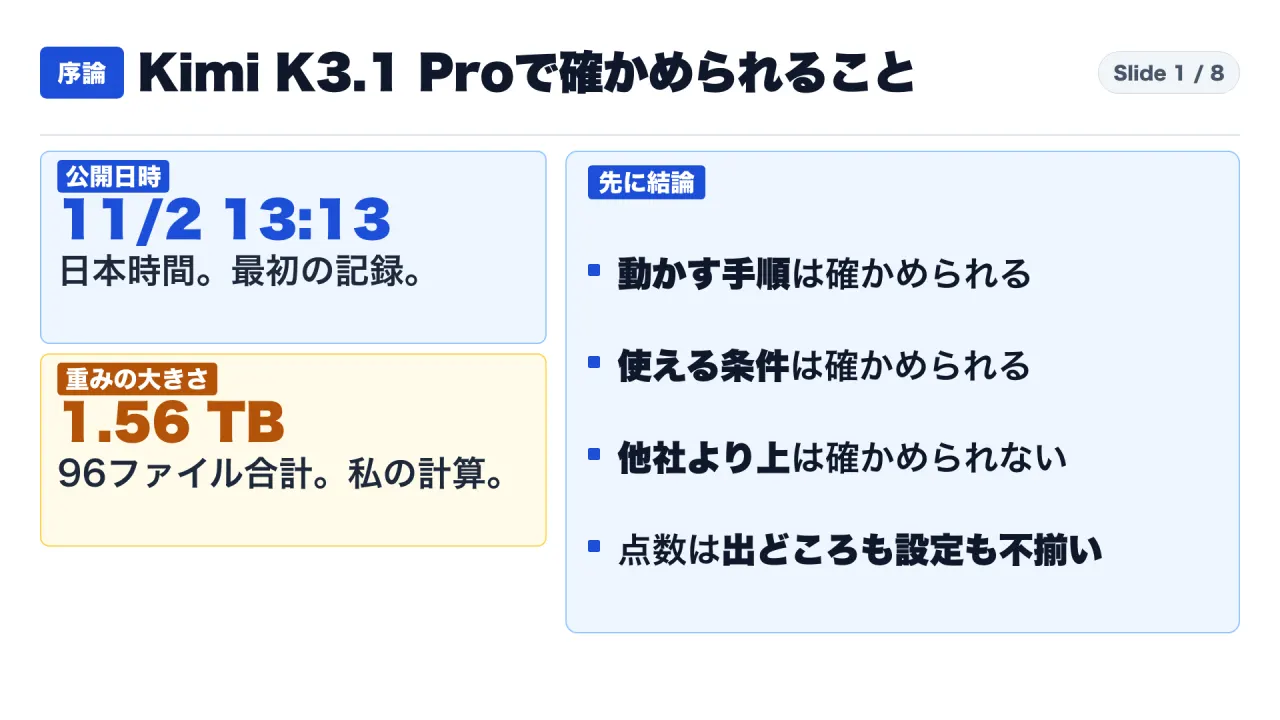
結論:重みは手に入り、手順と条件は読める。「他社より上」だけは確かめられない
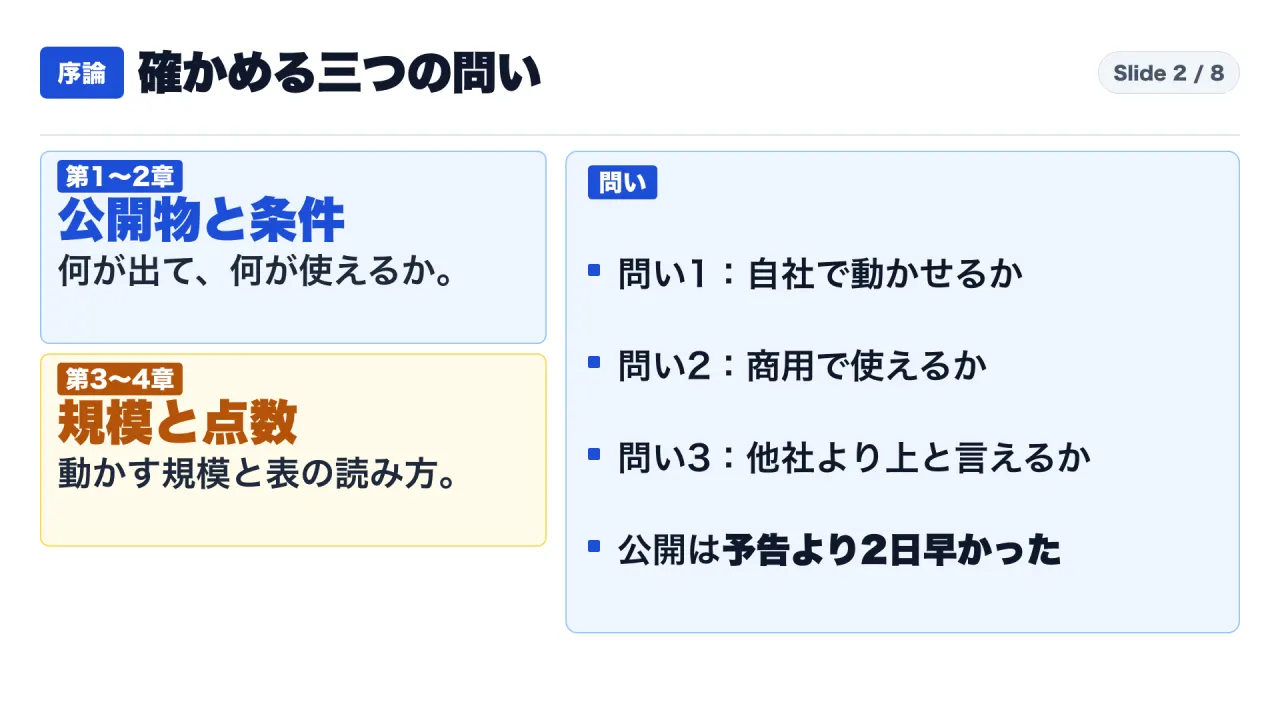
結論から書きます。Moonshot AI(ムーンショット)が2026年11月2日に公開した Kimi K3.1 Pro(以下、Kimi)について、「自社で動かせる」「商用で使える」「他社モデルより上」の3つのうち、一次資料で確かめられる範囲は次のとおりです。
1つ目の「動かせる」。重みのファイル(96個、合計1,561,293,160,568バイト、約1.56テラバイト)は、Hugging Faceで取得できます。動かす公式の手順は、推論ソフト vLLM の手順書にあります。基本の構成は、GPU 8基を一組にして動かす形です。確かめられるのは「構成と手順」までで、実際に動かした第三者の記録は、この記事の出典に含まれません。
2つ目の「商用で使える」。ライセンスの本文は短く、読めます。使う、複製する、改造する、再配布する、売る、追加で学習させる、を制限なしに認める書き出しです。ただし、本人か関連会社が Model as a Service という事業を運営していて、本人と関連会社の売上の合計が連続する12か月で2,000万米ドルを超える場合は、商用で使う前に Moonshot AI と別の契約が要ります。社内で閉じた利用は、この条件の対象外です。
3つ目の「他社より上」。確かめられません。評価表の点数は、出どころが分かれています。Kimi の点数は Moonshot AI 自身の測定が中心で、比べる相手の点数は、各社の発表、公式の掲示板、Artificial Analysis などからの引用です。測った人も設定も揃っていません。たとえば、表の Claude Opus 5.5 の Terminal-Bench 4.0 は66.4で、見出しは「max」ですが、原典の Anthropic の文書では、66.4は一つ下の「xhigh」設定の値で、max 設定では64.8です。
この記事は、重みが公開された新しいモデルを自社で使えるか迷う、開発・情報システムの担当者とその上司に向けています。読み終えると、次の3つができるようになります。自社の使い方が「社内で閉じる」のか「第三者に渡す」のかを書き分ける。月に出力するトークンの量から、窓口(API)と自前運用の分かれ目を概算する。自社の課題3件を同じ設定で試す計画を立てる。
売買の判断や投資の助言は扱いません。
読み方:事実、測った人、私の解釈を分けます
この記事では、3種類の文を分けて書きます。
- 事実:モデルカード、ライセンス本文、リポジトリの記録、公式の手順書、料金ページ、公式ブログ、比べる相手の発行元の文書に書いてあること。出典を付けます。
- 測った人:点数ごとに、誰が、どの道具で、どの設定で測ったかを添えます。
- 私の解釈:「私の計算」「私の読み」「私の提案」と書いた部分です。断定ではありません。
新しいモデルの紹介では、同じ分野の代表的なモデルと比べます。この記事では、最上位の閉じたモデルの代表として Claude Opus 5.5 を、Kimi の評価表に並ぶ相手として扱います。比べる相手の数字は、Moonshot AI の表と、Opus 5.5 の発行元である Anthropic の System Card(2026年9月22日)を並べて読みます。測定の設定が揃わないものは「出所により異なる」と書き、順位は作りません。
取得は2026年11月5日です。Hugging Faceの最新コミット(SHA)は 6d0a0202956796543364d666ab19c6ad1a494ee1 でした。カードやライセンスは更新されることがあるので、使う前に最新の版を確かめてください。
用語:先に言葉をそろえます
- 重み:学習で身につけた中身そのものです。手元のサーバーで動かすのに必要です。
- パラメーター:モデルの中の調整つまみのようなものです。数が多いほど大きなモデルです。
- 専門家混合(Mixture-of-Experts、MoE):小さな部品(専門家)を多数持ち、1つの言葉を処理するとき、その一部だけを使う作りです。
- 量子化:数を小さな桁数で持って、ファイルを軽くする工夫です。
- トークン:AIが文章を数える単位です。料金は100万トークンあたりで決まります。
- API:自分のプログラムから、ネット越しにAIを呼び出す窓口です。この記事では「窓口」とも書きます。
- vLLM:モデルを動かすための公開ソフト(推論エンジン)です。
- Model as a Service(MaaS):ライセンス上の用語です。第三者に、モデルの推論や追加学習へのアクセスを渡す事業を指します。定義は後で読みます。
問い1:何が公開されたのか
公開の日時:予告より2日早かった
Hugging Faceのリポジトリ記録では、最初のコミット(タイトルは「Initial commit」、コミットは1件のみ)の日時が 2026-11-02T04:13:51Z です。日本時間では11月2日の13時13分にあたります。取得前の承認を求める設定(gated)は、false でした。
Kimi の公式ブログは、重みの公開について「Full model weights will be released by Nov 4, 2026.」と予告しています。実際の公開は11月2日なので、予告より2日早い計算です(2日は私の計算です)。ブログ本文には発行日の表記が見つからず、発行日は確認できていません。
リポジトリの中身
ファイルの一覧は、次のものです。重みは model-00001-of-000096.safetensors から model-00096-of-000096.safetensors までの96個。ほかに、LICENSE、README.md、config.json、generation_config.json、tokenizer 関連のファイルと、configuration_kimi_k3.py、encoding_k3.py、kimi_k3_processor.py、kimi_k3_vision_processing.py、media_utils.py といった、動かすための Python ファイルが入っています。
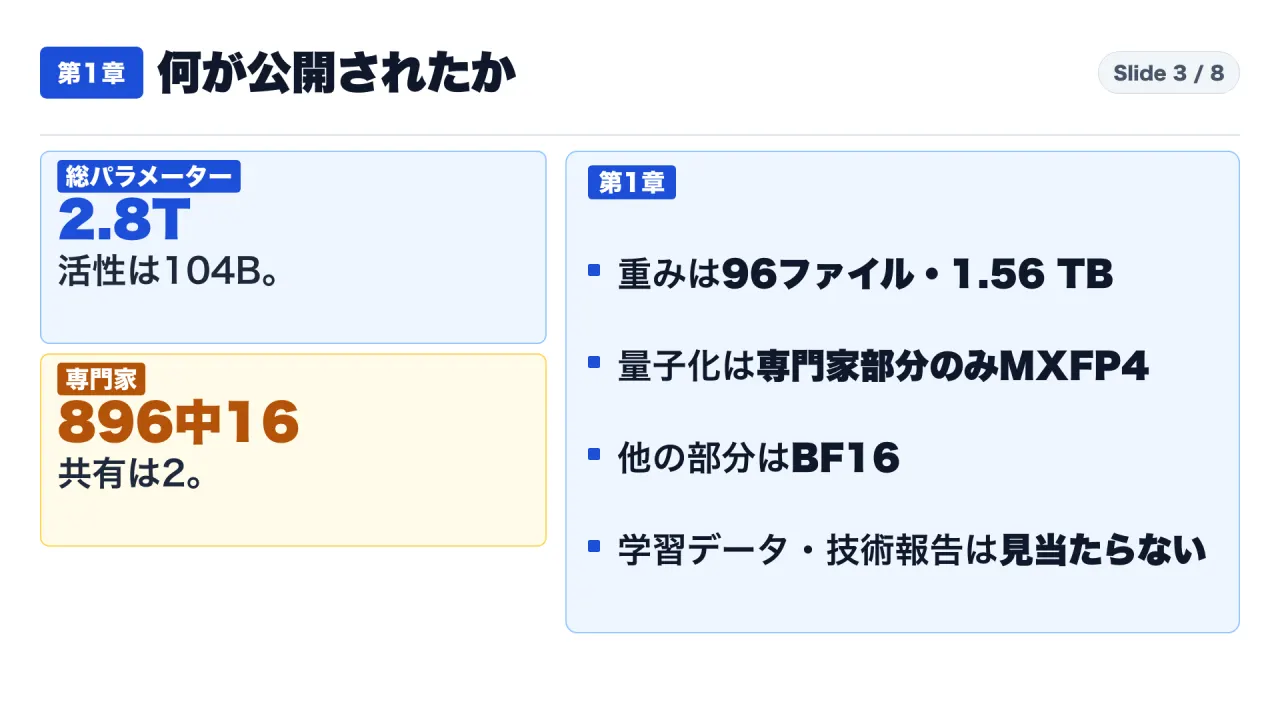
96個の重みファイルの大きさ(API の size の値)を足すと、1,561,293,160,568バイトです。1,561ギガバイト、約1.56テラバイトにあたります(この合計は私の計算です)。
中身の作り
モデルカードの要約表は、次のとおりです。
- 構造:専門家混合。総パラメーター数は2.8T(2.8兆)、1回の処理で働くパラメーターは104B(1,040億)。
- 層の数は93(うち密な層が1)。注意の層は、69層の KDA と24層の Gated DSA。脚注によると、前のモデル Kimi K3 の Gated MLA 層を、Gated DSA 層に置き換えたものです。
- 専門家は896。1つの言葉で16が選ばれ、共有の専門家が2つ。
- 文脈の長さは1048576トークン(約100万トークン)。
- 入力は文字と画像。画像用の部品(Vision Encoder)は MoonViT-V2、401M(4億1百万)パラメーター。
量子化の実態:全体が MXFP4 ではない
カードの表は「Quantization:MXFP4 weights / MXFP8 activations(quantization-aware training)」と書いています。ここだけ読むと、重みの全部が MXFP4 に見えます。
ところが、vLLM の公式の手順書は「The checkpoint ships MXFP4 routed-expert weights; everything else is BF16.」と書いています。MXFP4 にしたのは、専門家(routed experts)の重みだけで、ほかの部分は BF16 という、大きな桁数のままです。ですから、「全体が MXFP4」という言い方は、正確ではありません(この整理は私の判断です)。
公開されていないもの
取得したファイル一覧とモデルカードを読んだ範囲では、学習に使ったデータ、学習のプログラム、技術報告書の名前や、それらへのリンクは見当たりませんでした。カードのリンクは、Tech Blog と API Quickstart の2つです。カードは自分のことを「open-weight」のモデルと呼んでいます。重みが公開されたモデル、という意味です。
私は、この公開を「重みの公開」と呼び、「オープンソース」とは呼びません。学習を再現できる材料が見当たらないこと、そしてライセンスが一般的なオープンソースの型ではなく、カードの欄も「other」であることが理由です(呼び分けは私の判断です)。
問い2:商用で使えるのか。ライセンス全文を読む
ライセンスの名前は「Kimi K3.1-Pro License」で、本文は短い文書です。順に読みます。
最初の許可:広く、制限なし
冒頭は、広い許可の書き方です。重み、設定ファイル、推論と学習のコード、文書をまとめて「Software」と呼び、これを「without restriction」(制限なしに)扱ってよい、と書いています。例として、使う、複製する、改造する、統合する、公開する、配布する、サブライセンスする、売る、動かす、展開する、追加で学習させる、派生物を作る、が並びます。私の見立てでは、書き方は MIT という有名な型に近いです。ただし、この後に条件が付くので、同じ扱いにはできません。
条件1:表示と法令
著作権の表示と許可の文言を、すべてのコピーに付けること。そして、使い方は法令に従うこと。これはライセンスによくある条件です。
条件2:Model as a Service 事業の売上基準
本文は、Model as a Service を次のように定義します。第三者に、言語モデルの推論や追加学習へのアクセス(例:API 経由)を、入力、パラメーター、学習データに意味のある操作を許す形で渡すこと。
この定義から除かれるものが2つ書かれています。(a) モデルの機能が、特定の機能やハーネスの中にだけ組み込まれた、利用者向けの製品。(b) 他社が動かしているモデルへ、依頼を取り次ぐだけの中継。
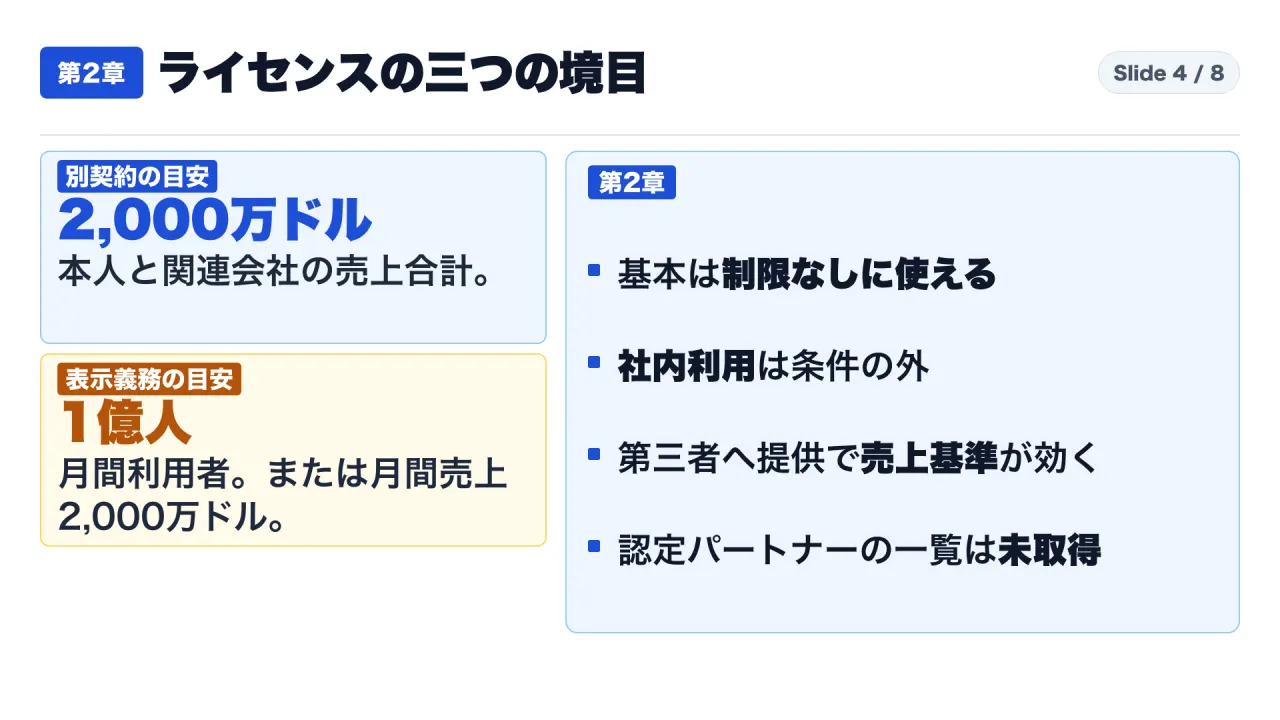
そのうえで、本人または関連会社が Model as a Service の事業を運営していて、本人と関連会社の売上の合計が、連続する12か月で2,000万米ドル(他の通貨なら同等額)を超える場合は、商用で使う前に Moonshot AI と別の契約を結ぶ必要があります。
注意したい点が2つあります。1つ目。基準にされる売上は「本人と関連会社の売上の合計」で、Model as a Service 事業だけの売上とは書かれていません。2つ目。別契約が必要になるのは、本人または関連会社が事業を運営している場合です。自社は運営していなくても、関連会社が運営していれば、この条件の対象になります。単にモデルを使う会社は、この条件の対象と書かれていません。
条件3:モデル名の表示
商用の製品やサービスで、月間のアクティブ利用者が1億人を超える、または月間の売上が2,000万米ドルを超える場合は、画面に「Kimi K3.1-Pro」を目立つ形で表示します。
例外:社内利用と公式経由
条件2と条件3は、次の場合にはかかりません。(a) 社内利用。ソフトウェア、その成果物、その能力を、第三者が使える形にしない利用、と定義されています。(b) Moonshot AI の公式製品、または認定された推論の提供元(certified inference partners)を通した利用。
書かれていないこと
「認定された推論の提供元」の一覧は、ライセンスにも、モデルカードにも、見当たりません。許諾の細かい境目についても、ライセンス本文以外の記載は、私が読んだ範囲にありません。
条件の組み合わせの例
条件は、事業の形ごとに効き方が変わります。たとえば、社内の文書要約だけに使う会社は、条件2と条件3のどちらも、例外(a)の社内利用に当たる可能性が高いです。自社のアプリの一機能として組み込む会社は、定義の除外(a)に当たるかが論点になります。自社の API として、外部の開発者にモデルを呼ばせる会社(関連会社がそうしている場合を含む)は、定義そのものに当たる可能性が高く、本人と関連会社の売上の合計が2,000万米ドルを超えるかを確かめます。この整理は、本文から私が読んだものであり、法的な判断ではありません。
私の読み
ここからは私の読みです。日本の多くの会社の、社内の資料作りや、社内システムの中だけで使う場面は、条件2と条件3の外に当たる可能性が高いです。自社のサービスにモデルを組み込んで、お客様に提供する場合は、「Model as a Service」の定義に当たるか、(a) の除外に当たるかを、契約の専門家に確認してください。私は法律の専門家ではありません。
次の表は、使い方を3つに分けた私の整理です。
| 使い方 | 例 | 条件2・3の扱い(本文から私が読んだもの) |
|---|---|---|
| 社内で閉じる | 社内の文書要約、社内の検索、開発者の補助 | 例外(a)の対象になる可能性が高い |
| 製品の一機能として組み込む | 自社アプリの要約ボタン | 定義の除外(a)に当たるかを確認 |
| 第三者に推論や追加学習へのアクセスを渡す | 自社の API として提供 | 定義に当たる可能性が高く、売上の基準を確認 |
問い3:動かす規模と、窓口の料金
公式の手順書が示す構成
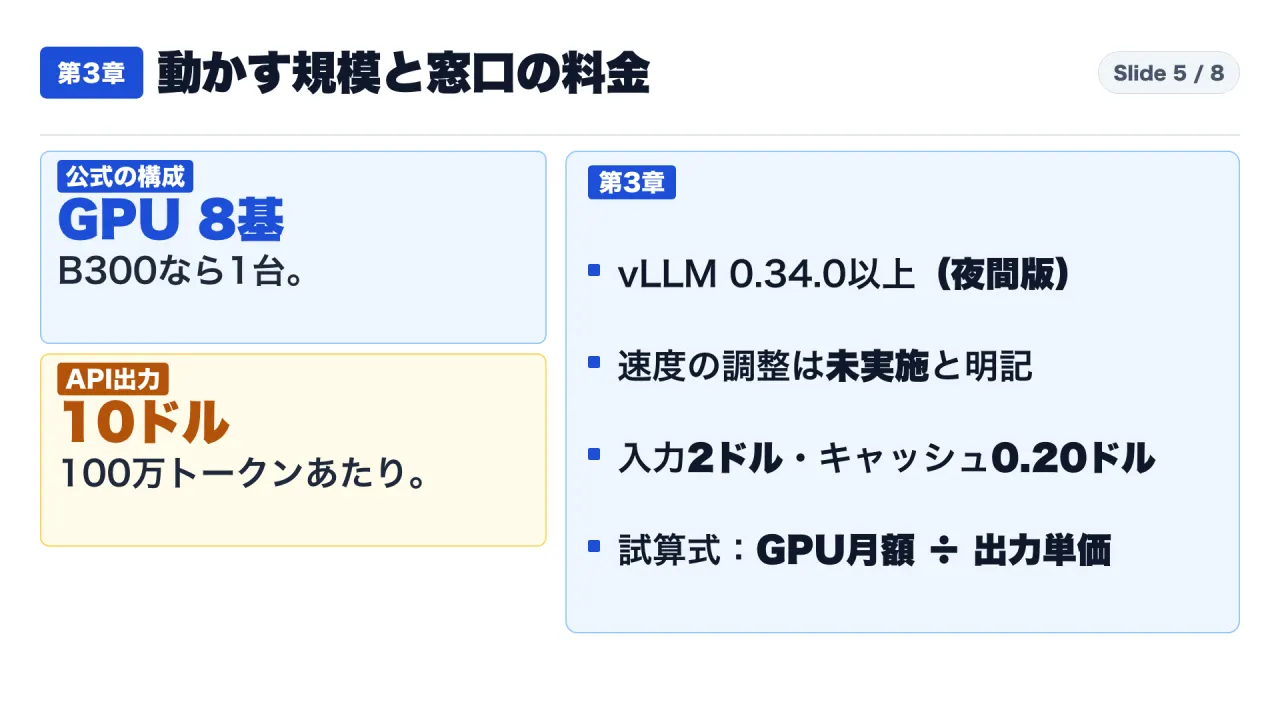
vLLM の公式の手順書(Kimi-K3.1-Pro の recipe)は、基本の構成を次のように書いています。「one tensor-parallel group of 8 GPUs, either two GB300 trays or one B300 node.」つまり、8基の GPU を一組にして動かす形で、NVIDIA の B300 なら1台のサーバー、GB300 なら2つのトレーです。続けて「Throughput was not tuned.」と書かれていて、速さの調整はしていません。
AMD の MI355X では、1台で同じ形が使えると書かれています。ただし「So far only the AgentX TP8 configuration has run on MI355X」とあり、動かした構成は特定の設定だけです。ほかに、Zhenwu PPU の2台構成や4台構成の記述もあります。
必要なソフトは、vLLM の0.34.0以上で、手順書は「not released yet — nightly wheel」(まだ公開前で、夜間版を使う)と書いています。
長い文脈を扱うときの注意
手順書の説明には、長い入力を扱うときの数字も出てきます。たとえば、8基の B300 で、34万トークンの1つの入力を読み込み終える(最初の出力が出る)までに、通常の並列方式で約15秒、別の方式(Tensor + Expert Parallel)で約10秒、と書かれています(測定は公開前のチェックポイントで、1リクエストずつ)。また、長い文脈の記憶(KV キャッシュ)を分散する方式(DCP8)では、保持できるトークン数が、8基の B300 で約260万から約1,850万に増える、とあります。ただし、この方式は1つずつ出力を作る速さが7〜25%遅くなる、とも書かれています。長い資料を何度も読ませる使い方では、基本の構成に加えて、こうした調整の検討が要ります。
確認できていないこと
私が確認できていないことを書きます。必要なメモリの公式の総量。実際にこの構成で動かした第三者の記録。日本語の仕事での性能。手順書には、構成のほかに測定の数字が少しあります。上で挙げた B300 8基の約10秒と約15秒(公開前のチェックポイント)のほか、GB300 8基で、KV キャッシュを NVFP4 にする設定を試した GSM8K の正答率が96.1%(FP8 は96.2%)と書かれています。ただし、これらは手順書に載った数字で、独立した第三者の再現は、この記事の出典に含まれません。
窓口(API)の料金
窓口越しなら、Kimi API の料金ページに料金が載っています(100万トークンあたり)。
| モデル | 入力 | 出力 | キャッシュ入力 |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
バッチ処理は、標準の価格の60%で請求されると書かれています。モデルカードは、OpenAI と Anthropic の互換の API がある、と書いています。考える深さの設定(reasoning_effort)は low、high、max のいずれかで、既定は max です。
粗い試算:窓口と自前運用の分かれ目
ここからは、私の粗い試算です。公表値ではなく、仮定を置いた計算です。
分かれ目を見る式は、次のとおりです。借りる GPU の月額 ÷ 出力の単価(100万トークンあたり)。結果は、月あたりの出力トークン量(100万単位)で、これより多く使うなら、費用だけで見ると自前運用が候補に入ります。
| 仮の GPU 月額 | 窓口の出力単価 | 分かれ目の出力量(月) |
|---|---|---|
| 5,000ドル | 10ドル | 500(100万トークン)=5億トークン |
| 10,000ドル | 10ドル | 1,000(100万トークン)=10億トークン |
| 20,000ドル | 10ドル | 2,000(100万トークン)=20億トークン |
たとえば、仮に月額が1万ドルなら、出力が月に10億トークンを超えるかどうかが目安になります。10億トークンは、1日あたりで約3,300万トークンです。社内の文書要約が中心なら、この量に届かない会社が多いと考えられます(これは私の推測で、根拠となる統計は持っていません)。
GPU の月額は、仮の数字です。実際に8基を借りる月額は、借りる先の料金表で確かめてください。この試算は、電気代、人件費、入力の費用、稼働率を含めていません。
問い4:他社より上と言えるのか。測った設定ごとに読む
評価表の前提
モデルカードの評価表は、Kimi と、Claude Fable 5.1、GPT-6 Astra、Claude Opus 5.5、DeepSeek-V4.1-Flash-1017、GLM-5.3 の計6つのモデルを並べています。冒頭の注によると、Kimi の結果は、考える深さを max にし、温度 1.0、top-p 0.95 の設定です。
表は47の評価が並び、そのうち8つは、名前に「Internal」(社内)と付く、Moonshot AI 自身の評価です。外の人は、同じ試験を受けられません(47と8は、取得した表の行を私が数えた値です)。
設定ごとの読み方
次の表は、主な行を、誰が、どの設定で測ったかと合わせて並べたものです。
| 評価 | Kimi(Moonshot AI の測定) | 表の Opus 5.5 | 原典・設定 | 読み方 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7(Claude Code) | 66.4(見出しは max) | Anthropic の文書では66.4は xhigh、max は64.8。安全装置が働いた試行が一割に影響。標準誤差±2.6 | 出所により異なる。順位なし |
| SWE Marathon v1.1 | 51.7(Claude Code で自測) | 46.3 | 注:Opus は公式の掲示板の値 | 測った人が違う。順位なし |
| HLE-Full w/ tools | 70.0 | 67.7 | 67.7は Anthropic の文書の値と同じ。Kimi 側の道具の構成は記載なし | 出所により異なる。順位なし |
| BrowseComp | 92.1(200K で文脈圧縮、手順は最大500回まで) | 90.8(GPT-6 Astra は91.5) | 相手の値の出所はカードに記載なし | 出所不明。順位なし |
| GDPval-AA v2.1 | 1846 | 1866 | Anthropic の文書は1846。表は引用元を Artificial Analysis と記載 | 出所により異なる |
| OSWorld | 79.6(V2.1) | 81.8 | Anthropic の文書の名称は OSWorld 2.0、同じく81.8 | 名称が違う |
Terminal-Bench 4.0 を詳しく読む
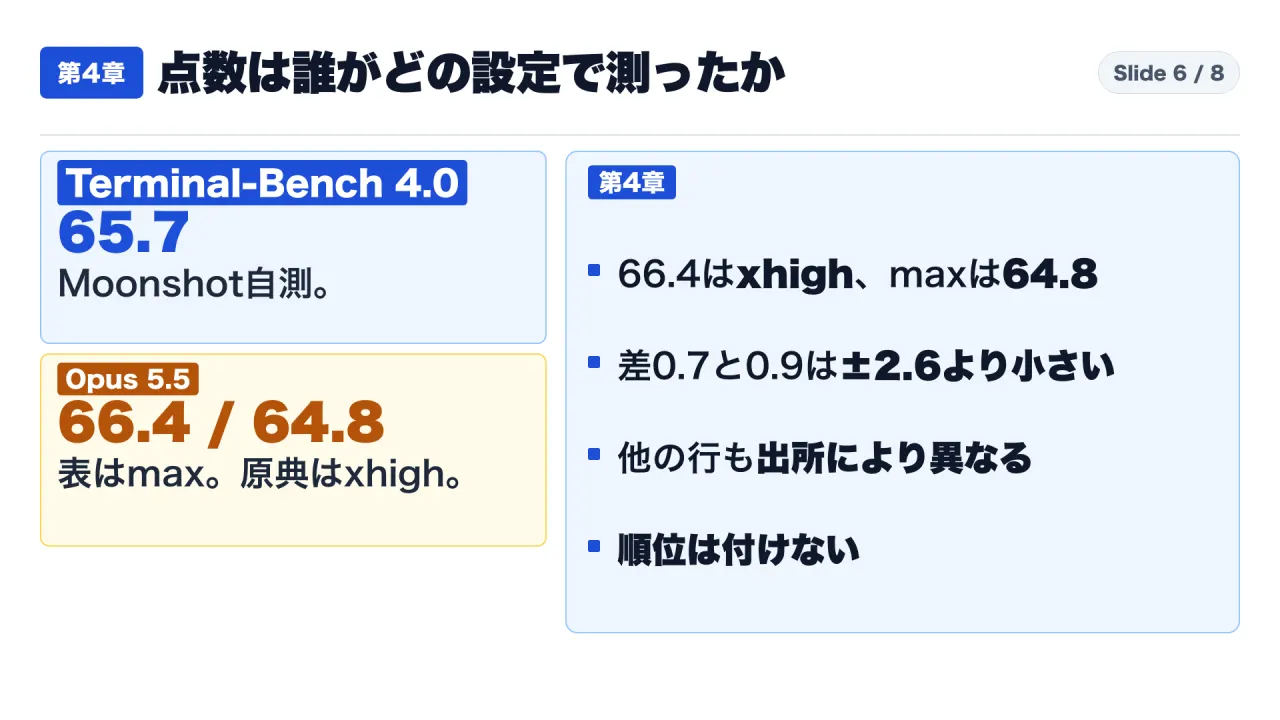
Kimi の65.7は、Moonshot AI が Claude Code という道具で自分で測った点数です(脚注1)。同じ脚注は、残りの点数は「モデルの発表や公式の掲示板にある最大値」と説明しています。
表の Opus 5.5 は66.4で、列の見出しは「max, w/ fallback」です。しかし Anthropic の System Card には、次のとおり書かれています。「Claude Opus 5.5 scored 66.36% on Terminal-Bench 4.0 with safeguards enabled; requests flagged by the safeguards were answered by a fallback model … (2.5% of requests, affecting 10% of trials).」そして「The numbers reported use Claude Code in –bare mode and xhigh thinking effort for Opus 5.5 (which at max effort scores 64.8%, within noise of xhigh)」。標準誤差は Opus 5.5 で±2.6点です。
整理します。66.4は xhigh 設定で、安全装置による切り替えが試行の一割に影響した値です。max 設定の値は64.8です。Kimi の65.7との差は、66.4とは0.7点、64.8とは0.9点です(私の計算)。どちらも、Opus 側の標準誤差±2.6点より小さい値です。ただし、Kimi 側の誤差の幅は、カードに書かれていません。
結論として、この行は順位を付けられません。付けられない理由は「差が小さい」ことだけではなく、「測った人が違い、設定が揃っていない」ことです。
そのほかの食い違い
HLE-Full with tools では、Kimi が70.0、Opus 5.5 が67.7です。67.7は、Anthropic の文書の表と同じ値です。ただし、カードには Kimi 側の道具の構成が書かれていないので、条件が揃っているかは確かめられません。
BrowseComp の Kimi の92.1は、文脈が20万トークンになったら圧縮し、手順は最大500回まで、という条件です。比べる相手の91.5と90.8が、どこから取った値かは、カードに書かれていません。
GDPval-AA v2.1 は、表の Opus 5.5 が1866ですが、Anthropic の文書は1846です。表は引用元を Artificial Analysis と書いていて、差の理由は書かれていません。OSWorld は、表の名称が「V2.1」、Anthropic の文書の名称は「2.0」で、Opus 5.5 の81.8は同じ値です。
表の中で、Opus 5.5 が Kimi 以上の行
表の全体を見ると、Kimi が全面的に上、というわけでもありません。たとえば Program Bench は、Kimi が31.5、Opus 5.5 が65.0です。AA-Briefcase v1.1 は、Kimi が1678、Opus 5.5 が1803です。APEX-Agents は、Kimi が69.4、Opus 5.5 が73.5です。いずれも、Moonshot AI が自分の表に載せた値です。点数の表は、強い行と弱い行を、まとめて見るためのものです。1行だけを取り出して「上」や「下」と言うのは、避けたほうが安全です。
点数を読むときの3つの問い(私の提案)
点数を見たら、次の3つを順に確かめます。1つ目、誰が測ったか。モデルを作った会社の自測か、評価の運営者か、第三者か。2つ目、どの道具と設定か。使った道具(Claude Code など)、考える深さ(max か xhigh か)、安全装置の有無。3つ目、差は誤差より大きいか。標準誤差が書かれていない点数は、差の大きさを判断できません。この3つが揃わない比べ方は、順位にしないほうがよい、というのが私の考えです。
独立した測定について
この記事の出典に、第三者が Kimi を測った結果は含まれません。ですから、「他社より上」という言い方は、少なくともこの記事の範囲では、確かめられません。
私なりの解釈:公開と条件は読める。点数は入口。決め手は自社の使い方
ここからは事実ではなく、私の解釈です。
第一に、公開された物と、使える条件は、本文で読めます。ここは確かめられる部分で、判断の土台にできます。
第二に、点数の表は、入口にはなります。ただし、測った人も設定も揃っていないので、他社より上、とは言えません。言えるのは、Moonshot AI が自社の測定で強いと示している、というところまでです。
第三に、自社で動かすかは、規模と使い方で決まります。GPU 8基を用意する力があるか。社内で閉じる使い方か。月の出力の量は、分かれ目の量を超えるか。この3つを順に見ます。
言えないことが4つあります。日本語の仕事での性能。「認定された推論の提供元」の範囲。安全性についての第三者の評価。そして、売買や投資の話で、これは扱いません。
明日できること:3つの確認と1つの試験(私の提案)
次の手順は、私の提案です。一次資料に書かれている範囲は、ここまでの各節に出典を付けています。
- 自社の使い方を書き分ける。社内で閉じるのか、製品に組み込むのか、第三者に推論へのアクセスを渡すのか。書き分けた結果を、ライセンスの条件2・3と照らして、必要なら契約の専門家に見せます。
- 月に出力するトークンの量を概算する。今の生成AIの利用ログから、出力の量を月で集計します。そして、上の式で分かれ目と比べます。GPU の月額は、借りる先の料金表の数字を使います。
- 自社の課題を3件選び、窓口を通して同じ設定で試す。互換の窓口があるので、試す手間は小さいです。考える深さの設定(既定は max)も、比べる相手とそろえます。やり切れたかと、かかった費用を、表に書きます。
- 使う前に、カードとライセンスの最新の版を確かめる。この記事は、2026年11月5日に取得した内容に基づきます。
契約の専門家に見せる質問の例も挙げます。自社のサービスは、定義の除外(a)(機能の一部への組み込み)に当たるか。自社と関連会社の売上の合計は、基準の2,000万米ドルに近いか。自社の利用者数や売上は、モデル名の表示が必要な水準か。使いたい推論の提供元は、認定されているか。この4つを書き出しておけば、相談の時間が短くなります。
よくある疑問
Kimi は他社のモデルより強いのですか?
確かめられません。評価表の点数は、Moonshot AI 自身の測定と、他社の発表や公式の掲示板からの引用が混ざっていて、測った人も設定も揃っていません。たとえば Terminal-Bench 4.0 の Opus 5.5 の66.4は、原典では xhigh 設定の値で、max 設定は64.8です。独立した第三者による比較測定は、この記事の出典に含まれません。
自社の社内システムで使うのに、別の契約は要りますか?
ライセンスの本文では、条件2(売上基準の別契約)と条件3(モデル名の表示)は、社内利用にはかからない、と書かれています。社内利用は「ソフトウェア、その成果物、その能力を、第三者が使える形にしない利用」と定義されています。自社の使い方が当てはまるかは、契約の専門家に確認してください。
重みは「オープンソース」ですか?
カードは「open-weight」と書いています。重みが公開されたモデル、という意味です。ライセンスは一般的なオープンソースの型ではなく、カードの欄は「other」です。学習データや学習のプログラムも、見当たりません。この記事では「重みの公開」と呼んでいます。
全体が MXFP4 で軽くなっているのですか?
専門家の部分だけです。公式の手順書は、MXFP4 は専門家(routed experts)の重みで、ほかは BF16 と書いています。重みの合計が約1.56テラバイトであることは、ファイルの大きさを足した値です。
認定された推論の提供元はどこですか?
ライセンスにも、モデルカードにも、一覧は見当たりません。私が読んだ範囲では不明です。使う前に、Moonshot AI に確認してください。
動画での解説
この記事の内容は、YouTube の動画でも解説しています。
https://www.youtube.com/watch?v=VyVWY-lWPmE
初めての方は、固定の自己紹介記事もご覧ください。
https://note.com/consuloji_ch/n/n1975ecc3cf48
この記事で扱わなかったこと
確認できなかったために、扱わなかったことを書きます。Moonshot AI の公式 X の投稿は、本文を読めず、確認していません。GPT-6 Astra の OpenAI の公式ページは、取得時にアクセスの確認画面が出たため、回避せず、取得していません。ですから、比べる相手の GPT-6 Astra の数字は、Moonshot AI の表の値として引用するにとどめ、原典との突き合わせはしていません。技術報告書は、カードにリンクがなく、見ていません。ブログの発行日、認定された推論の提供元の一覧、日本語の性能、日本国内での提供やデータの置き場所も、扱っていません。
また、2026年10月24日の、Kimi K3.1 Pro を扱った別の回の内容は、再び述べていません。その回は、重みの公開が予定だった時点のものです。この記事は、重みが実際に公開された後の、重み・ライセンス・動かす規模・点数の設定に絞っています。
出典
- S1:Kimi K3.1 Pro のモデルカード(Hugging Face):https://huggingface.co/moonshotai/Kimi-K3.1-Pro/raw/main/README.md
- S2:Kimi K3.1-Pro License(ライセンス全文):https://huggingface.co/moonshotai/Kimi-K3.1-Pro/raw/main/LICENSE
- S3:Hugging Faceのリポジトリ記録(API):https://huggingface.co/api/models/moonshotai/Kimi-K3.1-Pro
- S4:vLLM の公式レシピ(Kimi-K3.1-Pro):https://recipes.vllm.ai/moonshotai/Kimi-K3.1-Pro.md
- S5:Kimi API の料金ページ:https://platform.kimi.ai/docs/pricing/chat
- S6:Kimi 公式ブログ「Kimi K3.1 Pro」:https://www.kimi.ai/blog/kimi-k3-1-pro
- S7:Anthropic「Claude Opus 5.5 System Card」(2026年9月22日):https://www.anthropic.com/claude-opus-5-5-system-card