なぜ米巨大ITが社債を増やす裏で、主権AIが浮上するのか?──IMF報告書とMistral Large 4の重み公開から読み解く
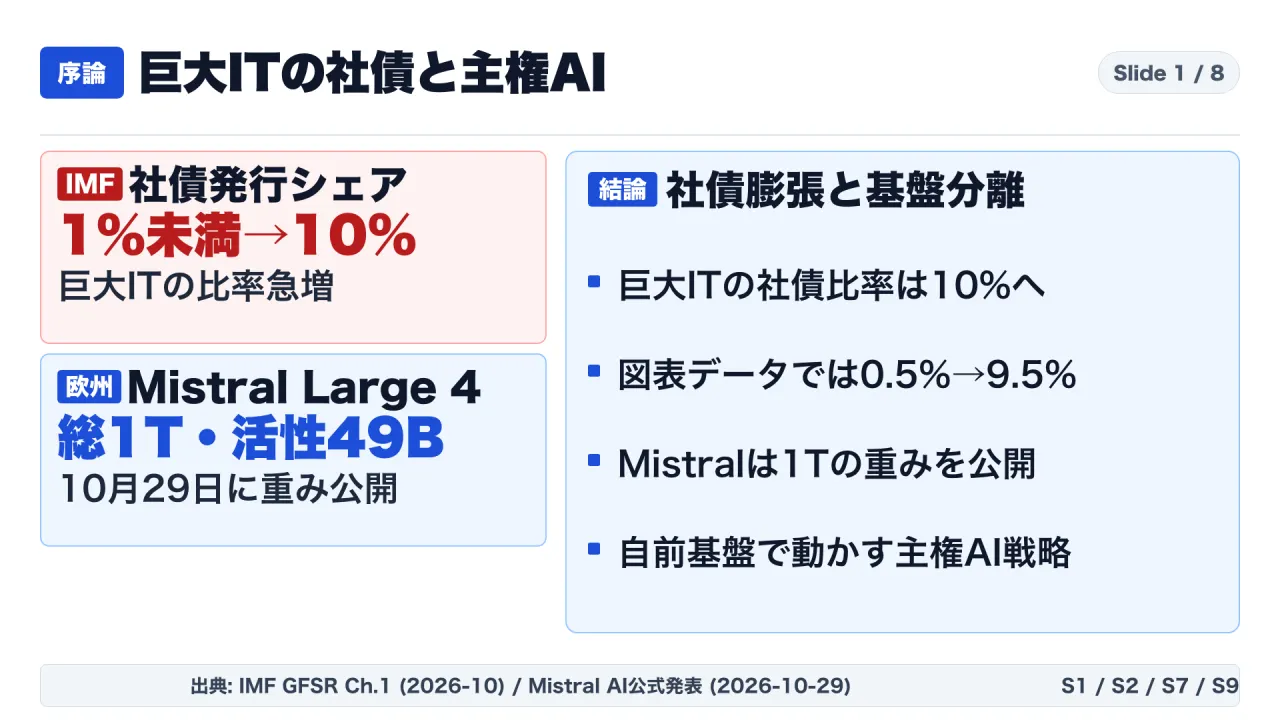
結論:米ハイパースケーラーの投資適格社債の発行シェア10%への急増とAI循環取引6,500億ドルに対し、欧州Mistralは重み公開と欧州法下インフラで対抗する
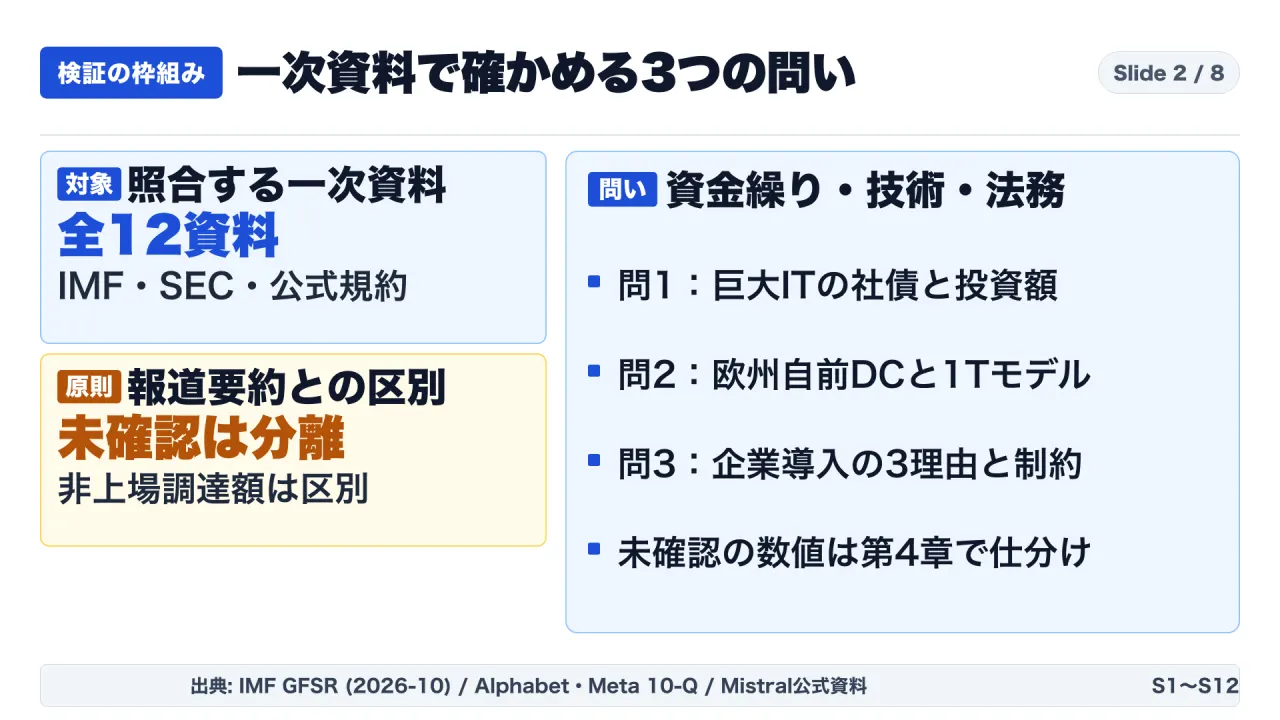
結論から書きます。国際通貨基金(IMF)が2026年10月に公表した『世界金融安定報告書(Global Financial Stability Report:GFSR)』の要旨および第1章、米国証券取引委員会(SEC)に提出された Alphabet と Meta の2026年第3四半期報告書(Form 10-Q)および社債の価格決定書(FWP)、そして仏 Mistral AI が公開した Mistral Large 4 の公式発表・技術ブログ・モデルカード・ライセンス全文という12件の一次資料を照合すると、次の3つの事実が確認できます。
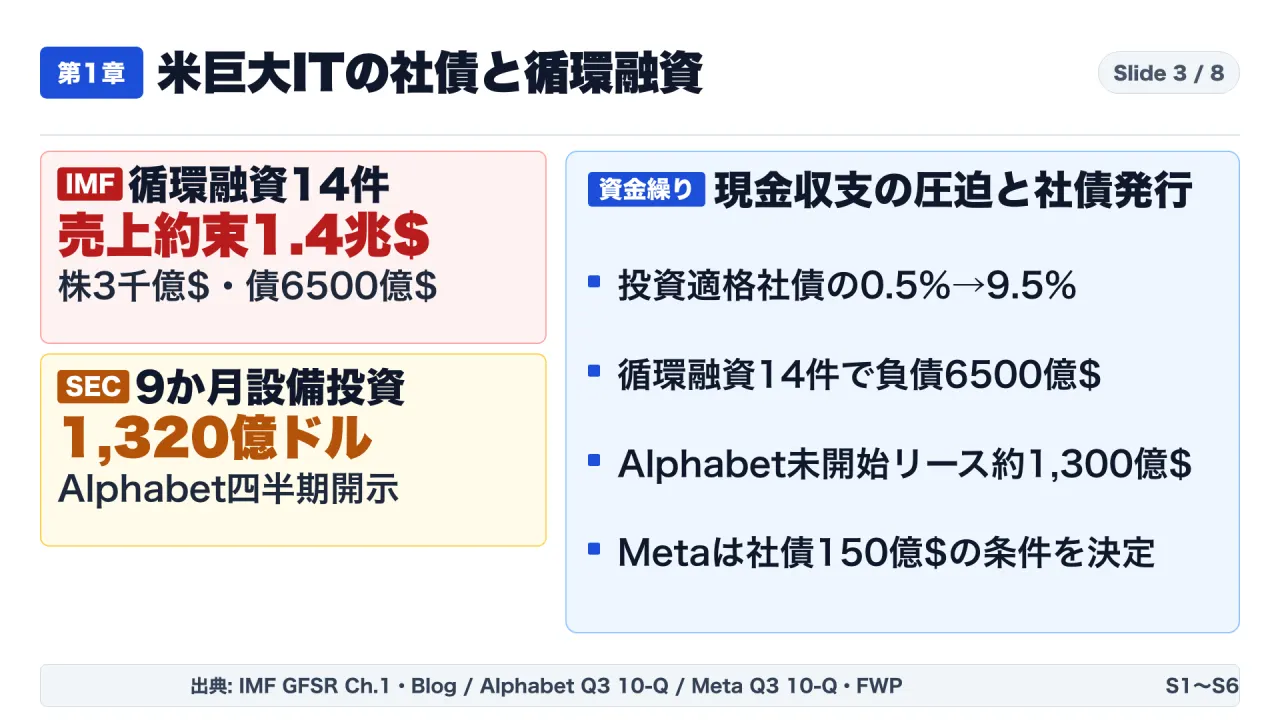
1つ目は、米国の巨大テック企業(ハイパースケーラー)のAIデータセンター投資が、手元資金だけでは賄いにくくなり、社債市場と、AI企業どうしの「循環融資(Circular Financing)」への依存が強まっていることです。IMFの2026年10月GFSR第1章(S2)によると、世界の投資適格(Investment-Grade:IG)社債の発行に占めるハイパースケーラーの割合は、2024年以降、1%未満から10%へ増えました(図表データでは2024年末の0.5%から2026年7月時点の9.5%)。さらにIMFは、2023年以降に公開された14件の取引で、ハイパースケーラー主導の株式出資が約3,000億ドル、そこに加わる負債が6,500億ドル、見返りの将来の売上の約束が1.4兆ドルあると集計しました。負債のうち約3,200億ドルは、出資を受けた側の企業が負っています(投資家の保証が付いた負債や簿外の負債を含みます)。SEC提出書類でも、Alphabet の2026年1〜9月期の設備投資は約1,320億ドル(前年同期は約636億ドルで、2倍超)、まだ開始していないリースの将来の支払額は1,305億ドル(130.5 billion)です。Meta は2026年通期の設備投資を1,350億〜1,450億ドルと見込み、解約できない契約上の支払約束は4,545億2,000万ドルで、11月3日には合計150億ドルの社債の発行条件を決めました。
2つ目は、欧州の Mistral AI が、こうした米ハイパースケーラーの閉鎖型API・巨額負債モデルとは異なる軸として、「主権AI(ソブリンAI)」とオープンウェイトモデルに経営資源を集中していることです。Mistral は総パラメータ1兆個(1T)・活性パラメータ490億個(埋め込み層・出力層込みで520億個)のネイティブマルチモーダルMoEモデル Mistral Large 4 を公開しました(S6, S7, S9)。このモデルは、フランス・パリ近郊の自社データセンターに設置された NVIDIA Grace Blackwell(GB200)GPU 3,840基(技術報告書S11の数。モデルカードS9と公式発表S6は欧州の自社データセンターのGrace Blackwell 3,800基と書いており、数が違います)を用い、**45日間(約415万GPU時間、S11)**かけてゼロから学習されました。欧州向けの提供環境は、欧州法のもとでMistralが一貫して運用するとされています。企業が同モデルを採用する構造的な理由は、①モデルの知財(IP)層とインフラ層の分離による事業継続性、②機密データを域外に出さず自社の管理下に置くデータ主権、③3段階の推論モード(reasoning_effort)切り替え等によるコスト制御の3点にあります。
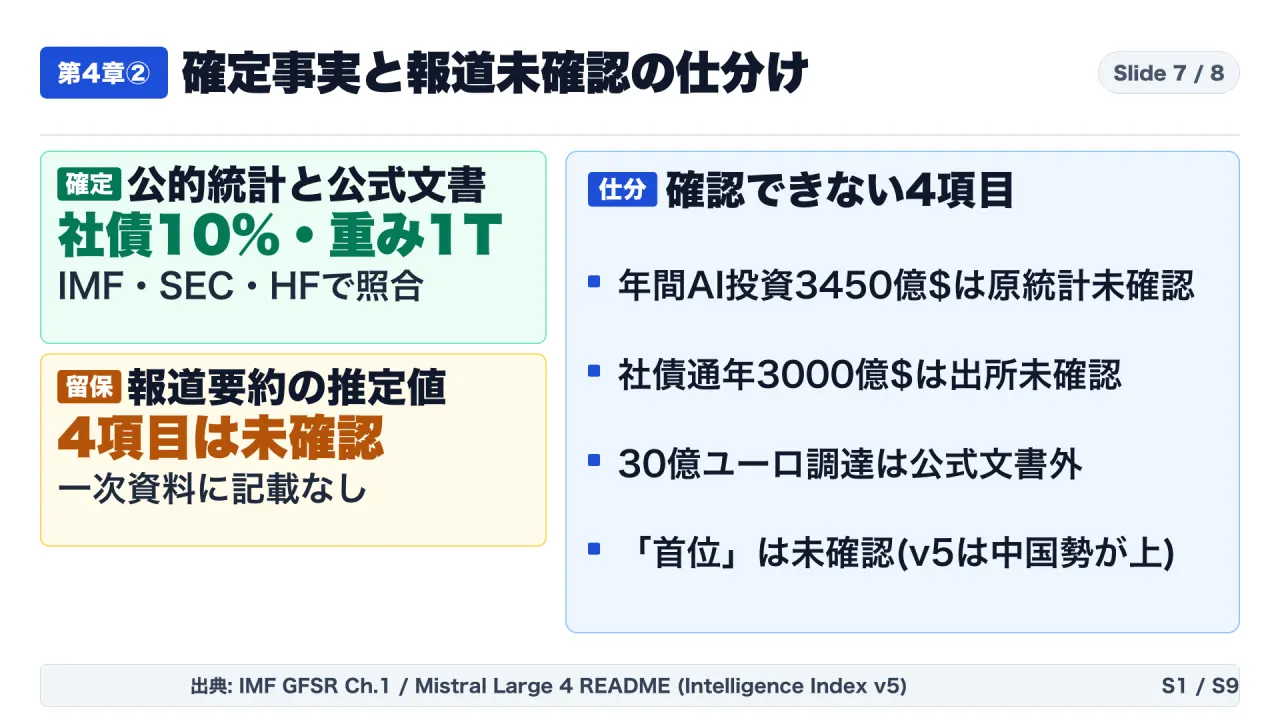
3つ目は、放送インタビューの要約等で流通している数値のうち、一次資料で確定できる事実と、非上場企業のため公開一次資料では確認できない事項(および自社運用の重い制約)を厳格に切り分ける必要があることです。インタビュー要約にある「AI年間投資額が2022年11月の1,120億ドルから2025年末に3,450億ドルへ増加」「Mistralが30億ユーロを調達し企業価値210億ユーロに到達」といった数値や、創業者によるテレビ番組での口頭発言は、非上場企業の報道値・放送発言であり、今回検証した公的統計や公式技術文書からは裏付けられないため**「未確認」**として分離します。また、Mistral Large 4 を自社導入する際には、①推論APIやホスティング窓口を外販する「Model as a Service(MaaS)」事業には別契約が必要(ライセンス第2条)、②リポジトリ全体の保存容量が約1.06テラバイト、圧縮したNVFP4版でも606ギガバイトという重い設備要件、③ソフトウェアと運用が欧州主権であっても計算ハードウェアは米国 NVIDIA 製GPUに依存している、という3つの実務上の制約を直視する必要があります。
この記事は、生成AIのインフラ選定や長期契約、社内・専用環境(オンプレミス/VPC)でのモデル運用を検討している経営企画・情報システム・アーキテクト・法務の担当者に向けて書いています。読み終えると、①米ハイパースケーラーの社債急増と循環取引6,500億ドルが自社のクラウド契約にどう影響するかを把握する、②Mistral Large 4 の技術仕様・ライセンス条文・設備要件(8基構成 vs 4基NVFP4構成)を正確に比較する、③報道のバリュエーション数字に惑わされず、公的統計と契約条文に基づいて自社のAI基盤戦略を設計する、という3つの実務判断ができるようになります。なお、株式や債券の売買・投資判断は一切扱いません。
この記事の読み方:放送インタビュー要約の「未確認事項」と一次資料の「確定事実」を厳格に分けます
本記事では、情報の出所と検証可能性に応じて、記述を次の3つの区分に厳密に分けて提示します。
- 一次資料の確定事実:IMFの『世界金融安定報告書(2026年10月版)』要旨・第1章・公式ブログ(S1〜S3)、SEC EDGARに提出された Alphabet および Meta の Form 10-Qと社債の価格決定書(S4, S5, S12)、Mistral AI の公式発表・技術ブログ・Hugging Face上のモデルカード・ライセンス全文・API記録(S6〜S11)に明記されている数値・条文・仕様です。
- 自前計算(公表値からの算術換算):Alphabet の2026年1〜9月期設備投資(キャッシュフロー計算書の有形固定資産の取得 131,953百万ドル)を前年同期(63,596百万ドル)で割った「約2.08倍(2倍超)」、3,840基のGPU×45日間×24時間から算出した「約415万GPU時間(4,147,200時間)」、およびHugging FaceAPIの
usedStorage(1,060,619,283,859バイト)を $10^{12}$・$10^9$ で割った「約1.06テラバイト(約1,061ギガバイト)」です。文中および検証票に「私の計算」と明記します。 - 一次資料で未確認の事項(放送インタビュー要約・報道値):入力された放送インタビュー要約に含まれる「2022年11月のAI投資1,120億ドル→2025年末3,450億ドル」「2026年のハイパースケーラー適格社債借入3,000億ドル・翌年15%増」「Mistralの30億ユーロ調達・企業価値210億ユーロ」「Station F や労働市場に関する口頭発言」です。これらは公的統計(IMF・SEC)および公式技術仕様書には記載がないため、事実として断定せず「未確認」として切り分けます。
先に用語をそろえます
本文に入る前に、金融安定報告書とAIモデル仕様書を横断して読むために必要な6つの専門用語を定義します。
- ハイパースケーラー(Hyperscalers):Google(Alphabet)、Meta、Microsoft、Amazon などの、世界規模で超大型データセンター網とクラウド・AI基盤を建設・運営する巨大テクノロジー企業を指します。
- 投資適格社債(Investment-Grade Bonds:IG社債):格付け機関から高い信用格付け(BBB格/Baa格以上)を付与された企業が発行する社債です。機関投資家や年金基金が幅広く保有する債券市場の中核であり、この市場での発行シェア急増は、特定の産業への信用リスク集中を意味します。
- 循環取引(Circular Financing Deals):IMFが2026年10月GFSR第1章で分析した構造で、巨大テック企業やチップ供給企業がAI新興企業やデータセンター事業者(ネオクラウド等)に出資・融資や将来購入保証を与え、その資金で投資先が再び出資元の半導体やクラウド・電力を購入・借り入れする相互依存的な資金循環を指します。
- ソブリンAI(Sovereign AI:主権AI):国家や地域の法制度(欧州であれば欧州の法制度)の管轄下にあるデータセンターと通信網の内部で、モデルの学習から推論運用、機密データの保管までを完結させ、域外の法執行や地政学的な供給停止から業務を守る考え方です。
- 知財(IP)層とインフラ層の分離(Decoupling IP from Infrastructure):AIモデルの重み(知識・アルゴリズム)と、それを動かす物理サーバーやクラウドを分けて管理する設計です。重みが公開(オープンウェイト化)されていれば、特定のクラウド事業者が値上げや規約変更を行っても、同じモデルを別のクラウドや自社サーバーへ移し替えて業務を継続できます。
- Model as a Service(MaaS):Mistral のライセンス契約第2条で定義される事業形態で、モデルやその派生モデルへの推論・ファインチューニングの窓口を第三者へ提供し、その第三者が入力やパラメータを実質的に制御できるようにするサービス(API外販やホスティング再販)を指します。
全体比較マトリクス:米ハイパースケーラーの財務膨張 vs. 欧州 Mistral AI の主権型オープン戦略
まず、IMF報告書・SEC提出書類が示す米国ハイパースケーラーの資金調達構造と、Mistral AI の技術・ライセンス・運用構造を一覧表で対比します。
| 検証領域 | 米国ハイパースケーラー(IMF GFSR / Alphabet & Meta SEC書類) | 欧州 Mistral AI(Mistral Large 4 公式発表・技術ブログ・モデルカード) | 企業導入・調達における実務上の意味 |
|---|---|---|---|
| 資本・設備投資の規模 | ・Alphabet 2026年1〜9月期CapEx:約1,320億ドル(MD&A表記。前年同期は約636億ドルで約2.08倍:私の計算) / ・Meta 2026年通期CapEx見通し:1,350億〜1,450億ドル(1〜9月は有形固定資産の取得830.55億ドル、ファイナンスリース元本返済を含めると858.2億ドル) | ・パリ近郊の自社データセンターで NVIDIA GB200(Grace Blackwell)3,840基(技術報告書の数。モデルカード・公式発表は3,800基で数が違う)を使用 / ・45日間(約415万GPU時間:私の計算)でゼロから事前学習 | 米大手のCapExは、Metaが通期1,350億〜1,450億ドル、Alphabetが9か月で約1,320億ドルです。Mistralは3,840基・45日間で1兆パラメータの重みを学習したと記録されています |
| 負債・社債市場への依存 | ・世界IG社債発行に占めるシェアが2024年以降の1%未満(2024年末0.5%)から10%(2026年7月時点9.5%)へ増加(IMF S1, S2) / ・Alphabet:2026年1〜9月に米ドル建社債450億ドル+外貨建358億ドルを発行(S4) / ・Meta:2026年11月3日に合計150億ドルの社債の発行条件を決定(S12) | ・※放送要約の「30億ユーロ調達・企業価値210億ユーロ」は非上場企業のため公開一次資料では未確認 / ・欧州向けの提供環境は欧州法のもとでMistralが運用 | クラウドAPIの価格や提供条件が、巨額CapExと社債・借り換えの環境にどう影響するかは、今回の資料からは断定できません(私の整理)。ただし資金調達への依存度は確認すべき論点です |
| 契約上の支払約束・循環融資 | ・IMFが集計した14件の取引:ハイパースケーラー主導の株式出資約3,000億ドル、負債6,500億ドル(うち出資を受けた側が負うのは約3,200億ドル)、将来の売上の約束1.4兆ドル(IMF S2) / ・Alphabet 未開始リースの将来支払額(割引前):1,305億ドル(S4) / ・Meta 解約できない契約上の支払約束:4,545.2億ドル(S5) | ・モデルの重み(Mistral-Large-4-1T-A52B)をHugging Faceで公開し、重み(モデル)と計算基盤(インフラ)を分離して持てる |
特定のクラウドや出資を受けた側の事業者の経営が悪化した場合に備え、重みを手元に持てば計算基盤を乗り換えやすくなります(私の整理) |
| モデル構造・推論コスト制御 | ・主に閉鎖型APIまたは自社クラウド密結合で提供 | ・総計1兆(1T)/活性49B(埋め込み・出力層込み52B)のネイティブマルチモーダルMoE、1Mコンテキスト / ・API価格:入力$0.70/キャッシュ**$0.07**/出力**$2.10**(100万トークンあたり) / ・推論の深さを3段階で切替可能(モデルカードの reasoning_effort は low/medium/high) |
タスクの難易度に応じて推論の深さを3段階で選べるため、トークン消費と性能のバランスを調整できます |
| ライセンスと利用制約 | ・各社のクラウド利用規約・API規約に従う(モデルの重み自体は非公開または独自制約) | ・Mistral Ecosystem Open-Weight License(S8) / ・第三者に提供しない社内利用は第2条の対象外(第3条) / ・機能の一部として組み込んだだけのエンドユーザー向け製品は、MaaSの定義から除外(第2条の定義) / ・MaaS事業を営む場合は別契約が必要(第2条) | 社内利用は第2条の対象外です。第三者に推論などのアクセスを、入力などを実質的に制御できる形で提供するなら、MaaSに当たるか法務で確認が必要です |
| 自社運用のハードル | ・API利用なら自社GPU不要だが、データが外部クラウドを通過する | ・リポジトリ全体の保存容量 約1.06TB(モデルカードのvLLM例はGPU 8基のテンソル並列) / ・NVFP4(4ビット量子化)版のチェックポイントは 606GB(技術報告書: GB300×4基で動作) / ・計算チップ自体は米国 NVIDIA製 に依存 | 自前運用には、GB300を4基〜8基規模のインフラが必要になりえます(保存容量はGPUメモリ量とは別の数字です) |
第1章:放送インタビュー要約の「未確認数字」と一次資料の「確定事実」を仕分ける
今回のテーマの出発点となった放送インタビュー要約には、マクロのAI投資額や社債借入額、そして Mistral AI の資金調達に関する複数の数値が含まれていました。しかし、企業の意思決定や技術選定において、テレビ番組での口頭発言や二次まとめの数値をそのまま根拠に使うことはできません。12件の一次資料と突き合わせた仕分け結果は以下の通りです。
1. 公開一次資料では「未確認」として切り分けるべき事項
以下の4点は、今回取得した公的機関(IMF・SEC)の報告書および Mistral AI の公式発表・技術資料には記載が存在しないため、**「未確認」**として扱います。
- 「AIへの年間投資額が2022年11月の1,120億ドルから2025年末に3,450億ドルへ200%以上増加した」という数値:放送番組のナレーション等で引用された推計値ですが、集計対象(民間VC投資のみか、設備投資を含むか等)の一次統計定義が不明確であり、今回の一次資料群では確認できません。
- 「2026年通年のハイパースケーラーによる投資適格社債市場での借入額が約3,000億ドルに達し、翌年さらに15%増加する」という予測値:報道の要約にある予測値で、出所を確認できません。後述の通り、IMFの公的統計で確認できるのは「世界の投資適格社債の発行に占めるハイパースケーラーのシェアが、2024年以降、1%未満から10%へ増えた」という確定実績と、「AI関連14件の循環取引における負債総額6,500億ドル(うち投資先側約3,200億ドル)」という集計です。
- 「Mistralが30億ユーロを調達し、企業価値が210億ユーロに達した」という資金調達・バリュエーション数値:Mistral AI は非上場企業であり、公式リリース(S6)や技術ブログ(S7)、モデルカード(S9)には資金調達額や企業価値の記載はありません。非上場企業のバリュエーション報道値は一次資料で裏付けられないため、未確認として分離します。
- 「欧州のレイトステージ資金ギャップや、北欧・バルト諸国・オランダ等の柔軟な労働市場でAI導入が速く進む」という見解:放送番組の出演者の口頭意見として要約に書かれた内容であり、検証可能な一次データではありません。
2. 公的機関および公式技術文書で「確定事実」として裏付けられる事項
一方、放送インタビューが提起した核心の論点――「米国ハイパースケーラーの設備投資が巨額の社債・オフバランス負債へ膨張していること」、および**「欧州の Mistral AI が主権型展開(ソブリンAI)とオープンウェイトモデルを軸に独自のポジションを築いていること」**――は、IMFのGFSR、Alphabet・MetaのSEC提出書類、およびMistralの公式資料によって、より具体的かつ厳密な数値で裏付けられます。次章以降で、これらの確定事実を順に読み解きます。
第2章:IMF『世界金融安定報告書(2026年10月)』が示すハイパースケーラー社債10%と循環融資の負債6,500億ドル
なぜ今、企業のAI基盤選定において「ハイパースケーラーの財務と社債発行」が問題になるのでしょうか。それは、AIデータセンターの建設競争が、巨大テック企業の潤沢な営業キャッシュフロー(手元資金)だけで完結する段階を過ぎ、世界の債券市場とプライベートクレジット市場を巻き込んだ巨大なレバレッジ構造へと変質しているためです。
1. 世界の投資適格(IG)社債発行シェアが「0.5%→9.5%(約10%)」へ急増
IMFの2026年10月GFSR第1章(S2)には、次の記述があります。
“First, since 2024, hyperscalers’ share of global investment-grade bond issuance has increased to 10 percent from less than 1 percent. … Yet, free cash flows are rapidly declining as hyperscalers try to sustain large AI investment needs, leaving debt financing increasingly necessary.”(出典:S2)
同報告書の図表データ(S2の図1.2)では、ハイパースケーラーのIG社債発行シェアは、2024年末の0.5%から2026年7月時点の9.5%へ上がっています。ここでのハイパースケーラーは、ブルームバーグの定義に基づく、巨大なクラウドとデータセンターの事業者です。
IMFは、ハイパースケーラーは本業では強い利益を上げている一方で、フリーキャッシュフローが急速に減っており、借り入れが必要になりつつあると述べています。社債市場での存在感が高まったことで、金利や信用環境の変化が投資ペースに響きうる、というのは私の整理です。
2. 主要14件の「循環取引(Circular Financing)」に潜む負債6,500億ドルと将来契約1.4兆ドル
IMF第1章(S2)は、ハイパースケーラー主導でAI企業に出資し、その見返りとして将来の売上を約束してもらう「循環融資」を集計しています。
“Fourteen publicly disclosed transactions since 2023 account for approximately $300 billion of aggregate equity investments led by hyperscalers in financially weaker AI firms, supplemented by $650 billion in debt, in exchange for $1.4 trillion in future revenue commitments through services or chip orders”(出典:S2)
“About $320 billion of the $650 billion debt is taken on by investees in circular financing deals, including debt backed by investor guarantees, contingent financing, and other off-balance-sheet debt.”(出典:S2 図1.2の注)
この14件の構造を整理すると、次の3点が読み取れます。
- 株式出資に対して大きい負債:株式出資が約3,000億ドルであるのに対し、そこに加わる負債は6,500億ドルです。
- 出資を受けた側への負債の集中:6,500億ドルの負債のうち約3,200億ドルは、出資を受けた側の企業が負っています。投資家の保証が付いた負債、条件付きの資金調達、その他の簿外の負債を含みます。
- 1.4兆ドルの将来の売上の約束:出資や融資の見返りとして、サービスや半導体の発注という形で、将来の売上の約束が1.4兆ドルあります。
IMFは、出資を受けた主要企業の経営が悪化すると、出資や融資の価値が、将来の売上が傷つくのと同じタイミングで下がる「誤った方向のリスク(wrong-way risk)」が生じうると指摘しています(S2)。
第3章:Alphabet と Meta の SEC 提出書類(Form 10-Q / 社債の価格決定書)で見る巨額 CapEx とリース債務の実態
IMFのマクロ分析が個々の企業の財務諸表でどう現れているのかを、Alphabet(Google親会社)と Meta Platforms が米国証券取引委員会(SEC)に提出した2026年第3四半期(9月30日終了四半期)の Form 10-Qと、Meta の社債の価格決定書(FWP)で確認します。
1. Alphabet(Google):9ヶ月間で設備投資約1,320億ドル、社債調達約808億ドル、未開始リースの将来支払額1,305億ドル
Alphabet の2026年第3四半期 Form 10-Q(S4)を確認すると、AIインフラ投資のすさまじい加速が具体的な数字で記録されています。
- 9ヶ月間の設備投資が前年同期の2倍超の約1,320億ドル:MD&A(S4)は、2025年と2026年の1〜9月の設備投資を636億ドルと1,320億ドルと記載しています。キャッシュフロー計算書の有形固定資産の取得は、63,596百万ドルから131,953百万ドルで、比は約2.08倍(私の計算)です。
- 9ヶ月間で約808億ドルの社債を発行:Alphabet は2026年に、米ドル建てのシニア無担保社債を 450億ドル、外貨建て(ポンド、スイスフラン、ユーロ、カナダドル、円、豪ドル)のシニア無担保社債を 358億ドル 発行しました。合計は 808億ドル(私の計算)です。2026年9月末の長期債務の帳簿価額は 1,251億ドル です。
- まだ開始していないリースの将来支払額が1,305億ドル:2026年9月30日時点で、データセンターとエネルギー設備を中心に、まだ開始していないリースの将来の支払額(割引前)は130.5 billion ドル(1,305億ドル)で、まだ帳簿に計上されていません。リースは2026年から2031年に開始し、解約できないリース期間は1年から26年です。
2. Meta Platforms:通期設備投資1,350億〜1,450億ドル、契約上の支払約束4,545億2,000万ドル、11月3日に社債150億ドルの発行条件を決定
同じく Meta Platforms の2026年第3四半期 Form 10-Q(S5)と、2026年11月3日付の社債の価格決定書(FWP、S12)にも、大きな資金需要と契約上の拘束が記されています。
- 通期設備投資見通し1,350億〜1,450億ドル:2026年1〜9月期の設備投資は、有形固定資産の取得とファイナンスリースの元本返済の合計で858.2億ドルです(うち有形固定資産の取得は830.55億ドル)。
- 解約できない契約上の支払約束が4,545億2,000万ドル:2026年9月30日時点の、解約できない契約上の支払約束(non-cancelable contractual commitments)は454.52 billion ドル、つまり4,545億2,000万ドルです。内訳や支払の時期は、本記事では確認していません。
- 2026年11月3日に合計150億ドルの社債の発行条件を決定:価格決定書は、2031年・2033年・2036年・2046年・2056年満期の5本(32.5億・32.5億・40億・17.5億・27.5億ドル)を示しています。受渡日は2026年11月5日です。
これらSEC提出書類の数字は、米国のハイパースケーラーが今後数年間で数千億ドル規模の固定費と負債・リース契約を背負っていることを示しています。企業ユーザーがこれらのクラウドAPIに全面的に依存する場合、将来的なコスト転嫁や提供条件の変更リスクを構造的に織り込んでおく必要があります。
第4章:欧州 Mistral AI の対抗軸――「Mistral Large 4」の仕様と主権型インフラ
こうした米国勢の巨額負債・閉鎖型クラウド路線に対し、欧州を代表するAI企業であるフランスの Mistral AI は、まったく異なるアプローチをとっています。それが、自前の欧州データセンターで学習したフラッグシップモデルの重みをオープンウェイトとして公開し、**「デジタル主権(ソブリンAI)」**を重視する企業や公共機関の需要を取り込む戦略です。
1. 総計1兆・活性49B〜52BのネイティブマルチモーダルMoE「Mistral Large 4」
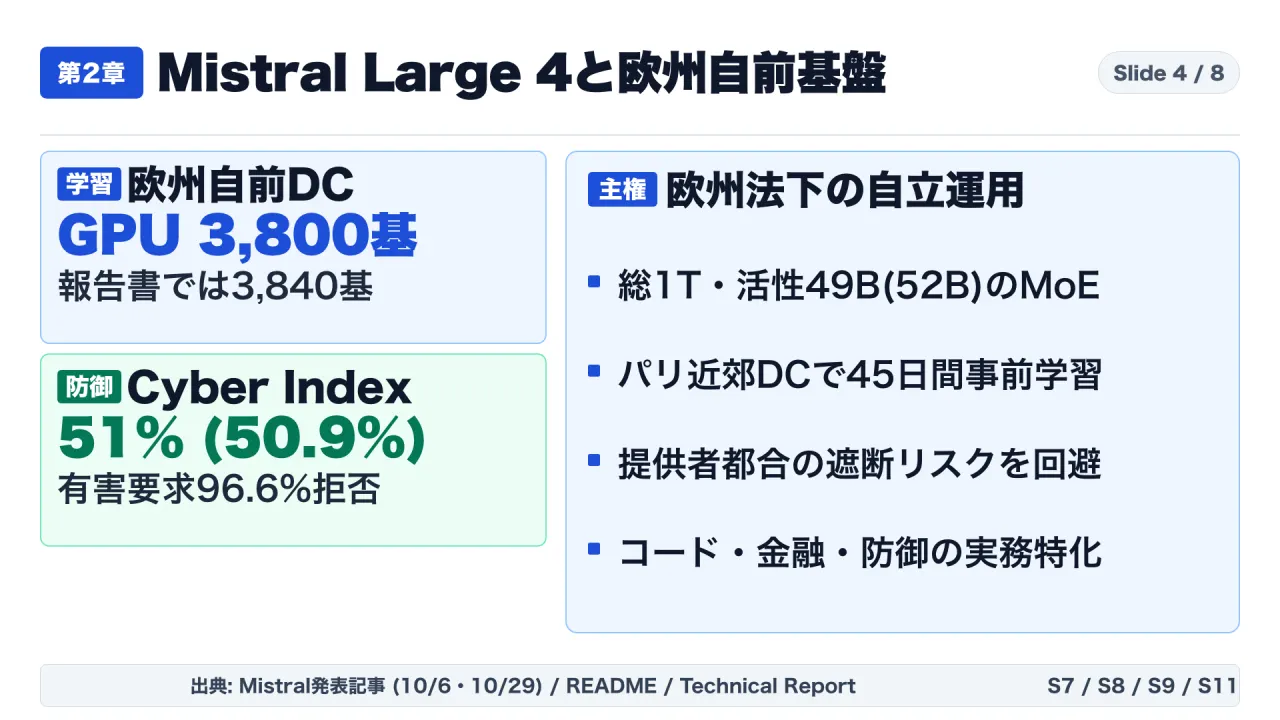
Mistral AI の公式発表(S6)、技術ブログ(S7)、およびHugging Face上のモデルカード(S9)によると、最新フラッグシップモデル Mistral Large 4(リポジトリ名:mistralai/Mistral-Large-4-1T-A52B、公式発表の愛称 “Le Chonk”)の主要仕様は以下の通りです。
- パラメータ構成:総パラメータ数は 1兆個(1 trillion) の Mixture-of-Experts(MoE)モデルです。1トークンを処理する際に動く活性パラメータは 490億個(49B)、埋め込み層(embeddings)と出力層(output layers)を含めても 520億個(52B) に抑えられています。
- ネイティブマルチモーダルと100万トークンコンテキスト:テキストと画像・文書を最初から統合して扱うネイティブマルチモーダル設計であり、最大 100万(1M)トークン のコンテキストウィンドウと、160以上の言語(コードを含む)に対応しています。
- パリ近郊の自社データセンターで3,840基のGB200を用い45日間で学習:技術報告書(S11)には、このモデルがフランス・パリ近郊の Mistral 自社データセンターに設置された NVIDIA GB200(Grace Blackwell)GPU 3,840基(モデルカード(S9)と公式発表(S6)の表記は欧州の自社データセンターのGrace Blackwell 3,800基で、技術報告書(S11)の3,840基と数が違います。どちらかに決めず、出所ごとに分けて読みます)の上で、わずか 45日間(3,840基×45日×24時間=約415万GPU時間:私の計算)でゼロから事前学習されたことが記されています。欧州向けの提供環境は、他のデジタルサービス事業者に依存せず、欧州法のもとでMistralが一貫して運用すると、発表記事(S6)に記載されています。
2. 汎用ベンチマークの点数競争から「実務タスク・主権展開」への集中
興味深いのは、Mistral 自身が自社の立ち位置をどう書いているかです。放送インタビューの要約では、創業者の「主権型展開向けのオープンソースモデル提供企業として首位にある」という発言が紹介されていましたが、モデルカード(S9)は、Artificial Analysis の Intelligence Index v5 での Mistral Large 4 のスコアを 26、「西側のオープンウェイトモデルでは最高」と記したうえで、中国の上位のオープンウェイトモデルはこの総合指標でより高いスコアだと書いています。
つまり Mistral は、「すべての汎用ベンチマークで世界1位になること」で勝負しているのではありません。公式発表(S6)および技術ブログ(S7)が強調しているのは、以下の実務特化性能とコスト効率です。
- コーディング・エージェント性能:Artificial Analysis の Coding Agent Index で 48% です。公式ブログ(S7)によると、先頭のオープンウェイトモデル GLM-5.3 とほぼ同等で、1タスクあたりのトークン消費は平均で47%少なくなっています。
- サイバーセキュリティ性能:Artificial Analysis の Cyber Index で 51%(技術報告書の表では50.9%)です。有害なサイバー要求への平均の拒否率は 96.6% で、公式ブログは、測定したオープンモデルの中で最高としています。防衛向けには、選ばれた設計パートナーに、侵入テストや脆弱性評価などに最適化した専用版のプレビューが提供されています。
- 欧州法のもとでの運用とデータの域内完結:欧州向けの提供環境は、Mistralが欧州法のもとで一貫して運用すると発表記事(S6)に書かれています。機密データを域外に出さずに自社インフラで動かせる点は、公式記事(S7)の導入企業のコメントでも評価されています。
第5章:企業がオープンウェイトモデルを導入する「3つの構造的理由」
放送インタビューの中で Mistral 側が挙げた「企業がオープンウェイトモデルを導入する3つの理由」は、公式発表(S6)および技術ブログ(S7)と照らして整理します。エンタープライズアーキテクチャの観点から、この3つの理由を整理します。
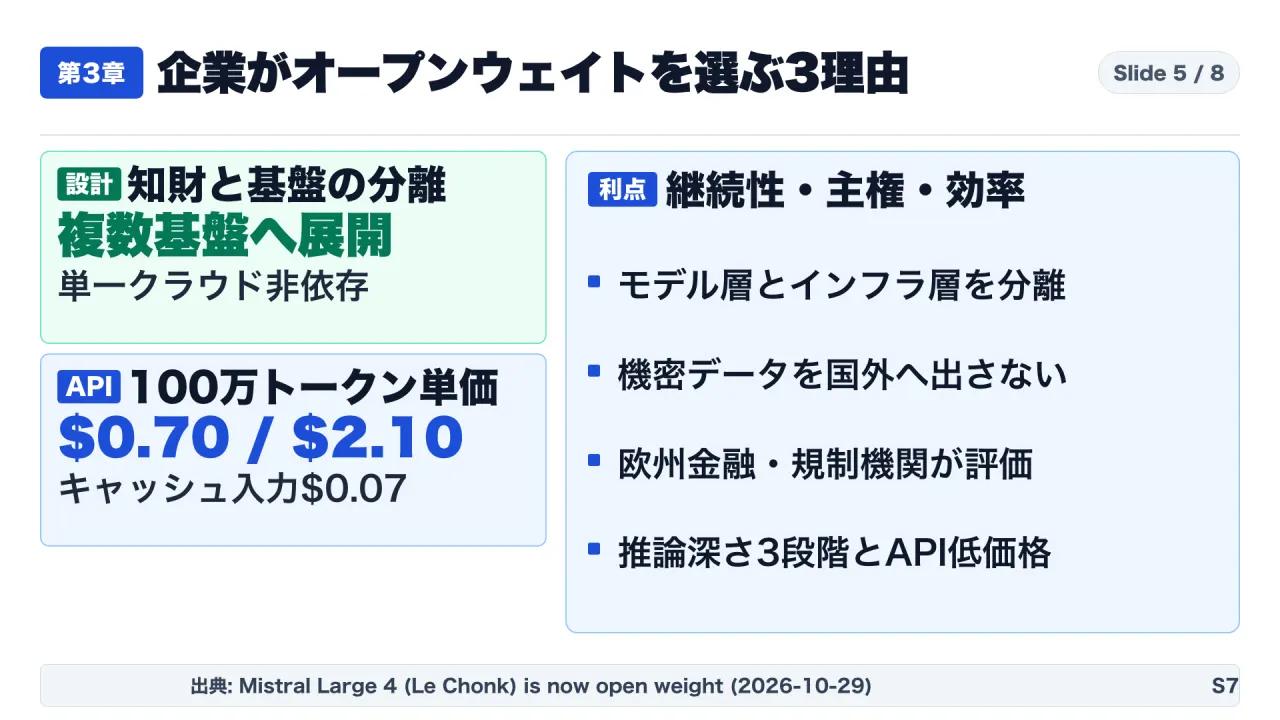
理由1:知財(IP)層とインフラ層の分離による「事業継続性(Business Continuity)」
閉鎖型の商用API(特定のハイパースケーラーが独占提供するモデル)に業務システムを密結合させてしまうと、そのクラウド事業者が料金を大幅に引き上げたり、特定バージョンの提供を打ち切ったり、あるいは第2章で見たようなインフラ投資・負債構造の歪みから供給制限を行ったりした際に、企業側は逃げ場を失います。
これに対し、Mistral Large 4 のように重み(IP層)が公開されていれば、普段は Mistral の公式APIや提携クラウドを使っていても、いざという時には同じ重みファイルを自社のオンプレミスサーバーや別のVPC環境へ持ち出して、業務ロジックやプロンプトを書き換えることなく稼働を続けられます。この「いつでもインフラを乗り換えられるポータビリティ」が、長期の事業継続性を担保します。
理由2:機密データの非共有(データを動かさず、モデルをデータの近くへ置く)
防衛、金融、医療、半導体設計、あるいは企業の未公開財務データを扱う業務では、たとえクラウド事業者が「API入力データは学習に使わない」と規約に書いていても、安全保障や業界規制の観点から**「そもそも自社の管理境界(オンプレミスや国内専用VPC)の外へデータを送信してはならない」**という厳格なガバナンス要件が課されます。
オープンウェイトモデルであれば、巨大な機密データベースを外部クラウドへ転送するのではなく、モデルの重みの方をデータが存在する社内ネットワークの内側へ持ち込んで推論を実行することができます。
理由3:3段階の推論モードと価格設計による「TCO(総所有コスト)の制御」
単発の試作であれば従量課金のクラウドAPIが安価ですが、全社員や顧客向けに毎日数億〜数十億トークンを処理する本番運用では、トークン消費量の制御がコストに直結します。Mistral Large 4 の公式発表(S6)およびモデルカード(S9)には、コストを抑えるための具体的な仕組みが2つ用意されています。
- API価格とキャッシュ割引:公式APIの価格は、入力が100万トークンあたり 0.70ドル、キャッシュヒット時の入力が 0.07ドル(10分の1)、出力が 2.10ドル です(S7)。
- 単一モデル内での3段階の推論の深さ:技術報告書と公式ブログによると、Mistral Large 4 は高・中・低の3段階の推論の深さを選べます。モデルカードでは
reasoning_effortにlow/medium/highを指定し、既定はhighです(S7, S9, S11)。low:高速なチャット応答向け(モデルカードの推奨)。medium:日常の利用向け(同)。high:複雑なプロンプトとエージェント用途向け(同)。
モデルを別々に立てることなく、1つのデプロイメントの上でリクエスト単位に出力トークン量(=推論コストと待ち時間)を制御できる設計になっています。
第6章:導入前に直視すべき「3つの実務上の壁」――ライセンス第2条・保存容量1.06TB・米国GPU依存
一方で、「オープンウェイトで主権AIだからどんな企業でもすぐに無制限で使える」と考えるのは危険です。一次資料(S8, S9, S10, S11)を精査すると、企業が導入前に必ず確認しなければならない**3つの実務上の壁(制約)**が存在します。
壁1:ライセンス第2条の「Model as a Service(MaaS)別契約条項」
Mistral Large 4 は Apache 2.0 ではなく、独自の Mistral Ecosystem Open-Weight License(S8)を採用しています。条文の第2条と第3条には、何が無料で何が別契約になるかの境界線が明確に書かれています。
“2. If the Licensee or any of its affiliates operates a Model as a Service business, the Licensee must enter into a separate commercial license with Mistral before using the Model or its derivative works for any commercial purpose.”(出典:S8 第2条)
“3. The requirements set forth in Section 2 do not apply to: (a) internal use of the Model or its derivative works, defined as any use that does not make the Model or its derivative works available to third parties; or (b) any use of the Model accessed through Mistral’s official products.”(出典:S8 第3条)
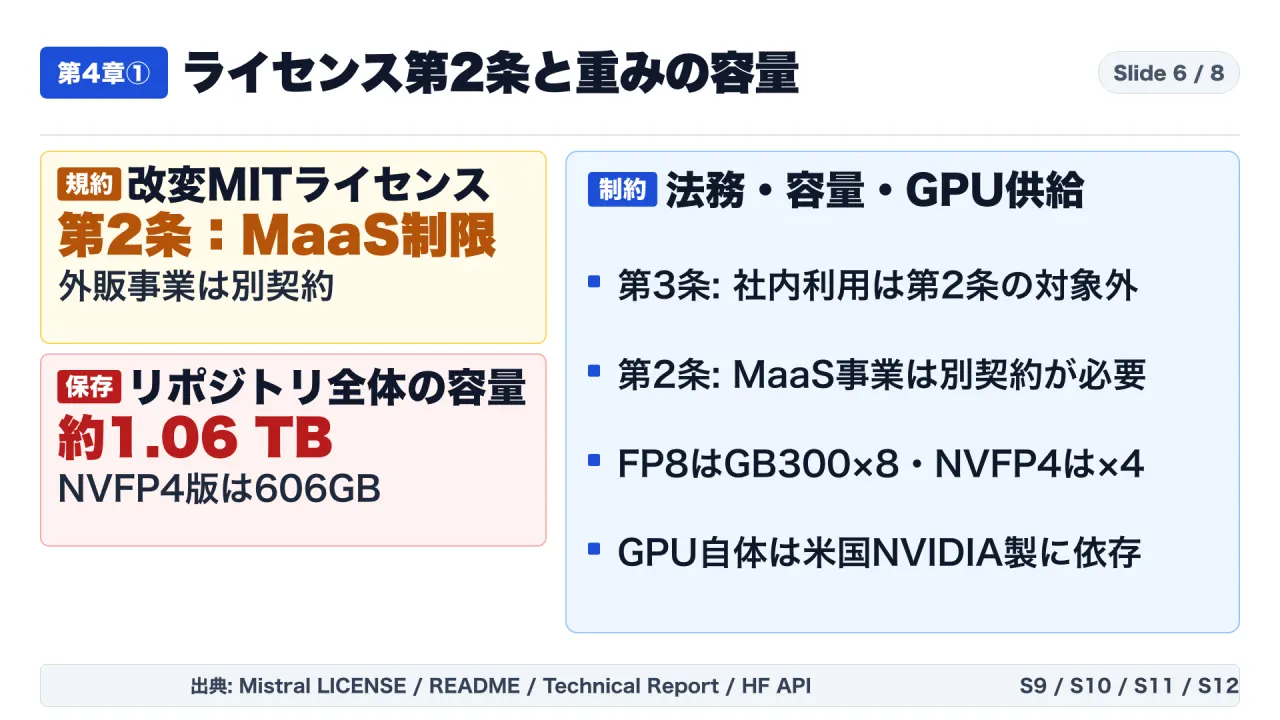
- 第2条の対象外になる範囲:(第3条)第三者に提供しない社内利用と、Mistral公式製品を通じた利用です。また第2条のMaaSの定義は、特定の機能の中にモデルの機能を組み込んだだけのエンドユーザー向け製品と、他社が運用するモデルへの単なる中継を、対象から除いています。
- 別契約が必要な範囲(第2条):ライセンスを受けた側かその関連会社が「Model as a Service」事業を営む場合です。MaaSとは、第三者に、入力・パラメータ・学習データを実質的に制御できる形で、推論や追加学習のアクセス(APIやホスティングされたエンドポイントなど)を与えることです。
自社が「AI機能を組み込んだ業務アプリ」を提供するのか、それとも「AIモデルそのもののAPI窓口」を顧客に外販するのかを、法務部門と事前に照合する必要があります。SaaSであっても、第三者が入力などを実質的に制御できる形でモデルへのアクセスを与える場合は、MaaSに当たりえます。該当するかどうかは、条文の文言をもとに法務が判断してください。
壁2:リポジトリの保存容量は約1.06TB、NVFP4でも606GB(GB300 4基)の重いインフラ要件
「活性パラメータが49B(52B)だから、小型サーバーでも動くはずだ」と誤解してはいけません。MoEモデルは、計算時に動く専門家が一部であっても、GPUのメモリ(VRAM)には総パラメータ1兆個(全専門家)を載せておく必要があります。
- 標準版(
Mistral-Large-4-1T-A52B):Hugging FaceAPIの記録(S10)によると、リポジトリ全体の保存容量(usedStorage)は 1,060,619,283,859バイト、つまり 約1.06テラバイト(私の計算) です。これは保存容量で、必要なGPUメモリの量とは別の数字です。モデルカード(S9)のvLLMの例は、8基のGPUにテンソル並列で分散します(--tensor-parallel-size 8)。技術報告書(S11)は、FP8版を8基のGB300で動かす構成を、推論の高速化の比較基準にしています。 - 4ビット量子化のNVFP4版:技術報告書(S11)によると、較正したNVFP4量子化でチェックポイントは 606ギガバイト に小さくなり、評価ではFP8の基準と同等で、GB300を4基 で動かせます。
とはいえ、606ギガバイト〜1.06テラバイトの重みを常駐させるには、最新世代のデータセンター向けGPUを4基〜8基束ねた専用サーバーが不可欠であり、一般的な中堅企業が手元の小さなサーバーで気軽に動かせるサイズではありません。
壁3:「ソフトウェアと法管轄は欧州、ハードウェアは米国NVIDIA製」という二層構造
主権AI(ソブリンAI)という言葉を使う際に冷静に見ておくべきもう一つの事実が、ハードウェア供給網の依存先です。Mistral Large 4 の学習データ管理、モデルの知財、データセンターの所在地(パリ近郊)、および準拠法(欧州法)はたしかに欧州で完結しています。しかし、学習に使われた 3,840基の GB200 も、NVFP4推論で推奨される GB300 も、すべて米国 NVIDIA 製の最先端GPUです(S6, S9, S11)。
つまり、データの保管場所と法的な管轄権を米国クラウドから切り離すことはできても、半導体の物理的な調達や輸出管理の面では米国製のハードウェア基盤に依存しているという現実を踏まえて、リスク分散の範囲を定義する必要があります。
第7章:実務への適用――日本企業が明日から使える3ステップのAI基盤選定フレームワーク
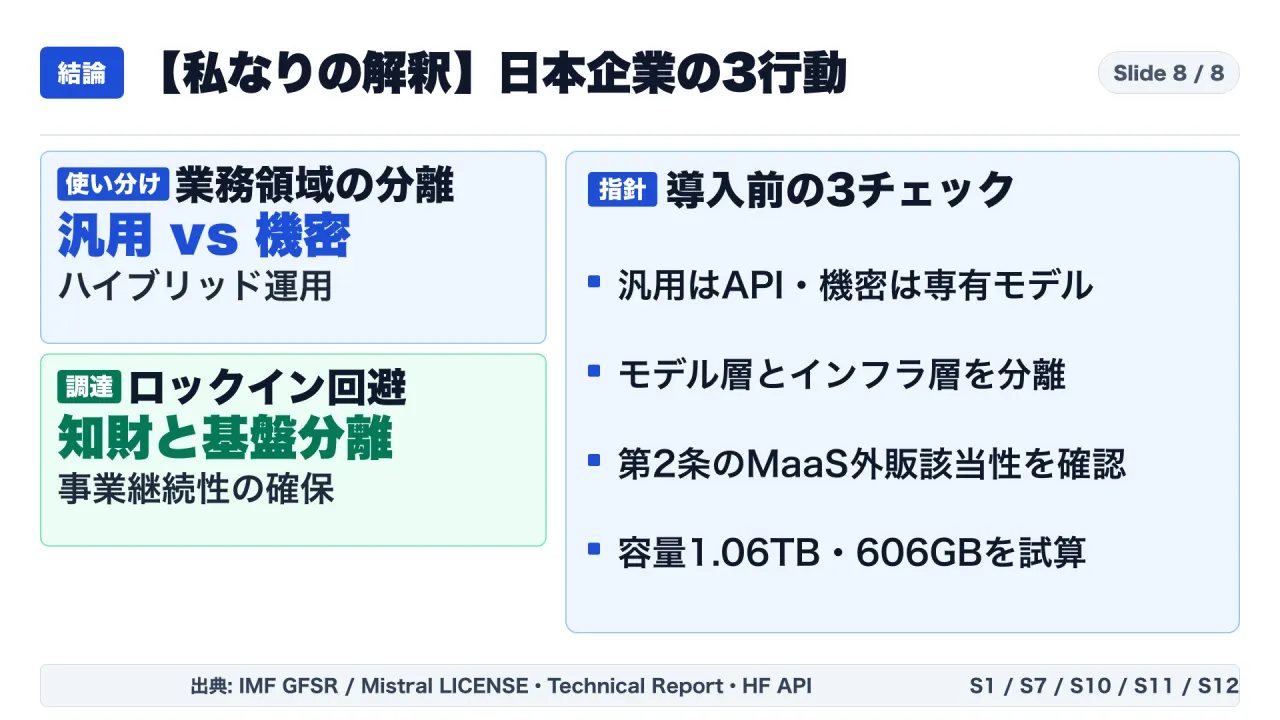
ここまでの一次資料の事実を踏まえ、日本の事業会社やシステム部門が「米国ハイパースケーラーのクラウドAPI」と「Mistral 等のオープンウェイトモデル(自前または専用環境運用)」をどう使い分けるべきか、私なりの実務フレームワークを3つのステップで整理します。
ステップ1:既存クラウド契約の「ロックイン度合い」と「データ境界」を棚卸しする
まず、社内で稼働中または計画中のAIシステムを次の2軸で分類します。
- 機密性と法規制の壁:国外サーバーへのデータ移転や外部APIへの送信が社内規程・業法で禁じられている領域か。
- 切り替えコスト(ロックイン)の壁:もし利用中のハイパースケーラーがAPI価格を引き上げたり特定モデルを廃止したりした場合、何週間以内に別のモデル/別のインフラへ移行できる設計になっているか。
IMF報告書(S1, S2)やSEC書類(S4, S5)が示す通り、ハイパースケーラーと新興データセンター事業者は巨額の設備投資と社債・リース契約を背負っています。長期の最低利用金額コミットメントを結ぶ際には、特定の閉鎖型モデルに業務ロジックを固定しすぎない「モデル抽象化レイヤー」を設けておくことが有効です。
ステップ2:オープンウェイト導入時は「提供形態(第2条)」と「GPUメモリ予算」を同時に照合する
機密データ保護やインフラ分離のためにオープンウェイトモデルを採用する場合、法務とインフラの2点を同時にチェックします。
- 法務チェック:自社の利用目的が、第三者に提供しない社内利用や、自社製品の特定の機能にモデルの機能を組み込むだけの形にとどまるか、それとも第三者へ推論などのアクセスを実質的に制御できる形で提供するMaaSに当たるかを判定します(第2条・第3条)。
- インフラのチェック:FP8版を8基のGB300で動かす構成か、606GBのNVFP4版を4基のGB300で動かす構成を確保できるかを確認します(保存容量は約1.06TB)。GPUの予算が小さい場合は、1兆パラメータ級にこだわらず、より小さなモデルへ候補を切り替えます。
ステップ3:ニュースの「資金調達額」ではなく、公式の「モデルカード・LICENSE・財務諸表」だけを根拠にする
AI業界では、「何十億ユーロを調達した」「企業価値が何兆円になった」「世界で最も優れたモデルだ」といった華々しい報道やインタビュー発言が日々飛び交います。しかし、稟議書やアーキテクチャ設計書の根拠にしてよいのは、公的機関の統計(IMF・SEC等)、公式のモデルカード(README.md / config.json)、そしてライセンスの原文(LICENSE)だけです。未確認の報道値と確定した技術・契約仕様を厳格に区別する習慣こそが、手戻りのないAI導入を支えます。
一次資料・出典一覧(2026年11月5日確認)
本記事で引用・照合した12件の一次資料は以下の通りです。
- S1:IMF『Global Financial Stability Report, October 2026: Executive Summary』(2026年10月公表)
- S2:International Monetary Fund (IMF)『Global Financial Stability Report, October 2026, Chapter 1: Global Financial Fragilities Set Against Growing Public and Private Debt』(2026年10月公表)
- S3:IMF Blog『Global Financial Markets Face Rising Risks From AI, Bond Yields, and Cyberattacks』(2026年10月公開)
- S4:Alphabet Inc.『Form 10-Q for the Quarterly Period Ended September 30, 2026』(米国証券取引委員会 SEC EDGAR 提出書類)
- S5:Meta Platforms, Inc.『Form 10-Q for the Quarterly Period Ended September 30, 2026』(米国証券取引委員会 SEC EDGAR 提出書類)
- S6:Mistral AI 公式発表『Introducing Mistral Large 4』(2026年10月6日)
- S7:Mistral AI 公式ブログ『Mistral Large 4 (Le Chonk) is now open weight』(2026年10月29日)
- S8:Mistral AI『Mistral Ecosystem Open-Weight License』(
mistralai/Mistral-Large-4-1T-A52Bリポジトリ内LICENSE全文) - S9:Mistral AI『Mistral-Large-4-1T-A52B Model Card (
README.md)』 - S10:Hugging Face API メタデータ記録(
mistralai/Mistral-Large-4-1T-A52BのusedStorage: 1060619283859) - S11:Mistral AI『Mistral Large 4 Technical Report』(
assets/technical_report.pdf) - S12:Meta Platforms, Inc.『Pricing Term Sheet: $15.0 Billion Senior Notes』(2026年11月3日、SEC EDGAR)
動画での解説
この記事の内容は、YouTube の動画でも詳しく解説しています。
{{YOUTUBE_URL}}
初めての方は、固定の自己紹介記事もあわせてご覧ください。