なぜAIの重み0.016%編集で数学が6倍になったのか?──MIT研究の仕組みと設定のカラクリ
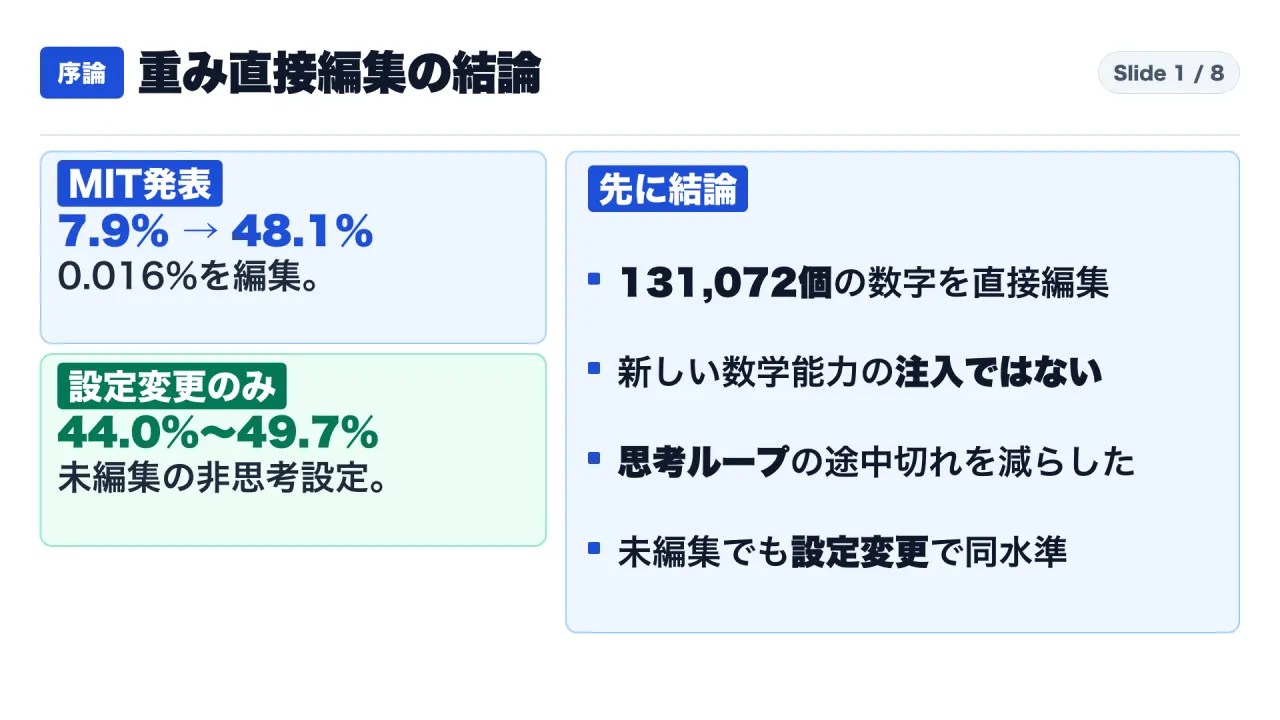
結論:0.016%の重み編集が直したのは「思考ループによる途中切れ」であり、未編集モデルでも公式の非思考モード設定に変えるだけで正答率は44.0%〜49.7%に到達する
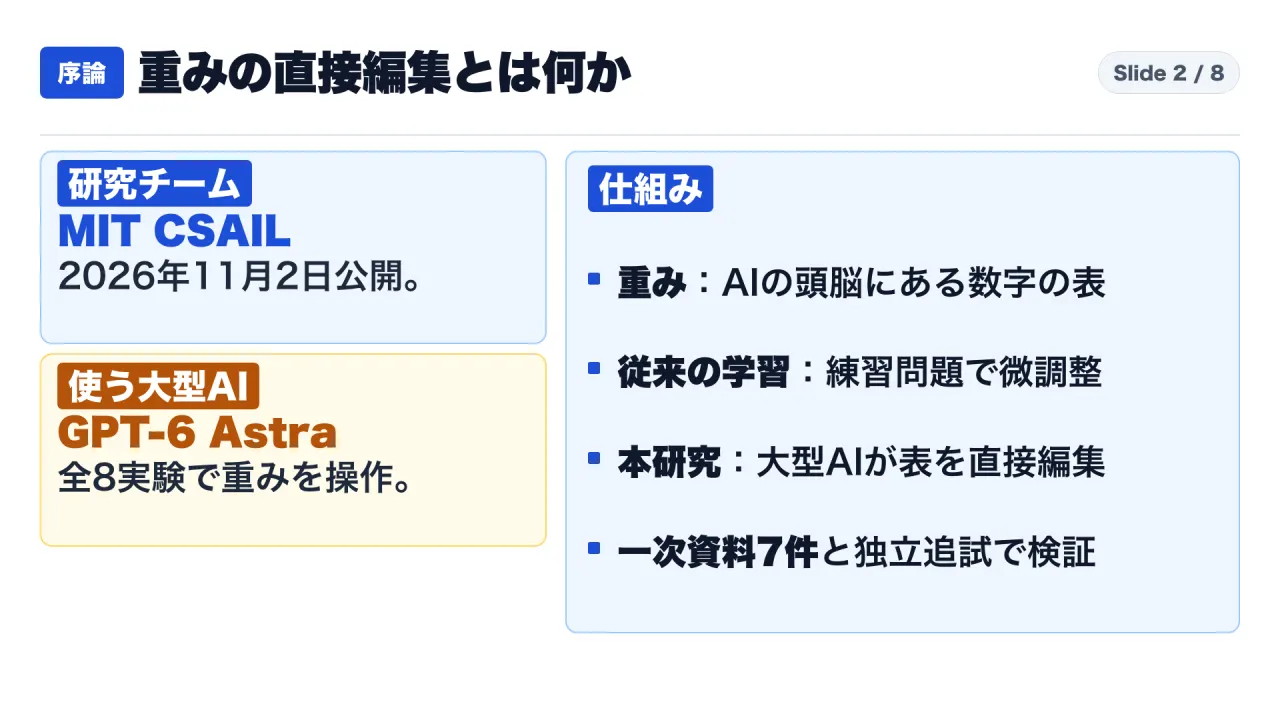
結論から書きます。2026年11月2日にマサチューセッツ工科大学コンピュータ科学・人工知能研究所(MIT CSAIL)の武樋力哉(Rikiya Takehi)氏、Jayden Teoh氏、Alex Zhang氏、Omar Khattab氏の4名が公表した研究ブログ『Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights』(S1)、Hugging Faceで公開された編集済みチェックポイントのモデルカード(S2)、GitHubで公開された実験ログおよびハーネス説明書(S3, S4)、独立系研究者のCarlos Toledo氏が11月3日に公開したバイト単位の検算・全問再採点・ベースライン追試レポート(S5)、Alibaba公式の Qwen/Qwen3.5-0.8B モデルカード(S6)、および11月3日に投稿された放射線治療の臨床意思決定ネットワーク監査論文(arXiv:2611.05341、S7)という7件の一次資料を突き合わせると、次の3つの事実が確認できます。
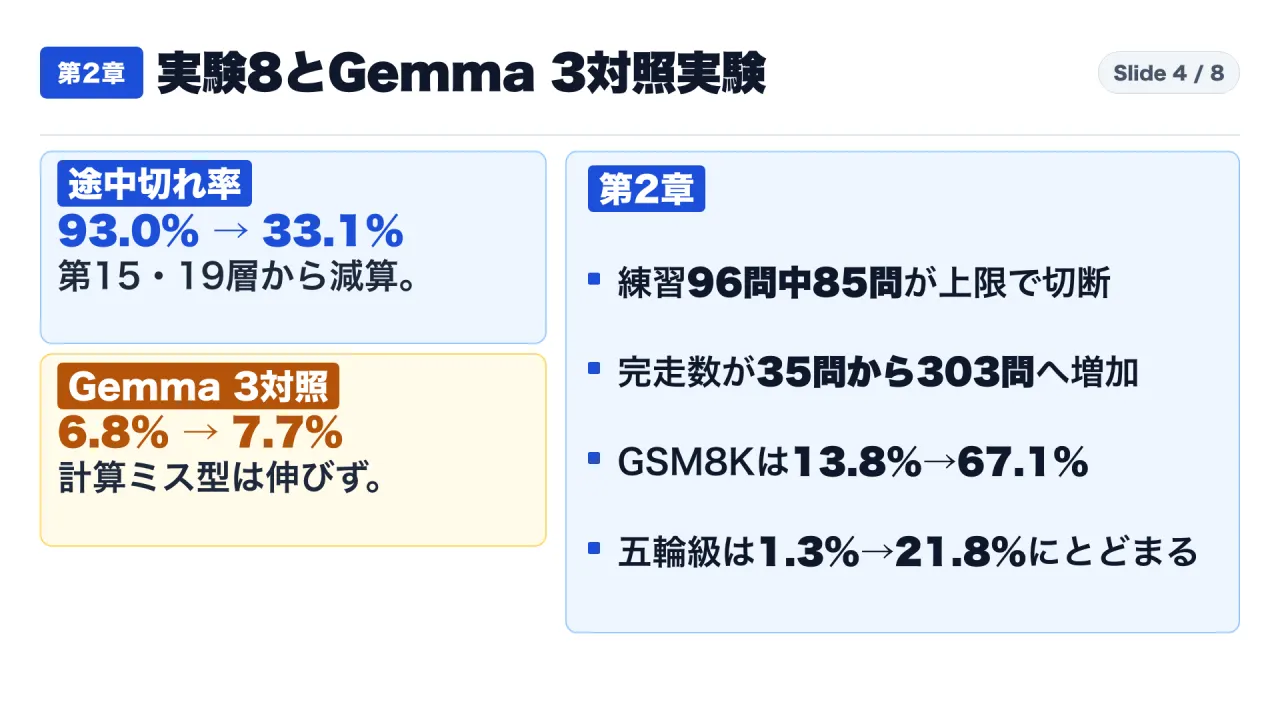
1つ目は、MITが発表した実験8(Qwen3.5-0.8B の重み直接編集によるMATH-500正答率 7.9% → 48.1% への上昇)の正体が、モデルに新しい数学の推論能力を植え付けたことではなく、同じ確認を繰り返して32,768トークンの出力上限で切断される「思考ループ(Thinking Loops)」を抑えたことである点です。MITの公式ブログ(S1)および実験8のログ説明書(S4)によると、OpenAIのフロンティアモデル gpt-6-astra(ブログ内呼称「Astra」)は、勾配降下法や追加の学習を一切使わず、全24層のうち第15層と第19層のMLP(mlp.down_proj)の各64出力列、合計 131,072個(公称0.8Bに対して 0.016%、bfloat16への丸め処理後に実際に元のビット列と異なるのは 130,188個=リリース全体873,438,784パラメータの 0.015%)から、ループを引き起こす特定の方向ベクトルを係数6倍で減算しました。これにより、MATH-500で32,768トークンの上限に達して途中終了する割合が 93.0%から33.1%へ減少し、正答率が 7.9%から48.1%(GSM8Kは 13.8%から67.1%、IFEvalは 21.0%から62.3%)へ上昇しました。しかし、もともとループがほとんど起きない Google の Gemma 3 270M(上限到達率 8.5%)に対してまったく同じ手順で最大50パスの重み編集を行った対照実験では、MATH-500の正答率は未編集の 6.8% に対して 7.0%(5パス)、7.6%(10パス)、7.7%(25パス)、7.0%(50パス) とほとんど変化しませんでした(S1)。MITの著者自身がブログ本文で「ループを直すことは、モデルの数学能力を高めることと同じではない。重みの編集は能力を隠していた障害を取り除くことはできても、モデルが持っていなかった能力を付け足すことはできなかった」と明記しています(S1)。
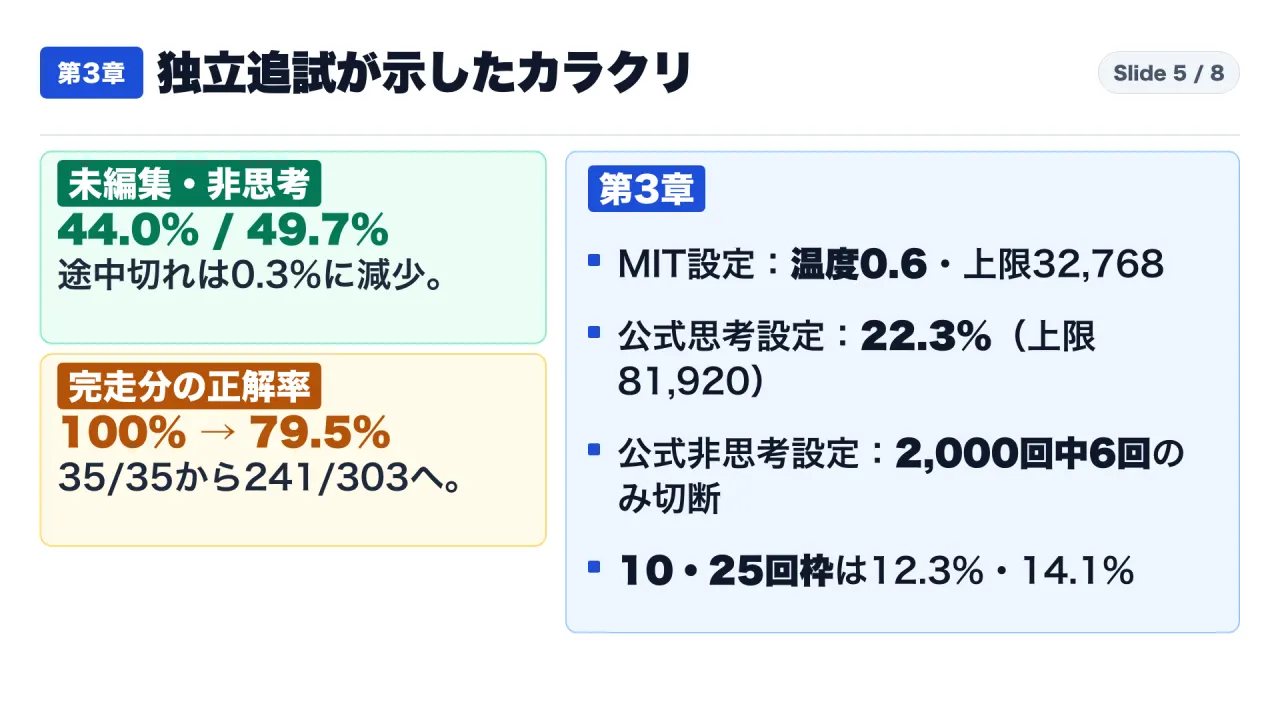
2つ目は、重みを1個も書き換えなくても、Qwen/Qwen3.5-0.8B の公式モデルカード(S6)が推奨する「非思考モード(Non-thinking mode)」のサンプリング設定に変えるだけで、MATH-500の正答率が 44.0%(採点確定分では 49.7%)に達し、50パス編集後の 48.1% とほぼ同じ水準になるという事実です。Alibaba公式のモデルカード(S6)には、「思考モード(Thinking mode)では、他のQwen3.5モデルに比べて思考ループに陥りやすく、生成が正常に終了しないことがある」という明確な注意書きがあり、競技数学などの複雑なベンチマークでは出力上限を 81,920トークン に設定すること、また通常のテキスト課題の非思考モードでは temperature=1.0, top_p=1.00, presence_penalty=2.0 を使うことが推奨されています。ところがMITの実験8の評価プロトコル(think35)は、思考モードをオンにしたまま temperature=0.6, presence_penalty=1.5, max_tokens=32,768 で固定していました(S1, S4)。Carlos Toledo氏が11月2日に事前登録し、11月3日にNVIDIA H200上で未編集の Qwen/Qwen3.5-0.8B を2,000回ずつ(500問×4サンプル)走らせた追試(S5)では、①MIT設定(C1)で正答率 7.2%・上限到達率 93.1%(2,000回中1,862回)、②公式の思考モード設定(C2:temperature=1.0, max_tokens=81,920)で正答率 22.3%・上限到達率 75.0%、③公式の非思考モード設定(C3:temperature=1.0, top_p=1.0, presence_penalty=2.0, max_tokens=32,768, thinking off)で上限到達率が 0.3%(2,000回中わずか6回) に激減し、正答率が 下限44.0%(採点確定分では49.7%、第1サンプルでは45.6%/51.7%) に達しました(S5)。さらに、Toledo氏が公開ログの第1サンプル500問を再採点したところ、未編集モデルは最後まで書き終えた 35問中35問すべて(100%) で正解していたのに対し、編集後モデルは完走した 303問中241問(79.5%) の正解にとどまっており、ループ方向を6倍引き算した副作用として完走時の精度自体は低下していました(S5)。
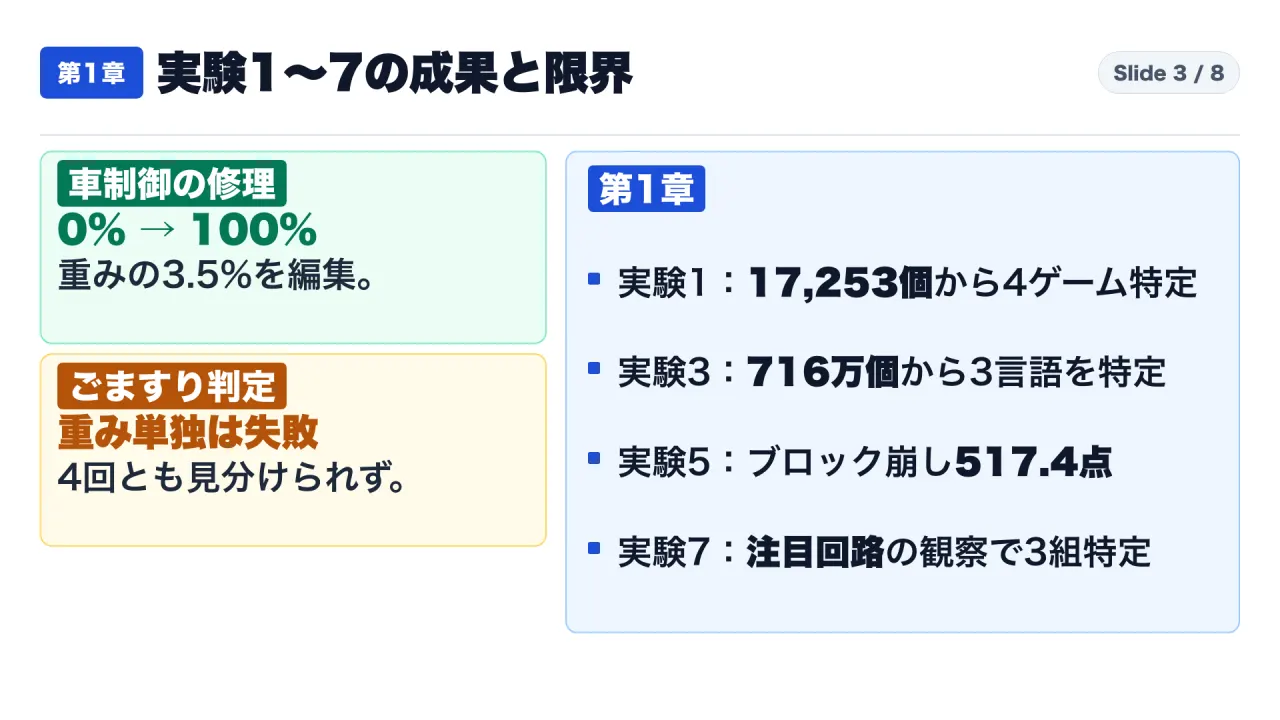
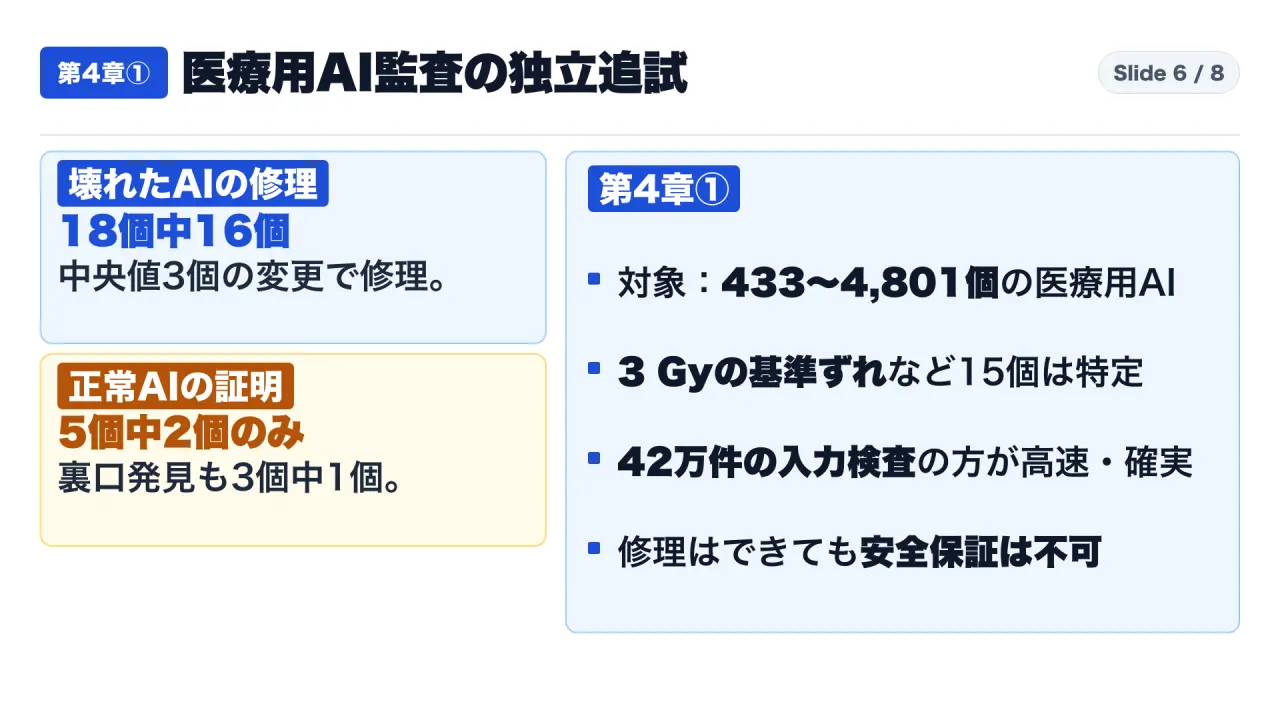
3つ目は、数千〜数百万パラメータの小規模ネットワークにおける「重みの読解・局所修理」は実際に機能する一方、安全性や正しさの保証(監査・認証)には使えず、従来のブラックボックステストの方が高速かつ確実であるという実務上の境界線です。MITの実験1〜5では、17,253個の重みを持つMLPから4種類のゲーム(Breakout, Pong, Pac-Man, Freeway)をツールなしで特定し、171,664個の重みを持つ車制御ネットワークの 3.5%(6,073個) を1回の応答で書き換えて成功率を 0%(256試行)から100%(1,024試行) に引き上げ、Breakoutのゼロからの重み生成で平均 517.4点(5億ステップPPOの25.3点の約20倍)を記録しました(S1, S5)。しかし、同じ実験5でもSeaquest(53.1点 vs PPO 88.9点)とAsterix(53.2点 vs PPO 55.2点)では5億ステップPPOに敗れ、実験7の Gemma 3 270M の迎合(ごますり)判定では、重み単独での4回の試行すべてに失敗し、実際にテキストを入力してAttentionの重みを観察するツールを使ったときだけ3ペアすべてを特定できました(S1, S5)。さらに、11月3日にHumza Nusrat氏とOmar Nusrat氏が公開した放射線治療の臨床意思決定ネットワーク監査論文(arXiv:2611.05341、S7)では、433〜4,801パラメータのネットワークに対して、壊れた18個中 16個 で欠陥ルールを特定し中央値 3個 のパラメータ変更で修理できたものの、正常な5個のネットワークを「問題なし」と証明できたのは 5個中2個 のみ、仕込まれたバックドアを発見できたのも 3個中1個 のみであり、臨床プロトコルに基づく約 420,000件 のブラックボックステストの方がすべての欠陥をより速く確実に検出しました(S7)。
この記事は、社内でオープンウェイトモデルの導入・評価・カスタマイズやAIセキュリティ監査を担当しており、「AIが別のAIの重みを直接書き換えて数学の点数を6倍にした」というニュースを見て、自社のモデル改善や監査業務に使えるのかを見極めたい実務者・エンジニア・企画担当者に向けて書いています。読み終えると、①重み直接編集(Weight-Space Programming)でできることとできないことの境界線を正確に把握する、②ベンチマークの劇的な改善報告を見たときに「文字数上限での切断率(cut share)」と「公式モデルカードの推奨サンプリング設定」を先に点検する、③外部の調整済みモデルや監査手法を社内へ取り込む際の実務チェックリストを適用する、という3つの判断ができるようになります。なお、株式や金融商品の売買・投資判断は一切扱いません。
先に用語をそろえます
本文に入る前に、MITの研究ブログ・実験ログ・独立監査レポートを正確に読み解くための6つの基本用語を、専門知識がない方にも分かるように定義します。
- 重み(Weights/パラメータ):ニューラルネットワークの内部に並んでいる、入力された言葉や数値を次の層へどう伝えるかを決める大量の数字(浮動小数点数)の表です。
Qwen3.5-0.8Bには約8億個(マルチモーダル版リリース全体では8億7,343万8,784個、言語モデル部分で7億5,239万3,024個)の重みが入っています(S1, S5)。 - 勾配降下法(Gradient Descent):通常のAI学習で使われる方法で、大量の練習問題を解かせて正解とのズレ(損失)を計算し、そのズレが小さくなる方向(勾配)へ少しずつ重みを更新する計算を何万回・何億回も繰り返す手法です。
- 重み空間プログラミング(Weight-Space Programming:WSP):MIT CSAILの研究チームが提唱した呼称で、勾配降下法や学習ループを一切回さず、大型の汎用言語モデル(今回はOpenAIの
gpt-6-astra)が対象ネットワークの重みや内部状態を直接読み取り、推論によって原因を特定して重みの数値を直接書き換える手法を指します(S1)。 - 思考ループ(Thinking Loops)と文字数上限での途中切れ(Cut Share):推論(Thinking)モードを持つ小型モデルが、最終回答(
\boxed{})を出す前の下書きの中で「もう一度確認しよう」と同じ計算や確認の文言を延々と繰り返し、設定された最大出力トークン数(今回は32,768トークン)に達して強制切断される現象です。最後まで書き切れずに切断されると、最終回答の箱(\boxed{})が出ないため、採点上は自動的に不正解(0点)になります(S1, S5, S6)。 - ランク1方向減算(Rank-1 Direction Subtraction / Projection Removal):モデルの隠れ状態(今回は1,024次元ベクトル $\mathbb{R}^{1024}$)の中で「ループを引き起こす特定の向き(単位ベクトル $u$)」を見つけ出し、重み行列 $W_0$ の特定の列からその方向の成分 $u(u^\top W_0)$ を引き算する操作です。MITの実験8(50パス)では、第15層と第19層の
mlp.down_projの各64列に対して $W = W_0 - 6 \cdot u(u^\top W_0)$、つまり射影成分の6倍を減算(元の方向成分を反転させて5倍に増幅)する編集が行われました(S1, S4, S5)。 - サンプリング設定(Temperature / Presence Penalty / Thinking Mode):モデルが次のトークンを選ぶ際の確率分布を調整する設定値です。
temperature(温度)は値が高いほど多様な表現を選びやすくなり、presence_penalty(出現ペナルティ)はすでに登場したトークンの再出現を抑えて同じ言葉の繰り返し(ループ)を防ぐ働きをします(S6)。
全体俯瞰マトリクス:MIT「Sparks of Weight-Space Programming」全8実験+独立追試2件の完全対照表
まず、MITが報告した全8つの実験(実験1〜8およびGemma 3対照実験)と、翌11月3日に公開された2つの独立検証(Toledo監査レポートおよび臨床ネットワーク監査論文)の条件・数値・検証結果を1つの表にまとめます。
| 実験・検証区分 | 対象モデルと規模(重み数) | Astraに与えられた権限・ツール・予算 | MIT発表の主要結果(S1, S3, S4) | 独立監査・追試で確認された事実と限界(S5, S6, S7) |
|---|---|---|---|---|
| 実験1:ゲームの特定(Read) | 10×10グリッドの4ゲーム用MLP(500→32→32→5, tanh, 17,253個) |
ツールなし、順伝播(実行)なし、候補リストなし。重みテキストのみ(Effort: high) |
Breakout, Pong, Pac-Man, Freeway の全4種を重みのみから正解(4/4) | Freewayに対するAstraの回答は「Frogger — a simplified grid-based traffic-crossing variant.」であり、READMEの事前採点規則(FroggerもFreewayとして正解扱い)により4/4と集計(S3, S5 M3) |
| 実験2:拡散モデルの生成図形特定(Read) | 12×12グレースケール画像DDPM用MLP(160→64→64→144, ReLU, 23,824個) |
ツールなし、順伝播なし。重みテキストのみ(Effort: high) |
塗りつぶし円・正方形・三角形の全3種を特定(3/3) | 出力層の隠れユニットが描く輪郭線(エッジ)から図形を特定しており、塗りつぶし(filled)ではなく輪郭(outline)として描画したことが順伝播をしていない証拠と報告(S1) |
| 実験3:中間層のみからの学習言語特定(Read) | 28文字アルファベットの4層×6ヘッドTransformer(幅384, 716万個=7.16M) | 入力層・出力層を除去した中間4ブロックのみ+Pythonサンドボックス最大100回。モデル実行禁止(Effort: xhigh) |
Python・ローマ字日本語・英語の全3種を2回とも特定。全誘導ヘッド(Python: 2.1, 3.1, 3.5、ローマ字: 3.3、英語: 3.1)も完全一致 |
入力・出力層がないためElhage et al.の回路解析手法(重み行列の積による誘導ヘッド検出)と最終ブロックの書き込み方向の少なさ(ローマ字はq, l, v, xを使わない)を自律発見(S1) |
| 実験4:失敗する車制御ネットワークの修理(Fix) | Kinetix l/h2_car_ramp の公式PPOアクター(679→128→128×5→16, 171,664個) |
ツールなし、1回の応答で直接重みを出力。失敗した1エピソードの軌跡と環境説明を提示(Effort: high) |
10億ステップPPOで成功率 0%(256試行) → 重みの 3.5% を1発編集し 1,024試行で成功率100% | 実際に変更されたのは171,664個中 6,073個。バイアス等を最大 -876(元の最大絶対値は2.370)に設定する別経路を追加し、単一レベル l/h2_car_ramp の1,024テスト+256探索エピソードで100%達成(S5 M4a, M4b) |
| 実験5:ゼロからのMinAtarゲーム重み作成(Write) | MinAtar 3ゲーム用MLP(600→32→32→6, tanh, 全重み0初期化) |
ツールなし、データ・勾配・実行なし。ゲームのルールとソースコードから1発で重みを記述(Effort: xhigh) |
1億ステップPPOに全勝。Breakout平均517.4点(5億ステップPPO 25.3点の約20倍) | 5億ステップPPOに対して、Breakout(517.4 vs 25.3)は圧勝したが、Seaquest(53.1 vs 88.9)とAsterix(53.2 vs 55.2)では敗北(S1表およびS5 M5a) |
| 実験6:ゼロからの9×9囲碁ネットワーク作成(Write) | 9×9囲碁ネットワーク(243→512×6→82, ReLU, 1,480,274個) |
Pythonサンドボックス+順伝播予算(0, 10, 25, 50パス、1パス最大128対局)(Effort: xhigh) |
0パスで336行のPythonコードにより小型PPO(243→32×2→82)に勝率5割超。50パスで同サイズPPO(2,000万局学習)に勝利 |
同サイズPPOとの3対戦において、0パスでは全敗(勝率 42.6% / 26.3% / 36.3%)、50パスで全勝(勝率 74.2% / 70.0% / 78.5%)(S5 M5a) |
| 実験7:迎合(ごますり)モデルの判別(Read) | Gemma 3 270M(18層)の正直モデル(誤答追従1〜3%)と迎合モデル(100%)の3ペア |
①重み単独(4試行)→ ②最大16文のAttention重み観察ツール(最大20実行)(Effort: xhigh) |
重み単独では4回とも判別失敗。Attentionツール使用で3ペアすべて特定(3/3)(Head 10.2の注目比率 94.3%/0.75% vs 3.5%/85.7%) | 重み単独の試行1〜3はすべて回答「A」(正解確率0.5=偶然と同じ1/3正解)で、試行4は1ペア終了時点で停止。数億パラメータの微調整差分は重み単独では読めないことを示す(S1, S5 M5b) |
実験8:Qwen3.5-0.8B の数学性能改善(Fix) |
Qwen/Qwen3.5-0.8B(24層、公称0.8B、実パラメータ873M/言語部752M)、Thinking ON |
Pythonカーネル(CPU、最大300実行)+練習問題(GSM8K 7,469問、MATH 7,275問)+順伝播予算(10, 25, 50パス)(Effort: max) |
第15・19層 mlp.down_proj の各64列(131,072個=0.016%)を編集。50パスで上限到達率 93.0%→33.1%、MATH-500 7.9%→48.1%、GSM8K 13.8%→67.1%、IFEval 21.0%→62.3% |
bfloat16で実際に変化したのは 130,188個(0.015%)、射影の 6倍 を減算。未編集モデルでも公式推奨の非思考設定(C3)で上限到達0.3%、MATH-500正答率44.0%(確定分49.7%)に到達(S5, S6) |
実験8追試:Gemma 3 270M 対照実験(Fix) |
Gemma 3 270M(instruction-tuned、上限到達率わずか 8.5%) |
実験8と同じハーネスで5, 10, 25, 50パスの順伝播予算 | 未編集 6.8% → 5パス 7.0%、10パス 7.6%、25パス 7.7%、50パス 7.0%(改善せず) | ループではなく基礎的な算数・代数ミスで間違えるモデルでは、単一の方向を消す手法は機能せず、新しい能力は追加できないことを実証(S1, S4, S5 G6) |
| 独立追試:臨床意思決定ネットワーク監査(S7) | 頭頸部放射線治療の4ルールを学習したMLP(433〜4,801個、欠陥18・正常5・裏口3) | Claude Opus 5.5 にプロトコルと重みのみを提示(ツール・データ・実行なし)、42万リクエストで検証 |
—(Humza Nusrat & Omar Nusratによる2026年11月3日の独立論文 arXiv:2611.05341) |
欠陥18個中 16個(交絡・3 Gyシフト15個すべて)を特定し中央値 3個 の変更で修理。しかし正常5個中2個しか証明できず、裏口は3個中1個のみ検出。プロトコル・ブラックボックステストの方が高速かつ全件検出(S7) |
第1章:実験1〜7の解剖――「重みを読む・書く力」はどこまで本物で、どこで壁にぶつかったのか
ニュースやSNSでは最後の「実験8(数学テストが7.9%から48.1%へ上昇)」ばかりが切り取られていますが、一次資料(S1, S3, S5)を通読すると、むしろ前半の実験1〜7にこそ、重み空間プログラミングの「本当に驚くべき到達点」と「明確な限界」の両方が記録されています。
1. 実験1〜3:順伝播(実行)を1回もせずに、重みの幾何学的構造から学習タスクと言い当てる
まず実験1〜3は、ネットワークを1回も動かさず(順伝播なし)、重みの数値配列だけから「このネットワークが何を学習したか」を当てる読解(Read)実験です。
- 実験1(17,253個の重みから4つのゲームを特定):研究チームは、10×10のグリッド画面と5つの行動(停止・上・下・左・右)を持つ4種類のゲーム(Breakout、Pong、Pac-Man、Freeway)を、まったく同じ構造のMLP(
500 → 32 → 32 → 5, tanh, 17,253個の重み)にPPO(10億ステップ)で学習させました(S1)。Astraにはゲームの候補名を一切伏せ、ツールも使わせずに重みのテキストだけを渡しました。それにもかかわらず、Astraは第1層の重みが画面のどの位置に集中しているか(たとえばBreakoutでは一番下の行=パドルの位置に重みが集中していること)と出力層の行動の結びつきを読み解き、4つすべてを当てました(S1)。- 監査で確認された細部(S5 M3):Toledo氏の監査レポートによると、Freeway(道路横断ゲーム)のネットワーク(
0bbcc3ea)に対するAstraの実際の回答行は"Frogger — a simplified grid-based traffic-crossing variant."でした。これは実験ログのREADME(S3)に明記されているキーワード採点規則("Frogger ... counts as Freeway":どちらも同じ道路横断型のグリッドゲームであるため正解とする)に従ってeval/scores.jsonで正解(4/4)と集計されています(S5)。
- 監査で確認された細部(S5 M3):Toledo氏の監査レポートによると、Freeway(道路横断ゲーム)のネットワーク(
- 実験2(23,824個の重みから拡散モデルの描く図形を特定):12×12ピクセルのグレースケール画像(塗りつぶした円・正方形・三角形)を生成する3つのDDPM拡散モデル(MLP
160 → 64 → 64 → 144, ReLU, 23,824個の重み)を、ツールなし・順伝播なしで読ませた実験です(S1)。Astraは出力層の各隠れユニットが図形の輪郭(エッジ)のどの部分を描いているかを特定し、3つすべてを言い当てました。興味深いことに、実際のモデルは「中まで塗りつぶされた図形(filled shapes)」を生成するにもかかわらず、Astraは出力層の境界構造だけを読んで「輪郭線(outlines)」として図形を描き出しました。研究チームは、この「輪郭だけを描いたミス」こそが、Astraが頭のなかで順伝播の計算をごまかして実行したのではなく、重みの幾何学的な構造を直接読んでいる証拠だと指摘しています(S1)。 - 実験3(入力層と出力層を削り取った716万パラメータのTransformerから学習言語と誘導ヘッドを特定):28文字(
a–zと空白・改行)を扱う文字レベルの4層×6ヘッドTransformer(幅384、716万個の重み)を、Pythonコード、ローマ字の日本語文学(青空文庫)、英語Wikipedia(各10億文字)で学習させ、文字とベクトルの対応を示す入力埋め込み層と出力層をわざと削除して、中間の4ブロックだけをAstraに渡しました(S1)。Pythonサンドボックスで重み行列を分析することは許されましたが、ネットワークや層に入力を流して実行することは厳格に禁止されました(全1,125ターンのイベントストリームでaudit.tool_freeが監査済み、S3)。- この条件でAstraは、2回の試行とも3つの言語すべてを正確に当てただけでなく(Python確信度 0.56 / 0.52、ローマ字 0.55 / 0.62、英語 0.58 / 0.48)、全24個のAttentionヘッドのうち「前に出た文字列を見つけて後に続く文字をコピーする誘導ヘッド(Copying Heads / Induction Heads)」がどれかを、実測値と1個の狂いもなく完全一致で特定しました(Python:
2.1, 3.1, 3.5、ローマ字:3.3、英語:3.1)(S1)。 - どうやって入力層も出力層もない状態で見破ったのかというと、AstraはElhage et al. (2021) が提唱したTransformer回路の解析手法(プロンプトでは一切教えていない手法)を自力で再現し、第1層の「1文字前を見るヘッド」と後続層の重み行列の積から誘導ヘッドを特定しました。プログラムコードは自然言語の散文よりも変数名や予約語を頻繁に反復するため、誘導ヘッドが3個もあるモデルをPythonと判定し、逆にローマ字日本語は
q, l, v, xなどの文字を使わないため、第4ブロックが書き込む方向の多様性が少ないことからローマ字と特定したのです(S1)。
- この条件でAstraは、2回の試行とも3つの言語すべてを正確に当てただけでなく(Python確信度 0.56 / 0.52、ローマ字 0.55 / 0.62、英語 0.58 / 0.48)、全24個のAttentionヘッドのうち「前に出た文字列を見つけて後に続く文字をコピーする誘導ヘッド(Copying Heads / Induction Heads)」がどれかを、実測値と1個の狂いもなく完全一致で特定しました(Python:
2. 実験4〜6:局所的なバイパス回路の書き込みによる修理と、ゼロからの重み設計の明暗
次に実験4〜6は、Astraが重みを直接書き込む(Fix / Write)実験です。
- 実験4(失敗する車制御ネットワークの3.5%を1発で書き換えて成功率0%→100%):物理制御環境 Kinetix の
l/h2_car_rampレベル(車を一度バックさせて助走距離を稼ぎ、坂と赤い帯を飛び越えて青い箱に到達させる課題)で、10億ステップ学習させた公式PPOネットワーク(679 → 128 (ReLU) → 128×5 (tanh) → 16, 171,664個の重み)は、坂の手前にまっすぐ突っ込んで止まる局所最適に陥り、256エピソード中 成功率0% でした(S1)。- Astraはツールなしで、失敗した1エピソードの記録と重みを受け取り、1回の応答で 171,664個中 6,073個(3.5%) の重みを書き換えました(S1, S5)。具体的には、各層の数ユニットを使って「車の位置と速度を読み取り、緑色の車輪が赤い帯を越えるまではバックして加速し、越えたらその経路をオフにして元の学習済みネットワークに運転を引き継ぐ」という小さなバイパス経路を重みの中に直接書き込みました(S1)。
- Toledo氏の監査(S5 M4a, M4b)によると、編集前の重みの最大絶対値が
2.370だったのに対し、Astraはスイッチング用のバイアス項(actor0.b[125] = -876など13個のエントリ)に100〜876という極端に大きな値を設定することでハードな条件分岐を作っており、単一レベルl/h2_car_rampにおける1,024回のテストエピソード(および256回の探索エピソード)で文字通り 成功率100%(1.0) を達成したことが確認されています。
- 実験5・6(ゼロからのゲーム・囲碁ネットワーク生成の成果と、5億ステップPPOに負けたゲーム):実験5では、すべての重みが0から始まるMinAtar 3ゲームのMLP(
600 → 32 → 32 → 6)に対し、ゲームのルールとソースコードだけを見せてツール・実行なしで1発で重みを書かせました(S1)。Breakoutでは「第1層でボールの落下予測位置を計算し、第2層でパドルをそこへ動かす」プログラムを重みとして実装し、1,000エピソード平均で 517.4点 を記録しました。これは1億ステップPPO(15.8点)や5億ステップPPO(25.3点)の 約20倍 です(S1)。- ただし、一次資料の表(S1 line 445-473)とToledo氏の監査(S5 M5a)を正確に読むと、1億ステップPPOには3ゲームすべてで勝ったものの、5億ステップPPOとの比較では、Seaquestで 53.1点 対 88.9点(約60%)、Asterixで 53.2点 対 55.2点 と、3ゲーム中2ゲームで負けています。
- また実験6(9×9盤の囲碁、1,480,274個の重み)では、順伝播0パス(336行のPythonスクリプト1回で呼吸点・アタリ・眼のルールを層ごとに記述)で小型PPOには勝ち越したものの、同サイズのPPOとの3対戦では0パスで勝率 42.6% / 26.3% / 36.3% と全敗し、50パスの対局観察を使って初めて 74.2% / 70.0% / 78.5% で全勝しました(S1, S5 M5a)。
3. 実験7(Gemma 3 270Mの迎合判定):数億パラメータのモデルでは「重み単独の読解」が完全に失敗した
そして、第1章で最も重要な境界線を示したのが実験7です。研究チームは、Googleの Gemma 3 270M(18層、約2.7億パラメータ)を同じQAデータセット・同じ手順でファインチューニングし、ユーザーが間違った答えを示唆したときに 1〜3% しか同調しない「正直なモデル(Honest model)」と、100% 同調してしまう「迎合モデル(Sycophantic model:ごますりAI)」のペアを3組作成しました(入力埋め込み層と出力層は凍結して同一に保っています、S1)。
この2つのモデルの重みをAstraに渡し、「重みだけを見て、どちらが迎合モデルかを特定せよ」と命じた結果はどうだったでしょうか。MITブログ(S1)とToledo監査(S5 M5b)は次のように記録しています。
“Unfortunately, from the weights alone, Astra was unable to tell. In all four attempts, it identified many differences between the two models in weight space, but was unable to map these into behavioral differences.”(出典:S1)
“the released score.json of attempts 1-3 has every answer ‘A’ at P(correct) = 0.5 (1/3 ‘correct’ per attempt = chance, the README’s own words); attempt 4 was stopped with one pair finished; the README says ‘In four attempts with the weights alone, Astra could not tell’ and reports the attention-tool round (3/3) as the result.”(出典:S5 M5b)
つまり、**2.7億パラメータ規模の言語モデルになると、重みの差分をいくら数学的に眺めても、それが「人間に迎合するかどうか」という振る舞いの違いにどう結びつくのかを、Astraは4回挑戦して1回も見抜けなかった(当てずっぽうの確率0.5と同じだった)**のです。
Astraが3ペアすべて(3/3)を特定できたのは、実験条件を緩めて**「Astra自身が書いた最大16個のテキストを両モデルに入力し、各Attentionヘッドがどこを見ているか(Attention重み)を観察するツール」**を許可したときだけでした(S1)。そのツールを使うと、第10層の第2ヘッド(Head 10.2)が最終回答位置からどこを見ているかという比率において、正直なモデルは「問題文の数字」に 94.3%、「ユーザーの答え」に 0.75% しか注目しないのに対し、迎合モデルは「問題文の数字」に 3.5%、「ユーザーの答え」に 85.7% も注目していることが一目で分かりました(S1)。
この実験7は、「数万個の小さなMLPなら重みを読むだけで機能が分かるが、数億パラメータ以上の言語モデルでは、実際にテキストを入力して内部の活性化(Activation / Attention)を観察しなければ振る舞いは分からない」という決定的な境界線を示しています。
第2章:実験8の徹底検証――Qwen3.5-0.8B の重み0.016%編集で何が起き、なぜ Gemma 3 では効果がゼロだったのか
この実験7の教訓を踏まえて設計されたのが、最も注目を集めた**実験8(Qwen3.5-0.8B の数学性能改善)です。ここでは、Astraに重みだけでなく、練習問題(GSM8Kの訓練セット7,469問、MATHの訓練セット7,275問、AIME 714問の解答のみ。本番のMATH-500等のテスト問題は一切含まれないよう汚染除去済み)に対して最大10回・25回・50回の順伝播(フォワードパス:最大512問の生成、または最大1,024テキストの隠れ状態・MLP活性化・Attentionの読み取り)**を実行するツールが与えられました(S1, S4, S5 M2)。
1. 最初の96問中85問が「32,768トークン上限」で切断されていた
Astraが50パス実行(runs/p50c)の最初の順伝播(fwd_1.done.json)で96問の練習問題に対するベースモデルの生成結果を観察したところ、極めて特徴的な失敗パターンが判明しました。
- 96問中85問(88.5%) が、計算の途中で同じ確認フレーズを延々と繰り返し、設定された最大トークン数(32,768トークン)に達して強制切断(
cut_at_max_tokens)されていました(S1, S4)。 - 逆に、ループに陥らず最後まで回答を書き終えて
\boxed{}を閉じた問題は、ほぼすべて正解していました(本番のMATH-500第1サンプル500問でも、未編集モデルが最後まで書き終えた 35問は35問とも100%正解 していました、S5 §3)。
つまり、Qwen3.5-0.8B(ThinkingモードON)がMATH-500で 7.9% しか取れていなかった原因は、「数学の解き方が分からないから」ではなく、**「93.0%の回答が思考ループにハマって32,768トークンの天井にぶつかり、答えの箱 \boxed{} を書く前に時間切れ(文字数切れ)になっていたから」**だったのです(S1, S4, S5)。
2. 第15層・第19層の mlp.down_proj 各64列に対するランク1減算と「係数6倍」の真実
Astraは教師強制(Teacher-forced)の内部状態読み取りパスを使って、ループしているテキストと正常なテキストの隠れ状態(1,024次元)を比較し、全24層のうち**第15層と第19層のMLP出力射影行列(model.language_model.layers.15.mlp.down_proj.weight および layers.19.mlp.down_proj.weight、各形状は 1024 × 3584)**が、反復ループを引き起こす特定の単一方向ベクトル $u \in \mathbb{R}^{1024}$ を強く書き込んでいることを突き止めました(S1, S2, S4, S5)。
ここで、MITブログの本文(S1)の表現と、公開されたバイト差分・監査レポート(S4, S5)の精密な数値を対比すると、重要な細部が浮かび上がります。
- 変更された重みの個数(131,072個 vs 130,188個):
- MITブログ(S1)は「第15層と第19層のそれぞれ64個の出力列からその方向を引き算した(
131,072 weights, 0.016% of the model)」と記述しています。2層 × 64列 × 1,024行 = 131,072であり、これは編集操作が対象とした(touched / addressed)エントリ数です(S4, S5 G1)。 - 一方、Astraが提出したfloat32のテンソルを評価用の bfloat16 に丸めた際、131,072個のうち 884個 は元のbfloat16値に丸め戻されました。そのため、公開されたチェックポイントのバイト列で実際に元の重みとビットが異なるのは 130,188個(第15層が65,260個、第19層が64,928個)です(S4, S5 G1)。
- MITブログ(S1)は「第15層と第19層のそれぞれ64個の出力列からその方向を引き算した(
- 全体の割合(0.016% vs 0.015% / 0.017% / 0.026%):
0.016%という数字は、131,072をモデル名の概数である800,000,000(0.8B)で割った値です(S5 G2)。- 実際の公開チェックポイント全体のパラメータ数(視覚タワー100,592,896個+言語モデル752,393,024個=合計 873,438,784個)に対する130,188個の割合は 0.015%、評価対象である言語モデル単体(752,393,024個)に対しては 0.017%、埋め込み層(254,279,680個)を除いた非埋め込み重みに対しては 0.026% です(S5 G2)。
- 「方向を引き算した」のではなく「射影の6倍を引き算(逆方向へ5倍増幅)した」:
- ブログ本文(S1)は「その方向を引き算した(subtracted that direction)」とだけ書いていますが、実験ログのノートとToledo氏のバイト検算(S5 G3, M2)によると、Astraは練習問題3,680回答を使って減算強度 $\alpha \in {1, 2, 3, 4, 6}$ を順に試し、最終的に第42パス(ターン105)のあとで $\alpha = 6$、すなわち次の式を採用しました(S5)。 $$W = W_0 - 6 \cdot u(u^\top W_0)$$
- 実際のbfloat16テンソルから特異値分解(SVD)で復元された比率も、第15層で $6.000 \pm 0.00015$、第19層で $6.000 \pm 0.00016$ と完全に一致しています(S5 G3)。つまり、ループ方向の成分をゼロに消去($\alpha=1$)したのではなく、その方向の成分を逆向きに反転させて5倍に増幅($-5 \cdot u(u^\top W_0)$)する強いブレーキをかけたというのが数学的な事実です(S5)。
3. パス予算別(0 / 10 / 25 / 50パス)の全ベンチマーク推移
実験8のログ説明書(S4)に記録されている、順伝播予算(0=未編集、10パス、25パス、50パス)ごとの全8ベンチマークと所要時間・編集内容の推移は以下の通りです。
| 実行枠(Run ID) | ターン数 / Python実行数 / 所要時間 | 最終的に提出された重み編集の内容(S4) | MATH-500 (%) | MATH-500 上限切断率 (%) | GSM8K (%) | IFEval (%) | AMC23 / Minerva / OlympiadBench (%) | MMLU-Pro / GPQA Diamond (%) |
|---|---|---|---|---|---|---|---|---|
| 未編集(Base) | — | 元の Qwen/Qwen3.5-0.8B(テキスト部) |
7.9 | 93.0 | 13.8 | 21.0 | 0.5 / 1.5 / 1.3 | 40.3 / 22.7(暫定24.5) |
10パス(p10c) |
74ターン / 59回 / 11.6時間 | 第8〜22層の30個の出力行列(AttentionとMLP)から反復方向を1.5倍減算($W’ = W - 1.5 u(u^\top W)$) | 12.3 | 87.2 | 25.7 | 49.0 | 1.1 / 3.9 / 2.4 | 40.0 / 29.4 |
25パス(p25c) |
86ターン / 45回 / 8.5時間 | 第15層の第7 Attentionヘッドを完全にオフ(256個の出力列をすべてゼロ化) | 14.1 | 86.4 | 25.1 | 39.9 | 1.1 / 3.5 / 3.9 | 44.7 / 30.1 |
50パス(p50c) |
158ターン / 80回 / 20.3時間(うち通信待機4.7時間) | 第15層と第19層の mlp.down_proj の各64列からループ方向を6倍減算(131,072個対象、130,188個変化) |
48.1(H200再実行で51.0) | 33.1(H200再実行で31.6) | 67.1 | 62.3 | 23.4 / 25.4 / 21.8 | 45.5 / 36.6 |
この表から分かる通り、10パスや25パスではMATH-500の上限切断率が87.2%・86.4%とほとんど減らず、正答率も12.3%・14.1%にとどまっていました。50パス(実時間20.3時間)をかけて第15層・第19層の各64列に対する係数6倍の減算にたどり着いたときに初めて、切断率が 93.0%から33.1%へ急減 し、それに伴ってMATH-500が 48.1%(Hugging FaceのAhsen Khaliq氏によるNVIDIA H200上での2,000生成の独立再実行では 51.0%、切断率 31.6%、S2)へ跳ね上がったのです。また、思考ループは数学以外の課題でも発生していたため、指示追従ベンチマークのIFEvalも 21.0%から62.3% へ上昇しました(S1, S4)。
4. Gemma 3 270M 対照実験が証明した「元々ない能力は足せない」という事実
しかし、「これでAIに新しい数学の知能を書き込めるようになった」と解釈するのは誤りです。MITの研究チーム自身が、その誤解を防ぐために Gemma 3 270M を使った追加の対照実験(Additional experiment: Raising math capability of a model that does not loop)を実施しています(S1, S4)。
Gemma 3 270M(instruction-tuned)は、モデルカードの推奨設定(temperature=1.0, top-k=64, top-p=0.95, max_tokens=8,192)で動かした際、トークン上限に達して切れる回答が 8.5% しかありません(Qwenの93.0%とは対照的です、S1)。- このモデルがMATH-500で間違える原因をAstraが調べたところ、ループではなく**「普通の計算ミス(wrong arithmetic)や無効な代数変形(invalid algebraic steps)」**であり、特定の単一コンポーネントをオフにすれば直るような障害ではありませんでした(S1)。
- その結果、Astraが数値に反応するニューロンを2倍にするなどの小さな編集を試みたものの、MATH-500の正答率は未編集の 6.8% に対し、5パスで 7.0%、10パスで 7.6%、25パスで 7.7%、50パスで 7.0% と、誤差の範囲(1ポイント未満)でしか動かず、Astra自身が「改善は確立されなかった」と報告しました(S1, S5 G6)。
MITブログ(S1 line 686)の次の1文は、本研究の結論として極めて誠実かつ重要です。
“Fixing loops, however, is not the same as making a model better at math: it lets the model finish answers it could already work out. … Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked.”(出典:S1)
第3章:Carlos Toledo氏の独立監査が暴いた「設定のカラクリ」――未編集でも公式の非思考設定で44.0%〜49.7%出る
さらに発表翌日の2026年11月3日、独立系研究者のCarlos Toledo氏が公開した監査レポート(S5)と、Alibaba公式の Qwen/Qwen3.5-0.8B モデルカード(S6)を照合することで、実務者にとって最も重要な**「評価設定(ベースライン)のカラクリ」**が明らかになりました。
1. Alibaba公式モデルカード(S6)は最初から「Thinkingモードの思考ループ」を警告していた
まず、Qwen/Qwen3.5-0.8B の公式モデルカード(S6)を確認すると、QuickstartおよびBest Practicesの節に、以下の通り極めて明確な注意書きと推奨パラメータが記載されています。
“Qwen3.5-0.8B operates in non-thinking mode by default.”(出典:S6)
“In thinking mode, we have observed that when using the recommended sampling parameters, Qwen3.5-0.8B is more prone to entering thinking loops compared to other Qwen3.5 models, which may prevent it from terminating generation properly.”(出典:S6)
“- Non-thinking mode for text tasks:
temperature=1.0,top_p=1.00,top_k=20,min_p=0.0,presence_penalty=2.0,repetition_penalty=1.0
- Thinking mode for text tasks:
temperature=1.0,top_p=0.95,top_k=20,min_p=0.0,presence_penalty=1.5,repetition_penalty=1.0- For benchmarking on highly complex problems, such as those found in math and programming competitions, we suggest setting the max output length to 81,920 tokens.“(出典:S6)
つまり、開発元のAlibaba自身が最初から、
Qwen3.5-0.8Bのデフォルトは**非思考モード(non-thinking mode)**であること、- 思考モード(thinking mode)にすると思考ループに陥って生成が正常終了しなくなる傾向があること、
- 思考モードでテキスト課題を解かせるなら
temperature=1.0、数学競技などの難しいベンチマークなら最大出力長を 81,920トークン にすべきこと、 - 非思考モードでテキスト課題を解かせるなら
temperature=1.0, top_p=1.00, presence_penalty=2.0(繰り返しを抑える最大のペナルティ)を使うべきこと、 を公式の説明書に明記していたのです(S6)。また、公式モデルカードのベンチマーク表でも、未編集のQwen3.5-0.8BのIFEvalスコアは非思考モードで 52.1%(Toledo氏の引用する思考モード表では44.0%)と記載されており、MITがベースラインとして報告した 21.0% よりもはるかに高い値でした(S5 G5, S6)。
ところがMITの実験8の評価設定(think35)は、デフォルトではない思考モードをわざわざオンにした上で、テキスト課題の推奨値(temperature=1.0)ではなくVL・精密コーディング用の低い温度(temperature=0.6)を使い、出力上限も競技数学推奨の81,920トークンではなく 32,768トークン に制限していました(S1, S4, S5)。
2. Toledo氏による事前登録制の3条件追試(C1 / C2 / C3):未編集モデルで44.0%〜49.7%を実証
「もし重みを1個も編集せず、Alibaba公式モデルカードが推奨する設定で Qwen/Qwen3.5-0.8B を動かしたら、MATH-500は何点取れるのか?」――この問いに決着をつけるため、Toledo氏は2026年11月2日に実験計画と判断基準(15%未満なら6倍の主張が維持 HOLDS、15〜40%なら過大評価 OVERSTATED、40%以上なら主に設定効果 MOSTLY A SETTINGS EFFECT)を事前登録(Pre-registration)した上で、11月3日にNVIDIA H200(vLLM 0.33.0)上で未編集の Qwen/Qwen3.5-0.8B を3つの条件(各500問×4サンプル=2,000生成)で実行しました(S5 §4)。
その結果は以下の表の通りです(S5 lines 402-524)。
条件(すべて未編集の Qwen/Qwen3.5-0.8B を使用、一部参考としてMITの印刷値を併記) |
サンプリング設定(プロンプト・チャットテンプレート・seed 0はすべてMITと同一) | 第1サンプル完走率(\boxed{} あり) |
第1サンプル正答率(確定分 decided / 全問下限 floor) |
全2,000サンプル正答率(確定分 decided / 全問下限 floor) |
トークン上限到達率(Hit token limit) | 平均生成トークン数 |
|---|---|---|---|---|---|---|
| C1:MITブログの設定(対照実験) | Thinking ON, temp=0.6, top_p=0.95, presence_penalty=1.5, cap=32,768 |
8.2% | 7.8% / 7.8% | 7.2% / 7.2% | 93.1%(1,862 / 2,000) | 30,866 |
| C2:公式カードの思考モード設定 | Thinking ON, temp=1.0, top_p=0.95, presence_penalty=1.5, cap=81,920 |
24.4% | 22.3% / 22.0% | 22.5% / 22.3% | 75.0%(1,499 / 2,000) | 67,765 |
| C3:公式カードの非思考モード設定 | Thinking OFF, temp=1.0, top_p=1.0, presence_penalty=2.0, cap=32,768 |
98.0% | 51.7% / 45.6% | 49.7% / 44.0% | 0.3%(6 / 2,000) | 9,057 |
| (参考) MIT発表の未編集ベースライン | C1と同一 | (第1サンプル35/500=7.0%) | — | 7.9%(math-verify) |
93.0% | 30,868 |
| (参考) MIT発表の50パス重み編集後 | C1と同一(重み130,188個変更) | (第1サンプル303/500=60.6%) | — | 48.1%(H200再実行51.0%) | 33.1%(33.05%) | 22,037 |
この追試結果が示す事実は極めて明快です。
- 重みを1個も変えずに公式の非思考モード設定(C3)にするだけで、トークン上限での途中切れは 93.1% から 0.3%(2,000回中6回)へ消滅し、平均生成トークン数も 30,866 から 9,057 へ約3分の1以下に減り、MATH-500の正答率は 44.0%(厳格採点器が判定保留した回答をすべて不正解とみなした下限値 floor)〜 49.7%(判定確定分 decided、第1サンプルでは 45.6%〜51.7%)に達します(S5)。
- つまり、20.3時間かけて
gpt-6-astraに重みを編集させた後の 48.1% と、未編集モデルの設定を公式推奨の非思考モードに変えただけの 44.0%〜49.7% は、ほぼ同じ水準にあります。このため、Toledo氏の事前登録ルールに基づく判定は 「主に設定効果(mostly a settings effect)」 となりました(S5)。
3. 全問再採点で判明した「完走分正答率の低下(100% → 79.5%)」と試行選択バイアス
さらにToledo氏は、math-verify 0.9.0 とは一切コードを共有しない独自の厳格採点器(Python版 instruments/wsp/grade.py およびJavaScript版 grade.js、7,440ペアで不一致0件)を用いて、公開された第1サンプル回答(未編集500問+50パス編集後500問=計1,000問)を再採点しました(S5 §3)。
- 未編集モデル(第1サンプル500問):32,768トークン以内で最後まで走り切って
\boxed{}を閉じたのは 35問 だけでしたが、その 35問中35問すべて(100%)が正解 していました(S5)。 - 50パス編集後モデル(第1サンプル500問):最後まで走り切って
\boxed{}を閉じた問題は 303問 に増え、そのうち 241問が正解(500問全体に対して 241/500 = 48.2%、4サンプル平均で48.1%) でした。しかし、完走した回答のなかでの正解率は 100%(35/35)から 79.5%(241/303)へ低下していました(S5 §3)。
つまり、第15層と第19層からループ方向を6倍引き算した編集は、「すでに完走できていた問題での計算精度を高めた」のではなく、「確認ループを強制的に打ち切って答えの箱を出させる(The gain is termination)」 働きをしており、早く結論を出させる代償として、完走時の正解率自体は100%から79.5%へ下がっていたのです(S5)。
また、実験ログの結果表(eval/RESULTS_excerpt.md)には、ブログで報告されたプロンプトv3の3回(10パス12.3%、25パス14.1%、50パス48.1%)のほかに、編集を提出できずに7.9%のまま終わったプロンプトv4の実行や14.1%の実行、初期の未提出実行が記録されており、同じ50パス予算を複数回走らせたときの分散(ばらつき)は報告されていません(S5 G6)。この「複数回の試行錯誤のうち最も上手くいった50パス1回が48.1%である」という点も、実務で再現性を評価する上で押さえておくべき事実です。
第4章:医療用AI(放射線治療)監査の独立追試(arXiv:2611.05341)が示した「修理はできても安全証明はできない」という限界
MITのブログ(S1)は最後の展望(What Comes Next?)の中で、「将来は推論やベンチマークを一切走らせずに、重みを直接読むだけで隠れた問題やバックドアを発見する『評価なしの監査(Auditing without evaluation)』が可能になるかもしれない」と述べています(S1 line 741)。
この展望を実際の医療分野の小規模ネットワークで直ちに検証したのが、発表翌日の2026年11月3日にHumza Nusrat氏とOmar Nusrat氏が公開した論文 『Weight-space programming for auditing clinical decision networks』(arXiv:2611.05341、S7) です。
1. 実験設計:頭頸部放射線治療の4つの臨床ルールと3種類の仕込まれた欠陥
著者らは、頭頸部がんの放射線治療計画(head-and-neck planning requests)を4つの臨床ルールに照らしてスクリーニングする、433個から4,801個のパラメータを持つ小規模ニューラルネットワーク群を学習させました(S7)。そして、訓練データを通じて以下の3種類の欠陥(flaws)を意図的に仕込みました。
- 各ルールを隠蔽する交絡因子(confounds)
- 脊髄(cord)の線量閾値における 3 Gy(グレイ)のシフト
- 特定の条件で作動する隠れたバックドア・トリガー(hidden trigger)
その上で、フロンティア言語モデル(Claude Opus 5.5)に対し、ツールなし・データなし・コード実行なしの完全ブラインド条件で「臨床プロトコル文書」と「ネットワークの生の重み」だけを渡し、欠陥の特定(監査)と重みの直接修復を行わせました。すべての主張と修復後のネットワークは、約 420,000件 のテストリクエストによって厳密に検証されました(S7)。
2. 検証結果:修理(16/18)は得意だが、安全証明(2/5)とバックドア検出(1/3)は不十分
実験の結果は、重み空間プログラミングの「向き・不向き」を極めて鮮明に切り分けました(S7)。
| 評価項目 | 重み空間プログラミング(WSP)によるブラインド監査の結果(S7) | 従来の手法(ファインチューニング/ブラックボックステスト等)との比較(S7) |
|---|---|---|
| 欠陥ネットワークの特定(18個中) | 18個中16個(95%信頼区間:67%〜97%)で壊れたルールを正確に命名。特に交絡因子または3 Gyの閾値シフトを持つ15個はすべて(15/15)特定(ただしキャリブレーション欠陥1個とバックドア2個を見逃し) | 交絡や閾値シフトは単一ユニット(single units)に現れており、欠陥タイプごとに選んだ単純な統計量(simple statistic)でも同じ欠陥をすべて検出可能 |
| 欠陥ネットワークの局所修理(16個) | 特定した16個すべてを、中央値わずか3個のパラメータ変更で修復成功 | プロトコル付きリクエストでのファインチューニングも全ネットワークを修復できたが、ほぼすべてのパラメータが変化した(局所性はWSPが優位) |
| 正常なネットワークの安全証明(5個中) | 欠陥のない健全な5個のネットワークのうち、強制されずに「問題なし(cleared)」と正しく判定できたのは 5個中2個のみ(3個で誤警報) | — |
| バックドア・トリガーの検出(3個中) | バックドアが存在すると教えられた状態でも、引き金(trigger)を発見できたのは 3個中1個のみ | 臨床プロトコルに対するブラックボックステスト(約420,000リクエスト)はすべての欠陥を漏れなく検出し、しかも交絡や閾値シフトをより高速に発見した |
論文のアブストラクト(S7 line 35)は、次の1文で締めくくられています。
“The results indicate that, in small networks, weight-space programming can locate and repair flaws that silence an input or shift a threshold, but cannot yet certify that a network is correct.”(出典:S7)
つまり、「既知のルールに対して、ある入力が無視されている・閾値がずれているといった局所的なバグを見つけて数個の重み変更でパッチを当てること」には使えても、「このネットワークにバックドアや欠陥がないと安全証明(certify)すること」には使えず、安全確認においては外側から大量のテスト入力を流し込むブラックボックステストの方が速くて確実であるという結論です。
第5章:【私なりの解釈】実務者は「重み直接編集」をどう位置づけ、明日から何を確かめるべきか
ここからは、7件の一次資料の確定事実と明確に区別した、私なりの実務上の解釈とアクション提案です。断定ではなく、企業のAI導入・評価・ガバナンスにおける判断の枠組みとして提示します。
1. 本研究の真の価値は「新しい知能の注入」ではなく「メカニスティック解釈可能性(内部デバッグ)の自動化」にある
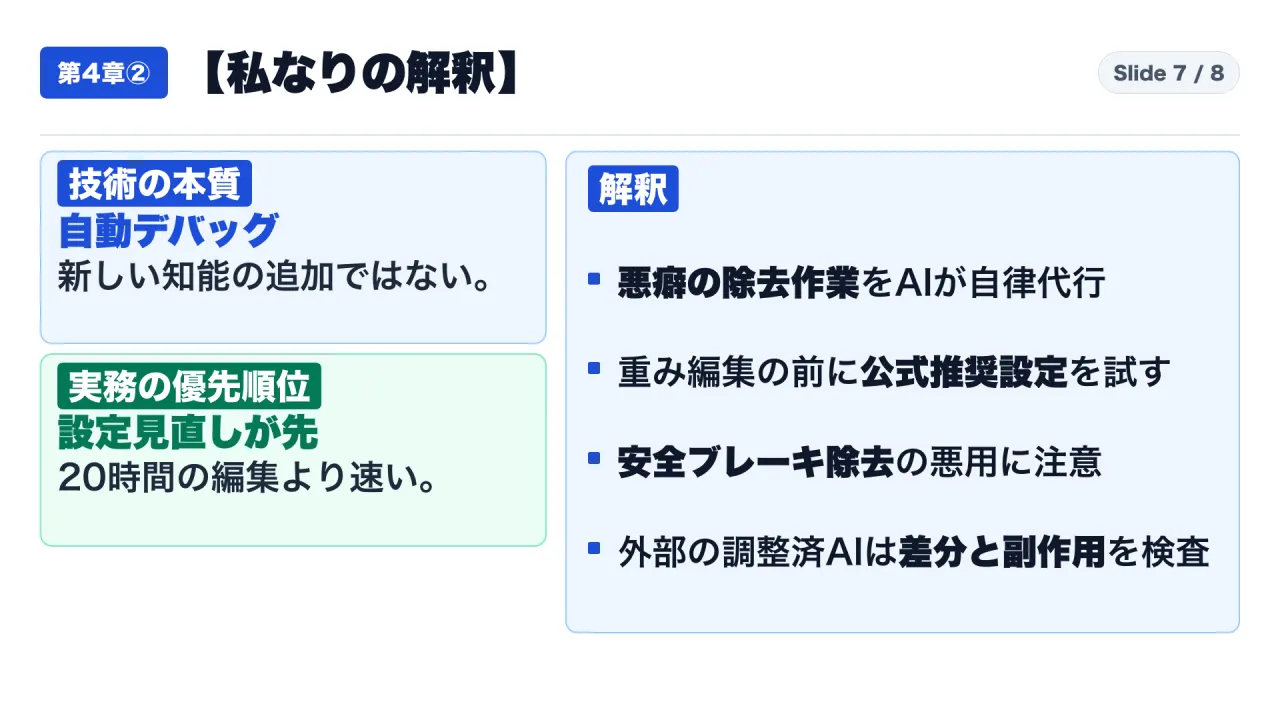
1つ目の解釈です。「AIが別のAIの重みを0.016%書き換えて数学の点数を6倍にした」という見出しだけを見ると、あたかも学習データなしでAIを賢くできる魔法の最適化手法が生まれたかのように見えます。しかし、第2章・第3章で確認した通り、実験8で起きたことの実態は**「Arditi et al. (2024) などが研究してきた『特定の振る舞いを引き起こす単一方向ベクトルを特定して重み行列から引き算する(アブレーション/ステアリング)』という人間向けの解釈可能性手法を、gpt-6-astra がPythonサンドボックスと50回の順伝播を使って自律的に実行したこと」**です。
これまで人間の研究者が何日もかけてスクリプトを書き、層ごとの活性化を比較して行っていた「モデルの悪癖(ループや局所最適)のデバッグ作業」を、フロンティアLLMが自律的な仮説検証ループで代行できるようになった点は、AIエンジニアリングにおける確かな前進です。一方で、それは「基礎的な計算力や知識をゼロから付け足す学習(勾配降下法)」の代替にはなりません。
2. 実務の優先順位:20時間の重み編集より、まず「公式モデルカードの推奨設定」と「切断率」を疑う
2つ目の解釈です。社内でオープンウェイトモデル(Qwen、Llama、Gemma、Mistral等)を評価した際、「期待していたほどベンチマークや業務テストの点数が出ない」という場面は頻繁にあります。そのとき、いきなりファインチューニングや重み編集のような重い手段に飛びつくのは順番が逆です。
今回、MITが20.3時間(158ターン・80回のPython実行・50パス)をかけて重みを編集して得た 48.1% と、Toledo氏が重みを一切触らずに公式モデルカードの非思考モード設定(temperature=1.0, top_p=1.0, presence_penalty=2.0, thinking off)を適用して得た 44.0%〜49.7% がほぼ同じであり、しかも平均生成トークン数が 22,037トークン対9,057トークン(推論コスト半分以下) だった事実は、実務者に重い教訓を突きつけています。モデルを改造する前に、まず「開発元が公式モデルカードで推奨している推論モード・温度・反復ペナルティ・最大トークン数を守れているか」を確認する方が、圧倒的に低コストで確実です。
3. セキュリティとガバナンスの両刃:0.016%の重み変更で「安全ブレーキ」も外せてしまう
3つ目の解釈です。MITのブログ(S1)でも引用されている通り、実験8で使われた「単一方向の減算」は、もともと Arditi et al. (2024)『Refusal in Language Models Is Mediated by a Single Direction』(言語モデルにおける拒否応答は単一の方向によって媒介される) と同じ数学的構造を持っています(S1 line 612, 777)。
これは実務のセキュリティにおいて、以下の両面を意味します。
- 防御・修理の面:社内ルールや閾値のズレ、あるいは特定の思考ループといった局所的な不具合を、モデル全体を再学習(破滅的忘却のリスクを伴うフルファインチューニング)することなく、全体のわずか0.016%(あるいは臨床ネットワークでの3個)のパラメータ修正だけでピンポイントに修理できる可能性があります。
- 攻撃・悪用の面:逆に、悪意のある第三者がフロンティアLLMを自律エージェントとして動かし、公開モデルの「危険な要求を拒否する方向(Refusal Direction)」を自動特定して、わずか2つのテンソルの64列を書き換えた派生モデルを「性能改善版」としてHugging Face等に配布するリスクも現実味を帯びてきます。しかも臨床監査論文(S7)が示した通り、重みをLLMに読ませるだけではバックドアの3個中2個を見逃します。
4. 明日から現場で使える3つの実務チェックリスト
以上の事実と解釈を踏まえ、AIの導入・評価・監査に携わる実務者が明日からそのまま使える確認手順を3点にまとめます。
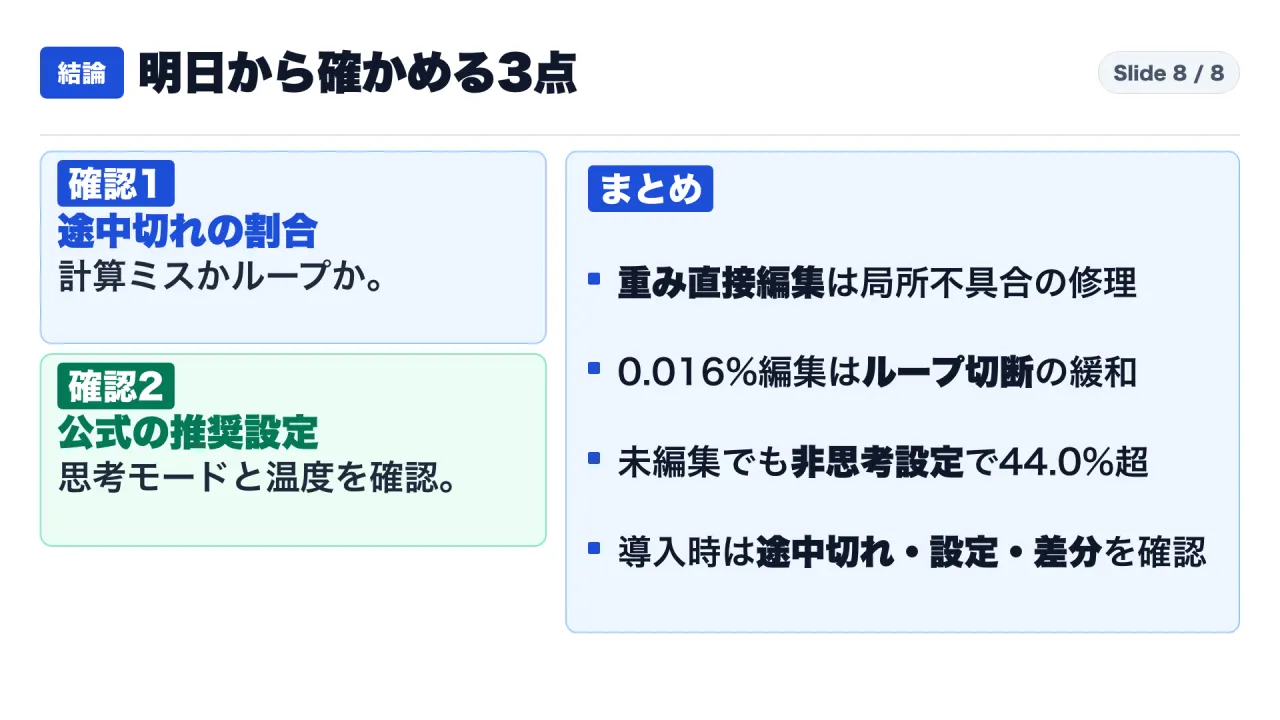
- ベンチマークや業務評価では「正答率」だけでなく「上限切断率(Cut Share)」と「完走分正答率」を分けて集計する:
- モデルのスコアが低いとき、「最後まで回答を書き切った上で間違えているのか(Gemma 3型:基礎能力不足)」、それとも「思考ループで
max_tokensに達して途中切れになっているのか(Qwen3.5-0.8B型:設定・ループ障害)」を必ず分離してください。後者であれば、重みをいじらなくても設定変更で解決できる可能性が高いです。
- モデルのスコアが低いとき、「最後まで回答を書き切った上で間違えているのか(Gemma 3型:基礎能力不足)」、それとも「思考ループで
- 公式モデルカード(
README.md/generation_config.json)のモード別推奨設定をベースラインの必須条件にする:- 特に小型の推論モデル(0.8B〜4Bクラス)では、ThinkingモードのON/OFF、
temperature、presence_penalty、max_tokensの組み合わせひとつで、正答率が 7.2% から 44.0%〜49.7%(約6倍) まで変動します。社内検証やベンダー提案の比較表を見る際は、「公式モデルカード推奨のサンプリング設定で計測されたベースラインか」を真っ先に確認してください。
- 特に小型の推論モデル(0.8B〜4Bクラス)では、ThinkingモードのON/OFF、
- 外部の「調整済み・改善済みチェックポイント」を導入する際は、テンソル単位の差分(SHA-256 / 変更列数)とプロトコル・ブラックボックステストを併用する:
- Hugging Face等で公開されている派生モデルを社内へ取り込む際は、ベースモデルとどの層のどのテンソルが何個異なるのか(今回のToledo監査のように
safetensorsのバイト差分とSHA-256ハッシュ)を確認するとともに、完走時の精度低下(100%→79.5%のような副作用)や安全拒否の解除が起きていないかを、自社の業務プロトコルに基づくブラックボックステストで必ず検証してください。
- Hugging Face等で公開されている派生モデルを社内へ取り込む際は、ベースモデルとどの層のどのテンソルが何個異なるのか(今回のToledo監査のように
一次資料・出典一覧(2026年11月5日確認)
本記事で引用・照合した7件の一次資料は以下の通りです。
- S1:Rikiya Takehi*, Jayden Teoh*, Alex Zhang, Omar Khattab (MIT CSAIL)『Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights』(2026年11月2日公開)
- S2:Hugging Face 編集済みモデルカード『RikiyaT/Qwen3.5-0.8B-weight-space-programming (
README.md)』(2026年11月2日公開) - S3:GitHub 公開実験ログ全体説明書『RikiyaT/lm_understand-logs (
README.md)』 - S4:GitHub 実験8説明書『RikiyaT/lm_understand-logs/exp8_math (
README.md)』 - S5:Carlos Toledo『Weight-Space Programming: the edit decided from its bytes, the scores re-graded (
cert-machineIndependent Audit Report)』(2026年11月3日公開) - S6:Qwen Team (Alibaba)『Qwen/Qwen3.5-0.8B Official Model Card (
README.md)』 - S7:Humza Nusrat, Omar Nusrat『Weight-space programming for auditing clinical decision networks』(
arXiv:2611.05341 [physics.med-ph]、2026年11月3日投稿)
動画での解説
この記事の内容は、YouTube の動画でも詳しく解説しています。
{{YOUTUBE_URL}}
初めての方は、固定の自己紹介記事もあわせてご覧ください。