なぜ公開AIのルールは、中国の2社が一番ゆるいのか?
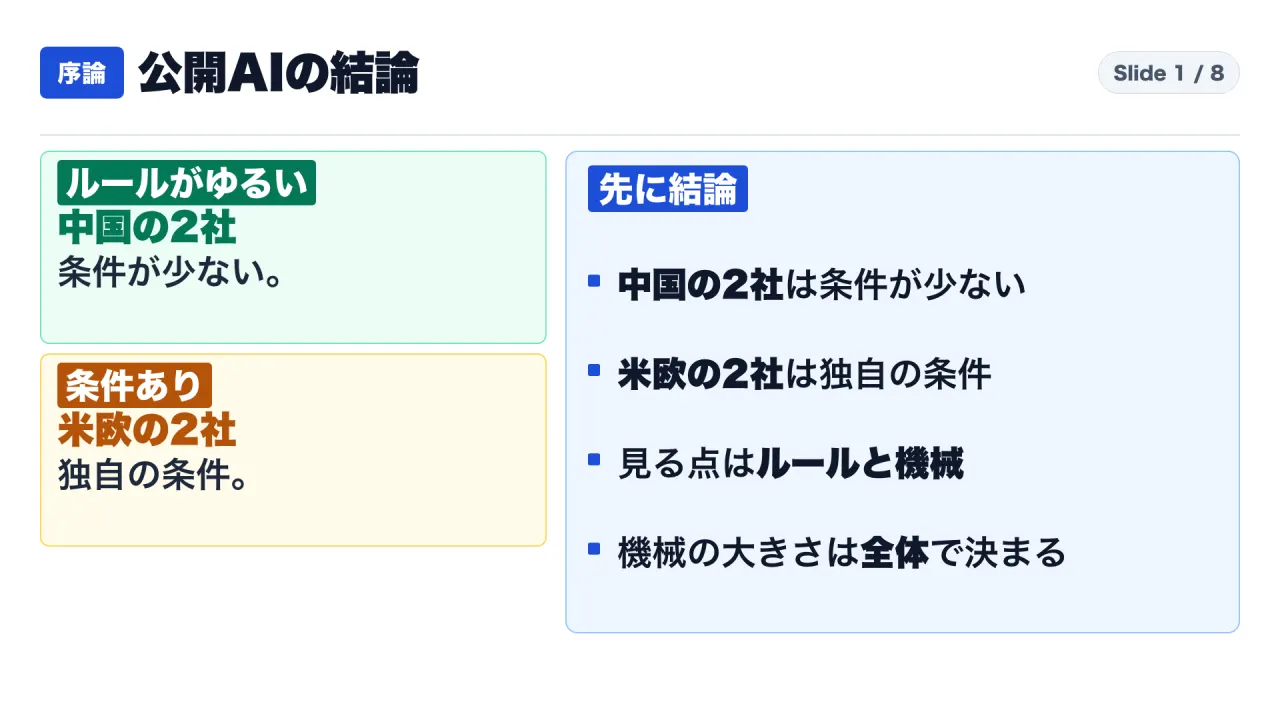
結論:ルールが最もゆるいのは中国の2社。機械の大きさは「AI全体の大きさ」で決まる
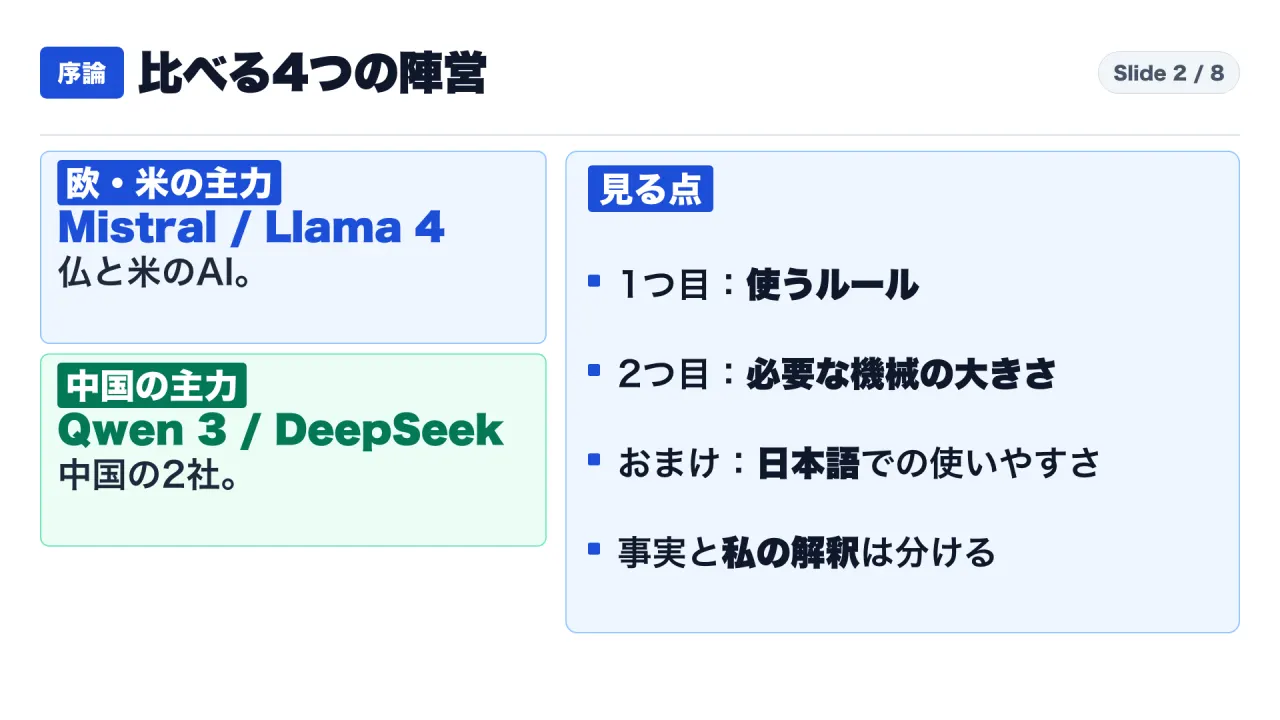
結論から書きます。AIの頭脳にあたるファイルを公開しているAIを、会社が自分の機械で動かすとき、確かめることは2つです。1つ目は、使うときのルール。2つ目は、必要な機械の大きさです。
1つ目のルールは、中国の2社が最もゆるく、アメリカとヨーロッパの2社には独自の条件があります。ゆるいのは、アリババのQwen 3(クウェン・スリー)と、ディープシークのDeepSeek-R1(アールワン)です。条件があるのは、アメリカのMetaのLlama 4(ラマ・フォー)と、フランスのMistral AIのMistral Large 4(ミストラル・ラージ・フォー)です。
2つ目の機械の大きさは、「一度に働く部分」ではなく、「AI全体の大きさ」で決まります。宣伝では前者の小ささが強調されがちですが、自分の機械でAIを動かす人にとって大事なのは後者です。
この記事は、AIの用語に詳しくない方を含め、会社でAIの導入に関わる担当者・管理職・法務・企画の方に向けて書いています。読み終えると、次の3つができるようになります。
- 自社の使い方が「社内で使う」のか「他の会社にAIの使い口を貸す」のかを、ルールの条文と照らして切り分ける
- 一度に働く部分の宣伝文句に惑わされず、AI全体の大きさから必要な機械を見積もる
- 「国の安全」「日本語と費用」「小さなAIの手本役」の3つの考え方で、候補のAIを絞る
なお、株式の売買や投資の判断は一切扱いません。
まず、公開AIとは何か。出前と、自分の厨房の違い
いま多くの人が使っているチャットのAIは、会社の外にあるサービスに質問を送り、答えをもらう形です。飲食店でいえば、出前を取るようなものです。これは、たとえ話です。
一方、AIの頭脳にあたるファイルを公開しているAIは、そのファイルをもらって、自分の会社の機械で動かす形です。レシピをもらって、自分の厨房で料理するようなものです。これも、たとえ話です。このタイプのAIを、専門的には「オープンウェイト」と呼びます。「ウェイト」は「重み」のことで、AIが学習して身につけた中身の数値データを指します。この記事では、分かりやすく「公開AI」と書きます。
自分の厨房で作れば、社内の資料を社外に出さずに使えます。費用の出方も、使うたびに払う形から、機械を用意する形に変わります。ただし、レシピには使っていい条件があり、広い厨房、つまり大きな機械も要ります。この記事で比べるのは、この「条件」と「厨房の広さ」です。ここは、一般的な考え方の説明で、各社の説明書の内容ではありません。
「公開されているなら、どれも同じように無料で、小さな機械で動かせるのでは」と思われがちです。しかし、各社のルールの全文と設定ファイルを読むと、はっきりした差があります。
この記事の読み方:確かめられた事実と、私の解釈を分けます
この記事では、書かれていることを3種類に分けます。
- 一次資料で確かめた事実:各社が公開している説明書(モデルカード)、ルールの全文(ライセンス)、利用規約、設定ファイル、公開場所の記録、公式ブログ、東京科学大学と産業技術総合研究所(産総研)の公式ページに書かれている内容です。すべて2026年11月5日に取得して照合しました。末尾の出典一覧(S1〜S15)に、取得先を載せています。
- 私の計算:公開されている数字から計算した値です。たとえば、公開場所の記録にあるファイルの大きさ1,060,619,283,859バイトを、1兆(10の12乗)で割ると、約1.06テラバイトになります。文中に「私の計算」と書きます。
- 私なりの解釈と提案:日本の会社が選ぶときの3つの考え方や、明日からの確認手順です。説明書に書かれた事実ではなく、導入する会社側の事情や、私の見方です。
先に、言葉を6つだけそろえます
本文で使う言葉を、日常の言葉で説明します。
- ライセンス:AIを使ってよい条件を書いた書類です。部屋を借りるときの契約書のようなものです(たとえ話です)。
- パラメータ:AIの頭脳の中にある、細かな調整の数値のことです。この数が多いほど、大きなAIです。「個」で数えます。
- 専門家混合(MoE:エムオーイー):頭脳の中に、得意分野の違う「専門家」がたくさんいて、質問のたびに、必要な専門家だけが働く作りです。会社でいえば、部署がたくさんあって、案件ごとに担当の部署だけが動くようなものです(たとえ話です)。
- 一度に働く部分と、AI全体:専門家混合のAIでは、質問のたびに働くパラメータ(働く部分)と、頭脳全体のパラメータ(AI全体)は、別の大きさです。
- メモリ:機械が作業をするとき、AIの頭脳のファイルを広げておく、作業机のようなものです。机が狭いと、ファイルが載りません(たとえ話です)。AI用の機械では、GPU(ジーピーユー)という専用の部品のメモリを使います。
- 蒸留(じょうりゅう):大きなAIの答えを教材にして、小さなAIを育てることです。ベテランの仕事ぶりを手本にして、新人を育てるようなものです(たとえ話です)。
もう一つ、ルールの中に出てくる言葉があります。**モデル・アズ・ア・サービス(MaaS)**です。ミストラルのルールでは、他の会社に、AIの使い口をインターネット経由などで貸し出し、相手が自由に質問や設定や学習データを入れて使える事業、と定義されています。
4つの陣営を、1つの表で見ます
次の表は、各社の説明書とルールの全文にある内容を、数字を絞ってまとめたものです。
| 比べる点 | Mistral(フランス) | Meta・Llama 4(アメリカ) | Alibaba・Qwen 3(中国) | DeepSeek(中国) |
|---|---|---|---|---|
| 取り上げたAI | Mistral Large 4 | Llama 4(Scout、Maverick) | Qwen3-30B-A3B、Qwen3-32B | DeepSeek-R1、DeepSeek-V3 |
| 使うルール | Mistral独自のルール(MITを少し変えたもの) | Meta独自のルール(Llama 4 Community License) | Apache 2.0 | R1はMIT。V3は独自のルール(条文は未確認) |
| 主な条件 | 他社へAIの使い口を貸す事業だけ、別契約(第2条)。社内利用(第3条)は対象外。著作権の表示は残る(第1条) | 月間の利用者が7億人超なら許可が必要。名前の表示とLlamaの名前付け。EUの企業は画像と文章を扱うタイプが対象外 | 売上や利用者数の上限なし。著作権の表示などは残る | R1は仕事での利用・手を加えること・蒸留を認める。著作権の表示は残る |
| AI全体の大きさ(働く部分) | 1兆個(490億個) | Scout:1,090億個、Maverick:4,000億個(どちらも働くのは170億個) | 305億個(33億個)、328億個 | 6,710億個(370億個) |
| 日本語 | 公式の言語数は160以上(EU公用語を含む)。日本語の個別の実績は確認していない | 公式の対応言語12に日本語は入っていない | 100以上の言葉に対応。国内の研究チームがQwen3 Swallowを公開 | 日本語の個別の実績は確認していない |
注意点は3つです。表の「1兆個」などは、説明書にある数字です。「働く部分」は、質問のたびに実際に計算に使う部分です。DeepSeek-V3の重みは、MITではなく独自のルールに従い、その条文は今回読んでいません。
第1章:使うルールは、中国の2社がゆるく、米欧の2社には条件がある
AIを会社で使うとき、最初に確かめるのは、テストの点数ではなく、ルールの条文です。各社のルールの全文(S2、S5、S6、S8、S12)を並べると、アメリカやヨーロッパのAIより、中国の2社のほうが、条件が少ないことが分かります。
1. 中国の2社:Apache 2.0とMIT
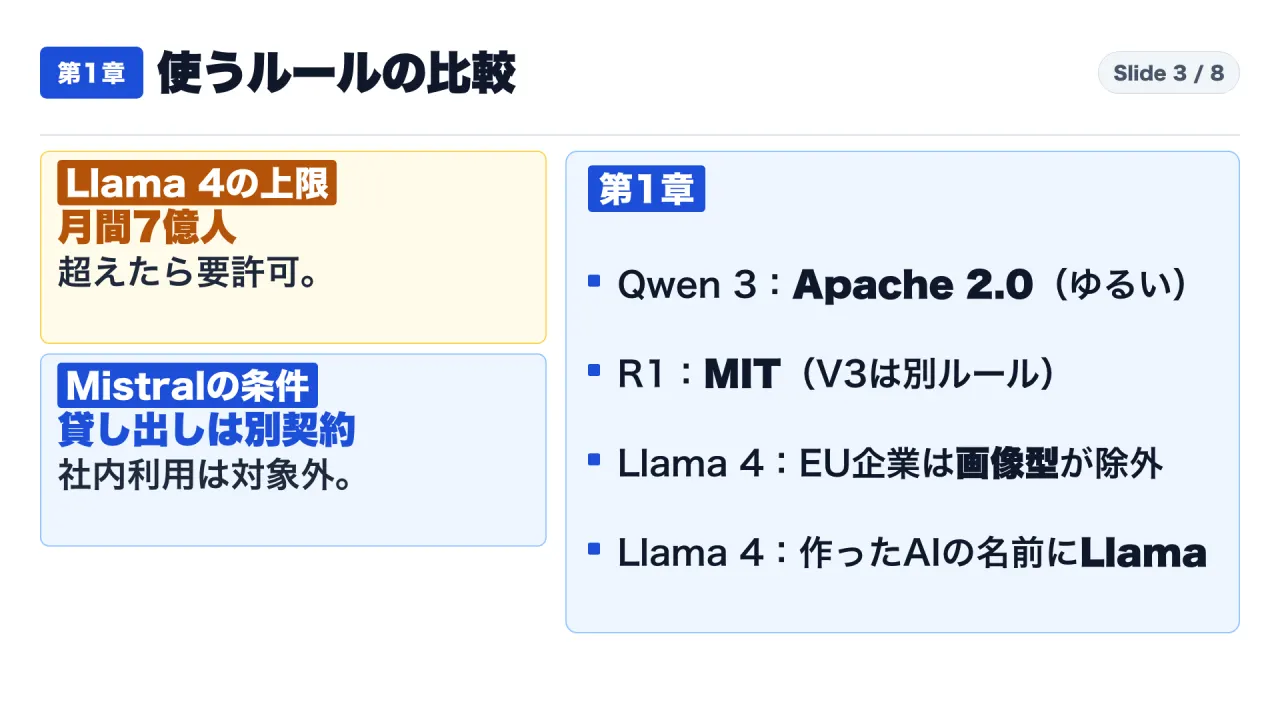
アリババのQwen 3(S8、S9)は、「Apache 2.0」というルールで公開されています。世界でよく使われる公開用のルールで、売上の上限も、利用者数の上限もありません。社内で使うことも、自社のサービスとして外部に提供することも、手を加えて配ることもできます。
ディープシークのR1(S11、S12)は、「MIT」というルールです。説明書には、仕事での利用も、手を加えることも、他のAIを育てるための蒸留も、認めると書かれています。
ただし、どちらも、作った会社の著作権の表示を残す、といった最低限の条件は付きます。
例外があります。 同じディープシークでも、DeepSeek-V3の重みは、MITではありません。V3の説明書(S13)には、プログラムを置く場所はMIT、AIの使い方は、ディープシーク独自のルールに従う、と書かれています。同じ箇所に、仕事での利用に対応するとも書かれています。ただし、その独自のルールの条文は、今回読んでいません。V3を使うなら、使う前に別に確認してください。
2. アメリカのMeta:3つの条件
MetaのLlama 4(S5、S6、S7)は、Meta独自のルールで、条件が3つあります。
1つ目は、利用者数の上限です(第2条)。 Llama 4が公開された日の時点で、その前の月に、自社の製品やサービスを使う人が、月に7億人を超えている会社は、Metaから個別の許可をもらわないと使えません。7億人は、日本の人口の何倍にもなる数字です。ここは私の見方ですが、ほとんどの日本の会社には、まず関係しない規模だと思います。
2つ目は、名前の表示です(第1条)。 Llamaを使った製品を出すときは、「Built with Llama(Llamaで作った)」と目立つ形で表示します。Llamaを土台に作った別のAIを配るときは、その名前の先頭に「Llama」を付けます。Metaの説明書は、大きなAIの答えを使って小さなAIを育てることも、このルールで認められると書いています。ただし、育てたAIの名前にも、先頭の「Llama」が要ります。
3つ目は、地域の制限です(利用規約の末尾)。 ヨーロッパ連合(EU)に住む個人や、主な事務所をEUに置く会社には、画像と文章の両方を扱えるタイプのLlama 4を使う権利を与えない、と書かれています。ただし、そのAIが組み込まれた製品を使うだけの利用者は、対象外です。
3. フランスのMistral:貸し出し事業にだけ別契約
Mistral Large 4(S1、S2)は、「Mistral Ecosystem Open-Weight License」という、MITを少し変えた独自のルールです。説明書には、商用でも非商用でも使える、ただしAIの使い口を貸す事業には別の商用契約が要る、とあります。
- 第1条:著作権の表示とライセンス文を、複製物に付けること。どの場合でも残ります。
- 第2条:他社にAIの使い口を貸す事業(MaaS)を行う場合は、仕事で使う前に、Mistralと別の商用契約を結ぶこと。AIの機能を、特定の機能の中だけに組み込んだ、利用者向けの製品は、MaaSに含まれません。他社が使うAIの窓口を、中継するだけの場合も、含まれません。
- 第3条:社内で使うこと、Mistral公式の製品を通して使うことには、第2条の条件は当てはまりません。
つまり、他の会社にAIの使い口を貸す事業にだけ別の契約を求め、社内利用や、機能の一部に組み込んだ製品には求めない、という作りです。
第2章:必要な機械の大きさは、働く部分ではなく、AI全体で決まる
1. 4つの陣営とも、専門家混合のAIを出しています
専門家混合のAIは、質問のたびに、一部の専門家だけが働きます。そのため、計算の量は軽くなります。Mistral Large 4(S1)、Llama 4(S7)、Qwen 3(S8)、DeepSeek-V3(S13)の説明書に、この作りのAIだと書かれています。
一度に働く部分と、AI全体の大きさは、次のとおりです。
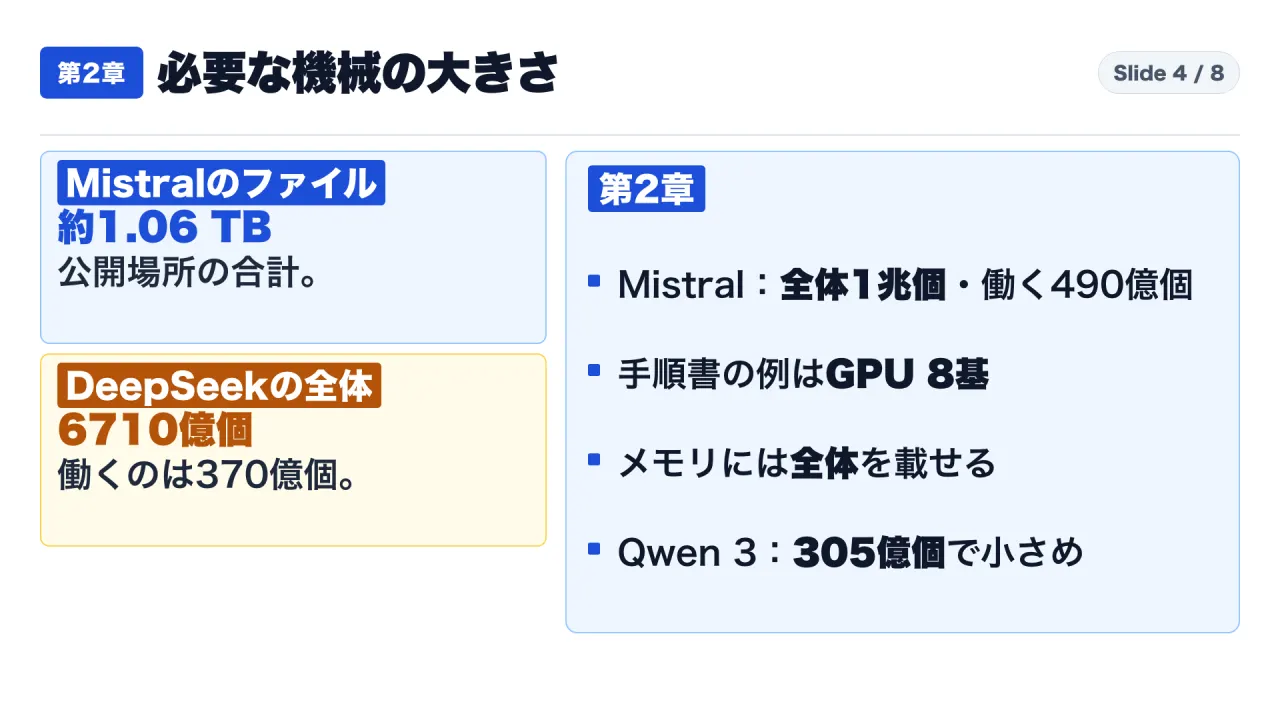
- Mistral Large 4:AI全体で1兆個、一度に働くのは490億個です(S1)。
- Llama 4:Scoutは全体で1,090億個、Maverickは全体で4,000億個で、どちらも働くのは170億個です(S7、S15)。
- DeepSeek-R1:全体で6,710億個、働くのは370億個です(S11、S13)。
2. 落とし穴:机には、AI全体を広げておく必要があります
「働く部分が小さいから、軽くて動かしやすい」と説明されることがあります。確かに、計算の量は軽くなります。しかし、機械にAIを読み込んで待たせておくときは、どの専門家に仕事が来てもすぐ答えられるように、原則として、AI全体をメモリに載せておく必要があります。部署のうち、動くのは一部でも、全部署の名簿は、机の上に置いておく必要がある、という感じです(たとえ話です)。
Mistral Large 4で、実際の数字を見ます。
- 公開場所の記録(S4)には、ファイル全体の保存量が1,060,619,283,859バイトと記録されています。1兆で割ると、約1.06テラバイトです。1テラバイトは、1,000ギガバイトです。これは私の計算で、AI本体だけの大きさではなく、公開場所に置かれたファイル全体の量です。
- 公式の手順書(S1)には、サービス用の設定例として、GPUを8つ並べて使う指定(
--tensor-parallel-size 8)があります。 - 設定ファイル(S3)によると、すでにメモリを節約した形式(8ビット)で保存されています。それでも、この大きさです。
- 同じ説明書(S1)には、メモリの使い方を抑えた縮小版(NVFP4版)も、別に公開されていると書かれています。
ここで一つ、大事な注意です。1テラバイトを超えるメモリ量が目安になる、というのは、保存量から私が見積もった話です。公式が示した必要メモリではありません。
ディープシークのDeepSeek-V3の説明書(S13)には、公開場所でのモデルの総サイズは、本体の671B(6,710億個)に、予測用の部品の14B(140億個)を足した685B(6,850億個)と書かれています。フルサイズを自社で動かすには、大規模な設備が要ります。
3. 手頃な機械で動かすなら、Qwen 3の30B〜32Bが候補です
大きな机は用意できないが、社外にデータを出さずに、自社の機械でAIを動かしたい。そういう会社に向く選択肢が、アリババのQwen 3です。
- Qwen3-30B-A3B(S8):AI全体で305億個、働くのは33億個の、専門家混合のAIです。
- Qwen3-32B(S9):全体で328億個の、専門家混合ではない(全体がいつも働く)AIです。
- どちらも、じっくり考えるモードと、すばやく答えるモードを、1つのAIの中で切り替えられると、説明書に書かれています。
Mistralの1兆個に比べて、ずっと小さな大きさです。
第3章:日本語での使いやすさと、小さなAIの育て方
1. Llama 4は、公式の対応言語に日本語が入っていません
Llama 4の説明書(S7)にある、公式に対応している言語は12言語で、日本語は入っていません。学習には200の言語が含まれていますが、12言語以外で使うときは、安全で責任ある形で使えているかを、使う側が自分で確かめる責任がある、と書かれています。
2. Qwen 3と、国内の研究チームによるQwen3 Swallow
Qwen 3は、100以上の言葉と方言に対応しています(S8)。2026年2月20日に、東京科学大学の岡崎研究室・横田研究室と、産業技術総合研究所の研究チームが、Qwen 3を土台に日本語と考える力を強めた「Qwen3 Swallow(スワロー)」を公開しました(S10)。
公式ページ(S10)によると、Swallowは8B、30B-A3B、32Bの3つのサイズで、Apache 2.0で公開されています。日本語の課題の平均点は、30B-A3Bが0.732、32Bが0.792でした。2026年2月時点で、32Bは、同じ大きさ以下の公開AIの中で、最も高い成績でした。これは、公式ページに書かれた内容です。
3. Mistral Large 4の得意分野は、ミストラル自身の紹介です
Mistralの説明書(S1)と公式ブログ(S14)は、プログラム作りとサイバー防衛の成績が高いと紹介しています。説明書は、第三者の測定機関(Artificial Analysis)のプログラム作りの指標で48%、先頭の公開AIとほぼ並ぶと書いています。公式ブログは、同じ機関のサイバー指標で51%と書いています。いずれもMistral自身が紹介している数字で、私は測り直していません。
4. DeepSeek-R1の強みは、小さなAIを育てる手本役としての実績
ディープシーク自身が、R1の答えから作った80万件のデータで、QwenやLlamaの小型モデルを育てて、公開しています(S11)。32Bの育てたモデルが、さまざまな試験で、OpenAIの小型モデル(o1-mini)を上回ったと、説明書に書かれています。
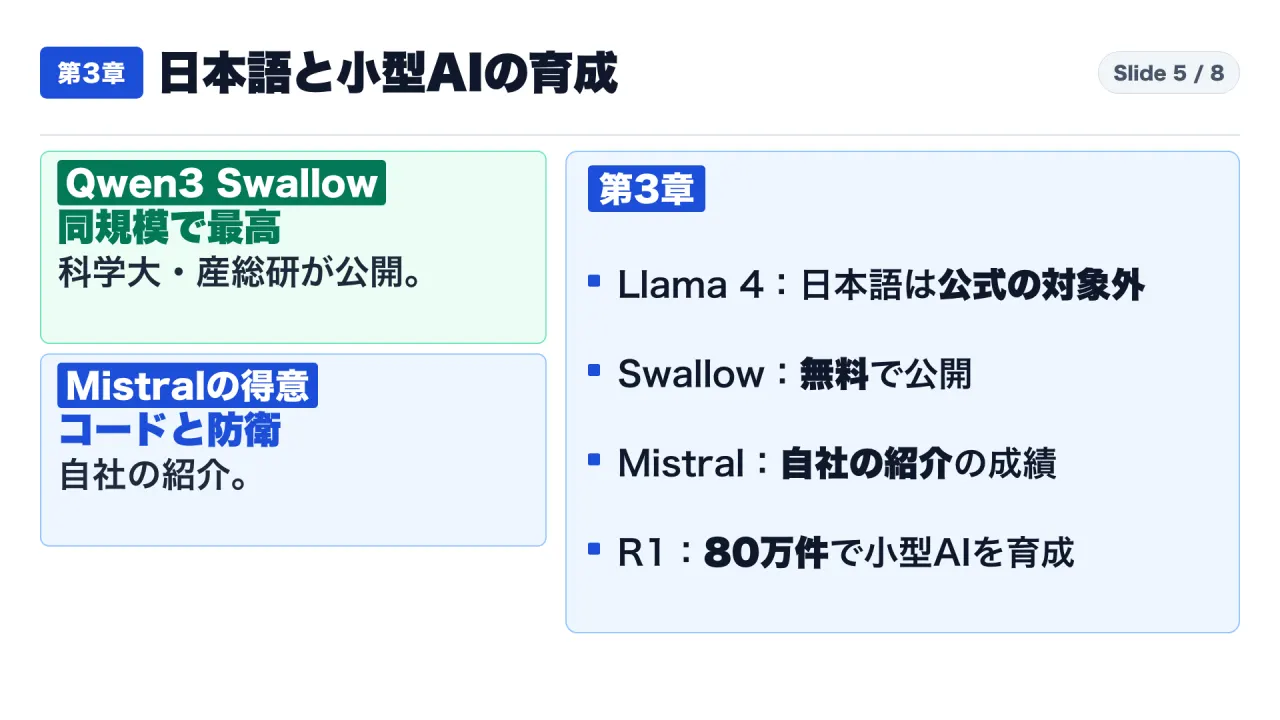
第4章①:日本の会社が選ぶときの3つの考え方(実務上の判断軸)
ここは、説明書に書かれた事実ではなく、導入する会社側の事情を整理したものです。
1. 国の安全や、データの置き場所を最優先にする場合
官公庁、防衛、金融、重要な設備を扱う会社では、会社の調達ルールにより、中国製のAIが候補から外れることがあります。その場合に残るのは、アメリカのLlama 4か、ヨーロッパのMistralです。ここは、会社側の基準の話で、AIの説明書に書かれた事実ではありません。
この2つを比べます。Llama 4には、7億人の上限や、EUでの制限があります(S5、S6)。Mistral Large 4は、ヨーロッパにある自社の計算施設で、ゼロから育てられました(S1)。他社に貸し出す事業でなければ、第1条の表示などの条件のもとで、社内で使うにも、機能に組み込むにも、別の契約は要りません(S2)。プログラム作りやサイバー防衛に使うなら、Mistralが有力な候補です。
2. 日本語の業務システムを、自社の機械で、手頃な費用で動かしたい場合
調達の制限がない会社なら、条件がゆるく、日本語に強くした版もある、Qwen 3の系列が使いやすい土台です(S8〜S10)。300億個前後の大きさなら、1兆個のAIより、機械の負担をずっと小さくできます。
3. 自社専用の小さなAIを育てる、手本役を探す場合
DeepSeek-R1は巨大ですが、MITで、答えを教材に使うことも、小さなAIを育てることも、認められています(S11、S12)。本番の機械には、軽い小さなAIを置き、手本役としてR1を使う組み合わせが考えられます。
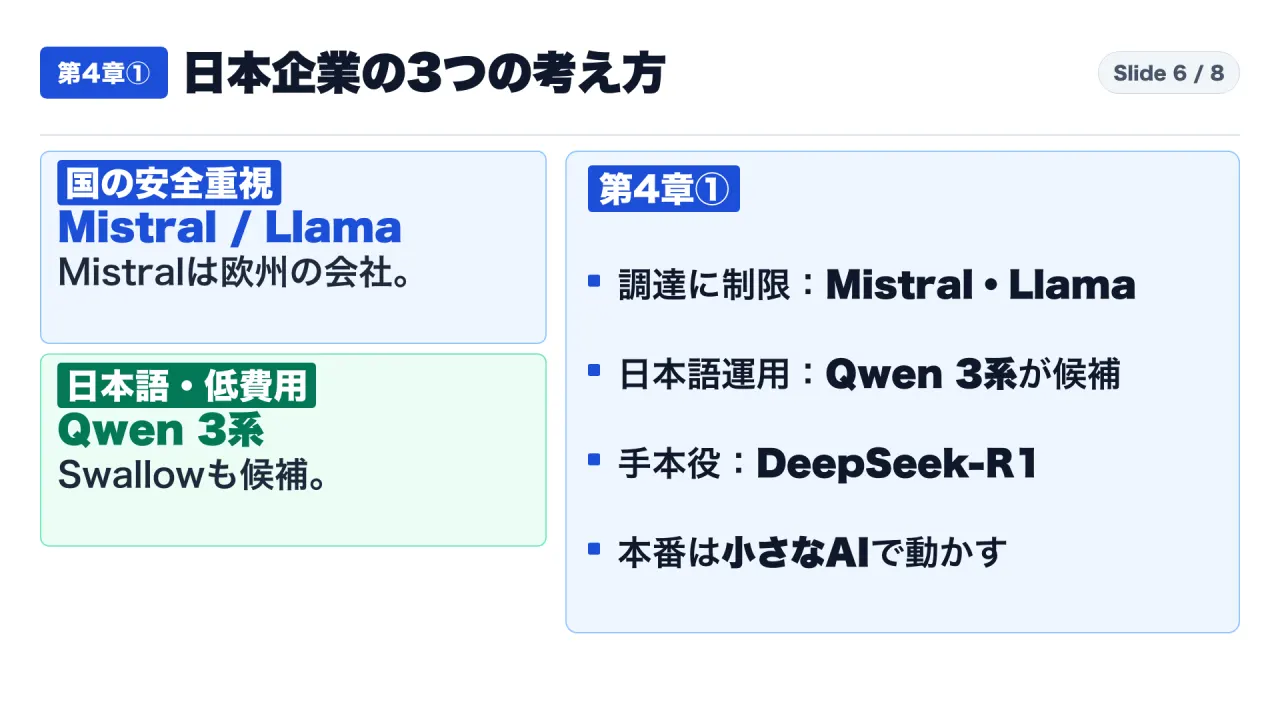
第4章②:【私なりの解釈】「公開」の一言で選ばない。ルールと机の広さで分けて使う
ここからは、事実ではなく、私なりの解釈です。断定ではありません。
解釈1:公開AIという言葉は、もう1つの意味ではない
使い方にほとんど制限をつけない中国の2社と、他社への切り売りや、巨大企業の利用に歯止めをかける米欧の2社に、ルールの役割が分かれていると、私は読みました。「公開」と書いてあるだけで、同じ使い方ができると思わないことです。
解釈2:大事なのは、働く部分ではなく、AI全体の大きさ
自社で機械を用意する人にとって、費用を決めるのは、AI全体の大きさです。1兆個の大きなAIを抱えるのか、300億個前後で足りるのか。最初に切り分ける必要があります。
解釈3:1つのAIに、すべてを任せなくてもよい
手本役には、大きくて条件のゆるいAI。本番の机には、中くらいで条件のゆるいAI、または条件の分かりやすいMistral。そう役割を分けるのが、現実的だと思います。
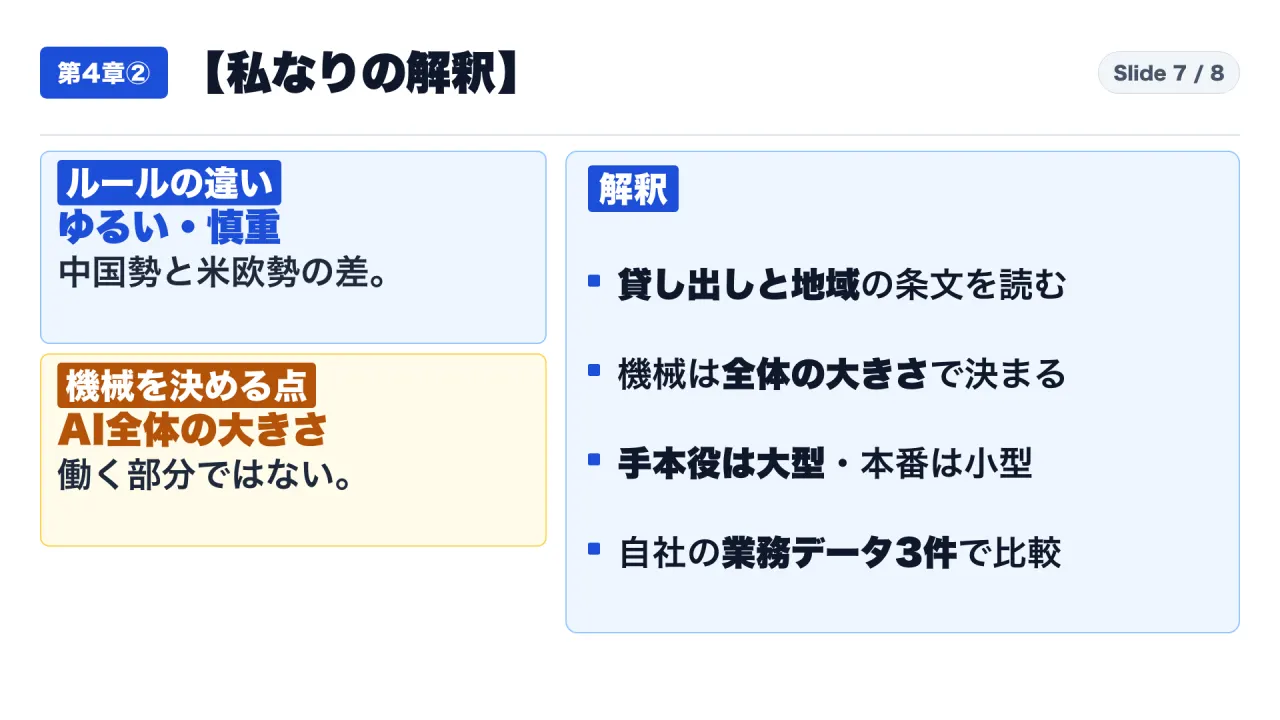
明日からできる3つの確認(私の提案)
- 自社の使い方を、紙に書き出します。 社内で使うだけか、機能の一部に組み込むのか、他の会社にAIの使い口を貸す事業なのか。そのうえで、ルールの条文(Mistralなら第2条、Metaなら第2条と利用規約)に当てはまらないかを確認します。迷うときは、画面やAPIの仕様を持って、契約の専門家に相談してください。
- 使いたいAIの、Hugging Faceというサイトのページを開きます。 働く部分の大きさではなく、ファイル全体の大きさを見て、必要なメモリを、機械の担当者と一緒に見積もります。
- 日本語の仕事なら、300億個前後のQwen 3やSwallowと、1兆個級のAIを、同じ業務データ3件で試します。 答えの質と、かかる費用を比べます。
よくある疑問(Q&A)
Q1. Mistral Large 4を、自社のWebサービスの裏側に組み込んで、お客様に提供する場合、別契約は必要ですか?
ルール全文(S2)の第2条は、別契約が必要な「Model as a Service」の定義から、「特定の機能の中にだけAIの能力が組み込まれた、利用者向けの製品」を除いています。また、第3条で、社内利用も対象外です。ただし、利用者が質問や設定を自由に入れられる、汎用の窓口に近い形で提供する場合は、MaaSに当たる可能性があります。具体的な画面やAPIの仕様をもとに、契約の専門家へ確認してください。
Q2. Llama 4のEUでの制限は、日本の会社がEU向けのサービスを作る場合にも影響しますか?
利用規約(S6)では、権利が与えられない対象は、「EUに住む個人、またはEUに主な事務所を置く会社」です。続けて、その画像と文章を扱うAIを組み込んだ製品やサービスの利用者には、この制限は当てはまらないと書かれています。日本に主な事務所を置く会社が開発するのか、EUの現地法人が開発するのかで、扱いが変わる可能性があります。EUの拠点が関わる場合は、法務部門で原文(S6)を確認してください。
Q3. DeepSeek-R1をそのまま本番の機械で動かすのが難しいときは、どう活用すればよいですか?
2つの方法があります。1つは、ディープシーク自身が、R1の80万件のデータで育てて公開している、小さな蒸留モデル(DeepSeek-R1-Distill-Qwen-32Bなど、S11)をそのまま使う方法です。もう1つは、R1のMITルールが、他のAIを育てる蒸留を認めている(S11、S12)ことを使い、自社の業務の模範解答をR1に作らせて、それを教材に、自社の小さなAIを育てる方法です。
動画での解説
この記事の内容は、YouTubeの動画でも詳しく解説しています。
{{YOUTUBE_URL}}
初めての方は、固定の自己紹介記事もあわせてご覧ください。
https://note.com/consuloji_ch/n/n1975ecc3cf48
出典(一次資料一覧・すべて2026年11月5日取得・照合)
- S1:Mistral Large 4 モデルカード(Hugging Face):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B/raw/main/README.md
- S2:Mistral Ecosystem Open-Weight License(ライセンス全文):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B/raw/main/LICENSE
- S3:Mistral Large 4 設定ファイル(
config.json):https://huggingface.co/mistralai/Mistral-Large-4-1T-A52B/raw/main/config.json - S4:Mistral Large 4 リポジトリ記録(Hugging FaceAPI):https://huggingface.co/api/models/mistralai/Mistral-Large-4-1T-A52B
- S5:Llama 4 Community License Agreement(ライセンス全文):https://raw.githubusercontent.com/meta-llama/llama-models/main/models/llama4/LICENSE
- S6:Llama 4 Acceptable Use Policy(利用規約):https://raw.githubusercontent.com/meta-llama/llama-models/main/models/llama4/USE_POLICY.md
- S7:Llama 4 Model Card(モデルカード):https://raw.githubusercontent.com/meta-llama/llama-models/main/models/llama4/MODEL_CARD.md
- S8:Qwen3-30B-A3B モデルカード(Hugging Face):https://huggingface.co/Qwen/Qwen3-30B-A3B/raw/main/README.md
- S9:Qwen3-32B モデルカード(Hugging Face):https://huggingface.co/Qwen/Qwen3-32B/raw/main/README.md
- S10:東京科学大学・産総研「Qwen3 Swallow」公式ページ:https://swallow-llm.github.io/qwen3-swallow.ja.html
- S11:DeepSeek-R1 モデルカード(Hugging Face):https://huggingface.co/deepseek-ai/DeepSeek-R1/raw/main/README.md
- S12:DeepSeek-R1 MIT License(ライセンス全文):https://huggingface.co/deepseek-ai/DeepSeek-R1/raw/main/LICENSE
- S13:DeepSeek-V3 モデルカード(Hugging Face):https://huggingface.co/deepseek-ai/DeepSeek-V3/raw/main/README.md
- S14:Mistral 公式ブログ「Mistral Large 4 (Le Chonk) is now open weight」:https://mistral.ai/news/mistral-large-4-oss/
- S15:Meta 公式ブログ「The Llama 4 herd: The beginning of a new era of natively multimodal AI innovation」:https://ai.meta.com/blog/llama-4-multimodal-intelligence/