なぜ0.57GBのPLaMo 3翻訳は社内利用でも事前登録が要るのか?
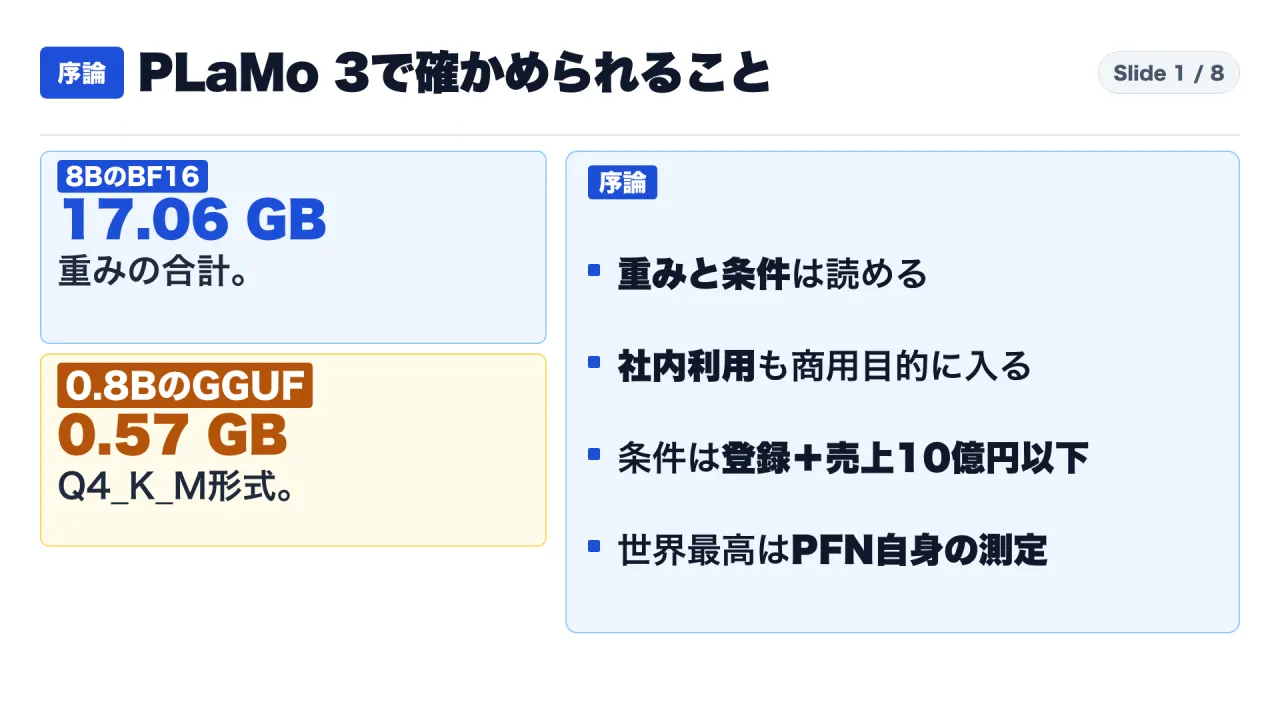
2026年11月5日、Preferred Networks(PFN)は翻訳特化の大規模言語モデル「PLaMo 3 Translate」のモデル重み(0.8B・2B・8B・31Bの4サイズ)をHugging Face上で公開しました。最小の0.8Bモデルを4ビット量子化(GGUF Q4_K_M形式)したファイルサイズはわずか0.57GBであり、プレスリリースや技術ブログでは「機内モードのスマートフォン単体で翻訳が動作するデモ」や「2Bサイズでも既存の翻訳特化モデルを全指標で上回る」といった特徴が紹介されています。
しかし、企業の情報システム部門や業務改善の担当者が「無料で重みが公開されたから、自社のPCや社内サーバーに入れて業務文書の翻訳に使おう」と判断する前に、必ず原典の条文と測定条件を確認しなければならない3つの実務上の論点があります。
- 自社のサーバーや端末で動かせるのか?(モデル構成・合成データの出自・量子化による精度低下)
- 会社の業務で無償利用できるのか?(ライセンス条文における「社内利用=商用目的」の定義と、事前登録・売上10億円以下の2条件)
- 「世界最高」「2Bでも全指標で上」という評価をそのまま信じてよいのか?(PFN自身の測定範囲、比較対象2系統の限定、評価指標の不一致)
この記事では、2026年11月5日に公開された「PLaMo 3 Translate」のモデルカード、PLaMoコミュニティライセンス全文、Hugging Faceリポジトリ記録(APIメタデータ・設定ファイル)、PFNのプレスリリースと技術ブログ2本、および比較対象として挙げられているGoogle「TranslateGemma」とTencent「Hy-MT2」の公式技術報告(計15件の一次資料)を原典まで遡り、資料で確認できる確定事実、資料に記載がない未確認事項、そして実務で導入判断を行うための手順を体系的に解説します。なお、この記事では技術仕様とライセンス条文の読み解きのみを扱い、特定企業の評価や株式等の売買判断は一切扱いません。
1. 結論と全体像:一次資料の照合から導かれる3つの要点
最初に、15件の一次資料を突き合わせて確認できた結論を3点に整理します。
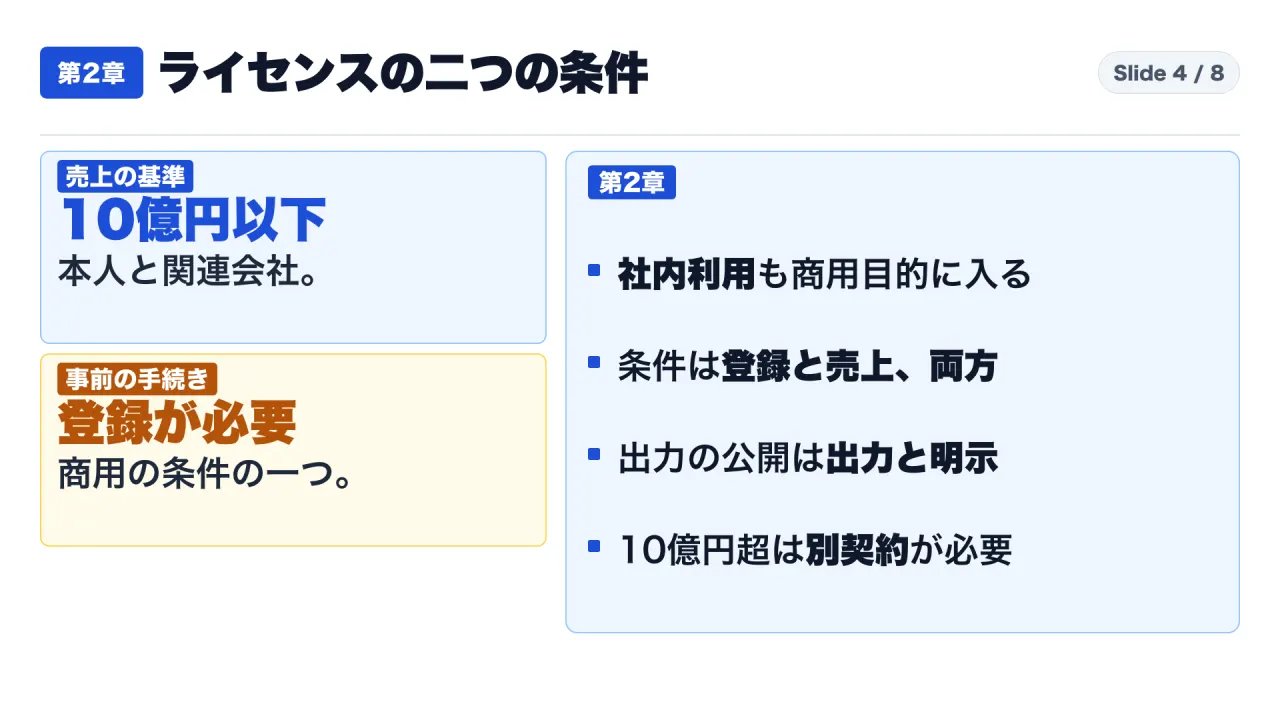
- モデル重みと利用条件は全文が公開されているが、「社内業務での利用」も商用目的に含まれ、無償利用には「事前登録」と「年間売上10億円以下」の2条件を両方満たす必要がある: PLaMoコミュニティライセンス(LICENSE/en)は、「商用目的(Commercial Purposes)」を「個人または学術利用を超えるすべての利用」と定義し、「利用者の組織の枠組み内での利用(社内利用)」を明示的に含めています。その上で、無償で商用利用できる条件として、①PFN公式登録ページでの事前登録、②利用者本人または関連会社の年間売上が10億円を超えないこと、の2つを同時に満たすことを求めています。年間売上が10億円を超える企業(関連会社を含む)が社内で試用・運用する場合は、無償利用の対象外となり別途商用ライセンス契約が必要です。
- 最小0.57GB(0.8B Q4_K_M)から63.51GB(31B BF16)まで多様な実行形式が揃うが、量子化による精度低下はモデルが小さいほど大きく、学習データの訳文の大半は「Gemma 4 31B IT」による合成データである: 公開された4サイズ(0.8B・2B・8B・31B)には、非圧縮のBF16に加えてFP8、NVFP4、GGUF(Q4_K_M / Q2_K等)、MLX 4bitが用意されており、GPUサーバーからCPU、Apple Siliconまで幅広く対応しています。ただしPFN自身の測定表を見ると、8BモデルをQ4_K_Mに圧縮した際のPFTBスコア低下は0.0019にとどまる一方、0.8BモデルをQ2_Kに圧縮すると英他言語のchrF++が54.44から51.15へと3.29ポイント低下します。また技術ブログには、約373億トークン(37.3Bトークン)の翻訳学習データの大半が、Web等から収集した原文に対して「Gemma 4 31B IT」で訳文を合成して作られたものであると明記されています。
- 「2Bでも全指標で上」「世界最高」という数値はPFN自身の測定であり、比較相手は図に載る2系統(TranslateGemma・Hy-MT2)に限られ、他社の公式発表値とは指標・言語範囲・目盛りが揃っていない: 今回の重み公開資料(モデルカード・プレスリリース・11月5日付技術ブログ)の比較図に含まれている他社モデルは、Googleの「TranslateGemma(4B / 12B / 27B)」とTencentの「Hy-MT2(1.8B / 7B / 30B-A3B)」の2系統のみであり、DeepLや商用APIとの直接比較は今回の4資料には載っていません(10月7日付の製品リリース記事には公開前の31BモデルとDeepLをGemini 3.1 Proに判定させた勝率が記載されています)。さらに、主要な評価軸である「PFTB」と「SAAS」はPFNが社内で作成したベンチマークであり、各社の公式論文が報告しているWMT24++やXCOMETの数値とは対象言語数もスコアの目盛りも異なるため、横並びの順位表を作ることはできません。
flowchart TD
    A["PLaMo 3 Translate 重み公開(0.8B / 2B / 8B / 31B)"] --> B["確認1:ライセンス条文(PLaMo Community License)"]
    B --> C{"用途は個人・学術のみか?"}
    C -- "はい(非商用)" --> D["事前登録不要・売上制限なしで無償利用可"]
    C -- "いいえ(社内業務での利用・製品組込を含む)" --> E{"本人または関連会社の年間売上は10億円以下か?"}
    E -- "10億円以下" --> F["PFN公式フォームへ事前登録した時点から無償商用利用可"]
    E -- "10億円超" --> G["無償利用不可:PFN窓口へ問い合わせて別契約が必要"]
    F --> H["確認2:出力の公開(モデル出力の明示義務)と別モデル学習(派生モデル条件の継承)"]
    G --> H
    H --> I["確認3:自社ハードウェア(0.57GB〜63.51GB)と自社文書10件での実測比較"]
2. 第1章:公開された4サイズの重みと、合成データ中心の学習構造
まず、2026年11月5日にHugging Face上で公開されたモデルの中身と技術仕様を、モデルカード(README.md)、APIリポジトリ記録、設定ファイル(config.json)、および技術ブログから確認します。
4つのモデルサイズと実パラメータ数
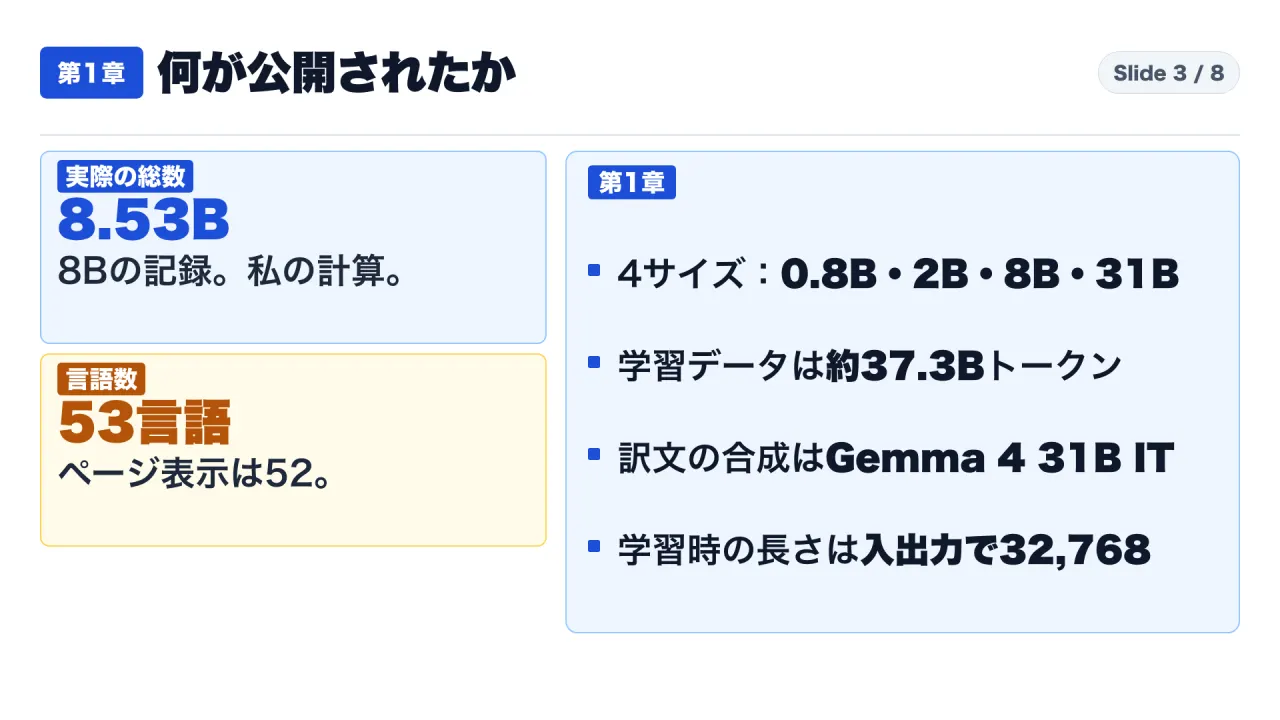
公開されたモデルは、情報通信研究機構(NICT)とPFNの共同研究によるベースモデル「PLaMo 3 NICT」を土台とし、翻訳タスクに特化させた4つのサイズです。モデル名に付いているサイズ表記と、Hugging FaceのAPI記録(safetensorsメタデータ)に記録されている実際の総パラメータ数を整理すると以下のようになります(十億単位への換算は実パラメータ数を10億で割った計算値です)。
- PLaMo 3 Translate 0.8B: 実パラメータ数 890,468,928(約0.89B)
- PLaMo 3 Translate 2B: 実パラメータ数 2,882,043,904(約2.88B)
- PLaMo 3 Translate 8B: 実パラメータ数 8,531,750,912(約8.53B)
- PLaMo 3 Translate 31B: 実パラメータ数 31,758,645,248(約31.76B)
対応言語数と3つの翻訳制御機能
- 対応言語数(53言語 / 表記上52言語): モデルカードの本文では、中国語の簡体字(Simplified Chinese)と繁体字(Traditional Chinese)を別々に数えて53言語と記載されています(Hugging Faceリポジトリ上部のメタデータタグ表示では、中国語が1つにまとめられて52言語と表示されています)。
- 実務で使える3つの制御機能:
単なる一文ずつの機械翻訳ではなく、以下の3つの指定に対応しています。
- 前後の文脈(コンテキスト)の付与: 翻訳対象の前後の文章を渡して文脈に沿った訳文を生成させる機能。
- 用語集(Glossary)による訳語固定: 社内の固有名詞や専門用語の対訳ペアを指定し、訳語を統一する機能。
- 日本語訳の文体(敬体・常体)の指定: 日本語へ翻訳する際、「です・ます調」か「だ・である調」かを選択する機能。
- コンテキスト長(32,768トークン vs 設定ファイルの262,144):
モデルカードには、学習時の最大コンテキスト長は入力と出力を合わせて32,768トークンであり、長文を翻訳する際はこの長さに収まるよう分割して入力するよう案内されています。一方、8Bモデルの設定ファイル(
config.json)にはmax_position_embeddings: 262144という数値が記録されていますが、モデルカード側にはこの262,144という数値の意味や長文外挿の保証に関する説明は書かれていないため、実務上の安全な上限目安としてはモデルカード記載の32,768トークンを採用する必要があります。
学習データの規模(約373億トークン)と「Gemma 4 31B IT」による合成
技術ブログ(Weight Release記事)によると、翻訳特化の追加学習(モデルカードでは「数百億トークン規模」と表記)に用いられた翻訳データの総量は表の合計で**37.3Bトークン(日本の単位に換算すると約373億トークン)**です。
ここで注目すべき確定事実は、学習データの訳文の大半が別の大規模言語モデルによって合成されたものであるという点です。技術ブログには、Web等から収集した原文に対し、Googleのオープンモデル「Gemma 4 31B IT」を用いて訳文を合成(Synthetic Data Generation)して学習データの大半を作成したと明記されています。また、今回の発表で公開されたのは学習済みのモデル重みファイルであり、学習データセットそのものの公開については確認した資料に記載がありません。
3. 第2章:ライセンス全文の精査──なぜ「社内利用」でも事前登録と売上確認が要るのか
モデル重みがHugging Faceで公開されていると、エンジニアや現場担当者はつい「Apache 2.0やMITライセンスのように、ダウンロードして社内で自由に動かしてよい」と誤解しがちです。しかし、PLaMo 3 Translateに適用されているのは独自ライセンス「PLaMo Community License」(Hugging Faceのライセンス欄は other)であり、条文全文(LICENSE/en)を読むと明確な境界線が定められています。
非商用利用と「商用目的(社内利用を含む)」の厳格な区分
- 非商用利用(Non-commercial purposes): 個人の学習、趣味、および学術研究を含む非商用目的での利用は、無償であり、事前登録も不要、売上による制限もありません。
- 商用目的(Commercial Purposes)の定義: ライセンス条文は、「商用目的」を「個人または学術の利用を超えるすべての利用(any use beyond personal or academic use)」と広く定義し、自社の製品・サービスの開発や提供だけでなく、「利用者の組織の枠組みの中での利用(use within the framework of the user’s organization)」も含むと明記しています。つまり、社外へ販売するサービスに組み込まなくても、社内の業務文書の翻訳や社内ツールとして利用する行為そのものが「商用目的」に該当します。
- 無償で商用利用できる2つの必須条件(AND条件):
条文では、以下の2つの条件を両方とも満たす場合(only if both conditions are met)に限り、無償で商用利用が許諾されると定めています。
- 条件① 事前登録: PFNの公式登録ページ(登録フォーム)から事前に登録を行うこと(モデルカードによれば、フォームを送信した時点から無償での商用利用が可能になります)。
- 条件② 年間売上基準: 利用者本人またはその関連会社(affiliates)の年間売上高が10億円(1 billion Japanese yen)を超えないこと。
「10億円未満」と「10億円以下」の表記揺れと別契約の境界
売上基準の表記については、一次資料間でわずかな表現の違いと訂正履歴があります。
- プレスリリース: 当初「売上10億円未満」と「10億円以下」の両方の表現が混在しており、2026年11月5日11時45分に訂正注記が追加されました。
- ライセンス条文(法的正本): 「does not exceed 1 billion Japanese yen(10億円を超えないこと=10億円以下)」と規定されています。また、モデルカードと技術ブログでは「直近の会計年度の売上」と説明されていますが、ライセンス条文の該当項自体には会計期間の限定表現は書かれていません。
- 条件を満たさなくなった場合・売上10億円超の場合: 年間売上が10億円を超える企業(親会社や子会社等の関連会社を含む)や、成長によって売上基準を超えた組織は、このコミュニティライセンスの下で商用利用(社内利用を含む)を行うことはできません。利用を継続または開始するには、PFNの問い合わせ窓口から別途商用ライセンス契約を締結する必要があります(なお、別契約の具体的な料金体系は今回の公開資料には記載されていません)。
第三者提供・出力の公開・別モデル学習時の引き継ぎ義務
社内利用から一歩進んで、翻訳結果(出力)を社外へ公開したり、別のAIモデルの学習に使ったりする場合には、条文上の以下の規定が適用されます。
- モデルや出力を第三者へ提供する際の3つの義務: ①本ライセンス契約書の写しを渡すこと、②「Built with PLaMo」と表示すること、③作成したAIモデルの名称の先頭または目立つ位置に「PLaMo」を含めること。
- 出力(翻訳結果)を公開・配布する際の明示義務: 翻訳結果などの出力を公開して配布する場合は、それが**PLaMo 3 Translateの出力であることを明瞭に示す(clearly indicate)**必要があります。
- 出力を別モデルの学習データに使う場合の条件継承: PLaMo 3 Translateの出力を使って別のAIモデルを学習・ファインチューニング等させた場合、その新しいモデルは「派生モデル(Derivative Model)」とみなされ、同じライセンス条件が引き継がれます。
- 免責・利用禁止用途・損害賠償上限: モデルの出力を、法律上の判断、医療診断、財務上の判断、または個人の重要な評価における唯一の根拠(sole basis)にしてはならないと定められています。また、業務利用においてPFNは一切の保証・責任を負わず、故意または重過失を除きPFNの損害賠償責任の上限は500円と規定されています(条文はPFNが通知の上で変更可能とされています)。
- 競合モデルとのライセンス比較: 比較対象であるTencentの「Hy-MT2-7B」はモデルカード上Apache 2.0ライセンスで公開されています。一方、Googleの「translategemma-27b-it」はGemma利用規約(Gemma Terms of Use)が適用され、Hugging Faceリポジトリでの取得時に利用条件への同意・承認が必要なゲート付き設定になっています。
4. 第3章:動かす大きさ(0.57GB〜63.51GB)と量子化による精度変化
次に、自社のどのハードウェアでどのサイズのモデルが動くのか、そしてファイルを小さく圧縮(量子化)したときに翻訳精度がどう変化するのかを、モデルカードの表から確認します。
モデルサイズ・形式別の合計ファイルサイズと対象ハードウェア
モデルカードには、4つのモデルサイズごとに複数の重み形式と合計ファイルサイズ(GB)、および推奨される実行環境(推論エンジン)が記載されています。
- BF16(非圧縮・標準精度):
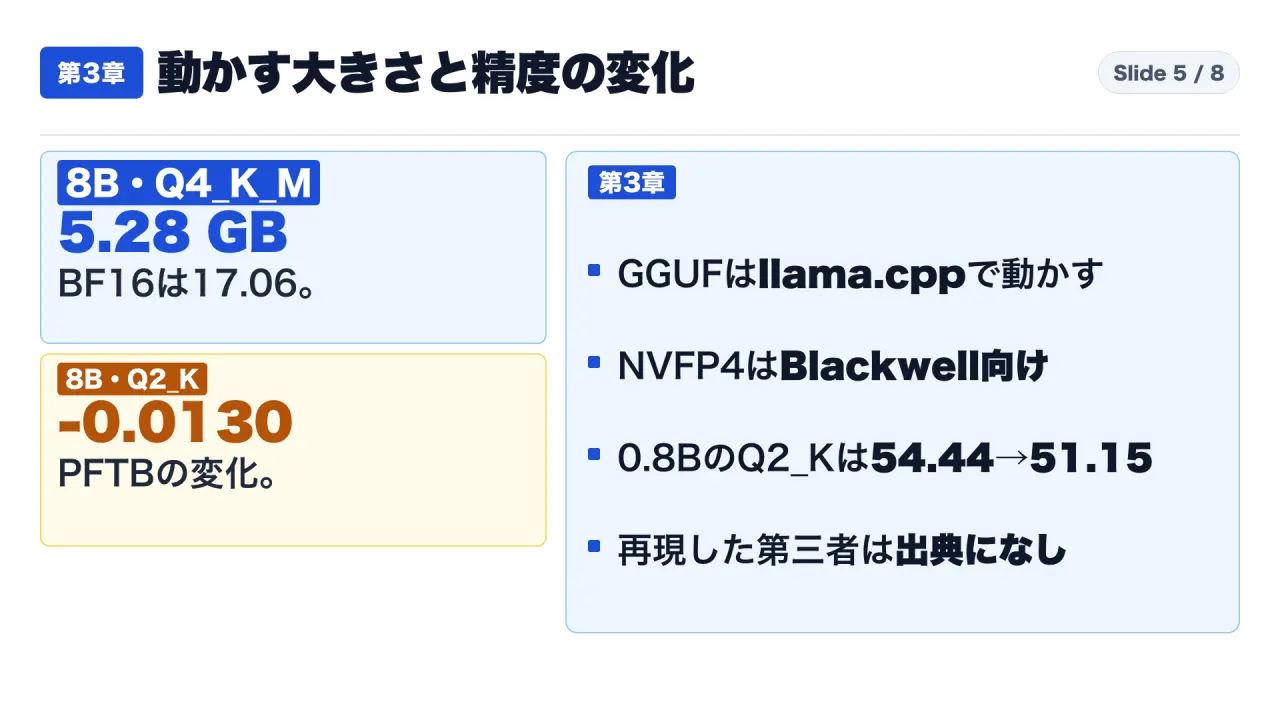
0.8B: 1.78 GB /2B: 5.76 GB /8B: 17.06 GB /31B: 63.51 GB
- GGUF(Q4_K_M:4ビット系量子化 / CPU・各種GPUで
llama.cppを使用):0.8B: 0.57 GB /2B: 1.81 GB /8B: 5.28 GB(BF16比で約31%) /31B: 19.53 GB
- その他の高速推論・専用ハードウェア向け形式:
- FP8: NVIDIAのAda Lovelace、Hopper、Blackwell世代GPU向け(
vLLMを使用)。 - NVFP4: NVIDIA Blackwell世代GPU向け。
- MLX(4bit): Apple Silicon(Mシリーズ搭載Mac等)向け。
- FP8: NVIDIAのAda Lovelace、Hopper、Blackwell世代GPU向け(
量子化(圧縮)による翻訳精度の低下幅:小さいモデルほど劣化が大きい
ファイルを小さくすれば手元のノートPCやCPUでも動かしやすくなりますが、どこまで精度が保たれるのでしょうか。PFNがモデルカードで公開している量子化別の精度測定値を見ると、明確な傾向が読み取れます。
- 8Bモデルの場合(劣化は軽微): PFN社内ベンチマーク「PFTB」のスコアは、非圧縮のBF16が 0.6119 であるのに対し、4ビット系のGGUF(Q4_K_M)では 0.6100(差はわずか -0.0019)とほぼ同等の水準を維持しています。ただし、極端に圧縮した2ビット系のGGUF(Q2_K)では 0.5989(BF16比で -0.0130 の低下)となります。
- 0.8Bモデルの場合(極端な圧縮で大きく劣化): 元のパラメータ数が小さい0.8Bモデルを2ビット系のQ2_Kに圧縮すると、英語と他言語間の翻訳指標(chrF++)がBF16の 54.44 から 51.15 へと 3.29ポイント低下します。
- スマートフォン機内モードデモとオンプレミス運用の注意点: プレスリリースには「機内モードにしたスマートフォン上で0.8Bモデルが翻訳を行うデモ動画」が掲載されていますが、技術ブログには「これは社内の内部デモであり、現時点でこのようなスマートフォンアプリは一般公開していない」と明記されています。また、自社のサーバーや端末内でモデルを動かせば原文や訳文が外部クラウドへ送信されないという機密保持上の利点がありますが、これらはすべてPFN自身の測定・説明であり、出力品質そのものはライセンス上「無保証(AS IS)」で提供されています。
5. 第4章:「世界最高」「2Bでも全指標で上」の測定条件を分解する
プレスリリースやモデルカードの見出しにある「世界最高クラスの翻訳性能」「2Bモデルでも既存の翻訳特化LLMを全指標で上回る」という主張は、どこまで客観的に検証できるのでしょうか。一次資料の記述とグラフの注記を照合します。
PFNの3つの資料における表現範囲の違い
- モデルカード(README.md): 「2Bモデルでも、比較した翻訳特化LLMを図のすべての指標で上回る」と記載。
- 技術ブログ(11月5日付 Weight Release): 「0.8Bモデルが日英および日本語・他言語間で既存モデルを上回り、英語・他言語間では2Bモデルから上回る」と記載。
- プレスリリース(11月5日付): 「最小の0.8Bでも比較した翻訳特化モデルを上回る」と記載(英語・他言語間では2Bから上回るという範囲の区別が省略されています)。
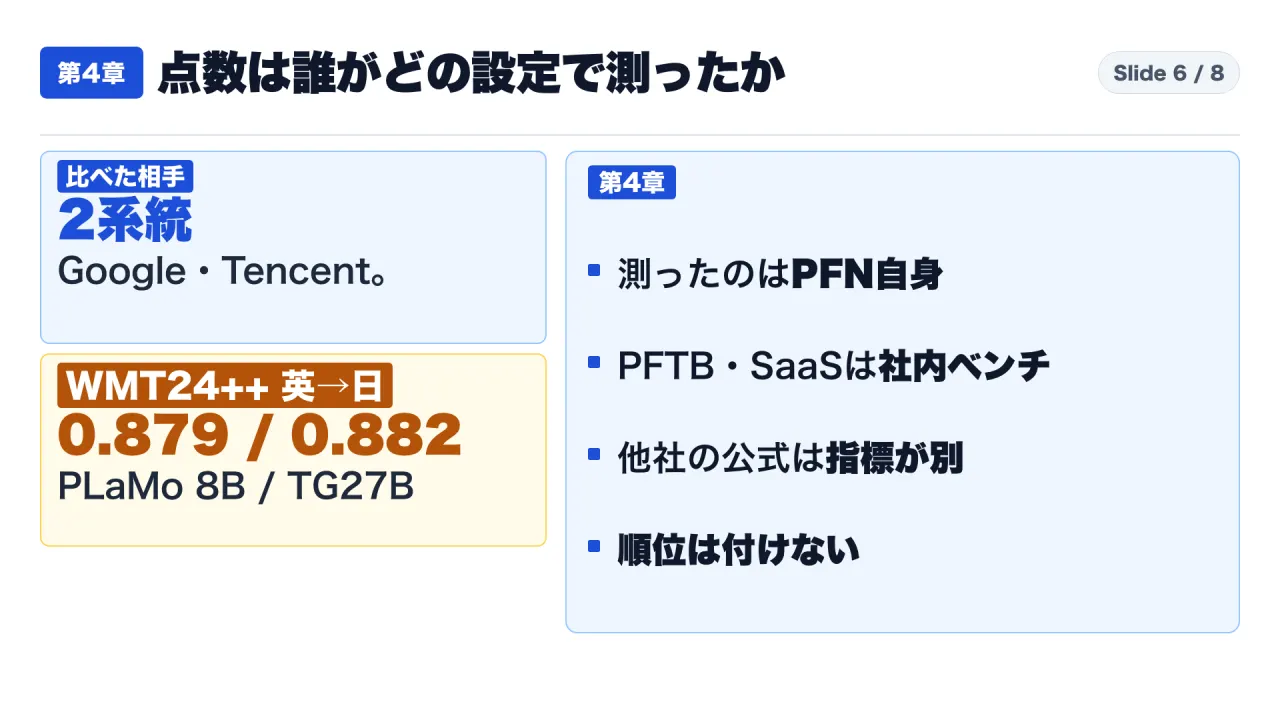
比較相手は2系統のみ、主要ベンチマーク(PFTB・SAAS)はPFN社内作成
技術ブログの比較図に含まれている他社モデルは、以下の2系統のみです。
- Google「TranslateGemma」: 4B / 12B / 27B
- Tencent「Hy-MT2」: 1.8B / 7B / 30B-A3B
今回の重み公開に関する4資料(モデルカード・ライセンス・プレスリリース・11月5日付ブログ)の比較図には、DeepLやOpenAI・Anthropic・Google等の商用APIとの比較は含まれていません。
さらに、評価に使われたベンチマークの内訳を見ると、なぜPFNの図で大きな差がついているのかが分かります。
- PFTBおよびSAAS(PFN社内作成ベンチマーク): 技術ブログによると、PFTBとSAASはいずれもPFNが社内で独自に構築したベンチマークであり、PFTBの参照訳(正解データ)は複数の強力なモデルによって合成されたものです。PFNは「公開ベンチマークのWMT24++は短文が中心で参照訳の品質に懸念があるため、開発では主に社内ベンチマークのPFTBとSAASに依拠した」と説明しています。
- 公開ベンチマーク「WMT24++」では差が極めて小さい(10月7日付ブログの数値): PFN自身が2026年10月7日の製品リリース記事で述べている通り、公開ベンチマークのWMT24++では性能が飽和しており、同記事の表では公開前のPLaMo 8B版が 0.879、GoogleのTranslateGemma 27Bが 0.882 と、むしろTranslateGemma 27Bの方がわずかに高い数値を示しています(一方、社内ベンチマークのSAASではPLaMo 0.571 vs TranslateGemma 0.395、PFTB英日では0.547 vs 0.438と大差がついています)。これらはいずれもPFN自身の測定による数値です。
他社公式論文との測定条件不一致と、10月7日記事の「DeepL比較」の正体
では、GoogleやTencentが自社の公式論文で発表している数値とPFNの数値を直接比較できるかというと、測定条件がまったく揃っていません。
- Google『TranslateGemma Technical Report』(arXiv:2601.09012): WMT24++の55言語ペアの平均を「COMET-22(0〜100スケール)」で報告しており、27Bが 84.4、12Bが 83.5、4Bが 80.1 です。一方、PFNのモデルカードは同じWMT24++でも「英語→日本語の1ペアのみ」を「0〜1スケール(2Bで0.8780)」で報告しているため、対象言語も目盛りも異なり横並び比較はできません。
- Tencent『Hy-MT2 Technical Report』(arXiv:2605.22064): 33言語を対象に「XCOMET」等の指標で評価しており、PFNが英語・他言語間で使っている「chrF++」とは指標自体が異なります。
- 10月7日付ブログにおける「DeepL比較」の条件: 今回の重み公開資料にはDeepLとの比較はありませんが、約1ヶ月前の2026年10月7日付ブログには、公開前の31B開発版モデルとDeepL翻訳の出力を「Gemini 3.1 Pro」に比較判定(LLM-as-a-Judge)させた勝率が載っています(PFTB英日で勝率87.00%、PFTB日英で58.00%、SAASで73.82%、WMT24++で59.17%)。ただし、①判定役が人間ではなくLLM(Gemini 3.1 Pro)であること、②10月7日時点の開発中モデルであり11月5日に公開された重みと同一バージョンか明記されていないこと、の2点に留意する必要があります。
6. 実務での解釈と導入前チェックリスト:売上基準と自社文書10件で決める
ここまでの一次資料の確定事実を踏まえ、企業の担当者が実務でどう判断し、明日からどの手順で検証すべきかを整理します。
実務判断の3つの原則
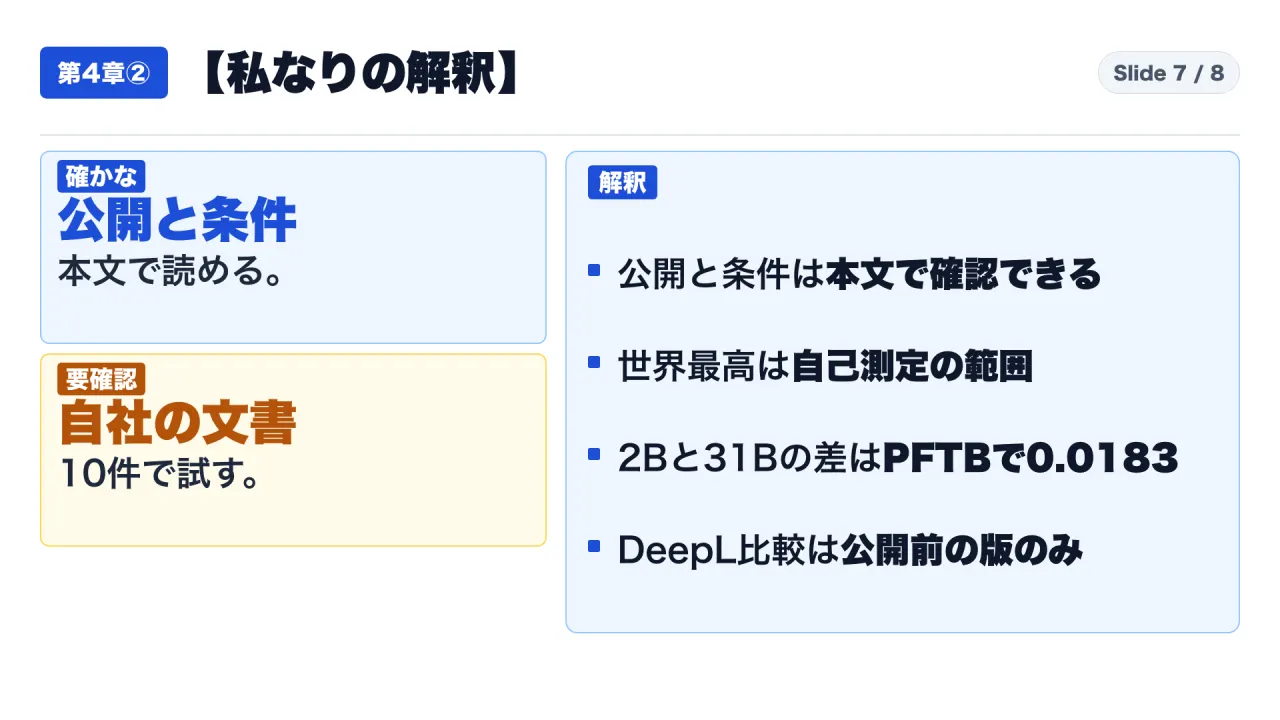
- 「オープンウェイト=無条件で社内利用できる」という思い込みを捨て、最初に関連会社を含む売上高を確認する: 重みファイルが誰でもダウンロードできる状態であっても、社内業務で使う行為はPLaMoコミュニティライセンス上の「商用目的」にあたります。自社単体だけでなく、親会社・子会社等の関連会社(affiliates)を含めた年間売上が10億円以下であるかを法務・経理部門に確認し、10億円以下であればPFN公式フォームから事前登録を済ませることが第一歩です(10億円超の場合は無断で社内試用せず、PFN窓口へ別契約の問い合わせが必要です)。
- 「2B(0.6061)と31B(0.6244)のスコア差0.0183」に着目し、まずは軽量な2B・8Bモデルを自社文書で試す: PFN自身の測定表(PFTB)において、2Bモデル(0.6061)と最大31Bモデル(0.6244)のスコア差はわずか 0.0183 です。63.51GBの31Bモデルを動かすために高価なGPUサーバーを用意する前に、まずは1.81GB(2B Q4_K_M)や5.28GB(8B Q4_K_M)のモデルを手元の環境で動かし、自社の実際の業務文書で十分な品質が出るかを確かめる方が圧倒的に経済合理的です。
- 社外公開や他モデル学習への転用有無をあらかじめ業務フロー上で分離する: 社内会議資料の翻訳と、Webサイト等で社外へ公開する翻訳、あるいは社内特化LLMの学習データを作るための翻訳では、ライセンス上の義務(モデル出力の明示義務、派生モデルとしてのライセンス継承)が異なります。用途を混ぜずにルール化しておくことが重要です。
導入前に確認する3ステップ・チェックリスト
社内でPLaMo 3 Translateの検証・導入を進める際は、以下の3つのステップを順番に実行してください。
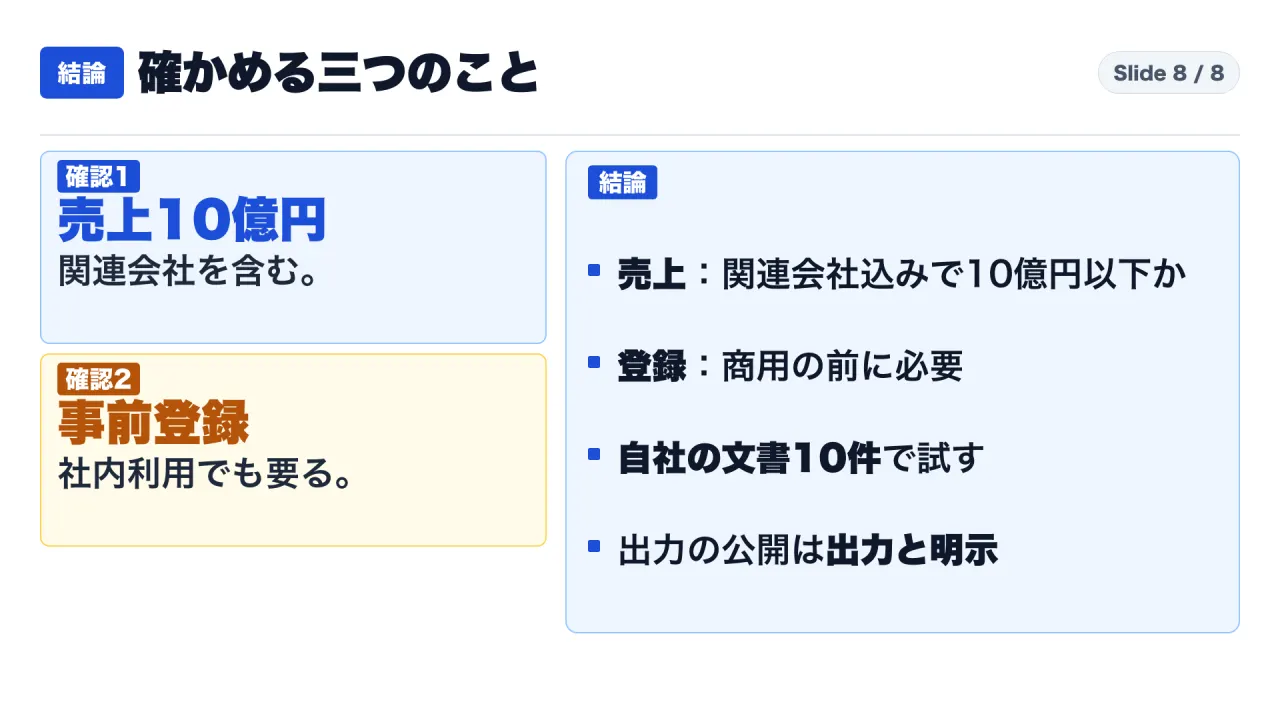
- ステップ1:売上基準(10億円以下)の確認と事前登録の完了: 自社および関連会社の年間売上高が10億円以下であるかを確認し、該当する場合はPFN公式登録ページから事前登録を完了させる(10億円を超える場合は商用ライセンス窓口へ問い合わせる)。※契約条文の最終解釈は法務専門家へ確認してください。
- ステップ2:自社の実務文書10件を用いたブラインド比較テスト: ベンダー公表のベンチマーク数値ではなく、自社で実際に翻訳したい契約書、技術仕様書、メール等の文書を10件選び、現在利用している翻訳ツール(DeepLや商用LLM API等)と、PLaMo 3 Translateの2B・8Bモデル(用語集指定あり・なし)で同じ設定で翻訳し、現場の担当者が品質を比較する。
- ステップ3:翻訳出力の利用範囲(社内完結・社外公開・学習利用)の区分け: 翻訳結果を社外へ公開する場合は「PLaMo 3 Translateによる出力である旨」の表示ルールを定め、別のAIモデルの学習データには流用しない(または派生モデル条件の継承を許容する)運用規程を明文化する。
このnoteでは、国内外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
参考・一次資料リンク一覧
- Preferred Networks『PLaMo 3 Translate 8B Model Card (Hugging Face)』: https://huggingface.co/pfnet/plamo-3-translate-8b/raw/main/README.md
- Preferred Networks『PLaMo Community License (LICENSE/en)』: https://huggingface.co/pfnet/plamo-3-translate-8b/raw/main/LICENSE/en
- Preferred Networks『プレスリリース:翻訳特化型大規模言語モデルPLaMo 3 Translateの重みを公開(2026年11月5日)』: https://www.preferred.jp/en/news/pr20261105/
- Preferred Networks Tech Blog『PLaMo 3 Translate Weight Release(2026年11月5日)』: https://www.preferred.jp/en/blog/tech/plamo-3-translate-weight-release/
- Preferred Networks Tech Blog『PLaMo 3 Translate Product Release(2026年10月7日)』: https://www.preferred.jp/ja/blog/tech/plamo-3-translate-product-release/
- Google『TranslateGemma Technical Report (arXiv:2601.09012)』: https://arxiv.org/abs/2601.09012
- Tencent『Hy-MT2 Technical Report (arXiv:2605.22064)』: https://arxiv.org/html/2605.22064
動画での解説
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48