なぜDeepLに勝率58〜87%の翻訳AIでも、そのまま乗り換えと言えないのか?
1. 導入:この記事で整理する3つの論点
業務で英語や多言語のメール、技術仕様書、契約書のドラフトを翻訳している現場では、「専用サービスのDeepLから、社内のサーバーや手元のPCで動かせるオープンウェイトの翻訳モデルへ切り替えられないか」という検討が繰り返されています。その候補として注目を集めているのが、日本のPreferred Networks(以下、PFN)が重みを公開した翻訳特化モデル「PLaMo 3 Translate」です。SNSや技術コミュニティでは「DeepLに勝った」「さよならDeepL」といった見出しも見かけますが、一次資料を突き合わせると、すぐに全面移行を決断する前に確認すべき境界線が浮かび上がります。
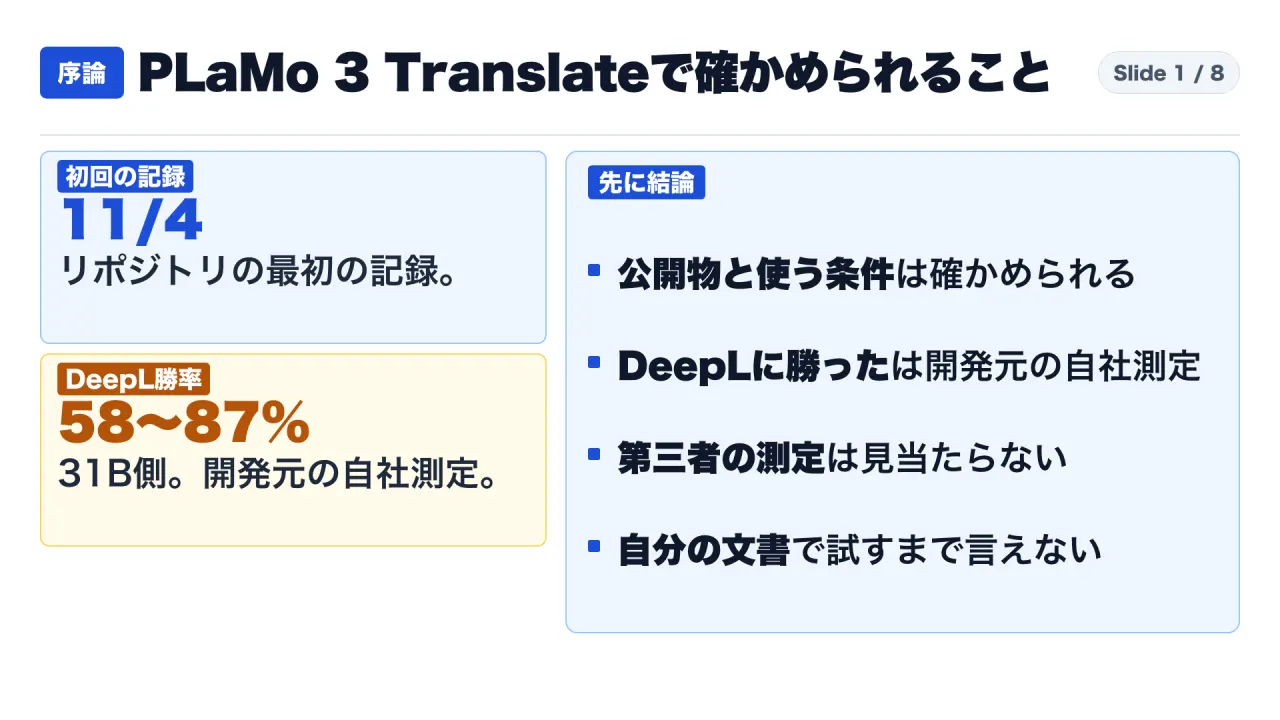
結論から整理すると、PLaMo 3 Translateは公開されている重みの構成(4サイズ・7形式)もライセンス条文も明確に読み取れる一方で、自社の実務でDeepLの代替になるかは、自社の実際の文書で検証するまで判断できません。なぜなら、根拠として引用される「DeepLに対する勝率58〜87%」という数値は、開発元であるPFN自身が自社のベンチマークと特定のAI審判(Gemini 3.1 Pro)を用いて測定した結果であり、DeepL側のプラン設定や用語集の有無、比較文数が記載されていないためです。さらに、社内業務で試すだけでもライセンス上は「商用利用」に分類され、年間売上高10億円の基準と事前登録の義務が課されます。
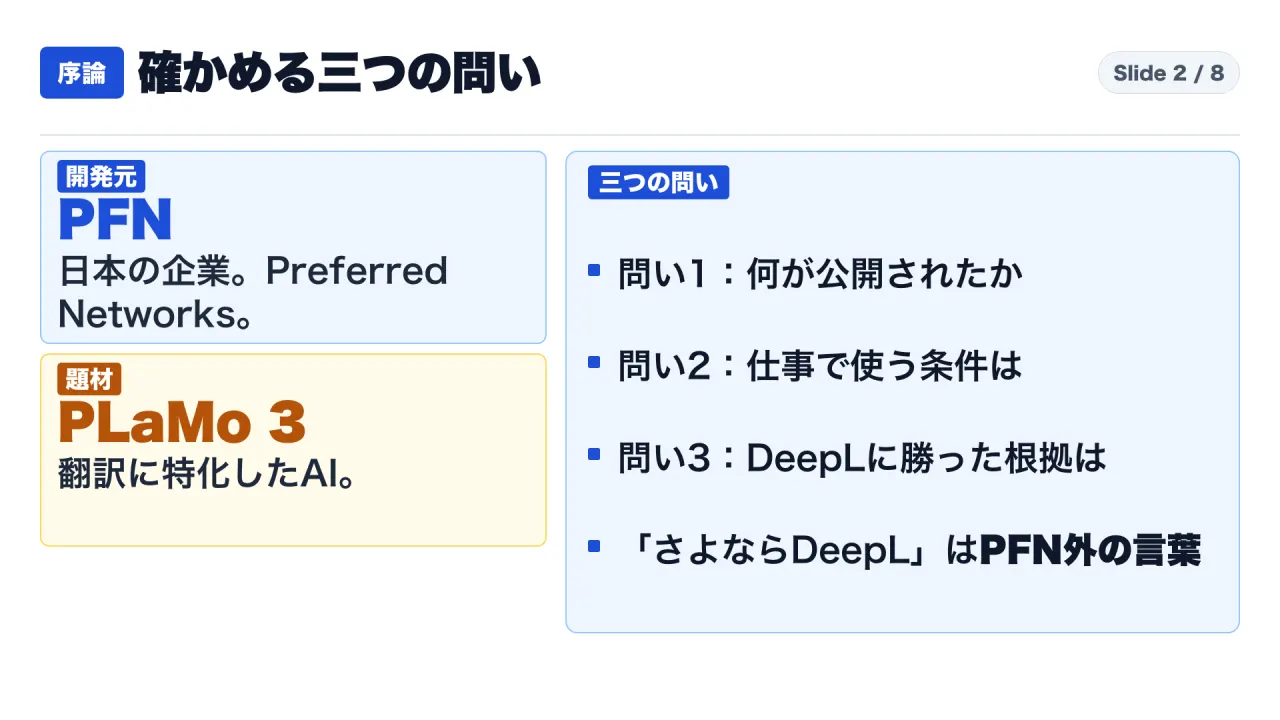
本記事では、PFNの公式技術ブログ2本(2026年10月7日付の製品版発表、および2026年11月5日付の重み公開発表)、Hugging Faceのモデルカード2件(31B版および0.8B GGUF版)、PLaMoコミュニティライセンス全文(英語版)、およびHugging FaceリポジトリのAPI記録を照合し、以下の3つの論点を検証します。
- 公開されたモデル資産と評価対象の範囲:4つのパラメータ規模(0.8B・2B・8B・31B)と7つの配布形式の仕様、および「53言語対応」のうち実際にスコアが測定された15言語の境界
- 社内利用におけるライセンスと免責の条件:PLaMoコミュニティライセンスにおける「商用利用」の定義、売上高10億円の閾値、再配布時の表示義務、および500円の賠償上限と事業利用免責
- 合成データ学習とDeepL比較の測定条件:約373億トークンの合成データ作成プロセス、自社ベンチマーク(PFTB・SaaS)の採点構造、および10月7日付ブログに掲載されたDeepL比較の未記載事項と実務での検証手順
※本記事は技術資料およびライセンス条文の調査記録であり、特定の金融商品の売買や投資判断、ならびに法的助言を扱うものではありません。自社での導入判断にあたっては法務部門へご確認ください。
flowchart TD
    A["PLaMo 3 Translate 導入・代替検討"] --> B{"1. ライセンス・売上基準の確認"}
    B -->|個人・学術研究| C["無料・事前登録不要"]
    B -->|業務利用(社内検証・社内ツール含む)| D{"自社・関連会社の年間売上は10億円以下か?"}
    D -->|10億円以下| E["事前登録フォーム送信で無料利用可"]
    D -->|10億円超 / 合算基準が不明| F["法務確認・PFNとの個別ライセンス契約が必要"]
    E --> G{"2. 対象言語と実行環境の確認"}
    G -->|日英・英日など評価済み15言語| H["自社の実務文書10件でDeepLと並べて人間が比較検証"]
    G -->|未評価の38言語 / 日英を介さないペア| I["ベンチマーク未測定のため独自検証が必須"]
    H --> J["固有名詞・数値・敬語・抜け漏れと手直し工数を記録して判断"]
2. 発端と公開タイムライン:「さよならDeepL」はどこから来た言葉か
まずは、今回の重み公開に関する時系列の事実と、ネット上で広まっている見出しの出所を切り分けます。
Hugging FaceのAPI記録(S6)を確認すると、リポジトリ(置き場所)自体は2026年10月26日に作成されており、モデルの中身である重みファイルに最初の記録が付いたのは2026年11月4日です。具体的には、最小サイズの0.8B版がUTC 07:57(日本時間換算で16時57分)、最大サイズの31B版がUTC 14:13(日本時間換算で23時13分)に記録されています。そして翌日の2026年11月5日に、PFNの公式技術ブログ(英語版:S1)で重み公開の技術解説が発表されました。
ここで注意したいのは、SNS等で散見される「さよならDeepL」というフレーズです。PFNの2本の公式技術ブログ(10月7日付の製品版ブログS2、および11月5日付の重み公開ブログS1)を全文照合しても、このような表現は一切使われていません。これは利用者の投稿から広まった言葉であり、開発元であるPFNの公式主張ではない点を押さえておく必要があります。
- 2026年10月7日:PFNが日本語の技術ブログ(S2)で「plamo-3-translate」製品版を発表(DeepLとの勝率比較はこの時の記事に掲載)
- 2026年10月26日:Hugging Face上にモデルリポジトリが作成される(S6)
- 2026年11月4日:Hugging Face上で重みファイルの初回記録が付く(0.8Bは日本時間16:57、31Bは23:13、日本時間はUTC+9による算出:S6)
- 2026年11月5日:PFNが英語の技術ブログ(S1)で「PLaMo 3 Translate」の重み公開と学習・評価手法を発表
3. 公開された資産の解剖:4つのサイズ・7つの形式と「53言語中15言語評価」の境界
第1の検証軸として、今回公開されたモデル資産の具体的な仕様と、対応言語の評価範囲を確認します。
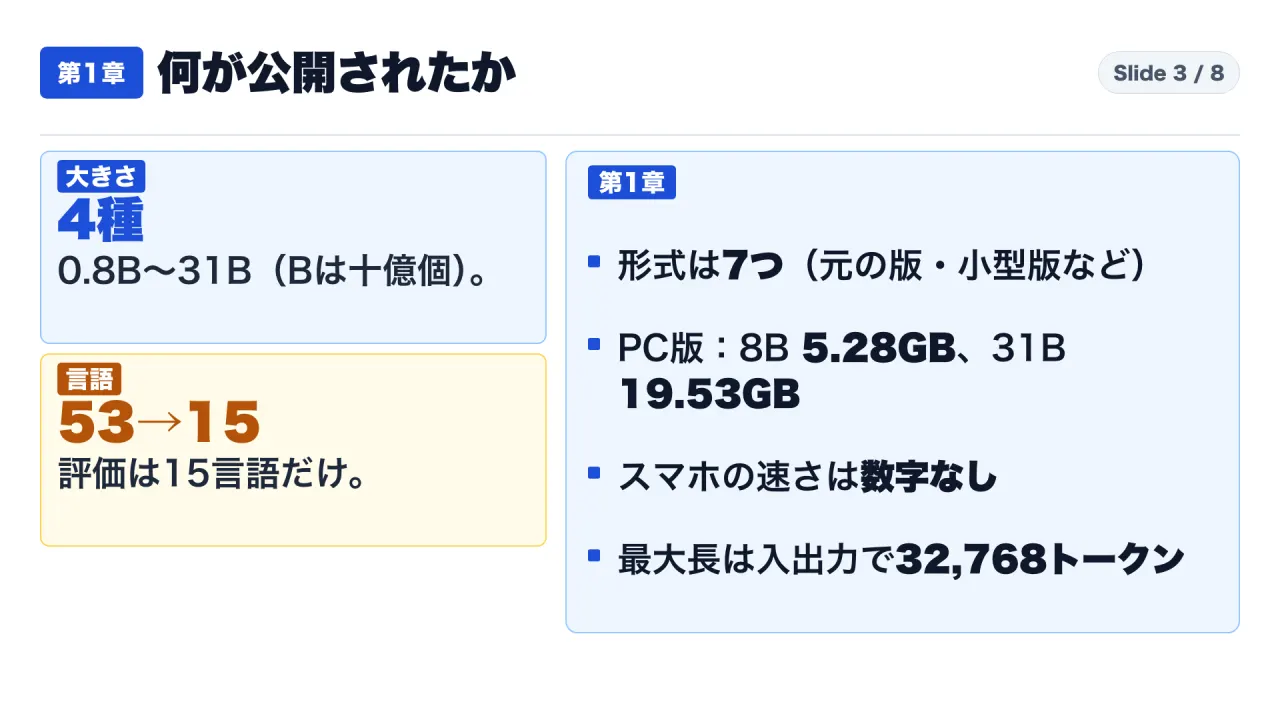
公開されたパラメータ規模は0.8B、2B、8B、31Bの4サイズです(「B」は10億パラメータを表します)。さらに各サイズに対して、元の精度(BF16)のモデルに加え、ファイルサイズを小さくした量子化モデル(NVIDIA GPU向けの4種類)、一般的なPC(CPUのみでも動作可能)向けのGGUF版、およびAppleのMac(Apple Silicon)向けのMLX版を合わせた計7つの形式が用意されています(S1, S3)。
ファイル容量をモデルカード(S3)の記載で確認すると、元の精度の版では8Bが17.06GB、31Bが63.51GBであるのに対し、GGUFの「Q4_K_M」量子化形式では8Bが5.28GB、31Bが19.53GBへと、どちらも約3分の1(筆者の算出で約0.31倍)に圧縮されています。PFNの測定によれば、最も圧縮率が高い「Q2_K」形式では一部の指標で精度が低下するものの、それ以外の量子化形式では元の精度とほぼ同等の翻訳性能が維持されたと報告されています(S1, S3)。ただし、これらは重みファイルの合計サイズであり、推論実行時に必要となる実メモリ(RAM/VRAM)の容量はモデルカードに明記されていません。また、ブログ内にはスマートフォンを機内モードにしてオフライン翻訳するデモ動画が掲載されていますが、これはPFN内部のデモであり、スマホアプリ自体は公開されていません(0.8B GGUF版のカードにはSnapdragon搭載端末で高速に動作する傾向があるとの記述がありますが、具体的な速度の数値は記載されていません:S1, S4)。
さらに実務で見落としやすいのが、対応言語と評価済み言語の差です。
- 学習された対応言語数(53言語):中国語の簡体字と繁体字を別々に数えた計53言語に対応しています(S3)。
- 実際に性能スコアを測定した言語数(15言語):53言語のうち、ベンチマークで点数を測定したのは15言語のみです。しかも、評価対象は「日本語または英語」と「他の言語」の組み合わせに限定されています(S1, S3)。
- 未評価の言語と組み合わせ(38言語):残りの38言語(53−15)、および日本語・英語を介さない直接翻訳(例:タイ語から中国語への翻訳など)は、全組み合わせの測定コストが高いという理由から評価対象外となっています(S1)。
- 実務向けの入力機能とトークン上限:前後の文脈(コンテキスト)や用語集(グロッサリー)の指定、日本語の文体(「です・ます調」または「だ・である調」)の切り替えに対応しています。学習時の最大長は入力と出力を合わせて32,768トークンであり、これを超える長文は分割して入力する必要があります(S3)。
4. ライセンス条文の精査:社内利用も「商用扱い」、売上10億円の壁と免責規定
第2の検証軸は、企業や組織が業務で試す際に直面するライセンス条件です。PLaMo 3 Translateには独自の「PLaMoコミュニティライセンス(PLaMo Community License)」(S5)が適用されています。
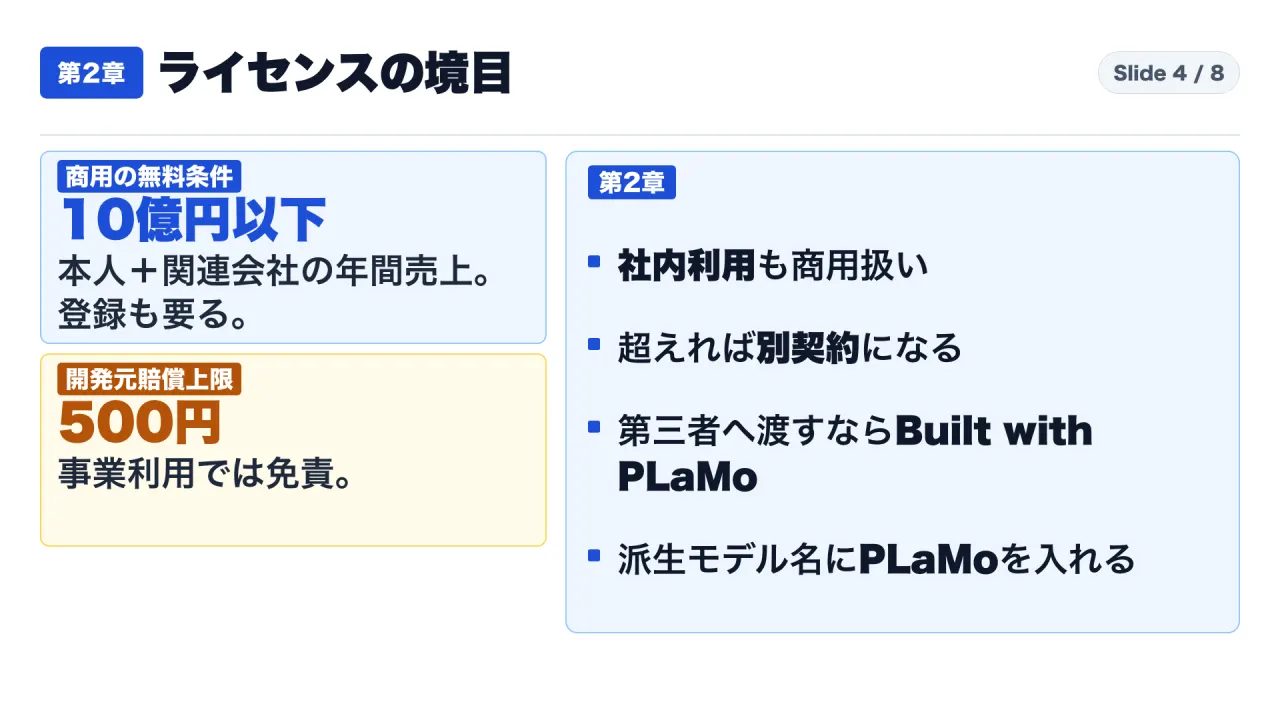
オープンウェイトのモデルと聞くと、「社内のクローズドな環境でメールの下書きや資料の翻訳に使うだけなら、自由に使ってよいだろう」と誤解されがちです。しかし、ライセンス全文(S5)を読むと、個人の趣味・学習および大学等の学術研究以外の利用はすべて「商用利用(Commercial Use)」と定義されており、社内の業務効率化や社内検証で使うだけでも商用利用に含まれます。
商用利用を無料で行うためには、以下の2つの条件を両方とも満たす必要があります(S3, S5)。
- 事前の利用登録:PFNが指定する登録フォームを送信すること(フォーム送信時点から無料で利用可能:S3)。
- 年間売上高10億円以下の基準:自社および関連会社(Affiliates)の直近会計年度の年間売上高が10億円以下であること。年間売上高が10億円を超える企業は、無料利用の対象外となり、PFNへの問い合わせによる個別ライセンス契約が必要です(S1, S3, S5)。なお、条文上「10億円」が単体売上なのか関連会社を含めた連結・合算売上なのかが明文化されていない箇所があるため、グループ企業に属する場合は法務部門での確認が必要です。また、条件を一つでも満たさなくなった時点で商用利用の権利は失효します(S5)。
さらに、モデルや翻訳結果を扱う際の義務と責任範囲についても、厳しい条文が設けられています(S5)。
- 第三者へのモデル配布時の3義務:モデルや派生モデルを第三者に渡す場合は、①ライセンス契約書の写しの添付、②「Built with PLaMo」の表示、③作成したモデル名への「PLaMo」の付与が義務付けられています。
- 出力結果の公開と派生モデルの伝播:翻訳結果を公開する際はPLaMoの出力である旨を明示する必要があります。また、PLaMo 3 Translateの翻訳出力を用いて別のモデルを学習・ファインチューニングした場合、その新しいモデルも「派生モデル」とみなされ、同じライセンス条件に縛られます。
- 特定領域での利用禁止と500円の賠償上限:モデルおよび出力は「現状有姿(AS IS)」で提供され、法律・医療・金融の意思決定における唯一の根拠として使用することは禁止されています。PFNの損害賠償責任の上限は500円と定められており(故意または重過失を除く)、事業で利用する場合にはPFNは一切の責任を負いません。利用に起因して第三者からPFNに請求が生じた場合は利用者が補償する規定となっており、条文自体もPFNが変更できる形式になっています。
5. 学習データと評価ベンチマークの構造:Gemma 4による373億トークン合成と自社物差し
第3の検証軸として、このモデルがどのように作られ、どのような物差しで採点されているのかを、11月5日付の技術ブログ(S1)から読み解きます。
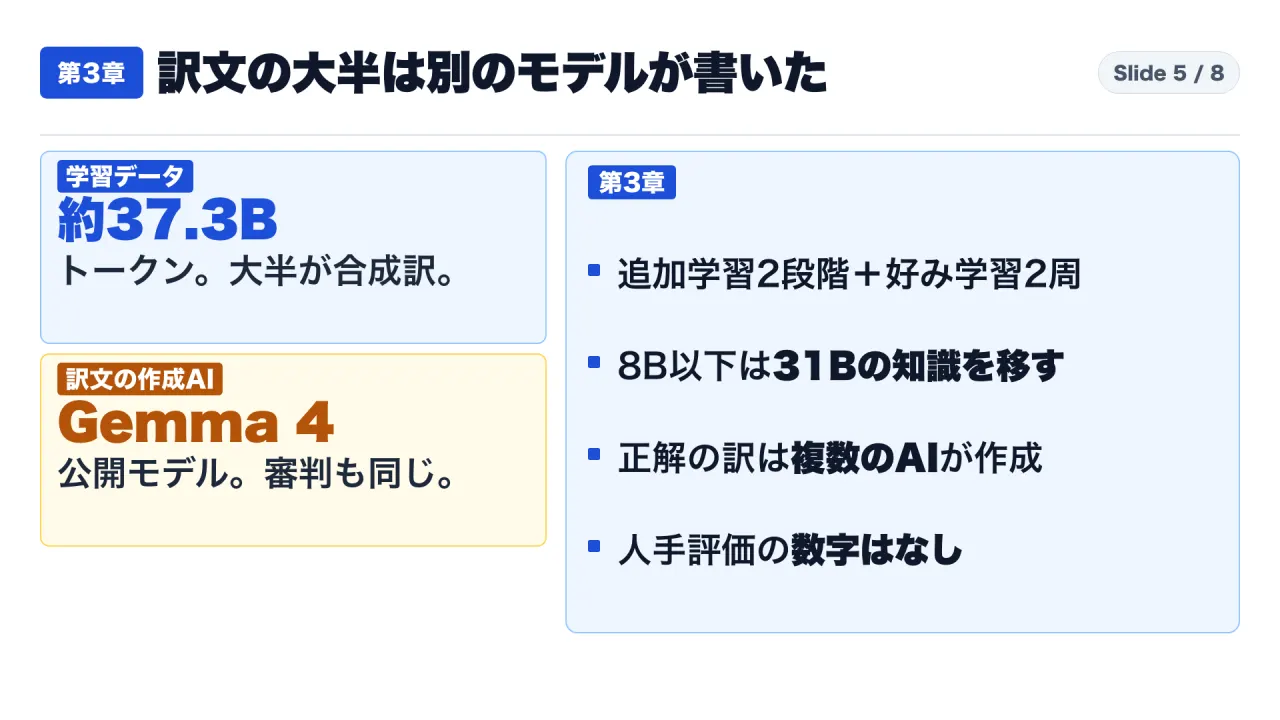
ベースモデルには、PFNと情報通信研究機構(NICT)の共同研究で開発された「PLaMo 3 NICT」が使われています。注目すべきは学習データの作り方です。原文はWebなどから収集されていますが、対となる訳文データの大部分は人間の翻訳者ではなく、公開モデルの「Gemma 4 31B IT」によって合成されています。その規模はブログの表に記載された「37.3Bトークン」、すなわち約373億トークンにのぼります(S1)。
合成訳文の品質を高めるため、PFNは①複数の翻訳候補を生成してトーナメント方式で最良の1つに絞り込む手法、②訳文から原文へ戻す逆翻訳(Back-translation)、③学習後のモデル自身でデータを再生成する自己改善の3つの工夫を組み合わせています。学習プロセスは、2段階の教師あり微調整(SFT)の後に、選好学習(Preference Learning)を2周実施し、8B以下の小型モデルにはその中間に31Bモデルからの知識蒸留(Distillation)を挟んでいます。この選好学習で「どちらの訳が良いか」を判定する審判役にもGemma 4が使われています(なお、別の強化学習手法も試されたものの、自動評価スコアが上がった一方で人間による評価で流暢さが低下したため不採用になったと記されています:S1)。
そして、モデルの性能を測るベンチマークにも特徴があります。
- 社内ベンチマーク「PFTB」:論文、レビュー、詩など多様なジャンルを集めたPFN社内試験です。ここで「正解の訳(参照訳)」を作っているのも複数の強力なAIモデルであり、採点はそのAI製の参照訳と文字の並びがどれだけ近いか(文字列・意味類似度)で行われます(S1)。
- 社内ベンチマーク「SaaS」:実際の翻訳サービスの利用場面に近づけた社内試験で、英語から日本語への翻訳においてWebページのHTMLタグや記号を壊さずに維持したまま翻訳する課題です(S1)。
- 外部ベンチマーク(WMT24++ / FLORES+):外部試験としてこの2つも併用されていますが、PFNはWMT24++について「参照訳の品質に懸念があるため、開発時は主に社内の2試験(PFTB・SaaS)を重視した」と説明しています(S1)。
- モデルサイズ間のスコア差:モデルカード(S3)に掲載された日英PFTB(BF16版)のスコアを比較すると、最大31Bが0.6244、最小0.8Bが0.5862であり、その差は0.0382(筆者算出)です。また、11月5日のブログ(S1)では他の翻訳特化モデル(TranslateGemmaやHy-MT2)と比較し、「0.8Bモデルであっても日英および日本語・多言語翻訳で30倍以上の規模の相手を含む全比較対象を上回り、世界最高の翻訳特化モデルを実現した」とPFN自身が結論づけていますが、具体的な数値はグラフ画像内のみで本文の表には記載されていません。
ここで構造的に押さえておくべきなのは、**「学習データの訳文を作ったのもAI、ベンチマークの正解(参照訳)を作ったのもAIであり、そのAI製の参照訳との近さで採点している」**という点です。PFN自身も10月7日のブログ(S2)で「今回の評価は参照訳に依存する面がある」と述べており、AIらしい整った訳文ほど高スコアが出やすい構造になっている可能性があります。
6. DeepLとの比較データをどう読むか:10月7日ブログの勝率58〜87%と6つの未確認事項
では、「DeepLに勝率58〜87%で勝ち越した」というデータはどの資料にあり、どのような条件で測定されたのでしょうか。
実は、11月5日の重み公開ブログ(S1)にはDeepLとの比較データは載っておらず、「他のモデルや翻訳サービスとの比較は以前の発表を参照してほしい」と記されています。該当するデータがあるのは、約1か月前の2026年10月7日付の製品版発表ブログ(S2)であり、対象となっているのは31Bモデルのみです(しかも、10月7日時点では「開発は進行中」と記されており、11月4日に公開された重みと完全に同一のチェックポイントであるかは明記されていません)。
10月7日付ブログ(S2)におけるDeepLとの比較方法と勝率は以下の通りです。
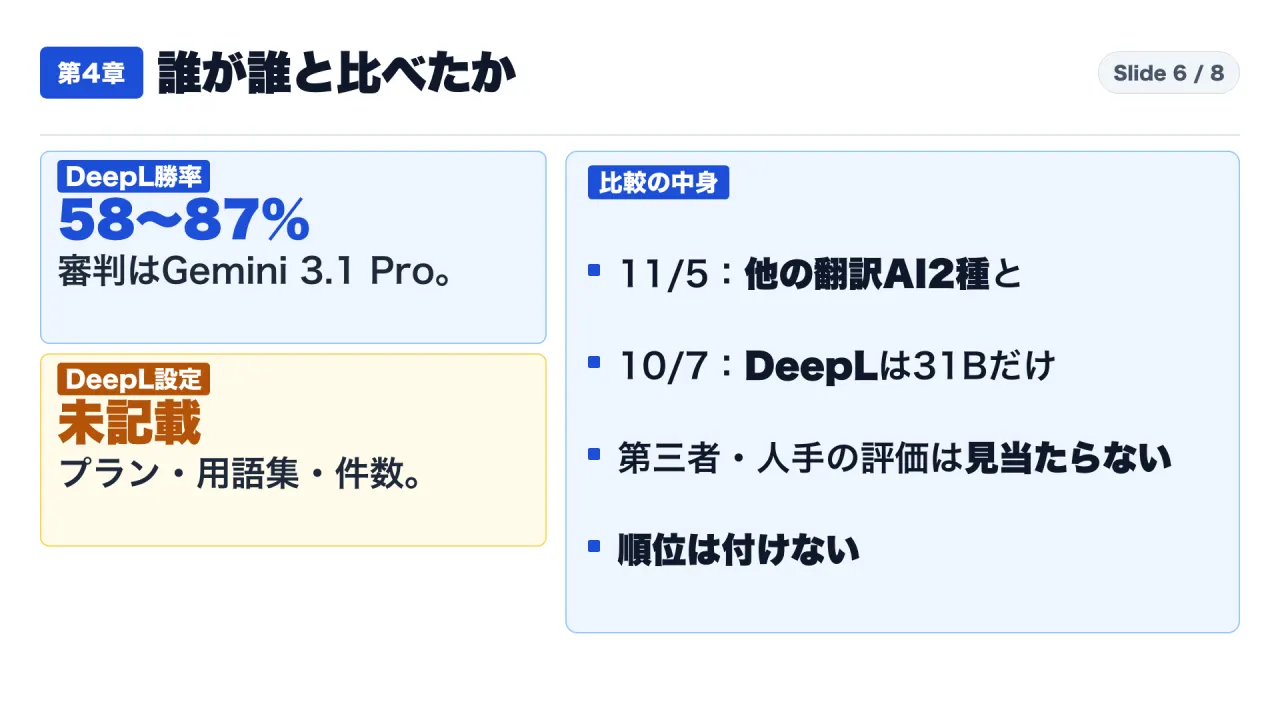
- 判定方法(LLM-as-a-Judge):DeepLの翻訳結果とPLaMo 3 Translate(31B)の翻訳結果を並べ、Gemini 3.1 Proを審判役として「どちらの訳が良いか」を判定させています。表示順序によるバイアスを消すため順番を入れ替えて2回判定し、1勝1敗で割れた場合は0.5勝ずつ(互角は50%)として集計しています。
- PFTB(英語→日本語)での勝率:87%(31B側の勝ち越し)
- PFTB(日本語→英語)での勝率:58%
- SaaS(英語→日本語、タグ維持)での勝率:73.82%
- WMT24++での勝率:59.17%
いずれの試験でも50%を超えて勝ち越しているのは事実ですが、これを「自社の業務でもDeepLより優れている」と直結させる前に、一次資料上で確認できない6つの未確認事項を整理しておく必要があります(S1, S2)。
- 測定主体と審判の選定:テスト設計、実行、および審判モデル(Gemini 3.1 Pro)の選定はいずれも開発元であるPFN自身によるものです。
- DeepL側の設定条件が未記載:比較対象となったDeepLが無料版か有料版(DeepL Pro)か、用語集(グロッサリー)やフォーマル/インフォーマルの文体指定を使用したかが記載されていません。
- 評価サンプル件数が未記載:各勝率を算出する母数となった比較文の件数が明記されていません。
- 小型モデル(0.8B・2B・8B)とDeepLの直接比較は不在:手元のPCで動かしやすい0.8B〜8BサイズとDeepLを直接対決させた勝率データは掲載されていません。
- 日英・英日以外の言語ペアでの比較は不在:中国語や欧州言語など、日本語・英語以外のペアにおけるDeepLとの比較データは見当たりません。
- 第三者機関による独立測定と人間の翻訳者による評価が不在:公式資料の中には、外部の第三者によるベンチマーク結果や、プロの人間翻訳者によるブラインド評価の数値は含まれていません(また、PFN自身も10月7日のブログ内の日英性能グラフにおいて、31Bを上回るモデルとして「Claude Fable 5.1」が存在することを記しています:S2)。
さらに、ベンチマークの選び方によって結果が大きく変わる実例も10月7日のブログ(S2)に載っています。8B版のPLaMo 3 Translate、前世代のPLaMo 2 Translate、およびTranslateGemma 27Bの3つを比較した表では、社内試験の「SaaS(英→日)」スコアがそれぞれ 0.571 / 0.430 / 0.395 と明確な差がついている一方、外部試験の「WMT24++」では 0.879 / 0.882 / 0.882 とほぼ横並びになっています(PFN自身もWMT24++は性能が飽和していると述べています)。どの試験で測るかによって優劣の見え方が変わるからこそ、自社の実際の文書での確認が不可欠です。
7. 実務での解釈と明日からできる3ステップの検証手順
ここまでの一次資料の事実を踏まえ、実務担当者や管理職がどのように判断を進めるべきか、筆者の解釈と具体的な検証手順を整理します。
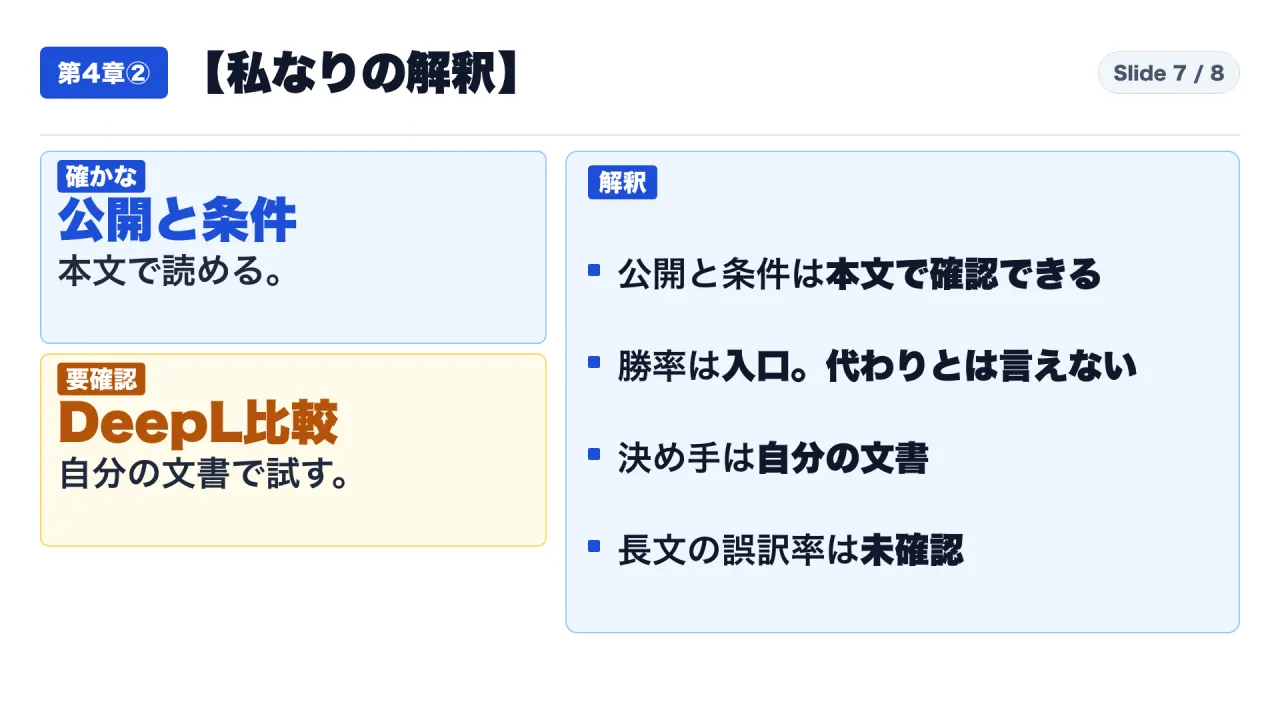
第1に、公開された重みの仕様とライセンス条文は一次資料で明確に確認できるため、まず法務・コンプライアンス面の足場を固めることができます。第2に、「勝率58〜87%」という数値はあくまで検討を始める入口であり、測定者も審判選定もPFN自身であるため、そのまま「DeepLの代わりになる」と結論づけることはできません。第3に、前世代のモデル(PLaMo 2 Translate)では「稀に情報の付け足しや欠落(ハルシネーションや訳抜け)があった」と10月7日のブログ(S2)で言及されていましたが、今回のPLaMo 3 Translateでその発生率がどう変化したかは明記されていません。また、長文や契約書での訳抜け割合、日英以外のDeepLとの差、手元のPCでの実測速度も公式資料からは分かりません。
機密文書を外部サーバーに送信せず手元のマシン(ローカル環境)で翻訳できる点は大きな魅力ですが、ライセンス条文(S5)の通り、誤訳による損害や第三者からの請求に対する責任はすべて利用者側が負います。したがって、導入判断にあたっては以下の3つのステップを順番に実行することを推奨します。
- ステップ1:売上高10億円の基準と事前登録の要否を法務と確認する 自社および関連会社の直近会計年度の売上高が10億円以下であるかを確認します。社内での検証や社内業務での使用であってもライセンス上は「商用利用」に該当するため、10億円以下であれば事前登録フォームの送信手続きを、10億円を超える(またはグループ合算の解釈が問題になる)場合はPFNへの個別契約の問い合わせを法務部門と相談します。
- ステップ2:自社の典型的な実務文書10件を選び、同一条件で並べて翻訳する 日頃扱っているメール、技術仕様書、契約書ドラフトなどから代表的な文書を10件選びます。DeepLとPLaMo 3 Translate(実際に運用可能なサイズ・量子化形式)の双方に、可能な限り同じ用語集や文体指定(「です・ます調」や「だ・である調」)を与えて翻訳結果を出力します。
- ステップ3:人間の目で4項目(固有名詞・数値・敬語・抜けと付け足し)を点検し、手直し時間を記録する AIの自動スコアではなく、実務担当者の目で①固有名詞の正確性、②数値・単位の維持、③ビジネス敬語やトーンの自然さ、④原文からの訳抜けや勝手な付け足しの有無をチェックし、「最終的な成果物にするまでに人間が何分かけて手直ししたか」を表に記録して比較します。
8. まとめと参照一次資料一覧
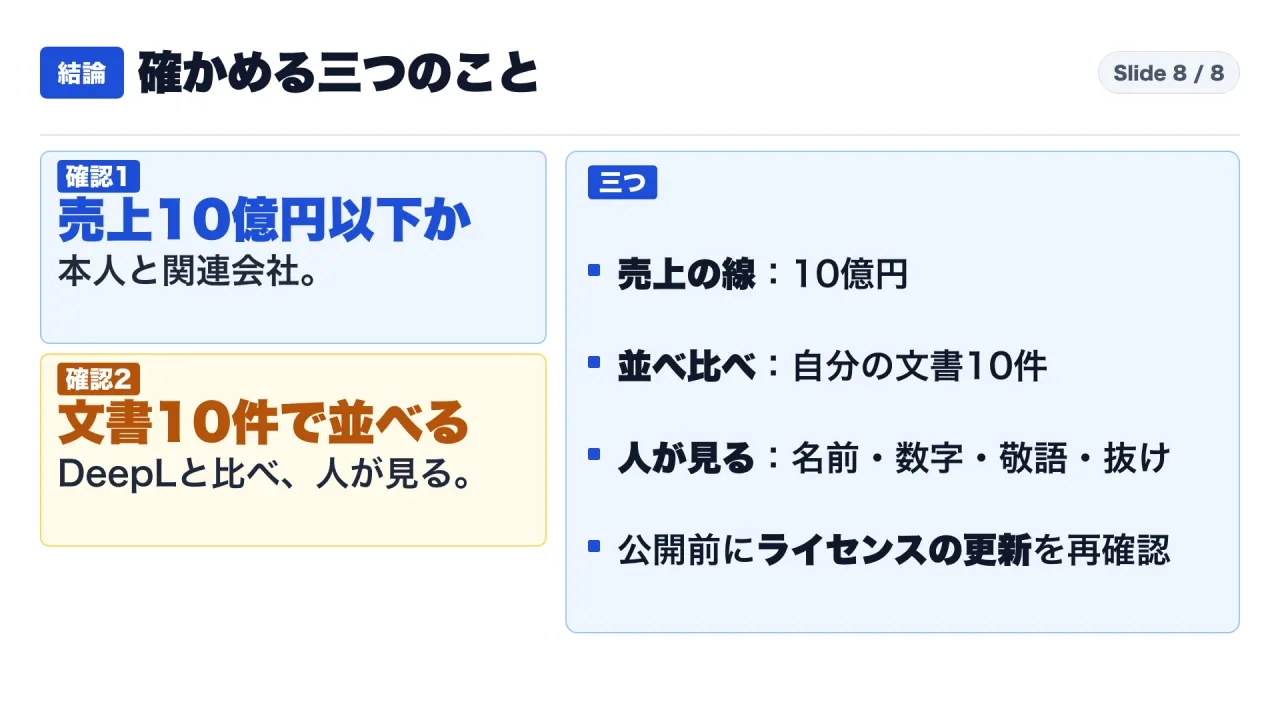
最後に、今回の検証の要点を3つにまとめます。
- 公開されたモデルと評価範囲:0.8B・2B・8B・31Bの4サイズ、GGUFやMLXを含む7形式が公開されました。53言語を学習していますが、実際にベンチマークで評価されたのは日本語・英語を軸とした15言語のみです。
- ライセンスと商用の境界線:社内利用も商用扱いです。自社・関連会社の年間売上が10億円以下なら事前登録で無料、10億円超なら別契約が必要です。事業利用ではPFNは一切の責任を負わず、賠償上限は500円と規定されています。
- DeepL比較の前提と実務判断:勝率58〜87%は10月7日付ブログの31BモデルにおけるPFN自身の測定(審判はGemini 3.1 Pro、DeepL側の設定・件数は未記載)であり、第三者測定や人間による評価は公式資料にありません。代替可否は自社の文書10件を並べて人間の目で確かめるのが確実です。
参照した一次資料(2026年11月5日取得・照合済み)
- S1(重み公開ブログ):PFN Tech Blog: PLaMo 3 Translate Weight Release (2026-11-05)
- S2(製品版発表ブログ):PFN Tech Blog: plamo-3-translate Product Release (2026-10-07)
- S3(31Bモデルカード):Hugging Face: pfnet/plamo-3-translate-31b README.md
- S4(0.8B GGUFモデルカード):Hugging Face: pfnet/plamo-3-translate-0.8b-GGUF README.md
- S5(ライセンス全文):PLaMo Community License (English)
- S6(リポジトリ記録):Hugging Face API: pfnet/plamo-3-translate-31b
動画での解説
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48