なぜPostHogはDuckDBを5ヶ月で捨てたのか?
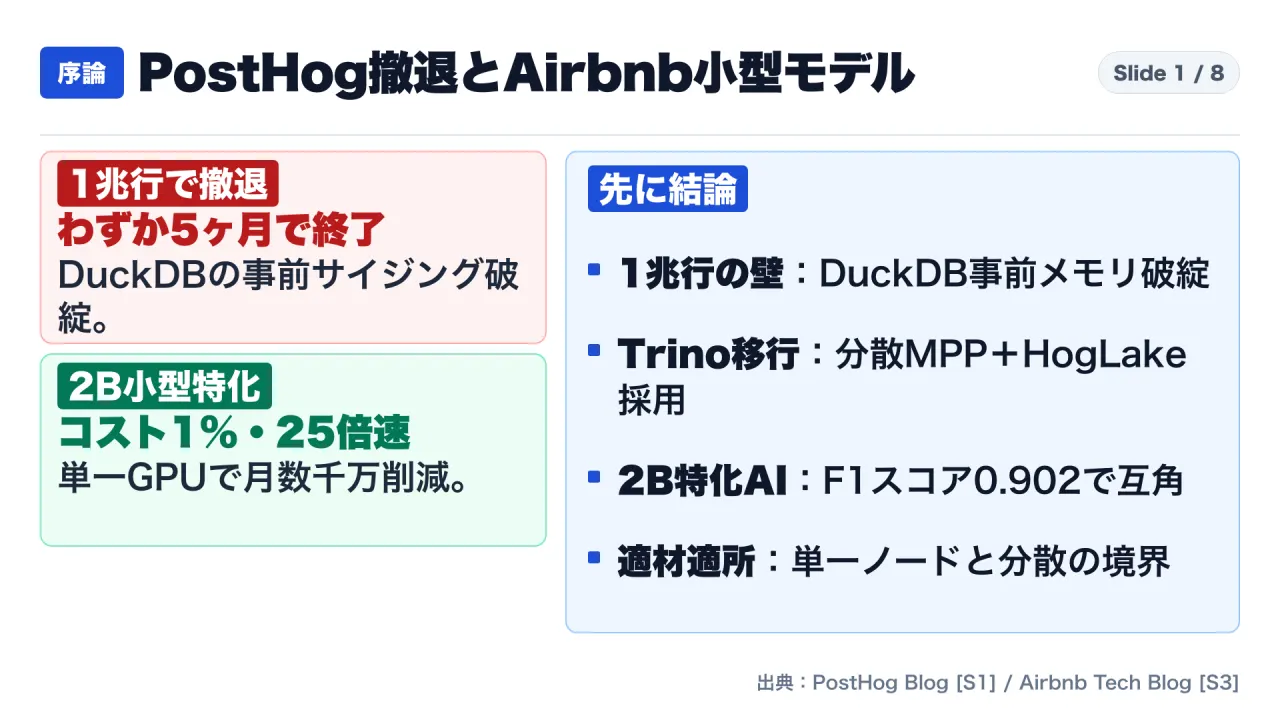
データ基盤と機械学習インフラの設計において、これまでの「流行りの新技術に飛びつく」「最高峰の巨大モデルにすべてを頼る」という常識を根底から覆す2つの決定的な一次レポートが、2026年11月に相次いで公開されました。
1つは、世界中で急速にシェアを伸ばす開発者向け分析プラットフォーム「PostHog」が、自社のデータウェアハウス製品に鳴り物入りで導入した「DuckDB」を、本番導入からわずか5ヶ月、蓄積データ1兆行(約2PB)の段階で全面撤退し、分散MPPエンジンであるTrinoと自社開発テーブルフォーマットHogLakeへ移行したという敗戦レポートです。
もう1つは、「Airbnb」がリスティング(物件情報)の規約・ポリシー違反を検知するリアルタイム審査基盤において、月間数千万円を消費していた商用巨大フロンティアモデルのAPI利用を完全廃止し、わずか20億パラメータ(2B)の小型モデルを特化学習させて、精度同等(F1スコア0.902)、レイテンシ35ms(25倍高速化)、コスト100分の1を単一GPUで達成したという鮮烈な成功実証です。
本記事では、PostHog公式エンジニアリングブログ、HogLake公式リポジトリ、Airbnb公式技術ブログ・ドキュメント、Trino公式アーキテクチャ仕様、およびvLLM公式ドキュメントの計6件の一次資料を徹底的に突き合わせ、なぜ単一ノード最強ツールがクラウドの壁に阻まれ、なぜ2B小型モデルが巨大フロンティアモデルを打ち負かしたのか、その技術的メカニズムとエンタープライズにおける適材適所の設計原則を解説します。
1. 結論と全体像:技術選定のリアルと「適材適所」の境界線
まず、2つの一次情報から導き出される結論を3点に整理します。
- 「1台で世界最強」のDuckDBが直面したクラウド・マルチテナントの3つの壁:
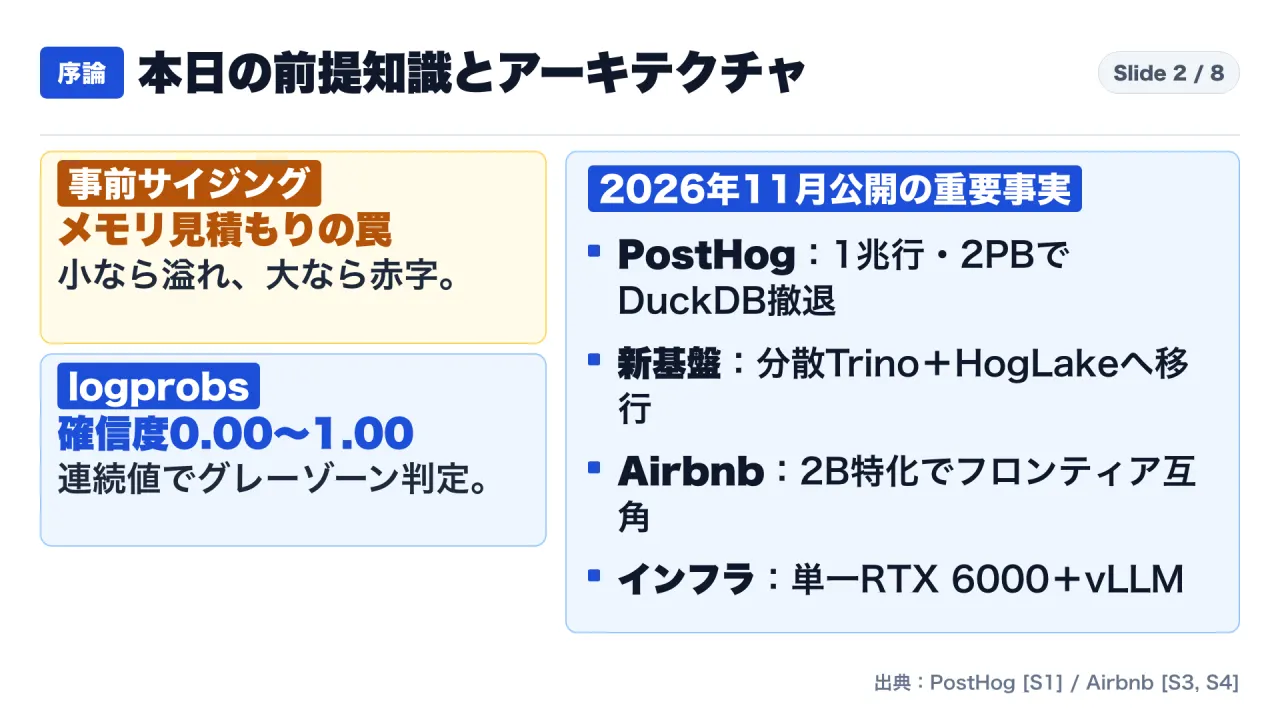
- DuckDBは単一ノードにおけるメモリ内ベクトル集計エンジンとして地球上屈指の性能を誇ります。しかし、不特定多数の顧客が異なるサイズのクエリを突発的に投げてくるクラウドSaaS環境では、「クエリ到着前にワーカーのメモリサイズを決めなければならない事前サイジングの罠(小さすぎるとSpill-to-diskで数分遅延、大きすぎるとインフラ赤字)」、1テーブル書き込みに3分以上かかるロック遅延、およびS3からの非同期フェッチのボトルネックにより、運用開始5ヶ月・1兆行(2PB)で破綻しました。
- Airbnbが証明した「2B小型特化モデル」の圧倒的経済合理性と速度:
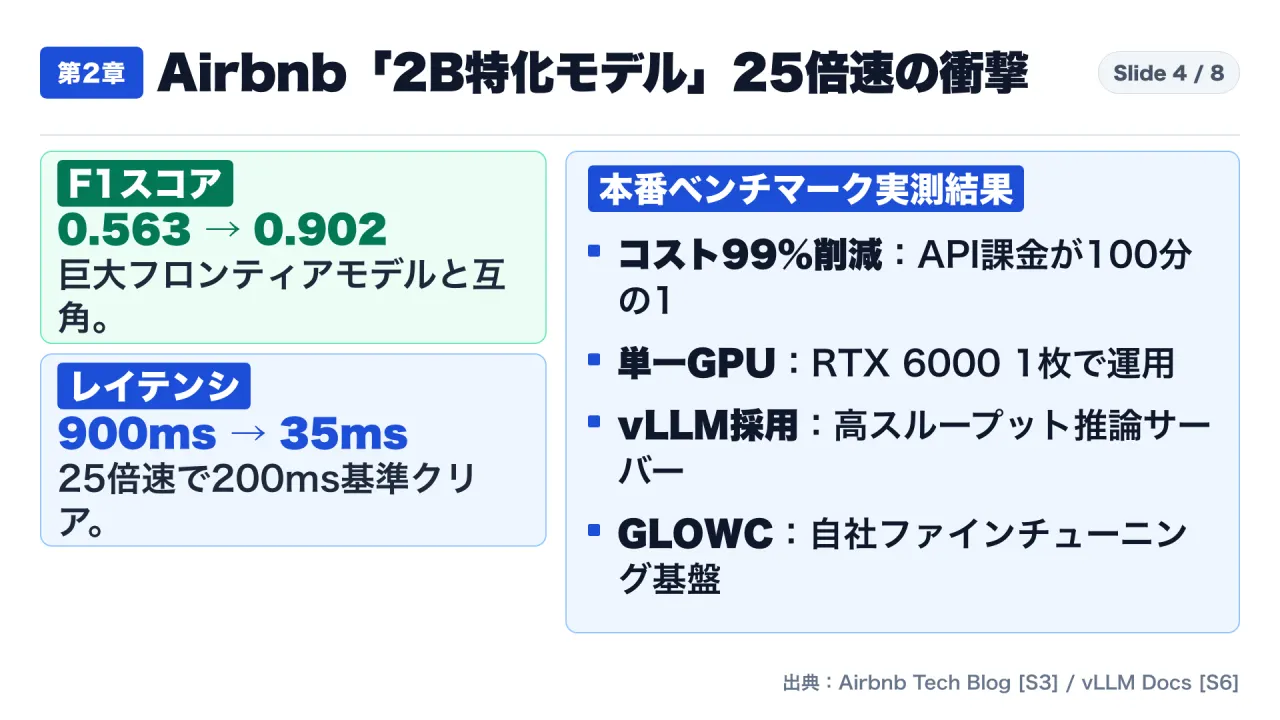
- リアルタイムで毎分数千件のリクエストを200ms以内に審査する本番要件に対し、商用フロンティアモデルAPIは月間数千万円の課金と中央値900msの遅延を発生させていました。Airbnbは自社フレームワーク「GLOWC」を用いて20億パラメータのオープンウェイト小型モデルをファインチューニングし、F1スコア0.902(巨大モデル互角)、レイテンシ35ms(25倍高速化)、コスト100分の1(99%削減)を達成し、たった1枚のNVIDIA RTX 6000 GPUとvLLMで本番トラフィックを完全処理しました。
- エンタープライズにおける「2大アーキテクチャ境界線」:
- データ基盤においては、ローカル・CI・エージェント一時領域には単一ノードのDuckDBを配し、ペタバイト規模の不特定多数クエリにはTrinoのような分散MPPエンジンとオープンテーブルフォーマット(Iceberg / HogLake)を配する。
- 機械学習基盤においては、日常のタスク分類やルーティングに巨大モデルを直結させる「コンビニにロケットエンジンで買い物に行く」設計を脱却し、プロトタイプと教師データ生成に上位モデルを活用し、本番の高頻度推論は小型モデルへ蒸留してlogprobsによる決定論的閾値コントロールを行うハイブリッド構成が最適解となります。
2. 1兆行2PBで白旗!PostHogを撤退に追い込んだDuckDB「3つの壁」
PostHogは2026年春、自社データウェアハウス(DWH)製品のバックエンドとして、当時データサイエンス界隈で絶大な支持を集めていた組み込み型OLAPエンジン「DuckDB」を採用したアーキテクチャ「DuckLake」を発表しました。ローカル環境や単一ノードで数百万行のParquetファイルを爆速で処理できるDuckDBは、インフラコストを劇的に下げつつ分析速度を跳ね上げる救世主と目されていました。
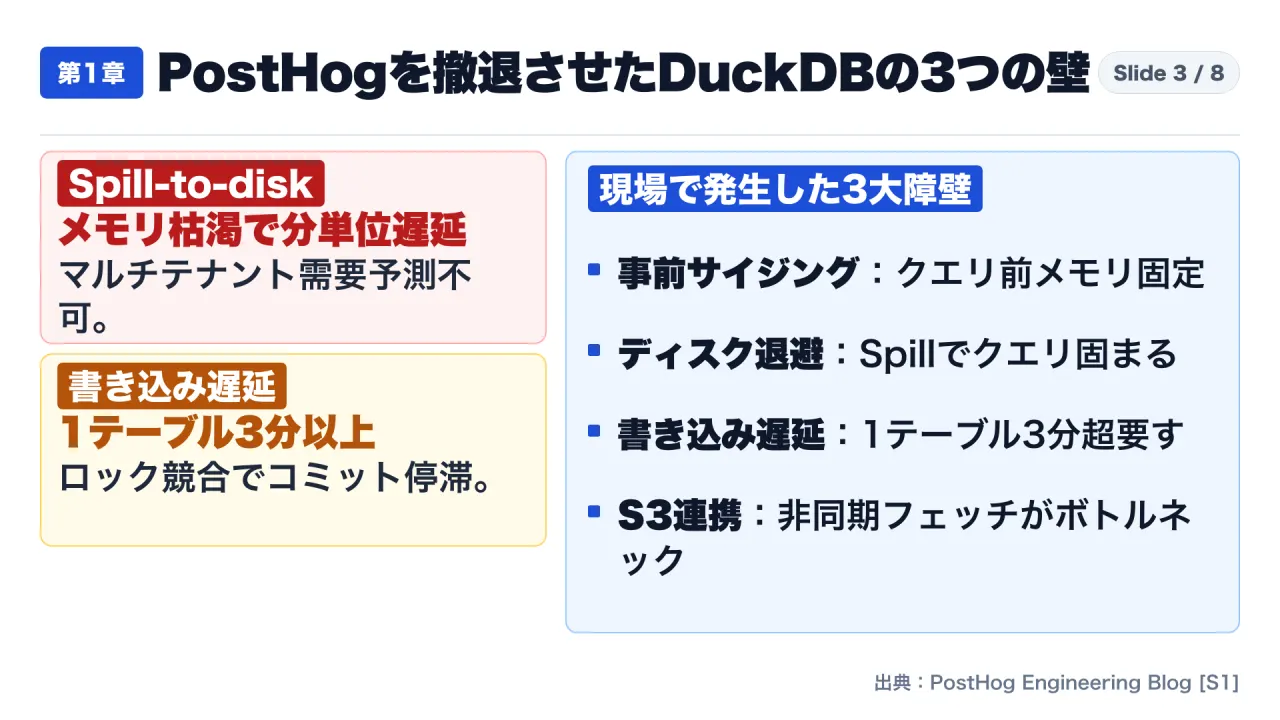
しかし、本番環境のデータ量が蓄積し、顧客テナント全体の総データ量が1兆行(1 Trillion rows)、容量にして約2ペタバイト(2PB)に達した段階で、PostHogのエンジニアリングチームは致命的な3つの構造的障壁に直面し、全面撤退を余儀なくされました。
壁①:事前メモリサイジングの罠(Pre-sizing Dilemma)とSpill-to-disk
DuckDBは単一ノードで動作するアーキテクチャです。クラウド上でワーカーインスタンスを動かす場合、事前にそのインスタンスに割り当てるメモリ容量(RAMサイズ)を決定しなければなりません。 しかしマルチテナントSaaSでは、ユーザーがいつ、どれほど巨大で複雑な多重JOINクエリを投げてくるかを事前に予測することは不可能です。
- メモリが不足した場合: クエリ実行に必要なメモリがインスタンスの上限を超えると、DuckDBはクラッシュを防ぐためにディスクへの一時退避(Spill-to-disk)を行います。ローカルの高速メモリからディスクI/Oへ切り替わった瞬間、クエリの実行時間は数秒から数分へと跳ね上がり、ユーザー画面はフリーズしてタイムアウトが多発しました。
- メモリを過剰に割り当てた場合: ディスク退避を防ぐために全ワーカーへ大容量メモリ(例えば256GBや512GBの巨大インスタンス)を常時プロビジョニングすると、大半の軽い集計クエリに対して過剰なインフラ費用が発生し、DWH製品の採算が完全に崩壊しました。
壁②:1テーブルへの書き込み・コミットに3分以上を要するロック遅延
分析ワークロードでは、データの読み出しだけでなく、継続的なイベントデータの追記や更新(バッチ挿入)が発生します。 DuckDBは単一ファイルや組み込み環境での高速性を優先して設計されているため、マルチテナント環境で複数のプロセスから同一テーブルに対する書き込みやメタデータ更新が重なると、ロック競合やコミット処理の待ち時間が増大しました。PostHogの測定では、1テーブルの更新完了までに3分以上を要するケースが頻発し、リアルタイム性が失われました。
壁③:Amazon S3からの非同期フェッチのボトルネック
DuckDBが真価を発揮するのは、ローカルの高速NVMe SSD上にデータが存在する場合です。しかし、ペタバイト規模のデータを安価に保持するためにはAmazon S3などのクラウドオブジェクトストレージが不可欠です。当時のDuckDBはオブジェクトストレージからの非同期HTTPフェッチや並列プリフェッチの最適化が不十分であり、ネットワークレイテンシがクエリ全体のボトルネックとなっていました。
これらの3つの問題は、チューニングや設定の微修正で解決できるレベルではなく、「単一ノード向けエンジンを不特定多数のクラウドマルチテナントDWHに適用した」という根本的なアーキテクチャのミスマッチに起因していました。
3. 月数千万円のAPI課金を1枚のGPUへ!Airbnb「2B特化モデル」25倍速のカラクリ
PostHogが直面したデータ規模の壁と鮮やかな対比を見せるのが、Airbnbが成功させた機械学習インフラの革命です。彼らは**「あえてモデルを極限まで小さくする(2B小型化)」**ことによって、コストとレイテンシの壁を打ち破りました。
Airbnbの直面していた課題と厳しい本番要件
Airbnbのグローバルプラットフォームでは、世界中のホストから毎日数十万件の宿泊施設(リスティング)登録や説明文の更新が行われます。 その中には、プラットフォーム外での直接支払いを誘導する文言、不当な追加料金の請求、電話番号や連絡先の巧妙な隠蔽など、サービス規約に違反するコンテンツが含まれているリスクがあります。
このポリシー違反検知システムには、以下の過酷な条件が課されていました。
- トラフィック: 毎分数千件のリクエストが継続的に発生する。
- 許容レイテンシ: ユーザーが投稿ボタンを押してから完了画面が表示されるまでの間に判定を下すため、エンドツーエンドで200ミリ秒以内の完了が必須。
- 文脈理解力: 文脈の中に巧妙に隠された違反表現を見抜く高度な言語理解力。
商用フロンティアモデルAPIの限界
初期の実装では、業界最高峰の商用巨大フロンティアモデルが採用されていました。プロンプトエンジニアリングによって高い検出精度が得られたものの、2つの致命的な問題に直面しました。
- 法外なAPIコスト: 毎分数千件のトラフィックをすべて外部APIに流した結果、月間のAPI請求額は数千万円単位に達し、持続可能性が危ぶまれました。
- 許容できないレイテンシ: 外部APIを呼び出すネットワークオーバーヘッドと巨大モデルの推論時間の合算により、応答時間の中央値は約900ミリ秒に達し、目標である200ミリ秒を4倍以上オーバーしていました。
GLOWCフレームワークと2Bモデルへの特化蒸留
Airbnbのエンジニアリングチームは、自社開発のLLMファインチューニング基盤「GLOWC」を構築し、わずか20億パラメータ(2B)のオープンウェイト小型モデルに対する特化学習を敢行しました。
| 評価指標 | チューニング前の小型モデル | 商用巨大フロンティアモデル | GLOWC学習済み2B小型特化モデル | 達成された成果 |
|---|---|---|---|---|
| F1スコア(精度バランス) | 0.563 | 約0.90 | 0.902 | 商用フロンティアモデルと完全互角 |
| 推論レイテンシ(中央値) | 約40ms | 約900ms | 35ms | 25倍の高速化(200ms要件を大幅クリア) |
| 月間インフラ費用比率 | — | 100%(数千万円/月) | 1%(数十万円/月) | コスト99%削減(100分の1に圧縮) |
| ホスティング環境 | — | 外部クラウドAPI | 単一GPU(RTX 6000 Ada)+vLLM | 自社インフラ内での完全自前運用 |
この結果は、「高度な自然言語分類タスクであっても、特定ドメインに絞り込んで高品質な教師データでチューニングすれば、2Bクラスの極小モデルで何百倍も巨大なフロンティアモデルと完全に互角の精度が出せる」ことを明確に証明しました。
4. なぜDuckDBはクラウドで破綻したのか?単一ノードと分散MPP「Trino」の境界線
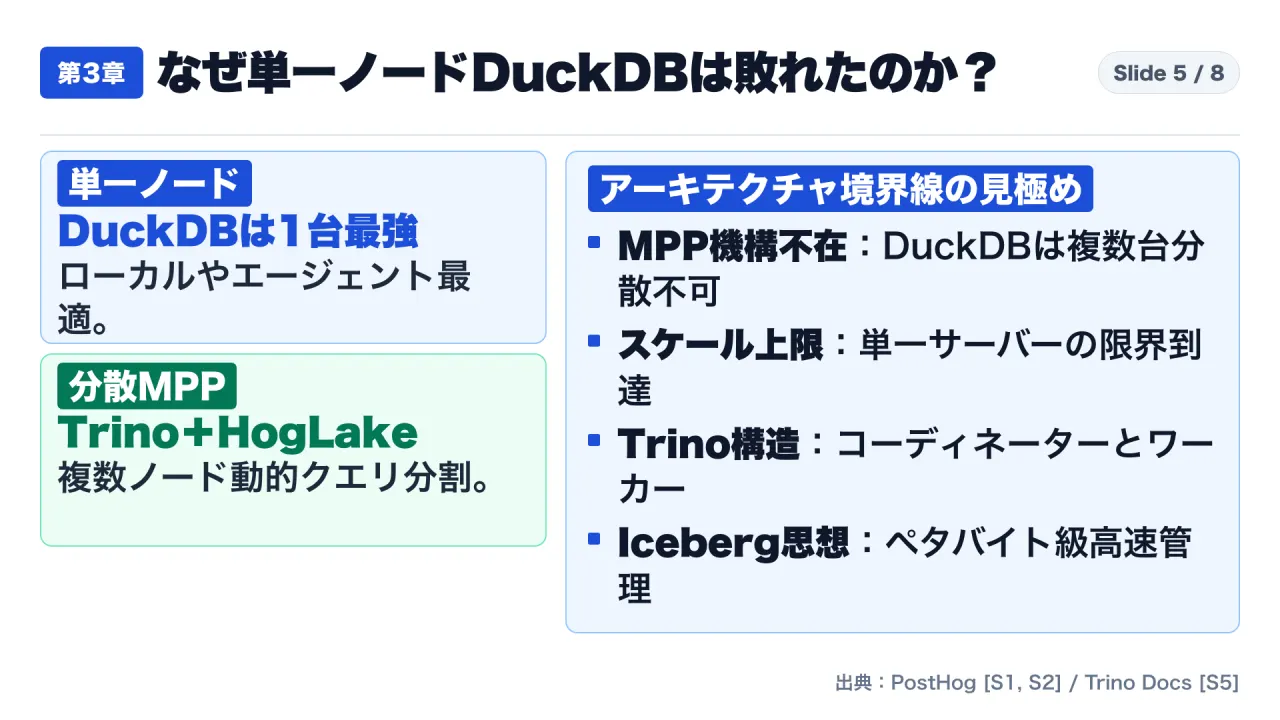
PostHogがDuckDBを諦め、移行先として選んだのが分散MPP(Massively Parallel Processing)クエリエンジンである「Trino」と、自社開発のオープンテーブルフォーマット「HogLake」でした。
単一ノードOLAPと分散MPPのアーキテクチャ比較
| 比較項目 | DuckDB(単一ノードOLAP) | Trino + HogLake(分散MPP) |
|---|---|---|
| 実行モデル | 単一マシン・単一プロセス内のマルチスレッド実行 | コーディネーターと多数のワーカーノードによる分散並列実行 |
| スケーラビリティ | スケールアップ(CPU・メモリ増設)のみ | スケールアウト(ノード追加)による線形拡張 |
| メモリ管理 | 事前に単一インスタンスのRAM容量を固定する必要あり | クラスタ全体のメモリプールからステージ単位で動的配分 |
| データ規模の上限 | 数GB〜数TB(単一マシンのメモリ/ディスクに依存) | ペタバイト(PB)〜エクサバイト(EB)規模に完全対応 |
| ストレージ連携 | ローカルNVMeで最速、リモートS3ではレイテンシ悪化 | S3やGCSからの超並列非同期読み出しを前提に最適化 |
| マルチテナント適性 | 低い(突発的な重クエリで他テナントやインスタンス全体が影響) | 高い(キューイング、リソースグループによる厳密な分離が可能) |
| 最適なユースケース | ローカルPC分析、データサイエンス、CI/CD、エージェント作業領域 | クラウド基幹DWH、エンタープライズ・データレイク、SaaS分析基盤 |
flowchart TD
    subgraph DuckDB_Arch["【単一ノード:DuckDB(DuckLake)の構造】"]
        Client1["クライアントA(軽クエリ)"] --> Instance["単一インスタンス(RAM固定)"]
        Client2["クライアントB(重クエリ)"] --> Instance
        Instance --> Memory{"RAM上限超過?"}
        Memory -- "Yes" --> Spill["Spill-to-disk(ディスク退避)\n→ 処理時間が数分に遅延!"]
        Memory -- "No" --> LocalExec["爆速実行"]
    end

    subgraph Trino_Arch["【分散MPP:Trino + HogLakeの構造】"]
        Clients["不特定多数のクライアントクエリ"] --> Coord["Trino コーディネーター\n(クエリ解析・動的ステージ分割)"]
        Coord --> Worker1["ワーカーノード 1\n(S3並列フェッチ)"]
        Coord --> Worker2["ワーカーノード 2\n(ステージ集計)"]
        Coord --> WorkerN["ワーカーノード N\n(動的スケールアウト)"]
        Worker1 & Worker2 & WorkerN --> HogLake["HogLake / Iceberg テーブルフォーマット\n(S3上のペタバイト級Parquet管理)"]
    end
Trinoの動的クエリ分割とHogLakeの役割
Trinoの最大の強みは、クエリが到着した瞬間にコーディネーターがクエリプランを無数の「ステージ」と「タスク」に分解し、クラスタ内に存在する多数のワーカーノードへ動的に割り振る点にあります。 あるワーカーノードのメモリが逼迫した場合でも、タスクの再配置や中間データのパイプライン転送によって処理が継続され、単一マシンのメモリ不足でシステム全体が機能不全に陥ることはありません。
さらにPostHogが開発した「HogLake」は、Apache Icebergの設計思想をベースに、ペタバイト規模のメタデータ管理、効率的なコンパクション(小さなParquetファイルの結合)、およびS3オブジェクトストレージとの親和性を極限まで高めたテーブルフォーマットです。これにより、書き込み遅延は解消され、1兆行を超える巨大データセットに対しても安定した数秒以内のクエリ応答が実現しました。
5. logprobsによる決定論的閾値制御とハイブリッド蒸留の黄金律
Airbnbの事例において、単なるコスト削減以上に実務アーキテクチャとして称賛されるべきは、**「logprobs(対数確率)を活用した決定論的な閾値コントロール」**の導入です。
曖昧な自然言語判定から「連続値スコア」への脱却
外部の商用フロンティアモデルをプロンプトで呼び出している場合、モデルからの返答は「この文章は規約に違反している可能性が高いと考えられます」といった非構造な自然言語や、単純なJSONフラグ({"is_violation": true})になりがちです。
これでは、「モデルがどれほどの確信度を持って違反と判断したのか」が分からず、誤検知(False Positive)によって善良なユーザーのアカウントを誤って停止してしまうリスクを制御できません。
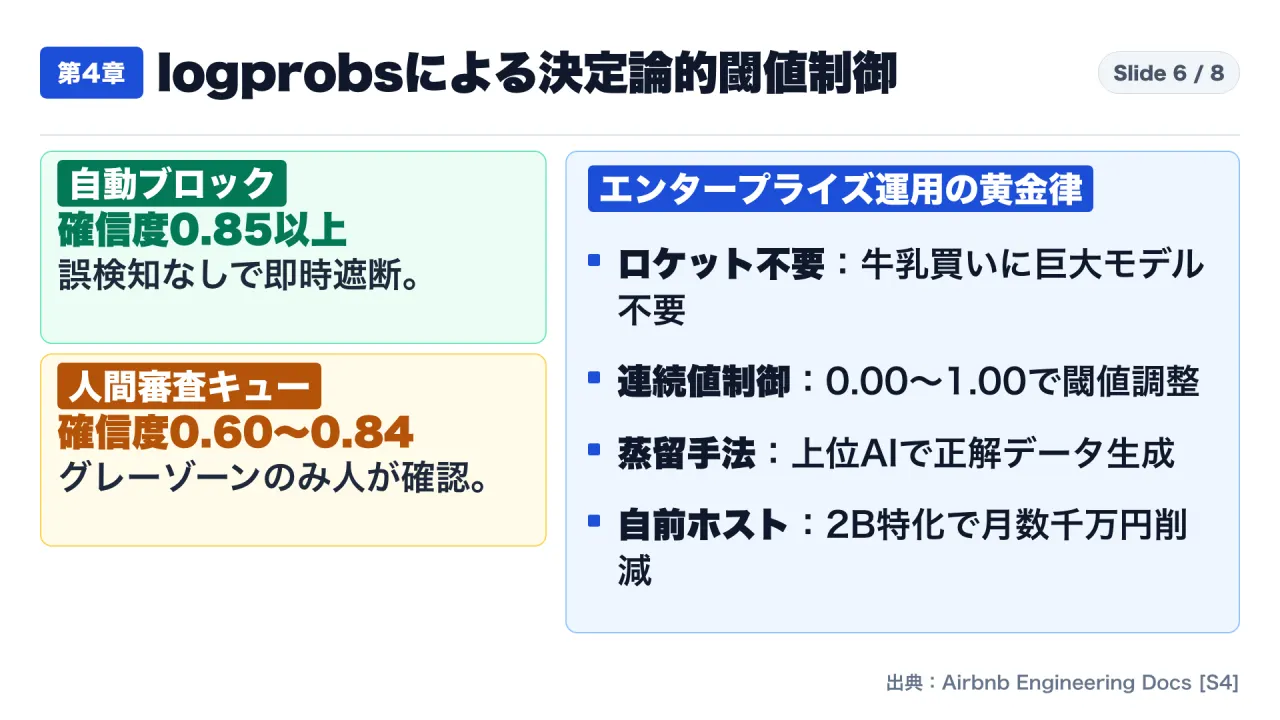
これに対し、自前でホストする小型モデル(vLLM経由)であれば、生成トークンの対数確率(logprobs)を抽出し、違反判定トークンの事後確率を0.00から1.00までの客観的な連続確信度スコアとして直接取得できます。
flowchart TD
    subgraph Pipeline["【Airbnb型 3段階ハイブリッド審査パイプライン】"]
        Req["物件情報の投稿・更新リクエスト\n(毎分数千件)"] --> vLLM["単一GPU推論(vLLM)\n特化型2B小型モデル(35ms)"]
        vLLM --> Score["連続確信度スコア算出\n(logprobs: 0.00 〜 1.00)"]

        Score --> Thresh{"確信度スコア判定"}

        Thresh -- "スコア >= 0.85\n(明確な違反)" --> Block["自動ブロック・修正要求\n(人間不要・即時完了)"]
        Thresh -- "0.60 <= スコア < 0.85\n(判断微妙なグレーゾーン)" --> HumanQueue["人間の専門審査スタッフキューへ転送\n(全体のわずか数%に抑制)"]
        Thresh -- "スコア < 0.60\n(正常なコンテンツ)" --> Pass["即時自動承認・公開\n(35msでユーザー体験を阻害せず)"]
    end
スライダー1つでビジネスリスクを調整できる威力
この3段階パイプラインの導入により、Airbnbは以下の運用自由度を手に入れました。
- 誤検知リスクの完全制御: 0.85以上の確信度を持つコンテンツのみを自動ブロックするため、無実のホストが機械的に締め出される事故がゼロ化。
- 審査スタッフ工数の劇的削減: 人間が目視確認しなければならないのは0.60〜0.84のわずかなグレーゾーンのみとなり、人件費とトリアージ時間を激減。
- 動的な閾値チューニング: キャンペーン期間中や不正利用の多発時期など、ビジネス状況の変化に応じて閾値を「0.85」から「0.80」へ変更するだけで、システム全体のセキュリティ強度をミリ単位で調整可能。
6. アーキテクチャ考察:「なんでもフロンティア」を卒業する設計指針
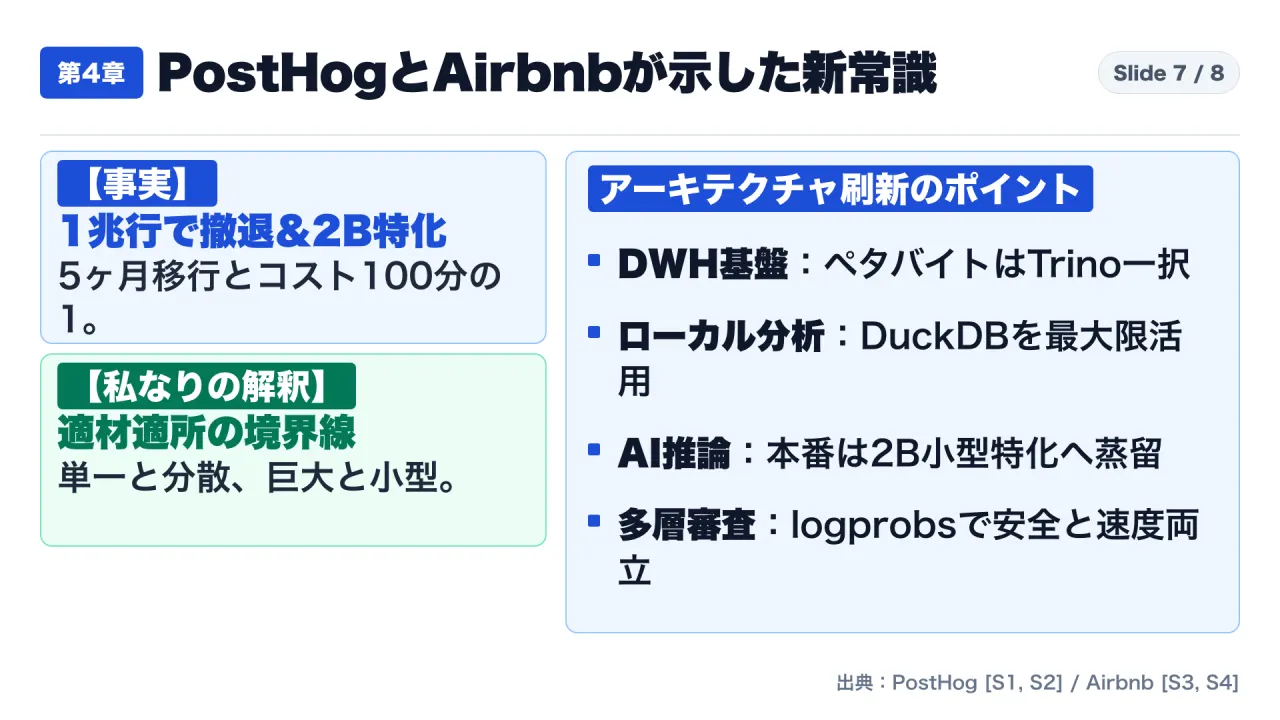
PostHogとAirbnbという、一見すると異なる領域の2つの事例は、現代のシステムエンジニアリングに対してまったく同じ教訓を突きつけています。それは**「道具の持つ前提条件と、解くべき課題のスケール特性を正しく一致させる」**というアーキテクチャの基本です。
「近所のコンビニにロケットエンジンで買い物に行く」設計の終焉
現在、日本のDXやAI導入プロジェクトにおいて頻繁に見られるアンチパターンが、「社内文書のルーティング」「問い合わせのカテゴリー分類」「定型テキストのフォーマット変換」といった比較的単純なタスクに対して、思考停止で最上位の商用フロンティアモデルをAPI連携させている構成です。
最上位フロンティアモデルは、医学、法律、高等数学、哲学からクリエイティブライティングまで、人類のありとあらゆる知識を包含しているからこそ、数千億から数兆パラメータという天文学的なサイズを誇り、高価な計算資源を消費します。 しかし、現場の個別業務タスクが必要とする知識は、その巨大な知識空間の「針の穴」ほどの極小領域に過ぎません。その針の穴のタスクを解くために、毎回全知識を抱えた巨大エンジンを駆動するのは、近所のコンビニに牛乳を買いに行くためだけにロケットエンジンに点火しているようなものです。
適材適所を導く2大黄金律
- データ基盤の黄金律:
- 開発者のローカルマシン、CIパイプライン、小規模なPoC、AIエージェントが一時的にSQLを実行する作業メモリとしては、DuckDBが今でも地球上最高のツールです。
- 一方で、データ量がテラバイト〜ペタバイトを超え、不特定多数のユーザーが予測不能なクエリを同時に実行するクラウド基盤では、最初から分散実行のために設計されたTrino、ClickHouse、SnowflakeなどのMPP基盤と、Iceberg / HogLakeのようなオープンテーブルフォーマットを選択しなければなりません。
- AI基盤の黄金律(蒸留ハイブリッド):
- システム開発の初期フェーズ(要件定義・プロトタイプ)や、正解データ(Golden Dataset)を作成する段階では、最上位フロンティアモデルをプロンプトで叩いて最高の出力を得るのが最も速い。
- しかし、本番環境で月間数十万回、数百万回叩かれる高頻度エンドポイントに達したら、その正解データを使って2B〜7Bクラスのオープンウェイト小型モデルを特化学習(Fine-tuning)し、vLLMなどの自前インフラでホストする。これによってコストは100分の1、速度は数十倍へと跳ね上がります。
7. 結論:明日から現場で実践する3つのアクションアイテム
最後に、明日からの実務開発やプロジェクトのアーキテクチャ設計において、今すぐ実践できる3つのアクションアイテムを提示します。
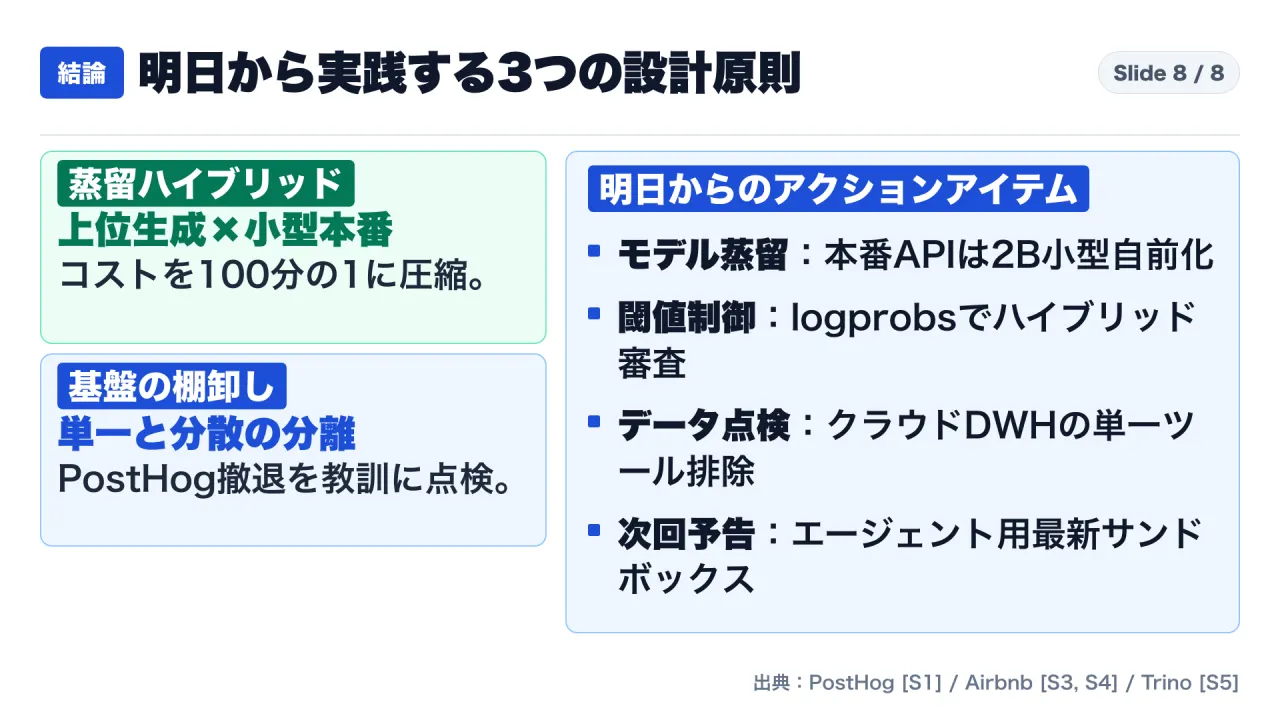
- 自社システムの「フロンティアモデルAPI請求明細」を点検する:
- クラウドの利用明細を確認し、「単なる分類、要約、エンティティ抽出なのに、高価な最上位フロンティアモデルを毎月何十万回も叩いているエンドポイント」がないかを洗い出してください。それらはすべて、2B〜7Bの小型特化モデルへ移行することでコストを99%削減できる最優先候補です。
- logprobsを活用した「3段階ハイブリッド審査」をPoCで試す:
- モデルの出力を単なる文字列として受け取るのをやめ、vLLM等の推論サーバーからlogprobsを取得して確信度スコアを算出してください。0.85以上の自動処理と、中間ゾーンの人手トリアージを組み合わせることで、システムの安全性とスループットを同時に極限まで高めることができます。
- データ基盤における「単一ノード前提」の過信を改める:
- 自社のDWHやデータ基盤において、ローカルでの成功体験を引きずったまま、単一マシン前提のツールを無理やりクラウドマルチテナントでスケールさせようとしていないか、PostHogの撤退レポートを題材にチーム内でアーキテクチャの棚卸しを実施してください。
参考・一次資料リンク一覧
- PostHog Engineering Blog: Why We’re Moving Our Warehouse Product Off DuckDB: https://posthog.com/blog/moving-off-duckdb
- GitHub PostHog/hoglake: Petabyte-Scale Open Table Format: https://github.com/PostHog/hoglake
- Airbnb Tech Blog: Frontier Quality at 1% of the Cost: A Production Benchmark of LLM Classifiers: https://airbnb.tech/ai-ml/frontier-quality-at-1-of-the-cost-a-production-benchmark-of-llm-classifiers/
- Airbnb Engineering Documentation: GLOWC fine-tuning and logprobs thresholding: https://airbnb.tech/ai-ml/glowc-fine-tuning-and-logprobs-thresholding/
- Trino Official Documentation: Distributed MPP Query Engine Concepts: https://trino.io/docs/current/overview/concepts.html
- vLLM Official Documentation: High-Throughput Single-GPU Serving: https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
動画での解説
{{YOUTUBE_URL}}
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48