なぜRippleとBeamの差は同じ試験で変わるのか?──自己申告の評価表と確かめる3つの手順
YouTubeポッドキャスト本編(動画・音声)はこちら:Ripple-65Bの評価表が示すことと、自社のサーバーで試す前に確かめる3つの手順
https://www.youtube.com/@consuloji
この記事が役立つ人と、読んだあとにできること
公開された AI モデル(重みが手に入るモデル)を、自社のサーバーで試すか選ぶ、開発・情報システム・企画の担当の方と、その上司の方に向けた記事です。「650億パラメータの小型モデルが、何倍も大きなモデルを抜いた」「開発費は10分の1」という見出しを見て、試すか迷っている場面を想定しています。
読み終えると、次の3つができるようになります。
- 比較表の点数を、「誰が、どの道具で測った値か」で読み分ける。
- 動かす前に、重みの容量と、使う窓口の文脈の上限を確かめる。
- 自社の課題を3つ選び、同じ設定で試して、結果を記録する。
結論:80.5点はリカーシブ自身の表の値。同じ表の別の行では、差が0.4点から9.7点に変わる
結論から書きます。Ricursive Intelligence(リカーシブ・インテリジェンス)が2026年11月4日に公開した Ripple-65B Preview(リップル)の、Terminal-Bench 2.1 での点数は80.5です。これは、開発元が作ったモデルカードの表の値です。
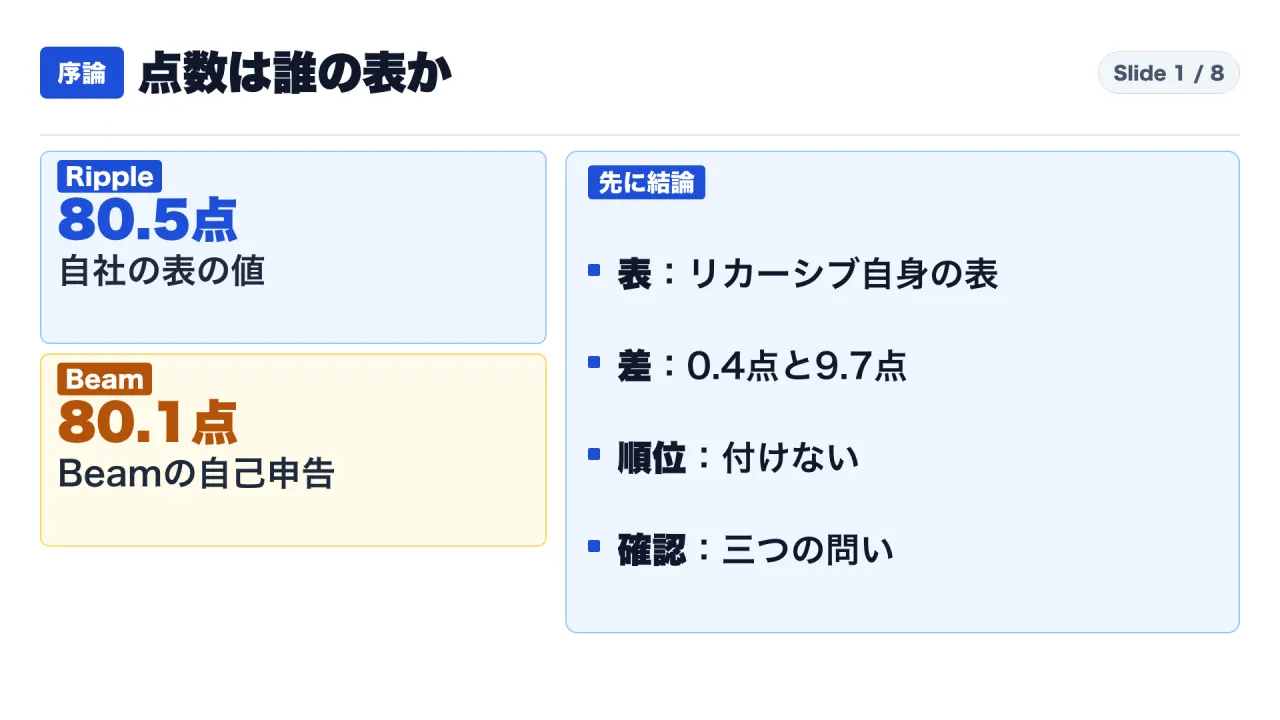
同じ表には、Terminal-Bench 2.1 の行が2つあります。
| 行 | Ripple | Beam | Muse Spark Open | Inkling | Nemotron 3 Ultra |
|---|---|---|---|---|---|
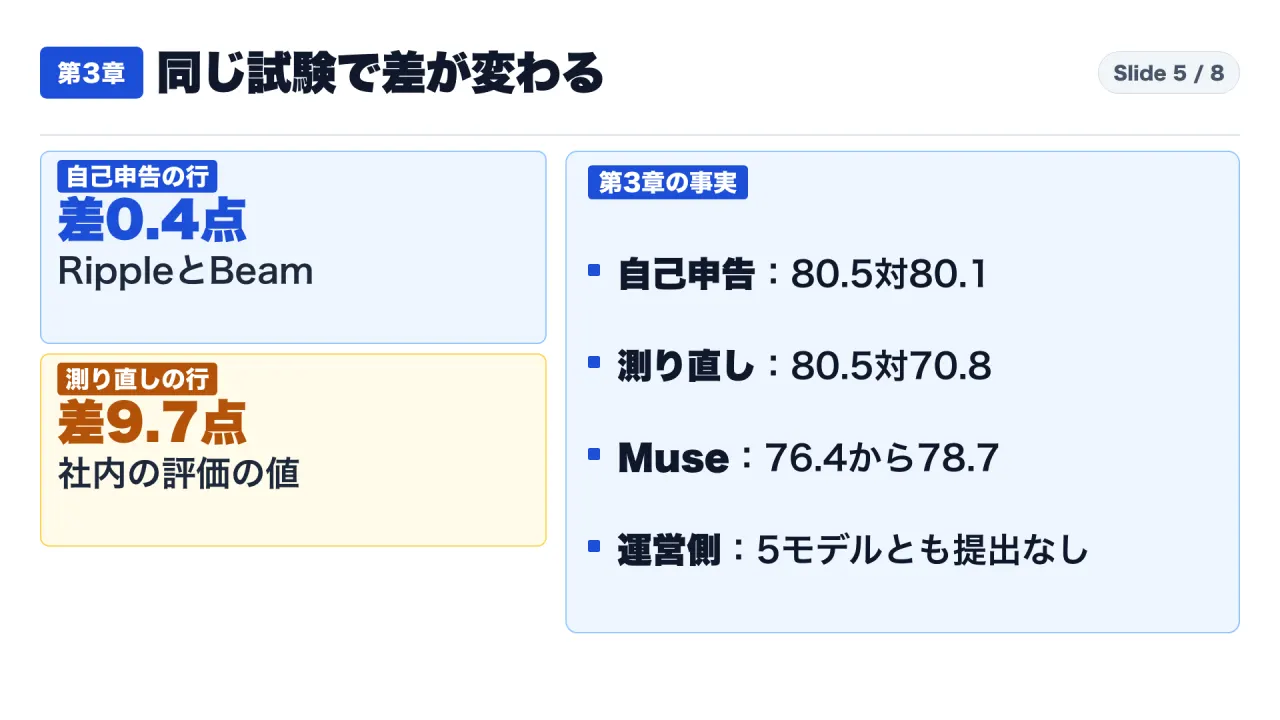
| 自己申告(self-reported) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminus 2 | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
(表の出典はリカーシブのモデルカード。Terminus 2 の行の相手の値は、斜体で、リカーシブの社内評価と示されています。)
私の計算では、Beam との差は、1つ目の行で0.4点、2つ目の行で9.7点です。2位と3位も入れ替わります。測った人も、使った道具も違うため、この記事では「出所により異なる」とだけ書き、順位は作りません。
この記事は、売買の判断や投資の助言を含みません。
読み方:事実、測った人、私の解釈を分けます
- 事実:各社の公式ページ、モデルカード、運営側のページに書いてあること。出典を付けます。
- 測った人:点数ごとに、誰が測った値かを添えます。
- 私の解釈:「私の計算」「私の読み」「私の提案」と書いた部分です。断定ではありません。
新しいモデルの紹介では、同じ分野の代表的なモデルと比べます。今回の比較相手は、リップルのカードの表に載る4モデルです。数字は、リップルのカード、各社の公式カード、試験の運営側の資料だけから取りました。取得日は、すべて2026年11月5日です。
用語:先に言葉をそろえます
- 重み:学習で身についた、モデルの中身そのものです。手元で動かすのに必要です。
- パラメータ:モデルの中にある、調整用の数です。
- dense(デンス):全部のパラメータが、毎回働く作りです。専門家を切り替える方式(MoE)は使いません。
- トークン:AI が文章を数える小さな単位です。
- 文脈の長さ:一度に読ませられる量の上限です。
- ハーネス:AI に命令を打たせて、結果を返す、外側の仕組みです。
- ロールアウト:AI が1つの課題を、最初から最後まで試す、1回分の試行です。
- Terminal-Bench 2.1:AI にコマンド操作の課題を解かせる試験です。運営側のページには、課題のフォルダが89個あります。
比較に出てくる4つのモデル
リップルのモデルカードは、比較の相手を、次のように呼んでいます。いずれも、米国の公開モデルとして並べられています。
- Reflection Beam 501B:Reflection の公開モデルです。専門家を切り替える方式(MoE)で、総パラメータは501B、動く部分は23Bです。
- Meta Muse Spark Open 816B:Meta の公開モデルです。MoE で、総パラメータは816B、動く部分は42Bです。
- Thinking Machines Inkling 975B:Thinking Machines の公開モデルです。MoE で、総パラメータは975B、動く部分は41Bです。
- NVIDIA Nemotron 3 Ultra 550B:NVIDIA の公開モデルです。MoE で、総パラメータは550B、動く部分は55Bです。
これらの数字は、リップルのモデルカードの表に書かれている値です。
問い1:何が公開されたのか
公開日と中身
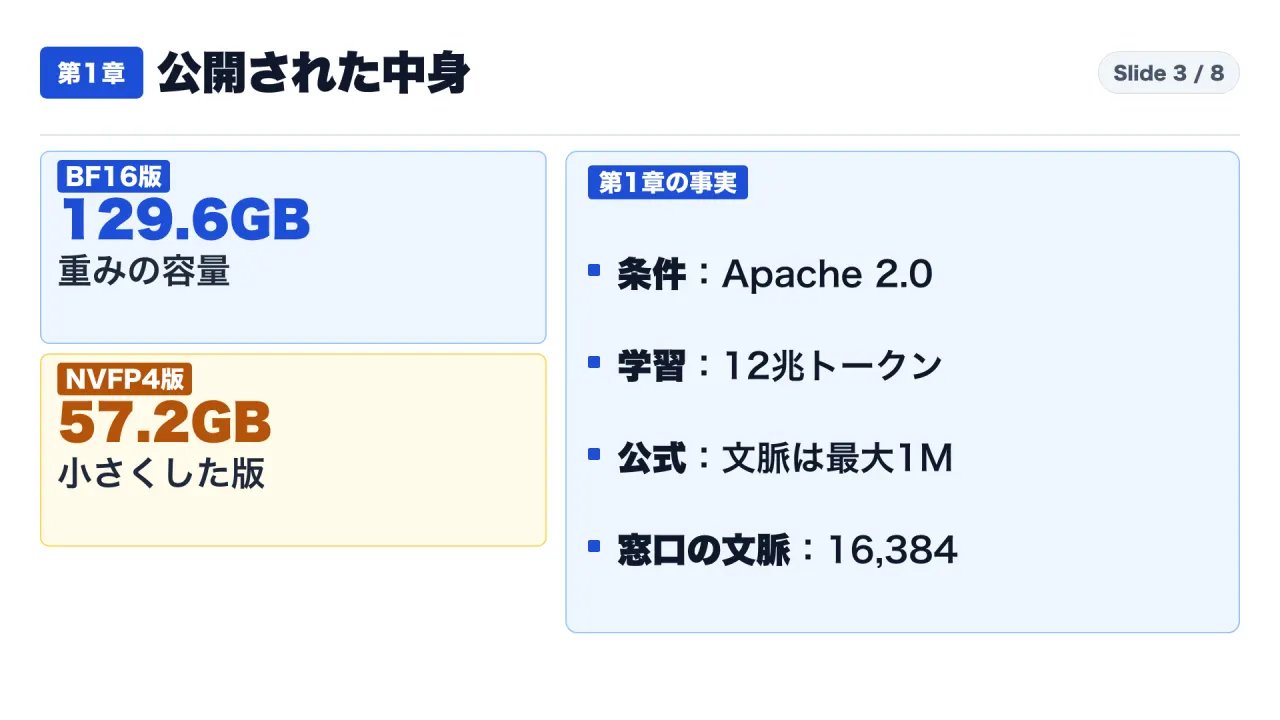
OpenRouter のモデルページは、リップルの公開日を2026年11月4日としています。リカーシブのブログによると、リップルは、同社の AI チップ設計の道具に使う社内モデルの、汎用版です。12兆トークンで事前学習し、最大1Mトークンの文脈に対応すると書かれています。
作りは dense で、モデルカードは、専門家を切り替える方式を使わなかった理由を、インフラの複雑さを減らすためと説明しています。ライセンスは Apache 2.0 です。
公開された重みと、容量
モデルカードによると、公開されたのは、指示に従うよう調整した版が2つ(BF16版、NVFP4版)と、調整前のベース版です。Hugging Face の置き場のファイル一覧から、私がファイルの大きさを足し合わせた値は、次のとおりです。
| 版 | 重みのファイル数 | 合計の大きさ(自前計算) |
|---|---|---|
| BF16版 | 16個 | 129,565,519,472バイト(約129.6GB) |
| NVFP4版 | 6個 | 57,213,852,024バイト(約57.2GB) |
容量の見積もりの考え方(私の計算)
ファイルの大きさから、1つのパラメータあたりの大きさを逆算できます。BF16版は、129,565,519,472バイトを、パラメータ数64,782,689,360で割ると、約2.0バイトです。NVFP4版は、57,213,852,024バイトを同じ数で割ると、約0.88バイトです。パラメータ数は、Hugging Face のモデル情報に載る値です。
つまり、同じモデルでも、数の持ち方を小さくすると、容量は半分以下になります。一方で、Beam のカードは、BF16版80.1、FP8版78.9、NVFP4版78.4と書いており、容量を減らした版では、点数が少し下がっています。リップルの NVFP4版の点数は、私が読んだ範囲では、見つかりませんでした。容量を減らした版を使うときは、自社の課題で、点数の下がり方を確かめる必要があります。
置き場には、モデルの定義を書いたファイル(modeling_ricursive.py)も入っています。私の提案として、自社の環境で外部のコードを実行してよいか、規則を確認してください。
重みの容量は、メモリに載せるときの最低の目安です。会話の記憶などの分も、実行時にはメモリが要ります。
使える場所と、文脈の上限
リカーシブのブログは、Hugging Face、Together AI、GMI Cloud、OpenRouter で使えると書いています。ところが、文脈の上限は、窓口で違います。
| 出どころ | 文脈の長さ |
|---|---|
| リカーシブのブログ | 最大1M |
| 設定ファイル(max_position_embeddings) | 2,097,152 |
| OpenRouter の提供情報 | 16,384(提供元は GMI Cloud の1社) |
| Together AI のページ | 説明は「1M context」。同じページに、サーバーレスは「coming soon」 |
私の計算では、1,000,000÷16,384は約61です。公式の「最大1M」と、OpenRouter の窓口で使える長さは、約60倍違います。OpenRouter の料金は、100万トークンあたり、入力0.20ドル、出力0.60ドルです。
私の提案です。「100万トークン対応」と聞いたら、使う窓口のページで、上限を先に確かめてください。
カードが書く、作りと学習のこと
モデルカードは、作りと学習について、次のように書いています。どれも同社の記述で、私は検証していません。
- 作りは、幅が狭く、層が深い形です。幅(d_model)は5120、層は80です。
- 注意の仕組みの一部に、窓の狭い方式(スライディングウィンドウ)を使い、窓の大きさは設定ファイルで1024です。
- 事前学習の効率は、先行する公開の学習手順(Olmo 3)に比べ、コードで16倍よい、と書かれています。
- 開発の人数は、1人から5人に増えた小さなチームだった、と書かれています。
- 後学習は、比較的軽く、エージェントとしてのコード作業に重点を置いた、と書かれています。
私の読みです。「小さなチームが、短い期間で作った」という物語は、開発費3200万ドルの主張と、同じ向きの記述です。ただし、どちらも同社の記述で、ほかの資料では確かめられていません。
問い2:表の点数は、誰が、どの道具で測ったのか
表の注記
リップルのモデルカードの注記は、次のように書いています。
- 全部のモデルを、フルの精度(BF16)と、最大の推論の設定で試した。
- 公式のカードに値があれば、それを使う。無い所は、自社の評価で埋めて、斜体で示す。
- SWE-bench Pro v2.0 Hard と DeepSWE 1.1 は、Ripple に Terminus 2 を使う。ほかで道具が決まっていないものは、OpenCode を使う。相手のモデルに何を使ったかは、この注記からは読み取れません。
- Terminal-Bench 2.1 は、公式の Terminus 2(長い文脈、要約あり)で測ると、Muse Spark Open を除いて、点数が下がった。そのため、できるだけ公平な比較を試みた。
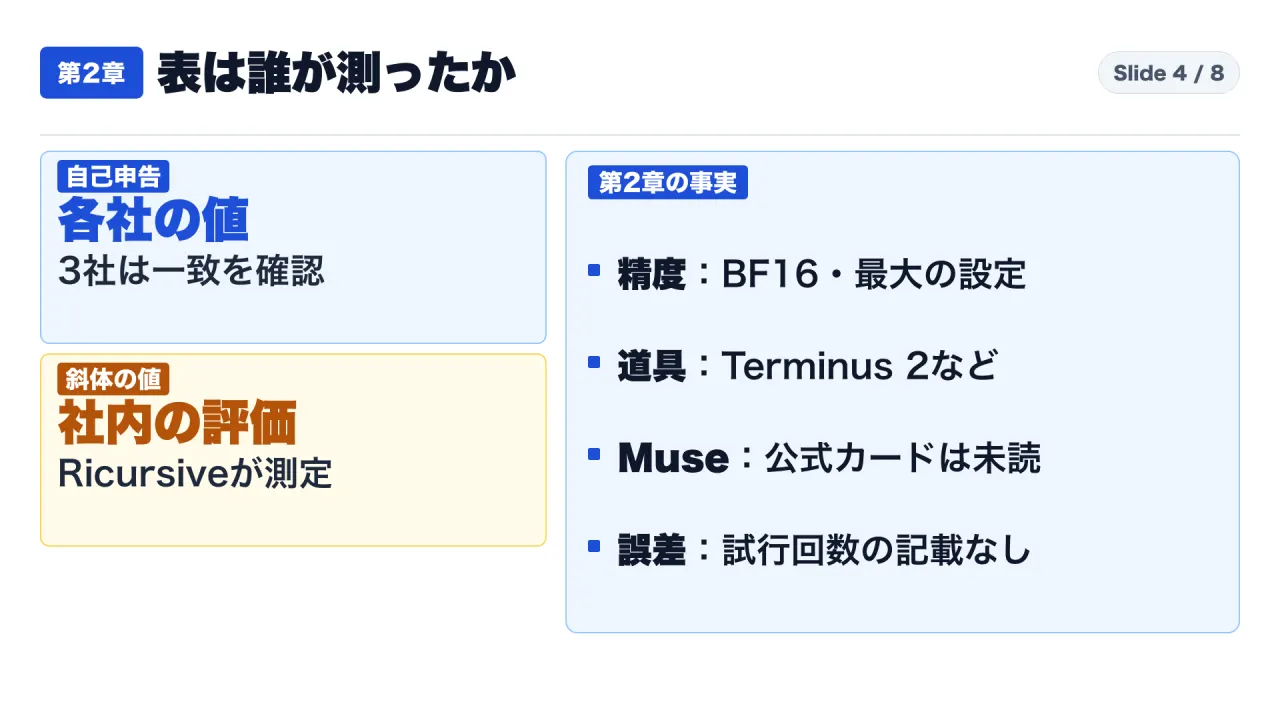
自己申告の行の相手の値を、各社の資料で確かめた
| 相手 | 表の値 | 各社の資料 |
|---|---|---|
| Beam | 80.1 | Beam のカードは、BF16版80.1、FP8版78.9、NVFP4版78.4。温度0.7。道具の名前の記載なし |
| Inkling | 63.8 | Inkling のカードは「Best Harness」の行で63.8。推論の強さは0.99 |
| Nemotron 3 Ultra | 56.4 | Nemotron のカードは56.4。Harbor という枠組みと、AWS ECS の隔離環境を使ったと記載 |
| Muse Spark Open | 76.4 | 公式カードは承認制で、私は読めていません。Hugging Face の一覧の行に、76.4と「Run with the Terminus 2 agent.」の記載 |
つまり、自己申告の行の相手の値は、3社分は各社のカードで確かめられました。ただし、設定は各社でばらばらです。Muse Spark Open は、一覧の行を介した値です。
問い3:同じ試験の2つの行で、何が変わるのか
差と順位
| 相手 | 自己申告の行 | Terminus 2の行 | 開き(自前計算) |
|---|---|---|---|
| Beam | 80.1 | 70.8 | −9.3 |
| Muse Spark Open | 76.4 | 78.7 | +2.3 |
| Inkling | 63.8 | 56.2 | −7.6 |
| Nemotron 3 Ultra | 56.4 | 55.1 | −1.3 |
Ripple を除いた順位は、自己申告の行で Beam、Muse Spark Open、Inkling、Nemotron の順です。Terminus 2 の行では、Muse Spark Open、Beam、Inkling、Nemotron の順です。どちらが正しいかは、言えません。1つ目は各社が自分の設定で測った値、2つ目はリカーシブが自分の道具で測り直した値だからです。
同じ試験で、点数が動く理由(私の読み)
Terminal-Bench のような試験では、モデルの賢さのほかに、いくつもの条件が点数に入ります。AI に命令を打たせる外側の仕組み(ハーネス)の種類、文脈の長さ、途中の要約の有無、推論の強さ、温度などの設定、課題を何回試すか、です。リカーシブのカードも、「最新のエージェント系の試験は、点数が動く要因が多く、再現が難しい」と書いています。
たとえるなら、同じ料理人でも、厨房の道具と制限時間が違えば、出来が変わります。表の2つの行は、道具が違う2つの厨房の記録のようなものです。どちらの厨房が公正かは、この表だけでは決められません。
読み方の練習:自己申告の行だけを見ると、何が起きるか
仮に、自己申告の行だけを見たとします。リップル80.5、Beam80.1で、「リップルが勝った」と読みたくなります。ところが、同じ表の下の行を見ると、Beam は70.8になっています。Beam の自己申告の80.1は、Beam のカードにある値で、設定は温度0.7、道具の記載なしです。下の行の70.8は、リカーシブが公式の Terminus 2 で測り直した値だと、注記から読めます。
どちらかが間違いというより、物差しが違います。点数を見たら、その値を測った人と道具を、すぐ隣に書き添える。この習慣があれば、「80.5対80.1」という見出しを見ても、慌てずに済みます。
同じ道具で、同じモデルが違う値になる例
Muse Spark Open は、自己申告の行の76.4が、Hugging Face の一覧で「Terminus 2 で実行」と注記されています。ところが、リカーシブが Terminus 2 で測り直した値は78.7で、差は+2.3点です。道具の名前が同じでも、文脈の長さ、要約の有無、試行の回数などの設定が違えば、値は動きえます。私の読みです。この例は、0.4点の差が、測るたびの揺れの中にありうることを示唆します。ただし、揺れの大きさは、資料からは分かりません。
0.4点の差の大きさ
リカーシブのカードには、試験を何回測ったかも、誤差の幅も、書かれていません(私が本文を検索して、見つからなかった範囲)。運営側のページには、課題のフォルダが89個あります。私の計算では、100÷89は約1.1で、1回だけ測った場合は、1課題が約1.1点です。0.4点の差は、1回だけ測った場合なら、課題1つ分より小さい差です。何回測ったかが分からないので、これ以上は言えません。
試験の運営側の確認
試験の運営側の README は、「コミュニティからの提出は、いま閉じている。運営側が実行した結果だけを、順位表に加える」と書いています。運営側の提出の一覧(2026年11月5日取得)は20件で、Ripple、Beam、Muse Spark Open、Inkling、Nemotron のいずれの名前も、含まれていません。
Hugging Face の Terminal-Bench 2.1 の一覧は、42行です。全部に検証済みの印がなく、源は各社のカードです。Ripple の行は、まだありません。上位は、DeepSeek-V4.1-Flash の90.6、MiMo-V2.6-Pro-RL の89.9、GLM-5.3 の88.2です。公式ブログの見出しは、英語で「Achieving U.S. Open-Weight SOTA on Agentic Coding」(エージェント型のコーディングで、米国の、重みが公開されたモデルの中で、最高水準を達成)です。範囲は、エージェント型のコーディングと、米国の、重みが公開されたモデルに限られています。ただし、一覧の値はどれも各社の自己申告で、設定はそろっていません。
なお、運営側の順位表(tbench.ai)は、取得した本文から2.1の表を読めませんでした。そのため、運営側の GitHub の提出一覧を直接読みました。順位表の画面そのものは、確認できていません。
点数の別の行は、出所つきで並べる
カードの表の別の行も見ておきます。斜体の値は、リカーシブの社内評価です。斜体でない値は、カードの注記によると、各社の公式カードの値です。測った人も設定もそろっていないので、行の中の順位は作りません。値と出所だけを並べます。
| 試験 | Ripple | Nemotron 3 Ultra | Inkling | Muse Spark Open | Beam | Ripple の道具(カードの注記) |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 76.5 | 71.9 | 77.6 | 78.7 | 81.6 | 指定なし(決まっていない場合は OpenCode と注記) |
| SWE-bench Pro v1.0 | 61.42 | 46.9 | 54.3 | 58.2 | 66.1 | 指定なし(同上) |
| SWE-bench Pro v2.0 Hard | 79.1 | 30.7 | 2.0 | 52.3 | 76.5 | Terminus 2(Ripple のみ) |
| DeepSWE 1.1 | 44.3 | 0.2 | 1.8 | 60.0 | 43.3 | Terminus 2(Ripple のみ) |
SWE-bench Pro v2.0 Hard の行では、Ripple だけが Terminus 2 で測られています。Beam の76.5は Beam のカードの値で、残りの3モデルはリカーシブの社内評価です。測った人も道具もそろっていないので、この行は、出所により異なる、とだけ言えます。DeepSWE 1.1 の行も、Ripple だけが Terminus 2 です。カードの注記だけでは、相手のモデルに何を使ったかは、読み取れません。
点数以外の行は、どう見えるか
モデルカードの表には、知識、数学、安全性、長い文脈などの行もあります。これらの行も、測った人と設定が行ごとに違います。値だけ挙げます。GPQA Diamond は、Ripple が85.2、Beam が90.6です。MMLU は、Ripple が89.6、Muse Spark Open が92.6です(Muse Spark Open の値は、リカーシブの社内評価を示す斜体)。AIME 2025 は、Ripple が98.3、Muse Spark Open が100.0です(同じく斜体)。IFBench の行では、Ripple は79.2、Nemotron は81.7、Inkling は79.8、Beam は79.6です。
私の読みです。公式ブログの見出しは、エージェント型のコーディングについての言い方です。知識、数学、安全性の行は、その見出しの対象ではありません。点数は、行ごとに、測った人と道具を添えて読みます。
比較表を読む5つの手順(私の提案)
新しいモデルの発表で、比較表を見たときの、確かめる順番です。
- 表の注記を最初に読む。斜体や星印が、誰の測定かを示していないか確かめます。
- 行ごとに、道具(ハーネス)と設定の名前が書かれているか確かめます。書かれていなければ、「不明」と記録します。
- 相手の値を、その相手の公式カードと突き合わせます。一致しない場合は、どちらが新しいか、設定が同じかを見ます。
- 試験の運営側の順位表や提出一覧に、同じモデルがあるかを見ます。なければ、「運営側の確認なし」と記録します。
- 差が小さい行は、試行回数と誤差の幅が書かれているかを見ます。書かれていなければ、勝ち負けを言いません。
この5つは、今回のリップルの表で、私が実際にたどった順番です。1時間ほどで済みます。
大きさと費用の主張
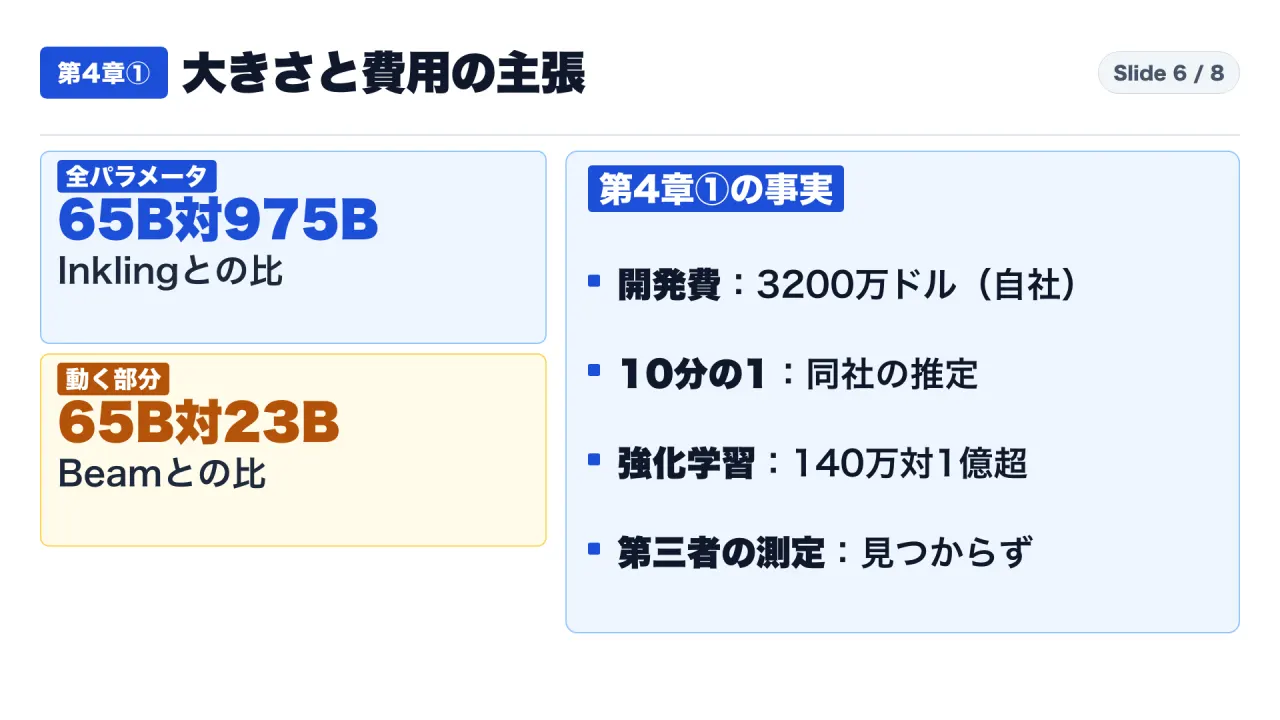
総パラメータと、動く部分
| 項目 | Ripple | Nemotron 3 Ultra | Inkling | Muse Spark Open | Beam |
|---|---|---|---|---|---|
| 総パラメータ | 65B | 550B | 975B | 816B | 501B |
| 動く部分 | 65B | 55B | 41B | 42B | 23B |
「大きなモデルに勝った」は、総パラメータの話です。動く部分で見ると、Ripple は4つの相手より大きい。大きさの比べ方で、見え方が変わります(私の読み)。
開発費3200万ドルと「10分の1」
リカーシブは、リップルの開発費を3200万ドルと書いています。事前学習だけでなく、実験、評価、データ作り、後学習まで含めた、全部の研究開発費だとのことです。「先行の最高の公開モデルの10分の1」は、同社が知る範囲での推定という注つきです。推定の根拠は、脚注にあります。ほかの会社が、SpaceX の計算資源に月1.5億ドルを約束したと報じられたこと、Beam の学習が事前学習4週間、後学習4週間と報告されたことです。
Beam を作った Reflection のブログには、費用の金額は書かれていません。書かれているのは、後学習の強化学習で1億回を超えるロールアウトを生成したこと、事前学習が4週間未満だったことです。リップルの強化学習は、140万回のロールアウトで、Beam の約70分の1と書かれています。私の計算では、1億÷140万は約71で、公式の約70分の1と合います。ただし、1回の試行の長さや中身は違うので、回数だけでは、手間を比べられません。
3200万ドルは同社の申告で、ほかの会社の費用は同社の推定です。この2つを並べた「10分の1」は、確かめられていません。独立した第三者の測定は、今回、見つけていません。
章ごとの、確かめるポイント(私の提案)
- 公開された物を見るとき:重みの容量、ライセンス、定義のファイルの有無、窓口ごとの文脈の上限を、書き出します。
- 表の注記を読むとき:斜体や星印が誰の測定か、道具の名前が書かれているかを見ます。
- 同じ試験の行を比べるとき:行ごとに測った人が違うなら、順位を作らず、「出所により異なる」と記録します。
- 大きさと費用の主張を見るとき:総パラメータと動く部分を分けます。費用は、申告か、推定か、第三者の確認かを分けます。
私なりの解釈:公開は前進、順位は保留、動かす前の確認が決め手
- 公開されたことは、前進です。重みと、定義のファイルと、ライセンスが手に入ります。
- 80.5は、強い手がかりです。ただし、順位ではありません。測った人と道具が、行ごとに違うからです。
- 「小さいのに勝つ」と「10分の1の費用」は、同じ会社の、同じページの主張です。確かめる材料が、まだ出ていません。
言えないことは、次の4つです。独立した測定での順位。Beam などの、リップルと同じ設定での値。3200万ドルと10分の1の裏付け。自社の課題での出来です。
制作の裏側も書きます。最初の下調べの資料では、容量がサードパーティのブログにしか見つからず、モデルカードも読めていませんでした。Hugging Face の置き場から、ファイルの大きさを直接足すと、129.6GBと57.2GBでした。出どころを1つ戻って確かめる習慣が、表を読むときの一番手前にあります。
明日できること:3つを書き出す(私の提案)
自社で動かしたいモデルを1つ決めて、次の3つを書き出してください。
- 重みの容量(129.6GBか57.2GB)と、手元のメモリを並べる。
- 使う窓口(OpenRouter、Together AI など)の、文脈の上限を、そのページで確かめる。
- 自社の課題を3つ選び、同じ設定で、今使っているモデルと、リップルに解かせる。正しさ、かかった時間、費用を並べて記録する。
自社で試すときの設計例(私の提案)
「自社の課題で試す」を、もう少し具体的にします。
課題の選び方
- 実際の仕事から、3件選びます。コード修正、ログの調査、設定ファイルの作成など、手順が文章にできるものが向いています。
- 正解が、人が見て判定できる課題にします。判定の基準を、試す前に書いておきます。
- 機密や個人情報を含む資料は、使いません。
同じ設定で比べる
- 今使っているモデルと、リップルに、同じ指示文、同じ道具、同じ文脈の長さで解かせます。
- 窓口(OpenRouter など)を使う場合は、その窓口の文脈の上限を先に確かめます。上限が16,384なら、長い資料を渡す課題は、そのままでは試せません。
- 自社のサーバーで動かす場合は、重みの容量(129.6GBか57.2GB)と、メモリを並べて、載るかどうかを先に見積もります。
試す費用の見積もり例(私の計算、仮定つき)
OpenRouter の料金は、100万トークンあたり、入力0.20ドル、出力0.60ドルです。仮に、1課題で入力3,000トークン、出力1,000トークンを使い、3課題を各5回試すとします。入力は3,000×15で45,000トークン、出力は1,000×15で15,000トークンです。料金は、0.20×0.045で0.009ドル、0.60×0.015で0.009ドル、合計で約0.018ドルです。数字は仮定で、実際の課題によって大きく変わります。
ここで気づく点があります。窓口の文脈の上限は、入力と出力を合わせて、16,384トークンです。最大出力は14,745トークンと表示されています。長い資料を丸ごと渡す課題は、この窓口では、そのままでは試せません。試す費用は小さくても、窓口の仕様で、試せる課題の範囲が決まります。自社のサーバーで動かすか、上限の大きい窓口を待つかは、課題の長さで決めてください。
記録のしかた
| 項目 | 書くこと |
|---|---|
| 課題 | 3件の内容と、判定の基準 |
| 設定 | 窓口、道具、文脈の長さ、温度 |
| 結果 | 成功か失敗か、かかった時間 |
| 費用 | 入力と出力のトークン数と、料金 |
これは、第三者の測定の代わりにはなりません。ただし、自社の仕事での出来を、自社の目で確かめられます。
よくある疑問
リップルは Beam より強いのですか。
この記事の資料からは、言えません。自己申告の行では80.5対80.1、Terminus 2 の行では80.5対70.8です。測った人と道具が違い、第三者の測定も見つけていません。
100万トークンの文脈は、使えますか。
公式ブログは「最大1M」と書いています。ただし、OpenRouter の提供情報では16,384でした。使う窓口の仕様を確かめてください。
手元で動かせますか。
カードは、DGX Spark のような機材に載せられると書いています。私は、この主張を確かめていません。重みの容量は、BF16版が約129.6GB、NVFP4版が約57.2GBです。
開発費3200万ドルは、本当ですか。
私は確かめていません。リカーシブは、全部の研究開発費だと書いています。ただし、ほかの会社の費用は同社の推定で、費用の内訳を第三者が確かめた資料は見つけていません。
Apache 2.0なら、自由に使えますか。
モデルカードの先頭に、apache-2.0と書かれています。置き場には LICENSE のファイルもあります。ただし、実際に使う前に、ライセンスの全文と、自社の規則を、法務や担当の方と確認してください。
運営側の提出一覧にないと、どうなるのですか。
運営側が実行した結果だけが、順位表に加わる、と運営側の README は書いています。提出一覧にないことは、点数が誤りという意味ではありません。運営側の確認を経ていない、という意味にとどまります。
点数が下がる Terminus 2 の行は、リップルに不利ですか。
カードの注記は、Terminus 2 では Muse Spark Open を除いて点数が下がったと書いています。ところが、リップルの値は、2つの行で同じ80.5です。なぜリップルの値が動かないのか、カードは説明していません。観察できる事実は、ここまでです。なお、注記は、道具が決まっていない場合は OpenCode を使うとも書いています。
日本語の仕事で使えますか。
モデルカードは、事前学習のデータを「英語とコードが中心」と書いています。日本語の出来については、カードに点数の行が見つかりませんでした。日本語の課題は、自社の課題3件に、必ず入れて試してください。
小さな版(NVFP4)の点数は分かりますか。
リップルの NVFP4版の点数は、私が読んだ範囲では見つかりませんでした。Beam のカードには、版ごとの点数がありますが、リップルのカードには、見当たりません。
この記事の結論を、もう一度
リップルの公開は、手元で試せる材料が増えたという意味で、前進です。一方で、「小さいのに勝つ」と「10分の1の費用」は、開発元の表と推定にとどまります。点数は、行ごとに、測った人と道具を添えて読む。動かす前に、容量と窓口の上限を確かめる。自社の課題3件で、同じ設定で試す。この3つが、見出しの強い言葉に流されないための、最小の手順です。どれも、特別な道具は要りません。表の注記を読む時間と、課題を3件書き出す時間があれば、始められます。また、運営側の確認が出たときは、この記事の表を、出所つきで更新してください。
確かめられなかったこと
- 運営側の順位表(tbench.ai)の画面。取得した本文から2.1の表を読めませんでした。
- Muse Spark Open の公式カード。承認制で読めていません。
- 開発費3200万ドルと「10分の1」の裏付け、独立した第三者の測定。
- Fireworks での提供開始。Together AI のサーバーレスの提供開始。
- 250 tok/s などの、同社の速度の主張。
上司に説明するときの、短い言い方(私の提案)
「リップルは、公開された650億のモデルで、Apache 2.0の重みが手に入ります。開発元の表では、コード操作の試験で、大きな公開モデルと並ぶ点数です。ただし、その表は開発元自身のもので、同じ試験でも、行によって差が0.4点から9.7点まで動きます。運営側の確認や、第三者の測定は、まだ見つかっていません。そこで、まず自社の課題3件で、同じ設定で試します。その前に、重みの容量と、使う窓口の文脈の上限を確認します」。
この言い方は、事実と、私の提案を分けています。売買や契約の判断は含みません。短くても、「誰の表か」「何が未確認か」「次に何をするか」の3点が入っていれば、相手は判断の材料として受け取れます。
数字を引用するときの注意
この記事の数字を、社内の資料に引用するときは、点数の隣に、次の3つを書き添えてください。誰が測った値か(開発元の自己申告か、リカーシブの測り直しか)。どの行か(self-reported か、Terminus 2 か)。取得日(2026年11月5日)です。出典のページは、あとで更新されることがあります。
この記事の作り方と、限界
この記事の数字は、すべて、2026年11月5日の朝に取得した資料から取りました。取得は、プログラムでページを読み、表の行や JSON の項目を、原文と突き合わせる方法で行いました。画面の目視には頼っていません。
- リカーシブのブログ、Hugging Face のモデルカード、設定ファイル、ファイル一覧は、同社の公開ページです。
- Beam、Inkling、Nemotron の数字は、各社のモデルカードと突き合わせました。Beam のカードは、表のセルが別々の行になるため、1行に書き直して照合しました。
- 試験の運営側の資料は、README と、GitHub の提出一覧のファイル名を読みました。
- 自前計算は、差、倍率、容量の合計、課題1つの点数です。算式は、主張の対応表に書きました。
限界も書きます。私は、測定をやり直していません。数字が正しいかは確かめておらず、各社のページに何が書かれているかを確かめただけです。「書かれていない」は、取得した本文を検索して見つからなかった範囲に限ります。
自分の判断に使うときの注意
この記事は、2026年11月5日に取得した資料を読んだものです。モデルカード、ページ、料金、順位表は、あとで更新されることがあります。判断に使うときは、最新の原文を直接確認してください。この記事は、売買の推奨、株価の予想、投資の助言、特定の製品の導入や契約の勧めを含みません。
YouTube本編:https://www.youtube.com/watch?v=cMzzU1mqrUQ
初めてこのチャンネルの記事を読まれた方は、https://note.com/consuloji_ch/n/n1975ecc3cf48 から読み始めてください。
出典一覧
- S1:Ricursive「Introducing Ripple-65B Preview」:https://www.ricursive.com/ripple
- S2:Hugging Face のモデルカード:https://huggingface.co/ricursiveAI/Ripple-65B-Preview/raw/main/README.md
- S3:置き場のファイル一覧(BF16版):https://huggingface.co/api/models/ricursiveAI/Ripple-65B-Preview/tree/main?recursive=1
- S4:置き場のファイル一覧(NVFP4版):https://huggingface.co/api/models/ricursiveAI/Ripple-65B-Preview-NVFP4/tree/main?recursive=1
- S5:OpenRouter の提供情報(API):https://openrouter.ai/api/v1/models/ricursiveai/ripple-65b-preview-20261104/endpoints
- S6:OpenRouter のモデルページ:https://openrouter.ai/ricursiveai/ripple-65b-preview
- S7:Together AI のモデルページ:https://www.together.ai/models/ripple-65b-preview
- S8:設定ファイル:https://huggingface.co/ricursiveAI/Ripple-65B-Preview/raw/main/config.json
- S9:Reflection「Introducing Beam」:https://reflection.ai/blog/introducing-beam
- S10:Beam のモデルカード:https://huggingface.co/reflection/Beam-1.0-501B-A23B/raw/main/README.md
- S11:Inkling のモデルカード:https://huggingface.co/thinkingmachines/Inkling/raw/main/README.md
- S12:Nemotron 3 Ultra のモデルカード:https://huggingface.co/nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-BF16/raw/main/README.md
- S13:Hugging Face の Terminal-Bench 2.1 の一覧(API):https://huggingface.co/api/datasets/harborframework/terminal-bench-2.1/leaderboard
- S14:運営側 README:https://raw.githubusercontent.com/harbor-framework/terminal-bench-2-1/main/README.md
- S15:運営側の提出一覧:https://github.com/harbor-framework/terminal-bench-2-1/tree/main/leaderboard/submissions
- S16:運営側の課題フォルダ:https://github.com/harbor-framework/terminal-bench-2-1/tree/main/tasks
- S17:Hugging Face のモデル情報(パラメータ数):https://huggingface.co/api/models/ricursiveAI/Ripple-65B-Preview