なぜ0.8B翻訳AIが27Bに勝ち10億円条項があるのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ0.8B翻訳AIが27Bに勝ち10億円条項があるのか?
2026年11月5日、国産AI開発の先駆者である株式会社Preferred Networks(PFN)は、翻訳特化型の大規模言語モデル「PLaMo 3 Translate」のオープンウェイト(モデル重み)をHugging Face上で一般公開しました。
公開されたラインナップは0.8B(8億)、2B(20億)、8B(80億)、31B(310億)の4種類のパラメータサイズで構成され、日本語・英語を含む53言語の翻訳に対応しています。
このモデル公開が産業界に与えた最大の衝撃は、**「わずか8億パラメータの極小モデル(0.8B)が、パラメータ数が30倍以上大きいGoogleの翻訳特化モデル『TranslateGemma 27B』や中国Tencentの『Hy-MT2』を日英翻訳で打ち負かした」**という定量的ベンチマーク結果です。
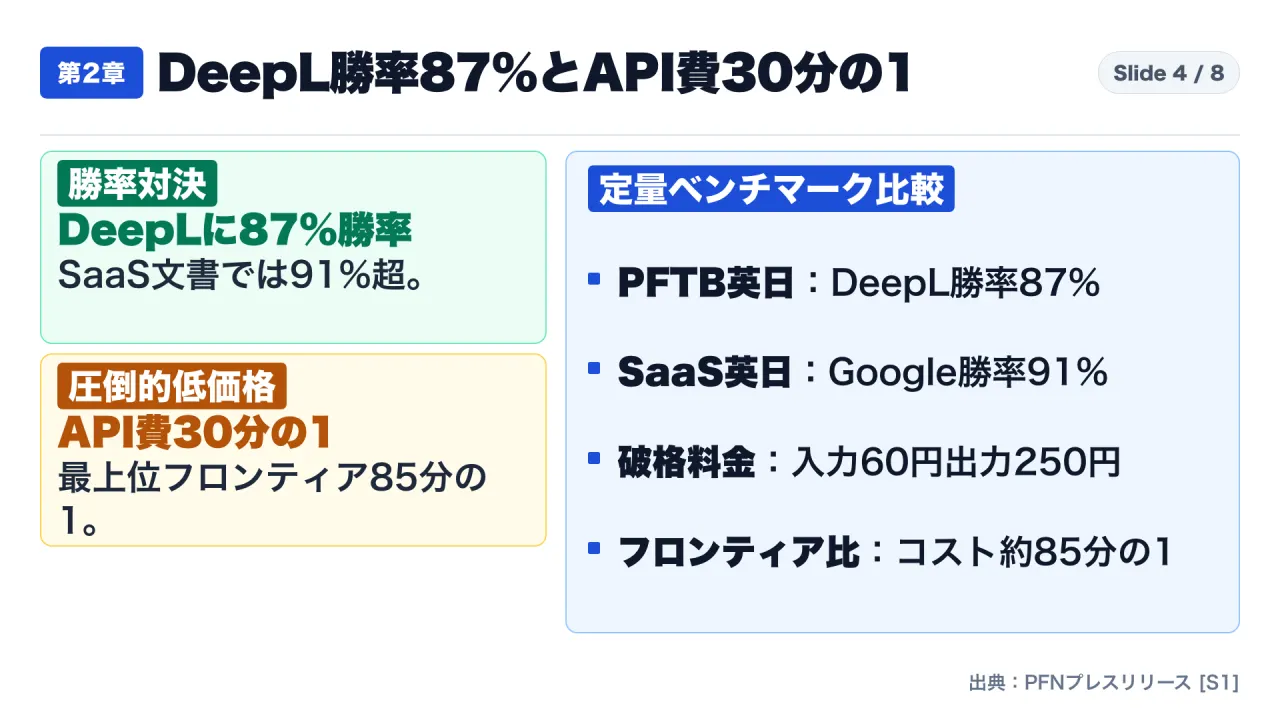
さらに、最大サイズの31Bモデルは商用APIの最高峰であるDeepL翻訳に対して勝率87.00%、Google翻訳に対して勝率91.47%を記録しながら、APIコストを約30分の1(最上位フロンティアモデル比では約85分の1)に圧縮しました。
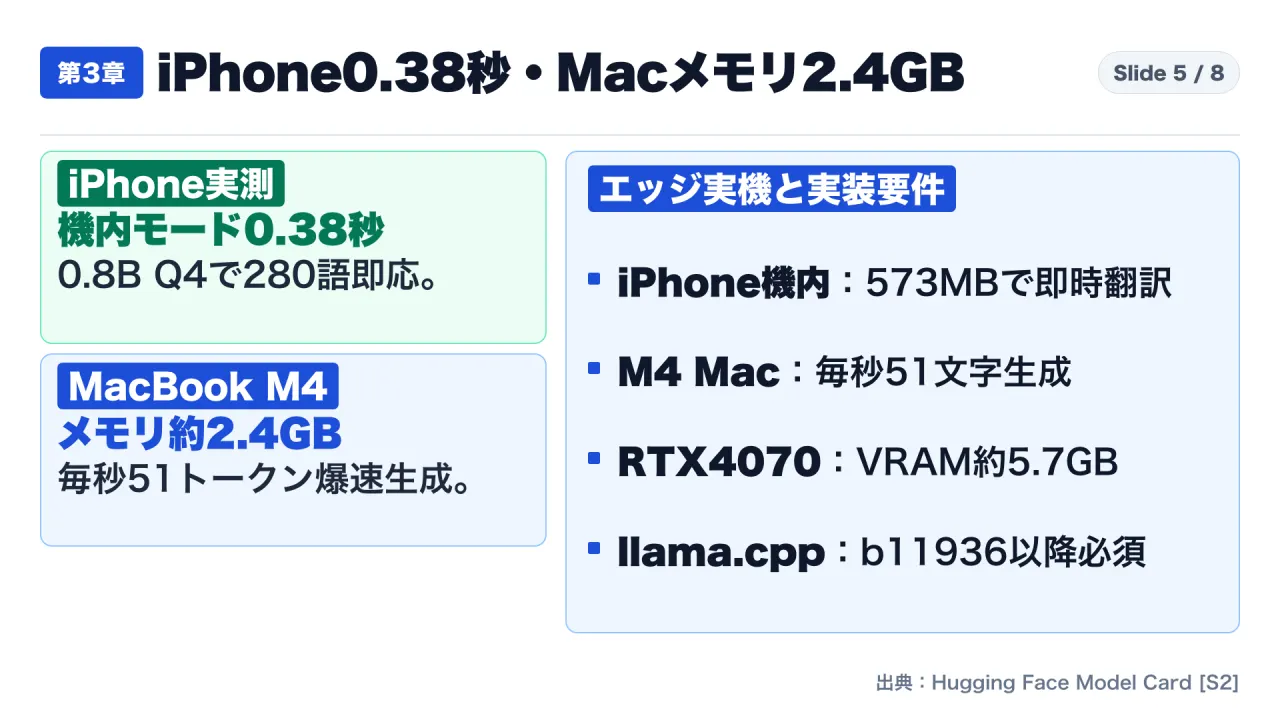
そして何より、iPhone 17 Proの完全オフライン(機内モード)で0.38秒、M4 Mac上でメモリ消費わずか2.4GB・毎秒51トークンという実用的なエッジ推論速度を達成したことで、**「機密データを外部クラウドに一切送信しないオンプレミス・オンデバイス翻訳パイプライン」**が現実のものとなりました。
本記事では、PFN公式プレスリリース、Hugging Face公式モデルカード、およびPLaMoコミュニティライセンス利用規約の計3件の一次資料を徹底的に突き合わせ、そのアーキテクチャ、データ洗練技術、実機推論性能、そしてライセンス条項に潜む法務境界線を徹底解剖します。
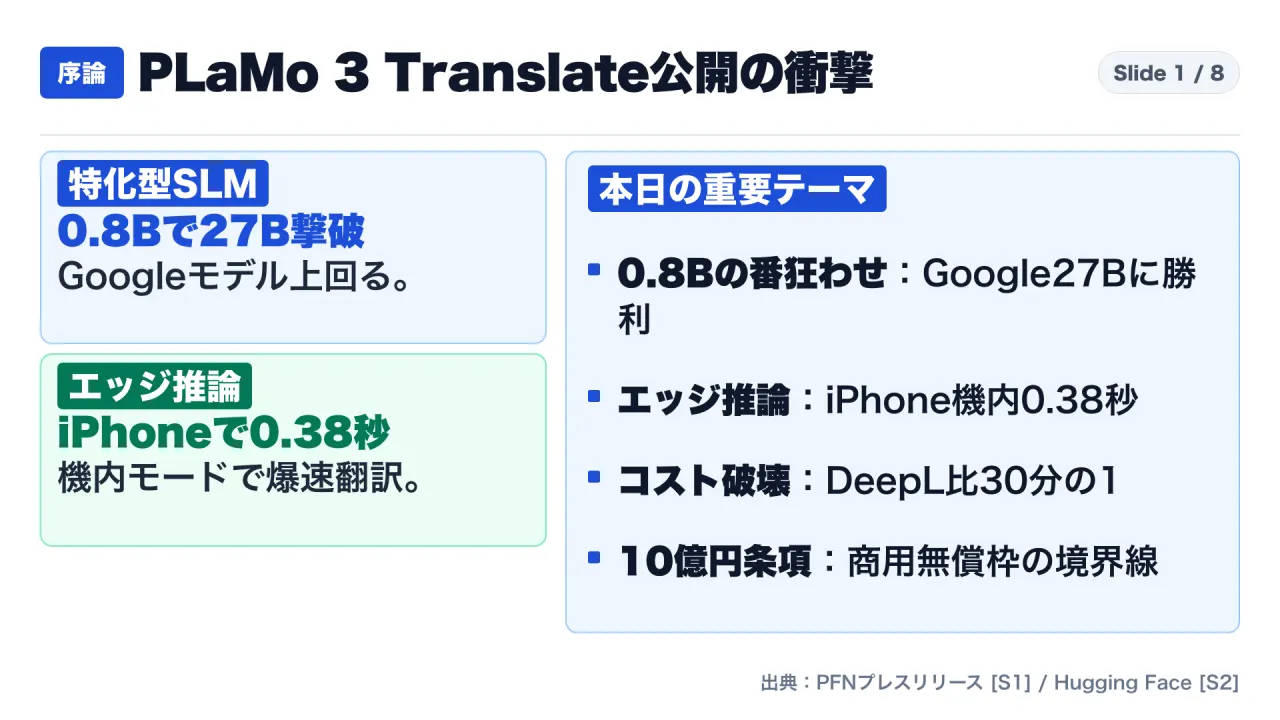
1. 結論と全体像:0.8Bの番狂わせとエッジ推論の実用化
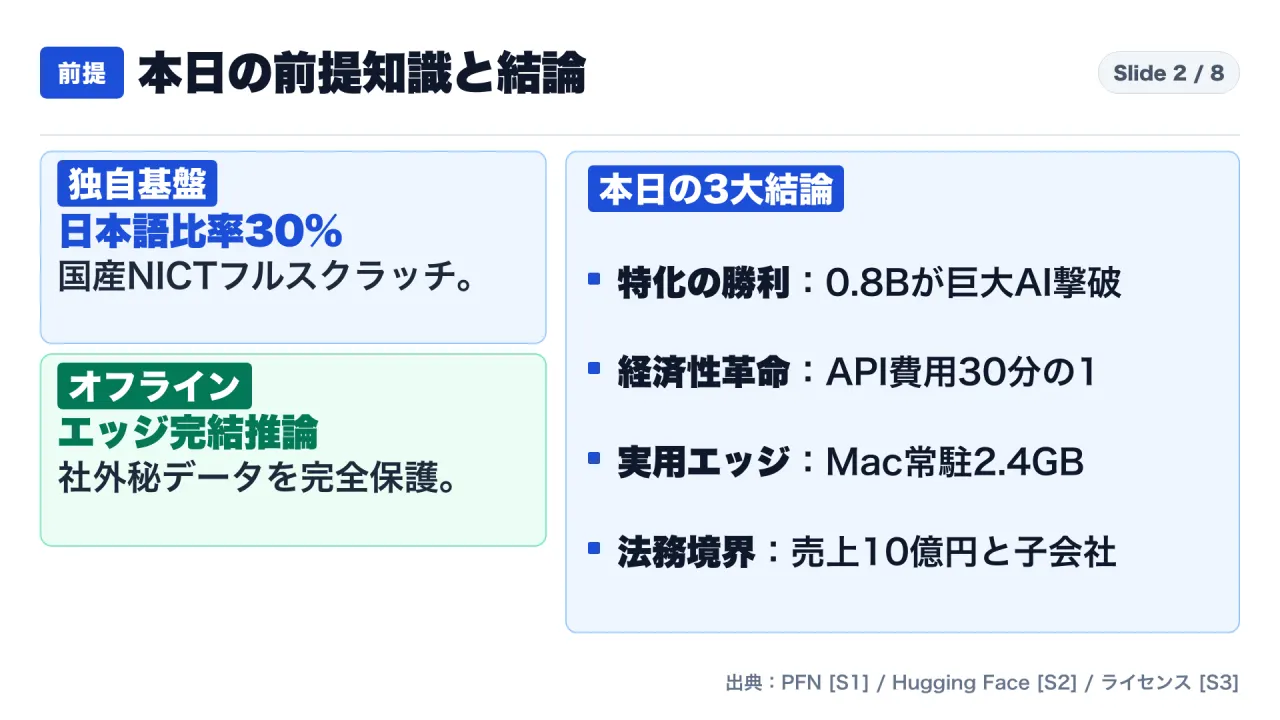
まず、公開された一次情報から導き出される重要な結論を3点に整理します。
- 373億トークンのデータ洗練が生んだ「小型特化モデル」の番狂わせ:
- PFNは学習アルゴリズムやハイパーパラメータをほぼ変更せず、トーナメント式データ合成、逆翻訳、反復的自己蒸留を組み合わせた合計373億トークンのデータセット洗練のみによって劇的な品質向上を達成しました。最上位31Bモデルからの蒸留とDPO(直接選好学習)を経た0.8Bモデルは、30倍以上巨大なGoogle TranslateGemma 27Bを凌駕しました。
- 商用翻訳APIを圧倒する経済性とエッジ推論速度:
- PLaMo 3 Translate 31Bは、DeepL勝率87.00%、Google翻訳勝率91.47%を達成しつつ、PLaMo API(入力100万トークン60円/出力250円)により商用翻訳APIの約30分の1のコストを実現しました。さらに7種類の量子化形式(BF16, FP8, W4A16, W4AFP8, NVFP4, GGUF, MLX-4bit)の提供により、iPhone機内モードで0.38秒、MacBook M4で毎秒51トークンのローカル生成が可能です。
- PLaMoコミュニティライセンスの「売上10億円」と「子会社の罠」:
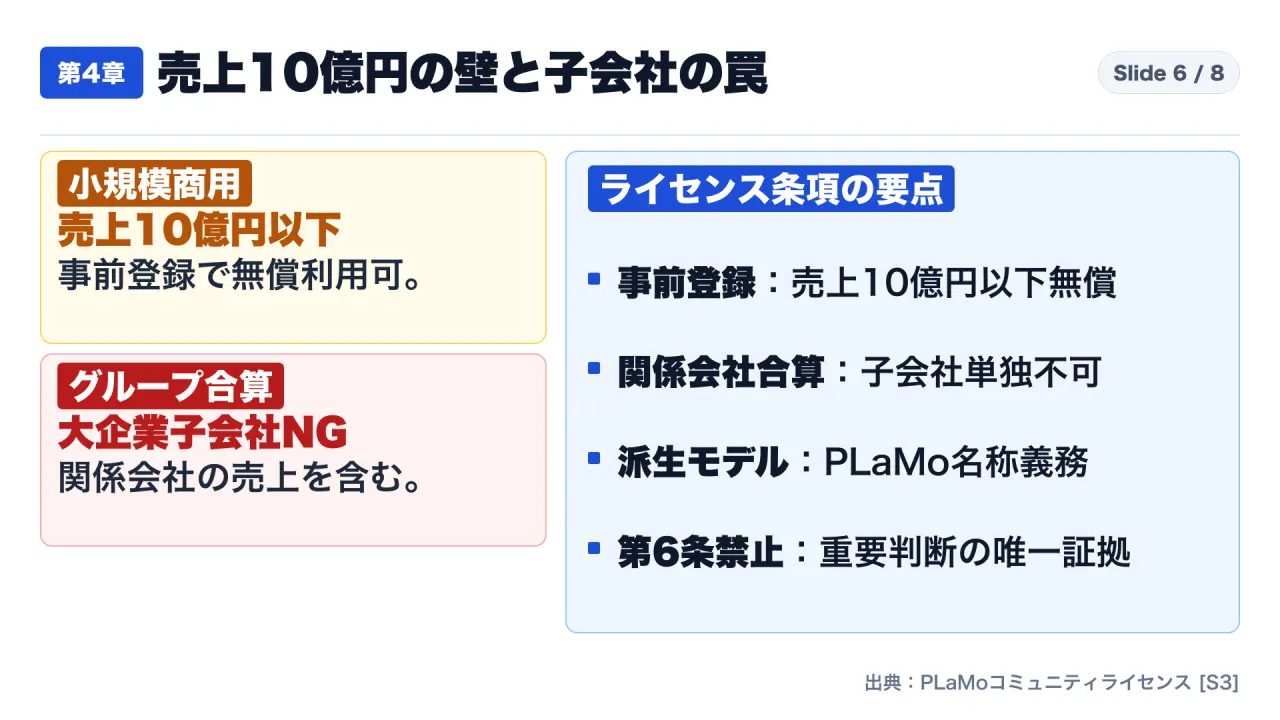
- 個人学習・学術研究は登録不要で無償ですが、商用利用が無償になるのは「利用者およびその関係会社の直近事業年度の売上高が10億円以下」の事業者に限定されます。大企業の子会社は関係会社条項により有償契約が必要となるほか、生成物を別AIモデルの学習に使用した際の「PLaMo」名称継承義務、および重要意思決定での唯一証拠としての使用禁止条項が存在します。
2. 373億トークンのデータ洗練!4段階パイプラインの技術解剖
「PLaMo 3 Translate」の卓越した翻訳品質を支えているのは、PFNと情報通信研究機構(NICT)の共同研究による事前学習基盤「PLaMo 3 NICT」です。
日本語比率30%と独自トークナイザの構造的強み
海外製モデルでは事前学習コーパスに占める日本語比率が数パーセント程度に留まることが一般的ですが、PLaMo 3 NICTは事前学習データセットの約30%を日本語が占めています。これにより、日本語特有の助詞の使い分け、敬語表現、ビジネス定型文のニュアンスがモデル内部に深く内面化されています。
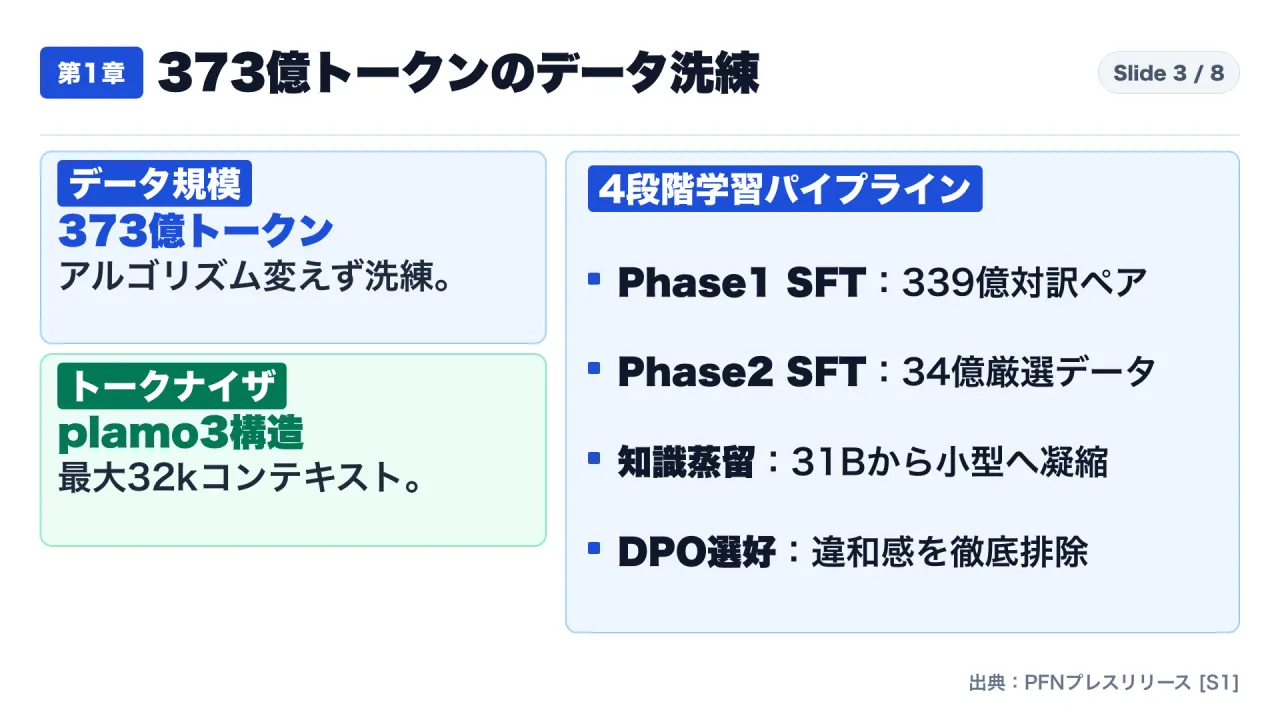
さらに、自社開発の独自トークナイザ(plamo3トークナイザ)によって、日本語および英語の1,000文字あたりのトークン消費量を極限まで抑制しています。最大32,768トークンのコンテキスト長と相まって、長大な技術マニュアルや契約書全体を文脈を崩さずに一括処理できます。
4段階の事後学習パイプライン
PFNは合計約373億トークンに及ぶデータを、以下の4段階の洗練パイプラインに投入しました。
| 学習段階 | データ規模 | 主な学習内容と技術手法 | 達成された効果 |
|---|---|---|---|
| Phase 1 SFT | 約339億トークン | 大規模対訳コーパスの学習(トーナメント式合成データ+逆翻訳) | 53言語に及ぶ基礎的な多言語翻訳能力の獲得 |
| Phase 2 SFT | 約34億トークン | 学術論文、ニュース、技術文書、Webページ等の厳選データ | 実務ユースケースにおける文脈理解と表現の自然さ向上 |
| 知識蒸留 | — | 完成した31Bモデルを教師とし、0.8B/2B/8Bへパラメータ空間を蒸留 | 大型モデルのニュアンス把握力を小型モデルへ凝縮 |
| DPO選好学習 | — | 同一原文に対する好ましい訳文(chosen)と劣る訳文(rejected)の直接選好最適化 | 機械翻訳特有の不自然な言い回しの徹底的排除 |
3. DeepL勝率87%・Google翻訳勝率91%!ベンチマーク性能と圧倒的経済性
PFNが公表した対戦評価データは、翻訳特化型モデルが汎用フロンティアモデルや専業翻訳サービスを上回る実力を証明しました。
定量ベンチマーク評価と対戦勝率
| 評価指標・ベンチマーク | PLaMo 3 8B | TranslateGemma 27B | PLaMo 3 31B vs DeepL勝率 | PLaMo 3 31B vs Google翻訳勝率 |
|---|---|---|---|---|
| PFTB(英 → 日 / charsim) | 0.547 | 0.438 | 87.00% | 86.00% |
| PFTB(日 → 英 / charsim) | 0.672 | 0.634 | 58.00% | 71.00% |
| SaaS(英 → 日) | 0.571 | 0.395 | 73.82% | 91.47% |
| WMT24++(英 → 日 / COMET-22) | 0.879 | 0.882 | 59.17% | 70.62% |
| FLORES+(日 → 多言語 / chrF++) | 43.40 | 42.17 | 対象外 | 対象外 |
特筆すべきは、PLaMo 3 Translate 8Bが、3倍以上大きいTranslateGemma 27Bをほぼすべての指標で上回っている点、そして最小の0.8Bモデルであっても英日翻訳および多言語翻訳においてTranslateGemma 27Bを凌駕した点です。
圧倒的なAPI経済性
PLaMo APIの標準料金は、入力100万トークンあたり60円、出力100万トークンあたり250円です。
- 商用翻訳API(DeepL等)およびフロンティアモデルAPIと比較して、約30分の1のコストで同等以上の翻訳出力を獲得可能。
- 唯一31Bモデルを上回るスコアを示した最高峰汎用フロンティアモデル「Claude Fable 5.1」と比較した場合、推論コストは約85分の1に圧縮されます。
4. iPhone機内モード0.38秒・Macメモリ2.4GB!エッジ推論の実測検証
PFNはオープンウェイト公開と同時に、7種類の量子化フォーマット(計28リポジトリ)を配備しました。これにより、クラウドを介さず末端デバイスのみで推論を完結させるエッジ推論環境が即座に構築できます。
flowchart LR
    subgraph Edge_Env["【オフライン・エッジ推論環境】"]
        direction TB
        Mobile["iPhone 17 Pro(機内モード)\n0.8B Q4_K_M(573MB)\n→ 280語を0.387秒〜0.515秒"]
        Mac["MacBook M4(16GB RAM)\n2B Q4_K_M(1.81GB)\n→ メモリ2.4GB / 毎秒51.6トークン"]
        Server["社内サーバー(RTX 4070)\n8B Q4_K_M(5.28GB)\n→ VRAM 5.7GB(16kコンテキスト)"]
    end

    subgraph Security["【データセキュリティ境界】"]
        Confidential["社内機密文書・未公開特許・契約書"] --> Edge_Env
        Edge_Env -- "外部通信ゼロ(完全遮断)" --> Output["安全な翻訳成果物"]
    end
実機ベンチマーク実測値
- iPhone 17 Pro(機内モード・PocketPal AI):
plamo-3-translate-0.8b(GGUF, Q4_K_M, 573MB)。- ジェイン・オースティン『高慢と偏見』冒頭(約280語):0.515秒。
- アインシュタイン『相対性理論』第1章冒頭:0.387秒。
- MacBook(Apple M4, 16GBメモリ, llama.cpp b11936):
plamo-3-translate-2b(Q4_K_M, 1.81GB):サーバー常駐メモリ約2.4GB、生成速度50.7〜51.6 t/s(1文0.22〜0.46秒)。難解文10問テストで9/10問正解。plamo-3-translate-8b(Q4_K_M, 5.28GB):サーバー常駐メモリ約5.3GB、生成速度17.1〜18.0 t/s。
- NVIDIA RTX 4070(VRAM 12GB):
- 8Bモデルを全33層GPUオフロード、16kコンテキスト(4スロット共用)で実行した際のVRAM消費量は5,733 MiB(約5.7GB)。
実装上の必須留意点
- llama.cpp: 独自トークナイザに対応した
build 11936以降が必須。--chat-template-file chat_template.jinja --no-prefill-assistantフラグを付与すること。 - Stop Tokens: 出力暴走を防ぐため、
stop: ["<|plamo:tag|>", "<|plamo:bos|>"]を明示指定すること。 - transformers: v5系では挙動が異なるため、
transformers<5.0.0を使用するか、AutoModelForCausalLMで直接ロードすること。
5. 売上10億円の壁と子会社の罠!「PLaMoコミュニティライセンス」の法務境界線
オープンウェイトの利用にあたっては、PFNが定める「PLaMoコミュニティライセンス」の条項を正確に理解しておく必要があります。
ライセンス区分の境界線
- 非商用利用(個人学習・学術研究):
- 事前申請や登録は不要、完全無償で利用可能。
- 小規模商用利用(無償利用枠):
- 条件:利用者およびその関係会社の直近事業年度における総売上高が**「10億円以下」**であること。
- 手続き:PFN公式フォームへの事前利用登録が必須。
- 大規模商用利用(売上10億円超):
- PFNとの個別有償商用ライセンス契約が必要。
「大企業子会社」が陥る関係会社条項の罠
利用規約上、売上基準は「利用者単体」ではなく「その関係会社」を含めた合算で判定されます。 例えば、設立間もない子会社単体の売上が1億円であっても、親会社グループの連結売上が10億円を超えている場合、小規模商用枠の無償適用を受けることはできません。無断で利用するとコンプライアンス違反となるため、社内開発では法務部門による資本関係の事前確認が不可欠です。
派生モデル規制と禁止用途
- 派生モデル条項(名称継承義務):
- PLaMo 3 Translateの出力を用いて別のAIモデルをファインチューニングまたは蒸留した場合、成果物は派生モデルとみなされ、モデル名に「PLaMo」を含める義務とライセンス条件の継承義務が発生します。
- 第6条 禁止利用用途(重要判断の唯一証拠禁止):
- 法律・法務判断、医療・診断、金融取引・与信、採用・人事評価など、個人の権利利益に重大な影響を及ぼす決定において、PLaMoの出力を「唯一の証拠または根拠」として使用することは明文で禁止されています。
6. アーキテクチャ考察:巨大クラウドAPI依存からの脱却と特化型SLMの台頭
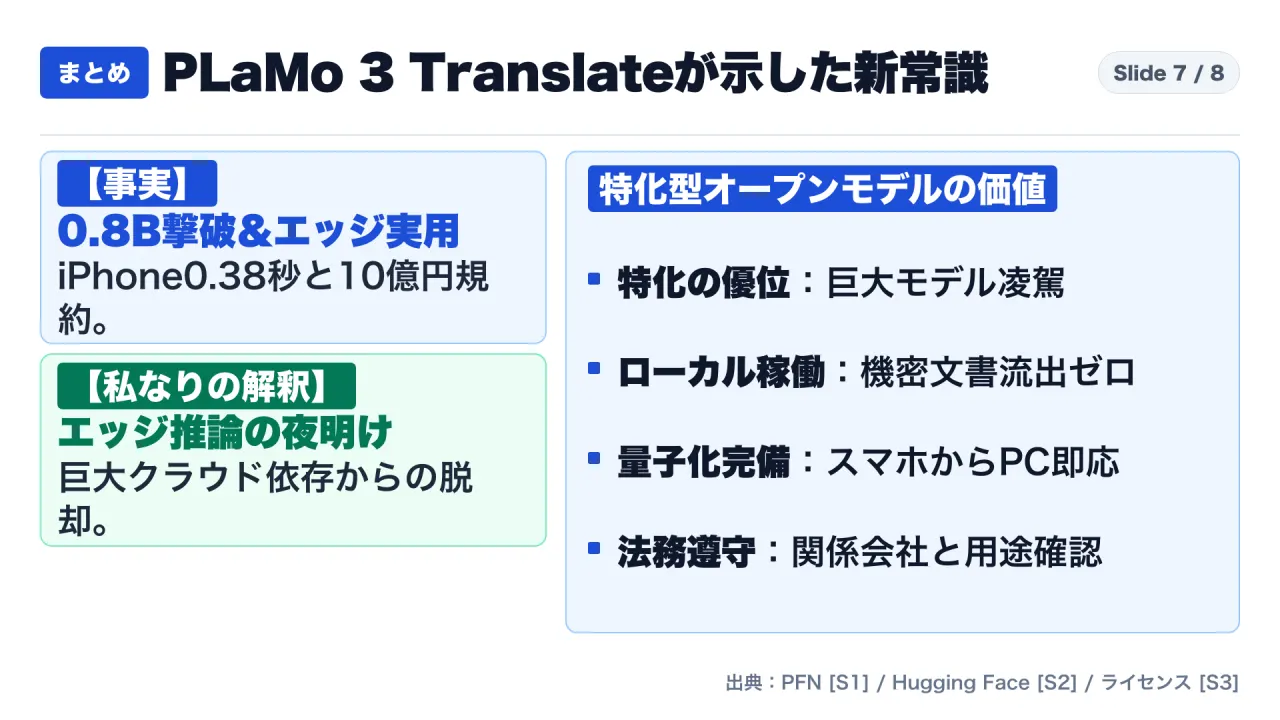
PLaMo 3 Translateの成功は、近年の生成AIアーキテクチャにおけるパラダイムシフトを象徴しています。
あらゆる知識を包含する超巨大汎用フロンティアモデルをクラウド越しにAPIで叩く方式は、多大なトークン課金、ネットワーク遅延、そして機密データ流出というセキュリティ懸念を常に伴います。
これに対し、特定のビジネスドメイン(翻訳、分類、要約)に絞り込んでデータを極限まで洗練させた**特化型小型モデル(SLM: Small Language Model)**は、以下の圧倒的な優位性をもたらします。
- セキュリティの完全担保: 機密文書を外部ネットワークに一切出さず、社内インフラ内で完結。
- コストの決定論的抑制: 月額のAPI従量課金から解放され、手持ちのハードウェア資産で固定費化。
- 低レイテンシのユーザー体験: 通信オーバーヘッドを排除し、ミリ秒単位での即時応答を実現。
7. 結論:明日から現場で実践する3つのアクションアイテム
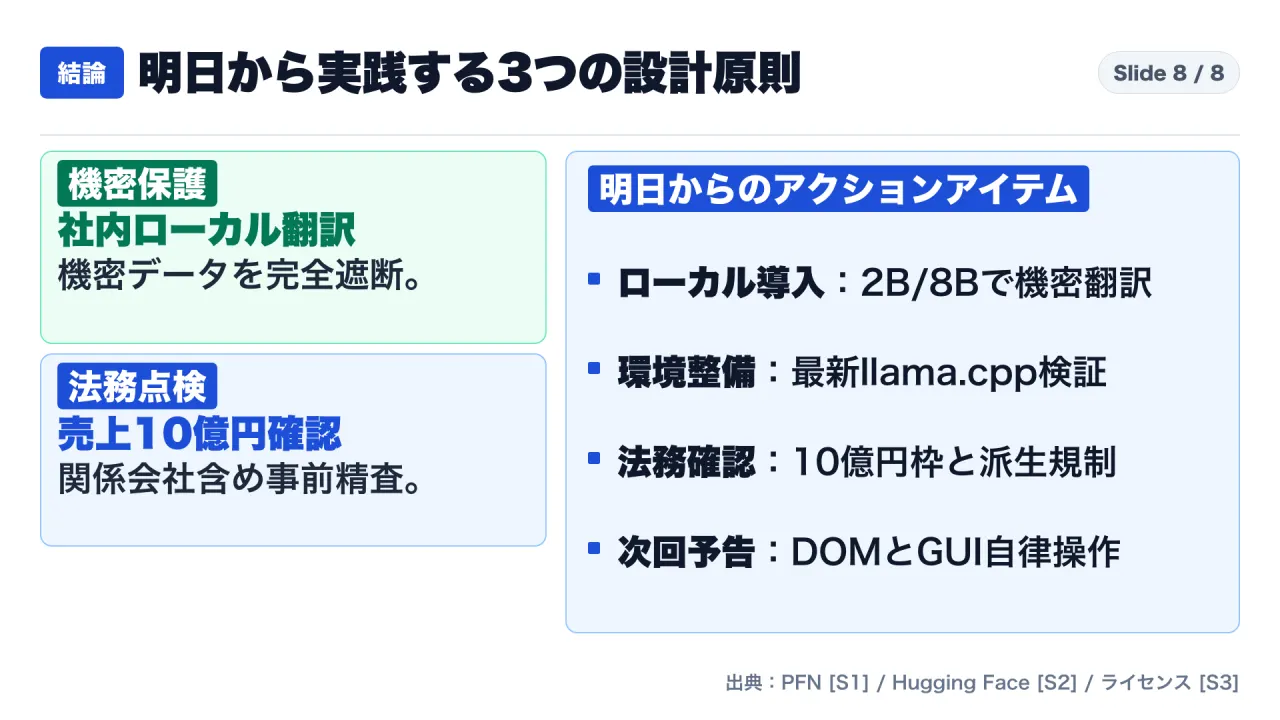
最後に、明日からの実務開発やアーキテクチャ設計に向けて、今すぐ現場で実践できる3つのアクションアイテムを提示します。
- 機密文書の社内ローカル翻訳パイプラインを立ち上げる:
- クラウド送信が禁止されている研究開発資料、特許明細書、未公開契約書を対象に、PLaMo 3 Translate 2Bまたは8BのGGUF/MLXモデルをMacBookやオンプレミスサーバーに配備し、セキュアな翻訳環境を構築してください。
- 最新llama.cpp推論環境と必須フラグを標準化する:
- 推論コンテナとしてllama.cpp(b11936以降)を整備し、
chat_template.jinja、--no-prefill-assistant、および停止トークン配列(stop: ["<|plamo:tag|>", "<|plamo:bos|>"])を正しく組み込んだDockerイメージをテンプレート化してください。
- 推論コンテナとしてllama.cpp(b11936以降)を整備し、
- ライセンス条項と企業資本関係の法務事前点検を行う:
- 自社グループの直近売上高を精査し、売上10億円以下の無償登録枠に適合するか確認してください。大企業子会社に該当する場合は速やかにPFNへの有償ライセンス相談を行い、派生モデル規定を踏まえた利用ガイドラインを整備してください。
参考・一次資料リンク一覧
- Preferred Networks プレスリリース: 翻訳特化型LLM「PLaMo 3 Translate」のモデル重みをオープンウェイトとして公開: https://www.preferred.jp/ja/news/pr20261105/
- Hugging Face Model Card: pfnet/plamo-3-translate-2b & Edge Benchmarks: https://huggingface.co/pfnet/plamo-3-translate-2b
- Preferred Networks: PLaMoコミュニティライセンス利用規約: https://www.preferred.jp/ja/projects/plamo/community-license/
動画での解説
{{YOUTUBE_URL}}
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48