なぜAIは記憶413個より9個で進んだのか?見直しで誤りを直す設計
この記事が役立つ人と、読んだあとにできること
AIのエージェントに仕事を任せ、「記憶」(会話をまたいで残る保存)を持たせて使っている担当の方と、その上司の方に向けた記事です。記憶機能を入れたら、かえって動きが悪くなった。間違った内容を覚え続けている気がする。毎回読ませる指示が、いつの間にか長くなった。こうした悩みを、Anthropicが2026年11月6日に公開した記事をもとに整理します。
読み終えると、次の3つができるようになります。
- AIに覚えさせる前に、「その情報は毎回、画面や資料から読み直せるか」を考えられるようになる。
- 記憶を原本(議事録・作業ログなど)と突き合わせる、見直しの手順を作れる。
- 毎回読ませる指示を短くし、記憶への書き込み権限を最小にする理由を、公式文書の記述つきで説明できる。
ただし、記事の数字はすべて、Anthropic自身の測定です。第三者による再現は、記事では示されていません。この記事では、記事が書いていること、書いていないこと、私の解釈を分けて書きます。
結論:覚える範囲を絞り、原本と突き合わせて見直し、毎回読む指示は短くする
結論から書きます。Anthropicは2026年11月6日、AIの記憶をどう設計するかについての記事「The components of agent memory」を公開しました。書いたのは、Lance Martinさんです。
ゲーム(ポケモン赤)の実験では、約1万歩進んだ時点の記憶フォルダを比べています。Claude Sonnet 3.7は記憶ファイルを413個書き、バッジは1つでした。Claude Fable 5は9個のファイルと、全体の目標を書いた1つのファイルで、バッジは4つでした。ただし、これは別のモデルどうしの、各1回の実行です。
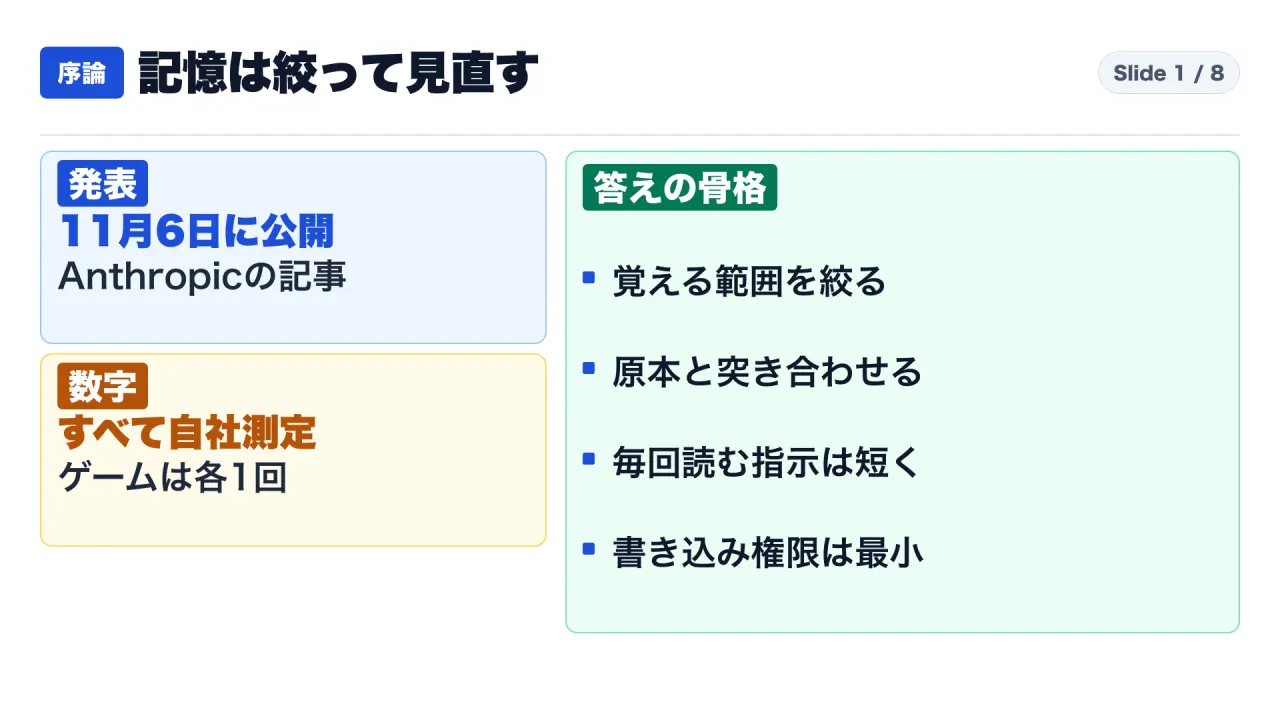
記事に出てくる主な数字は、次のとおりです。すべて、Anthropic自身の測定です。
| 数字 | 記事の書き方 | 私が読めた範囲で書かれていないこと |
|---|---|---|
| 413個対9個(バッジ1対4) | ポケモン赤で、Sonnet 3.7とFable 5の記憶フォルダを比較。約1万歩の時点、各1回の実行 | 実行を重ねたときのばらつき |
| 0.655→0.838 | CL-Bench 1.0のデータベース課題で、Opus 5.5の平均得点(記憶なし→記憶あり) | 実行回数 |
| 13%→48%、検索だけ53%、併用54%→61% | 約35万ファイルの文書を使う25問のウィキ実験 | 他の文書集合で同じになるか |
| 41/57→57/57 | 契約の57項目を、共有の表に書いたときと、契約ごとのページに書いたとき | 何回試したか |
背景:なぜ「何を覚えさせるか」が問題になるのか
AIに記憶を持たせる、と聞くと、「たくさん覚えるほど賢くなる」と考えがちです。記事は、その考えに注意を促しています。覚えた内容は、あとの会話で読まれ、信頼されます。内容が古い、あるいは最初から間違っていると、そのまま仕事に影響します。
記事の序盤には、こんな整理があります。人の脳は、起きている間に経験を素早く書き留め、眠っている間など、活動が少ない時間に、その経験を見直して長期の知識に組み込む、というしくみが考えられている、という説明です。AIの記憶にも、同じような役割分担ができる、と記事は書いています。日中の作業では記録を残し、あとから見直して整理する。この「あとからの見直し」が、ドリーミング(dreaming)です。人の睡眠にたとえた説明は、記事の著者による比喩で、事実の主張ではありません。
なお、10月24日の回では、作り込んだ記憶と、生の履歴を検索する方法の損得を扱いました。この記事は、記憶をあとから作り直す設計と、その失敗例を扱います。論点は近いですが、結論は食い違いません。ウィキだけで答えた得点(48%)が、検索だけの得点(53%)に届かず、併用が最も高かった(61%)という数字は、「作り込んだ記憶が、いつも生の検索に勝つわけではない」という見方と、同じ向きです。これは私の読みです。
読み方:事実、書かれていないこと、私の解釈を分けます
この記事では、次の3つを分けて書きます。
- 事実:Anthropicの記事、製品の告知、開発者向けの公式文書に、書かれていること。
- 書かれていないこと:私が取得した本文を検索して、見つからなかった範囲。
- 私の解釈・提案:私の読みと提案。文中で「私の」と明記します。
私が確かめたのは、これらのページに何が書かれているかです。実験をやり直してはいません。数字が正しいかは、確かめていません。図の数字は、図の説明文(ページ内の代替テキスト)の記載で、画像そのものは見ていません。
用語:先に言葉をそろえます
- 記憶(agent memory):記事の定義では、AIが経験から得て、会話をまたいで持ち続ける知識で、あとから読めるように保存したもの。
- 重み:訓練で決まる、モデル内部の数値。
- 圧縮(compaction):古い会話をAIが要約して置き換える処理。記事の「記憶」には含みません。
- ウィキ:AIが書いて保つ、ページの集まり。ページどうしがリンクでつながる。
- ドリーミング:記録を見直して、ミスを直したり、新しいメモやページを作ったりする処理の呼び名。
- Claude Managed Agents:Anthropicの、エージェントを動かすための仕組み。製品のドリーミングは、この機能のひとつです。
- CL-Bench:記事が使った課題。データベースから答えを探す質問に答える。
第1章:記憶とは何か。四つの層と、ドリーミング
記事の定義
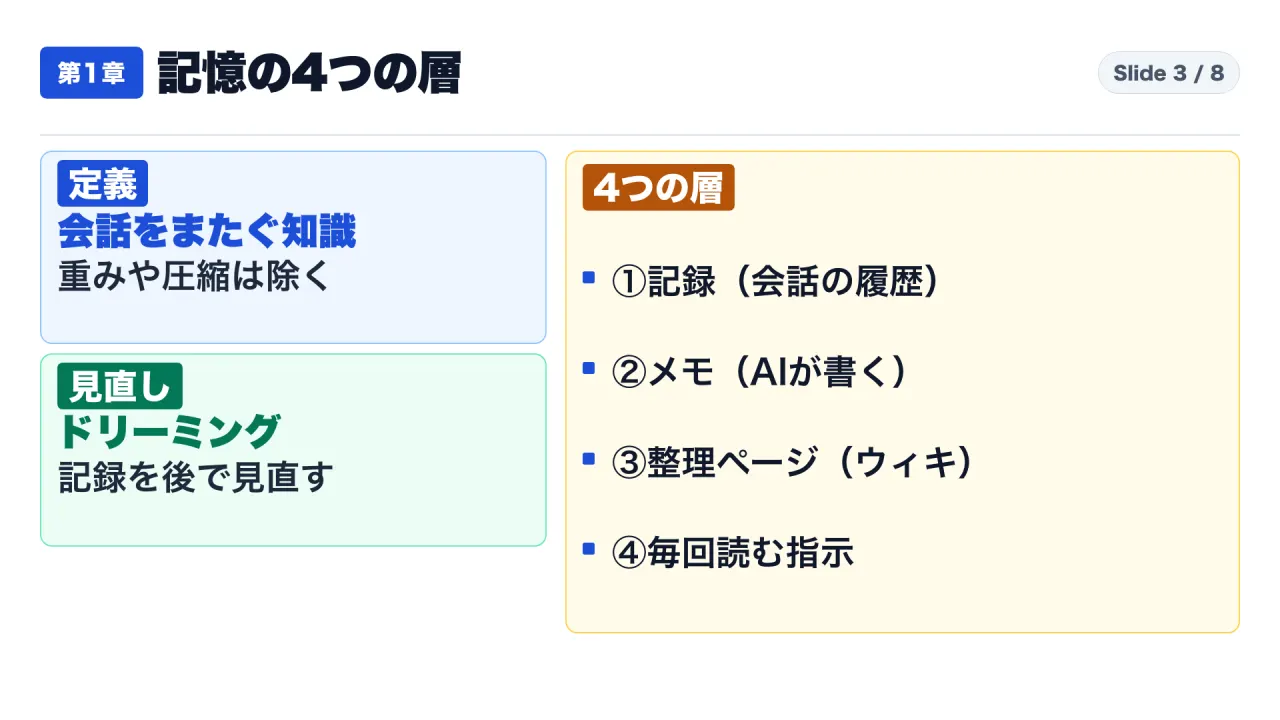
記事は、AIの記憶を、経験(利用者とのやりとりや、与えられた仕事)から得て、会話をまたいで持ち続ける知識で、あとから読めるように保存したもの、と定義しています。次のものは、記憶に含めないとしています。
- 重みの書き換え
- 一つの会話の中での学習(in-context learning)
- 圧縮
四つの層
図の説明では、記憶の置き場所は、下から順に次の四つです。
| 層 | 中身 | 例 |
|---|---|---|
| 1. 記録 | 検索できる、会話や作業の履歴 | 会話のログ |
| 2. メモ | AI自身が書く、大事な点の書き留め | メモのフォルダ |
| 3. 整理した表現 | メモなどを整理して、たどりやすくしたもの | ウィキ |
| 4. 毎回読み込む文脈 | 会話を始めるたびに最初から渡される内容 | 指示ファイル |
ドリーミングは、図の中で、記録から各層へ矢印が伸び、上の2層の間では双方向の矢印が引かれています。
ドリーミングの着想
記事は、着想の元として、Letta(レッタ)とカリフォルニア大学バークレー校の研究者が出した「sleep-time compute」(やりとりの合間の待ち時間に、文脈を整理するという考え)を挙げています。
注意:ドリーミングは、考え方の名前でもある
記事の中で、ドリーミングは「この処理は、よくドリーミングと呼ばれる」という書き方です。製品としての機能(Managed Agentsの「Dreams」)は別に存在し、第4章で見ます。両者が完全に同じものかは、記事には書かれていません。実験が製品の機能で行われたのか、研究用の手順で行われたのかも、書かれていません。
この章で確かめる点は、1つです。記憶という言葉が、4つの層のどれの話なのかを、分けて聞くことです。
第2章:何を覚えさせるか。413個と9個、そして得点の数字
ポケモン赤の実験
記事は、AIが何を覚える価値があると判断するかを見るために、ポケモン赤を使っています。実験の開始時に、各モデルへ、読み書きできる記憶ファイルのフォルダを渡しています。比べたのは、それぞれ1回の実行で、約1万歩進んだ時点の記憶フォルダです。
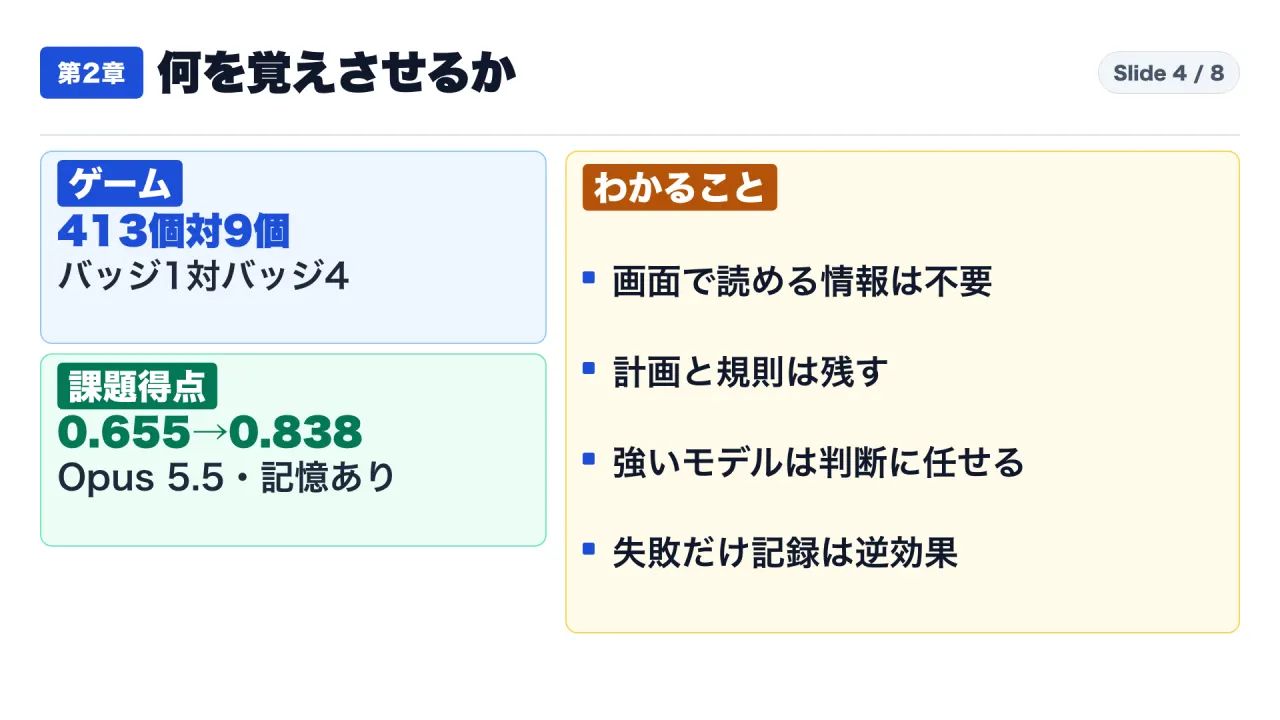
- Sonnet 3.7は、何でも大事かもしれないと考え、手当たり次第に書きました。戦った相手ごと、拾った道具ごと、出会った人ごとに、ファイルがありました。結果は、記憶ファイル413個(225のフォルダ)で、バッジ1つです。
- Fable 5は、2つのフォルダに9個のファイルと、全体の目標を書いた1つのファイル(global.md)でした。バッジは4つです。
記事は、理由をこう書いています。所持金や、地図上の今いる場所は、毎回、画面で読めます。保存しても無駄です。一方、戦略、計画、試して確かめた規則は、AIが書き留めないと消えてしまいます。Fable 5は、後者を覚えるために記憶を使いました。
Sonnet 3.7の詳しい記録は、ゲームの状況が変わるたびに古くなりました。記憶を探すのに時間がかかり、ゲームを進める時間が減った、と記事は書いています。約1万歩の頃には、4つ目の「まとめ」用のフォルダを作り始め、17歩のあいだに6個のファイルを作り、9個を消し、ゲームの操作は1回もしなかった、という記述もあります。
Opus 5.5も、小さなフォルダに、現在の目標と次の手順を書き、遊びながら書き直して、ゲームをクリアした、と記事は書いています。
Fable 5は、記憶を層ごとに使い分けていた
記事は、Fable 5の記憶の構成を、次のように説明しています。全体の目標を書いたglobal.mdは、いわば掲示板の役割で、現在の目標、ジム(バッジを得るための挑戦の場)に挑むための事前に書いた計画、そして、記憶の使い方についてモデル自身が決めた規則が入っていました。locations(場所)のフォルダには、特定の経路をたどるための計画、gameplay(遊び方)のフォルダには、ゲームのしくみについて学んだことに基づく戦略がありました。
具体例として、記事は、モンスターボールを7回続けて外したあとに、AIが書いたメモを紹介しています。内容は「3回以上続けて失敗したら、間に待ちの操作を挟んでタイミングを変える。そうしたら成功した」というものです。これは、画面を見ても分からず、試して初めて分かった規則です。覚える価値のある情報の、典型的な例と言えます。
私の読み:ファイル数だけが原因とは言えない
ここで気をつけたいのは、これが別のモデルどうしの、各1回の比較だという点です。ファイルの数だけが原因とは言えません。記事自身も、「各モデルが、何を覚える価値があると考えたか」の違いとして説明しています。私は、この例を「覚える前に、その情報が読み直せるかを考える」目安として受け取ります。
CL-Benchの実験
もう一つの実験は、CL-Bench 1.0の、データベースから答えを探す課題です。AIは質問のたびに新しい会話で始めますが、記憶のフォルダだけは、会話をまたいで読めます。回答のあとに、正しい答えを教えられ、次の質問のために記憶を書けます。
平均の得点(記憶なし→記憶あり)は、図の説明文によると、次のとおりです。
| モデル | 記憶なし | 記憶あり |
|---|---|---|
| Opus 5.5 | 0.655 | 0.838 |
| Sonnet 5.5 | 0.644 | 0.833 |
| Opus 5 | 0.564 | 0.828 |
| Opus 4.7 | 0.383 | 0.700 |
| Sonnet 5 | 0.306 | 0.610 |
| Sonnet 4.6 | 0.330 | 0.364 |
Sonnet 4.6は、増えた幅が0.034です(私の計算:0.364−0.330)。記事によると、Sonnet 4.6は、記憶のフォルダを読まないことが多く、立てた仮説も試しませんでした。「回答の前に記憶を読む」「仮説を明示的に試す」よう指示すると、得点は0.641まで上がり、記事は「ほぼ2倍」と書いています。記事は、指示(ステアリング)が最も効いたのは、古いモデルだった、とも書いています。
強いモデルには、書く内容を決める規則が逆効果だった
記事は、記憶に何を書くかの具体的な規則を、1回に1つずつ試しています。「失敗だけを記録する」という規則を与えると、Opus 5とOpus 4.7は、記憶による得点の上がり幅の多くを失いました。変化は、Opus 5が−0.234、Opus 4.7が−0.150、Sonnet 4.6が−0.020です。記事は、強いモデルには、何が大事かの判断を任せるほうが効果的だった、と書いています。
この章の整理
| 項目 | 記事の記述 | 注意 |
|---|---|---|
| 覚える価値のあるもの | 戦略、計画、試して確かめた規則 | 別のモデルどうし、各1回 |
| 覚える価値の低いもの | 毎回、画面で読める情報 | 同上 |
| 古いモデル | 使い方の指示が効いた | 実行回数は記載なし |
| 強いモデル | 書く内容を決める規則は逆効果 | 実行回数は記載なし |
この章で確かめる点は、1つです。覚えさせる前に、その情報が、画面や資料から、毎回読み直せるかを考えます。読み直せるなら、覚えさせません。これは私の提案です。
第3章:間違った記憶をどう直すか。見直しの効果と、失敗
記憶には、間違いが入る
記事は、AIが記憶に書く内容は、その会話の中で「大事だ」と判断したものに基づく、と説明します。最初から間違っているメモ、環境が変わって古くなったメモも、あとの会話で読まれ、信頼されます。
ドリーミングは、AIが、メモを元の記録(会話のログ)と突き合わせて直す手段です。記録が、正解の根拠になります。
ゲームの洞窟の例
ポケモンの洞窟の場面で、AIは、入り口の近くの建物の位置を、東側と間違えて書き留めました。その結果、崖から落ちて元の道へ戻る失敗を、3回くり返しました。3回目のあと、AIは「ループをやめる」と書きましたが、実験の装置が自動で「続けて」と返したため、続けて、山の手前の街まで戻りました。次の街には着かないまま、実行は終わりました。
見直し(ドリーミング)をかけた実行では、AIが、メモを会話の記録と突き合わせ、誤りに気づいて書き直しました。そして、洞窟に入り直し、図の説明文によると、1,935行動目で次の街に着きました。記憶なしの実行も、次の街に着きませんでした。
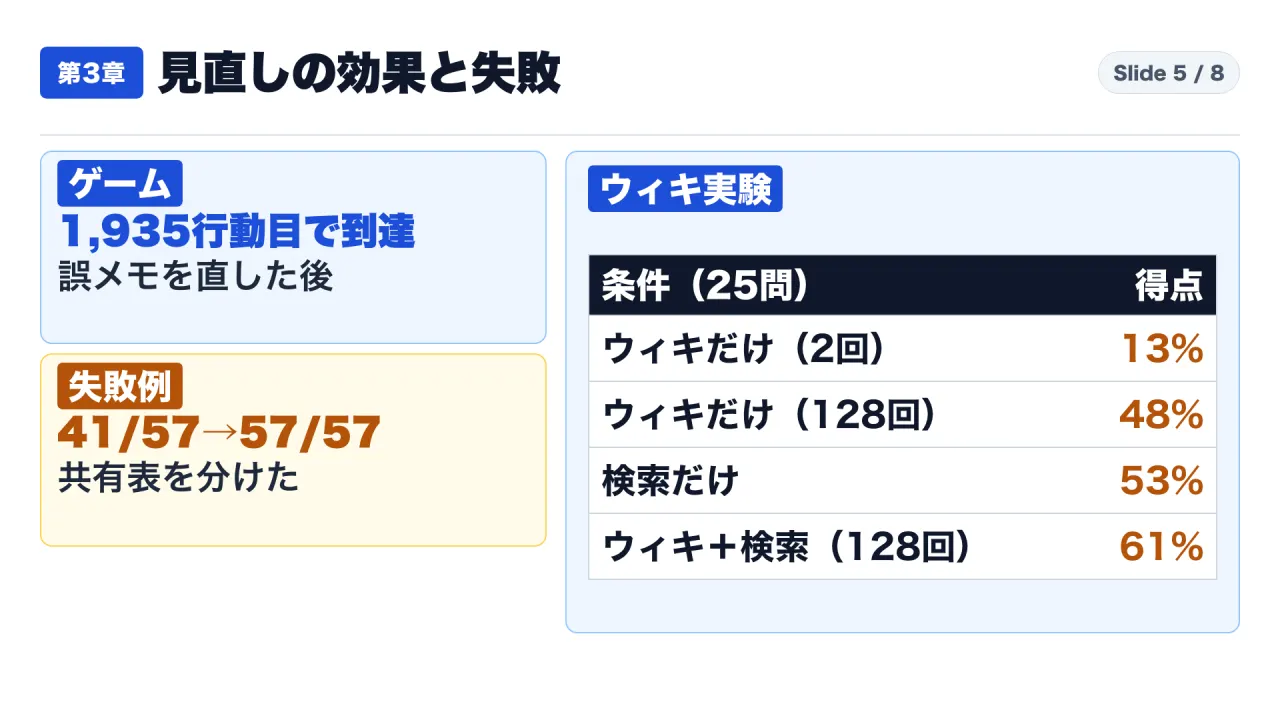
各条件の実行回数は、記事に書かれていません。事例として読みます。
ウィキの実験
次の実験は、約35万ファイル(約4.2億トークン)の社内文書を使い、25問の質問に答えさせるものです。AIには検索の道具を持たせ、さらに、ドリーミングでウィキを作らせました。Opus 5のAIに、128回の作業で、ページを書かせ、直させ、重なりを合わせ、元の資料と照らして確かめさせています。
結果は、次のとおりです(採点基準の達成率)。
| 条件 | 得点 |
|---|---|
| ウィキだけ(見直し2回) | 13% |
| ウィキだけ(見直し128回) | 48% |
| 検索だけ | 53% |
| ウィキ+検索(見直し2回→128回) | 54%→61% |
ウィキだけの最高点(48%)は、検索だけの点(53%)に届いていません。いちばん高いのは、併用の61%です。併用では、1問あたり約2万トークン(文章の量の単位)の節約にもなった、と書かれています。
ウィキが役に立たなかった例
- ある課題では、必要な情報が1つの文書に入っていて、文字検索だけで足り、ウィキの効果ははっきりしませんでした。
- 別の課題では、ウィキが元の資料より大きくなりました。資料は10文書で115KB、ウィキは68ページで203KBです。203÷115で約1.77倍です。記事は、非常に細かいのに、実質的に何も要約していないウィキだった、と書いています。
- 一方、合併の文書に関する24問のうち、複数の文書をまたぐ質問では、ウィキを使うと87%、検索だけだと73%でした。
共有の表に書くと、上書きで消える
契約の57項目を、複数のAIが、1つの共有の表に同時に書いたところ、あとの採点で残っていたのは57項目中41項目(72%)だけでした。原因は、書き手どうしが、お互いの内容を上書きしたことでした。契約ごとに別のページを作り、1人のAIが担当して、原文をそのまま引用させると、57項目すべてが残りました。
私の読みです。書く場所と書き方の設計で、結果が大きく変わります。AIが要約した内容は、元の資料と突き合わせる前提で使う、ということです。
この章で確かめる点は、1つです。AIが書いた要約は、必ず、元の資料と突き合わせます。
見直しには、他にも3つの使い道がある
記事は、ドリーミングの働きを、誤りの訂正とウィキの作成のほかに、3つ挙げています。
毎回読み込む層への「昇格」。 見直しで、大事なメモを、毎回読み込む層(4つ目の層)へ上げることができます。AIが検索しなくても、検索すべきものがあることを知らなくても、最初から読めます。ただし、記事は注意も書いています。毎回読み込む内容は、貴重な文字数(トークン)を使います。間違ったメモが入ると、すべての会話に持ち越されます。また、Claude Codeの文書は、長い指示ファイルは守られる割合を下げる、と警告しています。したがって、この層は小さく保つ必要があり、見直しの仕事の多くは、細部を下の層へ移し、リンクだけを残して、この層を小さく保つことだ、と記事は書いています。Claude Codeの自動の記憶も、同じ考えで、MEMORY.mdの先頭200行か25KBだけを毎回読み込み、この部分を「何を知っていて、どこにあるか」の目次として使います。
目的に合わせた記憶の育て方。 見直しの指示は、仕事ごとに変えられます。記事の例は、会社の買収を想定した契約書の課題です。最初は、ウィキの作り方の基本指示だけでしたが、契約の条件が最も重要なのに、指示には書かれていませんでした。そこで、AIが自分の失敗を振り返り、指示の変更を提案し、ウィキを作り直す、という手順をくり返したところ、AIは、契約の条件を忠実に残すことの重要さに気づき、指示を書き直しました。この結果が、先に見た、契約ごとに別ページ、原文のまま引用、という形です。
1回の会話が残した穴を埋める。 AIがメモを書くとき、見えているのは、その会話の内容だけです。見直しは、複数の会話を横断して、共通のパターンや、よくある間違いを見つけられます。記事の例では、ウィキが、まだ作っていないページへリンクしてしまうことがあり、2回目の見直しで、多くの穴が埋まりました。ある課題では、存在しない「エスクロー契約」のページへ向かう9本のリンクを、同じ書類を指す既存のページへ付け替え、索引を含む3つの新しいページを足しました。
第4章①:仕事でどう使うか。製品の状況と、四つの提案
製品としてのドリーミングの状況
| 項目 | 書かれていること | 出典 |
|---|---|---|
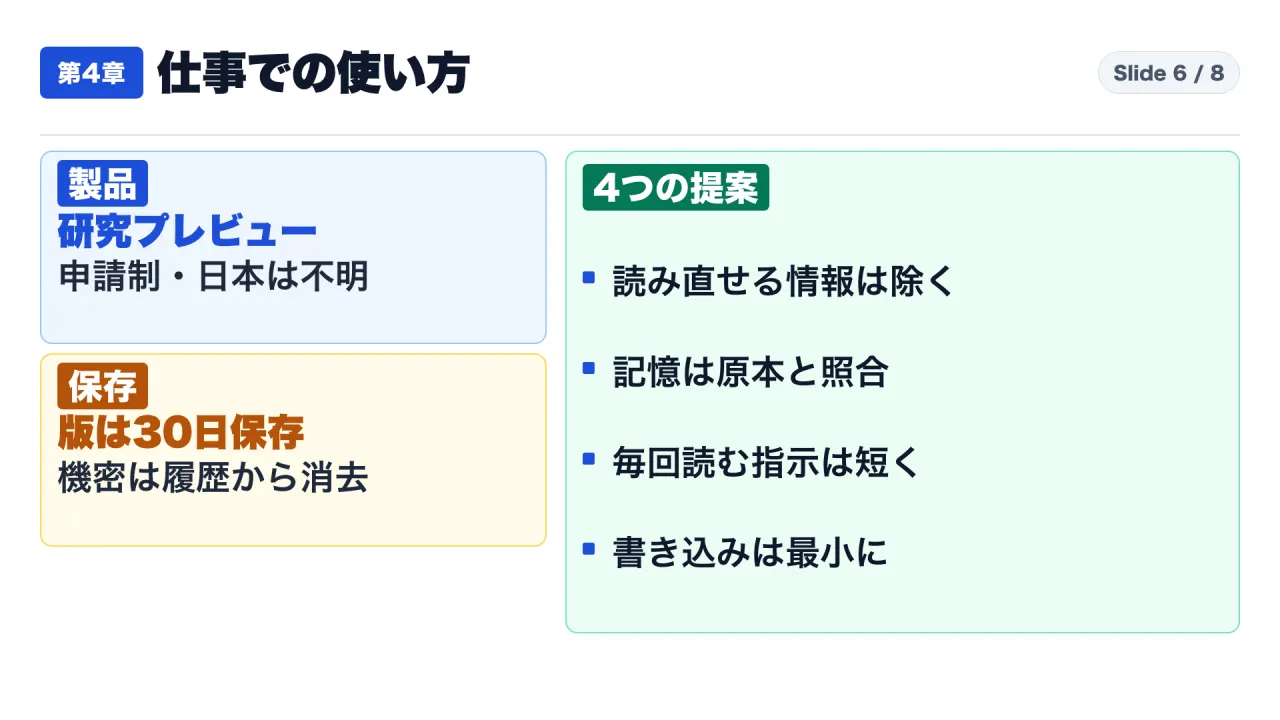
| 公開の状況 | 2026年5月19日に、Claude Managed Agentsの機能として、研究プレビューで発表。使うには申請が必要 | 5月19日の製品告知 |
| しくみ | 既存の記憶ストア1つと、過去のセッション1〜100件を読み、新しい記憶ストアを別に出力する。入力の記憶は変更しない | 開発者文書「Dreams」 |
| 制御 | 出力を確認して、採用するか捨てるか選べる。告知では、自動で更新するか、反映前に確認するかを選べる | 同上、製品告知 |
| 料金 | 選んだモデルの、標準のAPIトークン料金 | 開発者文書「Dreams」 |
| データの扱い | ゼロ・データ・リテンション(入力を保存しない契約)の対象外 | 同上 |
| 対応モデル | 一部のモデルのみ。例として、Haiku 5.5は非対応 | 同上 |
日本での提供可否は、私が見た資料には書かれていません。Claude Codeの文書にも、ドリーミングの記載は見つかりませんでした。Claude Codeの自動の記憶は、MEMORY.mdの先頭200行か25KBだけを毎回読み込む、と記事は書いています。
私の4つの提案(番組の提案で、一次資料の記述ではありません)
1. 覚えさせるのは、毎回は読み直せないものに絞る。 方針、確かめ済みの規則、失敗した理由。状況の記録(今の画面や資料から読めるもの)は、覚えさせません。
2. 記憶は、間違うものとして扱う。 議事録や作業ログなど、元の記録と突き合わせる、見直しの手順を作ります。見直しをAIに任せるなら、結果は、元を書き換えない別の保存先に出してもらい、採用するか捨てるかを自分で決めます。製品のドリーミングは、この形(入力を変更せず、別に出力)です。
3. 毎回読み込ませる指示は、短く保つ。 記事は、Claude Codeの文書が「長い指示ファイルは、守られる割合を下げる」と警告していることを引いています。間違ったメモが、毎回読み込まれる層に入ると、すべての会話に持ち越されます。
4. 書き込みの権限は、最小にする。 Memory storesの文書によると、記憶ストアは、既定で読み書きの両方が許可されています。外から入る文章(利用者の入力、取得したWebの内容、外部の道具の出力)を扱うと、「プロンプトインジェクション」(文章に命令を紛れ込ませる攻撃)で、悪意のある内容が書き込まれるおそれがあります。あとの会話は、それを信頼して読みます。文書は、参照するだけの記憶には、読み取り専用(read_only)を使うよう勧めています。
また、同じ文書によると、変更ごとの版は30日間保存されます(現行の版は期間に関係なく保持)。機密の内容は、redact(消去)の機能で履歴から消せます。1つのストアに入る記憶は、最大で1万件です。
点検の表(例)
自分の仕事に当てはめるときの、確認項目の例です。
| 確認項目 | はい/いいえ | 気づいたこと |
|---|---|---|
| 覚えさせている情報は、毎回、画面や資料から読み直せないものか | ||
| 記憶の内容を、元の記録と突き合わせる担当と頻度が決まっているか | ||
| 毎回読み込ませる指示は、何行か。読み直して、削れる行はないか | ||
| AIが記憶に書き込める場所は、どこか。参照だけの記憶は読み取り専用か | ||
| 外から入る文章(Web、メール、外部ツールの出力)を、AIが扱うか |
仮の例で考える:問い合わせ対応をAIに任せる場合
以下は、考え方を示すための仮の例で、実在の業務や実体験ではありません。社内の問い合わせにAIが答える仕組みを考えます。
| 区分 | 覚えさせる | 覚えさせない |
|---|---|---|
| 方針 | 返信の口調、エスカレーション(上の担当へ回す)の条件 | |
| 確かめ済みの規則 | 「この種類の質問は、この資料の、この章で答えが決まる」と、担当者が確認した規則 | |
| 失敗した理由 | 「古い料金表を見て誤答した。料金は必ず最新版を見る」 | |
| 状況の記録 | 今開いている問い合わせの本文、当日の担当者名、画面に出ている注文番号(毎回読み直せる) |
覚えさせた規則は、月に1回など、決めた間隔で、元の記録(実際の問い合わせと回答の履歴)と突き合わせます。間違った規則が見つかったら、記憶から消します。
最初の1か月でやること(私の提案)
記事や公式文書に書かれた手順ではなく、私の提案です。いきなり製品のドリーミングを申し込むより、手元の設定を点検するほうが、早く効果を確かめられます。
- 1週目:棚卸し。 いまAIに覚えさせている内容を、すべて書き出します。「毎回、画面や資料から読み直せるか」で、残すものと消すものに分けます。読み直せるものは、消します。
- 2週目:照合。 残した内容から、10件ほどを選び、元の記録(議事録、作業ログ、契約書など)と突き合わせます。食い違いが1件でもあれば、その内容を直し、なぜ食い違ったかを書き留めます。
- 3週目:権限の確認。 AIが記憶に書き込める場所を確認します。参照するだけの記憶は、読み取り専用にします。外から入る文章(メール、Webの内容など)をAIが読む仕組みなら、その入り口と書き込み先がつながっていないかを確認します。
- 4週目:記録。 毎回読み込ませる指示の行数と、照合で見つけた誤りの件数を、表に書きます。翌月に同じ表を作り、増減を見ます。
一度に全部をやる必要はありません。1週目の棚卸しだけでも、毎回読み込ませる指示が短くなり、読み込みの無駄が減ります。件数や回数は、あくまで目安で、仕事の性質に合わせて変えてください。
うまくいかないときの対応と、適用しない条件
- 得点が上がらない、動きが悪くなったとき:まず、記憶のフォルダの量と、毎回読み込む指示の長さを確認します。状況の記録が大量にたまっていれば、画面や資料から読み直せるものを消します。
- 同じ失敗をくり返すとき:記憶に、間違った規則が入っていないかを、元の記録と照らして確認します。記事のゲームの例のように、間違ったメモのまま続けると、同じ失敗をくり返すことがあります。
- 適用しない条件:1回で終わる単発の仕事、毎回すべての情報が入力に含まれる仕事では、記憶の設計は、あまり効きません。記事の実験も、会話をまたぐ長い仕事を対象にしています。
- 取り扱い注意の情報:機密情報や個人情報を、記憶に書かせるかは、慎重に決めます。製品のドリーミングは、ゼロ・データ・リテンションの対象外です。
第4章②:【私なりの解釈】数字は手がかり。設計の考え方として読む
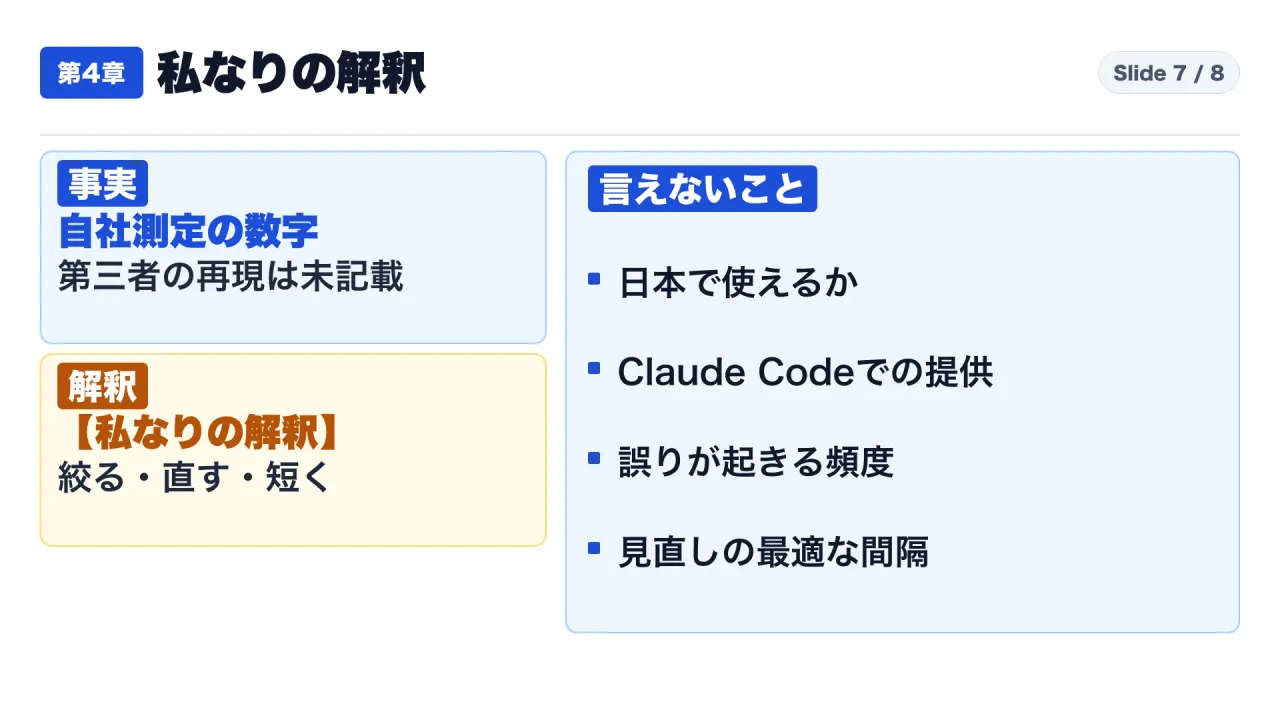
ここからは、事実ではなく、私なりの解釈です。断定ではありません。
第一の解釈。 この記事は、設計の考え方に、数字がついたものです。数字は、Anthropicが設計した課題での、自社測定です。第三者の再現は示されていません。「証明された」とは言えません。
第二の解釈。 413個対9個は、書き方の違いの、1つの例です。モデルが違い、各1回です。ファイルを減らせば進む、とは言えません。覚える前に、読み直せる情報かを考える、目安として受け取ります。
第三の解釈。 見直しは、無料ではありません。記事は、見直しには計算資源が要ると書いています。また、ウィキに、誤りやでたらめな内容がたまらないよう、手間をかけて保つ必要がある、とも書いています。
言えないこと
- 日本で使えるか。
- Claude Codeで、ドリーミングが使えるか。
- 誤った記憶が、どのくらいの頻度で起きるか。
- 見直しの間隔の決め方。記事は、「変わりやすい情報に絞る」「記憶が読まれる頻度に合わせて間隔を調整する」ことを、考えられる方向として挙げるにとどまり、答えは示していません。
記事が挙げる、まだ決まっていない問い
記事の終わりで、著者は、記憶の設計にはまだ多くの未解決の問いがある、と書いています。
- いつ記憶を作るか。 作業中に書けば、大事な点をその場で残せ、次のやりとりからすぐ使えます。しかし、書くたびに、本来の仕事から注意がそれます。見直しなら、記憶づくりを背景に回せますが、見直しの結果は、すぐには使えないかもしれません。
- 記憶を最新に保つ方法。 AIは、間違った予測をしたり、最初から間違った規則を書いたりします。環境が変わって、記憶が古くなることもあります。見直しは、これを直す方法の1つですが、計算資源が必要です。すべての記憶を継続的に点検するのは、現実的でないかもしれず、変わりやすい情報に絞る、あるいは、記憶が読まれる頻度に応じて見直しの間隔を調整する、といった工夫が必要かもしれない、と書いています。
- 記録の検索を、記憶の土台にする考え方。 ウィキなどの整理した表現と検索を組み合わせるのが、うまくいくこともあります。ただし、整理した表現を保つには計算資源が必要で、誤りや、でたらめな内容がたまらないようにする必要がある、と書いています。
- 未来は分からない。 AIの、何が大事かを見分ける判断は良くなってきていますが、先の会話で何が起きるかは、どのモデルにも分かりません。見直しは、あとから振り返って、記憶を整理し、誤りを直す機会を与えます。
私の読みでは、この4つの問いは、どれも「今の答えは、まだ試行の途中」という意味です。数字を、決定版としてではなく、設計の方向を示す手がかりとして受け取る、という私の解釈と合っています。
使わなかった主張
共有された話の中には、そのまま使うと誤りになるものがありました。
- 「ドリーミングはClaude Codeで使える」:Claude Codeの文書に記載が見つからないため、使いませんでした。
- 「顧客の完了率が約6倍になった」:製品告知に載る、顧客の自己申告で、条件が書かれていないため、使いませんでした。
- 「Fable 5は約10個のファイル」:本文は「9個のファイルと、全体の目標を書いた1つのファイル」です。本文に合わせました。
- Stainless社を買収した、という記述:記事自身の記述ですが、別の資料で確かめていないため、本編では使いませんでした。
結論:絞る、見直す、短く保つ
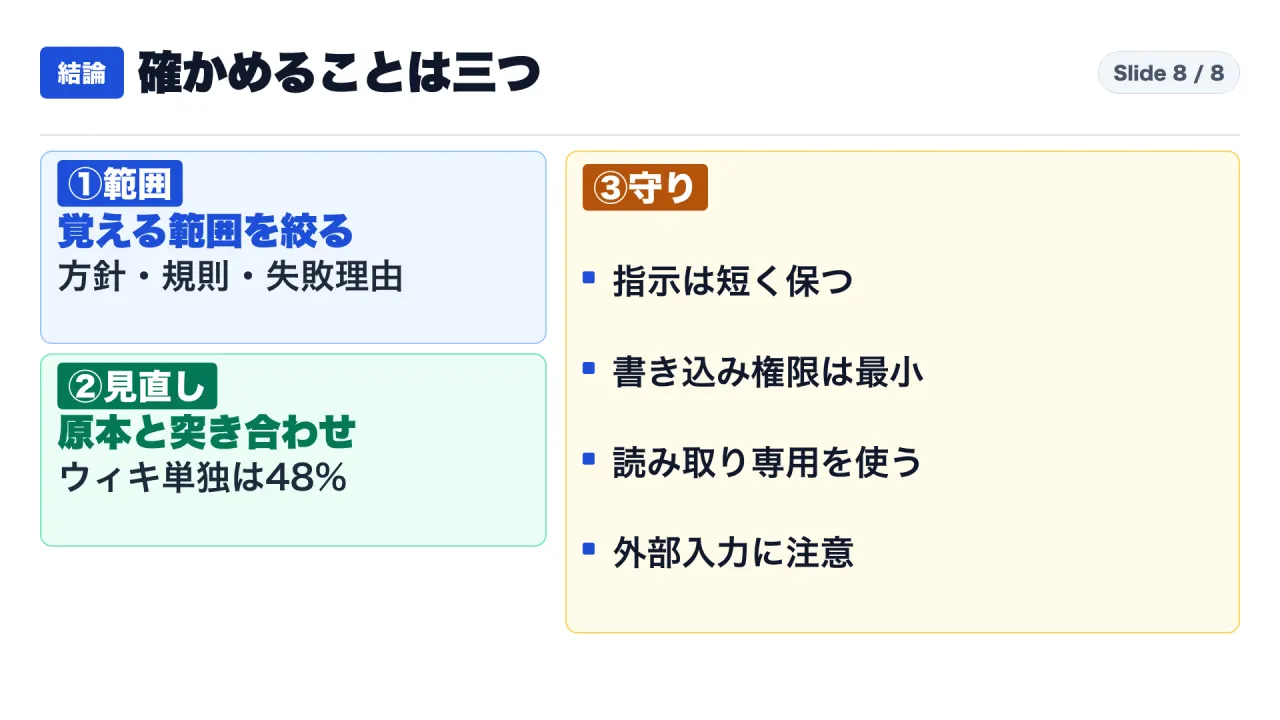
- 覚える範囲を絞る。 毎回読み直せる情報は覚えさせない。方針、確かめ済みの規則、失敗した理由に絞る。ゲームでは、413個のモデルより、9個のモデルが先へ進みました(各1回、自社測定)。
- 原本と突き合わせて見直す。 誤ったメモは、あとの会話で信頼されます。ウィキだけで48%、検索と併用で61%でした(25問、自社測定)。
- 毎回読む指示は短く、書き込み権限は最小に。 外から入る文章を扱うAIでは、記憶への書き込みが、攻撃の入り口になりえます。
小さな一歩として、いま使っているAIの設定で、毎回読み込ませている指示を、一度読み返してください。短くできる行と、画面や資料から読み直せる行を、消します。
よくある疑問と答え
Q1. 記憶は、少ないほど良いのですか。
そうは言えません。記事が示したのは、「何でも書く」より「読み直せないものに絞る」ほうが進んだ、という1つの例(各1回)です。CL-Benchでは、記憶を持たせると、多くのモデルで得点が上がっています。問題は量ではなく、何を、どの層に、どんな書き方で置くかです。
Q2. ウィキを作るのは、やめたほうがいいですか。
そうは言えません。複数の資料をまたぐ質問では、ウィキを使うと87%、検索だけだと73%でした。一方、必要な情報が1つの文書に入っている課題では、効果ははっきりしませんでした。使う課題を選ぶ必要がある、というのが記事の読みです。
Q3. 見直し(ドリーミング)をAIに任せれば、記憶の誤りはなくなりますか。
なくなる、とは言えません。記事は、見直しが誤りを直す例を示しますが、誤りの頻度や、見直し自体が誤りを作る確率は、示していません。ウィキに誤りが蓄積しうる、とも書いています。結果は、元を書き換えない別の保存先で受け取り、採用か破棄かを自分で決める形が、安全です。
Q4. 日本で、今すぐ使えますか。
分かりません。製品のドリーミングは、研究プレビューで、使うには申請が必要です。日本での提供可否は、私が見た資料には書かれていません。
Q5. 記事の数字は、信頼できますか。
数字は、Anthropic自身の測定です。実行回数は、ポケモンが各モデル1回、ウィキ実験が25問、CL-Benchは回数の記載がありません。第三者の再現は示されていません。設計の考え方として読み、自分の仕事で小さく試して確かめるのが、安全です。
Q6. 製品のドリーミングを使わずに、同じことはできませんか。
製品の文書には、ドリーミングを自分で作る方法(自分で選んだ指示とモデルで、いつ動かすか、どの記録を読むか、結果をどう使うかを決める)が、公式の事例集(Claude Cookbook)に載っている、と書かれています。私は事例集の中身までは確認していません。記事の考え方(記録を見直し、誤りを直し、整理し直し、結果を採用か破棄か選ぶ)は、人が手でやることもできます。議事録と記憶の突き合わせを、毎月の定例作業にするだけでも、記事の「見直し」の考え方に近づきます。ただし、これは私の解釈で、効果の大きさは確かめていません。
| 主張 | 出典 |
|---|---|
| 記憶の定義、4つの層、ドリーミングの呼び名と着想 | Anthropicの記事(11月6日) |
| ポケモン赤の記憶フォルダの比較、CL-Benchの得点、記録を失敗だけに限る規則の影響 | 同上(図の数値は図の説明文) |
| 誤ったメモの訂正、ウィキ実験、ウィキの失敗例、共有表の上書き、毎回読み込む層、見直しの未解決の問い | 同上 |
| 研究プレビュー、申請制、2026年5月19日 | 製品告知(5月19日) |
| 入力を変更せず別に出力、1〜100件のセッション、料金、ゼロ・データ・リテンション対象外、対応モデル | 開発者文書「Dreams」 |
| 既定の読み書き権限、プロンプトインジェクションの警告、読み取り専用の推奨、版の保存期間、1万件の上限 | 開発者文書「Memory stores」 |
| 0.364−0.330=0.034、203÷115=約1.77 | 私の計算(公表値ではない) |
出典
- Anthropic「The components of agent memory」(2026年11月6日)
- Anthropic「Claude Managed Agents」新機能の発表(2026年5月19日)
- Claude開発者文書「Dreams」
- Claude開発者文書「Memory stores」
- Claude Code文書「Memory」
この動画の元になった内容は、2026年11月7日に取得したものです。動画は、https://youtu.be/ynVt2aMjTKM で見られます。
数字や仕様は、公開後に更新されることがあります。最新の内容は、各出典で確認してください。
このチャンネルについて
はじめて読む方は、固定の自己紹介記事もご覧ください。https://note.com/consuloji_ch/n/n1975ecc3cf48