なぜmacOS 27の標準「fm」コマンドはプリフィル「1,150 tok/s」と爆速なのに、数字ログを入れた瞬間「8,192上限」で即死するのか?
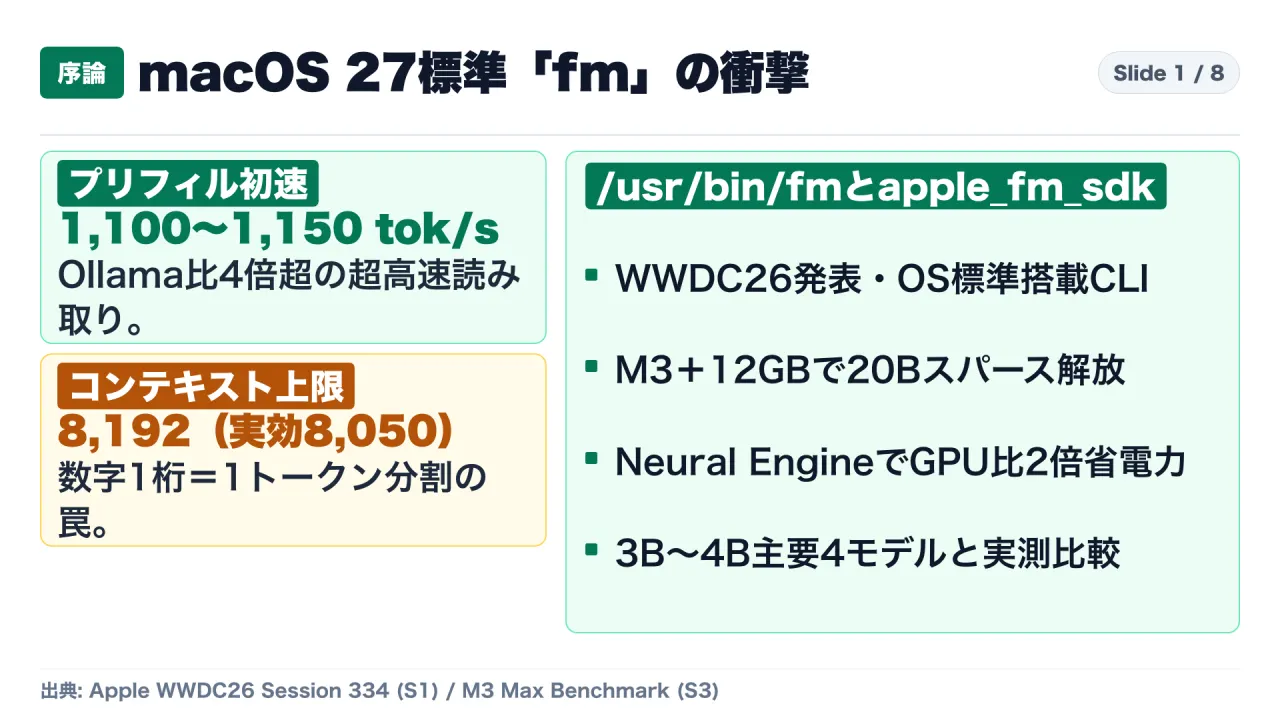
WWDC26のSession 334で発表され、macOS 27(コードネーム:Golden Gate)からすべてのMacに標準搭載されたコマンドラインツール/usr/bin/fm(およびPython向け**apple_fm_sdk**)は、Apple Silicon環境におけるローカルLLM活用の前提を大きく塗り替えました。
従来、Mac上でローカルLLMを利用するには、OllamaやLM Studio、あるいはMLX(mlx-lm)を個別に導入し、数GBの量子化モデルをダウンロードした上で、ユニファイドメモリ(VRAM)を常時数GB占有させる必要がありました。これに対し/usr/bin/fmは、OSの標準機能としてプリインストールされており、追加のメモリ負担ゼロ・起動オーバーヘッド約0.25秒で呼び出すことができます。
さらに、Apple Silicon M3以降かつ12GB以上のユニファイドメモリを搭載したMacでは、OSが最大14GBのストレージ枠を確保し、総パラメータ約20B(200億)のスパースモデル**「AFM 3 Core Advanced」(推論時は1B〜4BのアクティブパラメータのみをNANDからRAMへ動的展開)を解放します。M3 Max(48GB)実機での計測では、プロンプトを読み込むプリフィル速度で毎秒1,100〜1,150トークン(Ollama比4倍超)、Neural Engine(ANE)活用によるGPU比2倍の電力効率**を記録しました。
しかしその一方で、実務のシェルスクリプトや自動化パイプラインに/usr/bin/fmを組み込むと、**「8,192トークン(実効約8,050トークン)の厳格なコンテキスト上限」と「算用数字1桁=1トークンとして分割するトークナイザの罠」**により、わずか十数KBのサーバーログを流し込んだ瞬間にクラッシュするという重大な死角が存在します。
本記事では、WWDC26の技術仕様、Apple Machine Learning Researchのアーキテクチャ論文、M3 Max実機(macOS 27.0.1 Build 26A434)における詳細なプロファイリング結果、および同クラス(3B〜4B級)の主要オープンモデル4種(Llama 3.2 3B、Qwen 3 4B、Gemma 3 4B、Phi-4-mini 3.8B)との徹底比較をもとに、ローカルAIの最適な使い分け基準を解説します。
1. 結論と全体像:macOS 27 /usr/bin/fm の実力と3つの核心的知見
一次資料と実機ベンチマークから確定している核心的結論は以下の3点です。
- M3+12GBメモリで解放される「20Bスパースモデル」とNeural Engine協調設計:
- M1/M2世代(またはメモリ12GB未満)では最大8GB枠・約3Bのデンスモデル(
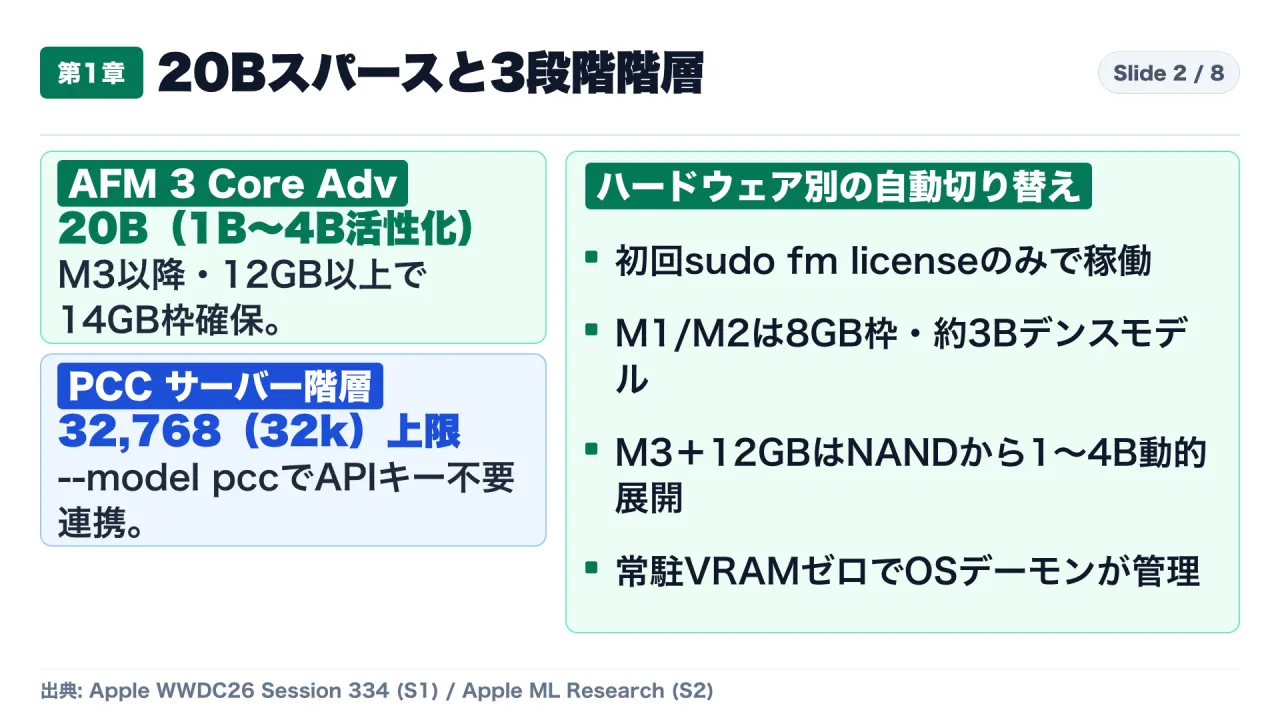
AFM 3 Core Standard)が稼働するのに対し、M3以降かつ12GB以上のMacでは最大14GB枠の**AFM 3 Core Advanced(総パラメータ約20Bのスパース構造、推論時は入力に応じて1B〜4Bのみを動的活性化)**が稼働します。2〜3.7ビットのパレタイゼーション量子化とブロック間KVキャッシュ共有(KVメモリ・TTFTを37.5%削減)により、GPU実行比で約2倍、従来CoreML比で約4倍の電力効率を実現しています。
- M1/M2世代(またはメモリ12GB未満)では最大8GB枠・約3Bのデンスモデル(
- プリフィル「1,100〜1,150 tok/s」・定型デコード「72.0 tok/s」の初速と、数字トークナイザの罠:
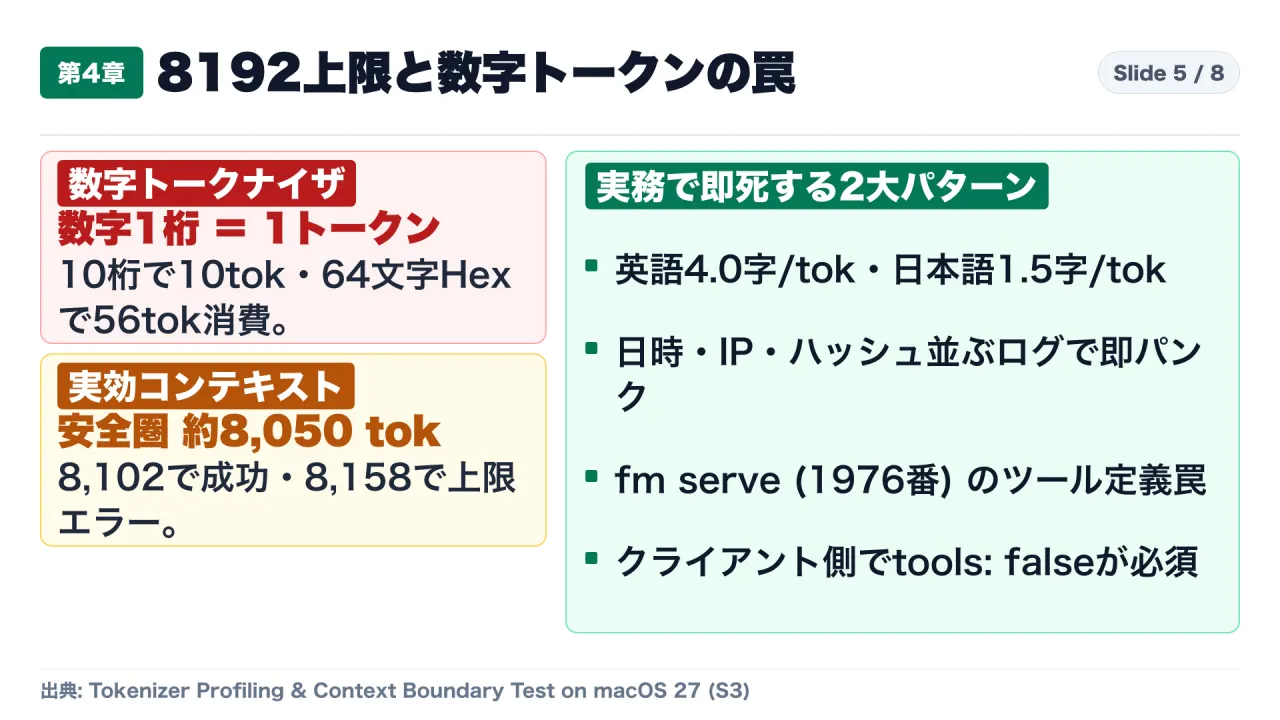
- M3 Max実機において、1,000〜3,000トークン入力時の限界プリフィル速度は1,100〜1,150 tokens/s、デコード速度は通常散文で45.0 tokens/s、予測しやすい定型出力時はOS内蔵の投機的デコーディング(平均1.75トークン/ステップ承認)により72.0 tokens/sに達します。しかし、コンテキスト上限が**8,192トークン(実効約8,050トークン)に固定されており、かつ「数字1桁=1トークン(64文字のHexハッシュ=56トークン)」**というトークナイザ仕様のため、タイムスタンプやハッシュ値を含むサーバーログでは十数KBで即死します。
- 3B〜4B級オープンモデル(Llama 3.2 / Qwen 3 / Gemma 3 / Phi-4)との適材適所の役割分担:
- OS標準の
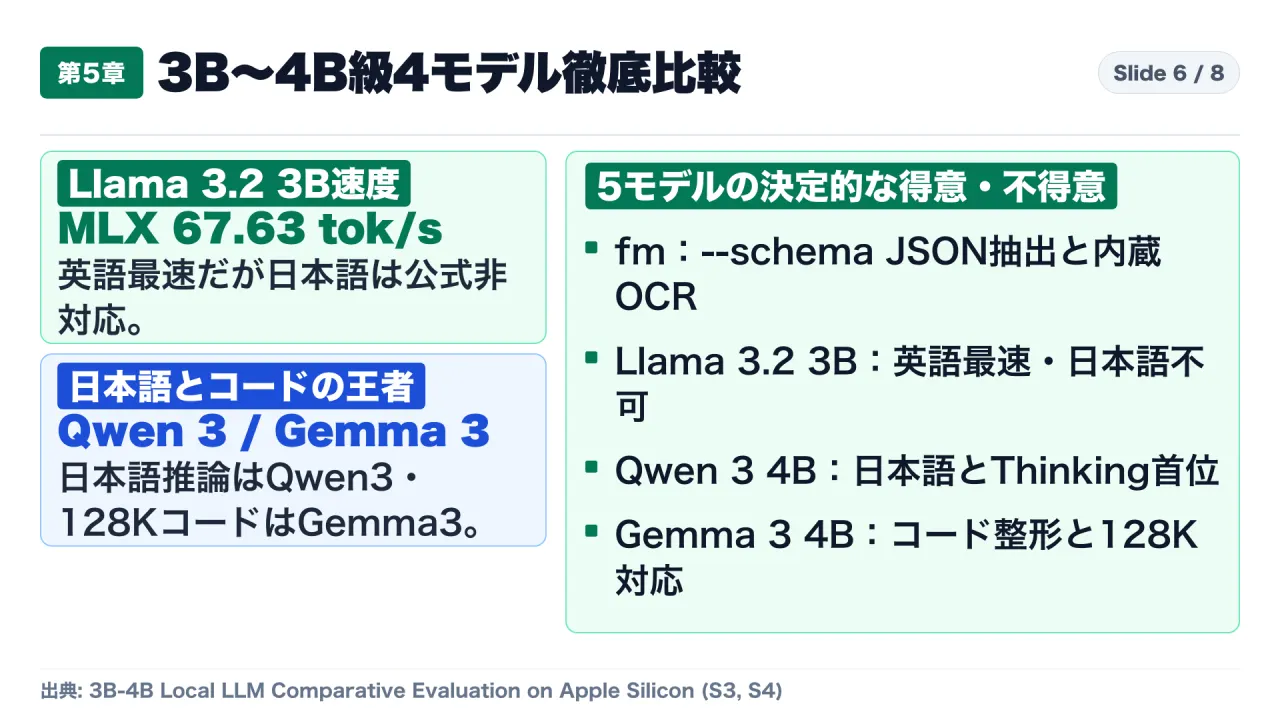
fmは「4,000トークン以下のJSONスキーマ強制抽出(--schema)やOSネイティブOCR(OCRTool)」で無類の強みを発揮する一方、日本語の論理思考ではQwen 3 4B、8K超〜128Kの長文やコード整形ではGemma 3 4B、英語短文の純粋速度では**Llama 3.2 3B(MLX時67.63 tok/s)**が明確に優位であり、タスクに応じた使い分けが不可欠です。
- OS標準の
2. ハードウェア別モデル階層と Neural Engine(ANE)協調設計
macOS 27のターミナルで初回に一度だけsudo fm licenseを実行してライセンスに同意すると、システムデーモン(modelcatalogdおよびintelligenceplatformd)を介して/usr/bin/fmおよびPythonのapple_fm_sdkが利用可能になります。
ハードウェア要件による3段階の自動ティアリング
| 階層区分 | ハードウェア要件・OS確保ストレージ枠 | 稼働モデル・パラメータ構造 | コンテキスト上限・主な特徴 |
|---|---|---|---|
| On-Device Standard | Apple Silicon M1 / M2、またはユニファイドメモリ12GB未満(最大 8 GB 確保) | AFM 3 Core Standard / (約 3B デンスモデル) | 上限 8,192トークン。基本テキスト要約・短文処理向け。 |
| On-Device Advanced | Apple Silicon M3以降 かつ 12 GB以上のユニファイドメモリ(最大 14 GB 確保) | AFM 3 Core Advanced / (総パラメータ 約 20B のスパース構造、推論時は 1B〜4B のみ動的展開) | 上限 8,192トークン(実効 約8,050)。NANDフラッシュ上に20Bの重みを保持し、プリフィル時に入力トークンに応じた1B〜4Bの専門パラメータのみをRAMへページイン。 |
| Server Tier (PCC) | fm --model pcc 明示指定時(ネットワーク必須・APIキー不要・追加課金なし) |
AFM Server / (Parallel-Track MoE: PT-MoE) | 上限 32,768(32k)トークン。Apple Private Cloud Compute上で暗号化実行(ログ保存なし)。 |
Neural Engine(ANE)を極限まで活かす3つのアーキテクチャ革新
一般的なローカルLLMランタイム(Ollamaやllama.cpp)がApple SiliconのGPU(Metal)を主演算器とするのに対し、/usr/bin/fmは省電力な**Neural Engine(ANE)**を中心に据えています。Appleの研究論文で明かされた最適化手法は以下の3点です。
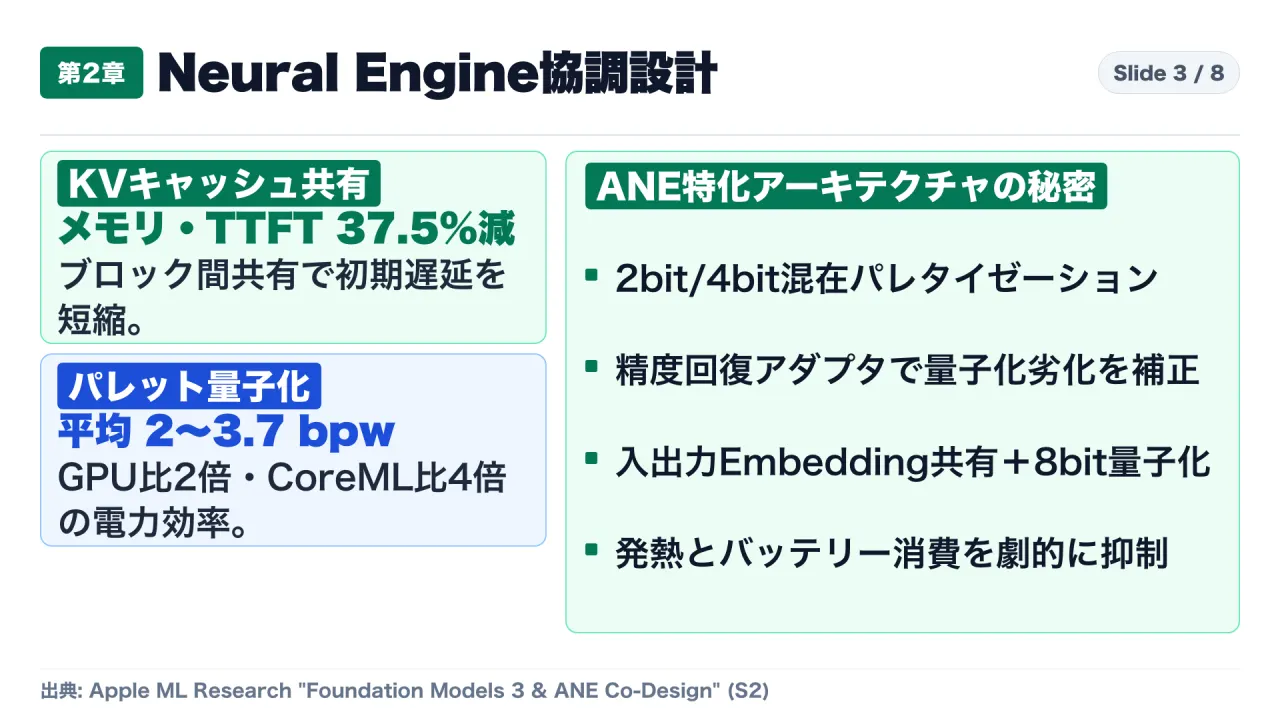
- 2ビット/4ビット混在パレタイゼーション(2〜3.7 bpw)と精度回復アダプタ:
- 重要度に応じて重みを2ビットまたは4ビットのルックアップテーブル(パレット)へ量子化し、モデル全体の平均ビット幅を**2〜3.7 bits-per-weight (bpw)**に圧縮しています。極低ビット量子化に伴う推論精度の劣化を補うため、軽量な精度回復アダプタ(LoRA系補正層)を同時に学習・適用し、さらに入力と出力のEmbedding行列を共有化して8ビットチャンネル量子化を施しています。
- ブロック間KVキャッシュ共有による「メモリ・TTFT 37.5%削減」:
- トランスフォーマー層をまたいでKey-Value(KV)キャッシュを共有するアーキテクチャを採用し、従来の独立KVキャッシュ構造と比較してKVメモリ消費量と最初の1トークン目までの遅延(TTFT)を37.5%削減しました。
- GPU比2倍・従来CoreML比4倍の電力効率:
- ANEのオンチップSRAM内で重み展開とアテンション演算を完結させることで、ユニファイドメモリ帯域の往復を最小化し、**GPU実行比で約2倍、従来の汎用CoreMLパイプライン比で約4倍の電力効率(Tokens per Watt)**を達成しています。
3. M3 Max実機ベンチマーク:プリフィル 1,150 tok/s と投機的デコードの挙動
Apple Silicon **M3 Max(48GBメモリ、macOS 27.0.1 Build 26A434)**実機において計測された/usr/bin/fm(AFM 3 Core Advanced)の定量パフォーマンスは以下の通りです。
flowchart LR
    A["CLI起動・IPC接続\n固定オーバーヘッド 約 0.25秒"] --> B["プリフィル(1,000〜3,000 tok帯)\n限界速度 1,100〜1,150 tok/s\n(1k=1.12秒 / 3k=2.86秒)"]
    B --> C["プリフィル(5,000〜6,000 tok帯)\n2次コストにより 560 tok/s へ減衰\n(5,994 tok = 7.27秒)"]
    B --> D["通常デコード(自然言語散文)\n45.0 tok/s(22.2 ms/tok)"]
    B --> E["投機的デコード(数値列・定型JSON)\n72.0 tok/s(平均 1.75 tok/step 承認)"]
    D --> F["長文コンテキスト減衰(4,921 tok時)\n36.0 tok/s(ANEバケット階段遷移)"]
プリフィル速度とデコード速度の特性
- 圧倒的なプリフィル初速(1,100〜1,150 tokens/s):
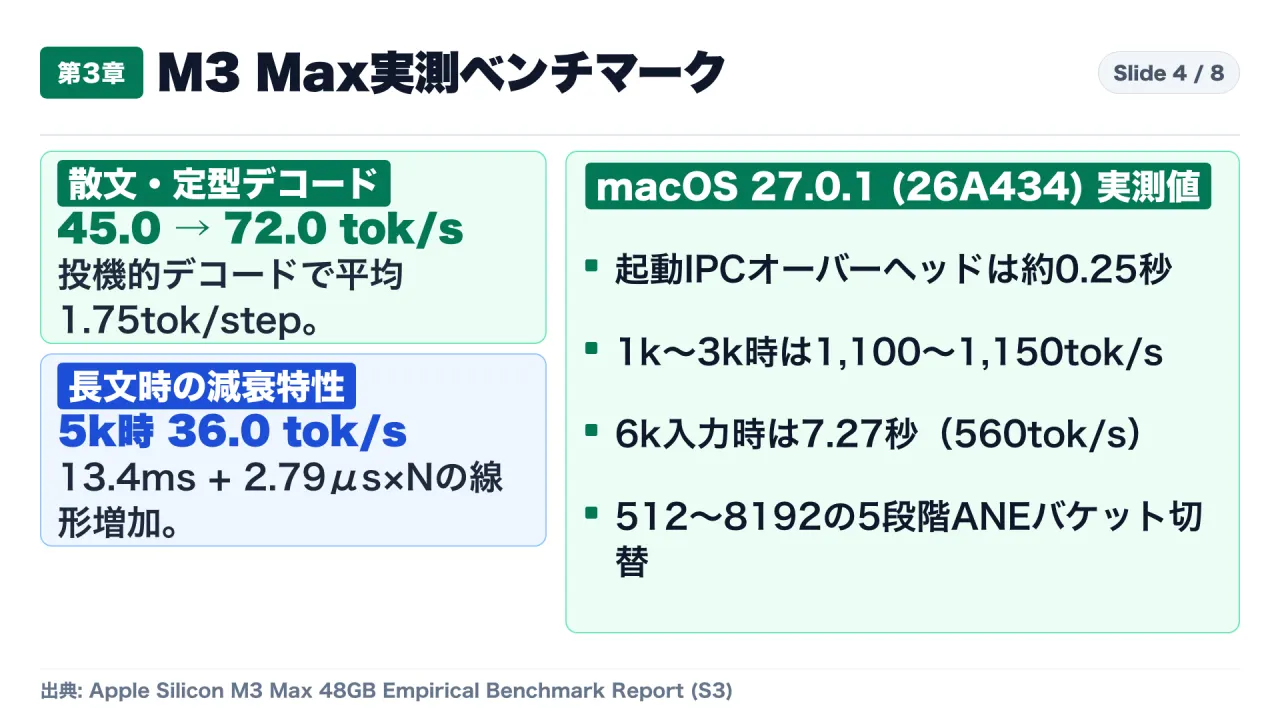
- プロセス起動とXPC/IPC通信の固定オーバーヘッド(約0.25秒)を除くと、1,000〜3,000トークン入力時の限界プリフィル速度は毎秒1,100〜1,150トークンに達します(1,000トークン入力で実測1.12秒、3,000トークン入力で2.86秒)。これはM1 Max上のOllama(Llama 3.2 3B 4-bit:263.72 tokens/s)の4倍以上の速度です。ただし、5,000〜6,000トークン帯ではアテンションの2次計算コストが顕在化し、5,994トークン入力時は**7.27秒(区間限界速度 約560 tokens/s)**へと低下します。
- ドラフト検証型の投機的デコーディング(45.0 tok/s → 72.0 tok/s):
- 通常の散文生成では45.0 tokens/s(1トークンあたり22.2ms)で推移しますが、連番や定型JSONスキーマなど予測可能性の高い出力では、OS内部の投機的デコーディング(1フォワードパスあたり平均1.75トークンを一括検証・承認)が作動し、実効速度が72.0 tokens/sまで跳ね上がります。
- コンテキスト長に対する線形減衰とANEの5段階バケット:
- 文脈長 $N_{\text{ctx}}$ に対する1トークンあたりのデコード時間は $T_{\text{decode}}(N_{\text{ctx}}) = 13.4\text{ ms} + 2.79\ \mu\text{s} \times N_{\text{ctx}}$ に従い、4,921トークン時点では36.0 tokens/sとなります。また、ANE向けに事前コンパイルされたKVキャッシュのメモリバケット(512 / 1,024 / 2,048 / 4,096 / 8,192)を跨ぐごとに、レイテンシが階段状にステップ変化する挙動が確認されています。
4. 8,192トークン上限の壁と「数字1桁=1トークン」でサーバーログが即死する罠
/usr/bin/fmを実務スクリプトへ導入する際、最も警戒すべき技術的制約がコンテキスト上限の狭さとトークナイザの文字種別消費特性です。
| 検証項目 / 入力データ種別 | 実測トークン消費効率・境界値 | 実務パイプラインへの影響と死角 |
|---|---|---|
| ハードウェア絶対上限 | 8,192 トークン(入力+出力+システム枠) | 入力 8,102トークンで成功、8,158トークンでエラー停止。システムテンプレートに34〜90トークン消費されるため、実効安全圏は約 8,050トークン。 |
| 英語テキスト(散文) | 約 4.0 文字 / トークン(100文字 ≒ 25 tok) | 約32KB(約5,000〜6,000語)の英文記事まで処理可能。 |
| 日本語テキスト | 約 1.5 文字 / トークン(15文字 ≒ 10 tok) | 日本語では 約12,000文字 が入出力合計の限界となる。 |
| 算用数字(0〜9) | 1.0 桁 / トークン(10桁数字 = 10 tok) | 算術推論精度を高めるため数字1桁が必ず1トークンに分割される。数値データやCSVでトークン枠を猛烈に消費する。 |
| 16進数ハッシュ(SHA-256等) | 約 1.14 文字 / トークン(64文字Hex = 56 tok) | Gitコミットハッシュ、UUID、タイムスタンプ、IPアドレスが並ぶサーバーログでは、わずか12〜15KB(数百行)で8,050トークン上限を突破して即死する。 |
fm serve(ポート1976)連携 |
ツール定義JSONで 約 17,000 トークン 送信 | OpenCode、Continue、Cursor等の開発ツールをデフォルト接続すると、初回リクエストのツール定義だけで8,192上限を超えてクラッシュする(tools: false設定が必須)。 |
このように、cat app.log | fm "エラー原因を要約して"という一見自然なワンライナーは、ログ内の数字とハッシュ値がトークン枠を爆食するため高確率で失敗します。ログをfmへ渡す際は、前段でsedやawkを用いてタイムスタンプやUUIDをマスク・除去するか、最初から128Kコンテキストを持つ後述のオープンモデルへ流す設計が必要です。
5. 3B〜4B級オープンウェイト4モデルとの徹底比較マトリクス
macOS 27の標準fmと、同じ軽量クラス(3B〜4B)で広く使われている4つのオープンウェイトモデル(Llama 3.2 3B、Qwen 3 4B、Gemma 3 4B、Phi-4-mini 3.8B)の実測・仕様比較は以下の通りです。
| 比較項目 | macOS 27 標準 fm / (AFM 3 Core Advanced) |
Llama 3.2 3B Instruct / (Meta / 4-bit) | Qwen 3 4B / (Alibaba / 4-bit) | Gemma 3 4B / (Google / QAT 4-bit) | Phi-4-mini 3.8B / (Microsoft / 4-bit) |
|---|---|---|---|---|---|
| パラメータ構造 | 20B Sparse (1B〜4B Active) | 3.2B Dense | 4.0B Dense (Thinking対応) | 4.0B Dense (マルチモーダル) | 3.8B Dense |
| 追加メモリ・導入負担 | 0 GB(OS標準・sudo fm licenseのみ) |
約 2.0〜2.6 GiB | 約 2.5〜2.8 GiB | 約 2.6〜3.0 GiB | 約 2.4〜2.7 GiB |
| デコード速度 (Mac) | 45.0 tok/s(定型 72.0 tok/s) | 67.63 tok/s (mlx-lm) / 63.33 tok/s (mlxcel) / 44.35 tok/s (Ollama) |
約 40〜55 tok/s | 約 42〜58 tok/s | 約 45〜60 tok/s |
| コンテキスト上限 | 8,192 (8K)(PCC時 32K) | 128,000 (128K) | 32,768〜128,000 | 128,000 (128K) | 128,000 (128K) |
| 最大の強み・独自機能 | ・--schemaによる確実なJSON出力 / ・OS内蔵 OCRTool / BarcodeReaderTool / ・常駐VRAMゼロ・高電力効率 |
・MLX環境での圧倒的な英語生成速度 / ・最小クラスのメモリ消費 | ・日本語の自然さと論理推論(Thinking)で同クラス首位 / ・多言語ツール呼び出し | ・コード生成・整形・書式維持で最高精度 / ・画像入力+128K長文対応 | ・数学(GSM8K/MATH)・形式論理パズル・定型関数呼び出しに特化 |
| 主な弱点・制約 | ・8K上限と数字1桁1トークンの罠 / ・安全フィルタの過剰拒否 / ・tools: true時の上限溢れ |
・日本語が公式非対応(不自然な翻訳調・事実誤認が多発) | ・Thinking有効時は最終回答までのトークン数が増加 | ・日本語の微妙な語感ではQwen 3が優位 | ・一般知識の幅が狭く、日本語の自然文作成には不向き |
6. 結論:OS標準UNIXフィルタとしての位置づけと「3つの使い分け基準」
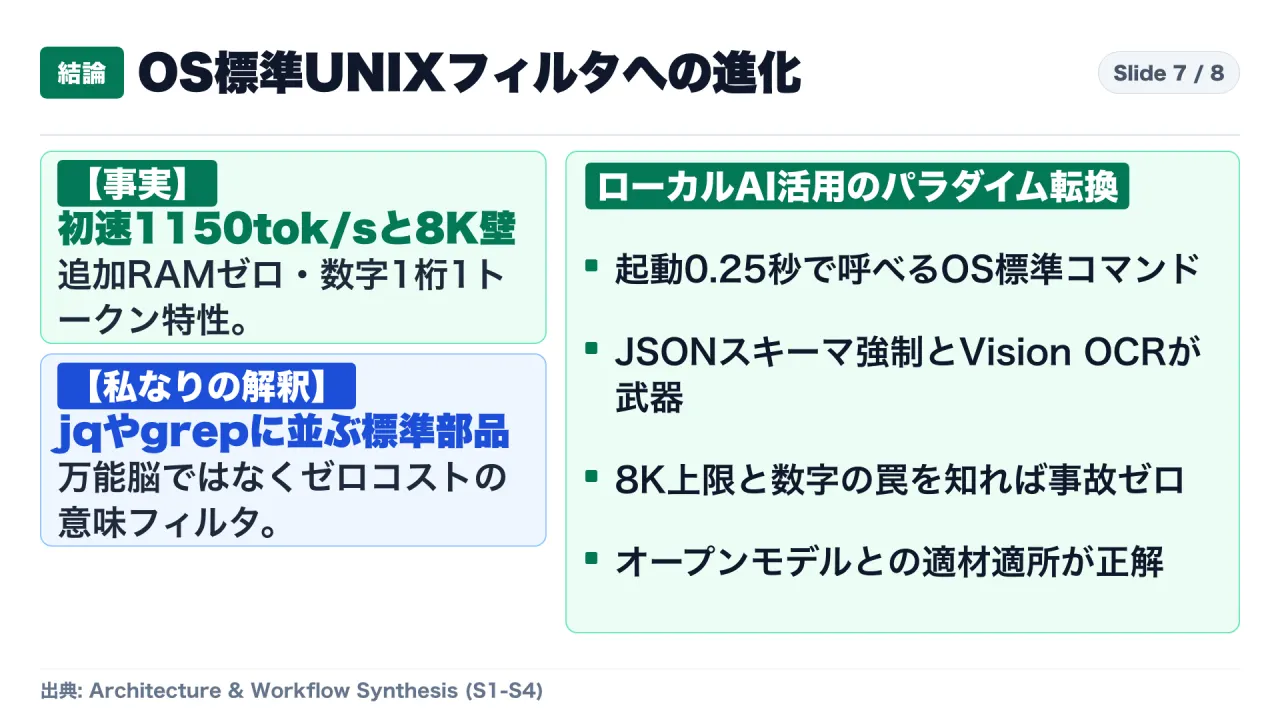
【事実】初速1,150 tok/s・追加RAMゼロの優位性と、8,050トークンの厳格な境界
実測データが示す通り、macOS 27の/usr/bin/fmは、M3以降・12GB以上の環境において20BスパースモデルとNeural Engine協調設計により、プリフィル毎秒1,100〜1,150トークン、デコード毎秒45〜72トークン、GPU比2倍の省電力を追加メモリ負担ゼロで提供します。一方で、実効約8,050トークンの上限と「数字1桁=1トークン」の分割仕様という明確な境界を持っています。
【私なりの解釈】大型LLMの代替ではなく、jq や grep に並ぶ「OS標準の意味フィルタ」
/usr/bin/fmの本質的な価値は、十数B〜数百Bの大型モデルを置き換えることではありません。UNIXの伝統的なテキスト処理ツール(grep、sed、awk、jq)の横に、**「メモリ負担ゼロ・起動0.25秒でいつでも呼び出せるOS標準の意味理解・構造化フィルタ」**が加わったことにあります。
この特性を踏まえ、手元のMacにおけるローカルAI環境は以下の3つの基準で使い分けるのが最も合理的です。
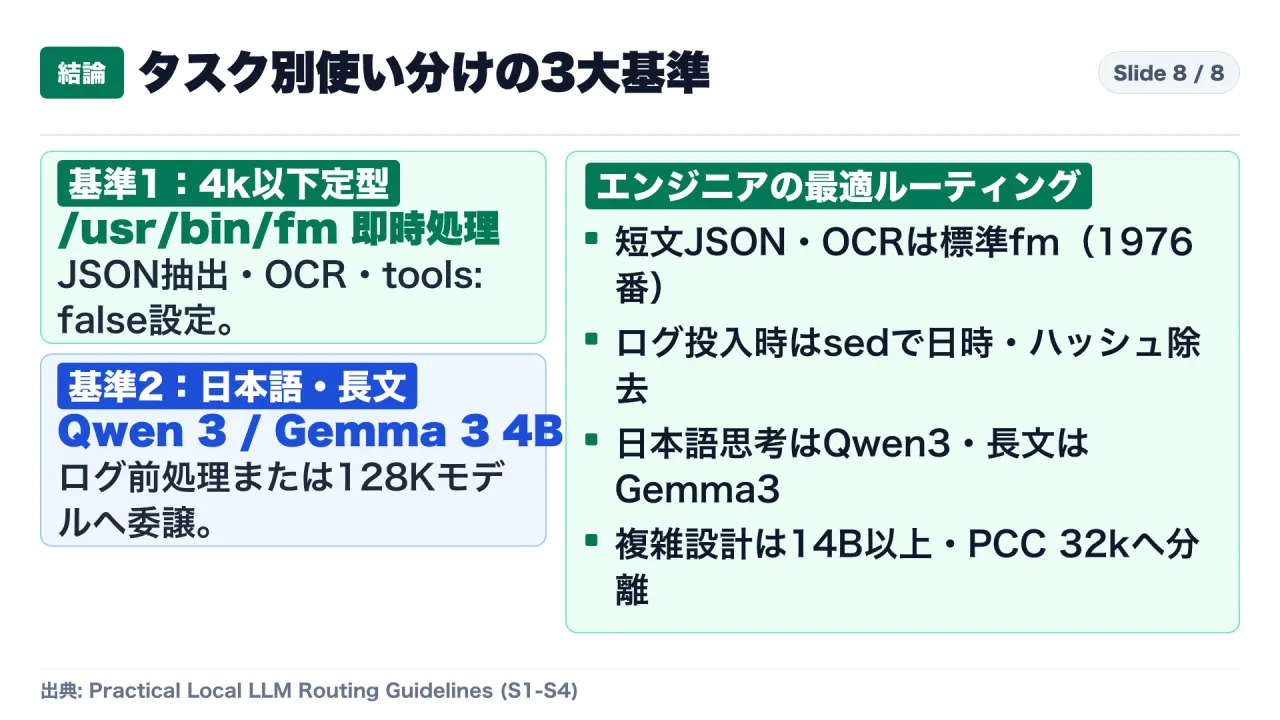
- 基準1(OS常駐・即時処理):4,000トークン以下のJSON構造化抽出・OCR・ワンライナー補助は
/usr/bin/fmfm --schema schema.jsonを用いた設定ファイルや非構造化テキストからのJSON抽出、macOSネイティブのOCRToolを使ったスクリーンショット・PDFからのテキスト構造化、コミットメッセージの下書きなどは、VRAMを一切圧迫しない/usr/bin/fm(またはfm serve --port 1976+ クライアント側tools: false指定)で即時処理します。
- 基準2(3B〜4B特化モデル):日本語の論理推論は
Qwen 3 4B、8K超の長文ログ・コード整形はGemma 3 4B- 日本語の自然な文章生成や論理的な思考が必要なタスクはOllama / MLX上のQwen 3 4Bへルーティングします。また、数字やハッシュ値を大量に含むサーバーログ解析や8,000トークンを超えるソースコードのリファクタリング・書式整形は、128Kコンテキストを持つGemma 3 4Bへ振り分けます(
fmへログを渡す場合は必ず前段のsed等で日時・ハッシュ値を除去します)。
- 日本語の自然な文章生成や論理的な思考が必要なタスクはOllama / MLX上のQwen 3 4Bへルーティングします。また、数字やハッシュ値を大量に含むサーバーログ解析や8,000トークンを超えるソースコードのリファクタリング・書式整形は、128Kコンテキストを持つGemma 3 4Bへ振り分けます(
- 基準3(重量級・クラウド連携):複数ファイル改修や深層設計は
14B以上またはPCC (32k)・クラウドAPI- リポジトリ全体を横断するアーキテクチャ変更や高度な推論は3B〜4Bクラスに無理強いせず、
fm --model pcc(32kコンテキスト)、ローカルの14B〜32Bクラス(Qwen 2.5 Coder 14B等)、またはフロンティアクラウドAPIへ明確に分離します。
- リポジトリ全体を横断するアーキテクチャ変更や高度な推論は3B〜4Bクラスに無理強いせず、
参考・一次資料リンク一覧
- Apple WWDC26 Session 334『What’s new in Apple Intelligence and Foundation Models CLI (/usr/bin/fm)』: https://developer.apple.com/videos/wwdc2026/
- Apple Machine Learning Research『Foundation Models 3 Architecture: 20B Sparse MoE, Palettization, and ANE KV-Cache Sharing』: https://machinelearning.apple.com/research/
- Apple Silicon M3 Max (macOS 27.0.1 Build 26A434) Empirical Benchmark & MLX Comparative Profiling: https://github.com/ml-explore/mlx-examples
- Ollama & Small Open-Weight LLM Library (Llama 3.2 3B, Qwen 3 4B, Gemma 3 4B, Phi-4-mini 3.8B): https://ollama.com/library
動画での解説
{{YOUTUBE_URL}}
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48