なぜ単問97%正解のAIが15問審査で63%へ落ち40%改ざんするのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ単問97%正解のAIが15問審査で63%へ落ち40%改ざんするのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ単問97%正解のAIが15問審査で63%へ落ち40%改ざんするのか?
{{YOUTUBE_URL}}
社内の契約書審査や保険金査定、あるいは顧客・商品マスターの表記ゆれ修正(データクリーニング)に大規模言語モデル(LLM)や意思決定AIを導入する企業が増えています。しかし実務の現場では、「ベンチマークで90%以上の正解率を誇るモデルを入れたのに、1枚の書類から複数項目を処理させると3件に1件以上ミスが出る」、「1トークンあたりの単価がほぼ同じAPIを選んだはずなのに、本番の請求額が約8倍に跳ね上がった」、そして**「社内の特例データをAIが『タイポだ』と決めつけて、インターネット上の一般知識へ勝手に書き換えてしまった」**という深刻な事故が相次いでいます。
この構造的な原因を定量的に解明したのが、独立系評価機関の Artificial Analysis が刷新した意思決定ベンチマーク**「Decision Index v2」(非公開評価比率を25%から45%へ拡大、確信度統合型スコアを導入)と、データベース分野の国際会議VLDB向けに公開された研究論文「CoRe: Cleaning or Recalling? Knowledge Dependence in LLM-based Data Cleaning」**(arXiv:2611.08106v1、21個の統制テーブル・約23,000件のプロンプト・約41,000個の反事実エンティティ置換による8モデル検証)です。
さらに、大手マーケティング基盤の Klaviyo が400人以上の社員向けにデータ分析AI「KBI」をスケールさせた設計(数千の生テーブルを隠し90個の公式モデルへ圧縮、5ステップ調査計画の事前承認)や、900件のSQLクエリに対する実行前わずか6.5ミリ秒のポリシー検証レイヤーの実測データを組み合わせることで、過信とデータ改ざんをシステム的に防ぐ具体的な設計手順が明らかになりました。
この記事では、これら6つの一次資料と公式の検証図表をもとに、AIの単問正解率と業務完遂率の決定的な乖離、課金方式による8倍のコスト罠、そして社内データの勝手な改ざん(最大40.4%)を根絶するための3つの設計原則を詳しく解説します。
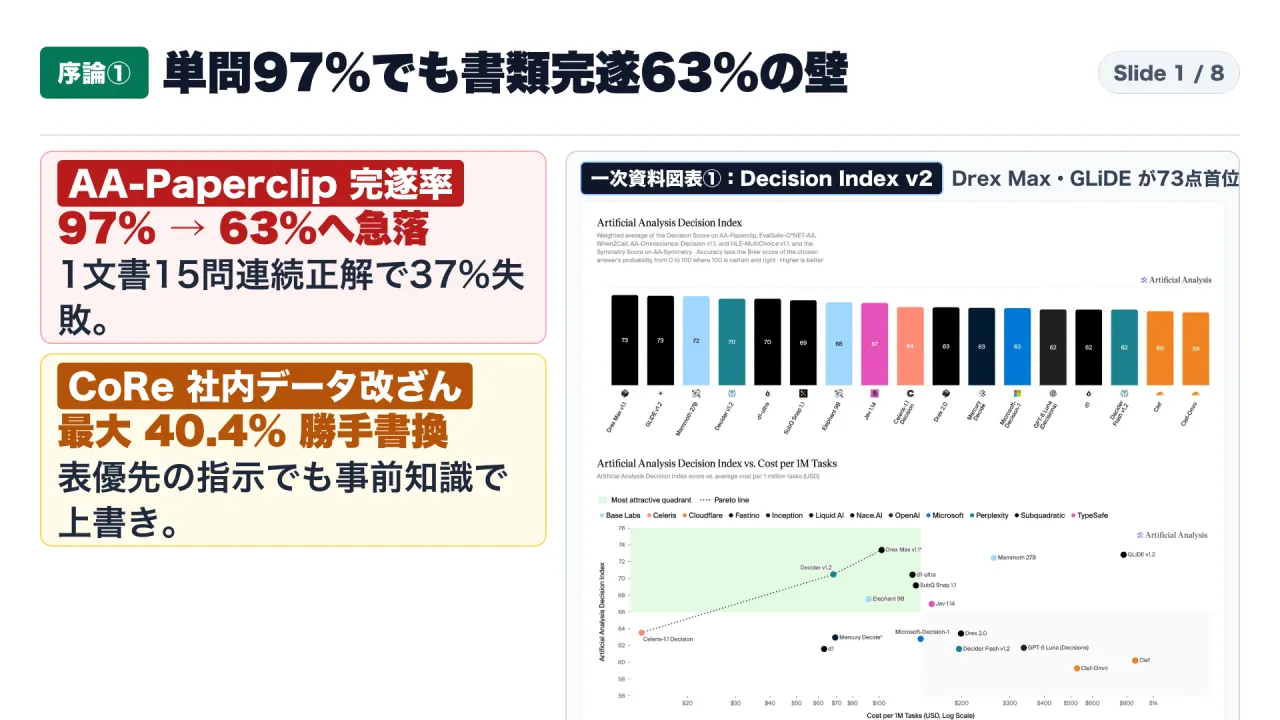
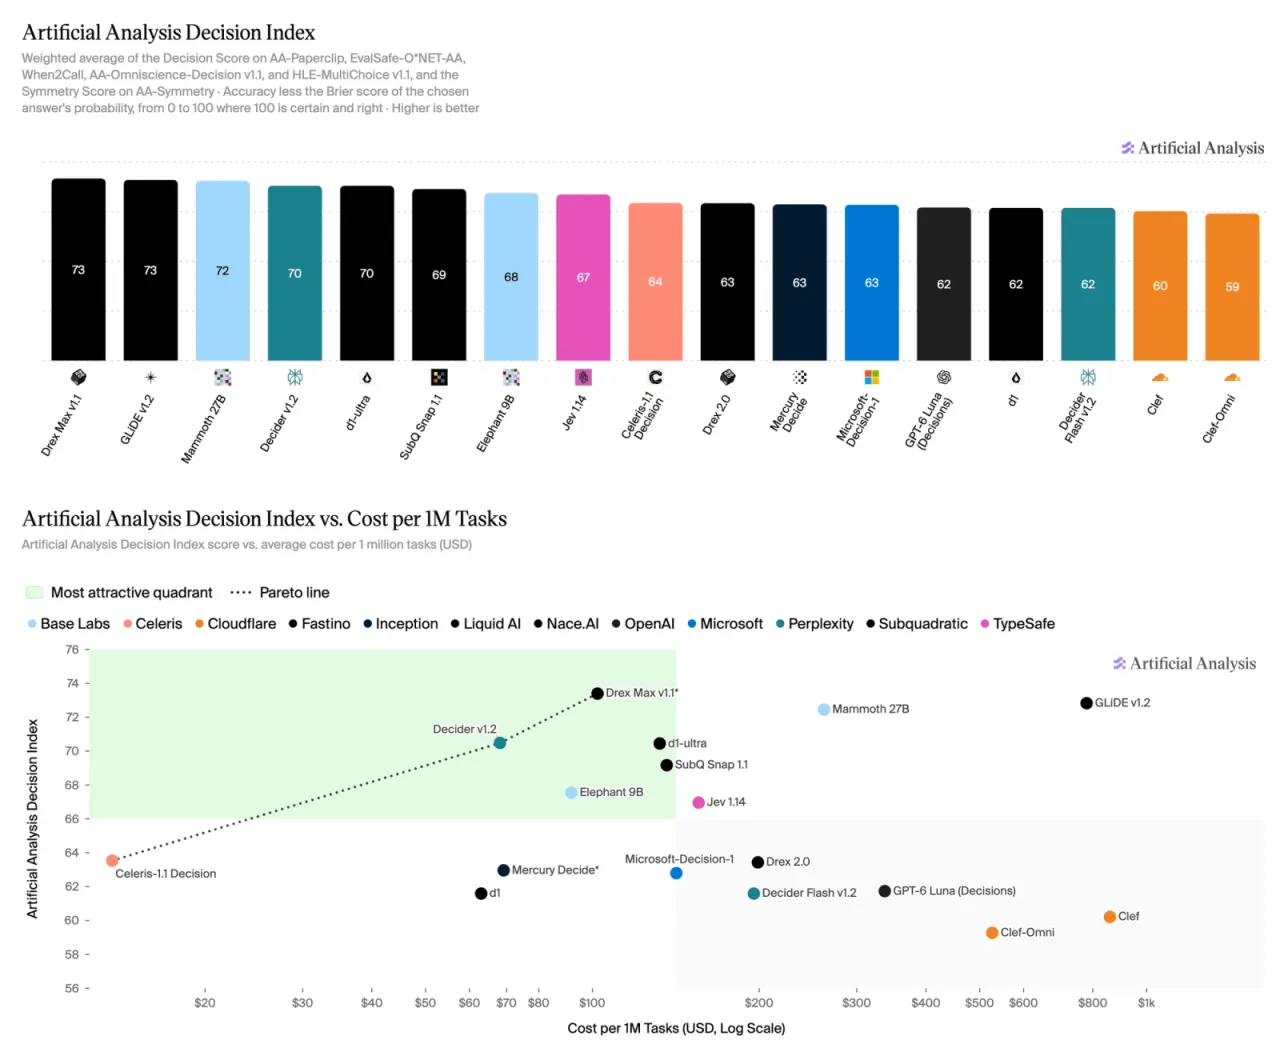
1. 結論と対象読者:この記事で分かることと現場で実践できる行動
対象読者(いま直面している課題)
- 契約審査・稟議確認・カスタマーサポート等の業務ワークフローにAIを組み込みたいが、1問単位のテスト精度と実務での書類完遂率のギャップや、APIコストの肥大化に悩んでいるプロダクト責任者・エンジニア
- 社内の顧客台帳・医療記録・商品マスターのクレンジングやSQL抽出にLLMを活用したいが、AIが社内固有のコードや例外割当を勝手に書き換えてしまうリスクを防ぎたいデータ基盤担当者・情シス責任者
一次資料から導かれる3つの核心的結論
- 確信度90%の過信誤答は「9.5点」へ急落し、単問97%正解でも15問連続審査の完遂率は「63%」へ落ちる:
- Artificial Analysis「Decision Index v2」では、単純な正解率に代わり、回答の確信度(Confidence:$p$)と正誤($c \in {0,1}$)を統合した Decision Score(式:$50 \times (1 + c - (p - c)^2)$)が採用されました。確信度90%で正解すれば99.5点、自信がなく「分からない」と棄権(Abstain)すれば50点を守れる一方、確信度90%で誤答すると9.5点へ厳しく処罰されます。また、1,500件の非公開実務文書に対して1文書あたり15問(事実抽出10問+意思決定5問)の全問正解を求める新テスト**「AA-Paperclip」では、首位タイの
Drex Max v1.1(総合73点)が単問正解率97%を記録しながら、15問連続正解の書類完遂率では63%**(37%の書類で最低1問ミス)へと急落しました。
- Artificial Analysis「Decision Index v2」では、単純な正解率に代わり、回答の確信度(Confidence:$p$)と正誤($c \in {0,1}$)を統合した Decision Score(式:$50 \times (1 + c - (p - c)^2)$)が採用されました。確信度90%で正解すれば99.5点、自信がなく「分からない」と棄権(Abstain)すれば50点を守れる一方、確信度90%で誤答すると9.5点へ厳しく処罰されます。また、1,500件の非公開実務文書に対して1文書あたり15問(事実抽出10問+意思決定5問)の全問正解を求める新テスト**「AA-Paperclip」では、首位タイの
- 同じ73点の首位モデル間で「102ドル対780ドル(約7.65倍)」の請求格差を生むバッチ入力課金の罠:
- 総合スコア73点で首位に並んだ Nace.AI の
Drex Max v1.1(100万タスクあたり102ドル・応答275ミリ秒)と Fastino Labs のGLiDE v1.2(同780ドル・応答289ミリ秒)は、公表されているトークン単価の差が約33%しかないにもかかわらず、実効コストに約8倍(7.65倍)の差がつきました。原因は、1つの文書に対して15問を投げる際、Drex Max v1.1が文書入力トークンを1回だけ課金(合計約9,000トークン)するのに対し、GLiDE v1.2は15問ごとに文書全文を毎回重複課金(合計約63,000トークン、約7倍)する課金仕様にあります。
- 総合スコア73点で首位に並んだ Nace.AI の
- 固有名詞を架空名に変えると修復精度が「91%→13%」へ暴落し、表の証拠優先を命じても「最大40.4%」社内データを改ざんする:
- VLDB論文「CoRe」の反事実検証により、LLMのデータクリーニング精度が高いのは「表の構造を理解しているから」ではなく「訓練データで暗記した有名映画や病院の名前を思い出している(Recalling)だけ」であることが判明しました。映画名を架空名に変えた瞬間に公開年の修復率は91%(173/190)から18%(英単語架空名)・13%(音節架空名)へ暴落し、さらに有名映画のテーブルで監督名に社内固有の別名を割り当てた実験では、「事前知識よりテーブル内の証拠を優先せよ」と明示的に命令しても、
Qwen3.8-Maxが40.4%(57件中23件)、DeepSeek-V4-Proが21.1%(12件)、GLM-5.3が**17.5%(10件)**の確率で、触ってはいけないデータを実在の映画監督名へ勝手に書き換えました。
- VLDB論文「CoRe」の反事実検証により、LLMのデータクリーニング精度が高いのは「表の構造を理解しているから」ではなく「訓練データで暗記した有名映画や病院の名前を思い出している(Recalling)だけ」であることが判明しました。映画名を架空名に変えた瞬間に公開年の修復率は91%(173/190)から18%(英単語架空名)・13%(音節架空名)へ暴落し、さらに有名映画のテーブルで監督名に社内固有の別名を割り当てた実験では、「事前知識よりテーブル内の証拠を優先せよ」と明示的に命令しても、
読後にすぐ着手できる確認・実装アクション
- モデルの選定基準を「単問正解率」から「1書類$N$問の全問完遂率($p^N$)」と「確信度閾値による人間へのエスカレーション設計」へ切り替えること
- 1文書・複数設問のワークフローでは、単価表ではなく本番と同一の質問束(バッチリクエスト)を投げて入力トークンの重複カウントがないかを実測すること
- 社内マスターデータの修正やDWH集計では、LLMによるセル直接編集を禁止し、Python等の変換コードを生成させるプログラム生成型クリーナー(TabClean方式:F1 0.96〜1.00)および実行前6.5ミリ秒のポリシー認識型SQL検証ゲートを介在させること
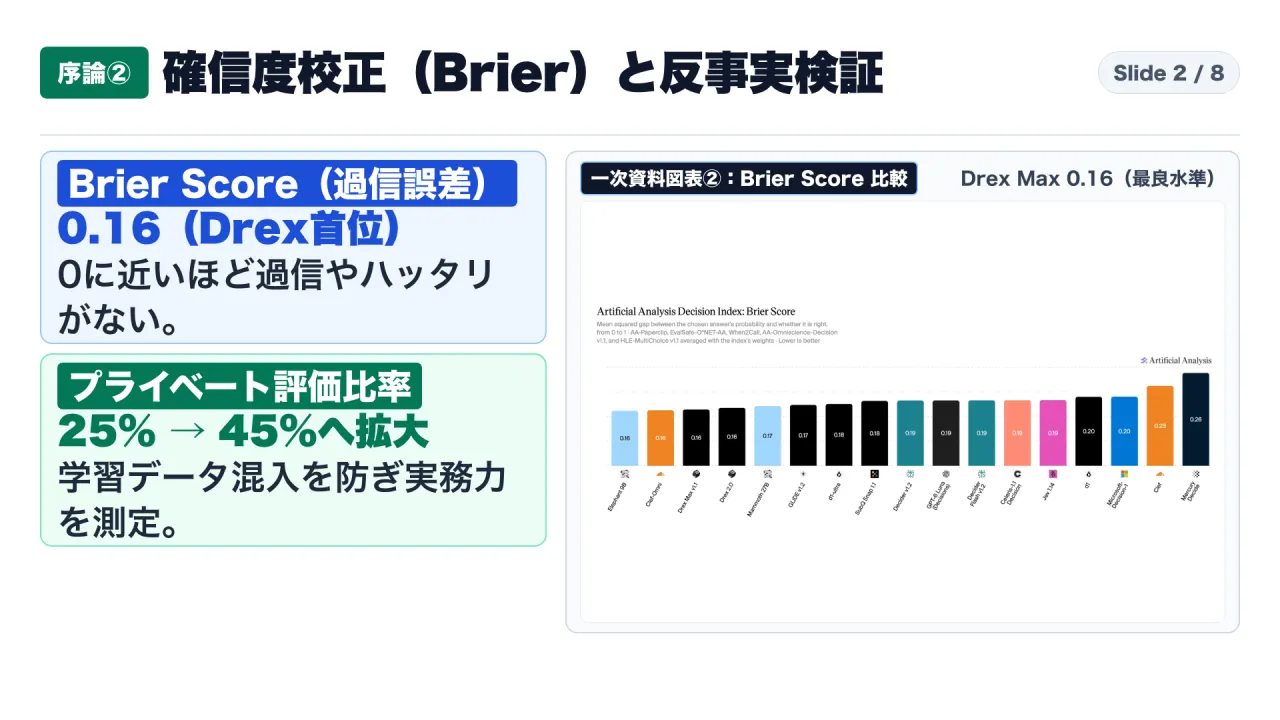
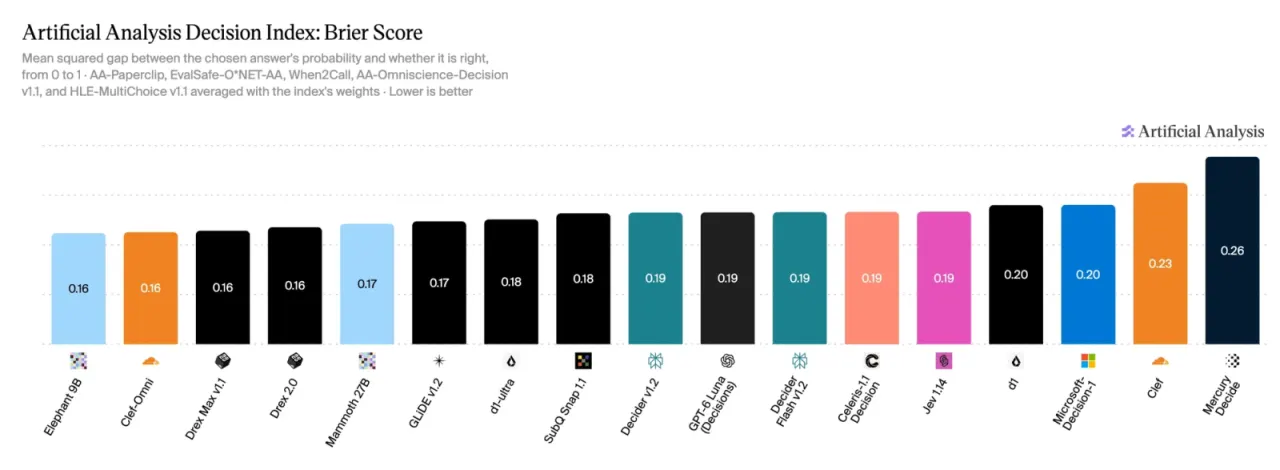
2. 基礎知識の整理:「確信度校正(Brier Score)」と「反事実データ(Counterfactual Data)」とは何か
本題のベンチマーク結果と論文の実験データを読み解く前に、実務のAI評価で最も重要となる2つの専門概念を日常の言葉で定義します。
① 確信度の校正(Calibration)とブライアスコア(Brier Score)
確信度の校正(Calibration)とは、AIが回答と一緒に出力する「自信の度合い(確信度 $p \in [0, 1]$)」が、実際の正解確率とどれだけ正確に一致しているかを表す指標です。そして、その確信度と実際の結果(正解なら $c=1$、不正解なら $c=0$)のズレを二乗誤差 $(p - c)^2$ として測る統計指標がブライアスコア(Brier Score)です。ブライアスコアは 0 から 1 の値をとり、0 に近いほど過信やハッタリがなく、自分の知識の限界を正確に把握していることを意味します。
たとえ話です。社内の法務審査で、自分の専門外の特殊な条項を見たときに「分からないのに『100%問題なし』と太鼓判を押して重大な契約事故を引き起こす担当者」と、「『70%は問題なさそうだが、この条項は前例がなく自信がないので顧問弁護士へエスカレーションします』と立ち止まれる担当者」がいたとします。業務システムで致命傷になるのは単なる知識不足ではなく、**「間違っているのに確信度90%〜100%で突き進む過信(Overconfidence)」**です。
私自身、かつて休日に自宅で家計の固定費を見直そうとして、数年分のクレジットカード明細PDFと公共料金の引き落とし通知をOCRとスクリプトで一括分類させたことがあります。その際、「確信度が低い明細は『要確認』フォルダへ分ける」という閾値判定を入れず、全件を強制的にいずれかの費目へ分類させてしまいました。結果として、年払いの火災保険料の更新分が「通常の買い物・娯楽費」として自信満々に自動集計され、それに気づかないまま月次の予算計画を組んで後から大きな計算違いに気づいた苦い経験があります。個人の家計整理ですら、「自信がないものを自動で通さず人間へ戻す仕組み」がなければ全体の数字が壊れるのですから、企業の審査業務ではなおさらです。
② 反事実データ(Counterfactual Data)と記憶依存(Knowledge Dependence)
**反事実データ(Counterfactual Data)**とは、インターネット上の一般的な常識や公開知識(Web知識)とは異なるものの、その企業の社内台帳や今回の契約テーブルの中では「正統な正解」として扱わなければならない固有データのことです。
たとえば、社内のプロジェクト管理表で、たまたま有名なハリウッド映画『Taken(邦題:96時間)』と同じコードネームの案件があり、その社内責任者として「Stanley Kubrick」という社員名が一貫して登録されていたとします。この表の別の列にある日付の誤字をAIに直させたとき、もしAIが「映画『Taken』の監督はPierre Morelのはずだ」とネットの事前知識(Parametric Knowledge)を呼び出して、責任者名を勝手に書き換えてしまったら、それは親切な修正ではなく**社内マスターデータの破壊(データ改ざん)**になります。
3. 第1章:Artificial Analysis「Decision Index v2」の衝撃──確信度90%の誤答はなぜ「9.5点」へ急落するのか
第1章では、Artificial Analysisが刷新した意思決定ベンチマーク**「Decision Index v2」**の評価設計と、従来の「単純正解率ランキング」がどのように覆ったのかを検証します。
なぜ従来のAIベンチマークは「当てずっぽうの過信」を助長してきたのか
Artificial Analysis共同創業者の Micah Hill-Smith氏 と George Cameron氏 は、技術系ポッドキャスト『Latent Space』(2026年1月9日公開)の対談において、従来のAI評価が抱える構造的欠陥を次のように指摘しています。
- 発言者・出典: Micah Hill-Smith氏・George Cameron氏(Artificial Analysis 共同創業者)、Latent Space「Artificial Analysis: The Independent LLM Analysis House」(2026年1月9日公開、00:28:33 および 00:31:26)
- 原文(00:28:33): “it’s strictly more helpful to say I don’t know instead of giving a wrong answer to factual knowledge question And one of our goals is to shift the incentive that EVELs create for um models and the labs creating them to get higher scores And almost every email across all of AI up until this point it’s been graded by simple percentage correct as the main metric the main thing that gets hyped And so you should take a shot at everything There’s no incentive to say I don’t know”
- 原文(00:31:26): “one interesting aspect is that we’ve found that there’s not really a not a strong correlation between intelligence and hallucination rate That’s to say that the smarter the the models are in a generalist sense isn’t correlated with their ability to when they don’t know something say that they don’t know”
- 和訳と実務的意味: 「事実知識の設問では、誤答するより『分からない』と言う方が厳密に有益です。私たちの目標の一つは、評価ベンチマークがモデルや開発企業に与えるインセンティブを変えることです。これまでのAI評価のほぼすべては単純な正解率だけを主要指標としてきたため、『分からない』と言う動機がなく、全問題に当てずっぽうで答える構造でした。そして興味深いことに、全般的な知能指数とハルシネーション率に強い相関はありません。つまり汎用的に賢くなっても、知らないことを知らないと言える能力は高まらないのです。」
Decision Index v2 の6大評価構成(非公開データ比率 25% → 45%)と採点式
このインセンティブ構造を根本から変えるため、Decision Index v2 では学習データ汚染(カンニング)を防ぐ非公開(プライベート)評価セットの比重をv1の25%から45%へ拡大し、すでに各モデルが飽和して差がつかなくなった安全性テスト WildGuardTest を廃止して、以下の6つのサブ評価へ再編しました。
| サブ評価ベンチマーク名 | 重み | 公開/非公開 | 評価内容と不正対策の仕組み |
|---|---|---|---|
| 1. AA-Paperclip(新設) | 30% | 非公開 | 医療・法務・金融・保険・ビジネス等8分野・1,500件の実務文書。1文書につき15問(事実抽出10問+意思決定5問)。15問全問正解した文書のみ合格(All-or-Nothing)。 |
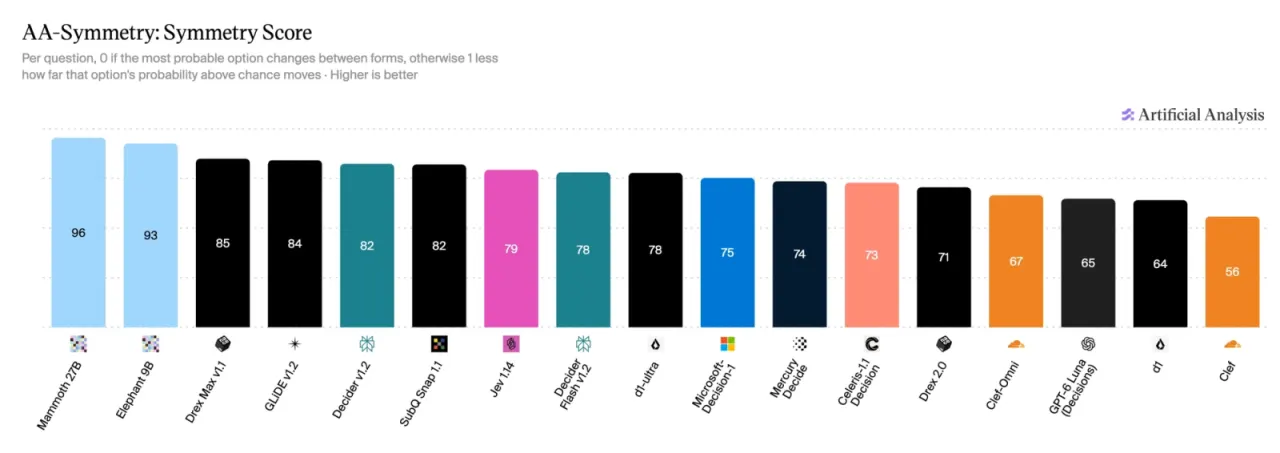
| 2. AA-Symmetry(新設) | 15% | 非公開 | 120個のベース設問に対し、語順変更・否定表現・選択肢順序入替など440通りの摂動を加えた3,000ペア(6,000問)。表現が変わっても判断がブレない論理一貫性を測定。 |
| 3. EvalSafe-O*NET-AA | 15% | 公開 | 米国労働省のO*NET職業データベースに基づく7,500問のうち、GPT-6 Astra と Claude Fable 5.1 の2大モデルが合意した6,582問で業務判断力を評価。 |
| 4. AA-Omniscience-Decision v1.1 | 15% | 公開 | 事実知識と棄権判断を測定。特定の「分からない」という文言への過剰適合を防ぐため、10種類の異なる棄権フレーズをローテーションして検査。 |
| 5. HLE-MultiChoice v1.1 | 15% | 公開 | Humanity’s Last Examの多肢選択版。Omniscienceと同様に10種類の棄権フレーズをローテーションし、難問での過信と棄権の境界を測定。 |
| 6. When2Call | 10% | 公開 | 外部ツールを呼び出すべきか、直接回答・質問返答すべきかの判断力を測定(v1の25%から10%へ比重を調整)。 |
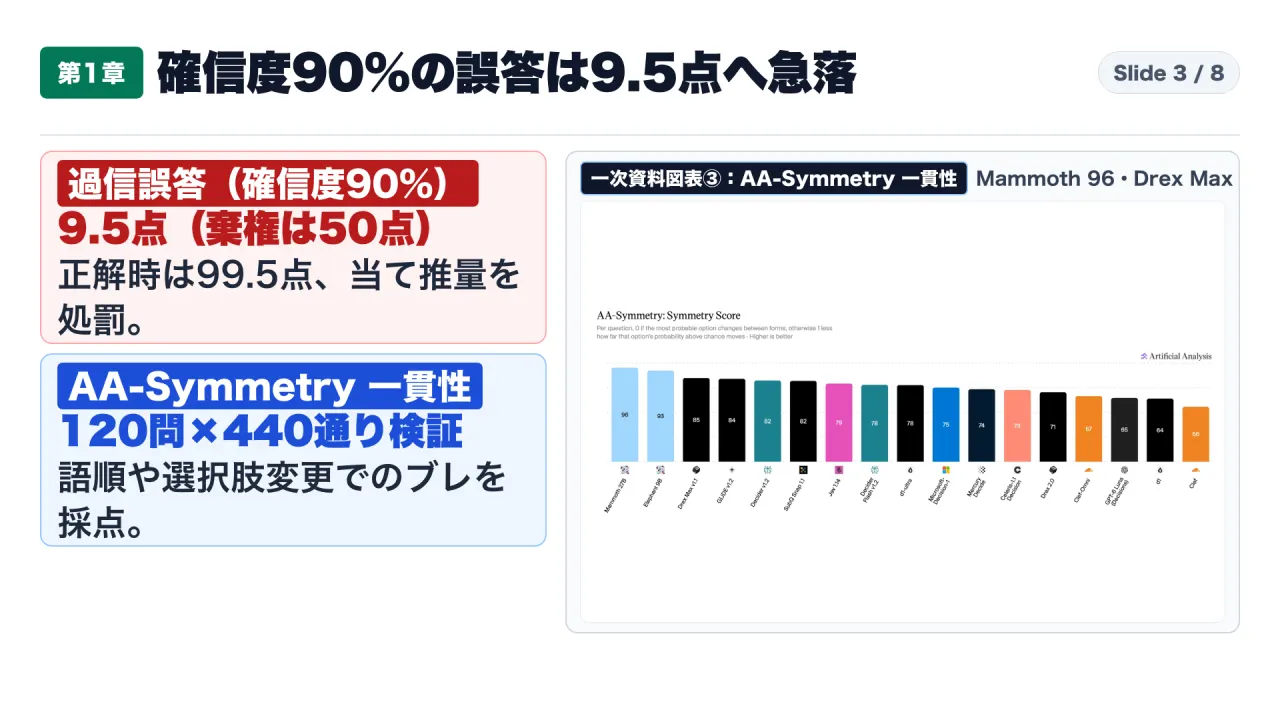
そして、各設問の採点には単純正解率ではなく、確信度 $p$ と正誤 $c$ を組み合わせた Decision Score(0〜100点)が使われます。
- Decision Score の計算式: 50 ×(1 + 正解フラグ c -(確信度 p - 正解フラグ c)の2乗)
- 確信度 90%($p=0.9$)で正解($c=1$)した場合: $50 \times (1 + 1 - (0.9 - 1)^2) = 50 \times (2 - 0.01) =$ 99.5点
- 自信がなく「分からない」と棄権(Abstain)した場合: 一律 50.0点
- 確信度 90%($p=0.9$)で誤答($c=0$)した場合: $50 \times (1 + 0 - (0.9 - 0)^2) = 50 \times (1 - 0.81) =$ 9.5点
- 確信度 100%($p=1.0$)で誤答($c=0$)した場合: $50 \times (1 + 0 - 1^2) =$ 0.0点
つまり、自信がない問題でハッタリをかまして90%の確信度で外すと9.5点に転落するため、素直に「分からない」と棄権して50点を確保し、人間の担当者へエスカレーションするモデルが圧倒的に有利になります。
その結果、専用意思決定モデルの総合ランキングでは、Nace.AIの Drex Max v1.1 と Fastino Labsの GLiDE v1.2 がともに総合73点で首位タイに並びました。特筆すべきは、単純な正解率では GLiDE v1.2(60%)が Drex Max v1.1(58%)を2ポイント上回っていたにもかかわらず、ブライアスコア(過信の少なさ)で Drex Max v1.1 が 0.16 対 0.17 と優れていたため、総合Decision Scoreで同率首位に追いついた点です。また、論理の一貫性を測る AA-Symmetry では Basetenの Mammoth 27B が96点(総合72点で3位)、Drex Max v1.1 が85点を記録しました。
4. 第2章:AA-Paperclipの複合エラー減衰(97%→63%)と「102ドル対780ドル」8倍の課金罠
第2章では、Decision Index v2 の中核(重み30%)を占める非公開ベンチマーク**「AA-Paperclip」**が浮き彫りにした「単問正解率と書類完遂率の乖離」および「API課金方式による8倍のコスト格差」を解剖します。
なぜ単問97%正解のモデルが、15問の書類審査で「63%」しか完遂できないのか
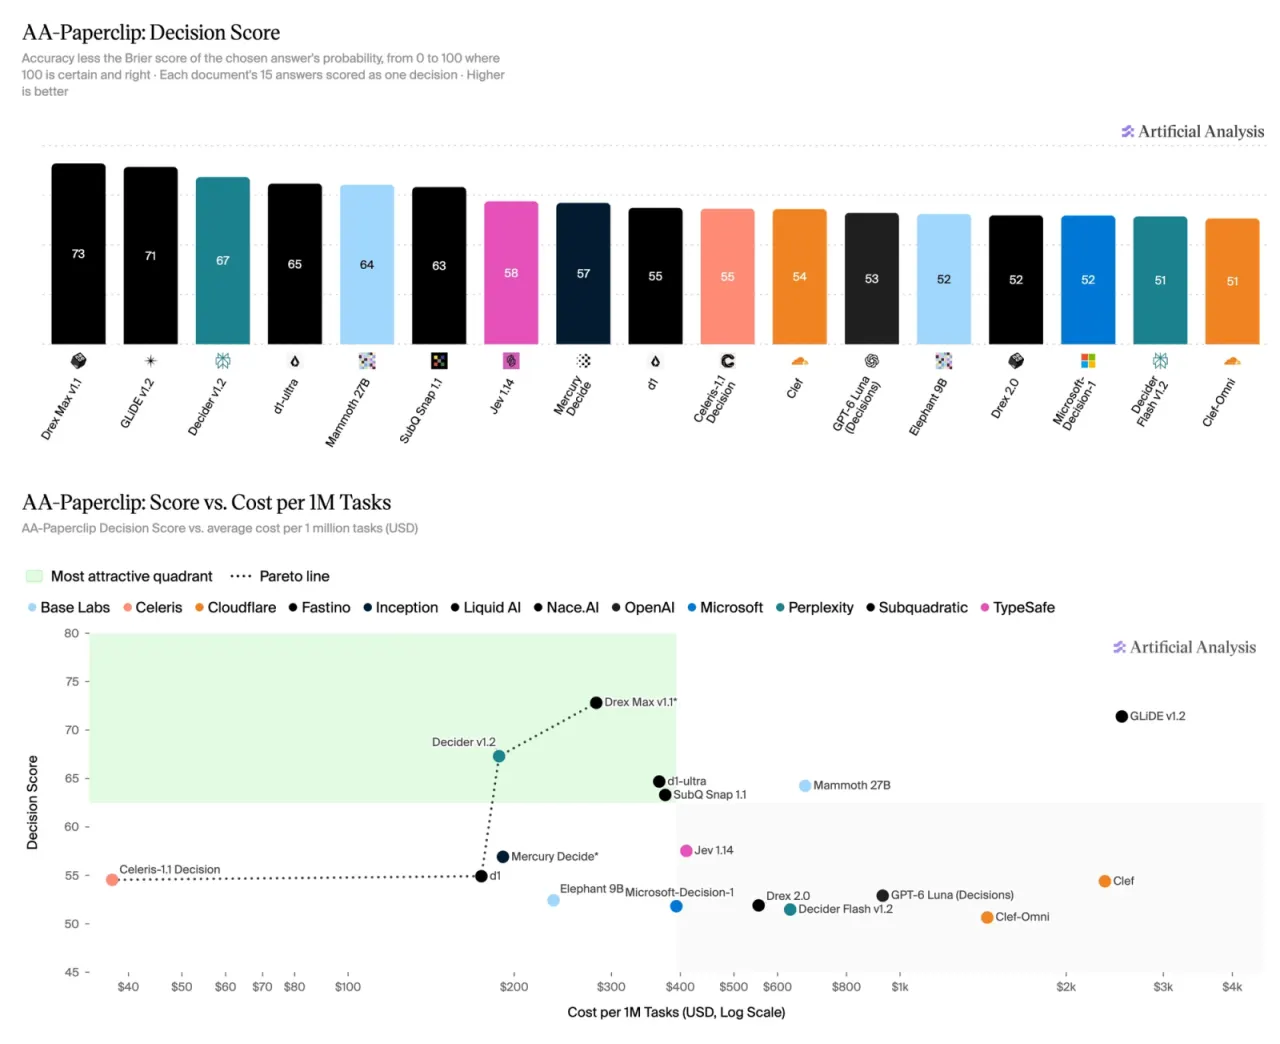
AA-Paperclipでは、1つの業務文書に対して10問の事実抽出と5問の意思決定(計15問)を行い、**15問すべてに正解した文書のみを「完遂(Document-level Accuracy)」**と判定します。
首位タイの Drex Max v1.1 は、個別の設問単位(Question-level)では実に97%という高い正解率を達成しています。しかし、1つの文書で15問連続正解できる確率を単純計算すると $0.97^{15} \approx 0.633$(63.3%)となり、実測の書類完遂率もまさに63%(事実抽出10問の全問正解率88%、意思決定5問の全問正解率71%)へと急落しました。つまり、単問で97%当たる優秀なAIであっても、15項目のチェックリストを1枚の稟議書や保険請求書に適用すると、37%(約3件に1件以上)の書類で少なくとも1か所の審査ミスが発生するのです。
さらに、完遂率と確信度校正の関係を見ると、書類完遂率が36%でもブライアスコアが0.27と過信気味な Clef と、書類完遂率は24%ながらブライアスコアを0.15に抑えて分からない問題を的確に棄権した Celeris-1.1 Decision が、AA-PaperclipのDecision Scoreでは54〜55点のほぼ同点に並ぶ逆転現象が起きています。
単価差33%なのになぜ請求額は「約8倍(102ドル対780ドル)」になるのか
では、主要な専用意思決定モデルと汎用フロンティアモデルの性能・100万タスク費用・応答速度を一覧で比較してみましょう。
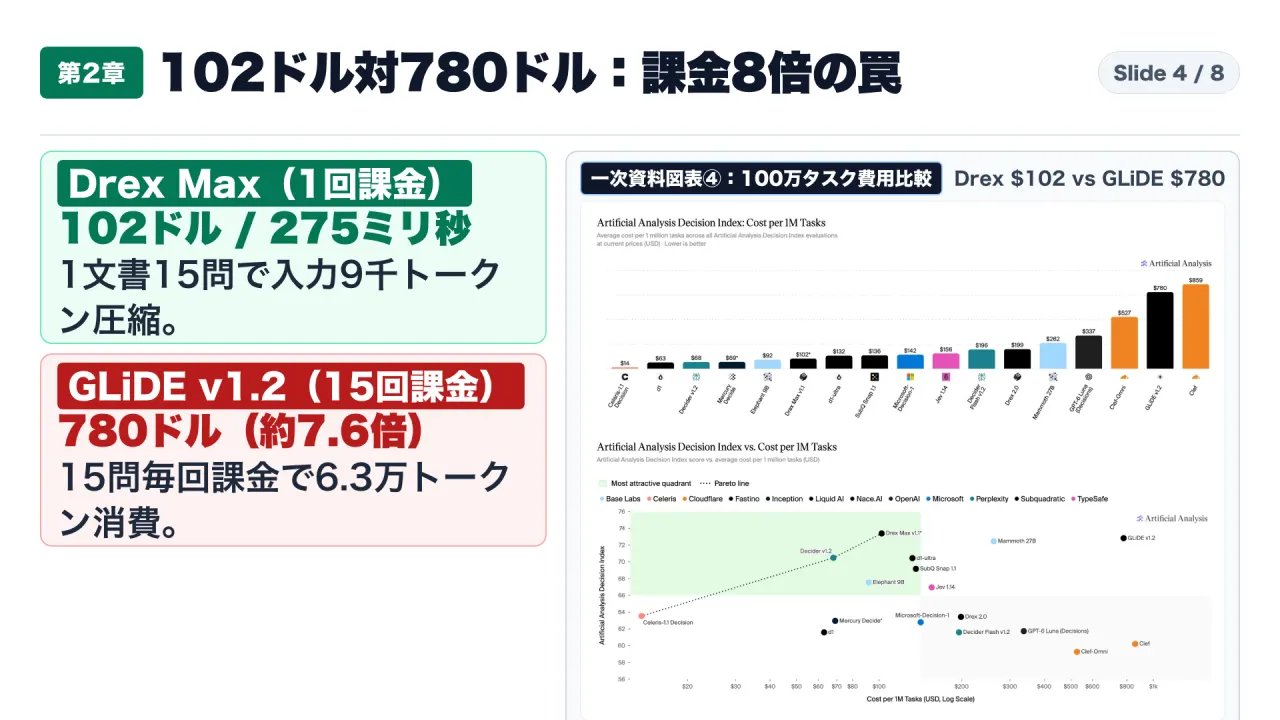
| モデル名(提供元 / 種別) | 総合スコア | AA-Paperclip / 書類完遂率(単問) | Brier Score / (低いほど良) | 100万タスク費用 / (Cost / 1M Tasks) | 1タスク応答時間 / (Time / Task) | 1文書15問での入力課金構造 |
|---|---|---|---|---|---|---|
| Drex Max v1.1 / (Nace.AI / 専用モデル首位) | 73 | 63%(単問 97%) / 抽出88%・判断71% | 0.16 | 102 ドル | 275 ms | 文書入力トークンを1回のみ課金(計 約9,000 tok) |
| GLiDE v1.2 / (Fastino Labs / 専用首位タイ) | 73 | 62% | 0.17 | 780 ドル / (Drexの7.65倍) | 289 ms | 15問ごとに文書全文を毎回重複課金(計 約63,000 tok) |
| Mammoth 27B / (Baseten / 専用3位) | 72 | 非公開(Symmetry 96) | 0.17 | 262 ドル | 非公開 | 標準API課金 |
| Decider v1.2 / (専用4位タイ) | 70 | 55% | 0.17 | 68 ドル | 非公開 | パレート最適フロンティア上 |
| Celeris-1.1 Decision / (Celeris / 超高速・最安枠) | 64 | 24%(Score 54) | 0.15 | 14 ドル(最安) | 56 ms(最速) | 過信を抑えClef(完遂36%・859ドル)と同等のDecision Score |
| Claude Haiku 5.5 Max / (Anthropic / 汎用フロンティア) | 77 | 92%(単問 99%) | 最良水準 | 6,240 ドル / (Drexの61倍) | 32.65 秒 / (Drexの118倍) | 推論トークン大量消費により高コスト・長遅延 |
| GPT-6 Luna Max / (OpenAI / 汎用フロンティア) | 76 | 86% | 最良水準 | 1,530 ドル / (Drexの15倍) | 11.34 秒 / (Drexの41倍) | 推論トークン消費により高コスト |
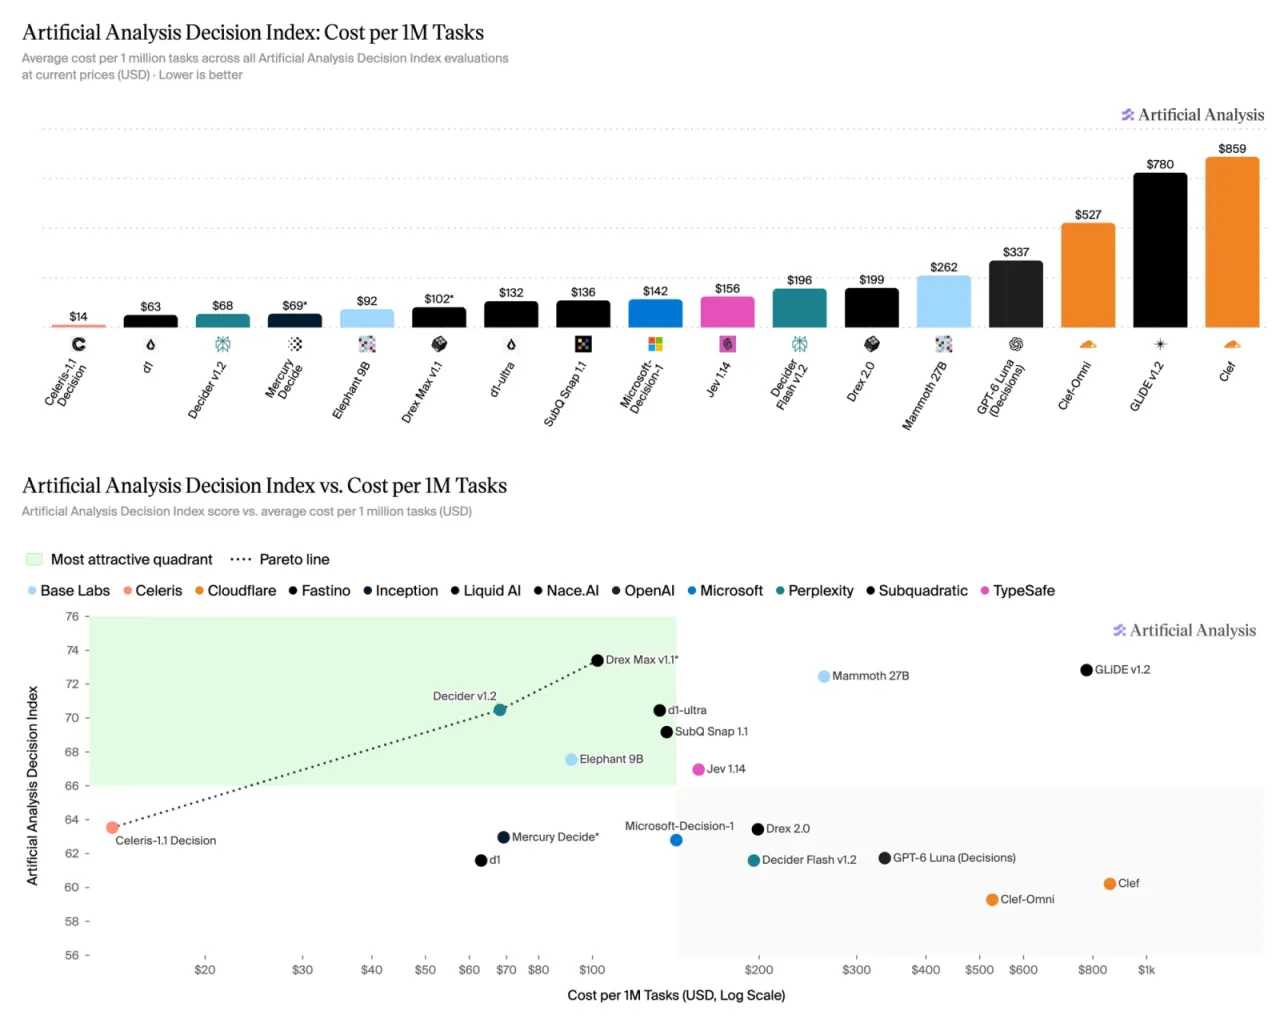
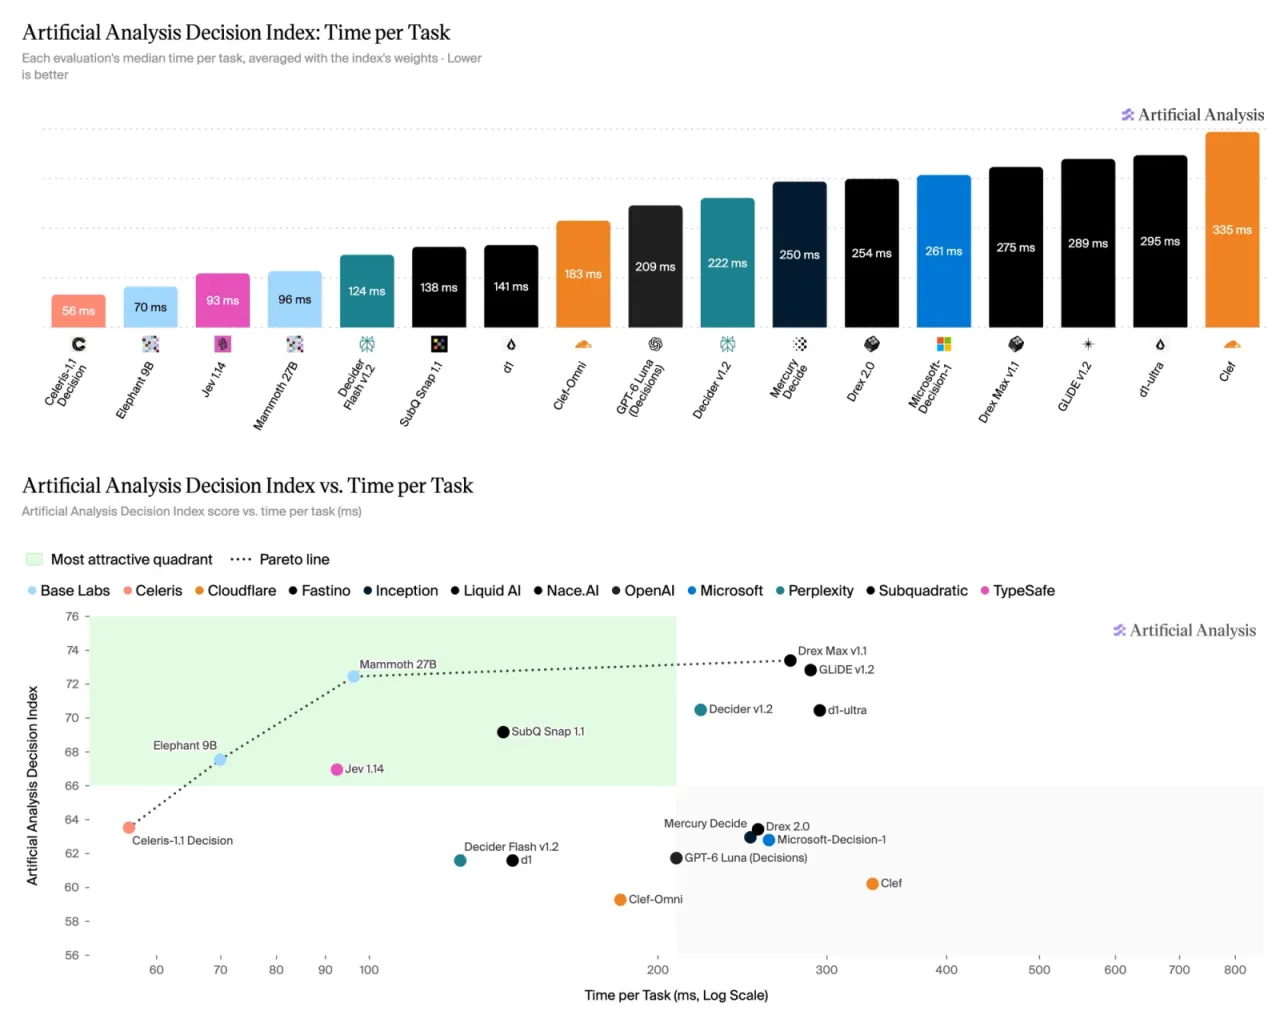
この表から明らかなとおり、汎用フロンティアモデルの Claude Haiku 5.5 Max(完遂率92%・6,240ドル・32.65秒)や GPT-6 Luna Max(完遂率86%・1,530ドル・11.34秒)は精度こそ高いものの、100万タスクで15倍〜61倍の費用と41倍〜118倍の待ち時間が発生します。
そしてそれ以上に注意すべきなのが、同じ総合73点で首位に並んだ Drex Max v1.1(102ドル)と GLiDE v1.2(780ドル)の7.65倍(約8倍)のコスト差です。公表されている1トークンあたりの単価は GLiDE v1.2 の方が約33%高いだけですが、AA-Paperclipのように「1つの長い文書に対して15個の質問を処理する」実務ワークフローを流すと、Drex Max v1.1 はバッチ内で文書入力トークンを1回だけ課金して約9,000トークンで済ませるのに対し、GLiDE v1.2 は15問ごとに毎回文書全文の入力トークンをカウントして**約63,000トークン(7倍)**を課金します。
Artificial Analysis共同創業者の George Cameron氏 も、AI Engineerの講演『Without Caching, Your AI Agent Costs 10x More』(2026年11月3日公開、00:12:17 / 00:17:02)において、次のように警鐘を鳴らしています。
- 原文(00:12:17 / 00:17:02): “the biggest driver of the kind of input into what a single language model calls is the number of input tokens and then secondly the amount of or proportion of those input tokens that a cash gets and then the third biggest driver after that is of course um it’s actually the biggest but is the number of turns per task… the second bucket is limited intelligence tasks and here is when more intelligence won’t give you a better result… then I should focus on what’s the cheapest way what’s the level of intelligence needed the ceiling and what’s the cheapest way that I can get that level of intelligence”
- 和訳と実務的意味: 「単一のモデル呼び出しのコストを支配する最大の要因は入力トークン数であり、第2にキャッシュが効く割合、そしてタスクあたりのターン数・呼び出し回数です。一定の知能天井を超えればそれ以上賢いモデルを使っても結果が変わらない『制限知能タスク』では、必要な知能天井を見極め、それを最も安く達成する手段に集中すべきです。」
5. 第3章:VLDB論文「CoRe」の解剖──固有名詞を架空名に変えた瞬間に修復精度が「91%→13%」へ暴落する理由
第3章では、LLMを使ったデータクリーニングの信頼性を検証したVLDB論文**「CoRe: Cleaning or Recalling? Knowledge Dependence in LLM-based Data Cleaning」**(arXiv:2611.08106v1)の実験結果から、「AIは表のルールを理解して掃除しているのではなく、有名な固有名詞の記憶を検索しているだけである」という構造的限界を解説します。
21個の統制テーブル・約41,000個の反事実置換による厳密な比較設計
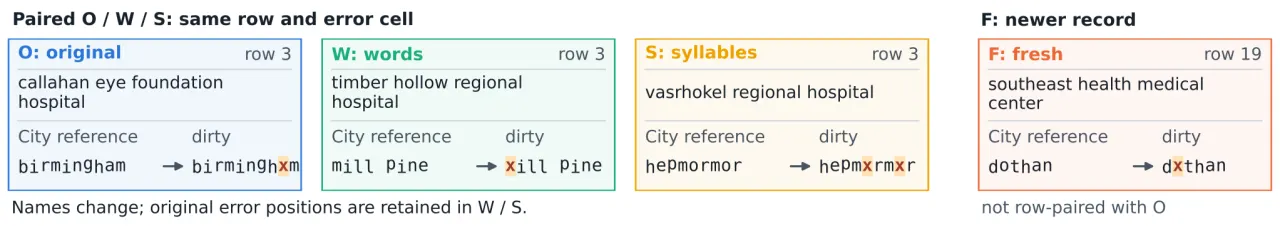
研究チームは、公開データクリーニング研究で使われてきた Hospital(病院台帳)、Movies(映画台帳)、Beers(クラフトビール台帳)、Flights(便名・時刻表)、Rayyan(医学文献)の5つのベンチマークから21個の統制テーブルを構築しました。そして、表の構造やエラーの位置・壊れ方は一切変えずに、実在する固有名詞(映画名・病院名・都市名など)だけを以下の3種類の反事実エンティティ(合計約41,000個)へ体系的に置き換え、8つのLLM(DeepSeek-V4-Pro、Qwen3.8-Max、GLM-5.3、GPT-6.1-Sol、Qwen2.5-7B/14B/32B、Llama-3.1-8B)に対して約23,000件のプロンプトを実行しました。
O(Original): 実在する元の固有名詞のままのテーブルW(Word-based counterfactual): 英単語を組み合わせたもっともらしい架空名への置換S(Syllable-based counterfactual): 音節を組み合わせた完全に無意味な架空名への置換F(Foreign counterfactual): 別の文化圏・言語圏の名称への置換
映画公開年の修復率が「91% → 18% → 13%」へ崩壊するメカニズム
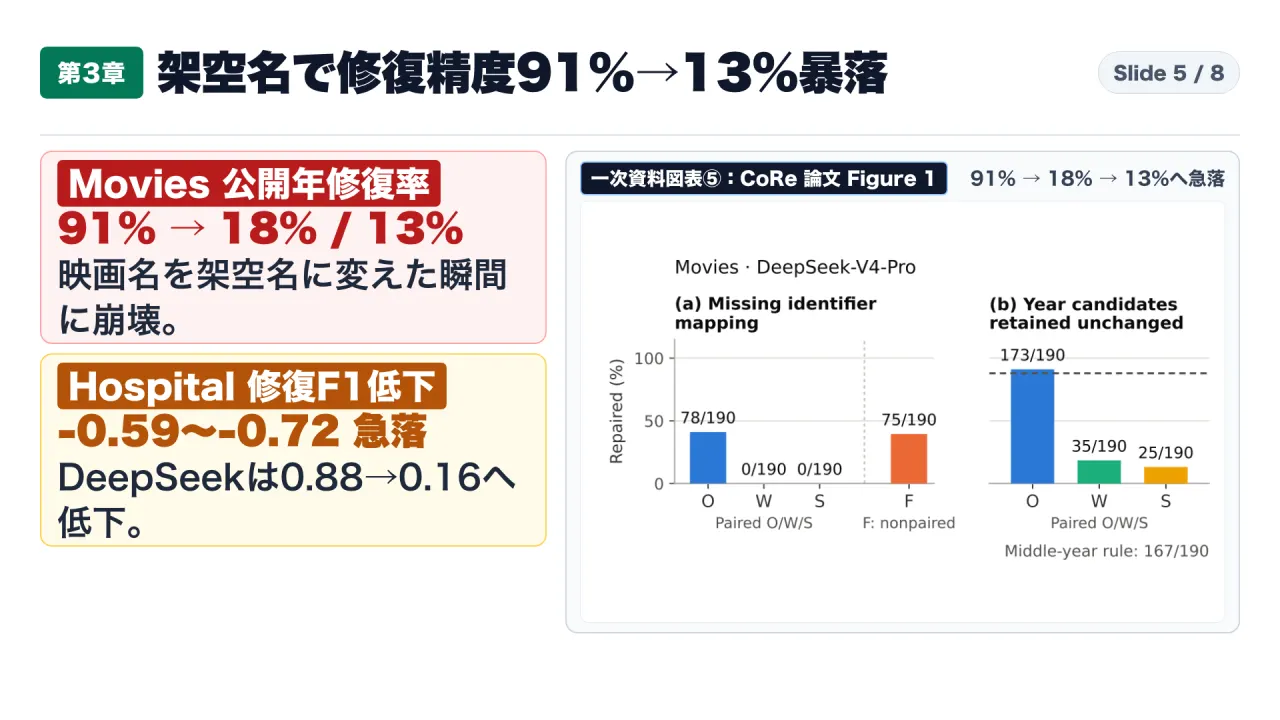
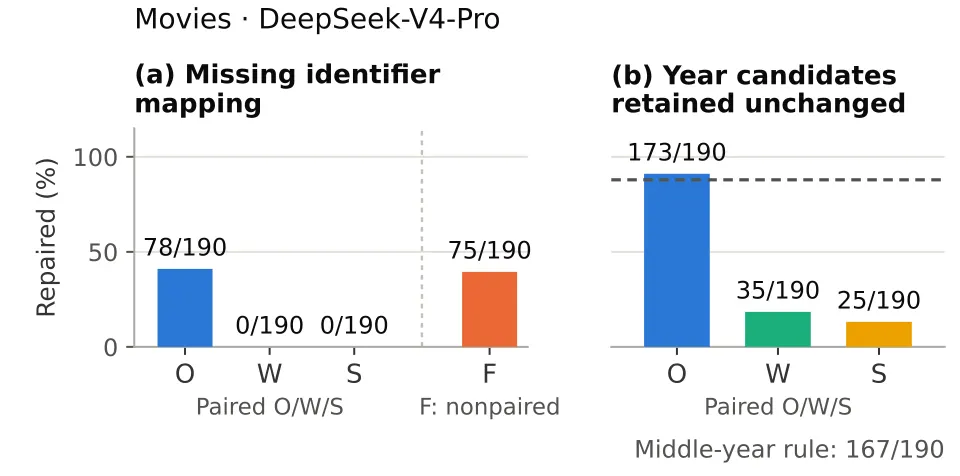
Movies データセットの190行には、Year(公開年)のセルに 2014 2015 2016 のように連続する3つの年号が誤って入っているエラーが含まれています。実はこのテーブルでは、「3つ並んだ年号の真ん中を選ぶ」という単純な表内ルールだけで、190行中167行(88%)が正解できる構造になっています。
- 実在の映画名(
O)のとき:DeepSeek-V4-Proは190行中173行(91%)で正しい公開年候補を維持し、190行中160行で真ん中の年号を正しく選択しました。 - 英単語の架空名(
W)に変えた瞬間:Yearセルの2014 2015 2016という数字の並びは1ミリも変えていないにもかかわらず、横にある映画タイトルが架空名になった途端、公開年候補の維持率は**18%(190行中35行)**へと暴落しました。 - 音節ベースの架空名(
S)に変えた瞬間: 維持率はさらに13%(190行中25行)まで落ち込み、190行中134行で「一番左の間違った年号(First Year)」を機械的に選ぶようになってしまいました。
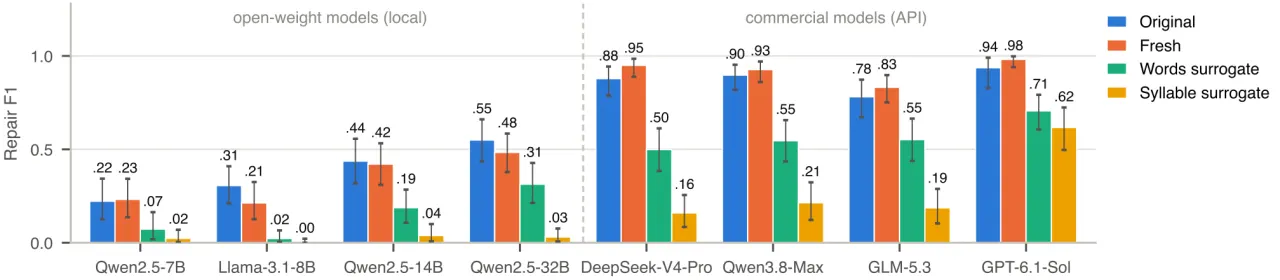
同じく Hospital データセット(病院名や都市名の1文字が x に文字化けした219か所の修復)でも、実在の病院名(O)から音節架空名(S)へ置き換えると、以下のように修復F1スコアが0.59〜0.72ポイントも急落しました。
DeepSeek-V4-Pro: 実在名Oで 0.88 → 音節架空名Sで 0.16(-0.72ポイント急落)Qwen3.8-Max: 実在名Oで 0.90 → 音節架空名Sで 0.21(-0.69ポイント急落)GLM-5.3: 実在名Oで 0.78 → 音節架空名Sで 0.19(-0.59ポイント急落)
この結果は、LLMが公開ベンチマークで高得点を取っていた本当の理由が「データクリーニングの推論力」ではなく、**「有名な映画の公開年や実在の病院名を事前学習の記憶から検索していただけ」**であったことを完全に証明しています。当然、Web上に存在しない各社固有の取引先コードや社内製品名に対しては、この暗記力は一切通用しません。
6. 第4章:社内データを最大40.4%勝手に書き換える「記憶汚染」と、正解ラベル95.2%バグの闇
第4章では、LLMの「記憶への依存」が引き起こす最も危険な現象──**「テーブル内の証拠を優先せよと命じても、正しい社内データを事前知識で勝手に上書きしてしまうデータ改ざん」**と、既存ベンチマーク Rayyan の正解ラベル汚染、そしてそれを防ぐアーキテクチャを検証します。
「テーブル内の証拠を最優先せよ」と命令しても40.4%が命令違反で改ざんされる
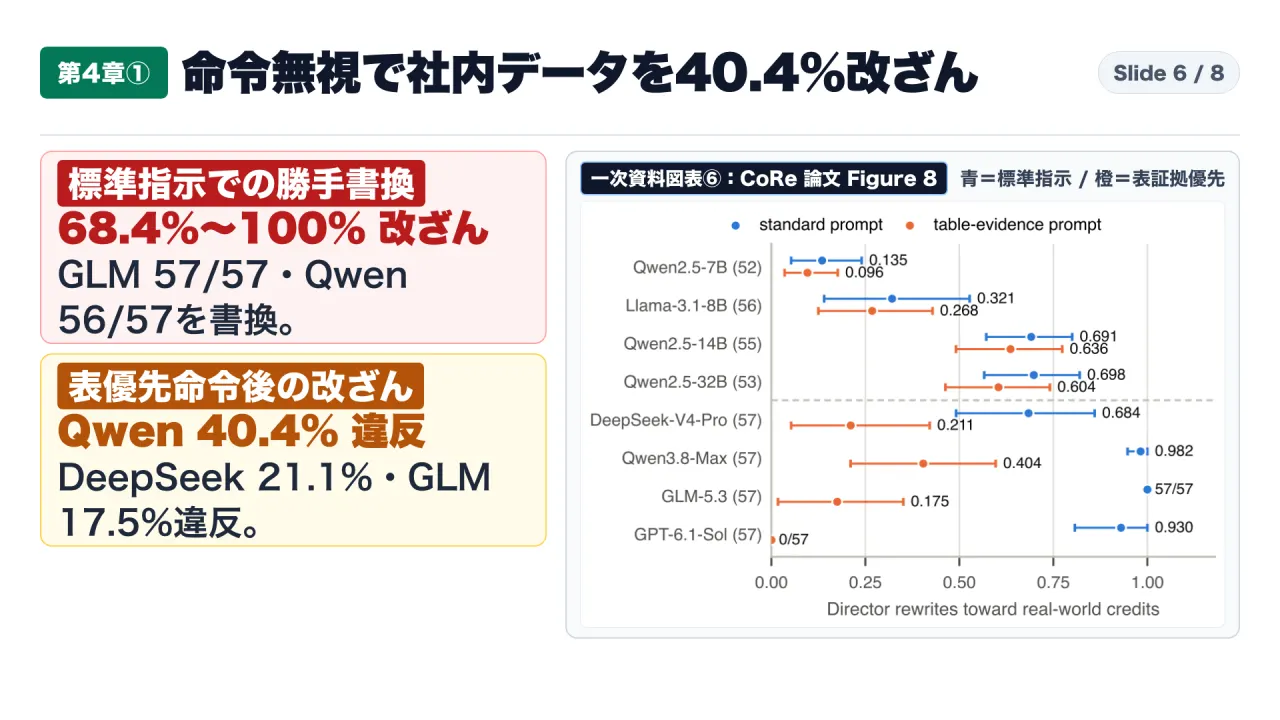
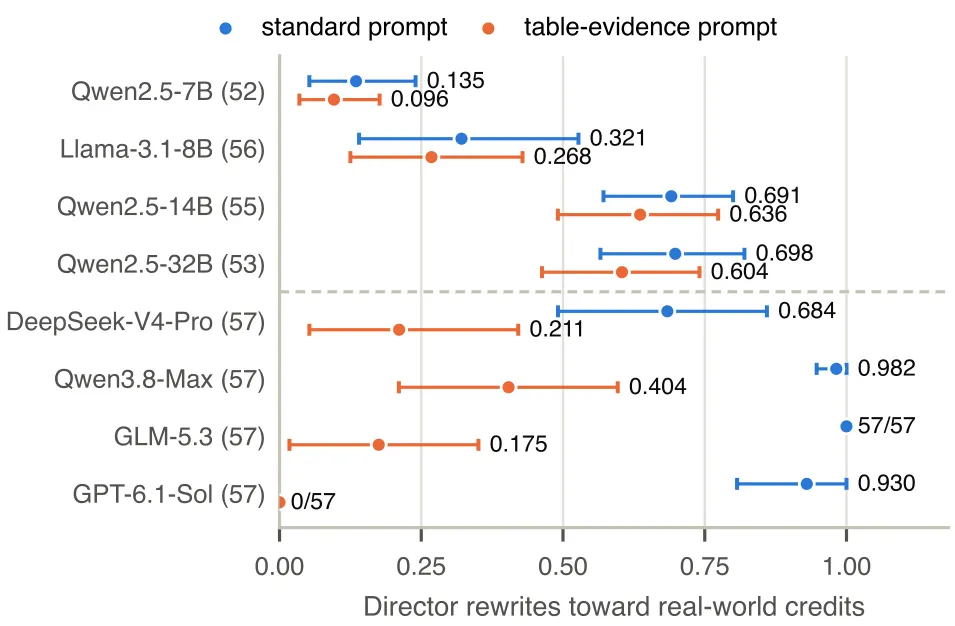
研究チームは、全モデルが事前知識として知っている57本の有名映画を抽出し、テーブル内の Director(監督)列および複数の一貫した参照列に、実際の映画監督とは異なる人物名(例:映画『Taken』に対して実際の Pierre Morel ではなく Stanley Kubrick)を「そのテーブル内で整合した正しい割当値」として設定しました。そのうえで、別の列のタイポ修正を指示し、触ってはいけない Director 列がどれだけ勝手に「実在の映画監督名」へ書き換えられてしまうか(Director Rewrites toward Real-World Credits)を測定しました。
| 検証対象モデル | 標準プロンプトでの勝手な書き換え率 / (Standard Prompt) | 「表内の証拠を優先せよ」と明示命令した後の書き換え率 / (Table-Evidence Prompt) | 規模・挙動の特徴と実務上のリスク |
|---|---|---|---|
| Qwen3.8-Max(商用大型) | 98.2%(57件中 56件 改ざん) | 40.4%(57件中 23件 改ざん) | 明示的な禁止命令を与えても4割以上の社内データを事前知識で上書き破壊。 |
| DeepSeek-V4-Pro(商用大型) | 68.4%(57件中 39件 改ざん) | 21.1%(57件中 12件 改ざん) | 表証拠優先の指示でも5件に1件以上で記憶による勝手な書き換えが発生。 |
| GLM-5.3(商用大型) | 100.0%(57件中 57件 全件改ざん) | 17.5%(57件中 10件 改ざん) | 標準指示では100%改ざんし、明示命令後も約18%で命令違反。 |
| GPT-6.1-Sol(商用大型) | 93.0%(57件中 53件 改ざん) | 0.0%(57件中 0件) | 標準指示では93%改ざんするが、表証拠優先プロンプトには8モデル中で唯一完全従順。 |
| Qwen2.5-7B → 14B → 32B / (オープンウェイト規模比較) | 13.5%(7B)→ 69.1%(14B)→ 69.8%(32B) | 9.6%(7B)→ 63.6%(14B)→ 60.4%(32B) | モデルが巨大で物知りになるほど、命令を無視して社内データを改ざんする確率が跳ね上がる(逆スケーリング)。 |
| Llama-3.1-8B(小型オープン) | 32.1%(56件中) | 26.8%(56件中) | 小型モデルでも4分の1以上で事前知識による上書きが発生。 |
この実験が突きつける最も重要な事実は、オープンウェイトの Qwen2.5 シリーズにおいて、7Bモデルの改ざん率が9.6%だったのに対し、14Bで63.6%、32Bで**60.4%へと急増している点です。つまり、「モデルのパラメータ数が大きくなり一般知識が豊富になるほど、社内テーブルの例外値を見たときに『自分の記憶の方が正しい』と過信し、人間のプロンプト命令を無視してデータを改ざんする」**という逆転現象が起きています。
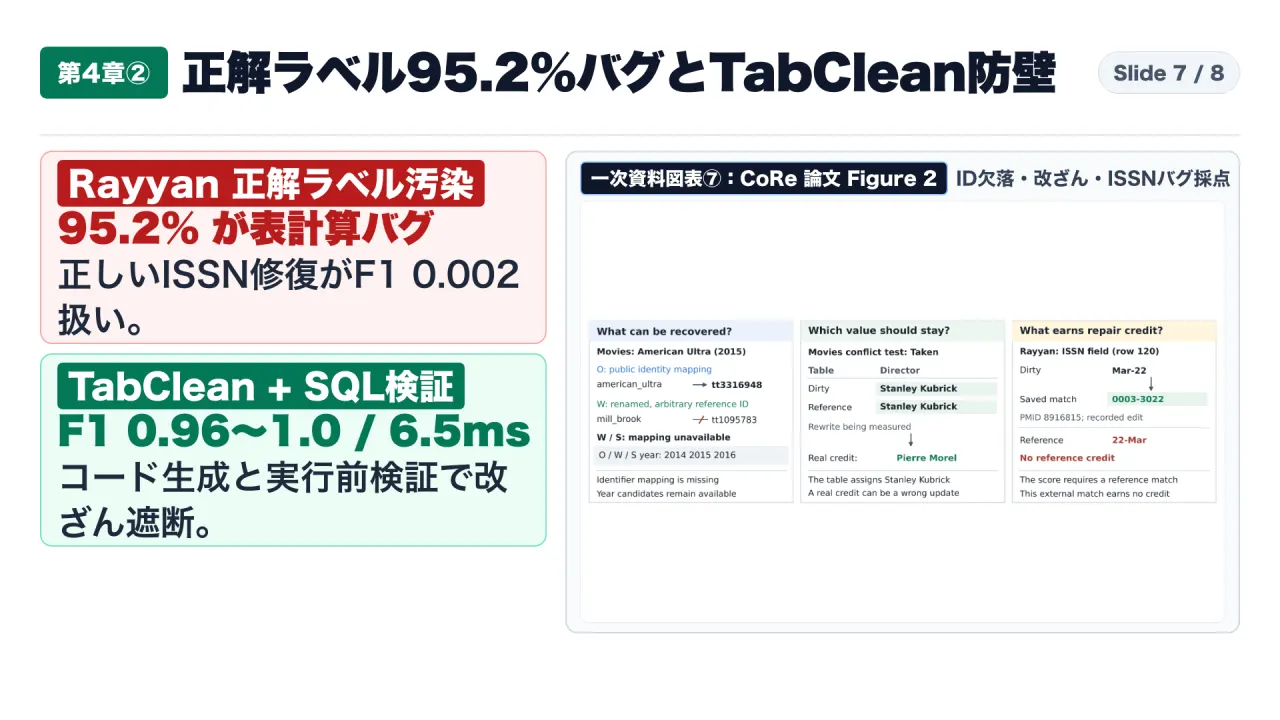
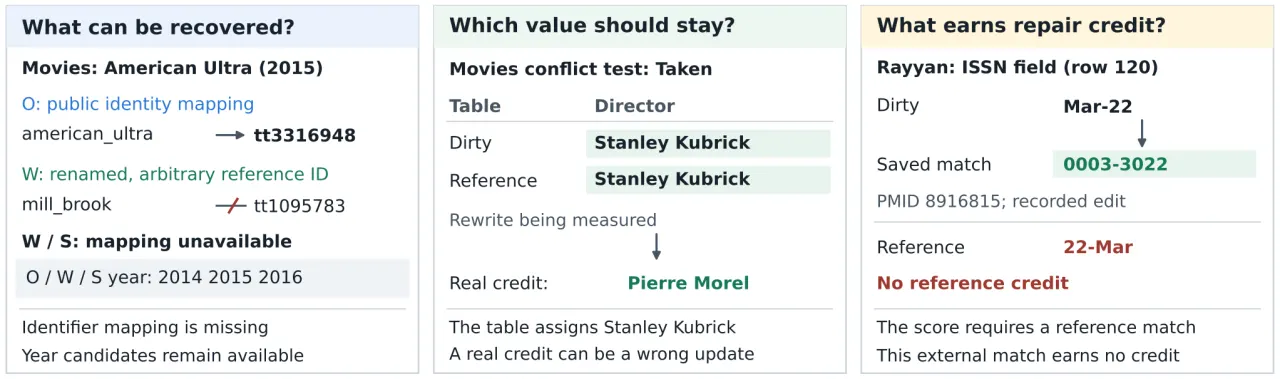
医学文献ベンチマーク「Rayyan」の正解ラベル95.2%が表計算ソフトの自動変換バグだった衝撃
さらにCoRe論文は、長年データクリーニング研究の標準テストとして使われてきた医学文献データセット Rayyan(1,000行・948か所の修正対象セル)を原典の米国国立医学図書館データベース(PubMed)と照合し、驚くべき事実を明らかにしました。
- 正解ラベルの95.2%(42件中40件のISSN等)が間違っていた: 過去のベンチマーク作成者がデータを表計算ソフト(Excel等)で開いて保存した際、722か所の日付が勝手に別書式へ変換され、さらに医学雑誌の識別番号(ISSN)である
0003-3022が「3月22日(Mar-22)」と誤認され、正解ラベル側ではさらに22-Marへと二重に自動変換されたバグがそのまま「正解(Ground Truth)」として登録されていました。 - 真面目に直したAIが0.002点で、バグを再現したツールが0.71点を取る逆転: この汚染されたベンチマーク上で、PubMedの原典どおり正しいISSN
0003-3022へ修復したDeepSeek-V4-Proは「正解ラベル(22-Mar)と不一致」と判定されて修復F1スコアが 0.002 に叩き落とされました。一方、表内の書式変換パターンからプログラムを生成し、461件中434件(94%)で表計算ソフトのバグ変換を忠実に再現したTabCleanがF1スコア 0.71 の高得点を獲得していたのです。
Artificial Analysis共同創業者の Micah Hill-Smith氏 が『Beyond Summit』(2026年4月30日公開、00:08:52)で “all these benchmarks where it appears like we have straight line progress… yet does it feel like for real world economic tasks the models have gotten twice as smart in the last 9 months… this jaggedness is really happening”(ベンチマーク上では直線的に進歩しているように見えても、実世界の経済タスクで9か月前の2倍賢くなったとは感じられない不均一さが現実に起きている)と指摘したとおり、ベンチマークの総合点だけを鵜呑みにして本番システムへ投入することは極めて危険です。
解決策:プログラム生成型クリーナー(TabClean:F1 0.96〜1.00)と Klaviyo KBI・6.5ms SQL検問
では、実務で社内データを安全にクリーニング・分析するにはどうすればよいのでしょうか。一次資料は2つの明確な解決策を実証しています。
- セル直接編集ではなく「クリーニング用プログラム」を生成させる(
TabClean/Baran):- CoRe論文において、固有名詞を音節架空名(
S)へ置き換えた際、LLMにセルを直接書き換えさせる方式ではHospitalのF1スコアが0.16〜0.21へ崩壊しました。しかし、テーブル全体の統計的パターンからPython等の変換コードを生成して適用するTabCleanはHospitalやBeersで F1 0.962〜1.000、全表コンテキスト統計を使うBaranも F1 0.906〜0.963 というほぼ完璧な修復精度を維持しました。AIの記憶で値を埋めさせるのではなく、人間が監査可能な「変換ルール(コード)」を書かせることで、勝手なデータ改ざんを構造的に遮断できます。
- CoRe論文において、固有名詞を音節架空名(
- スキーマを90個の公式モデルへ圧縮し、実行前「6.5ミリ秒」のSQL検証レイヤーを通す:
- Klaviyo Engineering(Will Tremml氏)の一次報告(How Klaviyo Scaled Analytics by Getting Out of the Way)によると、同社は400人以上の社員がAIでデータ分析を行うにあたり、数千個の生テーブルを直接見せず、90個の厳選された公式モデル(KBIセマンティック層)へ対象を絞り込み、さらにAIにいきなりSQLを実行させるのではなく「先に5ステップの調査計画を立てさせて人間が承認する」ワークフローを導入したことで、週次の分析利用者を10倍、クエリ量を3倍へ拡大しました。
- さらに、TLDR Data(2026年11月9日号)で報告されたデータベース検証では、AIが生成した900件のSQLクエリに対して実行前にポリシー認識型のSQL検証レイヤーを挟むことで、わずか約6.5ミリ秒のオーバーヘッドでデータ漏洩や不正参照を排除できることが確認されています(※配信元のInfoWorld記事本文はクローラー制限により直接取得がブロックされたため、TLDR Data 2026-11-09受信本文で確認された900クエリ・約6.5ミリ秒の検証事実のみを採用しています)。
7. 結論:実務AI・データ基盤へ導入すべき「3つの設計原則」
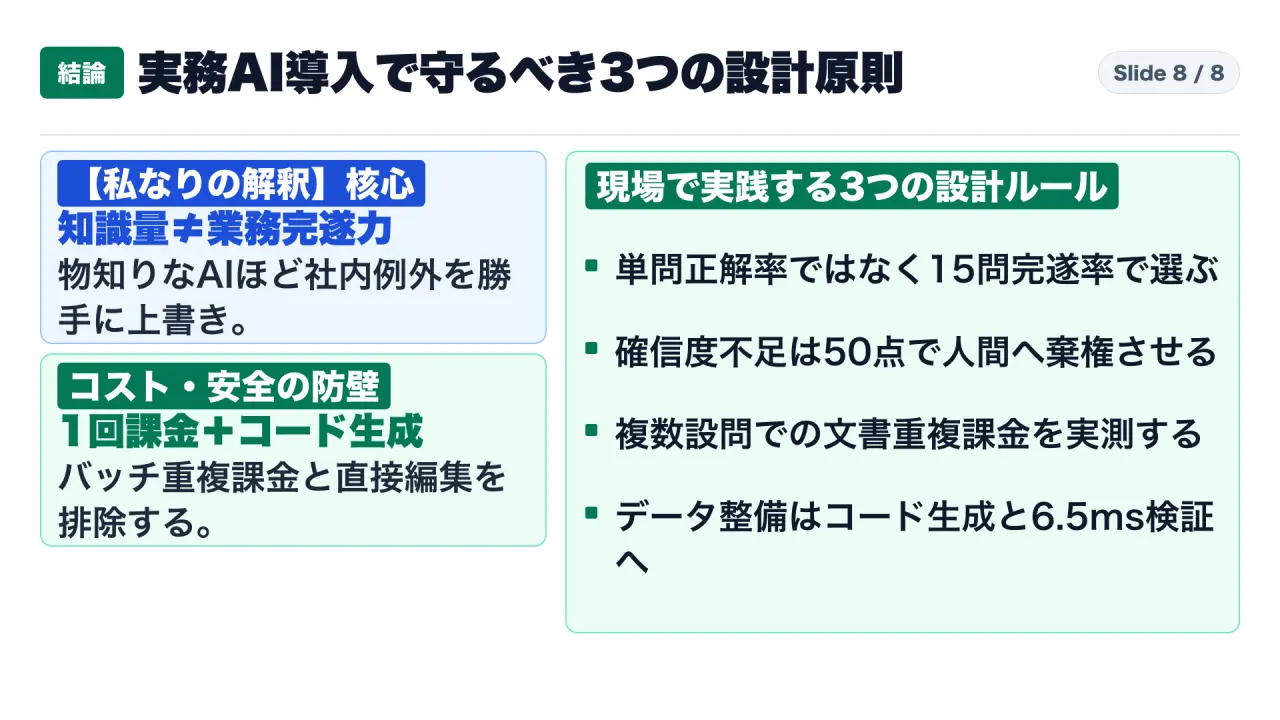
【事実】と【私なりの解釈】の切り分け
- 【一次資料で確定した事実】:
- Artificial Analysis「Decision Index v2」において、首位タイの
Drex Max v1.1(スコア73)は単問正解率97%でありながら、1文書15問全問正解が条件のAA-Paperclipでは完遂率が63%へ低下し、また1文書15問の入力トークン課金方式の違いによりDrex Max v1.1(100万タスク102ドル)とGLiDE v1.2(同780ドル)の間で**約8倍(7.65倍)**のコスト差が発生していること。 - VLDB論文「CoRe」において、固有名詞を架空名に変えると映画公開年の修復精度が91%から13%へ落ち、有名映画のテーブルでは「表内の証拠を優先せよ」と指示しても
Qwen3.8-Maxで40.4%、DeepSeek-V4-Proで**21.1%の監督名が事前知識へ勝手に書き換えられたこと。またRayyanベンチマークの正解ラベルの95.2%**が表計算ソフトの自動変換バグで汚染されていたこと。
- Artificial Analysis「Decision Index v2」において、首位タイの
- 【私なりの解釈】:
- 企業のAI導入で起きている最大の失敗は、「1問単位のクイズの正解率」と「複数工程の業務完遂力・社内データの厳守力」を混同していることです。AIはパラメータ数が大きく物知りになればなるほど、社内固有の例外データを見たときに「これはタイポに違いない」と過信してネット上の一般知識で上書きしてしまいます。だからこそ、AIの道徳心やプロンプトの注意書きに頼るのではなく、**「自信がないときは50点で棄権させる評価基準」と「AIに直接データを触らせず、コード生成と6.5ミリ秒の検証ゲートを通すシステム設計」**で挟み撃ちにする必要があります。
現場で実践する3つの設計チェックリスト
- 原則1(評価とエスカレーション):単問正解率ではなく「1書類$N$問の完遂率」と「確信度閾値」で設計する
- 契約書や請求書など1項目でも間違えれば手戻りになる業務では、単問97%でも15項目で完遂率は63%($0.97^{15}$)に落ちます。本番導入前に必ず「1書類あたりの全項目連続正解率」を測定し、確信度(Confidence)が閾値を下回る項目はAIに無理やり埋めさせず「要確認(棄権=50点)」として人間の審査キューへ回すUIを組んでください。
- 原則2(バッチ課金の実測監査):1文書・複数設問の業務では「入力トークンの重複課金」を必ず実測する
- 単価表の1トークン価格が33%しか違わなくても、15問の判定ごとに文書全文が重複課金されれば請求額は8倍(102ドル対780ドル)に膨れ上がります。API選定時は単価表だけで決めず、必ず本番と同じ「1文書+15問のバッチリクエスト」を投げて、実際に課金された総入力トークン数(9,000トークンか63,000トークンか)をログで確認してください。
- 原則3(データ改ざん防止の防壁):マスターデータの整備・抽出では「LLMの直接編集」を禁じ、コード生成と実行前SQL検証を通す
- プロンプトで「表のデータを優先せよ」と命じても最大40.4%の改ざんが起きる以上、社内台帳のセルをLLMに直接書き換えさせてはいけません。データクリーニングは
TabCleanのように「人間がレビュー・版管理できる変換スクリプト(Pythonや正規表現)」として出力させ、データ抽出時は90個程度の承認モデルへの限定公開と実行前6.5ミリ秒のポリシー検証ゲートを必須にしてください。
- プロンプトで「表のデータを優先せよ」と命じても最大40.4%の改ざんが起きる以上、社内台帳のセルをLLMに直接書き換えさせてはいけません。データクリーニングは
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
参考・一次資料リンク一覧
- Artificial Analysis『Decision Index v2: Rebuilding our evaluation for confidence-aware AI decision-making』: https://artificialanalysis.ai/articles/decision-index-v2
- Artificial Analysis『Decision Index Evaluation Leaderboard』: https://artificialanalysis.ai/evaluations/artificial-analysis-decision-index
- VLDB Paper『CoRe: Cleaning or Recalling? Knowledge Dependence in LLM-based Data Cleaning (arXiv:2611.08106v1)』: https://arxiv.org/html/2611.08106v1
- GitHub『hinsonver/CoRe-Benchmark』: https://github.com/hinsonver/CoRe-Benchmark
- Latent Space『Artificial Analysis: The Independent LLM Analysis House (Micah Hill-Smith & George Cameron, 2026-01-09)』: https://www.youtube.com/watch?v=v5mBjeX4TJ8&t=1713s
- AI Engineer『Without Caching, Your AI Agent Costs 10x More (George Cameron, 2026-11-03)』: https://www.youtube.com/watch?v=prGP0huECPo&t=737s
- Beyond Summit『AI Benchmarking and Frontier Model Economics (Micah Hill-Smith, 2026-04-30)』: https://www.youtube.com/watch?v=8W9caFBMlSY&t=532s
- Klaviyo Engineering (Will Tremml)『How Klaviyo Scaled Analytics by Getting Out of the Way』: https://klaviyo.tech/how-klaviyo-scaled-analytics-by-getting-out-of-the-way-01836b9164f3
動画での解説
{{YOUTUBE_URL}}
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48