なぜKlaviyoは90テーブルだけで社内DWHを解放できたのか?──6.5msのSQL検問で漏洩0行と夜間記憶編纂87%を実現する3ステップ
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜKlaviyoは90テーブルだけで社内DWHを解放できたのか?──6.5msのSQL検問で漏洩0行と夜間記憶編纂87%を実現する3ステップ
https://www.youtube.com/watch?v=MgU3ewUWdv4
社内データウェアハウス(SnowflakeやBigQueryなど)にAIエージェントを接続し、社員が自然言語でデータを集計・分析できるようにする取り組みが多くの企業で進められています。しかし実務の現場では、「誰が聞くかによって売上や解約率の数字が毎回変わる(ハルシネーション)」、そして**「閲覧権限のあるテーブル同士をAIが勝手にJOINして他部署の機密情報や報酬データを露出させてしまう」**という2つの壁にぶつかり、本番開放を断念するケースが後を絶ちません。
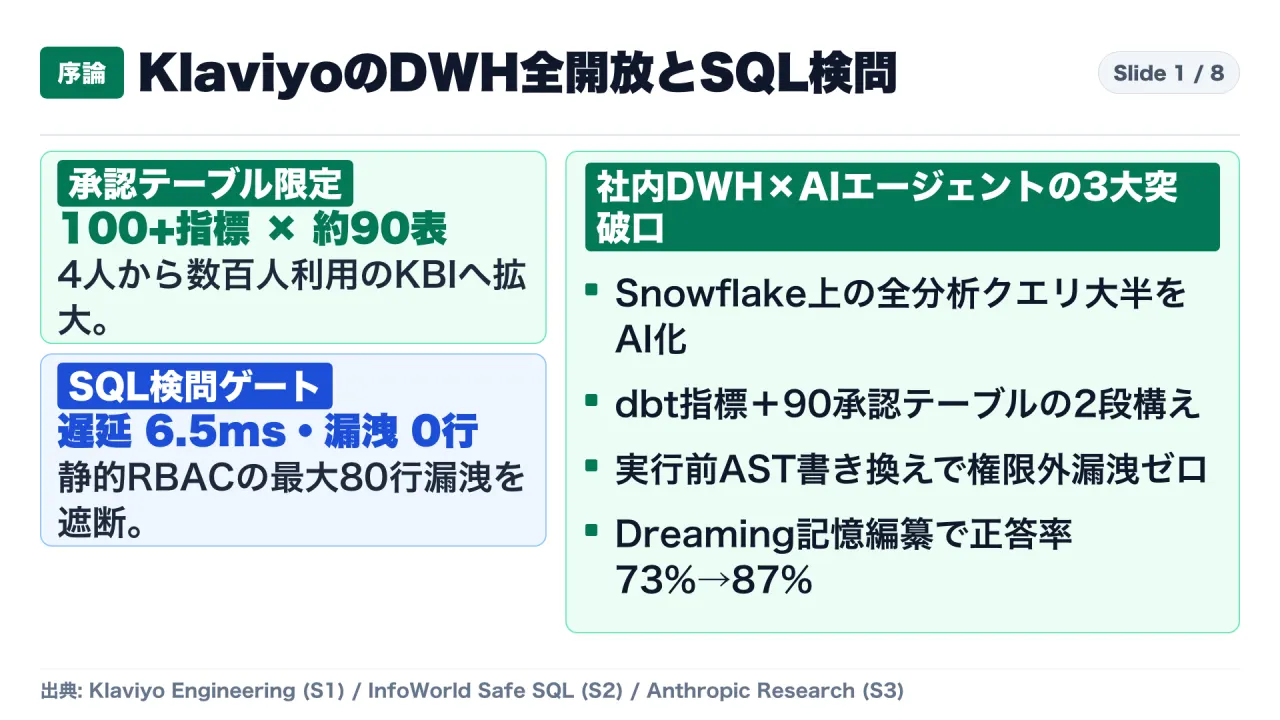
この課題に対し、大手マーケティングプラットフォームのKlaviyoは、わずか4人の初期コアチームからスタートした社内AI分析基盤**「KBI(Klaviyo Business Intelligence)」を12ヶ月間で月間数百人の社員**が日常利用する規模へと拡大させ、同社のSnowflakeに飛ぶ分析クエリの大半をAIエージェントによる自動生成へ置き換えることに成功しました。
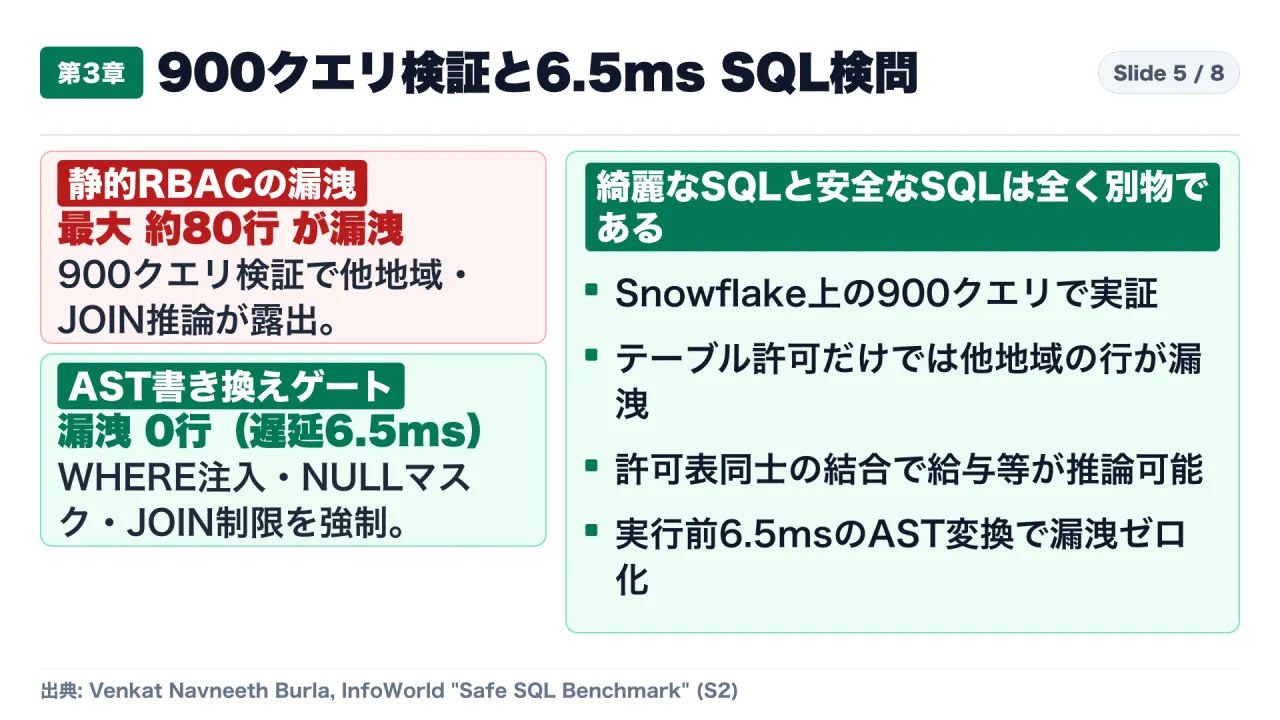
さらに、InfoWorldで公開されたSnowflake Cortex上の900クエリ安全性ベンチマークでは、通常のText-to-SQLと静的なテーブル権限(RBAC)だけでは最大約80行の権限外データが漏洩したのに対し、実行前にわずか6.5ミリ秒でSQL構文木(AST)を書き換える検問ゲートを挟むことで漏洩を0行(完全ゼロ)に抑え込めることが実証されています。そして、こうしたスキーマ定義やクエリ失敗履歴を長期記憶として定着させる手法として、Anthropic Researchが発表したオフライン記憶編纂「Dreaming(夢を見ること)」は、単純なベクター検索RAGの正答率73%に対して87%(35万ファイル規模のコードベースでは**13%から48%**への約4倍向上)を記録しました。
本記事では、これら3つの一次資料をもとに、社内データ基盤をAIエージェントへ安全に全開放するためのアーキテクチャと3つの実装ステップを解説します。
1. 結論と全体像:社内DWH×AIエージェントを成功させる3つの核心的知見
一次資料と定量ベンチマークから導かれる結論は以下の3点です。
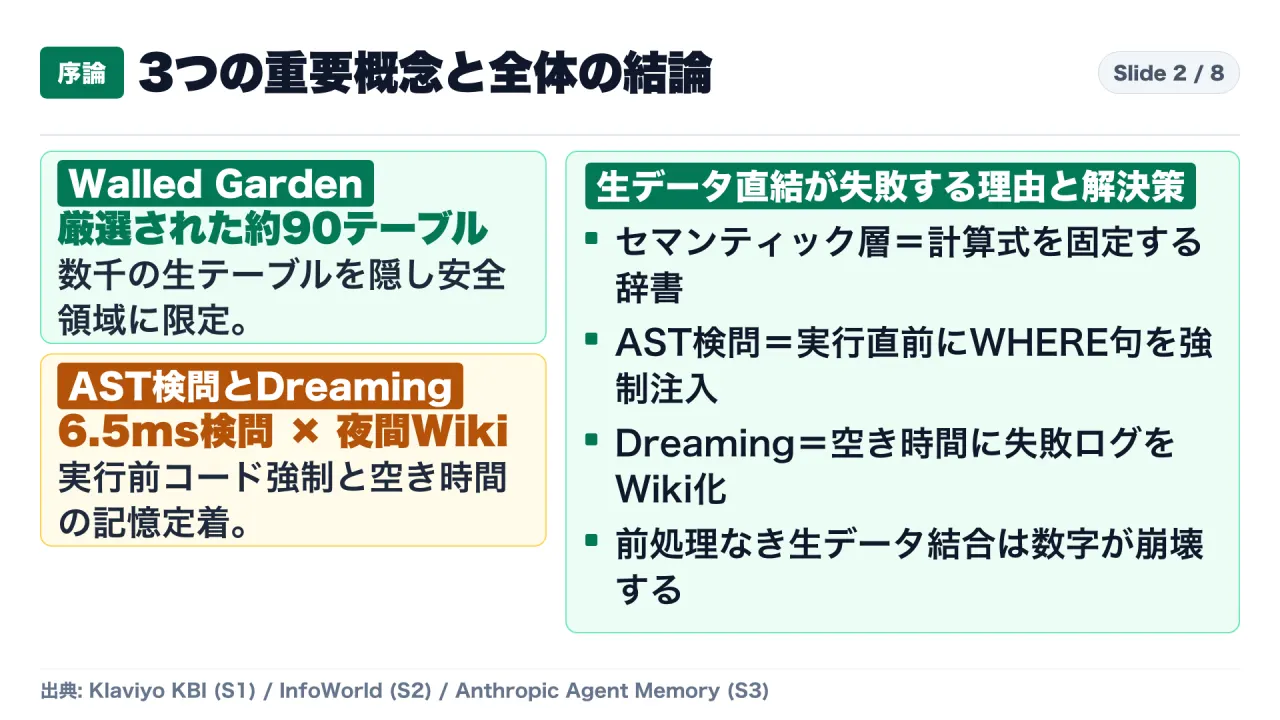
- Klaviyo「KBI」が実証した「100+ dbt指標」×「約90個の承認テーブル(Walled Garden)」の2段構え:
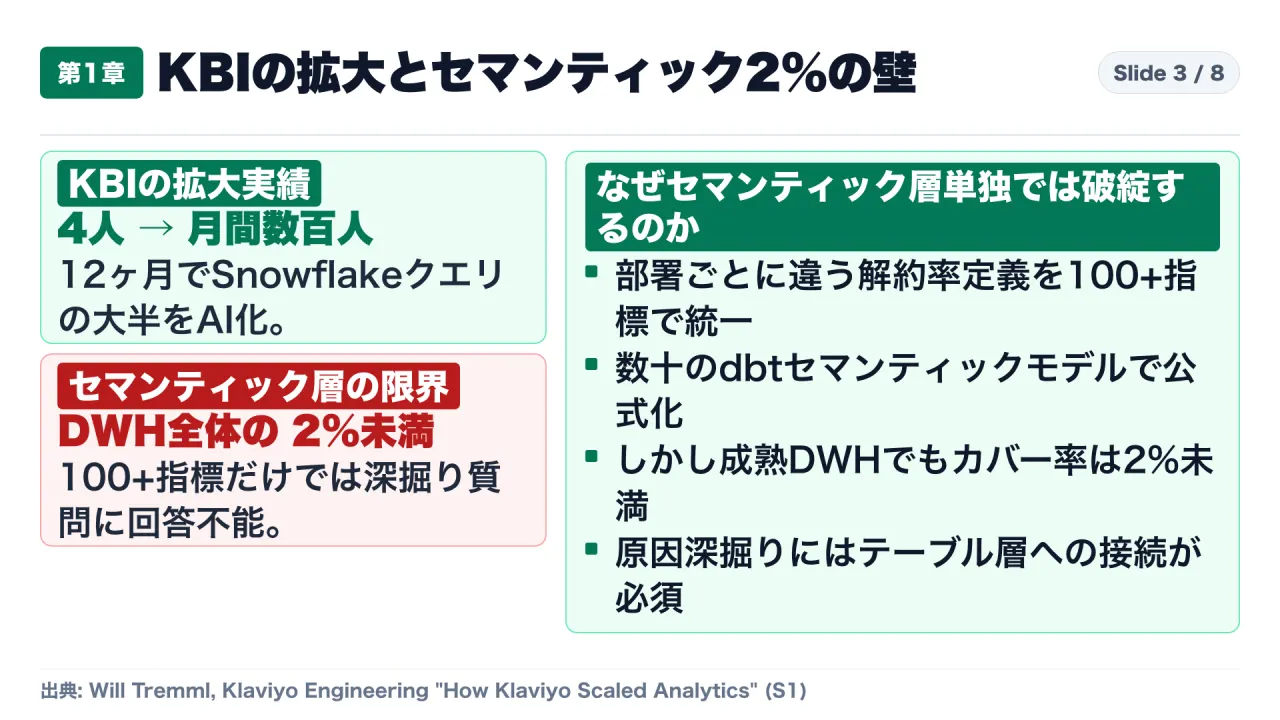
- Klaviyoは数十個のdbtセマンティックモデル上に100個以上の公式メトリクスを定義して指標のブレを防ぎました。しかし、成熟したデータ基盤であってもセマンティックレイヤーがカバーできるのは全DWHモデルの2%未満(
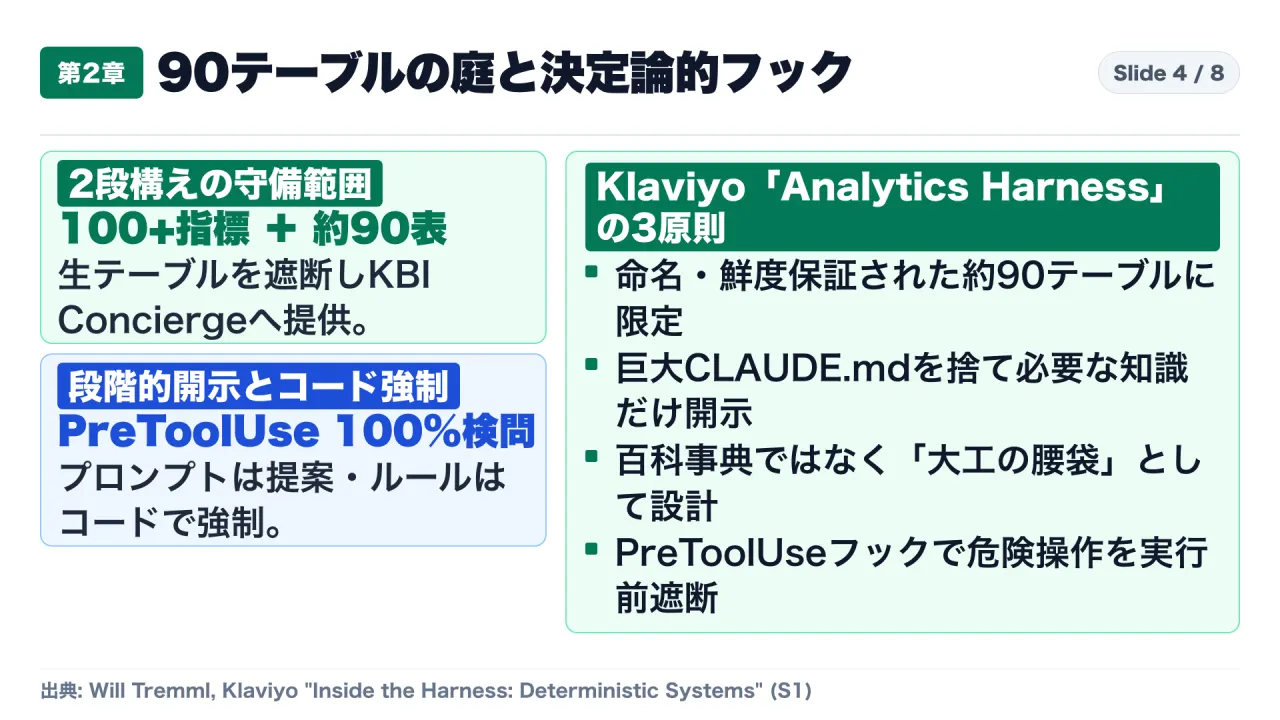
<2%)に過ぎません。そこでKBIは、数千個の生テーブルを遮断し、命名・鮮度・ドキュメントが保証された約90個の承認済みテーブル(Walled Garden:壁に囲まれた庭)だけを標準エージェント(KBI Concierge)へ公開し、必要な知識だけを段階的に読み込む段階的開示(Cascading Disclosure)とPreToolUseフックを組み合わせることで全社スケールを実現しました。
- Klaviyoは数十個のdbtセマンティックモデル上に100個以上の公式メトリクスを定義して指標のブレを防ぎました。しかし、成熟したデータ基盤であってもセマンティックレイヤーがカバーできるのは全DWHモデルの2%未満(
- 「綺麗なSQL」と「安全なSQL」の決定的乖離と、わずか「6.5ミリ秒」のAST書き換え検問ゲート:
- Snowflake Cortex上の900クエリ検証において、文法的に正しいSQLを生成できても、静的なテーブル単位のRBACだけでは他地域のレコード抽出やテーブル間
JOINによる推論を通じて最大約80行の権限外データ漏洩が発生しました。AIが生成したSQLを実行直前に抽象構文木(AST)へ分解し、行フィルタ(WHERE句)・列マスキング(NULL化)・JOIN制限をプログラムで強制注入するインターセプターを導入した結果、追加遅延わずか平均6.5ミリ秒で権限外漏洩0行を達成しています。
- Snowflake Cortex上の900クエリ検証において、文法的に正しいSQLを生成できても、静的なテーブル単位のRBACだけでは他地域のレコード抽出やテーブル間
- 素朴なベクター検索RAG(73%)を凌駕するオフライン記憶定着「Dreaming(87%)」:
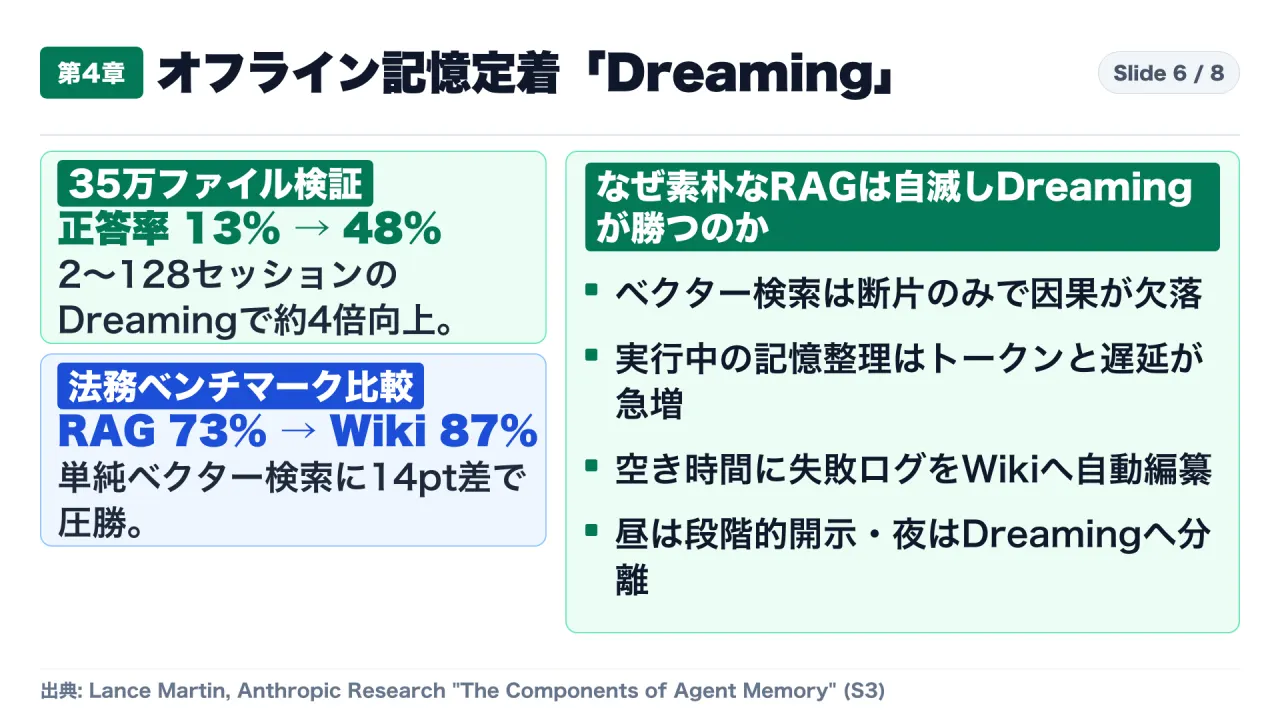
- 会話ログやテーブル定義をそのままベクターDBに入れて検索するだけの「Search Alone(単純RAG)」は、複数の出来事や仕様変更をまたいだ因果関係を統合できません。エージェントが稼働していない空き時間に過去ログや失敗クエリを振り返り、構造化されたMarkdown社内Wikiを自律編纂する**「Dreaming」により、約35万ファイルのコードベースで2〜128セッションの蓄積に伴い正答率が13%から48%へ急伸し、法務ベンチマーク(Harvey LAB)では単純RAGの73%に対し87%**で圧勝しました。
2. Klaviyo「KBI」の解剖:なぜセマンティック層は「2%未満」で破綻し、90テーブルの庭が必要なのか
KlaviyoのデータエンジニアであるWill Tremml氏の一次レポート(How Klaviyo Scaled Analytics by Getting Out of the Way および Inside the Harness: Deterministic Systems)は、AIデータ分析基盤が直面する「理想と現実のギャップ」を極めて率直に明らかにしています。
セマンティックレイヤー「カバー率2%未満」の現実と3層ハーネス
| ハーネス階層 | 構成要素と定量スケール | 解決する課題と限界(なぜ単独では不十分か) |
|---|---|---|
| 第1層:公式指標層 / (dbt Semantic Layer) | 数十個のセマンティックモデル上に 100個以上 の公式メトリクス(ARR、解約率、アクティブ顧客等)を定義 | 部署ごとに異なる計算式を統一し、経営指標のハルシネーションを防ぐ。ただしDWH全体の2%未満(<2%)のモデルしかカバーできず、「なぜこのセグメントだけ落ちたのか?」という一歩踏み込んだ深掘り質問には回答できない。 |
| 第2層:承認テーブル層 / (Walled Garden) | 数千個の生テーブル・中間テーブルを隠し、厳選された 約90個の承認済みテーブル のみを KBI Concierge に公開 |
セマンティック層から漏れた98%の深掘り質問に対し、users_v2_finalのような未整理テーブルを誤って結合する事故を防ぎ、信頼できるマート層内だけで自由なSQL生成を許可する。 |
| 第3層:動的文脈&コード強制 / (Cascading Disclosure & Hooks) | 段階的開示(ツールベルト方式)+ 実行前の PreToolUse 決定論的フック |
巨大なCLAUDE.mdに全テーブル定義を詰め込むことによるトークン爆発と注意力低下を防ぐ。また「プロンプトの指示は単なるお願い(suggestions)」と割り切り、禁止操作をコードで100%遮断する。 |
この3層構造により、Klaviyoは最初わずか4人だった開発チームから、12ヶ月で月間数百人の社員が自力でデータ分析を完結させるプラットフォームへとスケールさせました。
3. 900クエリ検証が暴いた「静的RBACの80行漏洩」と、わずか6.5ミリ秒のSQL検問ゲート
Klaviyoが強調した「ルールはプロンプトではなくコード(PreToolUse)で強制せよ」という原則を、セキュリティとアクセス制御の観点から定量的に実証したのが、InfoWorld(Venkat Navneeth Burla氏)による**「Your LLM writes good SQL. That’s not the same as safe SQL.」**です。
flowchart LR
    A["ユーザーの自然言語質問\n+ 実行者の属性・所属ロール"] --> B["LLM (Snowflake Cortex)\n文法的に正しいSQLを生成"]
    B --> C{"従来の静的RBACのみ\n(テーブル単位の閲覧許可)"}
    C -->|"行フィルタ欠落・JOIN推論"| D["最大 約80行 の権限外漏洩\n(他地域データ・報酬逆算)"]
    B --> E["ポリシー認識型SQLインターセプター\n(実行前 AST構文木解析・6.5ms)"]
    E -->|"WHERE句注入・列NULLマスク・JOIN制限"| F["安全な書き換え済みSQLを実行\n900クエリ検証で 漏洩 0行"]
なぜ「テーブル単位の閲覧許可(静的RBAC)」だけでは漏洩するのか?
製薬企業の地域営業・処方実績スキーマ(Snowflake Cortex上)に対して900本の分析クエリを実行したベンチマークでは、従来の静的RBAC環境で以下の3つの経路から1クエリあたり最大約80行の権限外データ漏洩が発生しました。
- 行レベル(Row-Level)の領域侵犯: テーブル自体のSELECT権限が許可されているため、AIが生成した集計・ランキングSQLが「質問者の担当地域(Territory)外」のレコードまで無制限に読み取ってしまう。
- 許可テーブル同士の
JOINによる推論漏洩: 単体では閲覧が許可されている「営業活動テーブル」と「業績評価テーブル」をAIが自動的にJOINすることで、本来秘匿されるべき個人のインセンティブ報酬や評価ランクが算出・露出する。 - 列レベル(Column-Level)の過剰取得: 質問の回答に不要な機密カラム(PIIや原価情報など)までSELECT句に含めて取得してしまう。
実行前わずか「6.5ミリ秒」で完結するAST書き換えインターセプター
この問題を根本から解決するため、LLMが生成したSQLをデータベースエンジンへ渡す直前に横取りし、**抽象構文木(AST)**レベルで以下の書き換えを強制するポリシー制御インターセプターが導入されました。
| 検証指標 | 通常のText-to-SQL + 静的RBAC | ポリシー認識型SQLインターセプター(AST書き換え) |
|---|---|---|
| 対象ベンチマーク規模 | Snowflake Cortex上の 900クエリ | Snowflake Cortex上の 900クエリ |
| 権限外データの漏洩行数 | 最大 約 80 行 漏洩 | 0 行(完全ゼロ) |
| 強制される制御内容 | テーブル・ビュー単位の静的な有無判定のみ | ・ユーザー属性に応じた行フィルタ(WHERE句)の動的注入 / ・権限外カラムの強制 NULL マスキング / ・危険なクロスドメイン JOIN の構文木レベル遮断 |
| 1クエリあたりの追加遅延 | 0 ms(検問なし) | 平均 6.5 ミリ秒(0.0065秒) |
LLMがトークンを生成してDWHがクエリを実行する数秒の待ち時間に対し、わずか6.5ミリ秒という人間には知覚できないオーバーヘッドで、プロンプトインジェクションやAIの思い込みに左右されない100%決定論的なデータ保護が成立します。
4. なぜ単純なベクター検索RAGは自滅し、オフライン記憶定着「Dreaming」が87%で勝つのか
データ基盤のハーネス(90テーブルと6.5ミリ秒検問)を整えた上で残る最後の課題が、**「日々変化するテーブル仕様や、過去の失敗クエリから得た教訓を、どうやってエージェントの長期記憶として定着させるか」**です。
Anthropic ResearchのLance Martin氏らが発表した**『The Components of Agent Memory』は、会話ログやドキュメントをそのままチャンク分割してベクターDBへ入れる「素朴なRAG(Search Alone)」の限界と、人間の睡眠時の記憶整理を模倣したオフライン処理「Dreaming」**の威力を定量的に示しています。
| 評価ベンチマーク / 検証環境 | 比較対象 / セッション規模 | 正答率(Accuracy)の推移 | 構造的な勝因とメカニズム |
|---|---|---|---|
| Stainless 大規模コードベース / (約 350,000 ファイル) | オフライン Dreaming を 2セッション → 128セッション へ拡大 | 13% → 48% / (約 3.7倍 に急上昇) | 稼働していない空き時間に過去の実行軌跡・エラーログを振り返り、古い前提の修正とモジュール間依存関係の構造化を自律蓄積。 |
| Harvey 法務ベンチマーク(LAB) / (企業統廃合・複雑依存関係) | 単純ベクター検索(Search Alone) vs Dreaming 自律編纂 Wiki | 73%(Search Alone) / → 87%(Dreaming Wiki) | 表面的な類似チャンクを拾うだけのベクター検索に対し、空き時間に因果関係を整理した Markdown Wiki(index.md+トピック頁) が +14pt の大差で勝利。 |
オンライン(業務実行中)にリアルタイムで記憶を整理させようとすると、思考トークンとレイテンシが爆発します。だからこそ、**「日中のクエリ実行時は段階的開示と6.5ミリ秒のAST検問ゲートで極小コンテキスト・高速・安全に動かし、夜間のアイドル時間にDreamingバッチを回してその日の失敗SQLや業務知識をMarkdownの社内Wikiへ統合・昇華させる」**というオンライン/オフラインの役割分離が極めて合理的なのです。
5. 結論:社内データ基盤をAIエージェントへ安全に開放する「3つの実装ステップ」
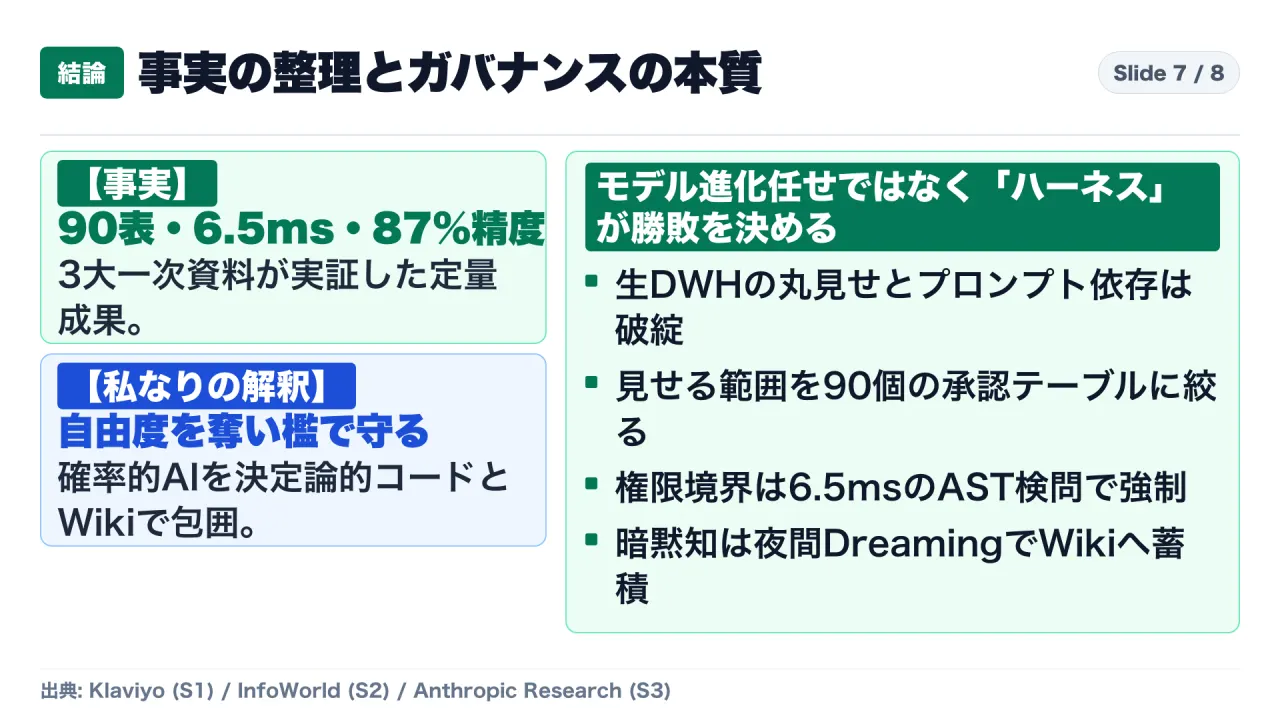
【事実】90個の承認テーブル・6.5ミリ秒のAST検問・87%のDreaming Wiki
KlaviyoのKBI(100+ dbt指標と約90個の承認テーブルによる4人から数百人への拡大)、InfoWorldのSafe SQL検証(900クエリで最大80行の漏洩を6.5ミリ秒のAST書き換えで0行に遮断)、そしてAnthropicのDreaming(35万ファイルで13%→48%、法務ベンチマークで73%→87%)は、いずれも**「モデル単体の賢さに頼るのではなく、モデルを取り囲む環境(ハーネス)と記憶構造を設計すること」**が決定的な差を生むという事実を示しています。
【私なりの解釈】確率的なAIを「決定論的なコードの檻」と「構造化Wiki」で挟み撃ちにする
AIエージェント導入で失敗する組織は、「生データベースをそのまま繋ぎ、システムプロンプトに『他部署のデータを見るな』『正しいテーブルを使え』とお願いを書く」というアプローチを採っています。しかし確率的にトークンを予測するLLMに対して、自然言語のルールは単なる「提案」にしかなりません。成功の鍵は、AIの自由度を意図的に奪い、見せる範囲を90テーブルに絞り、セキュリティ境界は6.5ミリ秒の構文木コードで物理的に強制し、知識の整理は夜間のWiki編纂へ分離することにあります。
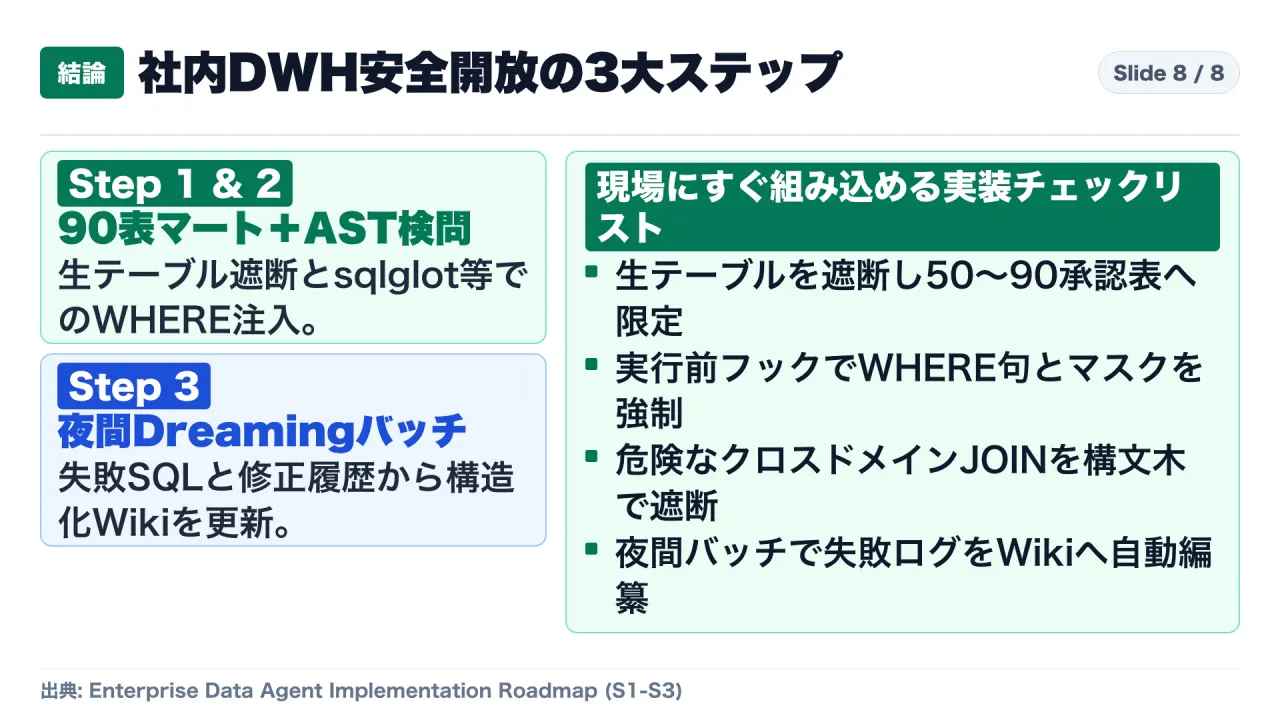
この設計を自社のデータ基盤へ導入するための具体的な実装ステップは以下の3つです。
- ステップ1(Walled Gardenの構築):生テーブルへのアクセスを遮断し、50〜90個の「承認済みマート層」だけを公開する
- AI用のデータベースロールからステージング層や未整理テーブルへの参照権限を完全に剥奪します。全社共通の主要KPIはdbt等のセマンティックレイヤーで計算式を固定しつつ、深掘り分析用にはカラム説明とデータ鮮度が保証された50〜90個のクリーンなマートテーブル群(Walled Garden)だけを切り出して接続し、段階的開示(ツールベルト方式)で必要なスキーマのみを注入します。
- ステップ2(決定論的SQL検問ゲート):プロンプトの注意書きを廃し、実行前「6.5ミリ秒」のAST書き換えフックを挟む
PreToolUseフックやDBプロキシ層にPythonのsqlglot等のSQLパーサーを組み込み、AIが生成したSQLを実行前に抽象構文木(AST)へ変換します。実行ユーザーの所属・ロールに基づき、行フィルタ(WHERE territory_id = ...)の強制注入、権限外カラムのNULLマスキング、および禁止されたテーブル間JOINの遮断をプログラムコードとして100%強制します。
- ステップ3(オフライン記憶定着):夜間アイドル時に失敗ログからMarkdownの社内Wikiを編纂する「Dreamingバッチ」を回す
- 生の会話ログをベクターDBへそのまま放り込む運用を見直し、夜間のバッチジョブ(Dreaming)として、その日に発生したSQLエラーやアナリストによる修正履歴を振り返らせます。テーブルごとの結合の罠やドメイン知識を「構造化されたMarkdown Wiki」として自動更新・編纂させることで、日中の段階的開示で参照される知識の精度を継続的に引き上げることができます。
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
参考・一次資料リンク一覧
- Klaviyo Engineering Blog (Will Tremml)『How Klaviyo Scaled Analytics by Getting Out of the Way & Inside the Harness: Deterministic Systems』: https://klaviyo.tech/blog/how-klaviyo-scaled-analytics-by-getting-out-of-the-way
- InfoWorld (Venkat Navneeth Burla)『Your LLM writes good SQL. That’s not the same as safe SQL.』: https://www.infoworld.com/article/safe-sql-llm-governance
- Anthropic Research (Lance Martin)『The Components of Agent Memory』: https://www.anthropic.com/research
動画での解説
{{YOUTUBE_URL}}
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48