なぜAIで開発速度が3倍でも「社内DDoS」と本番75%不合格が起きるのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜAIで開発速度が3倍でも「社内DDoS」と本番75%不合格が起きるのか?
AIコーディングエージェントの導入によって、エンジニア1人あたりのコード実装速度は劇的に跳ね上がりました。しかし、開発現場でいま実際に起きているのは「生産性の爆発」ではなく、未検証の変更が1日1,000件押し寄せて組織の意思決定を麻痺させる「社内DDoS攻撃(Internal DDoS)」と、開発ベンチマークで合格したシステムが本番の受入審査で75%不合格になる「AIスロップ(粗製乱造)」の蔓延です。
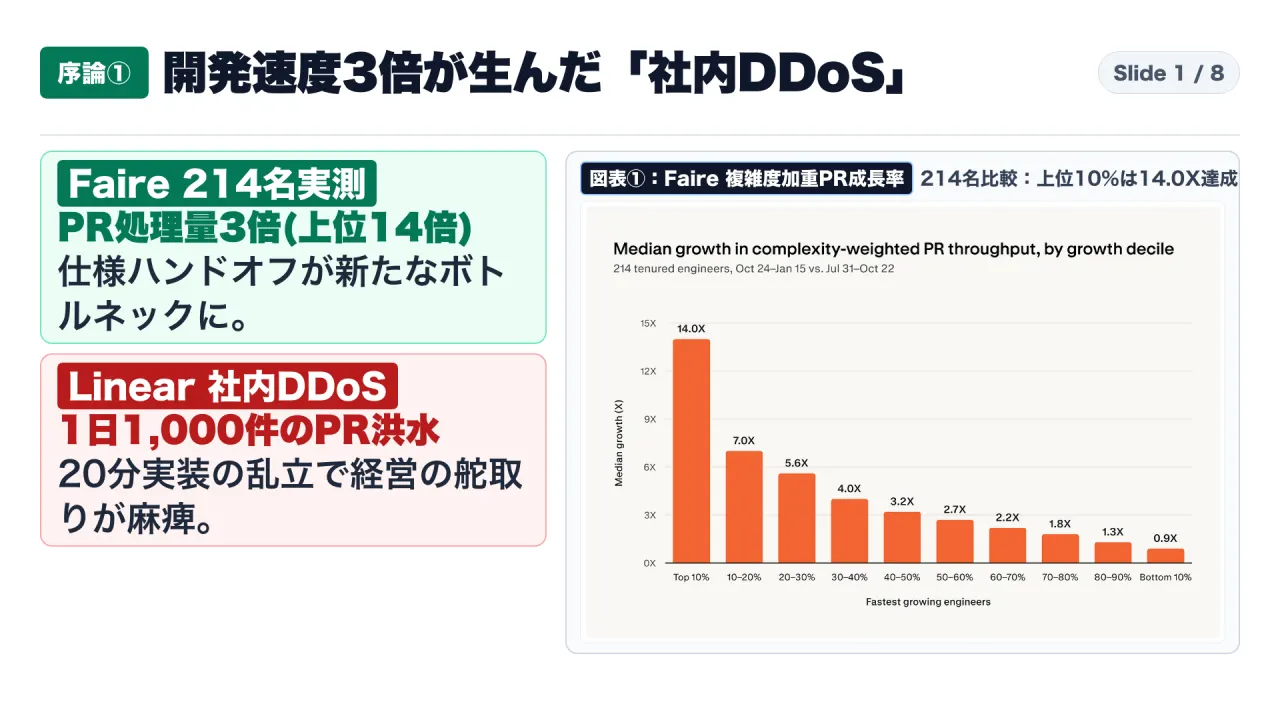
B2Bマーケットプレイス大手のFaireが社内エンジニア214名を対象に実施した実測調査(Faire: How Faire Developed Product Builders)では、AIツールの導入から1年間で複雑度加重後のプルリクエスト(PR)処理量が全社平均で約3倍、上位10%のエンジニアでは14.0倍に到達しました。一方で、Linear共同創業者兼CEOのKarri Saarinen氏は、従来2週間かかっていた機能実装がAIで20分に短縮された結果、あらゆる思いつきが未整理のまま1日1,000件のPRとなって押し寄せ、レビューと戦略の舵取りをパンクさせていると警告しています(Karri Saarinen: Our organizations are being DDoSed from the inside、Jeff Gothelf解説記事)。
さらに、Oracle AI研究チームが公開したFDE(Forward-Deployed Engineer:顧客常駐型実装エンジニア)エージェントの検証論文(arXiv:2611.03551v1)は、さらに深刻な構造欠陥を数値で突きつけました。15種類のAIモデルに顧客ヒアリングと要件定義(Discovery)を行わせたところ、顧客からせっかく引き出した4,122件の要件事実のうち、実に21.2%にあたる874件が最終仕様書(PRD)への書き起こし段階で抜け落ちました。その不完全な仕様書をもとに自律実装(Delivery)を行った結果、開発中の単体テストでは60%以上のスコアを出しながら、本番の受入基準(精度・エラー率・応答速度)をすべて満たした実行は8件中わずか2件(合格率25%)にとどまり、合格した2件もすべて人間のFDEの品質を下回ったのです。
本稿では、Google DeepMindでGeminiプロダクトマネジメント統括を務めるTulsee Doshi氏の一次対談(Lenny’s Podcast)、Oracle AI研究チームのFDEエージェント論文(arXiv:2611.03551v1)、Linear・Faire・Spotifyの一次技術記事、および顧客要望と減収リスクARRの逆転を実証したBellwetherの検証データを統合し、コード生成コストがゼロに近づく時代に「何を作らないか」を見極める審美眼(Taste)と要件定義・評価設計の経済学を解剖します。
序論:実装速度3倍・上位14.0倍の裏で起きている「社内DDoS」と「本番合格率25%」の現実
まず、AIコーディングツールが開発現場にもたらした「速度の急増」と、その結果としてどこに新しいボトルネックが移動したのかを一次データで確認します。
Faireのプロダクトリーダーシップチーム(束ね役を務めたプロダクト幹部陣)は、2025年1月から2026年1月までの1年間、在籍し続けたエンジニア214名全員のプルリクエスト(PR)を、単なる行数ではなく変更の複雑度で重み付けした「複雑度加重PRスループット(Complexity-Weighted PR Throughput)」として追跡しました(Faire: Accelerating Product Development in the AI Age)。
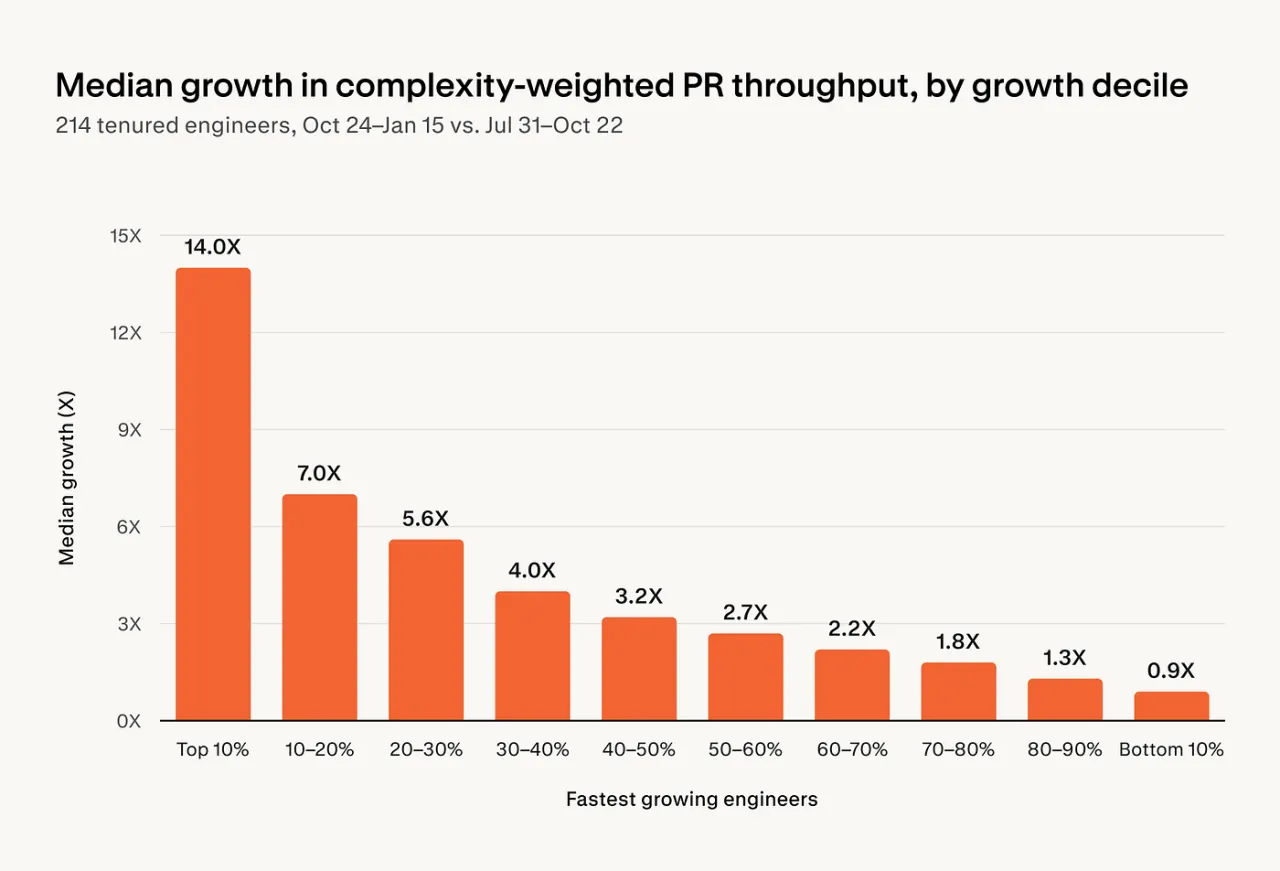
上の実測グラフが示す通り、214名全体の平均で約3倍、最もAI活用に習熟した上位10%のグループでは実に14.0倍という劇的な出力増加が記録されています。しかし、Faireのチームは「エンジニアがコードを書く速度が3倍になった瞬間、プロダクトマネージャー(PM)・デザイナー・エンジニア間の仕様確認とハンドオフ(引き継ぎ)が最大のボトルネックになった」と報告しています。
この現象を「組織内部からのDDoS攻撃(Internal DDoS)」と名付けたのが、Linear CEOのKarri Saarinen氏です(Karri Saarinen: Our organizations are being DDoSed from the inside)。DDoS攻撃とは本来、外部から大量の通信を送りつけてサーバーをパンクさせるサイバー攻撃を指します。しかし現在のソフトウェア企業では、AIエージェントによって「これまで2週間かかっていた機能実装がわずか20分で形になる」ようになったため、社内メンバーや自律エージェントが1日に何百件、組織全体では1日1,000件ものプルリクエストを次々と生成できるようになりました(Jeff Gothelf: How to Turn 1,000 Pull Requests a Day into the Few Your Customers Need、Waydev分析記事)。
かつては「実装に2週間かかる」という物理的な摩擦そのものが、「本当にその機能を作る価値があるか」を事前に考えさせる天然のフィルターとして機能していました。その摩擦が消滅した結果、顧客価値の薄い思いつきやエッジケースを考慮しない変更が大量に流れ込み、コードレビュー、QA検証、そして「製品としての一貫性を保つ意思決定」が内側からパンクしているのです。
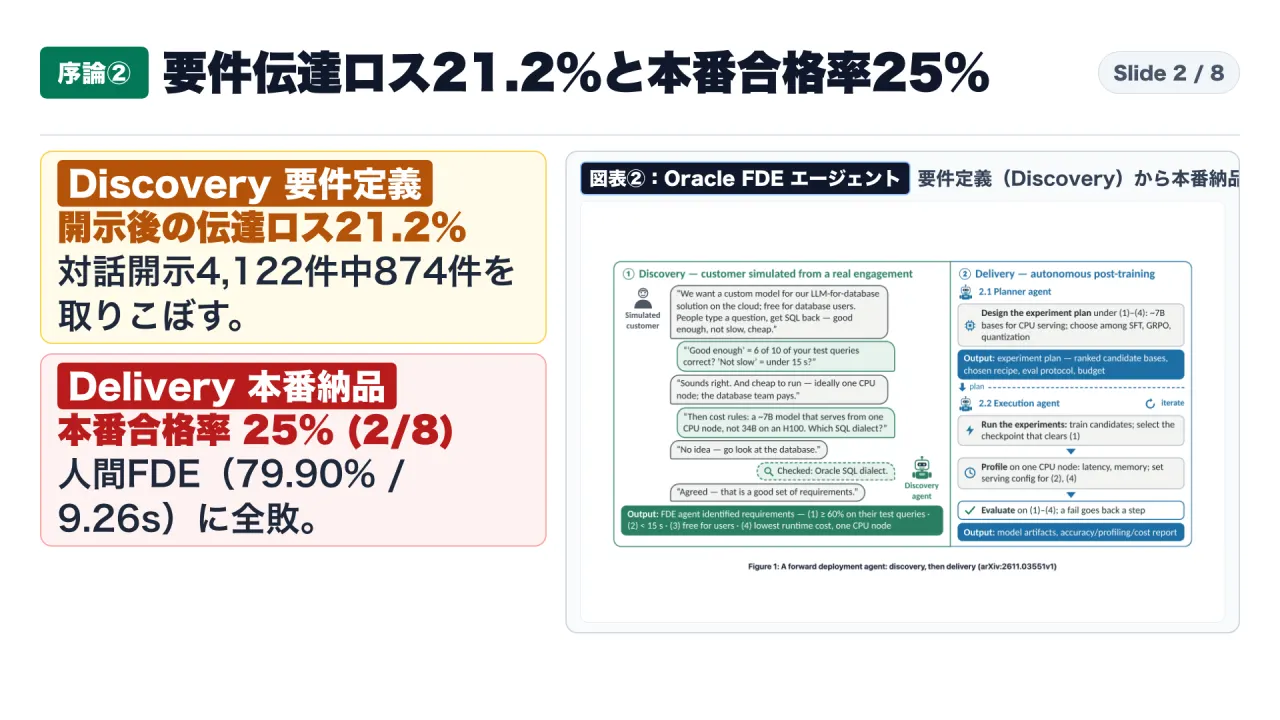
さらに、「AIに要件定義から実装まで一貫して任せれば解決するのではないか」という楽観論を覆したのが、Oracle AI研究チーム(Jie Liu氏、Minzhi Leticia Li氏、Caiming Xiong氏ら)が発表したFDEエージェントのベンチマーク論文『From Discovery to Delivery: Benchmarking Full-Cycle Forward-Deployed Engineering Agents』(arXiv:2611.03551v1)です。
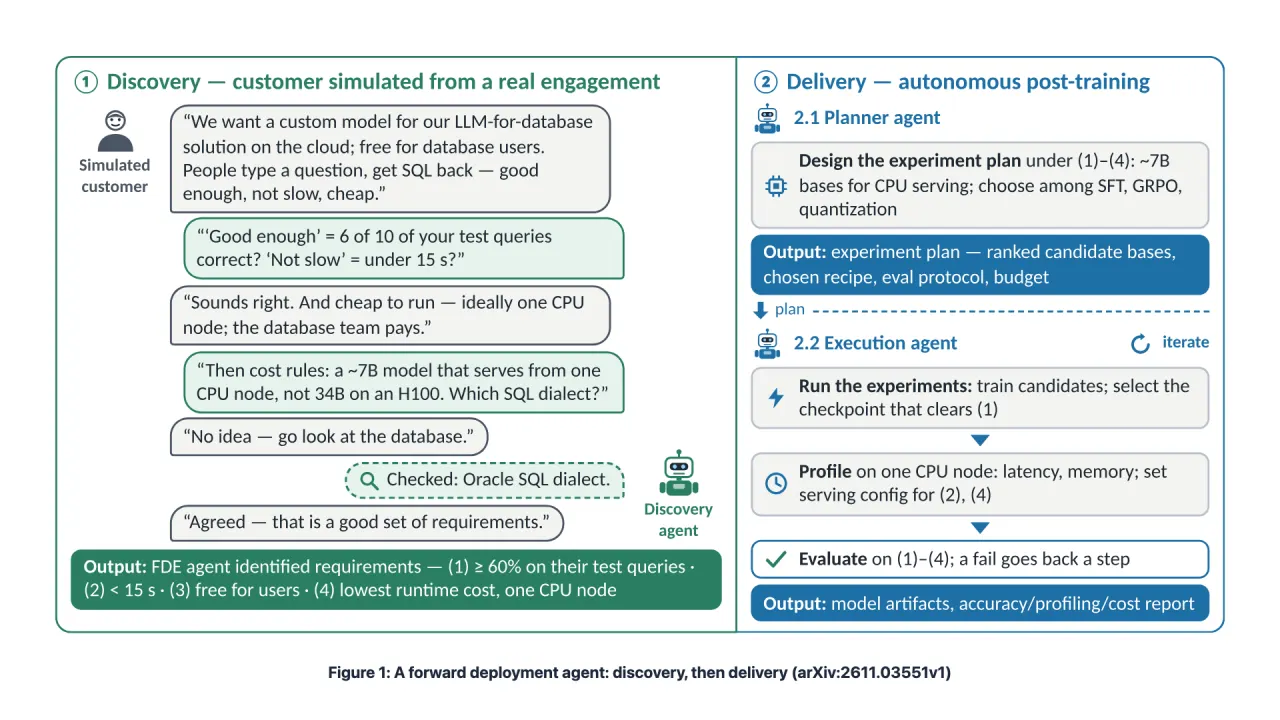
FDE(Forward-Deployed Engineer)とは、Palantirなどが確立した職種で、顧客企業の現場に入り込んで曖昧な業務課題をヒアリングし(Discovery)、仕様書(PRD)を書き上げ、本番環境で動くシステムを実装・納品する(Delivery)役割を指します。Oracleの研究チームは、この一連のサイクルをAIエージェントがどこまで代替できるかを検証しました。その結果、以下の3つの決定的なボトルネックが明らかになりました。
| 検証項目 | 一次資料の実測値 | 意味する構造的課題 | 出典 |
|---|---|---|---|
| 要件伝達ロス(Fact Transmission Loss) | 21.2%消失(開示4,122件→PRD記載3,248件、874件脱落) | 顧客対話で引き出した要件の5件に1件が、仕様書へまとめる段階で勝手に要約・削除される | Oracle FDE論文 Table 7(S2) |
| 本番受入合格率(Delivery Pass Rate) | 25.0%(8実行中2件のみ合格) | 開発ベンチ(Spider)で60%超でも、本番の失敗率(≤15%)やp90遅延(≤15秒)で75%が脱落する | Oracle FDE論文 Table 2(S2) |
| 人間FDEとの品質差 | 人間 79.90% / 失敗6% / 9.26秒 vs AI最高 77.40% / 失敗10% / 14.37秒 | 合格した2件のAI実装も、精度・安定性・速度のすべてで人間のFDEを下回る | Oracle FDE論文 Table 2(S2) |
第1章:Google DeepMind Gemini統括が語る「審美眼(Taste)」と60-20-20投資則、Spotifyの3層AI PM分業
コードやプロトタイプを誰でも20分で作れる時代に、人間のプロダクトリーダーやエンジニアが担うべき本来の価値はどこにあるのでしょうか。Google DeepMindでGeminiモデル群および検索・YouTube統合のプロダクトマネジメントを統括するTulsee Doshi氏は、Lenny’s Podcastの対談(YouTube一次音声、Lenny’s Newsletter記事)の中で、AI時代のプロダクト開発を支配する5つの原則を語っています。
1. カオスの中で秩序を作る「審美眼(Taste)」と「洞察(Insight)」
Doshi氏はまず、フロンティアAI開発の現場がいかに激しい変化の中にあるかを次のように表現しています。
“Everything feels like chaos all the time. How do we help establish clarity and structure and intent in that chaos?” (すべてが常にカオスのように感じられます。そのカオスの中で、どうやって明快さと構造、そして明確な意図を打ち立てるかが問われています) — Tulsee Doshi, Head of Product for Gemini, Google DeepMind(00:03:11)
そして、データ集計や定型文書作成をAIが瞬時にこなせるようになった今、人間のプロダクト担当者に求められる能力を「データ(Data)ではなく洞察(Insight)と審美眼(Taste)である」と定義しています。
“What you provide is not data, what you provide is insight. Taste is knowing how to take those insights and put the right weights on them to then make a decision.” (あなたが提供すべきなのは単なるデータではなく「洞察」です。そして「審美眼(Taste)」とは、それらの洞察を受け止め、適切な重み付けを行って意思決定を下す力なのです) — Tulsee Doshi(00:48:51)
AIに顧客ログや要望リストを読ませれば、もっともらしい機能案を100個並べることは簡単にできます。しかし、その中から「どの1個に賭け、残り99個を作らないと決めるか」という重み付け(Weighting)こそが審美眼であり、社内DDoSを止める唯一の防波堤となります。
2. モデル進化を先回りする「60-20-20のポートフォリオ投資則」
さらに、数ヶ月単位で基盤モデルの性能が跳ね上がる環境では、現在のモデルの弱点を人間側の小手先のコード(ルールベースのラッパー)で埋める作業は、次世代モデルが出た瞬間にすべて無駄になります。Doshi氏はリソース配分の黄金律として「60-20-20の法則」を提示しています。
“Spend 60% of your time on things we know the model can do today… 20% at the edge of capability… and 20% on glimmers of capability that the next model will unlock.” (時間の60%は現在のモデルで確実に動く価値提供に使い、20%は現在の能力のギリギリの境界線に使い、残りの20%は「今はまだ不完全だが次世代モデルで一気に開花する兆し(Glimmers)がある領域」に投資すべきです) — Tulsee Doshi(00:20:23)
Doshi氏自身の失敗談として、かつてコンテキスト長を128Kトークンへ広げる研究を進めていた際、別チームが密かに100万(1M)トークンへの跳躍を実現したことで、128K前提の段階的な最適化計画が一夜にして不要になった事例が語られています(00:33:58)。モデルの進化に逆らう補助輪を作るのではなく、モデルが賢くなるほど自動的に製品価値が上がる構造に20%の先行投資を張ることが不可欠です。
3. 「5本から20本のMini Eval(ミニ評価セット)」とSpotifyの3層AI PMモデル
では、その「能力の境界線」をどうやって日々見極めるのでしょうか。Doshi氏が実践しているのが、何万件もの巨大ベンチマークではなく、まずは5本、次に20本の厳選した難問プロンプトでモデルを徹底的に追い込む「Mini Evaluation(ミニ評価セット)」です。
“Come up with five prompts that really stress-test the capability you want… Then scale it to 20.” (自分が実現したい能力を極限までストレステストする5つのプロンプトをまず自分で作りなさい。そしてそれを20本に広げなさい) — Tulsee Doshi(00:23:29)
この「評価(Eval)そのものをプロダクトの核に据える」思想を組織構造へ落とし込んだのが、Spotifyが2026年11月に公開した技術ブログ『AI Product Management at Spotify: A View From Three Angles』(Spotify Engineering)です。
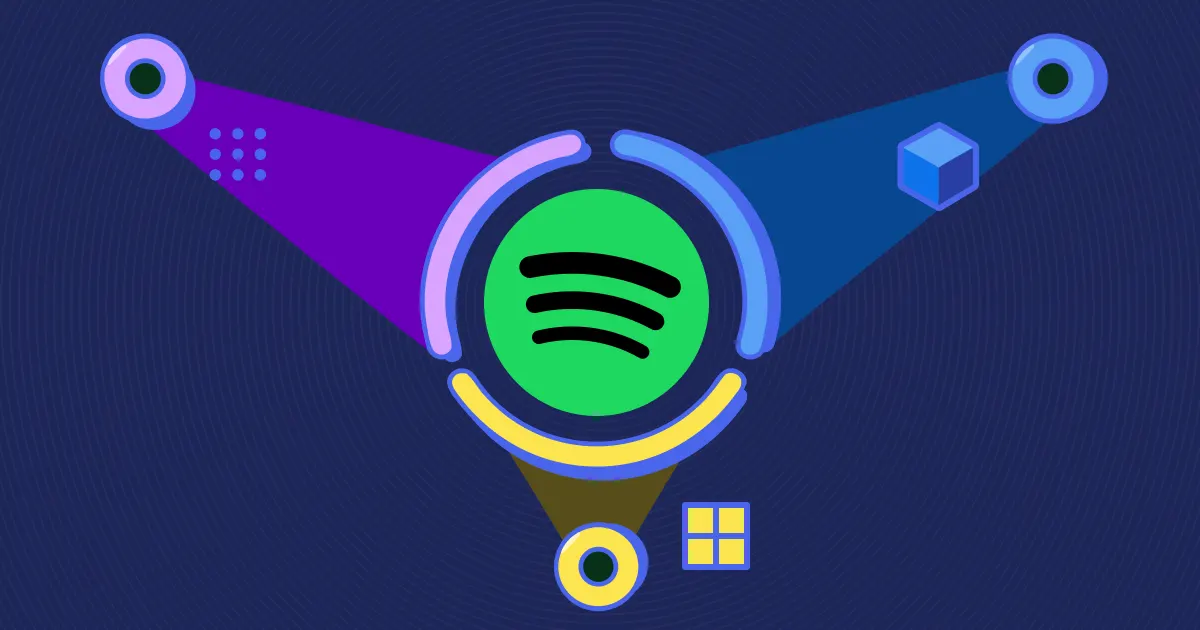
SpotifyはAIプロダクトマネジメントを単一の職種として扱うのをやめ、以下の3つの専門領域(Three Angles)による分業体制を定義しました。
- AI Research PM(研究層): 基礎研究とインフラのレバレッジを最大化し、どの技術的ブレークスルーを自社基盤へ取り込むかを決定する。
- AI Model PM(モデル層): 事後学習(Post-training)やファインチューニングを通じて、ドメイン固有の判断力や安全性をモデルに教え込む。
- AI Experience PM(体験層): 従来の「ボタンをクリックする決定論的UI」から、ユーザーが自然言語で何でも入力できる「無限の入力空間(Infinite Input Space)」へ変化したフロントエンド体験を設計する。
そしてSpotifyは、これら3層をつなぐ共通言語として**「Evaluation is a product, not just a process(評価とは単なる検証工程ではなく、それ自体が継続的に育て続けるプロダクトである)」**と明言しています。
第2章:Oracle FDE論文の衝撃──なぜ要件の21.2%が消え、本番受入の75%が落ちるのか
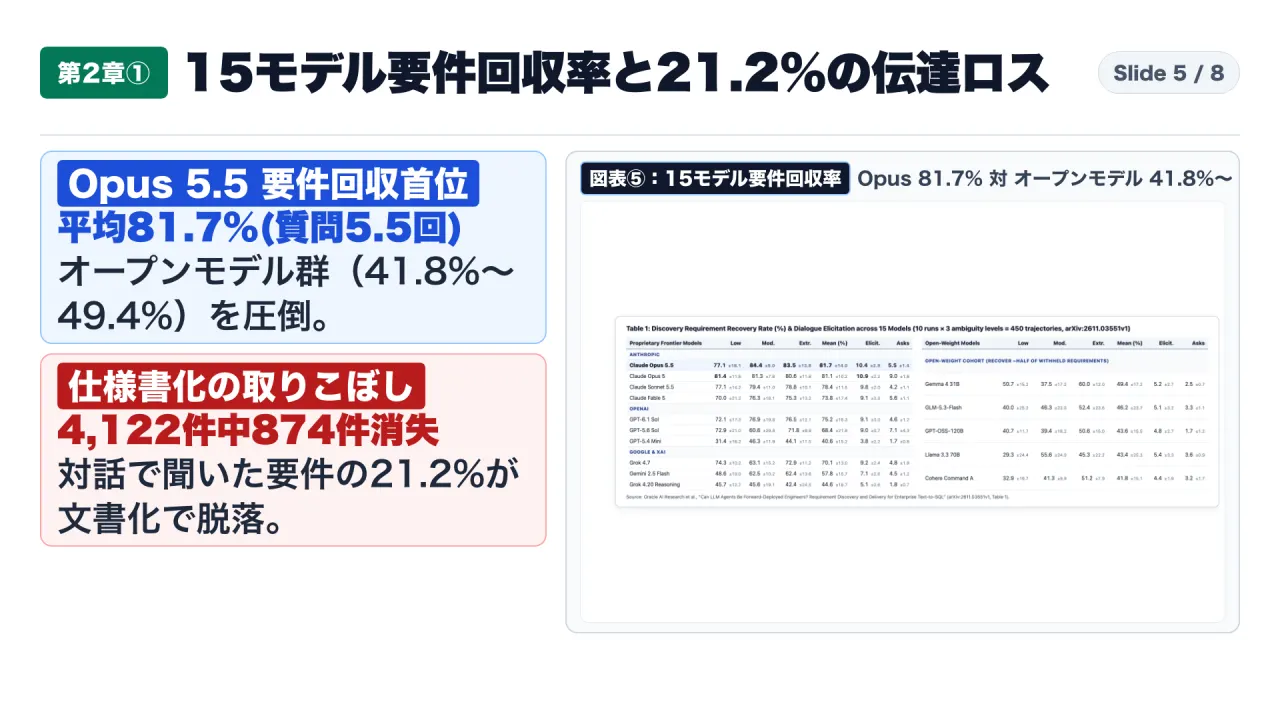
第1章で見た「要件の重み付け」と「評価ゲート」が欠落したまま自律エージェントに開発を丸投げすると何が起きるのか。それを徹底的な実験で明らかにしたのが、Oracle AI研究チームによるFDEエージェント論文(arXiv:2611.03551v1)です。
研究チームは、実際の企業システム導入を模した3つの複雑な業務ドメイン(① Text-to-SQLデータ分析基盤、② カスタマーサポートのチケット自動トリアージ、③ 医療機器メーカー等の営業提案・RFP自動生成)を構築し、AIエージェントに顧客役(User Simulator)へのヒアリングから仕様書(PRD)の作成までを行わせる「Phase 1: Discovery(要件定義)」を15種類のモデルで評価しました。
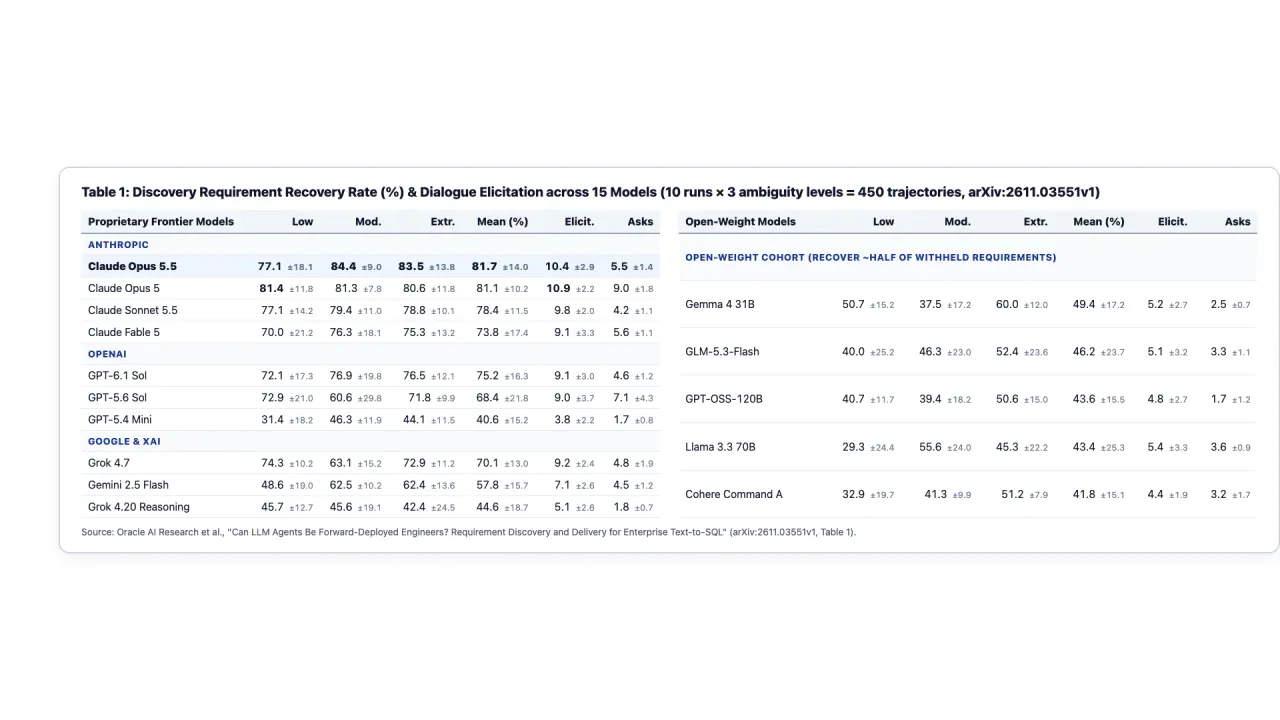
上のTable 1が示す通り、モデル間で「顧客から潜在要件を引き出す力」には2倍近い格差が存在します。
- 商用の最上位フロンティアモデル群:
Claude-Opus-5.5が平均要件回収率 81.7%(Text-to-SQL 81.9%、Ticket Triage 83.2%、Sales Proposal 79.9%)で全15モデル中トップに立ちました。しかも1回の対話あたりの質問数はわずか 5.5回、1質問あたりの新規事実獲得数は 0.65件 と、最小限の鋭い質問で核心の要件を引き出しています。次いでGPT-5.2(80.8%)、Claude-Sonnet-5.5(77.8%)、GPT-5.4(77.5%)、Gemini-3.1-Pro(77.1%)が続きます。 - オープンウェイトモデル群の苦戦: 一方、
Qwen3-32B(41.8%)、Llama-3.3-70B(42.3%)、Llama-4-Maverick(45.1%)、DeepSeek-V3(49.4%)といったオープンモデル群は、顧客が最初から教えてくれない非機能要件や例外ルールを深掘りできず、半分以上の要件を取りこぼしました。
さらに衝撃的なのが、論文のTable 7で明らかにされた**「開示後の要件伝達ロス(Post-Disclosure Fact Loss)」**です。
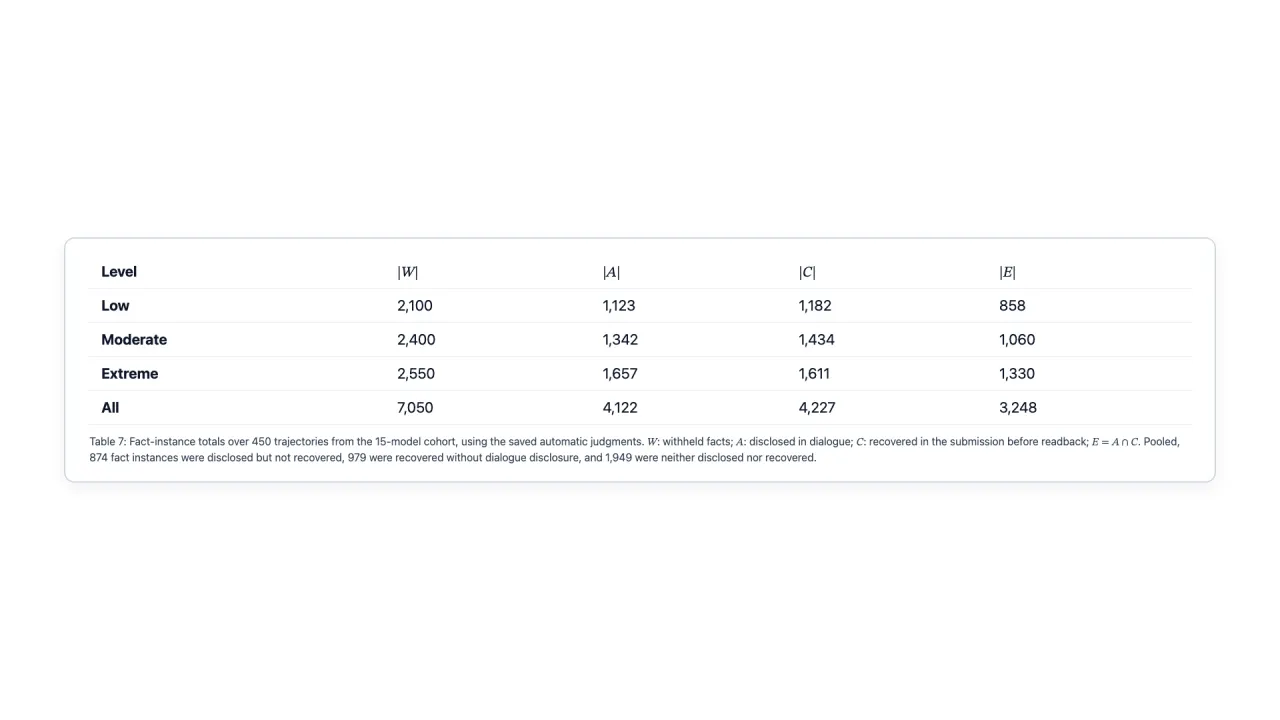
全15モデル・全実行を通じて、顧客役のシミュレータが対話の中で明確に口頭で開示した要件は合計 4,122件 ありました。ところが、エージェントがその対話履歴をもとに最終的な仕様書(PRD)を書き起こした際、記載されたのは 3,248件(78.8%) にとどまり、残りの 874件(21.2%)が仕様書から跡形もなく消えていたのです。
特に Gemini-2.5-Pro(伝達ロス38.7%)、Claude-Haiku-5.5(30.9%)、GPT-5.4(28.1%)などでも、対話中には把握していたはずの「特定カラムのNULL処理ルール」「15秒以内の応答時間制限」「禁止ワードの除外条件」といった細かい業務制約を、仕様書を綺麗に見せようとして勝手に要約・省略してしまう現象が多発しました。
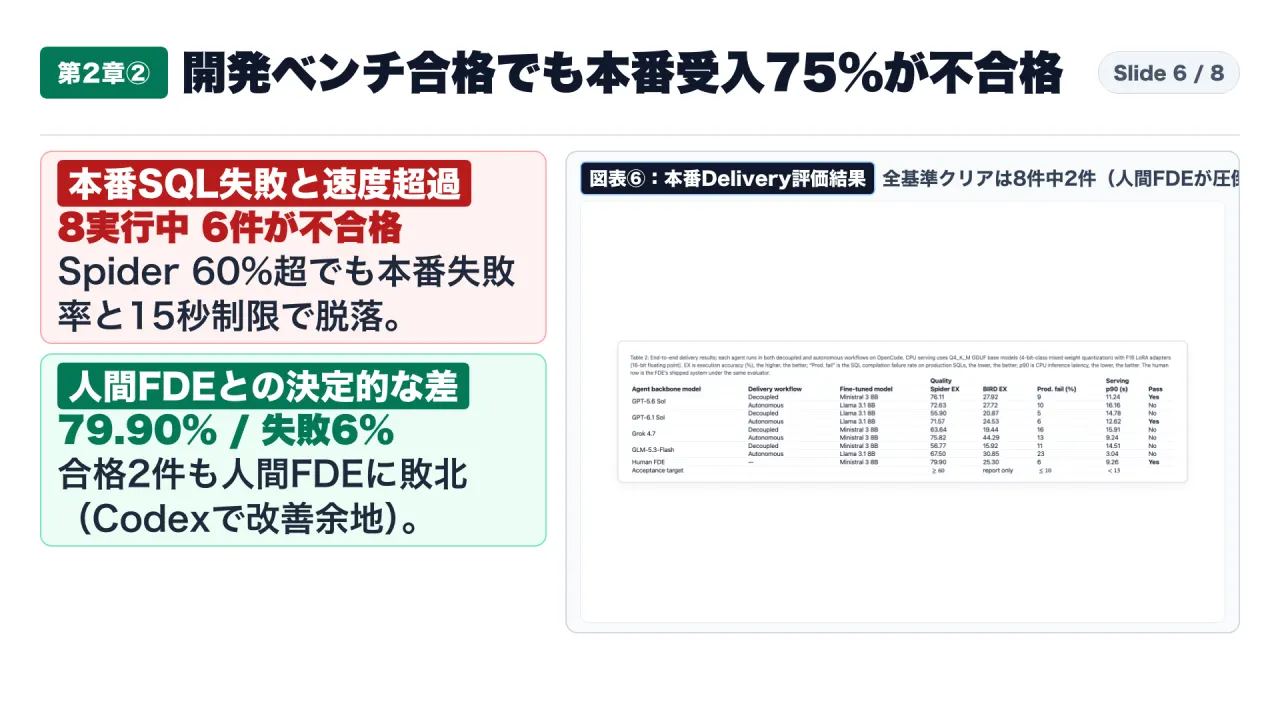
では、この21.2%の要件欠落を抱えた仕様書を「Phase 2: Delivery(システム実装・納品)」へ渡すとどうなるでしょうか。論文のTable 2(Text-to-SQLドメインの本番受入テスト結果)が、その冷酷な結末を示しています。
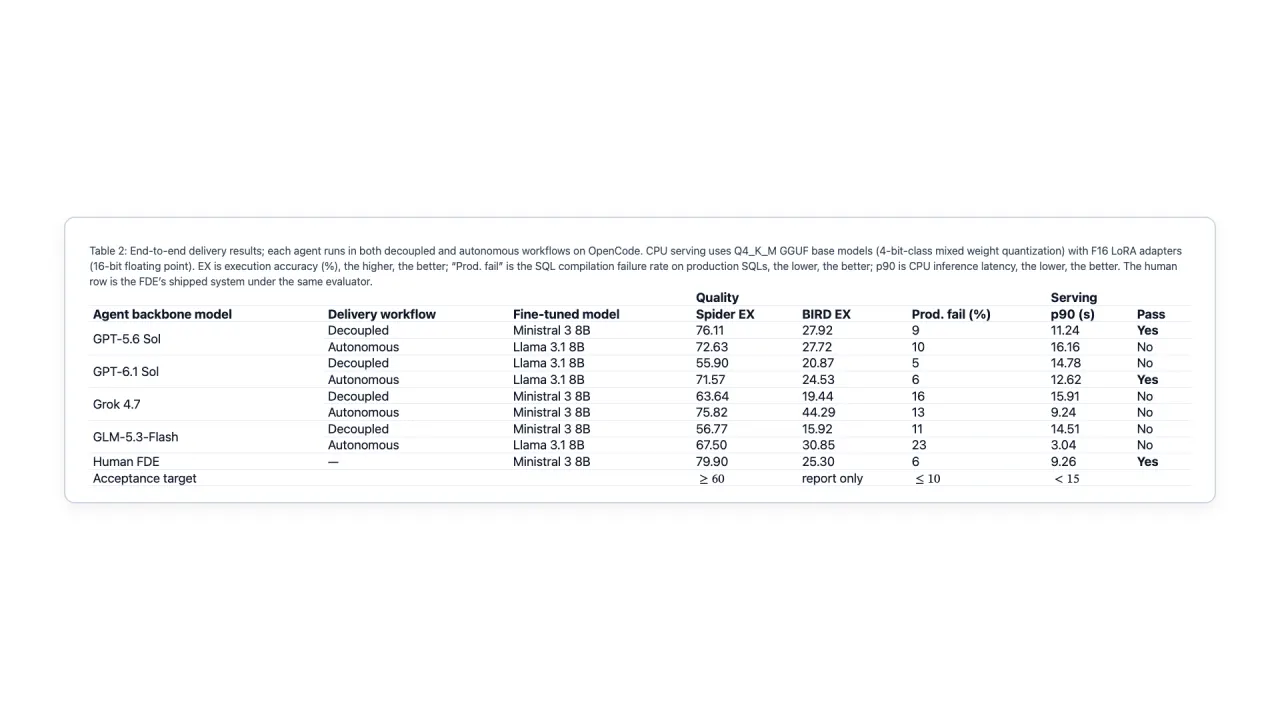
この実験では、本番納品の合格基準(Acceptance Criteria)として、以下の3つの条件すべてをクリアすることが求められました。
- Spider実行精度(EX): 60.0%以上
- 本番クエリの実行失敗率(Execution Fail Rate): 15.0%以下
- 90パーセンタイル応答遅延(p90 Latency): 15.0秒以下
Claude CodeハーネスおよびCodex CLIハーネスを使って計8通りのモデル組み合わせを走らせた結果、開発時のSpiderベンチマーク単体では8件中5件が60%以上を出して「一見動いている」ように見えたにもかかわらず、3つの本番基準をすべてクリアできたのは8件中わずか2件(合格率25.0%)だけでした。
- 不合格になった6件の死因: たとえば
Discovery: Opus-4.6 + Delivery: Opus-4.6 (Claude Code)の組み合わせは、Spider精度こそ65.91%を出しましたが、本番DBでのクエリ失敗率が 30%(基準15%以下)、p90応答遅延が 54.13秒(基準15秒以下) に達して不合格となりました。またGPT-5.4 + GPT-5.4 (Claude Code)もSpider精度は72.80%と高かったものの、p90遅延が 18.08秒 かかり、速度制限で落とされています。 - 人間FDEとの決定的な差: 合格したわずか2件(
Sonnet-4.6 + Sonnet-4.6の精度67.05%・失敗10%・遅延14.88秒、およびGPT-5.4 + Opus-4.6の精度77.40%・失敗10%・遅延14.37秒)であっても、熟練した人間のFDEが実装したベースライン(精度79.90%・失敗率わずか6%・p90遅延9.26秒)には、すべての指標で及びませんでした。なお、論文のTable 3ではハーネスをClaude CodeからCodex CLIへ変更することで一部の失敗率や遅延が改善する余地も示されていますが、要件定義段階での非機能制約の取りこぼしが本番障害に直結する構造は共通しています。
これこそが、単体テストだけを通過した「AIスロップ」が1日1,000件のPRとなって本番環境を脅かすメカニズムの正体です。
第3章:顧客要望75%の罠を破る「Bellwether」のリスクARR分析と、Faire「Product Builder」の3層改革
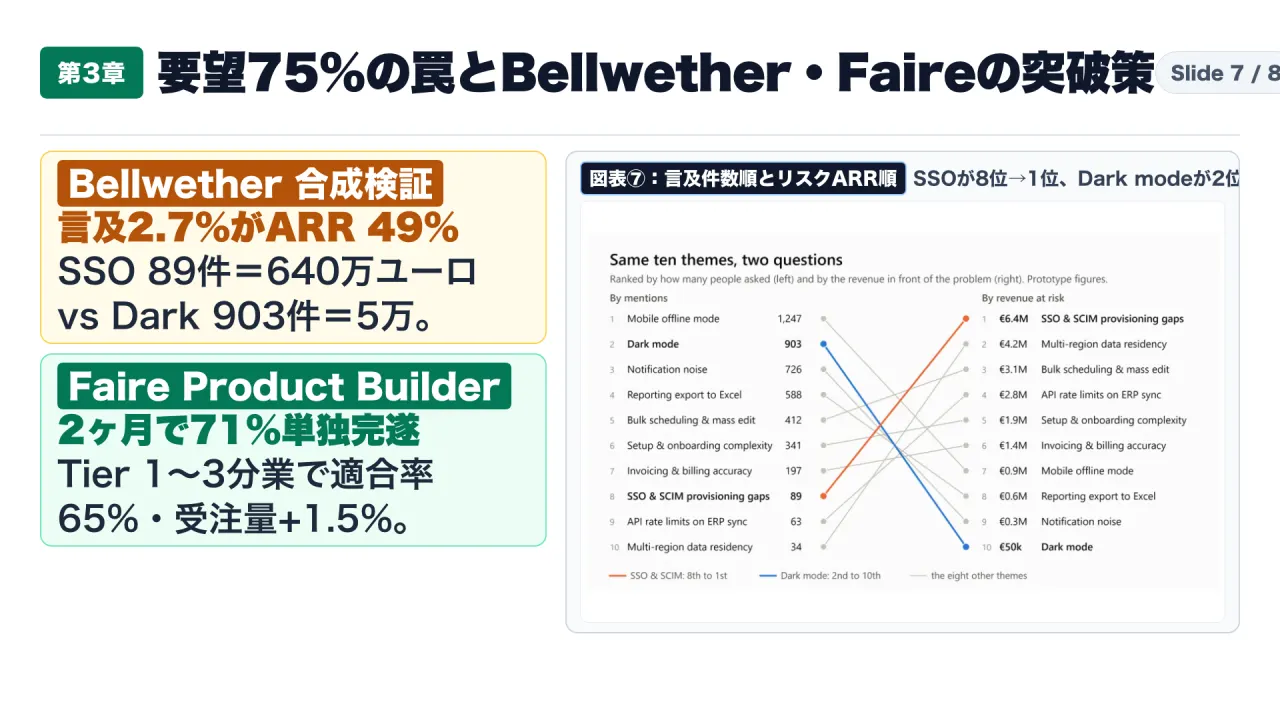
では、私たちはこの「社内DDoS」と「要件取りこぼし」をどうやって防げばよいのでしょうか。その具体的な解決策をデータで示したのが、データサイエンティストYassin氏が公開した顧客フィードバック分析システム「Bellwether」(Towards Data Science論文記事、GitHubリポジトリ)と、Faireの「Product Builder(プロダクトビルダー)」組織改革(Faire: The Craft)です。
1. 「声の大きい75%の要望」は減収リスクARRの8.5%しか持っていない
AIを使って顧客サポートのチケットやアンケートを自動集計すると、多くのチームは「言及件数(Mention Volume)が多い順」に機能開発の優先順位をつけてしまいます。しかしBellwetherの検証は、そのやり方がいかに危険な罠であるかを暴きました。
(※注記:このBellwetherのデータは、実在の特定企業の機密データではなく、年間経常収益(ARR)1,940万ユーロのB2B SaaS企業「Volta SA」を想定して構築された、6,693件の顧客シグナル・4,600件のクラスター化言及からなる公開合成ベンチマークデータセットによる検証です。)
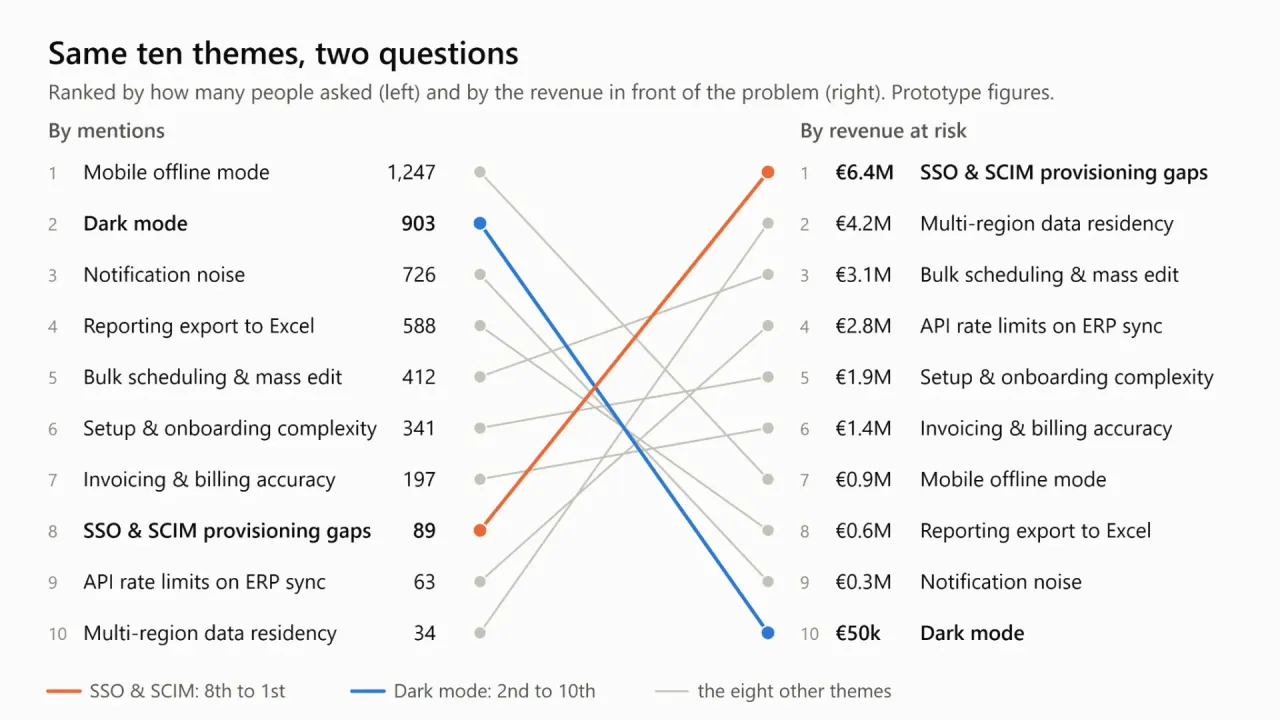
上のチャートが示す通り、単なる「言及件数」でランキングした場合と、顧客ごとの契約金額と解約確率を掛け合わせた「減収リスクARR(Revenue-at-Risk ARR)」でランキングした場合とでは、優先順位が完全に逆転します。
- 言及件数上位4テーマの罠: 「ダークモード(Dark mode:903件)」を含む言及件数トップ4のテーマは、全言及の 75% を占めていますが、それらが抱える減収リスクARRは全体のわずか 8.5% にすぎません。特にダークモードは903件もの要望がありながら、解約リスクのある大口顧客には全く関係がなく、リスクARRは最下位の 5万ユーロ(€50k) でした。
- 静かな2テーマが握る49%のARR: 逆に、言及件数が最も少ない部類の2つのテーマ──大口エンタープライズ顧客が求める「SSO & SCIM(シングルサインオンとID自動連携:わずか89件)」と「データレジデンシー(データ保管地域の法的指定:わずか34件)」──は、言及数では全体のわずか 2.7% しかありません。しかし、この2つを放置した場合の減収リスクARRは、SSO & SCIMが 640万ユーロ(€6.4M・第1位)、データレジデンシーが 420万ユーロ(€4.2M・第2位) と、たった2テーマで全社リスクARRの 49% を占めていたのです。
もしAIエージェントに「要望が多い順に1日1,000件のPRを作らせる」運用をしていれば、チームは5万ユーロの価値しかないダークモードの改修に追われ、1,060万ユーロのエンタープライズ契約を失うことになります。
2. Faireの「Tier 1〜3複雑度フレームワーク」とエンジニアの単独一気通貫リリース
一方、Faireは「仕様ハンドオフの渋滞」を解消するため、エンジニアとPMの役割分担を抜本的に作り変える「Product Builder(プロダクトビルダー)」プログラムを導入しました(Faire: The Craft)。
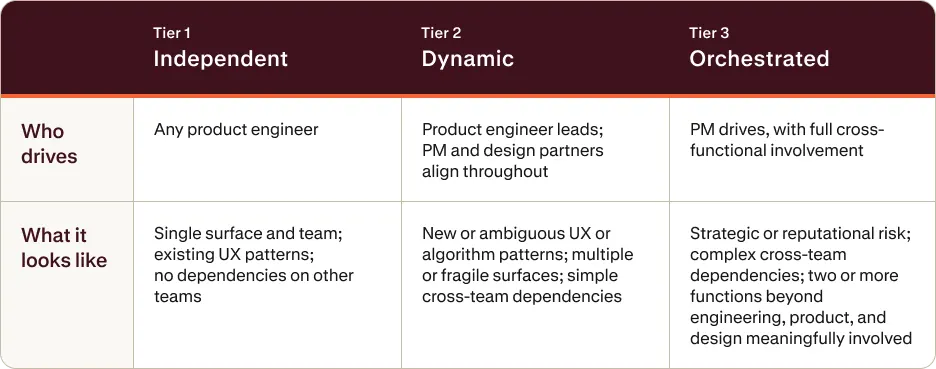
Faireはすべての開発案件を以下の3つの複雑度ティア(Complexity Tiers)に分類しました。
- Tier 1(低複雑度・明確な改善): PMやデザイナーを介さず、プロダクトビルダー訓練を受けたエンジニアが1人で「課題発見・要件定義・AIプロトタイプ作成・実装・実験計測・本番リリース」までを一気通貫(End-to-End)で完遂する。これにより部門間のハンドオフ待ち時間をゼロにする。
- Tier 2(中複雑度・複数領域にまたがる機能): PMが戦略的なガードレールと評価指標(Eval)を定義し、エンジニアがAIを使って複数のプロトタイプを高速検証しながら共同で進める。
- Tier 3(高複雑度・全社戦略や破壊的アーキテクチャ変更): PM・デザイン・エンジニアリングのリーダー陣が密接にタッグを組み、Tulsee Doshi氏が語った「審美眼(Taste)」と長期的なシステム整合性に集中する。
この改革の結果、Faireではプログラム導入からわずか 2ヶ月間で71%のエンジニアが、PMのハンドオフなしに少なくとも1つの機能を最初から最後まで単独で本番リリース しました。プロダクトビルダーとしての能力評価で「Capable / Strong(十分・優秀)」と認定されたエンジニアの比率は 41%から65%へ急上昇(年末目標85%) し、たとえば検索結果のカラーバリエーション表示(Color-Aware Variant Swatches)をエンジニア主導で改善した施策では、Faire全体の受注ボリュームを +1.5% 押し上げる直接的な事業成果を生んでいます。
また、投資家でリサーチャーのOguz Bilgic氏が提唱する通り(Maximum Viable Product)、AIによって実装コストが下がった時代には、中途半端な最小限の製品(Minimum Viable Product)を出して様子を見るのではなく、最初からエッジケースや非機能要件まで磨き上げた「Maximum Viable Product(最大限に完成された製品)」を少数精鋭で出し切る企業だけが顧客の信頼を獲得できます。
第4章:【私なりの解釈】AI時代の競争優位は「実装スピード」から「審美眼×自動評価ゲート」へ完全移行した
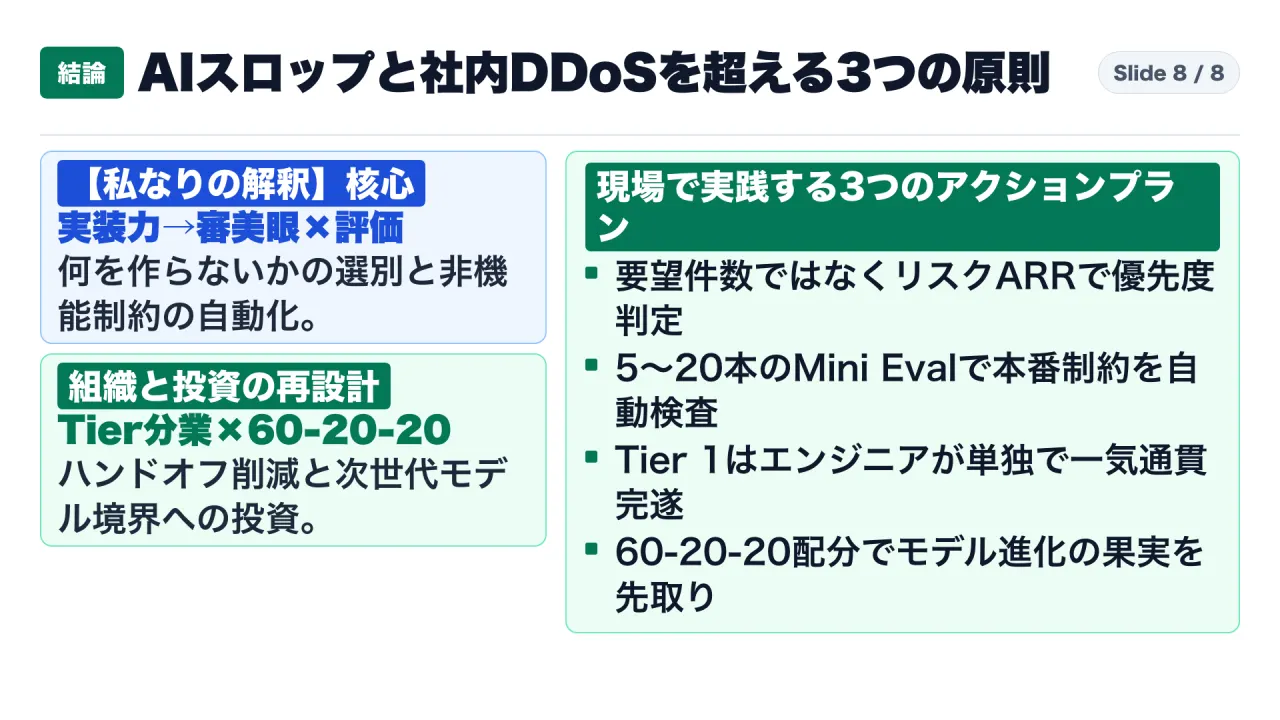
ここまで確認してきた一次資料の事実を踏まえ、私なりの解釈と実務への示唆を整理します。
これまでのソフトウェア開発では、「アイデアを動くコードに変換する実装力」が最も希少な資源でした。しかし、AIによって20分でPRが作れるようになった瞬間、コード生成そのものの希少価値は急速に低下し、代わりに**「① 何を作らないかを決める審美眼(Taste)」「② 対話から仕様書への21.2%の要件脱落を防ぐ構造化ヒアリング」「③ 本番の非機能制約(失敗率15%以下・p90遅延15秒以下など)を自動で弾く評価ゲート(Eval as a Product)」**の3つが、企業の生存を分ける真のボトルネックへと浮上しました。
今日から開発組織やプロダクトチームで実践すべき3つの具体的なアクションプランを提案します。
- 要望の件数順ではなく「減収リスクARR(Revenue-at-Risk)」で開発対象を絞り込むこと: AIで1日1,000件のPRを作れるからといって、声の大きい要望(言及75%・リスクARR 8.5%)を片っ端から実装すれば、社内DDoSで組織が崩壊します。Bellwetherの手法にならい、顧客フィードバックには必ず契約金額(ARR)と解約リスクの重みを掛け合わせ、全体の2.7%の声に隠れた「49%のリスクARR(SSOやデータガバナンス等の基幹要件)」を最優先で特定してください。
- 仕様書(PRD)の要件脱落チェックと「5〜20本のMini Eval+非機能受入ゲート」を自動化すること: Oracle FDE論文が示した通り、AIは対話で聞いた要件の21.2%を仕様書化で勝手に落とし、開発ベンチマークで合格しても本番の失敗率やレイテンシ制限で75%が落ちます。Tulsee Doshi氏の「5〜20本のストレステスト(Mini Eval)」と、本番相当のデータ量での「エラー率・p90応答時間ゲート」をCI/CDパイプラインに組み込み、基準を満たさないPRは人間がレビューする前に自動で差し戻す仕組みを作ってください。
- 案件を「Tier 1〜3」に分け、60-20-20の法則でリソースを配分すること: Faireのように定型的な改善(Tier 1)はエンジニアが単独で一気通貫リリースしてハンドオフの摩擦をなくし、浮いたPMとシニアエンジニアの時間を「現在のモデルの限界境界(20%)」と「次世代モデルで開花する領域(20%)」、そして高複雑度なTier 3案件の「審美眼(Taste)」に集中投下してください。
皆さんの開発現場では、AIによるPRの急増でレビューや仕様確認が詰まる「社内DDoS」の兆候は出ていませんか? ぜひ現場での課題や工夫をコメント等で共有してください。
参照一次資料・出典一覧
S1: Lenny’s Podcast: Tulsee Doshi (Head of Product for Gemini, Google DeepMind) — What it actually takes to build frontier AI products / Lenny’s Newsletter TranscriptS2: Oracle AI Research: From Discovery to Delivery: Benchmarking Full-Cycle Forward-Deployed Engineering Agents (arXiv:2611.03551v1) / AbstractS3: Karri Saarinen (CEO, Linear): Our organizations are being DDoSed from the inside / Jeff Gothelf: How to Turn 1,000 Pull Requests a Day into the Few Your Customers Need / Waydev: A Denial of Service from Your Own PeopleS4: Faire (The Craft): Accelerating Product Development in the AI Age: How Faire Developed Product BuildersS5: Spotify Engineering: AI Product Management at Spotify: A View From Three AnglesS6: Towards Data Science (Yassin): How to Prioritize Product Feedback by Revenue at Risk (Bellwether) / Bellwether GitHub Repository / Oguz Bilgic: Maximum Viable Product