なぜAIエージェントの「単一モデル統一」は破綻するのか?──Claude Fable 5.2・Muse Ember・Auto Codeの3層分業で単価74%削減
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜAIエージェントの「単一モデル統一」は破綻するのか?──Claude Fable 5.2・Muse Ember・Auto Codeの3層分業で単価74%削減
社内のソフトウェア開発、業務自動化、あるいは長時間にわたる技術調査にAIエージェントを導入する企業が増えています。しかし実務の現場では、「すべてのエージェント呼び出しを最も性能が高い単一モデルに統一したところ、簡単なファイル検索やログ確認だけでAPI費用が約72倍に膨れ上がった」、「逆に日常業務の標準モデルで30時間連続の難関タスクを回したところ、進捗率27%の地点でループに陥り完全に足踏みしてしまった」、そして**「コストを下げようと安価な自動ルーターを入れたのに、毎ターン違うモデルへ切り替わってプロンプトキャッシュが壊れ、かえって遅く高くなった」**という構造的な破綻が相次いでいます。
この「単一モデル統一の限界」と「キャッシュを守った3層分業の経済学」を定量的に実証したのが、Anthropic が公開した最上位フロンティアモデル**「Claude Fable 5.2 / Mythos 5.2」(前世代比20%値下げの入力8ドル・出力40ドル、生成速度最大30%高速化、約1,000体のエージェントによるフェルマーの最終定理30時間形式証明100%完遂)、Meta AI Research が公開し Artificial Analysis が独立検証した最小・最高効率モデル「Muse Ember」(入力0.10ドル・出力0.40ドル・キャッシュ入力0.015ドル、知能指数36で1タスク平均0.14ドル、ハルシネーション率17%)、そして月間2.5兆トークンを処理する OpenRouter が公開した次世代「Auto Router / Auto Code」(11因子のハーネス認識型ルーティングと連続10ターン中9ターンのモデル維持によるキャッシュ保護で、5つのベンチマーク全体でClaude Opus 5.5単体と同等の精度を維持しつつ1タスクあたりコストを74%削減**)です。
さらに、米国GDP主要産業・44職種の実務課題1,320件でAIの経済的価値を測定する GDPval-AA(および AA-Briefcase v1.1)の評価結果や、大量並列エージェントが検証用データベースを放置してインフラ破産・本番汚染を起こすのを防ぐ **MongoDB Atlas「Ephemeral Clusters(TTL自動破棄クラスタ)」**の仕組みを組み合わせることで、これからの実務AIエージェント基盤の標準設計が明確になりました。
この記事では、これら6つの一次資料と全20枚の検証図表(本編スライド8枚+一次資料公式図表12枚)をもとに、なぜ単一モデル統一が破綻するのか、そしてタスク単価を74%削減しながら30時間の難題を100%完遂させる「3層(3-Tier)エージェント分業アーキテクチャ」の設計手順を詳しく解説します。
1. 結論と対象読者:この記事で分かることと現場で実践できる行動
対象読者(いま直面している課題)
- Claude Code、Codex、Cline、OpenCode などのコーディング・業務エージェントを社内で本格運用したいが、上位モデル単体でのAPI請求額の肥大化や、軽量モデル単体での推論ループ・精度不足に悩んでいるエンジニアリング責任者・テックリード
- 複数のAIモデルを動的に使い分けるルーティング基盤や、並列エージェントが安全にテスト・検証を行えるデータベース隔離環境(CI/CD連携)を設計したいAIアーキテクト・SRE担当者
一次資料から導かれる3つの核心的結論
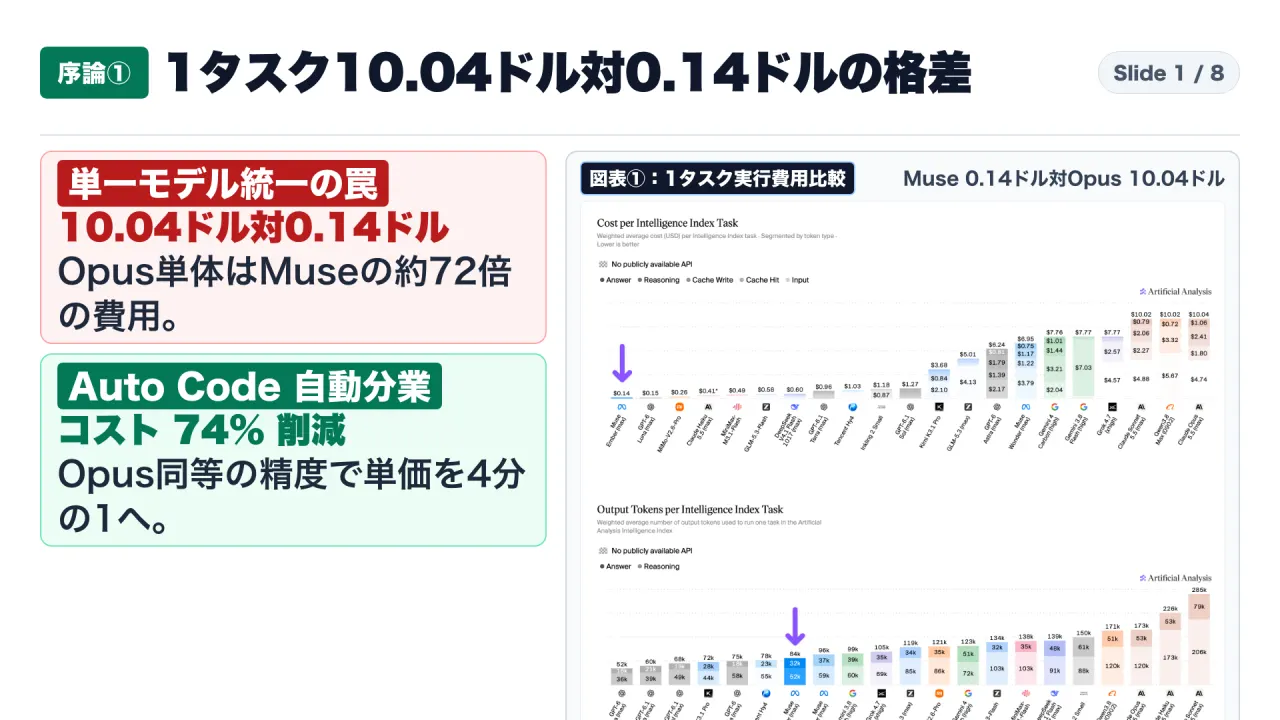
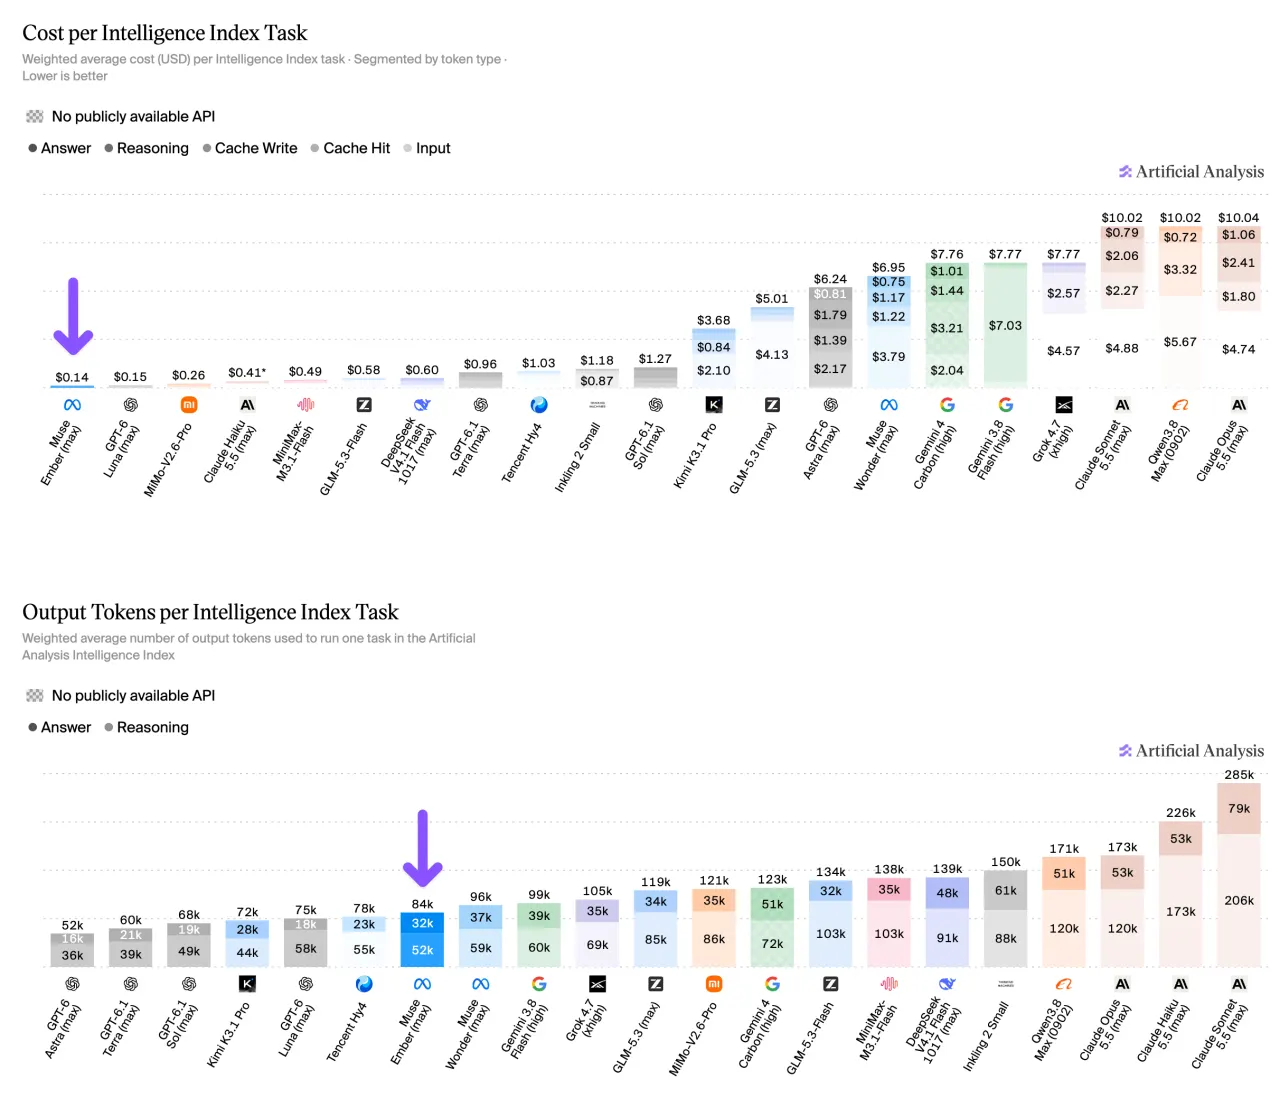
- 1タスク「10.04ドル」対「0.14ドル」の72倍コスト格差と、ハルシネーション率17%のサブエージェント層(Muse Ember)の誕生:
- Artificial Analysis「Intelligence Index v5.0.1」の実測において、上位モデルの
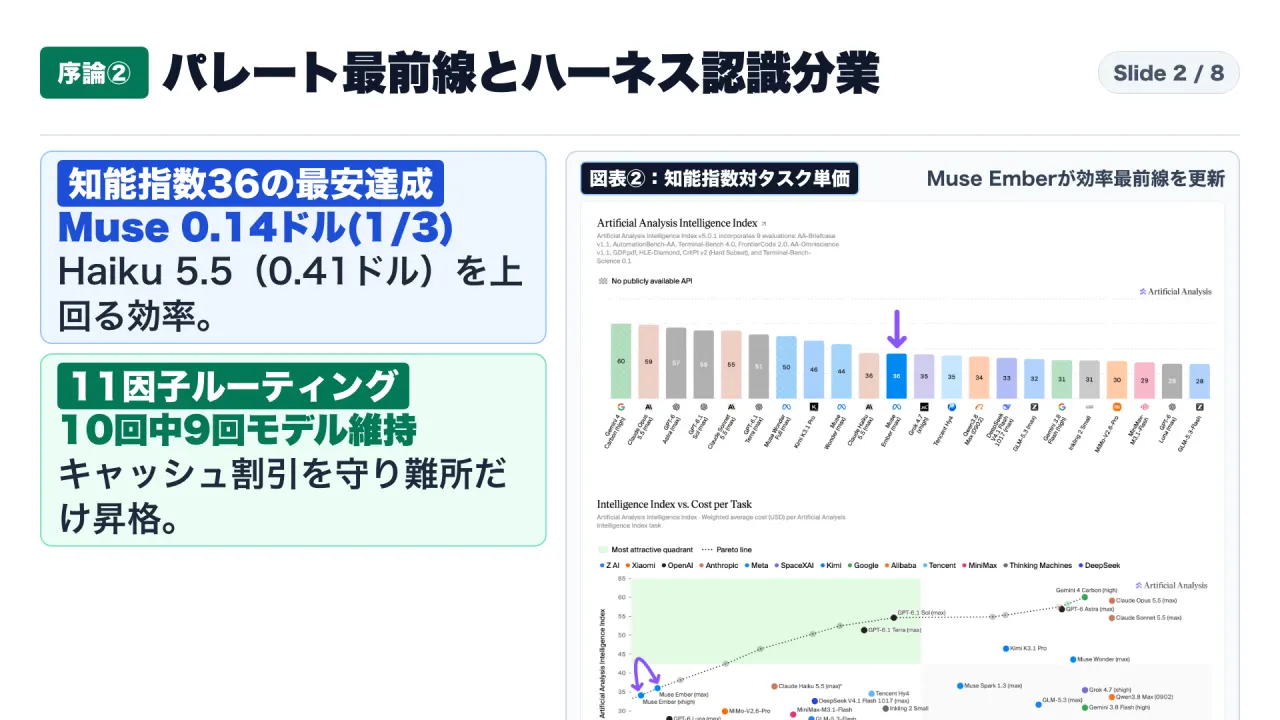
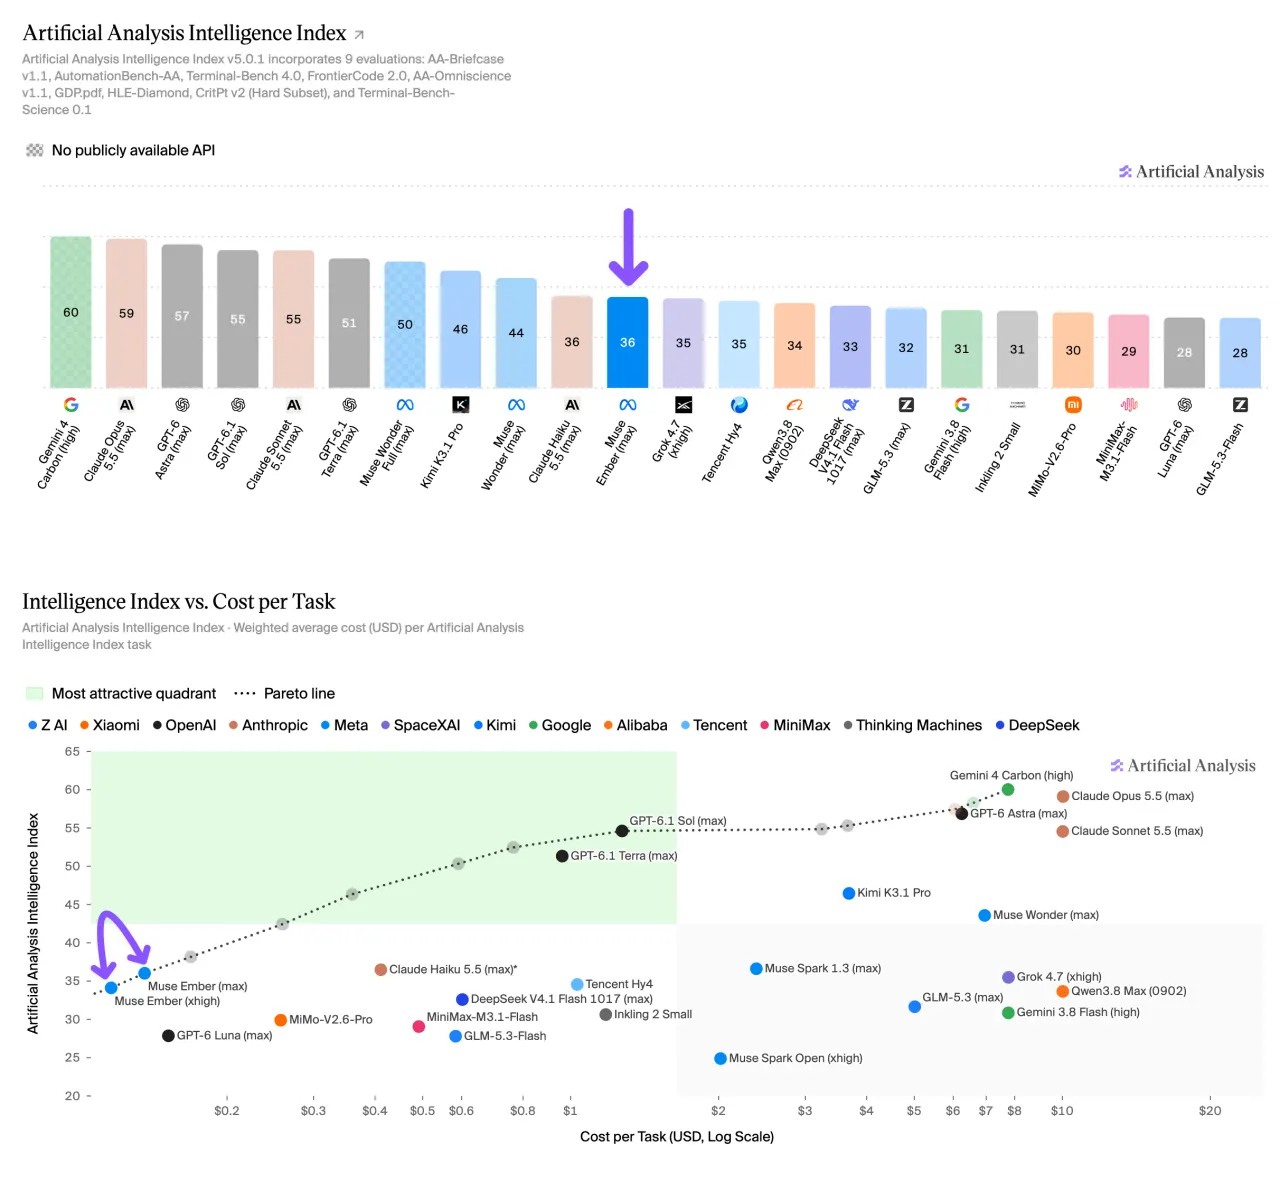
Claude Opus 5.5は1タスク平均 10.04ドル(Claude Sonnet 5.5は 10.02ドル、Claude Haiku 5.5は 0.41ドル)を要したのに対し、MetaのMuse Ember(100万トークンあたり入力 0.10ドル・出力 0.40ドル・キャッシュ入力 0.015ドル)は総合知能指数 36(正確には35.8、Haiku 5.5の35やGPT-6 Lunaの28を上回る)を達成しながら、1タスク平均わずか 0.14ドル(正確には0.136ドル、Opus 5.5の約72分の1、Haiku 5.5の約3分の1)という世界最安コストを記録しました。しかも知識テストAA-Omniscience v1.1におけるハルシネーション率(虚偽回答率)は 17% と全モデル中第2位の低さ(Haiku 5.5は34%、Opus 5.5は50%、GPT-6 Lunaは79%)であり、「知らない問題をハッタリせず棄権して上位モデルへ渡せる」理想的なサブエージェント特性を備えています。
- Artificial Analysis「Intelligence Index v5.0.1」の実測において、上位モデルの
- Claude Fable 5.2 の「20%値下げ・最大30%高速化」と、Opus 5.5 が27%で止まった「30時間形式証明」の100%完遂:
- Anthropicは日常のコーディングや知識労働の標準(default)として
Claude Opus 5.5(入力 4ドル・出力 20ドル)を推奨する一方、長時間自律タスクや極限の技術課題向けにClaude Fable 5.2および検証プログラム認証組織向けのClaude Mythos 5.2を公開し、価格を前世代Fable 5.1(入力10ドル・出力50ドル)から20%値下げして「入力8ドル・出力40ドル」(最大2.5倍速のFast modeは16ドル・80ドル)に設定しました。公式ベンチマーク11項目中10項目でOpus 5.5を逆転(FrontierCode 2.0で 49.1% 対 45.5%、Remote Labor Indexで 41.3% 対 21.3%の約2倍)し、さらにフェルマーの最終定理のLean形式証明では、Opus 5.5が12時間以降 26%〜27% で完全停滞したのに対し、約1,000体のFable 5.2エージェント群は18時間で 86%、30時間で100%完遂に到達しました。
- Anthropicは日常のコーディングや知識労働の標準(default)として
- OpenRouter「Auto Code」が実証した「10回中9回の同一モデル維持」と、Opus 9.0%温存によるコスト74%削減:
- OpenRouterが刷新したコーディング特化ルーター
Auto Code(openrouter/auto-code、ルーティング手数料 0ドル、判定遅延p90は旧世代の1.96秒から 0.65秒 へ約3倍高速化)は、11個のリクエスト要因と価格・健全性・キャッシュ状態を評価します。最大の革新は、毎ターン別モデルに変えてプロンプトキャッシュを壊す愚を避け、**「連続するエージェントターンの約10回中9回で同一モデルを維持し、難所だけを上位へ切り替える」**設計です。24時間のライブルーティング実測(266リクエスト)では、GPT-6.1 Solに 33.8%、DeepSeek V4.1 Flashに 21.4%、Kimi K3.1 Proに 12.8% を配分し、Claude Opus 5.5を全体のわずか 9.0% に温存することで、5つのベンチマーク全体で Opus 5.5 単体と同等のスコアを維持しながら1タスクあたりコストを74%削減(Deep SWEでスコア 74.3%・1.98ドル、SWE-Atlas QAで 62.5%・0.66ドル)しました。
- OpenRouterが刷新したコーディング特化ルーター
読後にすぐ着手できる確認・実装アクション
- 社内のエージェント呼び出しを単一モデル固定から、Tier 3(高頻度サブエージェント:Muse Ember / DeepSeek Flash、約55%)、Tier 2(日常の主力実装:Claude Opus 5.5 / GPT-6.1 Sol、約35%)、**Tier 1(長時間自律完遂・難関監査:Claude Fable 5.2 / Mythos 5.2、10%未満)**の3層へ分離すること
- ルーティング層には「連続ターンの9割で同一モデルを維持してキャッシュ割引を守るスティッキネス(粘着性)」と、タスク難易度に応じた5段階
effort(low/medium/high/xhigh/max)の動的制御を導入すること - コスト74%削減によって急増する並列エージェントのテスト・マイグレーション実行には、MongoDB Atlas Ephemeral Clusters のような「TTL(有効期限)付き自動破棄データベース」を義務づけ、放置クラスタ課金と本番データ汚染を構造的に遮断すること
2. 基礎知識の整理:「パレートフロンティア(Pareto Frontier)」と「ハーネス認識型ルーティング(Harness-Aware Routing)」とは何か
各社のベンチマーク数値とアーキテクチャを詳しく見る前に、今回の3つの一次資料を貫く2つの核心概念を日常の言葉で整理します。
① パレート最適・パレートフロンティア(Pareto Frontier)とモデルの3極化
**パレートフロンティア(効率の最前線)とは、横軸に「1タスクあたりのコスト」、縦軸に「到達できる知能・完遂率」をとったとき、「その価格帯で最も賢い(あるいは、その知能スコアを最も安く達成できる)モデルだけを結んだ境界線」**のことです。この境界線の内側(右下)にあるモデルは、「より安くてより賢い別のモデルが存在する」ため、経済合理性の観点からは選ぶ理由がなくなります。
たとえ話です。企業の物流網を組むとき、近所のコンビニへの書類配達から大陸間の精密機器輸送まで「すべて大型チャーター機」に統一すれば、スピードは出ますが燃料代で会社が倒産します。逆に「すべて電動自転車」に統一すれば、近所の配達は1件数十円で済みますが、30時間かかる長距離輸送は途中で止まってしまいます。物流の世界で「ラストワンマイルの小型便」「都市間の中型トラック」「大陸間の大型輸送機」が明確に分かれているのと同じように、AIエージェントの世界でも以下の3つのパレート最前線が確立されました。
| 階層(Tier) | 代表モデル | 100万トークン価格(入力 / 出力) | 1タスク平均コスト(AA実測等) | 主な守備範囲と特徴 |
|---|---|---|---|---|
| Tier 3:高頻度サブエージェント層 | Meta Muse Ember / DeepSeek V4.1 Flash | $0.10 / $0.40 / (キャッシュ入力 $0.015) | $0.14($0.136) / (知能指数 36) | ツール呼び出し、ファイル走査、情報抽出、一次判定。ハルシネーション率 17% で嘘をつかず上位へ渡せる。 |
| Tier 2:日常の主力実装・知識労働層 | Claude Opus 5.5 / GPT-6.1 Sol | $4.00 / $20.00 / (Opus 5.5 標準) | $1.98(Auto Code Deep SWE) / (Opus単体AAは $10.04) | 日常の大半のコーディング、バグ修正、オフィス文書作成(AA-Briefcase 1800 Elo)。キャッシュ維持で高速・高効率。 |
| Tier 1:長時間自律完遂・極限難題層 | Claude Fable 5.2 / Claude Mythos 5.2 | $8.00 / $40.00 / (Fast mode $16 / $80) | 長時間・高難度タスク特化 / (FrontierCode 2.0 49.1%) |
30時間連続の形式証明(100%完遂)、実機PCB基板設計、長期リモート実務(RLI 41.3%)、脆弱性再発見(89.6%)。 |
私自身、かつて個人の検証環境で、手元の数千本の技術メモやスクリプトの依存関係を整理させるバッチ処理を組んだ際、設定ファイルを書き換えるのが面倒で、ファイル一覧の取得から正規表現の整形、最終的なアーキテクチャ診断まで、すべて一番高価な最上位モデル1本に固定して一晩走らせてしまったことがあります。翌朝ログを見ると、全体の8割以上のトークンが「単なるファイルの中身の転記と定型フォーマット変換」に費やされており、10セント級の軽量モデルなら数十円で終わる作業に数千円分のAPIクレジットを溶かしていました。この失敗から痛感したのは、**「人間にとって設定が楽な『単一モデル統一』は、エージェントが自律ループを回し始めた瞬間に最大のコスト漏洩源になる」**という事実です。
② ハーネス認識型ルーティング(Harness-Aware Routing)とキャッシュ粘着性
**ハーネス(Harness)とは、AIモデル(頭脳)の周りにファイル読み書き、シェル実行、ブラウザ操作、テスト実行などのツール(手足)を接続し、目標達成まで何十ターンもループを回すエージェント実行環境(Claude Code、Codex、Cline、OpenCode など)**のことです。
従来の素朴なモデルルーターは、送られてきたプロンプトの文面だけを見て「短くて簡単そうだからモデルA、長くて難しそうだからモデルB」と毎ターンばらばらに振り分けていました。しかし、コーディング・ハーネスでは毎ターン数万〜数十万トークンのリポジトリ文脈(システムプロンプト+ツール定義+これまでの会話履歴)を引き継ぎます。もし1ターン目をモデルA、2ターン目をモデルB、3ターン目をモデルCと切り替えてしまうと、各プロバイダの「プロンプトキャッシュ(最大90%前後の入力割引とプリフィル高速化)」が毎回リセットされ、全履歴を定価で再課金・再計算することになって、かえってコストも遅延も悪化するのです。
OpenRouterの次世代 Auto Code が導入した「ハーネス認識型ルーティング」は、このキャッシュ破壊問題を根底から解決しました。リクエストの11個の要因に「現在のキャッシュ状態(Cache Status)」と「ハーネスの種類」を組み込み、連続するエージェントターンの約10回中9回(nearly 9/10 agent turns)で同じモデルを維持してキャッシュ割引を最大限に効かせつつ、本当に高度な推論が必要な局面だけを上位モデルへ昇格させます。
3. 第1章:Anthropic「Claude Fable 5.2 / Mythos 5.2」の解剖──20%値下げ・最大30%高速化と30時間完遂力
第1章では、Anthropicが公開した最上位モデル**「Claude Fable 5.2」と「Claude Mythos 5.2」**の仕様・価格・ベンチマーク、およびなぜ長時間エージェントで標準モデル Opus 5.5 との決定的な逆転が起きたのかを一次資料から検証します。
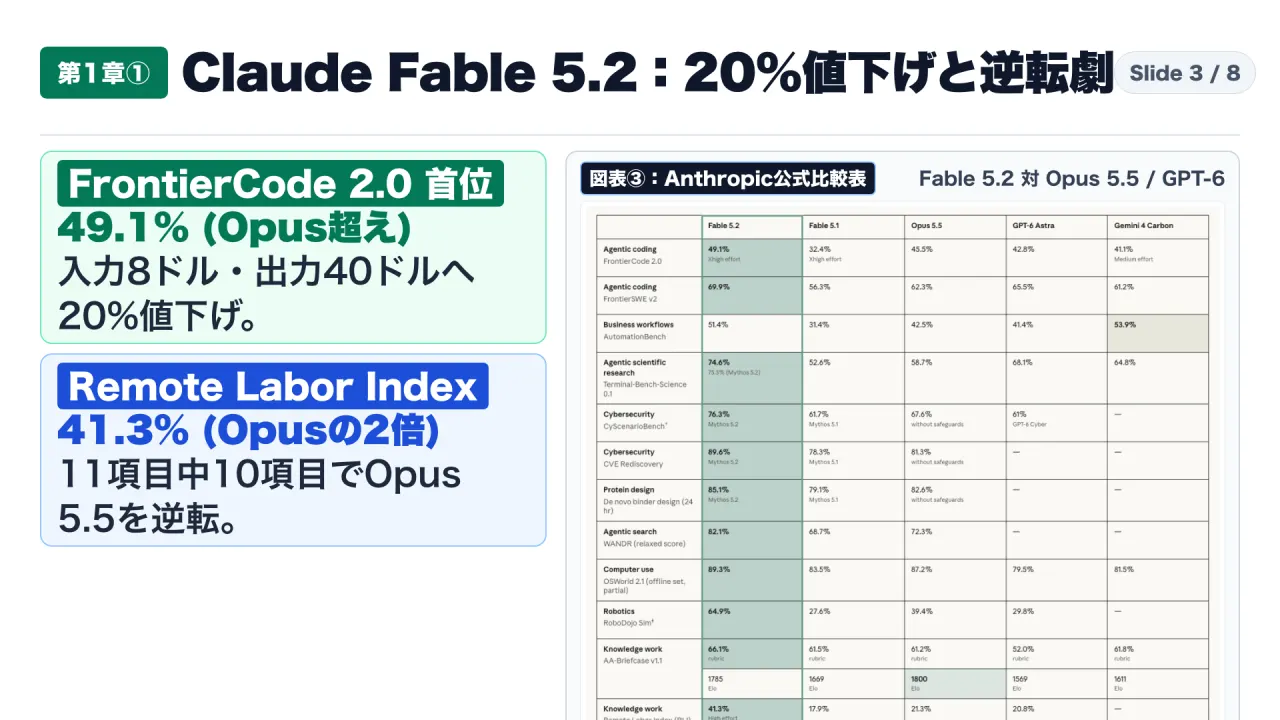
「1つの基盤モデル・2つのアクセス階層」と、Opus 5.5($4/$20)対 Fable 5.2($8/$40)の明確な棲み分け
Anthropicの公式発表および技術仕様(MLQ.ai、Fello AI、CellCogの検証記録を含む)によると、Claude Fable 5.2(API識別子:claude-fable-5-2)と Claude Mythos 5.2(claude-mythos-5-2)は同一の基盤モデルであり、安全ガードレールの構成と提供対象のみが異なります。
| モデル名 / モード | 100万トークン価格 / (入力 / 出力) | コンテキスト長 / 最大出力 | 前世代比の速度・価格変化 | アクセス対象と推奨ユースケース |
|---|---|---|---|---|
| Claude Fable 5.2 / (標準モード) | $8 / $40 | 1M(100万) / 128K | Fable 5.1($10/$50)から20%値下げ・出力速度最大30%高速化 |
一般公開(API、有料Claudeプラン、Google Cloud、Microsoft Foundry、AWS上のClaude Platform)。長時間自律タスク・高度工学・数学・ロボティクス。 |
| Claude Fable 5.2 / (Fast mode) | $16 / $80 | 1M(100万) / 128K | 標準モード比で出力生成速度が最大2.5倍高速 | Claude Code 等での対話的な超高速・高難度デバッグおよび緊急対応。 |
| Claude Mythos 5.2 | $8 / $40 | 1M(100万) / 128K | Fable 5.2 と同一仕様・同一価格・最大30%高速化 |
Cyber / Life Sciences Verification Program 認証組織および Claude Enterprise(Claude Security)限定。脆弱性発見・バイオ設計。 |
| Claude Opus 5.5 / (比較:日常標準機) | $4 / $20 | 1M(100万) / 128K | Fable 5.2 の半額(50%の価格) |
Anthropicが推奨する日常業務・一般コーディングのデフォルトモデル(Amazon Bedrock でも利用可能)。 |
| Claude Fable 5.1 / (比較:前世代機) | $10 / $50 | レガシー | 旧世代 | Opus 5.5 に11項目中10項目で逆転されていた旧上位モデル。 |
ここで注目すべきは、7週間前に公開された Claude Opus 5.5(入力4ドル・出力20ドル)が、前世代 Fable 5.1(入力10ドル・出力50ドル)の40%の価格でありながら一般ベンチマーク11項目中10項目で Fable 5.1 を上回っていたという経緯です。今回の Fable 5.2 は、価格を20%引き下げて8ドル・40ドルにしつつ、その11項目のうち10項目で再び Opus 5.5 を抜き返しました。
Anthropicの研究プロダクトマネジメント責任者 Dianne Penn氏(Head of Product Management for Research)はCNBCの取材に対し、**「Fable 5.2 は高度なエンジニアリング、数学、ロボティクスの難題(hard engineering, mathematics and robotics problems)を標的としている」と明言し、同社の開発方針について「一時停止ではなくペース配分を呼びかけたのだ(called for pacing, not pausing)」と語っています。またAnthropicの公式ドキュメントでも、「大半の日常業務には引き続き Claude Opus 5.5 をデフォルトとして推奨し、Opus 5.5 の高エフォート設定でも届かない長時間自律タスク(long-horizon agentic tasks)に Fable 5.2 を使うべきである」**と明確な2段階の使い分けを提示しています。
公式ベンチマーク全14項目の完全比較と、Effort(思考予算)5段階の費用対効果
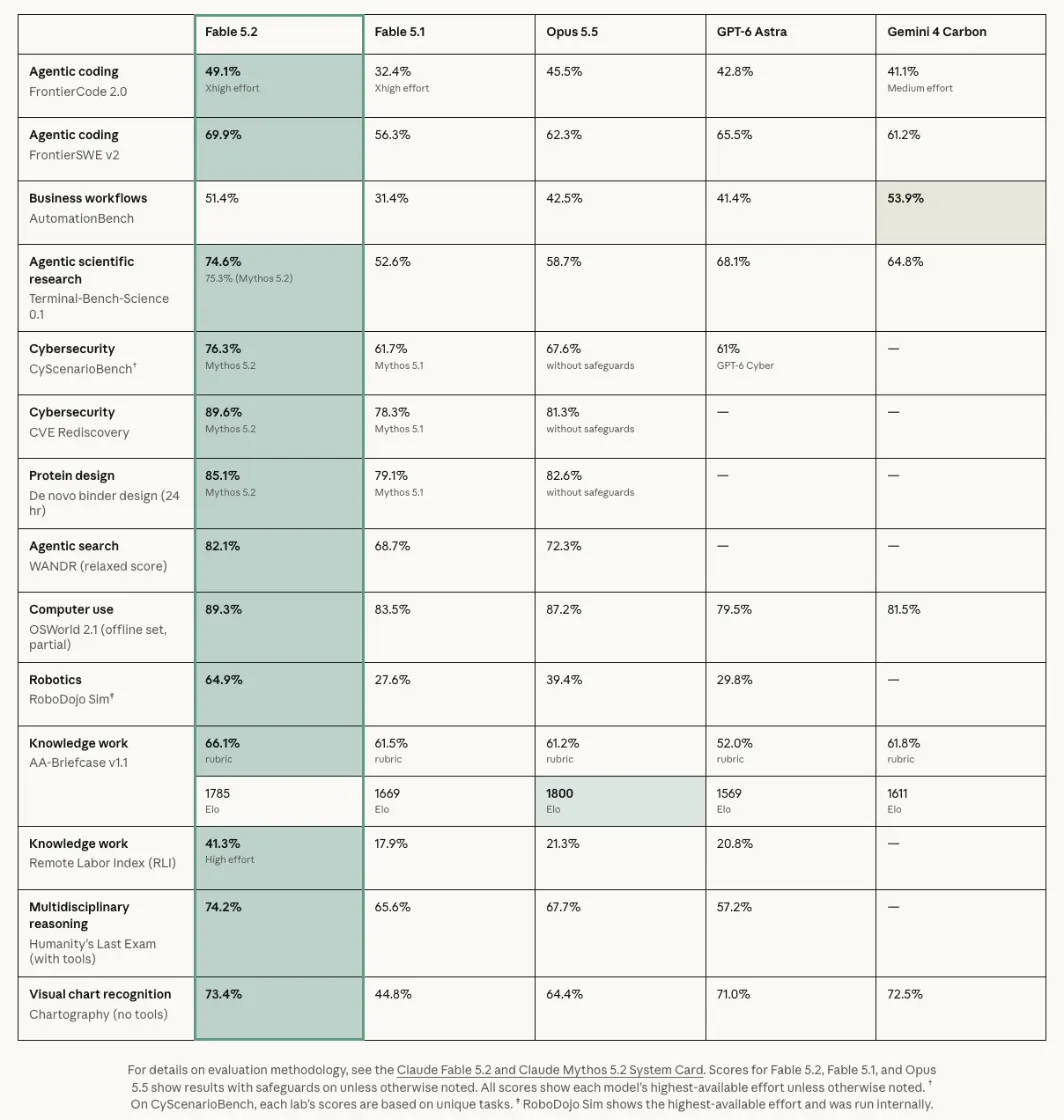
公式ベンチマーク表(fable52_benchmarks.png)に記録された全14項目のスコアを一覧化すると、Fable 5.2 / Mythos 5.2 がどの領域で突出しているかが一目で分かります。
| 評価領域 | ベンチマーク名 | Claude Fable 5.2 | Claude Fable 5.1 | Claude Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| Agentic coding | FrontierCode 2.0 | 49.1% (Xhigh) | 32.4% (Xhigh) | 45.5% | 42.8% | 41.1% (Medium) |
| Agentic coding | FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Business workflows | AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Scientific research | Terminal-Bench-Science 0.1 | 74.6% (75.3% Mythos 5.2) | 52.6% | 58.7% | 68.1% | 64.8% |
| Cybersecurity | CyScenarioBench | 76.3% (Mythos 5.2) | 61.7% (Mythos 5.1) | 67.6% (no safeguards) | 61% (GPT-6 Cyber) | — |
| Cybersecurity | CVE Rediscovery | 89.6% (Mythos 5.2) | 78.3% (Mythos 5.1) | 81.3% (no safeguards) | — | — |
| Protein design | De novo binder design (24 hr) | 85.1% (Mythos 5.2) | 79.1% (Mythos 5.1) | 82.6% (no safeguards) | — | — |
| Agentic search | WANDR (relaxed score) | 82.1% | 68.7% | 72.3% | — | — |
| Computer use | OSWorld 2.1 (offline, partial) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| Robotics | RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | — |
| Knowledge work | AA-Briefcase v1.1 (rubric / Elo) | 66.1% (1785 Elo) | 61.5% (1669 Elo) | 61.2% (1800 Elo) | 52.0% (1569 Elo) | 61.8% (1611 Elo) |
| Knowledge work | Remote Labor Index (RLI) | 41.3% (High effort) | 17.9% | 21.3% | 20.8% | — |
| Multidisciplinary | Humanity’s Last Exam (w/ tools) | 74.2% | 65.6% | 67.7% | 57.2% | — |
| Visual chart | Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
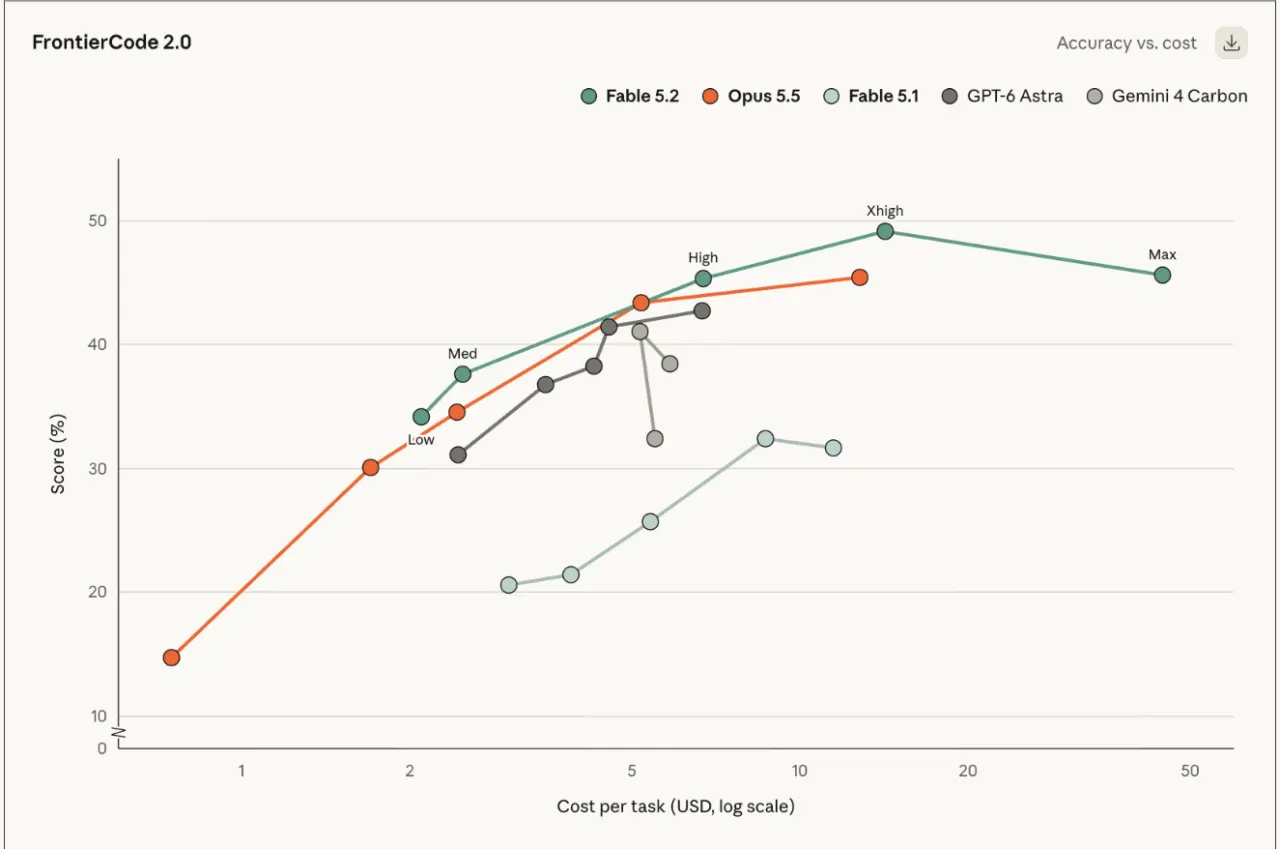
とりわけ実務上のインパクトが大きいのが、リモート労働の長期完遂力を測る Remote Labor Index(RLI) において、Opus 5.5(21.3%)や GPT-6 Astra(20.8%)が2割前後で頭打ちになる中、Fable 5.2 が 41.3% と約2倍のスコアを達成している点です。また、思考予算(effort:Low / Med / High / Xhigh / Max)ごとの FrontierCode 2.0 の精度対コスト曲線(下図 fable52_frontiercode.png)を見ると、Fable 5.2 はすべてのコスト帯で Fable 5.1 の曲線を大きく上方にシフトさせています。
フェルマーの最終定理「30時間形式証明」で100%完遂(Opus 5.5 は27%で停滞)と実機プリント基板(PCB)設計
なぜ日常の短時間タスクでは優秀な Opus 5.5 だけでは不十分で、Tier 1 として Fable 5.2 が必要なのか。その決定的な証拠が、数学の難問**「フェルマーの最終定理(Fermat’s Last Theorem)」の証明をLean形式言語で書き起こす30時間連続の自律エージェント実験**です。
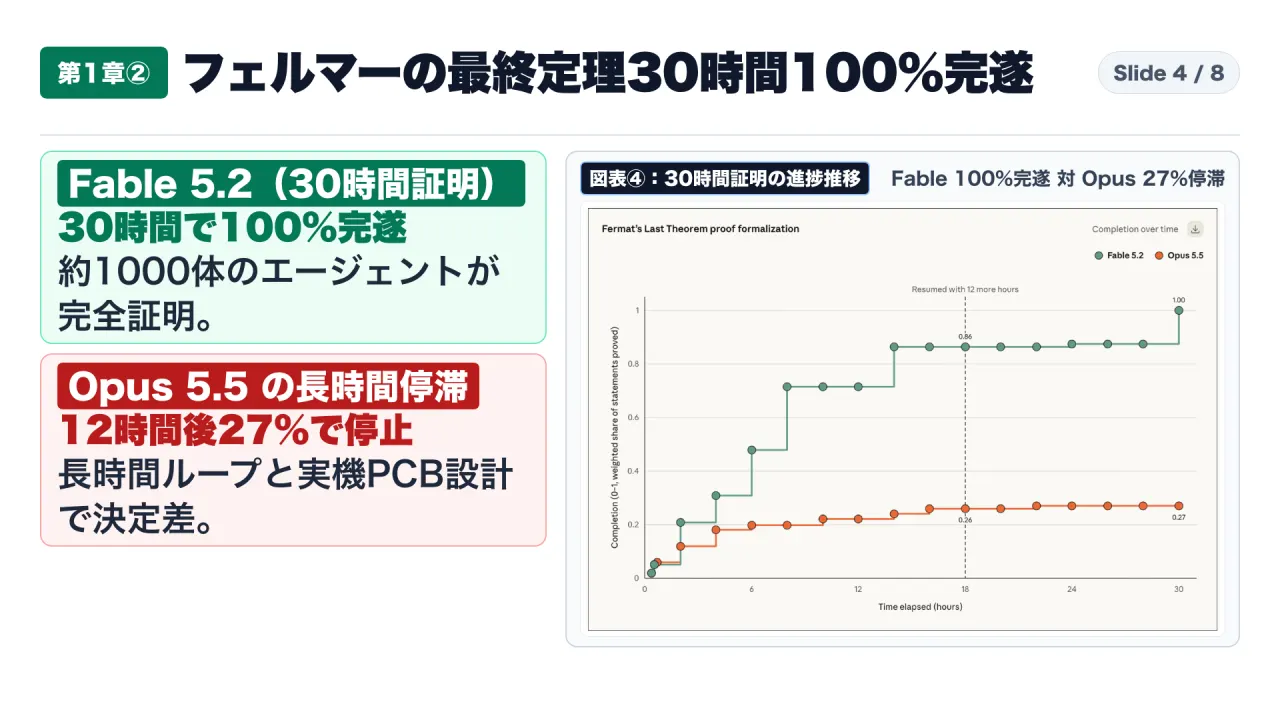
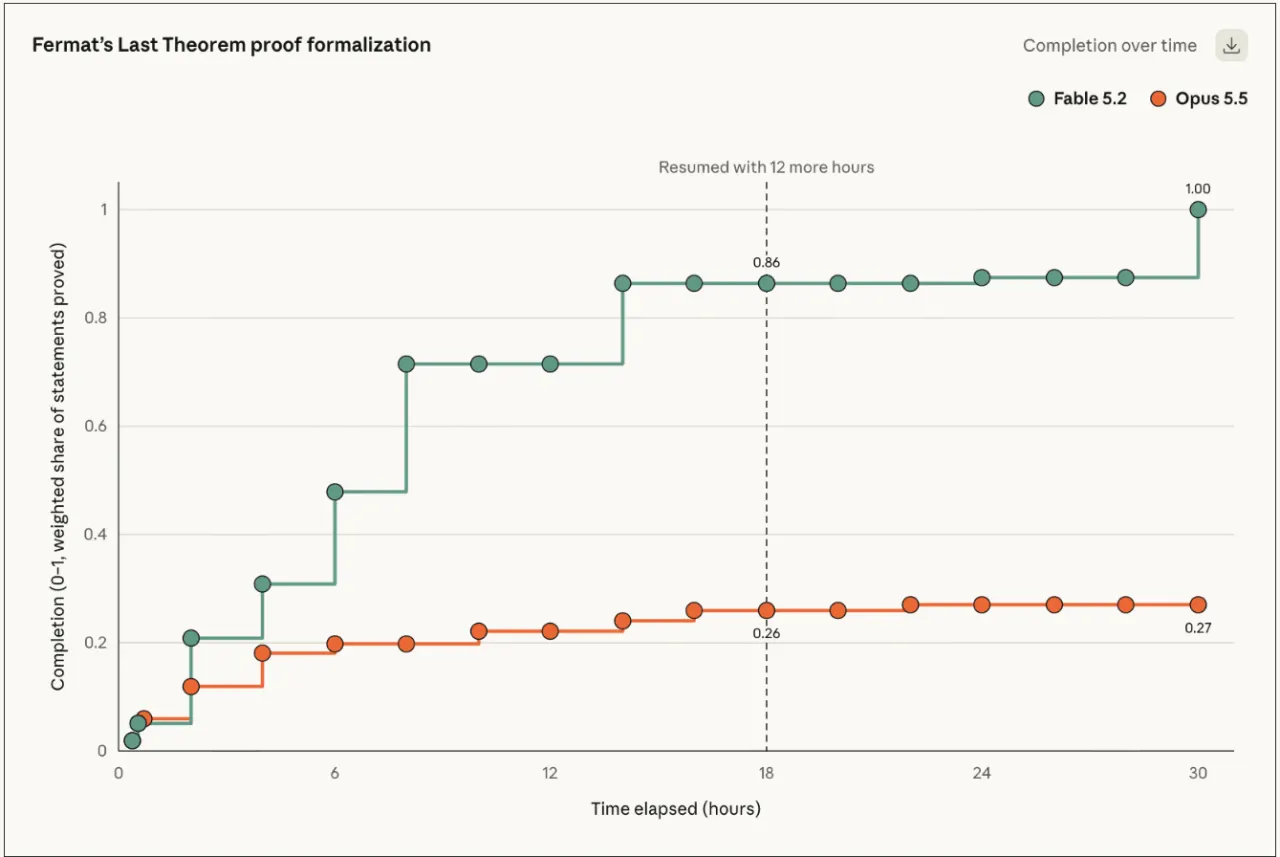
約1,000体のエージェントが協調して形式証明を進めたこの実験において、時間経過(6時間・12時間・18時間・24時間・30時間)に伴う証明完遂率(Proof completion)は以下のように推移しました。
- 開始6時間時点:
Opus 5.5が 0.17(17%)、Fable 5.2が 0.15(15%) と、序盤の立ち上がりはほぼ互角(むしろOpus 5.5がわずかに先行)。 - 開始12時間時点:
Opus 5.5が 0.26(26%)、Fable 5.2が 0.25(25%) と並走。 - 開始18時間〜24時間時点:
Opus 5.5は 0.26(26%) のまま完全に壁にぶつかり進捗がゼロになった一方、Fable 5.2は18時間時点で一気に 0.86(86%) へとブレイクスルーを達成。 - 開始30時間時点:
Opus 5.5が 0.27(27%) で終わったのに対し、Fable 5.2は 1.00(100%完遂) に到達。
さらにAnthropicの研究レポート『Evaluating Claude on Electronics Design』では、デジタル回路の Verilog RTL設計、アナログ回路の SPICEシミュレーション、および KiCadを用いたプリント基板(PCB)レイアウトの3領域でハードウェア設計能力を検証しています。旧世代モデルでは長時間の手戻りループで破綻していた複雑な電子回路設計において、Fable 5.2 は回路図作成、部品選定、自動配線、ファームウェア統合、そして工場へそのまま製造発注できるガーバーデータ(Gerber)の出力までを一気通貫で完遂し、実機基板として正常動作させることに成功しました。
4. 第2章:Meta「Muse Ember」の衝撃──1タスク0.14ドル・ハルシネーション率17%が変える大量処理層(Tier 3)
第2章では、エージェントが1日中繰り返す高頻度サブタスク(ツール呼び出し、コード検索、データ抽出、長文解析)のために Meta AI Research が投入した最小・最高効率モデル**「Muse Ember」**の一次データを解剖します。
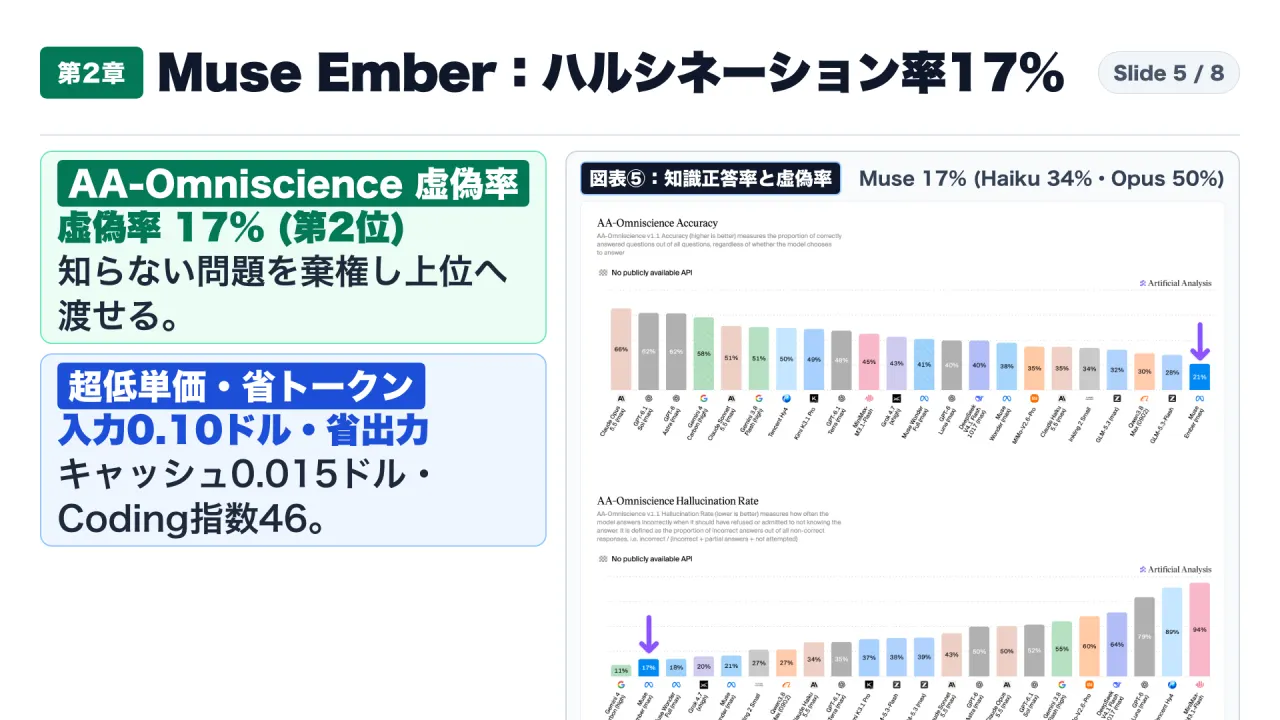
入力0.10ドル・キャッシュ0.015ドル、1タスク「0.14ドル」でHaiku 5.5の3分の1・Opus 5.5の72分の1
Meta公式発表(meta_muse_ember.html)および Artificial Analysis の独立検証レポート(aa_muse_ember.html)で確認された Muse Ember と主要競合モデルの価格・性能・トークン消費量の比較は以下のとおりです。
| モデル名(評価設定) | 100万トークン単価 / (入力 / 出力 / キャッシュ入力) | AA知能指数 / (v5.0.1) | 1タスク平均コスト / (AA実測) | 1タスク平均出力トークン数 / (回答+推論) | AA-Omniscience / 正答率 / 虚偽(Hallucination)率 | Coding Agent Index v2.0 |
|---|---|---|---|---|---|---|
| Meta Muse Ember (max) | $0.10 / $0.40 / $0.015 | 36(35.8) | $0.14($0.136) | 84k(回答32k+推論52k) | 21% / 17%(全モデル2位) | 46(Muse Code) |
| Claude Haiku 5.5 (max) | $1.00 / $5.00 / $0.10 | 35(36.2※) | $0.41($0.411) | 226k(回答53k+推論173k) | 35% / 34% | 37(Claude Code) |
| GPT-6 Luna (max) | 低価格帯 | 28(27.8) | $0.15($0.152) | 75k(回答58k+推論18k) | 40% / 79% | 31(Codex) |
| Meta Muse Wonder (max) | 上位モデル | 高知能帯 | $6.95 | 96k(回答59k+推論37k) | 38% / 21% | 52(Muse Code) |
| Claude Sonnet 5.5 (max) | 中上位モデル | 高知能帯 | $10.02 | 285k(回答206k+推論79k) | 51% / 43% | 59(Claude Code) |
| Claude Opus 5.5 (max) | $4.00 / $20.00 | 最高峰帯 | $10.04 | 173k(回答120k+推論53k) | 66% / 50% | 62(首位) |
※注:Claude Haiku 5.5 の知能指数は Artificial Analysis 記事見出しおよび総合比較では 35、Meta公式ブログ内の生データプロット点(max設定)では 36.2(コスト $0.411)と記録されています。いずれの基準でも、Muse Ember($0.136、xhigh設定では $0.116・スコア 33.9)は Haiku 5.5 の約3分の1のコストで同等の知能指数に到達しています。
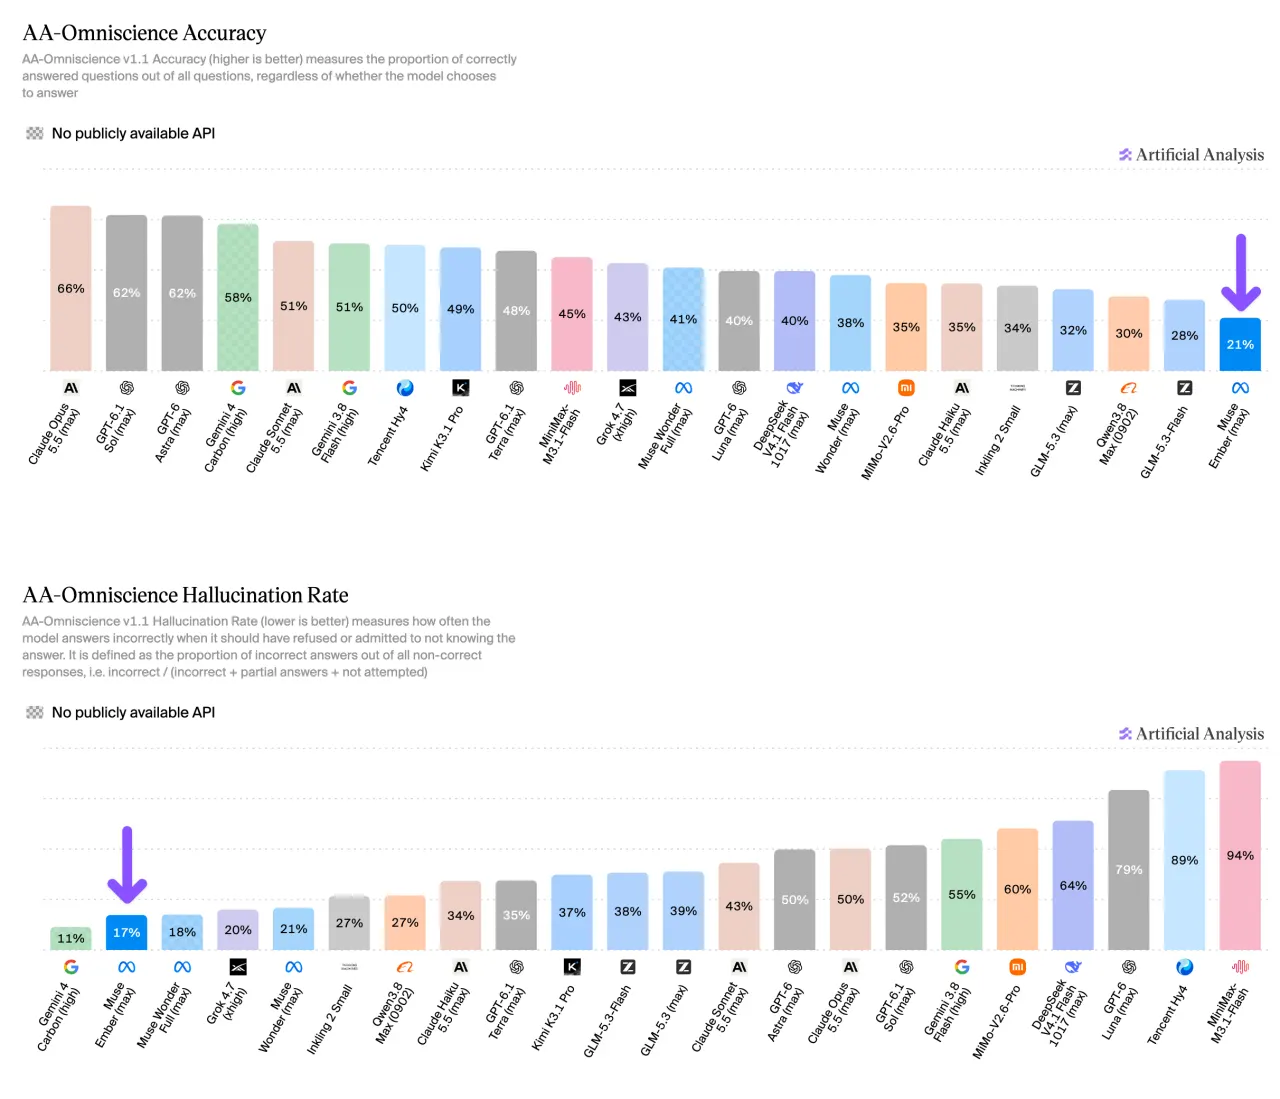
なぜ Muse Ember は1タスクわずか0.14ドルで済むのでしょうか。理由は単価の安さだけではありません。上の表および図表1(aa_muse_fig2_intelligence_index.png 下段)が示すとおり、Claude Haiku 5.5 が1タスクあたり平均 226,000トークン(うち推論に173,000トークン)、Sonnet 5.5 が 285,000トークンを大量消費しているのに対し、Muse Ember は回答32,000トークン+推論52,000トークンの**合計84,000トークン(Haikuの約37%)**で簡潔にタスクを完了させているからです。出力速度もMeta公式発表のピーク値で 155 tok/s(標準APIで約97 tok/s、Artificial Analysis実測中央値で 77 tok/s)と高速です。
なぜ「ハルシネーション率17%」がサブエージェントの絶対条件なのか
さらに実務のアーキテクトが注目すべきは、図表6(aa_muse_fig5_speed_vs_intelligence.png)に示された **AA-Omniscience v1.1 のハルシネーション率(Hallucination Rate:分からないのに間違った答えを言い切る割合)**です。
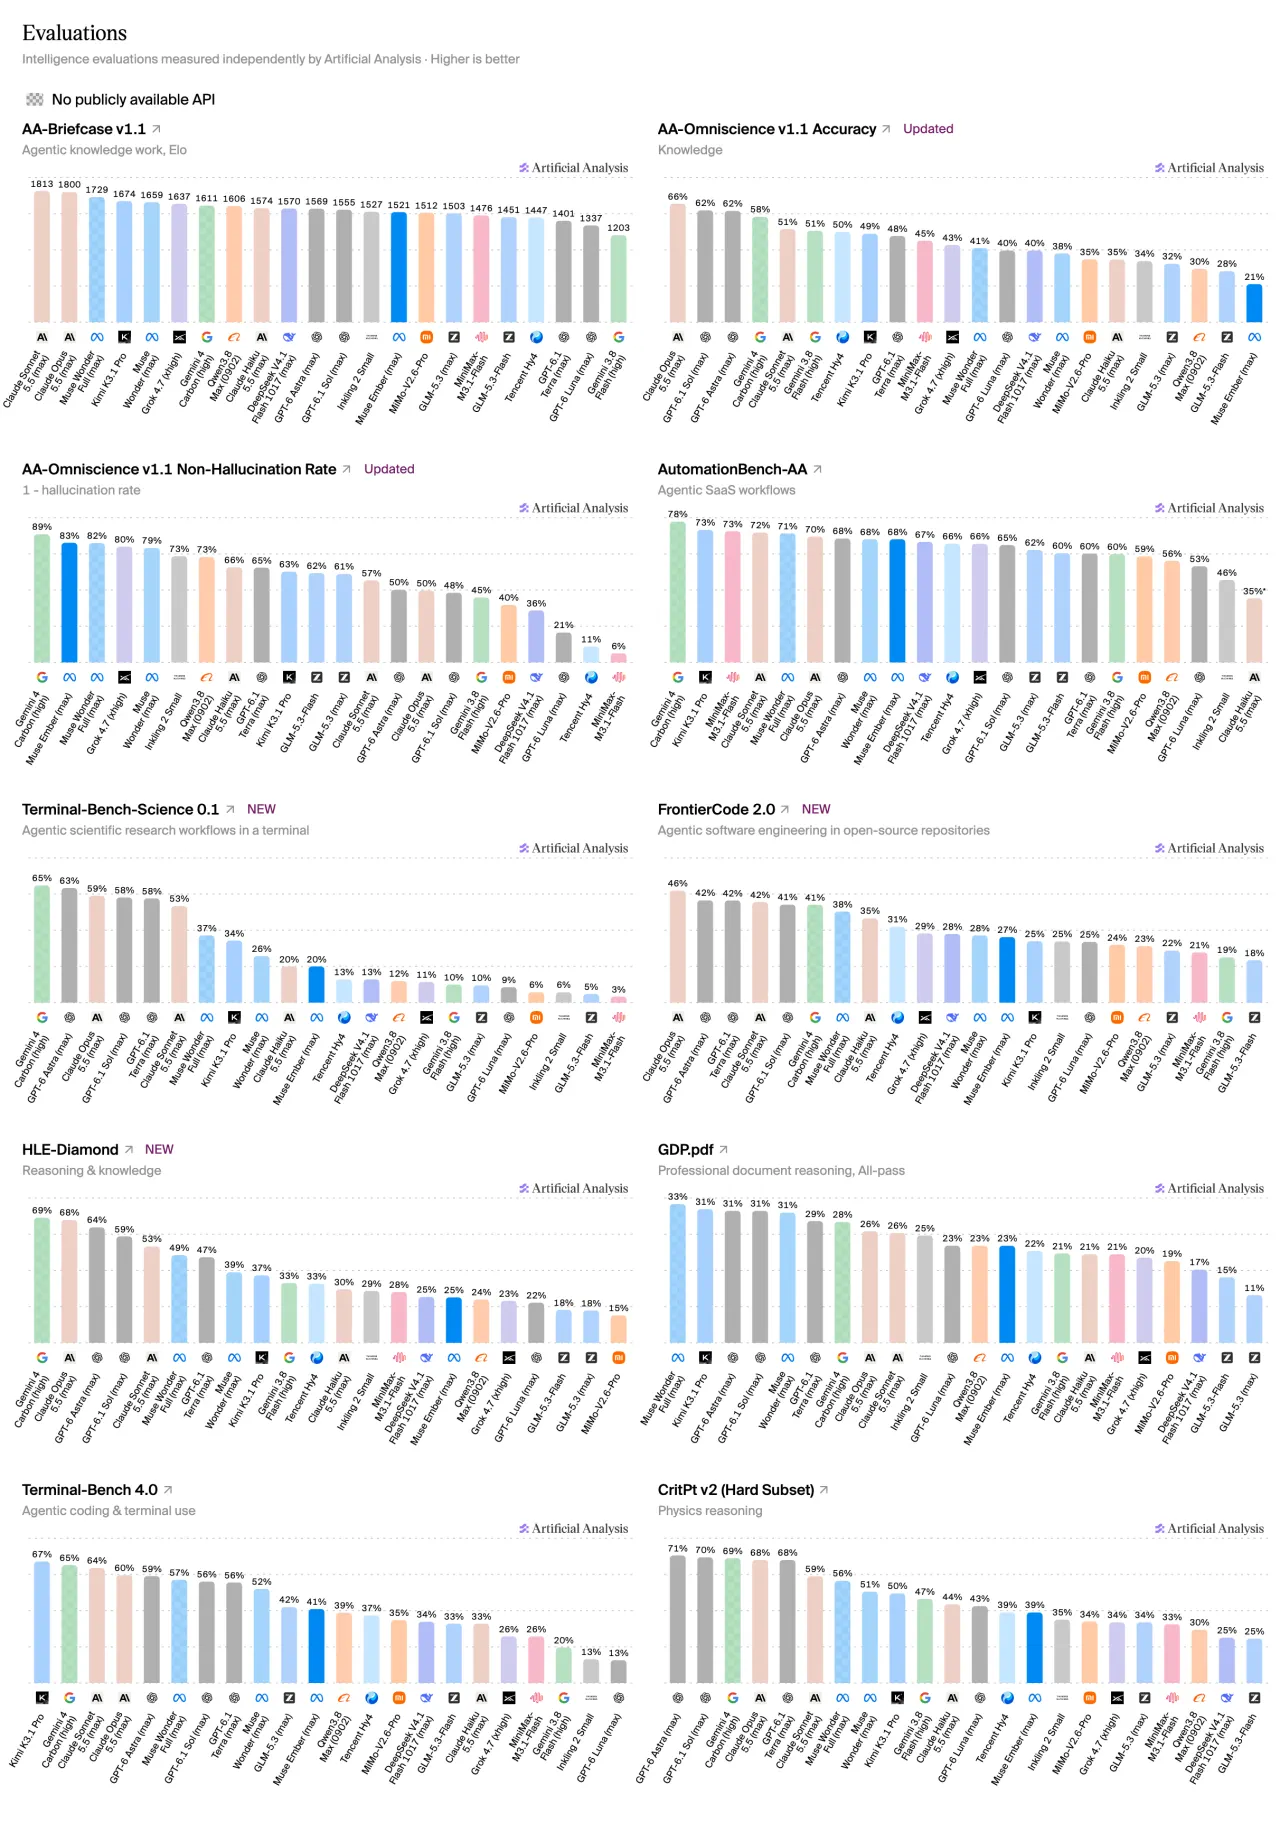
小型モデルである Muse Ember は、専門知識の暗記量を問う単純正答率(Accuracy)では 21%(Opus 5.5 は66%、Haiku 5.5 は35%)にとどまります。ところが、知らない問題に直面したときのハルシネーション率はわずか 17% であり、これは全モデル中で Gemini 4 Carbon(11%)に次ぐ世界第2位の低さです。同じ小型クラスの GPT-6 Luna が 79%、MiniMax-M3.1-Flash が 94%、Claude Haiku 5.5 が 34%、そして最上位の Claude Opus 5.5 ですら 50% の確率で誤答を言い切ってしまうのと比較すると、Muse Ember の「知らないことは知らないと認めて棄権する誠実さ」は際立っています。
コーディングエージェント「Cline」の創業者 Saoud Rizwan氏 は、Meta公式ブログの中で次のようにコメントしています。
- 発言者・出典: Saoud Rizwan氏(Founder, Cline)、Meta AI Research『Introducing Our Smallest, Most Efficient Model: Muse Ember』(2026年11月9日公開)
- 原文: “It’s incredible seeing Meta release a lightweight model for developers who want a fast, low-cost model they can rely on, and for teams cutting costs by running it as the subagent in their harness. Muse Ember is purpose-built for, and excels at, subagent work like coding and document analysis.”
- 和訳: 「信頼できる高速・低コストなモデルを求める開発者や、ハーネス内のサブエージェントとして走らせることでコストを削減しているチームに向けて、Metaが軽量モデルを公開したのは素晴らしいことです。Muse Emberはコーディングや文書解析といったサブエージェント業務のために特化して作られており、卓越した性能を発揮します。」
また、Box の VP of AI Products である Yashodha Bhavnani氏 も「企業コンテンツ上で実務を行うエージェントの高速・高効率な基盤である」と評価し、Oracle の SVP Konstantinos Papamiltiadis氏 も「初期テストで最大30%高速に動作した」と報告しています。
コーディング・業務自動化ベンチマークの実測値と「AutomationBench-AA」の定義差
Artificial Analysis が独立計測したコーディングおよびエージェント系ベンチマークの図表(下図 aa_muse_fig3_token_usage_cost.png および aa_muse_fig4_pricing_table.png)でも、Muse Ember の実務耐性が確認できます。
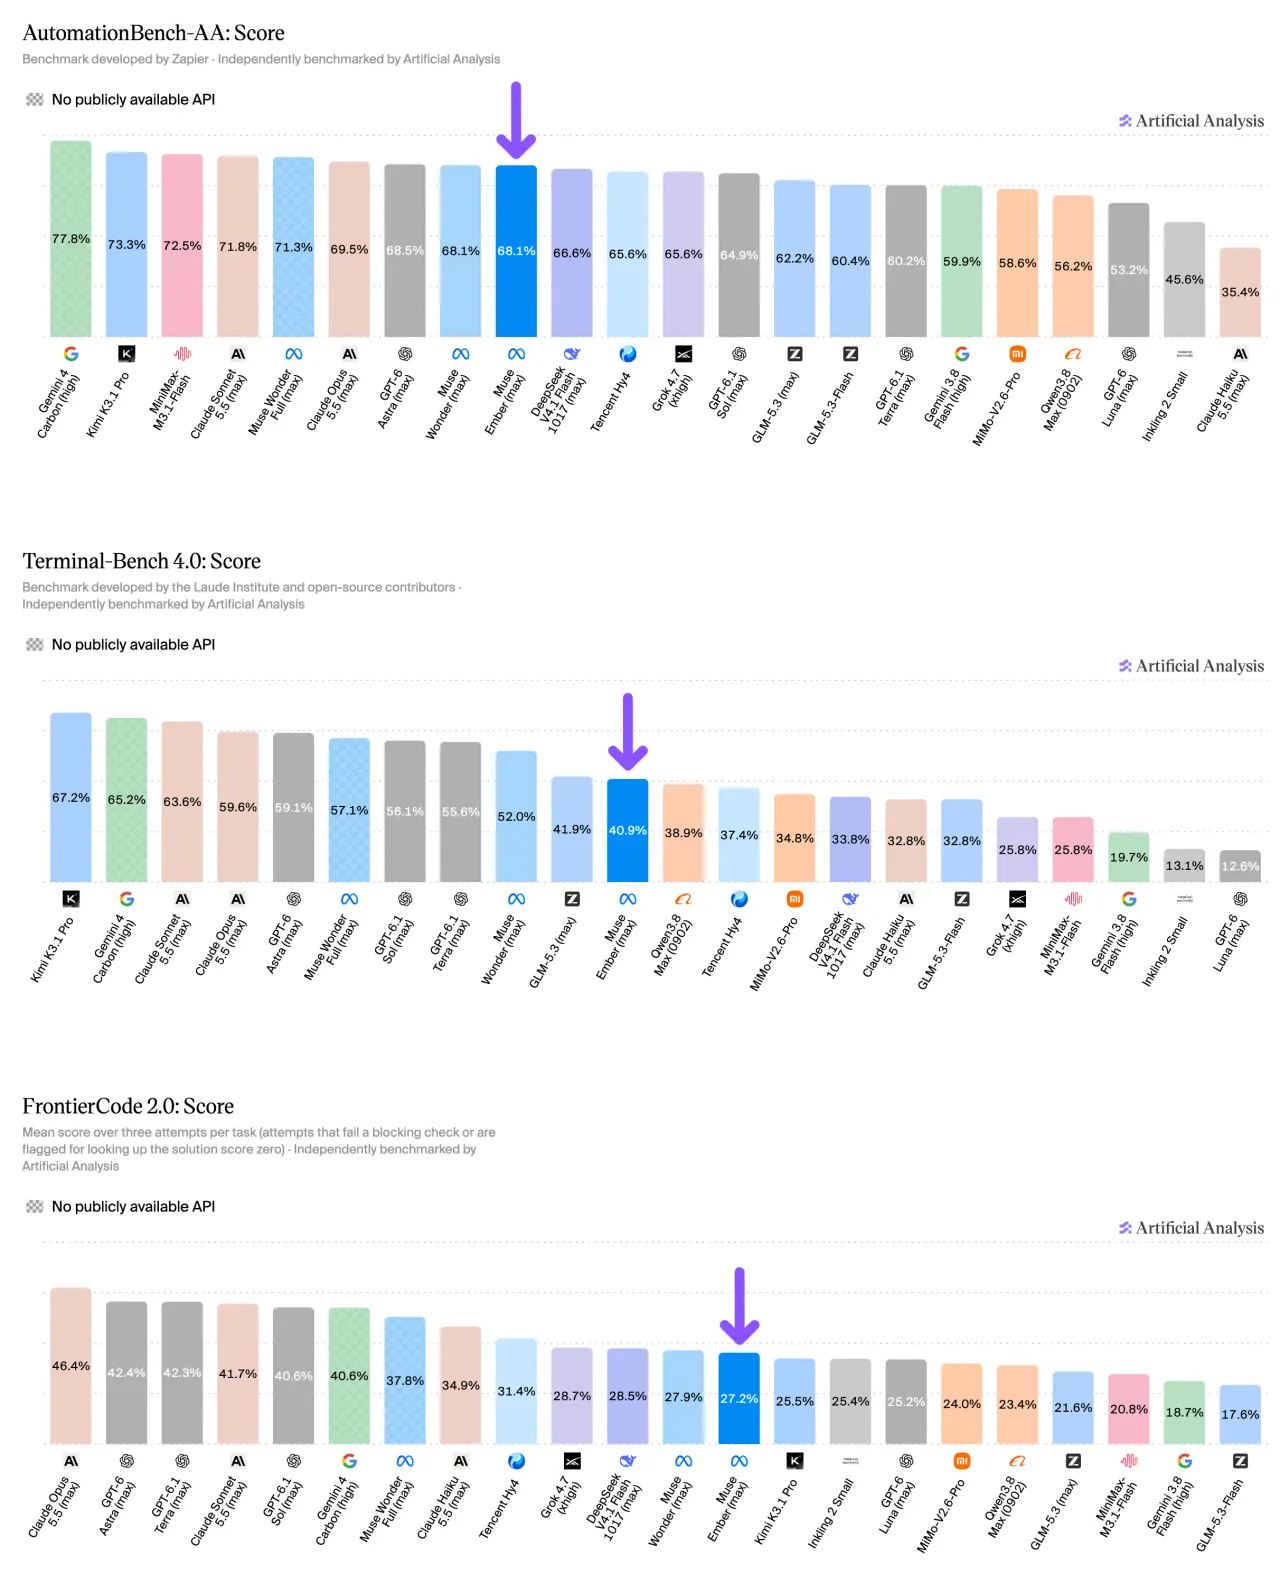
- Artificial Analysis Coding Agent Index v2.0(
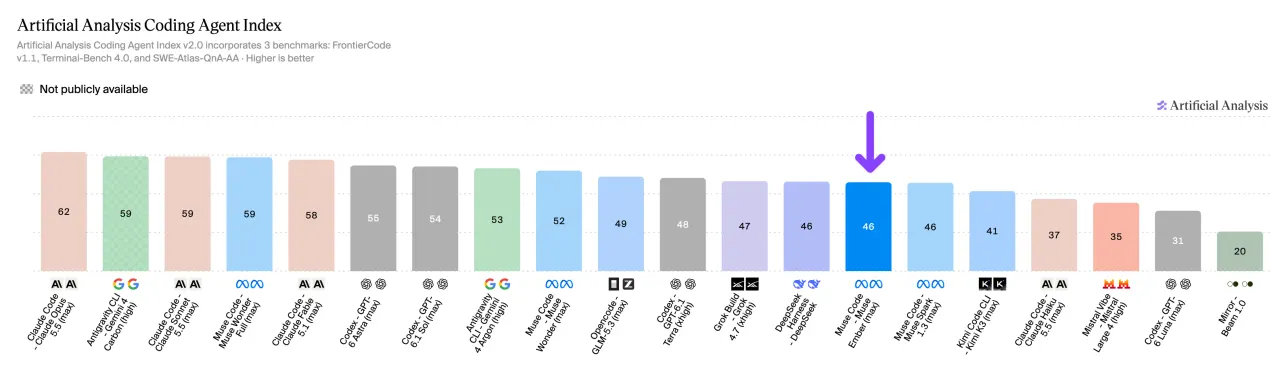
FrontierCode v1.1、Terminal-Bench 4.0、SWE-Atlas-QnA-AAの3指標統合):Muse Code - Muse Ember (max)はスコア 46 を記録し、Claude Code - Claude Haiku 5.5 (max)の 37 やCodex - GPT-6 Luna (max)の 31 を大きく引き離しました(総合首位はClaude Opus 5.5の 62、Claude Fable 5.1は 58)。 - Terminal-Bench 4.0:
Muse Emberは 40.9% を記録し、Claude Haiku 5.5(32.8%)やGPT-6 Luna(12.6%)を上回りました(この数値はMeta公式ブログの表とも完全一致しています)。 - FrontierCode 2.0:
Muse Emberは 27.2%(Haiku 5.5は34.9%、Opus 5.5は46.4%)。 - 【重要】AutomationBench-AA における数値差の検証:Zapierが開発しArtificial Analysisが計測する業務自動化ベンチマーク
AutomationBench-AAについて、Artificial Analysisの独立検証チャート(図表7上段)ではMuse Emberが 68.1%(Haiku 5.5は35.4%、GPT-6 Lunaは53.2%)と報告されている一方、Meta公式ブログ内の比較表ではMuse Ember37.8%(GPT-6 Luna20.6%)と記載されています。これは評価ハーネスまたは対象サブセットのバージョン差によるものですが、いずれの評価基準においても同クラスの小型モデル(Haiku 5.5やGPT-6 Luna)に対して約1.3倍〜1.9倍の優位性を示しています。
5. 第3章:OpenRouter「Auto Code」の証明──Opusを9.0%に温存し、10回中9回モデルを維持してコスト74%削減
第3章では、Tier 3 の超低価格モデルから Tier 1 の最上位モデルまでを1つのエージェント内でどう自動切り替えするのか、OpenRouter が公開した次世代**「Auto Router(openrouter/auto)」およびコーディング特化型「Auto Code(openrouter/auto-code)」**の内部機構とベンチマーク結果を検証します。
ルーティング手数料0ドル・p90遅延0.65秒・11因子判定と「10回中9回の同一モデル維持」
OpenRouterの公式発表(openrouter_auto_code.html)および AICoder の検証記事(aicoder_auto_code.html)によると、同社の Auto Router は毎月10万人以上の開発者から 2.5兆(2.5T)トークン以上 のリクエストを処理しています。過去3年間の運用知見をもとにゼロから再設計された今回の次世代版には、以下の4つの技術的特徴があります。
- ルーティング追加手数料は完全無料($0):
modelパラメータにopenrouter/autoまたはopenrouter/auto-codeを指定するだけで利用でき、支払うのは実際に選択された下流モデルの定価トークン料金のみです(BYOK:自社APIキー持ち込みやゼロデータ保持ポリシー、許可モデルリスト制限にも対応)。
- 11因子のリクエスト解析とルーティング遅延3倍高速化(1.96秒 → 0.65秒):
- 旧世代のルーターはタスク種別など少数の粗いシグナルだけで判定していましたが、新世代は**11個のリクエスト要因(タスク種別、難易度、要求精度、大型モデルの追加恩恵、希望応答長、速度優先度、コードベース統合度、視覚品質など)**に、リアルタイムの価格・プロバイダ稼働状態・キャッシュ状態を掛け合わせて判定します。しかもルーティングステップ自体の90パーセンタイル(p90)遅延は、旧世代の
1.96秒から0.65秒へと約3倍高速化されました。
- 旧世代のルーターはタスク種別など少数の粗いシグナルだけで判定していましたが、新世代は**11個のリクエスト要因(タスク種別、難易度、要求精度、大型モデルの追加恩恵、希望応答長、速度優先度、コードベース統合度、視覚品質など)**に、リアルタイムの価格・プロバイダ稼働状態・キャッシュ状態を掛け合わせて判定します。しかもルーティングステップ自体の90パーセンタイル(p90)遅延は、旧世代の
- プロンプトキャッシュを守る「10ターン中9ターンの同一モデル維持」:
- エージェント・ハーネス(Claude Code、Codex、OpenCode等)での最大の不満だった「毎ターンモデルが変わってキャッシュが切れる問題」を防ぐため、ベータ運用においてエージェントの連続ターンの約10回中9回(nearly 9/10 agent turns)で同一モデルを維持し、タスクの性質や難易度が大きく変化したターンだけモデルを切り替える設計が採用されました。
- Routing Insights パネルによる判断根拠の完全可視化:
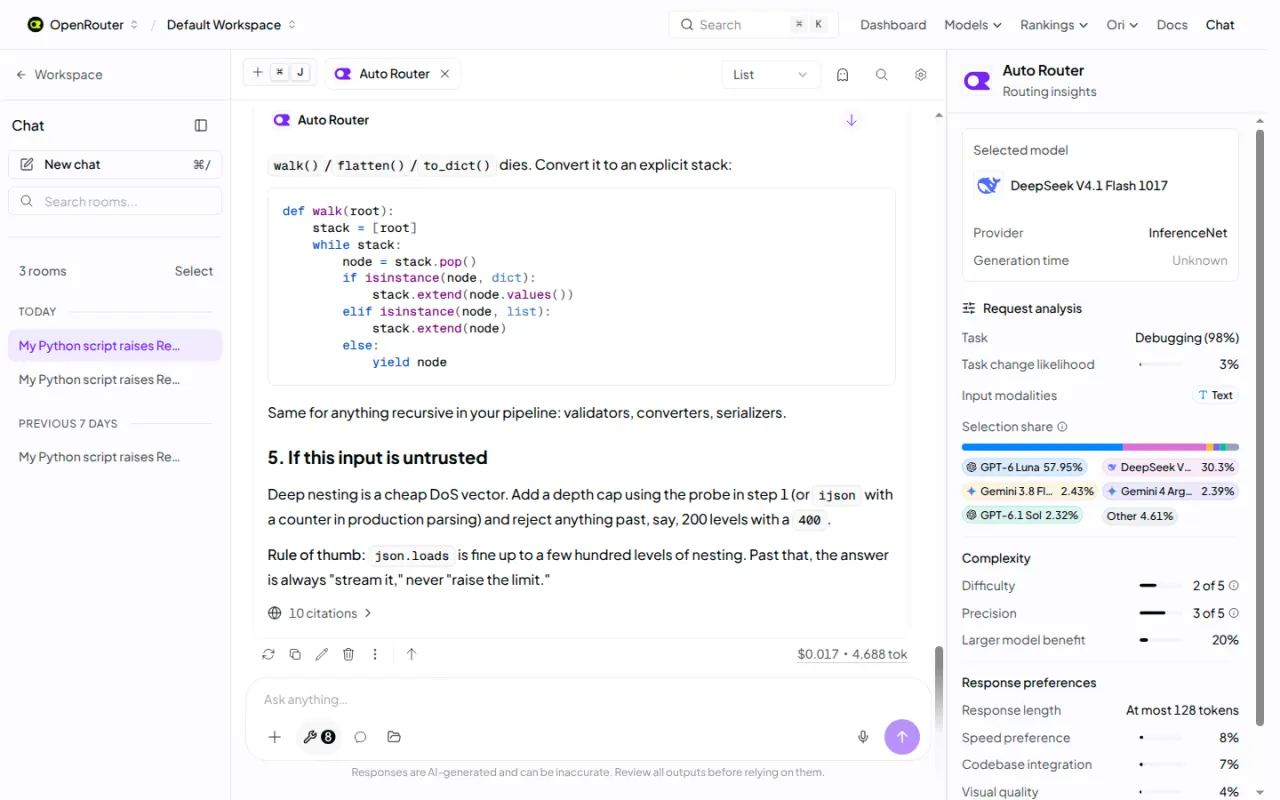
- 下図(
openrouter_fig3_chat_routing.png)のとおり、たとえばPythonの再帰関数(walk()/flatten())のスタックオーバーフローをループへ書き換えるデバッグ質問では、ルーターがTask: Debugging (98%)、Task change likelihood: 3%、Difficulty: 2 of 5、Precision: 3 of 5、Larger model benefit: 20%とリアルタイム採点し、DeepSeek V4.1 Flash 1017(4,688トークン・わずか $0.017)を選択した理由を明示します。
- 下図(
5大ベンチマークで「Claude Opus 5.5 と同等の精度・コスト74%削減」を実証
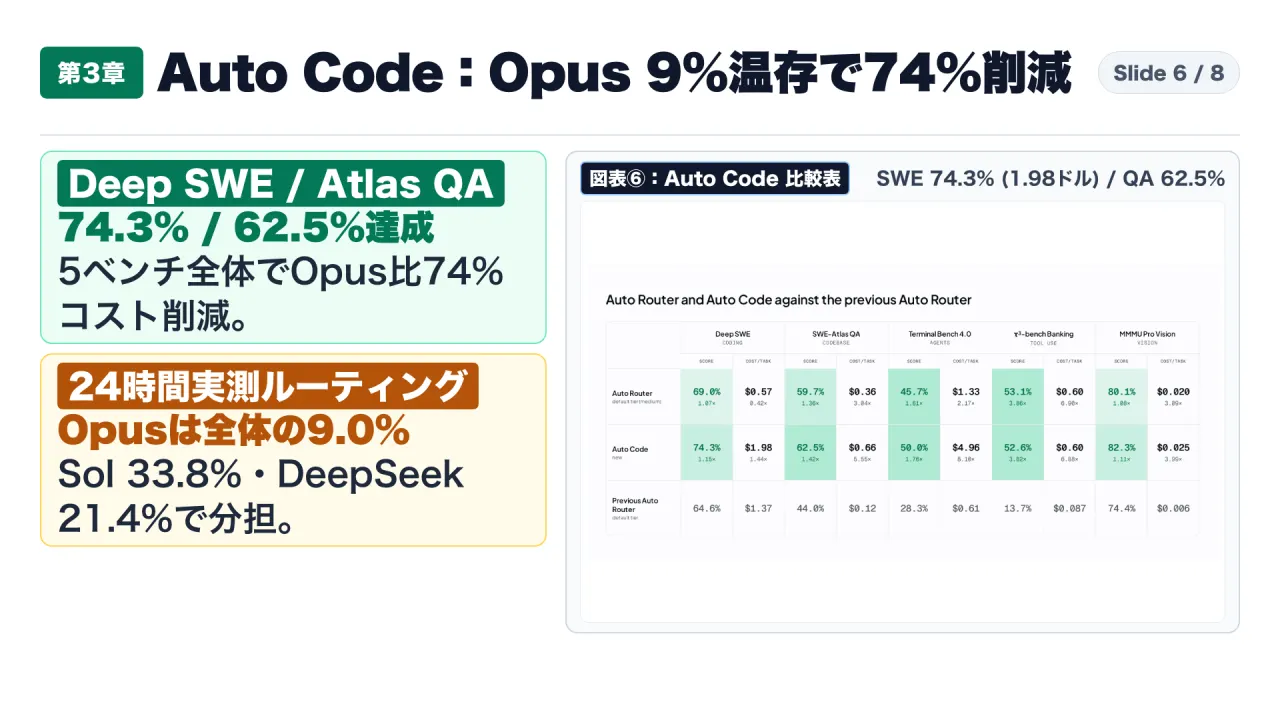
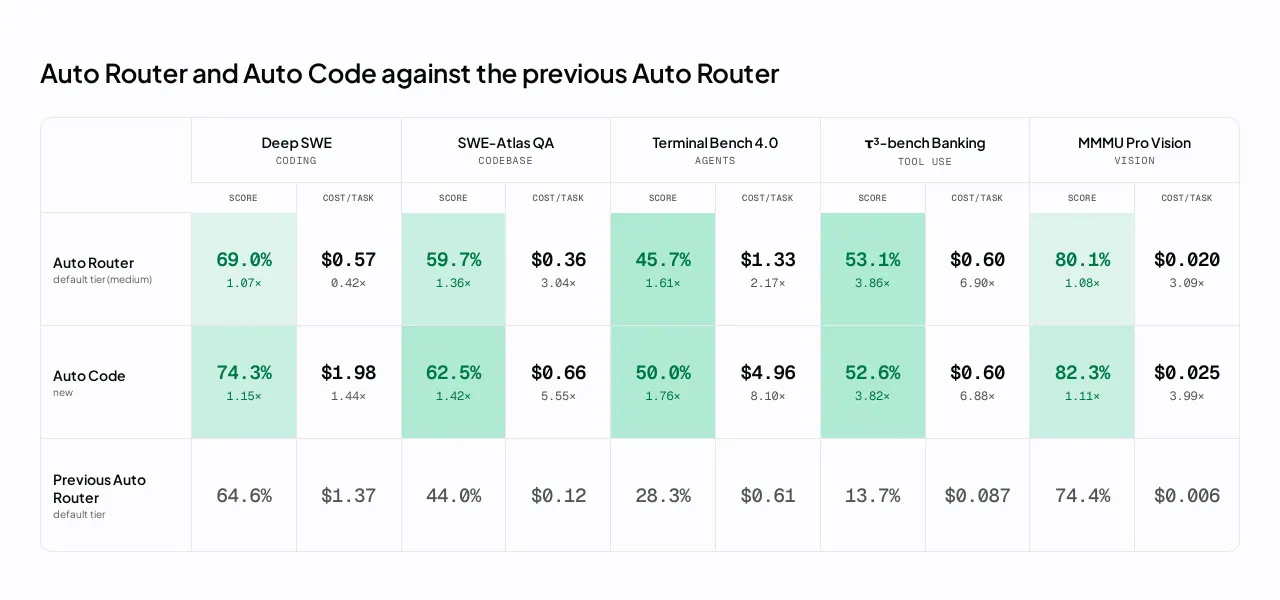
OpenRouterは公式ブログの中で、**「5つのベンチマーク全体において、Auto Code は Claude Opus 5.5 単体と同等のスコアを記録しながら、1タスクあたりのコストを74%削減した(Across the five benchmarks below, Auto Code scores in line with Claude Opus 5.5 while costing 74% less per task)」**と報告しています。
公式比較表(図表10:openrouter_fig2_benchmark_light.png)に示された Auto Router(標準mediumティア)、Auto Code(コーディング特化)、および Previous Auto Router(旧世代ルーター)の全5ベンチマークのスコアと1タスク平均コストは以下のとおりです。
| ベンチマーク名(カテゴリ) | Auto Code(新設・コーディング特化) / スコア / 1タスクコスト(旧世代比) | Auto Router(新世代・標準medium) / スコア / 1タスクコスト(旧世代比) | Previous Auto Router(旧世代) / スコア / 1タスクコスト | 実務上の評価ポイント |
|---|---|---|---|---|
| 1. Deep SWE / (CODING) | 74.3% / $1.98 / (スコア 1.15x / コスト 1.44x) |
69.0% / $0.57 / (スコア 1.07x / コスト 0.42x) |
64.6% / $1.37 | 難関SWE課題で74.3%の高精度を1タスク約2ドルで達成(汎用Auto Routerなら57セントで69.0%)。 |
| 2. SWE-Atlas QA / (CODEBASE) | 62.5% / $0.66 / (スコア 1.42x / コスト 5.55x) |
59.7% / $0.36 / (スコア 1.36x / コスト 3.04x) |
44.0% / $0.12 | 旧ルーターが44.0%で失敗していた大規模コードベースQAを62.5%(66セント)へ劇的改善。 |
| 3. Terminal Bench 4.0 / (AGENTS) | 50.0% / $4.96 / (スコア 1.76x / コスト 8.10x) |
45.7% / $1.33 / (スコア 1.61x / コスト 2.17x) |
28.3% / $0.61 | 旧ルーター(28.3%)では実用にならなかったターミナル自律操作を1.76倍の50.0%へ引き上げ。 |
| 4. τ³-bench Banking / (TOOL USE) | 52.6% / $0.60 / (スコア 3.82x / コスト 6.88x) |
53.1% / $0.60 / (スコア 3.86x / コスト 6.90x) |
13.7% / $0.087 | 金融業務の厳密なツール呼び出しで、旧世代(13.7%)の約3.8倍の完遂率を60セントで実現。 |
| 5. MMMU Pro Vision / (VISION) | 82.3% / $0.025 / (スコア 1.11x / コスト 3.99x) |
80.1% / $0.020 / (スコア 1.08x / コスト 3.09x) |
74.4% / $0.006 | マルチモーダル視覚推論でも82.3%の高精度を1タスク2.5セントで処理。 |
※なお、旧世代の Previous Auto Router は超低価格モデルへの偏重(ドリフト)によってコストが極端に低い代わりに、Terminal Bench 4.0(28.3%)や τ³-bench Banking(13.7%)で精度が大きく崩れていました。新世代では上位モデル群を適切に組み込むことで Claude Opus 5.5 並みの精度を取り戻しつつ、それでも Opus 5.5 単体比で 74%のコスト削減を達成しています(旧世代のような超低コスト優先の挙動が必要な場合は cost_tier: "low" を指定することで再現可能です)。
6. 第4章:実務の3層エージェント分業設計と「使い捨てDBクラスタ(Ephemeral Clusters)」による事故防止
第4章では、OpenRouterの24時間ライブルーティング実測データから「現場のタスク難易度に応じた最適モデル配分比率」を読み解き、さらにコスト削減によって急増する並列エージェントのインフラ事故を防ぐデータベース統治を解説します。
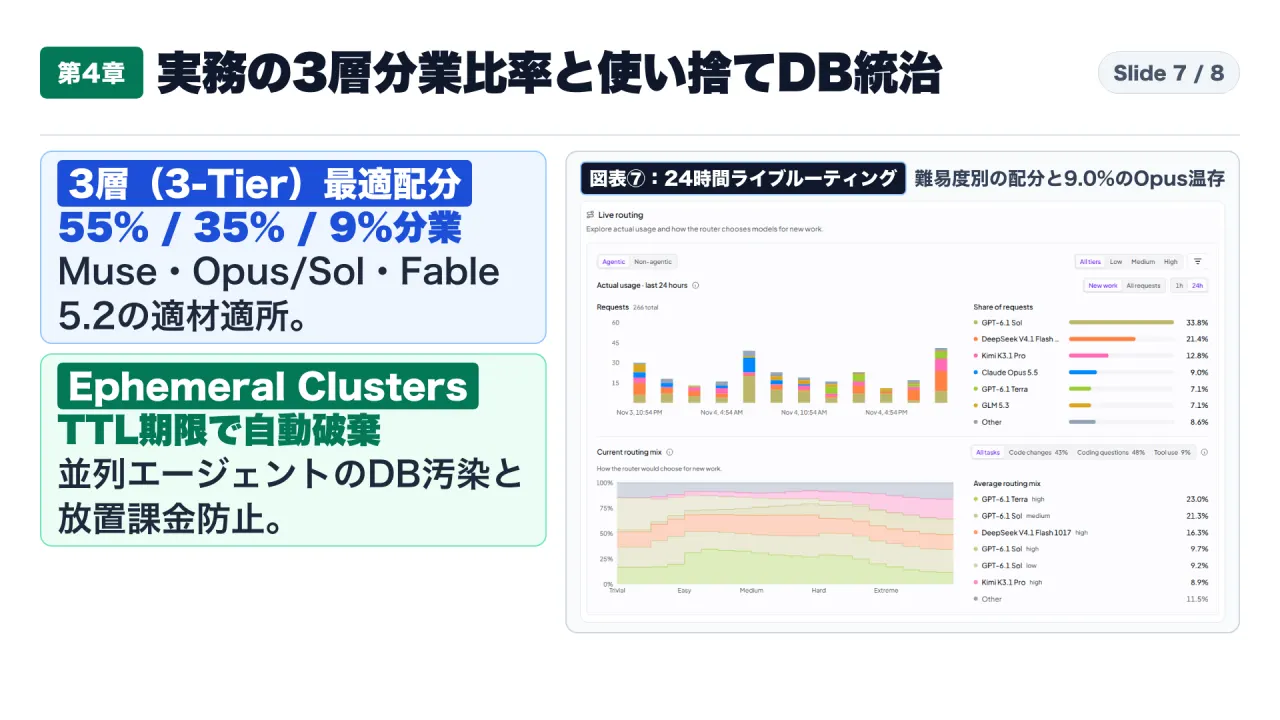
24時間ライブルーティング実測が示す「黄金の配分比率(Opus 5.5 は全体の9.0%)」
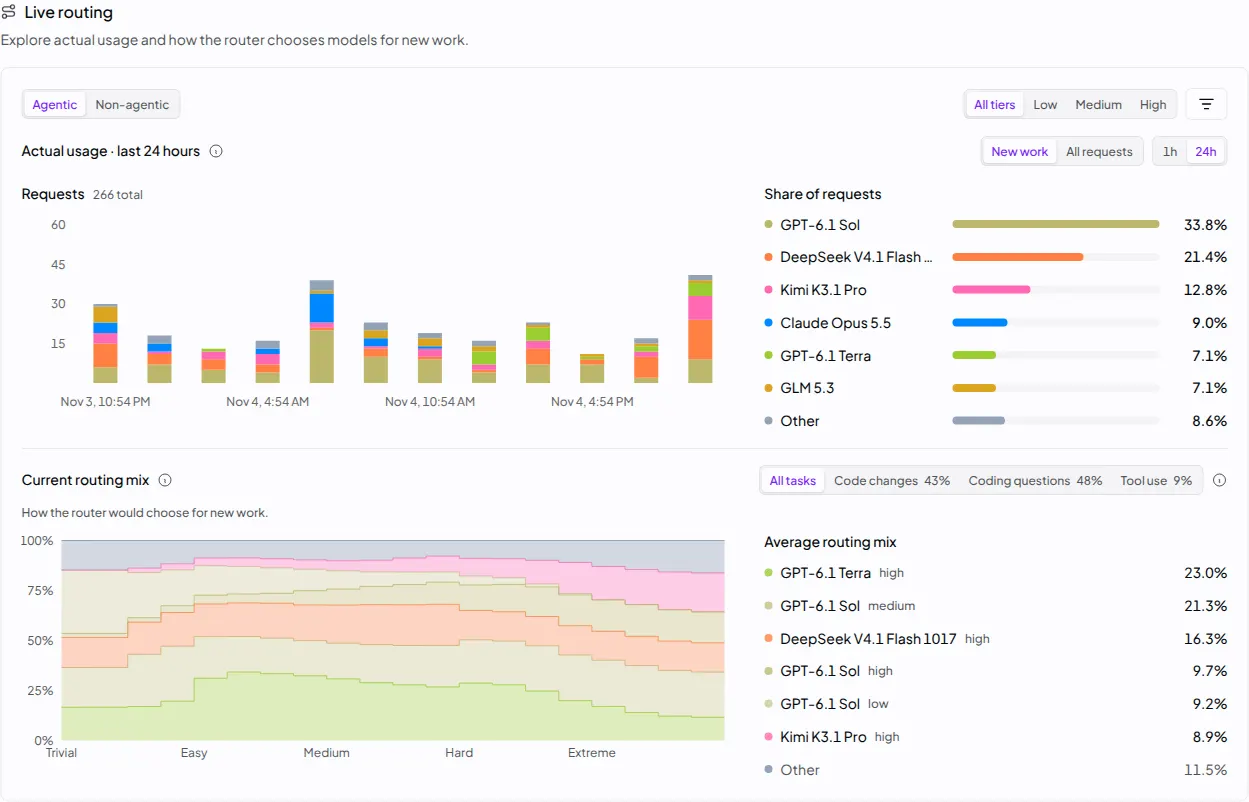
図表12(openrouter_fig4_live_routing.png)は、OpenRouter上で実際に稼働したエージェントセッション(直近24時間・266リクエスト、内訳:コード変更 43%、コーディング質問 48%、ツール利用 9%)において、ルーターがどのモデルを何パーセント選択したかを公開した貴重な実測データです。
- 実測リクエストシェア(Actual usage - Share of requests):
GPT-6.1 Sol:33.8%(日常の主力コーディング・中難易度タスクの筆頭)DeepSeek V4.1 Flash:21.4%(高速・低コストなサブタスクおよび定型処理)Kimi K3.1 Pro:12.8%(中〜高難易度の推論・コード解析)Claude Opus 5.5:9.0%(全体の1割未満の重要局面・難所にのみピンポイント投入)GPT-6.1 Terra:7.1%(高難度アーキテクチャ・複雑推論)GLM 5.3:7.1%- その他(Other):8.6%
- 難易度(Trivial → Easy → Medium → Hard → Extreme)別の平均ルーティング構成(Average routing mix):
- 下段の面グラフが示すとおり、
Trivial(些細な作業)やEasyでは軽量・中堅モデルが大半を占め、難易度がHardからExtreme(極限)へ上がるにつれてGPT-6.1 Terra (high)(平均 23.0%)や上位モデル群の比率が段階的に拡大します。
- 下段の面グラフが示すとおり、
この実測データに、第1章で見た Claude Fable 5.2(長時間難題特化)と第2章の Meta Muse Ember(1タスク0.14ドル・虚偽率17%のサブエージェント)を組み合わせると、企業が構築すべき**「3層(3-Tier)エージェント分業アーキテクチャ」**の設計図が完成します。
- Tier 3(高頻度サブエージェント層:呼び出し全体の 50%〜60%):
- 担当モデル:
Meta Muse Ember($0.10/$0.40、キャッシュ$0.015)、DeepSeek V4.1 Flash - 担当業務: リポジトリ内のファイル探索、ログ走査、ドキュメントからの定型データ抽出、単体テスト結果の一次判定、上位モデルへのエスカレーション判定。
- 担当モデル:
- Tier 2(日常主力コーディング・知識労働層:呼び出し全体の 30%〜40%):
- 担当モデル:
Claude Opus 5.5($4/$20)、GPT-6.1 Sol、Kimi K3.1 Pro - 担当業務: 通常の機能実装、バグ修正、PRレビュー、オフィス実務文書作成(
GDPval-AA/AA-Briefcase v1.1で1800 Eloクラス)。連続10ターン中9ターンは同一モデルを維持してプロンプトキャッシュを効かせる。
- 担当モデル:
- Tier 1(長時間自律完遂・難関技術課題層:呼び出し全体の 10%未満):
- 担当モデル:
Claude Fable 5.2($8/$40、Fast mode $16/$80)、Claude Mythos 5.2、GPT-6.1 Terra (high) - 担当業務: 12時間以上で
Opus 5.5が停滞する長期形式証明・大規模リファクタリング、長期リモート実務(RLI41.3%)、ハードウェア回路・PCB設計、およびゼロデイ脆弱性監査(CVE Rediscovery89.6%)。
- 担当モデル:
なぜコストが74%下がると「使い捨てDBクラスタ(MongoDB Atlas Ephemeral Clusters)」が必須になるのか
3層分業と自動ルーティングによって1タスクあたりのAPIコストが4分の1(74%減)になると、開発現場では次なるボトルネックが発生します。それは、**「開発者1人あたりが同時に走らせる並列エージェントの数が5倍〜10倍に急増し、テスト用のデータベース環境が汚染・放置されてインフラ費用が爆発する問題」**です。
たとえば、10本のコーディングエージェントにそれぞれ異なるブランチでスキーマ変更(マイグレーション)や結合テストを自律実行させたとき、もし全エージェントが同じステージングDBを共有していれば、互いのテーブルを壊し合ってテストが崩壊します。かといってエージェントごとに専用DBクラスタを立ち上げさせると、エージェントがエラーで途中終了した際に削除(Teardown)コマンドが実行されず、誰も使っていないゾンビDBクラスタが何週間も課金され続ける事故が頻発します。
この問題に対するインフラ側の決定打が、MongoDB Atlas が提供を開始した**「Ephemeral Clusters(一時クラスタ)」**(公式ドキュメント)です。
- API / CLI による即時プロビジョニング: エージェントやCI/CDパイプラインがタスク(PR検証や自律テスト)を開始する瞬間に、独立した検証用クラスタを即座に立ち上げます。
- TTL(Time-To-Live:有効期限)によるインフラ側での自動破棄(Auto-expire): クラスタ作成時にあらかじめ有効期限(TTL)を設定しておくことで、万が一エージェントが暴走・異常終了して削除処理を忘れたとしても、期限が来た瞬間にクラウド基盤側でクラスタが自動的に完全破棄されます。これにより、「本番・共有データの汚染ゼロ」と「放置インフラ課金ゼロ」を同時に保証できます。
7. 結論:単一モデル信仰を脱却する「3つのアクションプラン」
【事実】と【私なりの解釈】の切り分け
- 【一次資料で確定した事実】:
- Anthropicの
Claude Fable 5.2およびMythos 5.2は、前世代比20%値下げの入力8ドル・出力40ドル(100万トークンあたり)と最大30%の出力高速化を実現し、公式ベンチマーク11項目中10項目でOpus 5.5(入力4ドル・出力20ドル)を上回り(FrontierCode 2.049.1%、RLI41.3% 対 21.3%)、約1,000体のエージェントによるフェルマーの最終定理の30時間形式証明で 100%完遂(Opus 5.5は27%で停滞)を達成したこと。 - Metaの
Muse Emberは、入力0.10ドル・出力0.40ドル・キャッシュ入力0.015ドルで Artificial Analysis 知能指数 36、1タスク平均コスト 0.14ドル(Haiku 5.5の0.41ドルの約3分の1、Opus 5.5の10.04ドルの約72分の1)、AA-Omniscienceハルシネーション率 17%(全モデル中2位の低さ)を記録したこと。 - OpenRouterの
Auto Codeは、11因子のハーネス認識型ルーティング(p90遅延 0.65秒、連続10ターン中9ターンで同一モデル維持)により、24時間実測でOpus 5.5の呼び出しを全体の 9.0% に温存し、5つのベンチマーク全体で Opus 5.5 単体と同等のスコアを維持しながら1タスクあたりコストを74%削減(Deep SWE74.3%・1.98ドル、SWE-Atlas QA62.5%・0.66ドル)したこと。
- Anthropicの
- 【私なりの解釈】:
- これまで企業のAI導入では「どの単一モデルを社内標準として契約するか」という二者択一の議論ばかりが行われてきました。しかし、1タスク0.14ドルの高効率サブエージェント機(
Muse Ember)、日常標準機(Opus 5.5/GPT-6.1 Sol)、そして30時間の難題を突破する最上位機(Fable 5.2)の間で最大72倍のコスト差と明確な得意領域の分化が起きた以上、「単一モデルへの統一」はもはやアーキテクチャ上の怠慢と言えます。これからの競争力は、モデル単体の性能ではなく、「プロンプトキャッシュを壊さずに3層のモデル群を動的に束ねるルーティング設計」と「並列エージェントが暴走しても自動で消滅するエフェメラルな検証インフラ」の統合力で決まります。
- これまで企業のAI導入では「どの単一モデルを社内標準として契約するか」という二者択一の議論ばかりが行われてきました。しかし、1タスク0.14ドルの高効率サブエージェント機(
現場で今日から実践する3つのアクションプラン
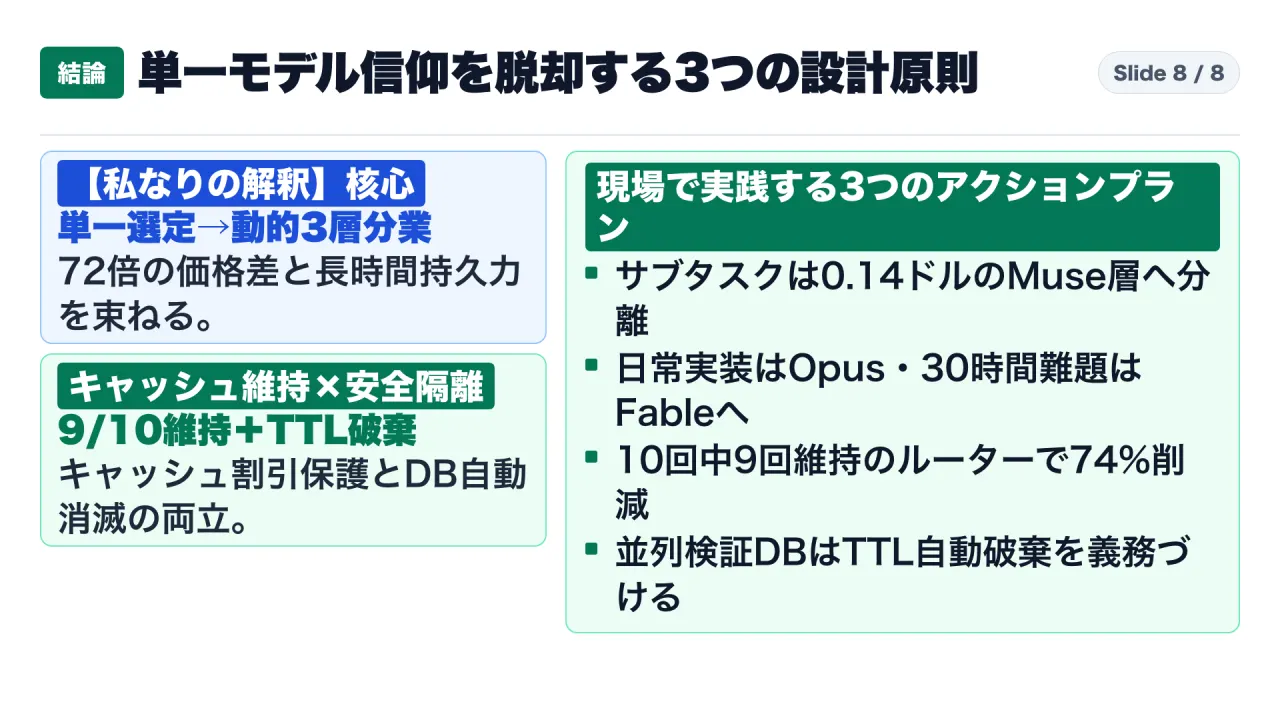
- アクション1(3層への棚卸しと分離):エージェントの呼び出しログを「Tier 3(55%)・Tier 2(35%)・Tier 1(10%未満)」へ分離する
- 社内のエージェントが消費しているトークンの中身を監査してください。ファイル検索・要約・一次判定などのサブタスク(全体の過半数)を1タスク0.14ドル・ハルシネーション率17%の
Muse Ember層へ移し、日常の実装をOpus 5.5/GPT-6.1 Sol層、そして長時間ループや難関設計だけをFable 5.2層へ割り当てる3層構成へ移行してください。
- 社内のエージェントが消費しているトークンの中身を監査してください。ファイル検索・要約・一次判定などのサブタスク(全体の過半数)を1タスク0.14ドル・ハルシネーション率17%の
- アクション2(キャッシュ保護ルーティングの導入):モデル名をハードコードせず、「10回中9回維持」の動的ルーターと5段階Effort制御を組み込む
- アプリケーションやハーネスの設定に単一モデル名をベタ書きするのをやめ、OpenRouterの
openrouter/auto-codeのようなハーネス認識型ルーター、あるいはタスクの難易度に応じたeffort(low〜max)の動的切り替えを導入してください。自社でルーターを組む場合も、キャッシュ割引がリセットされないよう「連続ターンの9割は同一モデルを維持するスティッキネス」を必ず実装してください。
- アプリケーションやハーネスの設定に単一モデル名をベタ書きするのをやめ、OpenRouterの
- アクション3(検証インフラのTTL自動破棄):並列エージェントが接続するDB・検証環境には「Ephemeral Clusters」を義務づける
- エージェントの単価が74%下がれば、現場での並列実行数は確実に跳ね上がります。エージェントに共有ステージング環境を直接触らせるのを禁じ、MongoDB Atlas の Ephemeral Clusters のように「タスク開始時にAPIで立ち上がり、TTL(有効期限)が来たらインフラ側で自動破棄される一時環境」をCI/CDとエージェントハーネスの標準仕様として組み込んでください。
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
参考・一次資料リンク一覧
- Anthropic『Introducing Claude Fable 5.2 and Mythos 5.2』: https://www.anthropic.com/claude-fable-and-mythos-5-2
- Anthropic Research『Evaluating Claude on Electronics Design』: https://www.anthropic.com/research/claude-electronics-design
- AWS Machine Learning Blog『Introducing Claude Fable 5.2 on AWS』: https://aws.amazon.com/blogs/machine-learning/introducing-claude-fable-5-2-on-aws/
- Meta AI Research『Introducing Our Smallest, Most Efficient Model: Muse Ember』: https://research.meta.ai/blog/muse-ember
- Artificial Analysis『Meta’s Muse Ember is the cheapest model scoring 36 on the Intelligence Index』: https://artificialanalysis.ai/articles/meta-s-muse-ember-is-the-cheapest-model-scoring-36-on-the-intelligence-index
- OpenRouter Blog『Introducing the New Auto and Auto Code Routers on OpenRouter』: https://openrouter.ai/blog/announcements/auto-and-auto-code-routers/
- Artificial Analysis『GDPval-AA Evaluation Leaderboard』: https://artificialanalysis.ai/evaluations/gdpval-aa
- MongoDB Atlas Documentation『Create an Ephemeral Cluster』: https://www.mongodb.com/docs/atlas/tutorial/create-ephemeral-cluster/
動画での解説
自己紹介・チャンネル案内:https://note.com/consuloji_ch/n/n1975ecc3cf48