なぜAI基盤は「メモリの壁」と「電力枯渇」で詰まるのか?──Google TPU 8i Max・NVIDIA AutoCompress・Ciscoが実証した特化・圧縮・高稼働の経済学
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜAI基盤は「メモリの壁」と「電力枯渇」で詰まるのか?──Google TPU 8i Max・NVIDIA AutoCompress・Ciscoが実証した特化・圧縮・高稼働の経済学
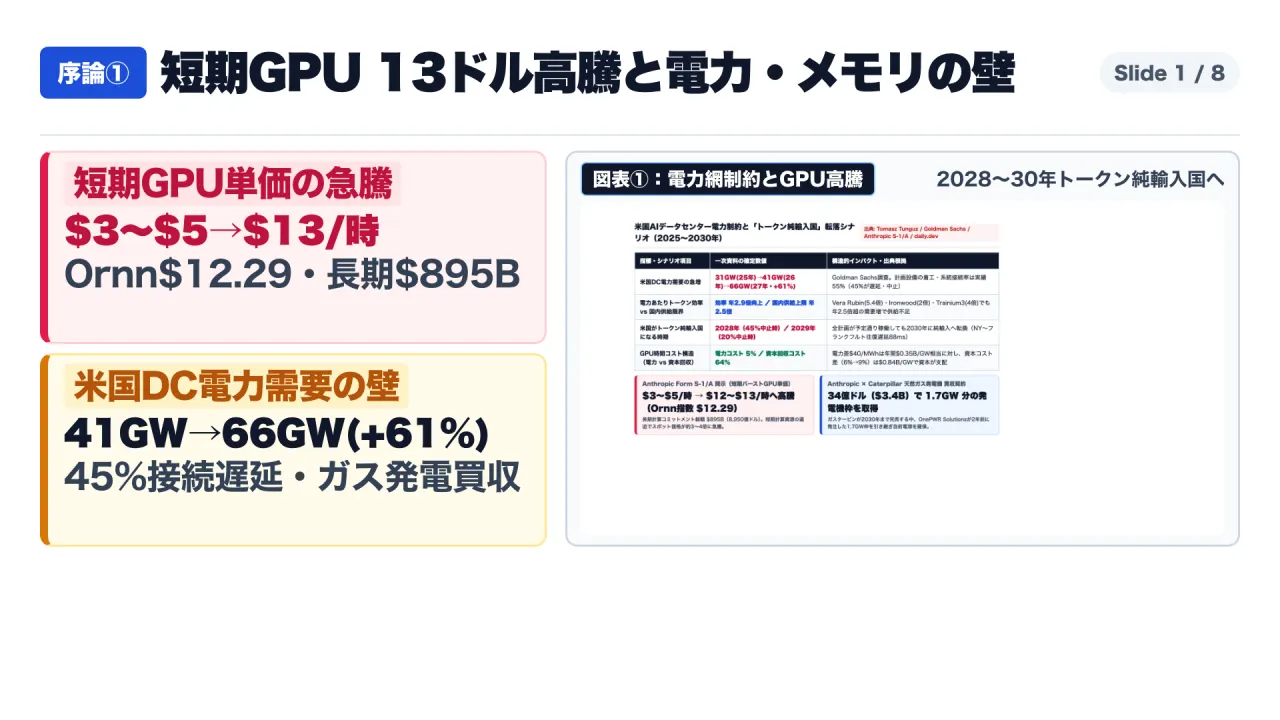
AIモデルの演算性能(FLOPS)が毎年何倍にも向上しているにもかかわらず、多くの企業やAI開発組織で**「長文の社内文書や対話履歴を読み込ませた途端に推論レイテンシが跳ね上がり、高価なGPUがメモリ待ちで遊んでしまう」、「短期バースト用のクラウドGPUレンタル価格が1時間あたり3〜5ドルから12〜13ドル超へと約3〜4倍に急騰し、従量課金だけで予算が溶ける」、そして「データセンターの電力確保が追いつかず、必要な計算資源を増設できない」**という深刻なボトルネックが顕在化しています。
この「メモリの壁(Memory Wall)」と「電力・計算資源の枯渇」という二重の危機に対し、ハードウェア特化・実機誘導型モデル圧縮・オンプレミス高稼働運用の3方向から明確な突破口を示したのが、Google が発表した第8世代TPUポートフォリオ**「TPU 8tx / TPU 8i Max」(オンチップVMEM 2倍の768MB・HBM帯域幅2倍の17.2 TB/s・Boardflyネットワーク最大7ホップ・AMD EPYC Turin機密計算)、NVIDIA Research が公開した自動モデル圧縮論文「AutoCompress」(arXiv:2611.08290v1:実機GPUプロファイリングと層別微分可能ルーターによりMinitron比+6.57ポイントを達成し、120Bモデルを74Bへ圧縮して単一B200 GPUで128K文脈駆動・平均スコア95%維持)、そして Cisco が社内9万人の従業員向けに構築した「Enterprise AI Factory」**(定常推論の80%をオンプレミスで処理し、共有プールと自動回収でGPU実効稼働率を3倍に向上)です。
さらに、Tomasz Tunguz氏(Theory Ventures)・Goldman Sachs・Anthropic Form S-1/A・daily.dev の一次データが明らかにした「米国データセンター電力需要66GW(前年比+61%)」「2028〜2030年の米国トークン純輸入国への転落予測」「GPU時間コストの64%を占める資本回収構造」、およびAnthropicによる「34億ドル・1.7GW分のCaterpillar製天然ガス発電機買収」を重ね合わせることで、これからのAIインフラ戦略の全体像が浮かび上がります。
この記事では、これら4系統の一次資料と全16枚の検証図表(本編スライド8枚+一次資料公式図表8枚)をもとに、なぜ汎用GPUのクラウド借り放題モデルが限界を迎えたのか、そして現場で直ちに実践すべき「特化・圧縮・高稼働」の3大設計原則を徹底解説します。
1. 結論と対象読者:この記事で分かることと現場で実践できる行動
対象読者(いま直面している課題)
- 長文コンテキストを扱うAIエージェントやRAG・コーディング支援を本番展開したいが、KVキャッシュによるVRAM枯渇やレイテンシ悪化、クラウドGPU費用の高騰に直面しているAIアーキテクト・インフラ責任者
- オープンウェイトモデル(10B〜120Bクラス)を自社のGPU(RTX 5070/5080、H100、B200等)に合わせてプルーニング・量子化・蒸留し、単一ノードまたはエッジ環境に収めたいMLエンジニア
- パブリッククラウドの従量課金とオンプレミス(または専有クラスタ)の投資配分を見直し、全社数万人規模のAIワークロードのROIを最大化したいCIO・IT部門リーダー
一次資料から導かれる4つの核心的結論
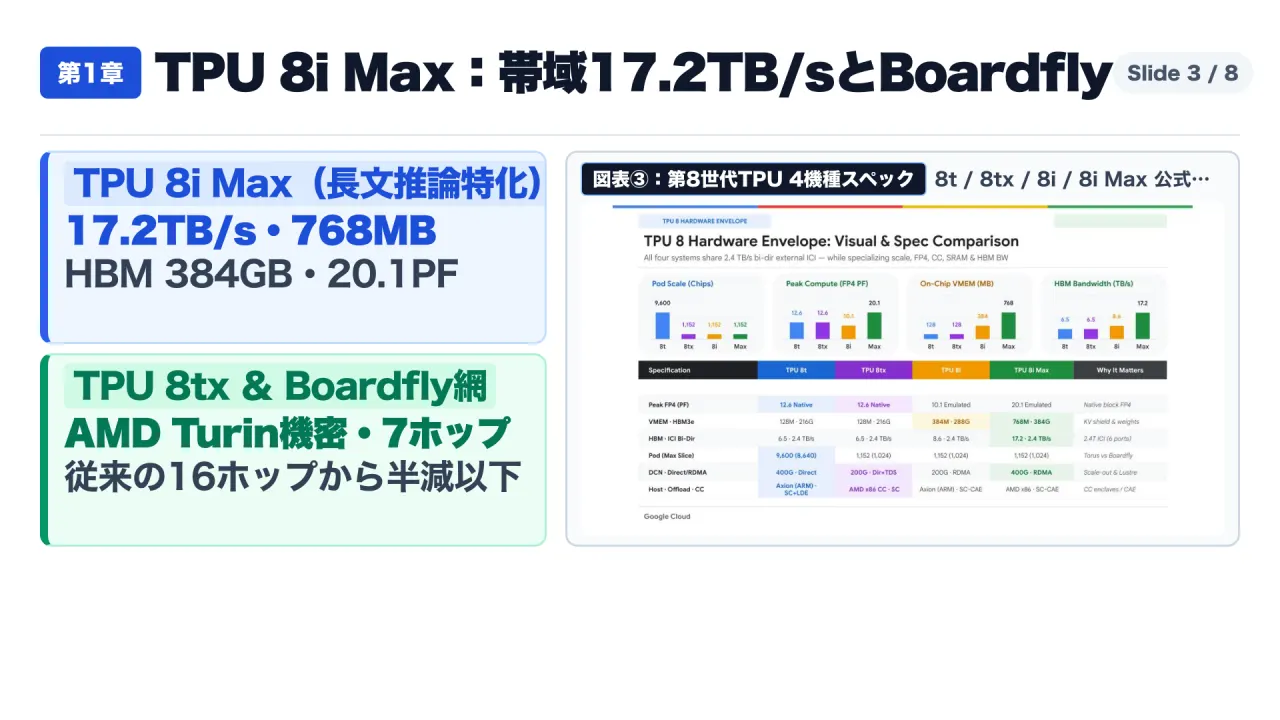
- Google第8世代TPUの4機種特化と「TPU 8i Max」によるメモリ帯域幅2倍(17.2 TB/s)・Boardfly最大7ホップの達成:
- GoogleでAIインフラを統括するAmin Vahdat氏は、単一チップで学習も推論もこなす時代の終焉を宣言し、第8世代TPUを
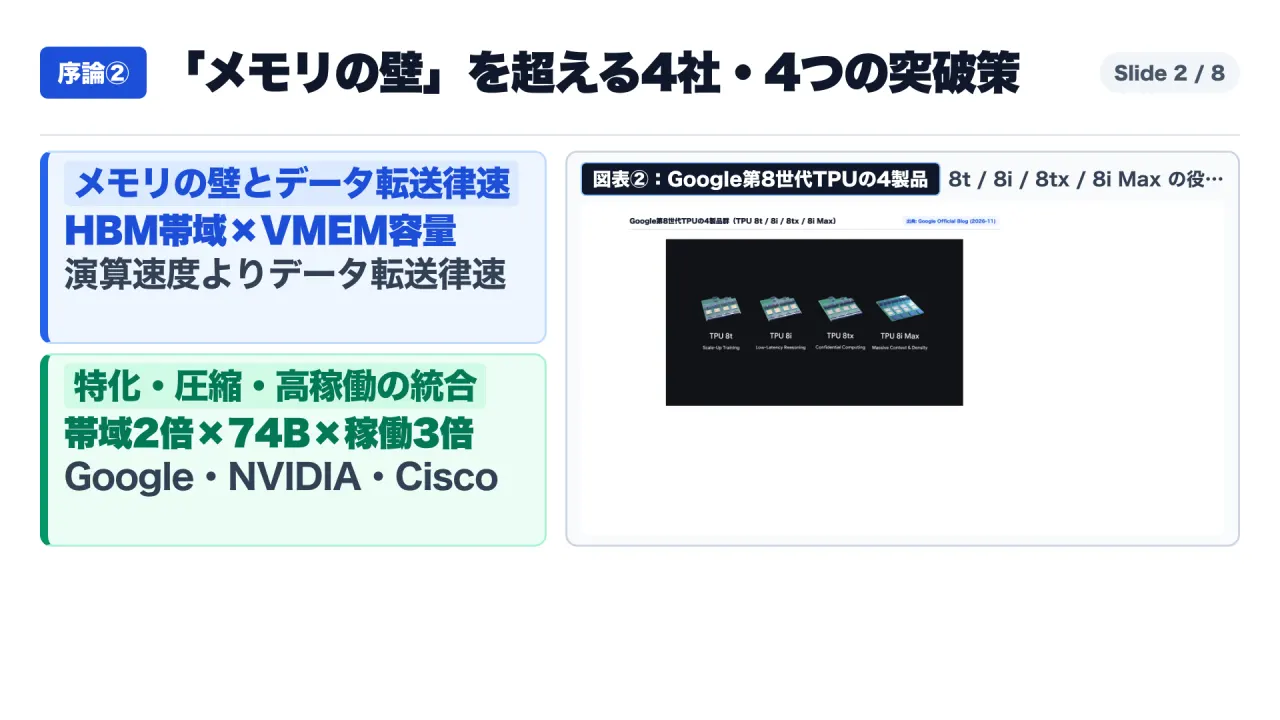
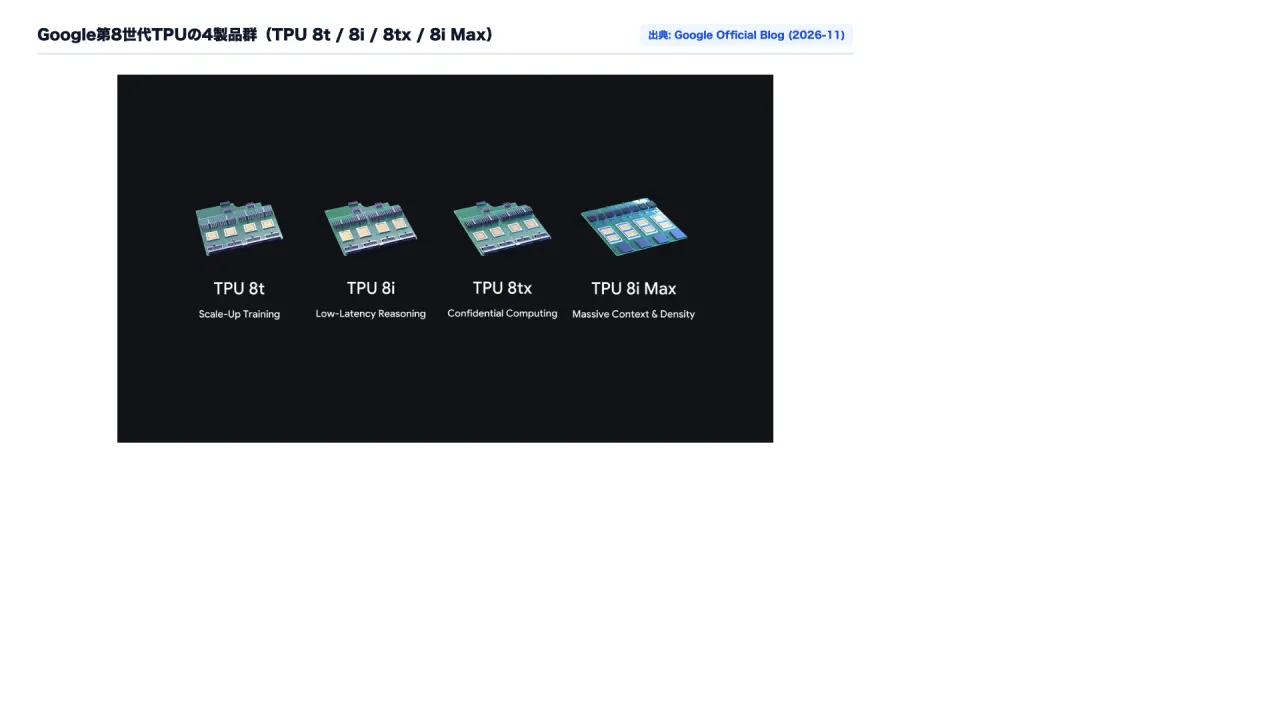
TPU 8t(大規模学習:9,600チップ、FP4 12.6 PF、VMEM 128MB、HBM3e 216GB、6.5 TB/s)、TPU 8tx(機密計算推論・微調整:1,152チップ、デュアルAMD EPYC Turin x86ホスト・128 PCIe Gen5・ハードウェアConfidential Computingエンクレーブ)、TPU 8i(低遅延リーズニング:FP4 10.1 PF、VMEM 384MB、HBM3e 288GB、8.6 TB/s)、およびTPU 8i Max(超長文・高密度エージェント推論:2チップ統合、FP4 20.1 PF、VMEM 768MB[8iの2倍・8tの6倍]、HBM3e 384GB[+33%]、HBM帯域幅 17.2 TB/s[8iの2倍]) の4機種へ分化させました。さらに新ネットワークトポロジBoardflyにより1,152チップ間の最大ホップ数を従来の3D Torus(16ホップ)から 7ホップ へ半減させ、TorchTPU(PyTorch/vLLM/SGLangネイティブ実行)とTPU Sync(HBM・ホストDRAM・共有ストレージ・ネットワーク横断のKVキャッシュ状態管理)でメモリの壁を突破しています。
- GoogleでAIインフラを統括するAmin Vahdat氏は、単一チップで学習も推論もこなす時代の終焉を宣言し、第8世代TPUを
- NVIDIA「AutoCompress」が暴いた「パラメータ数神話の崩壊(遅延35%差)」と、120Bモデルを単一B200(74B)へ収め精度95%を維持する技術:
- NVIDIA研究チームの論文(
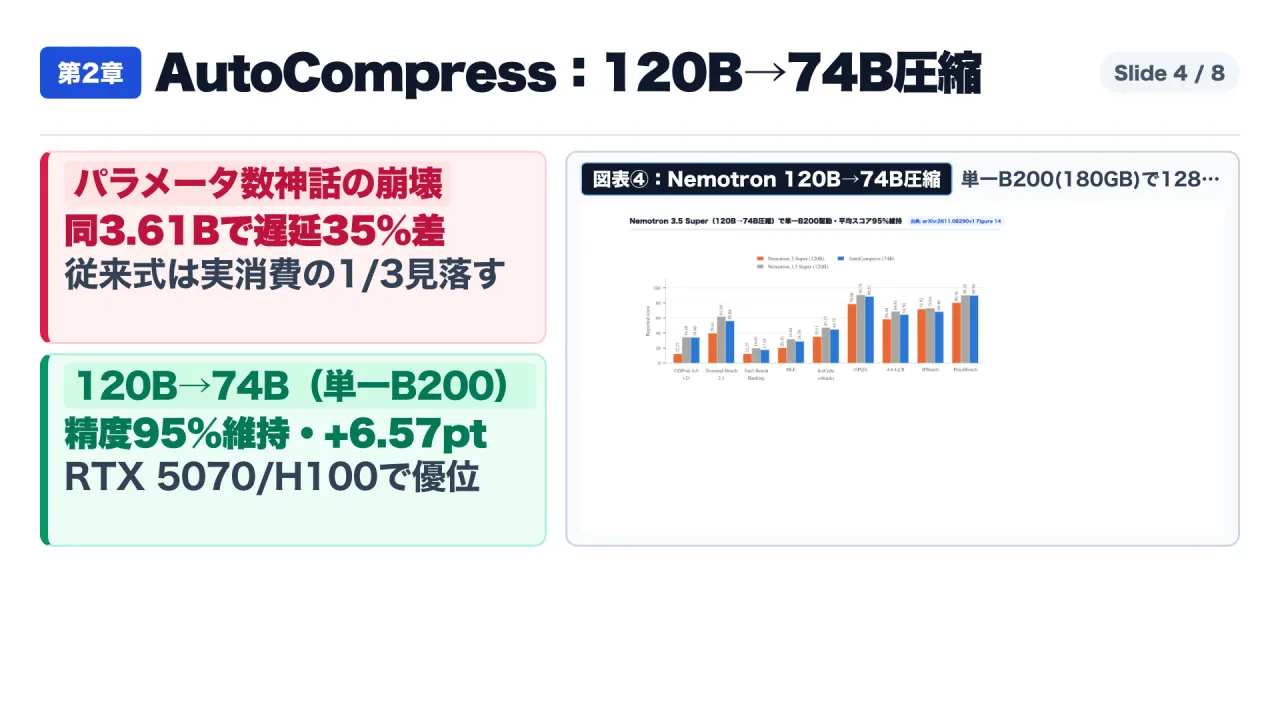
arXiv:2611.08290v1)は、まったく同じパラメータ数(総3.61B・アクティブ1.26B)でも層の深さと幅の違いでRTX 5070実機の推論遅延が 35%乖離 し、従来の理論メモリ計算式はCUDAランタイム等の実機オーバーヘッドを見落として 実メモリ消費量の約3分の1を取りこぼす ことを実証しました。AutoCompressは実機プロファイリングと微分可能ルーター(MoE出力マスクで学習損失23%減、ゼロ初期化で蒸留損失10.9%減)により、最先端のMinitronプルーニングに対し RTX 5070で+6.57ポイント(33.21 vs 26.64)、RTX 5080長文コーディングで+2.35ポイント(51.40 vs 49.05)、H100で+0.57ポイント の精度向上を達成しました。さらにBF16で280GBを要するNemotron 3.5 Super(120B)を74Bへ圧縮 し、単一B200 GPU(180GB)上で128K文脈・最大バッチ16での駆動を実現しつつ9ベンチマーク平均スコアの 95%(54.74 / 57.58) を維持しました。
- NVIDIA研究チームの論文(
- Cisco「Enterprise AI Factory」が実証した「定常推論の80%オンプレミス運用」と「GPU実効稼働率3倍」の経済学:
- Cisco IT部門は全社 90,000人(9万人) の従業員向けスーパーエージェント
MyAgentと顧客向けCisco IQを単一基盤で統合し、99.99%以上の可用性(SLA) を達成しました。その実測から、「予測可能な定常状態(steady-state)の推論ワークロードの 80% をオンプレミスAIファクトリーで実行すること」が最高のコスト効率を生むと結論づけています。部門別のサーバーサイロ化を廃止し、高帯域ファブリックと自動GPU回収(アイドル時にバッチジョブを充填)を導入したことで GPU稼働率を従来の3倍(3x) に引き上げ、Splunk Observability Cloudにより エンドポイント監視テレメトリ量を75%削減 しました。
- Cisco IT部門は全社 90,000人(9万人) の従業員向けスーパーエージェント
- 短期GPU価格の「13ドル急騰」、2028年「米国トークン純輸入国」予測、およびAnthropicによる34億ドル・1.7GW天然ガス発電機買収:
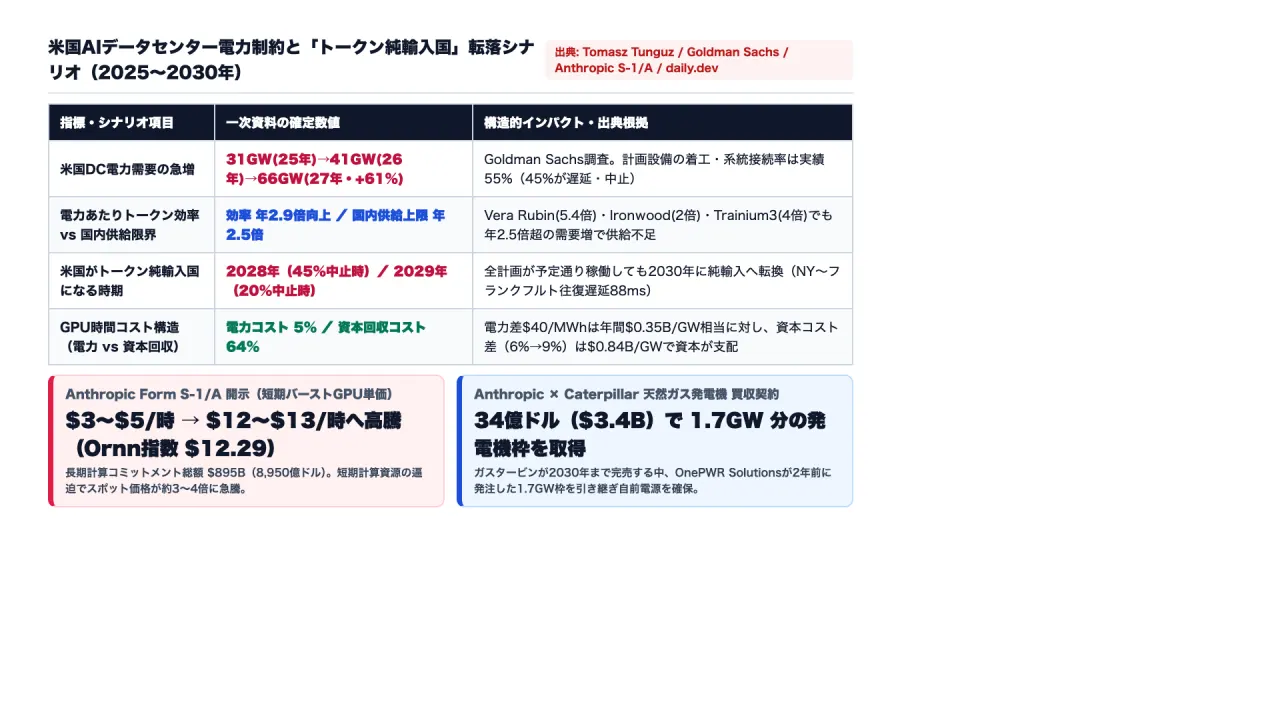
- Goldman Sachsの調査では米国のデータセンター電力需要は2025年の31GW、2026年の41GWから2027年には 66GW(+61%) へ急増する一方、計画設備の 45%が送電網接続の遅延・中止 に直面しています。チップの電力効率は 年率2.9倍 で伸びるものの国内電力網が支えられるトークン供給上限は 年率2.5倍 にとどまるため、米国は 2028年(45%中止時)〜2029年(20%中止時)、全計画が予定通り稼働しても 2030年 に「トークンの純輸入国」へ転落します。GPU 1時間コストのうち 電力代は5% にすぎず 資本回収が64% を占めるため、Anthropic(長期計算コミットメント総額 8,950億ドル、短期バーストGPU価格は 3〜5ドルから12〜13ドル超[Ornn指数12.29ドル]へ急騰)は、電力待ちでGPUを遊ばせる損失を防ぐべく、34億ドル($3.4B)でCaterpillar製天然ガス発電機1.7GW分 の注文枠を直接買収しました。
2. 第1章:Google第8世代TPUの4機種特化──「TPU 8i Max」メモリ帯域2倍とBoardfly 7ホップの衝撃
GoogleのAIインフラ統括バイスプレジデントであるAmin Vahdat氏は、公式ブログ記事『Our newest TPUs: 8tx and 8i Max, built for the agentic era』(Google Official Blog)および技術ブリーフィングにおいて、AIワークロードが「単発の質問応答」から「長大なコンテキストとツール呼び出しを伴う自律型エージェント」へ移行した結果、ハードウェア設計の前提が根底から変わったことを明らかにしました。
従来のAIチップ設計では、「事前学習(Training)用」と「推論(Inference)用」の2種類に分けるか、あるいは1つの汎用GPUであらゆるワークロードを処理するのが一般的でした。しかし、エージェント推論では数十万〜数百万トークンのKVキャッシュ(過去の文脈状態の記憶)を毎トークン生成ごとに高速に読み出す必要があり、演算器のFLOPSよりも**「オンチップSRAM(VMEM)の容量」「HBM(高帯域幅メモリ)の帯域幅」「チップ間ネットワークのホップ数」**が推論速度を決定づけます。
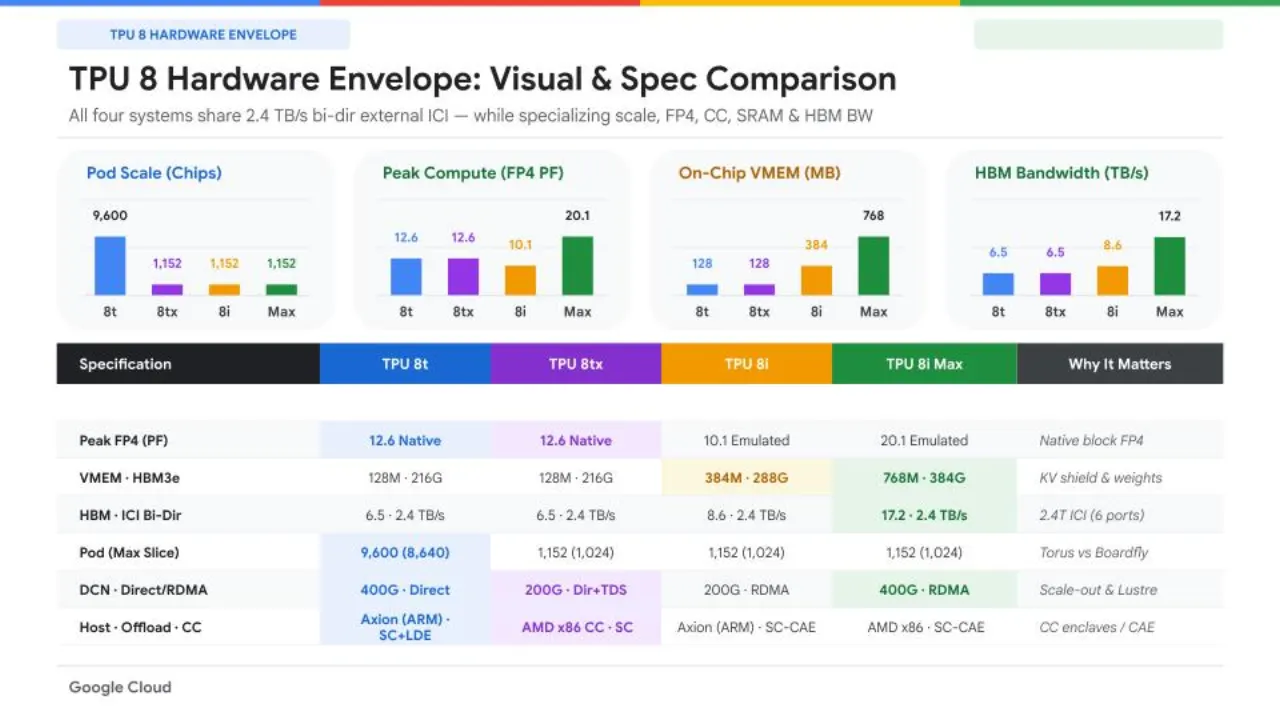
上のGoogle Cloud公式スペック比較図(ServeTheHome検証記事収録)が示す通り、第8世代TPUはすべてのシステムで外部双方向インターコネクト(ICI)の 2.4 TB/s(6ポート) を共通化しつつ、以下の4つの特化型システムへと分化しました。
- TPU 8t(Scale-Up Training / 大規模事前学習特化)
- Podスケール: 9,600チップ(最大スライス 8,640チップ)、3D Torusトポロジ
- ピークFP4演算性能: 12.6 PFLOPS(Native block FP4)
- メモリ構成: オンチップVMEM 128 MB / HBM3e容量 216 GB / HBM帯域幅 6.5 TB/s
- ネットワーク・ホスト: 400G Direct、ホストCPUは Google Axion(ARM)(SC+LDEオフロード対応)
- TPU 8tx(Confidential Computing / 機密計算推論・微調整特化)
- Podスケール: 1,152チップ(最大スライス 1,024チップ)、Boardfly トポロジ
- ピークFP4演算性能: 12.6 PFLOPS(Native block FP4)
- メモリ構成: オンチップVMEM 128 MB / HBM3e容量 216 GB / HBM帯域幅 6.5 TB/s
- ネットワーク・ホスト: 200G Dir+TDS、ホストCPUに デュアルソケット AMD EPYC Turin(x86) を採用。128レーンのPCIe Gen 5とハードウェアレベルの Confidential Computing エンクレーブ(CC・SC) を備え、金融・医療・公共機関などの厳格な規制下にある企業データや独自モデルの重みをメモリ上で暗号化したまま推論・ファインチューニング可能。
- TPU 8i(Low-Latency Reasoning / 低遅延リーズニング特化)
- Podスケール: 1,152チップ(最大スライス 1,024チップ)、Boardfly トポロジ
- ピークFP4演算性能: 10.1 PFLOPS(Emulated)
- メモリ構成: オンチップVMEM 384 MB(8t/8txの3倍) / HBM3e容量 288 GB / HBM帯域幅 8.6 TB/s
- ネットワーク・ホスト: 200G RDMA、ホストCPUは Google Axion(ARM)(SC-CAE対応)
- TPU 8i Max(Massive Context & Density / 超長文コンテキスト・高密度エージェント特化)
- アーキテクチャ: 2つの
TPU 8iチップを単一の論理システムとして統合したデュアルチップパッケージ - Podスケール: 1,152チップ(最大スライス 1,024チップ)、Boardfly トポロジ
- ピークFP4演算性能: 20.1 PFLOPS(Emulated)(
8i比で 約2倍) - メモリ構成: オンチップVMEM 768 MB(8iの2倍、8t/8txの6倍) / HBM3e容量 384 GB(8i比+33%増) / HBM帯域幅 17.2 TB/s(8iの2倍、8t/8txの約2.65倍)
- ネットワーク・ホスト: 400G RDMA、ホストCPUは AMD x86(SC-CAE対応)
- アーキテクチャ: 2つの
MoE推論の通信遅延を半減させる「Boardfly」トポロジと「TPU Sync」
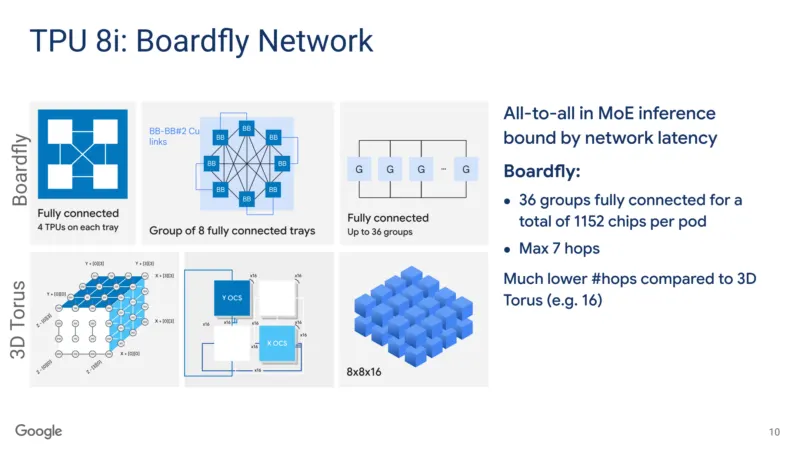
さらに注目すべきは、推論系の3機種(8tx / 8i / 8i Max)に導入された 「Boardfly」 ネットワークトポロジです。近年のフロンティアモデルの主流であるMoE(Mixture-of-Experts)アーキテクチャでは、トークンごとに異なるエキスパートへデータを振り分ける「All-to-All通信」が毎層発生するため、帯域幅だけでなく「チップ間の到達ホップ数(ネットワーク遅延)」が推論速度を直接律速します。
従来の学習向け 3D Torus(8×8×16構成) では、Pod内の端から端まで通信するのに最大 16ホップ を要していました。これに対し Boardfly は、1トレイ上の4チップを完全結合(Fully connected)し、さらに8トレイを銅線リンク(BB-BB#2 Cu links)で完全結合グループ化した上で、最大36グループ(計1,152チップ)を光回路スイッチ(OCS)で完全結合する階層構造を採用しました。これにより、1,152チップ規模のPod全体で最大ホップ数を 7ホップ(16ホップから半分以下)へと劇的に短縮しています。
またソフトウェア面では、PyTorchやvLLM、SGLangなどの標準エコシステムをコード変更なしでTPU上で動かす TorchTPU と、エージェントの長大な状態(KVキャッシュ)をチップ上のHBM・ホストCPUのDRAM・共有ストレージ・ネットワーク間でシームレスに階層管理する TPU Sync が統合されました。なお、TPU 8tx および TPU 8i Max の具体的な一般提供(GA)開始日とクラウド時間単価については、現時点の一次資料では 未確認 です。
3. 第2章:NVIDIA「AutoCompress」──実機計測×層別圧縮で120Bを単一GPU 74Bへ収める技術
ハードウェア側でメモリ帯域を広げるアプローチと対をなすのが、ソフトウェア側で「モデルの構造自体をターゲットGPUのメモリ枠と遅延予算に合わせて自動的に削り出す」技術です。NVIDIAの研究チーム(Sheldon Liang氏、Sharath Turuvekere Sreenivas氏、Pavlo Molchanov氏、Pavan. K. Anasosalu Vasu氏ら)が公開した論文『AutoCompress: Automated Hardware-Guided Model Compression』(arXiv:2611.08290v1)は、従来のモデル圧縮の常識を覆す2つの実証データから出発しています。
なぜ「パラメータ数」と「理論メモリ計算式」は当てにならないのか
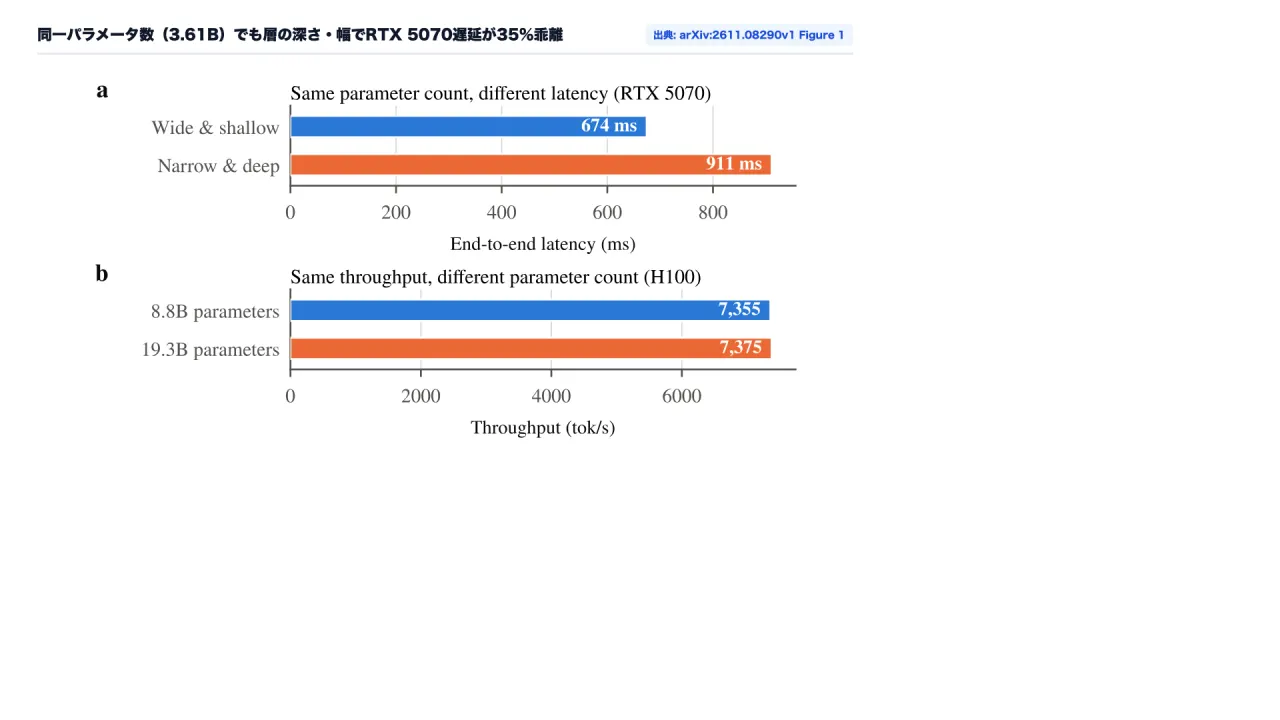
第1に、**「パラメータ数は実機サービングコストの粗悪な代理指標(poor proxy)である」**という事実です。上のFigure 1(a)が示す通り、総パラメータ数 3.61B(アクティブパラメータ 1.26B)というまったく同一の規模を持つ2つのハイブリッドMamba-Attention-MoEモデルであっても、層が深く幅が狭い(narrow, deep)アーキテクチャは、幅が広く浅いアーキテクチャに比べてRTX 5070実機上で 35%も高いレイテンシ を引き起こします。またFigure 1(b)では、アクティブパラメータ数が15%少ないモデルの方が、アクティブパラメータが多いモデルよりもH100上で逆にスループットが9%低くなる逆転現象も確認されています。
第2に、**「従来の理論メモリ計算式は実機メモリの約3分の1を見落とす」**という事実です(論文Figure 12)。モデルの重み(Weights)、シーケンスごとのKVキャッシュおよびMamba状態、MoEアクティベーションバッファだけを足し算する従来のメモリ推定式は、CUDAランタイムコンテキスト、CUDAグラフのメモリ予約、推論エンジン固有のワークスペースなどの実機オーバーヘッドを計算に入れていません。そのため、理論式で「VRAMに収まる」と判定されたモデルが実機では約33%のメモリ超過(Out-of-Memory)を起こすのです。
AutoCompressの3段階パイプラインと「微分可能ルーター」の革新
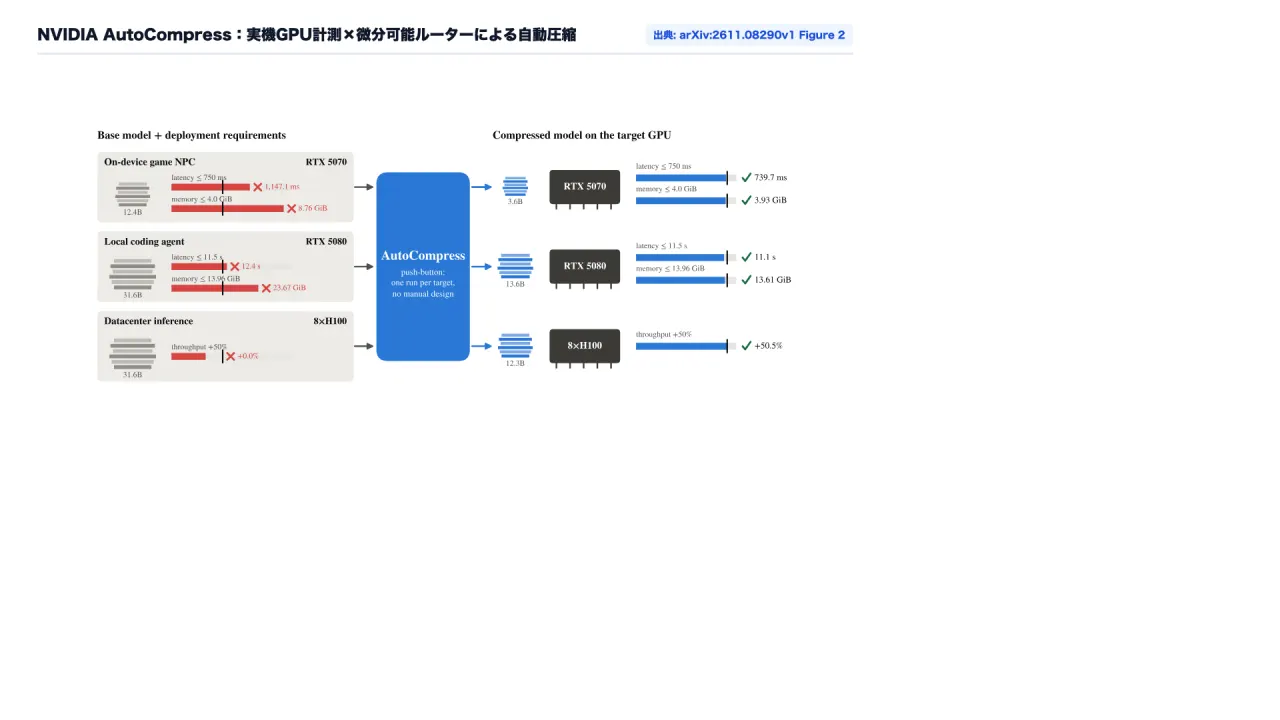
そこでAutoCompressは、人間による手作業の設計やヒューリスティックな重要度スコアを排し、以下の3段階でターゲットGPU直結の自動圧縮を実行します。
- 実機GPUプロファイリングによるコストモデル構築(Figure 4 & Table 4):
- ターゲットGPU(RTX 5070、RTX 5080、H100、B200)と本番推論エンジン(TensorRT-LLM / vLLM)上で、異なるレイヤー構成を持つモデルを実際に駆動させ、NVIDIA Nsight Systemsで各層のPrefill(プロンプト処理)時間、Decode(トークン生成)時間、および実メモリ消費量を計測します。
- このプロファイリングに必要なコストは、ローカルコーディング契約(RTX 5080、60実行・468エントリ)でわずか 3.5 GPU時間、オンデバイスNPC契約(RTX 5070、96実行・660エントリ)で 4.5 GPU時間、データセンター契約(H100、180実行・408エントリ)で 24.8 GPU時間 と極めて軽量でありながら、実測値とほぼ完全に一致する予測精度(Figure 11)を実現しています。
- 微分可能ルーターによる大域・層別ヘテロジニアス構造の同時探索(Figure 3, Figure 7, Figure 8):
- モデル全体で共有する隠れ層次元(Hidden size:例 2688〜1408)やMambaヘッド数(64〜32または層ごと削除)と、各層ごとに異なるFFN中間幅やMoEルーティングエキスパート数(128、112、96、80、64、32)に対して微分可能なソフトマスクを導入し、知識蒸留(KD)損失とハードウェア予算制約損失の勾配で同時最適化します。
- 特筆すべきアルゴリズム上の発見として、MoEエキスパートの枝刈りマスクをTop-kルーティング選択の「前(スコア段階)」ではなく**「後(エキスパート出力段階:Expert output masking)」**に適用することで、上位k個のエキスパートすべてに蒸留勾配が流れるようになり、学習損失を 23%低減 させました(Figure 8)。さらにルーター出力をランダムではなく「ゼロ初期化(一様分布開始)・ウォームアップなし」にすることで、蒸留損失をさらに 10.9%低減 しています(Figure 7)。
- 知識蒸留(Knowledge Distillation)による精度回復:
- 探索された非一様(層ごとにエキスパート数や幅が異なる)な圧縮モデルに対し、親モデルを教師として30Bトークンの知識蒸留を行い、精度を回復させます。
実機3契約でのMinitron圧倒(+6.57pt)と「Nemotron 3.5 Super 120B→74B」単一B200駆動
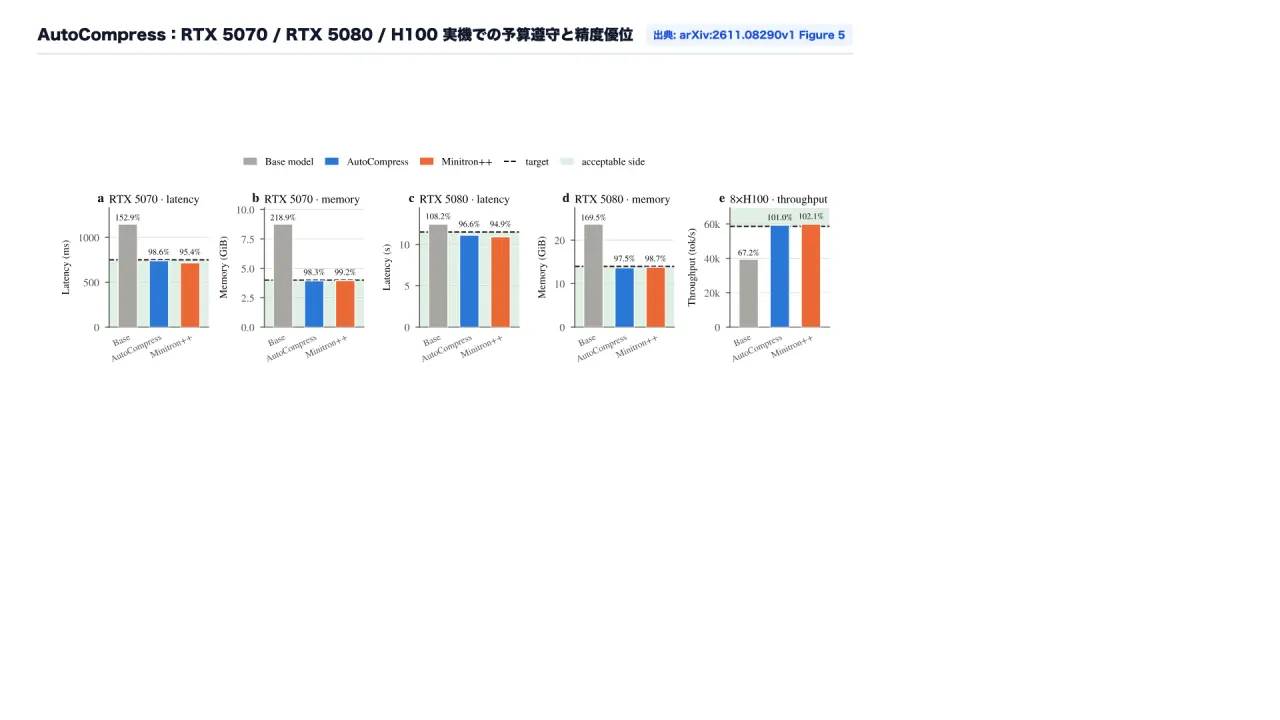
論文のTable 1およびTable 3では、3つの厳格な実機デプロイ契約において、最先端のプルーニング手法である Minitron と同一の探索・蒸留トークン予算で比較した結果が示されています。
- 契約①:オンデバイス・ゲームNPC(1×RTX 5070 12GB、予算:レイテンシ750ms以下・メモリ4.0GiB以下)
- 親モデル: Nemotron Nano 3 Elastic 12B(総12.4B / アクティブ2.1B)── 実機では遅延1,147.1ms・メモリ8.76GiBとなり予算を超過。
- AutoCompress結果: 総パラメータ 3.6B(遅延 739.7ms・メモリ 3.90GiB)へ圧縮し予算を完全遵守。8ベンチマーク(AIME25、LiveCodeBench、MMLU-Pro、MATH-500、GSM8K、IFEval、IFBench、GPQA)の平均スコアは、Minitronの 26.64 に対し 33.21(+6.57ポイント向上) を達成(MATH-500で36.40 vs 27.00、GSM8Kで47.23 vs 34.42)。
- 契約②:長文ローカル・コーディングエージェント(1×RTX 5080 16GB、バッチ1、キャッシュ262,144トークン+出力16,384トークン、予算:遅延11.5秒以下・メモリ13.96GiB以下)
- 親モデル: Nemotron 3.5 Lightning(総31.6B / アクティブ3.6B)── 実機では遅延12.4秒・メモリ23.67GiBで16GB VRAMに収まらず駆動不能。
- AutoCompress結果: 総パラメータ 13.6B(遅延 11.1秒・メモリ 13.61GiB)へ圧縮。8ベンチマーク平均スコアはMinitronの 49.05 に対し 51.40(+2.35ポイント向上) を達成(AIME25で19.17 vs 11.46、MATH-500で78.20 vs 74.60)。
- 契約③:データセンター高スループット推論(8×H100 TP1×DP8、予算:スループット+50%以上向上)
- AutoCompress結果: 親モデルから 17.7B(スループット +50.5%向上)へ圧縮し、8ベンチマーク平均スコアはMinitronの 54.24 に対し 54.81(+0.57ポイント向上) を達成。
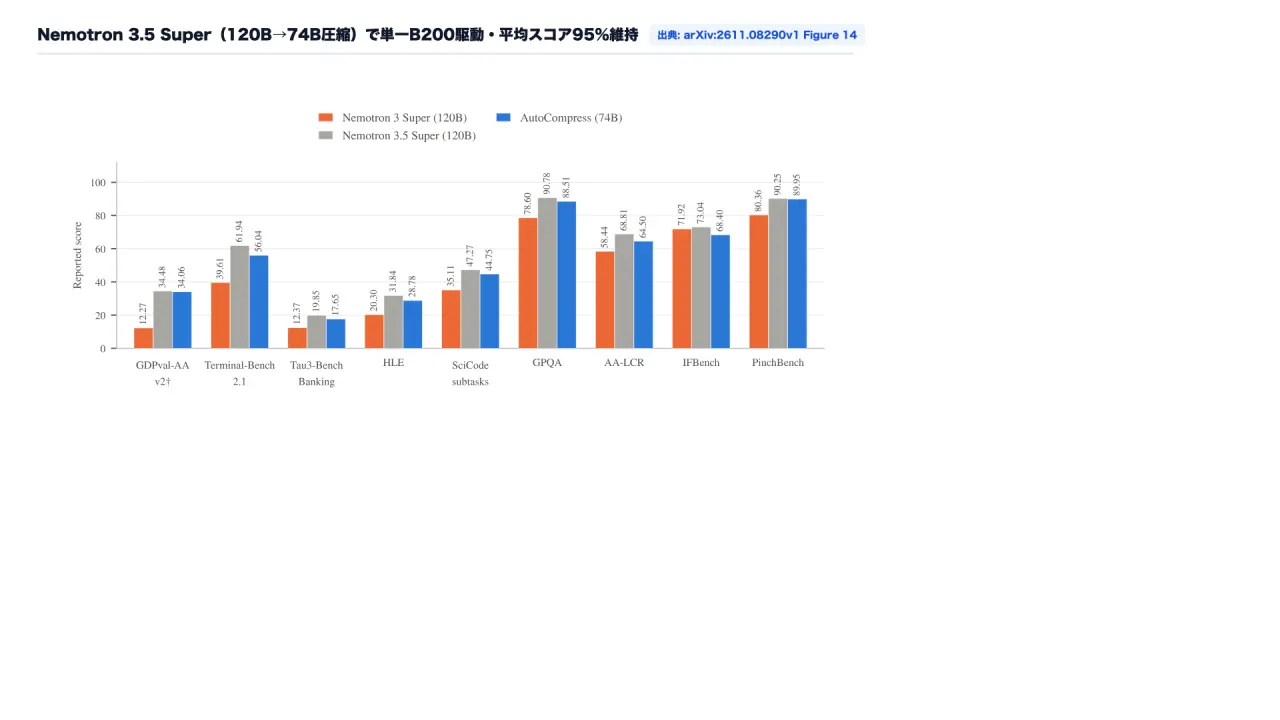
さらに大規模モデルへの適用(Figure 6, Figure 13, Figure 14)として、総パラメータ 120B のフラッグシップモデル Nemotron 3.5 Super を圧縮した結果が極めて重要です。120Bの親モデルはBF16精度でのサービング時に 約280GB のメモリフットプリントを必要とするため、180GB VRAMを搭載するNVIDIAの最新GPU B200 であっても単一GPUには収まりません。
AutoCompressはこの120Bモデルを 74Bパラメータ へと圧縮することで、単一のB200 GPU(180GB)上で131,072(128K)コンテキスト長・最大バッチサイズ16 でのBF16駆動を実現しました。しかも上のFigure 14が示す通り、9つのベンチマーク(GDPval-AA v2、Terminal-Bench 2.1、Tau3-Bench Banking、HLE、SciCode、GPQA、AA-LCR、IFBench、PinchBench)の非加重平均スコアにおいて、親モデル(57.58)に対して 54.74(親モデルの95.1%の性能) を維持し、前世代のフルサイズモデル Nemotron 3 Super 120B(平均 45.44)をすべての指標で圧倒しています。
4. 第3章:Cisco「Enterprise AI Factory」──定常推論80%オンプレミス回帰とGPU稼働率3倍の経済学
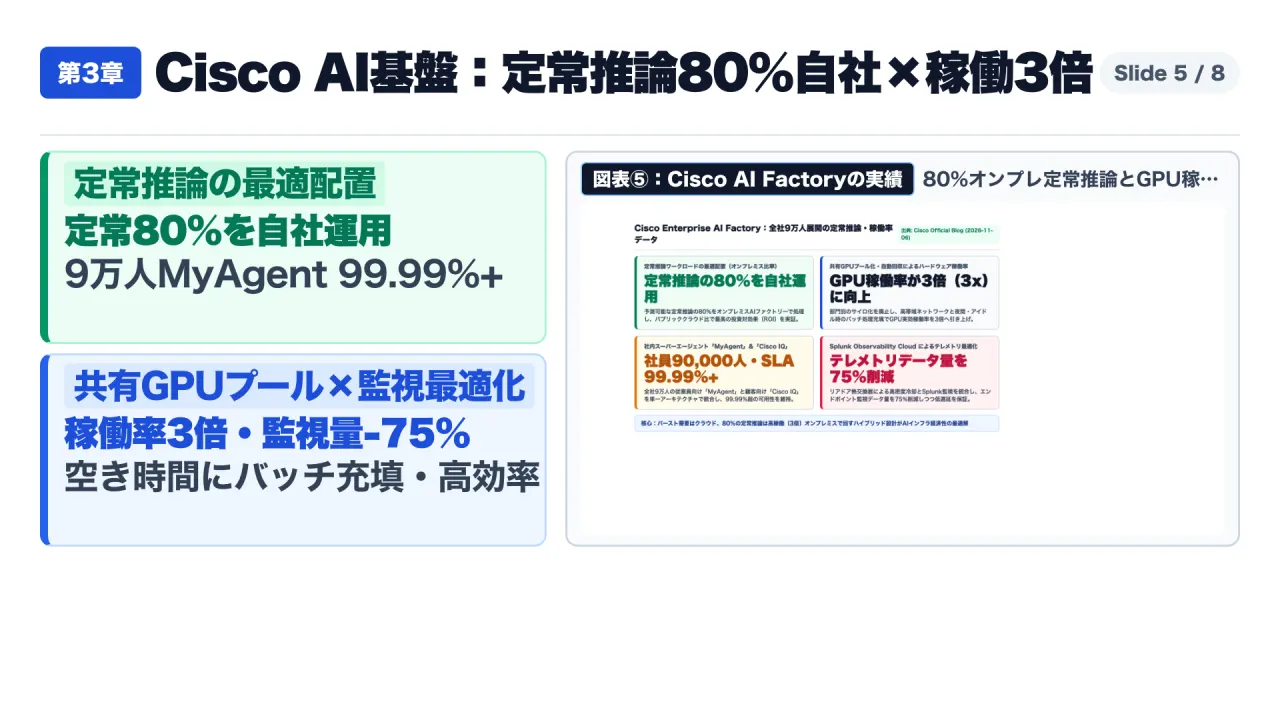
第3章では、こうしたAIモデルを企業内で大規模運用する際のインフラ経済学として、CiscoのIT部門バイスプレジデント Jon Woolwine氏とエンタープライズAIプラットフォーム担当バイスプレジデント Gregory Sylvester II氏が公式ブログで公開した『How Cisco Built an Enterprise AI Factory: Scaling Economics, Performance, and Security』(Cisco Official Blog)の実績データを検証します。
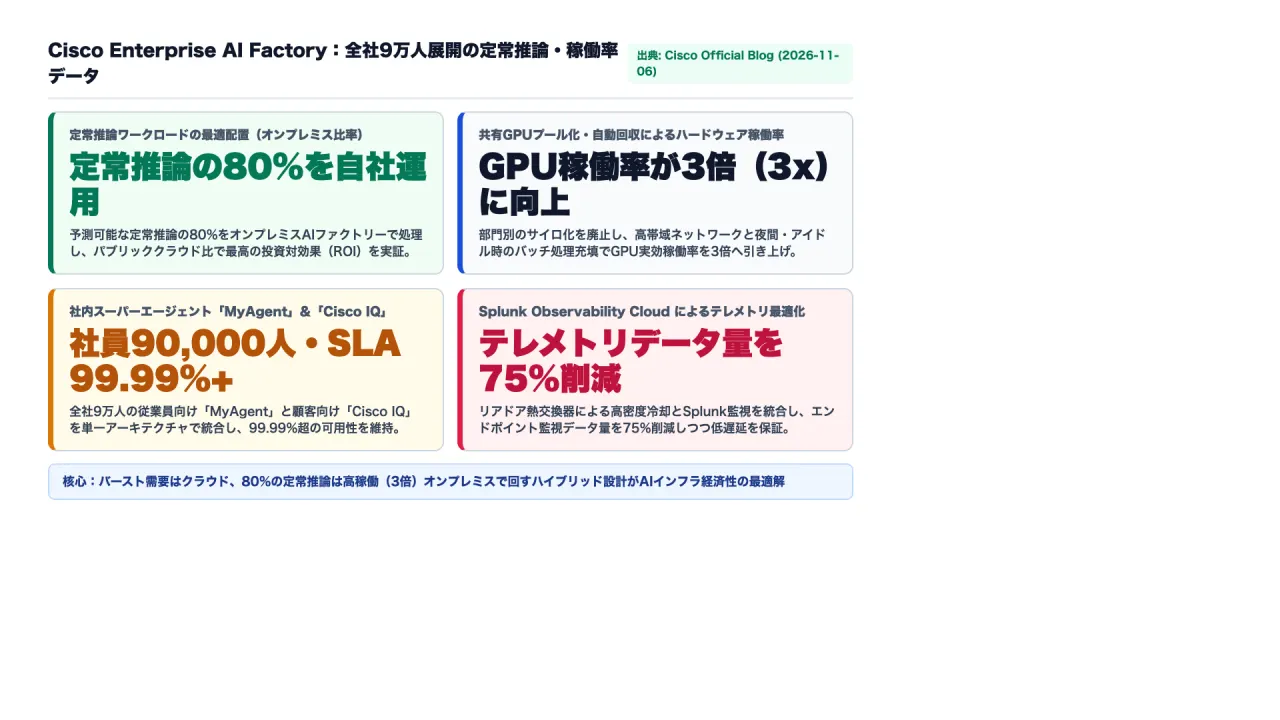
Ciscoは、社内 90,000人(9万人) の従業員が日常業務で利用するエンタープライズ・スーパーエージェント MyAgent と、外部顧客向けの Cisco IQ を単一の共通AIデータセンター基盤(Enterprise AI Factory)上に統合し、99.99%以上のサービス可用性(SLA) で本番稼働させています。この実運用から得られた知見は以下の3点に集約されます。
- 「定常推論の80%はオンプレミス運用」がもたらす最大のコスト効率:
- プロトタイプ開発や突発的なバースト需要にはパブリッククラウドの弾力性が有効ですが、全社9万人が毎日使うエージェントの推論は「予測可能な定常状態(steady-state)」のワークロードとなります。Ciscoは実測に基づき、定常推論ワークロードの80%を自社のオンプレミスAIファクトリーで処理し、残りのバースト分のみをクラウドへ逃がすハイブリッド構成 が最も高い投資対効果(ROI)を生むことを実証しました。
- サイロ廃止・自動GPU回収による「GPU実効稼働率3倍(3x)」の達成:
- 従来のオンプレミス運用が失敗する最大の原因は、部門やプロジェクトごとにGPUサーバーを固定割り当て(サイロ化)し、平均稼働率が15%程度に低迷することでした。Ciscoは Cisco Silicon One ベースの高帯域ネットワークファブリックで全GPUを単一の共有プールへ統合し、アイドル状態のGPUを自動的に回収する機能(Automated GPU reclaims)と、日中の対話型エージェント推論の谷間にバックグラウンドのバッチジョブを自動的に埋め込むスケジューリングを導入しました。これにより、GPU実効稼働率を従来の3倍(tripling GPU utilization) へと引き上げています。
- リアドア熱交換器による高密度冷却とSplunkによるテレメトリ75%削減:
- 高稼働化するGPUクラスタの熱対策としてリアドア熱交換器(rear-door heat exchangers)を導入するとともに、監視基盤には Splunk Observability Cloud を統合し、エンドポイントのテレメトリデータ量を 75%削減 しつつAI特有のレイテンシKPIとセキュリティガバナンスを維持しています。
5. 第4章:2028年「米国トークン純輸入国」予測とAnthropic 34億ドル自前ガス発電機買収の現実
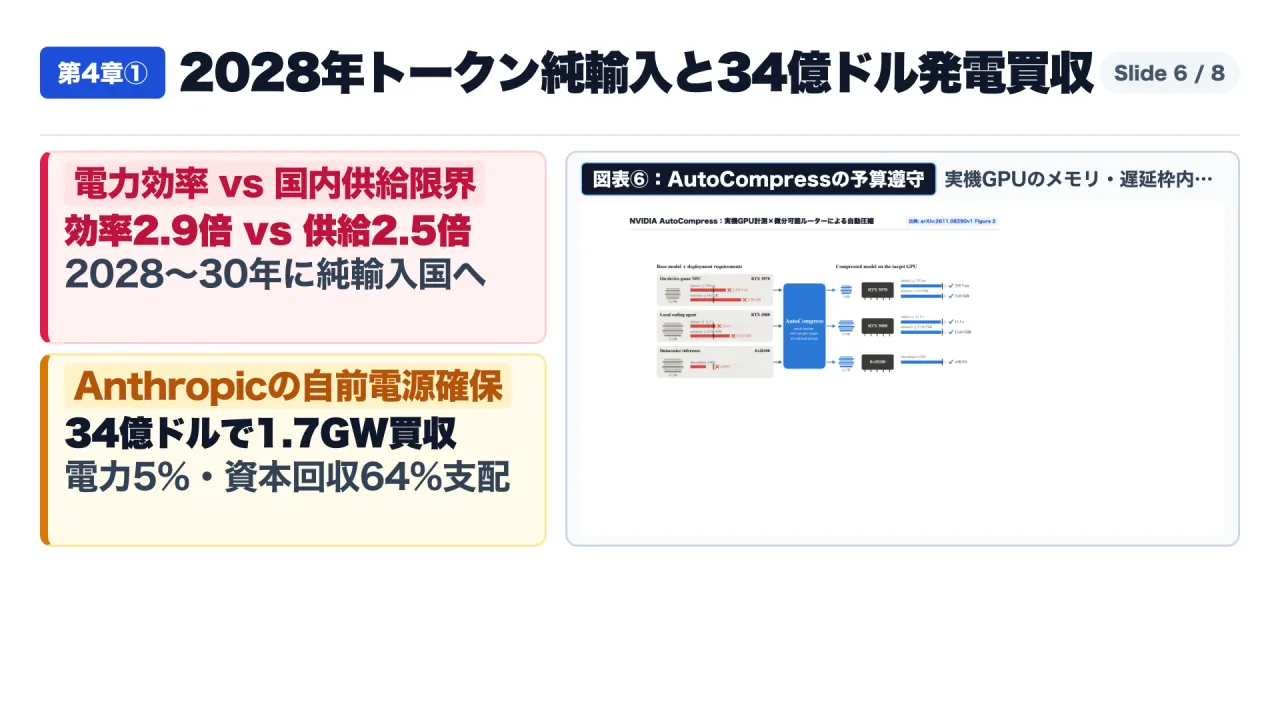
第4章では、なぜいまハードウェア特化・モデル圧縮・GPU稼働率3倍がこれほど死活問題になっているのか、マクロな電力網と計算資源市場の構造変化を、Theory VenturesのTomasz Tunguz氏による分析『When Does the US Become a Net Importer of Tokens?』(Tomasz Tunguz Blog)およびAnthropicの電源設備買収報道(daily.dev)から読み解きます。
米国データセンター電力需要66GW(+61%)と「トークン純輸入国」への転換点
Goldman Sachs Commodities Researchの調査によれば、米国のデータセンター電力需要は2025年の 31GW、2026年の 41GW から、2027年には 66GW(前年比+61%増) へと急膨張します。一方で、新世代チップの投入(NVIDIAのVera RubinがGB300比でワットあたりトークン効率5.4倍、GoogleのIronwoodがTrillium比2倍、AWSのTrainium3がTrainium2比4倍)により、1ワットあたりのトークン生成効率は年率約2.9倍 で複利向上しています。
しかし、米国内の送電網(グリッド)接続審査の渋滞や地域住民の反対、変圧器不足により、計画された米国内データセンターのうち予定通り稼働できるのは わずか55%(45%が遅延または中止) にとどまっています。その結果、米国内の電力インフラが支えられる実質トークン成長率は 年率2.5倍 が限界となります。Tunguz氏の需給モデルでは、以下の3つのシナリオすべてにおいて、米国は国内で消費するトークンを国内の電力だけでは生産しきれなくなり、レアアースと同様に 「トークンの純輸入国(海外のデータセンターで生成されたトークンを海底光ケーブル経由で輸入する国)」 へ転落します(ニューヨーク〜フランクフルト間の光通信往復遅延は88ミリ秒であり、推論の海外オフショアリングが物理的に成立します)。
- 計画施設の45%が接続失敗するケース(現状ペース): 2028年 に米国はトークン純輸入国へ転換
- 計画施設の中止率を20%まで改善したケース: 2029年 にトークン純輸入国へ転換
- 計画施設が100%遅延なく建設された理想ケース: それでも 2030年 にトークン純輸入国へ転換
GPU時間コストの「電力5% vs 資本回収64%」と、Anthropicの34億ドル発電機買収
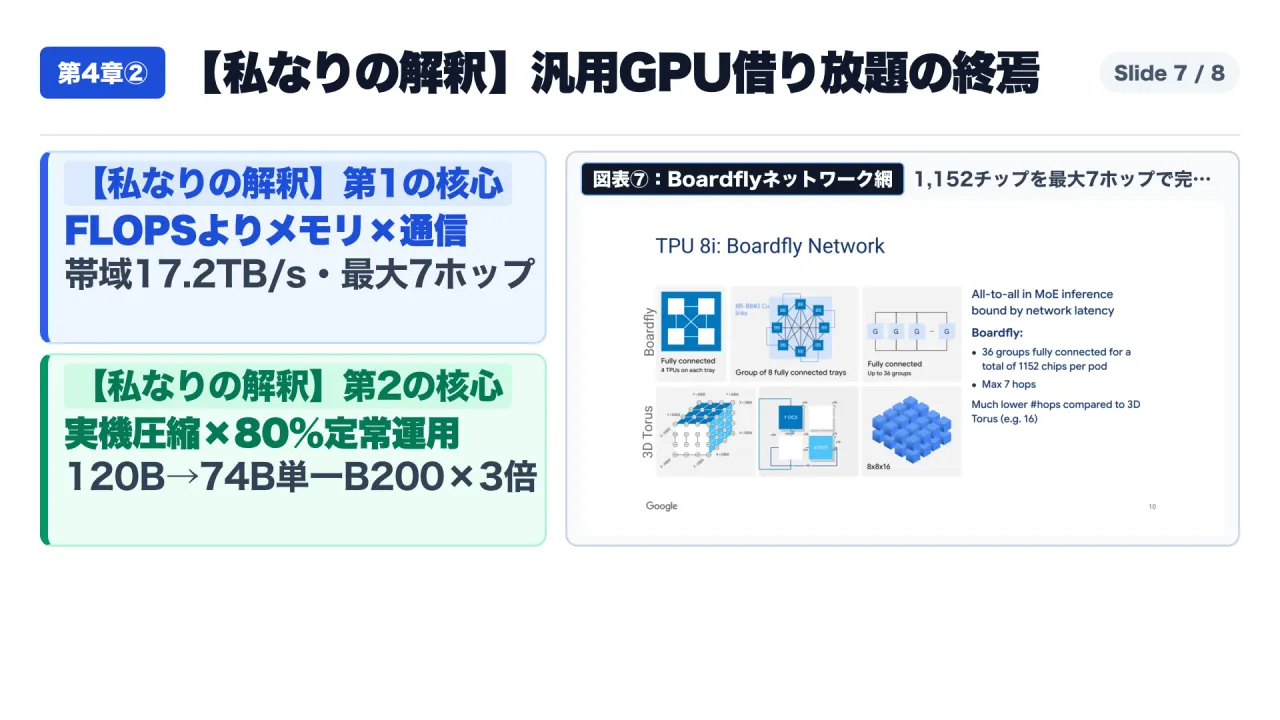
さらに重要な経済的ファクトが、GPU 1時間あたりコストの内訳です。Tunguz氏の試算によれば、GPU 1時間あたりの総コストのうち 「電力コスト」が占める割合はわずか5% にすぎず、実に 64%は「資本回収コスト(高価なGPUサーバー設備の減価償却と資本調達コスト)」 が占めています。具体的には、電力価格が1MWhあたり40ドル変動しても1GWあたり年間3.5億ドル($0.35B)の差にしかなりませんが、資本コストが6%から9%へ上がるだけで1GWあたり年間8.4億ドル($0.84B)もの負担増となります。
つまりAI企業にとって最大の財務リスクは「電気代が少し高くなること」ではなく、「電力が足りないせいで、巨額の資本を投じたデータセンターやGPUが稼働できず遊んでしまうこと」 なのです。実際、AnthropicのForm S-1/A開示によれば、同社の長期計算資源コミットメント総額は 8,950億ドル($895B) に達し、直近2四半期で短期バースト用GPUのレンタル価格は1時間あたり 3〜5ドルから12〜13ドル超(2026年10月のOrnn Compute Index決済値で12.29ドル)へと約3〜4倍に暴騰 しています。
大型ガスタービンが 2030年まで完売 する中、Anthropicがテキサス州サンアントニオのサプライヤー「OnePWR Solutions」(資金調達難に陥っていた企業)が約2年前に発注していた Caterpillar製大型天然ガス発電機 1.7GW分(および関連する設計・建設枠)を34億ドル($3.4B)で直接買い取った 理由はまさにここにあります。送電網の開通を何年も待つより、34億ドルで自前のガス発電機を押さえて即座にGPUを100%稼働させる方が、資本回収64%の経済構造において圧倒的に合理的だからです(なお、この1.7GWの発電機群が具体的にどのデータセンター拠点に設置され、いつ稼働を開始するかは一次資料上で 未確認 です)。
6. 結論:汎用インフラ依存を脱却し、明日から現場で実践する3つのアクションプラン
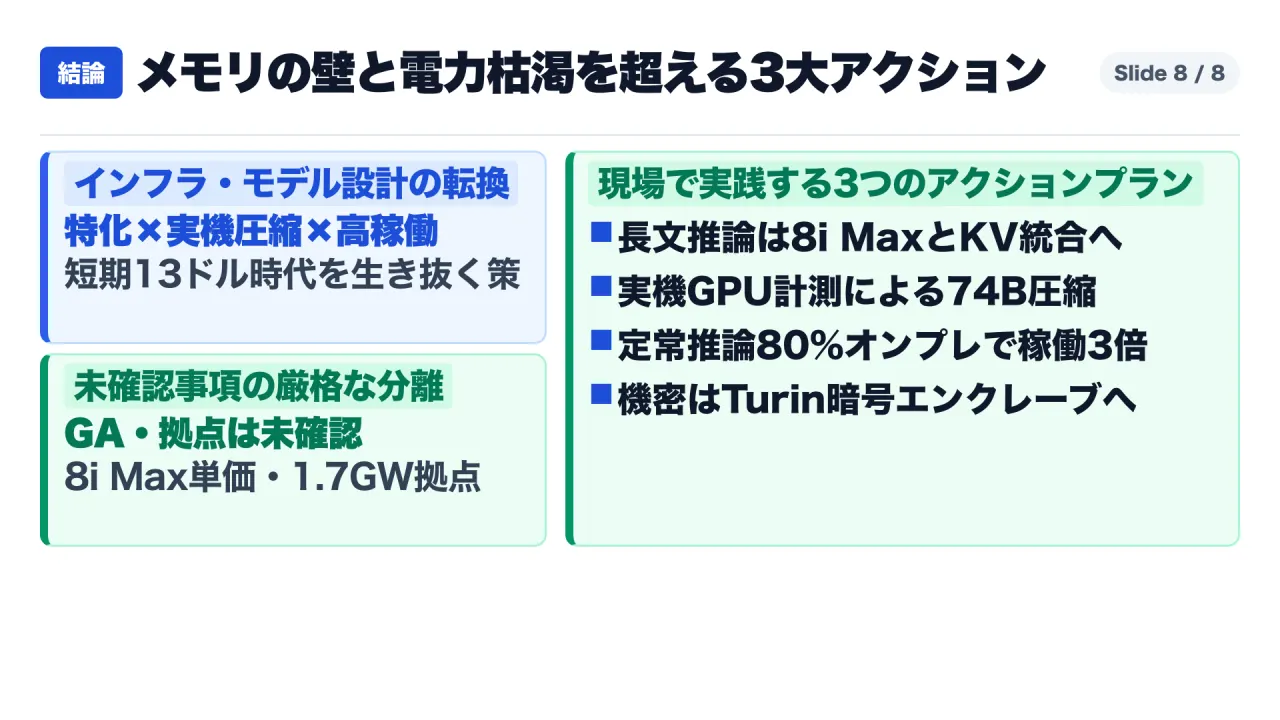
ここまでの一次資料の分析から明らかな通り、AIインフラの競争軸は「汎用GPUをクラウドでオンデマンド調達する」段階から、「①メモリ帯域と通信トポロジの特化(Google TPU 8i Max / 8tx)」「②ターゲット実機GPUに合わせた非一様モデル圧縮(NVIDIA AutoCompress)」「③定常推論80%のオンプレミス統合と稼働率3倍化(Cisco AI Factory)」 の3つを組み合わせる段階へと移行しました。
現場のエンジニアリング組織・インフラ責任者が直ちに着手すべき3つの実践ステップをまとめます。
- ステップ1:ワークロード特性に応じた特化型チップとメモリ階層(KVキャッシュ統合)の選定
- 着手条件: 長文ドキュメントの読解、マルチターン対話、MoEモデルの推論でレイテンシやVRAM不足が発生している場合。
- 実践内容: カタログ上のピークFLOPSだけでインスタンスを選ぶのをやめ、長文・エージェント推論には
TPU 8i Max(VMEM 768MB・HBM帯域幅17.2 TB/s・Boardfly最大7ホップ)やTPU SyncのようなKVキャッシュ階層化基盤を割り当て、機密データの微調整・推論にはAMD EPYC Turin搭載のTPU 8txのようなハードウェア暗号化エンクレーブを選定してください。
- ステップ2:「パラメータ数」ではなく「ターゲット実機GPUの遅延・実メモリ計測」に基づくモデル圧縮の導入
- 着手条件: 12B〜120Bクラスのオープンウェイトモデルを社内GPUやエッジ端末へデプロイする際、VRAM超過で複数GPUへの分割(Tensor Parallelism)を強いられている場合。
- 実践内容: 同じパラメータ数でも層の深さで実機遅延が35%変わり、理論メモリ式は実消費量の3分の1を見落とします。NVIDIA
AutoCompressの手法にならい、本番の推論エンジン(vLLM / TensorRT-LLM)とコンテキスト長・バッチサイズを固定した上で実機プロファイリングを行い、層ごとにFFN幅やMoEエキスパート数を削り出して知識蒸留(120B→74B化による単一GPU収納など)を実施してください。
- ステップ3:定常推論80%と突発バースト20%の切り分け、および共有GPUプールの高稼働化(稼働率3倍)
- 着手条件: 社内向けAIツールや顧客向けエージェントの利用が定着し、パブリッククラウドの推論API・オンデマンドGPU費用が毎月膨らみ続けている場合(短期GPUスポット価格が12〜13ドル/時へ高騰している現在、オンデマンド依存は極めて危険です)。
- 実践内容: Ciscoの
Enterprise AI Factoryが実証した通り、予測可能な定常推論の80%は予約インスタンスや自社統合GPUプールへ移行し、部門別のハードウェア固定割り当てを廃止してください。その上で、日中の対話推論の空き時間に夜間の要約・インデックス作成・蒸留などのバッチジョブを自動充填するスケジューリングを導入し、GPU実効稼働率を3倍へ引き上げてください。
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
動画での解説・自己紹介
- YouTubeポッドキャスト本編:なぜAI基盤は「メモリの壁」と「電力枯渇」で詰まるのか?──Google TPU 8i Max・NVIDIA AutoCompress・Ciscoが実証した特化・圧縮・高稼働の経済学
- 初めての方へ(固定自己紹介記事):なぜ海外一次資料の「原典」まで遡るのか──このnoteとポッドキャストの使い方