なぜAI利用24倍でもクラウド待機代と鍵漏洩を0にできるのか?
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜ会社のAIは「返事を待つだけの空白時間」でサーバー代が溶けるのか?2030年に利用量が24倍へ急増する時代に、0.5秒でAIを眠らせて同じ機械で10倍動かし、作業部屋のパスワードをゼロにする最新技術 40秒で要点がわかるショート動画はこちら:なぜAIが返事を待つ「空白の時間」を0.5秒で眠らせると、同じサーバーで「10倍多く」動かせるのか? #Shorts
AIを「人間が1回ずつ質問を入力するチャットツール」から「社内の書類を読み、外部システムを叩き、稟議や確認の返事を待ちながら自律的に仕事を進めるエージェント」へと移行させた瞬間、多くの開発・インフラ組織で3つの深刻な壁が立ちはだかります。
第1に**「返事待ちの空白時間によるサーバー代の浪費」**です。AIエージェントが外部APIの応答や人間の承認を待っている数秒〜数分の間も、従来のコンテナや仮想マシンはCPUとメモリを占領し続け、実質的に何も計算していない時間にクラウド費用が溶けていきます。
第2に**「長文の記憶(KVキャッシュ)の受け渡し渋滞」**です。数万文字の社内規定や対話履歴を毎回最初から読み直していては最初の返事(TTFT)までに何秒もかかり、かといってプロンプト処理用チップ(Prefill)から回答生成用チップ(Decode)へ記憶を受け渡そうとすると、チップ間の通信変換で数秒間の足止めが発生します。
第3に**「作業部屋(サンドボックス)へのパスワード・秘密鍵の持ち込みリスク」**です。AIが外部のWebページやメールを読んだ際、悪意のある隠し命令(プロンプトインジェクション)によって騙され、作業部屋の中に置かれた社内データベースのパスワードやAPIトークンを外部へ送信してしまう危険です。
この「利用量爆発」「記憶移動の渋滞」「待機資源の浪費」「秘密鍵の漏洩」という4つの課題を、経済予測とオープンソース/本番クラウド基盤の両面から一気に解き明かしたのが、Goldman Sachs Research の2030年トークン消費予測レポート(datePublished: 2026-05-20)、および Google Cloud が相次いで公開した3つの基盤技術――「TPU Sync」(datePublished: 2026-11-09:PCIe Gen5上限256GB/s中 223GB/s を達成しKV転送遅延を 90%以上削減[約230ms化])、「Agent Substrate 1.0」(datePublished: 2026-11-05:CNCF Sandbox #523 寄贈・GKE GA、休眠からの復元 500ms未満 でコンテナ収容密度 10倍)、そして 「Agent Compute Engine(ACE)」(datePublished: 2026-10-22:サンドボックス内の永続秘密鍵 ゼロ・4つの分離されたアイデンティティ とノード外 Agent Gateway での 通信途中トークン差し替え[in-flight token swap])です。
この記事では、これら6系統の一次資料と全16枚の検証図表(本編スライド8枚+一次資料公式図表8枚)をもとに、2030年に世界のAI利用量が 24倍(月間12京トークン) へ膨張する時代のシステム設計原則を徹底解説します。
1. 結論と対象読者:この記事で分かることと現場で実践できる行動
対象読者(いま直面している課題)
- 長文のシステムプロンプトや社内文書を扱うAIシステムを運用しており、最初の1文字が返るまでの待ち時間(TTFT)やアクセラレータ間のKVキャッシュ転送遅延を劇的に短縮したいAIアーキテクト・MLエンジニア
- Kubernetes(GKE等)上で多数の自律型AIエージェントやコード実行サンドボックスを動かしているが、外部API待ち・人間承認待ちのアイドル時間がサーバー資源を圧迫し、コンテナ収容密度と起動速度の壁にぶつかっているプラットフォームエンジニア
- AIエージェントに社内システムや外部SaaSの操作権限を委譲するにあたり、プロンプトインジェクションやコンテナ侵害による認証トークン・APIキーの漏洩を根本から防ぎたいセキュリティ責任者(CISO)・クラウド管理者
一次資料から導かれる4つの核心的結論
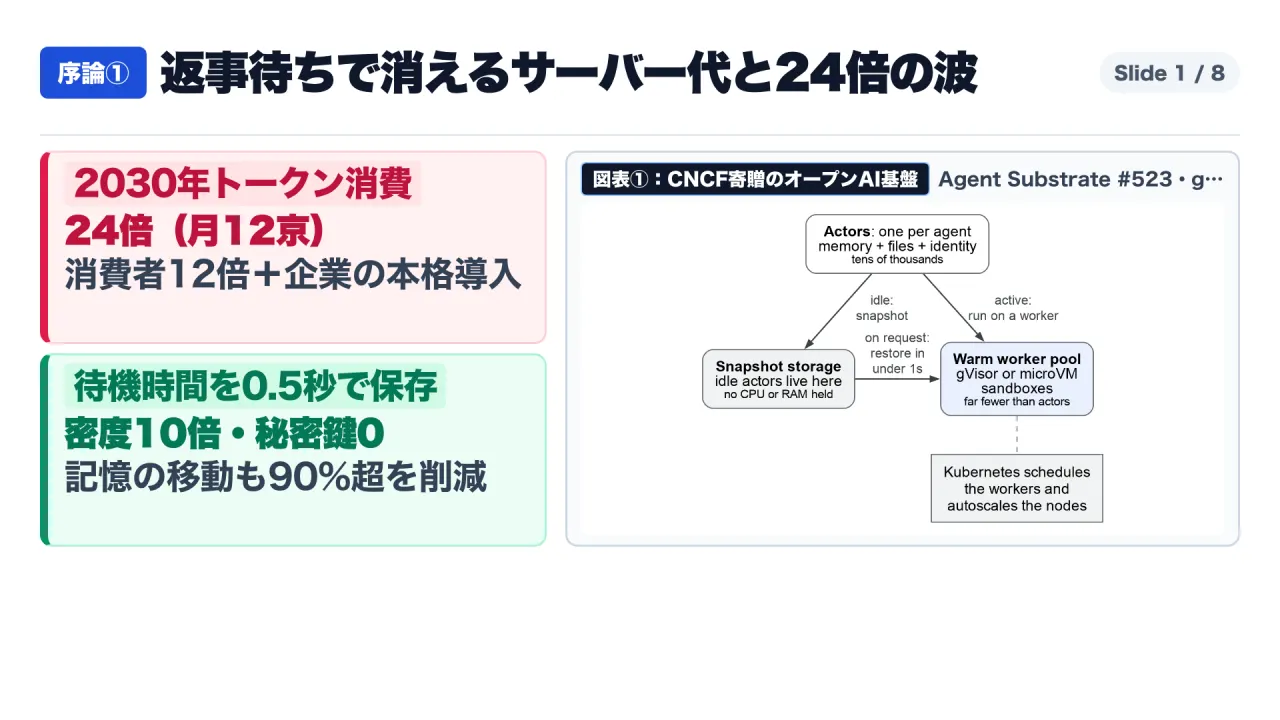
- Goldman Sachs Researchが示した「2030年トークン消費24倍(月間12京トークン)」と「推論単価 年60〜70%低下による粗利益率の転換点」:
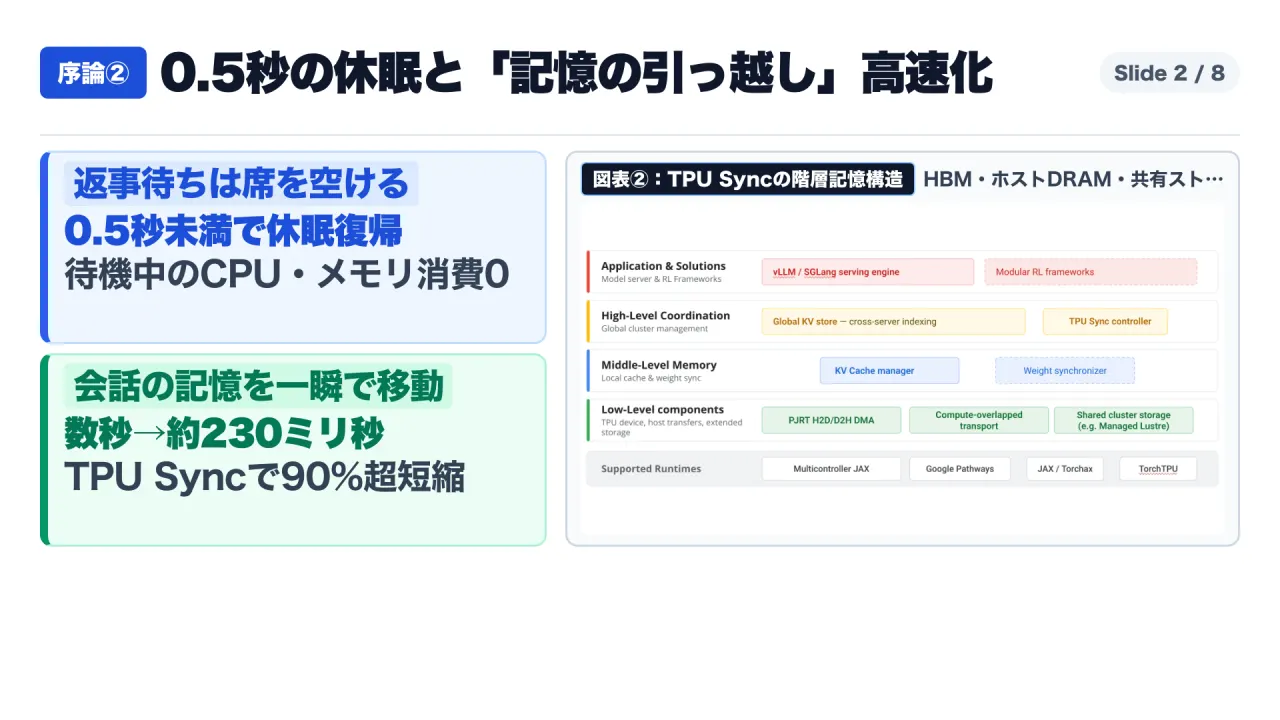
- Goldman Sachs Researchのシニア米国テクノロジー株アナリストであるJim Schneider氏のレポート(2026年5月20日公開)によれば、消費者向け利用の 12倍増 に企業での自律型AIエージェント導入が重なることで、世界のAIモデルにおけるトークン消費量は2026年から2030年の4年間で現在の 24倍、実数にして 月間120 quadrillion tokens(12京トークン:12の後ろに0が16個並ぶ規模) へ急拡大し、1日あたりのLLMクエリ数は 年平均40%(40% CAGR) で成長して2030年に 110億件(11 billion) に達します。
- 一方で、半導体メーカーが毎年投入する新世代チップの改良により、1トークンあたりの推論コストは 毎年60%〜70% のペースで急落しています。顧客向けトークン販売価格の値下げ速度よりも裏側の推論原価の下落速度が上回るため、今後 3〜12か月以内 にクラウド大手(ハイパースケーラー)のAI粗利益率は改善へ転じる「転換点(Gross Margin Inflection)」を迎えます。なお、欧米の知識労働者におけるエージェント型AIの利用率は2030年時点で 12%、2040年に 37% へと段階的に普及していく長期曲線が描かれています。
- Google「TPU Sync」によるPCIe Gen5実測223GB/s達成と、KVキャッシュ転送遅延90%超削減(約230ms化)・TTFT最大90%短縮:
- Google CloudがApache 2.0ライセンスでオープンソース公開したC++ネイティブ状態管理層
TPU Syncは、従来のPythonベース処理で発生していたデータ直列化と中間メモリコピーを廃止し、PJRTの生バッファ(Raw Buffer)を用いたDMA直接転送により、TPU v7x(Ironwood)実機でPCIe Gen5理論上限256GB/sのうち 223 GB/s(実効効率87%)、データセンターネットワーク(DCN)経由でも単一200G NICで 約192 Gbps、デュアル200G NICで 約350 Gbps を達成しました。 - これにより、プロンプト処理(Prefill)と回答生成(Decode)を別チップに分けるP/D分離推論において、
Qwen3 235BのKVキャッシュ転送時間は数秒から 約230ミリ秒へと90%以上削減 され、最初の1文字が出るまでの時間(TTFT)はQwen3 235Bで 60%短縮、Qwen3 Coder 480Bおよび64K長文プレフィックスキャッシュ環境では 90%短縮、スループットは 30%〜70%向上(64K環境で 50%超向上・P99トークン間遅延 30%削減)を記録しました。
- Google CloudがApache 2.0ライセンスでオープンソース公開したC++ネイティブ状態管理層
- CNCF寄贈「Agent Substrate 1.0」による「500ミリ秒未満の休眠・復元」と「コンテナ収容密度10倍」:
- Google CloudがGKE上で一般提供(GA)を開始し、同時にCNCF Sandbox(PR
#523)へ寄贈したAgent Substrate 1.0は、ステートフルな対話・記憶状態を持つActorsとポリシー制御を行うGatewaysを、事前ウォームアップされたKubernetes実行プールWorkersから完全に切り離しました。 - ツール応答待ちや人間の入力待ちに入ったエージェントの状態を即座にストレージへスナップショット保存して計算機を解放し、応答が返った瞬間に 500ミリ秒(0.5秒)未満 で復元することで、200,000体(20万体) のエージェント環境で 毎秒500回の起動(500 activations/sec) を持続しつつ、同一ハードウェアあたりの コンテナ収容密度10倍(10x container density) を実現しています。
- Google CloudがGKE上で一般提供(GA)を開始し、同時にCNCF Sandbox(PR
- 「Agent Compute Engine(ACE)」のハードウェア分離マイクロVMと「作業部屋の永続秘密鍵ゼロ・4段階アイデンティティ」:
- Geminiの本番環境を支える
Agent Compute Engine(ACE)は、カスタムセキュリティチップTitanとTitanium IPUによるハードウェア信頼の基点(Root of Trust)、dm-verity読み取り専用ホストOS、直接ネットワークカードを持たないマイクロVM隔離を採用しています。 - 最大の革新は、「エージェントが動くサンドボックスのメモリにもディスクにも、永続的な秘密鍵や認証トークンを一切置かない(Zero persistent secrets)」 という設計です。アイデンティティを① User identity、② Delegated Agent on-behalf-of Identity、③ SPIFFEベースの短命な Agent Workload Identity(ID-3)、④ Agent Workforce Identity の4つに厳格分離し、サンドボックスからの通信には短命な
ID-3のみを付与して、ノード外のAgent Gatewayを通過する瞬間に外部アクセス用トークンへ差し替えるin-flight token swapを実行します。
- Geminiの本番環境を支える
2. 第1章:Goldman Sachs「月12京トークン(24倍)」予測と、単価年60〜70%減がもたらす粗利益率の転換点
Goldman Sachs ResearchのJim Schneider氏が公開した調査レポート『AI agents are forecast to boost tech cash flow as usage soars』(Goldman Sachs Insights、datePublished: 2026-05-20)は、AIインフラ投資に対する市場の懐疑論(「巨額の設備投資に対して本当に収益が伴うのか」)に対し、トークン消費量と推論原価の双方から明確な定量モデルを提示しました。
なぜトークン消費量は2026年から2030年の4年間で「24倍(月間12京トークン)」に跳ね上がるのか
レポートが算出した最も重要な数字は、世界のAIモデルにおけるトークン消費量が2026年から2030年の4年間で現在の 24倍 に拡大し、月間120 quadrillion tokens(12京トークン:12の後ろに0が16個並ぶ桁) に到達するという予測です。
この24倍という急膨張の内訳を見ると、まず消費者向け(コンシューマー側)の利用だけでも2030年までに 12倍 に増えると試算されています。さらにそこへ、企業における自律型AIエージェントの本格稼働が乗算されます。1日あたりのLLMクエリ数は2030年まで 年平均40%(40% CAGR) で増え続け、全世界で 1日110億件(11 billion daily queries) に達します。
なぜ人間の数が増えるわけではないのに、ここまでの爆発が起きるのでしょうか。その理由は、人間がチャット画面に1文を入力して1文の回答を読む「1往復1回」のやり取りから、**「人間の1回の指示をきっかけに、AIエージェントが裏側で何十回も連続して資料を検索し、推論を回し、プログラムを実行して検証する」**という多段階ループへ移行するためです。
同時にレポートは、企業現場での普及スピードについて冷静な現実も示しています。米国および欧州の知識労働者(Knowledge Workers)のうち、日常業務でエージェント型AIを本格活用している人の割合は、2030年時点では12% にとどまり、その10年後の 2040年にかけて37% へ拡大していくと予測されています。つまり、まだ知識労働者の約8人に1人しか使っていない2030年の段階ですら、1人あたりのAI呼び出し回数と読み込む文脈長が桁違いに増えるため、社会全体のトークン消費量は24倍に達するのです。
| 指標項目 | Goldman Sachs Research 予測数値 | 背景メカニズム・備考 |
|---|---|---|
| 2030年の世界月間トークン消費量 | 月間 12京トークン(120 quadrillion / 現在の24倍) | 12の後ろに0が16個並ぶ規模 |
| 消費者向け(Consumer)利用の伸び | 2030年までに 12倍(12x) | 検索・日常アシスタント・マルチモーダル常時利用の拡大 |
| 1日あたりLLMクエリ数(2030年) | 1日 110億件(年平均成長率 40% CAGR) | 単発質問から自律エージェントの連続ツール呼び出しへ移行 |
| 欧米知識労働者のエージェント利用率 | 2030年に 12% → 2040年に 37% | 企業導入は10〜15年単位の長期普及曲線を描く |
| 1トークンあたり推論コストの低下率 | 年率 60%〜70% 削減 | 半導体メーカーの新世代チップ投入とシステムソフトウェア最適化 |
| ハイパースケーラー粗利益率の転換点 | 今後 3〜12か月以内(Gross Margin Inflection) | 販売単価の値下げ速度よりも裏側の推論原価低下速度が上回る |
半導体世代交代による「年60〜70%の原価低減」と利益率の転換点
利用量が24倍に増えるなら、クラウド企業や導入企業のコストも24倍に膨れ上がって破綻するのではないか――そう考えるのが自然です。しかしJim Schneider氏の分析は、正反対の結論を導き出しています。
半導体プロバイダーが毎年のように新しいアーキテクチャのAIチップを市場へ投入し、そこにソフトウェア側の効率化が加わることで、1トークンあたりの推論計算コストは毎年60%〜70%のペースで急激に低下 しています。
クラウド各社が顧客に請求するAPI料金(販売価格)も下がっていますが、現在起きているハードウェア・ソフトウェアの世代交代による「裏側の原価低減スピード(年60〜70%減)」は、販売価格の値下げスピードを上回っています。その結果、これまで巨額の減価償却費に圧迫されていたクラウド大手(ハイパースケーラー)のAI事業の粗利益率は、今後3〜12か月以内に底を打って改善へ向かう「粗利益率の転換点(Gross Margin Inflection)」 を迎えると予測されています。
ただし、この「1トークンあたりの原価を毎年60〜70%下げる」という数字は、ただ新しい半導体を買ってきて古い設計のまま並べるだけでは決して達成できません。長大な文脈の記憶(KVキャッシュ)の通信詰まりを解消し、エージェントの待機時間における計算資源の空転をゼロにするソフトウェア基盤の刷新が不可欠です。その具体的な回答が、次章から解説するGoogle Cloudの3大技術です。
3. 第2章:TPU Sync──PCIe Gen5実測223GB/sでKVキャッシュ転送遅延を90%超削減(約230ms化)するC++状態管理層
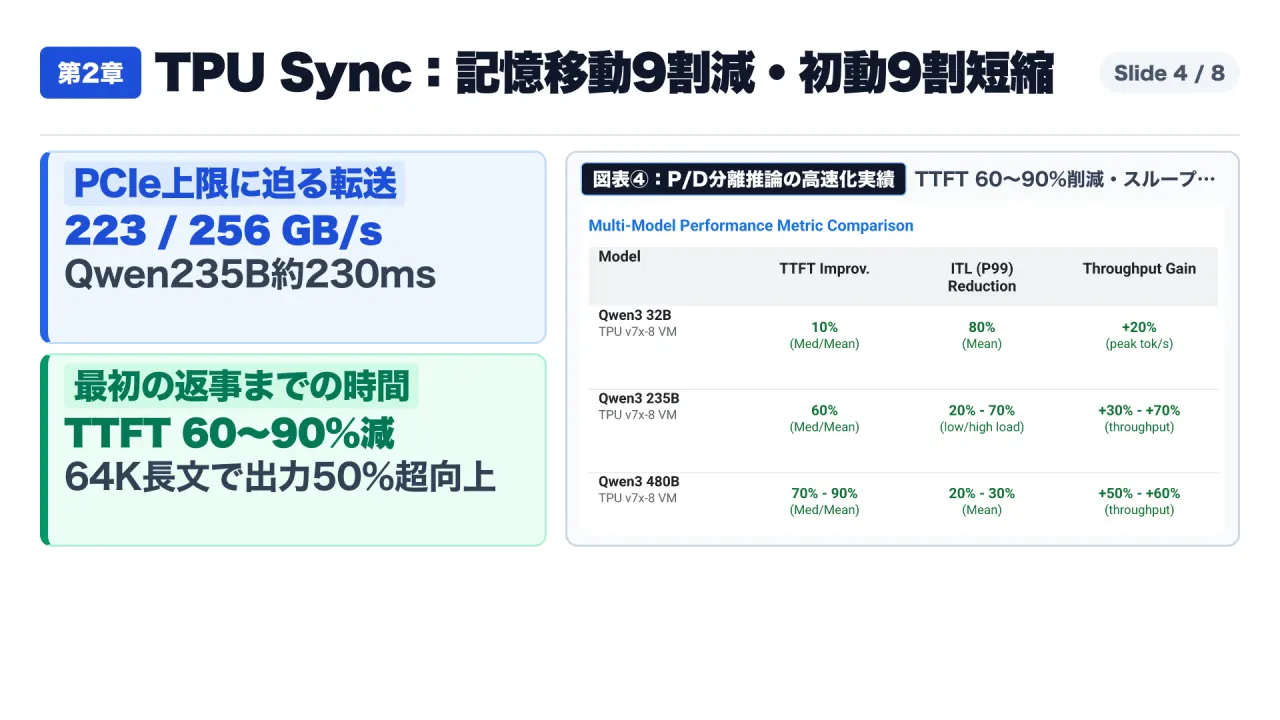
2026年11月9日、Google CloudはAI推論における「記憶の引っ越し渋滞」を根本から解消するオープンソースのC++モデル状態管理レイヤー 「TPU Sync」 を発表しました(公式ブログ:『Introducing TPU Sync: Fast KV cache and weight transfer on TPU』、datePublished: 2026-11-09、GitHub:https://github.com/google/tpu-sync、Apache 2.0ライセンス)。
なぜ長文推論と「P/D分離(Prefill / Decode Disaggregation)」で通信が詰まるのか
大規模言語モデル(LLM)や自律型エージェントの推論は、大きく2つのフェーズに分かれます。
- Prefill(プロンプト処理フェーズ): 入力された数万トークンのシステム指示書、社内ドキュメント、過去の会話履歴を一気に読み込み、各層のAttention状態である KVキャッシュ(Key-Value Cache) を計算する工程(演算密度が高い Compute-bound)。
- Decode(回答生成フェーズ): 計算されたKVキャッシュをメモリから毎ステップ読み出しながら、回答を1トークンずつ順番に生成していく工程(メモリ帯域幅が律速する Memory-bandwidth-bound)。
近年の本番推論基盤では、この性質の異なる2つの工程を同じチップで混ぜて動かすと互いの足を引っ張るため、「Prefill専用チップ群」と「Decode専用チップ群」を物理的に分ける「P/D分離(Prefill/Decode Disaggregation)」 や、共通のシステムプロンプトのKVキャッシュをホストメモリや共有ストレージに保存して再利用する 「階層型プレフィックスキャッシング(Tiered Prefix Caching)」 が標準となっています。
ところが、従来のPythonベースの推論フレームワーク実装では、TPUのチップ上メモリ(HBM)にあるKVキャッシュをホストCPUのメモリ(DRAM)や別ホストのTPUへ転送しようとすると、Pythonオブジェクトの直列化(シリアライズ)や中間バッファへの複数回のメモリコピーが発生し、PCIeバスやネットワークの物理帯域幅をまったく使い切れずに**「数秒間の転送待ち」**が発生していました。
4階層の記憶統合と「PJRT生バッファDMA」による223 GB/s(上限256GB/sの87%)達成
TPU Sync は、このボトルネックを解消するため、Inferact(vLLM-TorchTPU の KVConnector 統合)、RadixArk(SGLang-TorchTPU の階層型KVキャッシュおよびRL重み同期統合)、および llm-d コミュニティ(llm-d 1.0)との共同設計により、ゼロからC++で構築されました。
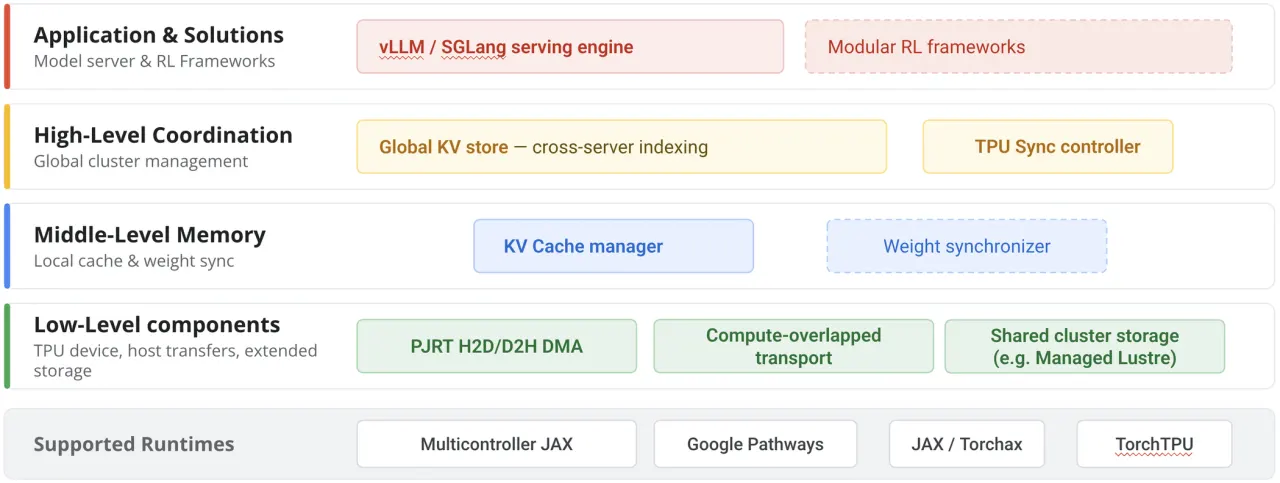
TPU Sync は以下の4つの記憶階層を単一の非同期APIで統合します。
- Tier 1(チップ上メモリ): TPU HBM(高帯域幅メモリ)
- Tier 2(ホストメモリ): ホストCPU側のピン留めされたメインメモリ(Pinned Host DRAM)
- Tier 3(永続・共有ストレージ): ローカルNVMe SSDおよび Google Cloud Managed Lustre
- Multi-host DCN: データセンターネットワーク(gRPCおよびゼロコピーTCPソケット)を介した別ホストのTPU・CPUメモリ間ストリーミング
Pythonのオーバーヘッドや中間コピーを完全にバイパスし、XLA/PJRTランタイムの生バッファ(Raw Buffer)に対して直接DMA(Direct Memory Access)転送を行うことで、2026年7月に実施されたGoogle社内ベンチマーク(TPU v7x[Ironwood]、2x2x1 トポロジ、tpu-inference v0.24.0 使用)において以下の圧倒的な実測帯域を記録しました。
- HBM ⇔ ホストDRAM間(PCIe Gen5経由): ハードウェア理論上限 256 GB/s のうち、実測 223 GB/s(実効効率 約87.1%) を達成。
- マルチホストDCN経由のデバイス・ツー・デバイス転送: 単一の200G NIC構成で 約192 Gbps(~192 Gbps)、デュアル200G NIC構成で 約350 Gbps(~350 Gbps) のワイヤスピードに近いストリーミング転送を達成。
実測ベンチマーク:Qwen3 235Bで転送遅延90%超削減(約230ms)、480B・64K長文でTTFT 90%短縮
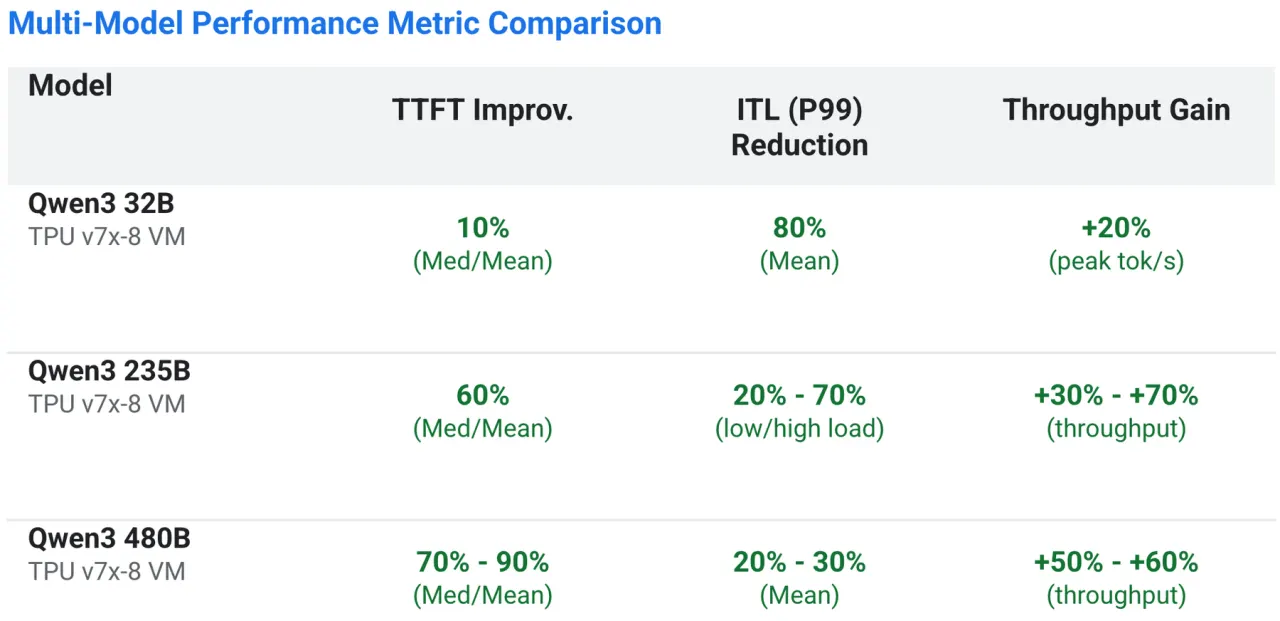
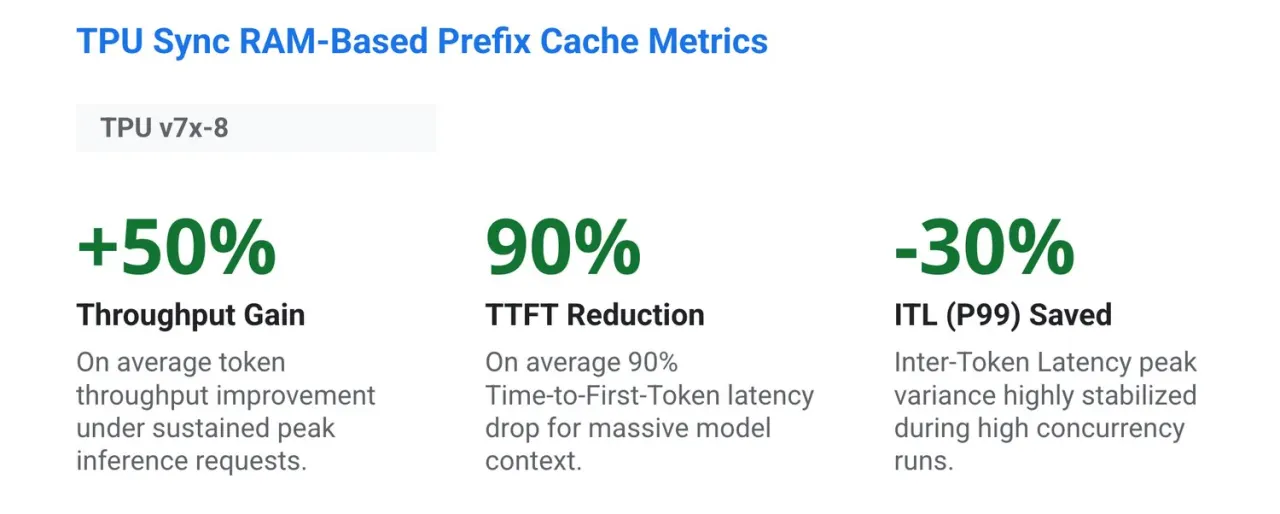
上の公式ベンチマーク図(Figure 2)と下の64K長文キャッシュ検証図(Figure 3)が示す通り、TPU Sync の導入によって本番ワークロードの性能は劇的に改善しました。
| 検証シナリオ・対象モデル | 従来方式の課題 | TPU Sync 導入後の実測結果 | 改善幅(一次資料記載値) |
|---|---|---|---|
P/D分離 KVキャッシュ転送遅延(Qwen3 235B) |
Pythonベース転送で 数秒間(several seconds) の停滞 | 約230ミリ秒(~230 ms) へ短縮 | 90%以上削減(over 90% reduction) |
P/D分離 初回応答時間 TTFT(Qwen3 235B) |
Prefill/Decode混在または転送待ちによる高遅延 | 最初の1文字までの待ち時間を大幅圧縮 | TTFT 60%削減 / スループット 30%〜70%向上 |
超大規模モデル P/D分離 TTFT(Qwen3 Coder 480B) |
480B規模の巨大KVキャッシュ移動がボトルネック | C++生バッファ直接転送により高速受け渡し | TTFT 最大90%削減 |
| 64K長文 階層型プレフィックスキャッシュ(Host DRAMオフロード) | 長文の共通指示を毎回再計算するかHBMが溢れる | Host DRAMから 223 GB/s でKVキャッシュを即座に再装填 | TTFT 90%削減 / スループット 50%超向上 / P99 ITL(トークン間遅延)30%削減 |
強化学習(RL)の重み同期(SGLang-TorchTPU / OpenRL) |
学習器(Trainer)から推論器(Rollout)への重み配布で停止 | DCN経由の高速ストリーミングで学習済み重みを即時同期 | ロールアウト待機時間の最小化 |
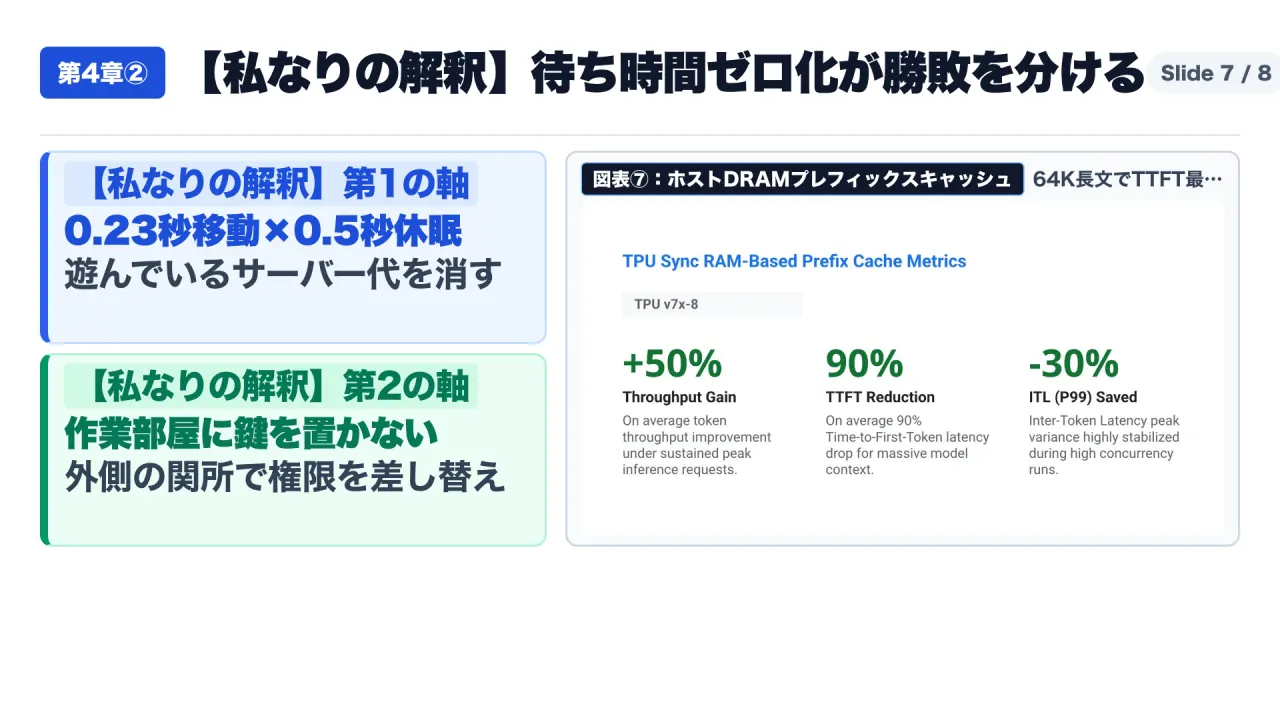
実務において特に重要なのは、**「64Kトークン(日本語で約5万〜6万文字)の共通システム指示や社内マニュアルを扱う際、ホストCPUのDRAMにKVキャッシュを逃がしておけば、高価なチップのHBMを消費せずにTTFTを90%削り、同じチップで1.5倍以上のリクエストを捌ける」**という点です。
4. 第3章:Agent Substrate 1.0──「500ms未満の休眠・復元」でコンテナ収容密度10倍を実現するCNCF標準基盤
チップ間の記憶移動と並んで、自律型AIエージェントの運用コストを圧迫している最大の要因が**「エージェントの返事待ち(アイドル時間)によるサーバー資源の空転」**です。
この問題を解決するため、Google Cloudは2026年11月5日、GKE(Google Kubernetes Engine)上で 「Agent Substrate 1.0」 の一般提供(GA)を開始するとともに、そのコア技術をCloud Native Computing Foundation(CNCF)のSandboxプロジェクト(PR #523)としてオープンソース寄贈しました(公式ブログ:『Open infrastructure for autonomous agents comes to CNCF』、datePublished: 2026-11-05)。
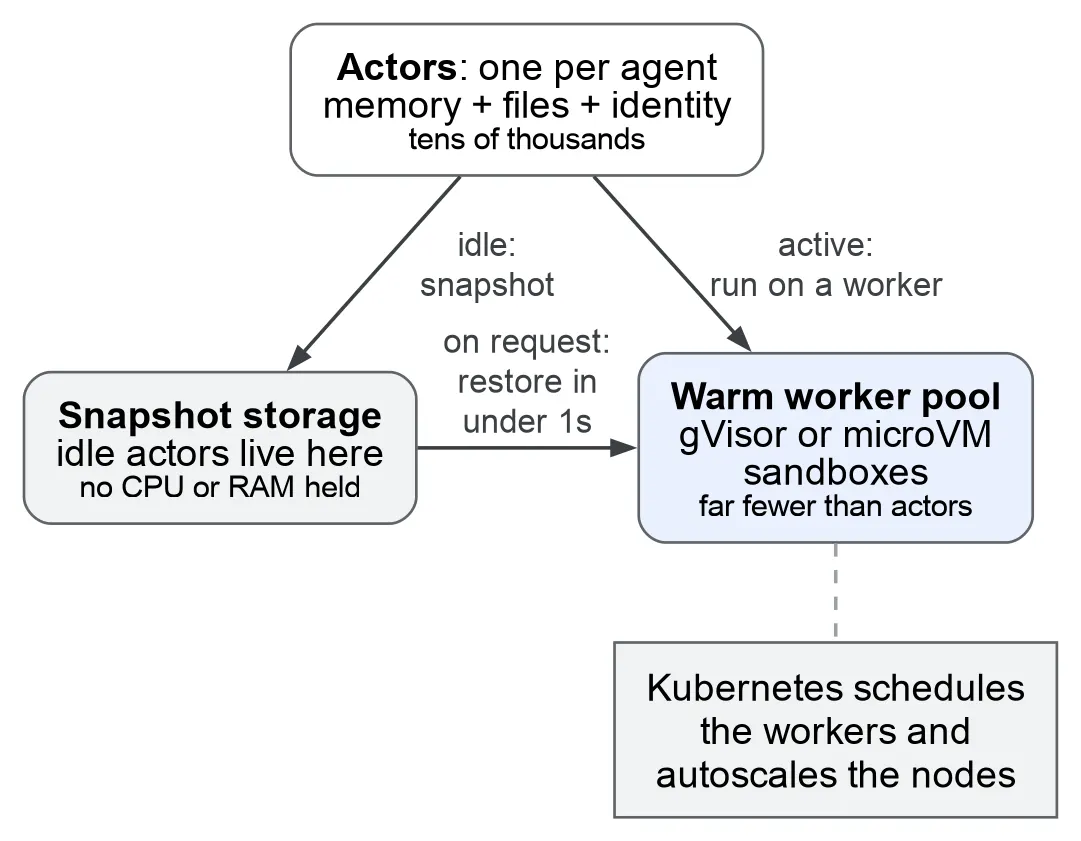
なぜ従来のKubernetesコンテナでは「返事待ちのエージェント」で破産するのか
従来のWebアプリケーション(ステートレスなマイクロサービス)では、1つのHTTPリクエストが数ミリ秒〜数百ミリ秒で完結するため、少数のコンテナで何千人ものリクエストを順番に処理できました。
しかし自律型AIエージェントは、以下のような**「長時間のステートフルな対話と待機」**を繰り返します。
- ユーザーから課題を受け取り、計画を立てて作業用サンドボックス内にファイルを生成する(数秒間のアクティブ計算)。
- 外部の検索APIや社内データベース、別の専門エージェントに問い合わせを投げ、数秒〜数十秒間、返事を待つ。
- 重要な変更(コードのマージや発注処理など)の前に人間に確認メッセージを送り、数分〜数時間、人間が承認ボタンを押すのを待つ。
もしエージェント1体ごとに専用のコンテナや仮想マシンを立ち上げっぱなしにすると、全体の90%以上を占める「ただ返事を待っているだけの空白時間」にもCPUとRAMが予約・占有され続け、サーバー代が10倍に膨れ上がります。逆に、待機するたびにコンテナを完全に削除(Scale-to-Zero)してしまうと、次に返事が来たときにコンテナのイメージ取得・起動・ライブラリ読み込み・作業状態の再構築に数秒〜数十秒のコールドスタート遅延が発生し、実用になりません。
「Actors・Gateways・Workers」の3層分離と500ms未満のスナップショット復元
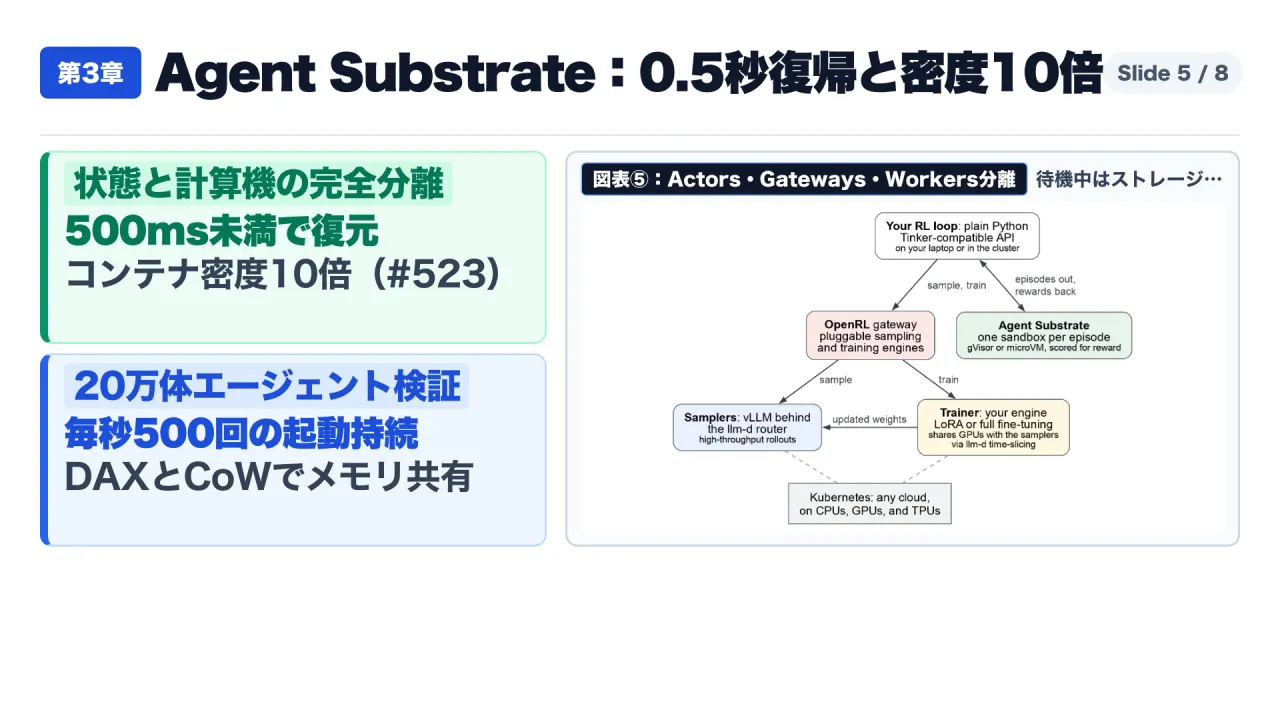
上の公式アーキテクチャ図(Figure 2)が示す通り、Agent Substrate 1.0 はエージェントの「状態(State)」と「計算機(Compute)」を以下の3つのプリミティブに完全分離することで、このジレンマを解決しました。
Actors(ステートフルな論理エージェント単位):- 各エージェント固有の会話履歴、メモリ状態、進行中のタスク文脈を保持する論理エンティティです。
Gateways(ルーティング・ポリシー・認証制御層):- 外部からのイベント、ツール応答、人間の返信を受け取り、ポリシー検査と認証を行った上で対象の
Actorを呼び起こします。
- 外部からのイベント、ツール応答、人間の返信を受け取り、ポリシー検査と認証を行った上で対象の
Workers(事前ウォームアップされたKubernetes実行プール):- 実際にプログラムや推論コードを実行する、起動済み(Warm)のコンテナ・サンドボックス群です。
Agent Substrate 1.0 上では、ある Actor(エージェント)が外部APIの応答待ちや人間の入力待ちに入った瞬間、そのメモリと実行状態がストレージへ高速スナップショット保存(休眠)され、割り当てられていた Worker は即座に解放されて別のアクティブなエージェントの計算に回されます。そして外部から返事が届いた瞬間、Gateway が空いている Worker にスナップショットを流し込み、500ミリ秒(0.5秒)未満 で元の作業状態へ完全に復元します。
Google Cloudが公開した実測値は以下の通りです。
- 休眠からの状態復元レイテンシ: 500ミリ秒未満(under 500 milliseconds)
- 大規模スケール検証: 200,000体(20万体) のエージェントが存在する環境下で、毎秒500回の起動・復元(500 activations per second) を安定持続
- リソース効率(コンテナ収容密度): 従来の常時起動コンテナ方式と比較して、同一サーバー台数あたり 10倍のコンテナ収容密度(10x container density) を達成
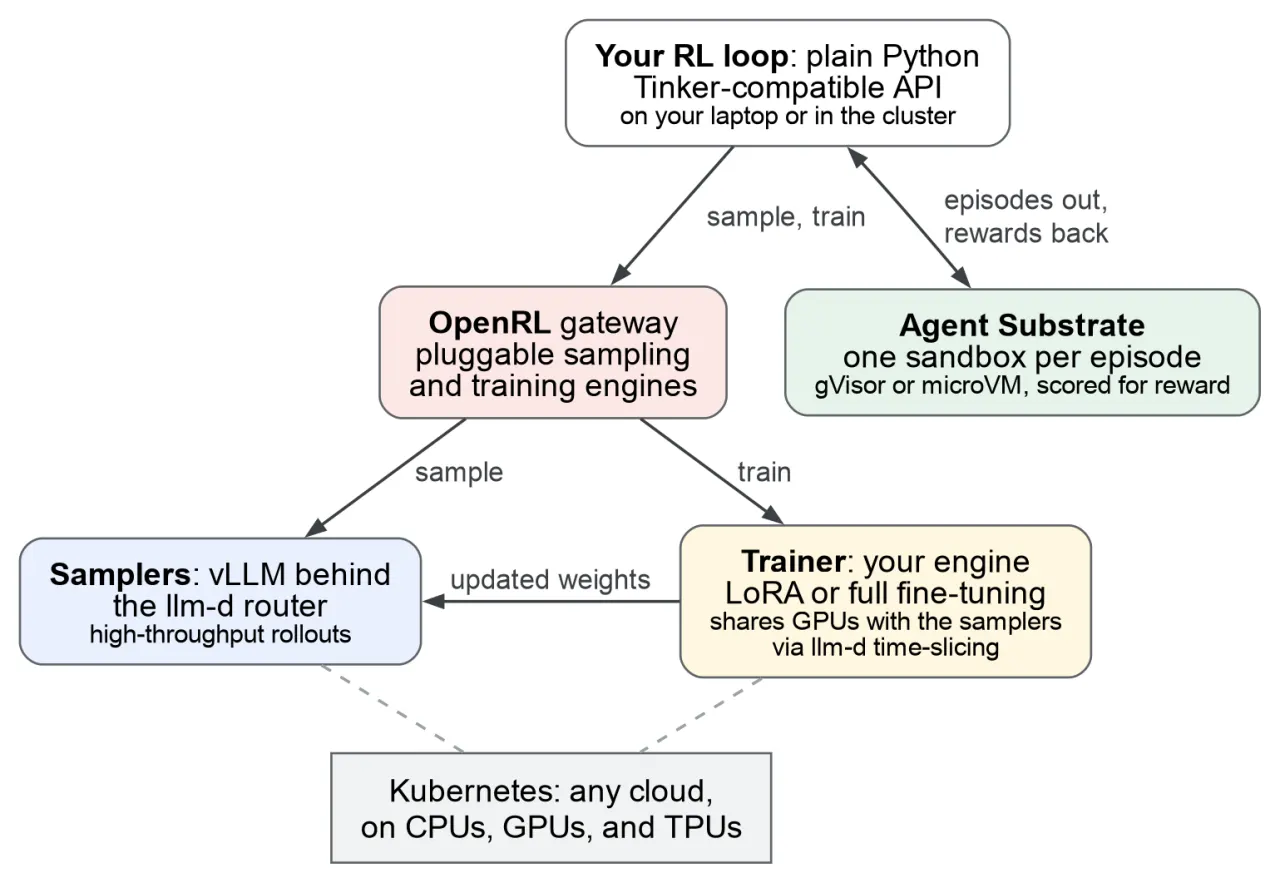
さらに今回のCNCF発表では、Agent Substrate 1.0(PR #523)と同時に、コンテナ隔離カーネル gVisor(PR #521)、強化学習ワークロード管理 OpenRL(PR #518)、および同一コホートの分散実行基盤 KubeRay(PR #525)が揃ってCNCF Sandboxへ提案・統合されており、ベンダーロックインのないオープンな標準仕様としてGKE以外のKubernetes環境でも利用できる体制が整えられました。
5. 第4章:Agent Compute Engine(ACE)──「作業部屋の秘密鍵ゼロ」と4段階ID・関所トークン差し替えの深層構造
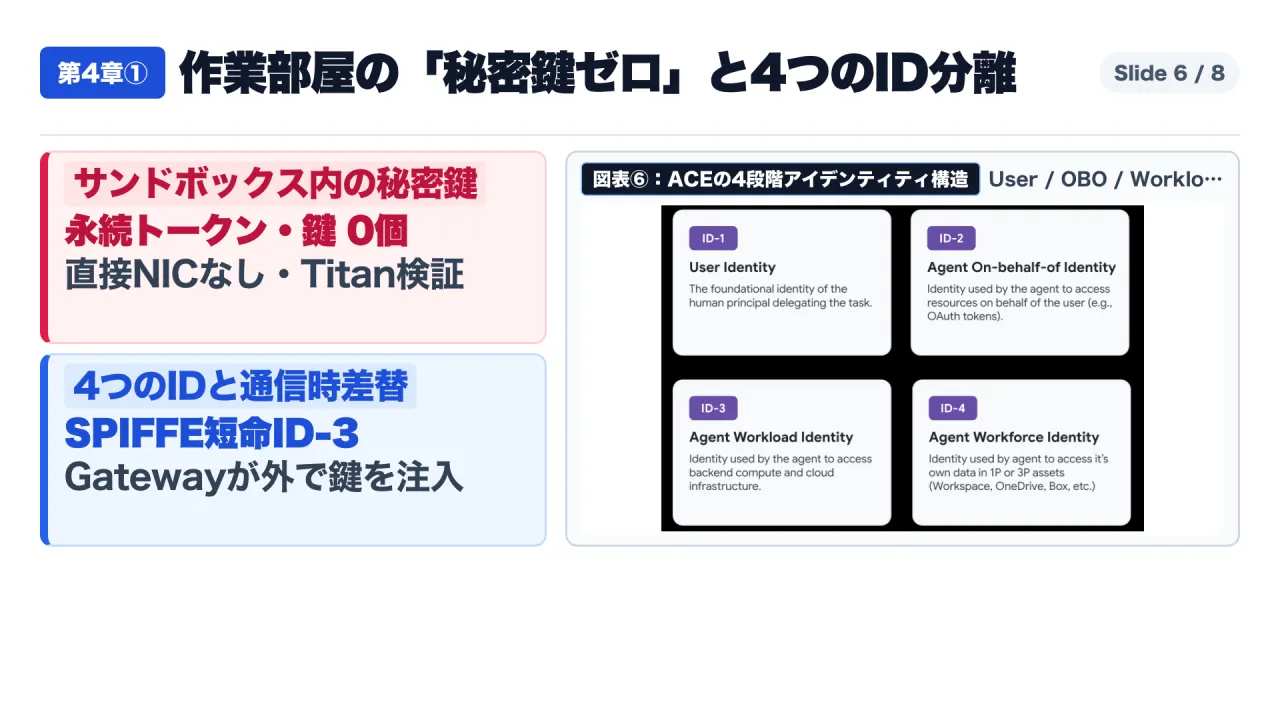
エージェントの「記憶移動(TPU Sync)」と「休眠・高密度スケジューリング(Agent Substrate 1.0)」が揃ったところで、企業導入における最大の関門となるのが**「セキュリティと権限統治(ガバナンス)」**です。
AIエージェントは、単なるチャットボットとは異なり、自らPythonやシェルスクリプトを生成・実行し、外部のWebサイトやメールを読み取り、社内のデータベースやクラウドAPIを操作します。もしエージェントが読み込んだ外部データの中に、悪意のある第三者が仕込んだ隠し命令(間接的プロンプトインジェクション)が含まれていたらどうなるでしょうか。
従来のコンテナ環境のように、エージェントが動く作業部屋(サンドボックス)の環境変数(.env)やメモリ、ローカルディスクの中に「社内データベースのパスワード」や「長期有効なクラウドAPIトークン(サービスアカウント鍵)」を置いていた場合、乗っ取られたエージェントがその秘密鍵を読み取って外部へ送信した瞬間に、社内システム全体が侵害されます。
この構造的欠陥を根底から排除するためにGoogleが設計し、実際に数億人が利用する Gemini の裏側で本番稼働させている基盤が 「Agent Compute Engine(ACE)」 です(発表ブログ:『Introducing Agent Compute Engine and expanded agent governance』、および技術深掘り記事:『Inside Agent Compute Engine: Building the compute foundation for the agentic era』、datePublished: 2026-10-22)。
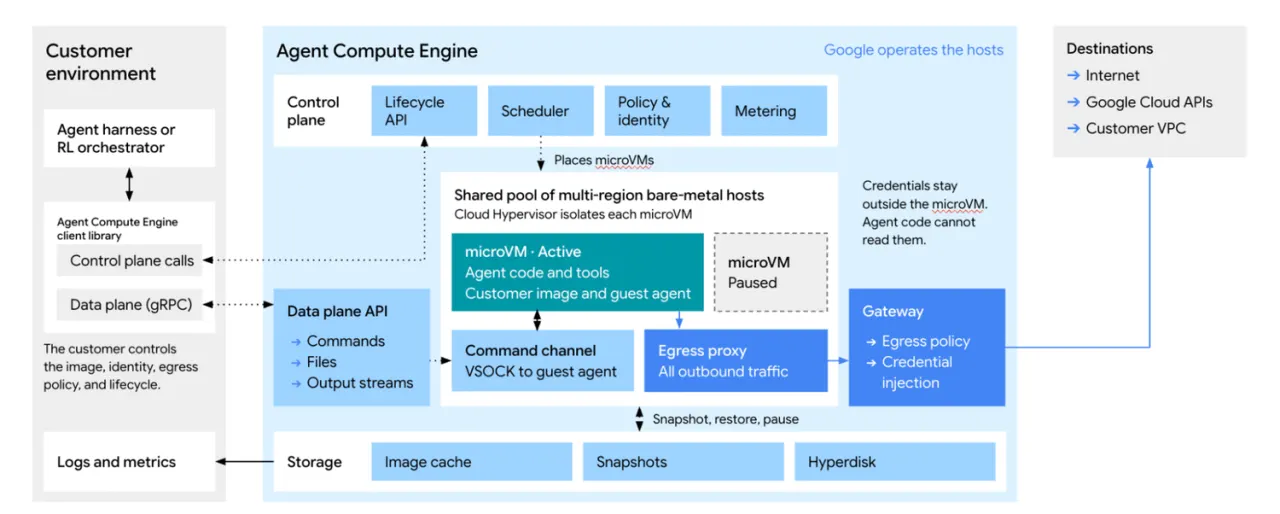
ハードウェア信頼の基点(Titan / Titanium IPU)と「直接ネットワークカードなし」のマイクロVM隔離
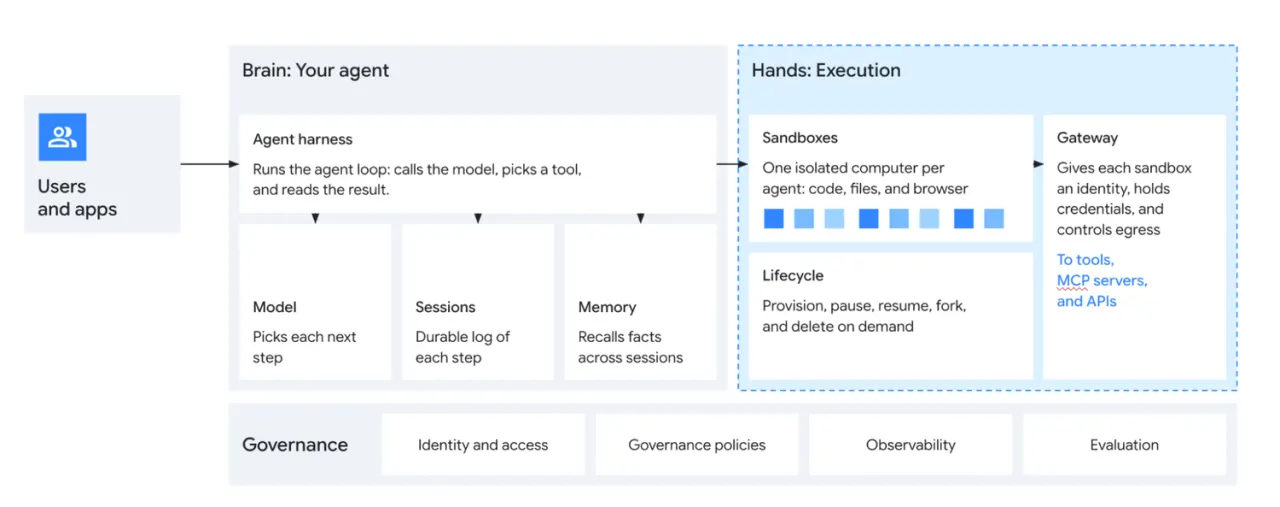
上の公式セキュリティ構成図(Figure 2)が示す通り、ACEはコンテナ共有カーネルではなく、エージェントのセッションごとに独立した軽量仮想マシン(MicroVM)を立ち上げます。その防御壁は以下の5層で構成されています。
- ハードウェア信頼の基点(Hardware-rooted Trust):
- マザーボード上の
TitanセキュリティチップとTitanium IPU(インフラ処理ユニット)がファームウェアとブートシーケンスを暗号学的に検証し、ホストOSにはdm-verityによる暗号署名付きの読み取り専用(Read-only)ファイルシステムを強制します。
- マザーボード上の
- DAX + Copy-on-Write(CoW)による高速起動とメモリ重複排除:
- 共通のベースイメージやランタイムはホスト側でページキャッシュを共有(Direct Access: DAX)し、エージェントが書き換えた差分ページだけをCopy-on-Writeで分離します。これによりマイクロVMでありながらミリ秒単位の高速起動と極小のメモリフットプリントを両立し、アイドル時にはホスト側のアクティブなCPU・メモリ消費をゼロにします。
- 直接ネットワークインターフェースの完全排除(No direct network card):
- エージェントが動くマイクロVMには、外部インターネットや社内LANへ直接パケットを送出できるネットワークカード(NIC)が一切割り当てられていません。すべての通信は必ずホスト外の検問所である
Agent Gatewayを経由しなければ外へ出られない構造になっています。
- エージェントが動くマイクロVMには、外部インターネットや社内LANへ直接パケットを送出できるネットワークカード(NIC)が一切割り当てられていません。すべての通信は必ずホスト外の検問所である
- サンドボックス内の永続秘密鍵・トークン「ゼロ」(Zero persistent secrets in memory or on disk):
- これが最も決定的な設計原則です。エージェントが動くマイクロVMのメモリ上にもディスク上にも、データベースのパスワード、APIキー、OAuthリフレッシュトークンなどの永続的な秘密情報(Secrets)は1つも存在しません。
4つの分離されたアイデンティティと、ノード外関所での「通信途中トークン差し替え(in-flight token swap)」
では、作業部屋の中にパスワードやAPIキーを1つも置かずに、どうやってエージェントに社内システムや外部ツールを操作させるのでしょうか。
ACEはその答えとして、エージェントに関わる身分証明(アイデンティティ)を以下の 4つの独立したID に分解し、ノード外の Agent Gateway で通信の瞬間に権限を差し替える仕組み(in-flight token swap)を導入しました。
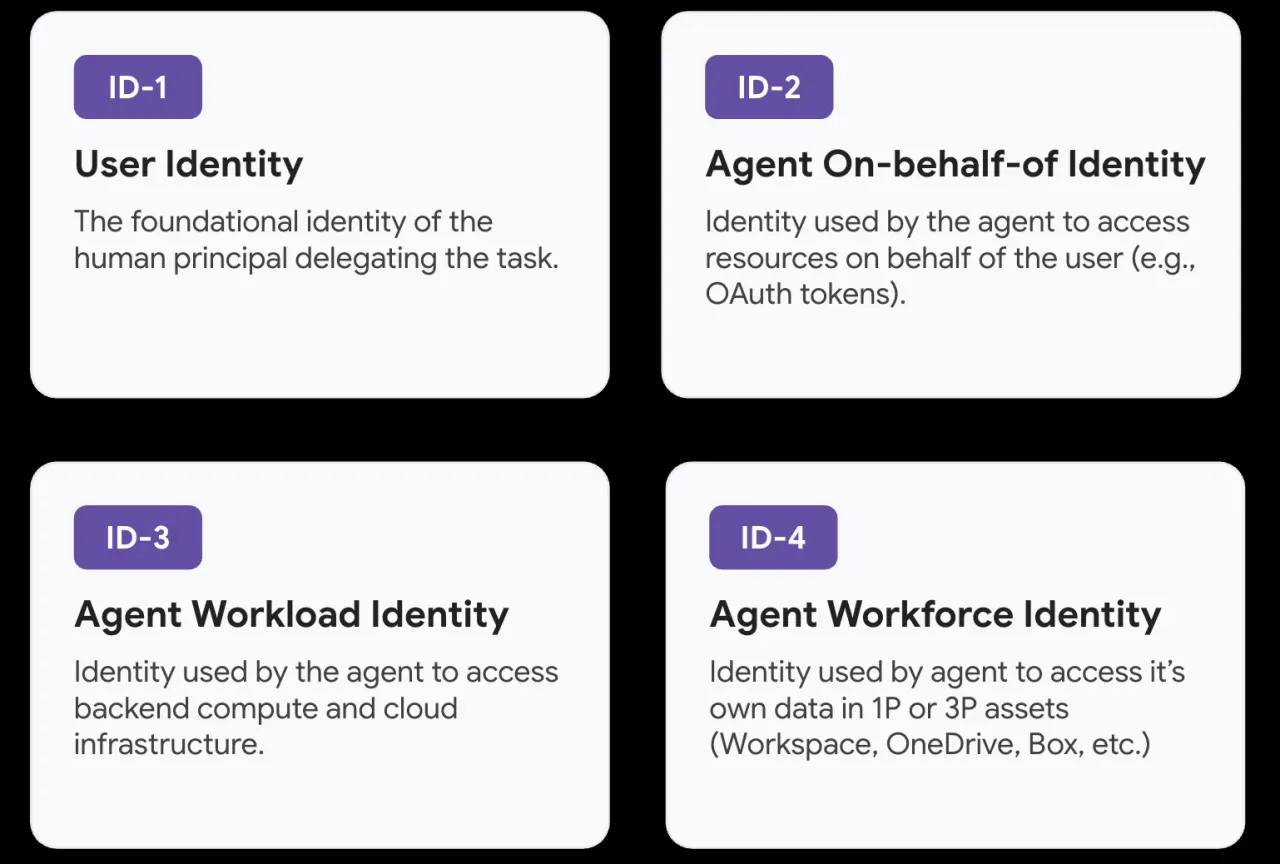
| ID階層 | 公式名称(一次資料 S4 / S5) | 役割・保持される場所・セキュリティ上の意味 |
|---|---|---|
| 第1のID | User identity(人間のユーザーID) |
エージェントに作業を依頼した「人間の社員や顧客」自身の本人確認ID。 |
| 第2のID | Delegated Agent on-behalf-of Identity(委任された代理実行ID) |
「どの人間が、どのエージェントに対し、どの範囲の権限(例:カレンダーの閲覧のみ、特定フォルダの読取のみ)を委任したか」を表す代理(On-behalf-of: OBO)認可コンテキスト。 |
| 第3のID | Agent Workload Identity (ID-3)(SPIFFEベースの短命ワークロードID) |
サンドボックス内部に唯一存在するID。SPIFFE標準に基づく暗号学的な短命証明書であり、「いま特定のマイクロVMの中でこのエージェントプロセスが動いている」ことだけを証明する番号札。これ単体では社内DBや外部APIを直接開く権限を持たない。 |
| 第4のID | Agent Workforce Identity(自律エージェント自身の社員証ID) |
人間の指示を待たずにバックグラウンドで定常稼働する自律エージェントに対して、人間とは独立した「AI従業員(Workforce)」としてIAM権限や監査ログ追跡を付与するためのID。 |
実際の通信フローは以下の通りに動作します。
- サンドボックス内のエージェントが外部ツールや社内DBへアクセスしようとする際、リクエストには第3のIDである 短命な
Agent Workload Identity (ID-3)だけを添えて送出します。 - ノード外(Off-node)に配置された検問所
Agent Gatewayがその通信を受け取り、ID-3の暗号署名と、User identity・Delegated Agent on-behalf-of Identity(またはAgent Workforce Identity)のポリシーを照合します。 - ポリシー上許可された通信であると確認された瞬間、
Agent Gatewayが通信の通過途中(in-flight)で、ID-3を接続先システム用の本物のアクセストークンへと自動的に差し替えます(in-flight token swap)。
この設計により、万が一プロンプトインジェクションや未知の脆弱性によってエージェントの作業部屋(マイクロVM)が完全にハッキングされたとしても、部屋の中には最初から本物のパスワードもAPIキーも存在せず、外へ直接通信するネットワークカードもありません。攻撃者が盗み出せるのは、ゲートウェイの外では何の役にも立たない短命な番号札(ID-3)だけなのです。
6. 第5章:NVIDIA Vera Rubin「A5X」最大96万GPUと、Googleが築くオープン×特化の全方位戦略
Google Cloudの戦略で見逃せないもう1つの事実が、自社製TPUとオープンソース基盤を進化させる一方で、NVIDIAの最新世代GPUシステムを誰よりも早く・大規模にクラウドへ統合している点です。
2026年11月6日、Google Cloudは NVIDIA Vera Rubin NVL72 ラックシステムを搭載した次世代GPUインスタンス 「A5X」 の一般提供(GA)を発表しました(公式ブログ:『Google Cloud infrastructure at NVIDIA GTC Berlin 2026』、datePublished: 2026-11-06)。
- ハードウェア構成: 1ラックあたり72基のRubin GPUと36基のVera CPUをNVLinkで超高密度統合した NVIDIA Vera Rubin NVL72 を採用。
- Virgoネットワークによる超大規模スケール: Google Cloud独自の低遅延・高帯域クラスタネットワーク
Virgoにより、単一サイト(1つのデータセンター拠点)で最大80,000基(8万基)のRubin GPU を単一ファブリックとして結合し、さらに複数拠点を束ねた マルチサイト構成では最大960,000基(96万基)のRubin GPU までスケールする設計となっています。 - AI Hypercomputer ソフトウェア統合: 上位レイヤーでは、GKE(Kubernetes)、
Agent Substrate 1.0、KubeRay、およびストレージ階層(Managed Lustre等)がTPUとGPUの両方で共通化されています。
つまりGoogle Cloudは、以下の**「3階建ての全方位アーキテクチャ」**を完成させています。
- 最下層のシリコン(計算機): 自社の
TPU v7x(Ironwood)と、NVIDIAの最新Vera Rubin NVL72(A5X:最大8万〜96万GPU)の両輪を揃える。 - 中間の状態・記憶移動レイヤー:
TPU SyncとTorchTPUにより、vLLMやSGLang、llm-dをそのまま動かしながら、HBM・ホストDRAM・Lustre・ネットワーク間でKVキャッシュとモデル重みを最大 223 GB/s で高速移動させる。 - 最上位のエージェント実行・統治レイヤー: CNCFに寄贈したオープンな
Agent Substrate 1.0でアイドル時の計算資源を 500ms未満 で休眠・再利用して 密度10倍 を達成し、本番環境ではAgent Compute Engine(ACE)の 4段階ID+in-flight token swapでサンドボックス内の秘密鍵をゼロにする。
なお、現時点の一次資料において、Agent Compute Engine(ACE) が社内Gemini基盤や一部のマネージドサービスを超えて、一般企業が任意のカスタムマイクロVMを直接プロビジョニングできる単体課金サービスとしていつ・いくらで提供されるのか、また A5X(Vera Rubin NVL72) インスタンスの具体的な時間単価については明記されておらず 未確認 です。
7. 第6章:明日から現場で実践できる「24倍トークン時代」のシステム設計3ステップ
Goldman Sachsが予測した「2030年に世界のトークン消費量が24倍(月間12京トークン)へ膨張する」という未来は、遠い先の話ではありません。社内で1つのAIエージェントが自律的にツールを呼び出し始めた瞬間、その部署のトークン消費量と待機コンテナ数は即座に10倍〜20倍へ跳ね上がります。
今回の一次資料が実証したメカニズムを自社のシステム設計へ取り入れるため、明日から着手できる3つの実践ステップを整理します。
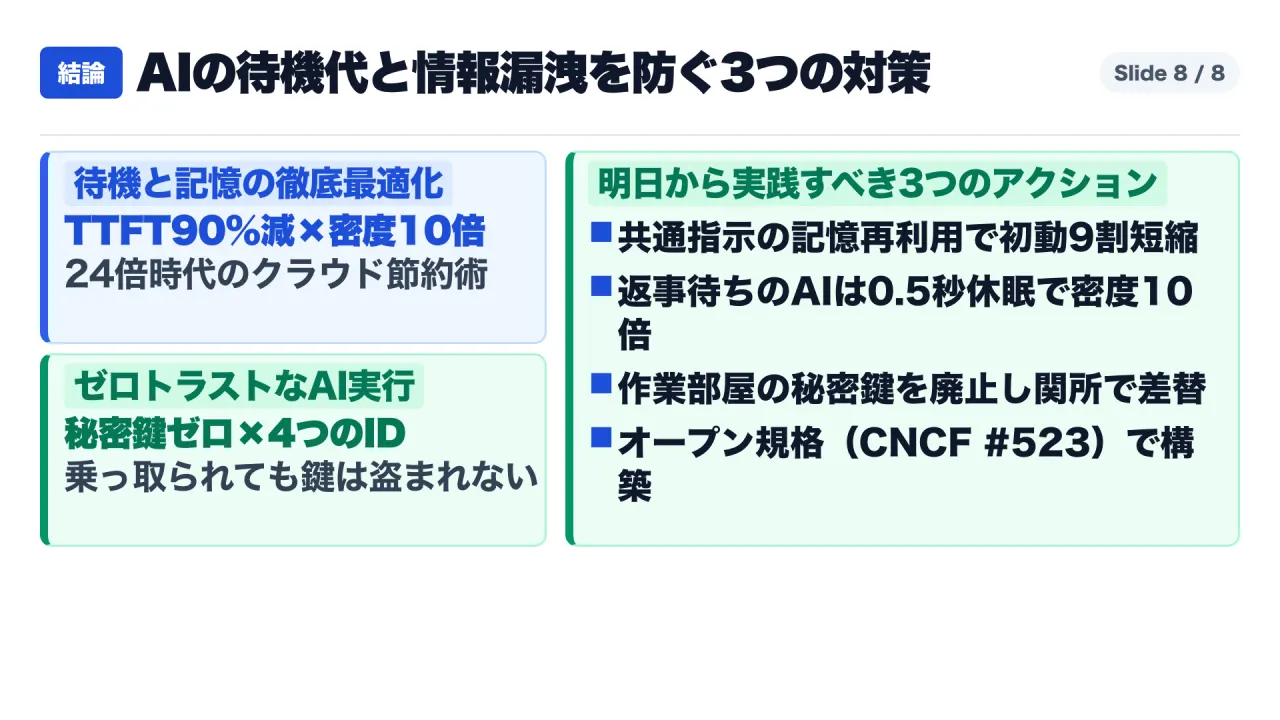
- ステップ1:長文システム指示・社内文書の「階層型プレフィックスキャッシング(Host DRAMオフロード)」の即時導入
- 着手条件: 数万トークン規模のシステムプロンプト、業務マニュアル、コードベース文脈を毎回LLMに読み込ませており、初回応答時間(TTFT)に数秒かかっている場合。
- 実践内容: 高価なGPU/TPUのチップ上メモリ(HBM)だけでKVキャッシュを抱え込むのをやめ、vLLM(
KVConnector)やSGLang、llm-d、そしてTPU環境であればオープンソースのTPU Syncを活用し、共通プレフィックスのKVキャッシュをホストCPUのメインメモリ(Pinned Host DRAM)や共有ストレージへオフロードしてください。TPU Syncが64K長文環境で実証した通り、これだけで TTFTを最大90%短縮 し、同じアクセラレータ台数で スループットを50%以上引き上げる ことができます。
- ステップ2:エージェントの「状態(Actors)」と「計算機(Workers)」の分離によるアイドル課金の撲滅
- 着手条件: 外部APIの応答待ち、データベース検索待ち、あるいは人間のチャット返信・承認待ちが発生するAIエージェントを、常時起動のコンテナやVM上で動かしている場合。
- 実践内容: エージェント1体ごとにコンテナを専有させる設計を廃止し、CNCF Sandboxへ公開された
Agent Substrate 1.0(または同等のActorモデル+Warm Pool基盤)を導入してください。待機に入った瞬間にエージェントの状態をストレージへ退避して計算機を解放し、イベント到着時に500ms未満で復元する構造へ切り替えることで、同じサーバー予算のまま 最大10倍のエージェントを同時収容 できるようになります。
- ステップ3:AIの作業部屋(サンドボックス)からの「永続秘密鍵・パスワードの完全撤去」とゲートウェイでのトークン差し替え
- 着手条件: AIエージェントや自動実行スクリプトが動くコンテナの環境変数(
.env)や設定ファイルに、社内DBのパスワード、クラウドのIAMキー、SaaSのAPIトークンを直接渡している場合。 - 実践内容: Googleの
Agent Compute Engine(ACE)が採用した「Zero persistent secrets in sandbox」の原則に倣い、エージェントが動くサンドボックス内から本物のAPIキーやパスワードをすべて撤去してください。サンドボックスには短命なワークロード証明書(SPIFFE ID等)のみを持たせ、直接の外部ネットワーク通信を遮断した上で、外側のAPIゲートウェイ(プロキシ)を通過する瞬間にだけ人間からの委任権限(On-behalf-of)を検証して外部トークンへ差し替える(in-flight token swap)アーキテクチャへ移行してください。これにより、万が一プロンプトインジェクションでAIが乗っ取られても、認証情報の漏洩を構造的にゼロにできます。
- 着手条件: AIエージェントや自動実行スクリプトが動くコンテナの環境変数(
8. 一次資料リンク集(全6系統)
- Goldman Sachs Research(2026-05-20): AI agents are forecast to boost tech cash flow as usage soars
- Google Cloud Blog(2026-11-09): Introducing TPU Sync: Fast KV cache and weight transfer on TPU
- Google Cloud Blog(2026-11-05): Open infrastructure for autonomous agents comes to CNCF
- Google Cloud Blog(2026-10-22): Introducing Agent Compute Engine and expanded agent governance
- Google Cloud Blog(2026-10-22): Inside Agent Compute Engine: Building the compute foundation for the agentic era
- Google Cloud Blog(2026-11-06): Google Cloud infrastructure at NVIDIA GTC Berlin 2026 (Announcing A5X instances, powered by NVIDIA Vera Rubin NVL72)
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
動画での解説・自己紹介
- YouTubeポッドキャスト本編:なぜ会社のAIは「返事を待つだけの空白時間」でサーバー代が溶けるのか?2030年に利用量が24倍へ急増する時代に、0.5秒でAIを眠らせて同じ機械で10倍動かし、作業部屋のパスワードをゼロにする最新技術
- 初めての方へ(固定自己紹介記事):なぜ海外一次資料の「原典」まで遡るのか──このnoteとポッドキャストの使い方
あわせて読みたい(関連する深掘り記事)
/ja/articles/2026-11-11-tpu-8i-max-autocompress-cisco-ai-factory-memory-wall/
/ja/articles/2026-11-11-softbank-3-7b-power-writedown-sb7-ports-pike-and-6yr-turbine-backlog/