なぜ企業のAI利用料は予算の2.5倍に膨らむのか?──「1ドルで1.7ドル儲かる」の誤解と、自動稼働8割・脱人月契約への3つの対策
「AIに1ドル投資すると、1.7ドルの生産性リターン(利益)が返ってくるらしい」──海外の経済番組やニュースの要約でそんな数字を見聞きし、自社のAI導入稟議書や来期の予算計画にそのまま書き込もうとしていないでしょうか。
結論から言うと、その「1ドルあたり1.70ドル」という数字を「AIを導入した企業の利益率(ROI)」だと信じて稟議を通すと、導入後に予算が計画の約2.5倍へ膨れ上がり、手痛い失敗を招きます。
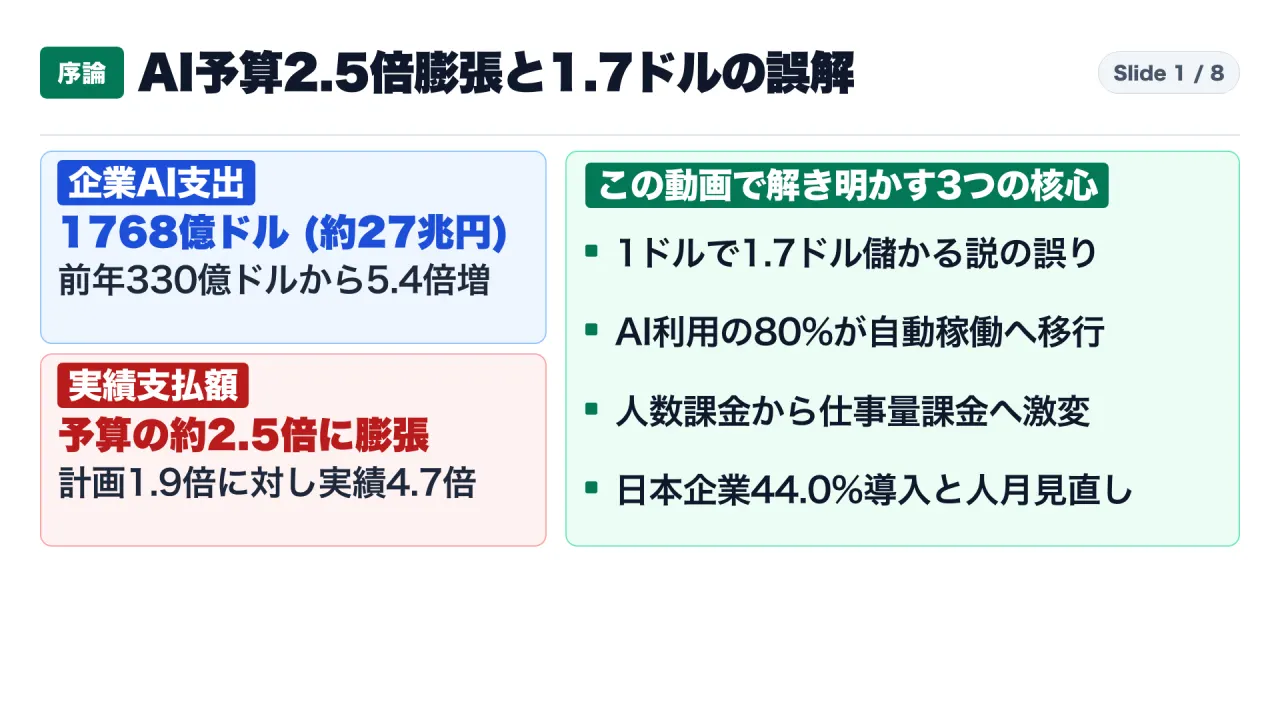
米国の有力ベンチャーキャピタルである Menlo Ventures が2026年11月3日に公開した最新調査レポート『2026: The State of Enterprise AI』(米国の企業意思決定者約400名・管理AI予算総額40億ドル超を対象とした調査、および公開決算・OpenRouter等の実利用統計を統合:S1)の原文を1行ずつ照合すると、驚くべき事実が浮かび上がります。世界の企業がAIを実務で動かすために支払った金額(AI導入支出)は、2025年の 330億ドル から2026年9月時点で年換算 1768億ドル(見出しの丸め表記で1770億ドル、日本円で約27兆円[1ドル=約152.7円換算]) へと、わずか1年で 5.4倍 に急拡大しました。
しかしその裏側で、企業は2026年の初めに「今年のAI予算は前年の 1.9倍 に増やそう」と計画していたにもかかわらず、実際の支払額は平均で前年の 4.7倍 ──すなわち 当初予算の約2.5倍(4.7 ÷ 1.9 ≒ 2.47倍) にまで膨張しているのです。さらに、話題となった「1ドルあたり1.70ドル」という数字の正体は、導入企業の利益率ではなく、「AI業界全体が新型モデルの開発に1025億ドル(1ドル)を投じるごとに、利用企業がAIを使うために1768億ドル(約1.70ドル)を支払っている」という、AIを売る側の売上倍率 にすぎません。
この記事では、Menlo Venturesの2026年企業AI調査レポート(S1)、米国8万5,000社以上の法人決済データを集計した Ramp Economics Lab「Ramp AI Index」(S2)、情報処理推進機構(IPA)の国内企業1,799社調査 『DX動向2026』(S3)、総務省・経済産業省の 『AI事業者ガイドライン(第1.2版)』(S4)、および NTTデータグループとINSEAD(欧州経営大学院)の共同研究発表(S5)という5つの一次資料を突き合わせ、AI利用の80%が「自動稼働エージェント」へ移った現場の経済学と、日本企業が明日から実践すべき3つの防衛・活用ステップを徹底解説します。
1. 結論と対象読者:この記事で分かることと明日から実践できる行動
対象読者(いま直面している課題)
- 社内でAIツールの導入稟議やクラウド予算の管理を担当しており、「従量課金のAIを入れると毎月いくらかかるのか」「ニュースで聞く費用対効果の数字をどう経営陣に説明すべきか」に悩んでいる企画・情報システム部門の担当者
- ソフトウェア開発や業務システムの外注・受託に関わっており、AIによる開発期間短縮が進む中で従来の「エンジニア何人×何ヶ月(人月契約)」の見積もりが立ち行かなくなっている発注側責任者・SIerのマネージャー
- 日本企業の生成AI導入率が44.0%に達したものの、社内の使い方が「個人の文章要約やメール下書き」にとどまっており、どの業務からどうやって自動化へ踏み出せばよいか迷っている現場リーダー
この記事を読んでできること(3つの実践ステップ)
- 予算管理の安全化: 「1ドルで1.7ドル儲かる」という誤解を排し、自動稼働AIがやり直しループで予算を2.5倍に食い潰すのを防ぐため、「1回の処理あたりの上限金額(ストッパー)」と「最上位モデル・安価モデルの2段階振り分け」を設計できる。
- 自動化対象業務の選定と契約見直し: 個人の文章要約から一歩進め、「結果が正しいかを自動で検査できる業務」を1つ選んで自動化し、外部発注の契約を「何人月か」から「処理件数・期間短縮の成果+緊急時の専門家対応枠」へ切り替えられる。
- 国内ガイドライン準拠の承認ルール構築: 総務省・経済産業省『AI事業者ガイドライン(第1.2版)』に沿い、社内で稼働するAIの台帳を整え、「社内集計・下書きは自動実行+履歴記録」「社外送信・決済・契約操作は人間の事前承認ボタン必須」の2段階ルールを導入できる。
2. 最初に押さえるべき2つの基本概念:「自律型AIエージェント」と「仕事量課金」
本題のデータに入る前に、2025年までのAI活用と2026年現在のAI活用を分ける「2つの基本概念」を日常の言葉で整理しておきます。ここを押さえるだけで、なぜ世界中でAI予算のパンクが起きているのかが一目で分かります。
① 自律型AIエージェント(人間の代わりに自分で段取りを組んで働くAI)
2025年までの生成AIは、人間が画面の前で1回ずつ質問を打ち込み、1回ずつ返事をもらう「優秀な話し相手(チャットボット)」でした。人間がキーボードから手を離せば、AIもそこで止まっていました。
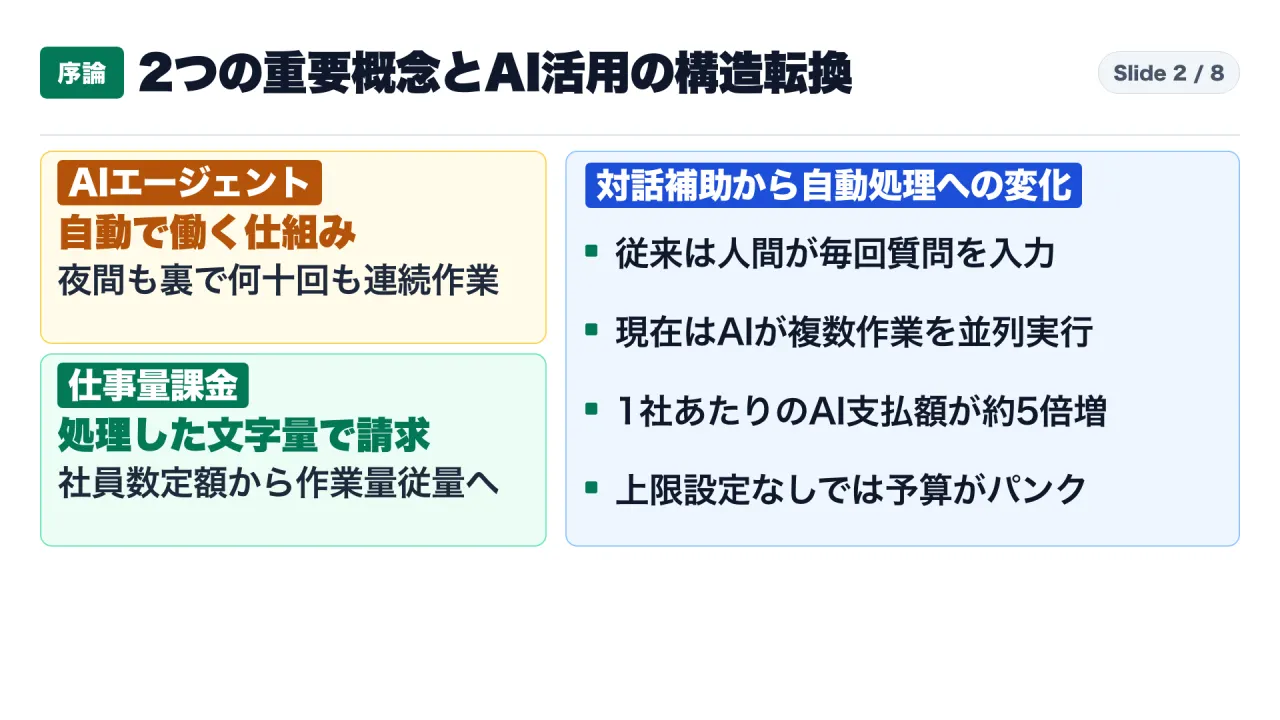
これに対して 「自律型AIエージェント」 とは、総務省・経済産業省の『AI事業者ガイドライン(第1.2版)』(S4)でも「ユーザーの意図を理解し、自律的にタスクを遂行するシステム」と整理されている通り、人間が最初に「この資料を調べて、プログラムを修正して、テストが通るまで直しておいて」と目標を渡せば、人間がパソコンの前を離れている間も、裏側で何十回も自分で作業を繰り返すAI です(Menlo Ventures 2026 Report:S1)。
② 仕事量に応じた従量課金(トークン課金)
これまでの業務用ソフトウェア(SaaS)は、「社員1人あたり月額いくら」という 人数単位の定額制(シート課金) が当たり前でした。社員が100人なら100人分の月額料金を払えばよく、予算が翌月に突然3倍になることはありませんでした。
ところがAIエージェントの時代になると、料金は「使う人間の人数」ではなく、「AIが裏側で読んだり書いたりした文字やデータの量(専門用語でトークン量)、つまりAIがこなした作業量」 で決まります(Menlo Ventures 2026 Report:S1)。
たとえるなら、これまでは「社員食堂の定額パスポート」を社員の人数分だけ買えばよかったのが、急に 「24時間眠らない食べ盛りの助っ人ロボットを何十台も職場に連れてきて、人間が寝ている夜中にも回転寿司のお皿を何千枚も自動で食べ続ける仕組み」 に変わったようなものです。ロボットが裏側でたくさん働けば働くほど、月末に届くお皿の請求書(トークン利用料)は青天井で増えていきます。
3. 第1章:「1ドルで1.7ドル儲かる」のウラ側──27兆円市場の内訳とAI利用の8割を占める自動処理
第1章では、Menlo Venturesの公式レポート(S1)の調査条件と数値を原典通りに確認し、メディアで広まった「1ドルあたり1.70ドル」という数字の取り違えを検証します。
調査の前提条件と利益相反(バイアス)の確認
一次資料を読む際は、まず「誰が、どの範囲を、どう調べた数字か」を確認する必要があります。
- 調査主体と時期: 米国のベンチャーキャピタル Menlo Ventures が、2026年9月8日から9月26日にかけて実施し、2026年11月3日に公開しました(Menlo Ventures 2026 Report:S1)。
- 調査対象と推計手法: 米国の企業でAI導入の意思決定に関わる 約400名(管理する年間AI予算の合計は40億ドル超) へのアンケート調査をベースに、上場企業の公開決算データ、およびモデル中継基盤である OpenRouter 等の外部利用統計を掛け合わせて市場全体の年換算支出額(Annualized Run-rate)を推計しています。
- 出資関係(ポジショントーク)の留意点: Menlo Ventures 自身が、レポート内で高く評価されている Anthropic、OpenRouter、法務AIの Eve、医療AIの commure や Pinecone などへの出資者(投資家)である点は、客観的な留保条件として押さえておく必要があります。そのため本記事では、Menloと資本関係のない独立した法人決済プラットフォーム Ramp(米国8万5,000社以上の実決済データ:
S2) や日本の公的調査(IPA『DX動向2026』:S3)を併用してクロスチェックを行っています。
企業のAI導入支出は3年で約100倍、1年で5.4倍の「1768億ドル(約27兆円)」へ
Menlo Venturesの推計によると、世界の企業がAIを実務に導入・運用するために支払っている年間支出額(Deployment Spend)は、以下のように急拡大しています。
- 2023年: 17億ドル
- 2024年: 85億ドル(前年比5.0倍)
- 2025年: 330億ドル(前年比3.9倍)
- 2026年(9月時点の年換算): 1768億ドル(見出しの丸め表記で 1770億ドル、前年比 5.4倍、2023年比で 約100倍、1ドル=約152.7円換算で 約27兆円)
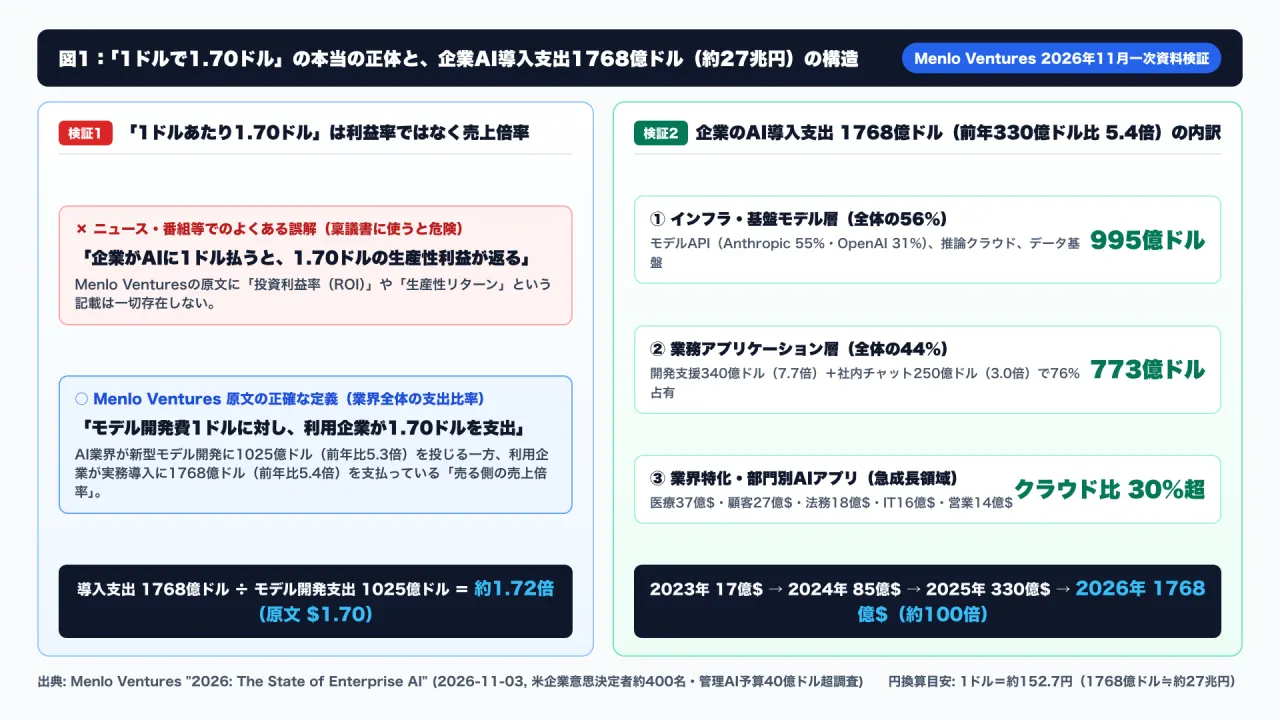
1768億ドルの内訳を見ると、AIモデルを動かす土台となる インフラ・基盤モデル層が995億ドル(全体の56%)、その上で動く 業務アプリケーション層が773億ドル(全体の44%) です。この1768億ドルという規模は、世界のパブリッククラウド市場全体の売上の 30%以上(前年の6%から急増)に相当します(Menlo Ventures 2026 Report:S1)。
【深掘り分析】2023年〜2026年の4年間で市場の構造はどう変わったのか?
ここで単に「1768億ドルに増えた」という結果だけを見るのではなく、2023年から2026年までの4年間で「企業がお金を払う対象」がどう変化したのかを時系列で整理すると、現在の構造転換の意味がより鮮明になります。
| 年次 | 企業のAI導入支出総額(年換算) | 前年比成長率 | 当時の主な利用形態(主役) | 課金・予算の単位 | 現場の主な課題 |
|---|---|---|---|---|---|
| 2023年 | 17億ドル | 基準年 | 画面上での対話実験(PoC)・プロンプトのお試し | 少額のAPI利用枠・個人課金 | 「自社の業務データのどこに使えるか分からない」「情報漏えいが怖くて社内利用を禁止する」 |
| 2024年 | 85億ドル | 5.0倍 | 社内専用チャットボットの構築・検索連動(RAG)の初期導入 | 社員数(ID数)に応じた定額シート課金 | 「全社員にアカウントを配ったが、一部の社員しか使わず利用率が2〜3割で頭打ちになる」 |
| 2025年 | 330億ドル | 3.9倍 | プログラミング補助(コード補完)と部門別AIアシスタントの普及 | シート課金+一部API従量課金の併用 | 「個人の作業時間は少し減ったが、会社全体の売上や利益にどう貢献しているか測定できない」 |
| 2026年 | 1768億ドル(見出し表記1770億ドル・約27兆円) | 5.4倍(2023年比で約100倍) | 自律型AIエージェントによる複数ステップの自動実行・夜間バッチ処理 | 処理した文字・データ量(トークン量)に応じた従量課金 | 「自動処理の普及でトークン消費量が爆発し、実際の支払額が当初予算の約2.5倍へ膨れ上がる」 |
この表から読み取れる最大のポイントは、「2024年〜2025年の成長は『AIを使う社員の人数(ID数)が増えたこと』による成長だったのに対し、2026年の330億ドルから1768億ドルへの5.4倍の急膨張は、『人間1人あたりの裏側で動くAIエージェントの作業量(トークン消費量)が爆発したこと』による成長である」 という点です。
さらに、インフラ・基盤モデル層(995億ドル:全体の56%)と業務アプリケーション層(773億ドル:全体の44%)のバランスにも重要な意味があります。通常のソフトウェア市場(たとえばクラウド移行期やモバイル移行期)では、最初は土台となるインフラにお金が集まり、数年かけてその上のアプリケーション市場が立ち上がります。しかし今回のAIシフトでは、モデルそのものの推論計算代を含むインフラ層が995億ドルへ膨らむのと同時に、コーディング支援や社内アシスタントを中心とするアプリケーション層も一気に773億ドルまで拡大しました。これは「AIモデルをそのままAPIで呼び出して自社開発に組み込む企業」と、「完成されたAI搭載アプリケーションを購入してすぐ業務に使う企業」の双方が、実験フェーズを終えて本予算を投じ始めたことを裏付けています。
「1ドルあたり1.70ドル」の原文照合──なぜ稟議書に書いてはいけないのか
海外の経済番組やSNSの要約では、「Menlo Venturesの調査により、企業がAIに1ドル支出するごとに1.70ドルの生産性リターン(投資利益)を得ていることが判明した」という趣旨の紹介がなされました。
しかし、Menlo Venturesのレポート全文を検索しても、「ROI(投資利益率)」という言葉は一度も登場せず、「生産性リターン(productivity return)」という表現も存在しません。 原文の該当箇所には、一字一句そのまま次のように書かれています。
“For every $1 the industry spends building AI models, enterprises spend about $1.70 putting them to work.” “Spend on building models grew 5.3x to $102.5B in 2026, and spend on using AI grew 5.4x to $176.8B, 1.7x as much.” (出典:Menlo Ventures “2026: The State of Enterprise AI”:S1)
ここで行われている計算は極めて単純な割り算です。
- 分子(AIを使う側の企業の導入支出): 1768億ドル(前年比5.4倍)
- 分母(AIを作る側の開発企業が新型モデルの学習・開発に投じた支出): 1025億ドル(前年比5.3倍)
- 比率: 1768億ドル ÷ 1025億ドル ≒ 1.724…(原文表記で約1.70ドル/1.7倍)
| 比較項目 | ニュース・番組等での誤解 | Menlo Ventures 原文の正確な事実 |
|---|---|---|
| 「1ドル」の主語(分母) | AIを導入した一般企業が支払ったAI利用料(1ドル) | AI開発業界が新型モデルの開発・学習に投じた費用(1025億ドル=1ドル) |
| 「1.70ドル」の意味(分子) | 導入企業が得た生産性向上や利益のリターン(1.70ドル) | 利用企業がAIを実務で使うために支払った導入支出(1768億ドル=約1.70ドル) |
| 数字の性質 | 導入企業側の投資利益率(ROI 170%) | AI業界全体の「開発費に対する実利用支出の倍率(売上倍率)」 |
| 稟議書への利用可否 | 不可(誤り):自社が100万円払えば170万円儲かる根拠にはならない | 「世界の企業が実験を終え、モデル開発費の1.7倍もの実利用料を払う段階に入った」という市場規模の根拠としてのみ使用可能 |
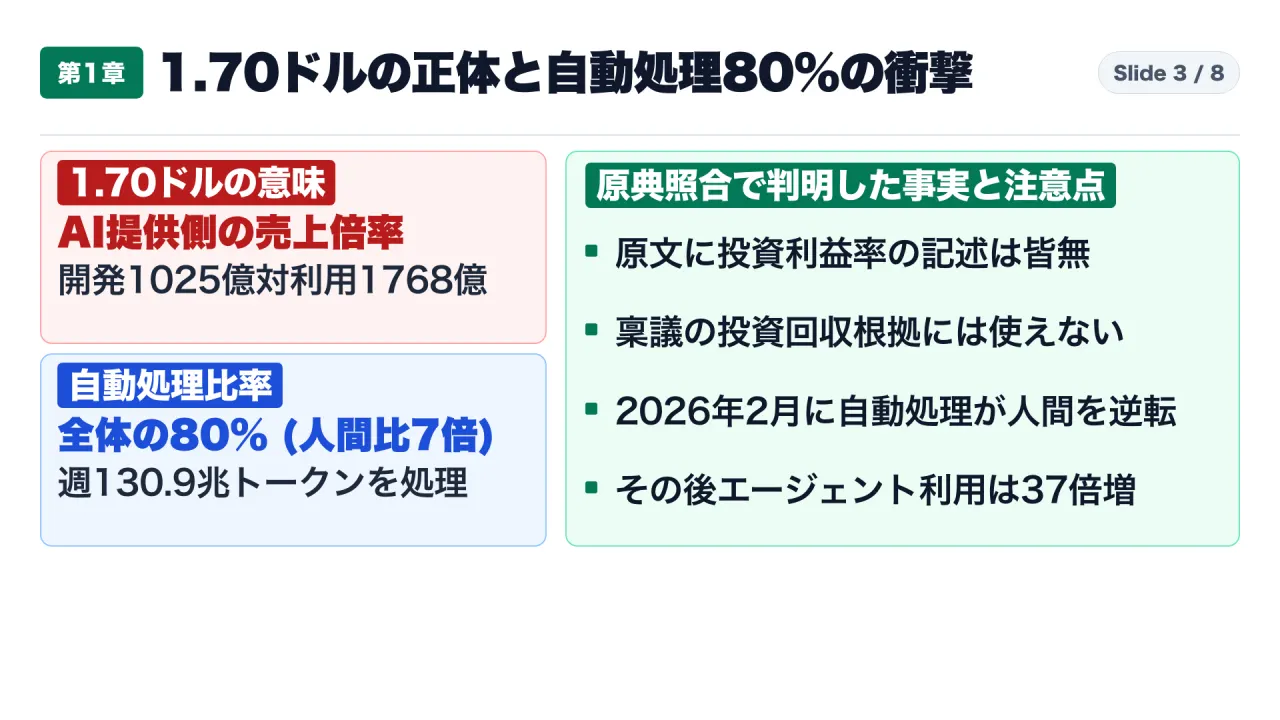
つまり「1.70ドル」とは、「AIを導入した会社が1.7倍儲かった」という数字ではなく、「AI業界全体で見ると、モデルを作るための研究開発費(1025億ドル)を上回る1.7倍ものお金(1768億ドル)が、企業の実務利用として支払われている」 というマクロな市場構造を示した数字なのです。「誰も価値のないものに毎年5.4倍ものお金を払い続けたりはしないから、現場で役に立っているはずだ」という間接的な推論が、伝言ゲームの中で「1ドルで1.7ドルの生産性リターン」へとすり替わった形です。社内の稟議書でこの数字を「投資回収の根拠」として使うことは絶対に避けてください。
OpenRouter統計が示す衝撃:AI利用量の80%(週130.9兆トークン)は「人間ではなくAIエージェント」
では、なぜ企業は1年で5.4倍ものお金をAIに支払うようになったのでしょうか。その直接の原因が、モデル中継基盤である OpenRouter(週に160兆トークン以上を処理し、数百万人の開発者が利用するルーティング基盤)の実測データに表れています(Menlo Ventures 2026 Report:S1)。
- 自律型AIエージェントのトークン占有率: OpenRouter上で処理される全トークン量の 80%(週あたり130.9兆トークン) は、人間が直接チャット画面から入力したものではなく、自律型AIエージェント(自動稼働プログラム) によって生成されています。これは人間由来のトークン消費量の 約7倍 にあたります。
- 2025年11月〜2026年2月の歴史的転換点:
- 2025年11月: Anthropicの Opus 4.5 が公開された直後、エージェントによるトークン消費量がわずか 1週間で3倍 に跳ね上がりました。
- 2026年2月初旬: Opus 4.6 と GPT-5.3-Codex が相次いでリリースされた直後、ついに エージェントのトークン消費量が人間の直接利用量を逆転 しました。
- 逆転後の爆発的乖離: 2026年2月の逆転以降、人間によるトークン利用量が 5倍 に増える間に、AIエージェントによるトークン利用量は実に 37倍 へと爆発的に拡大しました。
なお、OpenRouterは開発者やAIネイティブ企業の利用比率が高いプラットフォームであるため、「一般の伝統的な大企業の社内でもすでに80%がエージェント化している」とそのまま一般化することはできません。しかし、「人間が1回ずつ質問する使い方」から「エージェントが裏側で大量のトークンを消費して自律稼働する使い方」へ主役が完全に交代した事実は、疑いようのないトレンドです。
【深掘り分析】なぜ人間1回の指示が、AIエージェントでは「何十倍ものトークン消費」に化けるのか?
ここで、「なぜ人間がチャット画面で使うときと、AIエージェントが自動で動くときとで、週130.9兆トークン(全体の80%、人間の約7倍)もの圧倒的な差がつくのか」を、コンピュータの裏側の仕組みに踏み込んで解説します。理由は大きく3つあります。
- 「過去の作業履歴(文脈)」を毎回丸ごと読み直す構造(コンテキストの雪だるま式膨張):
- 人間がチャット画面で「このメールを要約して」と頼む場合、AIが読む文字数は数千文字で済みます。
- しかし、AIエージェントに「社内の仕様書フォルダとプログラム一式を調べて、不具合の原因を特定し、修正コードを書いてテストを通しておいて」と頼むと、エージェントは1つのゴールを達成するために20回〜50回もの小さなステップ(①ファイル一覧を見る→②仕様書を読む→③関連コードを探す→④仮説を立てる→⑤コードを書き換える→⑥テストを実行する→⑦エラーログを読む→⑧もう一度書き換える…)を連続で実行します。
- このときAIモデルは、ステップが進むたびに 「ステップ1から直前のステップまでに読んだ資料・書いたコード・出たエラーログのすべて」を毎回最初から読み直して次の判断を下す 仕組みになっています。つまり、1ステップ目で1万トークンだった入力量が、10ステップ目には10万トークン、30ステップ目には30万トークンへと雪だるま式に膨れ上がり、1つの仕事を終えるころには累計で数百万〜数千万トークンを消費するのです。
- 「親エージェント」が「複数の子エージェント(サブエージェント)」を並列で呼び出す構造:
- 2025年11月のOpus 4.5や2026年2月のOpus 4.6・GPT-5.3-Codex以降、エージェントの性能が上がったことで、1体の親エージェントが自分で全部やるのではなく、「調査担当の子エージェント3体」「実装担当の子エージェント2体」「検査担当の子エージェント1体」を同時に立ち上げて並列で作業させる設計が標準になりました。
- 人間から見れば「1回指示を出してコーヒーを飲んでいるだけ」でも、裏側では6体のAIが同時に何十回もの試行錯誤を回しているため、単位時間あたりのトークン消費速度は人間の手作業の何十倍にも跳ね上がります。
- 「エラーが出たら自分で直して再試行する(自己修復ループ)」の常時稼働:
- 人間がAIを使ってうまくいかなければ、2〜3回やり直して「今日はもうやめよう」と手を止めます。しかし自動稼働するAIエージェントは、「テストが合格するまで繰り返す」という条件が与えられている限り、夜中でも休日でも5回、10回、20回と黙ってやり直し(リトライ)を続けます。この「粘り強さ」こそがエージェントの実務能力の源泉であると同時に、予算を計画の2.5倍に膨張させる最大の要因でもあるのです。
4. 第2章:なぜAI予算は計画の2.5倍に膨らむのか──社員数課金から「仕事量課金」への変化と身近な失敗例
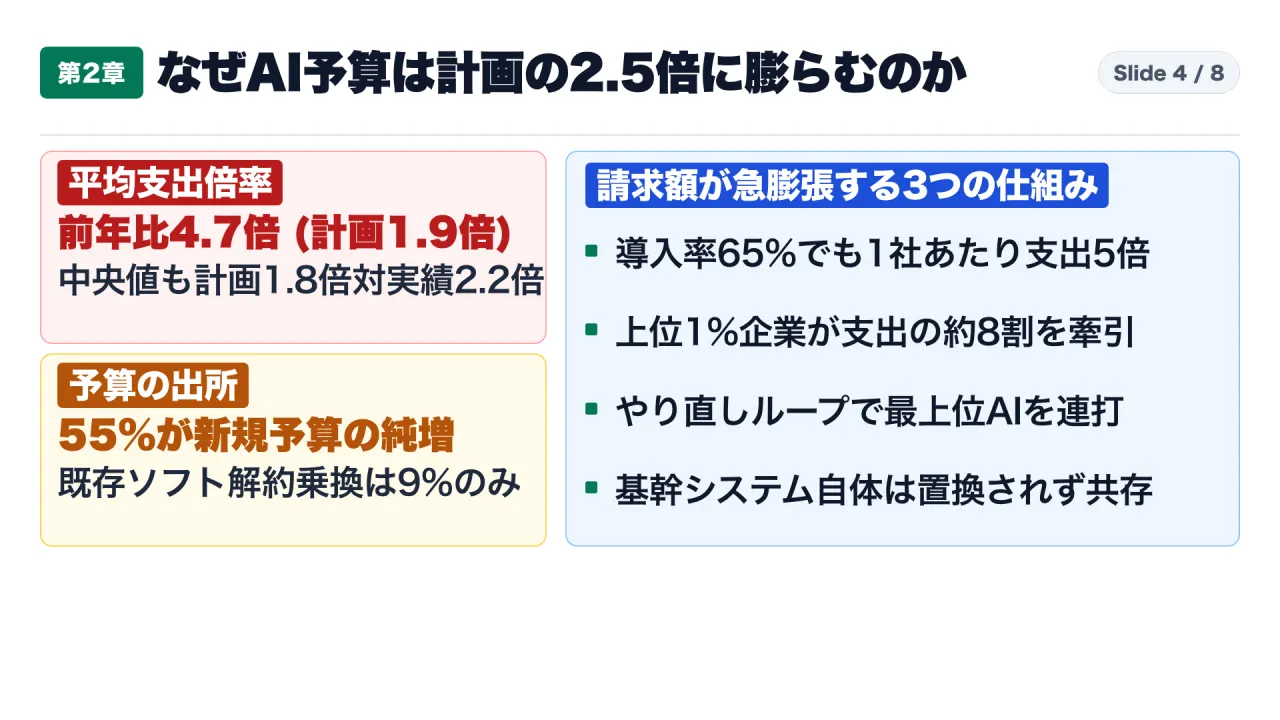
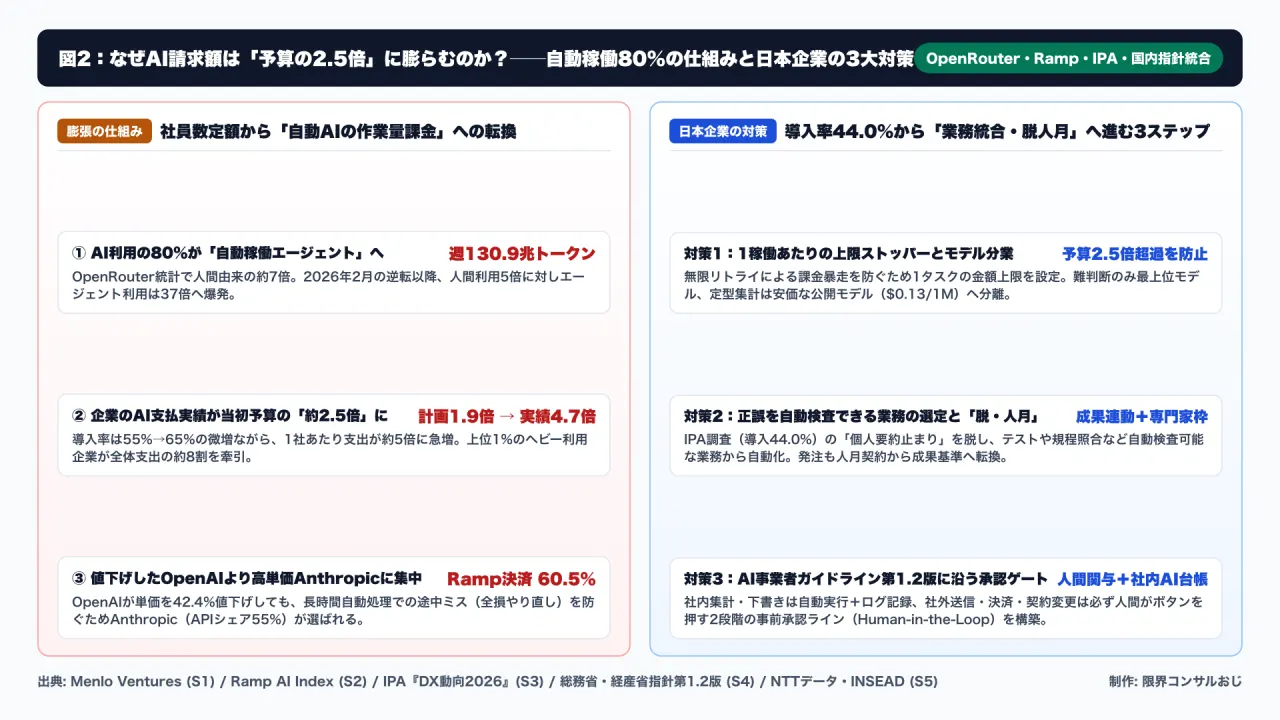
第2章では、世界中の企業で起きている「AIの請求書を開けたら当初予算の2.5倍になっていた」という現象のメカニズムを解き明かします。
計画1.9倍に対し実績4.7倍──「導入社数の増加」ではなく「1社あたりの消費量爆発」
Menlo Venturesの調査(S1)において、企業の2026年AI予算の「当初計画」と「実際の支出実績」を比較したデータは以下の通りです。
- 平均値(Mean)での比較:
- 2026年初頭時点の支出拡大計画:前年比 1.9倍
- 2026年実際の支出拡大実績:前年比 4.7倍
- 予算超過倍率: 4.7 ÷ 1.9 ≒ 約2.47倍(当初予算の約2.5倍)
- 中央値(Median)での比較:
- 当初計画:前年比 1.8倍
- 実際の実績:前年比 2.2倍(中央値ベースでも明確に予算を超過)
- 企業全体のAI導入率と1社あたり支出のギャップ:
- 何らかの生成AIを導入している企業の割合自体は、2025年の 55% から2026年の 65% へと 10ポイント増えただけ です。
- それにもかかわらず市場全体の支出が5.4倍に増えたのは、導入企業1社あたりの平均支払額が約5倍に跳ね上がった ためです。さらに、平均値(4.7倍)が中央値(2.2倍)を大きく上回っていることからも分かる通り、AIエージェントを本格稼働させ始めた上位のヘビーユーザー企業が支出全体を猛烈に引き上げています。この傾向はRampの法人決済データ(
S2)でも裏付けられており、上位1%のヘビー利用企業がAI支出全体の約8割を牽引する という極端な集中(べき乗則)が起きています。
身近な失敗例でわかる「自動やり直しループ」の恐怖
なぜAIエージェントを動かすと、人間が使っていたときの何倍もの請求が一気に発生するのでしょうか。
実は私自身も先日、休日に自宅のパソコンで個人用の家計簿レシートや過去の領収書PDFを自動整理させるスクリプトを組んだ際、まったく同じ構造の失敗をやらかしました。休日の昼間に「フォルダ内の画像を全部読んで、日付と品目ごとに集計表へ入れておいて」と自動処理プログラムを動かしたまま、近所のスーパーへ2時間ほど買い物に出かけたのです。
ところが、その中に1枚だけ、財布の中でくしゃくしゃになって印字がかすれた大根と牛乳のレシートがありました。プログラムの設定で「文字がうまく読み取れなかった場合は、画像を拡大したり角度を変えたりして、正しく読めるまで最上位のAIモデルで自動的にやり直す」というループを組んでいたせいで、私が買い物している2時間のあいだ、AIが同じ1枚のレシートを何百回も最高性能のモデルに送り続けていたのです。帰宅して管理画面を開いた瞬間、たった2時間の外出で普段の1か月分近いAPI利用料が溶けているのを見て、頭を抱えました。すぐに 「1回の処理で50円(またはリトライ3回)を超えたら自動で停止して人間に通知する上限ストッパー」 を入れて解決しましたが、まさにこれの何万倍ものスケールが、いま世界中の企業のクラウド請求書で起きています。
人間が画面の前で使うソフトなら、「社員が1日にキーボードを叩ける回数」という物理的な上限があります。しかしAIエージェントは、裏側で何十個ものサブタスクに分割し、エラーが出れば自動でリトライを繰り返し、夜間も休日も休まずにAPIを叩き続けます。「1稼働あたりの上限ストッパー」を入れずにエージェントを本番投入することは、上限のない法人クレジットカードを自動販売機に差しっぱなしにするのと同じ です。
「AIが既存の業務用ソフト(SaaS)をすべて駆逐する」は本当か?
もう一つ、予算の出所に関する重要なデータがあります。世間では「AIエージェントの登場で、SalesforceやWorkdayのような既存の業務用ソフト(SaaS)がすべて解約されるのではないか」という極端な議論もありました。しかし、Menlo Venturesが「新しく増えたAI予算はどこから捻出されたか」を調査した内訳は以下の通りです(Menlo Ventures 2026 Report:S1)。
- 完全に新しい純増予算(New budget / net-new spend): 55%
- 他部門・他用途からの予算振り替え(Reallocated from other budgets): 23%
- 既存のソフトウェア(SaaS)予算からの付け替え: 22%
- この22%のうち、既存ソフトベンダーが提供するAI追加機能(アップセル)への支払いが 13%
- 既存のSaaSを実際に解約し、新興のAIネイティブ企業へ乗り換えた分(Direct SaaS Displacement): 全体のわずか 9%(金額にして126億ドル)
つまり、企業のAI支出の過半数(55%)は純増の投資であり、既存の基幹SaaSを解約して乗り換えた割合は9%にとどまっています。会社の顧客台帳や人事台帳といった「記録の保管庫(System of Record)」そのものが急に消えるわけではなく、その上に「自動で仕事を進めるAIエージェント層」が積み重なる形で、ソフトウェア市場全体が膨張しているのが2026年の実態です。
【深掘り分析】なぜ基幹ソフト(SaaS)は9%しか解約されず、その上の「エージェント層」に予算が集まるのか?
ここで、多くの経営者やIT部門長が疑問に思うのが、「AIエージェントがそれほど優秀なら、なぜ高い利用料を払っている既存の営業管理ソフト(CRM)や会計ソフト(ERP)、人事管理ソフトを解約して、AIに全部置き換えないのか?」という点です。Menlo Venturesの調査(S1)で既存SaaSの解約・乗り換えが全体のわずか 9%(126億ドル) にとどまった背景には、企業の業務システムが持つ3つの構造的な理由があります。
| ソフトウェアの階層 | 主な役割 | 具体例 | 2026年の変化(Menlo調査 S1) |
なぜAIに丸ごと置き換わらないのか? |
|---|---|---|---|---|
| 第1層:記録の保管庫(System of Record) | 顧客台帳・会計仕訳・人事発令・契約書など「1円の狂いも許されない公式記録」を安全に保管し、監査証跡を残す | 基幹ERP、営業管理CRM、人事給与システム、ソースコード管理基盤 | 解約・乗り換えはAI予算全体の 9%(126億ドル) のみ。既存ベンダーのAI追加機能購入が 13% | 法令対応(監査・税務・アクセス権限)や社内業務フローが何十年もかけて作り込まれており、AIが確率的にデータを書き換えると帳簿の整合性が壊れるため |
| 第2層:人間の操作画面(従来の業務UI) | 社員がブラウザを開き、手作業で検索・入力・コピペ・集計を行うための画面 | 従来のダッシュボード、手入力フォーム、検索画面 | ここが最もAIに置き換わっている領域(人間が画面を開く回数が減少) | 人間が1件ずつ画面をクリックして入力するよりも、AIエージェントがAPI経由で裏側から読み書きする方が圧倒的に速いため |
| 第3層:自律実行・行動の層(System of Action / Agent Layer) | 複数の保管庫(第1層)からデータを集め、判断・加工・検査を行い、承認を得て書き戻す | コーディングAI(340億ドル)、社内横断アシスタント(250億ドル)、顧客対応・財務・法務AI | 新規純増予算(55%)と他部門予算からの振り替え(23%)が集中し、市場が 5.4倍 に膨張 | これまで「人間の社員の労働時間(人件費)」で賄っていた作業がソフトウェア代(トークン代)へ置き換わっているため、IT予算としては純増になる |
この表を見ると分かる通り、いま起きているのは「古いソフトウェア予算から新しいソフトウェア予算への単なる引っ越し」ではありません。これまで 「ソフトウェア予算(IT費)」の外側にある「人間の人件費・外注費・残業代」で処理していた膨大な実務作業が、AIエージェントのトークン消費量(仕事量課金)としてIT予算の中へなだれ込んできている のです。だからこそ、従来の「社員数×月額単価」というIT予算の物差しで計画を立てると、実際の支払額が計画の約2.5倍(前年比4.7倍対計画1.9倍)へと突破してしまうわけです。
【実践チェックリスト】自社のAI予算が「2.5倍膨張」の罠に陥っていないか診断する5つの質問
ここで、読者の皆さんの会社や部署で現在動いている(あるいはこれから導入しようとしている)AIプロジェクトが、予算暴走のリスクを抱えていないかを5つの質問で点検してみましょう。
- 【稟議の前提】 稟議書や企画書に「AIに1ドル投資すると1.7ドル返ってくる」といったマクロ市場の売上倍率を、自社の投資回収(ROI)の根拠としてそのまま転記していないか?
- 【1タスク上限】 自動で動くAIツールやAPI連携スクリプトに対し、「1回の指示(1ジョブ)あたり最大何回までリトライを許すか(例:3回まで)」「1ジョブあたり最大何円(何万トークン)を超えたら強制停止するか」というハードリミット(上限ストッパー)がコードまたは管理画面で設定されているか?
- 【日次・月次アラート】 クラウドやAPIの請求額が「月末に請求書が届くまで誰にも分からない状態」になっていないか? 1日あたりの消費額が予算ペースの150%を超えた瞬間に、管理者へチャットやメールで自動通知が飛ぶ設定になっているか?
- 【モデルの役割分担】 ファイルの定型分類、文字起こしの整形、単純なデータ抽出といった簡単な下処理にまで、最も単価の高い最上位モデル(100万トークンあたり数ドル〜数十ドル)を無造作に割り当てていないか?
- 【キャッシュと文脈整理】 エージェントが何十ステップも動く際、不要になった過去の長いエラーログや無関係な全文データを毎回そのままプロンプトに詰め込んで送り直し、入力トークン代を何倍にも膨らませていないか?
この5つのうち1つでも「いいえ(未設定)」がある場合は、利用が広がった瞬間に予算が2.5倍へ跳ね上がる予備軍と言えます。
5. 第3章:なぜ高価なAnthropicに6割の支出が集まるのか──モデル2強寡占と自動処理が成功する「3つの条件」
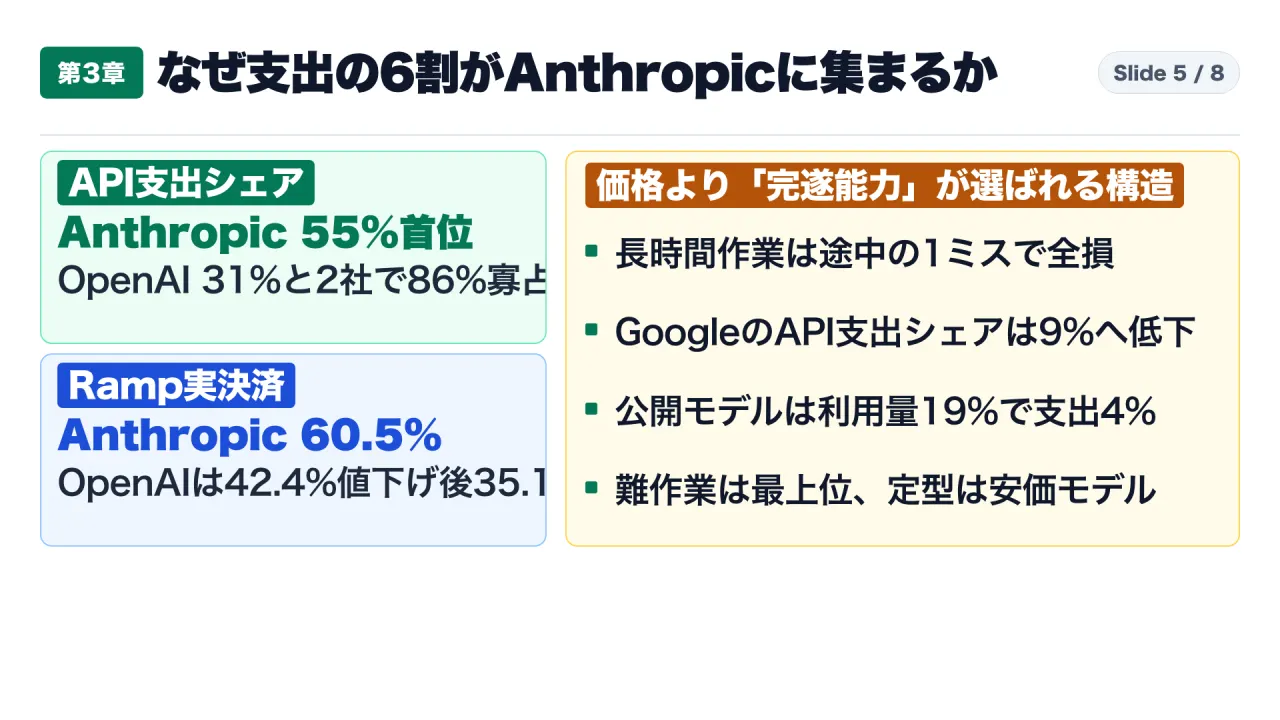
第3章では、企業がどのAIモデルにお金を払っているのか、そして773億ドルのアプリケーション市場の中で「どんな業務ならAIエージェントが成功するのか」を数字で確認します。
値下げしたOpenAIより、単価の高いAnthropicに企業支出の約6割が集まる理由
企業のAIモデル選びではいま、「多少単価が高くても、長時間の自動作業を途中で失敗せずに完遂できるモデルにお金が集まる」 という鮮明な二極化が起きています。Menlo Venturesのアンケート推計(S1)と、出資関係のない独立した法人決済サービス Ramp の8万5,000社超の実決済統計(S2:2026年10月23日までの週の集計)を並べると、驚くほど一致した結果が出ます。
| 指標・調査元 | Anthropic(Claude) | OpenAI(GPT) | Google(Gemini) | 公開モデル(Open-weight:Kimi K3 / DeepSeek V4等) |
|---|---|---|---|---|
企業向けAPI支出シェア(Menlo調査 S1) |
55%(前年40%から首位拡大) | 31%(前年27%から拡大) | 9%(前年21%から後退) | 金額シェア 4% / トークン利用量シェア 19%(平均 $0.13 / 100万トークン) |
法人トークン実決済シェア(Ramp統計 S2:2026年10月23日週) |
60.5%(9月の51.3%から急拡大) | 35.1%(9月の44.2%から低下) | 残り約4.4%(他プロバイダー含む) | Ramp直接決済上は少額 |
100万トークン平均単価の前月比変化(Ramp統計 S2) |
-15.7%(小幅な値下げ・高単価維持) | -42.4%(大幅な値下げを断行) | - | 超低単価(商用最上位の10分の1以下) |
この表で最も注目すべきは、Rampの実決済データ(S2)です。OpenAIが100万トークンあたりの平均価格を前月比で 42.4%も大幅に値下げ したのに対し、Anthropicの値下げ幅は 15.7% にとどまりました。普通の商品であれば、4割以上値下げした側にシェアが流れるはずです。ところが実際の法人支払額シェアでは、逆に単価の高い Anthropicが51.3%から60.5%へとシェアを伸ばし、AnthropicとOpenAIの2社だけで市場の約9割(Menlo推計で86%、Ramp決済で95.6%)を寡占 しています。
なぜ企業は安いモデルではなく高価なモデルにお金を払うのでしょうか。理由はエージェントの動作構造にあります。 10ステップ、20ステップと連続で作業を進める自律型AIエージェントでは、たとえば1ステップあたりの成功率が98%のモデルと90%のモデルがあった場合、20ステップ連続で成功する確率は $0.98^{20} \approx 66.8%$ に対し、$0.90^{20} \approx 12.2%$ まで暴落します。途中の1箇所で判断ミスが起きると、そこまでの計算代がすべて無駄になり、最初からやり直し(リトライ)になってかえって高くつくのです。
一方で、Moonshot AIの Kimi K3 や DeepSeek V4 といった誰でも自由に使える公開モデル(オープンウェイトモデル)は、全体のトークン利用量の 19%(約5分の1) を処理していますが、100万トークンあたり平均 0.13ドル と極めて安いため、金額ベースのシェアでは全体の 4% にとどまっています(Menlo Ventures 2026 Report:S1)。つまり賢い企業は、「複雑な判断や設計は高価でも失敗しないAnthropic等の最上位モデルに任せ、大量の定型分類や下処理は100万トークン0.13ドルの安価なモデルに流す」 という役割分担を進めているのです。
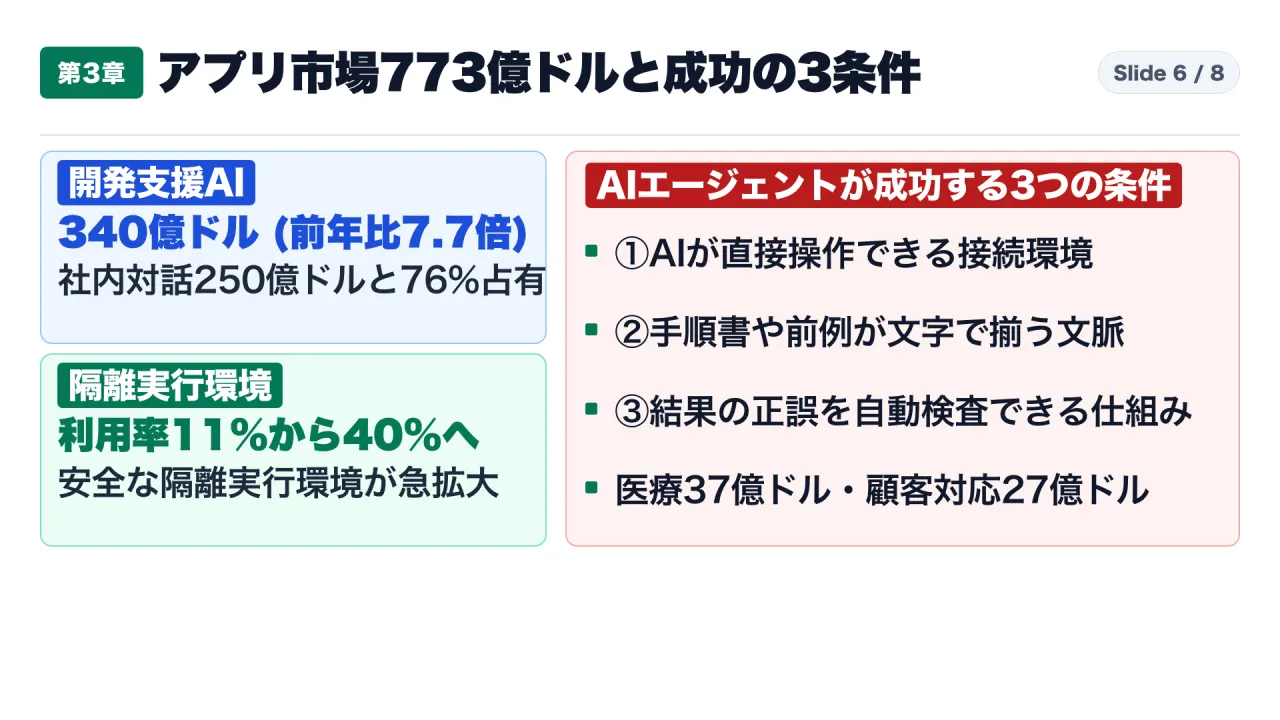
アプリ市場773億ドルの内訳と、AIエージェントが成功する「3つの必須条件」
続いて、アプリケーション層 773億ドル の部門別・業界別の内訳(S1)を見てみましょう。
- 2大コア領域(アプリ市場全体の76%=590億ドルを占有):
- プログラミング・開発支援(Coding): 340億ドル(前年比 7.7倍)
- 社内チャットボット・業務アシスタント(Horizontal Enterprise Chatbots): 250億ドル(前年比 3.0倍)
- 部門別(Horizontal Functions)および業界特化(Vertical AI)の内訳:
- 医療(Healthcare): 37億ドル(前年比 2.5倍)
- 顧客サポート(Customer Support): 27億ドル(前年比 4.3倍)
- 法務(Legal): 18億ドル(前年比 2.8倍)
- IT部門・運用管理(IT): 16億ドル(前年比 2.3倍)
- 営業(Sales): 14億ドル(前年比 3.6倍)
- 財務・経理(Finance): 13億ドル(前年比 5.5倍)
- マーケティング(Marketing): 12億ドル(前年比 1.8倍)
- 人事(HR): 9億ドル(前年比 2.0倍)
なぜ「プログラミング・開発支援」が340億ドル(7.7倍)と突出して大きく、次いで顧客サポート(4.3倍)や財務(5.5倍)、法務(2.8倍)が伸びている一方で、マーケティング(1.8倍)や人事(2.0倍)の伸びが緩やかなのでしょうか。Menlo Venturesは、AIエージェントが実務で自律稼働できるかどうかを決める 「3つの必須条件」 を明確に挙げています(Menlo Ventures 2026 Report:S1)。
- 条件1:AIが直接手を動かせる環境があること(Actionability)
- プログラムの保管庫(GitHub等)や、社内のメール、チャット、チケット管理システムにAPIで直接つながり、AI自身がファイルを読み書き・実行できる環境が整っていること。
- 条件2:仕事のルールや前例がすべて文字で揃っていること(Context)
- 過去のソースコード、設計書、契約書のひな形、顧客対応マニュアル、会計ルールなど、判断の根拠となる文脈がデジタルデータとして揃っていること。
- 条件3:結果が正しいかどうかを自動で検査できること(Verifiability)
- これが最も決定的な条件です。 AIに自由な文章を書かせると、もっともらしいウソ(ハルシネーション)が混じります。しかしプログラミングの世界には、「書いたプログラムを隔離された実験部屋(コード・サンドボックス)で実際に動かし、エラーが出ないか・自動テストに合格するかを機械的にチェックする」仕組みがあります。だからこそ、開発現場における コード・サンドボックスの利用率は2025年の11%から2026年には40%へと急増 しているのです(
S1)。 - 財務の数字突合や法務の条文照合も「ルールに合うか」を検査しやすいため自動化が進んでいます。逆に、人間の好みや主観で良し悪しが決まるマーケティングのコピー作成や人事評価は、「結果が正しいかの自動検査」が難しいため、自律エージェント化が起きにくい構造にあります。
- これが最も決定的な条件です。 AIに自由な文章を書かせると、もっともらしいウソ(ハルシネーション)が混じります。しかしプログラミングの世界には、「書いたプログラムを隔離された実験部屋(コード・サンドボックス)で実際に動かし、エラーが出ないか・自動テストに合格するかを機械的にチェックする」仕組みがあります。だからこそ、開発現場における コード・サンドボックスの利用率は2025年の11%から2026年には40%へと急増 しているのです(
【部門・業界別マトリクス】773億ドル市場の10領域を「成功の3条件」で徹底解剖する
では、読者の皆さんが自分の部署の業務を自動化しようとする際、具体的にどこから手をつければよいのでしょうか。Menlo Ventures(S1)が公表したアプリケーション市場 773億ドル の全10領域(2大コア領域+部門別6領域+医療・法務等の特化領域)について、市場規模・前年比成長率と「3つの条件(①操作環境・②文字の文脈・③自動検査)」の満たしやすさを一覧表にまとめました。
| 領域・部門 | 2026年市場規模(S1) |
前年比成長率 | 条件①:AIが直接操作できる環境(API・ツール) | 条件②:文字化されたルール・前例(文脈) | 条件③:結果の正誤を自動検査できる仕組み | 自律エージェント化の難易度と最初の着手ポイント |
|---|---|---|---|---|---|---|
| 1. プログラミング・開発支援(Coding) | 340億ドル | 7.7倍 | 極めて高い(Git、ターミナル、CI/CD) | 極めて高い(既存コード、仕様書、Issue) | 極めて高い(コード・サンドボックス利用率40%、自動テスト・型検査) | 【最優先】 単体テスト作成、古い言語やフレームワークの移行、定型バグ修正から即座に自律化可能 |
| 2. 社内横断チャット・業務アシスタント | 250億ドル | 3.0倍 | 高い(社内Wiki、メール、カレンダー、Slack等) | 高い(社内規程、過去の議事録・稟議書) | 中程度(引用元リンクの一致確認は可能だが、回答の妥当性は人間が確認) | 社内問い合わせ対応の一次回答と、複数システムにまたがる資料検索・要約の自動化に有効 |
| 3. 医療(Healthcare) | 37億ドル | 2.5倍 | 中〜高(電子カルテ、保険請求システム連携) | 高い(診療ガイドライン、保険算定ルール、音声記録) | 高い(保険請求コードの必須項目チェック、薬の飲み合わせ照合) | 医師の診察音声からのカルテ下書き作成と、保険請求(レセプト)の算定漏れ自動検査で急速に普及 |
| 4. 顧客サポート(Customer Support) | 27億ドル | 4.3倍 | 高い(問い合わせ管理システム、注文・配送DB) | 高い(FAQ、過去の対応履歴、返品・返金規約) | 高い(返品条件に合致するかのルール判定、解決率の即時計測) | 【高効果】 配送状況確認・住所変更・規約内の返品受付など、判断基準が明確な手続きから全自動へ |
| 5. 法務(Legal) | 18億ドル | 2.8倍 | 中〜高(契約書管理システム、Wordアドイン) | 極めて高い(過去の契約書、社内審査基準プレイブック、法令) | 高い(必須条項の欠落チェック、NG条項の検出ルール) | 秘密保持契約(NDA)や基本取引契約書の一次審査(社内基準からの逸脱箇所の自動赤入れ)で即戦力 |
| 6. IT部門・社内システム運用(IT) | 16億ドル | 2.3倍 | 極めて高い(監視ログ、アカウント管理、チケットシステム) | 高い(運用手順書、過去の障害対応記録) | 高い(疎通確認テスト、権限設定のポリシー照合) | パスワードリセットやアカウント権限付与の一次処理、システム障害時の初期ログ収集と原因切り分け |
| 7. 営業(Sales) | 14億ドル | 3.6倍 | 高い(CRM、メール配信、商談録画ツール) | 中〜高(商談文字起こし、製品資料、顧客企業情報) | 中程度(CRMへの必須項目入力チェックは自動、提案文の質は人間判断) | 商談録画からのCRM自動入力・次回アクション抽出、および見込み客企業の事前調査レポート自動作成 |
| 8. 財務・経理(Finance) | 13億ドル | 5.5倍 | 高い(会計ERP、請求書受取システム、銀行明細) | 極めて高い(会計基準、社内経費規程、過去仕訳データ) | 極めて高い(発注書・納品書・請求書の3点一致検査、貸借一致チェック) | 【急成長(5.5倍)】 請求書PDFの読み取りと発注データの金額突合、経費精算の規程違反チェックに最適 |
| 9. マーケティング(Marketing) | 12億ドル | 1.8倍 | 中程度(広告管理画面、CMS、SNS配信ツール) | 中程度(ブランドガイドライン、過去の配信実績) | 低い(キャッチコピーやデザインの良し悪しは主観が入り自動判定しにくい) | 全自動で公開させるのではなく、複数パターンの下書き生成と禁止表現チェックに限定して人間が選ぶ設計が安全 |
| 10. 人事(HR) | 9億ドル | 2.0倍 | 中程度(採用管理システム、勤怠・労務システム) | 中程度(就業規則、求人票、候補者履歴書) | 低い(人物評価や適性判断は正解の自動検査が困難で、法務リスクも高い) | 採用面接の日程調整や就業規則のQ&A対応に絞り、合否判定や人事評価には必ず人間の判断を介在させる |
この10領域の比較から導き出される実務上の鉄則は明快です。 自社でAIエージェントの導入テーマを選ぶときは、「テキストが上手に書けるか」ではなく、「財務の5.5倍成長や開発の7.7倍成長のように、出力結果がルールに合っているかを機械的に◯×判定できる検査機(ベリファイア)をセットで作れるか」 を基準に選んでください。検査機さえ作れれば、AIエージェントは人間が寝ている間も自分で検査と手直しを繰り返して99点の成果物を持ってきます。逆に検査機がない業務でエージェントを回すと、間違った結果をそのまま次の工程へ流し続け、手直しコストとトークン代ばかりが膨らむ結果になります。
6. 第4章:日本企業の導入率44.0%の現実──「人月契約」の限界と国内ガイドライン第1.2版のルール
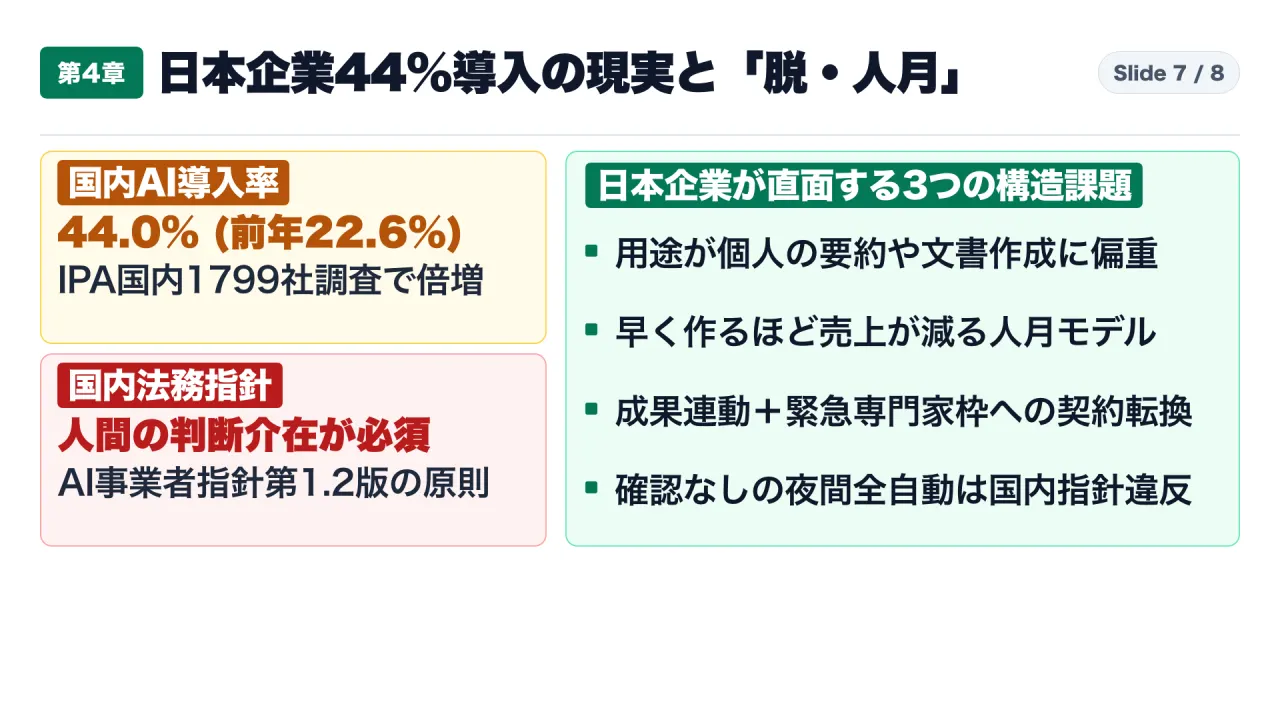
第4章では、こうした米国の急激な構造転換に対して、日本企業や国内のIT開発現場、そして法規制がいまどうなっているのかを3つの国内一次資料(S3・S4・S5)から確認します。
IPA『DX動向2026』が示す日本企業の現在地:導入率44.0%への倍増と「個人作業止まり」の壁
独立行政法人情報処理推進機構(IPA)が2026年7月30日に公開した国内企業 1,799社 対象の調査報告書 『DX動向2026』(S3)によると、日本企業における生成AIサービスの導入率は 44.0% に達し、前年度(2024年度調査)の 22.6% からほぼ倍増しました(図表3-5)。「試験導入中」の企業を含めれば過半数に迫る勢いです。
しかし、報告書の詳細データを見ると、米国企業との間に深刻な「使い方の質的ギャップ」があることが分かります。
- 日本企業における生成AIの利用用途は、「文章の要約・翻訳・校正」「社内文書やメールの下書き作成」「社内情報の検索」「アイデア出し」 といった、社員個人の手元で完結する内向きな作業 に大きく偏っています。
- 第1章・第2章で見たような、「部署の業務プロセス全体にAIエージェントを組み込み、夜間やバックグラウンドで自動処理・自動検査を回す」段階に進んでいる日本企業はまだごく一部にとどまっています(IPA DX動向2026:S3)。
システム開発の「人月モデル」の崩壊と、NTTデータ×INSEAD共同研究が示した転換
そして、AIエージェント(特に市場規模340億ドルへ急拡大したコーディング・開発支援AI)の普及が日本国内で最も大きな地殻変動を引き起こしているのが、日本のIT産業・システムインテグレーター(SIer)を支えてきた 「人月(にんげつ)モデル」 です。
日本のシステム開発では長年、「エンジニア1人が1か月働く作業量を1人月(例:単価100万円)とし、10人が6か月働けば60人月で6,000万円を請求する」という、投入した人間の労働時間(工数)に比例して対価を支払う契約 が標準でした。
ところが、AIエージェントが設計書の作成、古いプログラムの書き換え(マイグレーション)、単体テストの生成と実行までを自動でこなすようになると、「SIerが優秀なAIエージェントを導入して開発期間を3分の1に短縮するほど、請求できる人月(労働時間)が3分の1に減り、自社の売上が激減する」 という致命的な矛盾(自己否定)が発生します。実際に国内大手の実証報道でも、従来なら人間が3人月かけていた改修工程が、複数のAIエージェントの連携によって数時間で完了する事例が報告されています。
この構造問題に対し、国内最大手の 株式会社NTTデータグループ は2026年4月2日、世界有数のビジネススクールである INSEAD(欧州経営大学院) と実施した『AI時代におけるITサービス業の人材・組織変革に関する共同研究』(S5)の成果を発表しました。同発表の中では明確に、「AIの活用は、従来の人月型ビジネスモデルの持続可能性に影響を与える」 と指摘されており、投入した労働時間ではなく 「達成したビジネス成果(Outcome)や提供した知的資産の価値」に対して対価を受け取る成果志向型モデル への転換と、若手人材の育成方法の刷新が打ち出されています(NTTデータ・INSEAD共同研究:S5)。
これからのシステム発注では、発注する事業会社側も「何人月でいくらですか」と工数見積もりを値切るやり方をやめ、以下の 「ハイブリッド型契約(成果連動+定額の専門家枠)」 へ切り替える必要があります。
- ① 成果・処理単位のフィー: 「画面・API何本の移行完了」「テスト合格率」「業務処理1件あたりいくら」という成果ベースの対価。
- ② 緊急時の専門家対応枠(リテイナー契約): AIが自動生成したシステムで万が一の障害やセキュリティ事案が発生した際、業務構造とアーキテクチャを熟知した人間のシニアエンジニアが即座に介入・修正できる「保険としての固定維持枠」。
総務省・経産省『AI事業者ガイドライン(第1.2版)』が求める「人間の関与」と権限管理
もう一つ、日本企業がAIエージェントを導入するうえで絶対に守らなければならないのが、国内の法務・ガバナンス基準です。
総務省と経済産業省が2026年3月31日に公表した 『AI事業者ガイドライン(第1.2版)』(S4)では、新しく普及した 「AIエージェント」 について独立した記述が拡充されました。ガイドライン第1.2版は、AIエージェントが自律的に外部システムやクラウドサービスと連携してタスクを実行する際、「人間の意図しない商品の注文やファイル削除等の動作」「脆弱性を突かれた攻撃によるエージェント挙動の不正操作と内部データの漏えい」 が起きるリスクを明確に警告しています(総務省・経産省 AI事業者ガイドライン第1.2版:S4)。
そのうえで、AIを提供する事業者および業務で利用する企業(AI利用者)に対し、以下の安全統制を求めています。
- 人間の関与(Human-in-the-Loop)の設計: 重要な意思決定や、外部システムへの取り消せない操作(決済、発注、対外送信、本番データの削除・変更)を行う前には、必ず人間の確認・承認を挟むこと。
- 最小権限の原則(Least Privilege): エージェントに社内システム全体の管理者権限を渡さず、その業務に必要な最小限の読み取り・実行権限のみを付与すること。
- 実行履歴(ログ)の記録と監視: エージェントがいつ、どのデータにアクセスし、どんな判断でどのツールを呼び出したかを後から追跡できるように記録し、異常な連続呼び出しがあれば即座に停止できること。
米国のスタートアップのように「夜間に人間不在のまま本番環境へ全自動でデプロイさせる」といった運用をそのまま日本企業に持ち込むと、ガイドライン違反や重大な契約トラブルに直結します。「どこまでを全自動にし、どこで人間の承認ボタンを押させるか」の線引きこそが、日本企業の腕の見せ所です。
【保存版テンプレート①】システム開発・業務自動化の外注契約「従来型(人月)」vs「AIエージェント時代(ハイブリッド型)」比較表
ここで、情報システム部門や事業部門が外部のSIer・開発ベンダーへ発注する際、従来の「人月見積もり」からどうやって「成果連動+専門家枠(ハイブリッド型契約)」へ切り替えればよいのか、具体的な見積もり・契約条項の書き換え例を提示します。
| 契約の項目 | 従来の「人月(工数)モデル」 | AIエージェント時代の「ハイブリッド型(成果+専門家枠)モデル」 | 発注側・受注側双方のメリット |
|---|---|---|---|
| 1. 基本対価の算定単位 | 「上級SE 2名×6か月+PG 5名×6か月=42人月(4,200万円)」のように投入した人間の労働時間で請求 | 「対象画面・API 50本の移行完了および自動テスト合格(1本あたり60万円=3,000万円)」のように達成した成果単位で請求 | ベンダーがAIエージェントで期間を半分に短縮しても売上が減らず、発注側も総額が下がり納期が早まる(Win-Win) |
| 2. AIトークン代・実行環境費の扱い | 見積もり項目に存在しない(人間の人件費に丸め込まれている) | 「AI推論・自動検証環境費(上限付き実費精算枠:例・月50万円まで)」 を独立した費目として明記 | ベンダーが自腹を恐れて安価で低性能なAIを使う事態を防ぎつつ、上限設定で青天井の請求を防止できる |
| 3. 品質保証と検収条件 | 「テスト仕様書の消化件数」や「人間による目視確認の完了」 | 「隔離実行環境(サンドボックス)での自動回帰テスト合格率100%」+「セキュリティ静的解析での重大脆弱性ゼロ」 | AIが大量生成したコードの品質を、人間の目視ではなく機械的な自動検査ゲートで客観的に担保できる |
| 4. 稼働後の保守・障害対応 | 「常駐保守メンバー1人月(月100万円)」のように平時も人間を拘束 | 「緊急時のシニアアーキテクト介入枠(リテイナー契約:月40万円で重大障害時に2時間以内に専門家が直接調査・修正)」 | 平時はAIと自動監視でコストを抑えつつ、AIでは解決できない未知の複合障害時だけ一流の人間の頭脳を確保できる |
【保存版テンプレート②】総務省・経産省『AI事業者ガイドライン(第1.2版)』準拠の社内AIエージェント権限レベル(Lv.1〜Lv.3)定義表
次に、社内の部署でAIエージェントを動かす際、そのまま社内規程や運用ルールに貼り付けて使える「3段階の権限・承認ライン(Human-in-the-Loop)定義表」をまとめます。
| 権限レベル | 対象となるAIエージェントの操作内容 | 人間の承認(Human-in-the-Loop) | トークン予算・実行回数ストッパー | ログ記録・監査要件(国内指針第1.2版準拠) |
|---|---|---|---|---|
| Lv.1:完全自動実行(Read & Sandbox) | ・社内公開文書の検索・要約・翻訳 / ・隔離された実験部屋(サンドボックス)内でのコード生成とテスト実行 / ・下書きファイルの作成(本番未反映) | 事後確認のみ(事前承認不要) | ・1タスク上限:100円(またはリトライ3回まで) / ・1日あたり部署上限:5,000円 | 呼び出した日時・モデル名・消費トークン量を自動で台帳へ記録 |
| Lv.2:人間のワンクリック承認必須(Internal Write & External Send) | ・社内データベース(CRM・会計・台帳)のレコード更新 / ・取引先や顧客へのメール送信・チャット投稿 / ・本番プログラムへのマージ(PR統合) | 実行直前に人間の担当者が差分画面を確認し「承認ボタン」を押すことが必須 | ・1タスク上限:500円(またはリトライ5回まで) / ・異常ループ検知時は即時ロック | AIが生成した変更差分(Diff)と、「誰がいつ承認ボタンを押したか」のIDをセットで保存 |
| Lv.3:複数名承認またはAI直接実行の禁止(Critical Action) | ・1万円以上の発注・決済・送金処理 / ・顧客個人情報(機密区分)の外部送信や一括削除 / ・アクセス権限やセキュリティ設定の変更 | AIによる直接実行をシステム権限上で遮断(人間が上長承認を経て操作) | ・AIには「申請書の下書き作成」までしか権限を与えない | 権限昇格の試行や禁止APIへのアクセス試行があった場合は即座に管理者へ緊急アラート通知 |
このように「何でも禁止する」のではなく、「Lv.1の安全な箱庭では夜通し全自動で働かせ、Lv.2の外に出る瞬間だけ人間が承認ボタンを押し、Lv.3の決済や削除は権限自体を渡さない」という境界線を引くことで、安全とスピードを両立できます。
7. 結論:一次資料から確定した事実、【私なりの解釈】、明日から職場で試せる3つの実践ステップ
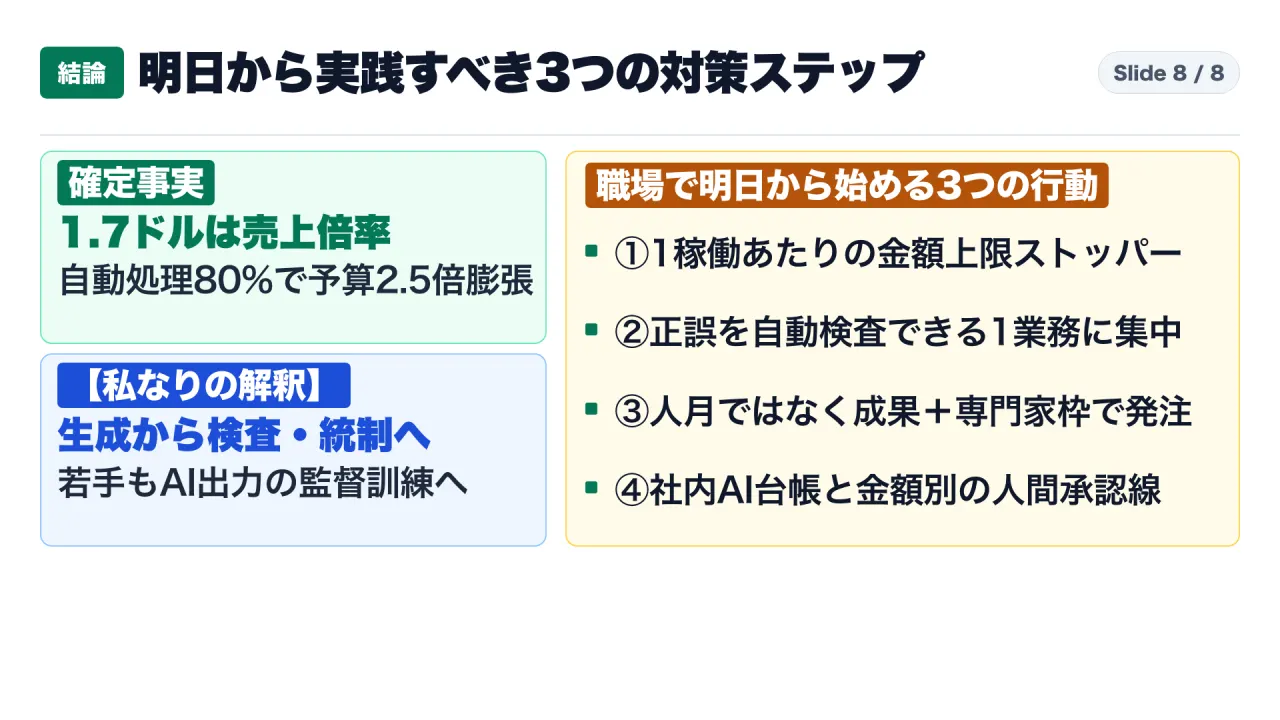
全体のまとめとして、5つの一次資料から確認できた「確定事実」と、データから導かれる「私なりの解釈」、そして明日から職場で着手できる「3つの実践ステップ」を整理します。
一次資料から確定した事実の整理
- 市場規模と「1.70ドル」の正確な定義(
S1): 企業のAI導入支出は2026年9月時点で年換算 1768億ドル(約27兆円、前年330億ドル比5.4倍、インフラ995億ドル+アプリ773億ドル) に達しました。一方、ニュース等で語られた「1ドルあたり1.70ドル」は、モデル開発費 1025億ドル(1ドル) に対する導入支出 1768億ドル(約1.70ドル) の比率(売る側の売上倍率)であり、導入企業の投資利益率(ROI)ではありません。 - エージェント比率80%と予算2.5倍膨張(
S1・S2): OpenRouter上の全トークン消費量の 80%(週130.9兆トークン、人間の約7倍) を自律型AIエージェントが占め、企業のAI支払実績は当初計画(前年比 1.9倍)に対し平均 4.7倍(当初予算の約2.5倍) に膨張しています。 - モデル2強寡占と成功の3条件(
S1・S2): 企業API支出では Anthropic(55%、Ramp実決済で60.5%) と OpenAI(31%、Ramp実決済で35.1%) が約9割を握り、長時間作業での途中ミスを防ぐため高単価でも完遂力の高いモデルが選ばれています。またアプリ市場773億ドルの76%は開発支援(340億ドル)と社内チャット(250億ドル)に集中しており、「操作環境・文字化されたルール・正誤の自動検査」の3条件が揃う業務で成果が出ています。 - 日本企業の導入率44.0%と「脱・人月」、国内指針(
S3・S4・S5): IPA調査で日本企業の生成AI導入率は 44.0%(前年度22.6%)へ倍増したものの個人用途が中心であり、SI業界での「人月モデル」から成果志向型モデルへの転換(NTTデータ・INSEAD共同研究)と、『AI事業者ガイドライン(第1.2版)』に沿った人間の承認関与・権限管理が急務となっています。
【私なりの解釈】
ここまでの一次データを突き合わせると、私なりの解釈として、これからの企業と個人の競争力は 「AIのチャット画面に上手な質問(プロンプト)を書けるかどうか」から、「自動検査できる業務を切り出し、予算暴走と権限暴走に安全ブレーキをかけながらAIエージェントを監督する設計力があるか」へと完全に移った と言えます。
これに伴い、ホワイトカラーの働き方とキャリアの階段も根本から変わります。これまで新卒や若手の社員が最初の3〜5年間で経験を積んでいた「資料の下調べ」「議事録や報告書の作成」「定型的なプログラムの書き換えとテスト」といった下積み作業は、最もAIエージェントに置き換わりやすい領域です。したがって企業は、「下積み作業をさせながら自然に仕事を覚えさせる」という従来のOJTを諦め、入社1年目から「AIエージェントが出した3つの案と検査ログを見て、根拠の誤りやリスクを見抜いて承認・修正する監督者(レビュアー)の訓練」 へと教育カリキュラムを切り替えなければ、数年後に中堅層が空洞化するリスクがあります。
明日から職場で確認・実行できる3つの実践ステップ
最後に、特別な開発予算がなくても明日から職場で着手できる3つの具体的な行動を提案します。
ステップ1:社内稟議とAIツール設定に「1稼働あたりの上限ストッパー」と「2段階モデル分業」を入れる
- 着手条件: 社内で従量課金(API課金・クレジット課金)のAIツールや自動実行スクリプトを導入・稟議申請する場合。
- 具体的な手順:
- 稟議書に「1ドルで1.7ドル儲かる」といった出所不明の利益率を書くのをやめ、まずは対象業務の「現在の作業時間×時給」と「AIの1回あたり想定トークン代」で現実的な試算を書く。
- システム設定(または利用ルール)において、「1回のタスク(1ループ)あたりの最大リトライ回数(例:最大3回まで)と金額上限(例:1タスク100円〜500円を超えたら強制停止して人間へ通知)」 を必ず設定する。
- すべてを最高単価のモデル(Claude Opus等)に処理させるのではなく、定型的な文字抽出や分類は安価な軽量モデル・公開モデル(100万トークン0.13ドル〜数ドル)に振り分け、最終判断や複雑な設計だけを最上位モデルに渡す2段階構成にする。
ステップ2:個人の文章要約から一歩進め、「正誤を自動でチェックできる1業務」を選んで自動化する(外注は「成果+専門家枠」へ)
- 着手条件: 社内のAI活用が「メールの下書きや議事録の要約」で止まっており、業務時間の削減につながっていない場合。
- 具体的な手順:
- Menlo Venturesの「成功の3条件(操作環境・文字のルール・自動検査)」に照らし、自部署の業務の中から 「結果が正しいかどうかをルールやプログラムで機械的に判定できる業務」 を1つだけ選ぶ(例:請求書PDFと発注データの金額・日付突合、社内規程集に照らした申請書の必須項目チェック、古いプログラムの書き換えと自動テスト実行)。
- その業務に必要な過去のお手本とチェックリストをテキストファイルにまとめ、AIに「チェックリストの全項目を満たすまで下書きと自己検査を繰り返す」手順を組ませる。
- 外部のシステム開発会社へ発注する際は、「エンジニア何人月か」で見積もりを取るのではなく、「移行・開発する機能単位の成果報酬」と「稼働後のトラブル時に専門家が即座に調査・修正する月額固定の保守枠」 に分けて提案を依頼する。
ステップ3:『AI事業者ガイドライン(第1.2版)』に沿い、社内AI台帳と「金額・影響度別の人間承認ライン」を作る
- 着手条件: 部署内や社内で、社内データや外部サービスにつながるAIツール・自動化連携(MCPやRPA連携など)を使い始めている場合。
- 具体的な手順:
- まずスプレッドシート1枚でよいので、「どの部署が、どのAIサービスを使い、どの社内データ(顧客情報・財務データ・ソースコード)にアクセスしているか」を一覧化した 社内AI台帳 を作る。
- AIが行う操作を2段階に分け、「Lv.1(自動実行OK):社内データの検索・集計・下書き作成・テスト環境でのプログラム実行(実行ログのみ自動保存)」 と、「Lv.2(人間の事前承認ボタン必須):社外へのメール送信・顧客データの書き換え・1万円以上の発注や決済・本番システムへの反映」 という明確な承認ライン(Human-in-the-Loop)を部署のルールとして明文化する。
【実践付録①】そのままコピペして使える「AIエージェント導入稟議書・費用対効果(ROI)試算シート」の書き方テンプレート
第1章で確認した通り、稟議書に「Menlo Venturesの調査で1ドルあたり1.70ドルのリターンがあると証明された」と書くのは事実誤認であり、導入後に予算が2.5倍へ膨らんだ際に説明がつかなくなります。では、経営陣や財務部門に対して、従量課金(仕事量課金)のAIエージェント導入をどう説明し、どう予算枠を取ればよいのでしょうか。明日から社内稟議にそのまま使える記述テンプレートと試算式をまとめます。
1. 稟議書の「導入目的と市場背景」欄の記述例(一次資料の正しい引用法)
【稟議書記載例:背景と目的】 米国Menlo Venturesの2026年企業AI調査(2026年11月公表)によれば、世界の企業によるAI実利用支出は年換算1768億ドル(前年比5.4倍)に達し、モデル開発費(1025億ドル)の1.70倍の規模へ拡大している。またモデル中継基盤OpenRouter上のトークン消費量の80%(週130.9兆トークン)を自律型AIエージェントが占め、国内でもIPA『DX動向2026』において生成AI導入率が44.0%(前年度22.6%)へ倍増するなど、AI活用は「個人の対話補助」から「業務プロセスの自動実行」へ移行している。 一方で、同調査では企業のAI支払実績が当初予算の約2.5倍(計画1.9倍に対し実績4.7倍)へ膨張している実態も報告されている。そのため本件では、①結果の正誤を自動検査できる「〇〇業務」に対象を限定し、②1処理あたりの上限金額ストッパーと2段階モデル分業(高難度判断のみ最上位モデル、定型処理は安価モデル)を組み込むことで、予算超過リスクを遮断しつつ業務処理時間を月間〇〇時間削減する。
2. 従量課金AIエージェントの「月間予算・費用対効果(ROI)」実務試算式
稟議書で予算を計算する際は、従来の「社員数×月額」ではなく、必ず以下の 「4変数モデル(件数×ステップ数×単価×安全係数)」 で試算してください。
- 月間の対象業務件数($N$): 例:月間 500件 の請求書突合・コード改修・契約書一次審査
- 1件あたりの標準消費トークン代($C_{\text{base}}$):
- 下処理(軽量・公開モデル:100万トークン0.13ドル〜1ドル)+ 最終判断・検査(最上位モデル:Anthropic Claude等)の合計で、たとえば1件あたり平均 40円 と実測
- 自動やり直し(リトライ)上限係数($R_{\max}$):
- 自動検査で不合格になった場合の再試行をシステム設定で 最大3回(平均1.5回稼働) に制限
- 月間トークン予算の上限枠(ハードキャップ):
- $500\text{件} \times 40\text{円} \times 1.5\text{(平均リトライ含む)} = 30,000\text{円/月}$
- ここに繁忙期の変動を見込んだ 安全バッファ(1.5倍) を掛け、システム上の月間強制停止ライン(ハードキャップ)を 月45,000円 に設定する。
- 削減される人間側の工数価値との比較(純効果の算出):
- 従来、人間が1件あたり20分かけていた作業が、AIエージェントの自動実行+人間の最終承認3分に短縮された場合、1件あたり 17分 の削減(月500件で 約141時間 の削減)。
- 時給換算3,500円とすれば月間 約493,500円相当 の工数削減となり、月間上限45,000円のトークン予算(+初期設定工数)に対して十分な投資回収が成り立つことが、誰の目にも検証可能な数字として説明できます。
【実践付録②】現場でよくある5つの疑問・反論への回答集(FAQ)
最後に、社内でこの「上限ストッパー」「自動検査」「脱・人月契約」を提案した際に、上司や他部署、あるいは発注先ベンダーから必ず出てくる5つの疑問と、一次資料に基づく具体的な回答例を整理しておきます。
Q1. 「OpenAIが42.4%も値下げしているなら、全部一番安いモデルに統一すれば予算2.5倍問題は解決するのではないか?」
- 回答: Rampの法人決済データ(
S2)とMenlo Venturesの調査(S1)が示す通り、「全部を安いモデルに統一する」とかえって失敗と手直しが増えて高くつきます。 - 複数ステップを連続で動かすAIエージェントでは、途中の1ステップで指示の読み違えや判断ミスが起きると、そこから先の処理がすべて無駄になり、リトライ(やり直し)でトークン代が何倍にも膨らみます。そのため世界の企業は、42.4%値下げされたモデルよりも、単価が高くても長時間の作業を正確に完遂できるAnthropic(企業APIシェア55%、Ramp実決済シェア60.5%)を主力に選んでいます。正解は「安いモデルへの一括統一」ではなく、「定型の下処理(全体の6〜8割)は100万トークン0.13ドル等の安価なモデルに流し、設計・判断・最終検査の急所(全体の2〜4割)にだけ最上位モデルを使う2段階分業」 です。
Q2. 「うちの部署はプログラミング(開発)部門ではないが、コーディング以外の業務ではどこから自動化すべきか?」
- 回答: Menlo Venturesの部門別データ(
S1)で前年比 5.5倍 と急成長している 財務・経理(13億ドル)、4.3倍 の 顧客サポート(27億ドル)、2.8倍 の 法務(18億ドル) の共通点に注目してください。 - これらはすべて 「チェックリストや数値の一致で、結果が正しいかを自動検査しやすい業務」 です。非エンジニアの部署であっても、①「請求書PDF・納品書・発注マスタの金額と日付の3点突合」、②「取引先から届いた秘密保持契約書(NDA)が自社の審査基準10項目を満たしているかの一次チェック」、③「顧客からの定型問い合わせに対する社内マニュアル照合と回答案作成(引用元リンク付き)」の3つは、判断基準が明確なため今日からでも高い精度で自動化できます。
Q3. 「開発ベンダー(SIer)に『人月ではなく成果連動+専門家枠で契約したい』と切り出したら、嫌がられないか?」
- 回答: NTTデータグループとINSEADの共同研究(
S5)が自ら「AI活用は従来の人月型ビジネスモデルの持続可能性に影響を与える」と公表している通り、優良なSIerや開発会社ほど、すでに「人月モデルの限界」を強く認識しています。 - 重要なのは、単に「AIで楽になったはずだから値下げしろ」と迫るのではなく、「AIエージェントを活用して50本の画面移行を3か月で完遂してくれたら、かかった人数や時間に関係なく成果報酬として〇〇万円を満額支払う。その代わり、AI推論費用は月〇万円まで実費枠を設け、稼働後の緊急障害対応はシニアエンジニアのリテイナー枠(月額固定)として別途契約する」 と提案することです。この形であれば、ベンダー側もAIを使って生産性を上げるほど利益率が向上するため、優秀なエンジニアと最新のAI環境を優先的に自社の案件へ投入してくれるようになります。
Q4. 「総務省・経産省の『AI事業者ガイドライン(第1.2版)』にある『人間の関与(Human-in-the-Loop)』を全部に入れると、結局人間が忙しくなって自動化の意味がなくなるのではないか?」
- 回答: すべてのステップに人間の確認を入れる必要はありません。ガイドライン第1.2版(
S4)が警戒しているのは、「意図しない外部発注や決済」「重要ファイルの削除」「攻撃による内部情報の外部送信」といった 取り消しができない対外・本番操作 です。 - したがって、資料の検索・集計・プログラムの下書き作成・隔離された実験部屋(サンドボックス)でのテスト実行といった 「やり直しが効く内部作業(Lv.1)」は100%全自動で夜間に回して構いません。 そして、翌朝出社した人間が「自動テストに合格した完成案と変更差分(Diff)の一覧画面」を見て、問題がなければ承認ボタンを1回押して本番反映・送信する(Lv.2)という設計にすれば、人間の作業時間は従来の10分の1以下に減りつつ、ガイドラインの安全要件も100%満たせます。
Q5. 「若手社員がやっていた下調べや初期コード作成をAIエージェントに任せると、3〜5年後に現場の誰も業務の中身を理解できなくなるのではないか?」
- 回答: これはNTTデータ×INSEADの共同研究(
S5)でも最重要課題として挙げられているポイントです。対策は明確で、「若手に手作業でゼロから作らせる訓練」を「AIエージェントが出した成果物と検査ログを監査・修正する訓練」へ置き換えること です。 - 具体的には、若手社員に対して「AIが作ったこの契約書審査案(またはプログラム修正案)の中に、意図的に2箇所だけルール違反や境界条件の抜け漏れを混ぜてある。一次資料と照らし合わせてその2箇所を見つけ出し、なぜAIが間違えたのかを説明せよ」という 監督・監査型のトレーニング(レッドチーム訓練) を日常業務に組み込みます。これにより、自分で手を動かして書くよりもはるかに多くの事例と判断基準を短期間で学ぶことができ、入社1〜2年目から「AIを使いこなして品質を保証できるプロフェッショナル」を育てることができます。
Q6. 「オープンウェイトの公開モデル(Kimi K3やDeepSeek V4など、100万トークン0.13ドル)を社内で使う場合、情報漏えいやセキュリティの心配はないのか?」
- 回答: Menlo Venturesのレポート(
S1)にある通り、公開モデル(オープンウェイトモデル)は全体のトークン利用量の 19% を占めていますが、これは必ずしも「海外のサーバーへ直接データを送っている」という意味ではありません。 - 公開モデルの最大の利点は、モデルの重み(プログラムの設計図)が公開されているため、自社が契約している国内リージョンのクラウド環境(AWS、Google Cloud、Azure等の専用仮想サーバー)や社内サーバーにモデルを持ち込んで、外部へ1文字もデータを出さずに動かせる(あるいはプライバシー保護契約のある米国・国内の推論中継基盤経由で動かせる) 点にあります。したがって、機密性の高い社内ログの一次分類や定型フォーマット変換こそ、安全なクラウド閉域網の中に置いた低単価な公開モデル(または軽量商用モデル)で処理し、どうしても高度な推論が必要な部分だけを法人契約(学習利用なし条件)の最上位モデルへ渡す構成が、コスト面でもセキュリティ面でも最も合理的です。
Q7. 「すでに社内で複数の部署がバラバラにAIツールを契約してしまっている場合、何から手をつければよいか?」
- 回答: まずは「禁止令」を出すのではなく、総務省・経済産業省『AI事業者ガイドライン(第1.2版)』(
S4)およびIPA『DX動向2026』(S3)の趣旨に沿い、「1週間で全社AI利用台帳(棚卸し表)を作ること」 から始めてください。 - 具体的には、各部署に対して「①ツール名・モデル名、②課金形態(定額シート課金か、API・クレジット従量課金か)、③接続している社内データの種類、④月間の予算上限設定の有無、⑤社外送信・本番反映時の人間承認の有無」の5項目だけをアンケートで回答してもらいます。そのうえで、定額シート課金で個人の要約にしか使われていない休眠アカウントを整理し、浮いた予算を「自動検査ができて業務時間が確実に減る領域(開発・財務突合・顧客サポート一次対応・法務一次審査)」のエージェント環境へ集中的に再配分してください。
8. 一次資料・参考文献一覧(全5件)
- S1: Menlo Ventures “2026: The State of Enterprise AI”(2026年11月3日公開)
- 米国の企業意思決定者約400名(管理AI予算40億ドル超)の調査およびOpenRouter等の実利用統計。企業のAI導入支出1768億ドル(前年330億ドル比5.4倍、インフラ995億ドル+アプリ773億ドル)、モデル開発費1025億ドルに対する1.70ドルの比率、OpenRouter上のエージェント占有率80%(週130.9兆トークン)、予算計画1.9倍対実績4.7倍、APIシェア(Anthropic 55%・OpenAI 31%)を確認。
- S2: Ramp Economics Lab “Ramp AI Index”(2026年10月集計)
- 米国8万5,000社以上の法人カード・請求書決済データに基づくAI支出指数。2026年10月23日週における法人トークン支払額シェア(Anthropic 60.5%・OpenAI 35.1%)、100万トークンあたり平均価格の前月比変化(OpenAI -42.4%・Anthropic -15.7%)、上位1%企業による支出牽引を確認。
- S3: 独立行政法人情報処理推進機構(IPA)『DX動向2026』(2026年7月30日公開)
- 国内企業1,799社対象の定点調査。日本企業の生成AI導入率44.0%(前年度22.6%から倍増、図表3-5)および個人単位の要約・文書作成への用途集中と業務プロセス統合の課題を確認。
- S4: 総務省・経済産業省『AI事業者ガイドライン(第1.2版)』(2026年3月31日公表)
- AIエージェントの自律的動作に伴う意図しない操作・外部連携リスクの定義、および人間の関与(Human-in-the-Loop)・最小権限設定・実行履歴記録のガバナンス要件を確認。
- S5: 株式会社NTTデータグループ・INSEAD『INSEADとAI時代におけるITサービス業の人材・組織変革に関する共同研究を実施』(2026年4月2日発表)
- AI活用が従来の人月型ビジネスモデルの持続可能性に与える影響と、成果志向型(Outcome-based)モデルへの移行および人材育成の変革を確認。
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
動画での解説・関連記事・自己紹介
- YouTubeポッドキャスト本編:なぜ企業のAI利用料は「予算の2.5倍」に膨らみ、「1ドルで1.7ドル儲かる」という話を信じると失敗するのか?
- 初めての方へ(固定自己紹介記事):なぜ海外一次資料の「原典」まで遡るのか──このnoteとポッドキャストの使い方
あわせて読みたい関連記事(AI予算・モデル分業・インフラの一次資料解説)
/ja/articles/2026-11-10-fable-5-2-muse-ember-auto-code-3tier-agent-economics/
/ja/articles/2026-11-11-tpu-8i-max-autocompress-cisco-ai-factory-memory-wall/