なぜAIが本番を書く時間は「23%」しかなく、残り77%を分担すると安くなるのか
YouTubeポッドキャスト本編(動画・音声)はこちら:なぜAIが本番を書く時間は「23%」しかなく、残り77%の下調べを「料金3分の1」のAIへ任せると安くなるのか?
https://www.youtube.com/watch?v=RPfAp2a6iuQ
社内のシステム開発や日常業務に自律型AIエージェントを導入したものの、「毎月のAPI利用料金ばかりが数倍に膨れ上がって採算が合わない」、**「AIに仕事を頼んでも、事前のファイル探しや開発環境のエラー、テスト待ちばかりでなかなか本番の仕事が進まない」**という悩みが多くの職場で噴出しています。
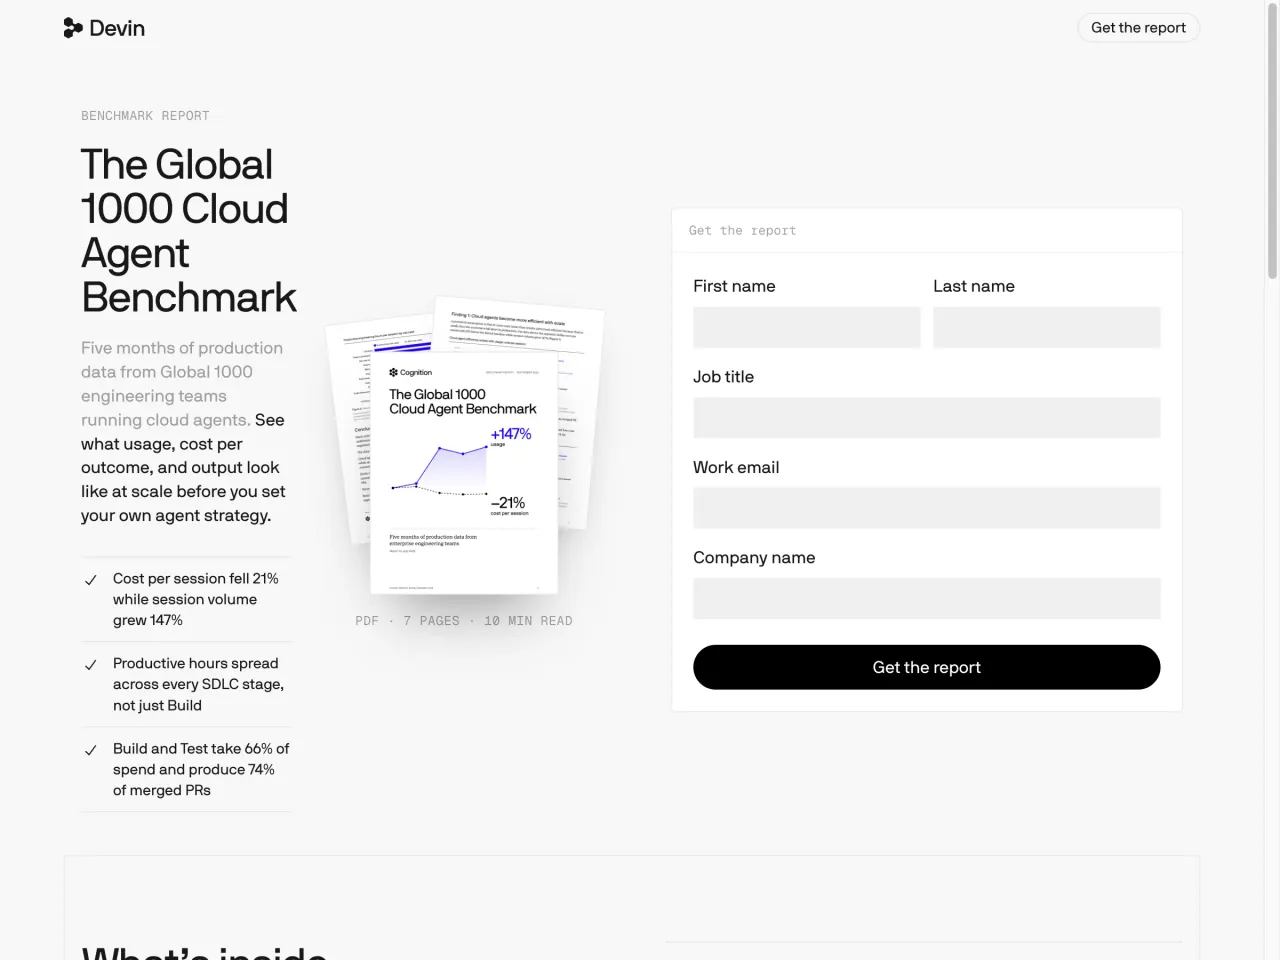
なぜ「一番賢い最高級AI」を1つ契約して全部の仕事を任せると、これほど費用が膨らみ、作業が止まってしまうのでしょうか。その答えを世界の大企業1,000社・5ヶ月間の本番稼働データから突きつけたのが、自律型AIソフトウェアエンジニア「Devin」を開発する Cognition の最新レポート 『The Global 1000 Cloud Agent Benchmark』(Devin公式ページ / TLDR AI公式要旨)です。同レポートは、AIエージェントの生産的な実働時間のうち、実際にプログラムのコードを書いている時間は全体のわずか「23%」にすぎず、残りの「77%」は計画・設計、環境構築、社内コードや資料の下調べ、テストの実行と検証、セキュリティ確認、デプロイといった「コード記述以外の周辺工程」に費やされているという決定的な事実を明らかにしました。
同時に、この「残り77%の下調べ・道具呼び出し・テスト反復」の費用と待ち時間を劇的に圧縮する切り札として、Meta は1タスクあたりの平均実行費用を従来の小型モデル(Claude Haiku 5.5:0.41ドル)の 約3分の1、最上位モデル(Claude Opus 5.5:10.04ドル)の 約72分の1 にあたる 0.14ドル(約21円) へ引き下げ、かつウソをつく確率(ハルシネーション率)を全モデル中2位の 17% に抑えたエージェント特化型小型モデル 『Muse Ember』(Meta Research / Artificial Analysis独立検証)を発表しました。さらに Cognition 自身も、上位モデルの 5分の1の価格・3倍以上の速度(毎秒200トークン) で動きながら実務ベンチマークで上位モデルを逆転した 『SWE-2 Flash』(Cognition公式ブログ)を投入しています。
この記事では、これらに Anthropic の最上位モデル 『Claude Fable 5.2』(20%値下げ・最大30%高速化・30時間証明100%完遂)、OpenRouter の自動振り分け基盤 『Auto Code』(上位AIを9.0%の難所に温存しコスト74%削減)、そして Google Cloud の長文推論特化半導体 『TPU 8i Max / 8tx』(メモリ帯域幅2倍の17.2 TB/s)を加えた全5系統の一次資料と15枚の検証図表をもとに、AIの無駄遣いとテスト待ちをなくす実践的な設計図を徹底解説します。
1. 結論と対象読者:この記事で分かることと明日から実践できる行動
対象読者(いま直面している課題)
- AIエージェントやコーディング支援を導入したが、1回あたりのAPI従量課金が高すぎて全社展開に踏み切れない開発責任者・事業企画担当者
- AIに作業を依頼しても、既存の社内コードの調査やテスト環境のエラーで何度も足踏みし、人間が手直しする時間が減らないエンジニア・PM
- 最上位モデル(Claude Fable 5.2 / Opus 5.5等)と、新しく登場した低価格・高速モデル(Meta Muse Ember / Cognition SWE-2 Flash等)をどう組み合わせればよいか基準を知りたい技術リーダー
一次資料から導かれる4つの核心的結論
- 大企業1,000社・5ヶ月間の本番データが証明した「コード記述は23%、残り77%は準備・調査・テスト」の現実:
- Cognitionが集計したGlobal 1000企業の5ヶ月間のDevin本番データにおいて、生産的なエンジニアリング実働時間のうち コードを書いている時間は23% しかなく、残り77%はソフトウェア開発ライフサイクル(SDLC)の他工程(計画・設計、環境構築、文脈探索、テスト検証、セキュリティ確認、デプロイ) に費やされています。特に 「構築(Build)」と「テスト(Test)」の2工程だけで全予算(ACU消費)の66%を占め、本番へ統合されたプルリクエスト(merged PRs)の74%を生み出しています。また、手順書(プレイブック)と開発環境を整備した企業では、5ヶ月間で セッション利用量が147%増加(約2.5倍)する一方、1セッションあたりのコストは21%低下 しました。
- Meta「Muse Ember」が達成した「1タスク0.14ドル(約21円:料金3分の1〜72分の1)」と「ハルシネーション率17%(世界2位の誠実さ)」:
- Metaの小型特化モデル
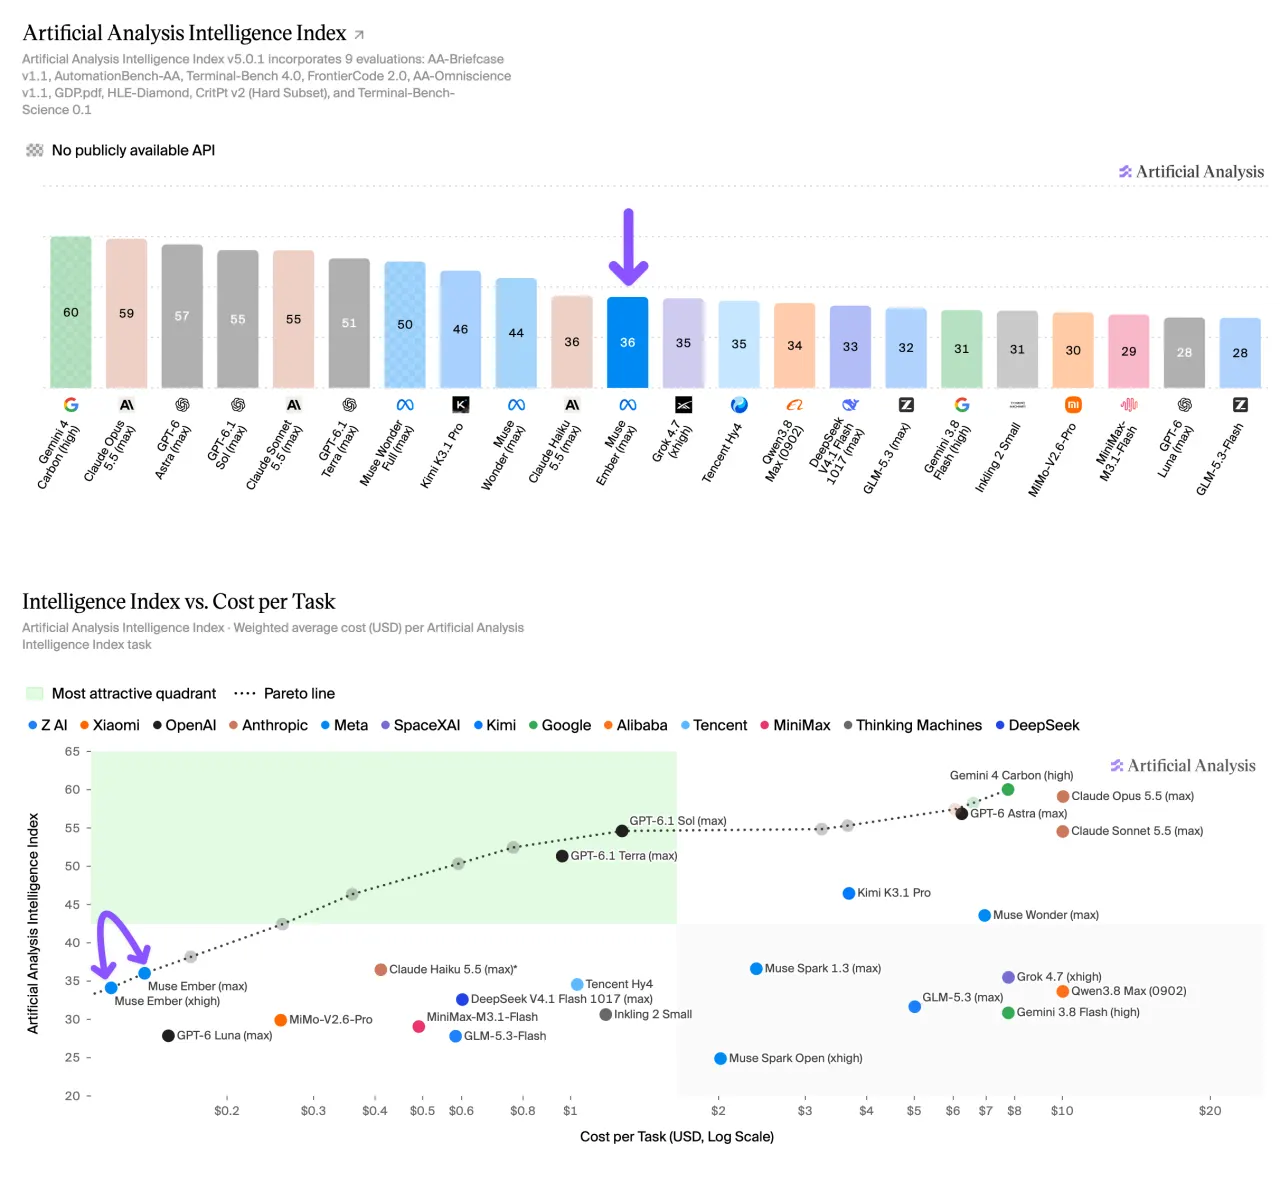
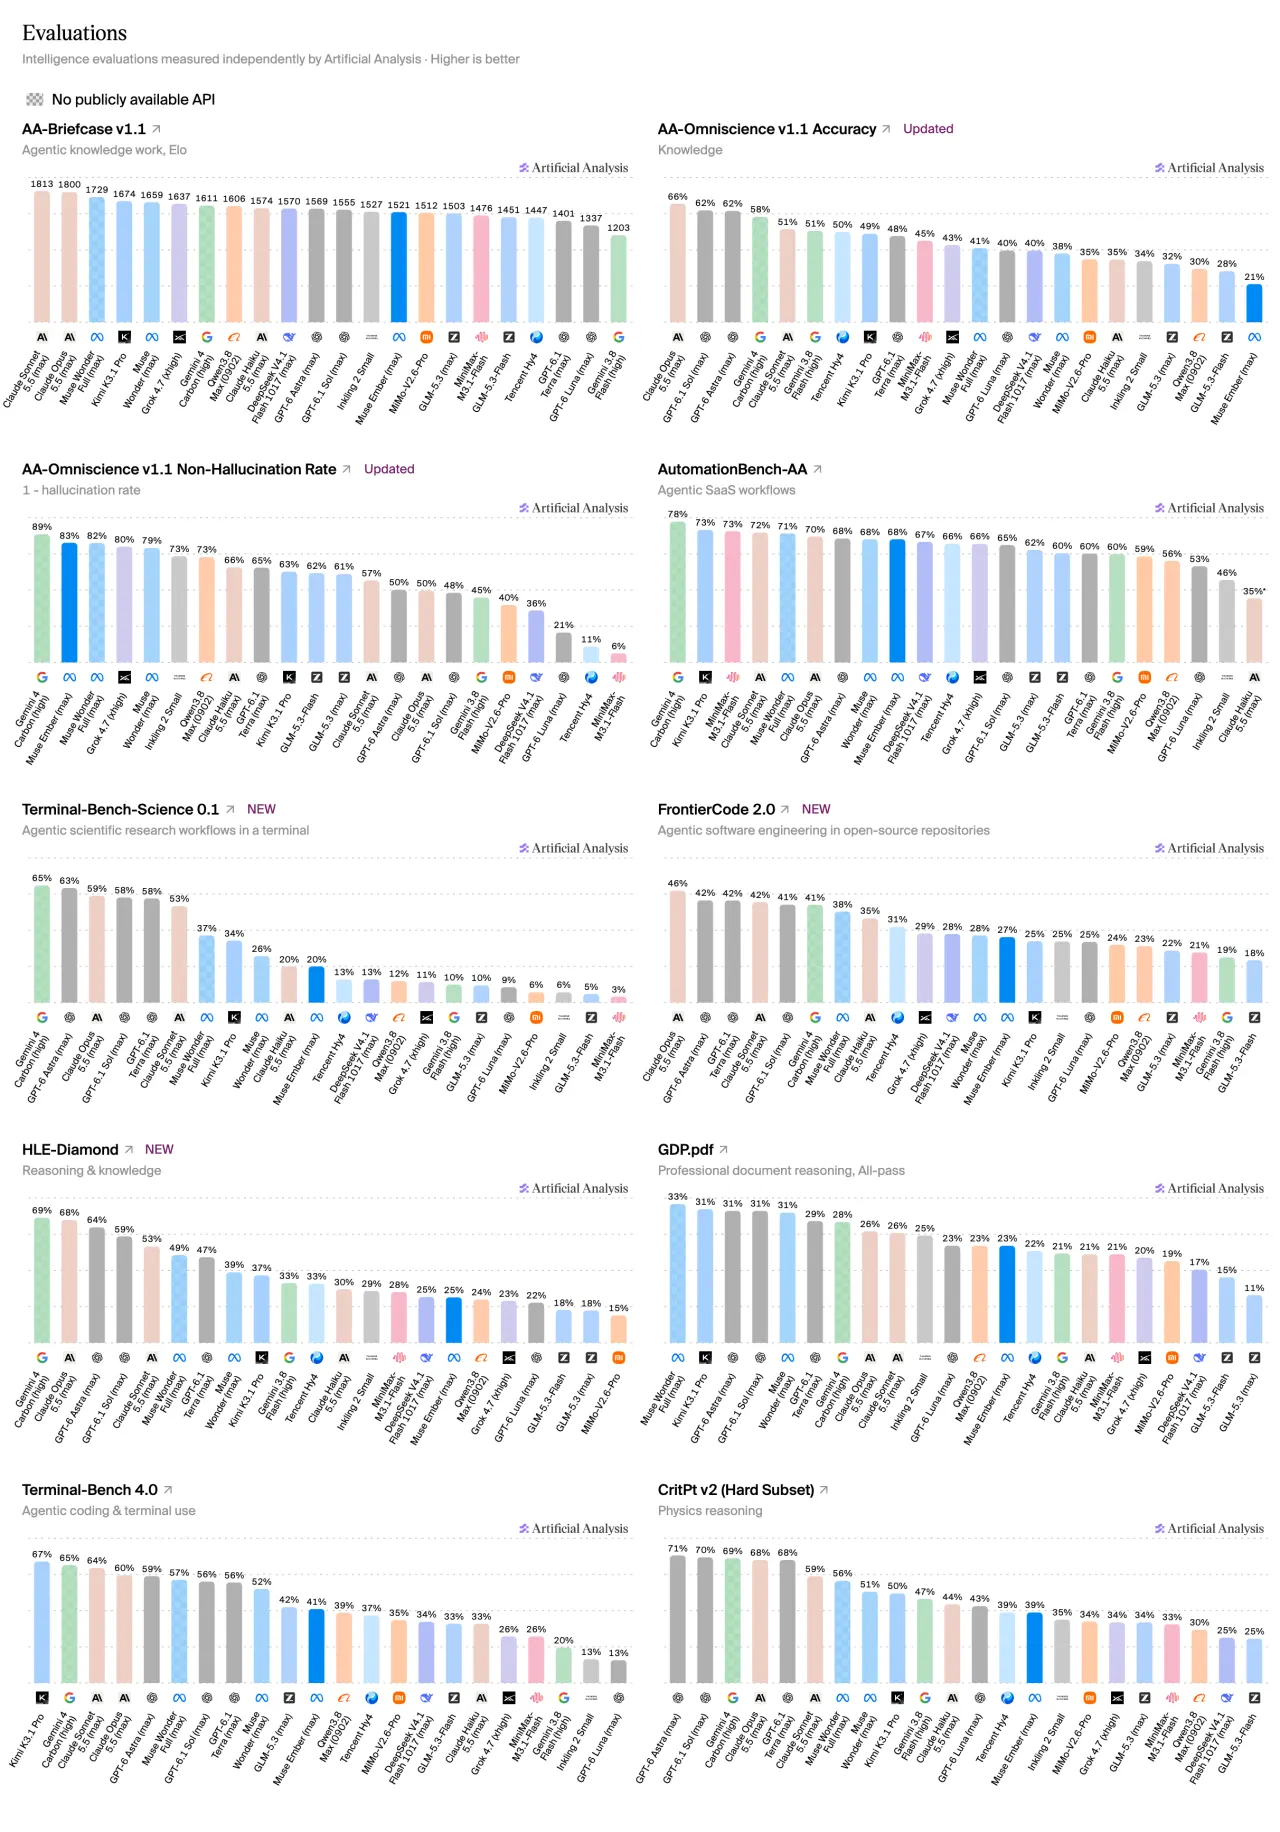
Muse Ember(入力256K・最大出力128K、100万トークンあたり 入力0.10ドル・出力0.40ドル・キャッシュ入力0.015ドル)は、Artificial Analysisの総合知能指数(v5.0.1)で スコア36(35.8) を記録し、Claude Haiku 5.5(スコア35)と同等の知能を持ちながら、1タスク平均コスト0.14ドル(Haiku 5.5の0.41ドルの約3分の1、Opus 5.5の10.04ドルの約72分の1) を実現しました。出力トークン量が8.4万トークン(Haiku 5.5の22.6万トークンの約37%)と無駄な長文思考を垂れ流さず、知らない問題を当てずっぽうで答えず棄権できるため ハルシネーション率はわずか17%(全モデル中2位)、コーディングエージェント指数では スコア46(Haiku 5.5は37、GPT-6 Lunaは31)を記録しています。
- Metaの小型特化モデル
- Cognition「SWE-2 Flash」による「料金5分の1・速度3倍(毎秒200トークン)」での上位モデル逆転と、性能を決める「指示・環境・テスト」の3要素:
- CognitionがInkling-Small(総276B・アクティブ12B)をベースに中間学習と強化学習で鍛えた
SWE-2 Flashは、上位モデルSWE-2(総2.8T・アクティブ104B)に対して 価格5分の1・生成速度3倍以上(毎秒200トークン vs 60トークン) でありながら、FrontierCode 2.0で 24.0% を記録して上位のSWE-2(23.8%)やGPT-6 Luna(21.9%)を逆転しました。Cognitionは「アルゴリズムの微調整以上に、課題の**指示文(instructions)・環境構築(environment setup)・検証テスト(verifiers)**の点検と修正が全ベンチマークの劇的な改善をもたらした」と結論づけています。
- CognitionがInkling-Small(総276B・アクティブ12B)をベースに中間学習と強化学習で鍛えた
- 最上位「Claude Fable 5.2」への難所9%集中、OpenRouter「Auto Code」による費用74%削減、およびGoogle「TPU 8i Max」による長文記憶の高速共有:
- 全体の約10%にあたる超難関設計や長時間タスクには、20%値下げ(入力8ドル・出力40ドル)かつ最大30%高速化され、30時間のフェルマーの最終定理証明を 100%完遂(Opus 5.5は27%で停止)した
Claude Fable 5.2を投入します。OpenRouterのAuto Codeは、連続10回中9回は同じAIモデルを維持してキャッシュ割引を守り、上位Opus 5.5の呼び出しを 全体の9.0% に温存することで、精度を落とさず 平均コストを74%削減 しました。さらにハードウェア面では、GoogleのTPU 8i MaxがオンチップVMEMを2倍の 768MB、メモリ帯域幅を2倍の 毎秒17.2 TB/s、1,152チップ通信を 最大7ホップ へ短縮し、TPU Syncで長大な文脈記憶(KVキャッシュ)を共有しています。
- 全体の約10%にあたる超難関設計や長時間タスクには、20%値下げ(入力8ドル・出力40ドル)かつ最大30%高速化され、30時間のフェルマーの最終定理証明を 100%完遂(Opus 5.5は27%で停止)した
2. 第1章:大企業1,000社のデータが暴いた「コード記述23% vs 残り77%の準備とテスト待ち」の正体
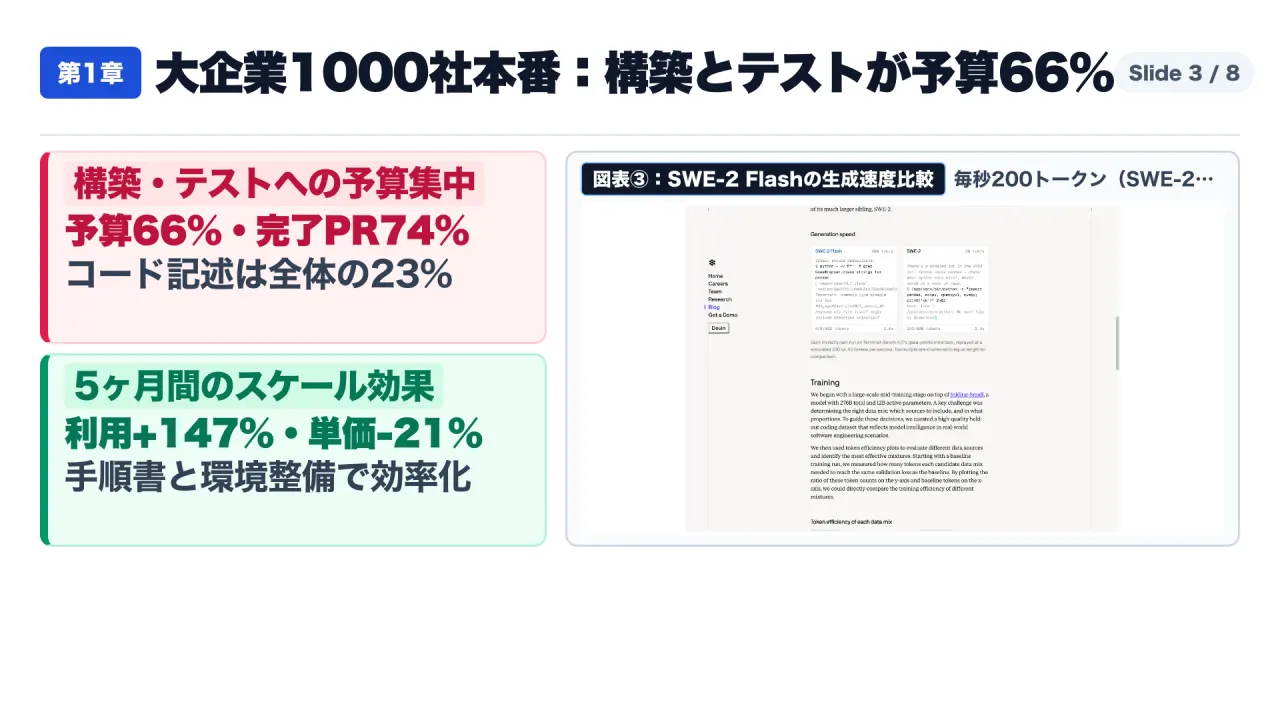
これまでAIエージェントの導入議論では、「どのAIモデルが一番賢いコードを書けるか」ばかりが注目されてきました。しかし、Cognitionが公開した『The Global 1000 Cloud Agent Benchmark』(Devin公式ページ および TLDR AI 2026-11-10 公式要旨)は、世界の大企業1,000社クラスのエンジニアリングチームにおける5ヶ月間の本番運用データから、まったく異なる現実を浮き彫りにしました。
なぜAIの実働時間の「77%」はコード書き以外に消えるのか
同レポートが明らかにした最重要の数値は以下の3点です。
- コード記述はわずか23%、残り77%は周辺工程:
- 自律型クラウドエージェント「Devin」の生産的なエンジニアリング実働時間(productive engineering hours)を工程別に分解すると、実際にコードを書いている時間(writing code)は全体のわずか
23%にすぎません。 - 残りの
77%は、ソフトウェア開発ライフサイクル(SDLC)のあらゆる周辺ステージ──すなわち ①計画と設計(Plan and Design)、②開発環境の構築と依存関係の解決(Environment Setup)、③巨大リポジトリや社内ドキュメントの探索(Context Gathering)、④自動テストの実行とエラー検証(Test)、⑤セキュリティ脆弱性の確認(Secure)、⑥デプロイと本番反映(Deploy)──に費やされています。
- 自律型クラウドエージェント「Devin」の生産的なエンジニアリング実働時間(productive engineering hours)を工程別に分解すると、実際にコードを書いている時間(writing code)は全体のわずか
- 「構築(Build)」と「テスト(Test)」が予算の66%と成果の74%を支配:
- SDLC全体の中で、BuildとTestの2工程だけで全エージェント計算予算(spend / ACUs)の
66%を消費し、最終的に審査を通過して本番統合されたプルリクエスト(merged PRs)の74%を生み出しています。 - つまり、AIエージェントが現場で最も多くの時間とトークンを消費しているのは「白紙から新しいプログラムをひねり出す瞬間」ではなく、「既存のシステム環境を立ち上げ、関係するファイルを読み漁り、ビルドとテストを何度も回してエラーを潰す地道な確認作業」なのです。
- SDLC全体の中で、BuildとTestの2工程だけで全エージェント計算予算(spend / ACUs)の
- 利用量が147%増えても、1セッション単価が21%下がった理由:
- 多くの企業は「AIの利用を拡大すると、API請求書が青天井に膨れ上がるのではないか」と懸念します。しかし5ヶ月間の本番データでは、セッション数が初月比で
147%増加(約2.5倍に拡大)する一方で、1セッションあたりの平均コストは21%低下 しました。 - この逆転現象を生んだのが、人間側による 「プレイブック(定型手順書)の整備」と「開発・テスト環境の標準化」 です。初期段階ではAIが環境の立ち上げやファイル探し(77%の領域)で何度も迷子になり無駄なトークンを消費していましたが、手順と環境を整えることで1回あたりの試行錯誤が減り、使うほど単価が下がる好循環が生まれました(なお、7ページのPDF本編に含まれる個別ユースケース別の細目グラフはフォーム登録ゲート内にあるため、本記事では公開ページおよび公式要旨で確認できる上記確定数値のみを根拠とします)。
- 多くの企業は「AIの利用を拡大すると、API請求書が青天井に膨れ上がるのではないか」と懸念します。しかし5ヶ月間の本番データでは、セッション数が初月比で
3. 第2章:料金が3分の1(1回20円)でウソもつかない小型AI「Meta Muse Ember」の実力
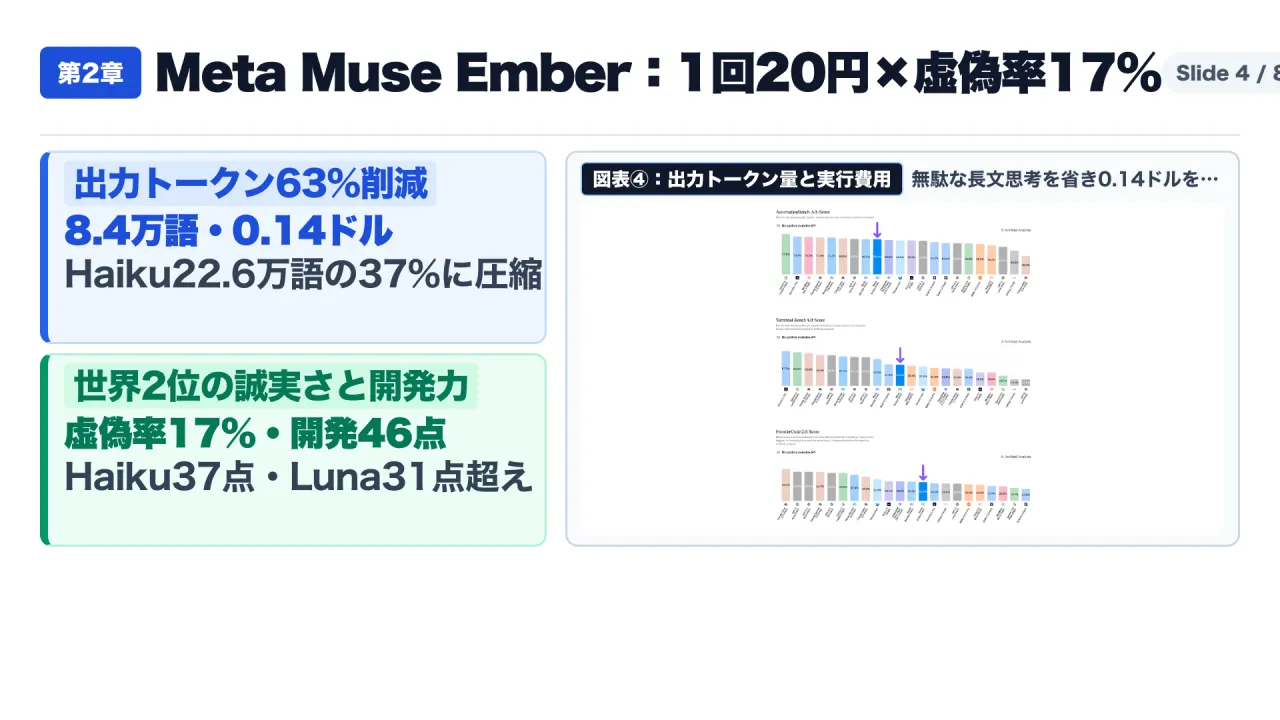
もしAIの実働時間の77%が「ファイルを探す」「外部ツールを呼び出す」「長文の資料やログを読む」「テスト結果を確認する」という下調べ・確認作業であるならば、その77%にまで1タスク10ドル(約1,500円)かかる最高級モデルを使い続けるのは明らかな過剰投資です。この77%の実務領域を最小コストで回すためにMeta Superintelligence Labsが投入したのが、小型・高効率推論モデル 『Muse Ember』(Meta公式ブログ / Artificial Analysis検証記事)です。
なぜMuse EmberはClaude Haiku 5.5の「3分の1」、Opus 5.5の「72分の1」で動くのか
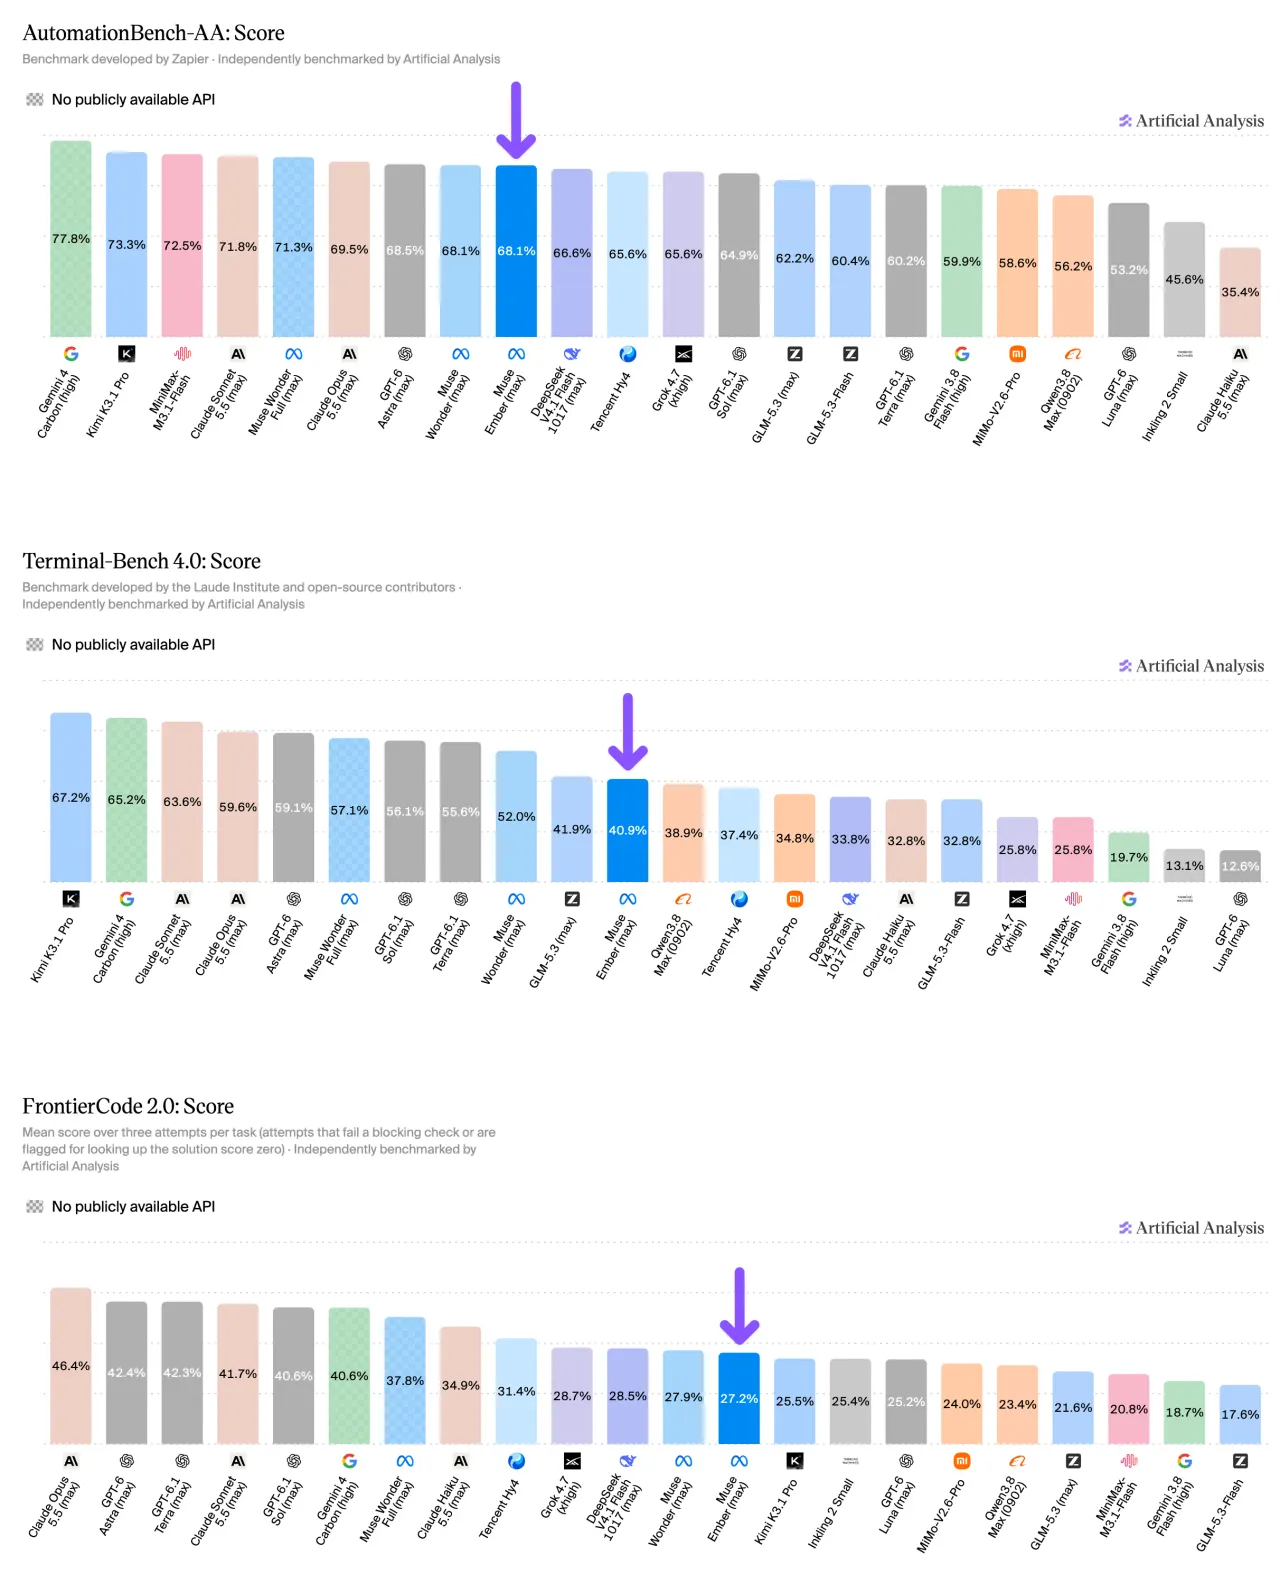
独立系評価機関Artificial Analysisの検証データ(上図)から、Muse Emberが圧倒的なコスト効率を実現した3つのメカニズムが確認できます。
- 破格のAPI単価とキャッシュ割引:
- Muse Ember(コンテキスト長256Kトークン・最大出力128Kトークン、テキスト・画像・音声・動画入力対応)の公式API価格は、100万トークンあたり 入力
0.10ドル(約15円)、出力0.40ドル(約60円)、そして一度読み込んだ文脈を再利用する キャッシュ入力はわずか0.015ドル(1.5セント=約2.3円) に設定されています。 - その結果、Intelligence Index(v5.0.1)の全評価スイートを走らせた際の平均コストは
0.14ドル(正確には0.136ドル、約21円) となり、同等の知能指数を持つ Claude Haiku 5.5(スコア35、コスト0.41ドル=約62円)の約3分の1、上位の Claude Opus 5.5(10.04ドル=約1,500円)やSonnet 5.5(10.02ドル)の約72分の1 という劇的な低コストを達成しました。
- Muse Ember(コンテキスト長256Kトークン・最大出力128Kトークン、テキスト・画像・音声・動画入力対応)の公式API価格は、100万トークンあたり 入力
- 無駄な「独り言(推論トークン)」を63%削減する簡潔さ:
- 上の図表3が示す通り、従来の推論モデルは簡単な確認作業でも長大な思考トークンを出力しがちでした。実際、テスト全体での出力トークン量はClaude Sonnet 5.5が 28万5,000トークン、Claude Haiku 5.5が 22万6,000トークン に膨らんでいます。
- これに対しMuse Emberは、推論トークン 5万2,000 +回答トークン 3万2,000 の 合計
8万4,000トークン(Haiku 5.5比で約37%、すなわち63%削減) で同等のスコア36(35.8)に到達しています。生成速度もピーク時 毎秒155トークン、標準API 毎秒97トークン(Artificial Analysis実測中央値77トークン/秒)と高速です。
- ハルシネーション率「17%(全モデル中2位)」の誠実さと、コーディング指数「46」:
- 企業の業務で小型AIを使う際に最も心配されるのが「知らないことをもっともらしくウソをつく(ハルシネーション)」リスクです。しかし
AA-Omniscience(難問知識テスト)において、Muse Emberは自身の記憶だけで解ける正答率こそ21%(Opus 5.5は66%、Haiku 5.5は35%)であるものの、分からない問題を当てずっぽうで捏造せず正しく棄権できるため、ハルシネーション率はわずか17%と、Gemini 4 Carbon(11%)に次ぐ 全モデル中第2位の低さ を記録しました(Haiku 5.5は34%、Opus 5.5は50%、GPT-6 Lunaは79%)。 - 「自分の記憶にないことはウソをつかず、素直に検索ツールやファイルを調べる」というこの性質により、エージェント作業のベンチマークでは Coding Agent Indexでスコア
46(Haiku 5.5の37、GPT-6 Lunaの31を圧倒)、Terminal-Bench 4.0で40.9%、AutomationBench-AAでMeta表37.8%/ AA独立計測68.1%(Haiku 5.5は35.4%)という極めて高い実務能力を発揮しています。
- 企業の業務で小型AIを使う際に最も心配されるのが「知らないことをもっともらしくウソをつく(ハルシネーション)」リスクです。しかし
4. 第3章:スピード3倍・料金5分の1の作業用AI「SWE-2 Flash」と最高峰「Claude Fable 5.2」の使い分け
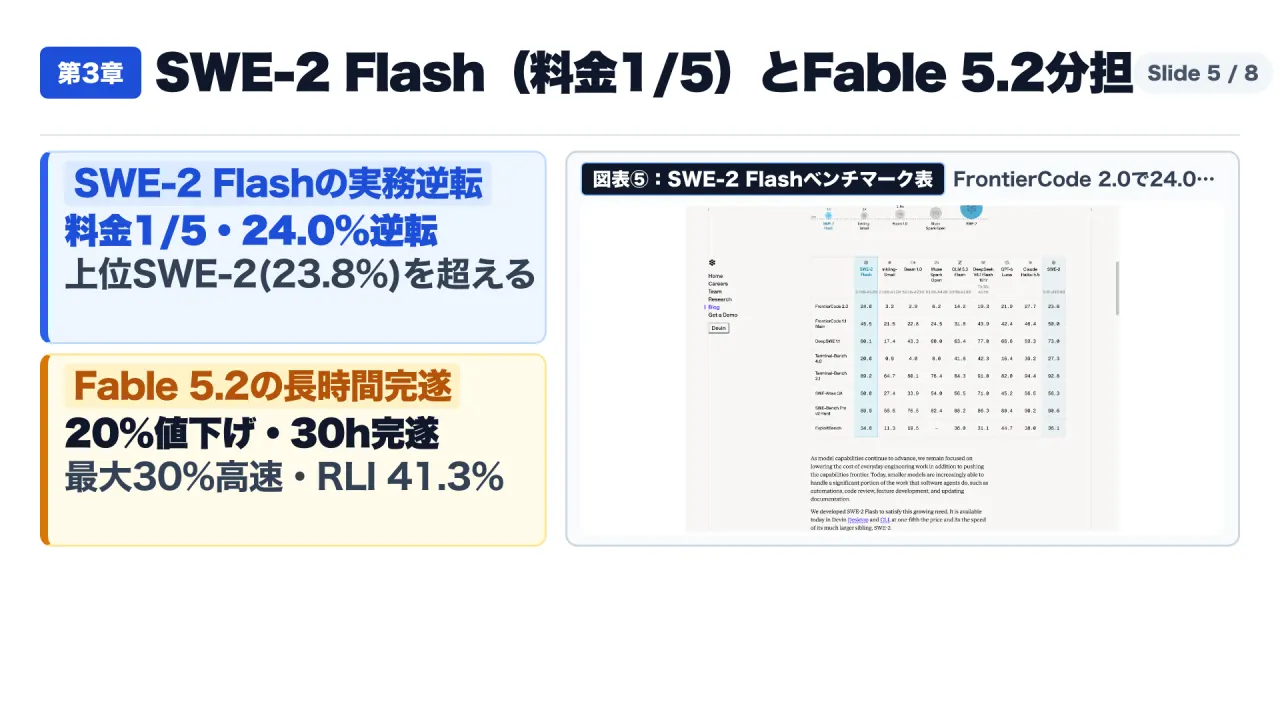
第1章で見た「実働の77%を占める調査・ビルド・テスト反復」を高速化するため、Devinの開発元であるCognition自身が投入したのが、高速コーディング特化モデル 『SWE-2 Flash』(Cognition公式ブログ)です。
なぜ「料金5分の1・毎秒200トークン」のSWE-2 Flashは上位モデルを逆転できたのか
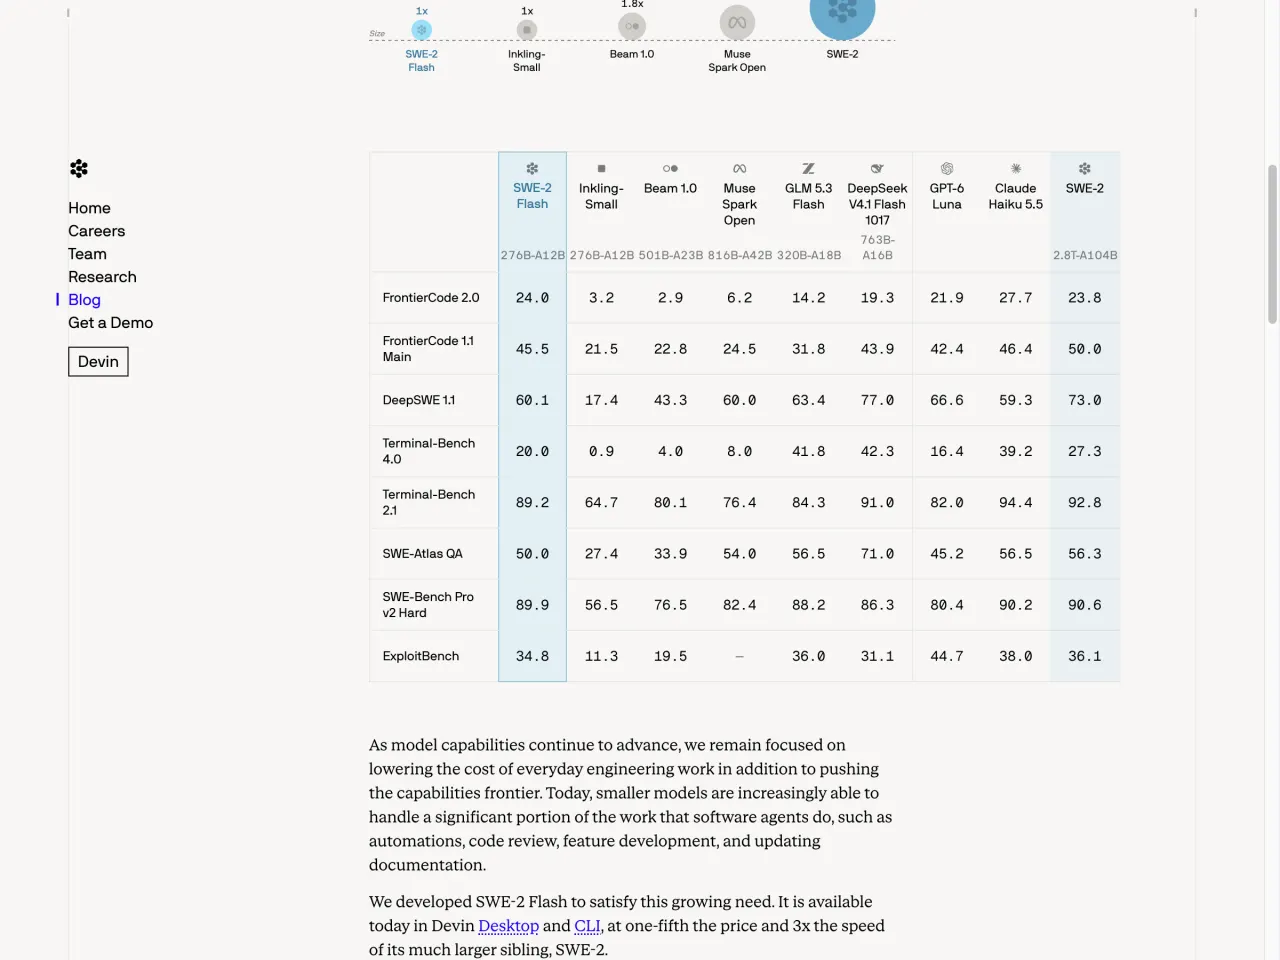
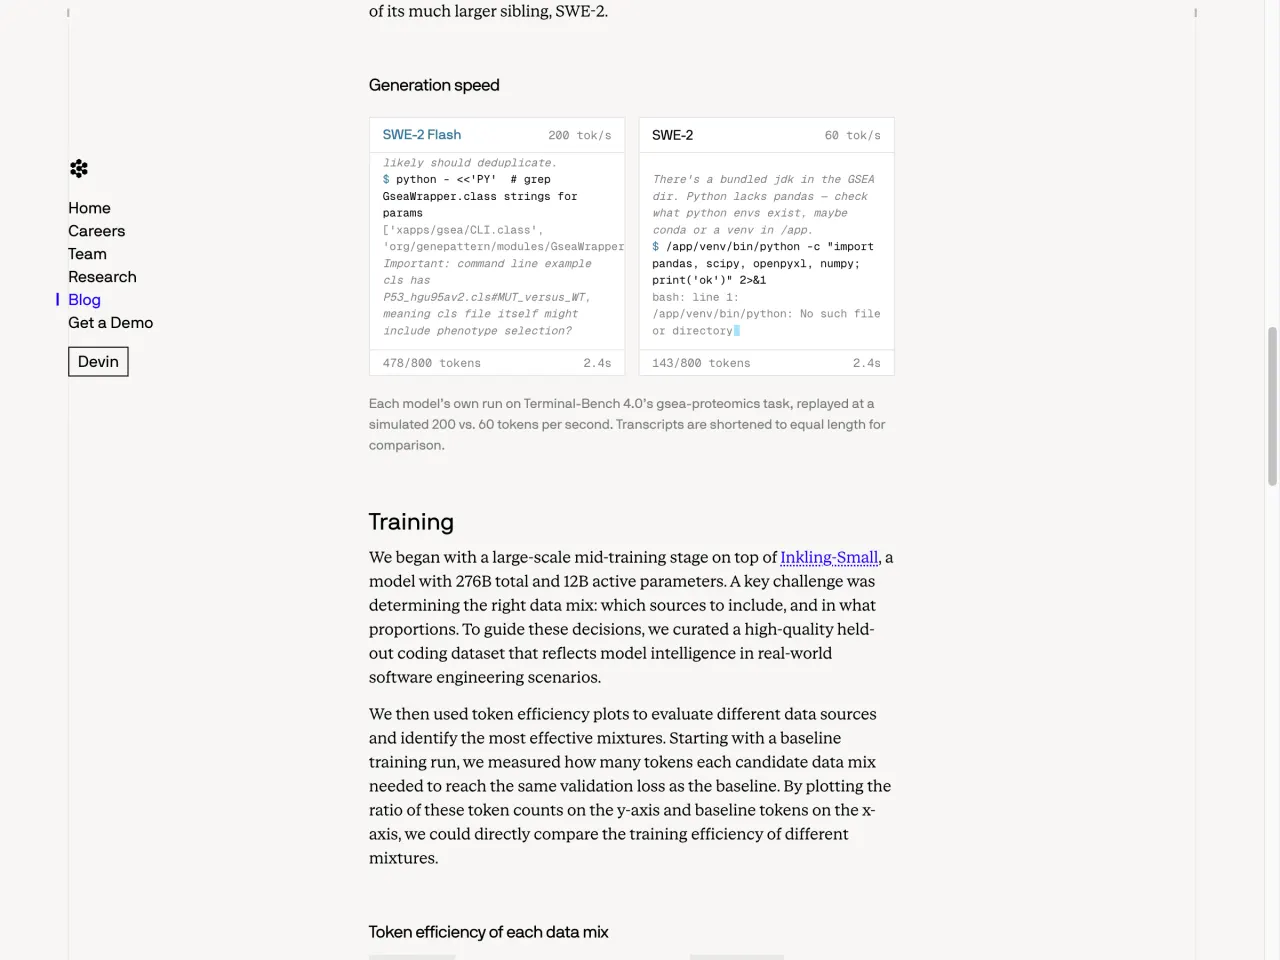
上の公式データ(図表5・図表6)が示す通り、SWE-2 FlashはThinking Machines社のオープンモデル Inkling-Small(総パラメータ 276B・1トークンあたりアクティブパラメータ 12B のMoE構造)をベースに、数兆トークンの科学論文・技術ブログ・高品質コードによる3段階の中間学習(mid-training)と大規模強化学習(RL)を施して開発されました。
- 価格5分の1・生成速度3倍以上(200 tok/s vs 60 tok/s):
- フラッグシップの巨大モデル
SWE-2(総パラメータ 2.8T・アクティブ 104B)と比較して、Devin DesktopおよびCLI上での利用価格は 5分の1(one-fifth the price)、生成速度はSWE-2の毎秒60トークンに対し 毎秒200トークン(3倍以上高速) で動作します。
- フラッグシップの巨大モデル
- 主要ベンチマークでの飛躍と上位モデル逆転:
FrontierCode 2.0: ベースモデルの3.2%から24.0%へ飛躍し、3倍以上の規模を持つ上位モデルSWE-2(23.8%) やGPT-6 Luna(21.9%)、DeepSeek V4.1 Flash(19.3%)を逆転しました(Claude Haiku 5.5は27.7%)。DeepSWE 1.1: ベースモデルの17.4%から60.1%へ向上し、Claude Haiku 5.5(59.3%) やMuse Spark Open(60.0%)を上回りました。Terminal-Bench 4.0:0.9%から20.0%へ大幅に向上(Beam 1.0は4.0%、Muse Spark Openは8.0%、GPT-6 Lunaは16.4%)。Terminal-Bench 2.1:89.2%、SWE-Bench Pro v2 Hard:89.9%(上位SWE-2の90.6%やHaiku 5.5の90.2%に肉薄)、サイバーセキュリティ検証のExploitBench:11.3%から34.8%へ向上(悪用防止のため重みは安全なパートナー共有プログラム経由で提供)。
- Cognitionが明かした「強化学習で本当に効いた3要素」:
- Cognitionの研究チームはブログの中で、「強化学習(RL)アルゴリズムの細かい調整以上に、学習タスクの①指示文(instructions)、②開発環境の設定(environment setup)、③正解を判定するテスト検証器(verifiers)の品質を徹底的に監査・修正したことが、ほぼ全ベンチマークでの劇的な性能向上をもたらした」 と明記しています。
全体の10〜20%の難所を受け持つ最高峰「Claude Fable 5.2」
一方、全体の10〜20%にあたる「最初の複雑なアーキテクチャ設計」や「数十時間に及ぶ超難関の論理構築・原因究明」では、Anthropicが発表した最上位モデル 『Claude Fable 5.2』(および認証組織向け Mythos 5.2、Anthropic公式発表)が圧倒的な威力を発揮します。
- 20%値下げと最大30%の高速化: Fable 5.2は100万トークンあたり 入力8ドル・出力40ドル と前世代Fable 5.1(入力10ドル・出力50ドル)から 20%値下げ され、出力速度も 最大30%高速化(Fast modeでは最大2.5倍高速、入力16ドル・出力80ドル)されました。
- 長時間・難関タスクでの決定的な差: 日常のコーディングには標準の
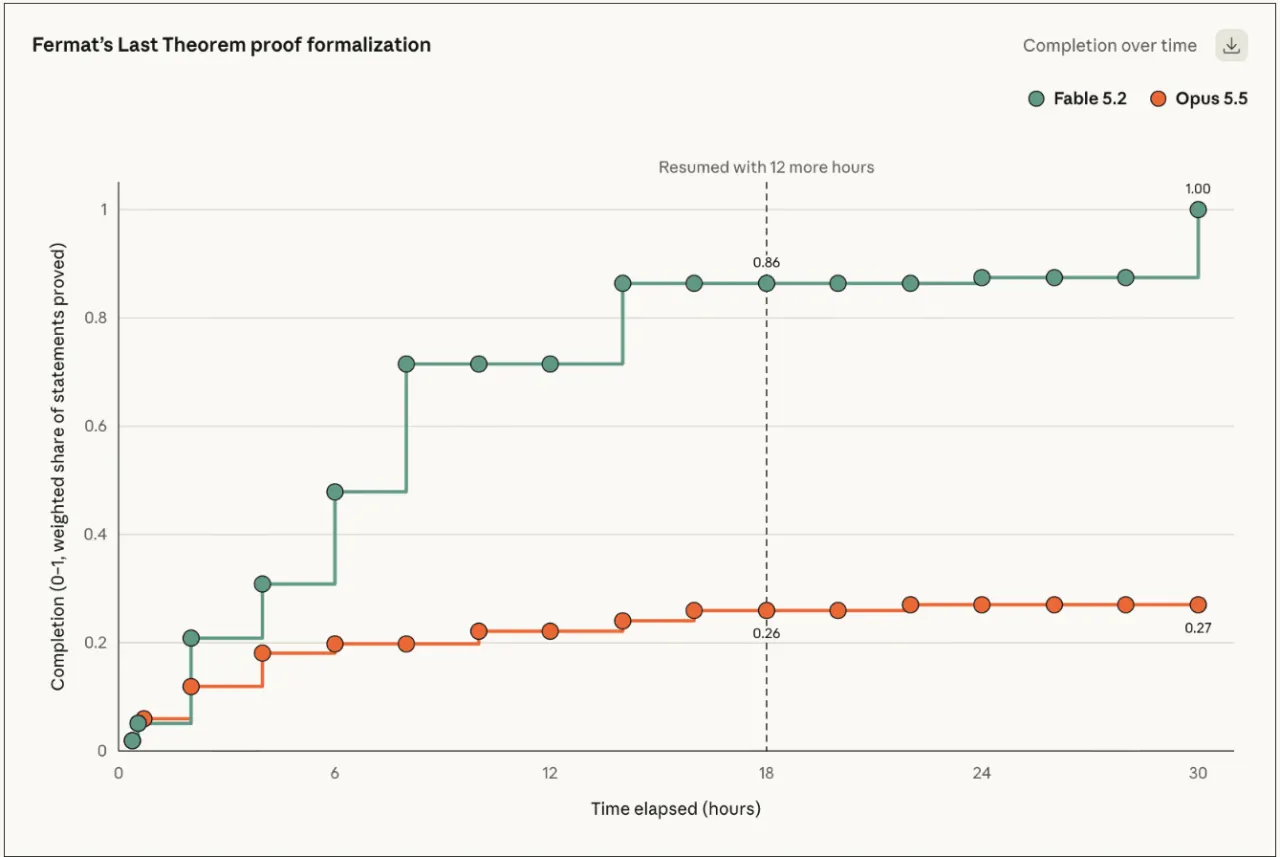
Claude Opus 5.5(入力4ドル・出力20ドル)が推奨されていますが、難関のFrontierCode 2.0ではFable 5.2が49.1%(Opus 5.5は45.5%)、FrontierSWE v2で69.9%(Opus 5.5は62.3%)、Remote Labor Indexで41.3%(Opus 5.5の21.3%の約2倍)を達成しました。さらに約1,000体のエージェントでフェルマーの最終定理を30時間連続で形式証明させる実験(図表7)では、Opus 5.5が12時間以降 26〜27% で足踏みしたのに対し、Fable 5.2は 30時間で100%完遂 に到達しています。
5. 第4章:OpenRouter「Auto Code」による費用74%削減と、Google「TPU 8i Max」による長文記憶の高速共有
では、この「1タスク10ドル級の最上位設計AI」と「1タスク0.14ドル(約21円)〜料金5分の1の高速作業AI」を、実際のシステムでどうつなぎ合わせればよいのでしょうか。ソフトウェアの自動振り分けとハードウェアの記憶共有の2つの一次データが、その具体的な解答を示しています。
10回中9回は同じAIを保ち、上位AIを「9.0%」に温存してコストを74%削る「Auto Code」
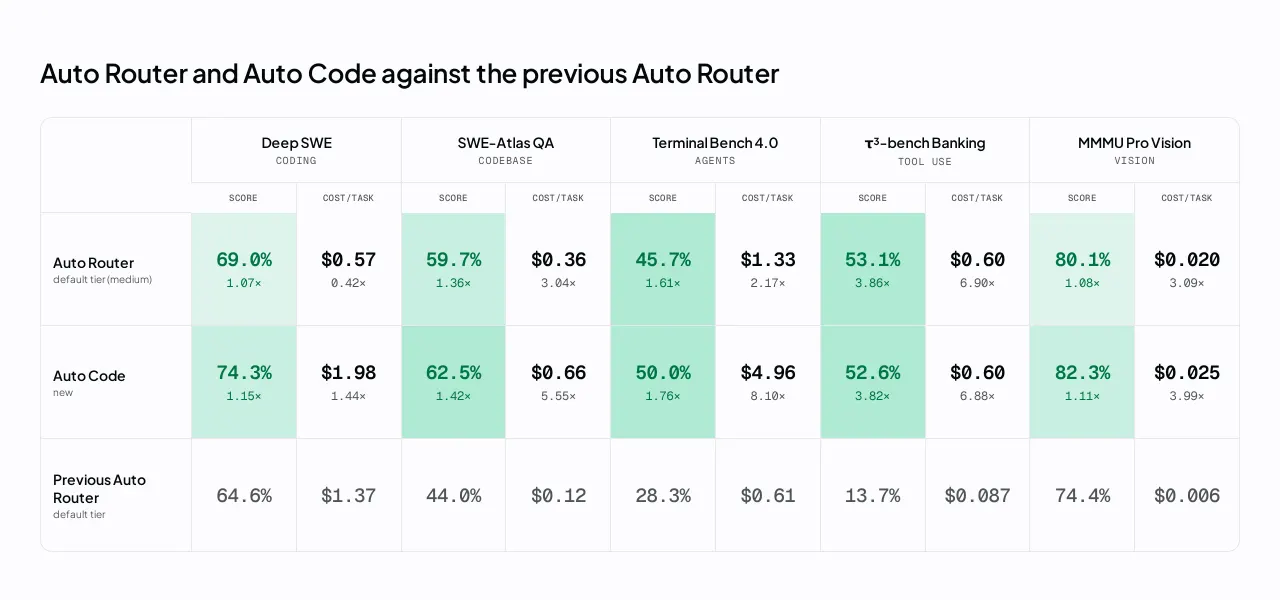
OpenRouterが公開した 『Auto Code』(OpenRouter公式ブログ)は、エージェントの作業状態(11個のハーネス特徴量:ツール実行結果か、手直しループか、コンテキスト長はどれくらいか等)を読み取り、36種類のモデルへ自動ルーティングします。
ここで最も重要な設計原則が 「プロンプトキャッシュを壊さないためのモデル維持(Stickiness:連続10ターン中9ターンは同一モデルを維持する)」 です。77%の下調べ工程で1ターンごとに別プロバイダのAIへ切り替えてしまうと、せっかく読み込んだ数十万トークンの社内資料のキャッシュ割引が毎回リセットされ、再読み込みの料金と待ち時間が発生してしまいます。Auto Codeは同じ作業フェーズの間は同一モデルを維持してキャッシュを守りつつ、最上位のClaude Opus 5.5の呼び出しを全体のわずか 9.0% の難所だけに温存 することで、5つのベンチマーク全体でOpus 5.5単体と同等の精度を保ったまま 1タスクあたりの平均コストを 74% 削減 しました(図表8)。
長文の記憶通り道を2倍(17.2 TB/s)に広げたGoogle「TPU 8i Max / 8tx」
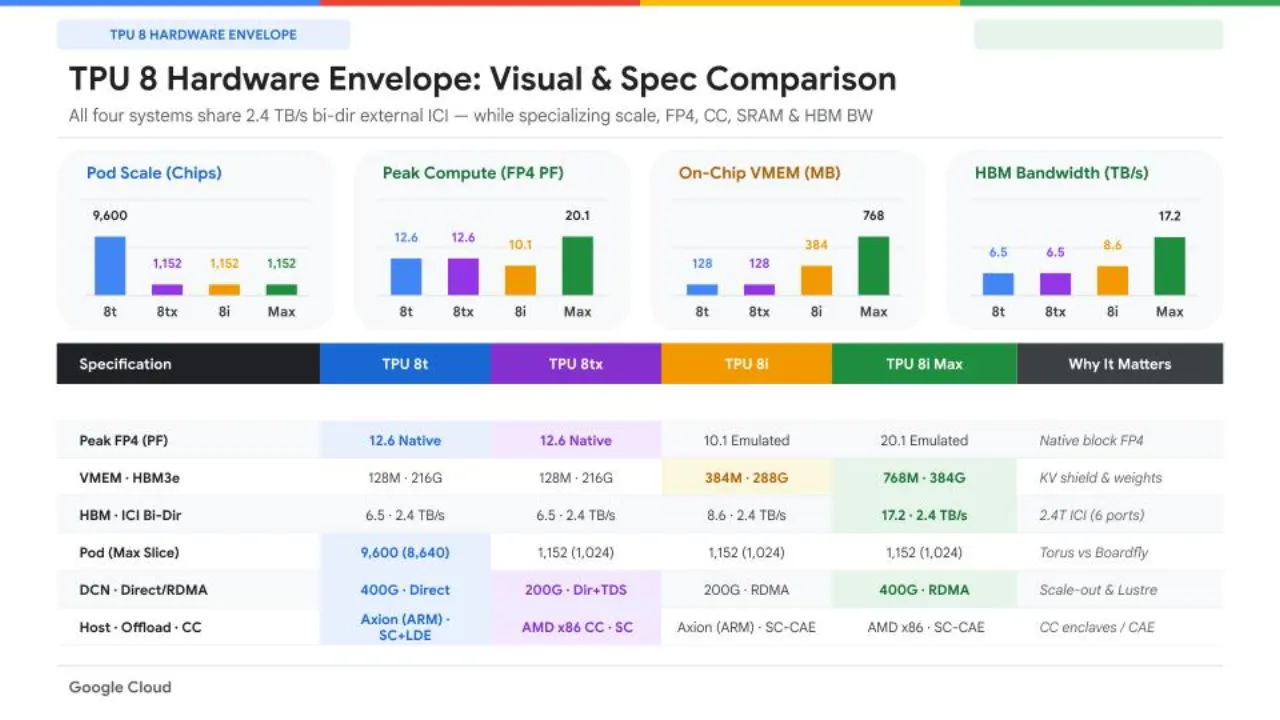
さらにインフラ層で、この「77%の下調べに伴う長大なコンテキスト(記憶データ)の受け渡し」を支えるのが、Googleが発表した第8世代TPUポートフォリオ 『TPU 8tx / TPU 8i Max』(Google公式ブログ)です。
- TPU 8i Max(超長文・高密度エージェント推論特化): 2つのTPU 8iチップを直結し、オンチップの超高速メモリ(VMEM)を2倍の
768 MB(学習用8tの6倍)、HBM3eメモリ容量を384 GB、そしてメモリ帯域幅を2倍の 毎秒17.2 TB/sへと引き上げました。さらに新ネットワークトポロジ 『Boardfly』 により1,152チップ間の最大通信ホップ数を従来の16ホップから7ホップへ半減させ、『TPU Sync』 によって複数のAIエージェントが参照するKVキャッシュ(記憶状態)をチップHBM・ホストDRAM・共有ストレージ間で高速共有します。 - TPU 8tx(機密計算推論・微調整特化): ホストCPUにデュアルソケットの AMD EPYC Turin(x86) と128レーンのPCIe Gen 5、およびハードウェアレベルの Confidential Computing(機密計算エンクレーブ) を採用し、金融・医療・政府機関の機密コードをメモリ上で暗号化したまま安全にエージェント処理できます(なお、TPU 8txおよび8i Maxの具体的な一般提供開始日とクラウド時間単価は現時点の一次資料では
未確認です)。
6. 結論:AIの無駄遣いとテスト待ちをなくす3つの実践アクションプラン
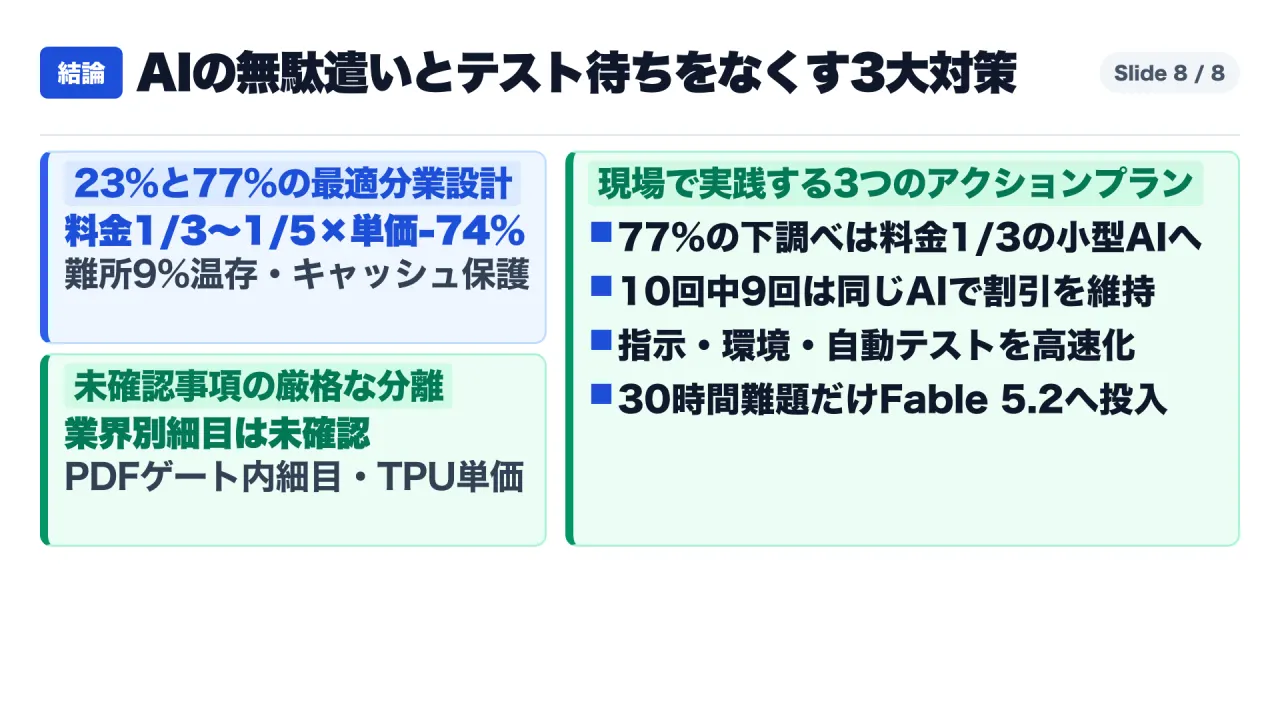
ここまでの5系統の一次資料が示す通り、AIエージェント活用で「利用量を2.5倍に増やしながら単価を21%〜74%下げる」ための鍵は、すべての作業を1つの高価なAIに押し付けるのをやめ、「23%の本番設計」と「77%の下調べ・テスト反復」を明確に切り分けて分担させることにあります。明日から職場で実践できる3つのアクションプランをまとめます。
- アクション1:AIの仕事を「難所10〜20%」と「下調べ・テスト77%」に分け、料金3分の1〜5分の1の小型特化AIへ分担する
- 着手条件: 社内ツールやコーディングエージェントのモデル設定が「常時Opus」や「常時最上位モデル」の1択に固定されている場合。
- 実践内容: 最初のアーキテクチャ設計や複雑な障害原因の特定(全体の約9〜20%)にだけ
Claude Fable 5.2(またはOpus 5.5)を呼び出し、残りの77%を占めるファイル検索・ドキュメント読解・ツール呼び出し・テスト実行には、1タスク約21円(0.14ドル・虚偽率17%)のMeta Muse Emberや、価格5分の1・毎秒200トークンのCognition SWE-2 Flashを割り当ててください。
- アクション2:連続する作業の「10回中9回」は同じAIモデルを維持し、資料の再利用割引(プロンプトキャッシュ)を守る
- 着手条件: 複数のAIモデルを連携させる際、1ステップごとに別プロバイダのモデルへ細かく切り替えている場合。
- 実践内容: OpenRouter
Auto Codeが実証した通り、モデルの頻繁な切り替えはプロンプトキャッシュを破壊し、数十万トークンの再読み込みコストを発生させます。同じ調査・実装フェーズの間は10回中9回は同一モデルを維持し、Muse Emberのキャッシュ入力(100万トークンあたり0.015ドル=約2.3円)やGoogleTPU Syncのような記憶再利用の仕組みを最大限に活かしてください。
- アクション3:AIの頭脳を責める前に、実働の77%を奪っている「指示文・開発環境・自動テスト」の3つを点検・高速化する
- 着手条件: AIエージェントのタスク完了率が低い、または1セッションあたりの時間が長引いてコストが膨らんでいる場合。
- 実践内容: Devin本番データで単価を21%下げ、SWE-2 Flashの性能を劇的に引き上げた最大の要因は「手順書(instructions)・環境設定(environment setup)・自動テスト(verifiers)」の整備でした。AIが毎回同じ環境構築エラーで躓いていないか、自動テストの実行に何十分も待たされていないかを計測し、AIが1秒でも速くテスト結果を受け取れるように環境を手直ししてください。
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日解説しています。参考になりましたら記事下部の「スキ」とアカウントの「フォロー」をお願いします。
動画での解説・自己紹介
- YouTubeポッドキャスト本編:なぜAIが本番を書く時間は「23%」しかなく、残り77%の下調べを「料金3分の1」のAIへ任せると安くなるのか?
- 初めての方へ(固定自己紹介記事):なぜ海外一次資料の「原典」まで遡るのか──このnoteとポッドキャストの使い方