月間1,300万回利用の音声モデル乗っ取り実証:失効ドメイン奪取と87秒の重み改ざんが検査を素通りする構造
YouTubeポッドキャスト本編(動画・音声)はこちら:月間1,300万回利用の音声モデル乗っ取り実証:失効ドメイン奪取と87秒の重み改ざんが検査を素通りする構造
https://www.youtube.com/watch?v=ElXuqVDpXHY
動画・音声本編はこちら:月間1,300万回利用の音声モデル乗っ取り実証:失効ドメイン奪取と87秒の重み改ざんが検査を素通りする構造
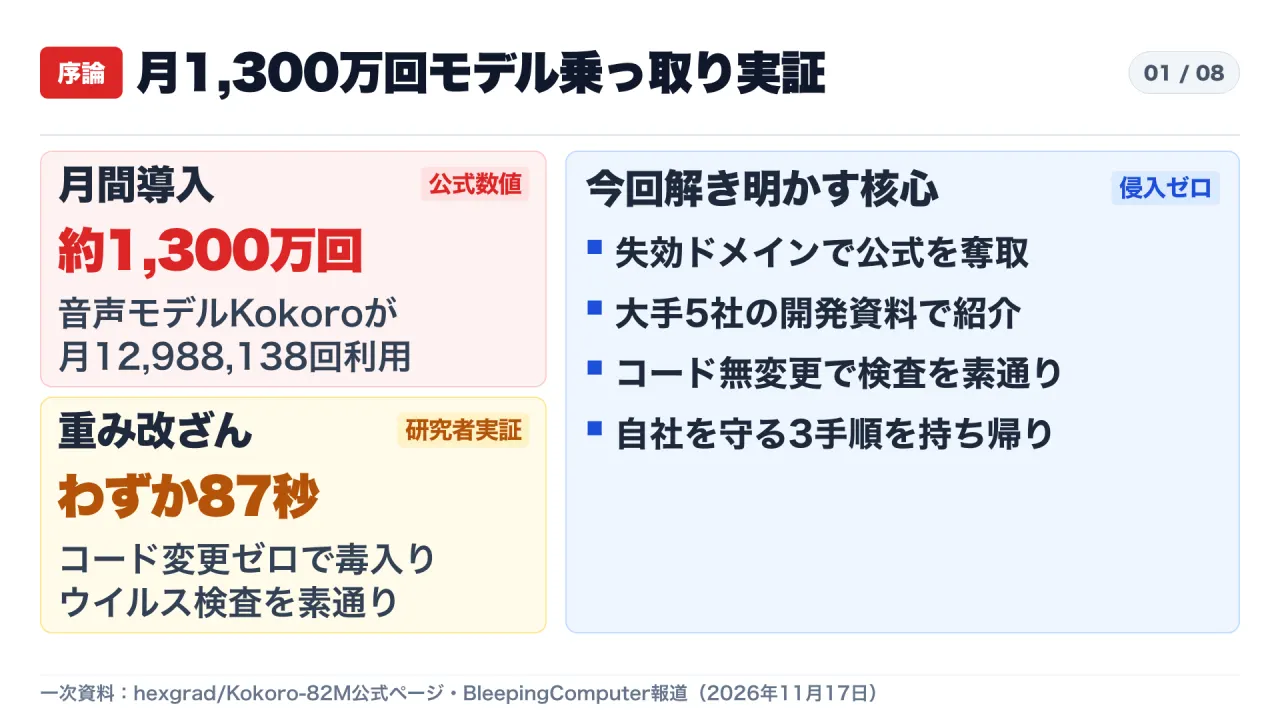
月間約1,300万回(12,988,138回)ダウンロードされるオープンウェイト音声合成モデル「hexgrad/Kokoro-82M」について、セキュリティ研究者アロン・ヘルツ(Alon Hertz)氏らのチームが、プラットフォームのサーバーへ一切侵入することなく公式アカウントの完全な制御権を奪い、わずか87秒でモデルの重み(weights)を改ざんできることを実証しました(BleepingComputer 2026年11月17日報道/hexgrad/Kokoro-82M 公式ページ)。
オープンモデルを業務システムや開発パイプラインへ取り込む企業の情報システム部門、AI基盤エンジニア、セキュリティ審査担当者が直面しているのは、「公式リポジトリから落としているから安全」「ウイルス検査を通したから問題ない」という従来の運用前提がもはや機能しないという現実です。本記事では、Hugging Face公式モデルカードに記載された数値、BleepingComputerが報じた研究者チームの実証手順とプラットフォームへの照会状況、WhyLabs(2023年11月)が示したオープンモデルのリスク原則、そしてCloud Security Alliance(2026年9月)の先行調査データを突き合わせ、侵入ゼロの乗っ取りと「ウイルス検査素通り」の技術的メカニズム、さらに日本企業が即座に導入すべき3つの防衛境界と実務チェックリストを詳しく整理します。
1. 事件の核心:サーバー侵入ゼロの公式アカウント奪取と87秒改ざん
2026年11月17日 13時21分(米国東部時間、日本時間2026年11月18日)にBleepingComputerが報じた内容によると、ヘルツ氏らの研究チームはHugging Faceのサーバーや認証基盤にある技術的な脆弱性を突いたわけではありません。プラットフォーム側のシステムへの不正侵入は一切行わず、開発元であるHexgradが公式モデルの更新を止めたあとに放置されたドメインを再登録し、プラットフォームが標準機能として提供しているパスワードリセット手順を実行しただけで、公式公開者アカウントの制御権を完全に掌握したと報告されています。
| 項目 | 一次資料に基づく実証・確認内容 |
|---|---|
| 対象モデルと規模 | hexgrad/Kokoro-82M(8,200万パラメータ、Apache-2.0、8言語・54ボイス、月間DL数 12,988,138回、Like 7.45k) |
| 採用・紹介範囲 | Google、NVIDIA、Intelの音声エージェント向け開発ツールが対応し、AMD・AWSの導入ガイドでも紹介 |
| 更新停止と乗っ取り口 | 2025年4月以降に公式更新・GitHub・PyPIが沈黙。公開ファイル DONATE.md 記載の hexgrad.com が未登録・失効状態 |
| 乗っ取り手順 | 研究者が hexgrad.com を登録し、Hugging Faceのパスワードリセットを実行して公式アカウントの制御権を取得 |
| 改ざん手法と所要時間 | 家庭用ゲーミングGPUで 87秒 の重み微調整を行い、入力文と異なる音声を出力する毒入りモデルを作成 |
| 検知回避と安全配慮 | 推論コード・設定・音声ファイルは1行も無変更。別アカウント試験で警告反応なし(悪影響防止のため改ざん重みは未アップロード) |
この乗っ取り手順が極めて深刻である理由は、攻撃に高度なエクスプロイト開発や標的型フィッシングが不要である点にあります。開発元が過去に寄付案内などの目的で公開リポジトリ内の DONATE.md に記していたドメイン hexgrad.com は、開発活動の停止に伴って契約が切れ、誰でも登録できる未取得状態となっていました。研究チームはそのドメインを通常の手続きで取得し、公開者アカウントに紐づくパスワードの再発行を実行しただけで、正規の運営者になりすますことができました。
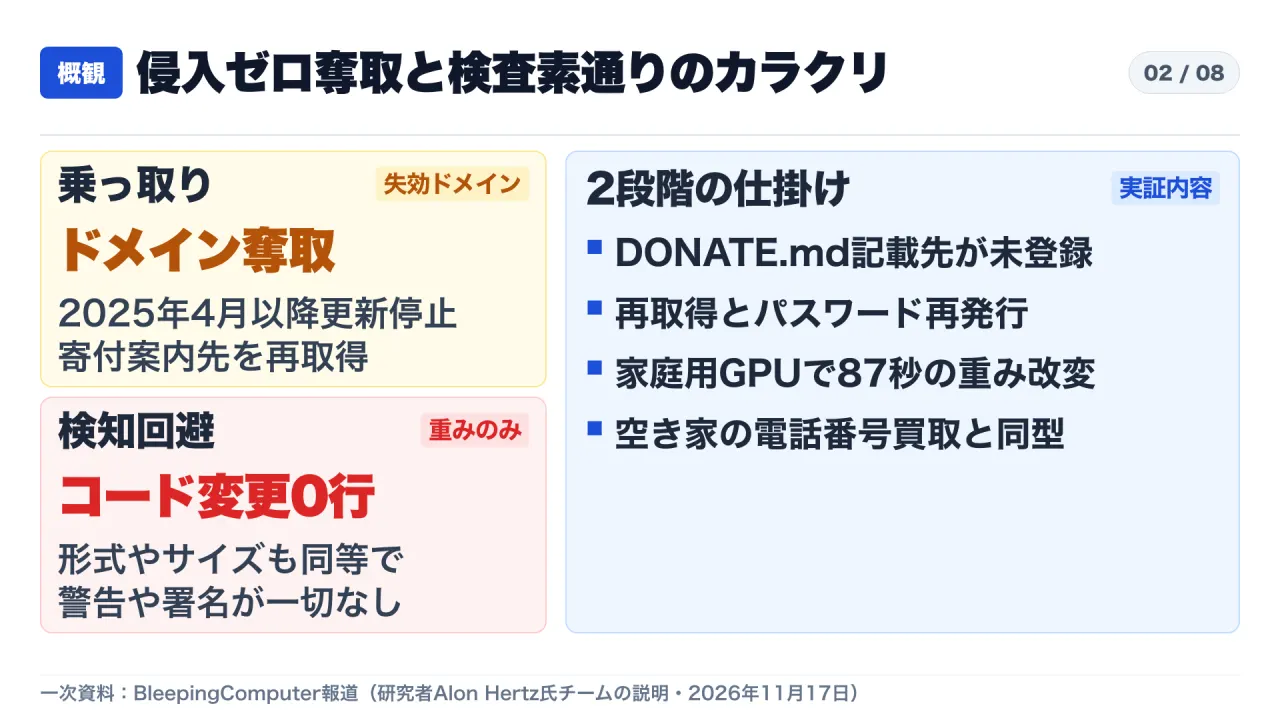
日常の事業環境に置き換えるなら、1年以上シャッターが閉まっていた人気店の解約済み電話番号を第三者が正当な契約手続きで買い取り、店舗の看板や暖簾を一切書き換えることなく、正規の取引先や配達員に対して店の奥から指示を出し続けるような構造です。外から見ている利用企業や開発ツールにとっては、モデルのURLも、提供元のアカウント名も、過去の評価実績もまったく変わっていないため、異常の兆候を察知する手がかりが乏しくなります。
さらに今回の実証が現場に突きつけたもう一つの衝撃が、「87秒の重み改ざん」と「ウイルス検査の完全素通り」です。研究チームは家庭用ゲーミングGPUを用いてわずか87秒間だけKokoroのニューラルネットワークの重み(weights)を微調整し、入力されたテキストとは異なる内容を発話する「毒入りモデル」を作成しました。この際、モデルを実行する推論アプリケーションのコード、音声アセット、設定ファイルのいずれも1行も書き換えていません。ヘルツ氏がBleepingComputerの取材で述べた通り、入力テキストも、音声ファイルも、設定ファイルも、推論コードもすべて同一のままで、変更したのはニューラル重みという数値配列だけです。
これは、市販飲料のペットボトルも外装ラベルも賞味期限の印字も変えず、中身の配合だけを87秒で書き換える偽装と同型です。プログラムのコードや不審な通信コマンドが追加されていないため、マルウェアスキャナーが照合するウイルス署名や悪意ある命令のパターンが存在しません。ファイルサイズや配信形式、ダウンロード経路も正規リリースと同等であるため、研究者が別アカウントを使って行ったテストでも、プラットフォーム側の不審判定機能やマルウェアスキャナーは一切反応しなかったとされています。
なお、研究チームは実社会の本番システムへ広範囲な悪影響が及ぶのを防ぐため、作成した毒入り重みファイル自体を hexgrad/Kokoro-82M の公式ページへアップロードする行為は避け、制御下での検証にとどめたと明記しています。しかし、もし悪意ある第三者が同じ手順で改ざん済みの重みを公式ページへ上書き公開していれば、モデル名を指定して自動取得している世界中の開発環境や本番サーバーへ、正規更新を装って無言のまま配信され得る状態にあったことが実証されています。
2. 時系列の整理:わずか数か月で放置された「人気インフラ」の空白
なぜ月間約1,300万回も参照されるモデルが、これほど無防備な空白状態に置かれていたのかを理解するには、一次資料に記されたリリースから更新停止、そして今回の実証に至るまでの時系列を正確に追う必要があります。
- 2024年12月25日(初期版
v0.19公開): Hugging Face公式モデルカードの記録によると、最初の主要リリースであるv0.19が公開されました。当時は1言語・10ボイス構成で、学習時間は100時間未満、公開ファイルのSHA-256先頭は3b0c392fとして記録されています。 - 2025年1月27日(
v1.0公開と普及加速): 続くv1.0では対応範囲が一気に8言語・54ボイスへ拡大しました。モデルアーキテクチャはStyleTTS 2およびiSTFTNetデコーダのみを用いた8,200万パラメータ構成となり、SHA-256ハッシュ496dba118d1a58f5f3db2efc88dbdc216e0483fc89fe6e47ee1f2c53f18ad1e4として確定版が公開されました。軽量さとApache-2.0という商用利用しやすいライセンスが評価され、その後Google、NVIDIA、Intelの音声エージェント向け開発ツールで対応が進み、AMDやAWSのAIエージェント構築ガイドでも取り上げられるようになりました。 - 2025年4月以降(公式更新の停止とエコシステム沈黙): BleepingComputerの調査によれば、開発元であるHexgradは2025年4月を最後にモデルへの新たな更新を止め、同時期にGitHubリポジトリおよびPythonパッケージ配布基盤(PyPI)での活動も停止しました。開発者コミュニティでは安定版としてそのまま使われ続け、月間ダウンロード数は約1,300万回規模に拡大した一方、一次管理者の運用体制は休眠状態に入りました。
- 2026年11月中旬(ドメイン失効の発見と乗っ取り実証): 2026年11月17日に報じられた検証に先立つ週末、ヘルツ氏らの研究チームは、公開ファイル
DONATE.mdに記されていたhexgrad.comが未登録・失効状態になっていることを発見し、ドメイン登録とパスワードリセットによって公式アカウントの制御権を取得、さらに家庭用GPUによる87秒の重み改ざんを実証しました。 - 同時期(関連調査との連続性確認): この手口は突発的な単発発見ではなく、2026年9月7日にCloud Security Alliance(CSA)が公開した研究ノートが指摘していた「放置されたドキュメントやドメインを起点としたAI開発パイプライン侵害」と同一の設計思想・リスク構造上にあります。
この時系列から見えてくるのは、ソフトウェアやAIモデルの「人気のピーク」と「開発元のメンテナンス継続」が必ずしも一致しないという厳然たる事実です。利用者が増えて大手企業の資料に載るほど「誰かが監視し保守しているはずだ」という集団的な安心感が生まれますが、実際には2025年4月以降の1年半以上にわたって管理実態が空白であり、その空白が公式アカウントの鍵であるドメインの失効という形で表面化していました。
3. オープンモデル安全神話の崩壊と llms.txt 先行研究の連続性
現場のエンジニアや意思決定層の間には、「プロプライエタリなAPIは中身がブラックボックスだが、オープンソースやオープンウェイトのモデルであれば重みや設定が公開されているため透明性が高く安全だ」という思い込みが根強く存在します。しかし、この前提に対しては数年前から専門家が明確な警告を発してきました。
2023年11月(米国時間11月16日 / 日本時間11月17日)に公開されたWhyLabsのセキュリティワークショップ映像『Intro to LLM Security - OWASP Top 10 for Large Language Models』の開始6分30秒付近で、同社CEOのアレッシャ・ヴィズニッチ(Alessya Visnjic)氏は次のように述べています(WhyLabs講座映像)。
“now you could think okay if I’m taking llama and it’s open source so there’s more sense of security unfortunately no because well you don’t know what the data it was trained on is like so you can’t really guarantee that there wasn’t any kind of training data poisoning or any other potential security exploits”
この発言が示しているのは、たとえソースコードやモデルの重みが公開されていたとしても、どのような学習データで構築されたかが外部から完全には検証できない以上、学習データの汚染(ポイズニング)や潜在的なセキュリティ上の悪用が紛れ込んでいないと保証することはできない、という原則論です。ここで重要なのは、ヴィズニッチ氏の見解が「学習段階・出自に関する一般原則」である点と、今回のヘルツ氏らの実証が「公開後の正規アカウント乗っ取りと重み差し替え」という具体的な攻撃経路を示した点とを明確に切り分けて捉えることです。公開時に善意の作者によって作られた無害なモデルであっても、公開後のアカウント管理が失われれば、正規URLのまま後から別物にすり替わり得ることが今回の実証で明らかになりました。
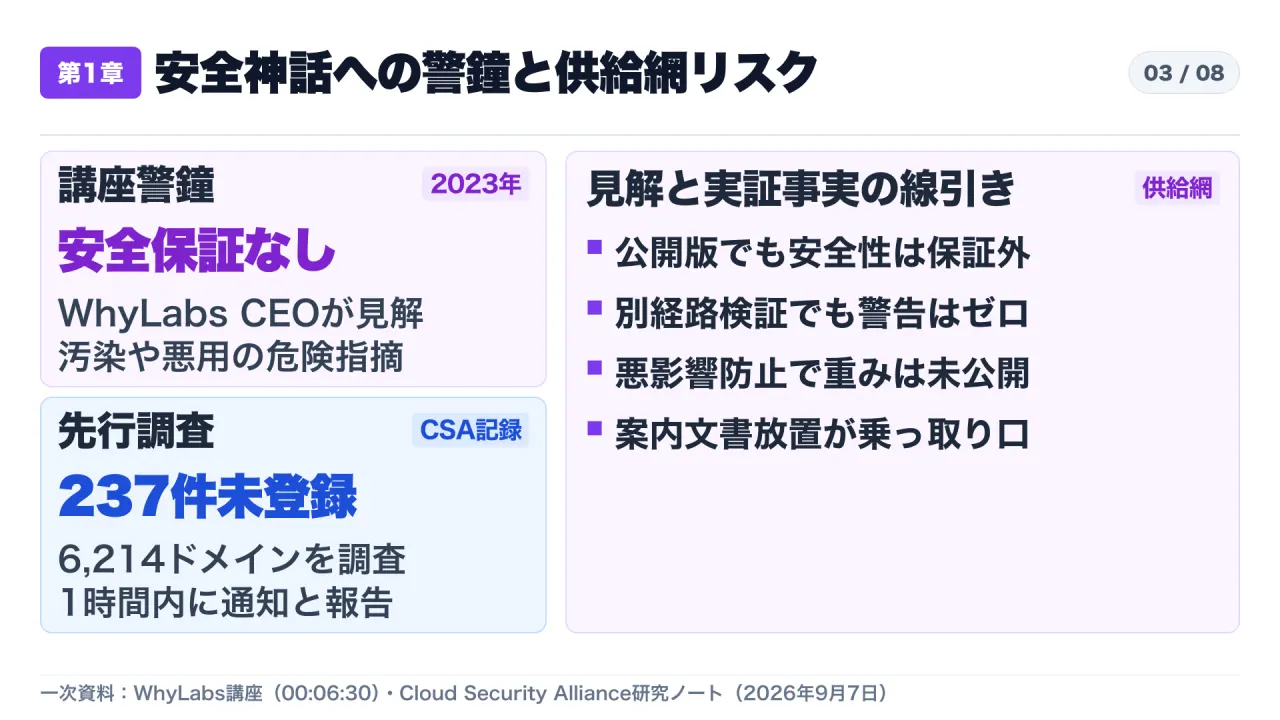
さらに、今回のKokoro実証を行ったアロン・ヘルツ氏が主導したもう一つの大規模調査が、Cloud Security Alliance(CSA)の2026年9月7日付研究ノート『The llms.txt Trust Model Is Broken』にまとめられています(CSA研究ノート)。2026年8月から9月にかけて実施されたこの調査では、自動化ツールやAIコーディング支援エージェントが参照するドキュメントの信頼モデルがいかに脆いかが定量的に示されています。
- 調査母集団の広さ: ヘルツ氏は防衛関連企業、Fortune 500企業、主要テック企業を含む 6,214件のアクティブなドメイン をスキャンし、8,265件(GBHackersの報道集計では8,565件)の
llms.txtおよびllms-full.txtファイルを検出しました。 - 未登録参照の残存率: 検出されたファイルのうち 120ファイル(全体の約1.5%)に、誰も所有していない未登録のパッケージ名や失効ドメインへの参照が含まれていました。その内訳は、未所有のインストールコマンド 227件 とドメイン参照を含む合計 237件 の未請求アーティファクト(unclaimed artifacts)でした。
- 実環境での極めて速い発火: 研究者がこれらの未登録名の一部を実際に登録し、悪意のない無害な通知用(phone-home)パッケージを設置したところ、最初の実行通知は 1時間以内(一部メディアの報道では4分以内) にFortune 500企業内の開発環境から届き、数日のうちに数十社の企業環境へ波及したことが記録されています。
llms.txt の調査と今回のHugging Faceアカウント乗っ取り実証は、一見すると別々の対象を扱っているように見えますが、根本の脆弱性構造は完全に同一です。どちらも「人間向けの案内文書や寄付用リンクに書かれたドメイン・パッケージ名」を、後段のAIエージェントや自動取得スクリプトが「正当な公式情報」として無条件に信頼して取り込んでしまう点に隙があります。公式サイトの隅に書かれた開発者向けメモや寄付ページであっても、そこに外部参照が残っている限り、開発ライン全体の入り口を乗っ取る鍵に変わり得ることを2つの研究が連続して証明しています。
4. 一次資料の数値精査と「約15万円対87秒」の非対称性
次に、Hugging Face上の hexgrad/Kokoro-82M 公式モデルカードに記載された全数値と学習コスト表を検算し、このモデルがいかに小さな初期投資から巨大な依存生態系へと育ったか、そして攻撃コストとの間にどれほど極端な非対称性があるかを確認します。
| 指標(公式カード記載値) | 数値・内訳 |
|---|---|
| アーキテクチャ・ライセンス | 8,200万パラメータ(StyleTTS 2 / iSTFTNet デコーダのみ)/ Apache-2.0 |
| v0.19 リリース(2024年12月25日) | 訓練100時間未満、1言語・10ボイス、SHA-256先頭 3b0c392f、A100 80GB 500時間 × 0.80ドル/時 = 400ドル |
| v1.0 リリース(2025年1月27日) | 訓練数百時間、8言語・54ボイス、SHA-256 496dba11...、A100 80GB 500時間 × 1.20ドル/時 = 600ドル |
| 合計学習コスト(一次検算) | A100 80GB GPU 1,000時間 ・ 約1,000ドル(1ドル150円換算で 約15万円) |
| 月間ダウンロード数・評価 | 12,988,138回 / Like 7,450件超(7.45k) |
| 派生エコシステム | ファインチューン 81件 / アダプタ 12件 / 量子化版 126件 / Spaces 100件 |
| API市場価格(2025年4月時点) | テキスト100万文字あたり 1ドル未満(比較ホスト上で0.65〜0.80ドル)/ 音声1時間あたり 0.06ドル未満 |
公式モデルカードの学習コスト表を1行ずつ検算すると、v0.19とv1.0を合わせた計算資源の投入量はA100 80GB GPUで合計1,000時間、ドル換算の総額は約1,000ドル、1ドル150円換算で約15万円にすぎません。生成AIの基盤開発というと数百億円規模の投資を連想しがちですが、用途を音声合成の8,200万パラメータに絞り込んだことで、個人や小規模チームでも手の届く約15万円の計算コストで高品質・低遅延のモデルが生み出されました。さらに2025年4月時点のAPI提供相場はテキスト100万文字あたり1ドル未満(比較対象ホスト上では0.65ドルから0.80ドル)、生成音声1時間あたり0.06ドル未満という圧倒的な経済性を示していました。
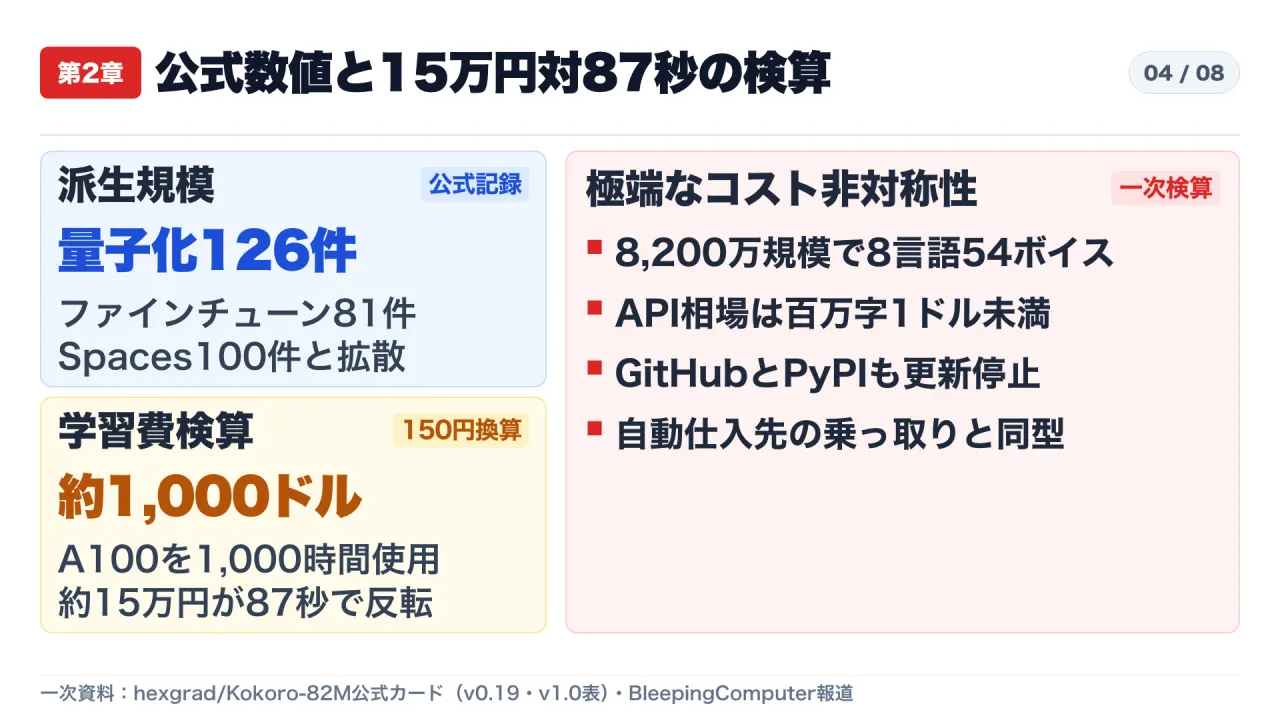
その結果として、Kokoroは単なる実験プロジェクトにとどまらず、月間約1,300万回ダウンロードされ、コミュニティによって81件のファインチューンモデル、12件のアダプタ、126件の量子化版、100件のデモアプリ(Spaces)へと派生し、さらにGoogle、NVIDIA、Intel、AMD、AWSといった主要ベンダーの音声エージェント開発資料やツール群で参照される中核コンポーネントへと成長しました。
しかし、この約15万円から育った巨大インフラの「正規性」を支えていたのは、2025年4月以降に更新が途絶えた開発者アカウントと、契約切れで数千円程度から誰でも再取得可能な1つのドメインでした。しかも、いったんアカウントの鍵を握ってしまえば、中身の振る舞いを変えるのに要する時間は、家庭用ゲーミングGPUでわずか87秒です。開発環境で「最新版のモデル名をそのまま取得する」自動仕入れの設定を組んでいる企業にとっては、取引先の問屋が乗っ取られたにもかかわらず、翌朝からも「いつもの納品書と同じデザインの正規トラック」で運ばれてくる毒入り食材を、中身を検品することなく全店舗の厨房へ自動で流し込み続ける事故と同じリスクを背負うことになります。
5. プラットフォーム検証不在の警告と重みファイル特有の死角
なぜモデル共有プラットフォーム側でこうした乗っ取りや改ざんを水際で止められないのか、またなぜ従来のエンドポイント保護や静的コード検査が通用しないのかを、研究者の指摘と技術的構造の両面から整理します。
BleepingComputerの取材に対し、アロン・ヘルツ氏はプラットフォームの審査体制について強い危機感を示しています。同氏の指摘によれば、Hugging Faceは公開者の本人審査を行っておらず、アカウントが元の正当な保有者の手元にとどまっているのか、あるいは直近でひそかに乗っ取られたのかさえ検証していません。さらに、アップロードされたモデルの重みやデータセットの内容自体についてもセキュリティ審査を実施していないため、同じ未検証の重みやデータセットが、ミラーサイトや量子化・変換版、GitHubのリリースページ、各種パッケージ登録基盤、企業の導入ガイド、直接ダウンロードを通じて、オープンモデルのエコシステム全体へ拡散していると警告しています。
同氏はまた、今回のようなドメイン失効を介したアカウント乗っ取りに限らず、さらに防ぎにくい攻撃パターンも指摘しています。それは「悪意ある人物が、最初は無害で有用なモデルをしばらく公開して利用者やプラットフォームの信頼を十分に稼いだあと、ある時点で悪意ある更新版を正規アカウントから押し込む」という手法です。この場合、ドメインの所有権自体は攻撃者本人のものであるため、仮にドメイン所有検証を強化したとしても防ぐことができません。なお、研究チームは今回の検証結果をHugging Face側へ報告しましたが、記事が公開された時点では返答がなく、BleepingComputerからの取材照会に対しても回答は得られていません。
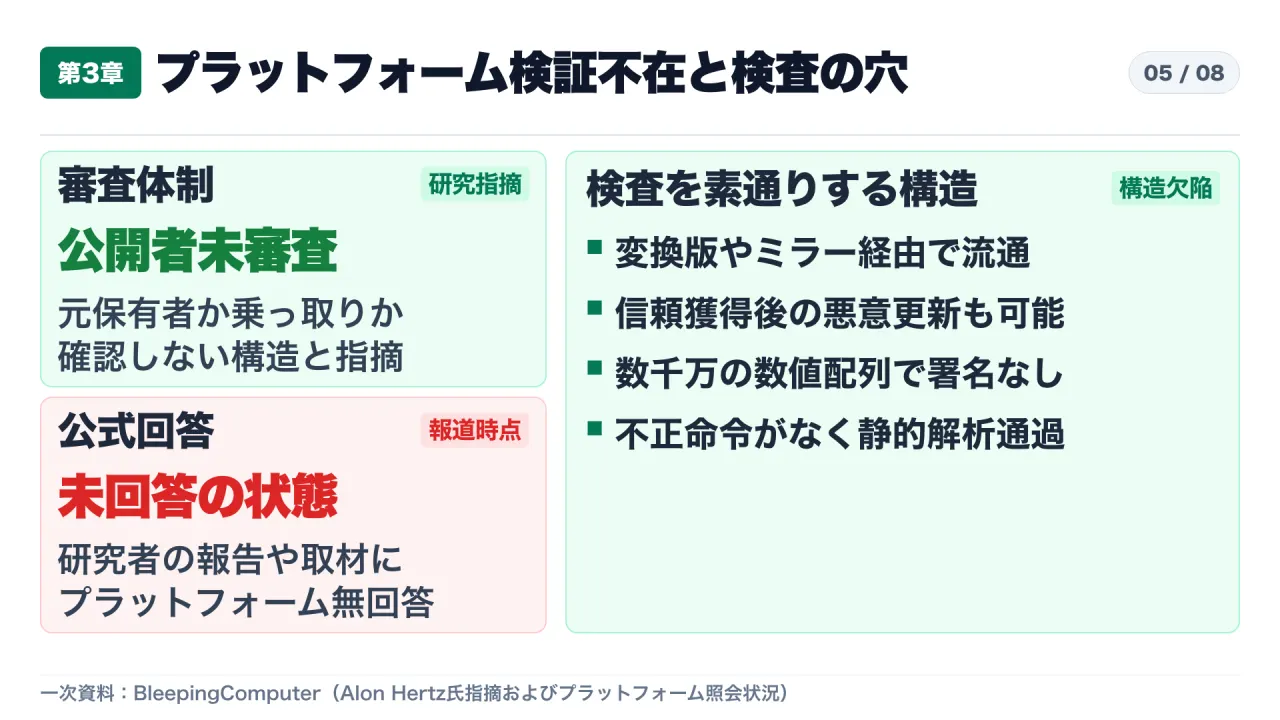
さらに企業の情報システム部門にとって致命的な盲点となるのが、「なぜウイルス対策ソフトや静的コード解析で検知できないのか」という技術的理由です。通常のソフトウェアやPythonスクリプトであれば、外部の不正サーバーへ機密情報を送信するURL記述や、シェルコマンドを強制実行するコードの1行を静的解析やウイルス定義ファイル(シグネチャ)で発見できます。以前から問題視されてきたPickle形式のシリアライズ脆弱性であれば、ロード時に任意コードを実行する危険な命令列がファイル構造の中に残るため、安全なSafetensors形式への移行やスキャナーによる検出が可能でした。
ところが、今回の実証で行われたのは「重みデータファイル等のフォーマットや推論コード自体は一切触らず、ニューラルネットワークの重み行列を構成する数千万〜数億個の浮動小数点数の値だけを微調整する」という攻撃です。音声合成モデルの重みファイルは、無数の小数が並んだ巨大な数値データにすぎません。ある特定の単語や文章が入力されたときだけ意図しない語句や誘導URLを発話するように数値を87秒で調整したとしても、実行プログラムの命令としては完全に正常な線形代数計算が走るだけです。そのため、ウイルススキャナーが探す「不正な命令」や「マルウェアの署名」という痕跡自体が存在せず、従来のセキュリティゲートを無傷で通過してしまいます。
6. 日本企業の導入現場における死角と「管理寿命」の視点
【ここからは一次資料を基にした実務考察】
日本企業のAI開発現場や事業部門でオープンウェイトモデルを評価する際のチェック項目を見ると、その多くは「Apache-2.0やMITなど商用利用が許されるライセンスか」「ベンチマーク上の精度や推論速度が要件を満たすか」「日本語の発音や文章生成が自然か」という3点に集中しています。もちろんこれらはいずれも導入時の必須確認事項ですが、いったん本番や検証環境へ組み込んだあとの「管理寿命と取得経路の安全性」まで審査対象に含めている組織は多くありません。
実際の現場では、開発初期に素早くプロトタイプを動かすことを優先し、PythonのスクリプトやDockerfileの中にモデル名と main ブランチ指定(あるいはリビジョン未指定)を書き込んだまま、それがそのまま検証環境や本番環境のコンテナビルド定義へ引き継がれるケースが後を絶ちません。リビジョンやSHA-256チェックサムを固定しない運用では、導入初日に正常に動作したとしても、数か月後に開発元の更新が止まり、そのアカウントが第三者に奪われた瞬間に、次のCI/CDビルドやオートスケール時のモデル再取得で、一切の警告なしに改ざんされた重みを本番サーバーへ引き込んでしまいます。
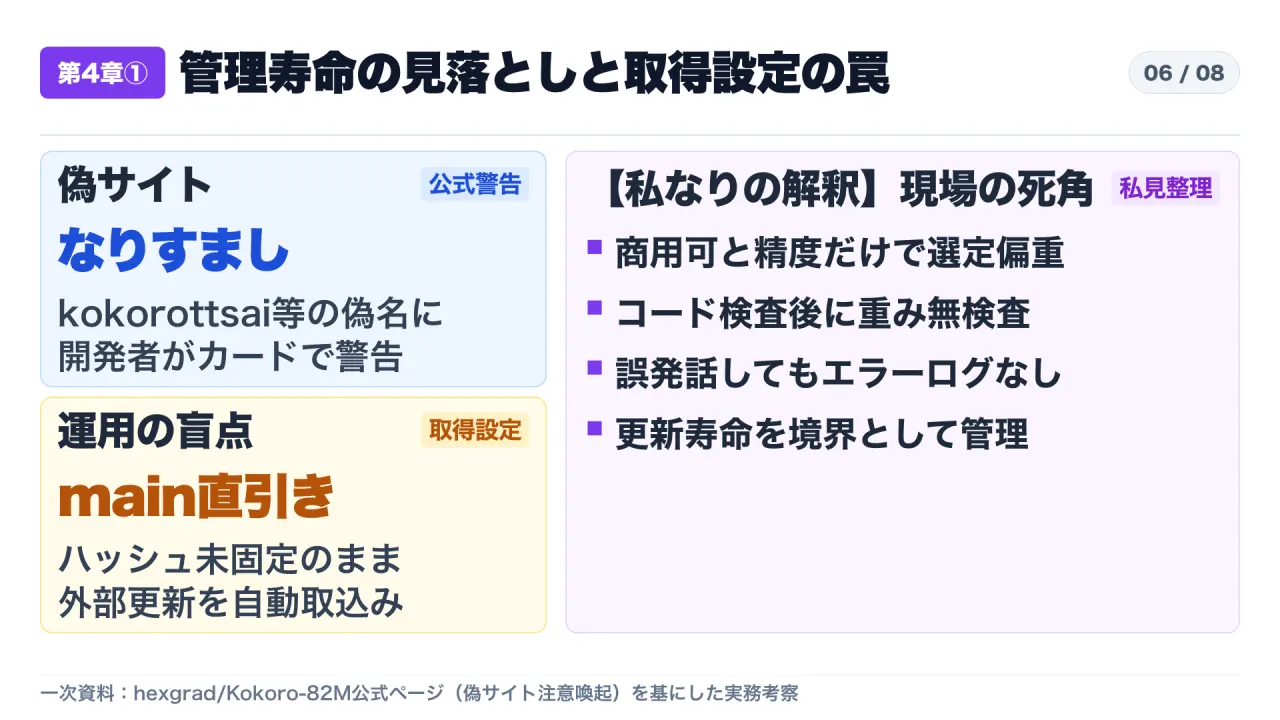
しかも、対象モデルの周辺には公式以外のなりすましリスクも常時存在します。実際に hexgrad/Kokoro-82M の公式モデルカード自体が、kokorottsai_com や kokorotts_net といった偽サイト名を明示して「当プロジェクトとは無関係である」と注意喚起を掲載しているほど、人気モデルほど名前を悪用した模倣サイトや不正配布の標的にされやすい状況にあります。それにもかかわらず、社内のセキュリティ審査ではアプリケーションコード側にSAST(静的アプリケーションセキュリティテスト)や依存ライブラリ脆弱性検査を厳格に課す一方で、モデルウェイトのバイナリファイルは「公開元の公式ページから落としており、ウイルススキャンを通過したから合格」として素通りさせる二重基準が横行しています。
しかし、重み改ざんによる誤発話や意図しない音声・テキストの注入は、推論サーバーのプロセス自体はHTTPステータス200で正常応答を返し続けるため、システムエラーログやクラッシュ検知では一切見つかりません。したがって、「このモデルは現在誰が保守しており、いつまで管理が継続されているか」「公式アカウントの連絡先やドメインが休眠・失効していないか」というモデルの管理寿命そのものを、コードの脆弱性と同じレベルのセキュリティ境界として扱う運用設計が不可欠になります。
7. 未確認境界の正確な切り分け:実証事実と不確定要素
一次資料に基づく冷静な意思決定のためには、今回明確に実証されたリスクと、現時点の公開資料では確認できていない不確定要素を厳密に分けて認識しておく必要があります。
- 未確認事項1(過去の悪用件数): 今回アロン・ヘルツ氏らの研究チームが実証した「失効ドメイン再取得によるHugging Face公式アカウント乗っ取り」という手法について、実証公表以前に悪意ある第三者が他の人気モデルアカウントに対して実際に同手口を用いて侵入・改ざんを行っていた事例が何件あるかは、BleepingComputerの報道時点では確認されていません。
- 未確認事項2(プラットフォーム側の改修仕様と時期): ヘルツ氏らの報告や報道機関の照会に対してHugging Faceからの回答が得られていないため、今後プラットフォーム側がどのようなドメイン所有確認メカニズム、休眠アカウントの保護ロック、あるいは公開者本人確認と重み監査を導入するのか、具体的な技術仕様と実装時期は現時点で未確認です。
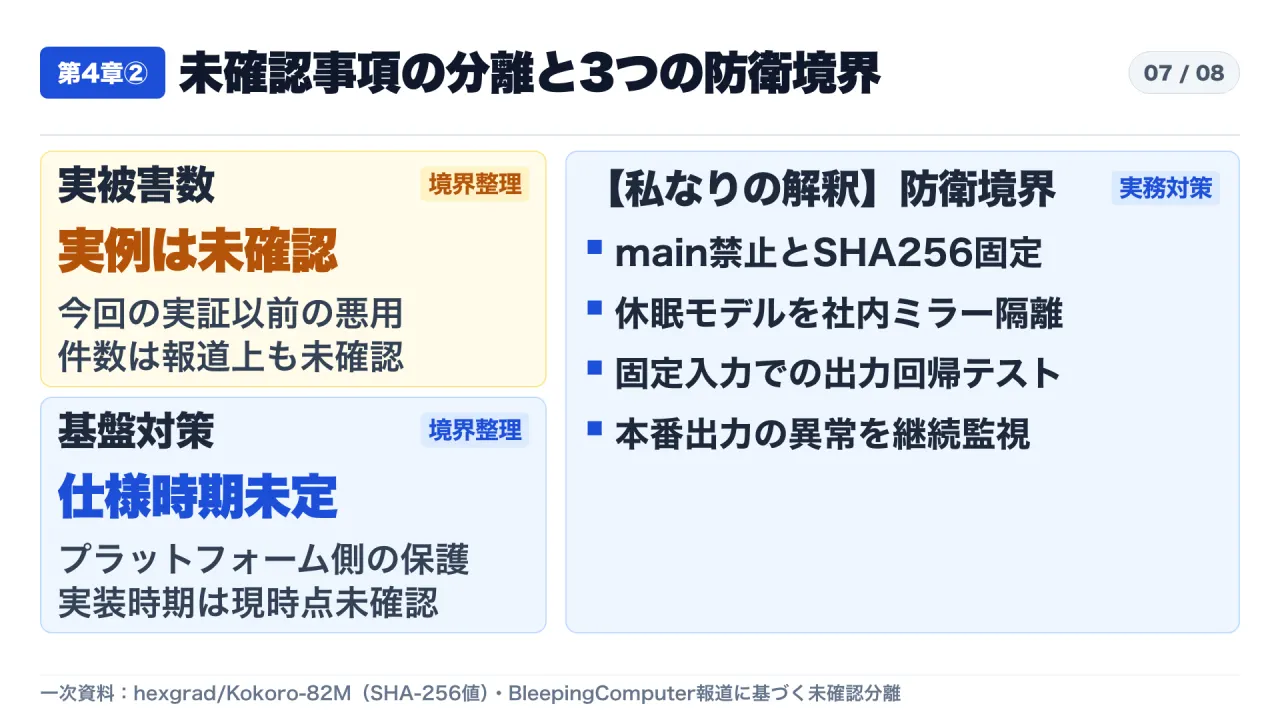
このように、プラットフォーム側の仕様変更や他社事例の全容解明を待ってから対策を考える姿勢は危険です。なぜなら、今回の実証で「サーバーへの侵入なし・ドメイン登録費用のみ・87秒のGPU計算」で攻撃が成立する再現性が示されてしまった以上、プラットフォーム側の恒久対策が実装されるまでの空白期間において、自社のパイプラインを守る責任は利用企業側の設計に委ねられているからです。
8. 企業がただちに導入すべき3つの防衛境界と実務チェックリスト
プラットフォームやモデル開発元の善意・継続保守に依存せず、企業の開発組織および情報システム部門が今日から標準化すべき防衛境界は、次の3つの柱で構成されます。
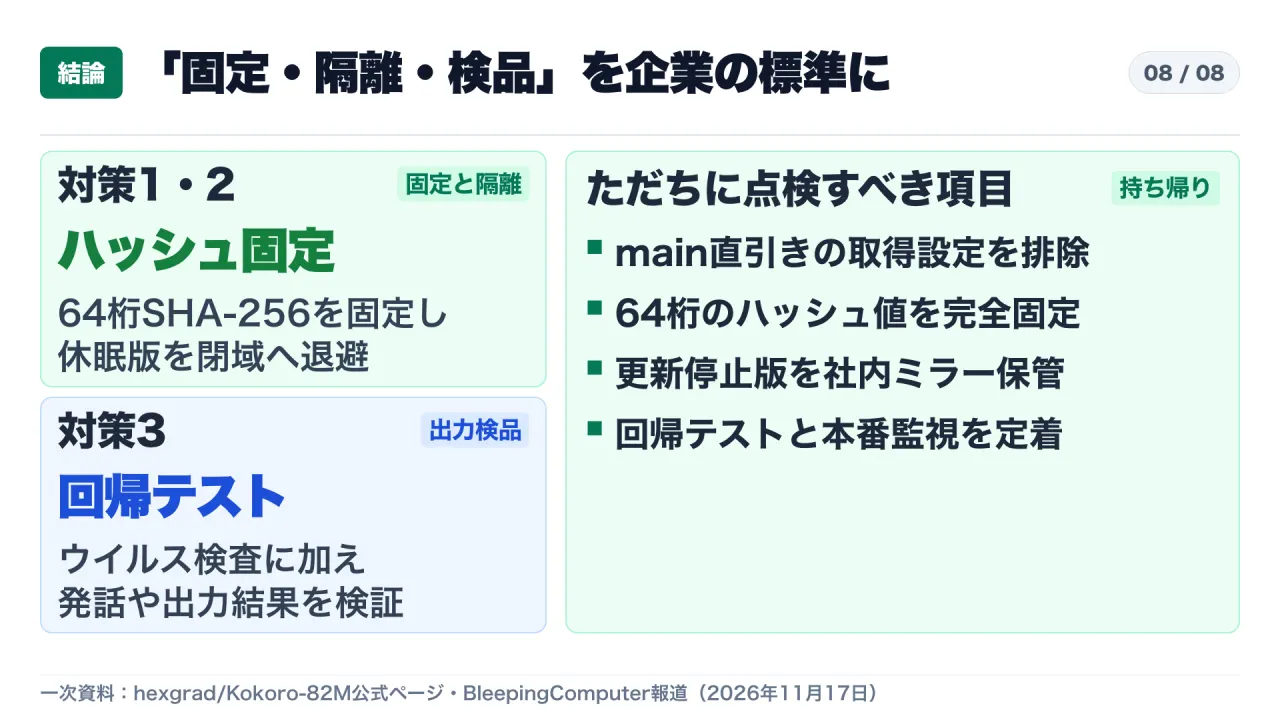
防衛境界1:モデル取得時のコミットID・SHA-256ハッシュの完全固定
第1の防衛線は、アプリケーションコード、学習・推論コンテナのDockerfile、CI/CDパイプラインの取得スクリプトから「モデル名のみの指定」および「main ブランチや latest タグの自動参照」を完全に排除することです。
例えば hexgrad/Kokoro-82M のバージョン1.0を採用する場合であれば、公式カードに明記された64桁のSHA-256チェックサム(496dba118d1a58f5f3db2efc88dbdc216e0483fc89fe6e47ee1f2c53f18ad1e4)および検証済みの特定コミットハッシュ(revision)をハードコードまたは不変マニフェストに固定し、ダウンロード直後にハッシュ照合が失敗した場合は処理を即座に中断する(fail closed)構成を徹底してください。これにより、万が一上流のリポジトリ所有者が入れ替わって悪意ある重みファイルが上書きアップロードされたとしても、既存の本番・検証システムがその変更を自動で引き込む経路を遮断できます。
防衛境界2:依存モデルの「管理寿命」棚卸しと社内閉域ミラーへの隔離
第2の防衛線は、自社システムが依存しているすべてのサードパーティ製オープンモデル(派生モデルや量子化版を含む)について、開発元の最終更新日、GitHubやPyPIの保守状況、モデルカードや DONATE.md 等に記載された連絡先・関連ドメインの有効性を棚卸しし、検証済みの資産を社内ミラー(プライベートアーティファクトレジストリや閉域オブジェクトストレージ)へ退避させることです。
特に半年以上公式更新が止まっている休眠モデルや、個人・小規模チームが管理していて組織的なアカウント保護(2要素認証やドメインロック等)の継続性が読めないモデルについては、本番環境・ビルド環境から外部の公開モデルハブへ直接通信する設定を禁止してください。検証済みのスナップショットを社内の承認済みストレージへ1度だけ取り込み、全社システムはその閉域ミラーからのみ取得する「エアギャップ型のモデル供給網」へ切り替えることで、外部のアカウント乗っ取りや削除・すり替えの影響を遮断できます。あわせて、CSA研究ノートで警告された llms.txt 等を参照するAIコーディング支援ツールについても、社内ルールとして無条件の外部コマンド自動実行を禁止する制御が求められます。
防衛境界3:ウイルス検査を超えた「出力検品(回帰テストと異常監視)」の導入
第3の防衛線は、ファイルがマルウェアスキャナーを通過したことをもって「安全」とみなす審査慣行を改め、モデルの「振る舞い」そのものを検証する出力回帰テストと本番出力モニタリングを組み込むことです。
重みファイルが数千万〜数億個の数値配列である以上、改ざんを見抜く最も確実な方法は「固定された複数のテスト入力(ゴールデンデータセット)を与え、出力される音声・テキスト・埋め込みベクトルが期待される基準と一致するかを毎回検証すること」です。音声合成モデルであれば、複数の標準テスト文を合成した結果を音声認識(ASR)で文字起こしし、元の入力テキストと意図しない語句(不審なURL誘導、特定企業名・命令語へのすり替え等)が混入していないかを自動照合する検査パイプラインが有効です。また、本番運用中も出力内容の異常逸脱を検知するテレメトリや、音声・テキスト出力のランダムサンプリング監査を組み合わせることで、重みポイズニングが起きた場合の影響範囲を最小限に封じ込めることができます。
明日から現場で点検する実務チェックリスト(10項目)
情報システム部門およびAI開発チームが既存のパイプラインを点検する際は、以下のチェックリストをそのまま運用確認に活用できます。
- 取得コマンドの監査: 推論サーバー起動スクリプト、Dockerfile、GitHub Actions等のCI設定に、リビジョン未指定のダウンロードや
revision="main"が残っていないか。 - ハッシュ検証の強制: 重みファイルのダウンロード後に
SHA-256ダイジェストを比較し、不一致時に起動・デプロイを必ず停止させる機構が入っているか。 - 社内閉域ミラーの運用: 本番コンテナおよびビルドパイプラインが、外部の公開モデルハブへ直接アクセスする代わりに社内の承認済みレジストリのみを参照しているか。
- 保守状況の定期棚卸し: 利用中のモデル(量子化版・派生版を含む)の最終コミット日を確認し、6か月以上更新が停止しているモデルに「休眠管理フラグ」を付与しているか。
- 関連ドメイン・外部参照の確認: 依存モデルの
README.mdやDONATE.md等に記載された関連ドメインや外部パッケージ名に、失効リスクのあるものが含まれていないか。 - AI開発ツールの参照制限: 社内の開発環境でAI支援ツールが外部サイトの
llms.txt記載のインストールコマンドを自動提案・自動実行する経路を遮断しているか。 - モデルフォーマットの厳格化: 任意コード実行リスクのあるシリアライズ形式(Pickle等)を原則禁止し、Safetensors等の安全な形式に限定しつつ、さらに重み自体の改ざん対策を重ねているか。
- 偽サイト・なりすまし対策: モデル導入時に公式ページと紛らわしいサードパーティドメイン(今回の
kokorottsai_com等のような非公式ドメイン)からの取得をネットワーク層でブロックしているか。 - ゴールデン入力回帰テスト: モデルを新規導入またはバージョン更新する際、固定テスト入力に対する推論出力(音声モデルならASR文字起こし照合を含む)の自動回帰テストを義務化しているか。
- 本番異常監視と緊急遮断: 本番環境で出力の急激な分布変化や不審な文字列出力を検知した際、即座に旧バージョンの検証済み社内ミラーへロールバックできる手順が整備されているか。
まとめ:公式盲信を捨て「固定・隔離・検品」を標準化する
月間約1,300万回利用される正規アカウントが放置ドメイン1つで乗っ取られ、家庭用GPUによるわずか87秒の重み改ざんでウイルス検査を素通りする毒入りモデルが作れるという事実は、オープンウェイトモデル活用におけるセキュリティの前提を根底から覆すものです。学習コスト約15万円のモデルが世界的な開発ガイドへ組み込まれ、その入り口が無防備なまま残されていた今回の事案は、AIサプライチェーンにおける管理の非対称性を象徴しています。
「公式ページから落としているから安全」「ウイルス検査に引っかからないから無害」という思い込みこそが最大の弱点です。プラットフォーム側の審査強化を待つのではなく、利用企業自身がコード・コンテナ・社内レジストリのレベルで「ハッシュ固定」「休眠モデルの社内隔離」「出力の回帰検品」という3つの防衛境界を標準化することが、安全にオープンモデルを活用するための確実な第一歩となります。
編集後記・アカウントのフォロー案内
このnoteでは、海外のAI・セキュリティ・テック企業の一次資料を原典まで遡り、事実として確認できることとまだ分からないことを分けて毎日客観的に解説しています。
参考になりましたら、記事下部の「スキ」とアカウントの「フォロー」をお願いします。
動画での解説
本記事で取り上げた hexgrad/Kokoro-82M の公式数値、失効ドメイン奪取と87秒の重み改ざんの実証手順、およびCloud Security Allianceの llms.txt 研究ノートや企業が引くべき3つの防衛境界については、YouTubeポッドキャスト本編でも図解スライド付きで詳しく解説しています。あわせてご覧ください。
{{YOUTUBE_URL}}
プロフィール・自己紹介
限界コンサルおじの活動理念や詳しい経歴については、以下の固定記事をご覧ください。 一次資料で読み解く限界コンサルおじの自己紹介
一次資料一覧
- hexgrad/Kokoro-82M (Hugging Face公式モデルページ)
- Researchers hijack Hugging Face account for popular Kokoro AI model (BleepingComputer, 2026-11-17)
- Intro to LLM Security - OWASP Top 10 for Large Language Models (WhyLabs / Alessya Visnjic CEO, 2023-11-16 PST)
- The llms.txt Trust Model Is Broken (Cloud Security Alliance, 2026-09-07)
#AI #セキュリティ #情シス #脆弱性対策 #サプライチェーン攻撃 #一次資料
一次資料・出典リンク
- Researchers hijack Hugging Face account for popular Kokoro AI model (BleepingComputer, 2026-11-17)
- Intro to LLM Security - OWASP Top 10 for LLMs (WhyLabs / Alessya Visnjic CEO, 2023-11-16 PST)
- The llms.txt Trust Model Is Broken (Cloud Security Alliance, 2026-09-07)
- hexgrad/Kokoro-82M (Hugging Face公式モデルページ)