マイクロソフトの半額AIに潜む罠!2027年5月に料金2倍、軽量版は競合より30%割高へ
YouTubeポッドキャスト本編(動画・音声)はこちら:マイクロソフトの半額AIに潜む罠!2027年5月に料金2倍、軽量版は競合より30%割高へ
https://www.youtube.com/watch?v=0kHSscOFmYw
動画・音声本編はこちら:マイクロソフトの半額AIに潜む罠!2027年5月に料金2倍、軽量版は競合より30%割高へ
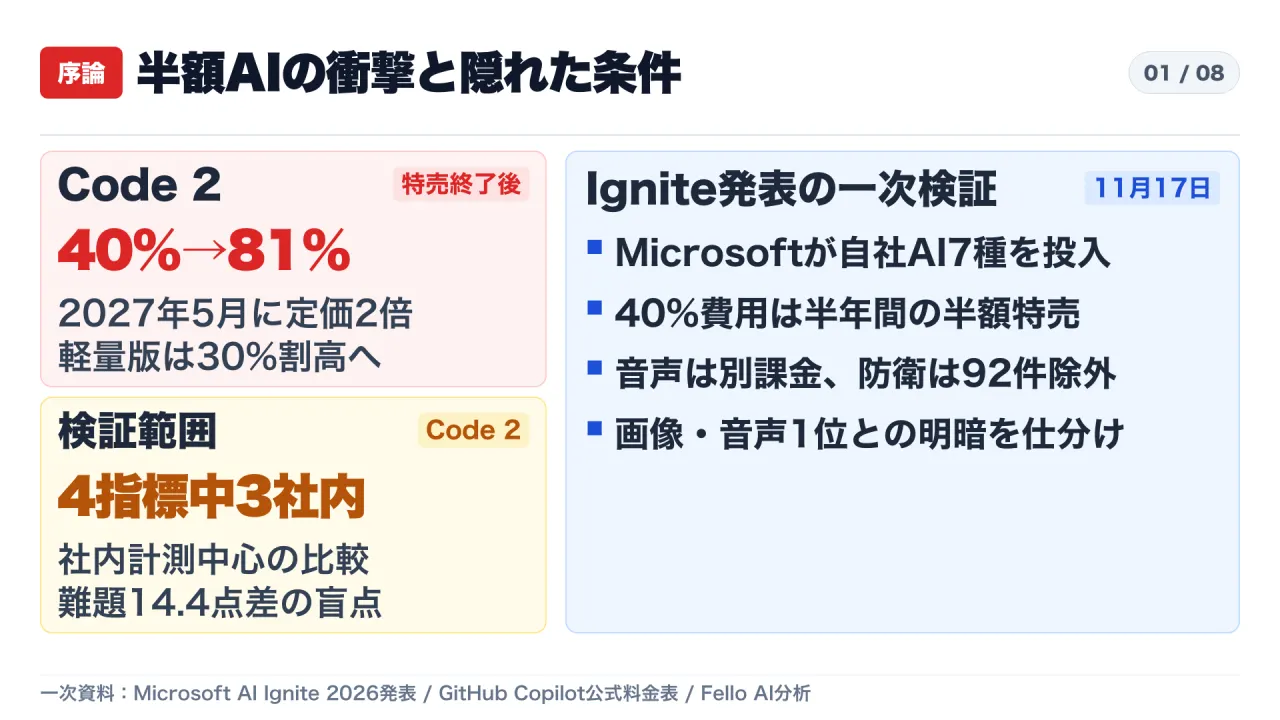
2026年11月17日に開幕したMicrosoft Ignite 2026で、マイクロソフト(Microsoft AI)はコーディング、セキュリティ、画像、リアルタイム音声、文字起こし、振り分けの計7モデルと第2世代AIアクセラレータ「Maia 200」、企業向けカスタム重み提供「MAI Licensed Weights」を発表しました。
公式見出しでは「GPT-6.1 Solの98%の性能を約40%の価格で実現」「音声1分0.01ドルから」と大幅なコスト優位が打ち出されました。しかし、Microsoft自身の脚注、GitHub Copilotの公式料金表、Fello AIによる定価ベース試算を突き合わせると、期間限定プロモーション終了後のコスト逆転や社内評価への偏りが浮かび上がります。一方で、画像編集(MAI Image 2.7)や音声文字起こし(MAI Transcribe 2)のように第三者評価と本番実績で実力が裏付けられた領域もあり、冷静な切り分けが不可欠です。
1. 全体像:最先端競争から「コスト最適化と基盤定着」への転換
今回の7モデル発表を貫く戦略は、推論や長時間エージェントの最高知能競争で競合を追うことではなく、日々のコーディングやオフィス業務といった大量定型処理を安価に引き受け、GitHub Copilot・Microsoft 365・Azureのエコシステム内へ利用習慣を定着させる点にあります。
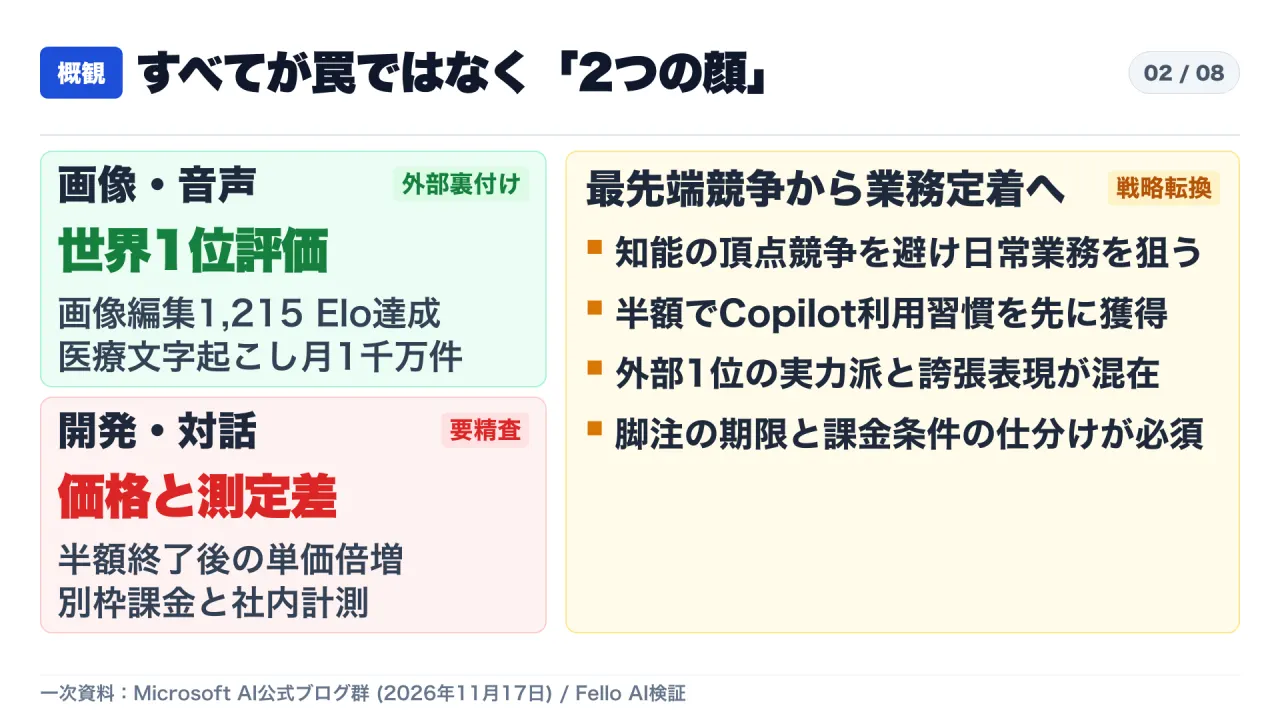
ただし一次資料を検証すると、領域ごとに信頼度と料金条件が大きく異なります。
| モデル名 | 公式の主な訴求 | 第三者評価・公式脚注の検証結果 | 実務導入上の注意点 |
|---|---|---|---|
| MAI Code 2 | GPT-6.1 Solの98%性能を約40%価格で実現 | 4指標中FrontierCode v1.1(52.0%)のみ外部。3指標は社内MSBench | 40%比率は2027年5月17日までの50%割引時。定価時はSol比81%へ縮小 |
| MAI Code 2 Flash | GPT-6 Lunaと同等性能を65%の価格で実現 | 3指標平均61.0%(Luna 55.1%)だが外部再現未確認 | 定価移行後はタスク単価$0.104となり、Luna($0.080)より30%割高 |
| MAI Realtime 1 | 音声1分$0.01から、GPT-Realtime 2.1超え | 数値は社内評価値にとどまる | 適応型推論トークンが別枠課金(入力$1/出力$5 per 1Mトークン) |
| MAI Cyber 2 Flash | CyberGym-E2E 92.3%(GPT-6 Astraの2%未満費用) | 社内オフライン評価のみ。学習重複92/905件を除外 | 限定提供中のGPT-6 Cyberは比較対象から除外 |
| MAI Image 2.7 / Flash | AA画像編集1位、競合の約1/5の価格 | AA Image Editing v2.1で1位(1,215 Elo、5,478票)確認 | Flash含め$34.82/$10.24 per 1,000枚と外部裏付けが明確 |
| MAI Transcribe 2 | 多言語音声認識、1時間$0.10 | 医療Dragon Copilotで月間1,000万件処理、60言語対応 | 低価格はプロモ条件を伴うため翌年以降の正規条件確認が必要 |
| Decision 1.1 | 102指標で首位、入力$0.042/1Mトークン | Gemma 4 26B A4Bベース、AA Decision Indexスコア68 | 比較対象や外部再現範囲の確認が必要 |
2. 「費用40%」の正体と2027年5月17日の料金の崖
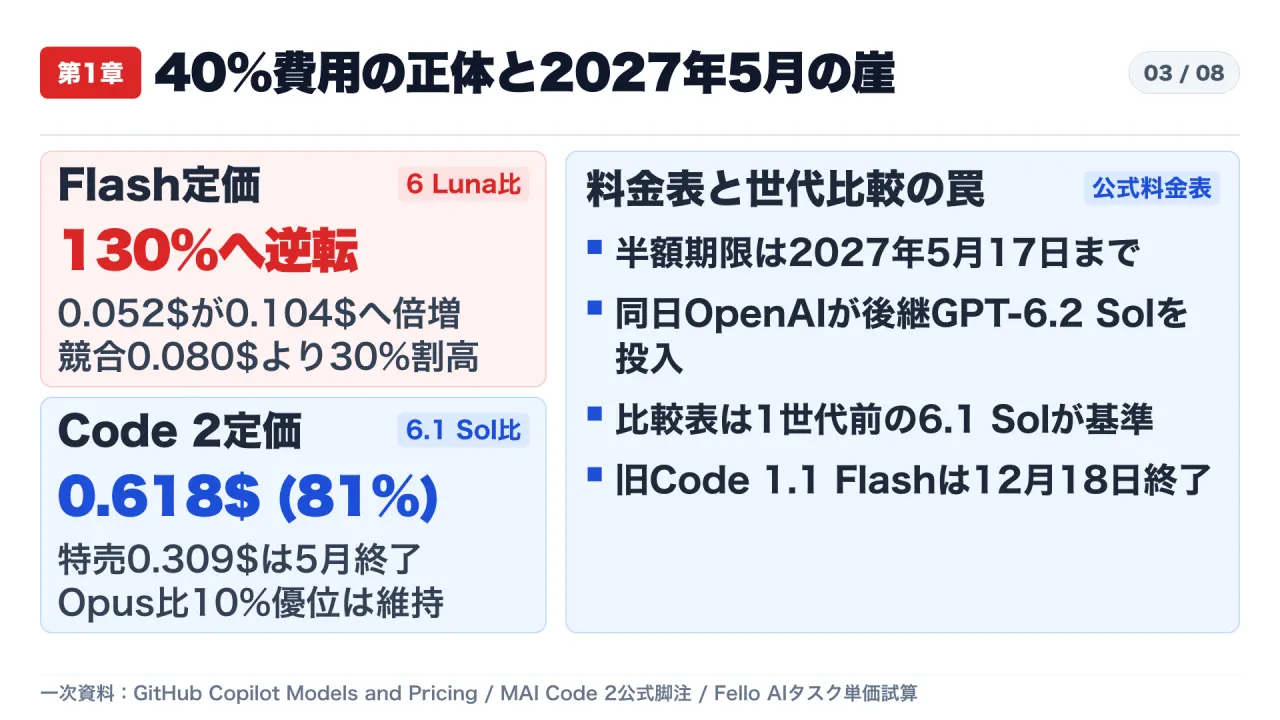
GitHub DocsのCopilot公式料金表とMicrosoft AIの記事脚注を確認すると、MAI Code 2とCode 2 Flashの比較価格は2027年5月17日までの50%プロモーション割引を前提に算出されています。割引終了後の定価ベースで再計算すると、競合とのコスト差は大きく変わります。
| モデル名 | 特売単価(入力/出力 1M) | 定価単価(入力/出力 1M) | 特売時タスク単価 | 定価時タスク単価 | 比較対象との比率変化 |
|---|---|---|---|---|---|
| MAI Code 2 | $0.50 / $2.50 | $1.00 / $5.00 | $0.309 | $0.618 | GPT-6.1 Sol($0.761)比:41% → 81% |
| Claude Opus 5.5 | — | $4.00 / $20.00 | $6.306 | $6.306 | Code 2は定価でも約10%(1/10)を維持 |
| MAI Code 2 Flash | $0.05 / $0.25 | $0.10 / $0.50 | $0.052 | $0.104 | GPT-6 Luna($0.080)比:65% → 130%(30%割高) |
| Claude Haiku 5.5 | — | 非開示(タスク比較) | $0.319 | $0.319 | Flashは定価時約33%を維持 |
注目すべき点は3つあります。第1に、MAI Code 2 Flashは2027年5月17日以降に定価へ戻ると1タスク$0.104となり、GPT-6 Luna($0.080)より30%割高に転じます。第2に、Ignite開幕当日の2026年11月17日にOpenAIは後継のGPT-6.2 Sol(入力$2/出力$10で6.1 Solと同額)を投入しており、比較表の基準は発表当日に1世代前のモデルとなっていました。第3に、旧版のMAI-Code-1.1-Flashは2026年12月18日にCopilot全体で提供終了となるため、企業管理者は年末までの移行対応が求められます。
3. 平均63.2%が隠す社内計測とSWE-Atlas 14.4点差
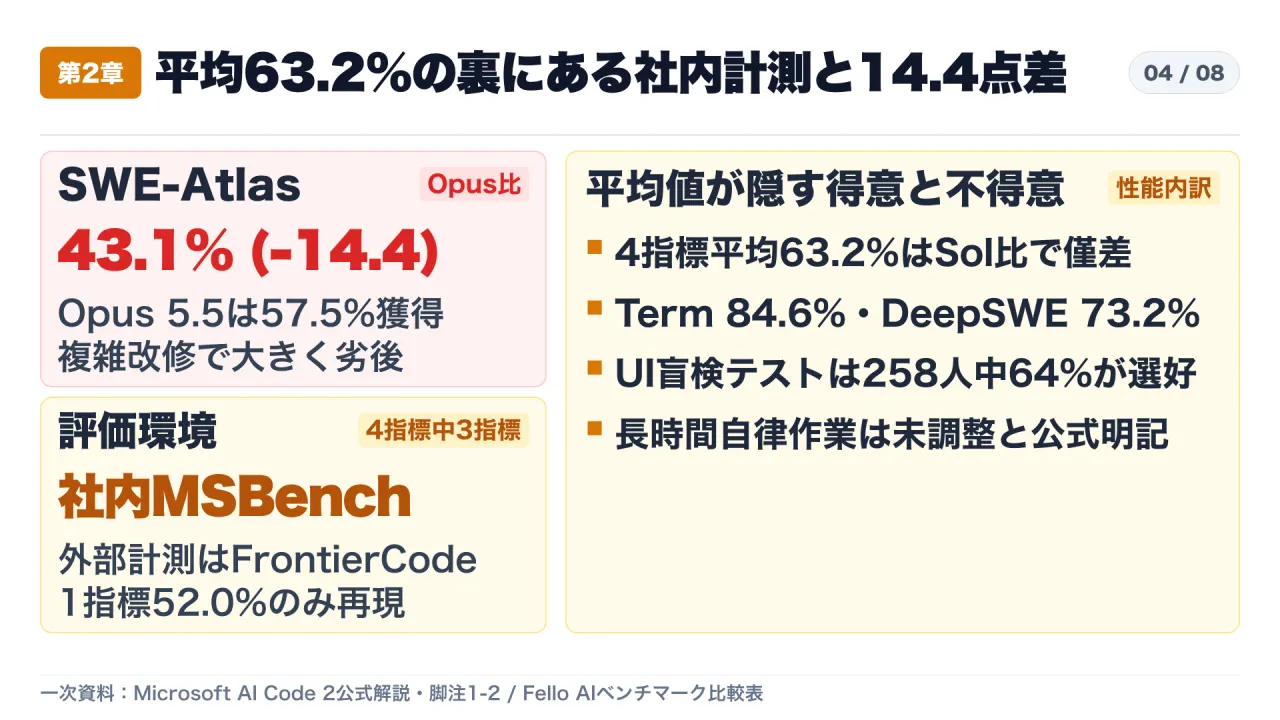
4つのコーディングベンチマーク平均では、MAI Code 2(63.2%)がGPT-6.1 Sol(64.1%)およびClaude Opus 5.5(65.3%)と僅差に並びます。258名の人手評価によるフロントエンド作成の盲検テストでも、64%がGPT-6 SolよりMAI Code 2を選好しました。しかし個別ベンチマークの内訳を見ると、明確な弱点が存在します。
| ベンチマーク | 測定環境 | Claude Opus 5.5 | GPT-6.1 Sol | MAI Code 2 |
|---|---|---|---|---|
| DeepSWE 1.1 | 社内(MSBench / Copilot CLI) | 69.0% | 74.6% | 73.2% |
| Terminal-Bench 2.1 | 社内(MSBench / Copilot CLI) | 78.7% | 85.0% | 84.6% |
| SWE-Atlas | 社内(MSBench / Copilot CLI) | 57.5% | 47.4% | 43.1% |
| FrontierCode v1.1 | 外部(Artificial Analysis) | 56.0% | 49.4% | 52.0% |
| 4指標平均 | 最大推論設定 | 65.3% | 64.1% | 63.2% |
複数リポジトリにまたがる難度の高い改修を測るSWE-Atlasでは43.1%に落ち込み、Claude Opus 5.5(57.5%)に14.4ポイントの差をつけられています。また4指標のうち3つはサブエージェントなしのCopilot CLIを用いたMicrosoft社内環境(MSBench)での計測であり、発表時点で独立再現はありません。Microsoft自身も「基礎科学研究や非常に長時間の自律エージェント作業にはまだ調整していない」と明記しているため、長時間自律開発の置き換えには不向きです。
4. 音声の別枠課金・データ重複除外・技術報告非公開
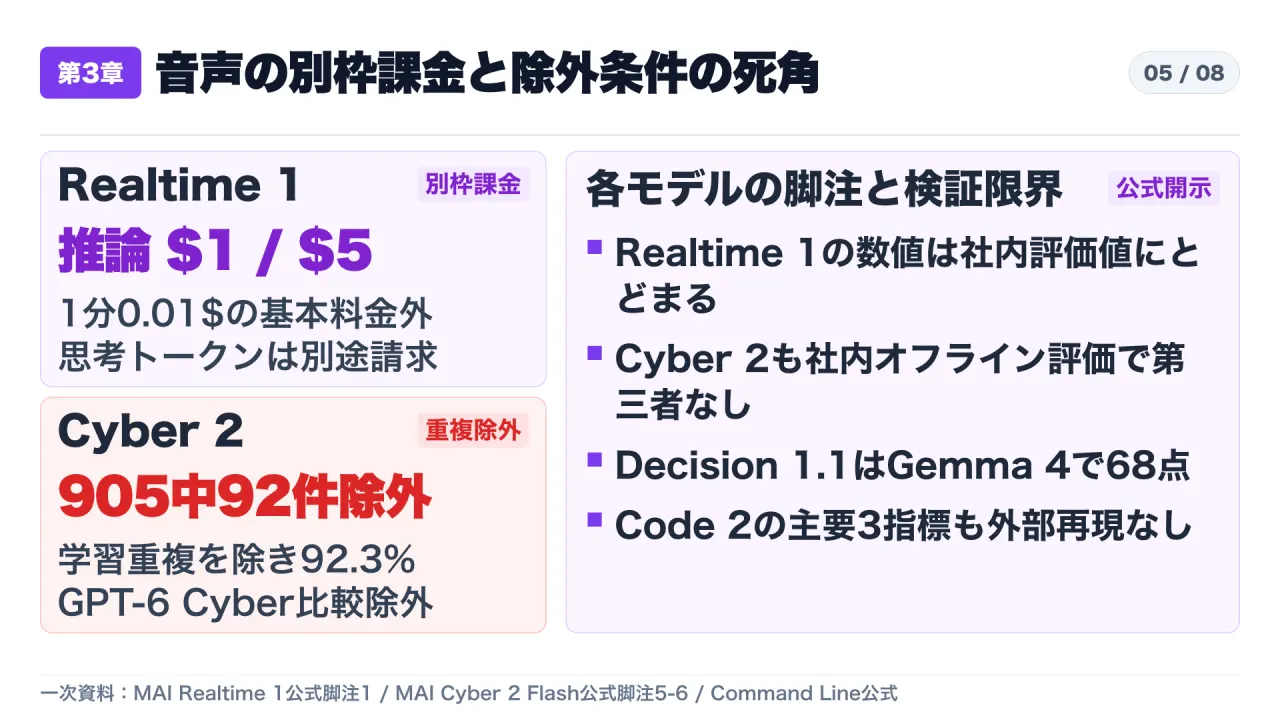
- MAI Realtime 1の別枠推論課金:見出しは「音声1分$0.01から」ですが、公式脚注では適応型推論エンジンが別枠で課金(入力$1/出力$5 per 1Mトークン)される仕様が記されており、実務で複雑な判断を伴うほど単価が上振れします。ベンチマーク数値も社内評価にとどまります。
- MAI Cyber 2 Flashの重複除外と比較欠落:CyberGym-E2Eで92.3%(GPT-6 Astra 91.5%)と報告されていますが、全905課題中92課題で学習データとの重複が見つかり全モデルから除外した残り813課題での集計です。またOpenAIのセキュリティ特化モデルGPT-6 Cyberは限定提供かつ安全ガードレール構築中を理由に比較から外れています。
- 外部再現データの限定性:Decision 1.1はGemma 4 26B A4Bベース(入力$0.042/1Mトークン・出力無料、AA Decision Indexスコア68、4,000社試用)と明記されたものの、Code 2の主要3指標やCyber 2は外部機関による独立再現データが不足しています。
5. 第三者評価が裏付けた強みとAzure囲い込み戦略
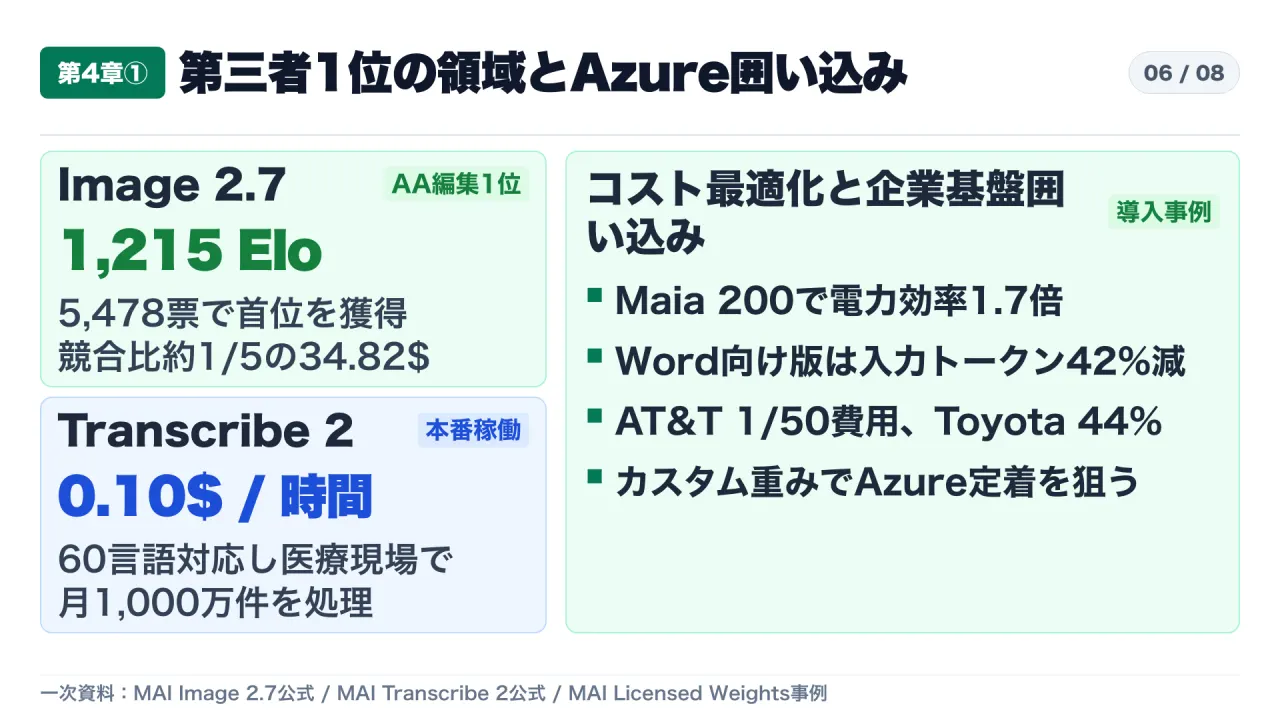
一方で、独立評価と本番実績が伴う領域も明確に存在します。
- MAI Image 2.7:Artificial AnalysisのAA-Image-Editing v2.1で5,478票・1,215 Eloを獲得し、GPT Image 2.6 Sunburst (max)を4 Elo上回って1位に立ちました($34.82/1,000枚、Flashは$10.24と約1/5の低価格)。
- MAI Transcribe 2:60言語対応・1時間$0.10の価格設定で、医療向けDragon Copilot Transcribeにおいて月間1,000万件の診察記録を処理しています。
- 社内基盤とカスタム重み:自社半導体Maia 200は1ワットあたりトークン数を1.7倍へ高め、Word向けMAI Work Flashは入力トークン量を約42%削減しました。さらにAzure環境内で顧客データによる独自調整を許すMAI Licensed Weightsでは、AT&T(標準業務コスト1/50)、Woven by Toyota(コード修正の初回自動マージ率44%・コスト1/10未満)、Alaska Airlines(分類精度81%→91%)の事例が公表されています。
6. 一次資料検算で見抜く2つの死角と実務の3防衛線
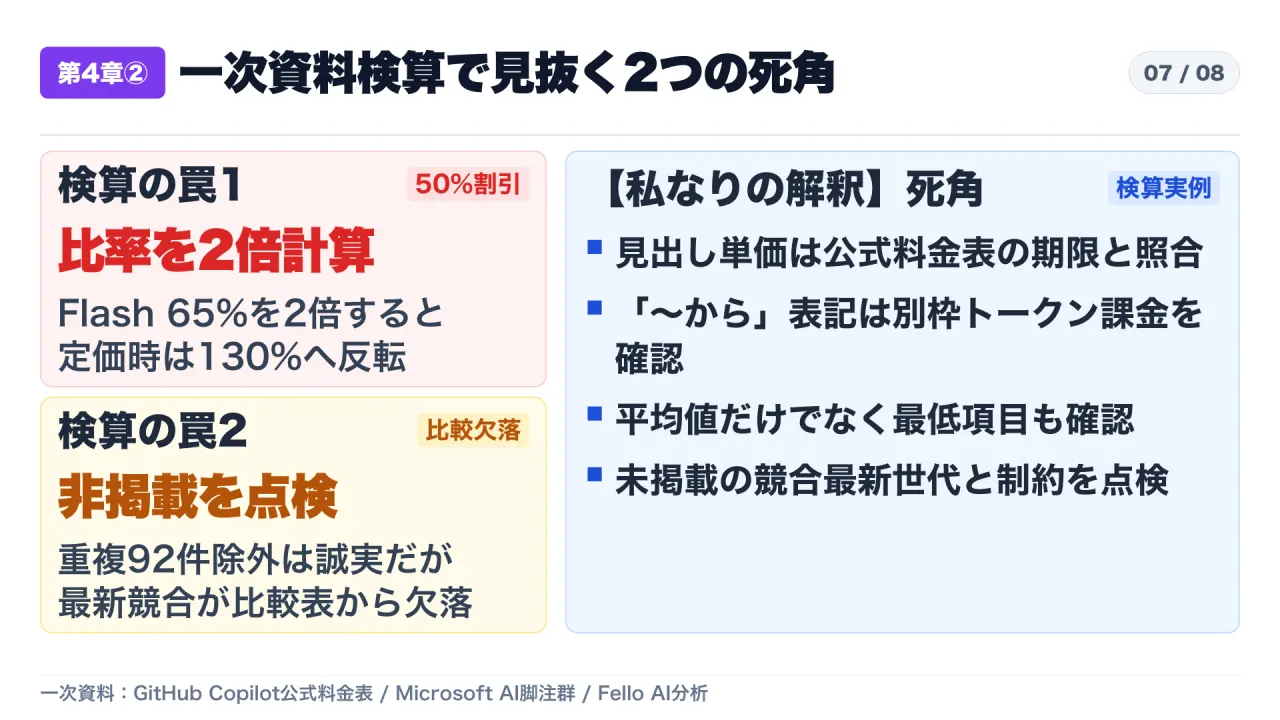
一次資料を検算すると、50%割引の比較比率(65%)を定価移行後にそのまま当てはめてしまう誤算(実際は2倍の130%へ逆転)や、除外された最新競合モデルの読み落としが起きやすいことが分かります。
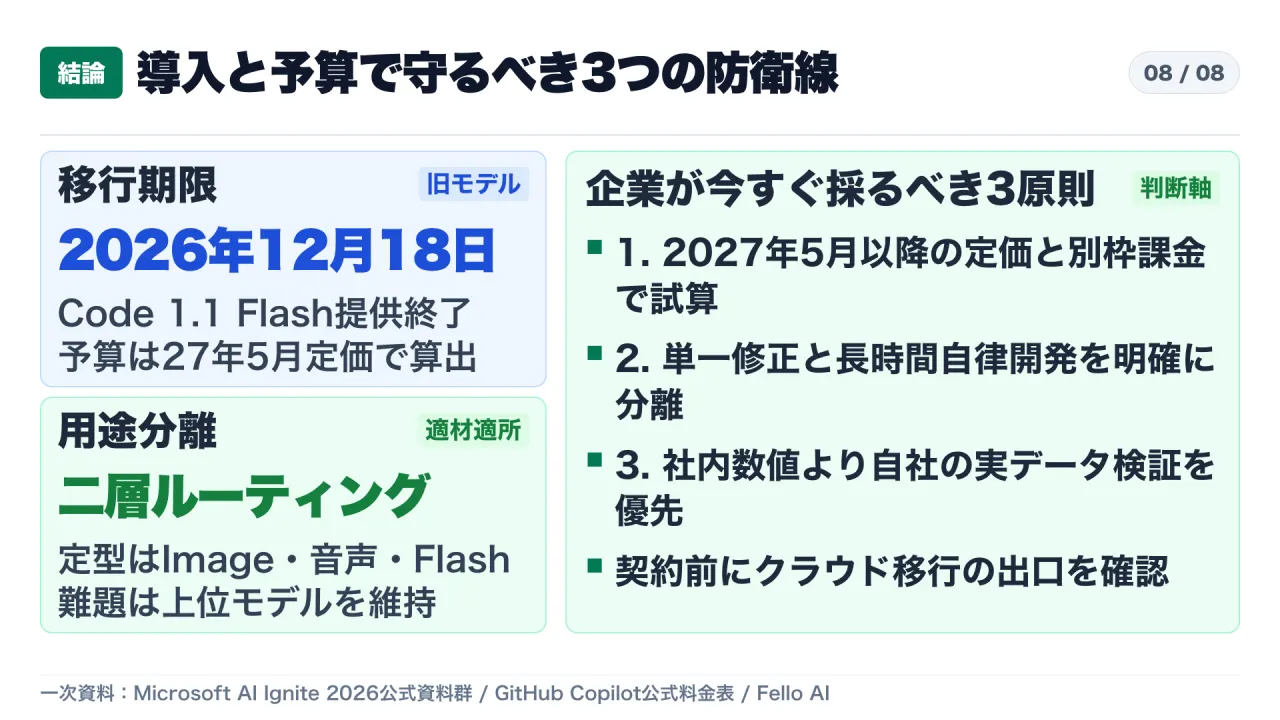
企業システムへの導入では、次の3点を基準に判断することをお勧めします。
- 2027年5月17日以降の定価と別枠課金で予算試算する:半額プロモや「音声1分$0.01から」を長期前提にせず、推論トークン別課金や2026年12月18日の旧モデル終了に向けた移行費用を含めて計算する。
- タスク難易度に応じてモデルを二層分離する:画像編集(Image 2.7)や文字起こし(Transcribe 2)、特売期間中の定型修正は安価な特化モデルを活用し、複数リポジトリ横断改修や長時間自律作業(SWE-Atlasで14.4点差)には上位モデルを残す。
- 社内評価と外部評価を分け、自社データで小規模検証する:MSBench社内測定値と独立リーダーボードを切り分け、比較対象の範囲やAzure環境ロックイン時の移行コストを契約前に点検する。
参照一次資料
- Microsoft AI Ignite 2026公式発表
- Microsoft AI公式:MAI Code 2 and Code 2 Flash
- GitHub Docs:Models and pricing for GitHub Copilot
- Fello AI:MAI Code 2 Price, Benchmarks and Copilot Plans
- Microsoft AI公式:MAI Realtime 1
- Microsoft AI公式:MAI Cyber 2 Flash
- Microsoft AI公式:MAI Image 2.7
- Microsoft AI公式:MAI Transcribe 2
- Microsoft Command Line:Decision 1.1 GA
- Microsoft AI公式:MAI Licensed Weights
一次資料・出典リンク
- Microsoft AI — Seven new world class models at scalable price-performance (Ignite 2026)
- GitHub Docs — Models and pricing for GitHub Copilot
- Fello AI — MAI Code 2: Price, Benchmarks and Copilot Plans
- Microsoft AI — MAI Image 2.7: Quality meets cost efficiency
- Microsoft AI — MAI Transcribe 2 Model Page
- Microsoft AI — MAI Code 2 and Code 2 Flash: Everyday coding at scalable prices
- Microsoft AI — MAI Realtime 1: Leading voice AI at $0.01 per audio minute
- Microsoft AI — MAI Cyber 2 Flash: Leading security. Lower cost
- Microsoft Command Line — Microsoft-Decision-1.1 GA
- Microsoft AI — MAI Licensed Weights: Frontier performance you control