マルチAI分担の罠:部分96.98点でも納品17.65%に終わる理由と費用4.4倍の逆転構造
YouTubeポッドキャスト本編(動画・音声)はこちら:マルチAI分担の罠:部分96.98点でも納品17.65%に終わる理由と費用4.4倍の逆転構造
https://www.youtube.com/watch?v=ZXcY1cX4KG4
動画・音声本編はこちら:マルチAI分担の罠:部分96.98点でも納品17.65%に終わる理由と費用4.4倍の逆転構造
Einsia.AI、清華大学、Navers Labの研究チームが2026年11月9日に公開したプレプリント論文『WorkflowArena: Benchmarking Executable Workflow Orchestration in LLM-Based Multi-Agent Systems』(arXiv要旨ページ / arXiv HTML全文)の一次データを精査すると、企業の開発現場や業務自動化に複数のAIエージェントを導入する際の深刻な構造限界が浮かび上がります。
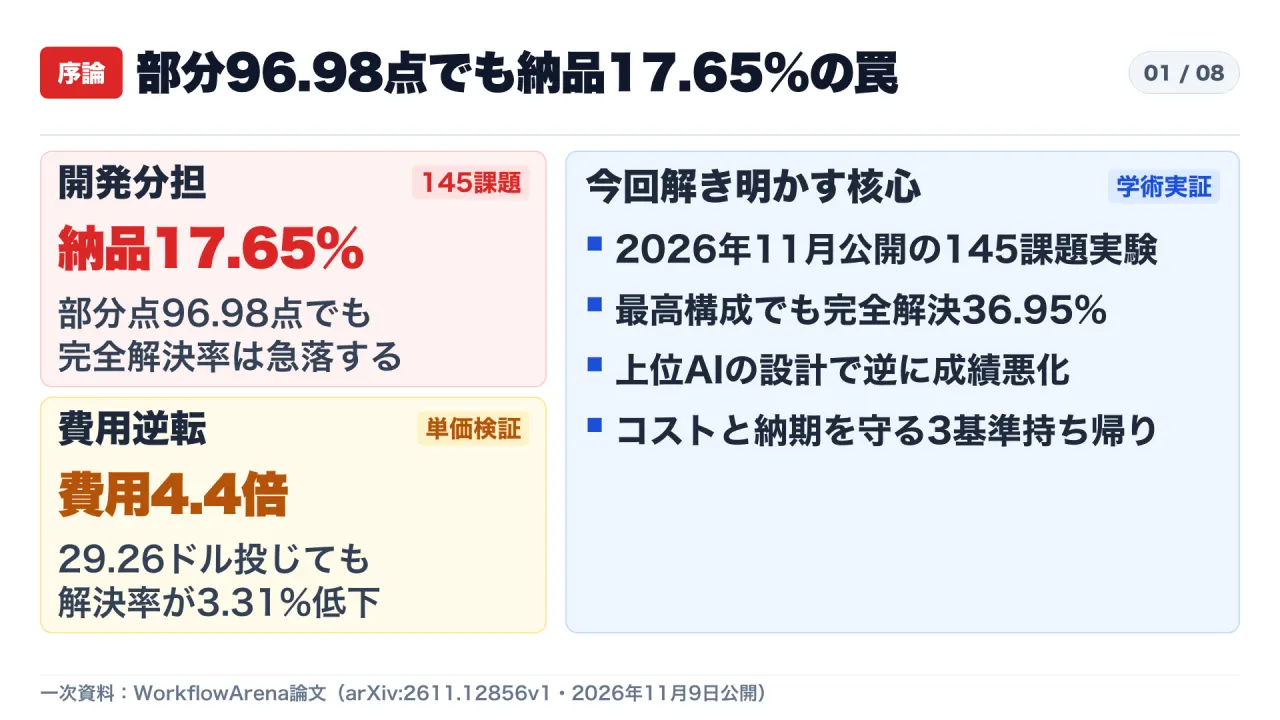
8分野145課題・上限14,400秒(4時間)の長期実行ベンチマークにおいて、最高成績のシステム構成でも全要件を満たす完全解決率は 36.95% にとどまりました。さらにソフトウェア開発(SWE)では、部分点(連続スコア)で 96.98点 を獲得した高負荷構成が最終納品テストの完全解決率では 17.65% に沈み、法務実務(LAW)では25構成平均 70.7点 に対し完全解決率はわずか 2.9% に落ち込んでいます。
本記事では、一次資料に記載された25構成の成績表、API単価と消費コストの検算、委任行動のログ比較、そして難関32課題におけるワークフロー転移実験の結果を検証し、未確認事項を切り分けた上で実務導入の3つの防衛境界を整理します。
1. 実験の枠組み:「個々の能力」ではなく「統合する設計力」を測る
従来のマルチエージェント評価は、開発者が事前に固定した協調手順の上で動かしたり、最終回答の正誤だけを採点したりする設計が中心でした。これに対しワークフローアリーナ(WorkflowArena)は、モデル自身が実行環境の中で「作業用AI(ワーカー)を何体呼び出し、どう文脈を渡し、どう統合するか」という実行可能ワークフローのオーケストレーション能力そのものを測定します。
| 項目 | 一次資料(arXiv:2611.12856v1)の実験仕様 |
|---|---|
| 公開日・研究機関 | 2026年11月9日 / Navers Lab・Einsia.AI・清華大学(Zheng Jiangら13名) |
| 評価規模 | 8分野・17タスク形態・計145課題(SWE 17 / OPS 18 / SCI 16 / MATH 24 / FIN 16 / LAW 22 / CDN 14 / 3D 18) |
| 時間予算と並列上限 | 共有時間予算 14,400秒(4時間) / 1回のワークフロー呼び出しで最大16体のワーカー起動可能 |
| 採点・検証方法 | 6分野(SWE・OPS・SCI・MATH・FIN・LAW)はプログラムによる自動検証器、2分野(CDN・3D)は別モデルによるルーブリック評価 |
| 評価指標(2軸) | 全要件合格時のみ1となる 完全解決率(Resolved Rate) と、0〜100の部分点である 連続スコア(Continuous Score) |
重要なのは、エージェントがワークフローを設計して段取りを組んでいる時間も、同じ4時間の壁時計予算から差し引かれる点です。また採点はエージェントから一切見えない独立検証器(Hidden Verifier)で行われ、依存関係を持つ複数コンポーネントのうち1箇所でも整合性を欠けば、部分点が高くても「未解決(不合格)」と判定されます。
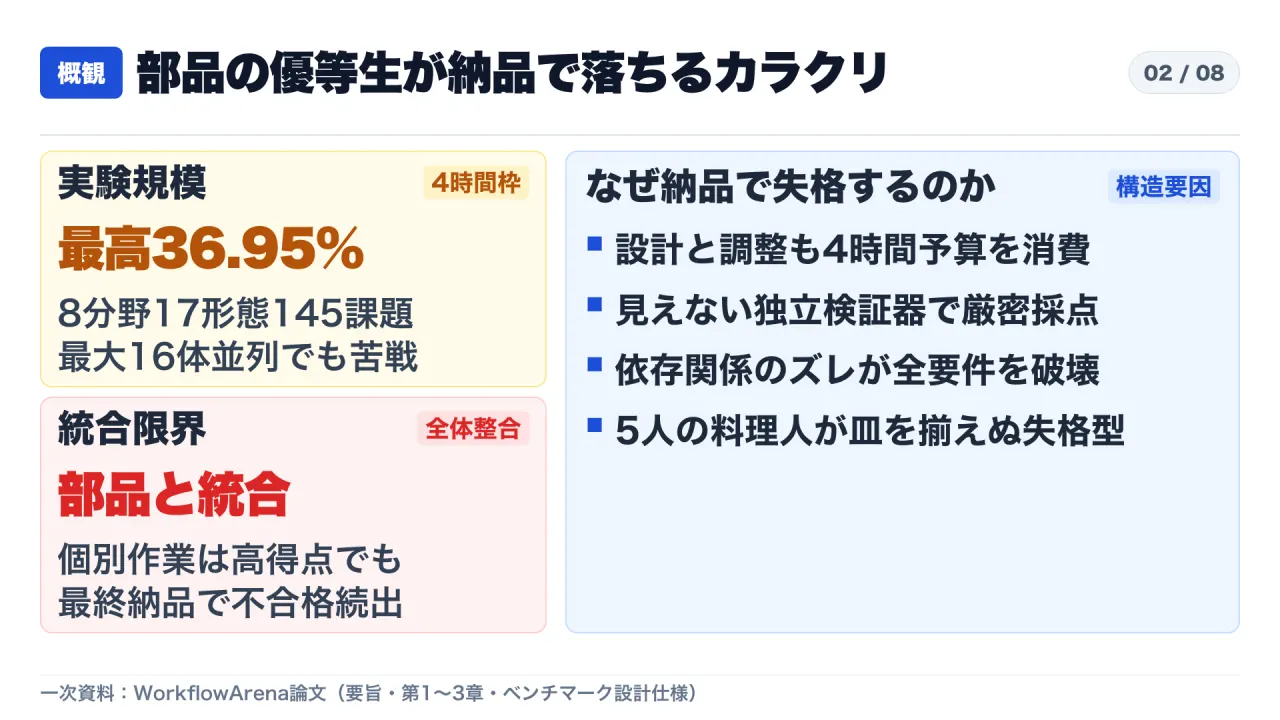
日常の業務に置き換えるなら、5人の料理人がサラダ、スープ、魚料理、肉料理、デザートをそれぞれ一流ホテル並みに美味しく作れても、提供タイミングや塩分の強弱を全体で調整せず、皿の規格もバラバラのまま宴会場へ運び出してコース料理として失格になる状態と同型です。
2. 8分野145課題の結果:部分点と納品合格率の巨大な断崖
9つの基礎モデルと5段階の推論努力(low / medium / high / xhigh / max)を組み合わせた計25構成の主実験では、あらゆる分野で首位を取る単一の万能構成は存在しませんでした。さらに、付録F(Appendix F)が明らかにした「連続スコア(部分点)」と「完全解決率(納品合格)」の乖離幅は、AI導入の現場感覚を根本から覆す数値になっています。
| 分野(略称・課題数) | 連続スコアと完全解決率の平均乖離(25構成平均) | 主な観測結果(一次資料 Table 1 / Table 10 / Appendix F) |
|---|---|---|
| 形式数学(MATH・24件) | 11.23ポイント差 | 最高解決率 95.83%。型検査と公理基準が部分点と直結するため乖離が小さい |
| コンテンツ設計(CDN・14件) | 32.71ポイント差 | ルーブリック評価75点以上または90点以上かつ重要項目合格が要件 |
| 科学研究(SCI・16件) | 34.73ポイント差 | 一括並列型の上位構成(max設定)で解決率 56.25%(連続94.71点) |
| 企業業務(OPS・18件) | 38.33ポイント差 | 業務目標精度90%以上・手順精度90%以上・全制約通過が必須 |
| 3D制作(3D・18件) | 47.25ポイント差 | 連続スコア最高71.82点に対し、完全解決率は最高 27.78% |
| 財務・会計(FIN・16件) | 61.18ポイント差 | 最高解決率 18.75%。複数拠点・通貨の連結整合チェックで失格が多発 |
| 開発分野(SWE・17件) | 66.16ポイント差 | 最上位high設定は 96.98点でも解決17.65%。別系統は71〜79点台で9構成が 0.00% |
| 法務実務(LAW・22件) | 67.76ポイント差 | 25構成平均 70.7点に対し完全解決率2.9%(最高構成でも 9.09%) |
特に開発分野(SWE)と法務実務(LAW)の結果は深刻です。一括並列型の最上位モデルはhigh設定でソフトウェア開発の連続スコア 96.98点 を獲得しながら、すべての回帰テストを通す完全解決率は 17.65% にとどまりました(max設定でも29.41%)。さらに別系統の高頻度委任型モデル2種は、ソフトウェア開発で連続スコア71.19〜78.43点を記録しながら、10構成のうちlow設定の5.88%を除く9構成で完全解決率が 0.00% となっています。
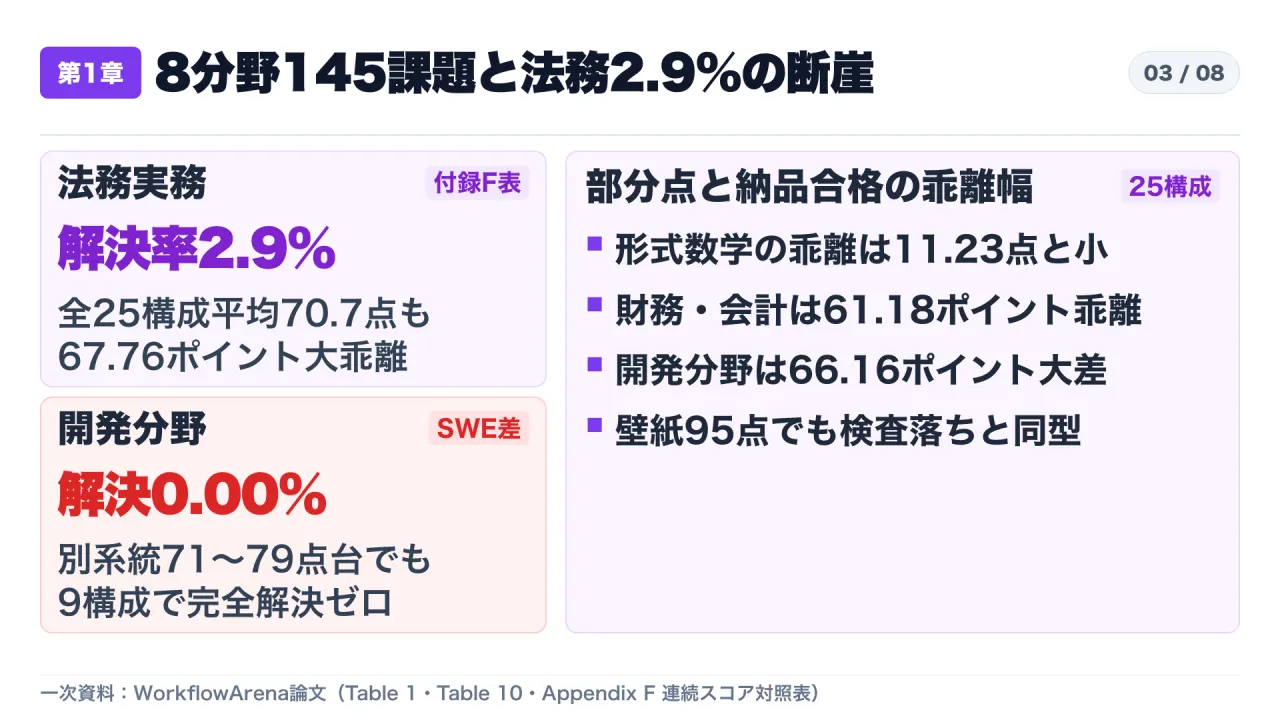
住宅リフォームに例えれば、壁紙も床材も照明もそれぞれ95点の仕上がりなのに、コンセントの位置が造作家具と干渉しており、引き渡しの建築検査で不合格になる状態です。実務の現場では「AIの出力を人間が部分的に見ると非常に賢いのに、本番へそのまま統合すると動かない」という現象が起きる明確な数値的裏付けと言えます。
3. コスト構造の検算:費用4.4倍でも解決率が下がる単価逆転
次に、論文第4章第3節(Section 4.3)の資源消費分析と付録Table 8のAPI単価表をもとに、1課題あたりの計算コストと完全解決率の関係を検算します。
実験対象モデルのAPI単価は、未キャッシュ入力100万トークンあたり 0.10ドル〜10.00ドル、出力100万トークンあたり 0.50ドル〜50.00ドル と、モデル間で 100倍以上の価格差 があります。この単価差がマルチエージェントの並列呼び出しと掛け合わさることで、コストと成果が逆転する現象が観測されました。
| 構成区分(推論負荷設定) | 1課題あたりの推定費用 | 完全解決率(145課題) | コスト効率・比較検算(一次資料 Section 4.3) |
|---|---|---|---|
| 一括並列型・最上位(high) | 6.66ドル | 34.11% | 平均 736万(7.36M)トークン 消費。トークン効率とコスト効率のフロンティア |
| 高頻度委任型・最上位(xhigh) | 29.26ドル | 30.80% | 上記high構成より解決率が 3.31ポイント低いのに費用は4.4倍(29.26÷6.66=4.39倍) |
| 高頻度委任型・効率版(low) | 3.61ドル | 27.59% | 高額構成の約8分の1の費用で27.59%を確保(高額構成との差は3.21ポイント) |
さらに同じモデル内で推論負荷を上げた場合の費用対効果も一様ではありません。一括並列型の中位モデルでは、high設定からmax設定へ引き上げるとトークン消費量が 3.2倍 になる一方、完全解決率は 7.95ポイント 上昇しました(25.26%→33.21%)。対照的に別系統の効率モデルでは、low設定からxhigh設定へ上げてトークン消費量を 1.9倍 に増やしても、完全解決率は 1.91ポイント しか伸びませんでした(27.59%→29.50%)。
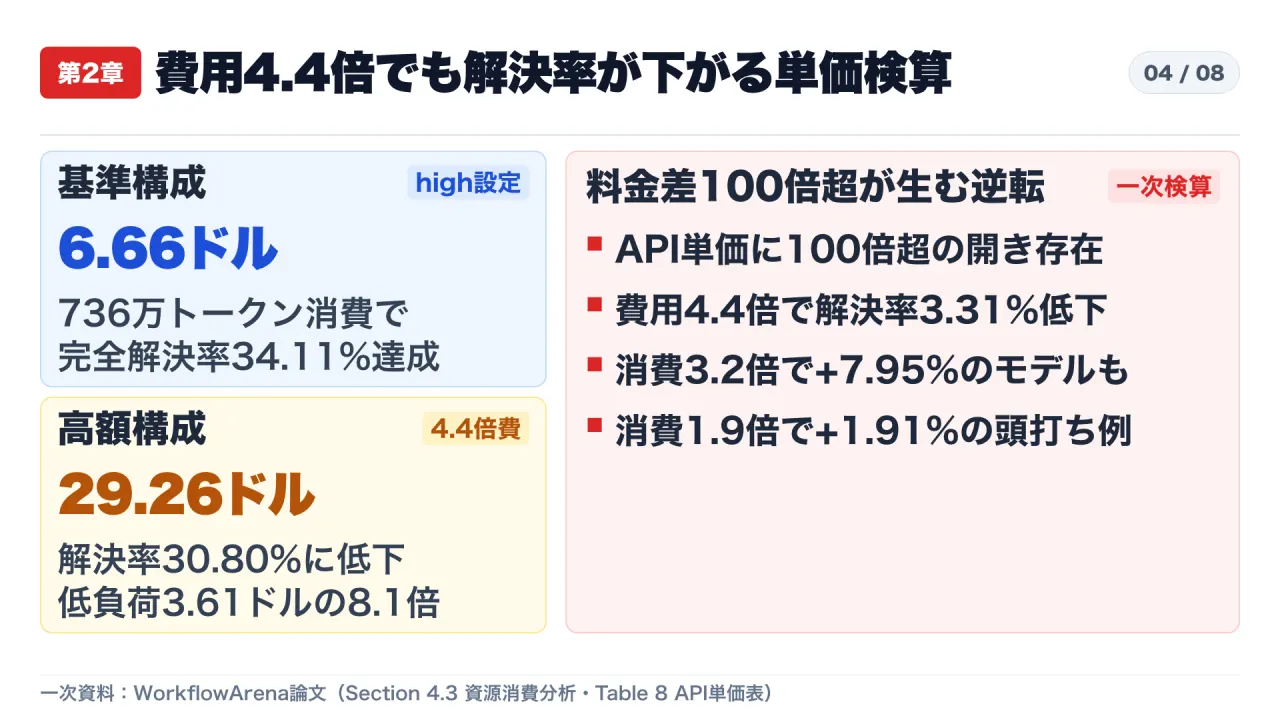
時給4倍の高級専門相談員を雇ったにもかかわらず、細切れの打ち合わせばかり増やして納期に追われ、手頃なチームより成果が少ない状態に陥っている構図です。
4. 2つの委任スタイルと「設計能力・実行能力の分離」
なぜ高い単独能力や高い費用をかけても、複数AIの運用が安定しないのでしょうか。論文第4章第4節と第5節は、実行基盤ごとの委任の癖と、単独能力と設計能力が別物である事実を示しています。
高負荷(high)設定における委任行動の対照的な癖
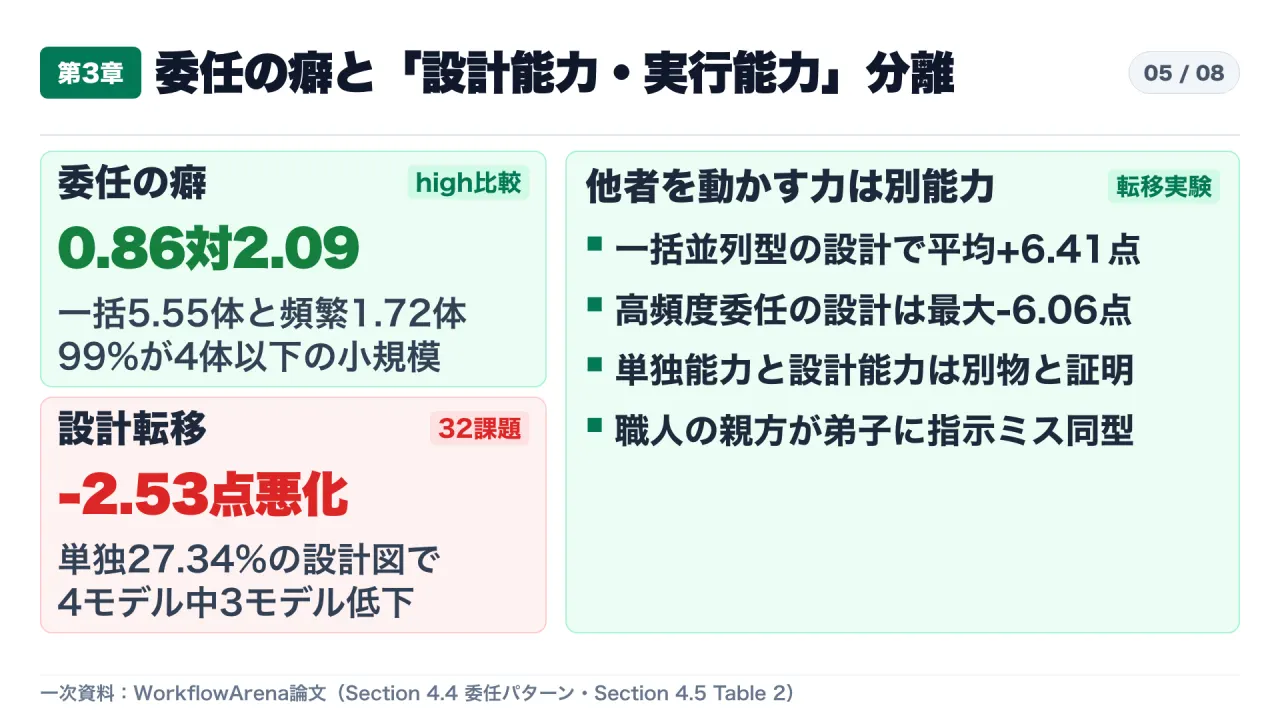
- 一括並列型の実行基盤(上位2モデル): 1課題あたりのワークフロー呼び出しは平均 0.86回・0.76回 と少ない一方、1回の起動で平均 5.55体・6.14体 のワーカーを一括投入する。呼び出しあり課題のうち単発起動が 70%・68% を占め、9体以上の大規模集団を起動する割合が 24%・30% に達する。
- 高頻度委任型の実行基盤(主力2モデル): 1課題あたり平均 2.09回・1.94回 と高頻度に呼び出しを繰り返し、1回あたりの起動規模は平均 1.72体・1.69体 にとどまる。起動されたワークフローの 約99%が4体以下 で、単発起動は 約32%。
難関32課題のワークフロー転移実験(Section 4.5 / Table 2)
研究チームは「自分で解く力」と「他者を動かして解かせる力」を切り分けるため、8分野の難関32課題を抽出し、2つの上位モデル(max設定)にファイル編集を一切禁止して設計だけを担当させ、単独解決率6.08%〜16.48%の軽量な4つの実行モデルへ作業を任せる転移実験を行いました。
| 実行モデル(単独解決率) | 自力動的制御(Self) | 高頻度側設計・静的 | 高頻度側設計・動的 | 一括側設計・静的 | 一括側設計・動的 |
|---|---|---|---|---|---|
| 軽量実行モデルA(16.48%) | 35.75 | 29.69(-6.06) | 33.80(-1.95) | 45.04(+9.29) | 46.61(+10.86) |
| 軽量実行モデルB(13.32%) | 25.08 | 24.87(-0.21) | 29.22(+4.14) | 30.37(+5.29) | 25.35(+0.27) |
| 軽量実行モデルC(10.84%) | 20.39 | 22.07(+1.68) | 24.25(+3.86) | 28.04(+7.65) | 27.46(+7.07) |
| 軽量実行モデルD(6.08%) | 18.37 | 12.85(-5.52) | 17.69(-0.68) | 21.79(+3.42) | 25.24(+6.87) |
| 4モデル単純平均 | 24.90 | 22.37(-2.53) | 26.24(+1.34) | 31.31(+6.41) | 31.17(+6.27) |
この表から、実務に直結する2つの重要なメカニズムが判明しています。
第1に、単独で優秀なモデルが優れた設計者になるとは限らないという点です。高頻度委任側の設計役は単独では27.34%を解決する実力者でありながら、自ら手を動かさずに静的設計図(Static)を4モデルへ渡すと、4モデル中3モデルで自力実行時を下回り、平均 2.53ポイント悪化 させました。対照的に、一括並列側の最上位モデルによる設計は4モデルすべての成績を押し上げ、静的モードで平均 +6.41ポイント、動的モードで +6.27ポイント 改善させています。
第2に、軽量実行モデルBにおける静的設計と動的再介入の極端な非対称性です。一括並列側の最上位モデルが事前に手順を固める静的設計図(Static)を渡したときは 25.08点→30.37点(+5.29点) へ大幅に向上したにもかかわらず、途中で結果を見て指示を出し直す動的制御(Dynamic)では 25.35点(+0.27点) に失速し、もう一方のモデルの動的制御(29.22点)にも及ばなくなりました。
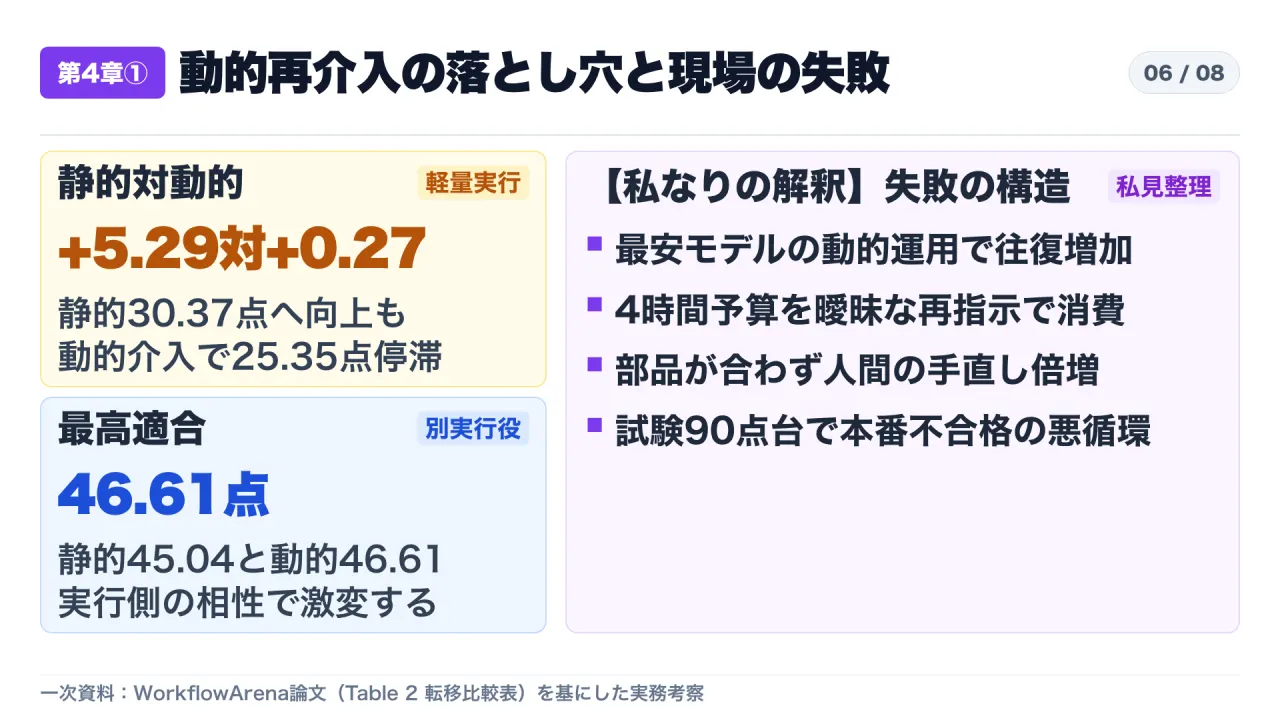
超一流の職人親方が自分で作れば完璧なのに、弟子向けの段取り表にすると前提を飛ばしてしまい、現場が混乱して弟子だけで進めたときより品質が落ちる構図、そして不慣れな作業員に対して作業途中で何度も指示を書き換えるほど整合性が崩れる構図がそのまま数値に表れています。
5. 未確認事項の分離と企業が導入すべき3つの防衛境界
一次資料に基づき冷静な判断を下すため、論文データから確定している事実と、本論文の集計表だけでは未確認の事項を明確に区別します。
- 未確認事項1(転移実験の完全解決率と分野別内訳): 難関32課題の転移実験(Table 2)で報告されているのは0〜100の「連続スコア」であり、32課題における「完全解決率」や8分野別の転移効果は公式集計表に含まれていません。
- 未確認事項2(ハイブリッド構成の総API費用): 主実験の単体運用については平均トークン消費量と推定費用(6.66ドル対29.26ドル等)が示されていますが、設計役と実行役を別モデルで組んだ転移実験ごとの個別トークン消費量・API総コストの集計表は一次資料に掲載されておらず、設計役単独運用より確実に安くなるかは自社タスクでの実測が必要です。
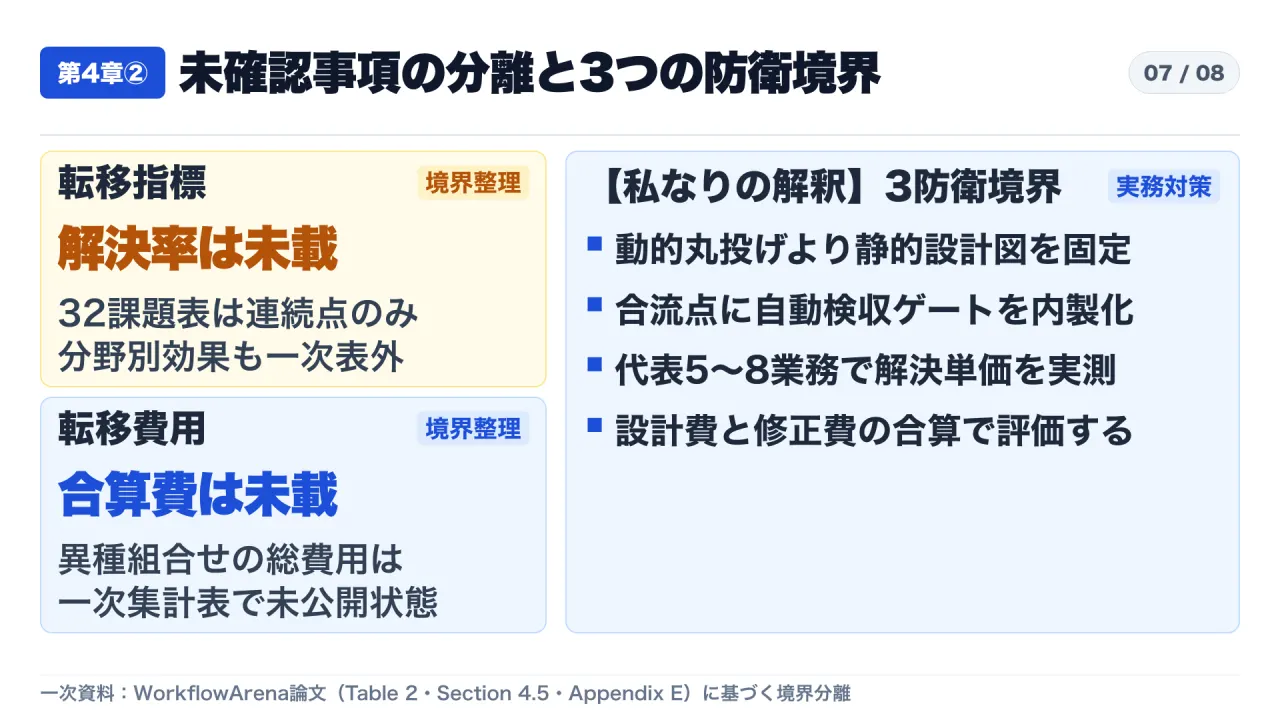
以上の事実と境界を踏まえ、企業の開発・業務自動化チームが直ちに実装すべき3つの防衛境界は次の通りです。
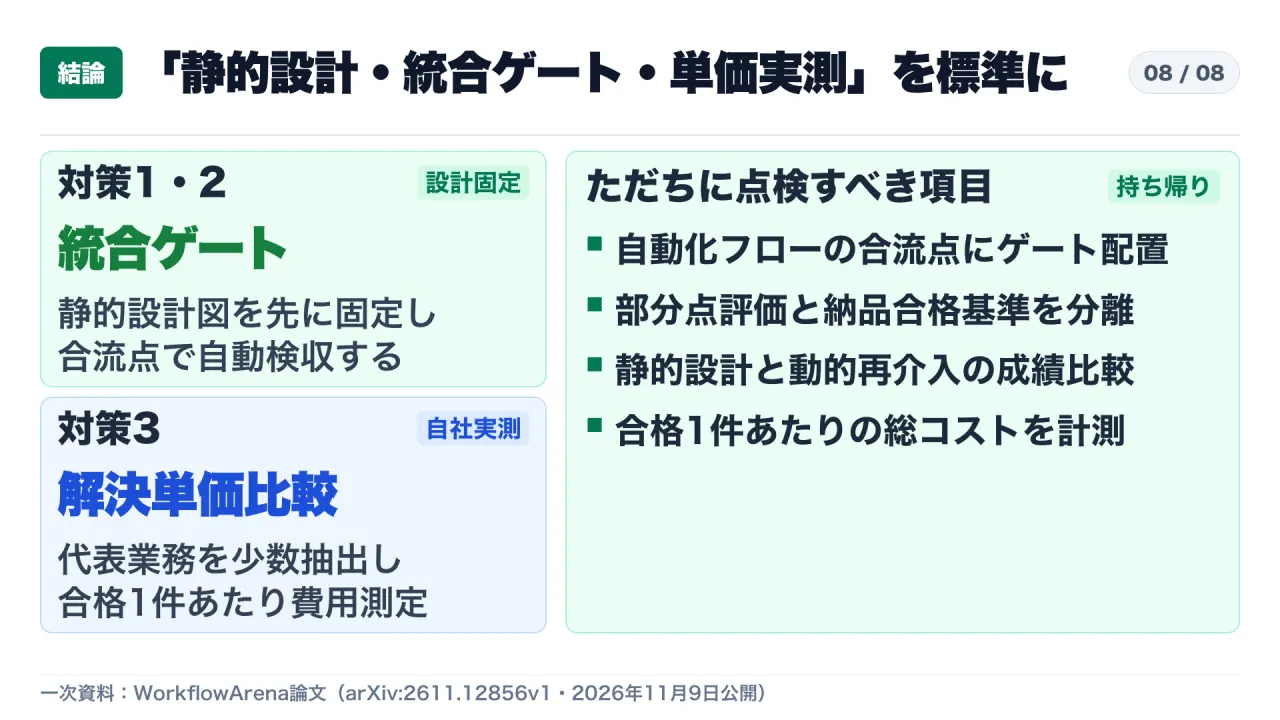
- 動的丸投げより「静的設計図と統合ゲート」を固定する 軽量・低単価なモデルを実行側に据える場合ほど、実行中のAIに動的な再計画を委ねるよりも、タスクの分解単位・入出力スキーマ・責任境界をあらかじめ固定した静的ワークフローを優先してください。
- 部分点ではなく「納品合格基準の決定論的ゲート」を合流点に置く ソフトウェア開発で96.98点、法務で70.7点を取っても納品基準を落とせば実務価値はゼロです。各ワーカーの成果物が合流する地点に、型チェック、回帰テスト、数値・契約整合性チェックを機械的に実行する統合ゲートを内製化し、不合格品を下流へ流さない構造を徹底してください。
- 代表5〜8業務の層化サンプリングで「合格1件あたりの総コスト」を実測する 145課題のような大規模ベンチマークに頼るのではなく、自社の主要業務(例:コード改修5件、文書・契約統合3件)を抜き出し、設計側と実行側、さらに人間の手直し工数まで合算した「合格1件あたりの実質単価」で運用構成を選定してください。
参照一次資料
- S1: WorkflowArena: Benchmarking Executable Workflow Orchestration in LLM-Based Multi-Agent Systems (arXiv:2611.12856, 2026-11-09)
- S2: WorkflowArena HTML全文(Table 1・Table 2・Table 8・Table 10・Section 4.3〜4.5・Appendix E/F)
一次資料・出典リンク
- WorkflowArena HTML全文 (arXiv:2611.12856v1)
- WorkflowArena: Benchmarking Executable Workflow Orchestration in LLM-Based Multi-Agent Systems (arXiv:2611.12856, 2026-11-09)